Si usas ClickHouse Cloud en Google Cloud, esta página no aplica, ya que tus servicios ya usarán Google Cloud Storage. Si buscas hacer
SELECT o INSERT de datos desde GCS, consulta la table function gcs.conf.d. A continuación se muestra un ejemplo de declaración de un disco de GCS. Esta configuración incluye varias secciones para configurar el “disco” de GCS, la caché y la política que se especifica en las consultas DDL cuando se crean tablas en el disco de GCS. A continuación se describe cada una de ellas.
Esta parte de la configuración se muestra en la sección resaltada y especifica lo siguiente:
- El tipo de disco es
s3porque se utiliza la API de S3. - El endpoint proporcionado por GCS
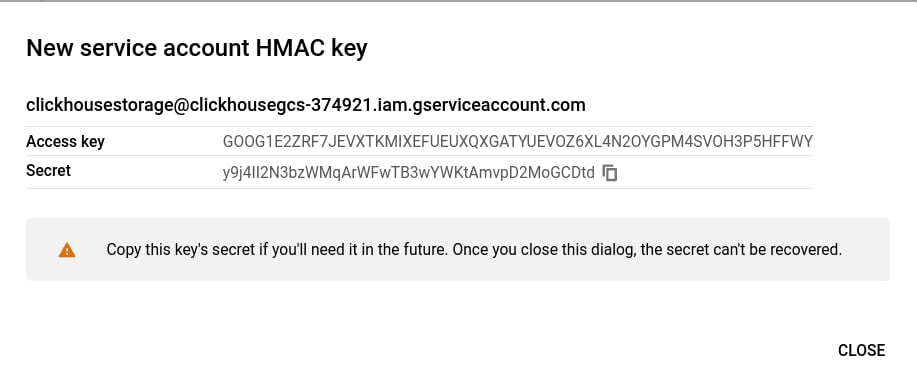
- La clave HMAC y el secreto de la cuenta de servicio
- La ruta de metadatos en el disco local
gcs.
gcs especificando la política gcs_main. Por ejemplo, CREATE TABLE ... SETTINGS storage_policy='gcs_main'.
ReplicatedMergeTree. Consulta la guía replicación de un único segmento en dos regiones de GCP mediante GCS para obtener más información.
La API XML de Cloud Storage es compatible con algunas herramientas y bibliotecas que funcionan con servicios como Amazon Simple Storage Service (Amazon S3).
Para obtener más información sobre cómo ajustar los hilos, consulta Optimización del rendimiento.
Este tutorial se ha escrito para describir una implementación replicada de ClickHouse que se ejecuta en Google Cloud y utiliza Google Cloud Storage (GCS) como “tipo” de disco de almacenamiento de ClickHouse.
En este tutorial, implementará nodos de servidor de ClickHouse en máquinas virtuales de Google Compute Engine, cada uno con un bucket de GCS asociado para el almacenamiento. La replicación la coordina un conjunto de nodos de ClickHouse Keeper, también implementados como máquinas virtuales.
Requisitos de ejemplo para alta disponibilidad:
- Dos nodos de servidor de ClickHouse, en dos regiones de GCP
- Dos buckets de GCS, implementados en las mismas regiones que los dos nodos de servidor de ClickHouse
- Tres nodos de ClickHouse Keeper; dos de ellos se implementan en las mismas regiones que los nodos de servidor de ClickHouse. El tercero puede estar en la misma región que uno de los dos primeros nodos de Keeper, pero en una zona de disponibilidad distinta.
* Puede ser una zona de disponibilidad distinta en la misma región que la 1 o la 2.
Despliegue ClickHouse en dos hosts; en las configuraciones de ejemplo, se llaman chnode1 y chnode2.
Ubique chnode1 en una región de GCP y chnode2 en otra. En esta guía se utilizan us-east1 y us-east4 para las VM de Compute Engine y también para los buckets de GCS.
No inicie
clickhouse server hasta haberlo configurado. Limítese a instalarlo.keepernode1, keepernode2 y keepernode3. keepernode1 puede implementarse en la misma región que chnode1, keepernode2 junto con chnode2 y keepernode3 en cualquiera de las dos regiones, pero en una zona de disponibilidad distinta a la del nodo de ClickHouse de esa región.
Consulte las instrucciones de instalación al realizar los pasos de implementación en los nodos de ClickHouse Keeper.
Los dos servidores de ClickHouse estarán ubicados en distintas regiones para garantizar alta disponibilidad. Cada uno tendrá un bucket de GCS en la misma región.
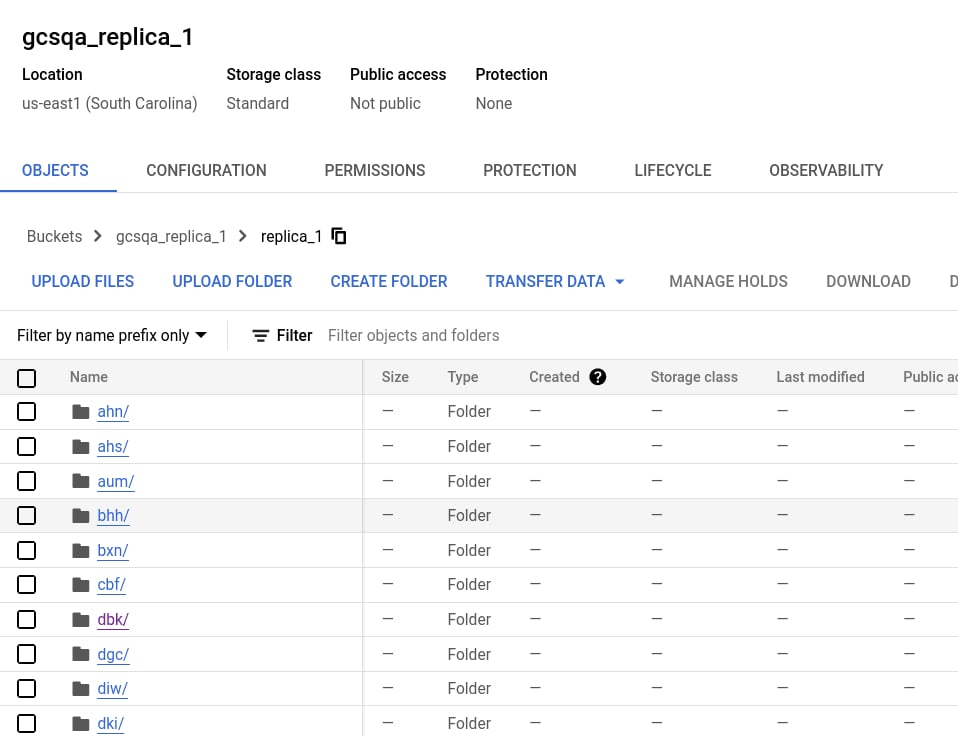
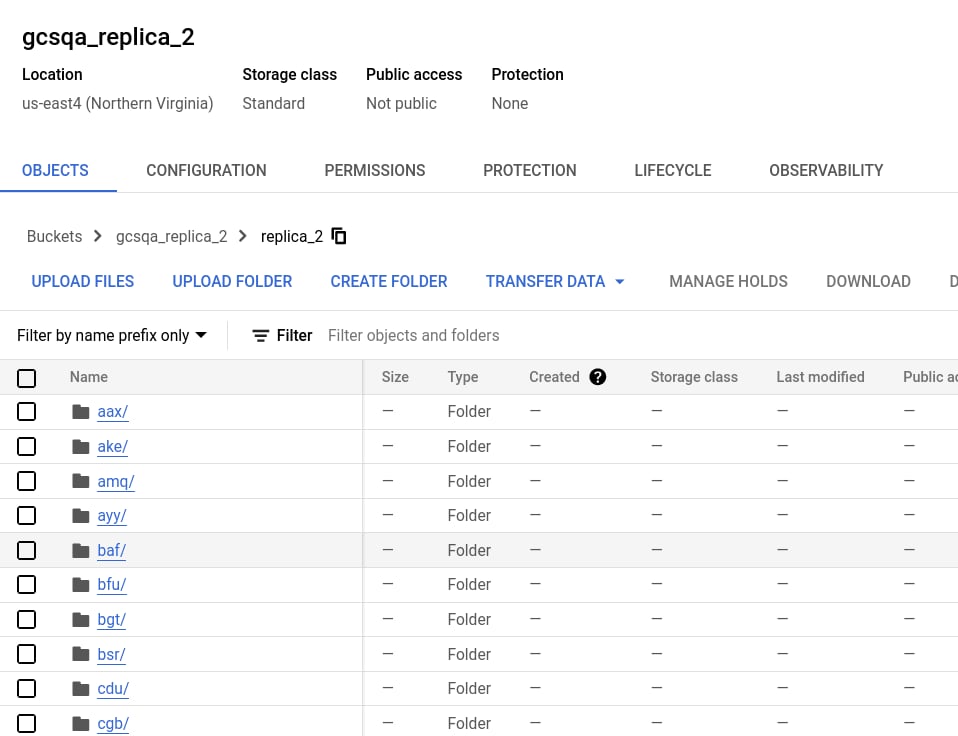
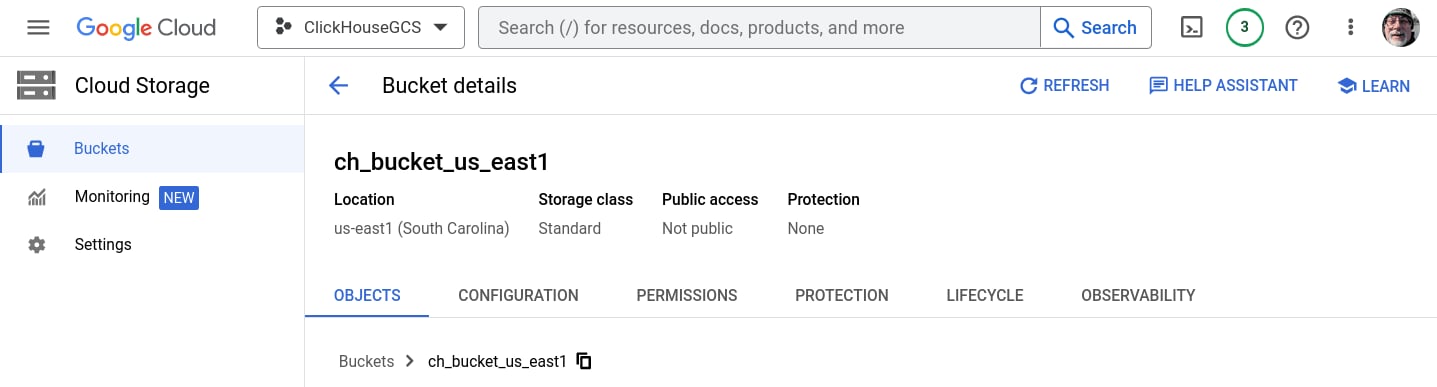
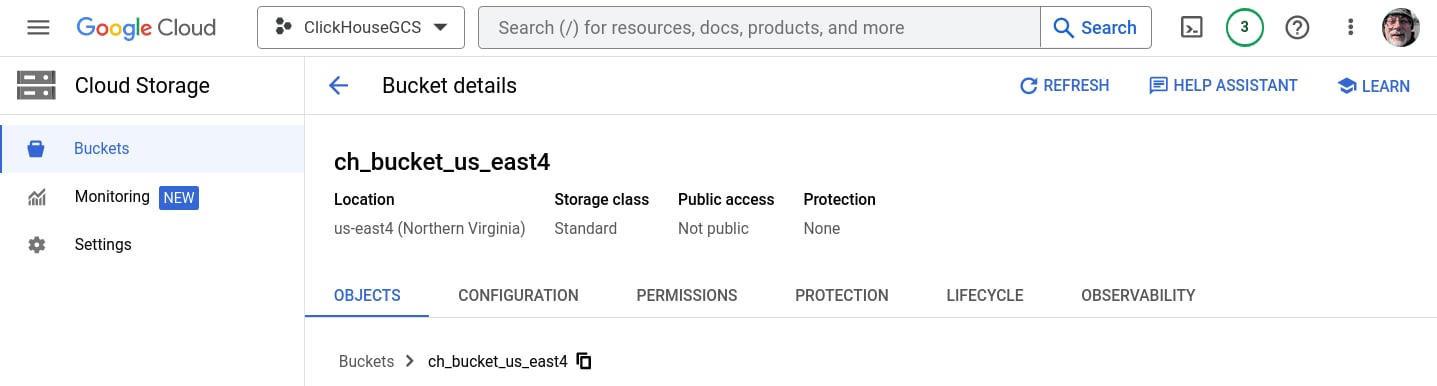
En Cloud Storage > Buckets, elija CREATE BUCKET. Para este tutorial, se crean dos buckets: uno en us-east1 y otro en us-east4. Los buckets son de región única, de clase de almacenamiento estándar y no son públicos. Cuando se le solicite, habilite la prevención de acceso público. No cree carpetas; se crearán cuando ClickHouse escriba en el almacenamiento.
Si necesita instrucciones paso a paso para crear buckets y una clave HMAC, expanda Create GCS buckets and an HMAC key y siga el procedimiento:
Crear buckets de GCS y una clave HMAC
Crear buckets de GCS y una clave HMAC
ch_bucket_us_east1
ch_bucket_us_east4
Generar una clave de acceso
Crear una clave HMAC y un secreto para una cuenta de servicio
Abra Cloud Storage > Settings > Interoperability y elija una Access key existente o CREATE A KEY FOR A SERVICE ACCOUNT. Esta guía explica cómo crear una nueva clave para una nueva cuenta de servicio.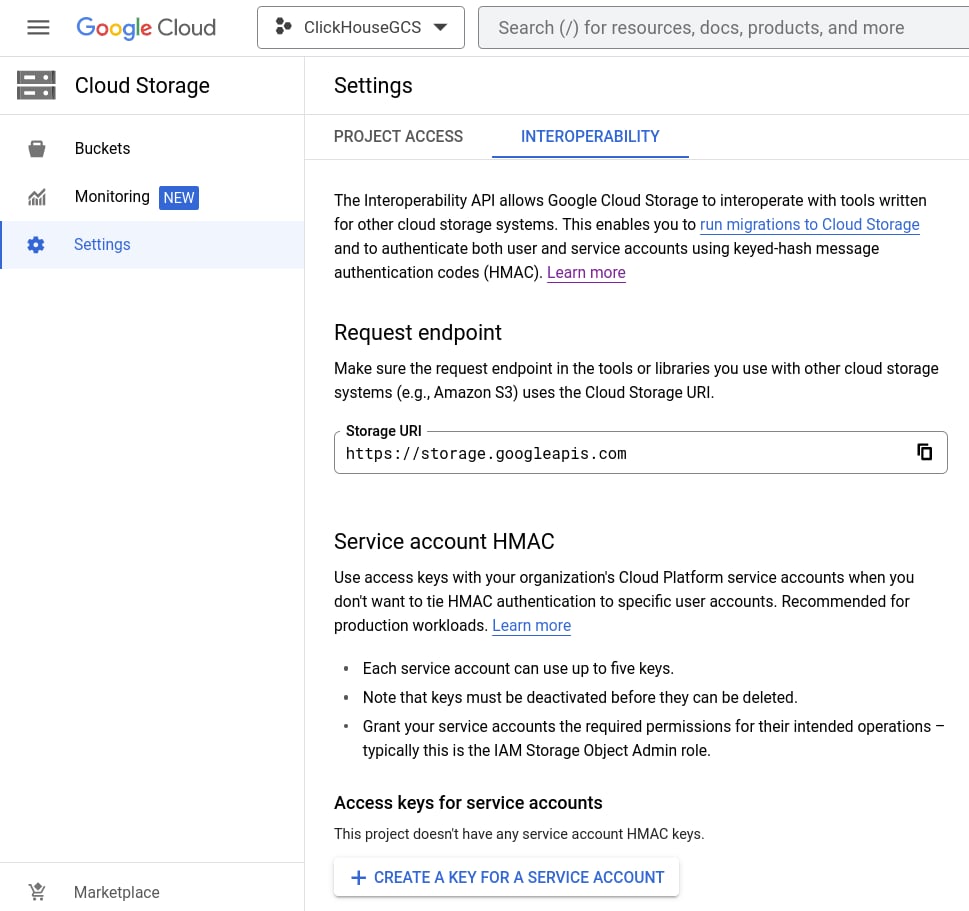
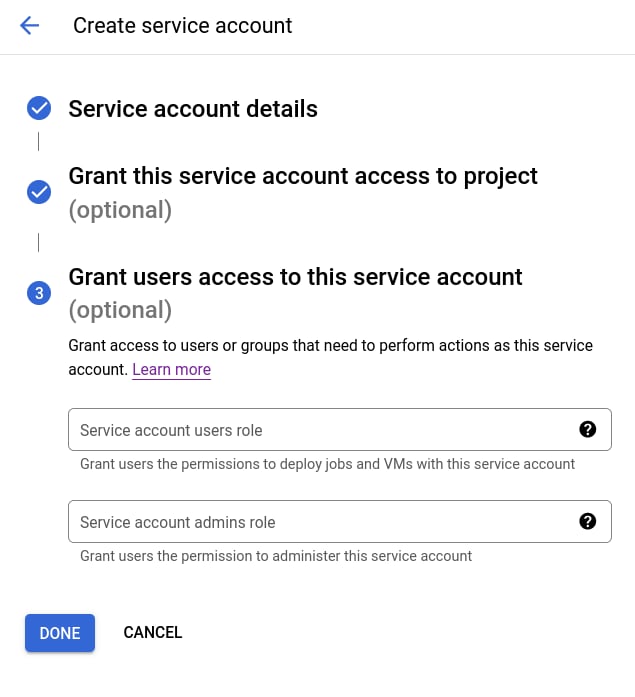
Agregar una nueva cuenta de servicio
Si se trata de un proyecto sin ninguna cuenta de servicio existente, haga clic en CREATE NEW ACCOUNT.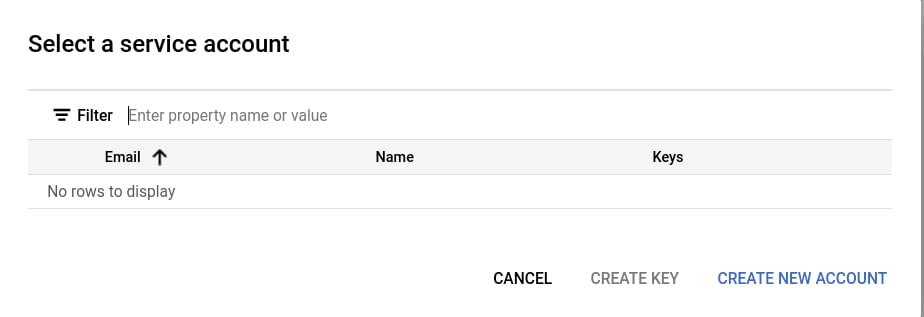
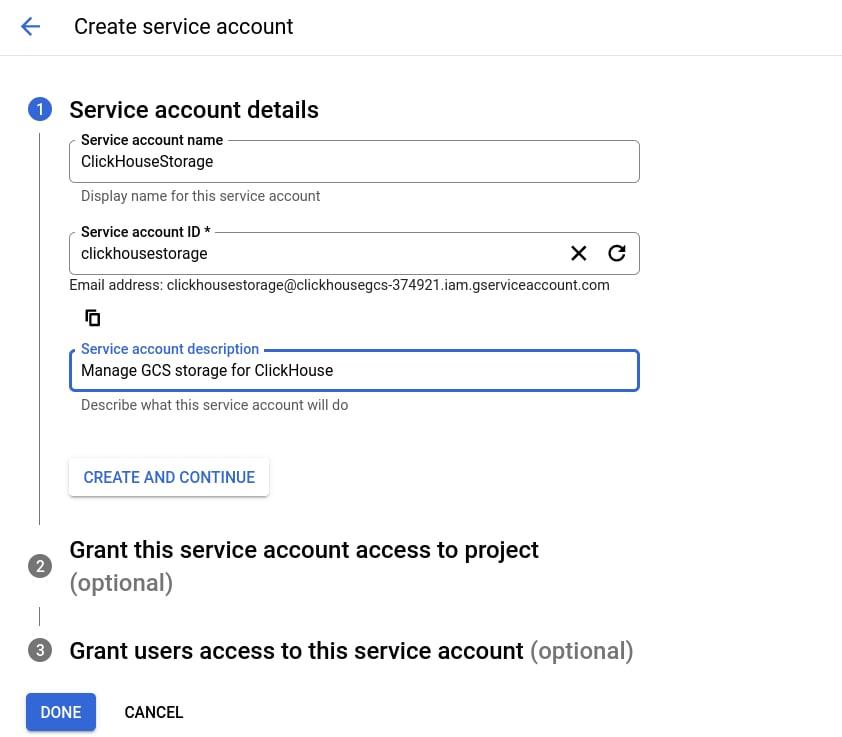
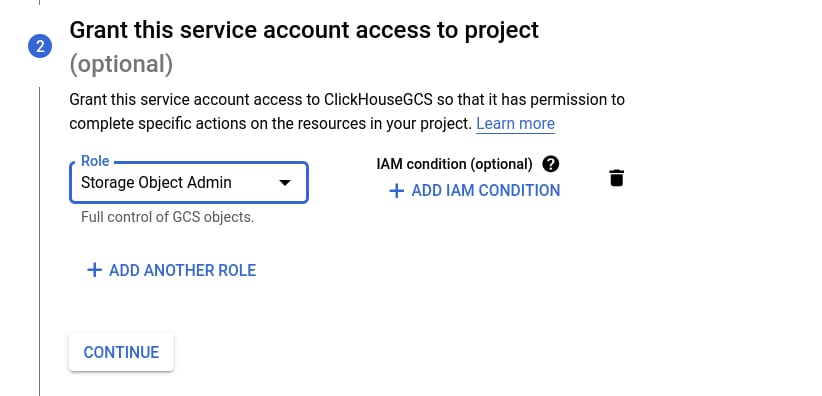
server_id (la primera línea resaltada a continuación). Modifique el archivo con los nombres de host de sus servidores de ClickHouse Keeper y, en cada uno de ellos, configure server_id para que coincida con la entrada server correspondiente en raft_configuration. Dado que en este ejemplo server_id está establecido en 3, hemos resaltado las líneas correspondientes en raft_configuration.
- Edite el archivo con sus nombres de host y asegúrese de que se resuelvan desde los nodos del servidor de ClickHouse y los nodos de Keeper
- Copie el archivo en la ubicación correspondiente (
/etc/clickhouse-keeper/keeper_config.xmlen cada uno de los servidores de Keeper - Edite el
server_iden cada máquina según el número de su entrada enraft_configuration
/etc/clickhouse-keeper/keeper_config.xml
práctica recomendadaEn algunos pasos de esta guía, se le pedirá que coloque un archivo de configuración en
/etc/clickhouse-server/config.d/. Esta es la ubicación predeterminada en los sistemas Linux para los archivos de sobrescritura de configuración. Cuando coloque estos archivos en ese directorio, ClickHouse fusionará su contenido con la configuración predeterminada. Al colocarlos en el directorio config.d, evitará perder la configuración durante una actualización./etc/clickhouse-server/config.d/network.xml
- Modifica los nombres de host para que coincidan con tus servidores Keeper
/etc/clickhouse-server/config.d/use-keeper.xml
replace="true" a la entrada remote_servers para que, cuando esta configuración se fusione con la predeterminada, reemplace la sección remote_servers en lugar de añadirse a ella.
- Edite el archivo con sus nombres de host y asegúrese de que se resuelvan desde los nodos del servidor de ClickHouse
/etc/clickhouse-server/config.d/remote-servers.xml
replica_1, y en el otro servidor como replica_2. Los nombres pueden cambiarse; siguiendo nuestro ejemplo de una réplica almacenada en Carolina del Sur y la otra en el norte de Virginia, los valores podrían ser carolina y virginia; solo asegúrese de que sean diferentes en cada máquina.
/etc/clickhouse-server/config.d/macros.xml
disks y policies. El disco que se configura a continuación se llama gcs y es de type s3. El tipo es s3 porque ClickHouse accede al bucket de GCS como si fuera un bucket de AWS S3. Se necesitarán dos copias de esta configuración, una para cada uno de los nodos del servidor de ClickHouse.
Estas sustituciones deben realizarse en la configuración siguiente.
Estas sustituciones difieren entre los dos nodos del servidor de ClickHouse:
REPLICA 1 BUCKETdebe establecerse con el nombre del bucket en la misma región que el servidorREPLICA 1 FOLDERdebe cambiarse areplica_1en uno de los servidores y areplica_2en el otro
access_key_iddebe establecerse con la clave HMAC generada anteriormentesecret_access_keydebe establecerse con el secreto HMAC generado anteriormente
/etc/clickhouse-server/config.d/storage.xml
netcat. Por ejemplo, mntr devuelve el estado del clúster de ClickHouse Keeper. Si ejecuta el comando en cada uno de los nodos de ClickHouse Keeper, verá que uno es el líder y los otros dos son seguidores:
chnode1 y chnode, ejecute:
system.disks debe contener registros para cada disco:
- default
- gcs
- cache
storage.xml. Expanda las carpetas y verá muchos archivos que representan las particiones de datos.