50.9k


コードの変更に追随し、整合性を保つ共有型エージェントメモリー。
Loom は、ClickHouse 上に構築されたオープンソースツールです。コーディングエージェントに共有のコードインデックスと学習内容の保存場所を提供し、次のセッションをゼロから始めずに済むようにします。
独自のベンチマークでは、Loom の導入によって ClickHouse コードに関する質問への平均回答品質スコアが 0.78 から 0.84 に向上しました。
なぜ Loom を開発したのか?
自律型コントリビューターの GroeneAI は、3月以降 ClickHouse のプルリクエストに取り組んできました。CI の失敗の再現、バグや不足しているテストの探索、レビューを通じた自身の PR の管理などを担当し、10月までに 3,000 件以上のプルリクエストがマージされました。しかし、これらの数字の裏には初期の弱点が隠れていました。GroeneAI のセッションは毎回、ほぼ何もない状態から始まっていたのです。
何もない状態からのスタートは、次第に大きな負担となっていきました。どのブランチも比較的標準的なライフサイクルをたどります。ビルド、夜間の CI 実行、その週の後半に戻ってくるレビュアー、前の火曜日からフレイキー(不安定)になったテストを発見する寄り道などです。標準的なプラクティスや細かな仕様が積み重なる中、過去の履歴に関する記憶がまったくないため、履歴の最新状態から作業を始める能力が痛切に不足していました。メモリーがなければ、エージェントは目の前の判断を下すために過去の履歴全体を最初から再構築しなければならず、最悪の場合は推測に頼ることになります。一方、メモリーがあれば、単に…思い出すだけです。あるセッションで GroeneAI は、特定の論理エラーが発生する throw 箇所が 2 箇所あり、作成中の修正では 1 箇所しかカバーされていないことを思い出し、コードを確認してメンテナーに正しい箇所を指摘しました。
そこで、メモリーシステムの検討を始めました。見つかった最も強力な 2 種類のエージェントメモリーツールを本番トラフィックで3か月間並行稼働させたところ、どちらもエージェントの回答を改善しました。その過程で、82,000 回以上のメモリー書き込みと 3 億 2,800 万文字におよぶエージェント自身のトランスクリプトが取り込まれ、各ツールの得意な点と苦手な点を詳細に把握できました。
これらのメモリーツールは、エージェントがコードについて書いた内容は記憶していましたが、コードそのものを見ることはできませんでした。ClickHouse は master ブランチに 92,000 件以上のファイルと 318,000 件以上のコミットを抱え、長年にわたり約 2,700 人の手によって書かれており、中央値で見ても1つのファイルが6人の異なる作成者によって編集されています。参考に比較すると、このコミット数は GCC、MySQL、Kubernetes よりも多い規模です。コミットの全タイムラインを頭の中に保持できる人はいません(保持すべきでもありません)し、メモリーツールにもそれは不可能でした。コードに関する記憶は永続化されても、コード検索自体はローカルにとどまったままでした。ローカルのコード検索は独自のプライベートインデックスを保持しており、どの関数がどの関数を呼び出しているかや、すべてのピースがどのように組み合わさっているかを教えてくれませんでした。コードの検索とその推論は、開発者のラップトップ上の Terminal.app の中でたまたま隣り合っているような 2 系統のシステムではなく、同一のシステムへと統合される必要がありました。
ここでツールの評価を打ち切り、開発へと舵を切りました。私たちが求めていたのは、トランスクリプトだけでなくリポジトリ自体も理解し、GroeneAI が学んだ内容を非公開情報を晒すことなく再利用して人間や他のエージェントと共有できるメモリーでした。そうして生まれたのが Loom です。
開発したもの
Loom は、同一の権限セットのもとで、単一の ClickHouse データベース内にメモリーとコードインデックスを保持します。メンテナーのメモはそのソースとともに保存され、説明対象のコードと紐付けられるため、後からその内容がまだ正確かどうかを判断できます。また、すべての実行ログも記録され、エージェントが何を読み込み、いくらのコストがかかり、実際に完了したかどうかも記録されます。
Loom はオープンソースであり、どのチームでも自身のリポジトリに対して自身のエージェントを使って実行できます。
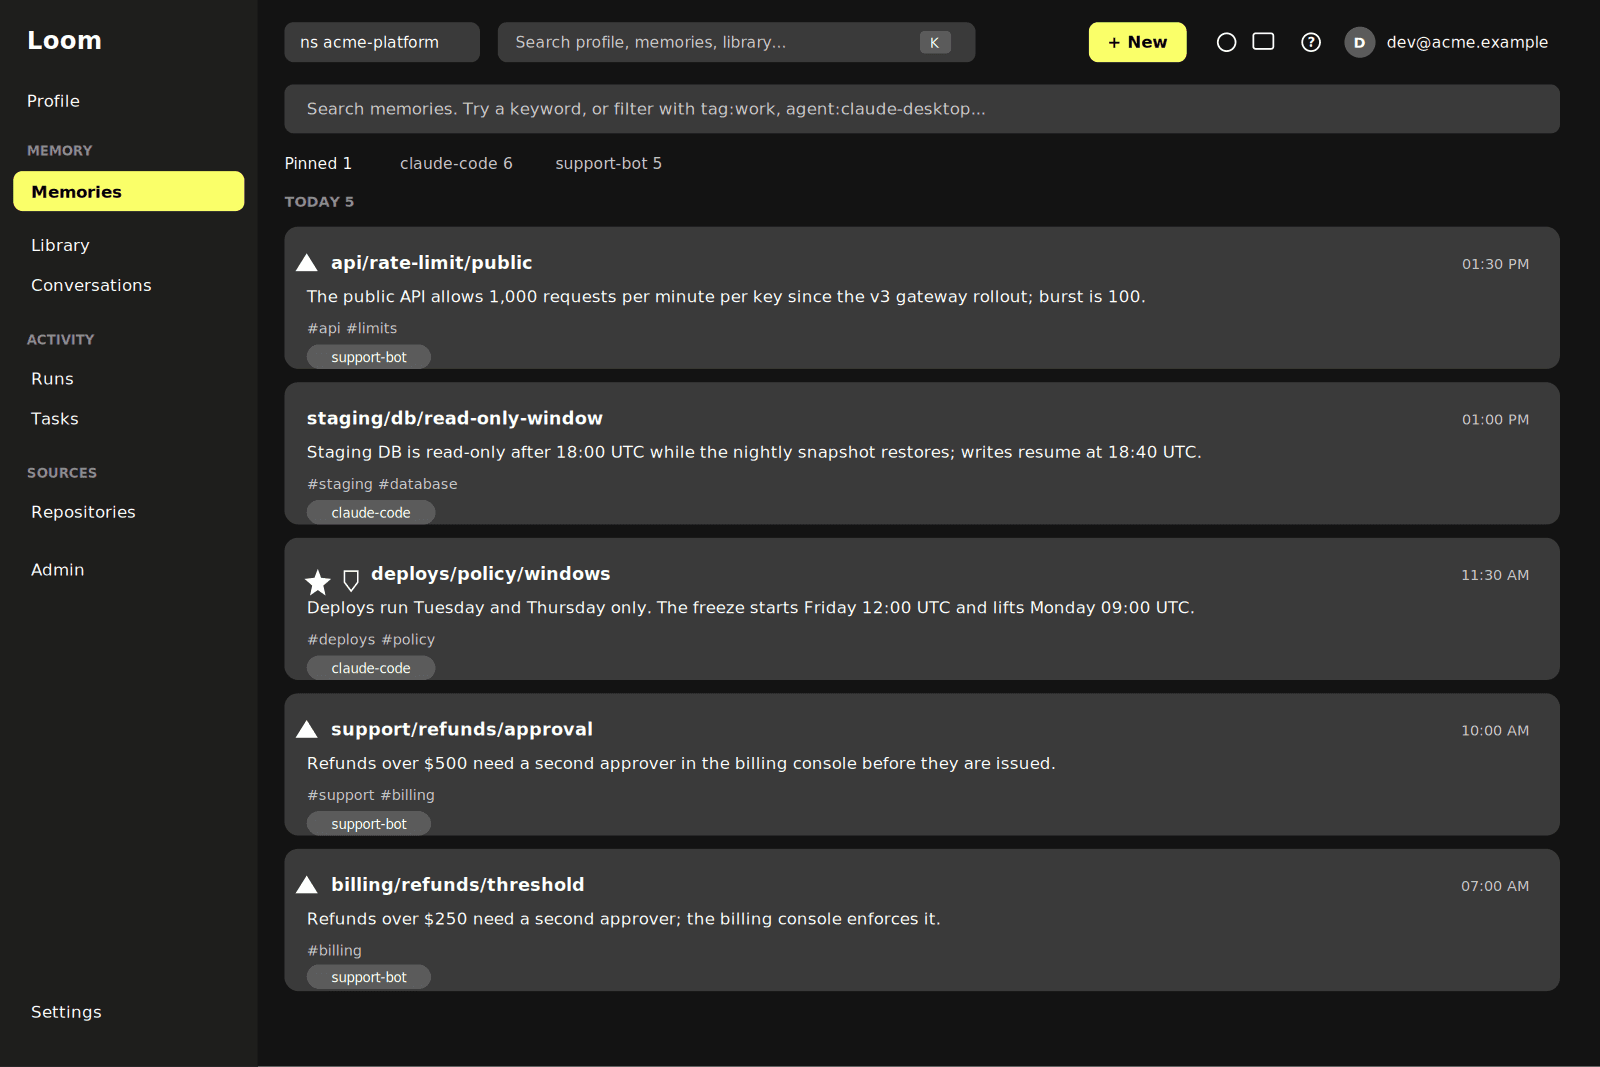
メモリーとコードインデックスは単体でも機能しますが、連動して動作するように設計されています。クライアントが MCP、HTTP API、または Python/TypeScript SDK 経由で接続すると、その単一の接続でメモリーの保存、コードの検索、実行ログの記録、ドキュメントの検索を行えます。
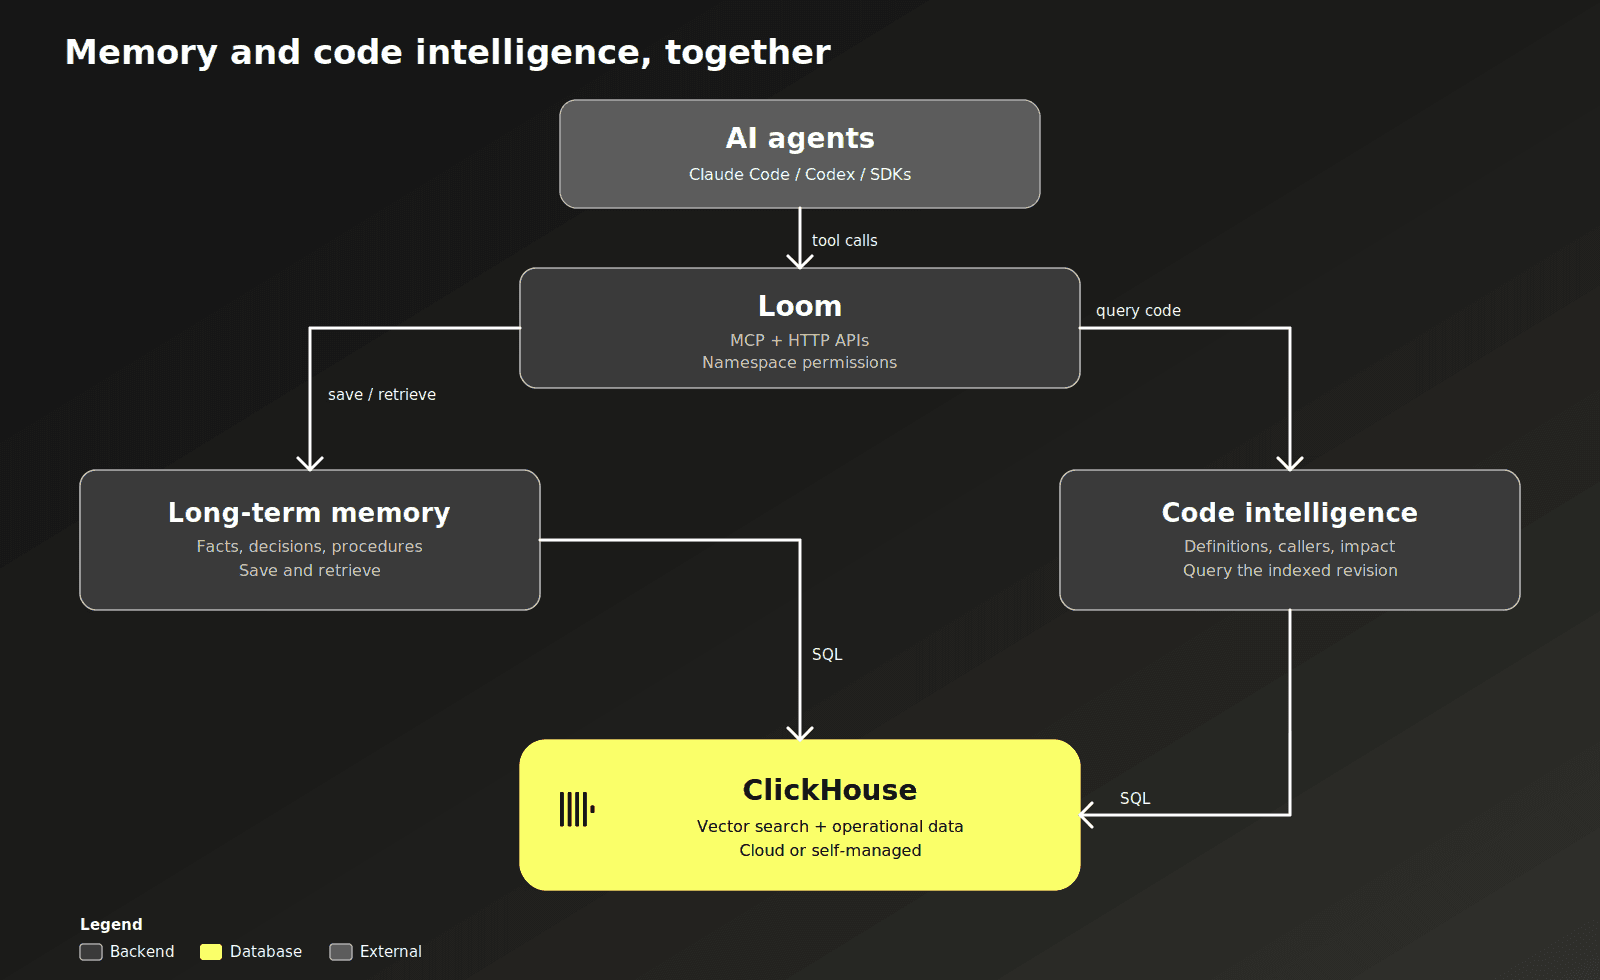
Loom は実際にどのように動作するのか?
昨今あふれるブログ記事の華やかな権威付けを鵜呑みにしたくはないからこそ、Loom を他のメモリーツールと差別化するコンセプトや、開発の過程で下された設計上の決定について説明します。
Loom は何を記憶できるのか?
ファクト、設定の好み、段階的な手順は通常の検索に表示されます。完了した作業の振り返り、過去のイベント、背景プロファイル、進行中作業の一時的なメモなどは、明示的に要求されない限り通常は表に出てきません。
ファクトはただ蓄積されて古くなるのではなく、改訂されていきます。例えば、エージェントが3月に、あるサービスのデフォルトが max_threads: 16 であると記録し、6月にそのデフォルトが2倍になったことを知ったとします。6月の情報が3月の情報を消去するわけではありません。同じファクトの新しいバージョンとなり、4月時点で何が正しかったかを尋ねれば、過去の値も確認できます。2人のユーザーが似たトピックに関して競合するファクトを保存した場合、Loom はどちらか一方を勝手に選ぶのではなく、フラグを立てて通知します。また、ピン留め機能により、重要なファクトが更新によって知らないうちに上書きされるのを防ぎます。人間の脳と同じように、メモリーは新しいコンテキストとともに進化しながらも、いつ何を学んだかの履歴を保持します。子供時代のベッドの下で埃をかぶっているノートの山をひっくり返すことなく、データベースに書き出せるのは便利な点です。
ドキュメント、手順、単発のタスクも同様に扱われます。関連性がある場合は検索可能になり、それ以外の場合は邪魔になりません。コードに関するファクトは実際の定義とも照合され、該当するコードが変更された場合にはフラグが立てられます。人間は自身が担当してきたコードの状態やその変更を記憶することには長けていますが、ClickHouse のように拡大し続けるリポジトリにおいて、すべての人間が他のあらゆる人間の作業の状態や変更を一元的に把握することを期待するのは無理があります。
コードをどのように読み取るのか?
エージェントが何かを尋ねる前に、Loom はすでにリポジトリを読み込んでいます。すべての関数、すべてのクラス、そしてどれがどれを呼び出しているかまで把握しています。何かがどこに実装されているか、あるいは特定の関数を何が呼び出しているかを尋ねると、検索語句に一致した単なるテキストや、定番の「回答する前にコードを読ませてください!」というフルクローンを伴う返答ではなく、実際のコードとファイルパスが返ってきます。高速なパスがほとんどの言語をカバーし、主要な言語についてはより低速ながらコンパイラ精度のパスが補完し、より精度の高い結果が採用されます。
この同じインデックスにより、保存されたメモリーが古くなっている可能性を Loom が検知できます。ある関数を2回呼び出すとバッファがリークするというメモがあり、その関数の名前が変更された場合、Loom はその名前変更に追従します。関数そのものが書き直された場合、メモは静かに陳腐化するのではなく、レビュー用のフラグが立てられます。何も自動的に書き換えられることはありません。フラグの立ったメモリーには変更済みと表示されるため、次にそれを読む人は再確認が必要だと分かります。専門知識を維持するために自分が調べ直さなければならなかった瞬間をすべて指摘してくれる付箋が、頭の中のモニターにびっしり貼られている様子を想像してみてください…便利かもしれません。しかし、全員が他の全員の付箋を活用でき、何百ものメモリーバンクが同じようなファクトを何百個も重複して生成せずに済むとしたら、さらに素晴らしいはずです。それらを共有できたら便利だと思いませんか?
チームでメモリーを共有する方法
ある開発者が Claude Code を使って変更による影響範囲を特定し、別の開発者が別のラップトップで Codex を使って実際の変更作業を行うとします。両者が同じ Loom デプロイを指していれば、両方のエージェントが同じ名前空間に対して読み書きを行うため、Codex が作業を開始した時点で Claude Code の調査結果(ソースやコミットを含む)がそのまま利用可能です。
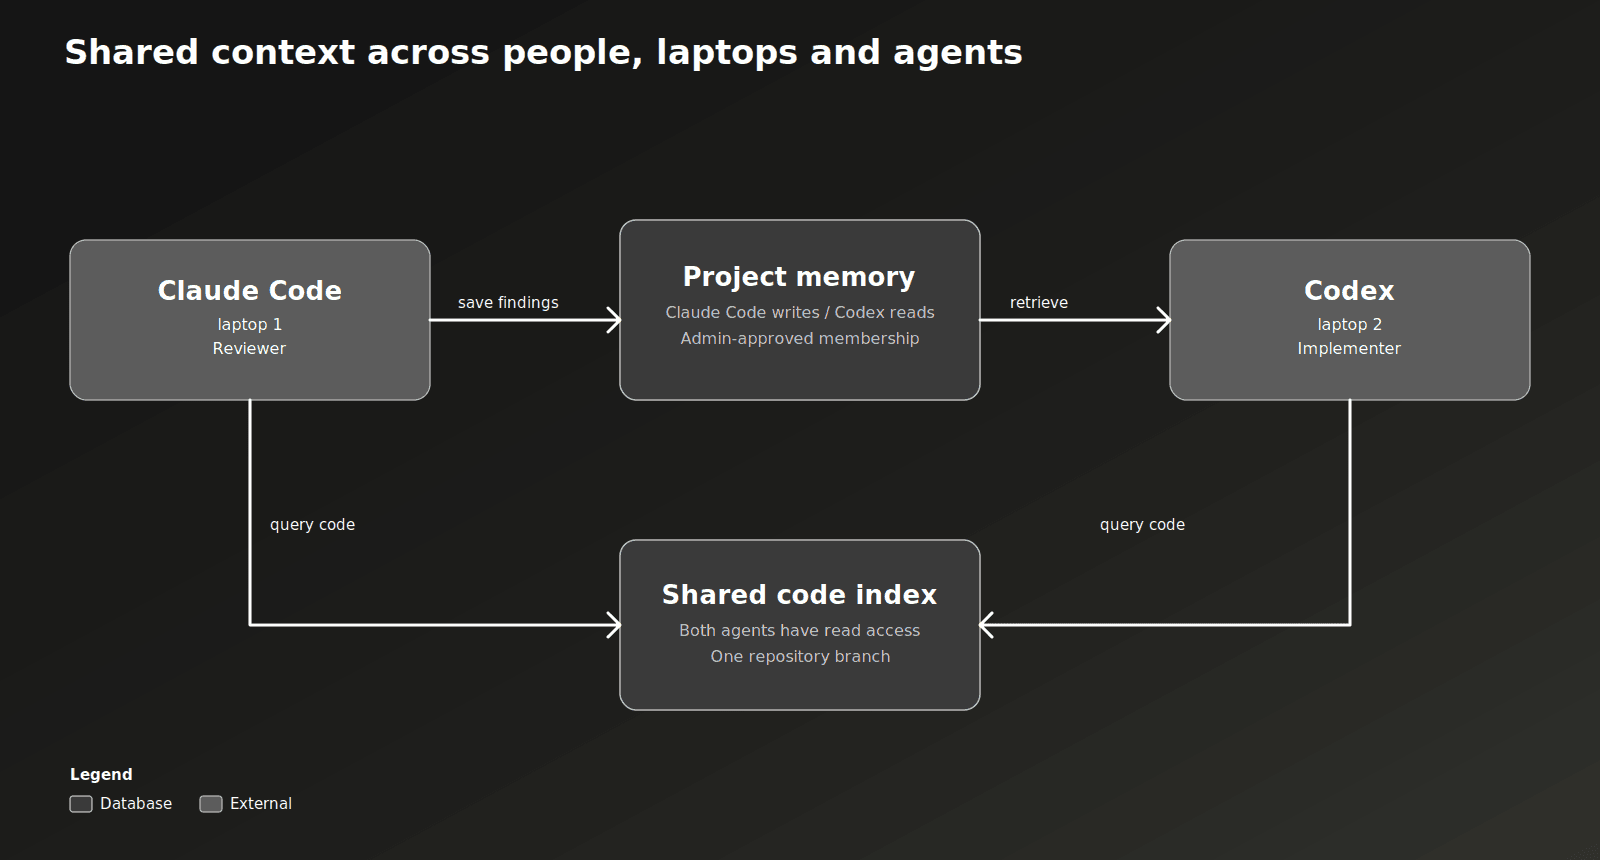
各エージェントにどちらの権限を与えるかは制御できます。全員のメモリーを同じ名前空間に放り込んで「早い者勝ち」にしているわけではありません。以下のような運用パターンを採用しています。
- 一方向(One-way):調査エージェントが書き込み、コーディングエージェントが読み取る構成。コストの大半を調査とタスク割り当てに費やす場合に、推論コストを削減するのに適しています。二度測って一度で切るようなものですが、これまでに測ったすべての測定値を完全に記憶している状態です。
- 双方向/N方向(Two/N-way):双方または全員が読み書きする構成。企業文化や社内用語の社内ナレッジベースに適しています。「トピック X はどのチームに聞くべきか」「質問 Y に最適な Slack チャンネルはどこか」、そして最も重要な「みんなが使っているこの謎の絵文字は何なのか」といった情報です。
- 個人から共有への昇格(Personal-to-Shared Promotions):共有チーム名前空間から読み取りつつ、自身の名前空間に書き込み、共有できる状態になったら昇格させる構成。チームは他のアクセス制御と同様に、名前空間をオープン、承認制、またはクローズドに設定できます。コードベースの趣向や設計判断の維持で協力が必要なチーム(まさに ClickHouse です)に適しており、コードと同じようにメモリーもレビューとメンテナンスが可能になります。
メモリー検索は実際にどのように実行されるのか?
エージェントがメモリーに質問すると、Loom は単なる最近傍探索を1回実行するだけではありません。質問を埋め込みベクトルに変換し、ClickHouse 内で複数の検索を同時に実行します。ファクトの埋め込みに対するベクトル検索、同じファクトに対する BM25 スコアリングを用いたキーワード検索、長い値の逐語的チャンクに対する走査、そして質問に人物やサービスの名前が含まれている場合はエンティティグラフをたどるホップ検索です。これらは後からフィルタリングされるのではなく、クエリの内部で呼び出し元が読み取り可能な名前空間にあらかじめ絞り込まれます。
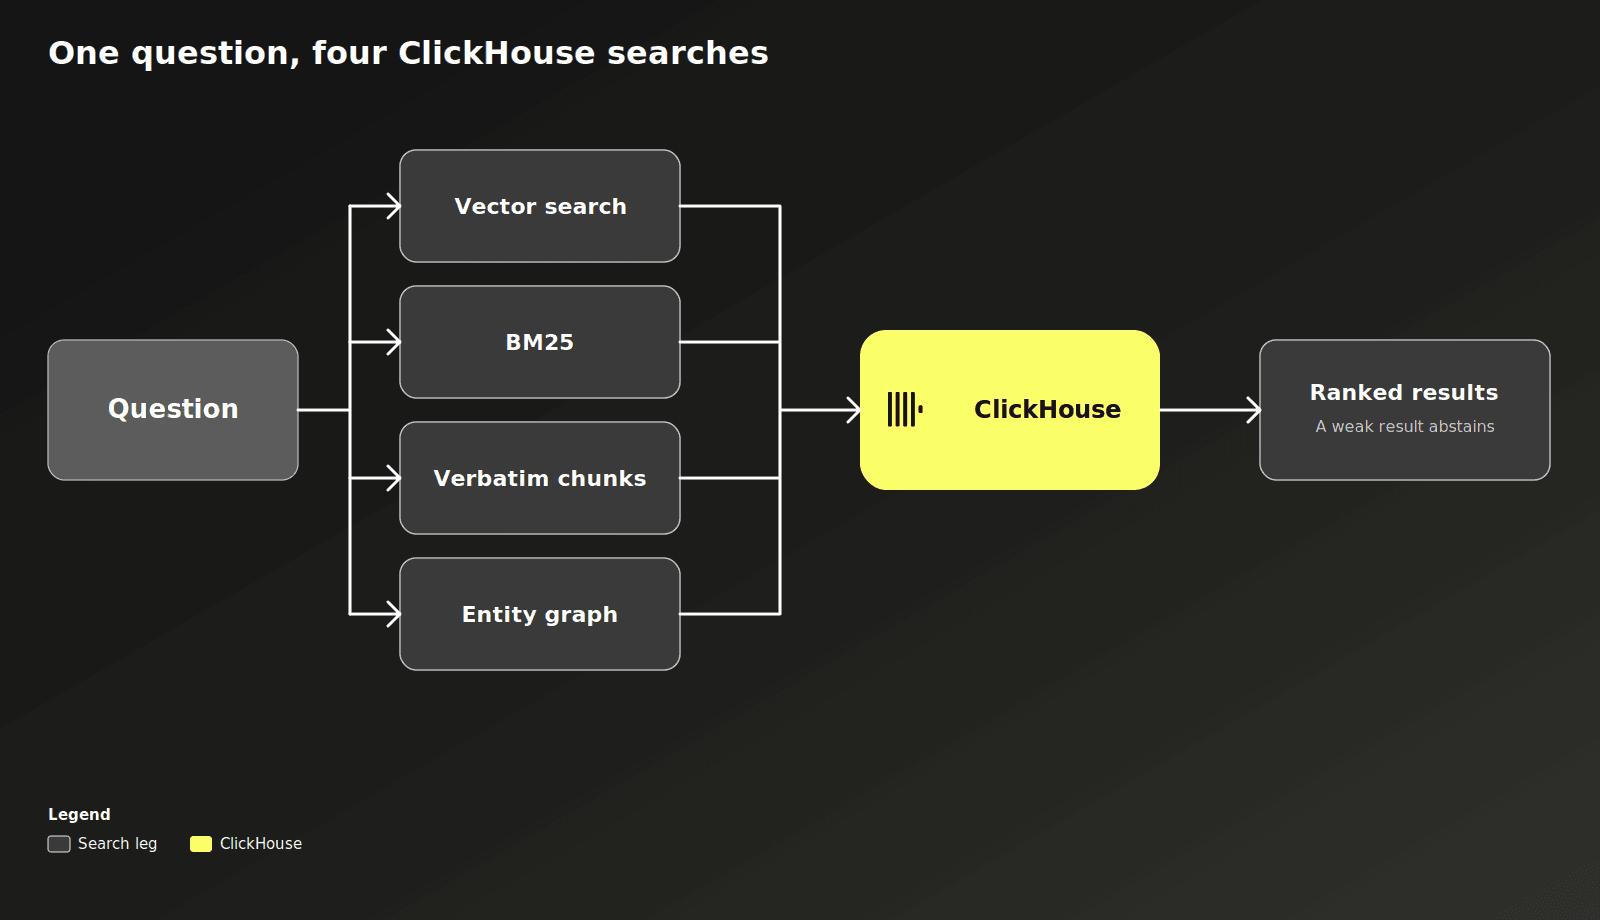
検索結果は1つのランキングに統合されます。確信度、出所、過去の実行からの強化学習によって僅差の結果を微調整できますが、上限が設けられているため、より一致度の高い結果を逆転することはありません。最後に、Loom は以前の重み付けを適用しない勝者の生の一致度をチェックします。類似度ランキングが非類似とランク付けされた結果を上回らない場合、検索はヒット結果を返すものの、エージェントに対して「不明」であると伝え、回答の根拠とするには弱すぎるとマークします。すべての結果には、その順位に至ったスコアが付与されます。
書き込み時にも同様の検証が行われます。新しいファクトは登録される前に周囲のデータと照合され、マージ、重複としてのフラグ付け、競合としてのマーク付け、または拒否の判断が下されます。すべてのバージョンが保持されるため、過去の日時時点での検索も実行できます。内部構造の全容は、メモリーアーキテクチャのドキュメントに記載されています。これらの検索パスはすべて、同じテーブルに対するプレーンな ClickHouse クエリです。
メモリーはどこに保存されるのか?
驚かないでいただきたいのですが…メモリーは ClickHouse に保存しています。驚きの事実、とまではいかないかもしれません。しかし手前味噌を抜きにしても、この形式のデータにとって ClickHouse は極めて適切なデータストアです。
ほとんどのエージェントメモリー構成は、結果として別々のサービスの寄せ集めになりがちです。ベクトル検索用、キーワード検索用、リレーションシップグラフ用、ジョブ用、分析用にそれぞれ1つずつ、といった具合です。そのすべてが、デプロイ、保護、同期を維持すべき対象となります。
Loom はそれらすべて(ファクト、埋め込み、全文検索インデックス、コードグラフ、タスク状態、コストと監査証跡)を単一の ClickHouse データベースに収めます。検索は呼び出し元が閲覧可能な範囲に絞り込まれ、前述のベクトル検索と BM25 検索によってランク付けされます。利用状況データも独立した分析ツールに置くのではなく、他のすべてのデータのすぐ隣に保存されます。更新、修正、埋め込みには、すべてをひとまとめにした汎用テーブルではなく、実際の読み書きのパターンに合わせて調整された ClickHouse ストレージエンジンがそれぞれ割り当てられます。
もちろん、トレースは最高水準のオブザーバビリティスイートである Langfuse に送信できます。
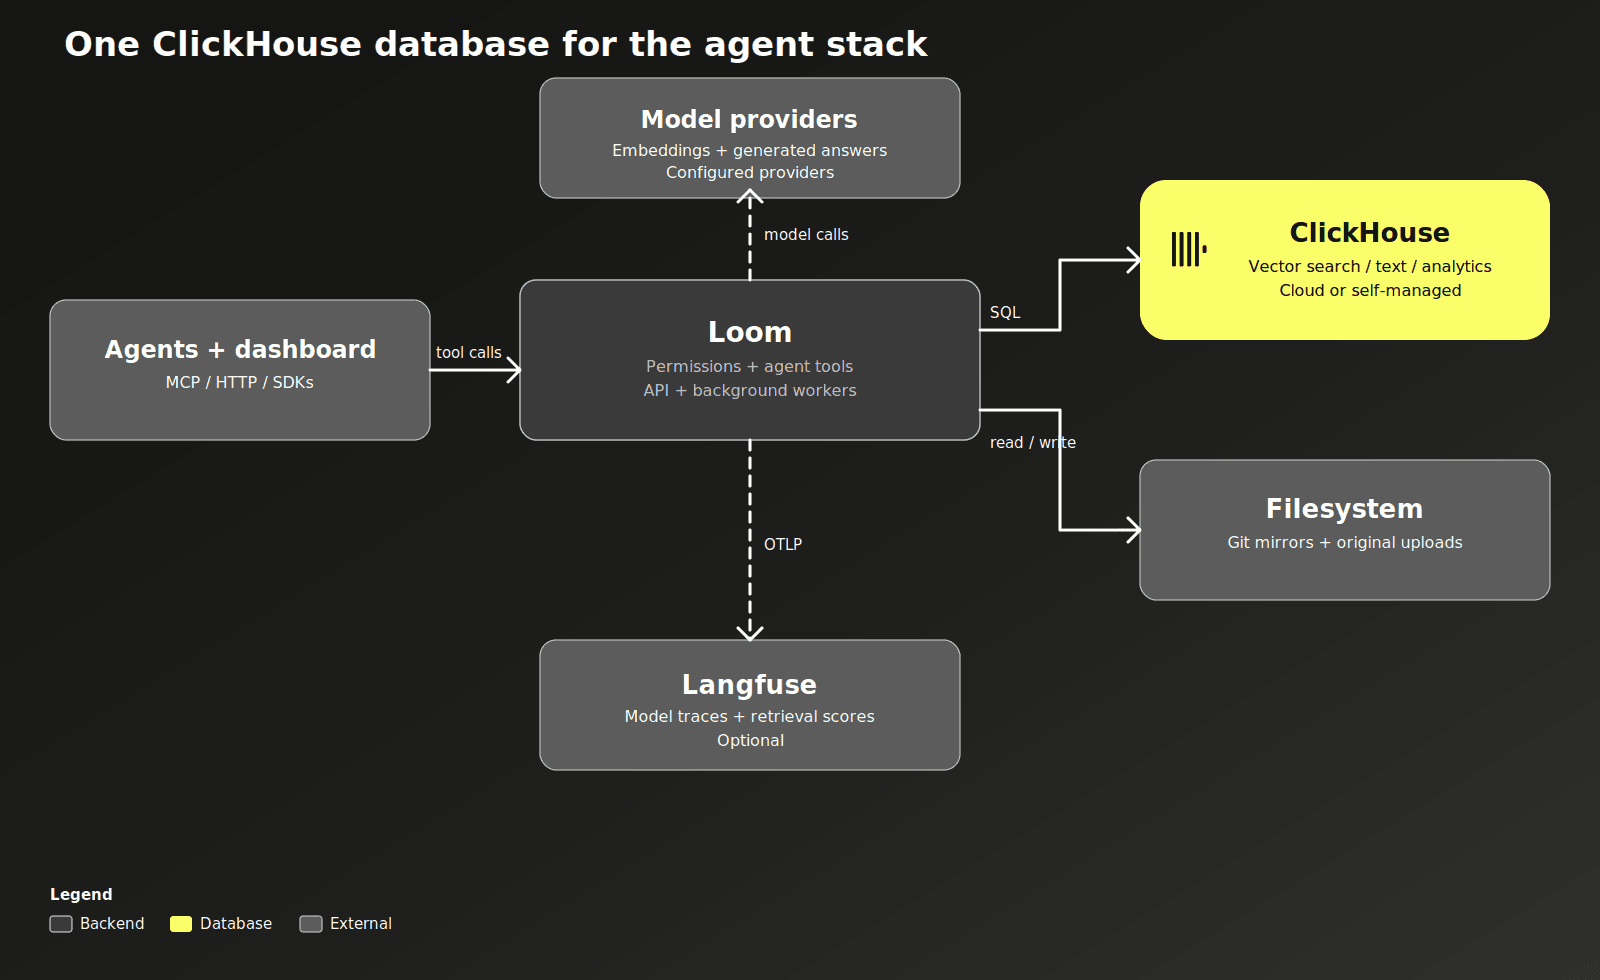
この構成により、これらの機能が実際に役立っているかどうかも容易に判断できます。すべての実行について使用内容と結果がログに記録されるため、継続して役立っているメモリーは強化され、そうでないものは自然と薄れていきます。個々のリクエスト、モデル呼び出し、コスト、検索スコアを詳しく確認したい場合は、Langfuse を見るだけで把握できます。
Loom はセルフマネージドの ClickHouse または ClickHouse Cloud で実行できます。ClickHouse 26.5 以降が必要で、高速なベクトル検索パスを利用したい場合は 26.8 以降を推奨します。
ベンチマークは実施したのか?
私たちは 2 つの異なる観点を測定しました。Loom を備えたエージェントが、grep、Read、Glob のみを持つエージェントよりもコードの説明や適切なファイルの検索をうまく行えるかどうか、そして取得されたメモリーがモデルに会話履歴全体を渡す手法に勝るかどうかです。どちらの比較でも、両者で同じ質問と同じモデルを使用し、Loom のオン/オフを切り替えてテストしました。
コーディングの質問では、適切な回答が押さえるべき要点をまとめた参照回答を用意しました。別のモデルが、エージェントの実際の回答がそれらの要点をどれだけ網羅しているかを採点し、回答が参照回答と真っ向から矛盾している場合はスコアを大幅に減点します。それぞれ3回実行した 24 の質問全体で、平均スコアは 0.78 から 0.84 へと約 8% 向上し、質問あたりの平均コストは $0.212 から $0.17 に低下しました。別のファイル検索タスク(それぞれ10回実行した 36 の質問)では、同様のコスト削減を達成しながら、精度が 91.4% から 96.4% に向上しました。
本日すぐ移行すべきだと誇張するような桁外れの数値をアピールするつもりはありませんが、+8% には非常に大きな意味があります。-$0.042 や +5% も同様に重要です。ClickHouse 自体も、何ヶ月も待った末に投入される大掛かりな変更によって構築されたわけではなく、10年以上にわたる細やかな配慮を通じた、一貫性のある漸進的な進歩によって作られてきました。
メモリー自体の測定結果は?
LongMemEval-S の 100 の質問において、同一モデルで比較したところ、プロンプトに会話履歴全体を詰め込んだ場合(90%)よりも、Loom で取得したメモリーを使用した場合(94%)の方が高い正解率を記録し、その際の読み込みトークン数は約 90% 削減されました。この差自体は単独で統計的有意と呼ぶには十分ではありませんが、より注目すべき数値は、公式ジャッジのもとで 500 問のベンチマーク全体にわたって memory.ask が 96.6% を記録したことです。これは実際に運用した際の結果により近い数値です。
完全な測定方法と質問ごとの結果は、GitHub の benchmarks フォルダにあります。
これらの効果を確かめる最も簡単な方法は、手元のリポジトリで試してみることです。
試すには?
Docker と Docker Compose をインストールし、以下を実行します。
curl -fsSL https://github.com/ClickHouse/loom/releases/latest/download/install.sh | shこれにより Loom と ClickHouse が起動し、すべての準備が整うのを待ってからダッシュボードの URL が表示されます。http://localhost:7777/me を開き、Settings → Models & keys でモデルと埋め込みのキーを設定します。Loom にはプレースホルダーモデルが同梱されているため、キーを一切設定しなくても実行自体は可能です。ただし、実際のキーを追加するまでは、意味に基づく検索や回答の生成は利用できません。
これはデフォルトでは個人用のセットアップとなっており、1人のユーザー、1つまたは複数のエージェントがすべて localhost 上で動作します。実際の社内アカウントや名前空間の権限を用いてチーム全体で共有する方法については、チームデプロイガイドで解説しています。
ローカルのコーディングエージェントの場合、リポジトリのインデックスが作成されると、Claude Code プラグインと Codex プラグインが自動的に接続されます。これらは git リモートを読み取り、適切な名前空間を見つけてクエリの送信を開始します。Cursor は MCP 経由で接続します。カスタムの連携機能を構築する場合は、HTTP API や Python/TypeScript SDK も利用できます。
使用感を掴む最善の方法は、「この関数を変更したら何が壊れるか?」といった実際の業務における疑問を投げかけ、返ってきた結果を確認し、その知見を保存して新しいセッションで再度呼び出してみることです。クイックスタートと最初のエージェントチュートリアルで、まさにその手順を説明しています。作業を始める前に1点留意すべき点があります。インデックスは作業中ブランチに対するサーバー側のミラーに基づいて構築されるため、コミットされていない変更は、コミットしてプッシュするまで反映されません。
私たちの主張がすべて正しいかソースを読んで確かめたい場合は、Loom は Apache-2.0 ライセンスのもと GitHub で公開されています。自身のリポジトリで動かしてみて、不足している点があればぜひフィードバックをお寄せください。
私たちが社内のために構築したメモリー空間を実際に見てみたい方は、採用情報ページをご覧ください。ClickHouse は、チームメイトの成果をこれまで以上に共有して活用できる、エージェント型コーディングの新時代を共に切り拓く人材を常に求めています。