5万

また1か月が経ち、新しいリリースの時期がやってきました。
ClickHouse 26.7 リリースには、61 件の新機能 🌻 112 件のパフォーマンス最適化 ⛱️ 329 件のバグ修正 🍉 が含まれています。
本リリースでは、GROUP BY ... ORDER BY ... LIMIT の高速化、3 つの JOIN 改善、QBit によるベクトル検索の高速化、位置を考慮したフレーズ検索、EXPLAIN ANALYZE、統合された URL アクセスなどが導入されています。
新しいコントリビューター
26.7 のすべての新しいコントリビューターを心から歓迎します。ClickHouse コミュニティの成長には目を見張るものがあり、ClickHouse をここまで広めてくれた貢献に常に感謝しています。
新しいコントリビューターの皆様は以下のとおりです。
Aditya Kumar, Ali Ayman, Andre Murbach Maidl, Antonio Álvarez Caballero, Arbin, Arup Chauhan, Bala Vignesh S, Blackmorse, ClickGap Bot, David Meng, Din, Eduardo Gomez Saldias, GalBenMoshe, Gaurav Dubey, Goutam Adwant, Jitendra, Keguang Xu, Kermit, Lalit Yadav, Manuel Cadarso, Maoyao233, Matheus Agio Nerone, Mihir G, Murphy, NIKTONIKTO717, Oranje AI, S Bala Vignesh, SBALAVIGNESH123, Samuel Krempaský, Sayantanu Dey, Stack Slayer AI, Tamish Mhatre, Umang Agrawal, Vismay, Yang Hu, Yanjun Qiu, adityaksolves, ashishch432, cadarso77, clickhouse-docs-bot, clickhouse-robot-gh, coderashed, fidelaggio, gaurav0107, jaehanbyun, jitendra, jordiori, kgeg401, lefteris gilmaz, linhaojie, lzp, malgamves, mintlify[bot], motsc, slach, unintended, vismaytiwari, wandersofb, ymy
ヒント: このリストをどのように生成しているか興味がある方は、こちらをご覧ください。
プレゼンテーションのスライドもご覧いただけます。
より高速になった GROUP BY ... ORDER BY ... LIMIT
コントリビューター: Konstantin Bogdanov、Nihal Z. Miaji
Top-N クエリは、アナリティクスにおいてあらゆる場面で利用されています。
「最新のイベントを表示したい」
「本日最も高額な注文は何か」
「キーの順序で上位 10 件の結果を返したい」
これらはすべて、よく知られた共通の SQL パターンを持っています。
... ORDER BY ... LIMIT NClickHouse は Top-N を第一級のクエリパターンとして扱っています。長い時間をかけて、エンジンにはストリーミング実行、順序通りの読み取り、遅延読み取り、グラニュール単位のデータスキッピングなど、互いを補完するいくつかの最適化が蓄積されてきました。
GROUP BY が通常すべてを読み取る理由
しかし、ClickHouse が先に行を集約しなければならない場合はどうなるでしょうか。
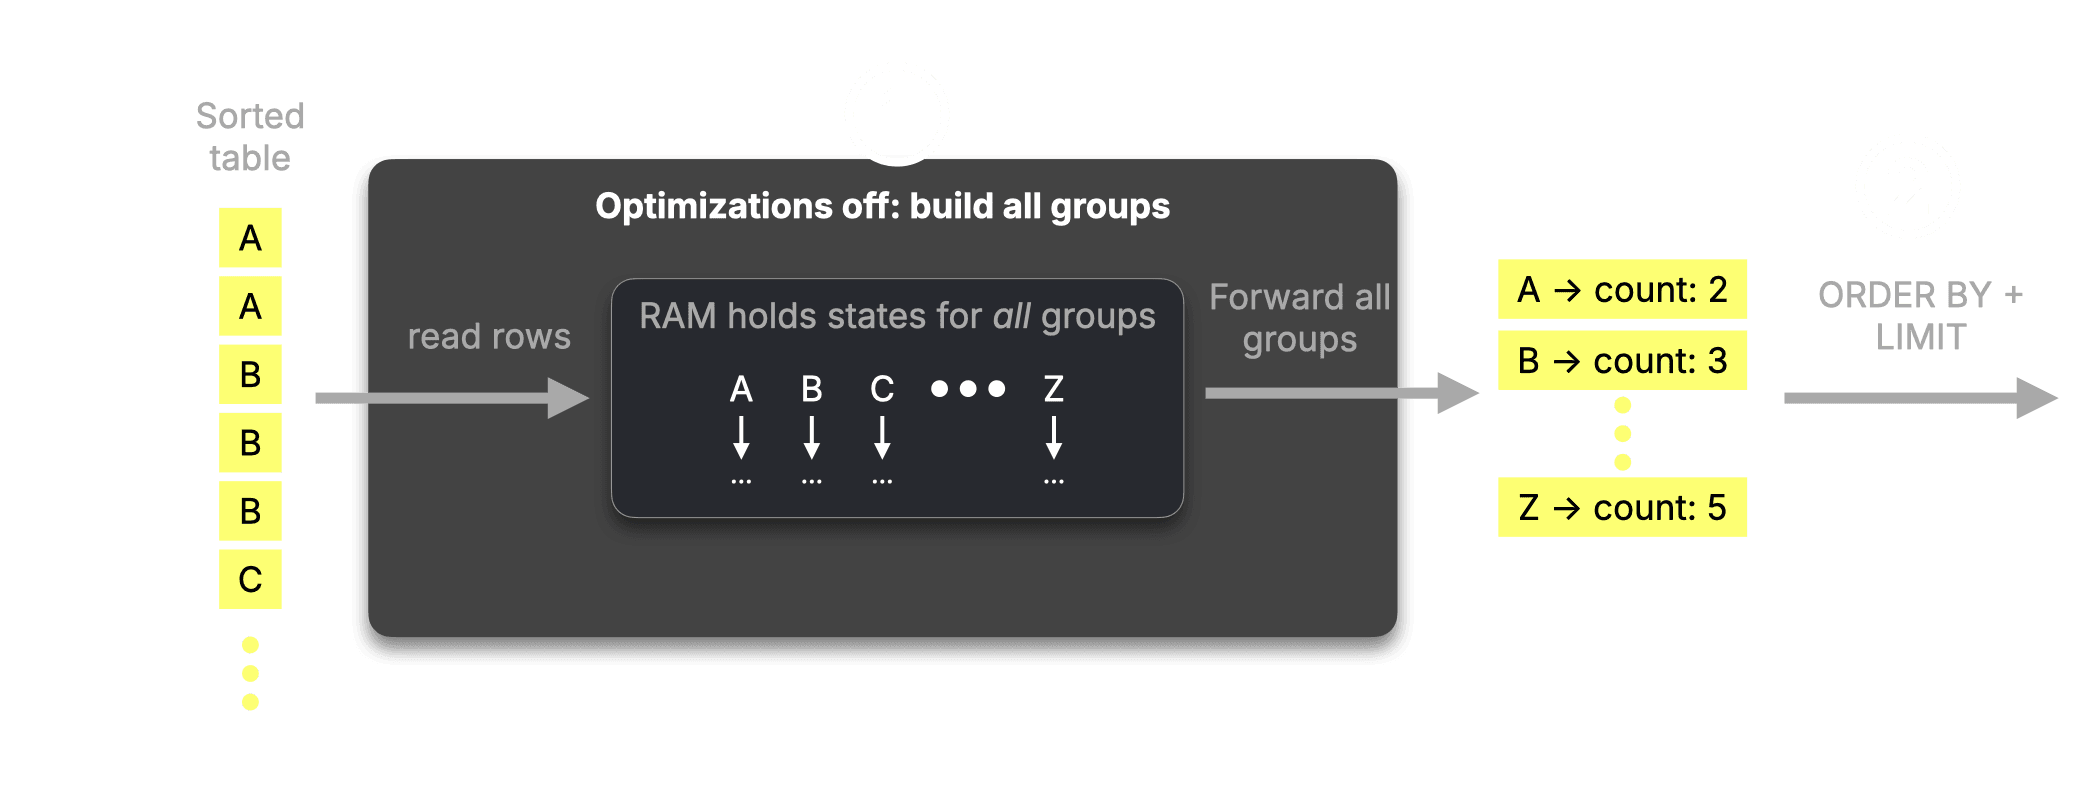
テーブルの順序を活用しない場合、従来の GROUP BY は ① すべての行が読み取られるまで、すべてのグループをメモリに保持する必要があります。例えば count() では、ClickHouse はすべてのキーを保持し、同じキーを持つ別の行が現れるたびにそのカウントを増やします。その後でようやく ② ORDER BY ... LIMIT が上位 N 個以外のすべてのグループを破棄できます。
最初のステップ: ソートなしの GROUP BY ... LIMIT
26.5 では、このパターンのバリエーションの 1 つである ORDER BY のない GROUP BY ... LIMIT を最適化しました。ClickHouse は入力をスキャンし続けますが、メモリには任意の N グループのみを保持します。
統合された 1 つのパイプラインによる 2 つの最適化
26.7 では、2 つの最適化を組み合わせることでソートのあるケースに対処します。
既存の optimize_aggregation_in_order は、グループ化キーがテーブルのソートキーのプレフィックスと一致していることを認識します。これにより、ClickHouse は順序通りにグループを集約できるようになります。count() の場合、これは ① 現在のキーとそのカウントのみをメモリに保持することを意味します。キーが変わると、ClickHouse はそのグループが完了したことを認識し、② そのカウントを出力して、次のキーのカウントを開始します。
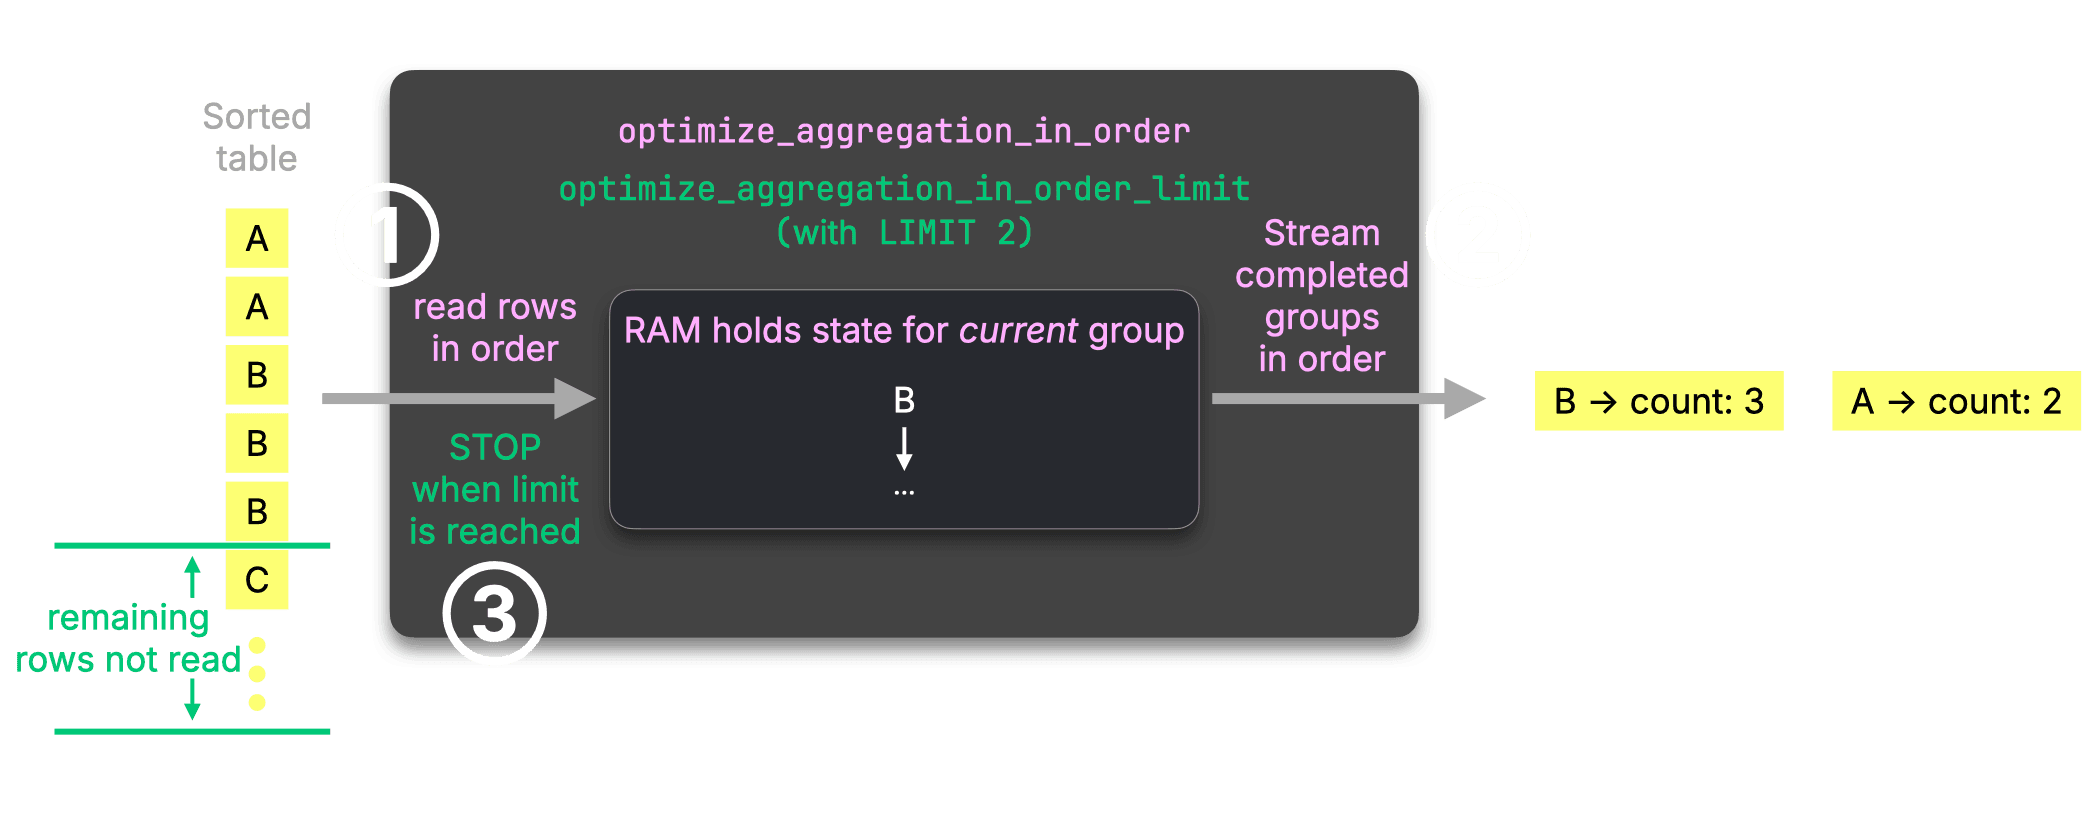
26.7 で新登場した optimize_aggregation_in_order_limit は、その既存の順序付き集約パイプラインに LIMIT をプッシュダウンします。N グループが完了して出力されると、③ ClickHouse は読み取りを停止します。
これら 2 つの最適化が合わさることで、GROUP BY → ORDER BY → LIMIT が、早期終了が可能なメモリ消費の少ないストリーミングパイプラインへと変わります。
ベンチマーク: 313 倍の高速化と 592 分の 1 のメモリ使用量
影響を評価するため、32 vCPU と 128 GiB の RAM を備えた AWS EC2 m6i.8xlarge インスタンス上で、スケールファクター 100 の TPC-H スキーマを作成してロードしました。
シンプルな注文サマリークエリでベンチマークを実行します。このクエリは、注文キー順に上位 10 件の注文を、明細項目数、合計数量、および割引と税の適用前の総額とともに返します。lineitem は (l_orderkey, l_linenumber) でソートされているため、GROUP BY と ORDER BY の両方が先頭のソートキーカラムに従っており、まさにこの最適化が対象とするパターンです。
SELECT
    l_orderkey,
    count() AS line_items,
    sum(l_quantity) AS total_quantity,
    sum(l_extendedprice) AS gross_value
FROM lineitem
GROUP BY l_orderkey
ORDER BY l_orderkey
LIMIT 10;まず、optimize_aggregation_in_order と optimize_aggregation_in_order_limit の両方を無効にし、クエリを連続して 3 回実行しました。
10 rows in set. Elapsed: 2.814 sec. Processed 600.04 million rows, 12.00 GB (213.21 million rows/s., 4.26 GB/s.)
Peak memory usage: 17.33 GiB.

10 rows in set. Elapsed: 2.818 sec. Processed 600.04 million rows, 12.00 GB (212.92 million rows/s., 4.26 GB/s.)
Peak memory usage: 17.35 GiB.

10 rows in set. Elapsed: 2.832 sec. Processed 600.04 million rows, 12.00 GB (211.86 million rows/s., 4.24 GB/s.)
Peak memory usage: 17.35 GiB.次に、両方の最適化を有効にして、同じ 3 回のテストを繰り返しました。
10 rows in set. Elapsed: 0.009 sec. Processed 1.77 million rows, 35.39 MB (197.78 million rows/s., 3.96 GB/s.)
Peak memory usage: 29.97 MiB.

10 rows in set. Elapsed: 0.010 sec. Processed 1.77 million rows, 35.39 MB (183.80 million rows/s., 3.68 GB/s.)
Peak memory usage: 34.83 MiB.

10 rows in set. Elapsed: 0.009 sec. Processed 1.77 million rows, 35.39 MB (194.19 million rows/s., 3.88 GB/s.)
Peak memory usage: 30.34 MiB.各構成の最速の実行結果を比較すると以下のようになります。
| 設定 | 実行時間 | 処理行数 | 処理データ量 | ピークメモリ |
|---|---|---|---|---|
| 両方無効 | 2.814 秒 | 6 億 4 万行 | 12.00 GB | 17.33 GiB |
| 両方有効 | 0.009 秒 | 177 万行 | 35.39 MB | 29.97 MiB |
| 改善 | 313 倍高速 | 339 分の 1 | 339 分の 1 | 592 分の 1 |
これら 2 つの最適化を組み合わせることで、313 倍の高速化、処理行数の 339 分の 1 への削減、およびピークメモリの 592 分の 1 への削減が実現します。
JOIN の右側から左側をプルーニング可能に
コントリビューター: Shankar Iyer
ClickHouse のリリースごとに JOIN の改善が行われていますが、26.7 には 3 つの改善が含まれています。まずは、右側(ビルド側)が左側(プローブ側)のインデックスプルーニングを誘導できるようにする最適化から見ていきます。ビルド側の結合キーによって、行を読み取る前にプローブ側のグラニュール全体を除外できるようになりました。
これは、大規模なファクトテーブルと、はるかに小さなテーブル(または選択的なフィルターによって小さくなったテーブル)との間の選択的な結合という、分析ワークロードにおける一般的なパターンを対象としています。
TPC-H(スケールファクター 100)の結合クエリ例は、まさにこの構成を持っています。このクエリは、o_totalprice > 500000 である注文に属する lineitem の行から収益を計算します。
SELECT
    sum(l.l_extendedprice * (1 - l.l_discount)) AS revenue
FROM lineitem AS l
INNER JOIN orders AS o
    ON l.l_orderkey = o.o_orderkey
WHERE o.o_totalprice > 500000;26.7 以前: 読み取り中に行をフィルタリング
デフォルトの並列ハッシュ結合アルゴリズムでは、ClickHouse は自動的に 6 億行の lineitem テーブルを左側(プローブ側)に配置し、フィルター処理された orders テーブルを右側(ビルド側)に配置します。また、ClickHouse はランタイムフィルタリングも適用します。
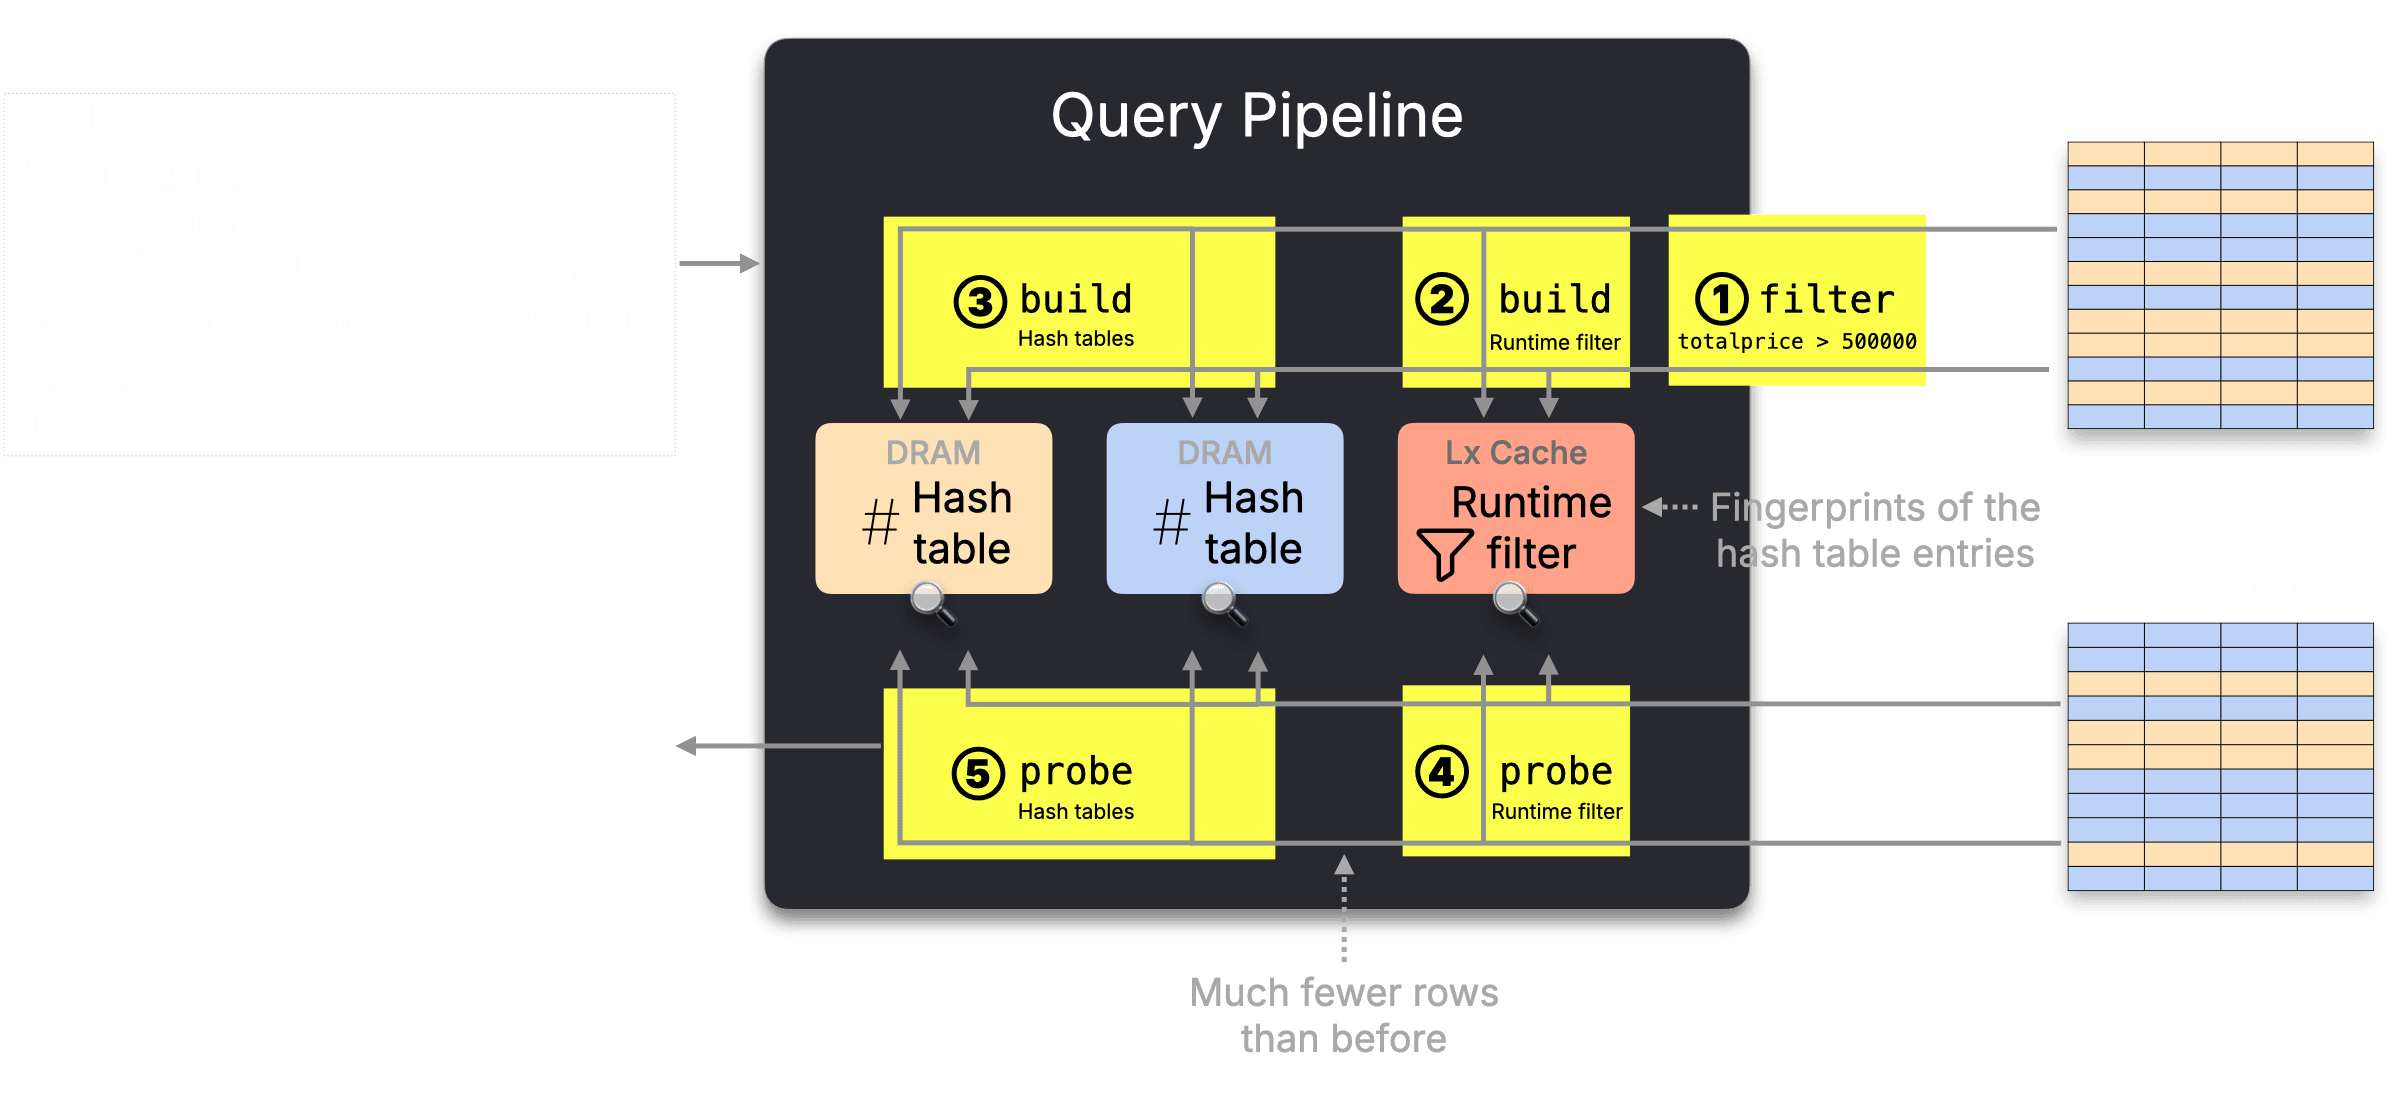
クエリパイプライン(物理クエリ実行プラン)を右から左へ追っていくと、以下のようになります。
① ClickHouse はまず、orders に o_totalprice > 500000 の述語を適用します。
② 残った o_orderkey の値から、コンパクトなランタイムフィルター(ブルームフィルターまたは最小値/最大値の範囲)を構築します。
③ 同じフィルター処理された orders の行がハッシュテーブルに投入されます。図では max_threads = 2 を使用しているため、2 つのハッシュテーブルが並列で構築されます。通常、max_threads はエンジンが利用可能な CPU コア数から導出されます。
④ lineitem の行が届くたびに、その l_orderkey の値がランタイムフィルターと照合されます。このチェックは軽量です。フィルターはステップ ⑤ のハッシュテーブルよりもはるかに小さく、通常は CPU に近い L1 または L2 キャッシュにとどまります。
⑤ ランタイムフィルターを通過した行のみが、よりコストの高いハッシュテーブルのルックアップに進みます。
この既存のランタイムフィルターは、ハッシュテーブルのルックアップ前に一致しないプローブ側の行を排除することで、ハッシュ結合におけるプローブ側の無駄な処理を減らします。しかし、ステップ ④ の時点ですでに ClickHouse は lineitem のグラニュール(ClickHouse における最小の処理単位で、デフォルトで各 8,192 行)を選択しており、そのすべての行を処理しています。
26.7 の新機能: 読み取り前にグラニュールをスキップ
26.7 では、既存の行レベルのフィルターの前にランタイムフェーズが 1 つ追加されました。
ClickHouse は ④ ランタイムフィルターで収集された結合キー(値のセットまたは最小値/最大値の範囲)を再利用して、lineitem の主キーおよびスキッピングインデックスの分析を行います。ストリーミングインデックスに関する記事で説明した増分インデックス評価技術を活用し、一致する行を含み得ないグラニュール全体をスキップします。これらのグラニュールが読み取られることはありません。
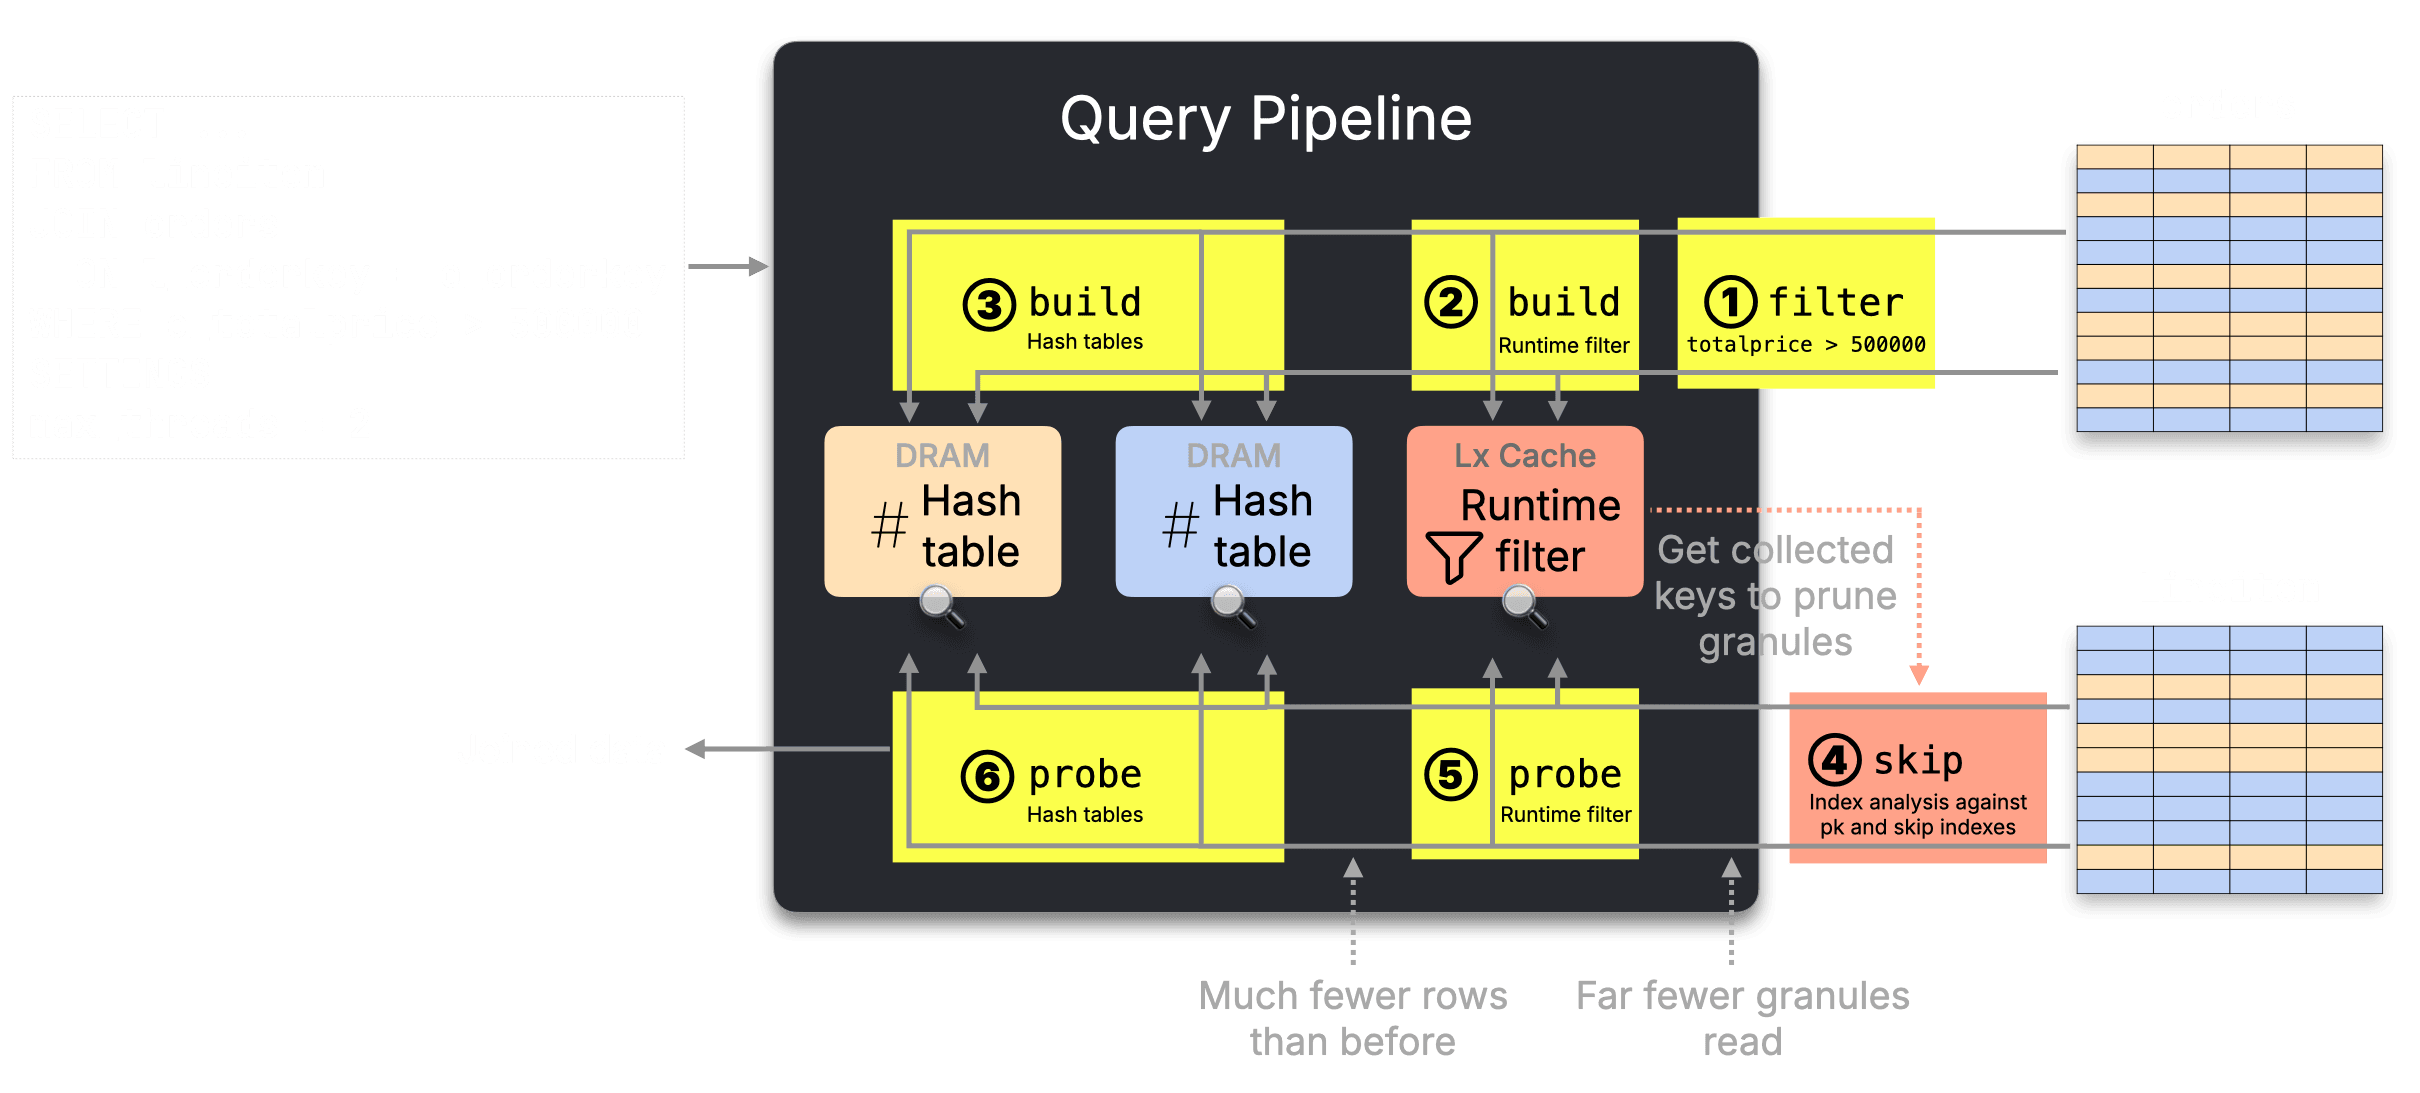
ステップ ①〜③ は変更ありません。ClickHouse はビルド側をフィルタリングし、ランタイムフィルターを構築して、ハッシュテーブルにデータを投入します。
プローブ側のフェーズは 1 つずつ後ろにシフトします。
⑤ 残ったグラニュールからの行がランタイムフィルターと照合されます。
⑥ 通過した行のみが、よりコストの高いハッシュテーブルのルックアップに進みます。
ベンチマーク: 6.2 倍の高速化と 8.8 分の 1 のメモリ使用量
影響を測定するため、前のセクションと同じ TPC-H スケールファクター 100 のデータセットと、32 vCPU および 128 GiB の RAM を備えた AWS EC2 m6i.8xlarge インスタンスを再度使用しました。
おさらいとして、サンプルクエリは o_totalprice > 500000 の注文に属する lineitem の行から収益を計算します。
SELECT
    sum(l.l_extendedprice * (1 - l.l_discount)) AS revenue
FROM lineitem AS l
INNER JOIN orders AS o
    ON l.l_orderkey = o.o_orderkey
WHERE o.o_totalprice > 500000;関連する 3 つの結合およびインデックス最適化を無効にした場合と有効にした場合を比較しました。結果に影響を与えないよう、クエリ条件キャッシュ(Query Condition Cache)は両方の構成で無効のままにしました。
| 設定 | 無効 | 有効 |
|---|---|---|
enable_join_runtime_filters | 0 | 1 |
enable_join_runtime_filters_index_analysis | 0 | 1 |
use_skip_indexes_on_data_read | 0 | 1 |
use_query_condition_cache | 0 | 0 |
まず、3 つの最適化をすべて無効にしてクエリを連続で 3 回実行しました。
1 row in set. Elapsed: 0.600 sec. Processed 750.04 million rows, 13.23 GB (1.25 billion rows/s., 22.03 GB/s.)
Peak memory usage: 19.70 MiB.

1 row in set. Elapsed: 0.597 sec. Processed 750.04 million rows, 13.23 GB (1.26 billion rows/s., 22.14 GB/s.)
Peak memory usage: 29.58 MiB.

1 row in set. Elapsed: 0.599 sec. Processed 750.04 million rows, 13.23 GB (1.25 billion rows/s., 22.10 GB/s.)
Peak memory usage: 25.74 MiB.次に、3 つの最適化をすべて有効にして、同じ 3 回のテストを繰り返しました。
1 row in set. Elapsed: 0.099 sec. Processed 162.98 million rows, 1.41 GB (1.65 billion rows/s., 14.29 GB/s.)
Peak memory usage: 3.90 MiB.

1 row in set. Elapsed: 0.097 sec. Processed 162.98 million rows, 1.41 GB (1.68 billion rows/s., 14.51 GB/s.)
Peak memory usage: 6.84 MiB.

1 row in set. Elapsed: 0.097 sec. Processed 162.98 million rows, 1.41 GB (1.67 billion rows/s., 14.48 GB/s.)
Peak memory usage: 3.38 MiB.各構成の最速の実行結果を比較すると以下のようになります。
| 設定 | 実行時間 | 処理行数 | 処理データ量 | ピークメモリ |
|---|---|---|---|---|
| すべて無効 | 0.597 秒 | 7 億 5,004 万行 | 13.23 GB | 29.58 MiB |
| すべて有効 | 0.097 秒 | 1 億 6,298 万行 | 1.41 GB | 3.38 MiB |
| 改善 | 6.2 倍高速 | 4.6 分の 1 | 9.4 分の 1 | 8.8 分の 1 |
3 つの最適化をすべて有効にすると、クエリは約 6.2 倍高速に実行され、処理行数は 4.6 分の 1、処理データ量は 9.4 分の 1、ピークメモリ使用量は 8.8 分の 1 に減少します。
行参照のパック化による JOIN ハッシュテーブルの小型化
コントリビューター: Harikrishnan Prabakaran
最初の JOIN 改善は、結合に届くプローブ側のデータ量を削減するものでした。2 つ目の改善は、ビルド側のハッシュテーブル自体を小型化します。
上記で示したように、ClickHouse はビルドフェーズ中、右側の行をメモリ内ハッシュテーブルに挿入します。各ハッシュテーブルのエントリには、対応する行への参照が含まれています。26.7 では、ClickHouse はその参照を、すべてのキー型に対してコンパクトな 8 バイトのインデックスベースの値として格納します。
その結果、ALL 結合のハッシュテーブルエントリが ANY 結合と同じくらいコンパクトになり、メモリ消費量が削減されてキャッシュ効率が向上しました。
1 億〜3 億行を含む結合全体において、この変更により中央値で 12% の高速化と 15% のピークメモリ使用量削減が確認されました。UInt64 キーに対する INNER 結合では、21% の高速化と 38% のメモリ削減を達成しています。
DPsub: 第 3 の JOIN 順序最適化アルゴリズム
コントリビューター: Fisnik Kastrati
前述の 2 つの JOIN 改善は、ハッシュ結合アルゴリズム自体の効率を最適化するものでした。1 つはプローブ側の入力を減らし、もう 1 つはビルド側のハッシュテーブルを縮小します。
3 つ目の改善は、複数テーブルのクエリにおいてそれらの結合をどのように配置すべきかを自動的に選択することで、1 つ上のレベルで機能します。
上記の最初の JOIN セクションでは、ClickHouse が 2 テーブルの並列ハッシュ結合において、より小さな入力を自動的に右側(ビルド側)に配置する様子を見ました。ClickHouse は以前から、より大規模な結合グラフ全体における自動的な順序変更もサポートしています。
こちらで詳しく説明しているように、ClickHouse はカラムの統計情報を使用して中間結果のサイズを推定し、適切な結合ツリーを選択します。これまで、小規模な結合グラフには全探索の dpsize を使用し、大規模な結合グラフにはより高速な greedy アルゴリズムを使用できました。
26.7 では 3 つ目の選択肢として、テーブルのサブセットに対して動的計画法を使用する dpsub が追加されました。
SET query_plan_optimize_join_order_algorithm = 'dpsub';dpsub はすべての有効な結合順序を考慮し、dpsize よりも低い最適化オーバーヘッドで最もコストの低いプランを選択します。また、内部結合以外の結合もサポートしています。
アルゴリズムをチェーンしてフォールバックを指定することも可能です。
SET query_plan_optimize_join_order_algorithm = 'dpsub,greedy';ClickHouse はそれらを順に試し、あるアルゴリズムでクエリを処理できない場合はフォールバックします。
QBit によるベクトル検索の高速化
ベクトル検索は、基礎となるデータの高次元数値表現である埋め込みを比較することにより、関連するドキュメント、商品、画像など、意味的に類似したアイテムを見つけ出します。
ClickHouse 26.7 では、これらのベクトルをより効率的に検索するためのいくつかの改善が導入されています。QBit に対する Int8 サポート、読み取る次元数を削減するためのストライドストレージ、量子化を改善するためのランダム化アダマール変換、そして高速な 2 段階検索のための量子化コーデックです。以下でそれぞれについて詳しく見ていきます。
これらの改善を理解する最良の方法は、実際の動作を確認することです。Alexey Milovidov は、数百万の画像埋め込みを探索できるインタラクティブな ClickHouse 製ツールである embeddings.info を構築しました。
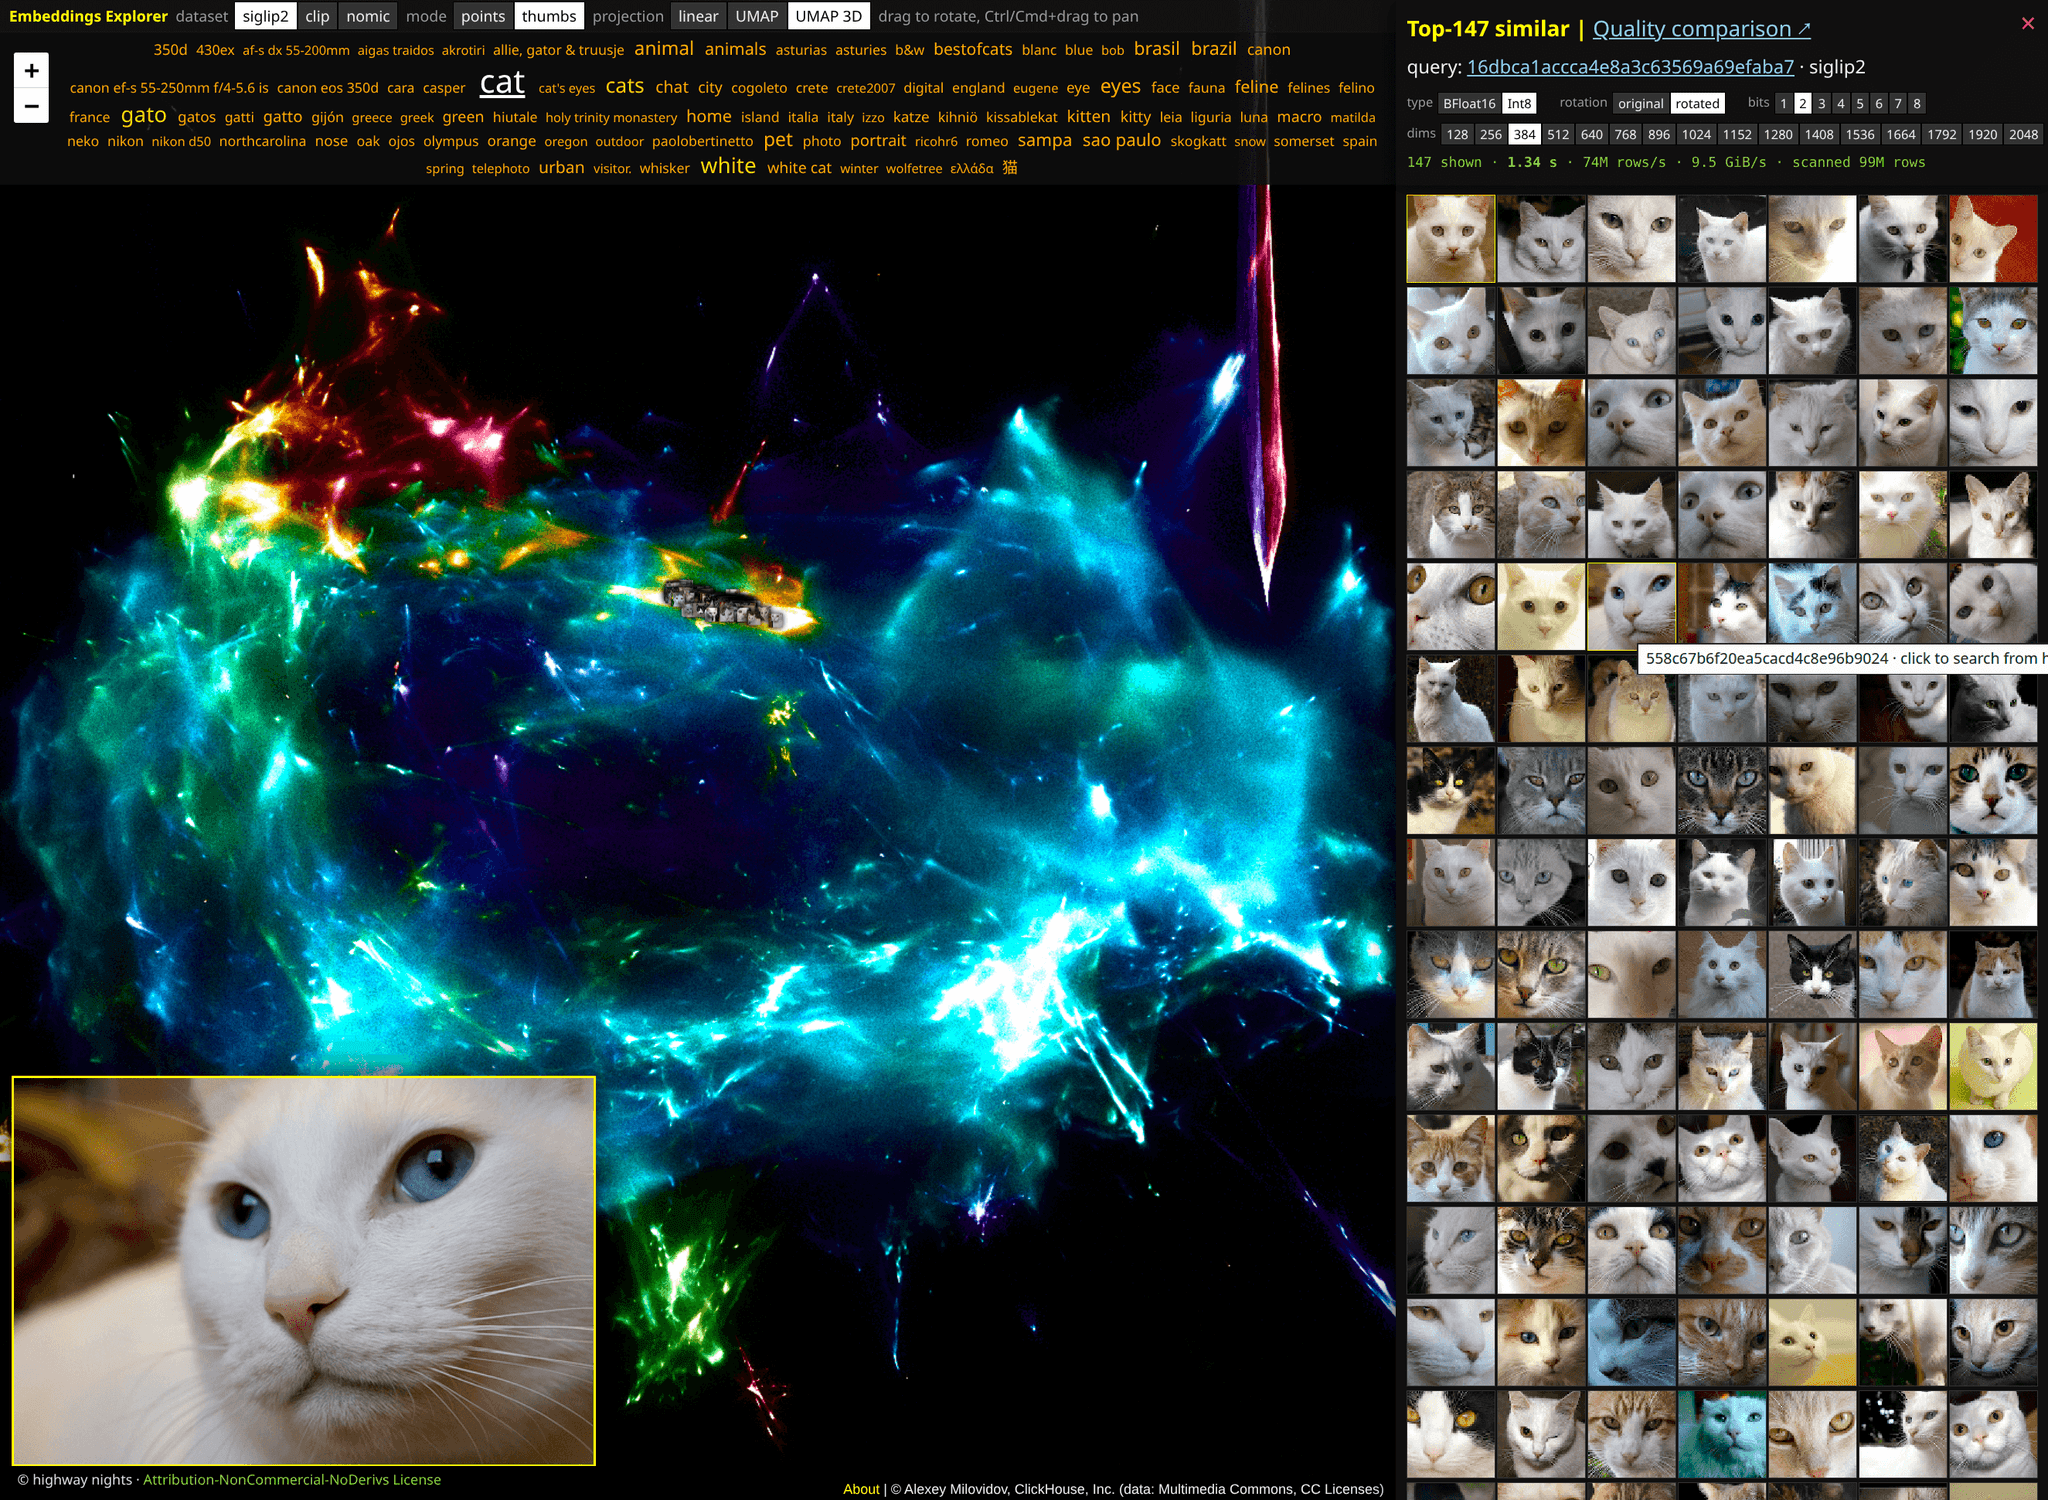
画像を選択して最近傍を見つけ、埋め込みモデル、数値表現、回転、ビット精度、次元数を変更して、検索速度と品質への影響を確認してみてください。完全な実装とデータパイプラインは ClickHouse/embeddings リポジトリで公開されています。
まず、QBit について簡単におさらいしましょう。ClickHouse 25.10 で導入され、26.2 から本番環境で利用可能になった QBit は、ベクトル埋め込みを格納するために設計されたデータ型です。
CREATE TABLE vectors
(
    id UInt64,
    name String,
    vec QBit(BFloat16, 1536),
    ...
)
ORDER BY (...);ここで、QBit(BFloat16, 1536) は、座標に BFloat16 型を使用する 1,536 次元の埋め込みを格納します。
QBit が特別なのは、クエリ側でそれらのベクトルをどれだけの精度で読み取るかを選択できる点です。BFloat16 は座標あたり 16 ビットを使用し、QBit はそれらのビットを最上位から最下位までの独立して読み取り可能なプレーンに整理します。そのため、距離クエリは最初の N プレーンのみを読み取ることができます。
SELECT id, name
FROM vectors
ORDER BY L2DistanceTransposed(vec, target, 10)
LIMIT 10;最後の引数は、ClickHouse に対して 16 ビットのうち上位 10 ビットを使用するよう指示しています。読み取るビット数を減らすと、I/O が削減され距離計算が高速化されます。ビット数を増やすと、より高い精度と再現率が得られます。
これは大規模な環境で重要になります。10 億個の 1,536 次元 BFloat16 ベクトルには、非圧縮で約 3 TB の数値データが含まれます。全 16 ビットプレーンではなく 10 ビットプレーンを読み取ることで、読み取られるベクトルデータが 37.5% 削減されます。完全な再現率よりも速度が重要な場合、クエリはさらに 8 ビットや 4 ビットまで削減することも可能です。
使用するビット数を減らすと、必然的に一部の情報が失われます。では、より低い精度で検索品質を維持するにはどうすればよいでしょうか。
それが 26.7 における最初の QBit の改善である Int8 量子化につながります。
QBit: 柔軟な Int8 量子化
貢献者: Alexey Milovidov
読み取るビットプレーンを減らすとベクトル検索は高速化されますが、情報も破棄されます。ClickHouse 26.7 では、より効率的な出発点が追加されました。埋め込みを Int8 に量子化し、QBit に直接格納できるようになりました。
数学的な背景になじみのない読者向けの説明: 量子化は、埋め込みの値をより少ないビット数で表現することで、検索精度を可能な限り維持しながらストレージを削減し、距離計算を高速化します。
QBit(Int8, N) は QBit のランタイムにおける柔軟性を維持します。データは 8 つのビットプレーンとして格納され、各クエリは 1 ビットを使用するバイナリ表現から完全な 8 ビットまで、任意の精度を選択できます。
ClickHouse の Int8 量子化機能は、ガウス分布に従う埋め込み座標向けに設計された 256 個の非均一バケットを使用します。その境界は、量子化データに対する距離計算の平均二乗誤差を最小限に抑えるよう調整されています。データスキャン、分布の推定、データセットごとのキャリブレーションは不要です。専用の quantizeBFloat16ToInt8 および dequantizeInt8ToBFloat16 関数がこの機能を公開しています。
CREATE TABLE images
(
    id UInt64,
    emb QBit(Int8, 2048),
    ...
)
ORDER BY (...);

INSERT INTO images
SELECT
    id,
    quantizeBFloat16ToInt8(embedding * sqrt(2048)),
    ...
FROM src;単位正規化された埋め込みの場合、次元数の平方根を掛けることで、座標が量子化機能の想定するスケールに調整されます。 クエリ側では実行時に精度を選択できます。
SELECT id
FROM images
ORDER BY cosineDistanceTransposedQuantized(emb, target, 4)
LIMIT 10;ここでは、ClickHouse は最上位の 4 ビットプレーンのみを読み取ります。これは、完全な 8 ビット表現で必要とされるベクトルデータの半分です。距離関数は量子化された値を直接解釈し、計算の一環としてそれらを復元します。 したがって、同じ格納済みベクトルで、1 ビットのバイナリ量子化から完全な 8 ビット精度まであらゆる処理に対応できます。テストしたデータセットでは、8 ビットすべてを使用した場合におよそ 99〜99.5% の再現率を達成し、精度を下げると I/O の削減量が段階的に大きくなりました。 ビット精度の調整は作業負荷を減らす一手段にすぎません。次の改善により、ClickHouse は読み取るベクトルの次元数も削減できるようになります。
QBit: ストライド付きストレージによる読み取り次元数の削減
貢献者: Alexey Milovidov
ビットプレーンを使用すると、クエリは各ベクトル座標から読み取るビット数を制御できます。ClickHouse 26.7 では、2 つ目の制御として読み取る次元数の制御が追加されました。
オプションの第 3 パラメーターであるストライド(stride)は、ベクトルの次元を独立して読み取り可能なグループに分割します。
emb QBit(Int8, 1024, 256)これにより、1,024 次元が 256 次元の 4 つのグループとして格納されます。各グループ内では、8 つの Int8 ビットプレーンが個別のオンスクリーンストリームとしてディスク上に格納されます。
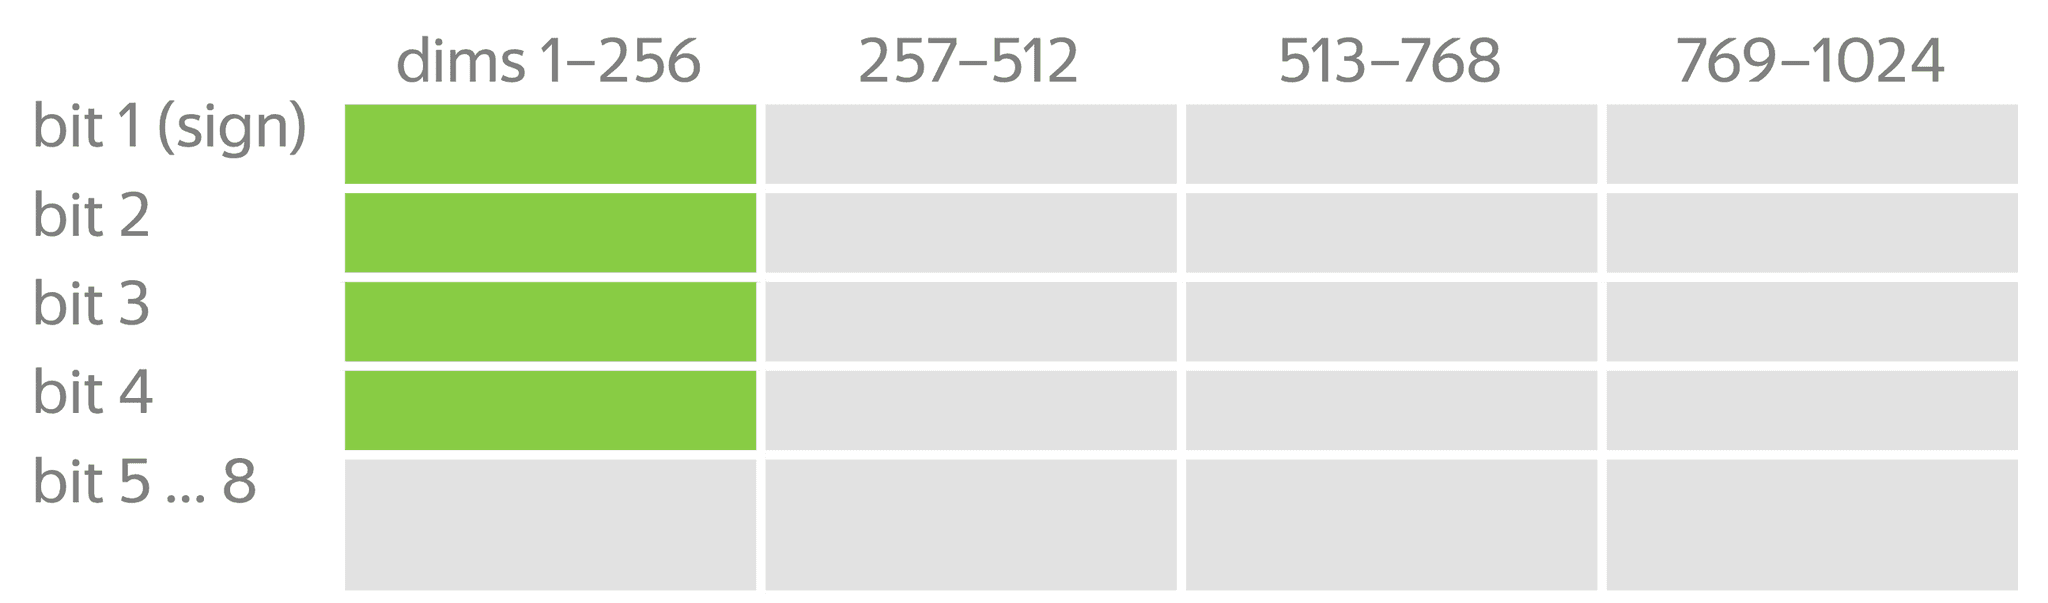
そのため、クエリはビット精度と次元数の両方を選択できます。
...ORDER BY cosineDistanceTransposedQuantized(
    emb,
    target,
    4,     -- read four bit planes
    256    -- read the first 256 dimensions
)このクエリは、ベクトルの最初の 4 分の 1 から 4 ビットのみを読み取ります。利用可能な 32 ストリームのうち 4 ストリームです。これは、同等の Float32 ベクトルペイロードの約 3% に相当します。
ストライド付きストレージは、Matryoshka Representation Learning でトレーニングされた埋め込みに特に有用です。これらのモデルは、最初の 256 次元や 512 次元といったベクトルのプレフィックスだけでも有用な表現となるように情報を配置します。そのため、各埋め込みの複数バージョンを保存することなく、多少の再現率と引き換えに I/O を大幅に削減し、距離計算を高速化できます。
QBit では、読み取るビット数と次元数の両方を変更できるようになりました。
次の改善では、それらのベクトルが量子化された際により多くの検索品質を維持することに焦点を当てています。
ランダム化アダマール回転による量子化の向上
貢献者: Alexey Milovidov
量子化は、情報がベクトルの次元全体に均等に分散している場合に最も効果的です。実際の埋め込みは常に都合よく分散しているとは限りません。一部の次元が他の次元よりもはるかに大きな値を持っていたり、大きなばらつきを持っていたりすることがあり、低精度な量子化によって不均衡に大量の情報が失われる原因になります。
一般的な解決策は、量子化の前にベクトル空間を回転させることです。格納されているすべてのベクトルとクエリベクトルに同一の直交回転を適用すると、元の距離を維持しながら、次元全体に情報をより均等に分散させることができます。これにより、量子化時の誤差を小さく抑えてベクトルを表現できます。
一般的なランダム回転にはコストの高い行列積が必要です。アダマール変換は、同じような混合をはるかに効率的に実現します。ClickHouse 26.7 では、ベクトル量子化パイプラインの構成要素として randomHadamardTransform が導入されました。
SELECT randomHadamardTransform(
    [1., 2., 3., 4.]::Array(Float32)
);

-- [0, 2, 1, -5]
-- an orthogonal, norm-preserving rotationこの変換は決定論的です。同じシードからは同じ回転が生成されるため、取り込み時と検索時で一貫して適用できます。
SELECT randomHadamardTransform(v, seed);オプションの第 3 引数を指定すると、変換されたベクトルが要求された次元数に切り詰められます。
SELECT randomHadamardTransform(v, seed, 256);これにより、ジョンソン・リンデンシュトラウスの補題スタイルのランダムプロジェクションが生成されます。これは、距離を近似的に維持するよりコンパクトな表現です。
ランダム化アダマール回転により、高品質な量子化パイプラインを明示的に構築できるようになりました。
次の改善では、ClickHouse が量子化された表現を自動的に管理できるように、その処理がコーデックとしてパッケージ化されています。
量子化コーデック: 高速な 2 段階ベクトル検索
貢献者: Shankar Iyer
これまでの改善は、カスタム量子化パイプラインを構築するための構成要素を提供するものでした。すなわち、ベクトルを回転させ、量子化し、得られた表現を保存して、適切な距離関数を呼び出します。
ClickHouse 26.7 では、量子化コーデックによってこれを自動的に管理できるようになりました。このコーデックは、完全精度のベクトルとともに、コンパクトに量子化されたコンパニオンデータを格納します。
CREATE TABLE vecs
(
    id UInt32,
    v Array(BFloat16) CODEC(Quantized('rabitq', 384)),
    ...
)
ORDER BY (...);サポートされている方式には、int8、1 ビットの rabitq、2 ビットの turboquant、mrl、積量子化(pq)があります。コーデックが必要な変換を処理し、両方の表現を維持します。
量子化されたコードにより、ベクトルインデックスを必要としない高速な 2 段階ブルートフォース検索が可能になります。
SET vector_search_use_quantized_codes = 1;

SELECT id
FROM vecs
ORDER BY L2Distance(v, target)
LIMIT 10;第 1 段階では、ClickHouse ははるかに小さな量子化表現をスキャンし、近似距離を使用して有望な候補を選択します。第 2 段階では、それらの候補についてのみ完全精度のベクトルを読み取り、正確な距離を再計算します。
すべてのベクトルは引き続き評価対象となりますが、負荷の高い完全精度の処理は小さな絞り込みリストのみに制限されます。量子化された第 1 段階では I/O を最大 8 分の 1 に削減でき、1 ビットコードは元の BFloat16 ベクトルと比べて 16 分の 1 のサイズになります。
クエリ自体を変更する必要はありません。量子化コード検索を有効にすると、ClickHouse は自動的に近似スキャンを実行した後に完全精度での再スコアリングを行います。
以上が 26.7 におけるベクトル検索の改善点です。
次に、テキスト検索と高速なフレーズマッチングについて見ていきましょう。
フレーズマッチングのための位置情報
貢献者: Elmi Ahmadov
テキストインデックスでトークンの位置情報が保存されるようになりました。これは効率的なフレーズ検索に必要な機能です。現時点では実験的機能であるため、allow_experimental_text_index_phrase_search 設定を使用して有効にする必要があります。
おなじみの HackerNews データセットを使ってテストしてみましょう。まず、フレーズ検索をサポートするテキストインデックスを持つテーブルを作成します。
CREATE TABLE hackernews
(
    `id` Int64,
    `deleted` Int64,
    `type` String,
    `by` String,
    `time` DateTime64(9),
    `text` String,
    `dead` Int64,
    `parent` Int64,
    `poll` Int64,
    `kids` Array(Int64),
    `url` String,
    `score` Int64,
    `title` String,
    `parts` Array(Int64),
    `descendants` Int64,
     INDEX idx_text text TYPE text(
       tokenizer = 'splitByNonAlpha', support_phrase_search = 1)

)
ORDER BY time
SETTINGS allow_experimental_text_index_phrase_search = 1;比較のために、ClickHouse 26.6 でも(フレーズ検索サポートなしで)同じテーブルを作成します。その後、データを取り込みます。
INSERT INTO hackernews
SELECT *
FROM url('https://datasets-documentation.s3.eu-west-3.amazonaws.com/hackernews/hacknernews.csv.gz', 'CSVWithNames');SELECT count() FROM hackernews WHERE hasPhrase(text, 'Google web search');26.6 の場合:
┌─count()─┐
│      82 │
└─────────┘

1 row in set. Elapsed: 1.343 sec. Processed 22.67 million rows, 7.57 GB (16.88 million rows/s., 5.64 GB/s.)
Peak memory usage: 247.40 MiB.

┌─count()─┐
│      82 │
└─────────┘

1 row in set. Elapsed: 1.645 sec. Processed 22.67 million rows, 7.57 GB (13.78 million rows/s., 4.60 GB/s.)
Peak memory usage: 280.37 MiB.

┌─count()─┐
│      82 │
└─────────┘

1 row in set. Elapsed: 1.448 sec. Processed 22.67 million rows, 7.57 GB (15.66 million rows/s., 5.23 GB/s.)
Peak memory usage: 282.45 MiB.26.7 の場合:
┌─count()─┐
│      82 │
└─────────┘

1 row in set. Elapsed: 0.033 sec. Processed 22.67 million rows, 22.67 MB (681.49 million rows/s., 681.49 MB/s.)
Peak memory usage: 42.51 MiB.

1 row in set. Elapsed: 0.034 sec. Processed 22.67 million rows, 22.67 MB (668.31 million rows/s., 668.31 MB/s.)
Peak memory usage: 42.16 MiB.

1 row in set. Elapsed: 0.039 sec. Processed 22.67 million rows, 22.67 MB (588.34 million rows/s., 588.34 MB/s.)
Peak memory usage: 38.66 MiB.26.6 での最速の実行時間は 1.343 秒だったのに対し、26.7 では 33 ミリ秒となり、26.7 は 40 倍以上高速化されています。
EXPLAIN ANALYZE
貢献者: Kirill Kopnev
ClickHouse の EXPLAIN 句ファミリーを使用すると、処理の段階を掘り下げながらクエリを詳細に検査できます。構文解析された抽象構文木(AST)や解析済みクエリツリーから、実行時の並列処理能力をまだ考慮していない論理実行プラン(PLAN)、そしてそれらの論理プランの各ステップが利用可能な CPU コア数に応じた並列処理スレッドへどのように分散されるかを示す物理実行プラン、すなわちパイプライン(PIPELINE)まで確認可能です。
また、インデックス分析を実行して、クエリ全体を実行することなく、主キーインデックスやスキッピングインデックスによってどのパートやグラニュールが除外されるかを確認することもできます。
EXPLAIN ファミリーは拡張を続けています。26.6 では、インデックスをディスク上に実体化する前にその潜在的な効果を評価できる EXPLAIN WHATIF とともに、仮想スキッピングインデックス が登場しました。
26.7 では、EXPLAIN ANALYZE により、計画上の実行と実測値のギャップが解消されます。論理実行プランの作成と最適化、物理パイプラインの構築、そしてそのパイプラインの実行という、クエリ処理のあらゆるフェーズを実行します。その後、結果行を破棄し、実際の実行中に収集された測定値を論理実行プランツリーに注記します。
プランニング時間、実行時間、および並列性
EXPLAIN ANALYZE は、クエリの主要な 2 つのフェーズを分けて表示します。論理プランの作成、プランの最適化、物理プラン(パイプライン)の構築を含むプランニング時間と、そのパイプラインの実際の実行を含む実行時間です。
特に注目すべき点として、EXPLAIN ANALYZE は各ステージで観測された並列性(parallelism)、すなわちそのステージで利用可能な最大スレッド数に対する、並行して動作した CPU スレッドの平均数を明らかにします。これにより、より高い並列処理能力があるにもかかわらず主に直列で実行されているステージなど、潜在的なボトルネックを特定するのに役立ちます。
前のセクションのフレーズマッチクエリで試してみましょう。
EXPLAIN ANALYZE
SELECT count()
FROM hackernews
WHERE hasPhrase(text, 'Google web search');┌─explain─────────────────────────────────────────────────────────────────────────────────────┐
│ Query summary: │
│ Time: 29.32 ms (planning 1.74 ms · execution 27.58 ms) │
│ Read: 22.67 million rows, 22.67 MB (822.00 million rows/s., 822.00 MB/s.) │
│ Peak memory: 42.13 MiB │
│ │
│ Output: count() │
│ │
│ Expression ((Project names + Projection)) │
│ │ I/O: rows 1 → 1 · 8 B → 8 B │
│ │ time 1.33 us (0.0%) · parallelism 0.94/1 │
│ └──Aggregating │
│ │ Keys: │
│ │ Aggregates: count() │
│ │ Skip merging: 0 │
│ │ I/O: rows 82 → 1 (1.22%) · 0 B → 8 B │
│ │ Stage (partial aggregation): time 100.30 us (0.4%) · parallelism 0.96/12 │
│ │ Stage (final aggregation): time 2.83 us (0.0%) · parallelism 1.00/1 │
│ └──Expression (Before GROUP BY) │
│ │ I/O: rows 82 → 82 │
│ │ time 16.87 us (0.1%) · parallelism 0.60/12 │
│ └──Filter │
│ │ Filter column: __text_index_idx_text_hasPhrase_df63d4eb06569fbf3c4f7c773f7332ac │
│ │ I/O: rows 22.67 million → 82 (0.00%) · 22.67 MB → 0 B │
│ │ time 2.68 ms (9.7%) · parallelism 2.24/12 │
│ └──ReadFromMergeTree (default.hackernews) │
│ Read type: Default │
│ Parts: 6 | Granules: 3533 │
│ Output: __text_index_idx_text_hasPhrase_df63d4eb06569fbf3c4f7c773f7332ac │
│ Indexes: │
│ PrimaryKey │
│ Condition: true │
│ Parts: 6/6 │
│ Granules: 3533/3533 │
│ Skip │
│ Name: idx_text │
│ Description: text GRANULARITY 100000000 │
│ Condition: (mode: All; tokens: ["Google", "search", "web"]) │
│ Parts: 6/6 │
│ Granules: 3533/3533 │
│ Ranges: 6 │
│ I/O: rows 0 → 22.67 million · 0 B → 22.67 MB │
│ time 27.18 ms (98.6%) · parallelism 11.59/12 │
└─────────────────────────────────────────────────────────────────────────────────────────────┘上部のクエリ概要では、合計実行時間 29.32 ms が プランニング時間 1.74 ms と 実行時間 27.58 ms に分けて表示されています。また、総読み取りデータ量、スループット、ピークメモリ使用量もレポートされます。
概要の下にある注記付きプランには、各ステップを通過するデータ量、消費された実行時間、および各ステージで達成された並列性が示されています。
プランを下から上へ確認すると、まず ReadFromMergeTree が hackernews から選択された 6 つのパートと 3,533 個のグラニュールを読み取り、2,267 万行および 22.67 MB を生成しています。このステージが実行の大部分を占めており、実行時間の 98.6% にあたる 27.18 ms を要し、利用可能な 12 個の CPU スレッドのうち平均 11.59 スレッド という、ほぼ完全な並列処理を達成しています。
続いて Filter ステップが hasPhrase(text, 'Google web search') を適用し、2,267 万行の候補行をわずか 82 件の一致行に削減しています。これには 2.68 ms(実行時間の 9.7%) かかり、平均並列性は 12 スレッド中 2.24 でした。
最後に、集約処理によって 82 件の一致行が単一の count() 結果にまとめられます。その部分集約ステージは平均して約 1 スレッドで動作し、最終集約はシングルスレッドです。残っているデータが非常に少ないため、これ以上作業を分散させる必要はありません。
一目で、クエリがどこで時間を費やしているか、パイプラインを進むにつれてデータがどのように削減されているか、そして各ステージが利用可能な CPU 並列処理をどれだけ効果的に活用しているかを確認できます。
Remote および RemoteSecure エンジン
貢献者: Alexey Milovidov
データフェデレーションは ClickHouse の中核機能です。クエリエンジンは、ClickHouse にあらかじめデータを取り込むことなく、60 以上の外部システムや 100 以上のフォーマットから直接データを読み取り、結合できます。
これはテーブル関数を介して実行でき、ローカルの ClickHouse テーブルと同様に、リモートデータソースを SELECT(多くのソースでは INSERT も可能)で使用できるテーブルとして公開します。多くのテーブル関数には対応するテーブルエンジンも用意されており、クエリごとに接続を記述する代わりに、一度定義するだけで済むようになっています。
古くから提供されている remote および remoteSecure テーブル関数は、ClickHouse 間のフェデレーションを実現し、あるクラスターから別のクラスターがホストするテーブルへの読み書きを可能にします。ClickHouse 26.7 では、これらの接続を永続的に定義するための専用の Remote および RemoteSecure テーブルエンジンが追加されました。
永続的なリモートテーブルにより、マルチリージョン分析、分離されたデプロイ環境間での一元的なレポーティング、INSERT SELECT を使用した移行やバックフィルが簡素化されます。これらは ClickHouse Cloud で特に有用であり、RemoteSecure を使用して他のサービスやリージョンのテーブルを通常のローカルテーブル名として公開できます。
例
prod サーバーの default データベースに events テーブルが存在するとします。これを永続的なローカルテーブル名として公開できます。
CREATE TABLE events_on_prod
ENGINE = Remote('prod:9000', default, events);カラムリストは不要です。ClickHouse がリモートテーブルから構造を推論します。作成されたテーブルは永続的なリンクとして機能し、読み取りと書き込みが prod に転送されます。
SELECT count()
FROM events_on_prod;

INSERT INTO events_on_prod
SELECT *
FROM local_events;RemoteSecure は TLS 経由で同じ機能を提供します。どちらのエンジンも、host{1..3}:9000 や TLS 経由の host{1..3}:9440 といったクラスター形式のアドレスパターンをサポートしています。
URL の統合
貢献者: Alexey Milovidov
url テーブル関数と URL テーブルエンジンが、URL スキームに基づいて適切なバックエンドに処理を振り分けるようになりました。
ファイルパス、S3、GCS、Azure、HDFS に対応しており、HTTP も従来どおり機能します。
以下は、S3 バケットから Amazon レビューデータセット をクエリする例です。
SELECT count(), avg(star_rating)
FROM url('s3://datasets-documentation/amazon_reviews/amazon_reviews_2015.snappy.parquet');┌──count()─┬──avg(star_rating)─┐
│ 41905631 │ 4.249571829618793 │
└──────────┴───────────────────┘認証情報が必要なバックエンドの場合、追加のパラメーターとして渡すか、環境変数として設定できます。
たとえば、S3 をクエリする場合、次のように認証情報を渡すことができます。
SELECT count()
FROM url(
  's3://not/public/file.parquet',
  '',
  '',
  ''
);あるいは(clickhouse-local を使用する場合)、環境変数として指定することもできます。
export AWS_ACCESS_KEY_ID=""
export AWS_SECRET_ACCESS_KEY=""
export AWS_SESSION_TOKEN=""SELECT count()
FROM url(
's3://not/public/file.parquet',
);DateTime64: 0 年から 9999 年まで
貢献者: Alexey Milovidov
ClickHouse 26.7 より前では、DateTime64 型は 1900 年から 2299 年までの値をサポートしていました。26.7 リリース以降、0000-01-01 から 9999-12-31 までの値をサポートするようになりました。
歴史的な出来事と将来予測のイベントを含む小さなデータセットを使って、どのように動作するか見てみましょう。
SELECT *
FROM s3('s3://public-pme/26.7/history_events.parquet')
LIMIT 10;┌─event────────────────────────────────────────────┬─happened────────────────┬─category────┐
│ Eruption of Mount Vesuvius buries Pompeii │ 0079-08-24 13:00:00.000 │ disaster │
│ Roman Emperor Hadrian begins the wall in Britain │ 0122-01-01 00:00:00.000 │ politics │
│ Diocletian splits the Roman Empire │ 0285-01-01 00:00:00.000 │ politics │
│ Council of Nicaea convenes │ 0325-05-20 00:00:00.000 │ religion │
│ Fall of the Western Roman Empire │ 0476-09-04 00:00:00.000 │ politics │
│ Justinian's Corpus Juris Civilis published │ 0534-01-01 00:00:00.000 │ law │
│ The Hijra: Muhammad travels to Medina │ 0622-09-24 00:00:00.000 │ religion │
│ Coronation of Charlemagne as Holy Roman Emperor │ 0800-12-25 12:00:00.000 │ politics │
│ Leif Erikson reaches North America │ 1000-01-01 00:00:00.000 │ exploration │
│ Norman conquest at the Battle of Hastings │ 1066-10-14 09:00:00.000 │ military │
└──────────────────────────────────────────────────┴─────────────────────────┴─────────────┘テーブルを作成します。
CREATE TABLE history
(
    event    String,
    happened DateTime64(3),
    category LowCardinality(String)
)
ENGINE = MergeTree
ORDER BY happened;続いてデータを取り込みます。
INSERT INTO history
SELECT *
FROM s3('s3://public-pme/26.7/history_events.parquet');これで、出来事が起きてからどれだけの時間が経過したかを計算できます。
SELECT event, age('year', happened, now()) AS years_ago
FROM history
WHERE category != 'future'
ORDER BY years_ago DESC
LIMIT 10;┌─event────────────────────────────────────────────┬─years_ago─┐
│ Eruption of Mount Vesuvius buries Pompeii │ 1946 │
│ Roman Emperor Hadrian begins the wall in Britain │ 1904 │
│ Diocletian splits the Roman Empire │ 1742 │
│ Council of Nicaea convenes │ 1702 │
│ Fall of the Western Roman Empire │ 1550 │
│ Justinian's Corpus Juris Civilis published │ 1492 │
│ The Hijra: Muhammad travels to Medina │ 1403 │
│ Coronation of Charlemagne as Holy Roman Emperor │ 1225 │
│ Leif Erikson reaches North America │ 1027 │
│ Norman conquest at the Battle of Hastings │ 960 │
└──────────────────────────────────────────────────┴───────────また、ある日付から 1,000 年後の未来を計算することもできます。計算結果の日付が 2299 年を超える場合、以前は不可能でした。
SELECT event, happened, happened + INTERVAL 1000 YEAR AS one_millennium_later
FROM history
WHERE happened > '1300-01-01'
ORDER BY happened
LIMIT 5;┌─event──────────────────────────────────┬────────────────happened─┬────one_millennium_later─┐
│ The Black Death reaches Europe │ 1347-10-01 00:00:00.000 │ 2347-10-01 00:00:00.000 │
│ Gutenberg completes the printing press │ 1440-01-01 00:00:00.000 │ 2440-01-01 00:00:00.000 │
│ Fall of Constantinople to the Ottomans │ 1453-05-29 06:00:00.000 │ 2453-05-29 06:00:00.000 │
│ Columbus reaches the Americas │ 1492-10-12 06:00:00.000 │ 2492-10-12 06:00:00.000 │
│ Vasco da Gama reaches India by sea │ 1498-05-20 00:00:00.000 │ 2498-05-20 00:00:00.000 │
└────────────────────────────────────────┴─────────────────────────┴─────────────────────────┘groupFormat
貢献者: Yang Hu
groupFormat は、各グループの行を任意の出力形式でフォーマットし、結果を文字列として返す集約関数です。
レポート作成だけでなく、LLM や Webhook に送信するデータをグループ化するのにも便利な関数です。
以下のクエリは、歴史データセットを世紀ごとにグループ化し、各グループのイベント名と年を JSON 形式で返します。
SELECT intDiv(toYear(happened), 100) + 1  AS century,
       groupFormat('JSONEachRow')(event, toYear(happened))
FROM history
GROUP BY century HAVING length(groupArray(happened)) > 1
ORDER BY century
LIMIT 5;┌─century─┬─groupFormat('JSONEachRow')(event, toYear(happened))────────────────┐
│ 11 │ {"c1":"Leif Erikson reaches North America","c2":1000} ↴│
│ │↳{"c1":"Norman conquest at the Battle of Hastings","c2":1066} ↴│
│ │↳{"c1":"First Crusade captures Jerusalem","c2":1099} ↴│
│ 13 │ {"c1":"Signing of the Magna Carta","c2":1215} ↴│
│ │↳{"c1":"Marco Polo departs for Asia","c2":1271} ↴│
│ 15 │ {"c1":"Gutenberg completes the printing press","c2":1440} ↴│
│ │↳{"c1":"Fall of Constantinople to the Ottomans","c2":1453} ↴│
│ │↳{"c1":"Columbus reaches the Americas","c2":1492} ↴│
│ │↳{"c1":"Vasco da Gama reaches India by sea","c2":1498} ↴│
│ 16 │ {"c1":"Luther posts the Ninety-five Theses","c2":1517} ↴│
│ │↳{"c1":"Magellan's expedition circumnavigates the globe","c2":1522}↴│
│ │↳{"c1":"Copernicus publishes On the Revolutions","c2":1543} ↴│
│ │↳{"c1":"Defeat of the Spanish Armada","c2":1588} ↴│
│ 17 │ {"c1":"Galileo observes the moons of Jupiter","c2":1610} ↴│
│ │↳{"c1":"The Mayflower reaches Plymouth","c2":1620} ↴│
│ │↳{"c1":"Newton publishes the Principia","c2":1687} ↴│
└─────────┴────────────────────────────────────────────────────────────────────┘実行可能 UDF 向けドライバー
貢献者: Daniil Timižev、Alexey Milovidov
ClickHouse はすでに 実行可能ユーザー定義関数 をサポートしていますが、以前はこれを作成する際、実行可能ファイル自体の準備とその実行方法を記述した ClickHouse 設定ファイルの作成という、SQL の外部で 2 つの別個の手順が必要でした。
ClickHouse 26.7 では、実験的機能として 実行可能 UDF 向けドライバー が導入されました。プログラミング言語またはツールチェーン用のドライバーをサーバー上で設定すれば、ユーザーは C、Rust、Python、その他サポートされている任意の言語で、標準の SQL CREATE FUNCTION 文の中に直接 UDF 全体を記述できます。必要なのはその文だけであり、個別のソースファイル、コンパイル手順、実行可能ファイルのデプロイ、実行可能 UDF の設定は不要です。
それ以外の処理はすべてドライバーが担います。CREATE FUNCTION から関数シグネチャと埋め込まれたソースコードを受け取り、コンパイル、インタープリター実行、その他の処理を行って、ClickHouse がすでに読み込みと実行の方法を把握している実行可能ファイルおよび設定を生成します。
ドライバーは XML または YAML で定義されるサーバー側のレシピです。次の項目を宣言します。
CREATE FUNCTION ... ENGINEを通じて公開される名前。- 実行可能 UDF を作成するコマンド。
- 任意のクリーンアップコマンド。
- SQL からドライバーを設定するための、検証対象となる任意の引数。
- 各コマンドに渡される任意の環境変数。
CREATE FUNCTION 内で使用できる言語は、選択されたドライバーによって決まります。
PR に含まれている概念実証用の GVisorC ドライバーは、特に C 言語向けに作られています。作成スクリプトが C 関数の本体を受け取り、ラップしてコンパイルし、実行可能 UDF を生成します。
<clickhouse>
<driver>
<name>GVisorC</name>
<create_command>
../user_defined_executable_function_drivers/gvisor_c_create.sh
</create_command>
<drop_command>
../user_defined_executable_function_drivers/gvisor_c_drop.sh
</drop_command>
<env>
<CLICKHOUSE_C_DRIVER_MEMORY>256m</CLICKHOUSE_C_DRIVER_MEMORY>
<CLICKHOUSE_C_DRIVER_CPUS>1.0</CLICKHOUSE_C_DRIVER_CPUS>
<CLICKHOUSE_C_DRIVER_GVISOR_BINARY>runsc</CLICKHOUSE_C_DRIVER_GVISOR_BINARY>
</env>
</driver>
</clickhouse>参照されている gvisor_c_create.sh および gvisor_c_drop.sh スクリプトは、概念実証用ドライバーの一部として PR に含まれています。これらは設定で参照される作成手順とクリーンアップ手順を実装しています。
ENGINE = GVisorC() でこの C 言語専用ドライバーが選択されるため、AS 句に C 関数の完全な本体を直接記述できます。
CREATE FUNCTION add
ARGUMENTS (x UInt8, y UInt8)
RETURNS Int64
ENGINE = GVisorC()
AS 'return (int64_t) x + (int64_t) y;';

SELECT add(40, 2);42作成の完全なフローは以下のとおりです。
ENGINE = GVisorC()により、設定名がGVisorCであるドライバーが選択されます。- ClickHouse がその
create_commandを呼び出し、関数名、戻り値の型、引数のシグネチャ、宣言されたエンジン引数を渡します。関数本体は設定された環境とともに標準入力経由で送られます。 GVisorCドライバーが周囲の実行可能 UDF コードを生成してコンパイルし、標準の実行可能 UDF 設定を返します。- ClickHouse が既存の実行可能 UDF の仕組みを通じてその設定を保存およびロードします。
- 元の定義は
ATTACH FUNCTION文として永続化されるため、サーバーを再起動しても関数は維持されます。 DROP FUNCTIONは任意のdrop_commandを呼び出し、生成された設定と作業用ファイルを削除します。
この GVisorC の例では、C 関数の本体をコンパイルし、生成された実行可能ファイルを gVisor サンドボックス内で実行します。PR には DockerC と UnsafeC の例も含まれていますが、ドライバーの仕組み自体は言語やツールチェーンに依存しません。デプロイ環境ごとに Python、Rust、C、その他の環境向けのドライバーを定義できます。
これらのコンポーネントがドライバーと呼ばれるのはそのためです。コンパクトで言語固有の関数定義を、ClickHouse が実行方法をすでに把握している実行可能ファイルおよび設定へと変換します。ドライバーは、ClickHouse が実行可能 UDF をユーザーにとって直接利用しやすいものにするための仕組みです。
なお、同梱されている C ドライバーは概念実証用であり、ClickHouse のパッケージにはインストールされません。実装 PR および完全な GVisorC ドライバー設定 を参照してください。
組み込み Web UI が本格的な SQL ワークスペースへと進化
貢献者: Alexey Milovidov
ClickHouse 26.7 では、オープンソースの組み込み Web UI(/play エンドポイント)に大幅な機能強化が施されました。手軽なブラウザベースのクエリコンソールとして始まったものが、本格的な SQL ワークスペースの使い心地へと進化しています。
- タブで複数のクエリを並行して作業できます。タイトル、パラメーター、小さな結果スナップショットはリロードしても保持され、状態はブラウザの履歴や URL に統合されます。
- 改良されたデータベースパネルからデータベース、テーブル、カラムをナビゲートできます。データ型、圧縮後および非圧縮のサイズ、圧縮率も確認可能です。
- スキーマを考慮したオートコンプリート、キーボードナビゲーション、一致する識別子や括弧の強調表示、インラインの構文エラー表示、インデントの改善により、クエリをより素早く記述できます。
- カラムごとの棒グラフ、ヒートマップ、カテゴリ別の色分けを使って結果を探索でき、幅の広いテーブルをスクロールする際には重要なカラムを固定表示できます。
- パラメーター付きクエリを実行し、クエリの実行中に結果がプログレッシブに更新される様子を確認できます。
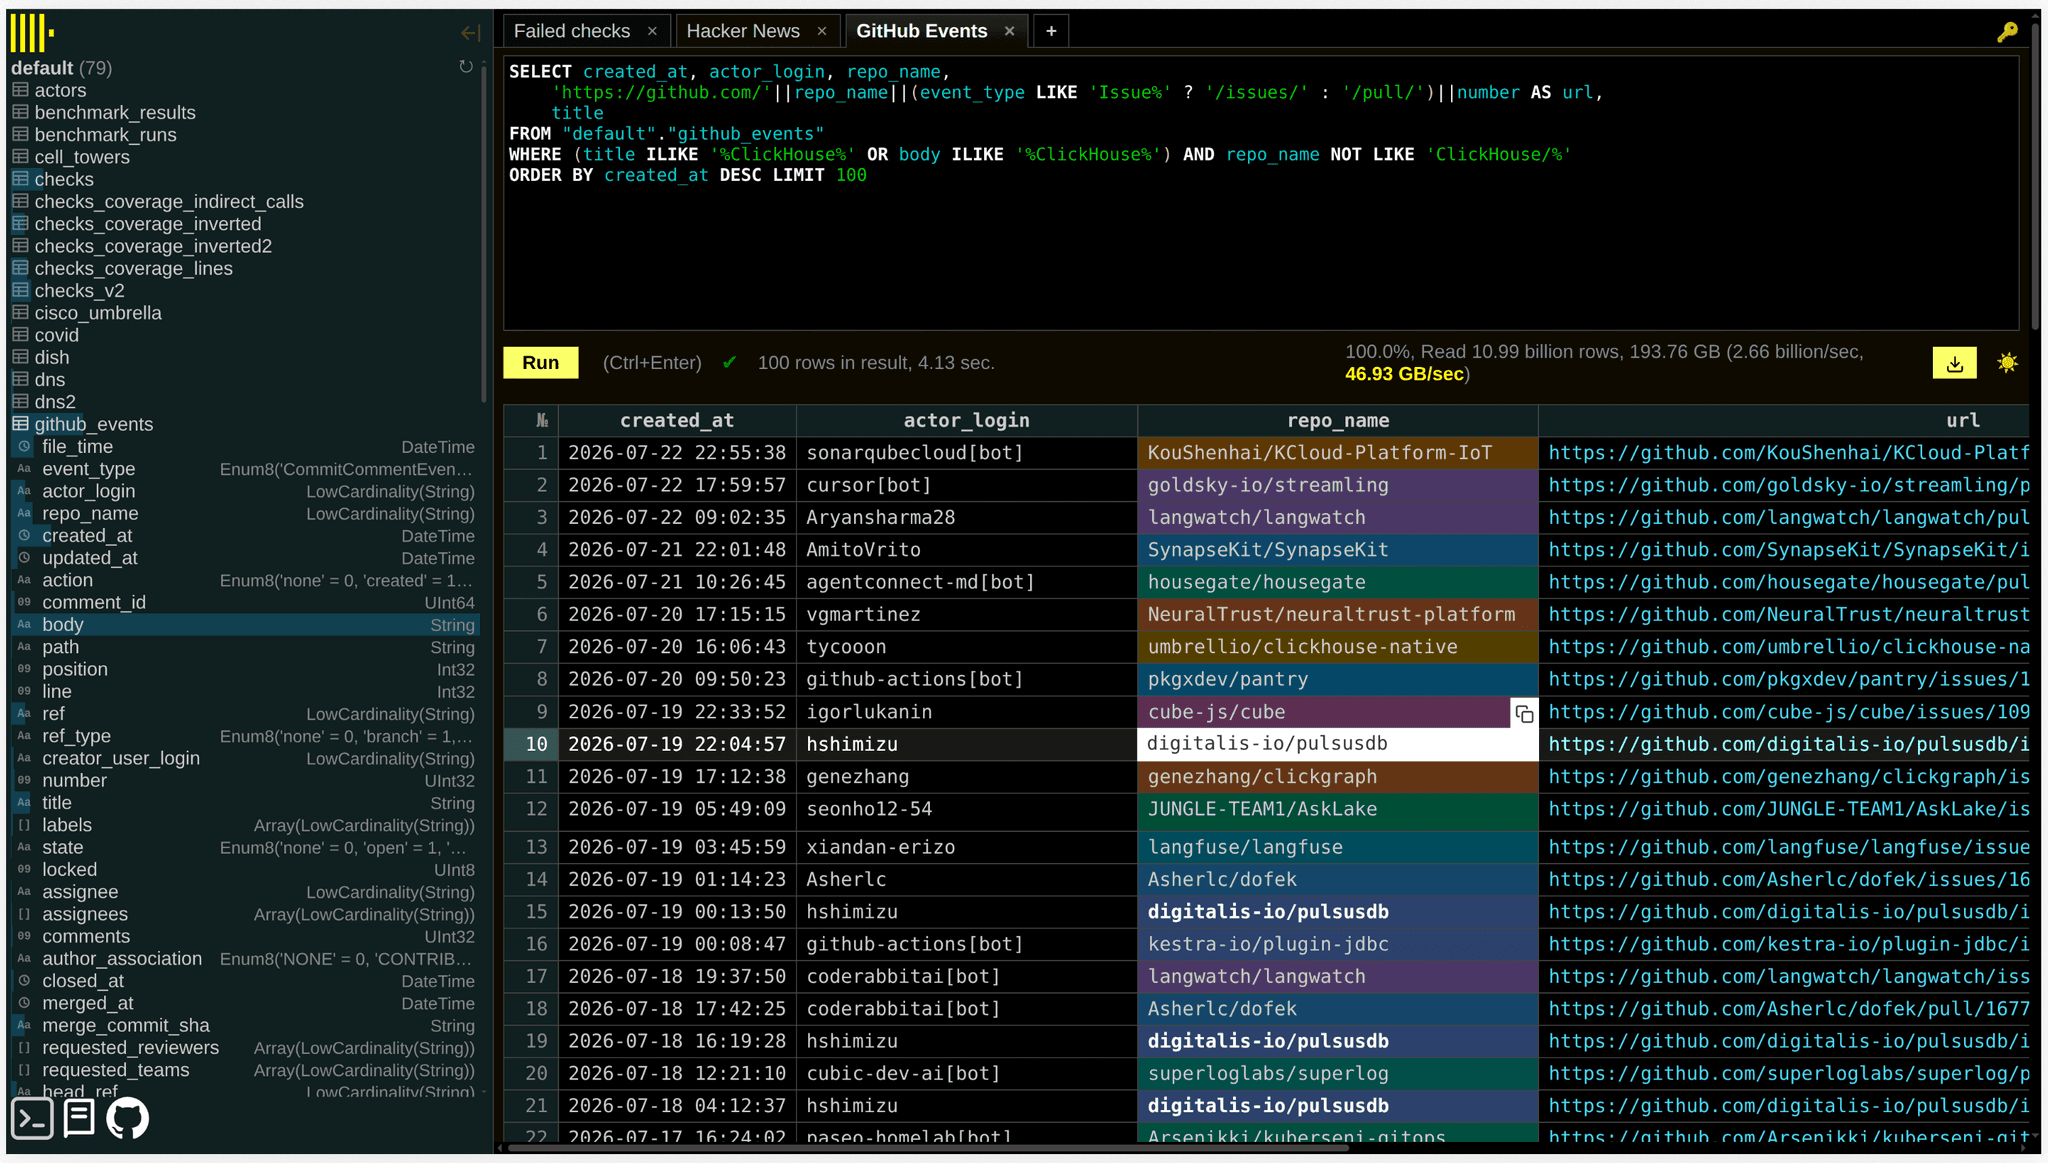
機能リストとして説明する項目は多岐にわたりますが、実際の動作を見るのが一番わかりやすいでしょう。インターフェースは高速で洗練されており、純粋に使っていて楽しい仕上がりです。ぜひご自身でお確かめください。以下の動画は Alexey によるデモから直接始まります。
バージョンに一致した即時リファレンスドキュメント
貢献者: Alexey Milovidov
組み込み Web UI に、頼もしいパートナーが加わりました。すべての ClickHouse サーバーが /docs で検索可能なリファレンスドキュメントを公開するようになりました。
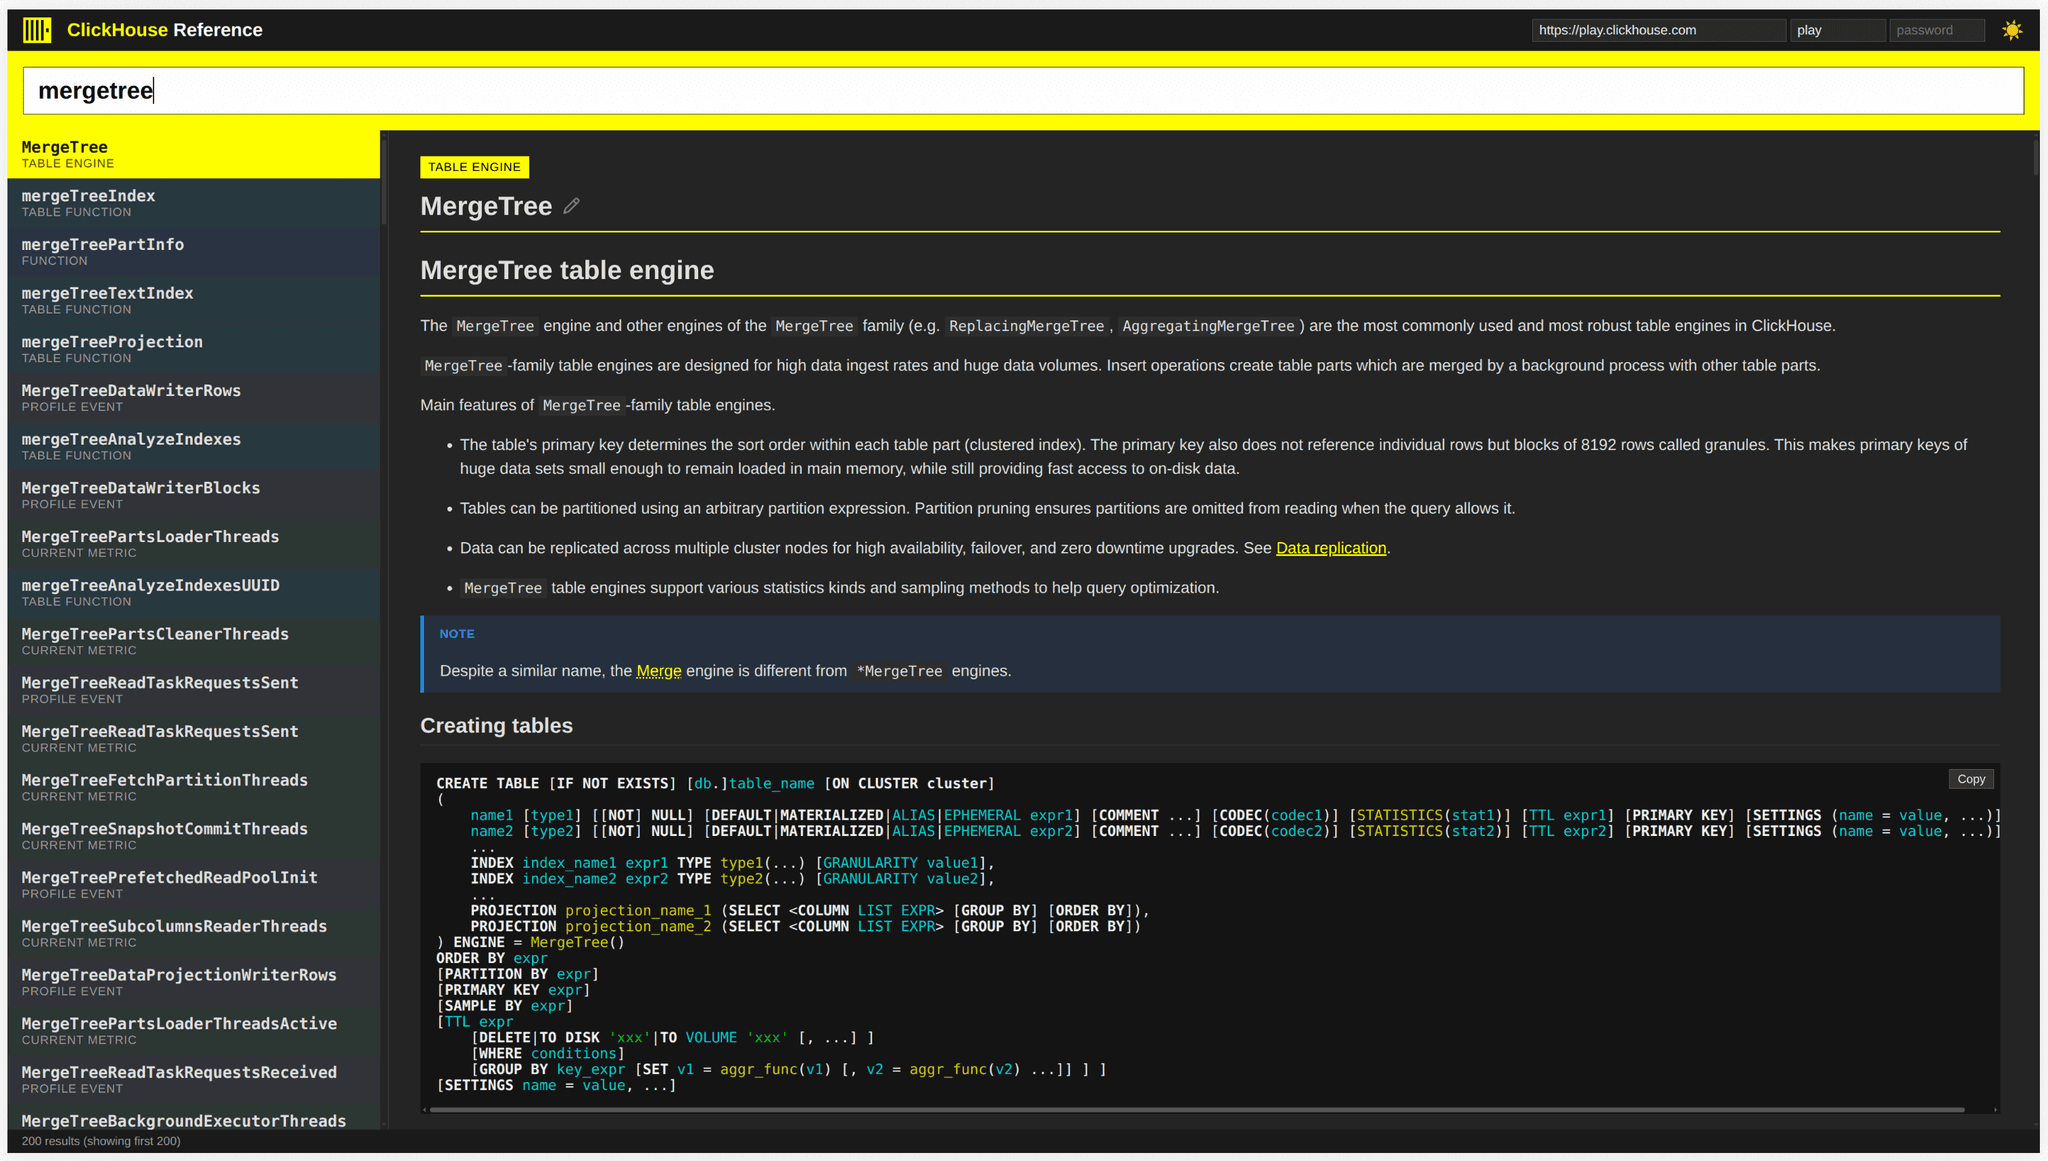
このページでは system.documentation を検索して、関数、設定、テーブルエンジン、データ型、フォーマットなどを調べ、構文ハイライト、数式、クロスリンクを含む完全なリファレンスページを表示します。すべてサーバー自体から提供されるため、インターネットアクセスがなくても動作し、実行中の ClickHouse バージョンと常に一致します。
内部的には、検索は ClickHouse のシステムテーブルに対する単なるクエリであるため、結果は即座に表示されます。
実際の動作をご覧ください。以下の動画は Alexey によるデモから直接始まります。
締めくくりとして、さらに 2 つの高速化を取り上げます。正規表現処理の高速化と、macOS 上での ClickHouse の大幅な高速化です。
ネイティブコードにコンパイルされる正規表現
貢献者: Alexey Milovidov
ClickHouse は、利用できる最速のライブラリを採用しています。正規表現においては、Russ Cox 氏によって作成された RE2 がその代表です。さらに ClickHouse は、適切なパターンを SIMD で高速化する Vectorscan も使用しています。
しかし、それでも十分な速さではありませんでした。
26.7 では、ClickHouse 独自の JIT コンパイル正規表現エンジンが追加されました。サポート対象のパターンについて、LLVM を使用して正規表現を実行時に動的コンパイルし、クエリを実行している CPU に最適化されたネイティブマシンコードを生成します。
SELECT count()
FROM logs
WHERE match(line, '^[a-z]+[0-9]+@example[0-9]+\\.com$');この新エンジンは、match、extract、extractAll、replaceRegexpOne、replaceRegexpAll、LIKE を高速化します。compile_regular_expressions によってデフォルトで有効化されており、サポートされていないパターンは透過的に代替ライブラリへとフォールバックします。
書き換えや設定変更は不要です。26.7 にアップグレードするだけで、既存の正規表現クエリは可能な限り自動的に高速なパスを利用します。
2,000 万件の文字列に対して match() を実行したテストでは、実行時間が 2.7 秒から 1.1 秒へと短縮され、約 2.5 倍高速化 しました。
macOS 上で ClickHouse がより高速に
貢献者: Alexey Milovidov、Raúl Marín
ClickHouse 26.7 では、macOS におけるパフォーマンスと機能のギャップもいくつか解消されました。
-
jemallocがダーティページを即座にではなくバックグラウンドスレッドでパージするようになり、Linux での動作と一致しました。再帰的 CTE など、メモリ割り当ての多いワークロードは約 2 倍高速 に実行されます。 -
CPU ごとの
jemallocアリーナとメモリ割り当てプロファイリングが有効になりました。 -
リモートレプリカからの非同期読み取りが
kqueueをベースにしたepoll互換レイヤー経由で機能するようになり、分散クエリがシャードから順次ではなく同時に読み取れるようになりました。 -
SSD キャッシュ辞書と
FileLogエンジンが macOS 上で動作するようになりました。 -
STREAMクエリがサポートされるようになりました。
Apple ハードウェア上で ClickHouse をローカル実行する開発者にとって、26.7 はより高速で、より完成度の高いものとなっています。