50.8k

本稿は、日本のIT企業でデータベースエンジニアを務め、AWS Community Builder でもある朝比日出彦氏によるゲスト投稿です
注意: 本稿の内容はすべて、2026年9月から10月にかけてプライベートプレビュー段階の WalShadow で検証したものであり、すべての数値は当時の同環境における結果を反映しています。一般提供 (GA) までに、デフォルト値や動作が変更される可能性があります。
概要
- Postgres の変更データを ClickHouse で分析する際、レプリケーションの遅延をどれだけ小さく抑えられるかは重要な設計要素となります
- 一定間隔でバッチ書き込みを行う方式では、その間隔を調整することで、パイプが処理できる書き込みレートの範囲内でレプリケーション遅延と書き込み頻度をトレードオフにできます。一方、スタックの両端を ClickHouse が管理しているからこそ実現できる WAL の直接読み込みでは、書き込みレートを上げても遅延をほぼ一定に維持できました
- アプリケーションは Postgres にのみ書き込みを行い、スキーマ変更や運用イベントが発生しても、人手による介入なしにレプリケーションは継続しました。同期先テーブルの利用には、WalShadow の仕組みに由来する留意点がいくつか存在します
- プライベートプレビュー中に報告した不具合は修正され、同じ手順を用いてそれぞれの修正を確認できました
はじめに
少し前、私はオープンソースの walshadow を自身で EC2 上にデプロイし、Postgres から ClickHouse Cloud へのレプリケーションに利用していました。それを見た ClickHouse チームのメンバーから声がかかり、ClickHouse Managed Postgres に組み込まれたマネージド版 WalShadow をプライベートプレビューで試す機会を得ました。
Managed Postgres の「Sync to ClickHouse」ページには、既存の選択肢である ClickPipes と、新たに追加された WalShadow の 2 つのレプリケーション方法が用意されています。
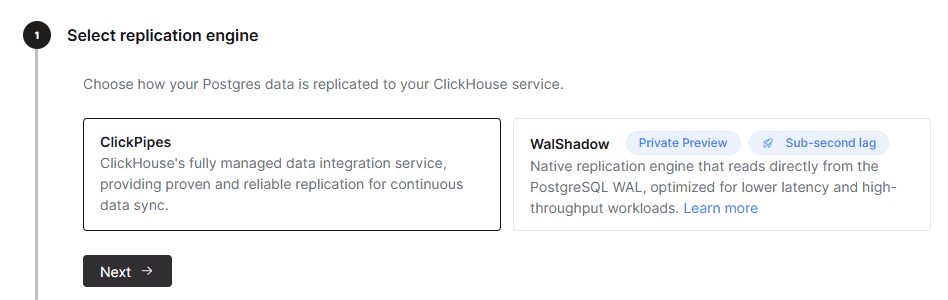 図 1: 「Sync to ClickHouse」ウィザードの最初のステップで ClickPipes と WalShadow のいずれかを選択
ClickPipes は、Postgres のロジカルレプリケーションを介して変更を受け取るフルマネージド型のデータパイプラインです。同期元は Managed Postgres に限らず、Amazon RDS や Google Cloud SQL などの Postgres も利用できます1。
WalShadow はロジカルレプリケーションを使用しません。レプリカと同様に物理 WAL を受け取り、Postgres の外部でデコードして、その結果をブロックとして直接 ClickHouse に書き込みます2。このアプローチは、同期元の Postgres と同期先の ClickHouse というスタックの両端を ClickHouse が管理し、WAL から ClickHouse へのネイティブな経路を確保できるからこそ実現可能です。大半のマネージド Postgres サービスでは、物理 WAL が利用者に公開されていません2。WalShadow のドキュメントでは、最も低いレイテンシと最小のレプリケーションオーバーヘッドが求められる場合に WalShadow を選択することを推奨しています3。
1か月にわたる検証の中で、同一の同期元および同期先において 2 つの方式にどれほどの違いがあるのか、アプリケーションが Postgres にのみ書き込む構成で同期先での集計結果が正しく保たれるか、そして運用イベントの発生時にユーザーの介入が必要となるかを確認しました。
テスト環境
| 項目 | 詳細 |
|---|---|
| 同期元 | ClickHouse Managed Postgres (東京、PostgreSQL 18.6)。2 方式の比較では 16 vCPU、アプリケーションおよび運用のテストでは主に 2 vCPU を使用 (各セクションに記載) |
| 同期先 | ClickHouse Cloud (東京、16 GiB / 4 vCPU のレプリカ 2 基) |
| 負荷 | 手元のノート PC (WSL2 上の Python): レイテンシ計測用の行 (毎秒 1 行)、generate_series による一括 INSERT、注文アプリケーション (1 トランザクションで注文とその明細行を書き込み、毎秒 100 注文) |
比較検証には、同期元 CPU がボトルネックにならないよう、WalShadow の開発チームからも推奨された 16 vCPU を使用しました。
ClickPipes と WalShadow のレイテンシを並行して計測
まず、同一の同期元に対して WalShadow と ClickPipes を同時に設定し、同一の ClickHouse Cloud サービス内の 2 つのデータベースへとそれぞれレプリケーションを行いました。両方式ともまったく同じ書き込みを同じタイミングでレプリケーションするため、時間帯や同期元の状態による差異は比較に影響しません。
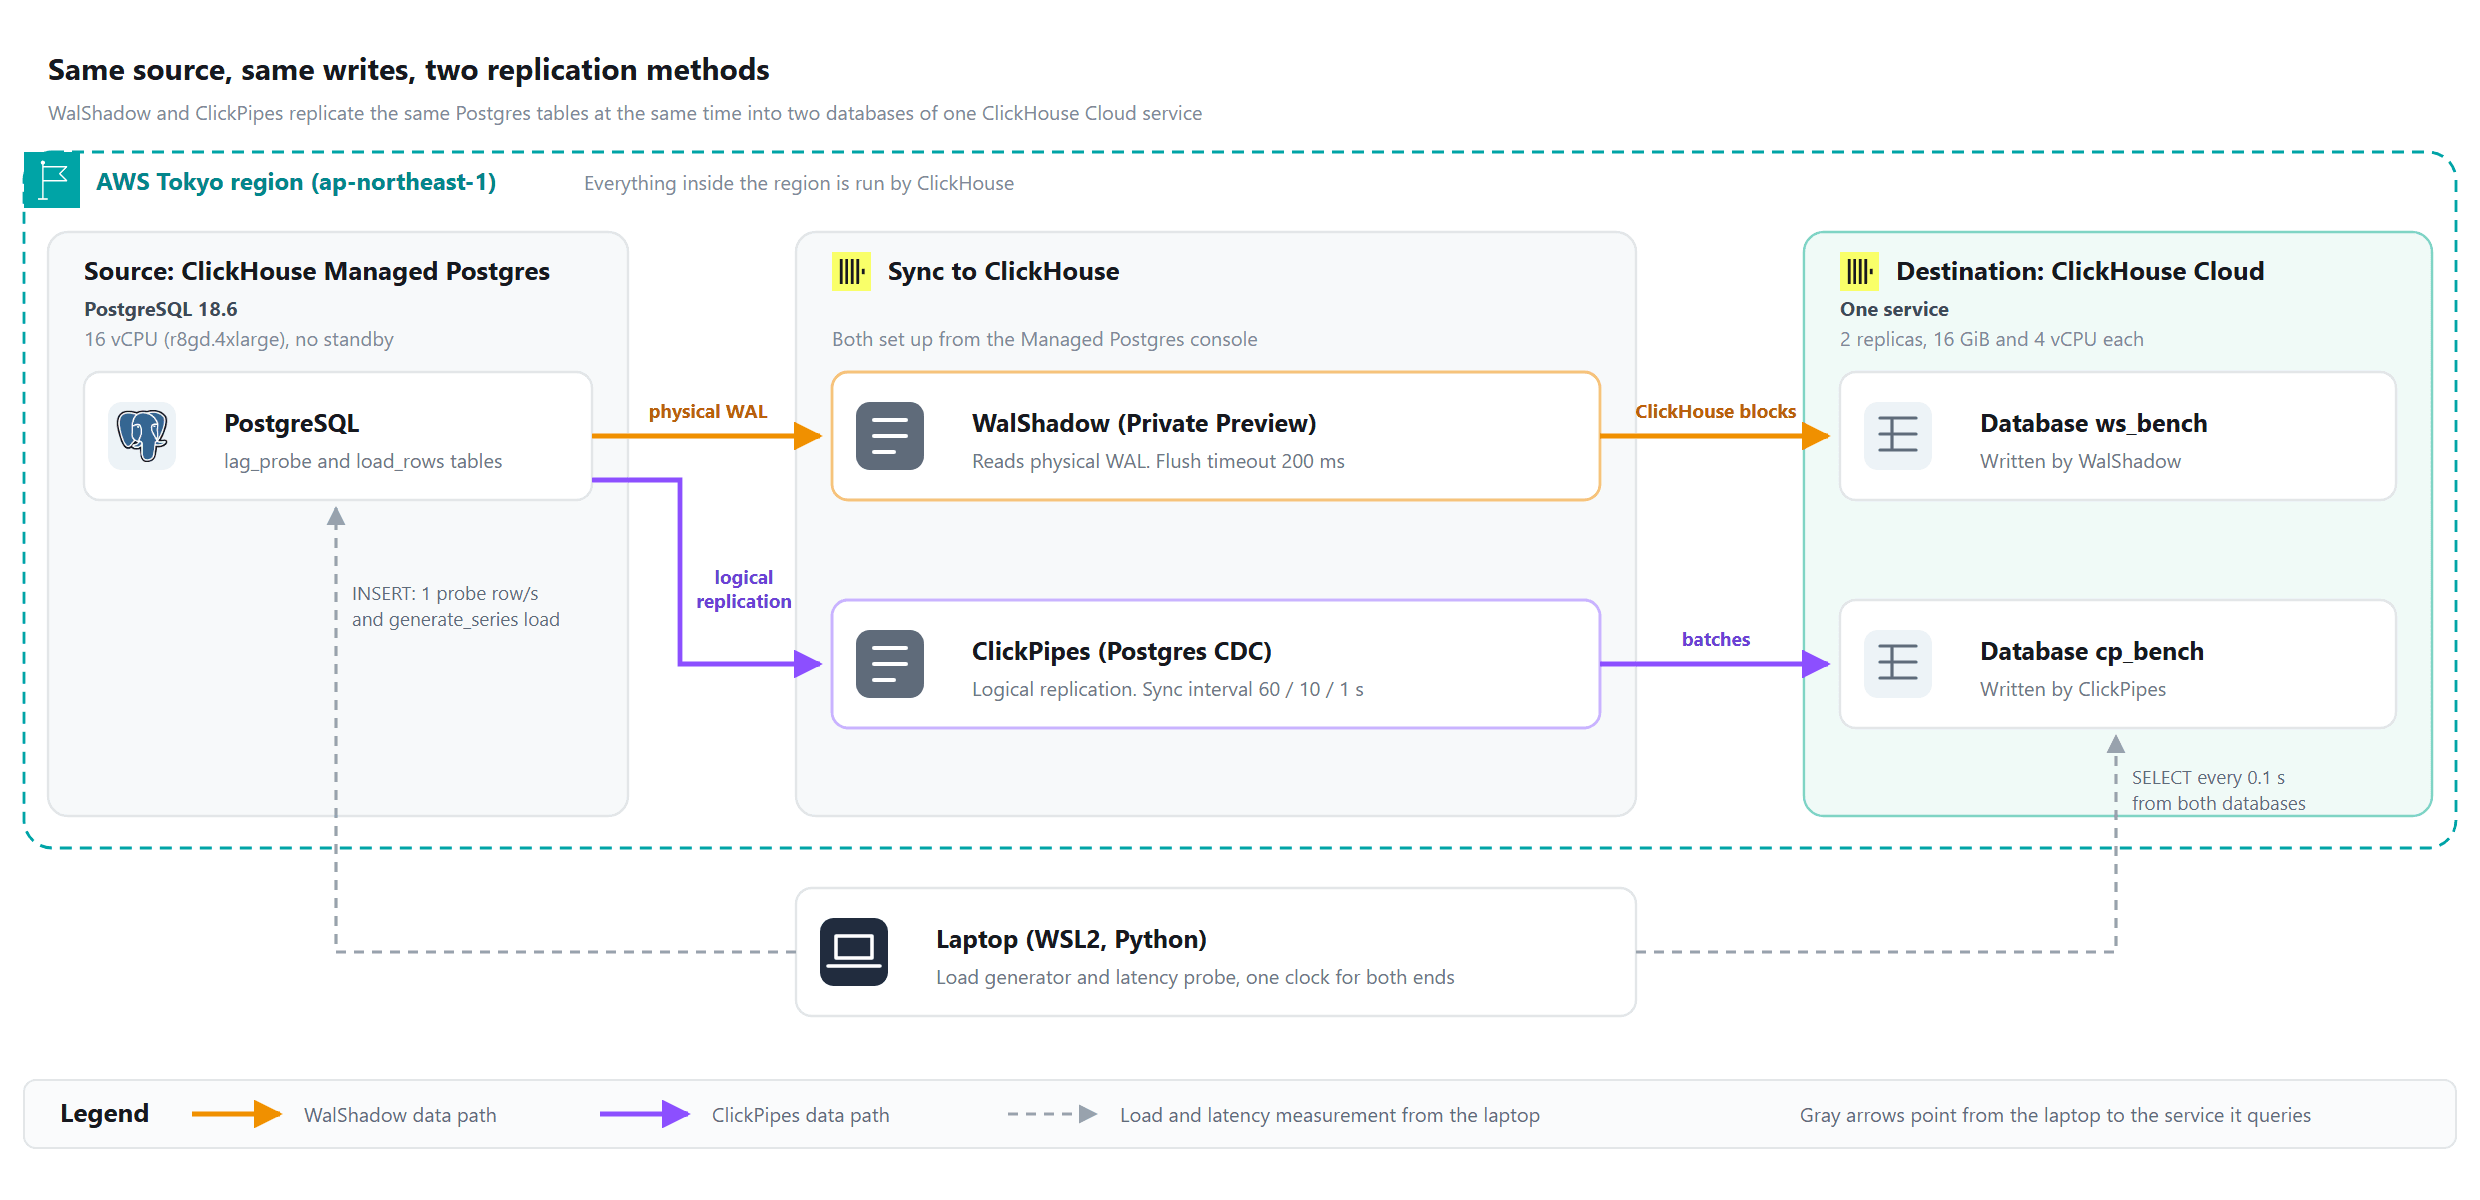 図 2: テスト構成。1 つの同期元、2 つの方式、同一 ClickHouse Cloud サービス内の 2 つのデータベース
ClickPipes には 2 つの同期設定があります。同期先への書き込み頻度を決める「Sync interval」と、一度に読み出す行数を指定する「Pull batch size」 (デフォルトは 100,000 行) です。いずれかの閾値に達した時点で書き込みが開始されます4。WalShadow には同期先へ書き込むまでの最大待機時間を決める「Flush timeout」設定があります。今回の計測の途中で、開発チームにより WalShadow の Flush timeout が 200 ms に変更されました5。表内の値はこの変更後のものです。
レイテンシは、「同期元で行が挿入・コミットされた瞬間」から「その行が同期先で可視化された瞬間」までを、同一ノート PC 上の同一クロックを用いて計測しました。同期先に対しては 0.1 秒ごとにポーリングを行いました。下表は、毎秒 1 行のペースで 120 行ずつ書き込んだ 3 回の実行結果を示しています。ClickPipes の Sync interval を 60 秒 (デフォルト)、10 秒、1 秒に設定し、各回で WalShadow も同時に計測しました。ドキュメントでは Sync interval を 10 秒以上に維持することが推奨されていますが、今回は挙動を確認する目的で 1 秒も試しています4。
| ClickPipes の Sync interval | ClickPipes 中央値 / 最大値 | WalShadow (同時計測) 中央値 / 最大値 |
|---|---|---|
| 60 秒 (デフォルト) | 31.10 〜 31.14 秒 / 60.62 〜 60.69 秒 | 0.38 〜 0.40 秒 / 0.49 〜 0.75 秒 |
| 10 秒 | 5.56 〜 5.60 秒 / 10.68 〜 10.74 秒 | 0.38 〜 0.39 秒 / 0.48 〜 1.42 秒 |
| 1 秒 | 1.43 〜 1.44 秒 / 1.72 〜 1.75 秒 | 0.38 〜 0.40 秒 / 0.47 〜 0.49 秒 |
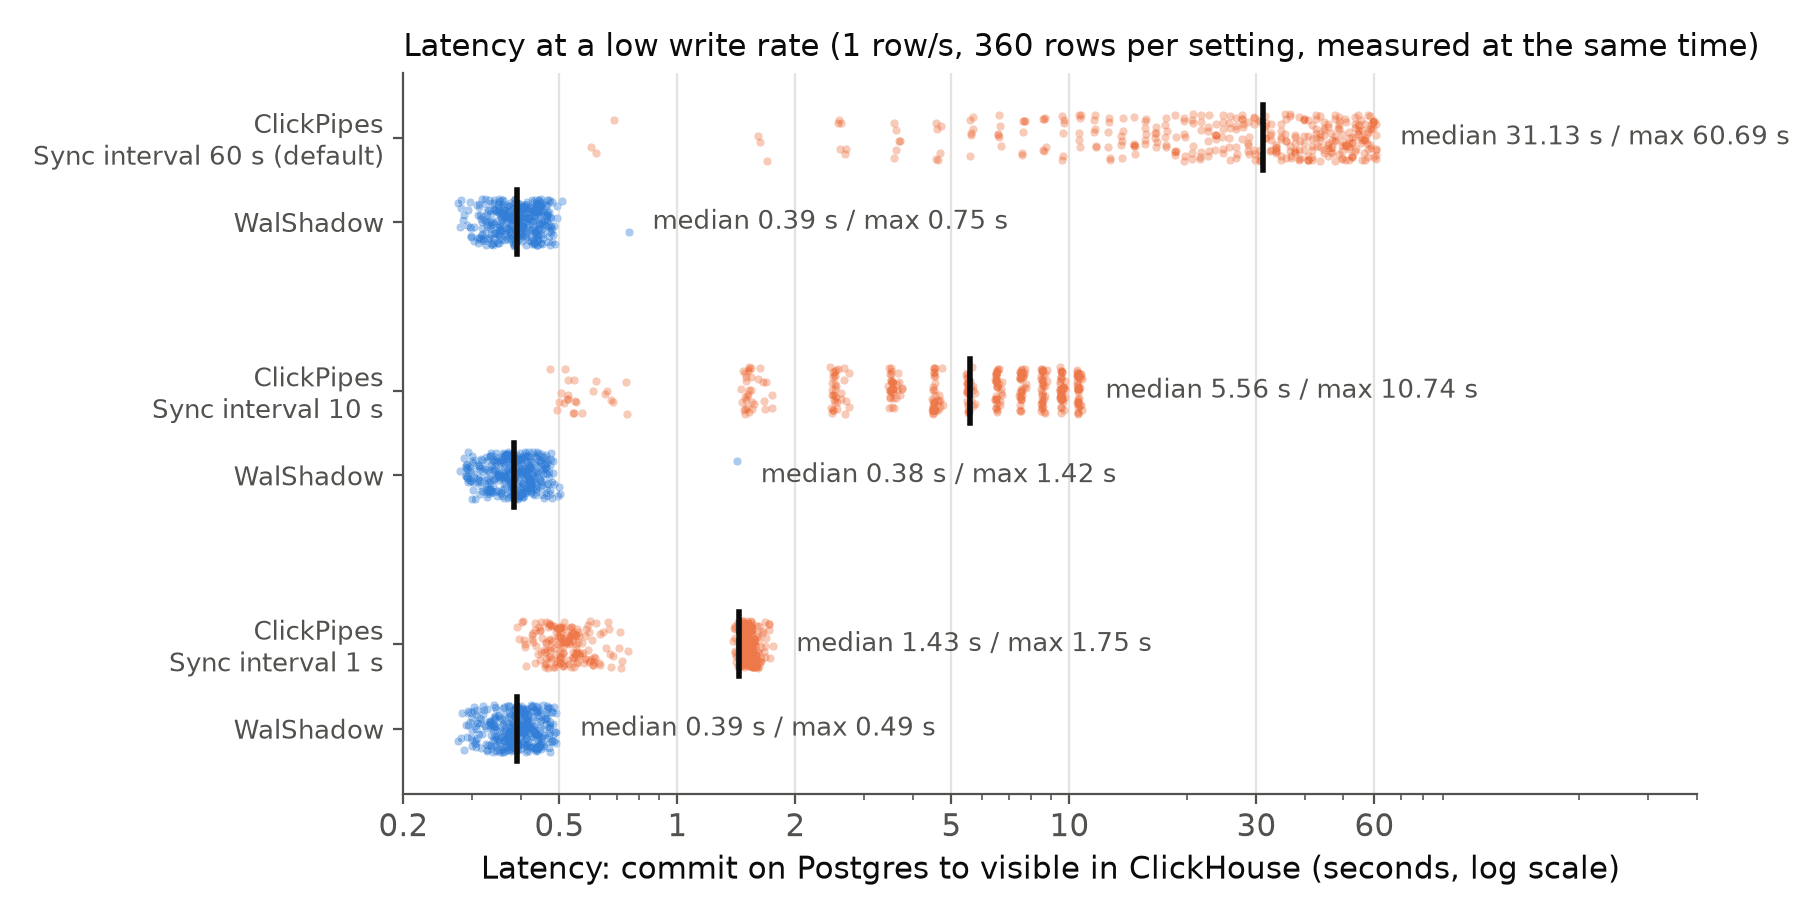 図 3: 低書き込みレートにおける ClickPipes と WalShadow のレイテンシ分布 (毎秒 1 行、各設定 360 行。黒の垂直線は中央値)
ClickPipes のレイテンシは、選択した Sync interval に大きく左右されます。最大値はほぼ Sync interval の値と一致しました。書き込み量が多い場合、ClickPipes は 60 秒の満了を待たずに 100,000 行に達した時点で書き込みを開始するため、レイテンシは毎秒 1 行のときよりもさらに低下します。数十秒の遅延が許容されるユースケースであればデフォルトのままで十分であり、より鮮度の高いデータが必要な場合は、パイプが処理できる書き込みレートの範囲内である限り (後述参照)、間隔を短縮できます。
WalShadow の中央値レイテンシは、どの測定回でも約 0.4 秒でした。最大値は一度 1.42 秒に達しました。次に、書き込みレートを毎秒 1,000 行から 200,000 行まで段階的に引き上げていきました (各ステップ 3 分間)。WalShadow の中央値はすべてのステップで 0.37 〜 0.41 秒の間に収まり、毎秒 200,000 行の時点でも最大値は 1.71 秒でした。この時点での同期元 (16 vCPU) の CPU 使用率は約 10% でした。
ClickPipes については、デフォルトの Sync interval である 60 秒に設定して WalShadow と同時に各ステップを計測したほか、同サイズ (16 vCPU) の新たな同期元インスタンスを用意し、Sync interval を 1 秒に設定して再度同じステップを実行しました。1 秒の設定でのテストには WalShadow を接続せず、Pull batch size の 100,000 行など、その他の設定はデフォルトのままにしました。各ステップは、同期先が同期元に追いつくのを待ってから次のステップを開始しています。
| 書き込みレート (行/秒) | ClickPipes (Sync interval 1 秒) 中央値 / 最大値 | ClickPipes (Sync interval 60 秒、デフォルト) 中央値 / 最大値 | WalShadow 中央値 / 最大値 |
|---|---|---|---|
| 1,000 | 1.50 秒 / 1.75 秒 | 31.26 秒 / 60.79 秒 | 0.38 秒 / 0.48 秒 |
| 5,000 | 1.48 秒 / 1.76 秒 | 10.37 秒 / 19.93 秒 | 0.40 秒 / 0.51 秒 |
| 20,000 | 1.00 秒 / 1.89 秒 | 3.16 秒 / 5.31 秒 | 0.37 秒 / 0.50 秒 |
| 50,000 | 1.48 秒 / 2.06 秒 | 2.15 秒 / 2.81 秒 | 0.40 秒 / 0.51 秒 |
| 75,000 | 43.8 秒 / 87.6 秒 | 36.8 秒 / 130.2 秒 | 0.41 秒 / 0.54 秒 |
| 100,000 | 87.2 秒 / 173.6 秒 | 78.0 秒 / 153.9 秒 | 0.40 秒 / 0.52 秒 |
| 200,000 | 258.9 秒 / 522.6 秒 | 154.6 秒 / 306.8 秒 (180 行中 114 行が計測時間内に到達) | 0.38 秒 / 1.71 秒 |
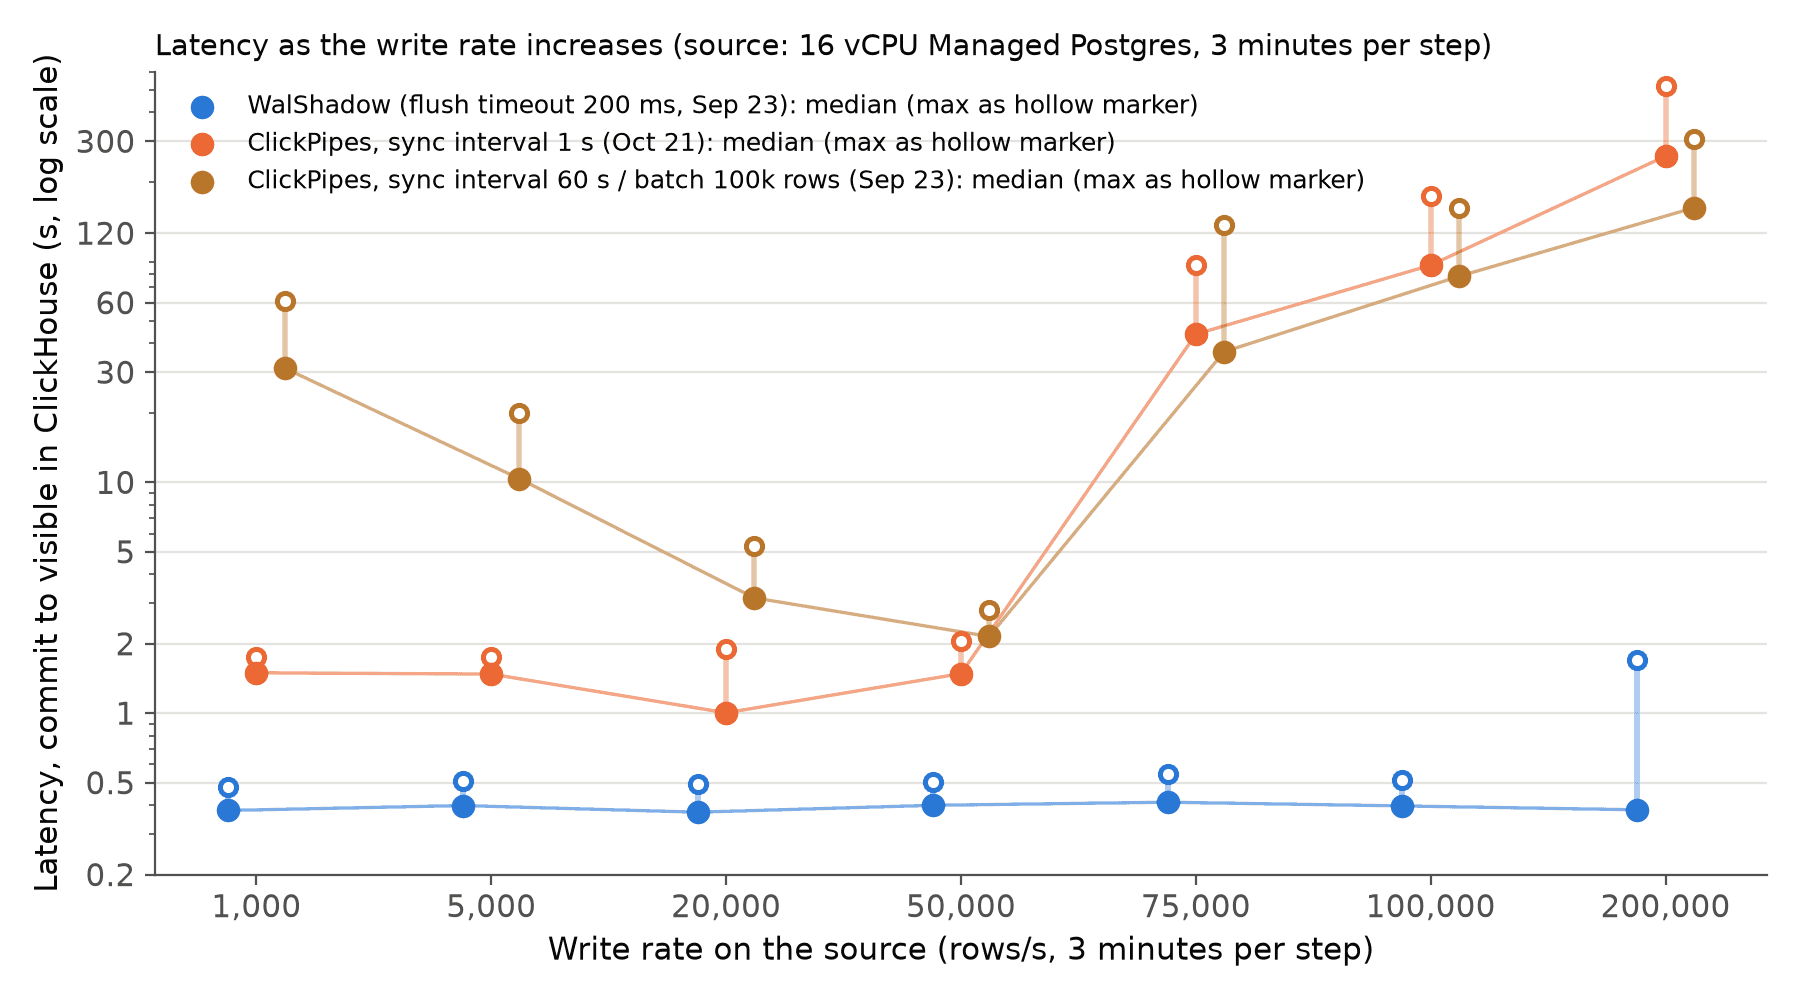 図 4: 書き込みレート増加に伴うレイテンシの変化 (各ステップ 3 分間、中央値および最大値、対数目盛)
毎秒 50,000 行までは、ClickPipes のレイテンシは設定どおりに推移しました。1 秒間隔の場合は 1 〜 1.5 秒となり、60 秒間隔の場合でも 100,000 行のバッチが先に満たされるため数秒にとどまりました。しかし毎秒 75,000 行以降は、どちらの設定でもステップの経過とともにレイテンシが増大し続けました。1 秒間隔で毎秒 75,000 行を処理した際の中央値は、最初の 1 分間が 15 秒であったのに対し、最後の 1 分間では 74 秒に達しました。各ステップ完了後に同期先が追いつくまでの時間から計算すると、ClickPipes はすべてのステップで毎秒約 50,000 行 (1 時間あたり 1 億 8,000 万行) を処理していました。Sync interval を短縮すると書き込み前の行の待機時間は短くなりますが、パイプ自体の処理能力が向上するわけではありません。この間、同期元の CPU 使用率は約 10% を維持しており、同期元側には十分な余力がありました。また、ClickPipe 自体のコンピュート設定を 2 vCPU から 8 vCPU にスケールアップした上で、1 秒間隔のまま毎秒 75,000 行、100,000 行、200,000 行のテストを再実行しました。その結果、中央値レイテンシは 34.7 秒、72.5 秒、224.6 秒となり、10 〜 20% の改善が見られました。追いつき時間から算出したパイプの処理能力は毎秒約 55,000 行で、CPU 使用率は 8 コア中約 2 コア分にとどまっていました。
レイテンシと並行して、両方式が同一のデータをレプリケーションできているかも確認しました。計 9 回の各チェックポイントにおいて、同期元と 2 つの同期先の間で行数、合計値、MD5 ハッシュを比較したところ、すべて完全に一致しました。最終チェックでは、負荷テスト用テーブル内の全 85,618,571 行が 3 箇所すべてで一致していることを確認しました。その後の ClickPipes 単体のテストでも、全ステップ終了時点で同期元と同期先の 108,178,569 行が完全に一致しました。
アプリケーションは Postgres に書き込むだけでよいのか
ここからは WalShadow のみを用い、アプリケーションは Postgres にのみ書き込みを行い、ClickHouse 側から集計値を読み出す構成をテストしました。同期元には 2 vCPU インスタンスを使用しました。
注文アプリケーションを 30 分間稼働させました。30 秒ごとに、同期先において「1 分前に終了する 5 分間のウィンドウ」の注文数と売上高を集計し、その時点の Postgres の結果と比較しました。計 61 回の比較はすべて一致しました。テストの途中で、orders テーブルへのカラム追加、アプリケーションからの書き込み対象となる新規テーブルの作成、およびインデックスの作成を実施しました。いずれの場合も、手作業での介入を一切行うことなくレプリケーションが継続しました。追加したカラムは直ちに同期先へ反映され、新規テーブルも作成から約 11 秒後に確認した時点で既に同期先に存在していました。負荷を停止した後の全体比較でも、件数、合計値、ステータス別の内訳に至るまで完全に一致しました。
WalShadow ウィザードのテーブル選択ステップでスキーマに対して「Select all tables」を選択しておくと、新しく作成されたテーブルも自動的に取り込まれます。テーブルを個別に選択した場合は、後から作成されたテーブルは含まれません。頻繁にテーブルが追加されるアプリケーションでは、「Select all tables」を選んでおくことで、後から手動でテーブルを追加する手間を省けます。
WalShadow は、同期先のテーブルに 3 つのカラムを追加します。削除を示す _is_deleted、コミット時刻を示す _commit_ts、WAL の位置を示す _lsn です。同期先テーブルを利用するにあたっては、以下の留意点があります。これらはいずれも不具合ではなく、WalShadow の動作原理に由来する仕様です。
- 1 つのトランザクションが 2 つのテーブルに書き込みを行う場合、同期先では一時的に一方のテーブルの変更のみが反映されて見えることがあります。これは WalShadow がテーブルごとにブロックを構築し、それらを並列で書き込むためであり2、オープンソース版のドキュメントでも制限事項として記載されています6。最終的には状態が一致します
- 同期先のテーブル上にマテリアライズドビューを作成すると、CDC を通じて届いた行もビューへと流れます。更新された行の新しいバージョンや、
_is_deleted = 1の行もそのまま渡されるため、ビュー側で行のバージョン管理や削除をどう扱うかを設計しておく必要があります - 初期ロード時にバックアップから読み込まれた行については、
_commit_tsと_lsnにコミットごとの値ではなく、全行で同一の固定値が設定されます。_commit_tsに基づく TTL を追加したところ、TTL の設定直後にこれらの行がすべて削除されてしまいました。経過時間の計算や TTL にこれらのカラムを使用する場合は、CDC 経由で届いた行にのみ適用してください - 同期先のテーブルにカラム、TTL、プロジェクションを追加しても、レプリケーションが停止することはありませんでした (
deduplicate_merge_projection_modeをrebuildに設定することでプロジェクションを追加できました)。なお、同期先のテーブルを DROP した場合、同期元のテーブルに次の変更が発生したタイミングで空のテーブルとして再作成され、それ以前の行は復元されません
レプリケーションはコミット順に処理されます。月末締め処理のような大規模なトランザクションが 1 つ存在する場合、その背後にある小さな書き込みは、その大規模トランザクションが同期先に到達するまで待たされることになります。2 vCPU の同期元において、1 トランザクションで 200 万行を挿入した際、その最中にコミットされた行が同期先に現れるまでに数分を要しました。これはコミット順レプリケーションの仕様どおりの挙動です。大規模な更新処理を行う際は、同期先の遅延が一時的に増大することを考慮して設計してください。
運用イベント: 再起動、リサイズ、同期先の停止
マネージドサービスでは、ユーザーの操作やメンテナンスによって同期元の再起動やリサイズ、同期先の停止が発生します。それぞれのシナリオを 1 回ずつテストし、レプリケーションにどのような影響があるかを確認しました。
| イベント | 同期元 | 結果 |
|---|---|---|
| 同期元 Postgres の再起動 | 2 vCPU | Postgres の起動から約 0.1 秒後に WalShadow が再接続しました。コンソール上に表示される WalShadow の稼働時間 (Uptime) はリセットされませんでした |
| 同期元のリサイズ | 2 → 4 → 2 vCPU | サービスが新しいノードに切り替わるたびに、WalShadow は自動的に新ノードへ再接続しました。5 秒ごとに挿入していたレイテンシ計測用の行は、1 行も失われませんでした |
| 同期先サービスの停止と起動 | 16 vCPU | サービス起動から約 1 分後に WalShadow が自動で再開し、同期先の行数は同期元と一致しました |
| 同期先の自動アイドル (auto-idle) | 2 vCPU | 同期元への書き込みによってアイドル状態の同期先が復帰し、WalShadow は停止することなく追いつきました |
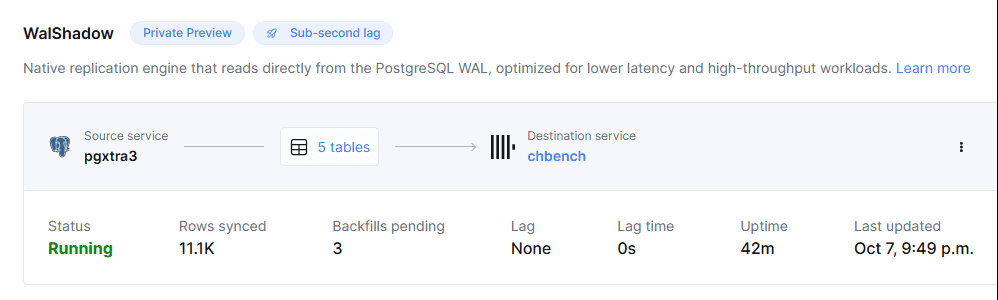 図 5: 同期元を 2 から 4 vCPU にリサイズした後の WalShadow。ステータスは Running のままで、Uptime もリセットされず
ウィザードにおける Flush timeout のデフォルト値は 500 ms です。デフォルト設定のままでもレイテンシは 1 秒未満を維持でき、タイムアウトを 200 ms に下げることでレイテンシはさらに低下しました。
WalShadow の作成からレプリケーション開始までにかかる時間は、10 月に実施した 7 回のセットアップ全体で 2 〜 7 分でした。9 月下旬から 10 月 1 日にかけては、セットアップに約 15 〜 20 分かかるケースもありました。観察した挙動から判断すると、初期ロードは日次バックアップとそれに続く WAL を組み合わせて構築されているようです。
改善要望を 1 つ挙げると、現時点では WalShadow のレプリケーションが停止したことを把握する手段がコンソールのステータス確認しかありません。ClickPipes には一時停止と再開の機能に加え、ログページが用意されています。また、同期先が停止した際にはメール通知も送信されました。ドキュメントによると、「運用管理機能とより詳細なメトリクス」がロードマップに予定されているとのことです3。WalShadow にも同様の通知機能が備われば、運用がより容易になるはずです。
プライベートプレビュー中に報告し、修正された不具合
開発チームとは共有の Slack チャンネルを通じてコミュニケーションを取りました。発見した不具合を再現手順やタイムスタンプとともに報告し、修正版がリリースされた際には同じ手順を用いて再検証を行いました。以下は、修正が確認された順に並べた主な事象です。
| 発見した事象 | 報告日 | 修正確認日 | 修正後の状況 |
|---|---|---|---|
| カラムの型変更 (int → bigint) 後にレプリケーションが停止した | 9月24日 | 9月25日 | レプリケーションが継続し、同期先側のカラムも自動的に Int32 から Int64 へと拡張されました。int の範囲を超える値も正確にレプリケーションされ、同期元と一致しました |
| 同期元のリサイズ (新ノードへの切り替え) 後、WalShadow が再接続せず、再作成しても起動しなくなった | 9月24日 | 9月25日 (再作成時に起動可能に)、10月7日 (自動再接続) | 2 回のリサイズを通じて、人手を介さずに自動で再接続されるようになりました |
| 同期先を手動で停止・起動した後、WalShadow がエラー状態のまま復旧しなかった (チームによれば再起動制限に達していたとのこと) | 9月28日 | 10月2日 | Start 操作から約 1 分後に自動で再開するようになりました |
| 主キーのないテーブル (REPLICA IDENTITY FULL 設定) において、初期ロードの結果が 1 行に縮退した。また、更新された行の古いバージョンや削除された行が同期先に残存した。さらに主キーの値が書き換えられた際、古いキーを持つ行が残存した | 9月28日 | 10月7日 (初期ロード)、10月13日 (残りの問題) | 初期ロードですべての行が取得されるようになりました。同期先テーブルの ORDER BY キーにすべてのカラムが含まれるようになり、古いバージョンも削除行も残存しなくなりました。古いキーに対しては _is_deleted = 1 の行が書き込まれるようになりました |
| 日次バックアップ以降に作成されたテーブルにおいて、TOAST に格納されるサイズの大きな値が存在すると初期ロードが停止した | 9月26日 | 10月16日 | 初期ロードおよびその後の変更データが、値に至るまで同期元と完全に一致するようになりました |
修正は報告から数日から数週間で提供されました。一部の修正はオープンソースの walshadow リポジトリに変更として公開されていたため、後から根本原因を確認することもできました。たとえば、リサイズ後に再作成しても WalShadow が起動しなかった問題は、同期元のノード切り替えに伴って同期元のタイムラインが進んでいるにもかかわらず、WalShadow が古いタイムラインから再開を試みていたことが原因でした。自らが報告した内容が製品へと反映され、同じ手順でそれぞれの修正を確認できたことは、プレビュー参加者として非常に刺激的な体験でした。
所感
2 つの方式の選択は、まず Postgres をどこで稼働させているかによって決まります。
- Amazon RDS や Google Cloud SQL など、ClickHouse Managed Postgres の外部で Postgres を稼働させている場合、ClickPipes は極めて確実な選択肢となります1。今回のテストでは毎秒約 50,000 行を処理し、データは同期元と完全に一致しました。パイプの処理能力の範囲内であれば Sync interval によってレイテンシを調整でき、一時停止や再開、ログページといった運用管理機能も備わっています
- Postgres を ClickHouse Managed Postgres 上で稼働させているのであれば、リアルタイム分析には WalShadow が最適な選択肢です。スタックの両端を ClickHouse が管理しているからこそ、WAL から ClickHouse へのネイティブな経路を構築でき、それが圧倒的なパフォーマンス上の優位性を生み出しています2。テストしたすべての書き込みレートにおいて中央値レイテンシは約 0.4 秒を維持しており、低遅延が求められる特殊なケースにとどまらず幅広く活用できるはずです
WalShadow を使用していて印象的だったのは、レイテンシとユーザー体験の双方への強いこだわりです。Postgres に書き込んだ直後に ClickHouse 側のダッシュボードを開くと、そこには既にデータが届いていました。分析用レプリケーションでありがちな「もう反映されただろうか?」と身構える瞬間が完全になくなり、非常に快適に扱えるツールだと感じました。
WalShadow を活用することで、アプリケーションは Postgres にのみ書き込みを行い、ClickHouse 側の集計値は何の追加作業もなく自動的に更新される環境を構築できました。約 0.4 秒という遅延であれば、直前に書き込まれた内容を即座に表示するなど、分析処理をアプリケーションそのものの中に自然に組み込むことができ、「ニアリアルタイム」にとどまらない真のリアルタイム性を実現できます。テーブルの選択方法、同期先テーブルの取り扱い、そして大規模トランザクションへの配慮といった留意点はありますが、それらはすべて前述のセクションで網羅したとおりです。
まとめ
- 毎秒 1,000 行から 200,000 行に至るすべての書き込みレートにおいて、WalShadow の中央値レイテンシは約 0.4 秒を維持しました。ClickPipes のレイテンシは毎秒約 50,000 行までは Sync interval の設定値どおりに追従したものの、それを超えると設定やパイプのコンピュートサイズにかかわらず増加しました。どちらの方式も、同期元と完全に一致するデータをレプリケーションできました
- アプリケーションからの書き込み、スキーマ変更、同期元の再起動やリサイズ、同期先の停止や自動アイドリング(auto-idle)を経ても、手動での介入を一切必要とせずにレプリケーションが継続しました
- プライベートプレビュー中に報告した不具合は修正され、同じ手順を用いてそれぞれの修正を確認できました
参考文献
- ClickPipes for Postgres (サポートされている同期元のリストを含む、ClickPipes の Postgres CDC ドキュメント)
- WalShadowのご紹介 (ClickHouse ブログ。WalShadow が物理 WAL を読み取り、テーブルごとのブロックを並列に書き込む仕組みについて)
- Sync to ClickHouse with WalShadow (Managed Postgres ドキュメント。WalShadow を選択すべきケースと、プライベートプレビューにおける留意事項)
- Postgres ClickPipe Sync Control (Sync interval と Pull batch size のデフォルト値、いずれかに達した時点での書き込み、および間隔を 10 秒以上に保つ推奨事項について)
- チームから変更前の値は共有されませんでした。変更前の中央値レイテンシは約 1.1 秒でした。開発チームは 200 ms を新たなデフォルト値にする予定だと述べていました。その後、10月上旬にはウィザード上で Flush timeout をユーザー自身で設定できるようになりました (デフォルトは 500 ms。運用イベントに関するセクションを参照)
- walshadow: Limitations (オープンソースのドキュメント。単一のトランザクション内で異なるテーブルに対して行われた変更は、ClickHouse 上で異なるタイミングで可視化される場合があります)
ClickHouse Managed Postgres を今すぐ始める
実際のデータで ClickHouse Managed Postgres の動作を確認してみませんか?ClickHouse Cloud は数分で使い始めることができ、300 ドル分の無料クレジットも利用可能です。
サインアップ