

- el cuerpo de los paquetes
Data,Totals,Extremes,LogyProfileEventsen el protocolo TCP nativo (el paqueteTableColumnsno es un bloque Native: transporta dos cadenas binarias, por lo que su disposición se describe en la especificación del protocolo nativo); - la salida de
SELECT ... FORMAT Nativea través de HTTP; - las exportaciones a archivo generadas con
INTO OUTFILE ... FORMAT Native; - las cargas útiles de replicación entre servidores.
Descripción general
Todo lo que transporta filas en formato wire es un Block: un fragmento autodescriptivo de filas almacenado columna por columna. Primero van todos los valores de la columna 1, luego todos los de la columna 2, y así sucesivamente. Un Block contiene solo las columnas a las que hace referencia la consulta, nunca la tabla completa. Eldata de una columna se organiza según la familia a la que pertenece su tipo. Las familias, en orden creciente de complejidad para el decodificador, son:
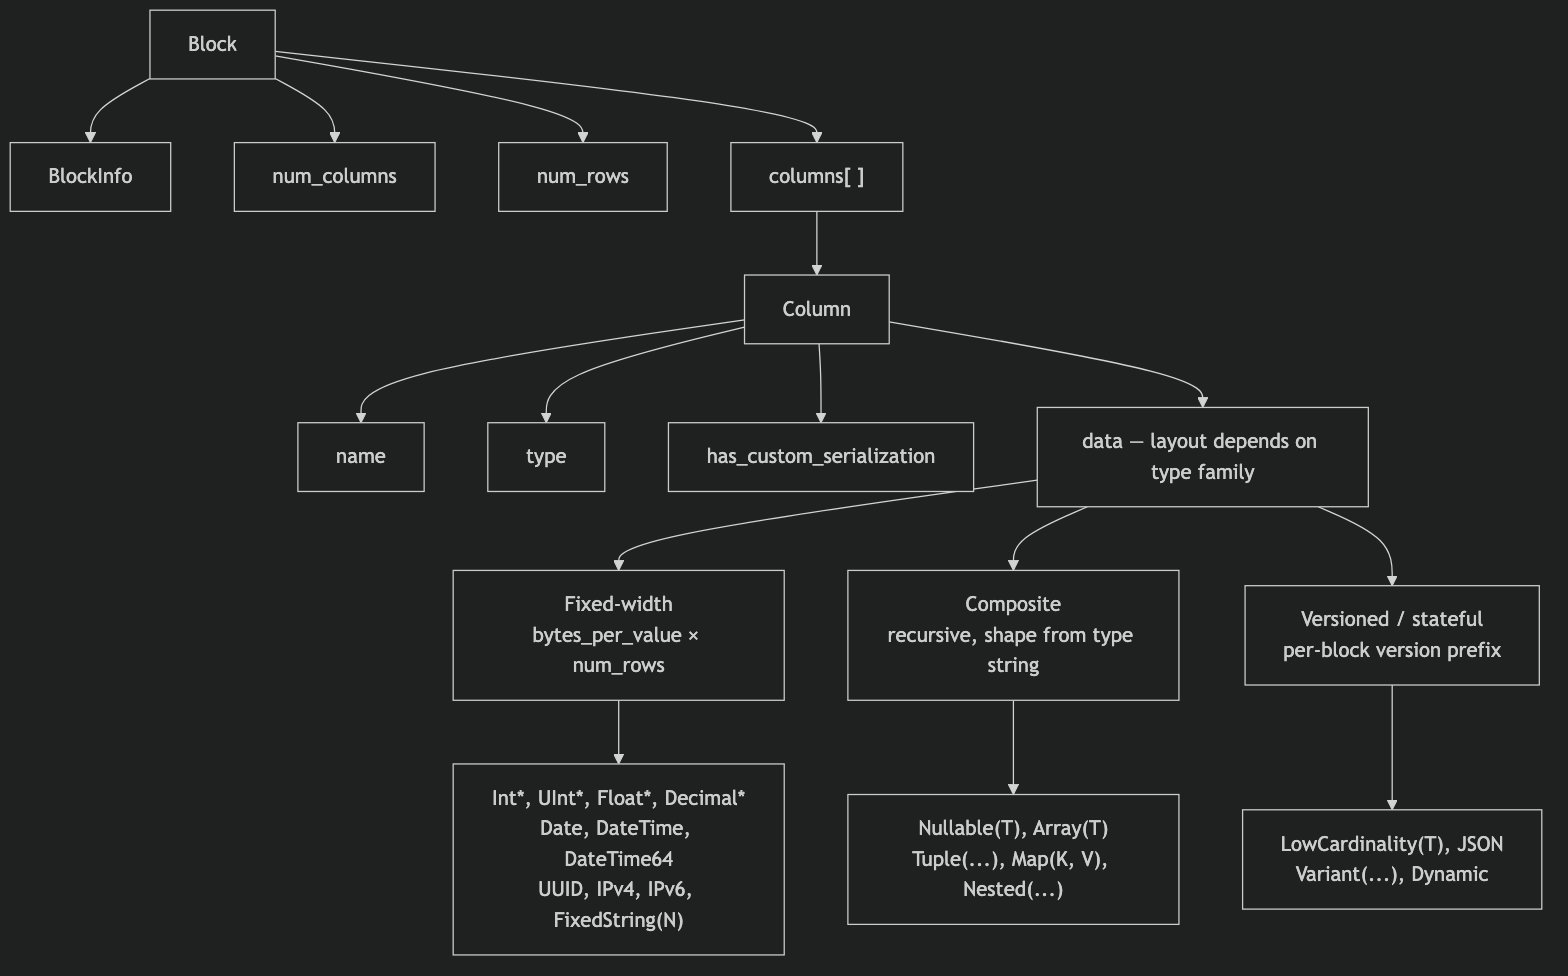
- Los tipos de ancho fijo organizan
datacomobytes_per_value × num_rowsbytes sin procesar, sin delimitación por fila. - Los tipos compuestos (
Nullable,Array,Tuple,Map,Nested) tienen una estructura recursiva que se deriva íntegramente de la cadena de tipo, sin prefijo de versión ni estado entre bloques. - Los tipos versionados / con estado (
LowCardinality,JSON,Variant,Dynamic) comienzan cada bloque no vacío con un prefijo de versión de serialización/estado. En el formato wireNative, este prefijo y cualquier diccionario son por bloque: el formato no conserva estado entre bloques (el escritor crea un estado de serialización nuevo para cada bloque y establecelow_cardinality_max_dictionary_size = 0). El estado entre bloques atañe al almacenamiento en disco de MergeTree, no a la disposición en formato wire de Native.
Primitivas de wire
El formato Native se basa en cuatro codificaciones primitivas.VarUInt
Un entero sin signo de longitud variable que utiliza la codificación LEB-128. Cada byte contiene 7 bits de datos en las posiciones 0–6 y 1 bit de continuación en la posición 7. El bit de continuación vale1 cuando hay más bytes a continuación y 0 en el último byte.
Codificación del valor
300:
0xAC 0x02:
Enteros de ancho fijo
Por ejemplo, el valor UInt32
1 se codifica como 01 00 00 00 y el valor Int32 -1, como FF FF FF FF.
String
Una secuencia de bytes precedida de su longitud:0x00, y las cadenas pueden contener cualquier valor de byte, incluidos caracteres NUL intermedios. La cadena "ab" se codifica como 02 61 62; para decodificarla, lea la longitud VarUInt (2) y, a continuación, lea ese número de bytes.
Bool
Un único byte.0x00 es false; cualquier valor distinto de cero es true (el valor canónico es 0x01).
Estructura de bloques y columnas
Disposición en formato wire del bloque
BlockInfo depende del canal, porque el escritor está parametrizado por una revisión (consulte Revisión del protocolo y el formato Native para ver el tema en detalle, incluido el hecho de que client_protocol_version solo afecta a la salida):
-
En el protocolo TCP nativo, el servidor escribe los bloques con la revisión negociada de la conexión (un valor elevado:
DBMS_TCP_PROTOCOL_VERSION, consultesrc/Core/ProtocolDefines.h).BlockInfose escribe siempre que esa revisión sea mayor que cero, lo que siempre ocurre en una conexión real. El bytehas_custom_serializationde cada columna (consulte disposición en formato wire de columnas) se escribe a partir de la revisión54454. -
El formato de salida
Native(SELECT ... FORMAT Nativesobre HTTP,INTO OUTFILE ... FORMAT Nativey el formatoNativeque generaclickhouse-client) serializa con la revisión0de forma predeterminada. Con la revisión0se omiten tanto el prefijoBlockInfocomo el bytehas_custom_serialization, por lo que un bloque consta únicamente denum_columns,num_rowsy las columnas. Sobre HTTP, esta revisión no es fija: un Client puede elevarla con el parámetro de consulta?client_protocol_version=<n>, y el servidor utiliza ese valor como revisión de serialización de la respuesta. Con un valor suficientemente alto, la salida HTTP incluye el prefijoBlockInfo(que se escribe siempre que la revisión sea mayor que0) y el bytehas_custom_serialization(que se escribe a partir de la revisión54454), exactamente igual que en la ruta TCP. Por lo tanto, los Clients no deben dar por hecho que toda carga útil HTTP deFORMAT Nativecorresponde a la revisión0.
BlockInfo describen la carga útil de un paquete Data de TCP. La misma consulta ejecutada mediante FORMAT Native produce la forma abreviada que se muestra junto a ellos.
BlockInfo
BlockInfo es una secuencia de campos, cada uno precedido por un ID de campo VarUInt, que termina con un ID de campo0. El formato wire no es autodescriptivo: un ID de campo no codifica la longitud ni el tipo de su valor, por lo que un lector debe conocer de antemano el tipo de cada ID de campo que pueda encontrar. El propio lector de ClickHouse trata un ID de campo no reconocido como un dato corrupto y lanza una excepción (UNKNOWN_BLOCK_INFO_FIELD). La compatibilidad hacia adelante se gestiona, en cambio, mediante la revisión del protocolo: el emisor solo escribe un campo si la revisión negociada es igual o superior a la revisión mínima de ese campo, de modo que un receptor más antiguo nunca recibe un campo que no conoce.
Los campos
1 y 2 tienen revisión mínima 0, por lo que están presentes siempre que se escribe un BlockInfo. El campo 3 solo se escribe a partir de la revisión 54480. Disposición en formato wire para el caso habitual (revisión inferior a 54480):
Disposición en formato wire de las columnas
Una Column aparecenum_columns veces dentro de un Bloque.
Un decodificador decide cómo procesar cada columna en función de la cadena
type. Las cadenas de tipo suelen incluir parámetros entre paréntesis; el decodificador elimina el sufijo (...) para obtener el tipo base y, a continuación, analiza los parámetros para determinar el tamaño, la escala o el tipo interno. Para analizar una lista de parámetros con tipos anidados (por ejemplo, un Tuple dentro de un Array), se necesita un divisor por comas que tenga en cuenta la profundidad y controle el anidamiento de paréntesis, en lugar de una simple división por ,.
Codificación binaria de tiposEl campo
type es un String textual solo en el modo predeterminado. Cuando se establece el ajuste de consulta output_format_native_encode_types_in_binary_format = 1, este campo pasa a ser una codificación binaria de tipo (la misma codificación basada en etiquetas que se documenta en codificación binaria de tipos de datos), y las listas aplanadas del tipo Dynamic usan esa misma codificación binaria para los nombres de cada tipo. Un decodificador que siempre lea el campo 2 como una cadena con prefijo de longitud interpretaría la primera etiqueta de tipo binaria como la longitud de una cadena y perdería la sincronización, por lo que debe saber qué modo utiliza el stream.En una consulta con query_kind = SECONDARY_QUERY (enviada por otro servidor para remote, Distributed o réplicas paralelas, o por clickhouse-client --query_kind secondary_query), ambos extremos ignoran output_format_native_encode_types_in_binary_format e input_format_native_decode_types_in_binary_format en los bloques de esa consulta: dichos bloques transportan nombres de tipos en formato textual en ambas direcciones. Los servidores anteriores a esta regla aplican estos ajustes a las consultas secundarias igual que a cualquier otra consulta.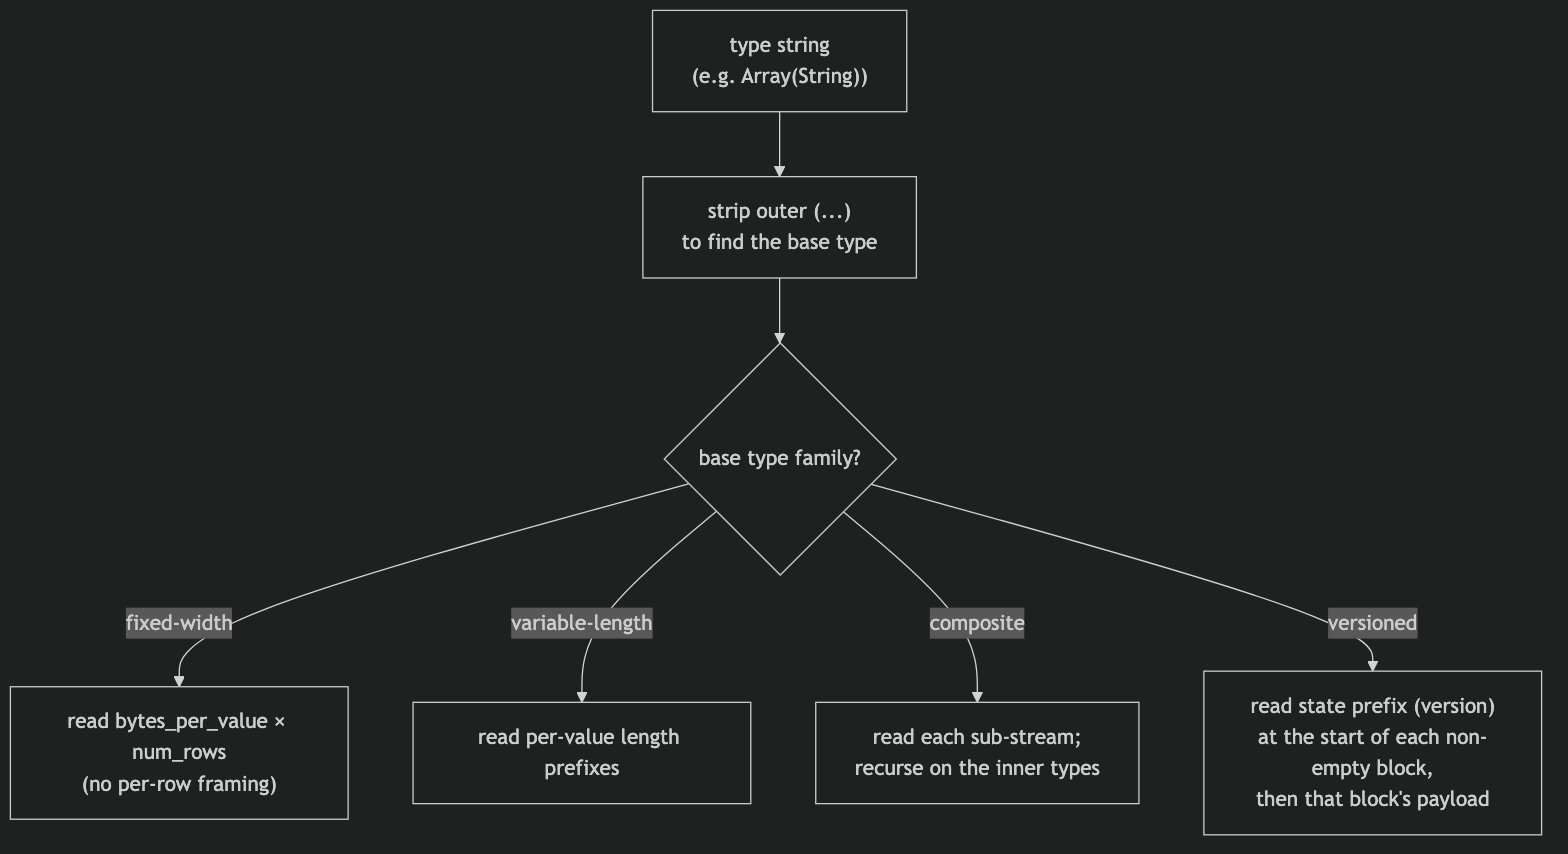
kind_stack y codificación dispersa
El bytekind_stack enumera una serialización por columna no predeterminada:
La carga útil de
COMBINATION usa un enum diferente. Las cinco filas anteriores son códigos compactos de un byte. COMBINATION (0x05) es el mecanismo de escape general para cualquier pila que no cubran: va seguido de un VarUInt count y, a continuación, de count entradas de un byte. Esas entradas no son los códigos compactos de la tabla, sino los valores sin procesar de ISerialization::Kind:
Los valores de byte no coinciden con los códigos compactos:
REPLICATED es 0x03 en este enum anidado, pero 0x04 como código compacto, y no existe ninguna entrada DETACHED_OVER_SPARSE; esa combinación aparece como dos entradas consecutivas, SPARSE y DETACHED. Un decodificador que siga usando la tabla compacta para los bytes anidados asignará mal 0x03/0x04 y perderá la sincronización.
count es la longitud total de la pila, incluida la entrada DEFAULT inicial con la que comienza toda pila. Los códigos compactos ya cubren todas las pilas de una y dos entradas, por lo que un COMBINATION siempre tiene un count de al menos tres.
Validez de la pila de tipos. Un decodificador rechaza una pila mal formada con INCORRECT_DATA en lugar de construir la serialización que describe:
- la pila comienza con
DEFAULT; - la pila es una subsecuencia de
DEFAULT,SPARSE,REPLICATED,DETACHED, que es el orden en que los tipos se envuelven entre sí.SPARSEpuede estar dentro deREPLICATED, pero no al revés, yDETACHEDsiempre va al final porque unColumnBLOBcontiene la forma serializada de todo lo que hay por debajo. Esto también implica que ningún tipo aparece dos veces, por lo quecountno puede superar el número de tipos.
ColumnSparse cuya columna de valores sea a su vez dispersa o replicada permanece envuelto.
kind_stack recursivo para columnas Tuple. La carga útil kind_stack anterior es el byte (o la secuencia COMBINATION) correspondiente a la información de serialización propia de una columna. Un Tuple incluye un SerializationInfoTuple, que primero escribe la carga útil de pila de tipos propia de la tupla y después una carga útil completa de pila de tipos para cada elemento, en orden; un decodificador lee esa misma estructura recursiva. Así, para Tuple(A, B, C) los bytes del campo 4 son [tuple_kind][A_kind][B_kind][C_kind], y la carga útil de cada elemento es a su vez recursiva si dicho elemento también es un tipo compuesto. El byte has_custom_serialization (campo 3) se activa siempre que la información propia de la tupla o la de cualquiera de sus elementos no sea la predeterminada, de modo que un Tuple cuyo único elemento especial sea disperso o replicado también activa la carga útil de pila de tipos. Un decodificador que lea únicamente el byte de enum inicial de un Tuple se detendrá antes de tiempo e interpretará erróneamente los bytes de tipo de los elementos restantes como datos de columna.
Formato wire disperso. Cuando kind_stack = 0x01, el data de la columna consiste en dos streams escritos uno tras otro dentro del único stream TCP compartido:
- Stream de desplazamientos — una secuencia de
VarUInts. Cada valorves uno de los siguientes:vcon el bit alto en la posición 62 sin activar:(v & 0x3FFFFFFFFFFFFFFF)= el número de posiciones con valor predeterminado antes del siguiente valor explícito no predeterminado. Esa posición no predeterminada escursor + group_size, dondecursores la posición actual; a continuación,cursoravanzagroup_size + 1posiciones.vcon el bit 62 activado (END_OF_GRANULE_FLAG): el valor con el indicador desactivado = el número de posiciones finales con valor predeterminado tras el último valor no predeterminado. Esto marca el final del stream de desplazamientos del bloque.
- Stream de valores —
countvalores no predeterminados codificados de forma densa en el tipo interno, dondecountes el número de VarUInts no EOG leídos anteriormente.
num_rows entradas rellenando cada posición no explícita con el valor predeterminado del tipo interno (0 para enteros y números de coma flotante, "" para String, 0 días para Date, etc.).
Una columna Nullable(T) dispersa es un caso especial, ya que el valor predeterminado de Nullable(T) es NULL. La codificación dispersa prescinde por completo del stream habitual del mapa de nulos de Nullable: el stream de desplazamientos identifica las posiciones no predeterminadas —es decir, no NULL—, el stream de valores contiene únicamente esos valores no NULL codificados de forma densa en T, y cada posición no explícita se reconstruye como NULL. Por lo tanto, un decodificador no debe buscar un mapa de nulos en el stream de valores ni rellenar los huecos con un 0 presente, sino con NULL.
Formato wire Replicated. Cuando kind_stack = 0x04, el data de la columna es un diccionario: una lista de valores de elementos distintos junto con un índice por fila que apunta a esa lista (la misma estructura de búsqueda que LowCardinality). Cuando el tipo interno está versionado a su vez —por ejemplo, LowCardinality(T)—, su prefijo de estado se escribe primero, antes del stream de índices: la serialización replicada delega la fase de prefijo en el tipo interno antes de escribir num_rows. Los tipos internos con un prefijo vacío (los tipos hoja y los tipos compuestos simples) no aportan ningún byte en este punto.
elements[indexes[i]] para cada fila de salida i. Los tipos internos compuestos se procesan de forma recursiva: la lista de elementos se materializa en el tipo interno y después se indexa. Entre los tipos internos compatibles se incluyen los tipos hoja, Nullable(T), Array(T), Tuple(...), Map(K, V), Nested(...) (cada campo se expande como un Array) y LowCardinality(T) (se conserva el diccionario compartido; solo se indexan las claves de cada elemento).
Formato wire separado. DETACHED (0x02) y DETACHED_OVER_SPARSE (0x03) sí aparecen en la transmisión por red: no son puramente internos. En la ruta TCP, cuando la compresión está habilitada y la revisión negociada es igual o superior a DBMS_MIN_REVISON_WITH_PARALLEL_BLOCK_MARSHALLING (v54478), la columna pasa por tres pasos:
- Cada columna apta (no
const, noTuple, en un bloque con más de una fila) se envuelve en unColumnBLOBque contiene la columna ya serializada y comprimida fuera del thread principal. - Se añade
DETACHEDal final de la pila de tipos de la columna envuelta. - Los
datade la columna se escriben como un tamaño de blobVarUInt, seguido exactamente de esa cantidad de bytes del blob.
{DEFAULT, SPARSE, DETACHED}, que se serializa como DETACHED_OVER_SPARSE. Un Client que decodifica una columna de este tipo lee la longitud y los bytes del blob y, a continuación, descomprime el blob para recuperar la carga útil de la columna interna (consulte la nota sobre ColumnBLOB en la sección de compresión).
DETACHED es direccional: solo puede aparecer en los bloques de resultados que envía un servidor, y únicamente para una columna de nivel superior completa, nunca como uno de los tipos de elemento de un Tuple. A diferencia de los demás tipos, hace que la columna en tiempo de ejecución sea un ColumnBLOB en lugar de una columna del tipo declarado, por lo que un receptor solo lo acepta si su propia canalización vuelve a convertir el blob. Por eso, un servidor rechaza con INCORRECT_DATA cualquier bloque enviado por un Client que contenga DETACHED, ya sean datos de tablas externas, escalares o datos de inserción.
Variantes de bloque
Todos los paquetes de la familia Data comparten el mismo formato wire de Block. Las variantes solo se diferencian en el recuento de columnas y de filas:Ejemplos a nivel de bytes
Todos los ejemplos de esta sección se han extraído de la ruta del paquete Data de TCP, por lo que incluyen el prefijoBlockInfo y el byte has_custom_serialization. Con FORMAT Native, los mismos bloques son más cortos; cuando resulta útil, se indica la forma abreviada equivalente.
Un bloque vacío (con BlockInfo), 8 bytes en total:
SELECT 1 anuncia una columna llamada "1" de tipo UInt8, sin filas. Con versiones de protocolo ≥ 54454, se incluye el byte has_custom_serialization:
FORMAT Native (revisión 0), el mismo bloque de resultados no incluye BlockInfo ni el byte has_custom_serialization: SELECT 1 FORMAT Native ocupa 11 bytes:
FORMAT Native, ya que el formato de salida no emite bloques vacíos).
Revisión del protocolo y el formato Native
Lo que más determina la estructura de un stream de bytes Native es la revisión del protocolo con la que operan su escritor y su lector. La revisión no figura en ninguna parte de los propios bytes (no existe ningún campo de revisión en el wire), pero aun así decide si varias funcionalidades aparecen o no. Por ello, un decodificador necesita saber con qué revisión se escribió una carga útil antes de poder analizarla. Como la revisión no está en el stream, el lector y el escritor deben acordarla por otra vía. Se trata de un únicoUInt64, y tanto NativeWriter como NativeReader lo reciben como argumento del constructor. El escritor lo llama client_revision y el lector, server_revision, pero es el mismo número. La revisión más reciente que conoce esta versión es DBMS_TCP_PROTOCOL_VERSION (consulte src/Core/ProtocolDefines.h).
Qué controla la revisión
Cada funcionalidad depende de un umbralDBMS_MIN_REVISION_WITH_*. El escritor emite la funcionalidad solo cuando su revisión alcanza el umbral, y el lector la busca siguiendo exactamente la misma regla, de modo que ambos se mantienen sincronizados; si la revisión es incorrecta en cualquiera de los dos lados, se desincronizan. Los controles relevantes para el formato Native son:
Esto convierte a la revisión
0 en la codificación más conservadora para casi todo: el stream no incluye BlockInfo ni el byte has_custom_serialization, usa Dynamic/JSON V1, no incluye versión de función de agregación y emplea un DateTime simple, sin el parámetro de zona horaria. Las versiones del estado de las funciones de agregación son la excepción en la revisión 0: no hay ningún interlocutor del que derivar una versión —el stream lo escribe y lo vuelve a leer quien lo produjo (un archivo de datos StripeLog, una copia de seguridad Set/Join, un archivo en formato Native)—, por lo que el escritor conserva la versión fijada en el tipo (indicándola explícitamente en la cadena de tipo, como de costumbre) en lugar de degradar el estado a la versión 0. Solo los tipos que no fijan ninguna versión se escriben con la versión 0.
LowCardinality es la única excepción, y una importante. La comprobación del escritor es remove_low_cardinality || (client_revision && client_revision < DBMS_MIN_REVISION_WITH_LOW_CARDINALITY_TYPE). La clave está en el client_revision && inicial: cuando la revisión es exactamente 0, la evaluación en cortocircuito hace que toda la condición resulte falsa.
Por tanto, en la revisión 0 —el valor predeterminado para FORMAT Native— LowCardinality(T) no se elimina. Su cadena de tipo y el prefijo de estado por bloque se mantienen en el stream, y el lector de la revisión 0 los vuelve a leer tal cual. La eliminación solo se produce con una revisión distinta de cero inferior a 54405, o cuando se fuerza con independencia de la revisión.
Ese forzado se controla mediante el indicador remove_low_cardinality. La salida de FORMAT Native nunca lo activa, pero la ruta del protocolo TCP nativo sí lo hace cuando low_cardinality_allow_in_native_format = 0 (valor predeterminado: 1). Es decir, esa configuración modifica la salida por TCP nativo, pero no afecta en absoluto a FORMAT Native.
En la práctica: un stream FORMAT Native predeterminado puede contener LowCardinality de forma legítima, así que no dé por hecho que se trata de una funcionalidad ausente en la revisión 0.
De dónde procede la revisión según cómo viajen los datos
Los mismos bytes en formato Native pueden transmitirse por distintas vías: el protocolo TCP nativo, una solicitud HTTP o un archivo en disco. Cada vía establece la revisión a su manera. Conviene tener en cuenta algo: el lado de lectura y el de escritura se configuran por separado, por lo que pueden terminar con revisiones distintas.Protocolo TCP nativo — negociado, en ambas direcciones
En el protocolo TCP nativo, la revisión se obtiene del handshake Hello. El Client envíaDBMS_TCP_PROTOCOL_VERSION, el servidor responde con la suya y, a partir de ese momento, cada lado serializa según la revisión anunciada por el otro lado: el servidor construye su NativeReader/NativeWriter a partir de client_tcp_protocol_version, mientras que el Client usa la server_revision que recibió. No existe un min explícito, pero ningún lado puede emitir una funcionalidad que no haya implementado, por lo que, en la práctica, cada dirección queda limitada por el más antiguo de los dos extremos.
Cuando ambos extremos ejecutan el mismo build moderno, las dos direcciones coinciden en la misma revisión (DBMS_TCP_PROTOCOL_VERSION, consulte src/Core/ProtocolDefines.h) y todas las condiciones están activas. Es el caso habitual, pero no está garantizado. Si los extremos tienen versiones distintas o son de terceros, cada dirección puede estar en una revisión diferente, por lo que las condiciones deben evaluarse por separado en cada dirección: BlockInfo está presente en cualquier revisión distinta de cero, pero el resto —incluido has_custom_serialization— solo aparece cuando la revisión efectiva de esa dirección alcanza los umbrales correspondientes. Por ejemplo, un extremo que anuncia una revisión inferior a 54454 no envía ni recibe el byte has_custom_serialization.
Salida FORMAT Native: revisión 0 de forma predeterminada, ampliable a través de HTTP
El formato de salida Native usa de forma predeterminada la revisión 0. Esto abarca SELECT ... FORMAT Native a través de HTTP, INTO OUTFILE ... FORMAT Native y la salida Native que escribe clickhouse-client; en todos los casos, la fábrica de salida pasa FormatSettings::client_protocol_version directamente al NativeWriter, que determina el entramado de BlockInfo / has_custom_serialization y la disposición de String con desplazamientos. Así, una consulta HTTP SELECT ... FORMAT Native con un client_protocol_version elevado (≥ 54492) escribe la disposición con desplazamientos, mientras que la revisión predeterminada 0 conserva la disposición portable por valor.
A través de HTTP, ese valor predeterminado no es la última palabra. Un Client puede elevarlo con el parámetro de consulta ?client_protocol_version=<n>, que el handler HTTP trata como un parámetro reservado y no como un ajuste SQL: se asigna al contexto de la consulta y la capa de formato lo copia en FormatSettings. Con un valor lo bastante alto, la salida HTTP FORMAT Native empieza a incluir el prefijo BlockInfo y el byte has_custom_serialization, igual que la ruta TCP; por tanto, no dé por hecho que una carga útil HTTP FORMAT Native es siempre de revisión 0.
Como el parámetro se asigna a todo el contexto de la consulta, llega a cada NativeWriter creado para esa solicitud, no solo al stream de resultados. En concreto, una escritura del lado del servidor como INSERT INTO FUNCTION file('x.native', 'Native', ...) SELECT ... a través de HTTP con un ?client_protocol_version= elevado escribe el archivo con esa revisión. Se trata de un comportamiento antiguo (anterior a la serialización de String con desplazamientos y que también afecta a BlockInfo y has_custom_serialization), y además asimétrico: el lado de lectura (véase más abajo) no se eleva de la misma manera, por lo que ese archivo no puede volver a leerse mediante file(...). No incluya client_protocol_version en solicitudes que escriban datos que vayan a leerse de nuevo. INTO OUTFILE y la salida local de clickhouse-client no ofrecen ese ajuste y se mantienen en 0.
Entrada FORMAT Native: siempre revisión 0
El formato de entrada Native siempre construye su NativeReader con la revisión 0. Nunca espera un prefijo BlockInfo, nunca lee el byte has_custom_serialization y siempre asume la serialización predeterminada, tanto si analiza el cuerpo de un INSERT ... FORMAT Native como si lee un archivo Native o infiere un esquema. ?client_protocol_version=<n> no eleva la revisión de entrada (solo el lado de salida lee ese parámetro).
Como la revisión de entrada es siempre 0, el formato de entrada siempre lee la disposición String por valor. Un stream escrito con la disposición de desplazamientos (a través del protocolo TCP nativo o mediante un SELECT ... FORMAT Native con un client_protocol_version elevado) no puede volver a leerse mediante la entrada FORMAT Native: se trata de la misma asimetría que ocurre con el entramado de BlockInfo.
Implicaciones para el ida y vuelta
ParaFORMAT Native, el valor predeterminado es la revisión 0 en ambos extremos. Los datos escritos por SELECT ... FORMAT Native con la revisión 0 se pueden volver a leer directamente con INSERT ... FORMAT Native sin sorpresas.
Un stream generado con una revisión de salida elevada (?client_protocol_version=<n> en el SELECT) incluye el entramado de BlockInfo y has_custom_serialization, así como la disposición de String con desplazamientos, y el formato de entrada (siempre en la revisión 0) no puede leer ninguno de ellos. Por lo tanto, elevar client_protocol_version solo tiene sentido para un consumidor que utilice el protocolo TCP nativo, no para un ida y vuelta de FORMAT Native sobre HTTP.
Los archivos son el caso asimétrico. Un ?client_protocol_version= elevado en un INSERT INTO FUNCTION file(...) del lado del servidor (o s3, url) escribe el archivo con esa revisión, pero una lectura de file(...) siempre analiza con la revisión 0, por lo que ese archivo no admite un ida y vuelta. O bien omita client_protocol_version en la solicitud de escritura para que el archivo quede en la revisión 0 estándar, o bien transfiera los datos mediante el protocolo TCP nativo, donde cada dirección utiliza la revisión negociada en el handshake.
Revisión del protocolo frente a versión de serializaciónNo confunda la revisión del protocolo con la versión de serialización. La revisión de la que hablamos aquí se aplica a toda la conexión o solicitud y nunca aparece en los bytes. La versión de serialización es por columna, la transportan los tipos versionados y se escribe en cada bloque no vacío. La revisión determina si una funcionalidad está presente o no; la versión de serialización, una vez dentro de una columna versionada, determina qué variante de la codificación de ese tipo concreto viene a continuación.
Tipos de datos
Esta sección documenta la codificación wire de los tipos que el formato Native puede transportar dentro deldata de una columna, agrupados en cuatro familias según la complejidad creciente que suponen para el decodificador. Dos tipos, AggregateFunction(func, ...) y QBit(T, N[, stride]), son tipos de columna Native válidos, pero tienen cargas útiles específicas de cada función o tipo que quedan fuera del alcance de este documento; se indican más abajo en los puntos donde podrían confundirse con alias.
Tipos de ancho fijo
Cada valor ocupa un número constante de bytes. Una columna deM filas ocupa exactamente bytes_per_row × M bytes en el wire, concatenados sin separadores ni relleno.
Tipos integer
UInt8–UInt256 e Int8–Int256 son codificaciones binarias directas de valores integer. Un decodificador lee bytes_per_row × num_rows bytes y los interpreta según el tipo.
Una columna UInt32 con los valores [1, 256, 65536]:
Int8 que contiene [-1, 42]:
Float32 y Float64
Números de coma flotante binarios estándar IEEE 754: 4 bytes en precisión simple (binary32) y 8 bytes en doble precisión (binary64), ambos en little-endian. NaN, ±Infinity, ±0.0 y los números subnormales se conservan intactos en el ida y vuelta, sin normalización.
Valor Float32 1.5 (0x3FC00000):
Float64 1.5 (0x3FF8000000000000):
BFloat16
El formato brain-floating-point: los 16 bits superiores de unFloat32 IEEE 754 (1 bit de signo, 8 bits de exponente y 7 bits de mantisa). Cada valor ocupa 2 bytes, en little-endian, y contiene el patrón de 16 bits sin procesar. Para recuperar el valor numérico, amplíelo de nuevo a Float32 colocando el patrón en la mitad superior y poniendo a cero la mitad inferior (bits << 16 reinterpretado como Float32); a partir de ahí, el valor ampliado usa el mismo formato de texto que Float32.
Valor BFloat16 1.5 (patrón 0x3FC0, la mitad superior del Float32 0x3FC00000):
Bool
Compatible a nivel de wire conUInt8: 1 byte por fila, 0x00 = false, 0x01 = true. En el wire, la cadena de tipo es literalmente Bool (no UInt8), por lo que un decodificador que seleccione la ruta de decodificación según la cadena de tipo debe reconocerla por separado.
Una columna Bool [true, false, true]:
Date y Date32
Ambos codifican las fechas como un recuento integer de días respecto a la época Unix1970-01-01. Ninguno de los dos incluye un componente de hora.
Valor
Date 1970-01-02 (1 día):
Date32 1900-01-01 (-25567 días):
DateTime
Compatible a nivel de wire conUInt32: una marca de tiempo Unix en segundos, de 4 bytes en little-endian. El tipo puede aparecer como DateTime o DateTime('Timezone'); la zona horaria solo afecta a la visualización y no forma parte del valor en el wire. Dos columnas DateTime con distintos parámetros de zona horaria generan bytes idénticos para un mismo instante. Un decodificador elimina el sufijo de parámetro (...) y procesa la columna como UInt32.
Valor 2024-03-15 14:30:00 UTC de tipo DateTime('UTC') (marca de tiempo 1710513000):
DateTime64(scale[, timezone])
8 bytes: un Int64 en formato little-endian que representa ticks a escala de10^-scale segundos desde la época Unix. El parámetro scale (0–9) forma parte de la cadena de tipo y define la unidad de tiempo:
El tipo aparece como
DateTime64(s) (zona horaria predeterminada del servidor, implícita) o como DateTime64(s, 'TimezoneName') (zona horaria explícita, solo a efectos de visualización). Los valores negativos representan ticks anteriores a la época.
Valor DateTime64(3, 'UTC') correspondiente a 2024-01-15 12:30:45.123 UTC (1705321845123 ms):
DateTime64(0) 2024-01-15 12:30:45 UTC (1705321845 s):
Time y Time64(scale)
Una duración de reloj, no un momento dado.Time es un recuento de segundos con signo, almacenado en 4 bytes como Int32 little-endian; Time64(scale) es un recuento de ticks con signo en la escala decimal indicada (0–9), almacenado en 8 bytes como Int64 little-endian, es decir, la misma forma en wire que DateTime64.
La forma textual es [-]HH:MM:SS[.fraction], pero, a diferencia de DateTime, el campo de la hora no se reinicia al completar un día de 24 horas: representa el número total de horas y puede ser mayor que 23. La magnitud mostrada tiene un tope de 999:59:59 (3599999 segundos); una magnitud mayor se representa con los segundos en el tope y conserva tal cual la fracción almacenada, de modo que un recuento de ticks de 3700000.25 se representa como 999:59:59.250000. CAST satura el valor almacenado al mayor tick representable en la escala de destino (999:59:59.999999 para Time64(6)), y no al segundo entero, mientras que las operaciones aritméticas aún pueden dejar en la columna un recuento de ticks fuera de rango que solo se limita al mostrarse. Nada de esto afecta a los bytes en wire, que son simplemente el integer con signo.
Valor Time 45296 (12:34:56):
Time64(3) de 45296789 ticks (12:34:56.789):
Time y Time64 son experimentales y requieren allow_experimental_time_time64_type = 1 en el servidor.Interval
Interval<Unit> — IntervalSecond, IntervalMinute, IntervalHour, IntervalDay, IntervalWeek, IntervalMonth, IntervalQuarter, IntervalYear, IntervalNanosecond, etc. Todas las unidades comparten la misma codificación wire: el recuento como un Int64 con signo de 8 bytes en little-endian. La unidad figura únicamente en la cadena de tipo: no altera ni los bytes wire ni la forma textual, que es simplemente el integer. Una única ruta de decodificación sirve para todas las unidades.
Valor 5 de IntervalDay:
UUID
16 bytes por valor. La codificación wire no corresponde a los 16 bytes canónicos en big-endian: el orden de los bytes de cada mitad de 8 bytes se invierte de forma independiente. El modelo lógico es un identificador de 128 bits en su forma de texto canónicaxxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx, en la que, por convención, los bytes se escriben en big-endian. El modelo wire toma esos 16 bytes canónicos, los divide en dos mitades de 8 bytes y escribe cada mitad en little-endian:
- Bytes wire 0..7 = bytes canónicos 0..7 en orden inverso.
- Bytes wire 8..15 = bytes canónicos 8..15 en orden inverso.
550e8400-e29b-41d4-a716-446655440000:
IPv4 e IPv6
Dos tipos de dirección relacionados, pero con codificaciones distintas.IPv4 ocupa 4 bytes y se codifica como un UInt32 little-endian que contiene la dirección canónica de 32 bits (el valor (a << 24) | (b << 16) | (c << 8) | d obtenido de a.b.c.d). Los bytes en el wire son los bytes en orden de red, pero en orden inverso.
192.168.1.10 (valor canónico de 32 bits 0xC0A8010A):
IPv6 ocupa 16 bytes y se escribe tal cual, en orden de bytes de red, sin intercambio de bytes: el mismo orden de bytes que inet_pton(AF_INET6, ...).
2001:db8::1:
u32 para permitir operaciones aritméticas y consultas de rango compactas, mientras que IPv6 mantiene la disposición en orden de red habitual en la mayoría de las API de red.
Enum8 y Enum16
Compatibles a nivel de wire conInt8 e Int16, respectivamente: 1 o 2 bytes por fila, en complemento a dos little-endian para la variante de 16 bits. La correspondencia completa de valores se encuentra en la cadena de tipo:
(...) y despacharlo como Int8 / Int16: los wire bytes son simplemente el índice integer. Un client que expone la etiqueta analiza el mapa 'name' = value a partir de la cadena de tipo y lo conserva junto con la columna, ya que el integer por sí solo no permite recuperar la etiqueta. La salida orientada a texto muestra la etiqueta (active) en lugar del índice, entre comillas simples ('active') cuando el enum está anidado dentro de un tipo compuesto. Como el mapa no puede recuperarse a partir de la columna de integers, debe conservarse en el caso de enums anidados como Array(Enum8(...)) o Map(Enum16(...), V).
Una columna Enum8('active' = 1, 'inactive' = 2) con los valores [active, inactive, active]:
Enum16(...) igual a 30000:
Decimal(P, S)
Un integer con signo escalado por una potencia de 10. El ancho en bytes del integer viene determinado por la precisiónP; la escala S es el exponente negativo (el número de dígitos después del punto decimal). Ambos parámetros se indican en la cadena de tipo.
La codificación wire es el integer subyacente en complemento a dos little-endian, y el valor decimal lógico es
wire_integer × 10^(-S).
ClickHouse siempre emite Decimal(P, S), independientemente de cómo se haya declarado el tipo. Decimal32(S), Decimal64(S), etc., se normalizan todos a Decimal(P, S) en el wire (con P fijado en el máximo natural para cada ancho: 9, 18, 38, 76). Un decodificador que solo reconozca Decimal(P, S) cubre todas las variantes que emite el servidor.
El valor 123.4567 de tipo Decimal(9, 4) → integer subyacente 1234567:
-1.5 de tipo Decimal(18, 1) → integer subyacente -15:
Decimal(38, 4) 123.4567 (16 bytes en total):
Nothing
El tipoNothing no contiene valores. En la práctica, solo aparece como tipo interno de Nullable(Nothing), que es lo que el servidor devuelve para una expresión como SELECT NULL, cuyo único valor válido es precisamente la ausencia de valor. Conceptualmente, se trata de un tipo unitario.
En el wire ocupa exactamente un byte de relleno por fila. El servidor emite el carácter ASCII '0' (0x30), pero el deserializador ignora estos bytes: su contenido no está definido y los decodificadores no deben depender de ningún valor concreto. El número de bytes escritos es num_rows × 1, por lo que el num_rows del encabezado de la columna determina por completo cuántos bytes hay que consumir.
Este byte por fila preserva el invariante del bloque: cada columna ocupa una longitud que puede derivarse de num_rows, de modo que los decodificadores avanzan secuencialmente sin necesidad de prefijos de longitud por celda. El Nullable que lo envuelve siempre marca todas las posiciones como NULL, por lo que los bytes de relleno nunca llegan a inspeccionarse.
Una columna Nullable(Nothing) con 3 filas (todas NULL):
Nullable (consulte Nullable); los tres bytes internos corresponden a la carga útil de Nothing, que el decodificador omite.
Tipos de longitud variable
Cada valor incluye su propia longitud en la representación wire.String
Cadena de tipo:String. Una columna String tiene dos disposiciones en formato wire, que se seleccionan según la revisión del protocolo (consulte Qué controla la revisión). La revisión es la negociada en el protocolo TCP nativo y, en el caso de la salida FORMAT Native, la indicada por client_protocol_version (valor predeterminado 0); la entrada FORMAT Native siempre usa la revisión 0, y el formato Buffers siempre utiliza la disposición por valor.
Disposición por valor — por debajo de DBMS_MIN_REVISION_WITH_STRING_WITH_SIZE_STREAM_SERIALIZATION (54492), lo que incluye la revisión 0 predeterminada de FORMAT Native: una secuencia de num_rows secuencias de bytes, cada una precedida por su longitud:
0x00. El número total de bytes que ocupa la columna es Σ (varuint_size(len_i) + len_i) para todas las filas.
Una columna de 3 cadenas ["ab", "", "c"] (6 bytes en total):
54492, dos flujos concatenados; primero, los desplazamientos acumulados en bytes y, a continuación, todos los datos:
Array envía sus desplazamientos a través del protocolo nativo. El desplazamiento i es la posición final del valor i en el blob de datos, por lo que el tamaño del valor i es offset[i] - offset[i-1] (con offset[-1] = 0) y el último desplazamiento es el tamaño total del blob de datos. Un decodificador lee 8 × num_rows bytes de desplazamientos y, a continuación, lee todo el blob de datos de una sola vez, usando el último desplazamiento como su longitud exacta. Esto permite preasignar el búfer con exactitud y realizar copias masivas en lugar de analizar fila por fila, sin necesidad de convertir tamaños en desplazamientos. Una columna con num_rows = 0 no aporta ningún byte en ninguno de los dos flujos.
Las mismas 3 cadenas ["ab", "", "c"] (27 bytes en total):
String del bloque, incluidos los String anidados dentro de tipos compuestos (Array(String), Nullable(String), Map, Tuple, Variant, Dynamic, JSON), con una excepción: el diccionario de una columna LowCardinality siempre se escribe con la serialización anidada predeterminada, por lo que sus valores String mantienen la disposición por valor en todas las revisiones. Esto incluye LowCardinality(String), LowCardinality(Nullable(String)) y cualquier otro diccionario LowCardinality que contenga valores String.
En ambas disposiciones, el tipo String de ClickHouse está orientado a bytes, no a texto: no se exige que los valores sean UTF-8 válidos, y un valor puede contener cualquier byte, incluidos caracteres NUL incrustados. Un decodificador que asigne los datos a un tipo de cadena UTF-8 debe validarlos durante la lectura o bien exponer los bytes sin procesar al llamador.
FixedString(N)
Cadena de tipo:FixedString(N), donde N es un integer positivo (por ejemplo, FixedString(16)). La columna ocupa exactamente N × num_rows bytes sin procesar, sin prefijos de longitud ni separadores. Un decodificador analiza N a partir de la cadena de tipo y consume esa cantidad de bytes por fila.
Cuando la sentencia SQL inserta un valor de menos de N bytes (por ejemplo, CAST('abc' AS FixedString(5))), el servidor lo rellena por la derecha con bytes NUL (0x00) hasta alcanzar la longitud declarada. Estos bytes de relleno forman parte del valor almacenado y se transmiten por el wire tal cual; eliminarlos es responsabilidad del client. Al igual que String, FixedString(N) se comporta más como un array de bytes que como texto; suele usarse para identificadores de ancho fijo, bytes de direcciones o digests de hash.
Dos valores FixedString(3) ["abc", "de\0"] (6 bytes en total):
Tipos compuestos
Los tipos compuestos envuelven uno o más tipos internos y comparten un modelo wire común: múltiples flujos por columna. Una única columna lógica se codifica como dos o más secuencias de bytes concatenadas que se leen de forma independiente. Comparten tres propiedades estructurales:- Forma fija según el esquema. La estructura queda determinada por completo por la cadena de tipo en el momento de la decodificación.
Array(UInt32)siempre tiene la misma disposición de flujos, de un bloque a otro. - Sin prefijo de versión propio. El envoltorio compuesto en sí no añade ningún byte de versión; su estructura de tramas (desplazamientos, mapa de nulos, flujos de elementos) se mantiene estable entre versiones de ClickHouse. Esto se aplica únicamente al envoltorio; para los tipos internos versionados, consulte más abajo la nota sobre la fase de prefijo.
- Sin estado propio entre bloques. La estructura de tramas del envoltorio es totalmente autodescriptiva en cada bloque; cualquier cuestión relativa al estado entre bloques proviene de un tipo interno versionado, no del envoltorio.
SerializationArray ejecuta la fase de prefijo de su tipo interno antes de escribir los desplazamientos del array, y Tuple, Map, Nested y Nullable hacen lo mismo a través de las serializaciones de sus elementos (Nullable ejecuta el prefijo interno antes de su mapa de nulos).
Por lo tanto, cuando un tipo compuesto envuelve un tipo versionado/con estado (LowCardinality, Variant, Dynamic, JSON), el prefijo de versión/estado de ese tipo interno se emite primero, antes de los desplazamientos y de la carga útil de elementos del envoltorio. Por ejemplo, Array(LowCardinality(String)) se dispone como [LowCardinality state prefix] → [array offsets] → [flattened LowCardinality element payload], y no con los desplazamientos en primer lugar.
Un decodificador que lea los desplazamientos antes de ejecutar la fase de prefijo interna perderá la sincronización con cualquier tipo compuesto que contenga LowCardinality, Variant, Dynamic o JSON. Cuando todos los tipos internos son hojas simples u otros tipos compuestos no versionados, la fase de prefijo no emite ningún byte y la descripción que aparece a continuación, con los desplazamientos en primer lugar, se aplica tal cual.
Nullable(T)
Cadena de tipo:Nullable(InnerType). Ejemplos: Nullable(UInt32), Nullable(String), Nullable(FixedString(16)), Nullable(DateTime('UTC')).
Al igual que los demás tipos compuestos, Nullable delega la fase de prefijo en su serialización interna antes de escribir el mapa de nulos: cuando el tipo interno es versionado, su prefijo de estado se emite primero. Por tanto, Nullable(Tuple(LowCardinality(String))) comienza con el prefijo de estado de LowCardinality, no con el mapa de nulos. Cuando el tipo interno es un tipo hoja u otro tipo no versionado, la fase de prefijo no emite ningún byte.
La disposición en formato wire consta de la fase de prefijo interna (vacía, salvo que el tipo interno sea versionado), seguida de dos flujos concatenados, empezando por el mapa de nulos:
num_rows bytes, uno por fila:
El flujo de valores contiene la codificación estándar del tipo interno para todas las
num_rows filas, incluidas las posiciones nulas. Un decodificador debe leer igualmente los bytes de relleno de las posiciones nulas para avanzar en el flujo, pero debe consultar el mapa de nulos antes de interpretar cualquier valor individual. Los emisores pueden escribir cualquier byte en las posiciones nulas, por lo que los decodificadores no deben depender de un valor de relleno concreto.
Valores de relleno según la familia del tipo interno:
Nullable(T) puede aparecer dentro de Array, Tuple, Map y Nested; Array(Nullable(T)) y Tuple(Nullable(T1), T2) son habituales. La nulabilidad no puede anidarse en sí misma: el servidor rechaza Nullable(Nullable(T)).
Un Nullable(UInt8) con tres filas [5, NULL, 9] (6 bytes en total):
Nullable(String) con tres filas ["hello", NULL, "world"] (15 bytes en total):
Array(T)
Cadena de tipo:Array(InnerType). Ejemplos: Array(UInt32), Array(String), Array(Nullable(UInt32)), Array(Array(UInt8)).
La disposición en formato wire consta de la fase de prefijo del tipo interno (vacía salvo que el tipo interno esté versionado), seguida de dos flujos concatenados, empezando por los desplazamientos:
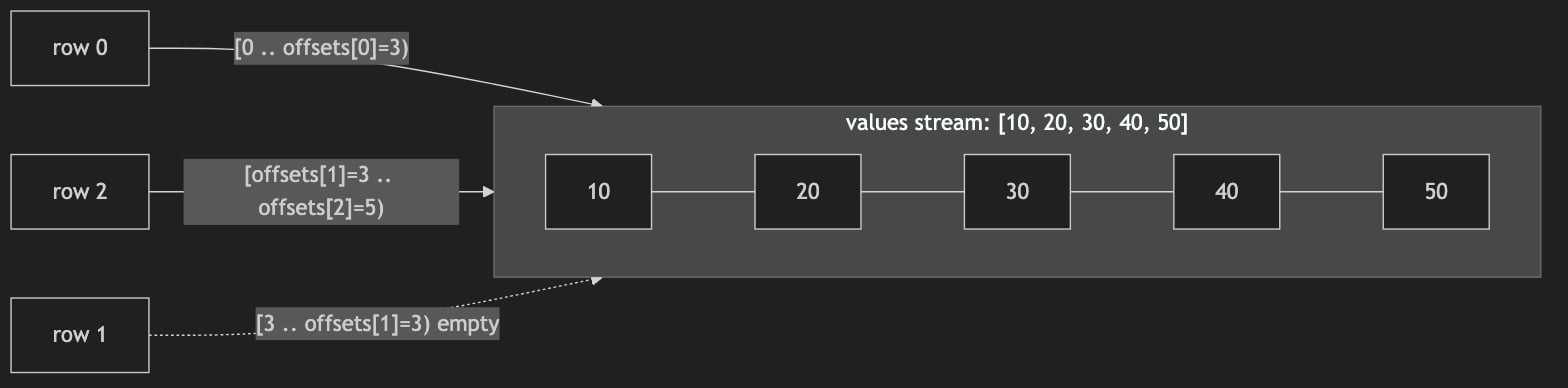
num_rows valores UInt64 en formato little-endian, cada uno de los cuales indica la posición final acumulada en el flujo de valores (values stream) tras los elementos de esa fila:
- Índice inicial de los elementos de la fila
N=offsets[N - 1](o0cuandoN == 0). - Índice final de los elementos (exclusivo) de la fila
N=offsets[N]. - Número de elementos de la fila
N=offsets[N] - offsets[N - 1].
offsets[num_rows - 1] es el número total de elementos de todas las filas, y el flujo de valores contiene esa misma cantidad de valores internos concatenados uno tras otro.
Los desplazamientos son monótonamente no decrecientes: dos desplazamientos consecutivos iguales indican una fila vacía, y un decodificador debe rechazar los desplazamientos no monótonos por considerarlos datos corruptos. Una columna vacía (num_rows == 0) escribe cero bytes, es decir, no hay flujo de desplazamientos ni flujo de valores. Los tipos internos pueden ser de cualquier tipo, incluidos otros tipos compuestos: Array(Array(T)), Array(Tuple(...)) y Array(Nullable(T)) son todos válidos.
Array(UInt32) con las filas [[10, 20, 30], [], [40, 50]] (44 bytes en total):
0 para la fila 0). Dos desplazamientos consecutivos iguales indican una fila vacía:
Array(String) con las filas [["a", "bb"], []] (20 bytes en total):
Array(Array(UInt32)) con las filas [[[1,2]], [], [[3], [4,5]]] anida la misma estructura:
- Desplazamientos externos:
[1, 1, 3]: la fila 0 tiene 1 array interno, la fila 1 tiene 0 y la fila 2 tiene 2. - El
Array(UInt32)intermedio decodifica 3 filas con desplazamientos[2, 3, 5]. - El
UInt32más interno decodifica 5 valores:[1, 2, 3, 4, 5].
Tuple(T1, T2, …)
Cadena de tipo:Tuple(T1, T2, ..., Tn). Ejemplos: Tuple(UInt32, String), Tuple(Int32), Tuple(Array(UInt32), String), Tuple(UInt8, Tuple(Int32, String)). ClickHouse también admite tuplas con nombre mediante Tuple(a UInt32, b String); los nombres son solo metadata y no afectan al formato wire.
La disposición en formato wire consta de la fase de prefijo de los elementos (cada elemento versionado aporta su prefijo de estado, en orden de declaración; los elementos no versionados no aportan nada), seguida de N flujos concatenados, uno por cada tipo de elemento, en orden de declaración:
num_rows valores. No hay prefijo de longitud, ni flujo de desplazamientos, ni separadores entre flujos. Una columna vacía (num_rows == 0) escribe cero bytes por flujo. Los tipos de los elementos pueden ser cualquiera, incluidos otros tipos compuestos: Tuple(Tuple(...), ...), Tuple(Array(...), ...) y Tuple(Nullable(T1), T2) son todos válidos.
La tupla sin elementos Tuple() también es válida; se genera a partir de expresiones como SELECT tuple() o CAST(x AS Tuple()). Como no tiene flujos de elementos, se serializa como Nothing: un byte de relleno (0x30, ASCII '0') por fila, que el deserializador descarta. El número de filas se obtiene del encabezado del bloque, exactamente igual que con Nothing.
Tuple(UInt8, UInt8) con 3 filas (1,4), (2,5), (3,6):
[1, 2, 3] para el elemento 0 y [4, 5, 6] para el elemento 1.
Tuple(UInt32, String) con 2 filas (10, "a"), (20, "bb") (13 bytes en total):
Map(K, V)
Cadena de tipo:Map(KeyType, ValueType). Ejemplos: Map(String, UInt32), Map(String, Array(UInt32)), Map(UInt8, Tuple(Int32, String)), Map(Array(String), Int8). El formato wire no impone ninguna restricción a ninguno de los dos tipos: tanto K como V pueden ser cualquier tipo compatible, incluidos los tipos compuestos. (Las reglas de ClickHouse a nivel de SQL sobre los tipos de clave admitidos han variado de una versión a otra; consulte la documentación de SQL correspondiente a la versión del servidor de destino).
La disposición en formato wire es idéntica byte a byte a la de Array(Tuple(K, V)), por lo que comienza con la fase de prefijo interna (vacía, salvo que K o V sean versionados):
total_pairs = offsets[num_rows - 1] (o 0 cuando num_rows == 0). El flujo de desplazamientos tiene la misma semántica que en Array. Las claves están alineadas posicionalmente con los valores: el par i es (keys[i], values[i]).
En memoria, ClickHouse representa una columna Map como un array de tuplas; el sistema de tipos la expone como un tipo independiente para facilitar su uso en SQL (m['key'], mapKeys, mapValues). El formato wire es una serialización directa de ese almacenamiento, por lo que Map y Array(Tuple(K, V)) son intercambiables byte a byte.
Los desplazamientos son monótonos no decrecientes, y tanto el flujo de claves como el de valores contienen exactamente total_pairs valores. Una columna vacía no escribe ningún byte. Dentro de una misma fila, las claves suelen ser únicas, pero se trata de una regla semántica, no de una restricción impuesta por el formato wire: este permite que las claves duplicadas se escriban y se vuelvan a leer sin alteraciones, y la semántica del lado del servidor resuelve los duplicados solo cuando una función compatible con Map procesa la fila.
Map(UInt8, UInt8) con 2 filas {1:10, 2:20}, {3:30} (22 bytes en total):
i se reconstruye leyendo keys[i] y values[i] a la vez.
Map(String, UInt32) con 1 fila {'a':1, 'b':2} (20 bytes en total):
Nested(name1 T1, name2 T2, …)
La representación en el wire deNested depende de la configuración flatten_nested del lado del servidor, lo que da lugar a dos casos distintos.
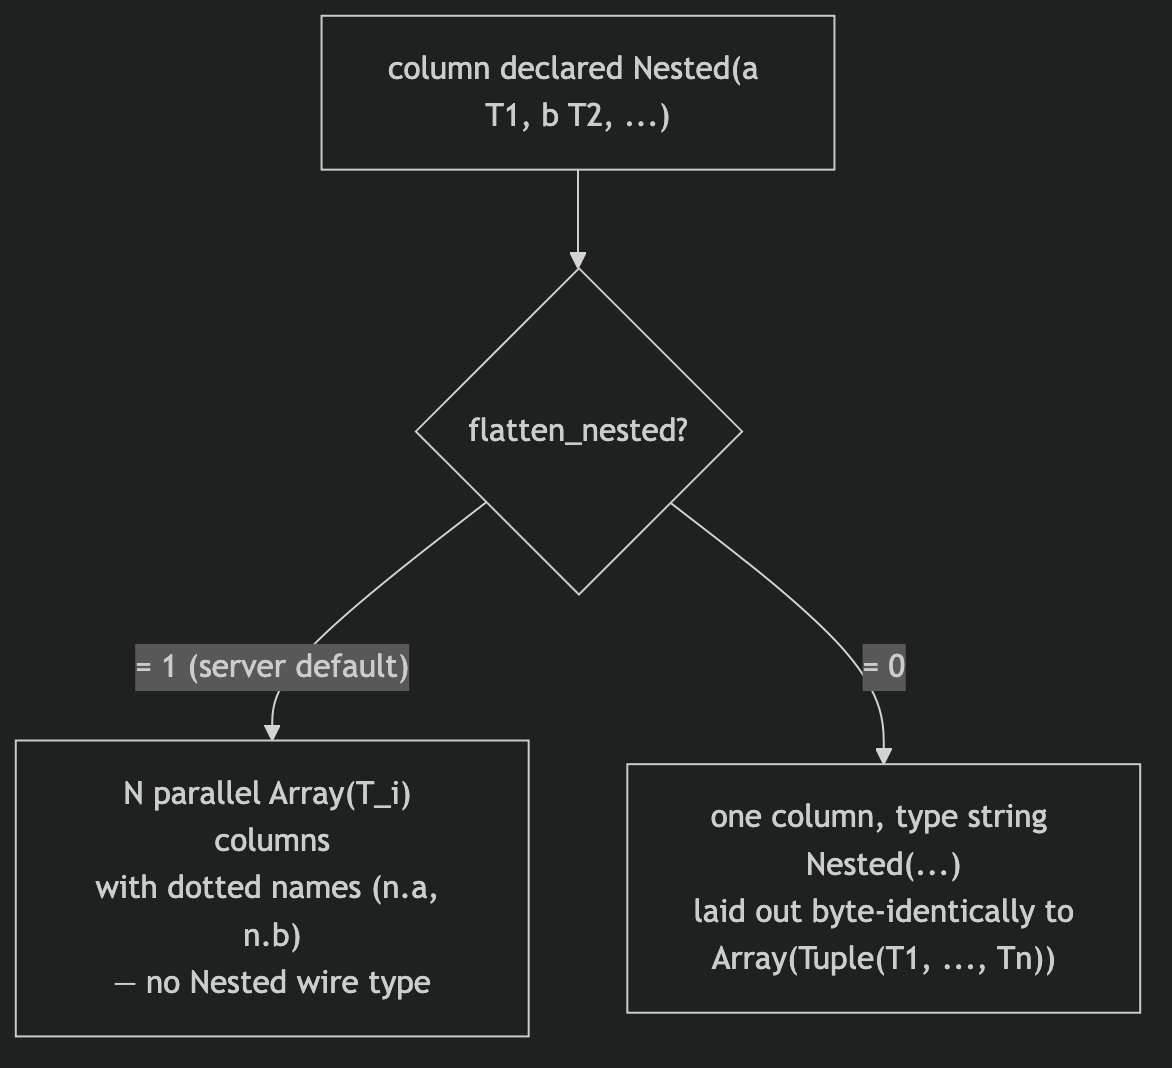
flatten_nested = 1 (valor predeterminado del servidor). Si la tabla se creó con la configuración predeterminada, Nested no es un tipo wire. El servidor almacena y expone la columna como N columnas Array(T_i) paralelas con nombres separados por puntos (outer.field1, outer.field2, etc.). Para la capa de formato no hay nada nuevo: cada una de estas columnas es un Array normal:
flatten_nested = 0. Si la tabla se creó con flatten_nested = 0, la columna aparece en el wire como una única columna con la cadena de tipo Nested(name1 T1, name2 T2, ...), y su disposición tras la cadena de tipo es idéntica byte a byte a Array(Tuple(T1, T2, ..., Tn)), incluida la fase de prefijo interna, de modo que cualquier campo versionado T_i emite primero su prefijo de estado, antes de los desplazamientos. El siguiente ejemplo utiliza campos no versionados, por lo que la fase de prefijo está vacía:
Nested conserva los nombres de los campos (a, b), mientras que Array(Tuple) no los incluye como posiciones con nombre.
La cadena de tipo del caso B es una lista de pares (nombre, tipo) separados por comas. El primer espacio en blanco separa el nombre de su tipo; el tipo en sí puede contener más espacios en blanco, comas y paréntesis, por lo que, para analizarla, se necesita el mismo divisor sensible a la profundidad que se utiliza para Tuple. La disposición en formato wire:
total_elements = offsets[num_rows - 1] (o 0 cuando num_rows == 0). Los desplazamientos son monótonos no decrecientes, y cada flujo de campo contiene exactamente total_elements valores. En el momento del INSERT, el servidor exige que, dentro de una misma fila, todos los campos tengan el mismo número de elementos. Una columna vacía no escribe ningún byte.
Nested(a UInt8, b String) con 2 filas, [(10,'x'),(20,'y')] y [(30,'z')] (25 bytes después de la cadena de tipo):
Alias de tipos
Varios tipos son simples alias: el servidor envía el nombre del alias en el encabezado de la columna, pero los bytes que siguen corresponden a un tipo subyacente. Un decodificador asigna el alias a ese tipo y reutiliza su códec; no interviene ningún formato wire nuevo. Los tipos geográficos son alias de arrays y tuplas anidados:
Así, una columna
Point se decodifica exactamente como Tuple(Float64, Float64) (y se representa como (1,2)), una Ring como Array(Tuple(Float64, Float64)) ([(0,0),(1,1)]), y así sucesivamente a lo largo de la jerarquía.
Geometry también es un alias, pero de un Variant en lugar de un array anidado: su carga útil es la variante de los siete tipos geográficos anteriores. El encabezado de la columna contiene únicamente la cadena de tipo Geometry —no desglosa la variante—, por lo que el decodificador debe expandirla por su cuenta. A diferencia de un Variant definido por el usuario, los discriminadores de Geometry no siguen el orden alfabético por nombre: son fijos por motivos de compatibilidad, y los nuevos tipos geográficos siempre se añaden al final. La correspondencia es 0 = LineString, 1 = MultiLineString, 2 = MultiPolygon, 3 = Point, 4 = Polygon, 5 = Ring, 6 = MultiPoint (añadido en 26.7; los flujos procedentes de servidores más antiguos simplemente nunca contienen el discriminador 6). A continuación, cada valor seleccionado se decodifica mediante su alias geográfico correspondiente de la tabla anterior (NULL usa el discriminador NULL de Variant, 255).
SimpleAggregateFunction(func, T) es un alias de su tipo de valor T. Almacena un valor de agregación ya finalizado, por lo que su forma wire y su representación son exactamente las de T (SimpleAggregateFunction(sum, UInt64) se decodifica como UInt64). Solo la forma con un único tipo de valor funciona como alias de este modo; el tipo subyacente puede ser, a su vez, un tipo compuesto.
Dos tipos relacionados no son alias. Son tipos de columna
Native válidos —por ejemplo, un cliente puede recibir una columna AggregateFunction procedente de un combinador -State o de una agregación distribuida—, pero cada uno lleva su propia carga útil especializada, que queda fuera del alcance de esta página:AggregateFunction(func, ...)contiene un estado de agregación intermedio (no un valor final); su disposición binaria depende de la función de agregación y de su versión. El nombre de la función puede incluir parámetros, cada uno impreso como un literal SQL, como enAggregateFunction(topK(3), UInt64). Algunas funciones de agregación imprimen un sufijo explícito::Typeen un parámetro, como enAggregateFunction(topK('3'::Decimal32(0)), UInt64), porque un valorDecimalo de entero ancho no tiene una forma literal simple que imprimir; que una función lo haga depende de esa función y no del formato, por lo que un decodificador que inspeccione los parámetros debe aceptar ambas grafías. Un decodificador que solo necesite los tipos de los argumentos no se ve afectado. Una función de agregación versionada escribe explícitamente una versión de estado distinta de cero como primer argumento de la cadena de tipo —AggregateFunction(1, quantileDeterministic, UInt64, UInt64)—, mientras que la versión0no se imprime, de modo que la cadena de tipo sigue siendoAggregateFunction(quantileDeterministic, UInt64, UInt64). En una conexión negociada (revisión superior a0), el emisor elige la versión únicamente en función de la revisión del protocolo —nunca de una versión que esté fijada en su tipo local, porque en el wire la versión0no se distingue de «ninguna versión anunciada»—, por lo que la misma función puede anunciar versiones distintas en conexiones distintas, y un lector debe tomar la versión de la cadena de tipo en lugar de dar por hecho que es la más reciente. En la revisión0no hay ningún par para el que derivar una versión —el stream es autodescriptivo y lo vuelve a leer quien lo escribió—, por lo que una versión fijada en el tipo se conserva en el stream (y en la cadena de tipo anunciada) en lugar de rebajarse a0.quantileDeterministic(junto con las grafíasquantilesDeterministicymedianDeterministic) está versionada a partir de la revisión54491: la versión1añade al final del estado unUInt8 skip_degree, y su prefijo es idéntico byte a byte al de la versión0. Por debajo de esa revisión, el emisor genera estados de versión0, por lo que un par más antiguo no se ve afectado.uniqestá versionada a partir de la revisión54493: la versión1antepone un byte de indicadores a la disposición de la versión0y, cuando el bit0de los indicadores está activado, añade al final una pequeña muestra adicional de hashes completos de 64 bits, cada uno combinado mediante XOR con la constante0x9E3779B97F4A0000(UInt8 skip_degree,VarUInt county, a continuación, los valores de 8 bytes), lo que mantiene la precisión de la estimación con cardinalidades superiores a dos mil millones; un estado de versión0solo incluye la muestra principal de 32 bits. El bit1de los indicadores señala que la muestra de 64 bits está incompleta —el estado ha absorbido un estado de versión0, cuyos elementos nunca se ofrecieron a una muestra de 64 bits—, en cuyo caso no se escribe ninguna muestra de 64 bits y un lector debe realizar la estimación únicamente a partir de la muestra principal de 32 bits (y seguir indicándolo en los estados que escriba después); por tanto, los dos bits son mutuamente excluyentes, y un lector debe rechazar un estado que active ambos. No se define ningún otro bit, y un lector debe rechazar un estado que active alguno. Todo esto se aplica igualmente a un estado anidado dentro de un tipo contenedor —Array,Tuple,Map,Nullable,Variant(donde la versión explícita de la alternativa cambia la cadena de tipo sin alterar el orden del discriminador), o un envoltorioNested/SimpleAggregateFunction—. También se aplica a los combinadores de funciones de agregación: un combinador transparente sobre una función versionada —uniqIf,uniqArray,uniqForEach,uniqMap,uniqArgMin/uniqArgMax,uniqOrNull/uniqOrDefault,uniqResampley el adaptador implícito para argumentosNullable— transmite la versión a los estados anidados que contiene su carga útil, escribe explícitamente la versión actual de la función anidada en la cadena de tipo de un estado recién creado, exactamente igual que la función simple (AggregateFunction(1, uniqIf, UInt64, UInt8)), y, en una conexión negociada, deriva la versión de la revisión del protocolo de la misma manera. El nombre personalizado de un envoltorio contiene una segunda copia de su tipo de argumento, por lo que el emisor debe reconstruir esa copia con la misma versión negociada del estado de agregación; de lo contrario, su encabezado podría anunciar la versión1para una carga útil de versión0. Hay un caso límite deVariantque no tiene ninguna representación en el wire: cuando dos alternativas solo difieren en una versión de estado explícita (algo válido como tipo de columna, ya que las cadenas de tipo son distintas), volver a versionar ambas para la revisión negociada las fusionaría en una misma alternativa, por lo que el emisor debe hacer fallar la transferencia en lugar de anunciar versiones que no corresponden a las de la carga útil.Dynamices la excepción deliberada al versionado derivado de la revisión: una columnaDynamicanuncia por sí misma sus tipos anidados —mediante sus propias listas de tipos y mediante la codificación binaria de tipos, cuyo campo de versión explícito transporta la versión de estado explícita (los valores de su variante compartida incrustan así su tipo incluso en reposo)—, y esos anuncios forman parte de los propios datos de la columna, idénticos para cualquier par y cualquier medio, por lo que nunca se reescriben para una revisión negociada. Por tanto, un estado anidado dentro de un valorDynamicse escribe con la versión indicada en su tipo (que todo estado recién creado incluye, ya que el resultado de una consulta-Stateescribe su versión explícitamente), o con la versión0cuando el tipo no indica ninguna, en todas las conexiones y medios por igual.QBit(T, N[, stride])almacena un vector con sus planos de bits transpuestos para cargas de trabajo de búsqueda vectorial; la disposición de su flujo en el wire (flujos de planos de bitsFixedStringordenados por grupo,element_size * (N / stride)de ellos con unstrideexplícito) y su codificación binaria de tipos (etiqueta0x36, o0x37QBitWithStridecuandostride != N) se documentan en la página del tipo de datosQBity en la referencia de la codificación binaria de tipos, de modo que un lector deNativeno tiene que deducirlas a partir del código fuente en C++.
Tipos versionados
Los tipos versionados incluyen, en su representación wire, un prefijo de versión de serialización que indica qué variante de la codificación viene a continuación. También pueden usar múltiples flujos (como los tipos compuestos). En el formato wireNative, el prefijo y cualquier diccionario son por bloque: estos tipos no mantienen ningún estado entre bloques (consulte la nota sobre el prefijo por bloque más abajo); el estado de serialización entre bloques solo existe en el flujo en disco de MergeTree.
Estos tipos son bastante más complejos que los tipos compuestos de forma fija, por lo que un Client orientado a consultas analíticas sencillas puede dejar su implementación para más adelante.
Versión de serialización: concepto
Una versión de serialización es un número de versión on-wire, por tipo y por columna, que indica qué variante de la codificación de un tipo utiliza el emisor. Es lo primero que aparece en el prefijo de estado de la columna, de modo que el decodificador la lee y delega en el analizador adecuado para el resto de la columna. No debe confundirse con la versión del protocolo:
La mayoría de los tipos versionados escriben la versión como un UInt64 little-endian justo antes de cualquier otro dato del prefijo de estado; unos pocos usan VarUInt o UInt8. Un decodificador lee primero la versión y rechaza los valores desconocidos: una versión superior implica un formato de emisor más reciente que el decodificador no entiende, y analizarlo incorrectamente corrompe todos los bytes posteriores.
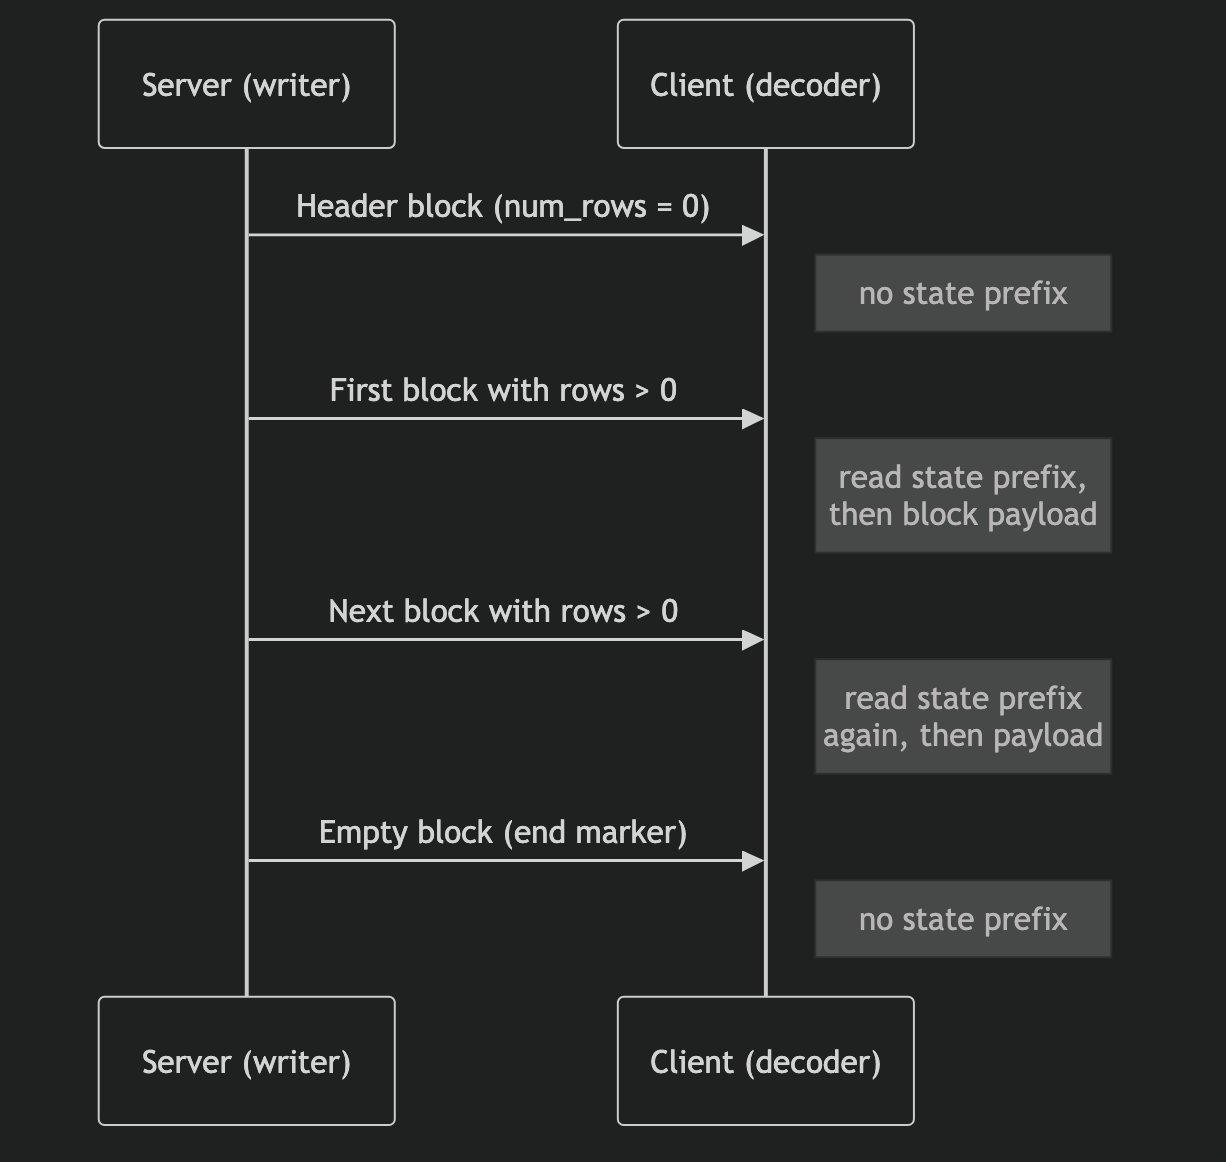
El prefijo de estado se emite al comienzo de cada bloque cuyo número de filas es mayor que cero, justo antes de la carga útil de ese bloque.
El escritor y el lector Native no conservan el estado de serialización entre bloques:
NativeWriter crea un estado de serialización nuevo y escribe un prefijo de estado por cada bloque de columna no vacío que escribe, y NativeReader crea un estado de deserialización nuevo y lo lee por cada bloque no vacío que lee (ambos omiten por completo el prefijo cuando rows == 0).
Por lo tanto, los bloques de encabezado (rows = 0) y los bloques vacíos no emiten nada, y un decodificador debe volver a leer el prefijo de estado al comienzo de cada bloque no vacío. Un decodificador que lea el prefijo una sola vez y trate los bloques posteriores como si solo contuvieran carga útil interpretará el prefijo del siguiente bloque como datos y perderá la sincronización:
Referencia de versiones de serialización
Algunos aspectos de la tabla que conviene destacar:
- Los valores no son contiguos.
Dynamicusa1,2,3y4, conV3en4yFLATTENEDen3. Un número mayor no implica necesariamente una versión más reciente. - Algunos valores son exclusivos del formato Native.
Object::STRING,Object::FLATTENEDyDynamic::FLATTENEDexisten para mantener la compatibilidad del protocolo nativo con los Clients que no implementan Object/Dynamic por completo. No aparecen en el almacenamiento en disco de MergeTree. V3es exclusivo del almacenamiento en disco.Object::V3yDynamic::V3figuran en la tabla porque esos valores ya están asignados y no deben reutilizarse, no porque un decodificador pueda encontrárselos: ClickHouse nunca los envía a través deNativey, en ese contexto, los rechaza conINCORRECT_DATA. Todo lo que contienen —la subversión de shared-data deObject::V3y sus disposiciones de buckets y gránulos— describe una parte y no un bloque, por lo que queda fuera del alcance de esta página. Los Clients que consumen el protocolo TCP nativo solo venV1,V2,STRINGoFLATTENED.
LowCardinality(T)
El tipo versionado más sencillo. Sustituye una columna deN valores internos por un pequeño diccionario de valores únicos y N índices que apuntan a ese diccionario.
Cadena de tipo: LowCardinality(InnerType). Ejemplos: LowCardinality(String), LowCardinality(FixedString(4)), LowCardinality(Nullable(String)).
sharedDictionariesWithAdditionalKeys; los demás valores están reservados.
El UInt64 de metadata por bloque es un campo de bits:
En una respuesta de consulta típica con un único bloque de datos por columna, la metadata es
0x600 (HasAdditionalKeys + NeedUpdateDictionary).
Los valores del dict son dict_size valores codificados con el tipo interno T. El diccionario reserva las primeras posiciones para valores especiales: una columna no Nullable reserva una (dict[0] contiene el valor predeterminado del tipo interno, p. ej., "" para String), y los valores distintos reales empiezan en dict[1].
En LowCardinality(Nullable(T)), el dict se sigue codificando como T simple (sin stream de mapa de nulos), pero se reservan dos posiciones: dict[0] es el marcador NULL y dict[1] es el valor predeterminado del tipo interno (p. ej., "" para String); los valores distintos reales empiezan en dict[2]. La clave de una fila NULL apunta a dict[0], y esa posición se escribe en el wire con los bytes predeterminados del tipo interno.
Las claves son índices del dict; cada índice ocupa 1 << key_type_code bytes (1, 2, 4 u 8), y el valor N se reconstruye como dict[keys[N]].
keys_count es el número de valores LowCardinality en el nivel recursivo actual, que no tiene por qué coincidir con el número de filas del bloque. En una columna LowCardinality de nivel superior, ambos coinciden. Pero cuando LowCardinality está anidado dentro de un tipo compuesto, el recuento es el número aplanado de valores que le transmite el tipo compuesto: en Array(LowCardinality(String)) con tres filas que contienen cinco elementos en total, keys_count es 5, no 3; en Map(K, LowCardinality(V)) es el número total de pares, y así sucesivamente. Un decodificador debe obtener keys_count de este campo en lugar de suponer que equivale al número de filas del bloque. Cuando ese recuento aplanado es cero (por ejemplo, en un bloque cuyos arrays están todos vacíos), la fase de datos de LowCardinality no escribe absolutamente nada: solo está presente el prefijo de estado (emitido en la fase de prefijo del tipo compuesto), sin metadata, diccionario ni keys_count a continuación.
El prefijo de estado se lee al inicio de cada bloque cuyo número de filas es mayor que cero; los bloques de encabezado (rows = 0) y los bloques vacíos no emiten nada. Dentro de un bloque, keys_count es igual al número de filas, dict_size es igual al número de valores del stream del diccionario, y cada clave ocupa 1 << key_type_code bytes.
En el formato
Native, cada bloque incluye su propio diccionario autocontenido y local al bloque: no se comparte estado de diccionario entre bloques. El escritor Native establece low_cardinality_max_dictionary_size = 0, de modo que SerializationLowCardinality nunca construye un diccionario compartido: cada bloque no vacío escribe sus claves como claves adicionales locales al bloque con NeedGlobalDictionaryBit desactivado (metadata 0x600), y el lector Native rechaza NeedGlobalDictionaryBit cuando native_format es true. Por lo tanto, un decodificador debe restablecer el diccionario en cada bloque y leer las dict_size entradas presentes en ese bloque; reutilizar el diccionario de un bloque anterior haría que las claves del siguiente bloque se leyeran incorrectamente. (Persistir un diccionario LC entre bloques es una cuestión del almacenamiento en disco de MergeTree, no de la disposición en formato wire de Native).LowCardinality(String) con los valores ['a', 'b', 'a', 'c', 'b']:
dict[1], dict[2], dict[1], dict[3], dict[2] = ["a", "b", "a", "c", "b"].
LowCardinality(Nullable(String)) con los valores ['a', NULL, '', 'b'] muestra las dos posiciones reservadas: dict[0] para NULL y dict[1] para la cadena vacía como valor predeterminado:
dict[2] = "a", dict[0] = NULL, dict[1] = "", dict[3] = "b", es decir, ["a", NULL, "", "b"]. Tanto dict[0] como dict[1] son bytes vacíos en el wire; la nulidad se debe a que la clave apunta a la posición 0, no a los bytes.
JSON (Tier 1: String fallback)
El tipoJSON de ClickHouse tiene varias codificaciones wire (consulte la referencia de versiones de serialización). Tier 1 es la más sencilla: cuando se establece el ajuste de consulta output_format_native_write_json_as_string = 1, el servidor convierte cada valor JSON en su texto serializado y emite la columna como String con un marcador de prefijo de estado.
Cadena de tipo: JSON.
1 para este String fallback. Los demás valores indican distintas codificaciones de JSON/Object: 0 = V1, 2 = V2 (la predeterminada en el protocolo TCP nativo), 3 = FLATTENED, 4 = V3 (consulte la referencia de versiones de serialización). Si un decodificador encuentra aquí un valor distinto de 1, no se trata del String fallback. El prefijo se lee al inicio de cada bloque con filas > 0, y el stream de valores es una columna String estándar de num_rows filas.
Valor JSON '{"a":1}' (una fila):
{"a":1}), y el integer se mantiene como integer. El texto es simplemente un valor String, por lo que el Client recibe el JSON para transportarlo de forma opaca, pero no recupera las rutas individuales ni sus tipos de ClickHouse; para obtener un tipado fiel por ruta se necesita la codificación Tier 2 que se describe a continuación.
Variant(T1, T2, …)
Una unión discriminada: cada fila contiene un valor de exactamente uno de los tipos Variant, o NULL. Cada fila lleva un discriminador global de un byte que selecciona su tipo, y los valores de cada tipo se almacenan después de forma compacta, en un bloque contiguo por cada tipo Variant. Cadena de tipo:Variant(T1, T2, ...). El servidor normaliza el orden (los tipos Variant se ordenan por nombre), por lo que la cadena de tipo recibida ya enumera los tipos en orden de discriminador global: el discriminador 0 selecciona el primer tipo de la lista, 1 el segundo, y así sucesivamente. 255 (NULL_DISCRIMINATOR) indica que la fila es NULL. Los elementos de Variant nunca son Nullable: representar NULL es tarea del discriminador. Ejemplos: Variant(String, UInt64), Variant(Array(UInt8), String).
El prefijo de estado contiene un modo de discriminadores UInt64 LE: 0 = BASIC (el discriminador de cada fila se escribe literalmente), 1 = COMPACT (codificación run-length por gránulo). De forma predeterminada, el servidor utiliza BASIC en el protocolo nativo (use_compact_variant_discriminators_serialization = false); aquí solo se especifica BASIC.
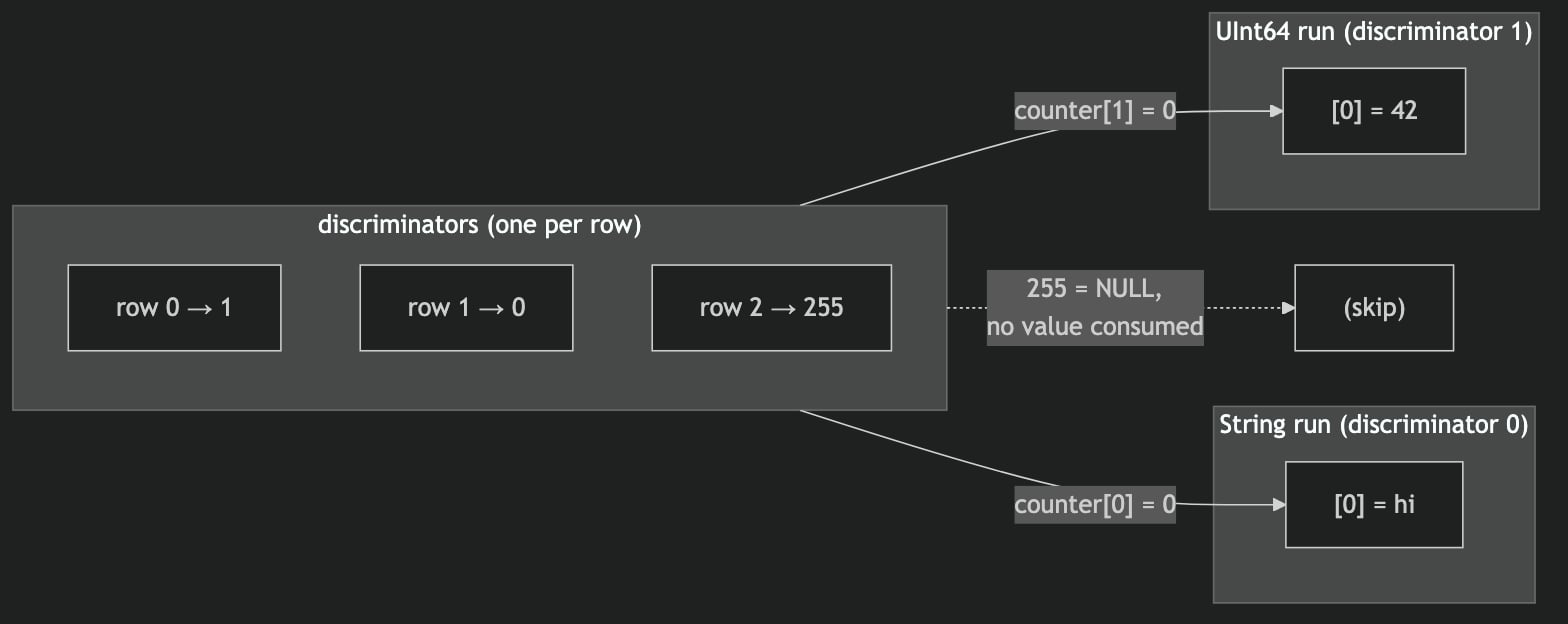
r con discriminador d (≠ 255) toma el valor situado en el índice counter[d] de la secuencia de valores del tipo Variant d y, a continuación, se incrementa counter[d]. Las filas con discriminador 255 son NULL y no consumen ningún valor de ninguna secuencia, por lo que la suma de los contadores por tipo es igual al número de filas no NULL.
El prefijo de estado (el modo UInt64) se lee al inicio de cada bloque con más de 0 filas; los bloques de encabezado y los bloques vacíos no emiten nada. Cada discriminador no NULL es menor que el número de tipos Variant, y el tipo Variant i se decodifica para exactamente count[i] filas.
Los elementos de Variant que, a su vez, tienen estado (
LowCardinality, Variant, Dynamic, JSON) emiten su propio prefijo de estado en la fase de prefijo de estado por elemento, después del modo UInt64. Los tipos hoja y los tipos compuestos simples (Array, Tuple, Map de tipos hoja) tienen prefijos de estado vacíos y pueden componerse libremente.Variant(String, UInt64) con los valores [42, 'hi', NULL] (el orden canónico sitúa String antes que UInt64, por lo que el discriminador 0 = String y 1 = UInt64):
42; fila 1 = String run[0] = "hi"; fila 2 = NULL.
El stream de discriminadores actúa como índice: cada discriminador no NULL toma el siguiente valor del bloque denso de su tipo, mientras que 255 (NULL) no consume nada. Este mismo recorrido permite reconstruir Dynamic, que solo se diferencia en la forma de codificar NULL:
Dynamic
Una columna cuyo tipo de valor se determina en tiempo de ejecución: cada fila contiene un valor de uno de los tipos de un conjunto determinado en tiempo de ejecución, o NULL. A diferencia deVariant, el conjunto de tipos no figura en la cadena de tipo de la columna, sino que se transmite en el prefijo de estado.
Cadena de tipo: Dynamic o Dynamic(max_types=N). El parámetro max_types limita cuántos tipos distintos registra la columna, pero no afecta al formato wire que se describe a continuación.
Dynamic tiene cuatro codificaciones: V1 = 1, V2 = 2, FLATTENED = 3, V3 = 4. La que emite el servidor depende del canal y de los ajustes de consulta:
- A través de
clickhouse-clienty de HTTPFORMAT Native, la revisión del escritor es0(salvo que se aumente conclient_protocol_version), por lo que la codificación predeterminada es V1. - A través del protocolo TCP nativo, con su revisión negociada, la codificación predeterminada es V2. El escritor
Nativemantiene las estadísticas deshabilitadas, por lo que una carga útilV2predeterminada no incluye estadísticas por variante: tras la lista de tipos aparecen directamente el prefijo y los datos delVariantanidado. (Las estadísticas por variante atañen al almacenamiento en disco de MergeTree y no forman parte del formato wire Native). - El ajuste de consulta
output_format_native_use_flattened_dynamic_and_json_serialization = 1prevalece sobre ambos casos y emite FLATTENED (versión 3) independientemente de la revisión.
AlcanceEsta página especifica únicamente la disposición
FLATTENED. Las disposiciones binarias no aplanadas V1/V2/V3 son la representación interna/en disco (listas de tipos codificadas en binario, estadísticas por variante) y no se especifican aquí. Un Client que quiera decodificar Dynamic siguiendo esta página debe solicitar FLATTENED estableciendo output_format_native_use_flattened_dynamic_and_json_serialization = 1; la disposición siguiente presupone ese ajuste. Dado que el byte de versión encabeza el prefijo, un decodificador puede detectar qué codificación ha recibido realmente y rechazar V1/V2/V3 si solo implementa FLATTENED.num_types tipos más la posición reservada para NULL: UInt8 para num_types ≤ 255 y, a continuación, UInt16, UInt32 y UInt64. NULL se representa con el valor de discriminador igual al propio num_types, a diferencia de Variant, donde NULL es el valor fijo 255. La reconstrucción sigue el mismo recorrido denso que en Variant: se mantiene un contador por tipo, y la fila r con discriminador d (≠ num_types) toma el valor counter[d] de la secuencia del tipo d.
El prefijo de estado (versión + lista de tipos) se lee al inicio de cada bloque con filas > 0; los bloques de encabezado y los bloques vacíos no emiten nada.
Recuentos malformados
num_types se lee del flujo antes que cualquier nombre de tipo. Un decodificador debe considerarlo no fiable y no debe usarlo directamente para dimensionar una asignación: ni un recuento cercano a SIZE_MAX (que puede desbordar la aritmética intermedia o lanzar una excepción distinta de DB::Exception) ni un recuento grande pero representable como 100000000 (que está muy por debajo del max_size() de un vector y, sin embargo, asignaría gigabytes antes de leer un solo nombre de tipo). ClickHouse lee la lista de tipos entrada a entrada, con solo una sugerencia de preasignación limitada, de modo que un num_types corrupto se rechaza como INCORRECT_DATA (“Dynamic column has too many types”, cuando el recuento supera lo que el contenedor puede almacenar) o como un error de lectura ordinario en cuanto el flujo se queda sin entradas de tipo, pero nunca como un fallo por falta de memoria.Sin embargo, no limite el num_types aplanado con ColumnDynamic::MAX_DYNAMIC_TYPES_LIMIT (254 en ClickHouse): la lista de tipos aplanada incluye todos los tipos de tiempo de ejecución distintos, incluidos los que se desbordaron hacia la variante compartida, por lo que un bloque aplanado válido puede enumerar legítimamente muchos más. El límite MAX_DYNAMIC_TYPES_LIMIT solo se aplica al recuento num_dynamic_types de los prefijos no aplanados V1/V2/V3, que cuenta las posiciones de variantes regulares y está acotado por dicho límite (ClickHouse lo valida ahí, antes de sumar el + 1 correspondiente a la variante compartida).Flujos truncadosLa secuencia de discriminadores contiene exactamente
num_rows entradas, y un decodificador debe comprobar que ha leído esa cantidad en lugar de aceptar lo que contenga el flujo. Una secuencia más corta no contradice nada de lo que viene después: los recuentos de valores por tipo se derivan de los discriminadores realmente leídos, por lo que siguen siendo coherentes con las secuencias de valores, y una secuencia compuesta íntegramente por marcadores NULL no requiere ningún byte de valor. ClickHouse rechaza una secuencia de discriminadores corta con INCORRECT_DATA (“Mismatch in flattened Dynamic column: N rows are expected, but the indexes stream contains only M rows”) antes de cualquier comprobación por tipo, porque a continuación la columna reconstruida se usa para num_rows filas, independientemente de su tamaño real.Los tipos de tiempo de ejecución con serialización con estado (
LowCardinality, Variant, Dynamic, JSON) incluyen prefijos de estado anidados después de la lista de nombres de tipo.Variant: las posiciones de variantes regulares se escriben en el orden de DataTypeVariant (por nombre de tipo), de modo que el orden de transmisión no coincide con el orden de inserción. Sin embargo, no siempre está ordenada globalmente: los tipos que se desbordaron hacia la variante compartida (por ejemplo, con Dynamic(max_types=N)) se añaden tras las posiciones regulares en el orden en que aparecieron por primera vez, por lo que el final de la lista puede romper el orden por nombre de tipo. Por tanto, un decodificador debe tomar la lista de tipos transmitida como referencia autorizada para la asignación de discriminadores y no debe reordenarla por su cuenta. Lo que la lista no puede contener es un tipo repetido ni Nothing: dos entradas iguales corresponden a un único discriminador y Nothing ni siquiera es una variante, así que en ambos casos parte de la lista no tiene dónde reconstruirse. ClickHouse rechaza ambos casos con INCORRECT_DATA. Para las filas [42::UInt64, "hi", NULL], los dos tipos son String y UInt64, y "String" va antes que "UInt64" en el orden, por lo que los discriminadores son 0 = String, 1 = UInt64, 2 = NULL:
42; fila 1 = String run[0] = "hi"; fila 2 = NULL. Las secuencias por tipo siguen el mismo orden de wire que la lista de tipos (String antes de UInt64).
JSON (Tier 2: objeto FLATTENED)
La codificación JSON más completa: en lugar de aplanar cada valor como texto (Tier 1), la columna se divide en una subcolumna por cada ruta JSON. Se selecciona sin solicitar la alternativa de Tier 1 (output_format_native_write_json_as_string = 0) y con el indicador de serialización aplanada activado (output_format_native_use_flattened_dynamic_and_json_serialization = 1); en ese caso, el servidor emite la serialización versión 3.
Existen dos tipos de ruta:
- Las rutas tipadas se declaran en la cadena de tipo, por ejemplo
JSON(a UInt32, b String), y se decodifican con su tipo declarado. Si un nombre de ruta contiene puntos, se delimita con acentos graves en la cadena de tipo. - Las rutas dinámicas se descubren en tiempo de ejecución y cada una se decodifica como una columna Dynamic.
num_rows valores.
Dynamic de una ruta dinámica (en la fase de prefijos) queda separado de sus datos (en la fase de datos). El prefijo de estado se lee al inicio de cada bloque con filas > 0, y cada columna de ruta (tipada o dinámica) contiene exactamente num_rows valores. El objeto de la fila r se construye leyendo el valor de cada ruta en el índice r; una ruta dinámica cuyo discriminador Dynamic sea NULL en esa fila no aporta ninguna clave. Los nombres de las rutas dinámicas deben ser distintos y ninguno puede repetir una ruta que la cadena de tipo ya declare como tipada: en cualquiera de los dos casos, el objeto resultante tendría dos valores bajo una misma clave, por lo que ClickHouse rechaza ambos con INCORRECT_DATA. Lo mismo se aplica a la lista de rutas dinámicas de las codificaciones no aplanadas.
Recuentos malformados
num_dynamic_paths en la disposición FLATTENED que se documenta aquí —y el recuento de rutas dinámicas en las codificaciones no aplanadas V1/V2— se lee del flujo antes que los nombres de las rutas. (Los prefijos no aplanados no incluyen un campo aparte para las rutas aplanadas: solo contienen el recuento de rutas dinámicas, además de un valor max_dynamic_paths en V1 que se lee y se descarta). Al igual que con Dynamic, un decodificador debe considerar estos recuentos como no fiables y no debe dimensionar una asignación directamente a partir de ellos, ya sea un recuento de la familia SIZE_MAX o uno grande pero representable. ClickHouse lee los nombres de las rutas de uno en uno, con solo una sugerencia de preasignación limitada, de modo que un recuento corrupto se rechaza como INCORRECT_DATA (“JSON/Object column has too many paths”, cuando supera lo que el contenedor puede albergar) o como un error de lectura ordinario cuando el flujo se queda sin nombres de rutas.Flujos truncadosLos
num_rows valores por columna de ruta son un requisito estricto, no un límite superior: un decodificador debe comprobar cada columna de ruta, tanto tipada como dinámica, con el recuento de filas del bloque, en lugar de confiar en que el flujo termine donde debería. El objeto resultante no tiene un tamaño propio con el que contrastar —su recuento de filas es el que haya producido el desaplanado—, por lo que una columna de ruta incompleta no puede detectarse más adelante, y leer su fila r implica leer más allá de su final. ClickHouse la rechaza con INCORRECT_DATA (“Unexpected size of typed path / flattened path p in flattened Object column”). En el caso de una ruta dinámica, esta comprobación se suma a la equivalente que se realiza dentro de su columna Dynamic.JSON {"a": 42, "b": "hi"} (una fila, ambas rutas dinámicas). Un integer JSON se infiere como Int64:
JSON no aplanado (V1/V2)
Las codificacionesObject no aplanadas son las que el servidor emite on the wire cuando el indicador de aplanado está desactivado: V1 a través de clickhouse-client / HTTP FORMAT Native (revisión 0) y V2 a través del protocolo TCP nativo. (V3, la tercera codificación no aplanada, solo se escribe en partes de MergeTree y se rechaza on the wire). Incluyen una columna shared-data y no se especifican en esta página. Tenga en cuenta que no incluyen estadísticas por ruta en el wire de Native: NativeWriter mantiene las estadísticas desactivadas, por lo que el prefijo de estructura de Object carece de sección de estadísticas y los bytes que lo siguen corresponden directamente a los prefijos typed/dynamic/shared-data y a los datos. Las estadísticas solo aparecen en las rutas en disco de MergeTree que las habilitan. Para decodificar una columna JSON con esta página, el Client debe elegir uno de los niveles documentados: establezca output_format_native_write_json_as_string = 1 para el String fallback, o bien output_format_native_use_flattened_dynamic_and_json_serialization = 1 (con output_format_native_write_json_as_string = 0) para la disposición FLATTENED Object.
Trama de compresión
ClickHouse puede comprimir los datos de columna de un streamNative mediante un formato de trama interno. La disposición de la trama que se describe a continuación es independiente del transporte —las mismas tramas aparecen tanto en el protocolo TCP nativo como en HTTP—, pero la forma de solicitar la compresión, y lo que rodea a las tramas, varía según el transporte.
- Protocolo TCP nativo. La compresión es opcional y se activa por consulta mediante el indicador
compressiondel paquete Query. Cuando está activa, el cuerpo de cada paqueteData,Totals,Extremes,LogyProfileEvents—los bytes que siguen a la cadenatable_name— se envuelve en el formato de trama. El sobre del paquete en sí, es decir, el código de tipo de paquete y la cadenatable_name, no se comprime; el servidor los escribe directamente en el stream sin procesar. Todo lo que emite elNativeWriterva al stream comprimido, por lo que el prefijoBlockInfoes lo primero que aparece dentro de la trama, junto con las dimensiones y las columnas. Por tanto, un Client debe descomprimir la trama antes de poder leerBlockInfo. - HTTP.
SELECT ... FORMAT Native&compress=1envuelve todo el stream de bytes deFORMAT Nativeen las mismas tramas (el servidor usa el mismoCompressedWriteBufferinterno), y?decompress=1espera esas mismas tramas en un cuerpo de entradaNative, que decodifica mediante elCompressedReadBuffercorrespondiente. En esta ruta no hay tipo de paquete TCP,table_nameni sobre de paquete: toda la carga útil comprimida se compone únicamente de bloquesNativeenmarcados (el prefijoBlockInfosolo está presente si la revisión negociada es mayor que0, igual que en la disposición sin comprimir descrita anteriormente). Este enmarcado interno decompress/decompressno debe confundirse con la compresión de transporte HTTP (Content-Encoding: gzip/zstd, habilitada medianteenable_http_compression), que envuelve la respuesta en la capa HTTP y no corresponde al formato de trama que se describe a continuación.
FORMAT Native tendrá que añadir igualmente esta capa de tramas para leer una respuesta HTTP Native comprimida o para enviar un cuerpo de solicitud con decompress=1.
Formato de trama
16 + compressed_size = 16 + 9 + body_size = 25 + body_size. Tenga en cuenta los dos intervalos: la suma de comprobación abarca el encabezado de 9 bytes y el cuerpo, mientras que compressed_size incluye el encabezado y el cuerpo, pero no la propia suma de comprobación:
Valores del byte de método
Estos tres códecs son los que el servidor genera para el enmarcadoNative de stream completo: la salida HTTP con compress=1 utiliza el códec predeterminado del servidor (ZSTD(3)), y el protocolo TCP nativo utiliza LZ4, ZSTD o NONE según network_compression_method. A un Client Native genérico le basta con generar y consumir estos tres.
El byte de método también codifica los códecs a nivel de columna. Estos se aplican por columna en las rutas en disco de MergeTree y no al enmarcado de stream completo, pero la ruta de entrada HTTP con
decompress=1 toma el códec del byte de método de cada trama, por lo que cualquiera de estos bytes puede aparecer legítimamente en la entrada. Por tanto, un decodificador conforme debe reconocer todo el espacio asignado y rechazar los bytes que no implemente, en lugar de interpretar erróneamente el cuerpo. Sus cuerpos son específicos de cada códec y quedan fuera de este contrato genérico de trama:
DoubleDelta (0x94) almacena las segundas diferencias como bits de prefijo/signo/magnitud, empezando por el MSB. La decodificación basada en palabras conserva esta codificación, el número de elementos y el relleno del último byte.
0x9c (ALP) es un códec sin pérdida en beta para Float32 y Float64 (compresión adaptativa sin pérdida de coma flotante). Solo se puede crear una tabla con CODEC(ALP) cuando el ajuste enable_alp_codec está activado, pero el byte de método siempre se acepta al descomprimir para que los datos escritos previamente sigan siendo legibles. 0x9d (SZ3) es un códec con pérdida experimental y con error acotado para Float32, Float64 y Array de esos tipos. Solo se puede crear una tabla con CODEC(SZ3) cuando el ajuste enable_sz3_codec está activado, pero el byte de método siempre se acepta al descomprimir para que los datos escritos previamente sigan siendo legibles. 0x9f (ZXC) es un códec LZ asimétrico experimental: lento al comprimir, pero muy rápido al descomprimir, con una tasa de compresión intermedia entre LZ4 y ZSTD. Solo se puede crear una tabla con CODEC(ZXC) cuando el ajuste enable_zxc_codec está activado, pero el byte de método siempre se acepta al descomprimir para que los datos escritos previamente sigan siendo legibles. Los bytes 0x99 (DeflateQpl) y 0x9b (ZSTD_QPL) se asignaron a códecs que ya se han eliminado; están reservados y no se reutilizan.
0x9e (Quantized) es un códec de columna experimental para columnas de vectores densos (Array(Float32) y similares). Al igual que NONE, es de paso directo (el cuerpo de precisión completa se almacena tal cual), pero su presencia asocia una serialización que escribe un stream complementario, compacto y cuantizado, que se utiliza para acelerar la búsqueda vectorial. Solo se puede crear una tabla con CODEC(Quantized(...)) cuando el ajuste enable_quantized_codec está activado, y el byte de método siempre se acepta al descomprimir.
Suma de comprobación
ClickHouse utiliza CityHash v1.0.2 (la variante histórica), no el CityHash moderno de Google; ambos generan resultados distintos. La suma de comprobación se calcula sobre los 9 bytes del encabezado (method + compressed_size + uncompressed_size) más los N bytes del cuerpo, es decir, todo lo que hay entre la suma de comprobación y el final de la trama. Los primeros 8 bytes de la salida de 16 bytes de CityHash128 corresponden a la mitad baja (LE) y los 8 bytes siguientes, a la mitad alta (LE). El decodificador vuelve a calcular el CityHash128 sobre el encabezado y el cuerpo recibidos y lo compara con los 16 bytes iniciales; si no coinciden, los datos se consideran corruptos y el decodificador falla.Límites por bloque
La carga útil comprimida de un bloque es un flujo de una o más tramas, no necesariamente una sola trama. El emisor escribe el bloque serializado a través de unCompressedWriteBuffer que emite una trama cada vez que su búfer interno se llena (≈1 MB, DBMS_DEFAULT_BUFFER_SIZE) y una trama final cuando se vacía el bloque. Así, un bloque pequeño ocupa una sola trama, mientras que un bloque grande ocupa varias tramas consecutivas.
El invariante funciona en un solo sentido: dado que el emisor vacía el búfer comprimido al final de cada bloque, cada final de bloque coincide con un límite de trama, pero lo contrario no se cumple. Un límite de trama intermedio, emitido porque el búfer se llenó a mitad de un bloque, queda en medio del bloque y no constituye un límite de bloque. Por lo tanto, un decodificador debe usar las propias dimensiones del bloque (num_columns/num_rows) para determinar dónde termina; no debe suponer que cada trama corresponde a un bloque completo.
Un receptor procesa las tramas en flujo: lee 16 + 9 bytes, lee exactamente compressed_size - 9 bytes del cuerpo, los descomprime en exactamente uncompressed_size bytes y entrega esos bytes al decodificador de bloques; cuando el decodificador necesita más datos de los que contiene la trama actual, obtiene la siguiente. Como el emisor vacía el búfer en cada bloque, una vez que un bloque se ha decodificado por completo, el búfer de tramas queda vacío y el siguiente bloque comienza en una trama nueva.
En el protocolo TCP nativo, el sobre del paquete (el VarUInt del tipo de paquete y la cadena table_name) se escribe en el flujo sin procesar, fuera de la carga útil comprimida; solo el cuerpo del bloque (BlockInfo + columnas) se encapsula en tramas. La ruta HTTP compress/decompress carece de dicho sobre: todo el flujo está formado por bloques encapsulados en tramas.
Negociación
En el protocolo TCP nativo, la compresión se aplica por consulta, no por conexión. El campocompression: bool del paquete Query la solicita solo para esa consulta. El servidor atiende la solicitud y emite cuerpos Data/Totals/Extremes/Log/ProfileEvents comprimidos durante toda la duración de la consulta (Log/ProfileEvents solo a partir de v54481). Asimismo, espera que los bloques Data salientes del Client (tablas externas, el marcador vacío de fin de datos y las filas de INSERT) se enmarquen de la misma forma. Las consultas posteriores en la misma conexión pueden comportarse de otra manera.
En HTTP no existe el paquete Query: el parámetro de consulta compress=1 selecciona la salida enmarcada para esa solicitud, y decompress=1 indica que el cuerpo de la solicitud está enmarcado. La salida de compress=1 se escribe con el códec predeterminado del servidor (ZSTD(3)) y no con network_compression_method; el lector de decompress=1 obtiene el códec del byte de método de cada trama, por lo que en la entrada se acepta cualquier códec.
Con la compresión activada, el servidor también puede encaminar las columnas por la ruta de serialización paralela de bloques /
ColumnBLOB (PARALLEL_BLOCK_MARSHALLING, v54478) en bloques con más de una fila. Una implementación que comprima datos de INSERT debe estar preparada para gestionar esa ruta (o desactivarla explícitamente) a fin de evitar que el stream se desincronice.Glosario
Bloque — la unidad de intercambio de datos en el formato Native. Un fragmento autodescriptivo de filas almacenadas en formato columnar. Consulte estructura de bloques y columnas. BlockInfo — el encabezado de metadata que precede a un bloque en la ruta de paquetes Data de TCP (se escribe siempre que la revisión de la conexión sea mayor que cero). Consiste en una secuencia de campos etiquetados con un ID de campo y condicionados por la revisión. El formato de salidaNative lo omite, ya que serializa con la revisión 0. Consulte BlockInfo.
Cuerpo de columna — los bytes de una columna que contienen los valores reales y que siguen al encabezado de la columna (nombre, tipo, byte has_custom_serialization). La disposición depende del tipo. Consulte disposición de columnas en el wire.
Tipo compuesto — un tipo formado por uno o más tipos internos, que se codifica como varios streams por columna. El formato wire es estable y no está versionado. Consulte tipos compuestos.
Diccionario (LowCardinality) — el array de valores únicos al que una columna LowCardinality(T) hace referencia mediante índices enteros. Consulte LowCardinality.
Bloque vacío — un bloque con num_columns = 0 y num_rows = 0. Se utiliza como centinela: como marcador de fin de entrada en el lado del Client y como marcador de límite de stream en el lado del servidor. Consulte variantes de bloque.
Bloque de encabezado — un bloque con num_columns > 0 y num_rows = 0 que el servidor envía como primer paquete Data de la respuesta a una consulta. Anuncia el esquema del resultado. Consulte variantes de bloque.
Tipo interno — el tipo que envuelve un tipo compuesto. El tipo interno de Array(UInt32) es UInt32; el de Nullable(T) es T.
Stream de desplazamientos — el array UInt64 de posiciones finales acumuladas que Array, Map y Nested utilizan para delimitar los elementos de cada fila. Consulte Array.
Valor de relleno — los bytes que se escriben en las posiciones nulas del stream de valores de una columna Nullable(T). El decodificador los lee para avanzar en el stream, pero ignora su contenido. Consulte Nullable.
Bloque de resultado — un bloque con num_rows > 0 que contiene filas reales del resultado de una consulta. Consulte variantes de bloque.
Bloque de esquema — sinónimo de bloque de encabezado que se emplea al describir la fase de INSERT, en la que el bloque de esquema indica al Client la forma esperada de las columnas.
Versión de serialización — un número de versión en el wire, específico de cada tipo, con el que los tipos versionados declaran qué variante de la codificación viene a continuación. No debe confundirse con la versión del protocolo. Consulte versión de serialización: concepto.
Prefijo de estado — los bytes que preceden a la carga útil de cada bloque en un tipo versionado. Contiene la versión de serialización y (en el caso de LowCardinality) la metadata del diccionario de cada bloque. Se emite al inicio de cada bloque con filas > 0 y no se conserva de un bloque a otro.
Stream — una secuencia contigua de bytes dentro del cuerpo de una columna que codifica un subcomponente lógico (un mapa de nulos, un array de desplazamientos, un stream de valores). Los tipos multistream concatenan dos o más streams por columna.