5万


TL;DR
ClickHouse に、分析とオブザーバビリティのために設計された新しい全文検索が加わりました。高速な複数トークン検索と大規模な集計を 1 つのエンジンで行えます。
これにより、ログ分析における Elasticsearch の有力な代替となります。
このベンチマークでその理由を示します。
最後に残った優位性が消える
長年、選択は単純でした。テキスト検索なら Elasticsearch、分析なら ClickHouse です。
いまは ClickHouse がその両方を担います。
ClickHouse は現在、転置インデックスを基盤に再設計された全文検索を備えています。ただし従来の検索エンジンと異なり、マッチしたドキュメントはそのまま同じベクトル化分析エンジンへ渡されます。このエンジンは、フィルタリング、集計、大規模スキャンですでに定評があります。
この組み合わせが最も効くのは、検索が最初の一歩にすぎない場面です。オブザーバビリティ、とくにログ分析では、検索がテキストを見つけるだけで終わることはまれです。ユーザーはエラーパターンを検索し、次にその出現回数を数え、サービス別にグループ化し、より狭い時間範囲へ絞り込んだり、影響を受けたホストを特定したりします。
言い換えれば、ログとは、たまたまテキストを含んでいる分析データです。
このベンチマークでは、ClickHouse と Elasticsearch の OSS 版を、最大 500 億行のデータセットにわたる現実的な OpenTelemetry ログワークロードで比較します。
先に結論: 検証したすべてのデータセット規模で、ClickHouse は全文検索を伴う分析ワークロードを Elasticsearch より 2〜6 倍高速に実行しました。また ClickHouse は、OTel ログデータセットを Elasticsearch よりはるかにコンパクトに保存します。
ベンチマークは全工程を再現できます。ソースデータ、スキーマ、クエリ、取り込みスクリプト、測定結果は公開 GitHub リポジトリにあります。
以下では、まずベンチマークの構成と方法論を説明し、次に両システムが OTel ログをディスク上にどう保存するかを確認したうえで、ストレージ使用量とクエリ実行時間を比較します。
Managed ClickStack で今すぐ始める
本番環境で使いたいチームには、Managed ClickStack が高速なログ検索と高速な分析を、マネージドのオブザーバビリティスタック 1 つで提供します。
Managed ClickStack を試すベンチマークの構成
結果に入る前に、ベンチマークの構成をすべて示します。データセット、クエリ、ハードウェア、システム設定です。
結果だけを知りたい方は、ストレージ使用量とクエリ実行時間まで読み飛ばしてください。
データセット
このベンチマークでは、私たちの OpenTelemetry デモアプリケーションが生成した現実的な OpenTelemetry ログデータセットを使います。現代のオブザーバビリティパイプラインで見られるものに近い、構造化されたサービスログです。
ベンチマークを完全に再現できるように、ソースデータは Amazon S3 の公開バケットに Parquet ファイルとして公開しています。
- リージョン: eu-west-3 (欧州、パリ)
- 公開バケット: s3://public-pme/text_bench
- 直接 URL: https://public-pme.s3.eu-west-3.amazonaws.com/text_bench/part_{000..009}.parquet
- ファイル構成: 各 Parquet ファイルには、タイムスタンプ順にソートされた 10 億行のログが含まれます
- ヒント: リージョンをまたぐ取り込みのレイテンシとエグレス料金を避けるため、EC2 のベンチマークインスタンスは eu-west-3 で実行してください
このソースデータから、同一のベンチマークデータセットを 3 つの規模で ClickHouse と Elasticsearch の両方にロードしました。
| データセット | 行数 |
|---|---|
| Small | 10 億 |
| Medium | 100 億 |
| Large | 500 億 |
これにより、10 億行規模のデプロイから大規模な本番オブザーバビリティワークロードまで、両システムの挙動を評価できます。
クエリ
全文検索を伴う分析クエリの性能を現実的な条件で評価するため、9 本の OpenTelemetry ログクエリからなるスイートを使います。各クエリは単一または複数トークンの全文検索を中心に構成され、多くの場合その後にフィルタリング、カウント、グループ化、ランキング、時間ベースの集計が続きます。
クエリは両システムのネイティブなクエリ言語で実装しています (ClickHouse は SQL、Elasticsearch は Query DSL と ES|QL)。
このスイートは、Kibana や ClickStack のようなツールでの典型的なログ分析ワークフローを反映するよう設計しています。ユーザーはエラーメッセージを検索し、その直後にフィルタリング、カウント、グループ化、ランキング、時系列での分析を行います。
クエリの組み合わせは、よくある 4 つの調査パターンを網羅しています。
Q1〜Q3: インシデントのドリルダウンとログ取得
指定した語にマッチするログ行を特定し、フィルタを適用して、該当するイベントを確認します。
Q4〜Q5: エラー件数とマッチ件数の概況
マッチしたレコードを数えたり、サブセット間でマッチ量を比較したりします。
Q6〜Q7: サービス単位の内訳
マッチしたログをサービス名、ホスト、重大度などのディメンションでグループ化し、問題が集中している箇所を特定します。
Q8〜Q9: 時間ベースのトレンド分析
マッチを時間バケットに集約し、スパイク、リグレッション、繰り返し発生するパターンを明らかにします。
まとめると、これらのクエリは、絞り込んだログの取得から大規模な分析検索まで、ログ分析の典型的なタスクを網羅的に模しています。
ハードウェアとシステムのバージョン
同じ条件で公平に比較できるように、両システムはそれぞれ独立した同一構成の単一ノード環境でベンチマークしました。各エンジンは、同じ CPU、メモリ、ストレージ構成の専用 EC2 インスタンス上で動かしています。
| システム | インスタンス | CPU / RAM | ストレージ | バージョン |
|---|---|---|---|---|
| ClickHouse | AWS EC2 m6i.8xlarge | 32 vCPU / 128 GiB RAM | gp3 (16k IOPS、1,000 MB/s) | OSS v26.3 |
| Elasticsearch | AWS EC2 m6i.8xlarge | 32 vCPU / 128 GiB RAM | gp3 (16k IOPS、1,000 MB/s) | OSS v9.3.2 |
システム設定
ClickHouse
ClickHouse では、OpenTelemetry ログのスキーマを持つ標準的な MergeTree テーブルを使いました。タイムスタンプ、数値、文字列、マップにはネイティブのデータ型を使っています。テーブルのソート順は次のとおりです。
(ServiceName, Timestamp)このソートキーは、サービスと時間範囲でフィルタする一般的なログ分析クエリの局所性を高め、同時に圧縮率も改善します。
Body 列には全文検索インデックスを作成しました。
Elasticsearch
Elasticsearch では、同じ論理スキーマと同じ物理的なソート順を持つ同等のインデックスマッピングを使いました。
index.sort = (ServiceName ASC, Timestamp ASC)主なマッピングの選択:
Bodyは標準アナライザーのtextとしてマッピング (全文検索が可能)- 構造化された文字列ディメンションは
keywordとしてマッピング - マップ型の属性フィールドは
flattenedとしてマッピング TraceFlagsとSeverityNumberはbyteとしてマッピング- ディスク使用量を最小化するため
codec: best_compressionを有効化
これは、ストレージのベストプラクティスに従いつつ、Elasticsearch で可能な限り ClickHouse のセマンティクスに近づけた構成です。
単一ノードで安定した性能を得るため、次の JVM と OS の設定を使いました。
- CompressedOops を維持するため、ヒープを
30 GiBに固定 (-Xms30g -Xmx30g) bootstrap.memory_lock: truevm.max_map_count=262144
シャード構成
ベンチマークでは、両システムともレプリカなしの単一ノードでストレージ最適化した構成を使いました。
データセットごとに、ClickHouse は単一シャード (単一テーブル) を使い、Elasticsearch は最適なシャードサイズのベストプラクティス (シャードあたり 50GB) に従って複数シャードを使いました。
Elasticsearch のシャードはすべて、測定前にシャードあたり 1 セグメントへフォースマージしました (ベストプラクティスに従っています)。これによりストレージ効率が向上し、しかも検索の並列実行は妨げられません。Lucene はクエリ時に単一のセグメントを論理的に分割できるためです。
データのロード
ClickHouse は、ネイティブの Parquet 取り込みで Parquet ファイルを直接ロードしました。
Elasticsearch は Parquet のネイティブ読み込みに対応していないため、Parquet ファイルからデータをストリーミングし、NDJSON に変換して Bulk API で取り込みました。
取り込みについての補足: この記事の焦点は分析的なログ検索の性能なので、体系的な取り込みベンチマークは実施していません。ただしデータセット準備の過程で、500 億件の OTel ログレコードを単一ノードの ClickHouse インスタンスへロードするのにかかった時間は、初期設定のままで 4 時間未満でした。同等の単一ノード Elasticsearch では、許容できるスループットを得るために取り込みパイプラインと設定のチューニングが必要で、それでも同じロードに数日 (約 5 日) かかりました。
取り込みスループットはオブザーバビリティシステムの本番運用で重要な関心事なので、OTel ログの取り込み側は別途、専用のベンチマークで取り上げるかもしれません。
両システムにデータをロードしたところで、次はクエリ性能を公平に比較するための方法論に移ります。
方法論
実際のオブザーバビリティのワークフローを反映するため、両システムをコールドとホットの条件でベンチマークしました。
コールド実行は、それまで参照していない時間範囲に対する初回のクエリを模したものです。必要なログデータはディスクからロードしなければなりません。
ホット実行は、同じデータがすでにキャッシュされた状態での繰り返し実行を模したものです。
このベンチマークで考慮したキャッシュ
クエリのレイテンシに影響しうるキャッシュ層は 3 つあります。
-
Linux ページキャッシュ
オペレーティングシステムのファイルキャッシュで、ディスクからの再読み込みを避けます。 -
フィルタ評価キャッシュ
以前の述語/フィルタの結果を記憶し、繰り返しのフィルタ処理を高速化するエンジンレベルのキャッシュです。- ClickHouse: クエリ条件キャッシュ
- Elasticsearch: ノードクエリキャッシュ
-
クエリ結果全体のキャッシュ
同一クエリの繰り返しに対して、クエリ応答全体を保持するキャッシュです。- ClickHouse: クエリキャッシュ
- Elasticsearch: シャードリクエストキャッシュ
中核となる実行性能に焦点を当てるため、ベンチマーク中はクエリ結果全体のキャッシュを無効にしました。そうしなければ、メモリ上の結果を繰り返し参照する速度を測ることになり、ここではあまり意味がありません。一方、フィルタ評価キャッシュはエンジンの通常の実行経路の一部なので、有効のままにしました。
コールド実行の測定
コールド実行では、両システムを完全に停止し、Linux ページキャッシュを破棄し、サーバーを再起動してから、クエリを実行しました。
つまり次の状態です。
- データページはメモリにキャッシュされていない
- エンジンは必要なデータをディスクからロードする必要がある
- 実行時間には、ストレージ効率、プルーニング能力、素の実行速度が反映される
OTel ログクエリスイートの各クエリをこのコールドスタート条件で実行しました。報告するコールドの合計値は、クエリごとの実行時間の総和です。
ホット実行の測定
ホット実行では、Linux ページキャッシュを破棄せず、実行の間も両システムを稼働させたままにしました。
各クエリについて:
- 同じクエリを連続で 3 回実行
- クエリ結果全体のキャッシュは無効のまま
- フィルタ評価キャッシュは有効のまま
- 3 回のうち最速の結果をホットの結果として記録
これにより、結果全体の再利用を許さずに、繰り返しクエリの性能を切り出せます。
OTel ログクエリスイートの各クエリをこの条件で測定しました。報告するホットの合計値は、クエリごとの実行時間の総和です。
Elasticsearch の Query DSL と ES|QL
主要なチャートに示す Elasticsearch の結果は Query DSL によるものです。スイート全体を ES|QL でも実装しましたが、私たちのテストでは一貫して実行時間が遅かったため、メインのベンチマークでは、Elasticsearch 側のより強いベースラインとして Query DSL を採用しています。
公開ベンチマークリポジトリには、Query DSL と ES|QL を比較したコールドおよびホットのクエリ別チャートが含まれています。
ベンチマークの方法論を確認したところで、次は両システムが OTel ログをディスク上にどう保存するかを見ます。このディスク上のレイアウトは、その後の結果を理解するうえで欠かせない背景です。
OpenSearch はどうか
このベンチマークは OpenSearch ではなく Elasticsearch を対象としています。Elasticsearch をベースラインに選んだのは、全文ログ検索の基準点として依然もっともよく知られているからです。OpenSearch は Elasticsearch と近い関係にあり、Elasticsearch 互換や AWS ネイティブ、低コストといった選択肢を求めるチームによく選ばれています。
この記事では OpenSearch に対して完全なベンチマークスイートを実行していないため、以下の結果は、あくまで ClickHouse と Elasticsearch の比較として読んでください。ただ、ログ分析で OpenSearch と ClickHouse を比較しているチームにとっても、アーキテクチャ上の核心となる問いは同じです。検索はたいてい最初の一歩にすぎません。マッチしたログ行をフィルタし、数え、サービス別にグループ化し、時間軸で集計する必要が生じた時点で、ワークロードは分析的なものになります。ClickHouse はまさにその領域で先行するように設計されています。
OTel ログはディスク上にどう保存されるか
次のセクションのストレージ使用量の結果を理解しやすくするため、まず Elasticsearch と ClickHouse が取り込んだ OTel ログをディスク上でどのように保存し圧縮するかを見ます。次の図は簡略化したスケッチです。
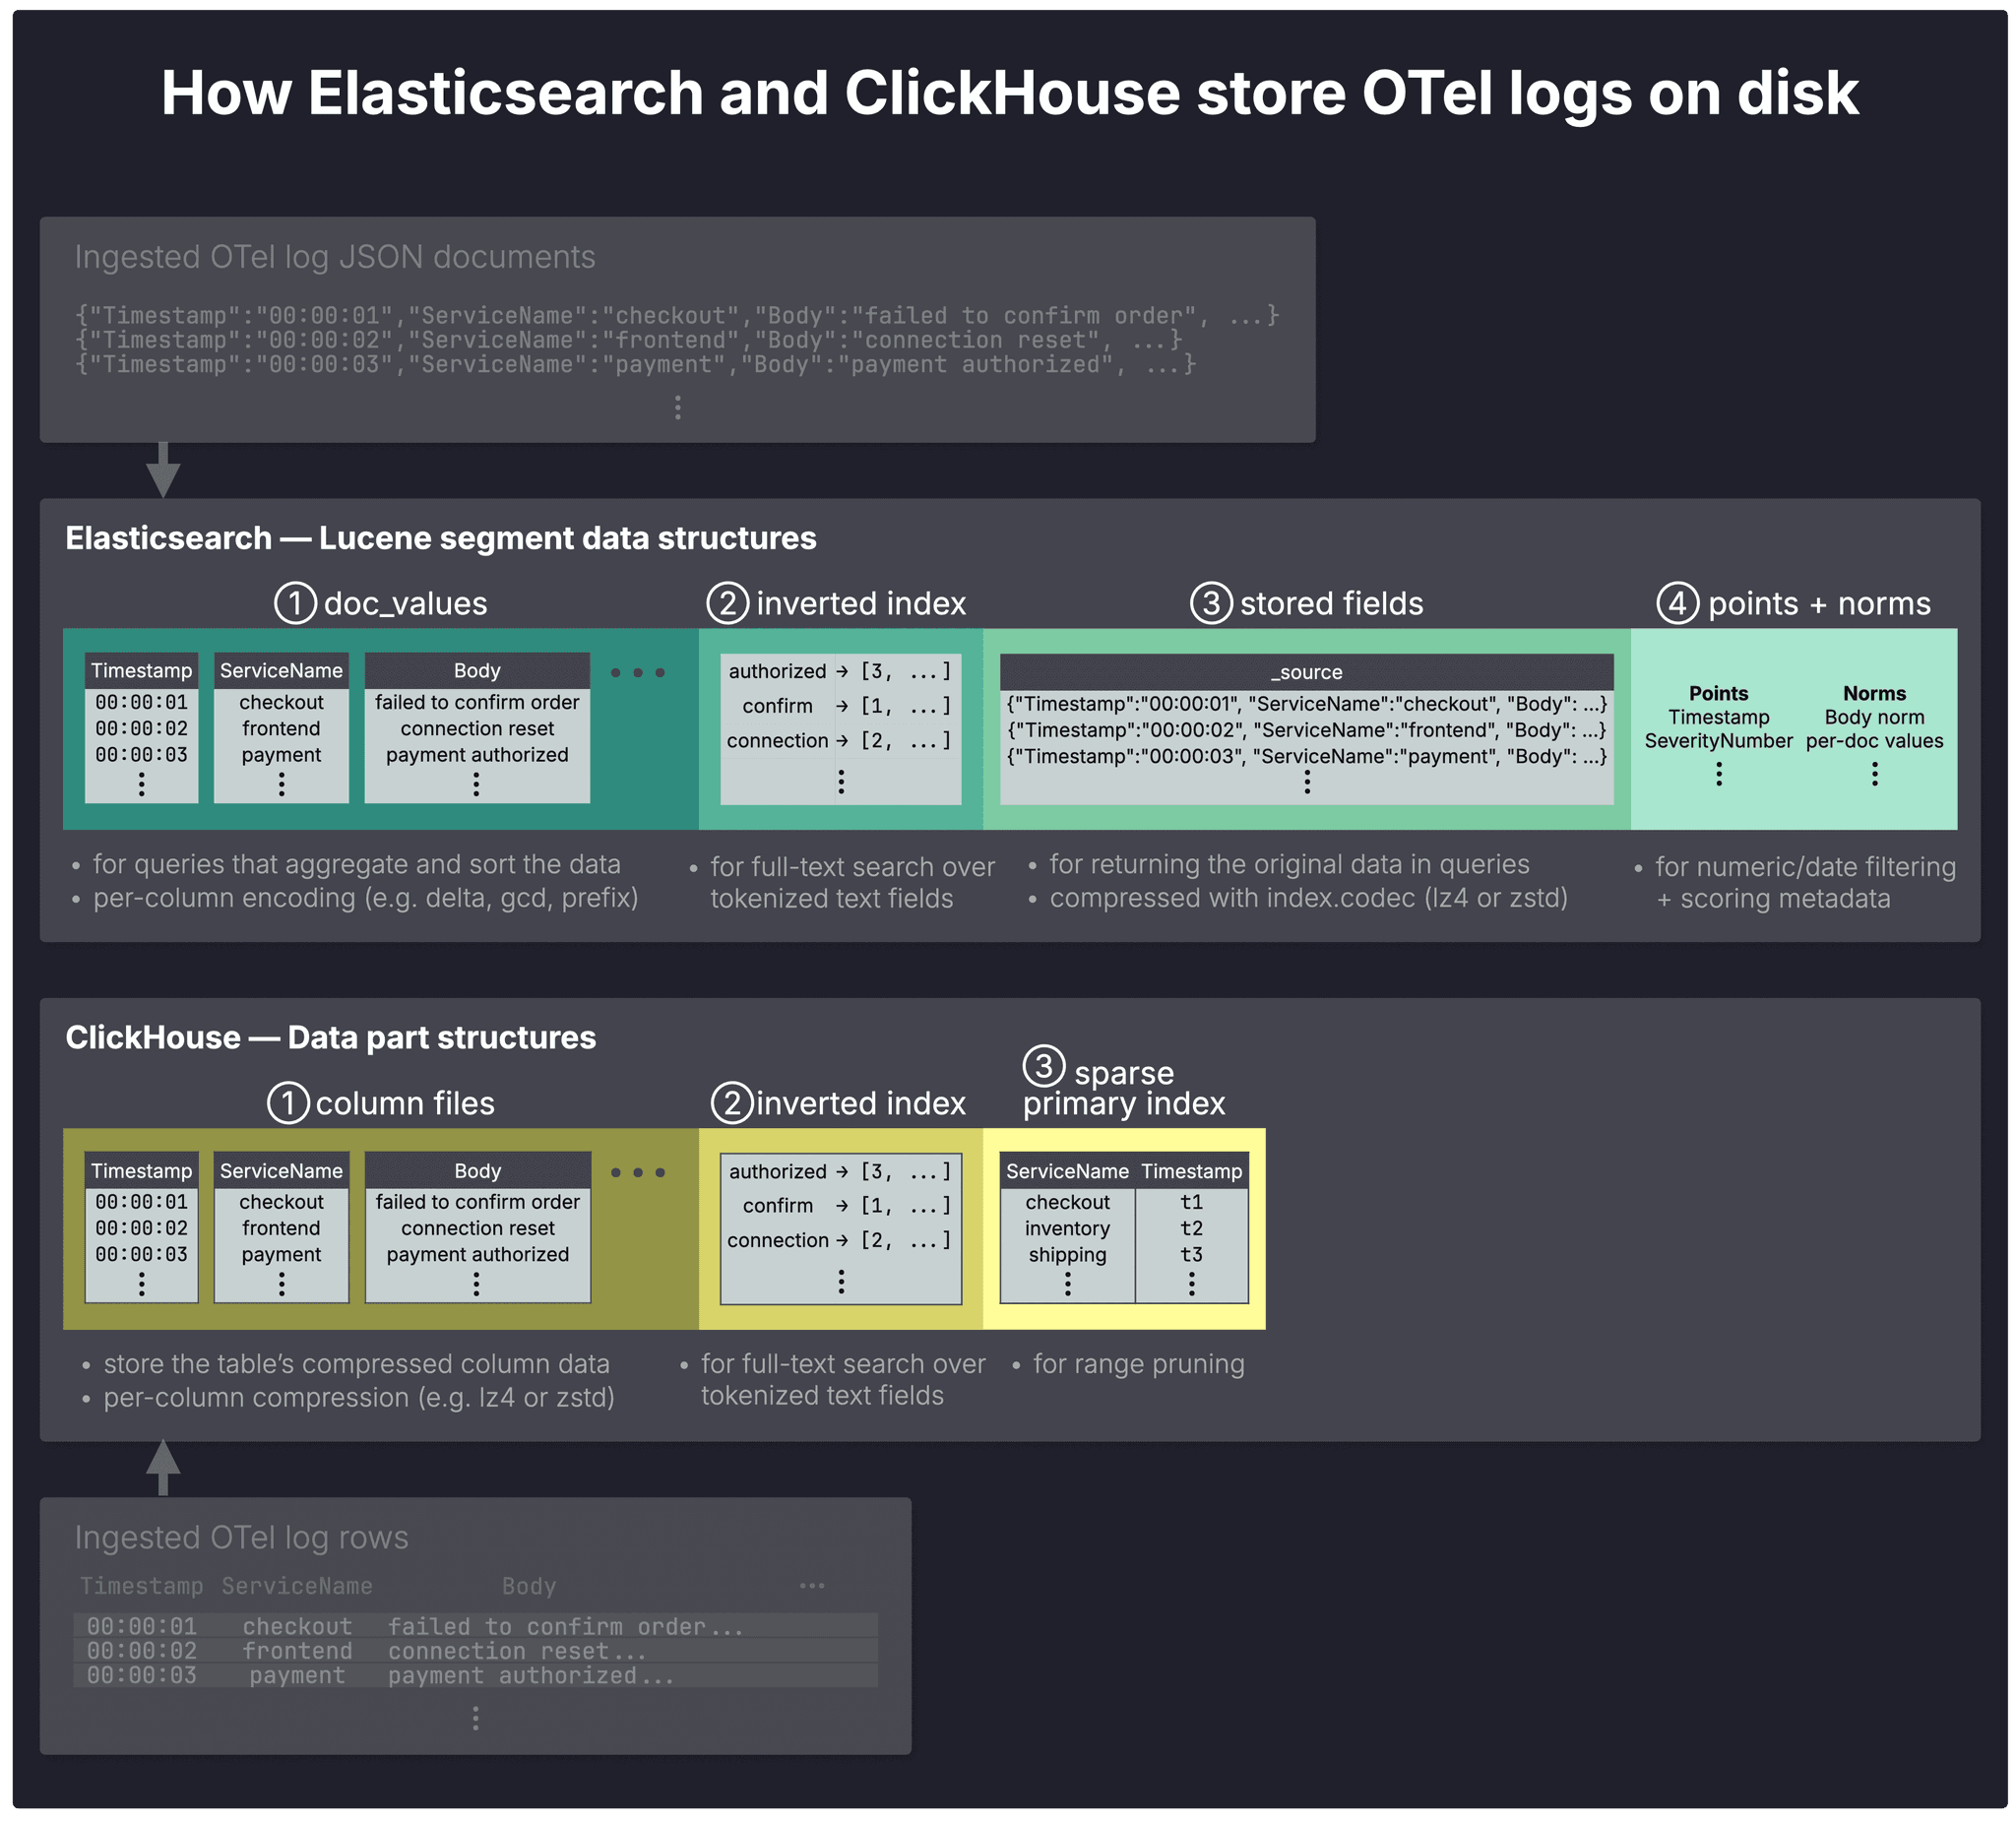
どちらのシステムでも、取り込まれた OTel ログデータは最終的に、変更不可能なディスク上の単位へ書き込まれます。
- Elasticsearch では Lucene セグメント
- ClickHouse ではデータパート
これらの単位は論理的にはシャード (図には示していません) に属し、バックグラウンドで継続的にマージされて、より大きな単位になります。セグメントは通常およそ 5 GB、パートはおよそ 150 GB まで成長しますが、どちらのシステムでも強制的なマージでさらに大きくすることは可能です。
Elasticsearch ではシャードがインデックスを構成します (こちらで説明しています)。ClickHouse のシャードはこちらで説明しています。
これらのディスク上の単位の中で、両システムはデータを専用の構造へ整理しています。その主な目的は 4 つあります。高速な集計、全文検索、元のドキュメントの返却、クエリ実行時の不要データのプルーニングです。
高速な集計のための列指向ストレージ
両システムは① 列指向ストレージを使っています。集計クエリは参照する列だけを読み、連続したデータに対してベクトル化 (SIMD) 演算を実行します。列ごとの圧縮によって、走査するバイト数も減ります。
Elasticsearch の doc_values では、各列がデータ型とカーディナリティに応じて、delta や gcd のような専用コーデックで個別に自動的にエンコードされます。ただし、lz4 や zstd のような汎用圧縮アルゴリズムは適用されません。
ClickHouse でも、圧縮コーデックは**列ファイル**ごとに適用されます。ClickHouse は汎用 (lz4、zstd など)、特殊 (delta、gcd など)、暗号化 (AES_128 など) の各コーデックに対応しており、列ごとに連結することもできます。
全文検索のための転置インデックス
両システムは、全文検索の基本データ構造として**② 転置インデックス**を使っています。
Stored fields と _source
Elasticsearch の ③ stored fields は、クエリ応答で元のフィールド値を返すためのドキュメントストアとして機能します。既定では、取り込んだ元の JSON ドキュメントを含む _source もここに保存されます。stored fields は index.codec 設定で定義したアルゴリズムで圧縮されます。既定は lz4 で、性能を犠牲にして圧縮率を高めるなら zstd です。
ログにとって _source が重要な理由
ログ分析では、取り込んだ元のドキュメントを返すことがしばしば不可欠です。そのため Elasticsearch OSS では、_source を避けることが実質的に難しくなります。Enterprise ティアでは代わりに synthetic _source を使えます。
ClickHouse には、これに相当する別個の構造はありません。元の行は、列ファイルに保存された値から直接再構築されます。
プルーニングのためのスパースインデックス
ClickHouse はスパースインデックスを使います。OTel ログレコードはディスク上にソート順で保存されているため、エンジンはそれらをブロックにまとめ、各ブロックの値の範囲を**③ スパースな主キーインデックス**に記録し、要求された範囲から完全に外れるブロックをスキップできます。
Lucene にもソート済みデータに対する同種のスパースインデックス機能がありますが、Elasticsearch は今回の比較に使った _disk_usage の出力で、それを独立したストレージ区分としては公開していません。
また、Elasticsearch では転置インデックスが全文検索だけに使われるわけではない点にも注意してください。Body 以外のすべての文字列フィールドには keyword 型を使い、Timestamp は date 型、数値フィールドは数値型です。これらの型はいずれも既定で転置インデックスにも値を登録し、完全一致フィルタに使います。値は解析されず、そのまま索引付けされます。つまり、これらのフィールドに対するフィルタは転置インデックスで効率的に解決できます。今回の比較では、この転置インデックスが ClickHouse のスパースな主キーインデックスに最も近い対応物です。
フィルタリングとスコアリングのための points と norms
Elasticsearch では、④ points が数値フィールドと日付フィールドに対する効率的なフィルタリングと範囲クエリを支え、norms はドキュメントごとに、テキストの関連度を算出するためのスコアリング係数を保持します。
ClickHouse は points に相当する別個の構造を使いません。数値と日付のフィルタリングは、列のスキャンに、スパースな主キーインデックスとスキッピングインデックスを組み合わせて処理します。また ClickHouse は現時点で全文検索の結果にスコアを付けませんが、今回のロギングのユースケースには関係ありません。
ストレージの構成要素が明らかになったので、次はそれらを合わせたディスク使用量への影響を見ます。
OTel ログのストレージ使用量
上記のストレージ構造を見れば、容量がどこに使われているかがわかります。全体の使用量を公平に比較するため、ディスク使用量に最も影響する主要な変数をまず揃えました。
-
同じディスク上の順序: データは同じキーでディスク上にソートされています。ClickHouse ではソートキー (ServiceName, Timestamp)、Elasticsearch では同じフィールドに対するインデックスソートです。
-
同じ圧縮アルゴリズム: 元のログ内容を保存する主要な構造には同じ圧縮アルゴリズムを使います。ClickHouse の列ファイルは ZSTD、Elasticsearch の stored fields も ZSTD です。
-
同じ全文転置インデックスの範囲: 両システムとも、全文転置インデックスは Body フィールドにだけ構築します。Elasticsearch では、その他の文字列フィールドはすべて keyword としてマッピングしており、完全一致フィルタには対応しますが、全文検索のための解析は行いません。
最後に、前述のとおり、この比較ではストレージ最適化した単一ノード構成を使っています。両システムともレプリカなし、ClickHouse は 1 シャード、Elasticsearch は最適なシャードサイズのベストプラクティス (シャードあたり 50GB) に従った複数シャードで、シャードあたり 1 セグメントにフォースマージ済みです。
これを踏まえて、次のチャートは 1B、10B、50B の OTel ログレコードを保存したときの両システムのストレージ使用量を示します。
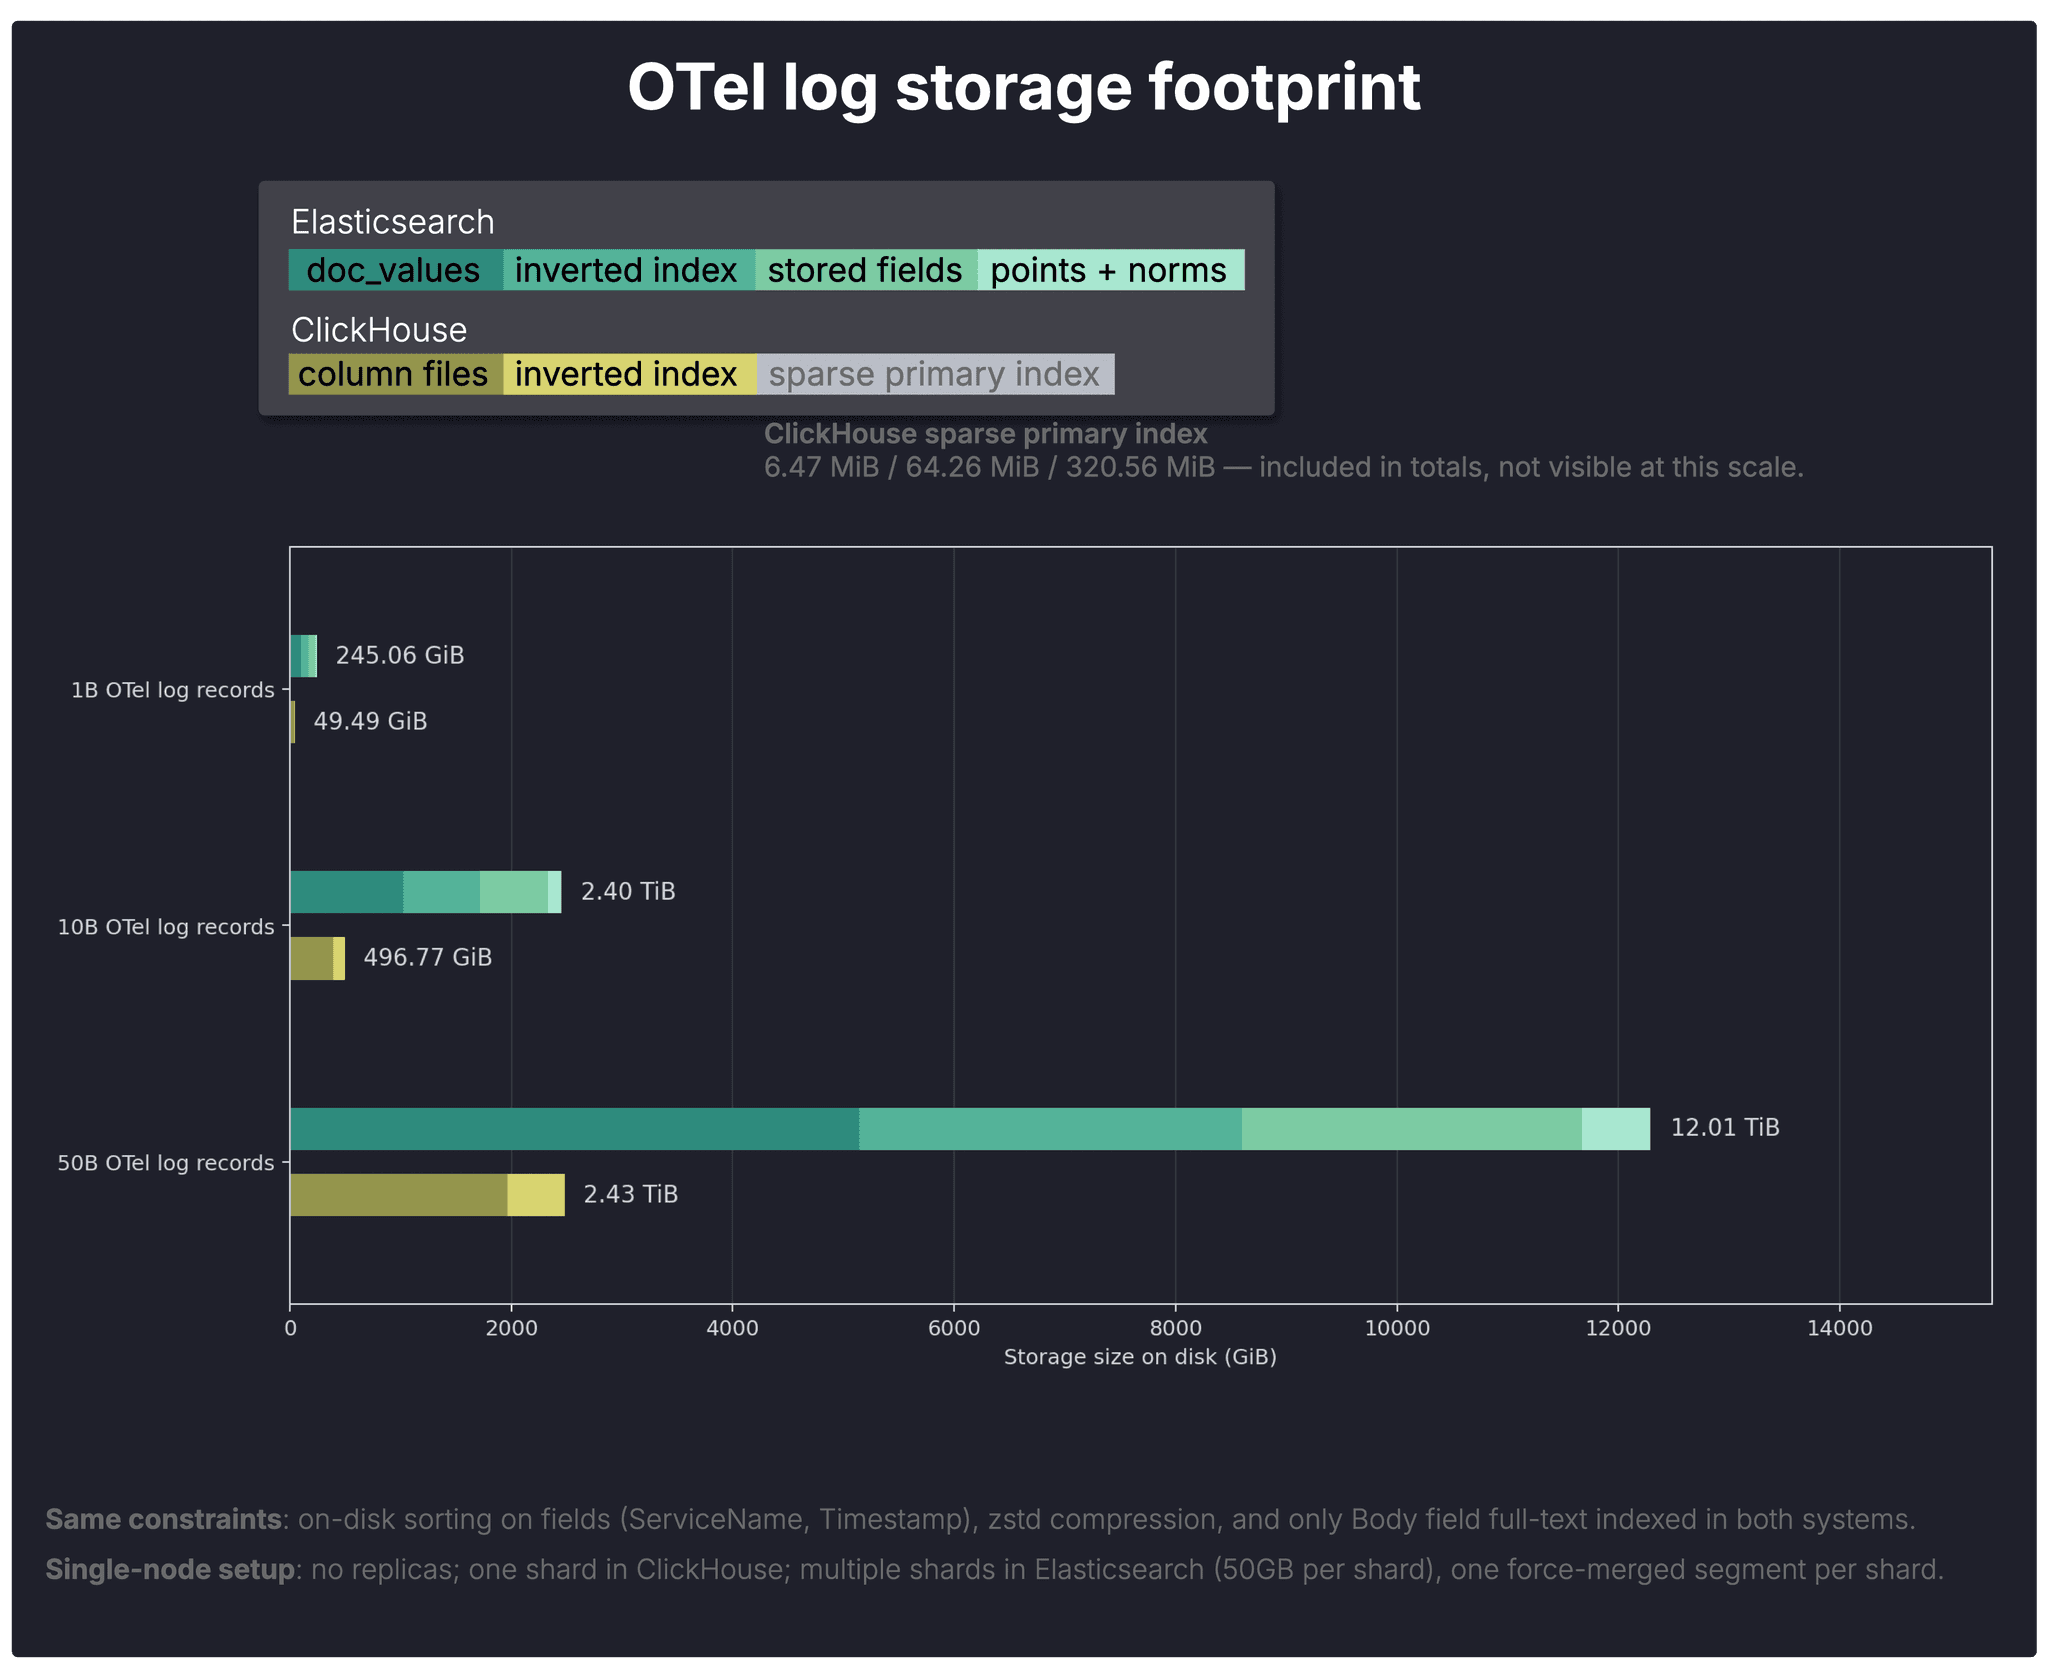
合計を読み取りやすくするため、チャートでは前のセクションで紹介したディスク上の個々のデータ構造に分解して示しています。凡例は、色分けした各セグメントが Elasticsearch と ClickHouse のどの構造に当たるかを示しています。元になるサイズは、Elasticsearch の _disk_usage API と ClickHouse の parts システムテーブルから取得しました。
注: ClickHouse のスパースな主キーインデックスは合計に含まれていますが、この縮尺では見えません (6.47 MiB / 64.26 MiB / 320.56 MiB)。
ストレージ使用量の全体
全体として、ClickHouse は同じ OTel ログデータを、Elasticsearch が必要とする容量のおよそ 5 分の 1 で保存します。
これは 3 つの規模すべてで一貫しています。
- 1B: ClickHouse 49.49 GiB 対 Elasticsearch 245.06 GiB → ClickHouse は 4.95 分の 1
- 10B: ClickHouse 496.84 GiB 対 Elasticsearch 2.40 TiB → ClickHouse は 4.95 分の 1
- 50B: ClickHouse 2.43 TiB 対 Elasticsearch 12.01 TiB → ClickHouse は 4.95 分の 1
列指向ストレージの使用量
主要な列指向ストレージ構造の段階で、すでに大きな差があります。Elasticsearch の doc_values だけでも、ClickHouse の列ファイルよりかなり多くの容量を占めます。
- 1B: ClickHouse 39.33 GiB 対 Elasticsearch 102.49 GiB → ClickHouse は 2.61 分の 1
- 10B: ClickHouse 393.54 GiB 対 Elasticsearch 1.00 TiB → ClickHouse は 2.61 分の 1
- 50B: ClickHouse 1.92 TiB 対 Elasticsearch 5.02 TiB → ClickHouse は 2.61 分の 1
注目すべき点として、ClickHouse は OTel ログの全フィールドを列ファイルに含めていますが、データセットで最大のフィールドである Body は、text としてマッピングされているため Elasticsearch の doc_values からは除外され、転置インデックスにだけ登録されます。
ClickHouse の圧縮効率
ここから、ストレージ全体の差の主因がすでに見えてきます。ClickHouse は列ファイルを非常によく圧縮します。
- 1B: 非圧縮 642.42 GiB → 圧縮後 39.33 GiB → 16.33 倍の圧縮
- 10B: 非圧縮 6.26 TiB → 圧縮後 393.54 GiB → 16.29 倍の圧縮
- 50B: 非圧縮 31.31 TiB → 圧縮後 1.92 TiB → 16.29 倍の圧縮
なお、データ型とディスク上の順序を圧縮向けに最適化すれば、さらに高い圧縮率も可能です。nginx ログの例では、ClickHouse は最大 178 倍の圧縮に達しています。
データ構造別のストレージ内訳
次の表は、両システムと 3 つの規模すべてについて、構造ごとのディスク使用量をまとめたものです。
| 規模 | システム | ディスク合計 | 列指向ストア | 転置インデックス | Stored fields | Points + norms | スパースな主キーインデックス |
|---|---|---|---|---|---|---|---|
| 1B | Elasticsearch | 245.06 GiB | 102.49 GiB (doc_values) | 68.37 GiB | 61.54 GiB | 12.36 GiB | — |
| 1B | ClickHouse | 49.49 GiB | 39.33 GiB | 10.15 GiB | — | — | 6.47 MiB |
| 10B | Elasticsearch | 2.40 TiB | 1.00 TiB (doc_values) | 690.12 GiB | 616.18 GiB | 123.62 GiB | — |
| 10B | ClickHouse | 496.84 GiB | 393.54 GiB | 103.24 GiB | — | — | 64.26 MiB |
| 50B | Elasticsearch | 12.01 TiB | 5.02 TiB (doc_values) | 3.37 TiB | 3.00 TiB | 617.55 GiB | — |
| 50B | ClickHouse | 2.43 TiB | 1.92 TiB | 515.78 GiB | — | — | 320.56 MiB |
Elasticsearch のストレージ使用量が大きい理由
Elasticsearch のインデックスが大きいのは、フレーズクエリ、あいまい一致、ワイルドカード検索、ランキング関連のメタデータといった、より広い検索機能を反映している面があります。今回のベンチマークのような典型的な OTel ログ分析クエリは、一般にこれらに依存しません。
それがここでのストレージ消費にどれほど影響するかを確かめるため、機能を削減した Elasticsearch の構成でも測定しました。
中程度の構成では、norms を無効化し (norms パラメータを false に設定)、主要な Body テキストフィールドをドキュメントのみのポスティングに縮小しました (index_options を docs に設定)。それでも合計使用量は約 2% しか減りませんでした。
より大きな削減 (ディスク上で約 20% 縮小、それでも ClickHouse の 4 倍) を得るには、さらに多くのフィールドで索引付けをはるかに積極的に無効化する (index パラメータを false に設定) 必要がありました。その結果、構成は典型的な Elasticsearch のログデプロイからは離れたものになります。たとえば、私たちのクエリスイートが参照する少数のフィールドを除き、大半の OTel フィールドでフィルタリングが大幅に遅くなります。
どちらの場合も、クエリ実行時間の合計はわずかにしか変わりませんでした。Query DSL と ESQL それぞれのホットおよびコールド実行時間の追加チャートは、GitHub リポジトリのこちらにあります。
ストレージの削減にとどまらない効果
ストレージ使用量が小さいことで、大規模なログ分析において ClickHouse は Elasticsearch に対していくつかの利点を得ます。
- ストレージコストの低減。 同じ OTel ログデータをはるかに小さな容量で保存できるため、大量のログをオンラインに保持するコストが直接下がります。
- クエリ I/O の削減。 ディスク上のバイト数が少なければ、スキャン、フィルタリング、集計で読むデータも少なくなります。これは次のセクションで示す実行時間の改善の一因でもあります。
- 取り込みの余力の拡大。 ディスク上の構造が小さいほどストレージサブシステムへの負荷が減り、現代のオブザーバビリティパイプラインでは典型的な、持続的な書き込みスループットを受け止める余力が増えます。これは、500 億行のロードが ClickHouse ではるかに速く完了したという前述の取り込み時の観察とも整合します。
この効果は、ClickHouse OSS がネイティブの MergeTree エンジンで S3 バックエンドのストレージを標準で利用できることで、さらに増幅されます。大量の生ログをオンラインに保持することが、実質的にずっと経済的になります。
OTel ログのクエリ実行時間
まずコールド実行の合計を見て、次にクエリ別の内訳からその理由を説明します。最後にホット実行を調べ、データがキャッシュされると状況がどう変わるかを確認します。
コールド実行時間の合計
次のチャートは、1B、10B、50B のレコードを保存したデータセットに対する、OTel ログクエリスイート全体のコールド実行時間の合計です。
念のため繰り返すと、このスイートは Kibana や ClickStack のようなツールでの典型的なログ分析ワークロードを反映しており、インシデント、エラー、トレンドを調査するために全文検索を集計やフィルタリングと組み合わせています。
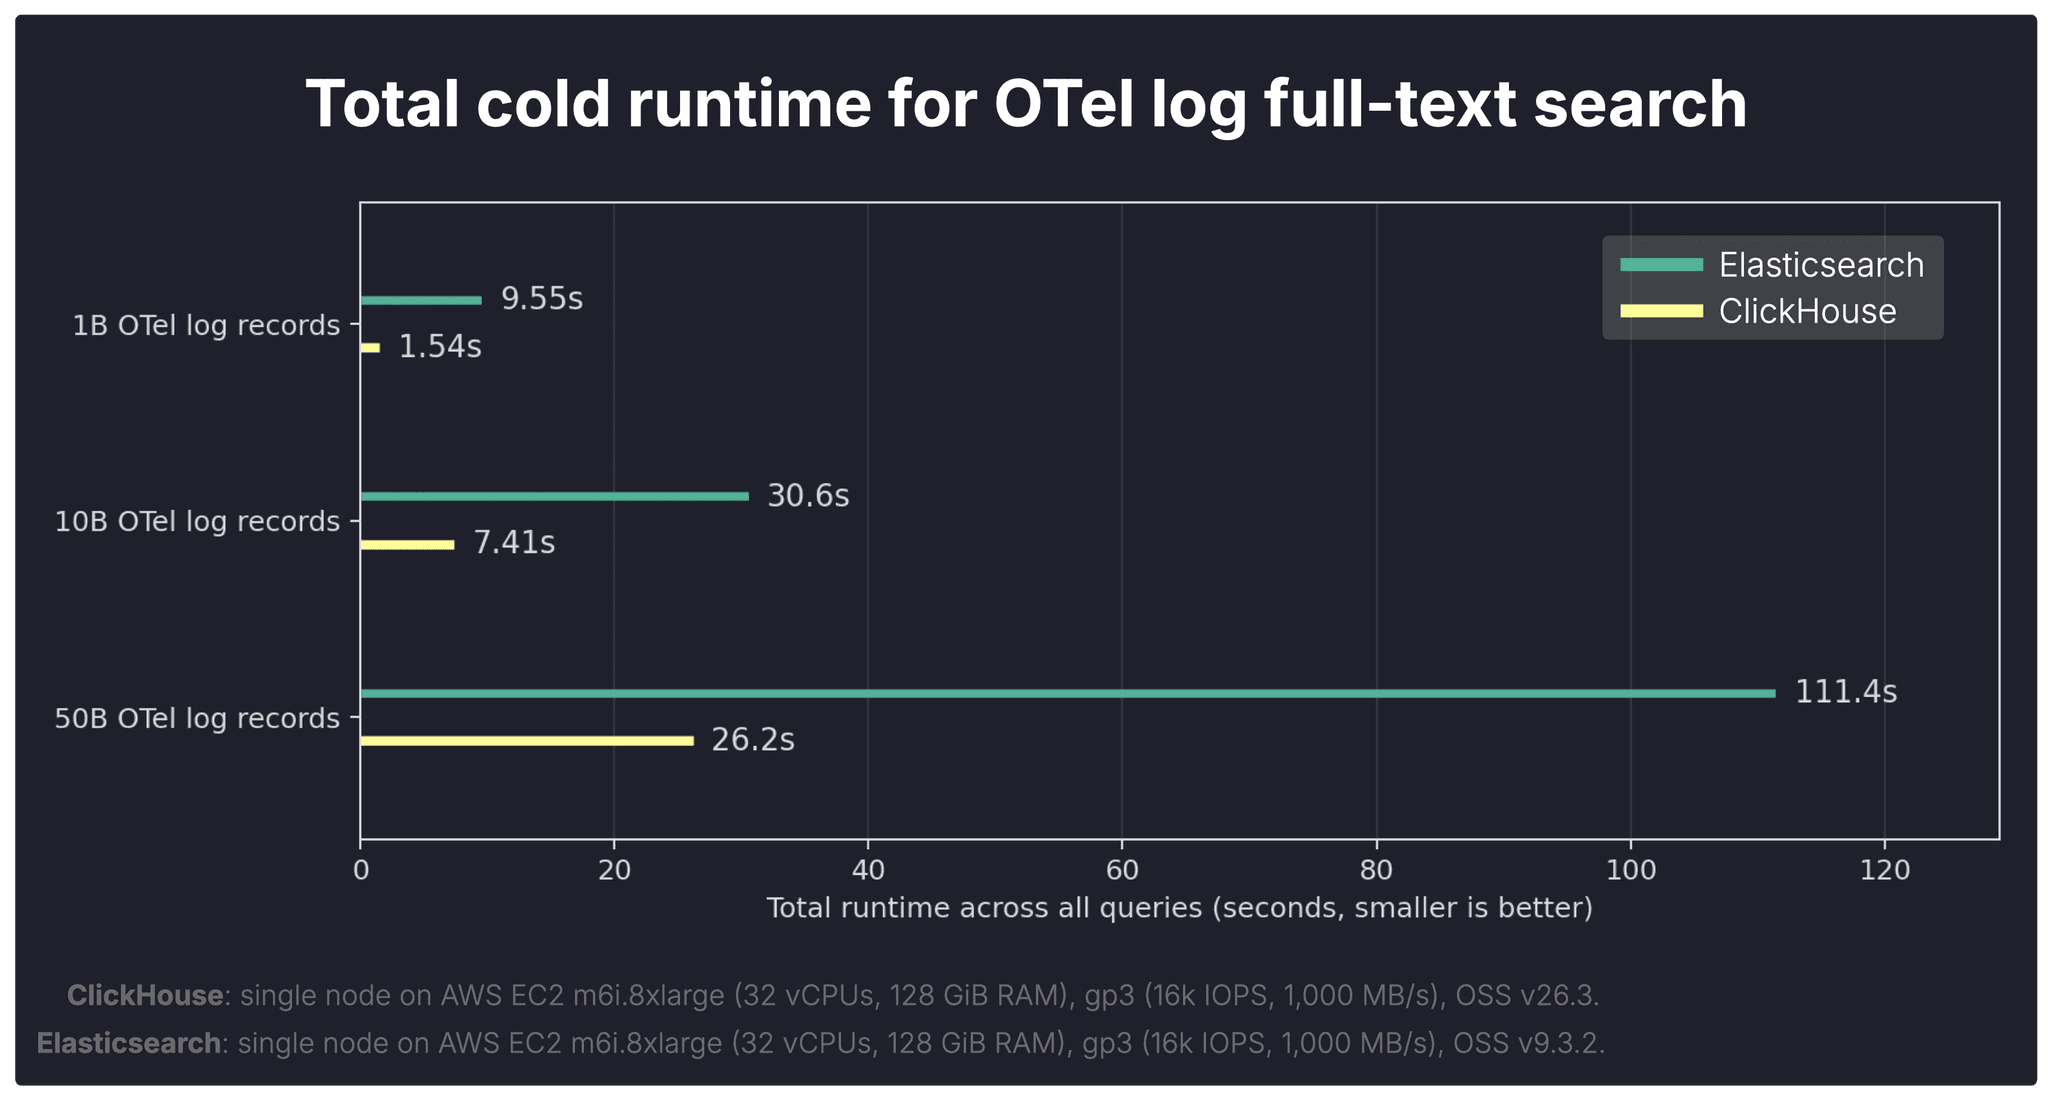
前述のとおり、コールド実行では両システムを完全に停止し、Linux ページキャッシュを破棄し、システムを再起動してから、クエリを実行しました。これは、データが何もキャッシュされておらず、エンジンが必要なデータをディスクからロードしなければならないときの実行時間を反映します。
OTel ログクエリスイートの各クエリをこのコールドスタート条件で実行し、上のチャートはクエリごとの実行時間を合計したものです。
オブザーバビリティにおいて、コールドなクエリは例外的なケースではありません。
エンジニアは、新たに発生したインシデントを調査したり、それまで見ていなかった時間範囲へ移動したり、保持している古いログを検索したりします。そうした状況では、キャッシュが温まっていることを前提にできません。
全体として、ClickHouse は 3 つの規模すべてで、コールドのクエリスイート全体を Elasticsearch よりかなり速く完了しました。
- 1B: ClickHouse 1.54s 対 Elasticsearch 9.55s → ClickHouse が 6.20 倍高速
- 10B: ClickHouse 7.41s 対 Elasticsearch 30.6s → ClickHouse が 4.13 倍高速
- 50B: ClickHouse 26.2s 対 Elasticsearch 111.4s → ClickHouse が 4.25 倍高速
次の問いは、その差がどこから来るかです。そこで、合計をクエリの種類ごとに分解します。
クエリ別のコールド実行時間: ClickHouse が最も差を広げる場所
クエリ別の内訳を見ると、ClickHouse のコールド実行での最大の利得は、全文検索によるフィルタリングと、その後段の重い集計処理を組み合わせたクエリで現れています。
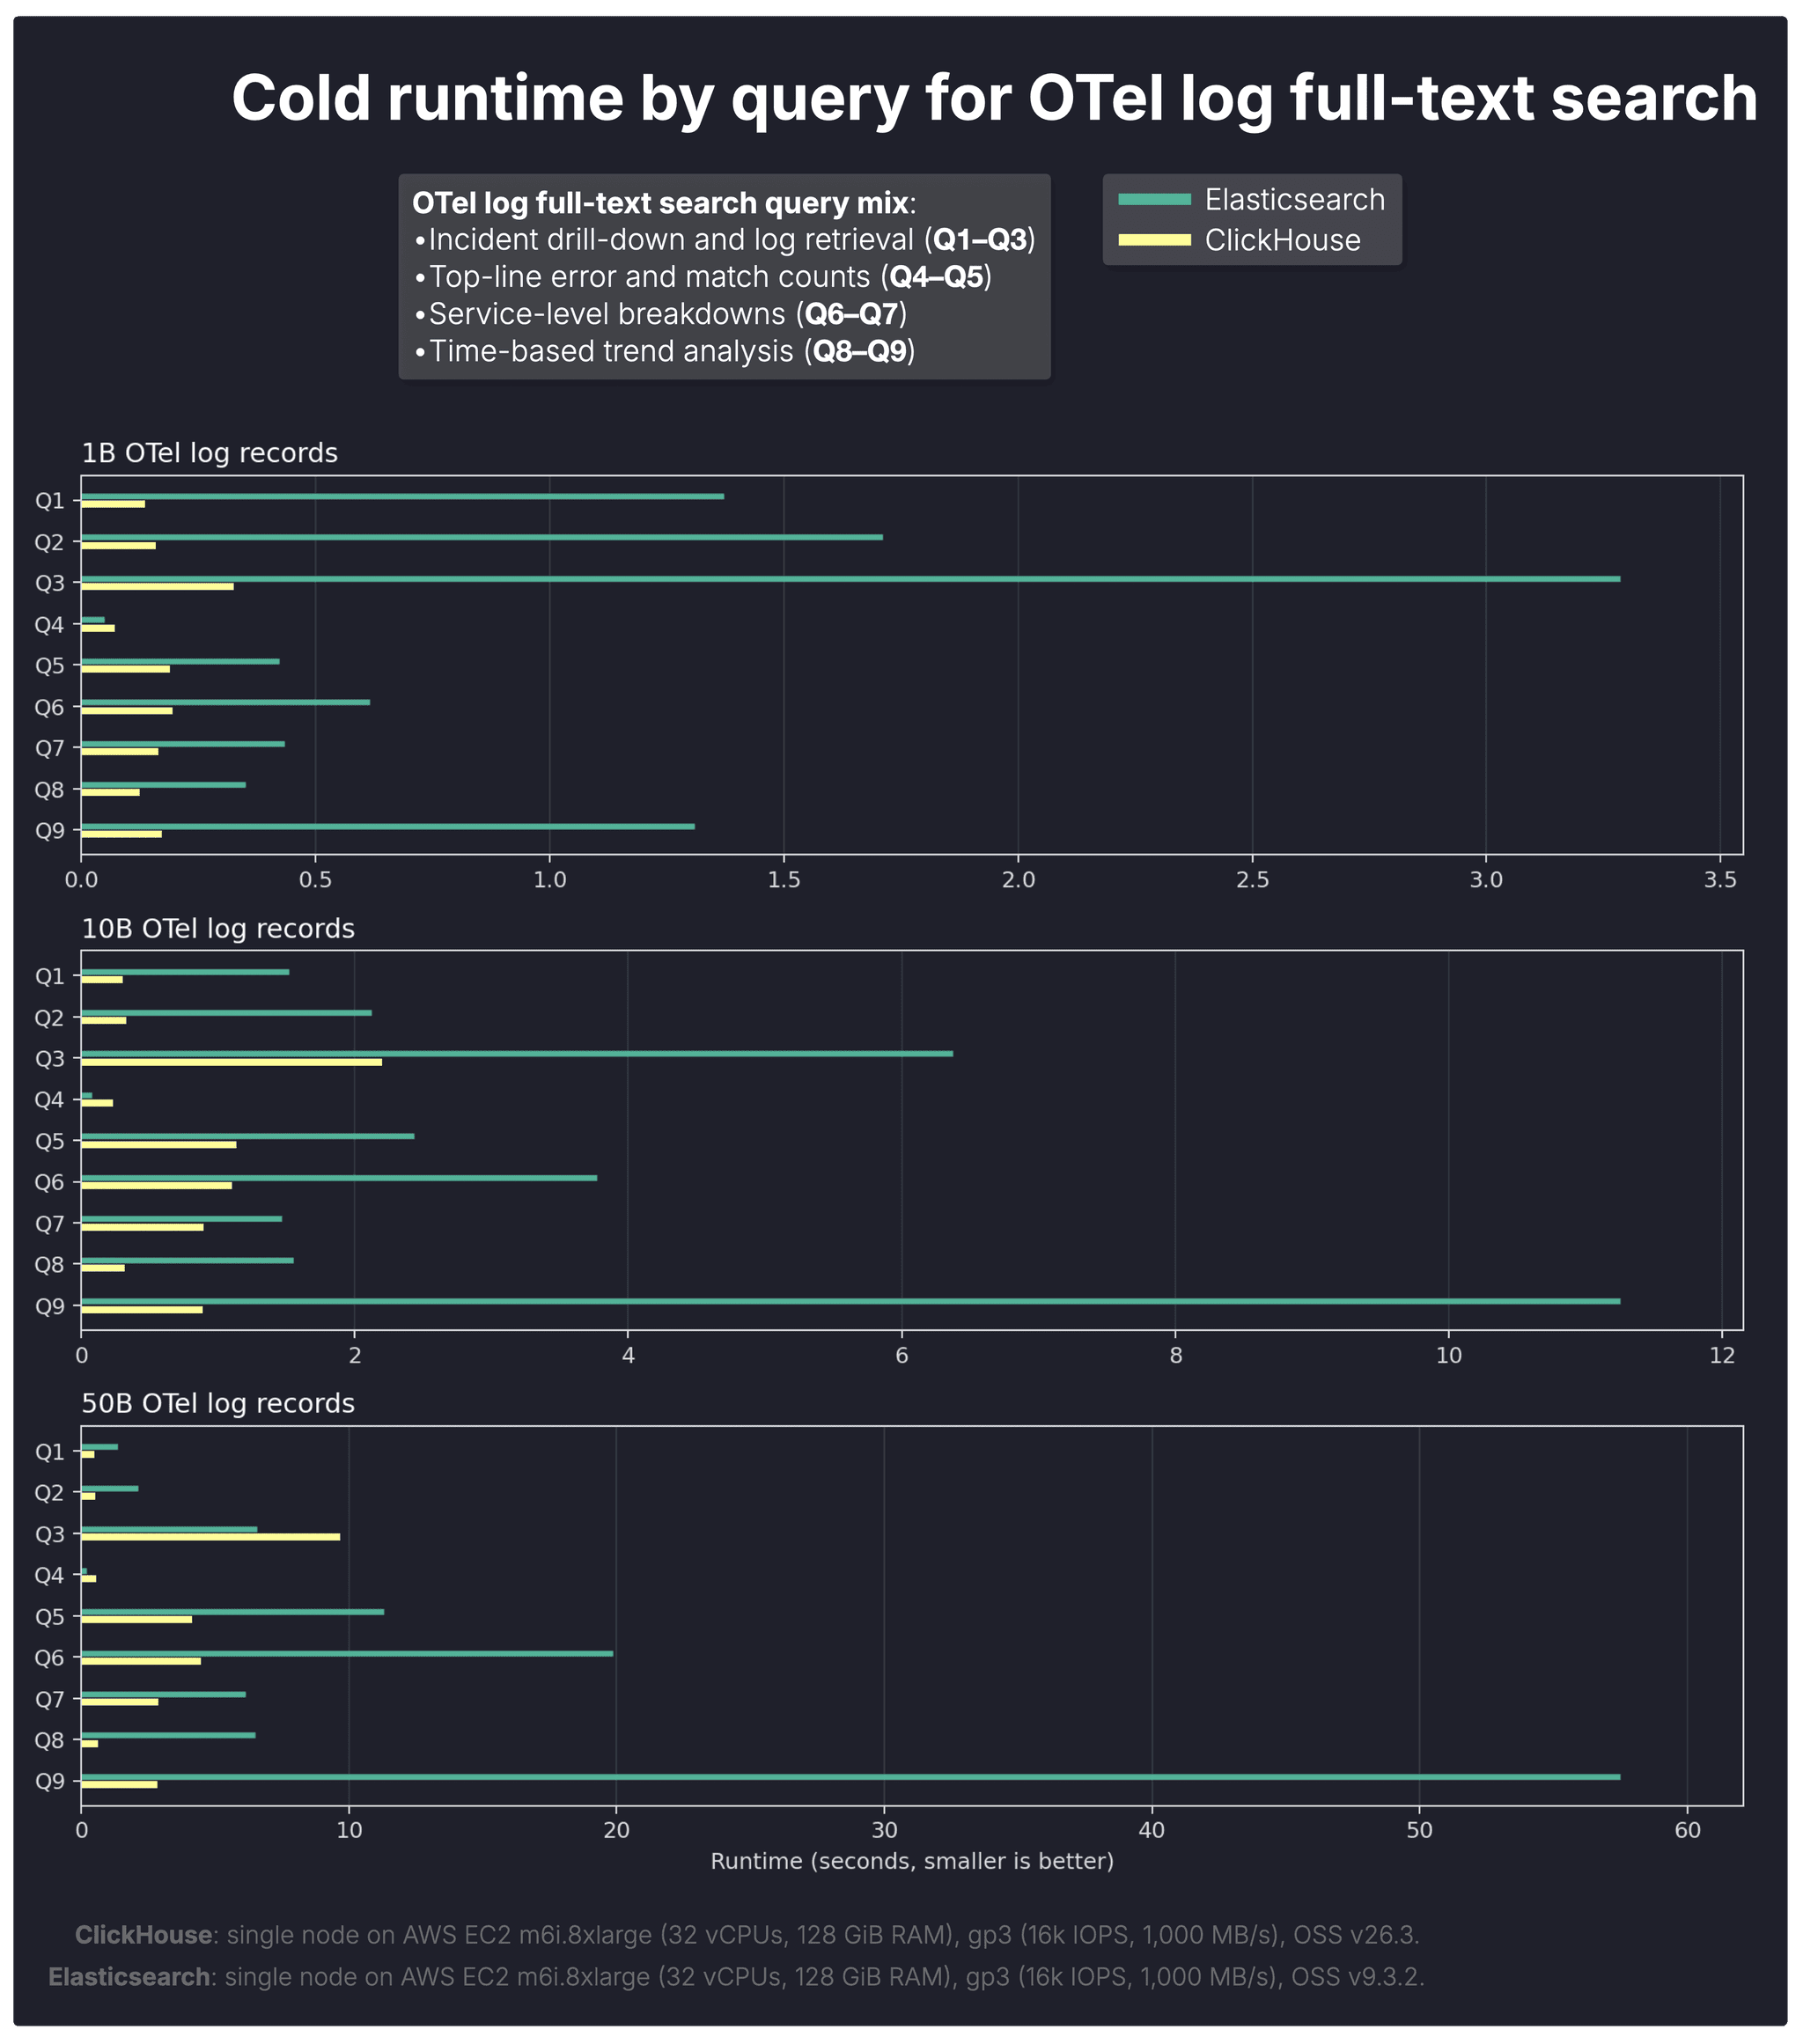
全体として、典型的なログ分析クエリのように、ワークロードが純粋な取得から「検索 + 分析」へ移るほど、ClickHouse の優位は大きくなります。
-
Q8〜Q9 のトレンド分析クエリは、大規模になると最も大きな差を示します。多数のマッチした行を時間バケットにグループ化して数える必要があるためです。
-
Q6〜Q7 のサービス内訳クエリも規模に応じて差が大きく広がります。大きな結果セットを多数のグループに分けて集計する処理を反映しています。
-
Q1〜Q3 のインシデントドリルダウンクエリは比較的差が小さいままです。取得寄りのクエリで、フィルタ後の集計が少ないためです。
これは、集計と JSON 分析に関する私たちの過去のベンチマークと一致します。そこでは ClickHouse が大規模な GROUP BY とカウントのワークロードで Elasticsearch を大幅に上回りました。同じ集計の強みが、テキストのマッチが見つかった後の処理でここでも表れています。
コールド実行は、ストレージ効率と素の実行速度を際立たせます。しかし、オブザーバビリティのワークロードには、温まったデータに対する繰り返しのクエリも含まれます。そこで次にホット実行時間を比較します。
ホット実行時間の合計
次のチャートは、1B、10B、50B のレコードを保存したデータセットに対する、OTel ログクエリスイート全体のホット実行時間の合計です。
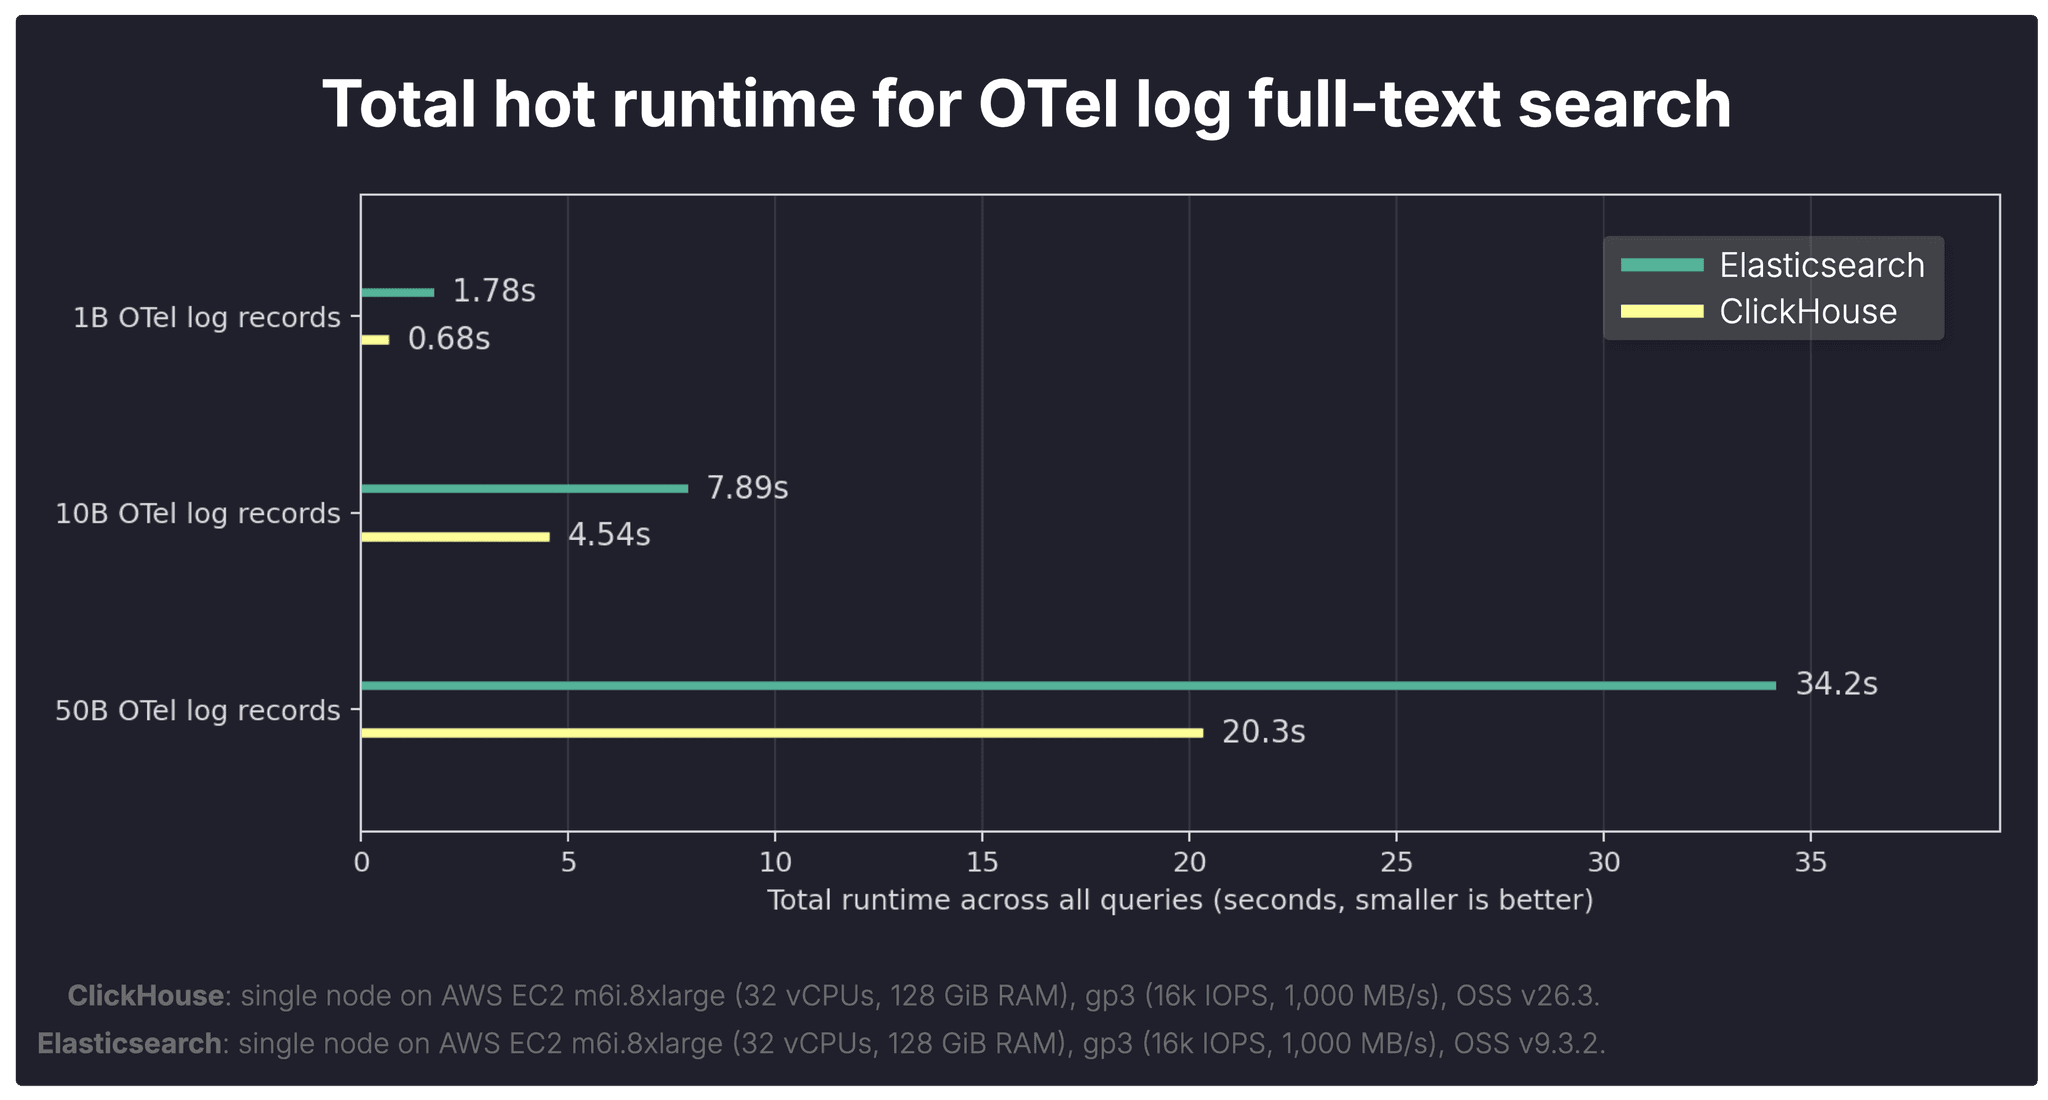
改めて確認すると、上のコールド実行と異なり、ホット実行では実行の間もシステムを稼働させたままにするため、Linux ページキャッシュが利用できます。各クエリについて同じクエリを連続で 3 回実行し、両システムでクエリ結果キャッシュは無効に、相当するフィルタ評価キャッシュは有効のままにしました。そして 3 回のうち最速の結果をホットの結果とします。
OTel ログクエリスイートの各クエリをこの条件で測定し、上のチャートはクエリごとの実行時間を合計したものです。
オブザーバビリティでは、ホットなクエリも重要です。
ダッシュボードは自動更新され、調査では似たフィルタが繰り返し実行され、対話的なドリルダウンでは同じワーキングセットを何度も参照します。
キャッシュが温まると差は縮まりますが、それでも ClickHouse はすべての規模でクエリスイート全体を Elasticsearch より速く完了しています。
- 1B: ClickHouse 0.68s 対 Elasticsearch 1.78s → ClickHouse が 2.62 倍高速
- 10B: ClickHouse 4.54s 対 Elasticsearch 7.89s → ClickHouse が 1.74 倍高速
- 50B: ClickHouse 20.3s 対 Elasticsearch 34.2s → ClickHouse が 1.69 倍高速
理由を理解するため、ここでも結果をクエリの種類ごとに分解します。
クエリ別のホット実行時間: キャッシュは差を縮めるが、一様ではない
キャッシュが温まると一部のクエリでは差が目に見えて縮まりますが、クエリ別の内訳を見ると、キャッシュは両システムの実行モデルの根本的な違いを消し去るわけではありません。
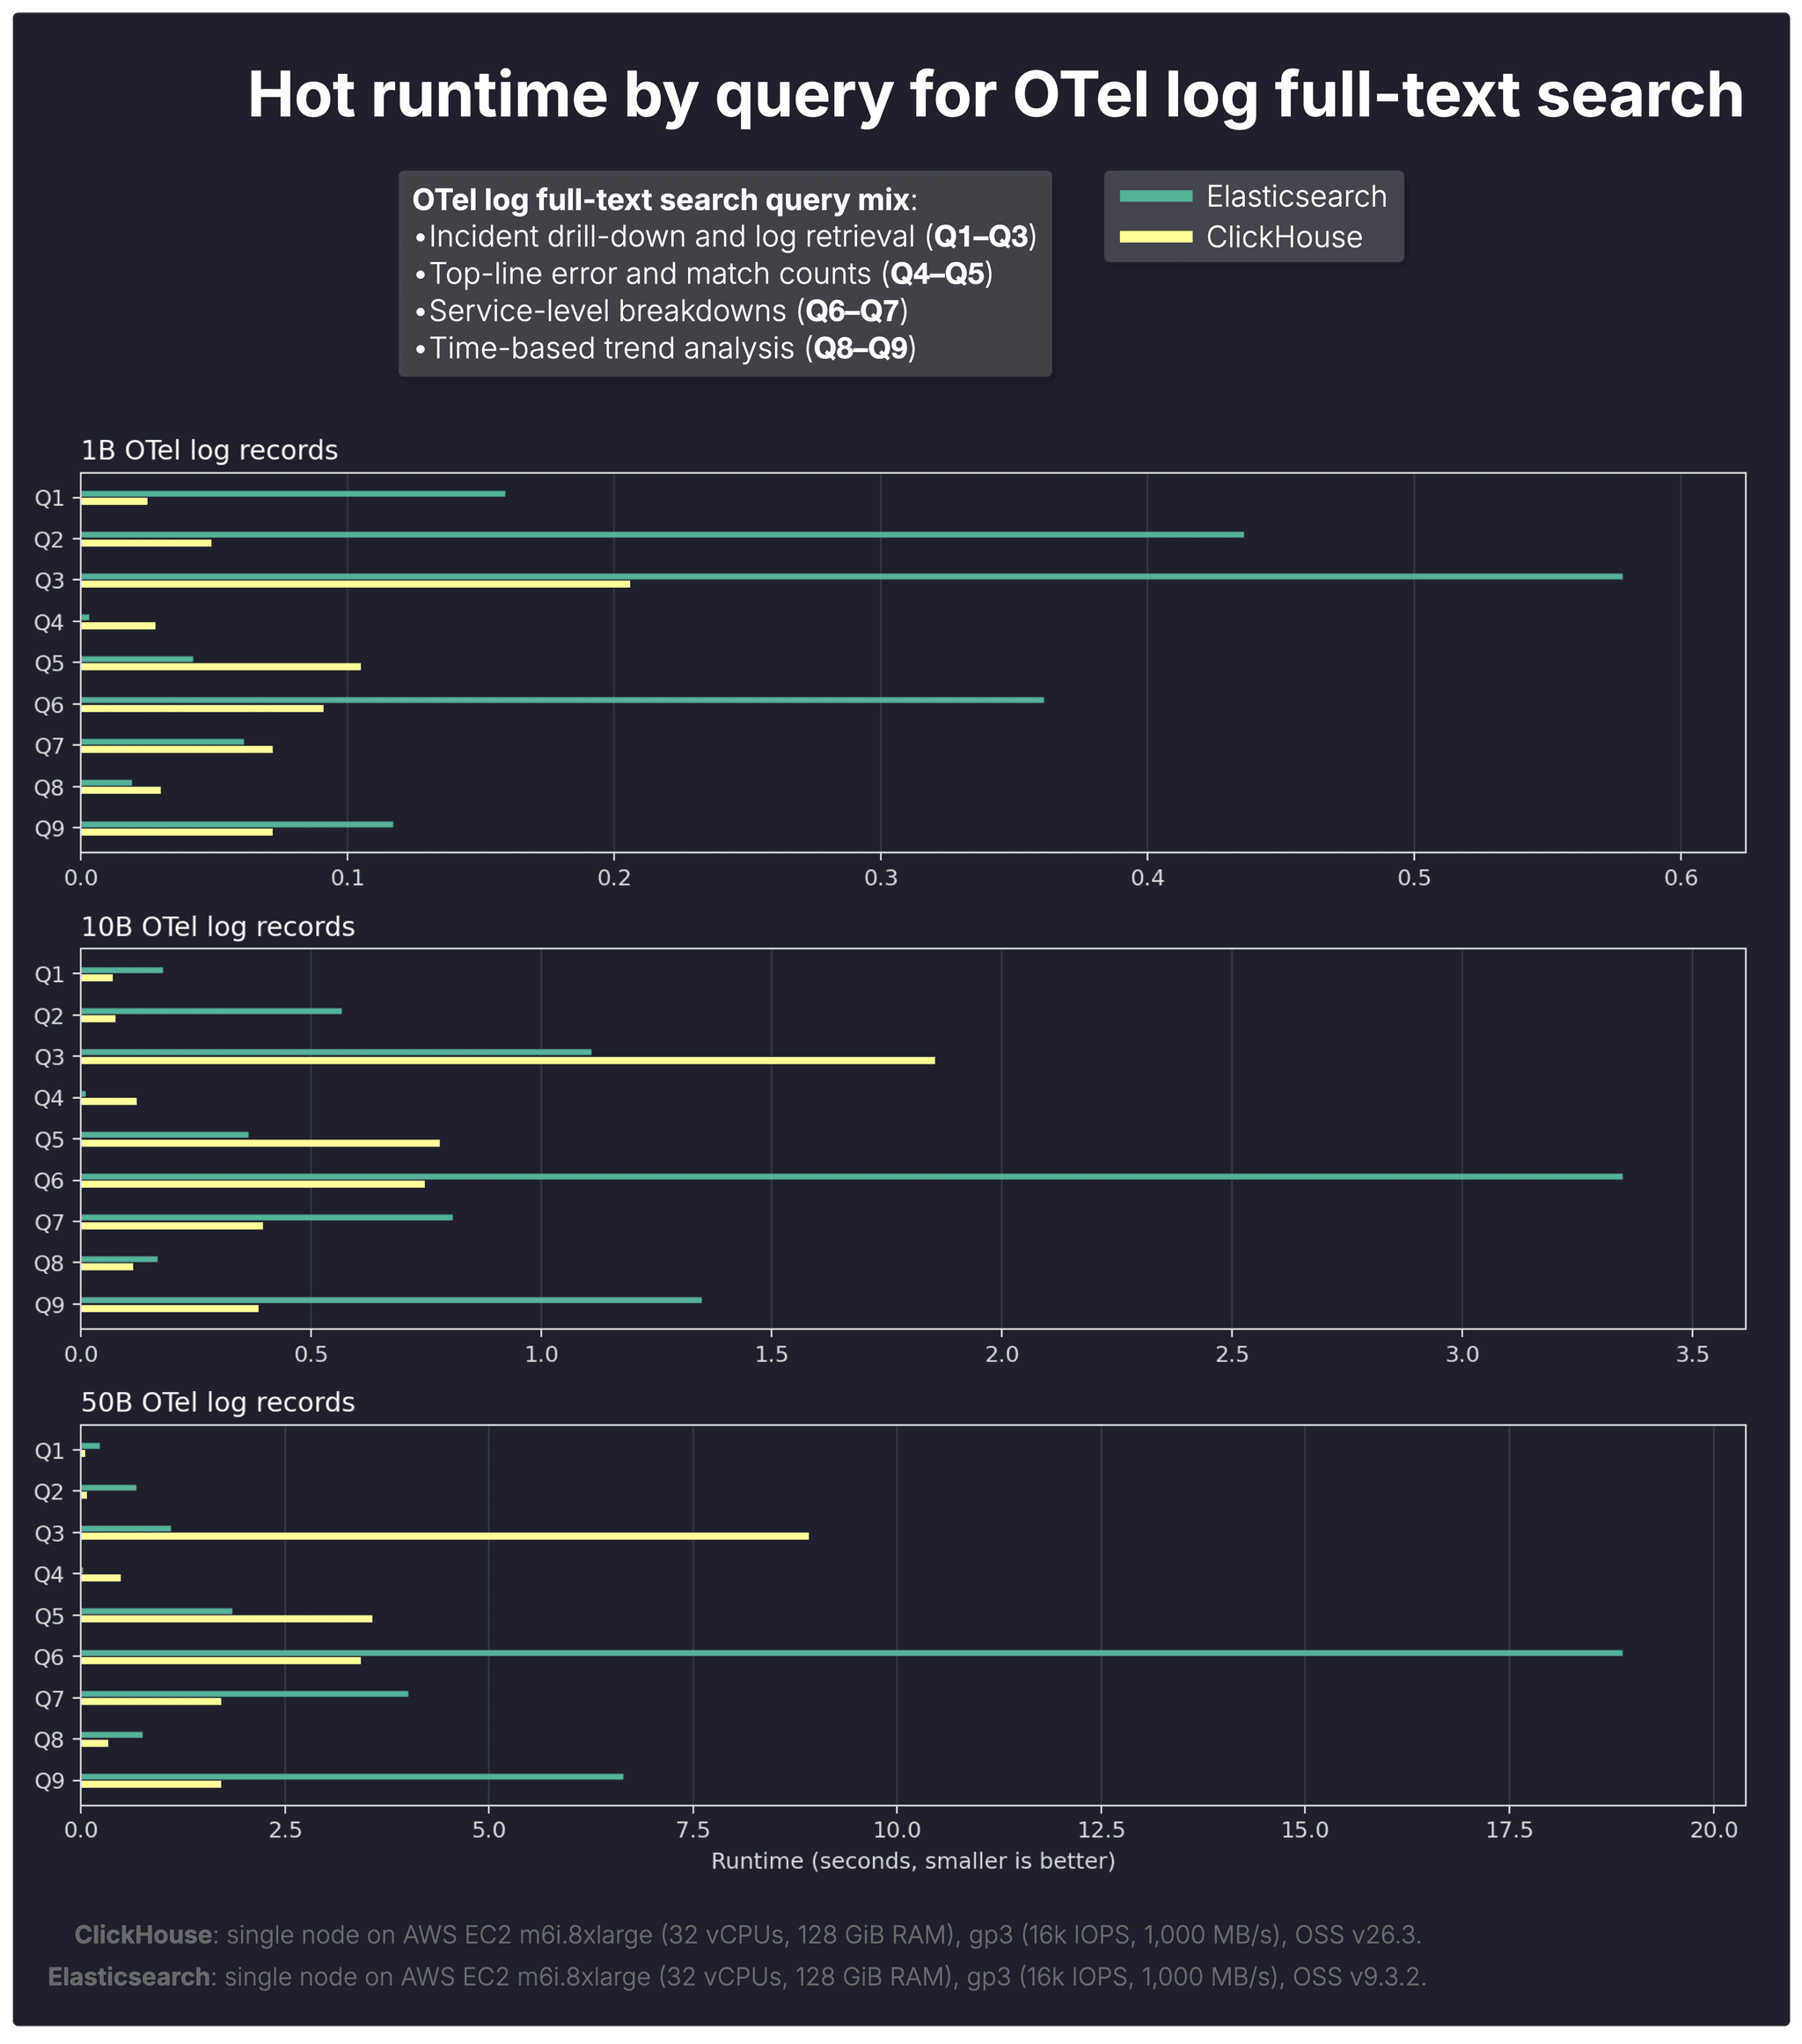
全体として、キャッシュは取得中心のクエリでは差を縮めますが、後段の集計が依然として支配的な「検索 + 分析」のワークロードでは縮めません。
- Q1〜Q3 のインシデントドリルダウンクエリはホット条件で差が縮まります。これは、両システムが述語評価のキャッシュの恩恵を受けていることと整合します。
とはいえ、これらの相当するキャッシュは粒度が同一ではありません。Elasticsearch は以前にフィルタにマッチしたドキュメントを記憶しますが、ClickHouse はフィルタ結果をグラニュール (行ブロック) の単位でキャッシュします。そのため ClickHouse はグラニュール全体を素早くスキップできますが、残ったグラニュールの中で実際にマッチする行を特定する処理は依然として必要です。
- Q6〜Q9 のサービス内訳とトレンド分析クエリでは、ClickHouse の優位が依然として明確で、とくに大規模で顕著です。これらのクエリは、マッチする行を特定した後の後段の集計に引き続き多くの時間を費やすためです。
Elasticsearch が細かい粒度のフィルタキャッシュから得るホット実行での優位も、規模が大きくなると弱まるように見えます。考えられる説明はキャッシュ圧の増大です。データが増え、異なるワーキングセットが増えるほど、ドキュメント単位でキャッシュしたフィルタ結果は保持されにくくなり、細かい粒度の実用上の利点が薄れます。
OSS の比較はここまでです。次に、同じワークロードのスケーリングを ClickHouse Cloud がどう簡単にするかを手短に見ます。
おまけ: ClickHouse Cloud で同じワークロードをスケールさせる
多くの分析ワークロードでは、マテリアライズドビューのような手法でデータを事前集計し、クエリが走査するデータ量を減らせます。
ログ分析は違います。
インシデント対応では、エンジニアは元の生イベントを必要とすることが多いのです。エラーメッセージを検索し、前後のログを確認し、影響を受けたホストを特定し、結果をサービス別に分解し、新しいフィルタで何度も切り口を変えます。そのため、積極的な事前集計は従来の BI ワークロードに比べてはるかに役立ちにくくなります。
生データをクエリしなければならないなら、速くするための現実的な方法は単純です。コンピュートを追加することです。
ClickHouse Cloud ではコンピュートがストレージから分離されているため、追加のレプリカノード (データではなくコンピュートを複製) は、事前にデータを再配置することなく即座に参加できます。すべてのノードは同じ共有オブジェクトストレージから読み取ります。
参加するノードが増えるほど、同じクエリをより多くのマシンへ分散でき、実行時間が短くなります。次のチャートは、500 億行のクエリスイートでの効果を示します。
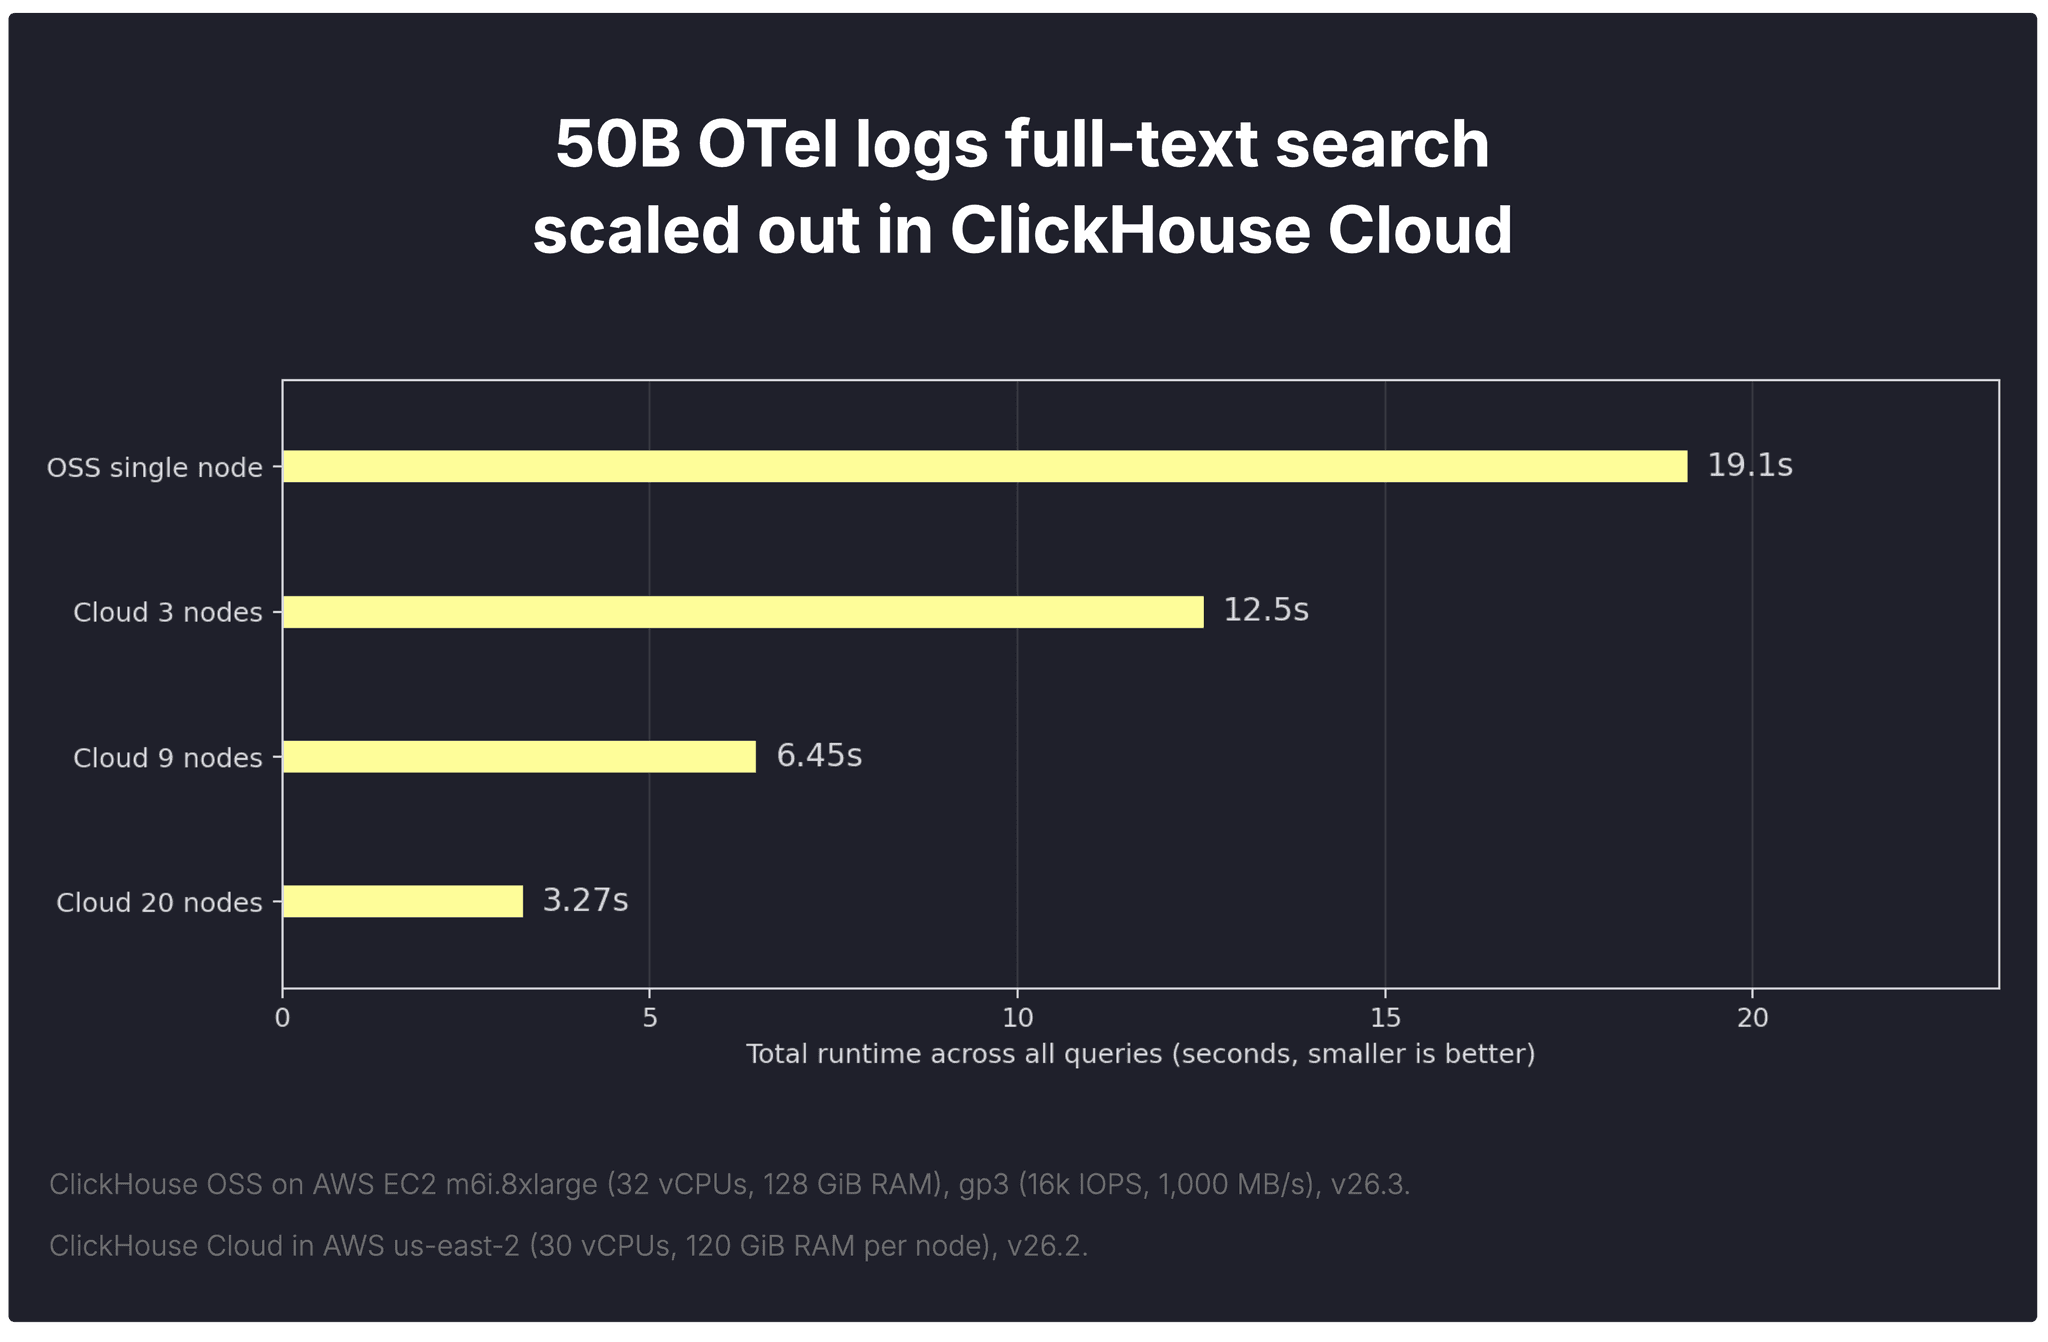
OSS 単一ノードのベースライン (19.1s) と比べて、同じワークロードは 3 ノードで 12.5s、9 ノードで 6.45s、20 ノードで 3.27s まで短縮されます。実用上は、ログの検索と分析がはるかに対話的に感じられるようになります。人が ClickStack のダッシュボードを探索する場合でも、エージェントがループでログをクエリする場合でも同じです。
これはインデックスシャーディングでさらに強力になります。ストレージのセクションで示したとおり、500 億件の OTel データセットの全文インデックスは、すでに約 0.5 TiB (515.78 GiB) あります。インデックスシャーディングは、並列レプリカがデータの読み取りを分散するのと同じように、このインデックスの解析をレプリカ群に分散します。
500 億行のテーブルで、ClickHouse は全文インデックスの解析で 5.8 倍の高速化を測定しました。
Cloud のスケールアウトはおまけです。それがなくても、単一ノードの OSS ベンチマークだけで話は明確です。
全体像
このベンチマークで全体像が完成しました。ClickHouse はまず集計で、次に JSON 分析で Elasticsearch を上回り、いまや全文検索を伴う分析検索でも上回りました。
ClickHouse は検索をこなし、世界最高水準の集計エンジンもそのまま維持しています
ClickHouse の全文検索は分析とオブザーバビリティのために設計されており、数十億から数兆行に対して、集計を伴う高速な複数トークン検索を実現します。
このベンチマークがそれを裏付けています。最大 500 億行の現実的な OpenTelemetry ログワークロードにわたって、ClickHouse は一貫して総合的に優れた結果を出しました。
-
はるかに小さいストレージ使用量: ディスク容量はおよそ 5 分の 1で、ストレージコストの低減、クエリ I/O の削減、持続的な取り込みの余力につながります。
-
はるかに速いコールドクエリ: ディスクからデータを読む必要がある場合に 4〜6 倍高速です。オブザーバビリティではコールドなクエリが日常的なので、これは重要です。
-
より速いホットクエリ: キャッシュが温まった状態でもおよそ 1.7〜2.6 倍高速で、ダッシュボード、ドリルダウン、繰り返しの分析の応答性を保ちます。
差が最も大きかったのは、テキスト検索とグループ化、カウント、時系列の内訳を組み合わせたワークロードでした。
オブザーバビリティでは、検索がクエリの終点であることはまれです。
そこで ClickHouse が差を広げます。
本番環境で使いたいチームには、Managed ClickStack が高速なログ検索と高速な分析を、マネージドのオブザーバビリティスタック 1 つで提供します。
Managed ClickStack を試すオブザーバビリティは強力なユースケースの一例です。もっと遊び心のある例として、100 億件超の GitHub イベントを対象にした ClickHouse 全文検索の対話的デモ GitTrends をお試しください。