5万

概要
- LinkedInのオブザーバビリティチームは、まず分散トレースで実績を確認した上で、トレースに加えてメトリクスのメタデータ探索と分析をClickHouse上で運用しています。
- 1%のヘッドサンプリングであっても、そのシステムは1日あたり約0.8兆スパン、200 TBの非圧縮データを生成します。
- メトリクスメタデータインデックスは、3つのシステムを単一のClickHouseクラスターへと統合し、130億超のメトリクスに対して毎分15万件以上のクエリを平均レイテンシ68 msで処理しています。
- レガシースタックからの移行により、メモリ使用量は約5分の1に、コンピュートは約3分の2に削減され、メトリクス量を2倍にできる余力も確保されました。
世界中で 10 億人以上のメンバーを抱え、数千のサービスが連携して動いている LinkedIn では、フィードを 1 回読み込んだり求人を検索したりするだけでも数十ものバックエンドシステムとやり取りします。そのうちの 1 つでも速度が低下した場合、原因を特定するにはそのすべてを内部まで把握できなければなりません。
その可視化を担っているのが同社のオブザーバビリティチームです。ホスト、コンテナ、サービス、ストレージから、オンライン、ニアライン、オフラインのワークフロー、さらにはリアルユーザー監視に至るまで、プラットフォームの測定性を維持するフルスタックを管理しています。その上には取り込み、アラート、トリアージ、オンコール、可視化の各レイヤーも構築されています。このスタックは、メトリクス、ログ、トレース、イベント、プロファイル、例外など、あらゆる種類のオブザーバビリティシグナルを網羅しています。
LinkedIn の ClickHouse 活用は、2 年前の分散トレーシングから始まりました。Arun Gupta 氏が 2026年4月のサンフランシスコでの ClickHouse Meetup で詳しく語ったように、チームは 3 つのデータセンターにまたがって本番環境へ導入しました。1 日あたり約 8,000 億スパンを処理し、エンジニアにほぼリアルタイムのトラブルシューティング基盤を提供するシステムを構築したのです。「LinkedIn における ClickHouse の取り組みは、まだ始まったばかりです」と Arun 氏は当時述べていました。
Open House SF 2026 では、スタッフソフトウェアエンジニアの Jacob Zelek 氏がその話を引き継ぎ、LinkedIn のオブザーバビリティにおける次の一歩を紹介しました。レガシーなメトリクスメタデータシステムを単一の ClickHouse インデックスへ統合したことで、運用コストを削減し、従来のスタックでは対応できなかった問い合わせにも答えられるようになり、今後の拡張余力も十分に確保できたという経緯です。
LinkedIn と ClickHouse の最初のステップ
2024年、Arun 氏とチームは OpenTelemetry ベースの分散トレーシングシステムを本格展開していました。これはメンバーのアプリから関係するすべてのバックエンドサービスに至るまで、リクエストをエンドツーエンドで追跡するものです。ヘッドサンプリングを 1% に絞っても、このシステムは 1 日あたり約 8,000 億スパン、非圧縮データで 200 TB を生成します。書き込み側でこのデータ量に追従でき、読み取り側でも高速性を保てるストレージが必要でした。Arun 氏が言うように、「問題が発生したときや、エンジニアが追加機能のデバッグを行っているときには、社内アプリを使ってトレースの結果をすばやく確認できなければならない」からです。
このシステムに求められた目標として、エンドツーエンドの取り込みを 10 秒未満で完了させること、2 時間のウィンドウでのトレース一覧取得を P99 で 2.5 秒以内に返すこと、ID によるトレース全体の取得を 750 ミリ秒以下で完了させることが挙げられていました。また、7日間の保持ポリシー、階層型ストレージ、カスタマイズ可能なインデックス、クエリワークロードの分離 も求められました。さらに、どのソリューションを採用するにしても、LinkedIn で広く好まれているクエリ言語の 1 つである KQL に対応している必要がありました。
現在、このデプロイは 3 つのデータセンターにまたがっています。各データセンターは PubSub とインジェスター層からデータを受け取る 22 シャードの ClickHouse クラスターをそれぞれ備えています。チームはレッドブラック構成を採用しており、2 つのクラスターに書き込みを行い、読み取りは 1 つから行っています。1 つ目のクラスターに障害が発生した場合は 2 つ目が引き継げるように待機しており、3 つ目のクラスターは検証を担当しています。スキーマはフラット化され、スパン属性が併せて保持されており、分散テーブル上で 3 重のローカルレプリケーションを実行しています。圧縮率は約 5 倍です。定常状態では各ノードが毎秒 35 万スパンを取り込み、最大負荷時には毎秒 120 万スパンを超えます。
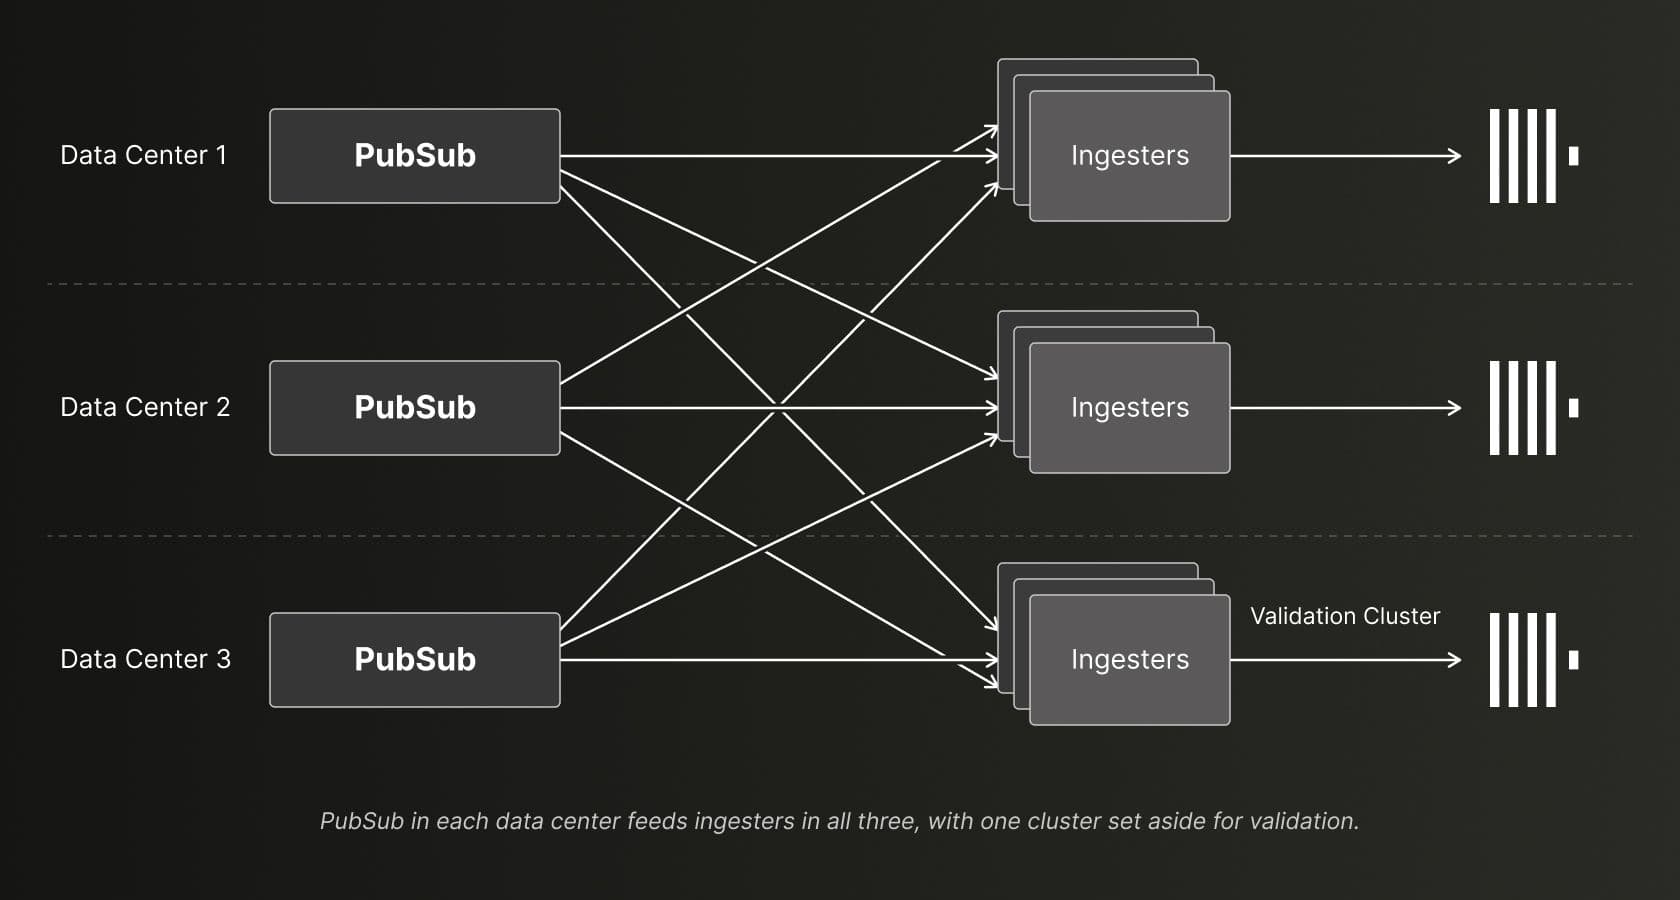
各データセンターの PubSub が 3 つのデータセンターすべてのインジェスターにデータを供給し、1 つのクラスターは検証用として確保されています。
チームはテーブルの並び順を変更して低カーディナリティのカラムを先頭に配置し、実際にクエリ対象となるフィールドで 再パーティショニング を実施しました。また、コストを抑えられるカラムについては Bloom フィルター の偽陽性率を厳格化し、クエリ実行時間を 2 秒未満へと短縮しました。「これは私たちにとって極めて大きな成果でした」と Arun 氏は述べています。
同様に重要だったのは、このプロジェクトによって ClickHouse が大規模な本番環境へ導入され、複数のチームがその運用に慣れることができた点です。この経験が弾みとなり、LinkedIn のオブザーバビリティチームは ClickHouse を分散トレーシングからメトリクスの検出と分析へと拡張していくことになります。
次の課題: レガシーなメトリクスメタデータ
以前、LinkedIn は RRDtool と呼ばれるレガシーな時系列データロギングおよびグラフ作成システムに依存していました。しかし、そこで導入された命名規則はその後も残り続け、LinkedIn の規模とサイズになってもそのまま使われ続けていました。
現在でも、このメトリクスは RRD(2 つから 6 つの標準化されたディメンションを連結した単一の文字列。例: 「my-server/responses.status.200.rrd」)によって参照されています。当初は単一のメトリクスを対象に指定できましたが、ある時点で複数のメトリクスにまたがって正規表現を適用し、1 つのグラフに複数の系列を生成したり、一致ごとに別々のグラフを生成したりする機能が導入されました。「これがなぜ問題になり始めるのかは想像がつくでしょう」と Jacob 氏は言います。
この問題は、LinkedIn の運用規模によってさらに深刻化しています。同社には RRD セマンティクスを用いて参照されているメトリクスが 130 億件以上存在し、日々約 30% が入れ替わっています。何百万ものグラフやアラートがこの方法で定義されており、数十ものツールやサービスが依然として RRD メトリクスにクエリを実行しています。その間にもメトリクス数は増加の一途をたどり、新しいツール、サービス、ユースケースが次々と追加されています。
LinkedIn のオブザーバビリティチームにとっての課題は、その全体にわたって検出と分析を行えるようにすることでした。たとえばエンジニアは、指定したメトリクスを出力しているホストはどれか、あるサービスがどの RRD を出力しているか、全サービスにわたって特定のパターンに一致するメトリクスはどれか、増加傾向を追跡するためにユニークなメトリクス数がどのように推移しているか、といった点を確認したい場合があります。「大きな問題は」と Jacob 氏は言います。「全員を完全に移行し終えるまで、ユーザーがこれらをクエリできるようにし続けなければならない点にありました」
従来のスタックは、単一のゲートウェイの背後にある 3 つの個別サービスへと肥大化していました。Jacob 氏が入社した時点では、カスタムのインメモリ検索インデックスとカスタムのインメモリ KV ストアが存在していました。後に彼は、すべてのクエリを処理して他のサービスを廃止できることを期待して Elasticsearch を導入しました。「残念ながら、それらのクエリを処理するためのサービスがもう 1 つ増えただけでした」と彼は振り返ります。Elasticsearch は広範囲にわたる大規模な集計処理が苦手で、大きな結果セットを返すにはメモリ上でシリアライズする必要があったためです。
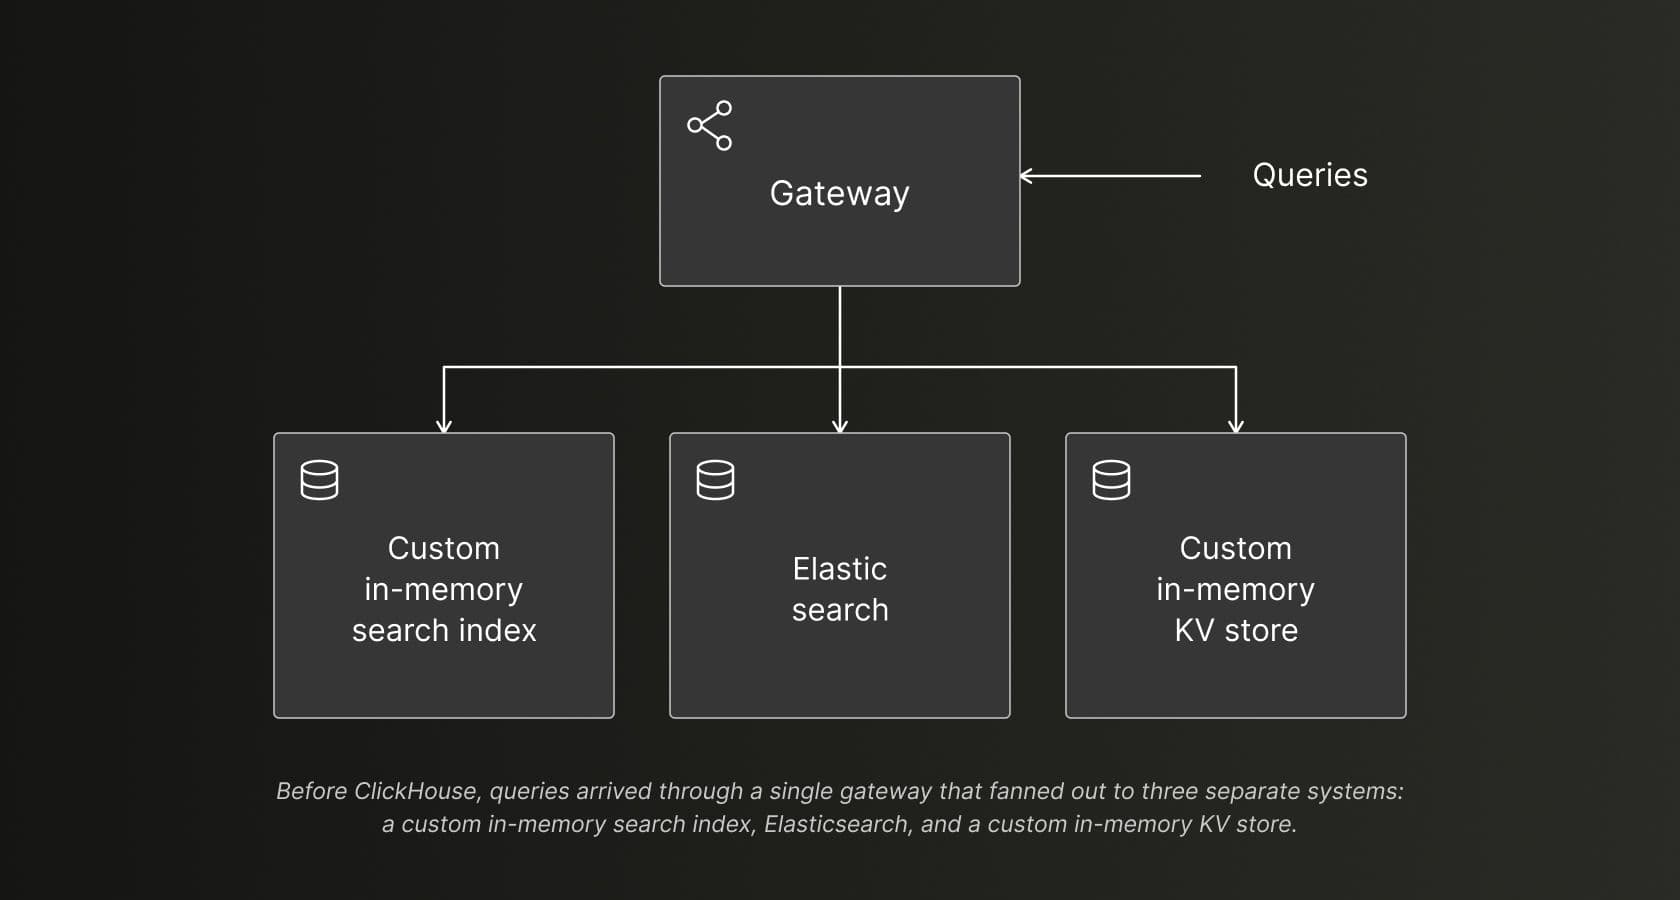
ClickHouse 導入前は、単一のゲートウェイからカスタムのインメモリ検索インデックス、Elasticsearch、カスタムのインメモリ KV ストアという 3 つの独立したシステムへクエリが振り分けられていました。
2025年までに既存の 3 つのサービスはすべてスケーリングの限界に達し、3 つの個別システムの管理は運用上の重荷となっていました。さらに、これらを合わせてもエンジニアが求めるクエリの一部には対応できませんでした。より優れたソリューションが必要とされていたのです。
LinkedIn における ClickHouse エコシステムの発展
チームはいくつかの選択肢を検討しました。さらにもう 1 つカスタムソリューションを構築する案は魅力的ではありませんでした。Jacob 氏が「汎用的なソリューションほど柔軟にはならず」、ノウハウも一握りの開発者に留まってしまうと話す通りです。「私たちはすでにそれを経験しており、その道へ再び進むつもりはありませんでした」と彼は付け加えます。
シャーディングされた MySQL の特性は把握されていましたが、好ましい理由からではありませんでした。過去に信頼できる情報源(Single Source of Truth)として Vitess を使用した際、読み取りをスケールできないことが判明していたためです。Elasticsearch はすでに手元にあり試行もされていましたが、トラフィックを移行する以前の試みは失敗に終わっており、探索目的でのみ手元に残されていました。
一方、ClickHouse は既存のすべてのクエリに対応していました。カスタムのインメモリデータベースと比較ベンチマークを実施したところ、大半のクエリが ClickHouse 上でより高速に動作し、遅いものでも十分に許容範囲内に収まりました。クォータとクエリログ機能により、各クエリを発行しているチームやサービスを特定できたため、Jacob 氏が言うように「過剰なクエリを停止させるだけでなく、それらのチームと協力してクエリを書き直し、効率を高めること」も可能になりました。あらゆるディメンションを保持する汎用 OLAP ストアとして機能するため、チームが思いつきもしなかった分析クエリを実行できるようになり、その中には既存のクエリをより効率的な形で置き換えるものもありました。
「トレーシングで ClickHouse を使用して得た知見のおかげで、新しいプロジェクトの立ち上げが非常に容易になりました。私たちは LinkedIn 内で ClickHouse のエコシステムを構築し始めています」— Jacob Zelek, Staff Software Engineer
「私たちにとって、利用者が離れつつある Elasticsearch のような別のシステムを導入したり、自チームしか理解できないカスタムシステムを構築しようとしたりするよりも、ClickHouse を拡張していくほうがずっと安心感がありました」と Jacob 氏は述べています。
レガシーメトリクスメタデータ向けの新 ClickHouse アーキテクチャ
現在のアーキテクチャは「極めてシンプル」だと Jacob 氏は言います。チームの時系列データベースから継続的な変更キャプチャシステムを通じて ClickHouse へデータが送られ、すべてのメタデータクエリを受け付けていたゲートウェイが、それらのクエリを SQL に書き換えて ClickHouse に対して実行します。
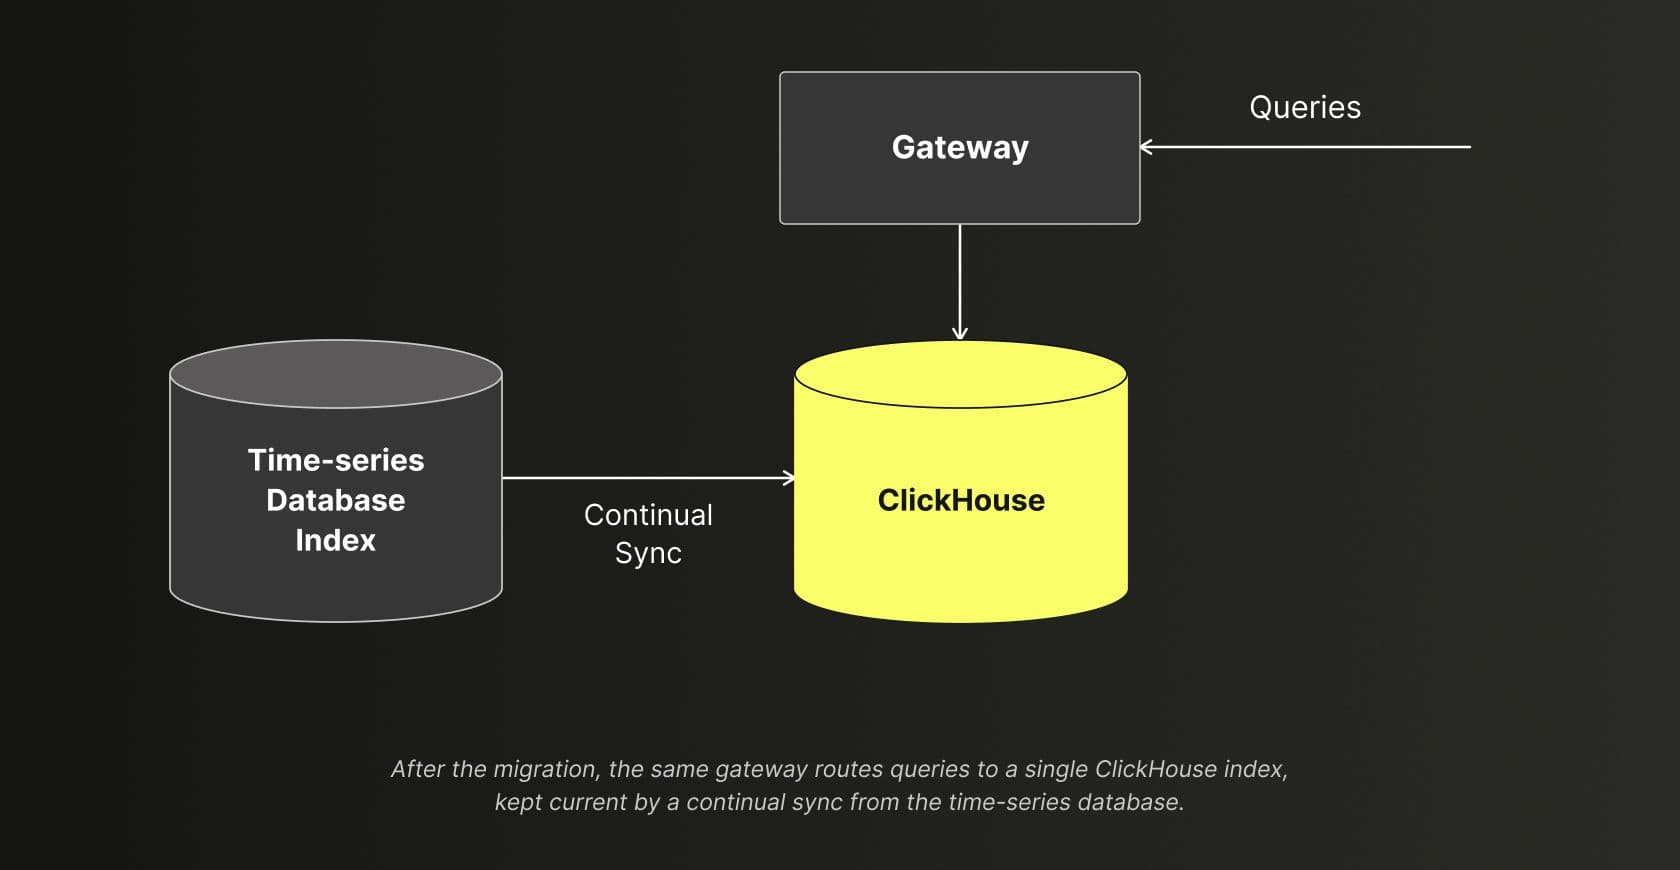
移行後は、同じゲートウェイが単一の ClickHouse インデックスへクエリをルーティングし、時系列データベースからの継続的な同期によって最新状態が保たれます。
Jacob 氏によれば、このゲートウェイのおかげで移行は「透過的」に進められました。社内のすべてのツールとサービスはすでにこのゲートウェイを経由していたため、ゲートウェイが 3 つの個別サービスへのファンアウトを取りやめ、代わりに ClickHouse へ SQL を発行するように切り替えても、下流のシステムでは何の変更も必要ありませんでした。「RRD を使用している人は誰でも、すでに意識することなく ClickHouse を使っています」と彼は述べています。
内部では、テーブルはレプリケーション構成の ReplacingMergeTree となっており、検出ディメンションを効率的に処理できるよう順序付けられ、ユニーク ID をキーとして重複排除が行われます。変更キャプチャストリームは at-least-once(少なくとも 1 回)で配信されるため重複は避けられませんが、ClickHouse がマージ時にそれらを破棄できるようにしたことで、余計な仕組みを作り込むことなくストリームのセマンティクスを許容できました。このパイプラインでは、オフラインの時系列データベースから新しい日次テーブルを作成し、変更キャプチャデータで最新状態まで追いつかせた後、エイリアスを使用してテーブルのポインタを切り替えてトラフィックをカットオーバーし、その後に古いテーブルを削除します。
サービスごとのメトリクス数、サービスごとのユニーク RRD 数、データセンターごとのホスト一覧など、旧システムでは対応できなかった重い集計は プロジェクション で処理します。また、スキーマでは個々のディメンションが直接公開されているため、以前は RRD 文字列全体に対して正規表現を実行していたエンジニアも、カラムに対するフィルタリングを行えるようになりました。「これにより大幅に効率化されました」と Jacob 氏は述べています。
成果と今後の展望
現在、この統合インデックスはフリート全体で毎分 15 万件以上のクエリを処理しており、平均レイテンシは 68 ミリ秒です。Jacob 氏が指摘するように、この平均値には、旧システムではまったく処理できなかった処理時間の長い深層分析クエリを含むすべてのクエリタイプが含まれています。「個別に見ていけば、1 桁ミリ秒で完了するクエリも見られます」と彼は言います。これほどの処理を、LinkedIn における日次 30% のデータ入れ替わりを伴う 130 億件以上の全メトリクスに対して、単一のシャード上で実現しています。
リソース面について Jacob 氏は、従来の 3 システム構成のスタックと比較してメモリ使用量が約 5 分の 1 に、コンピュートが約 3 分の 2 に削減されたと試算しています。メタデータインデックスは単一シャードであるため再シャーディングを考慮する必要がなく、メトリクス量が倍増しても耐えうる十分なヘッドルームを備えています。スケーリングの限界に達していた従来のアーキテクチャとは大きく異なる点です。
すべてのディメンションに対してクエリが可能になったことで、主要な社内ユーザーは正規表現を多用した古いクエリを、より効率的なネイティブクエリへと書き換えています。これにより、メトリクス量が増加しても、クラスターを長期的には縮小できる可能性すらあります。LinkedIn がグラフやアラートを RRD セマンティクスからネイティブな形式へと移行していく中で、ClickHouse を基盤とするこのインデックスは、エンジニアがメトリクスを見つけ出し、理解するための強力なツールとなりつつあります。こうして、Jacob 氏や Arun 氏をはじめとするオブザーバビリティチームが長年取り組んできた大規模な移行が実現へと向かっています。