5万

TL;DR
- ClickHouse の全文検索が GA になりました。ネイティブの転置インデックスにより、大規模なテキストデータセットをトークン単位で高速かつスケーラブルに検索できます。
- 大幅な性能向上: コールドクエリでは従来手法と比べて最大 7〜10 倍高速になり、ホットクエリではさらに高速になります。
- 分析とオブザーバビリティのために設計: 数十億〜数兆行に対する集計を伴う、高速な複数トークン検索を実現します。
- テキストワークロードでは Bloom フィルターより強力: 結果が決定的で、スケーラビリティが高く、大規模環境でのクエリ性能も大幅に速くなります。
「ClickHouse の全文検索で、スキャンするグラニュール数がインデックスなしのクエリより 96% 減りました。私たちのベンチマークワークロードでは、クエリのレイテンシが一貫して 7 倍近く改善しました。」
はじめに
ClickHouse の全文検索(Full-text Search)が一般提供(GA)となり、本番環境で利用できるようになったことをお知らせします。
今回の GA は、強力なテキスト検索機能を ClickHouse にネイティブに組み込む取り組みの集大成です。最初の構想から実装は何度もイテレーションを重ね、そのたびに性能、使いやすさ、ClickHouse アーキテクチャ全体との統合を磨いてきました。
直近では、オブジェクトストレージ上で高い性能を確保することに注力してきました。これにより、ClickHouse Cloud のユーザーも、オープンソース版のユーザーが当然のものとしてきた速度と効率を享受できます。この実現には、的を絞った最適化をいくつも積み重ねる必要がありました。その詳細は、包括的なベンチマーク結果とあわせて、続編の記事で取り上げます。
本記事では、全文検索の主な利点を紹介し、どのような場面で使うべきかの指針を示し、実際のシナリオでの挙動を実演します。
ClickHouse の全文検索とは
ClickHouse の全文検索は、Lucene などの検索技術と同様のアプローチで、転置インデックスとして実装されています。大まかに言えば、テキストインデックスは、各トークンとそれを含む行番号との対応を保存します。この構造により、ClickHouse は列のすべての値をスキャンすることなく、検索条件(これもトークンで構成されます)に一致し得る行を素早く特定できます。要するに、このインデックスはテキストベースのフィルタリングを高速化するものです。
トークンは、トークン化(tokenization)と呼ばれる処理で生成されます。トークン化の前に文字列値へ前処理関数を適用して値を変換し、検索の挙動を変えられます。たとえば、大文字小文字を区別せずに検索できるよう小文字化する、といった処理です。例として次を見てみましょう。
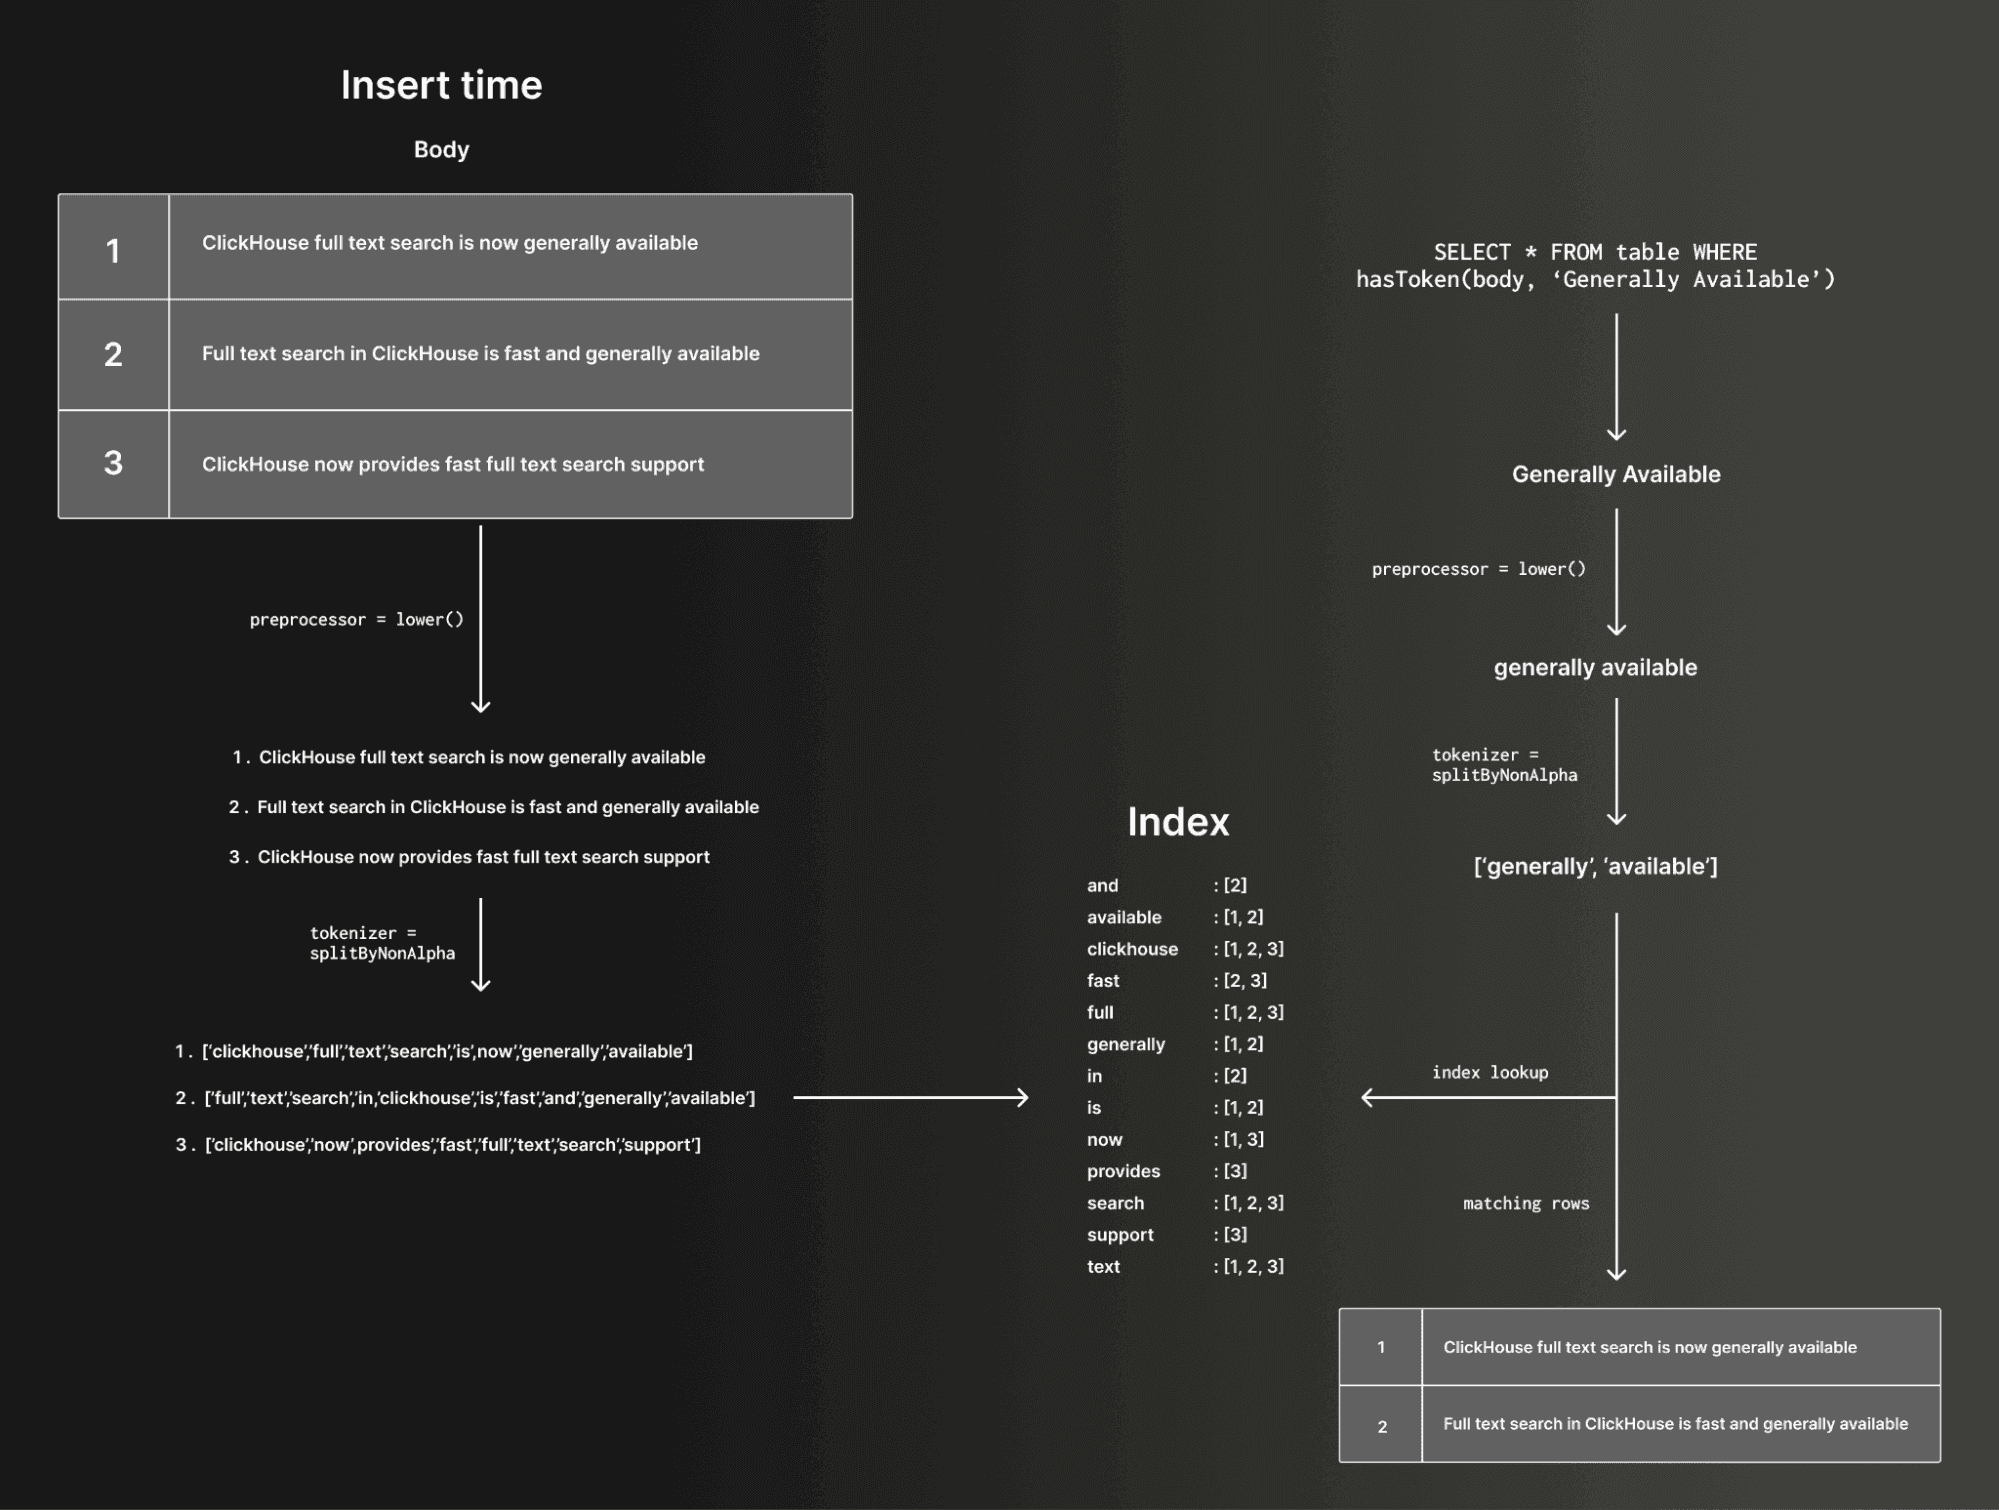
列にテキストインデックスを定義すると、このトークン化処理が挿入時(またはインデックスをマテリアライズする時)に列の値へ適用され、得られたトークンから行へのマッピングが内部に保存されます。クエリ時には、同じトークン化ロジックが検索文字列に適用されます。そのうえで転置インデックスを使い、要求されたトークンを含む候補行を効率的に特定します。
このようにテキストインデックスを使うと、文字列列を単一トークンでも複数トークンでも高速に検索できます。テキストインデックスは、通常の文字列に加えて、文字列の配列や、Map のキーと値にも使えます。
フレーズ検索、すなわちあるトークンの直後に別のトークンが続くことを要求する検索は、現時点ではテキストインデックスで直接には高速化されません。ただし、複数トークン検索で候補集合を絞り込んだうえで、残ったグラニュールに対して通常の線形スキャンでフレーズ照合を行うことはできます。この形であれば、フレーズ検索も間接的に恩恵を受けられます。フレーズ検索の直接的な高速化は、今後のイテレーションで予定しています。
後述の例で示すように、ClickHouse ではトークン化と前処理を標準的な SQL 式で設定できます。ユーザーは、インデックス対象のデータと検索文字列の双方について、どのようにトークンへ分割するかを制御できます。これは照合の挙動と性能の両方に影響します。たとえば、n-gram トークナイザーや sparse n-gram トークナイザーを使えば、部分文字列に近い照合ができます。トークン化の戦略を選ぶことで、ユーザーは特定のユースケースやトレードオフに合わせて調整できます。
近く公開するエンジニアリング寄りの記事では、ClickHouse の列指向アーキテクチャ上での実装を詳しく解説します。あわせて、ClickHouse で従来使われてきた手法や、他の伝統的な検索エンジンと比較したベンチマーク結果も示します。
全文検索インデックスを使うべき場面
ClickHouse の全文検索は、大規模な文字列ベースのフィルタリングを速くすることを目的に設計しています。特に効果的なのは、大量のテキストデータの中からトークンを検索するクエリです。こうしたワークロードは、これまで文字列照合を高速化する Bloom フィルターのスキッピングインデックスなどの手法に頼っていたかもしれません。テキストインデックスを使えば、String 列、文字列の配列、Map のキーと値を効率よく検索できます。その他の半構造化型のサポートも今後拡充していきます。
これまで、ClickHouse のユーザーは Bloom フィルターベースのスキッピングインデックスで文字列検索を高速化してきました。Bloom フィルターは有用ですが、確率的であり、グラニュール単位で動作します。つまり偽陽性が生じ得るうえ、「このデータ範囲にそのトークンが存在するかもしれない」という粗い粒度の判定しかできません。また、慎重なチューニングが必要で、複数トークン検索をネイティブにはサポートしません。テキストインデックスは根本的に異なるアプローチを取ります。トークンに対する決定的な転置インデックスを構築し、行レベルの情報を保存するため、インデックス自体が偽陽性を出すことなく、語を正確に検索できます。テキストインデックスは Bloom フィルターより大きくなりますが、大規模なテキストコーパスに対して大幅に優れたスケーラビリティと性能を発揮し、現在では大規模な文字列照合における推奨アプローチとなっています。
このため全文検索は、非常に大きなデータセットに対してフィルタリングと集計を組み合わせる分析ワークロードによく適合します。ClickHouse ならではの強みの一つは、数十億、さらには数兆行に対して検索を行い、その結果をすぐに集計できることです。ペタバイト規模のデータを検索し、同じクエリで集計を計算することは、高性能な分析データベースとしての ClickHouse の中核的な強みにそのまま重なります。
オブザーバビリティはその自然な例です。ClickStack では、ログ検索を高速化するために全文検索がすでに統合されています。こうしたワークロードでは通常、特定の語でログをフィルタリングしたうえで、集計、グルーピング、可視化を行います。ログデータは、たまたま大量のテキストを含んでいるだけの、分析データの一形態にすぎません。高速なトークン照合とリアルタイム分析の組み合わせこそ、全文検索が想定しているシナリオです。
一方で、ClickHouse の全文検索が担わない領域もはっきりさせておきます。これは関連度エンジンではなく、TF-IDF や BM25 のようなスコアリングモデルを実装していません。高度なフレーズランキングのための位置情報も保存しません。トークンベースのフィルタリングを高速化する目的で設計したものです。高度な自然言語処理(NLP)や関連度重視のユースケースに向けた専用検索エンジンの代わりにはなりません。洗練されたランキングや言語処理の機能が必要であれば、従来の検索エンジンのほうが適しているかもしれません。テラバイトからペタバイト規模のデータを極めて高速にトークン照合・文字列照合し、それをリアルタイムの集計や分析と組み合わせたいなら、ClickHouse の全文検索はまさにそのためのものです。
ユーザー事例 - Ryft.io
ベータ期間中、ClickHouse Cloud のユーザーは、既存の本番ワークロードで全文検索を有効化し、大規模環境での性能と使いやすさの検証を始めました。
その一つが Ryft.io です。Ryft.io は、実際の利用パターンに基づいて Apache Iceberg テーブルのメンテナンスとコンパクションを自動化するプラットフォームで、チームがレイクハウスを効率的で常に最適化された状態に保てるようにします。顧客がクエリログを提供すると、Ryft はテーブルがどのようにアクセスされているかを分析し、継続的にテーブルを管理・最適化します。
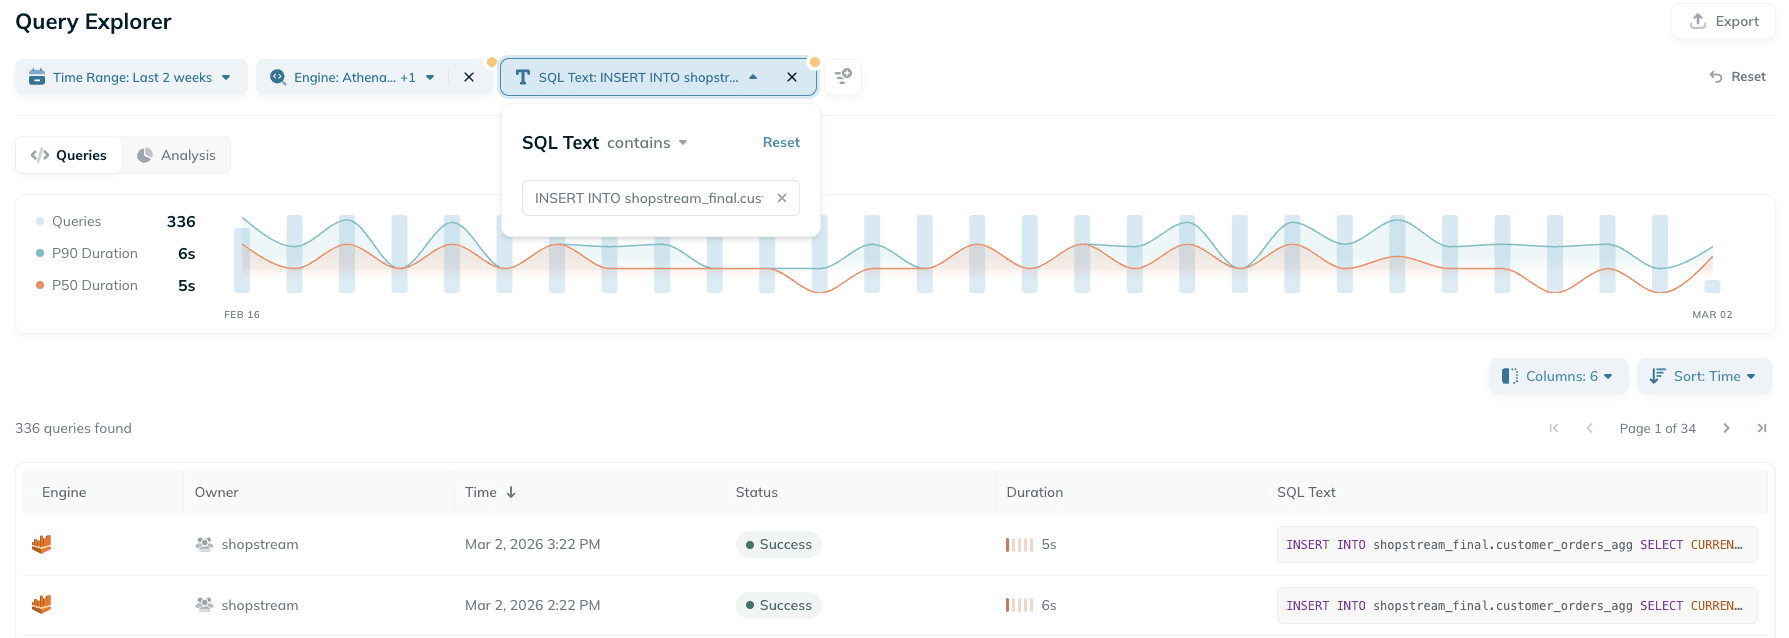
このワークフローの一部として、Ryft は現在、数億件の過去クエリに対する自由テキスト検索を ClickHouse の全文検索で実現しています。
「ClickHouse の全文検索で、スキャンするグラニュール数がインデックスなしのクエリより最大 96% 減りました。私たちのベンチマークワークロードでは、クエリのレイテンシが 7 倍近く改善しました。これにより、当社のクエリ分析エンジンにおける自由テキスト検索の使い勝手は根本的に変わりました。今ではシームレスな検索体験を提供でき、Ryft が継続的にもたらす性能面の効果と最適化の価値を明確に示せるようになりました。」
Guy Gadon 氏(Ryft Co-Founder & VP R&D)
ユーザー事例 - Icite
Icite が作られた目的は、セキュリティオペレーションのチームにアイデンティティ固有のコンテキストを提供し、脅威対応を確信を持って大規模に行えるようにすることです。ユーザーが誰で、何にアクセスでき、そのアクセスでどのような操作が許され、実際に何をしたかを明確に示します。とりわけ、チームがアクセスを迅速に隔離・封じ込め、リアルタイムにリスクを低減できる点が重要です。
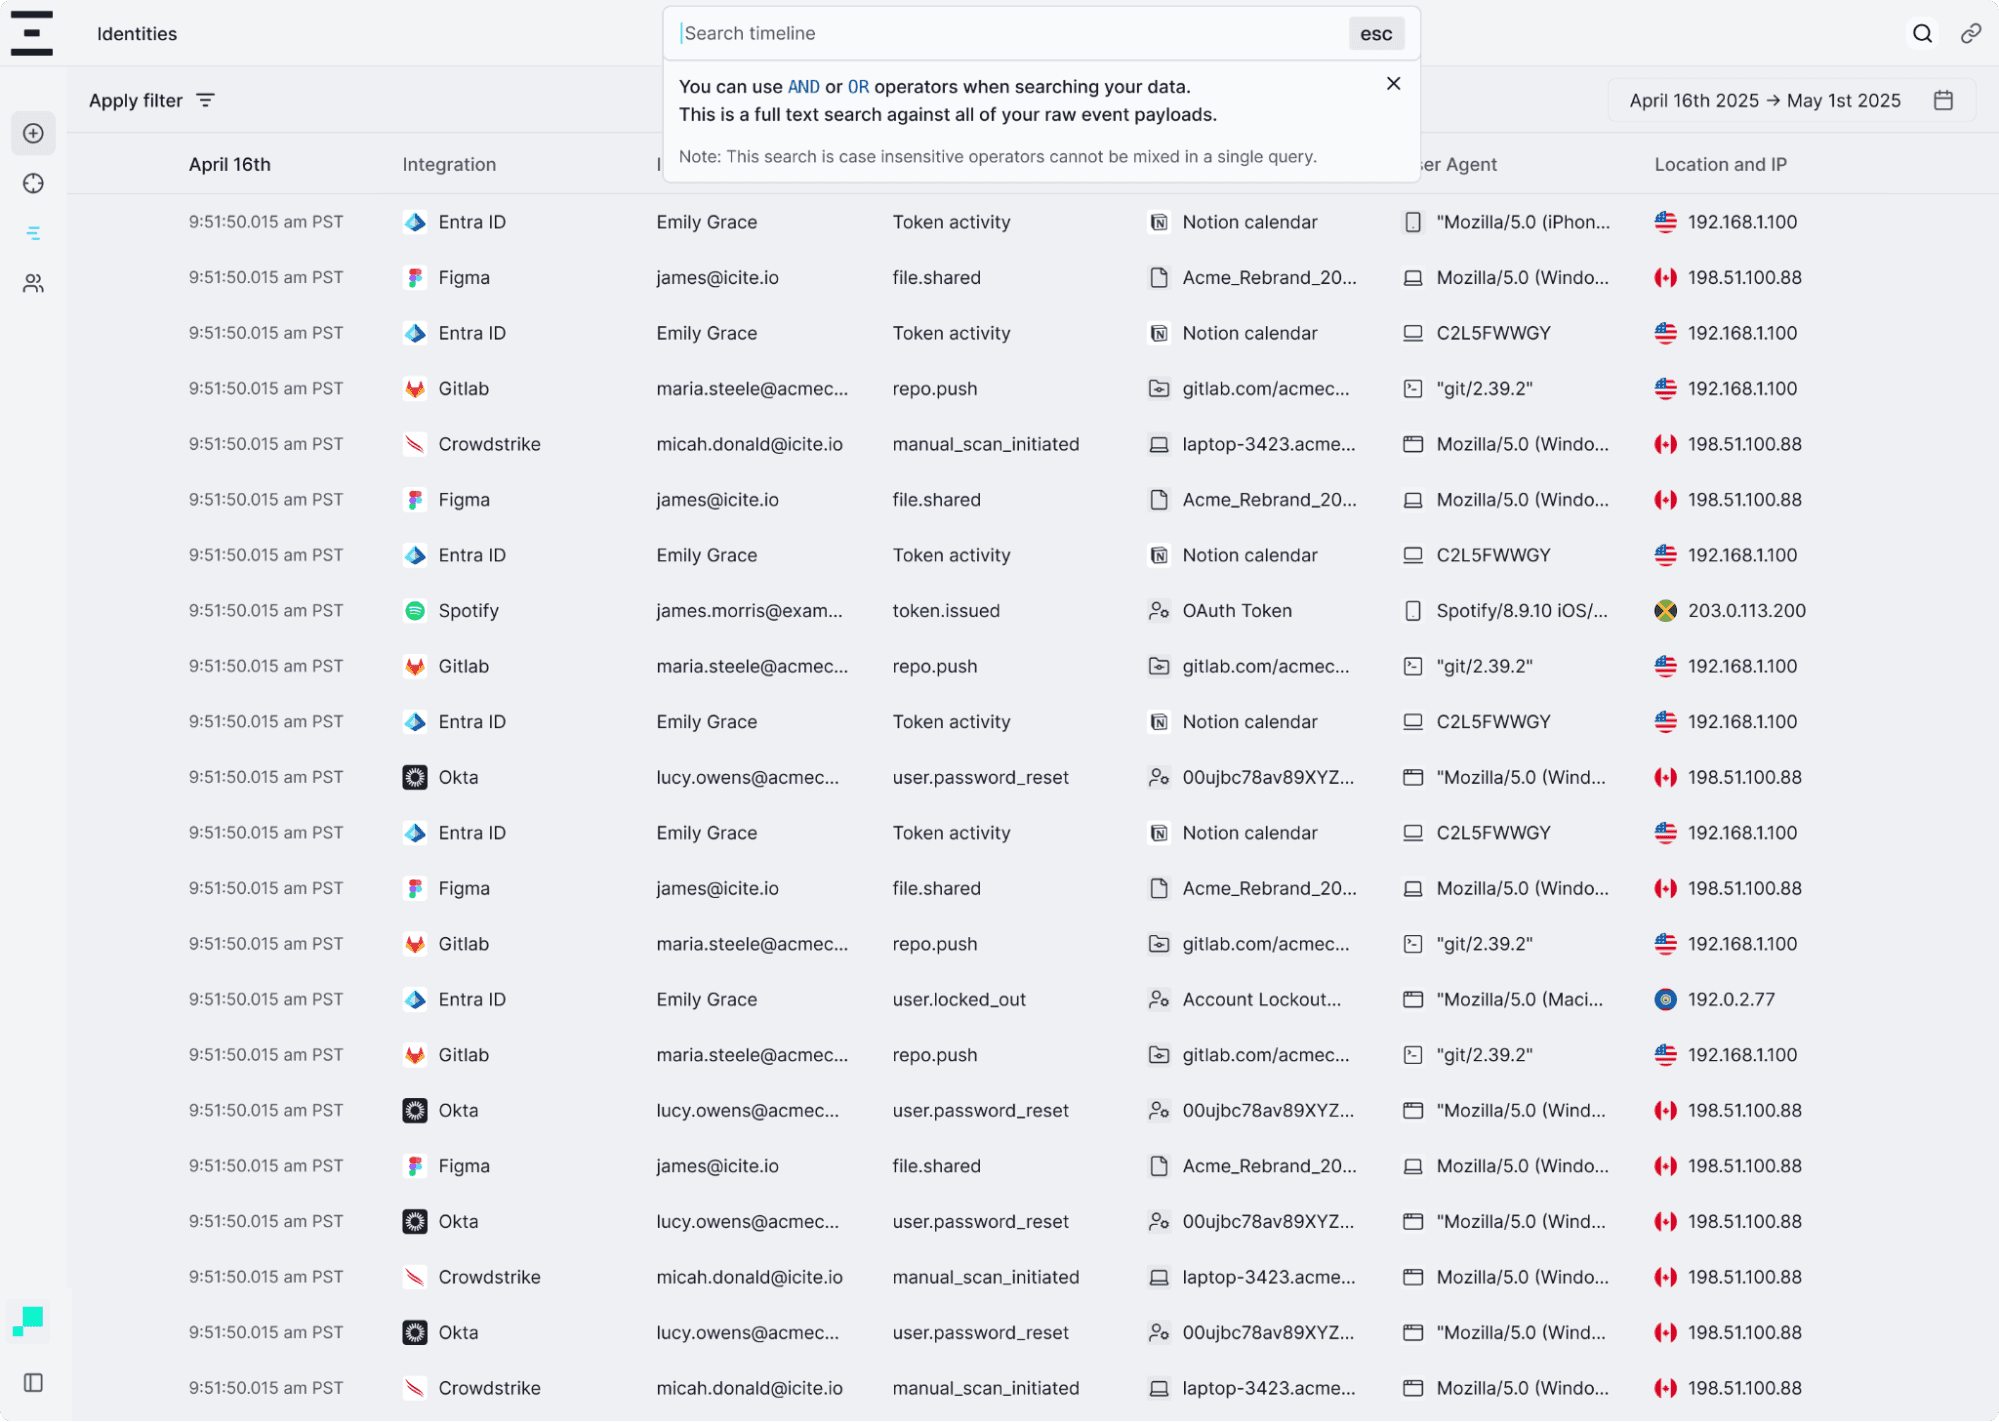
「ClickHouse の全文検索は、私たちのログデータの検索方法を根本から変えました。私たちは多様なソースから数百万件のイベントを取り込み、生のペイロードを String 列に保存しています。以前は、複数語の検索は線形スキャンで 30〜45 秒かかることがありました。新しい転置インデックスでは、同じクエリが 400 ミリ秒前後で完了します。これにより、追加のインフラを導入したり ClickHouse の外にデータを複製したりすることなく、ログコーパス全体に対して高速でインタラクティブな検索体験を提供できるようになりました。」
Kevin Manson 氏(Icite Principal Cloud Engineer)
全文検索が一般提供となった今、より多くのユーザーが分析やオブザーバビリティのワークロードで同じ恩恵を得られることを期待しています。
全文検索の使い方
全文検索は、テーブルにテキストインデックスを宣言することで有効になります。インデックスを付ける列を選び、トークナイザーと、必要に応じて前処理(preprocessor)を指定します。トークナイザーは値をどのようにトークンへ分割するかを制御し、前処理はトークン化の前に入力を変換します。たとえば、大文字小文字を区別せずに検索できるよう小文字化する、といった処理です。キャッシュなど、インデックスの高度なチューニングオプションもあり、ドキュメントで確認できます。
以下の例では、公開デモ環境で利用できる GitHub Events データセットにテキストインデックスを追加します。このデータセットは 100 億行を超え、各行が issue、コメント、watch、pull request といった、全リポジトリの公開 GitHub イベントを 1 件ずつ表します。構造化データの分析については、以前にこのデータセットの分析例を公開していますが、この規模でテキスト中心の分析を効率よく行うのは、これまで難しいままでした。
CREATE TABLE github.github_events(
...
body String,
...
INDEX fts_body body TYPE text(
tokenizer = splitByNonAlpha,
preprocessor = lowerUTF8(body)
),
INDEX bloom_body tokens(lower(body)) TYPE bloom_filter(0.01) GRANULARITY 8
)
ENGINE = MergeTree
ORDER BY (repo_id, event_type, created_at);テーブルスキーマ全体はこちらを参照してください。
たとえば、次の問いには素早く答えられるようになりました。GitHub のコメント全体で、「ClickHouse」は時間の経過とともにどれくらい言及されているのでしょうか。
ここでのクエリはすべて 3 回実行したうちの最速値です(実質的にファイルシステムキャッシュがホットな状態)。クエリの実行には ClickHouse Cloud の 32 コアのノードを使用しています。
まず、テキストインデックスと Bloom フィルターの両方を無効にし、線形スキャンを強制します。ClickHouse の並列処理をもってしても、数ギガバイトのテキストのスキャンはインタラクティブな分析には速さが足りません。
SELECT
toStartOfMonth(created_at) AS month,
count() AS count
FROM github.github_events
WHERE hasTokenCaseInsensitive(body, 'ClickHouse')
GROUP BY month
ORDER BY month ASC
SETTINGS enable_full_text_index = 0, use_skip_indexes = 0;┌──────month─┬─count─┐
│ 2015-02-01 │ 1 │
│ 2016-06-01 │ 68 │
│ 2016-07-01 │ 60 │
│ 2016-08-01 │ 53 │
│ 2016-09-01 │ 42 │
—omitted for brevity
119 rows in set. Elapsed: 193.018 sec. Processed 10.50 billion rows, 2.96 TB (54.40 million rows/s., 15.34 GB/s.)大文字小文字を区別しない照合のために、
hasTokenCaseInsensitive関数を使っている点に注意してください。
次に、テキストインデックスは無効のまま、Bloom フィルターインデックスを有効にします。グラニュールの約 80% が除外され、性能が改善します。
SELECT
toStartOfMonth(created_at) AS month,
count() AS count
FROM github.github_events
WHERE hasAny(tokens(lower(body)), ['clickhouse'])
GROUP BY month
ORDER BY month ASC
SETTINGS enable_full_text_index = 0, use_skip_indexes = 1, use_query_condition_cache = 0;119 rows in set. Elapsed: 143.293 sec. Processed 2.16 billion rows, 729.00 GB (15.05 million rows/s., 5.09 GB/s.)現時点で Bloom フィルターインデックスを効かせるには、クエリの式をインデックス定義と同じ式、すなわち
tokens(lower(body)に一致させる必要があります。
ここでの Bloom フィルターのオーバーヘッドは意外なほど大きいものです。スキャンされるデータ量は大幅に減っているものの、性能の改善はそれほど劇的ではありません。改善の余地はありますが、良い結果を得るにはチューニングが必要です。
最後に、全文検索インデックスを有効にします。ClickHouse は転置インデックスを使って一致する行を効率的に特定できるようになり、読み取る必要のあるデータ量が劇的に減ります。
SELECT
toStartOfMonth(created_at) AS month,
count() AS count
FROM github.github_events
WHERE hasToken(body, 'ClickHouse')
GROUP BY month
ORDER BY month ASC
SETTINGS use_query_condition_cache = 0;119 rows in set. Elapsed: 0.422 sec. Processed 334.92 million rows, 1.36 GB (794.41 million rows/s., 3.23 GB/s.)この場合、クエリはよりシンプルになり、かつ大幅に速くなります。自然な述語を書くだけで、トークン化と前処理はインデックスに任せられます。その結果、スキャンされるグラニュールが劇的に減り、クエリのレイテンシは段違いに改善します。以前は重いスキャンだった処理が、数十億行の規模でもインタラクティブに応答する処理へと変わります。
照合でサポートされるクエリ構文や、前処理とトークナイザーの詳細は、ドキュメントを参照してください。
全文検索はどれくらい速いのか
上で示したように、全文検索による性能向上は劇的なものになり得ます。この例は 1 つのデータセットの 1 つの語に絞ったものであり、結果はワークロードによって異なりますが、一貫して確かな改善を確認しています。実際の検索クエリの大半では、コールドクエリで 7〜10 倍、ホットクエリではそれ以上の高速化が期待できます。
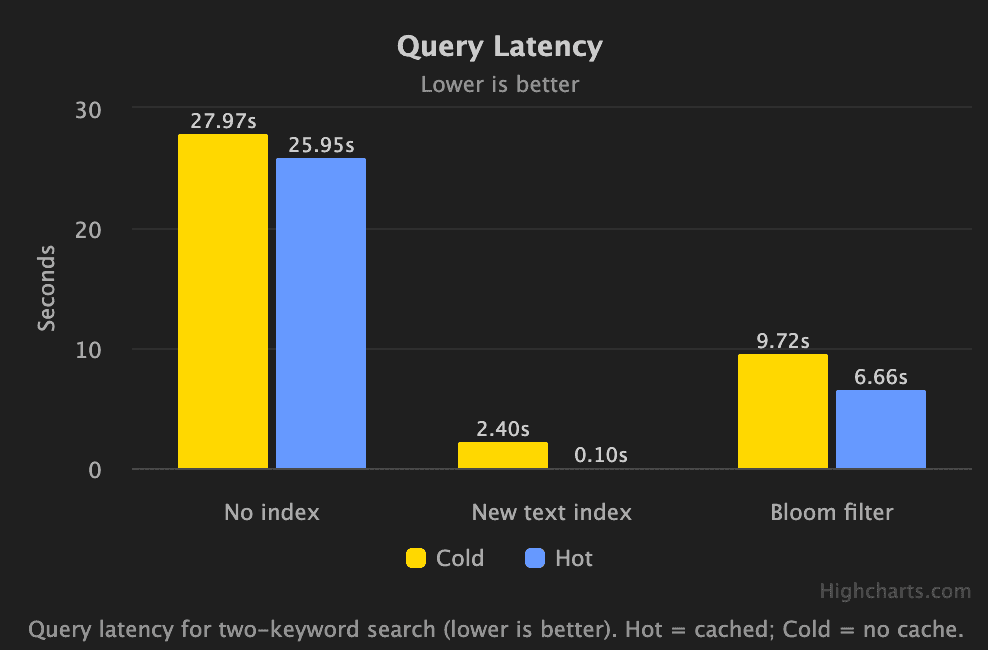
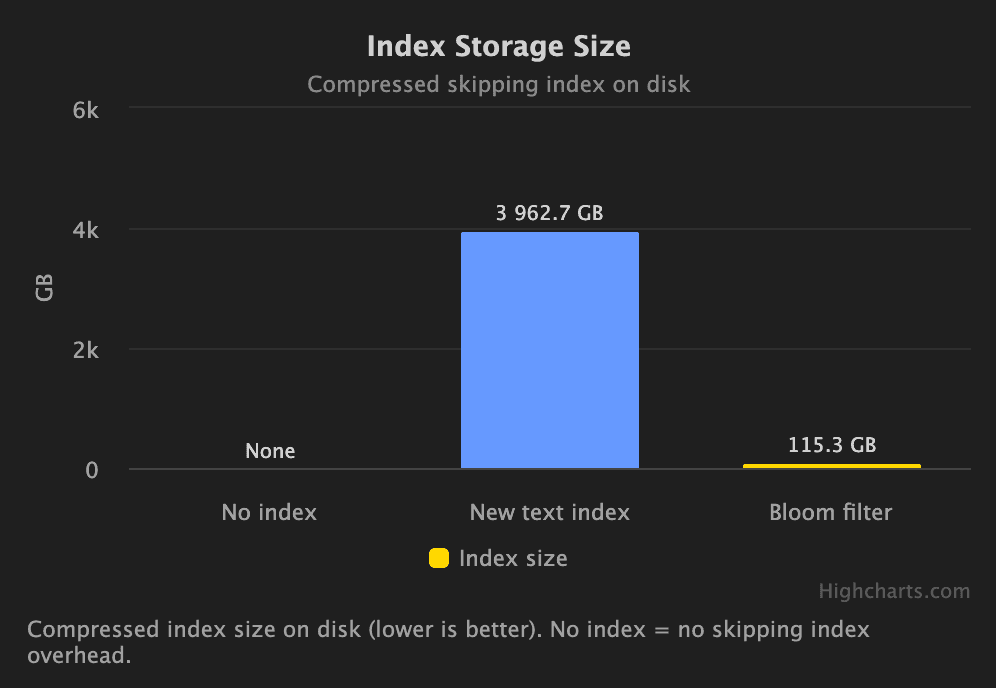
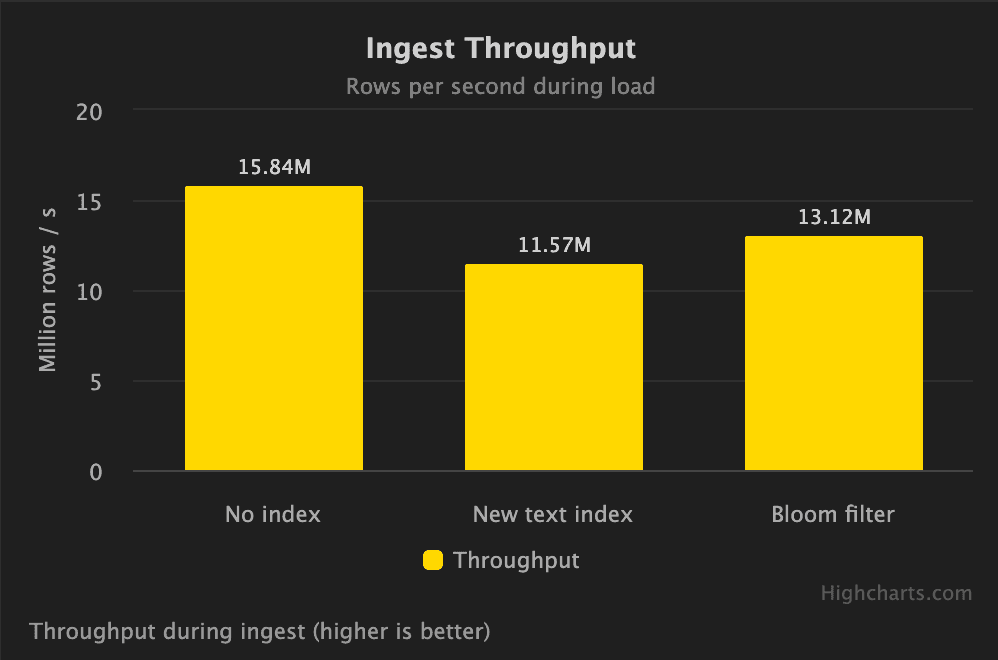
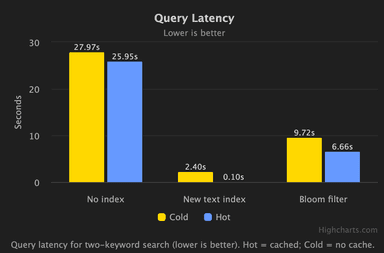
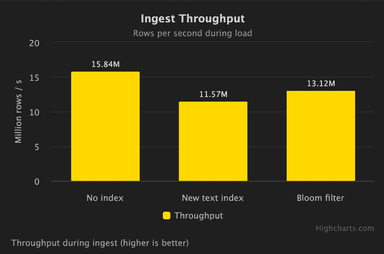
これをより広く検証するため、ClickHouse Cloud 上で 59 vCPU、256GB の RAM を使い、50 TB のログデータに対して全文検索をベンチマークしました。クエリのレイテンシに加えて、ストレージのオーバーヘッドと挿入性能も測定しました。インデックスは書き込みコストを増やし、挿入スループットはインデックスなしの場合と比べて約 50% 低下します。しかし、クエリ性能の向上は大きく、コールドクエリで最大 10 倍、データがローカルノードにキャッシュされている場合はさらに大きく改善します。Bloom フィルターベースのアプローチと比べると、全文検索は通常、挿入はわずかに遅いものの、クエリ時には数倍高速な性能を発揮します。
以下のアニメーションは、代表的なワークロードにおけるエンドツーエンドのクエリレイテンシへの影響を示しています。
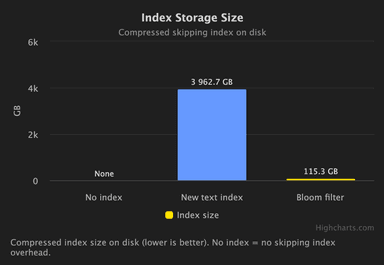
ストレージのトレードオフもあります。全文検索インデックスは Bloom フィルターより大きく、どちらもインデックスなしの場合より大きくなります。GitHub データセットのインデックスサイズを直接比較すると、その差がはっきり分かります。
SELECT
name,
type,
formatReadableSize(data_compressed_bytes) AS compressed_bytes,
formatReadableSize(data_uncompressed_bytes) AS uncompressed_bytes
FROM system.data_skipping_indices
WHERE (`table` = 'github_events') AND (database = 'github') AND ((name = 'bloom_body') OR (name = 'fts_body'));┌─name───────┬─type─────────┬─compressed_bytes─┬─uncompressed_bytes─┐
1. │ fts_body │ text │ 215.84 GiB │ 223.13 GiB │
2. │ bloom_body │ bloom_filter │ 7.04 GiB │ 7.24 GiB │
└────────────┴──────────────┴──────────────────┴────────────────────┘
2 rows in set. Elapsed: 0.003 sec.とはいえ、ClickHouse Cloud では多くの場合、ストレージのコストはインフラ支出全体のごく一部です。1 TB あたり月額約 $25 なので、かなり大きなインデックスでも、大規模な分析ワークロードでコストの大半を占めることはまれです。全体の圧縮率も高い水準を保ちます。
たとえば GitHub テーブルの圧縮率を見ると、テキストインデックスを考慮に入れる前は約 9 倍です。テキストインデックスを含めると約 6 倍に下がります。
SELECT
formatReadableSize(sum(data_compressed_bytes)) AS compressed_size,
formatReadableSize(sum(data_uncompressed_bytes)) AS un_compressed_size
FROM system.columns
WHERE (`table` = 'github_events') AND (database = 'github');┌─compressed_size─┬─un_compressed_size─┐
│ 477.09 GiB │ 4.23 TiB │
└─────────────────┴────────────────────┘
1 row in set. Elapsed: 0.004 sec.一部のシナリオには未解決の課題も残っています。特に、オブザーバビリティのワークロードで、インデックスがノード単位のキャッシュ層や分散キャッシュ層とどう相互に影響するかという点です。このため ClickStack ではまだ既定で有効にしていませんが、近い将来にこれらの点を解決し、既定で使える範囲を広げていく予定です。
GitSearch - 全文検索のデモ
上の例は仕組みと性能特性を示すものですが、全文検索を理解する最良の方法は自分で試すことです。それを手軽にできるように、同じ GitHub Events データセットの上に、インタラクティブな公開デモ GitTrends を構築しました。
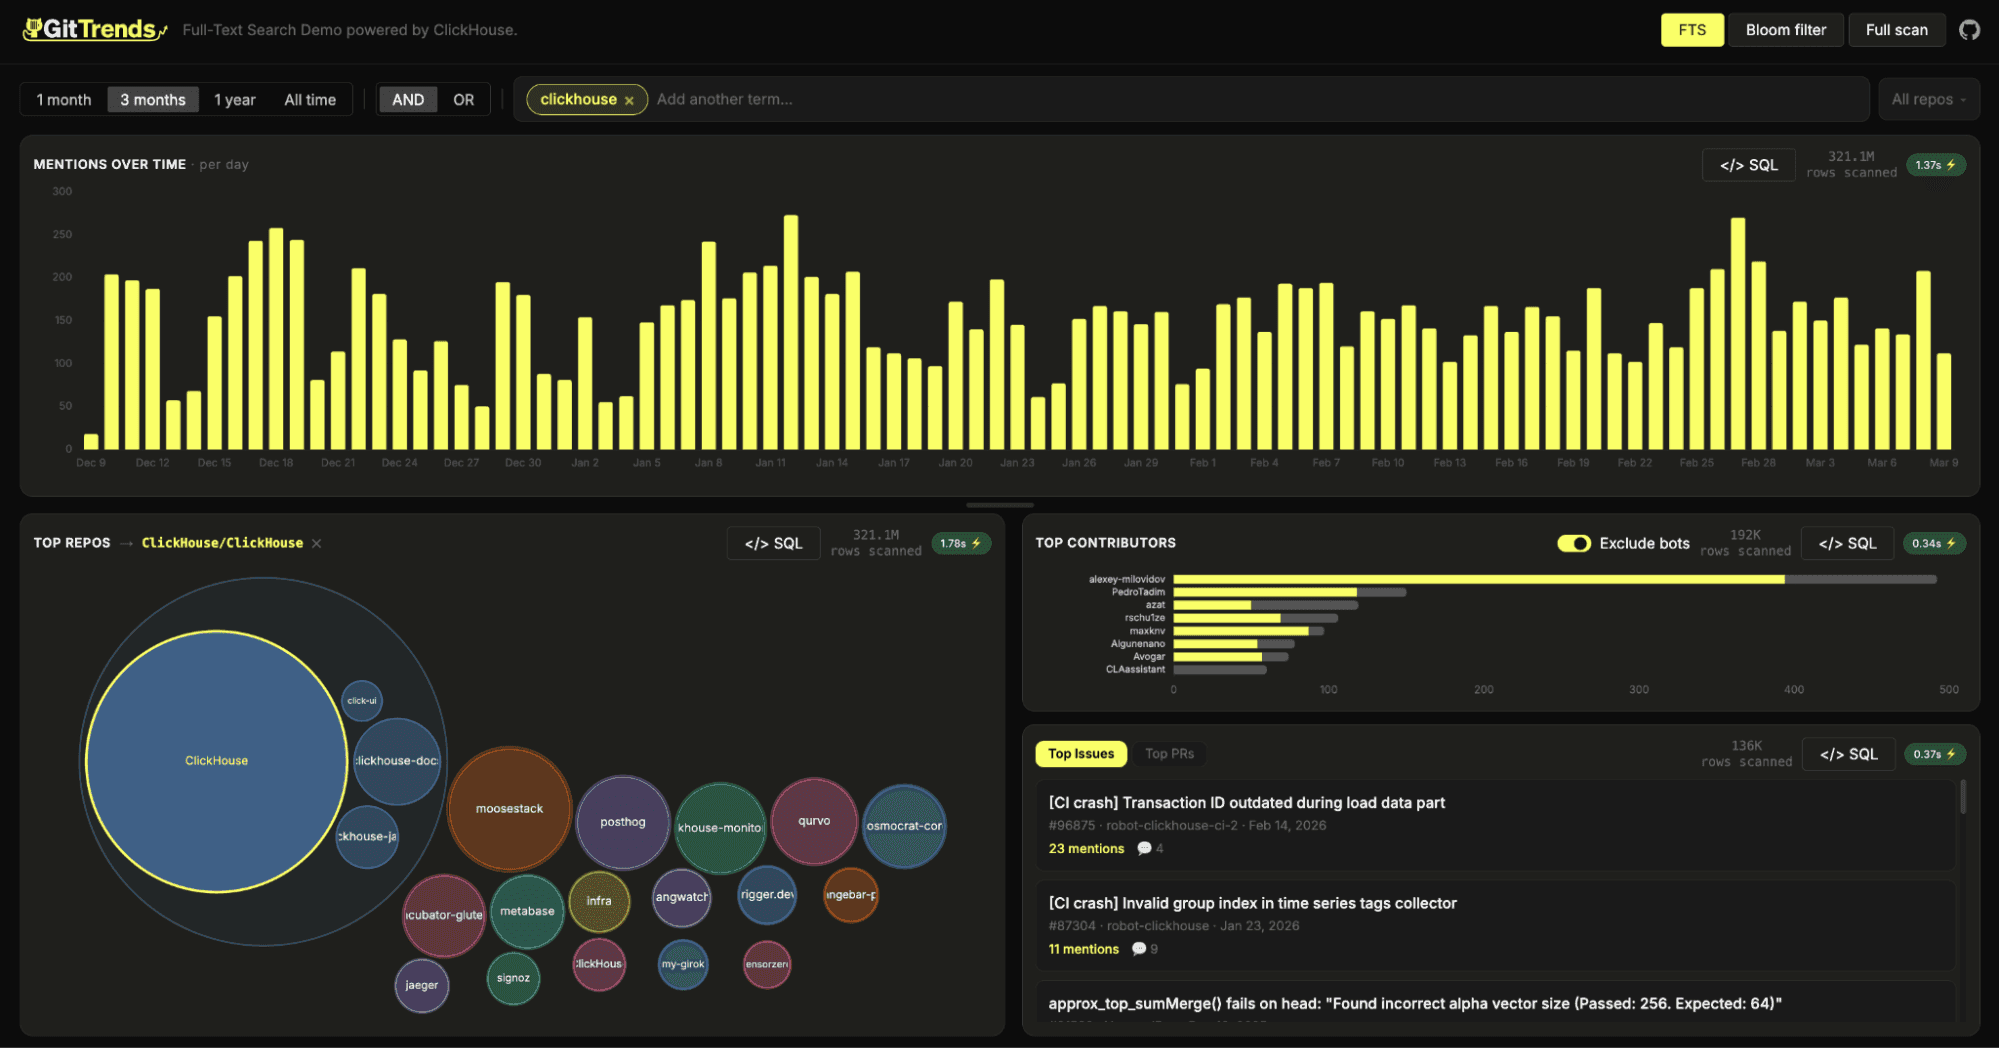
このデモでは、任意の技術用語を検索し、すべての公開 GitHub リポジトリにおける言及数の推移をすぐに確認できます。
さらに、その技術が登場する特定のリポジトリまで掘り下げ、issue や pull request でどのように現れているかを分析し、あるプロジェクトへの関心がどう変化してきたかを調べられます。複数の技術を並べて比較することもでき、開発者エコシステム内の活動や勢いを把握するうえで、Google Trends のようなツールの軽量な代替となります。
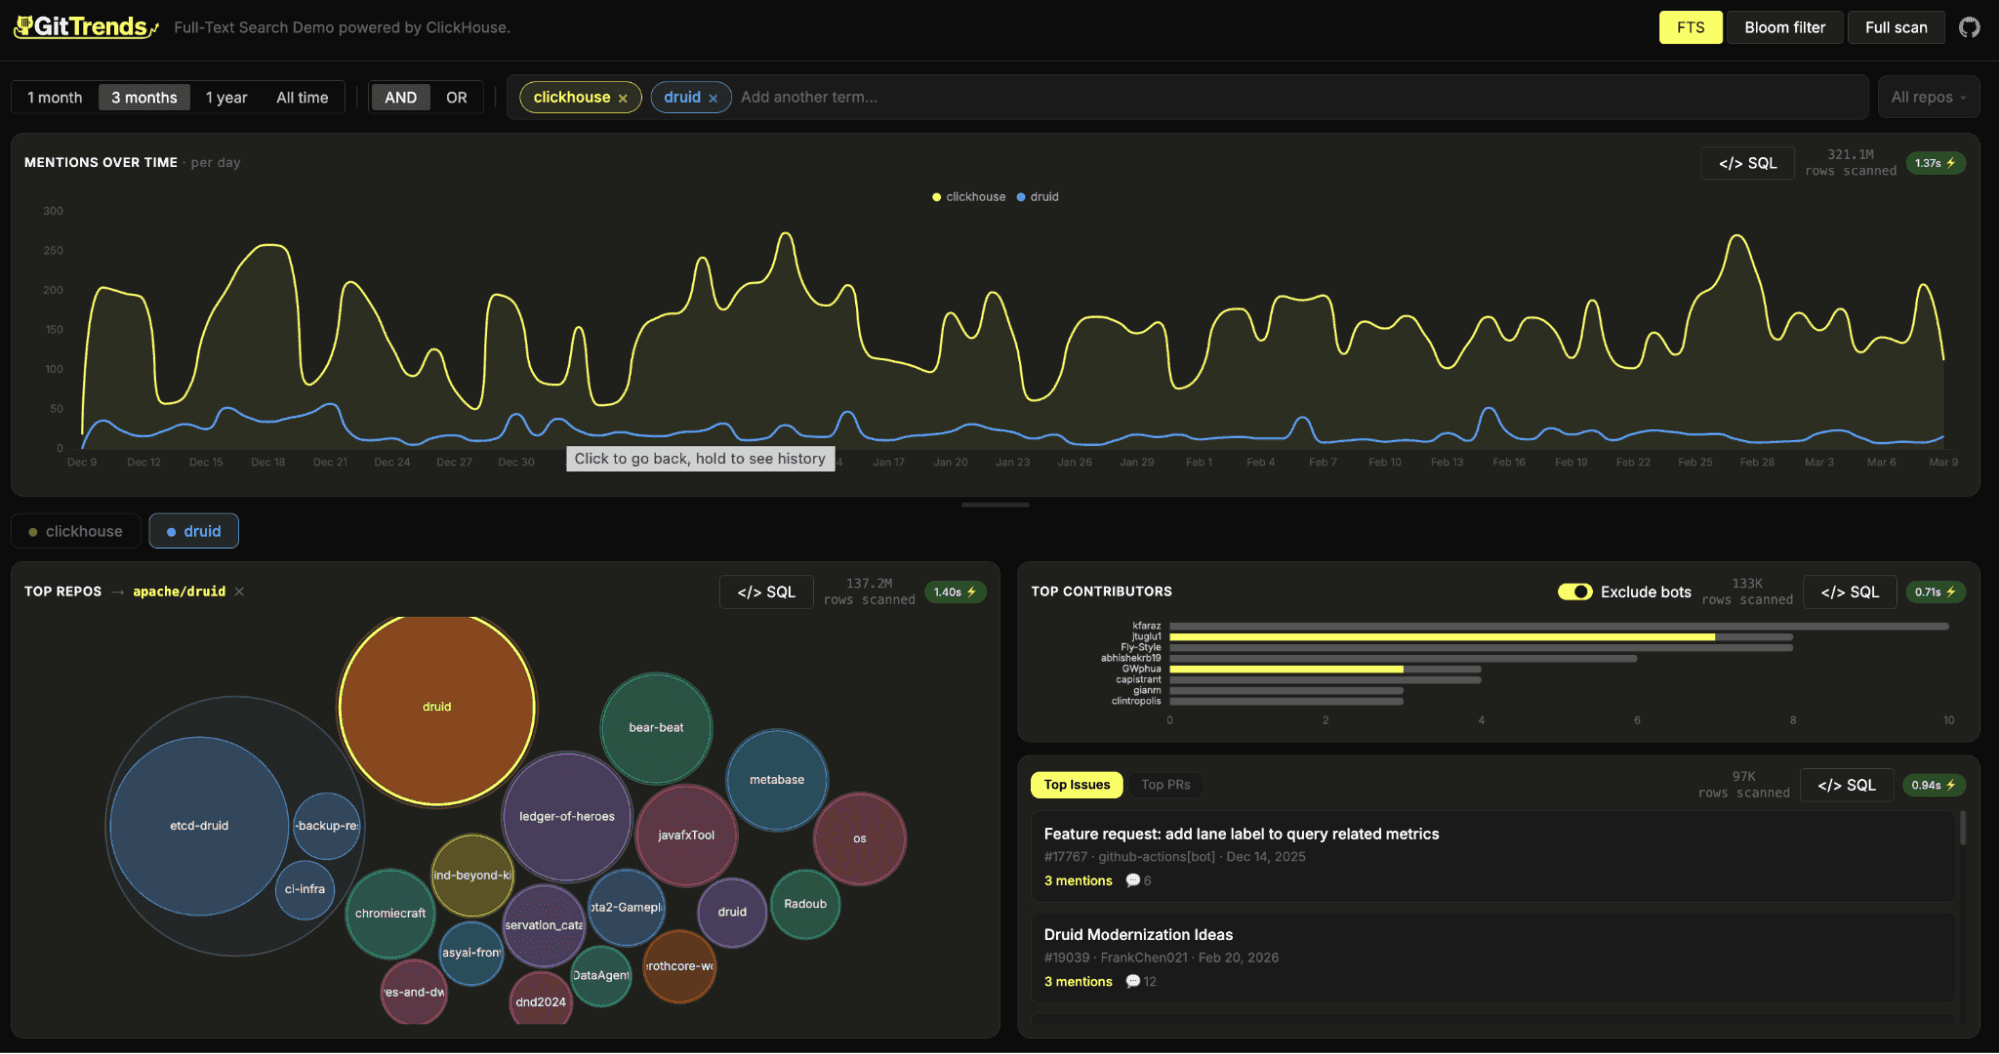
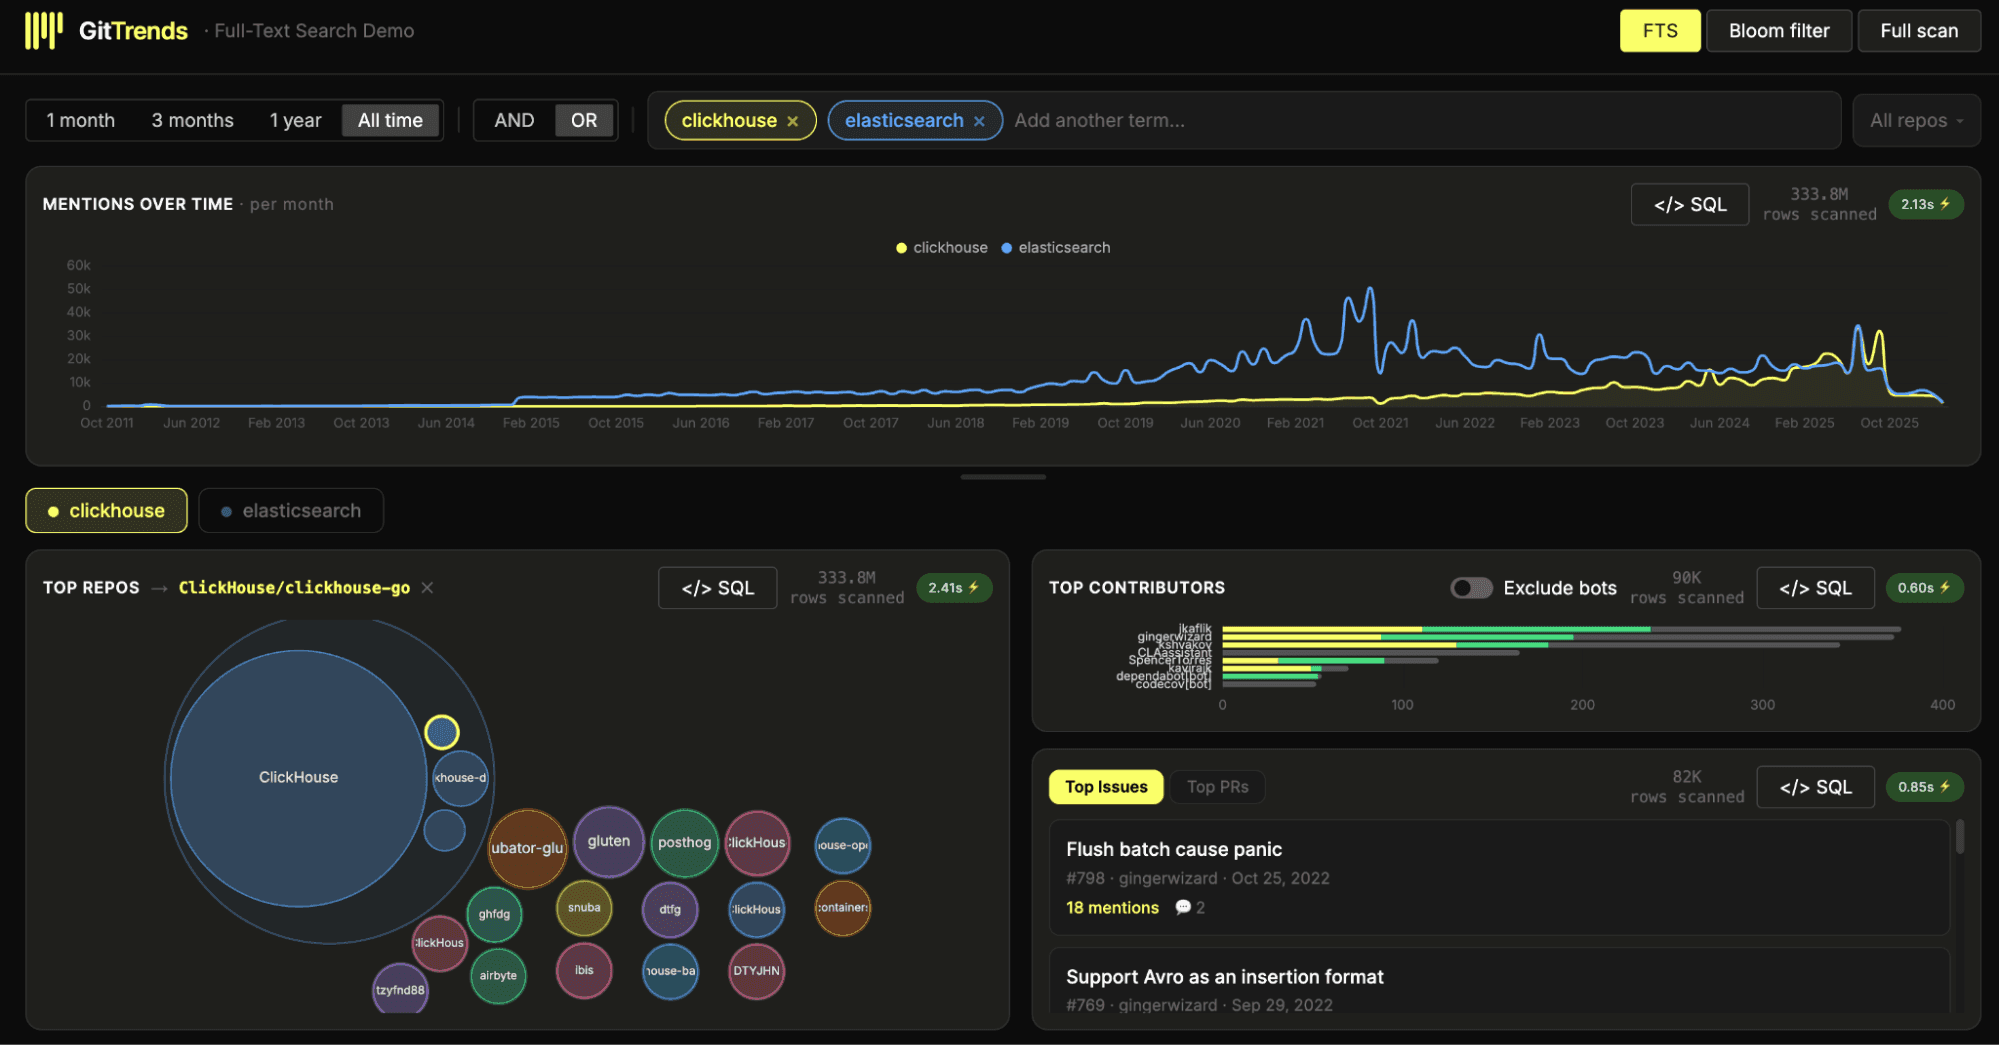
これらはすべて全文検索によって実現されています。性能差を直接確かめたい場合は、UI 上で全文検索、Bloom フィルターベースの検索、線形スキャンを切り替えて、それぞれのアプローチの影響をリアルタイムに見ることもできます。
他の公開デモと同様に、このデータセットも継続的に(1 時間ごとに)更新し、ユーザーが GitHub の分析を無料で利用できるようにします。
まとめ
ClickHouse の全文検索が一般提供となり、本番環境で利用できるようになったことを嬉しく思います。何度ものイテレーションと、ClickHouse Cloud のオブジェクトストレージ向け最適化を含む大がかりな性能改善を経て、ユーザーが高速でネイティブな大規模テキスト検索の恩恵を受け始めるのが待ち遠しいです。
GA リリースを記念したウェビナーを、3月11日にエンジニアリングチームとともに開催します。全文検索の内部構造、設計上の判断、ベンチマーク結果をより深く解説します。
コミュニティがこの強力な新機能を分析やオブザーバビリティ、さらにその先の領域でどのように活用するのか、そこから生まれる成功事例を聞けることを楽しみにしています。