5万


はじめに
多くの組織が、Apache Iceberg や Delta Lake などのオープンテーブルフォーマット上に構築されたデータレイクを標準として採用してきました。クラウドストレージのコストが下がり、ベンダーロックインの課題が大きくなるにつれて、オープンフォーマットはデータを一度保存すればどこからでもクエリできる手段をチームにもたらしました。その利点は、データがオープンのまま保たれ、ポータビリティがあり、複数のエンジンからクエリできるため、自社のスタックに最も適したツールを自由に選べる点にあります。しかし、その柔軟性はリアルタイム分析において代償を伴います。
レイクフォーマットはオープンなストレージと相互運用性を重視して設計されており、速度のために設計されたわけではないため、チームは壁に直面します。リアルタイムワークロードに必要な専用インデックス、キャッシュ、クエリエンジンの緻密な最適化がないと、データレイクでのクエリは大規模環境で急速に遅くなり、コストも跳ね上がります。
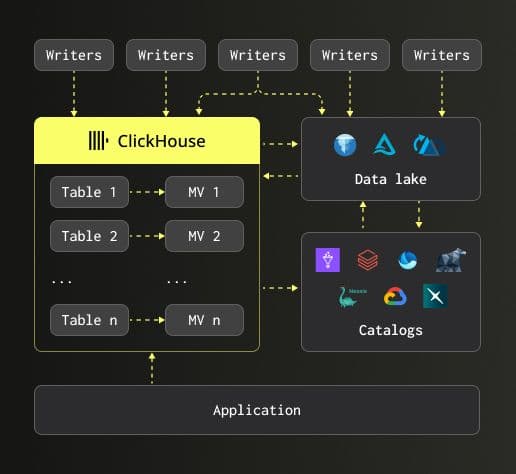
本日、ClickHouse がデータレイクに対応(data lake ready)したことを発表します。ClickHouse を Iceberg や Delta Lake のファイル、あるいは各種ベンダーやオープンソースのカタログに直接向けることで、その場でデータをクエリできます。また、サブ秒単位の高同時実行クエリを実現するためにデータを ClickHouse ネイティブのストレージエンジンにロードして分析を高速化することも可能です。さらに結果をオープンフォーマットに書き戻せるため、エコシステム全体の相互運用性も維持されます。
データレイク対応への歩み
これを実現するために 2 年におよぶエンジニアリングの取り組みが行われました。ここまでの経緯をご紹介します。
真の意味でデータレイクに対応するには、クエリエンジンが 3 つのことを高いレベルでこなす必要があります。Parquet ファイルの高速な処理、Iceberg や Delta Lake などのオープンテーブルフォーマットのサポート、そしてその上位にあるカタログとの統合です。過去 2 年間でこれらの機能をどのように構築してきたかを説明します。
私たちはまず Apache Iceberg フォーマットの初期サポートのリリース(23.3)から着手しました。これによりオブジェクトストレージ上のデータをネイティブに読み込めるようになり、ユーザーはレイクデータに対するクエリエンジンとして ClickHouse を初めて活用できるようになりました。続いて Parallel Replicas(25.8)を投入し、レイク規模のワークロードに対してクエリ実行を複数ノードに分散できるようにしました。
そこから、Iceberg や Delta Lake テーブルの基礎となるファイルフォーマットである Parquet に多大な投資を行いました。Parquet メタデータを利用したローグループスキッピングの追加(23.8)、高速な count 処理の実現、不要なファイル読み込みを防ぐためのファイル名メタデータを用いたフィルタリングを可能にしました。23.7 では Parquet の書き込み性能を向上させました。ストレージ側では Azure Blob Storage へとサポートを拡張し(23.5)、ClickHouse の対応先を S3 と GCS だけにとどまらないものにしました。
24.12 では、Unity Catalog による初のカタログサポートを、スキーマ進化(schema evolution)とともに導入しました。外部サービスで管理されているカタログから Iceberg データをクエリできるようになり、カラムの追加、削除、リネーム、型の変更を ClickHouse が自動で検出するようになりました。Polaris カタログもサポートされました。
また、独自の Delta Lake リーダーを置き換える形で、Delta Rust Kernel を ClickHouse に統合することにも大きな力を注ぎました。車輪の再発明をするのではなく、コミュニティのオープンソースカーネルをベースに構築することで、Delta Lake の読み込み、書き込み、チェンジデータフィードのサポート、スキーマ進化、タイムトラベル、パーティションプルーニング、統計情報ベースのプルーニングを実現しました。
カタログのサポートは 25.3 でも拡充を続け、AWS Glue や Unity Catalog の Delta Lake サポートを追加しました。それ以降、Microsoft OneLake、Iceberg REST Catalog、AWS Glue のサポートを追加し、テーブルの管理方法をユーザーが自由に選択できる、真のカタログアグノスティックなソリューションを提供しています。25.4 では Iceberg 向けのタイムトラベルを追加し、データの過去のスナップショットをクエリできるようにしました。これは、監査性や特定時点へのクエリが重要となるデータウェアハウス型のワークロードで特に威力を発揮します。25.6 では Parquet 内の JSON サポートと Iceberg の詳細な履歴調査機能をリリースし、テーブルが時間の経過とともにどう変化したかをより詳細に把握できるようにしました。
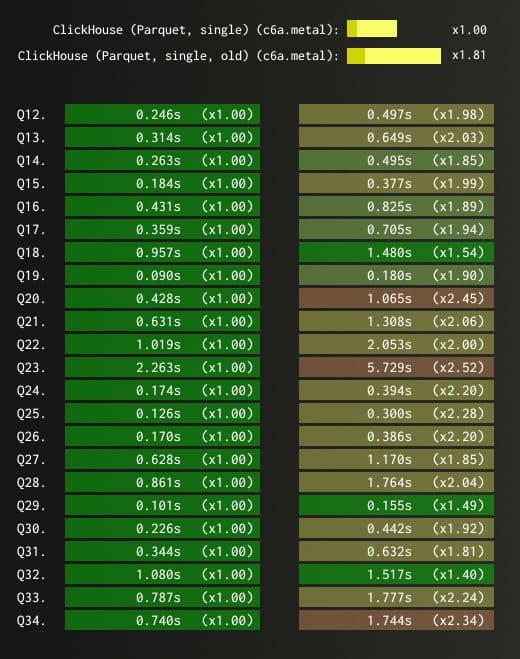
25.8 は、データレイクの進化において最も重要なリリースの 1 つとなりました。新しいネイティブ Parquet リーダーによりページレベルの並列処理が実現し、余分な Arrow レイヤーを排除して、Parquet ファイルを ClickHouse のインメモリフォーマットへ直接読み込めるようになりました。その結果、ClickBench 全体で平均 1.8 倍高速な読み込み と圧倒的なパフォーマンスを達成しました。
さらに、Iceberg テーブルに対する insert、delete、update、alter schema 操作をフルサポートし、ClickHouse にデータを取り込むことなくインタラクティブな DML を実行できるようにしました。基盤となるオブジェクトストレージへのサポート投資も継続し、Azure Blob Storage での大幅なパフォーマンス向上を実現しました。
25.9 では、Iceberg、Delta Lake、クラウドストレージ連携の安定性に重点を置き、スキーマ解決とメタデータの一貫性を改善しました。
私たちの取り組みはこれで終わりではありません。今年後半にはさらに多くのカタログサポートをリリースし、パフォーマンスと相互運用性への投資を継続する予定です。今後も楽しみな開発が数多く控えています。
では、これらすべてのエンジニアリング作業によって何が可能になるのでしょうか。
データレイクで ClickHouse を活用する 3 つの方法
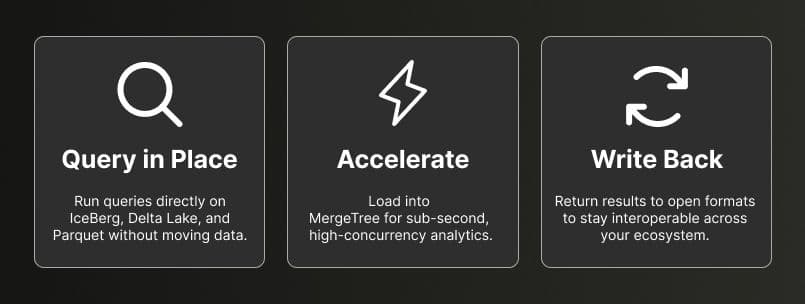
お使いのデータレイクで ClickHouse のパワーを余すところなく活用できるようになりました。どのカタログやクラウドを使っていても、同じ SQL、同じ使用感で利用できます。現在利用可能な 3 つの方法をご紹介します。
その場で高速にクエリを実行する
ClickHouse は、データをどこにも移動させることなく、データレイク上で直接クエリできるようになりました。S3、GCS、Azure 上の Iceberg、Delta Lake、Parquet データを指定すれば、すぐにクエリできます。内部では、ClickHouse がオープンテーブルフォーマットからメタデータを読み取り、スキーマを自動的に推論します。AWS Glue、Unity Catalog、REST Catalog などのカタログとも連携可能です。
ClickHouse は、場合によっては他のクエリエンジンよりも高速に動作します。しかし、より大きな強みはその柔軟性にあります。ClickHouse はクラウドにもカタログにも依存しません。データがどこにあっても、どのカタログで管理されていても、ClickHouse はそれらすべてにアクセスできる単一のクエリエンジンを提供します。
複数のカタログにまたがるフェデレーションを実行し、同一の SQL を使ってカタログ間でデータを JOIN することも可能です。
データレイクは、ClickHouse 内のもう 1 つのデータベースとしてそのまま認識されます。
このようなシナリオを考えてみましょう。データチームがユーザーの解約率の急増を調査する必要があるとします。データは S3 上の Iceberg にあり、AWS Glue を通じて管理されています。データをクエリ可能な場所へ移動するパイプラインを構築する代わりに、ClickHouse をそのデータに向けて指定すれば、すぐに探索を始められます。同じ SQL、即時のアクセスが可能になり、エンジニアリングチームの作業完了を待つ必要もありません。
以下のクエリは S3 上の Iceberg テーブルを直接参照し、レコード数と運賃(fare_amount)の分位数を返します。
SELECT
count(),
quantiles(0.5, 0.75, 0.9, 0.99)(fare_amount)
FROM icebergS3('https://storage.googleapis.com/biglake-public-nyc-taxi-iceberg/public_data/nyc_taxicab/');┌────count()─┬─quantiles(0.⋯are_amount)─┐
│ 1293069366 │ [9,14,22,52] │
└────────────┴──────────────────────────┘
1 row in set. Elapsed: 50.068 sec. Processed 1.29 billion rows, 17.55 GB (25.83 million rows/s., 350.58 MB/s.)
Peak memory usage: 63.12 MiB.あるいは、カタログに接続して、それが管理する任意のテーブルをクエリすることもできます。 まず、利用料金をご自身の Google アカウントに請求するための権限を設定する必要があります。
export PROJECT_ID="<project_id>"
export EMAIL="<email>"
gcloud services enable biglake.googleapis.com --project=$PROJECT_ID
gcloud projects add-iam-policy-binding $PROJECT_ID
--member="user:$EMAIL"
--role="roles/biglake.viewer"
gcloud projects add-iam-policy-binding $PROJECT_ID
--member="user:$EMAIL"
--role="roles/storage.objectViewer"
gcloud auth application-default set-quota-project $PROJECT_ID
gcloud auth application-default login
--scopes="https://www.googleapis.com/auth/cloud-platform,https://www.googleapis.com/auth/iam"設定が完了したら、BigLake カタログを指すデータベースを作成できます。
CREATE DATABASE biglake
ENGINE = DataLakeCatalog('https://biglake.googleapis.com/iceberg/v1/restcatalog')
SETTINGS
catalog_type = 'biglake',
google_adc_client_id = '',
google_adc_client_secret = '',
google_adc_refresh_token = '',
google_adc_quota_project_id = '',
warehouse = 'gs:///';上記サンプルの設定項目には、認証情報ファイルから読み取った認証情報を指定する必要があります。
本稿執筆時点では、Iceberg サポートはまだベータ段階であるため、
allow_database_iceberg=1の設定を構成する必要があります。
データベースを作成したら、その中のテーブルをクエリできます。
SELECT
count(),
avg(fare_amount),
max(fare_amount),
quantiles(0.5, 0.75, 0.9, 0.99)(fare_amount),
median(fare_amount)
FROM biglake.`public_data.nyc_taxicab`
GROUP BY ALL;Row 1:
──────
count(): 1293069366 -- 1.29 billion
avg(fare_amount): 12.325858933602774
max(fare_amount): 998310
quantiles(0.⋯are_amount): [9,14,22,52]
median(fare_amount): 9
1 row in set. Elapsed: 51.147 sec. Processed 1.29 billion rows, 17.55 GB (25.28 million rows/s., 343.19 MB/s.)
Peak memory usage: 122.69 MiB.SELECT
toHour(pickup_datetime) AS hour,
avg(trip_distance) AS avg_distance,
avg(total_amount) AS avg_fare,
count() AS trips
FROM biglake.`public_data.nyc_taxicab`
GROUP BY hour
ORDER BY hour ASC;┌─hour─┬───────avg_distance─┬───────────avg_fare─┬────trips─┐
│ 0 │ 8.112041044132008 │ 15.526927635270393 │ 47879195 │ -- 47.88 million
│ 1 │ 6.785222437788446 │ 15.052749704027802 │ 34934869 │ -- 34.93 million
│ 2 │ 7.407750625736156 │ 14.76697933689647 │ 25650987 │ -- 25.65 million
│ 3 │ 7.657523650630094 │ 15.283234402593072 │ 18652780 │ -- 18.65 million
│ 4 │ 9.31540622346101 │ 17.573114561330925 │ 13776900 │ -- 13.78 million
│ 5 │ 11.588025098571462 │ 19.706420763167998 │ 12637532 │ -- 12.64 million
│ 6 │ 9.745398309303608 │ 15.61424064665526 │ 27208315 │ -- 27.21 million
│ 7 │ 5.029114605823485 │ 14.334673041209152 │ 46858474 │ -- 46.86 million
│ 8 │ 5.997686015180531 │ 14.345667705243487 │ 58135645 │ -- 58.14 million
│ 9 │ 6.3355125177348155 │ 14.340152953723262 │ 60083794 │ -- 60.08 million
│ 10 │ 4.418390507581312 │ 14.416366144054908 │ 59271469 │ -- 59.27 million
│ 11 │ 5.419518100945745 │ 14.62377920076008 │ 61551480 │ -- 61.55 million
│ 12 │ 6.216885853896169 │ 14.697381827240532 │ 64966072 │ -- 64.97 million
│ 13 │ 5.475978455895815 │ 15.154941814778102 │ 64817919 │ -- 64.82 million
│ 14 │ 6.652825409842271 │ 15.684872166503094 │ 67360670 │ -- 67.36 million
│ 15 │ 6.423309499236642 │ 15.801439058909274 │ 64772331 │ -- 64.77 million
│ 16 │ 6.299770010900412 │ 16.67369163194398 │ 56957482 │ -- 56.96 million
│ 17 │ 4.95315626472069 │ 16.038749112293292 │ 67184352 │ -- 67.18 million
│ 18 │ 4.456214572757751 │ 15.188949293837657 │ 79296851 │ -- 79.30 million
│ 19 │ 5.145068799707873 │ 14.685932167610192 │ 80469021 │ -- 80.47 million
│ 20 │ 4.601634515827461 │ 14.8398186781247 │ 75007166 │ -- 75.01 million
│ 21 │ 5.646558343981034 │ 15.039326033758444 │ 73539351 │ -- 73.54 million
│ 22 │ 6.50326126765614 │ 15.357166060024737 │ 70622385 │ -- 70.62 million
│ 23 │ 6.2432607112900405 │ 15.618929242378396 │ 61432633 │ -- 61.43 million
│ ᴺᵁᴸᴸ │ ᴺᵁᴸᴸ │ ᴺᵁᴸᴸ │ 1693 │
└──────┴────────────────────┴────────────────────┴──────────┘
25 rows in set. Elapsed: 129.854 sec. Processed 1.29 billion rows, 17.55 GB (9.96 million rows/s., 135.17 MB/s.)
Peak memory usage: 651.80 MiB.分析を高速化する
レイク上のデータを直接クエリする手法は、探索やアドホック分析に適しています。しかし、高い同時実行性のもとでサブ秒単位の応答時間が求められる場合、ネットワーク経由でのファイル読み込みがボトルネックになります。そうした場面では、ClickHouse ネイティブのストレージエンジンである MergeTree にデータをロードします。インデックス作成、圧縮、スマートなデータスキッピングが適用され、S3 上のファイルをスキャンするのに数秒かかっていた同じクエリが、桁違いに高速に実行されるようになります。
これによって何が可能になるかを考えてみてください。たとえば、エンドユーザー向けの分析ダッシュボードを構築しているとします。ユーザーはサブ秒の応答時間を期待しており、何百人ものユーザーが同時にクエリを実行しています。クエリのたびにオブジェクトストレージ上のファイルを直接スキャンしていては到底対応できません。ミリ秒単位のレイテンシが重要になります。
データが MergeTree に保存されると、ClickHouse は分析ワークロード専用に設計されたさまざまな最適化を適用できます。スパースプライマリインデックスにより、データセット全体をスキャンする代わりに、関連するデータグラニュールのみが読み込まれます。クエリ結果キャッシュ、述語レベルのキャッシュ、ローカル SSD キャッシュ、分散キャッシュを含む多層キャッシュによって、ストレージから読み込む必要のあるデータ量がさらに削減されます。
同様に重要な点として、データフォーマットとクエリエンジンが一体となって設計されていることが挙げられます。MergeTree は効率的な JSON 処理を含む豊富なデータ型をサポートしており、オープンなファイルを直接クエリするだけでは不可能なエンジンレベルの最適化を実現します。その結果、単に分析機能を提供するのと、リアルタイムかつサブ秒単位の分析を大規模に実現するのとでは決定的な差が生まれます。
BigLake を使った高速化ワークフローがどのようなものか見てみましょう。まず、ClickHouse 内にネイティブテーブルを作成します。
CREATE TABLE nyc_taxi
(
`pickup_datetime` DateTime64(6, 'UTC'),
`dropoff_datetime` DateTime64(6, 'UTC'),
`passenger_count` Int64,
`trip_distance` Decimal(10, 0),
`payment_type` String,
`fare_amount` Decimal(10, 0),
`tip_amount` Decimal(10, 0),
`total_amount` Decimal(10, 0),
`pickup_location_id` String,
`dropoff_location_id` String
)
ENGINE = MergeTree
ORDER BY pickup_datetime次に、BigLake カタログからデータを取り込みます。
INSERT INTO nyc_taxi
SELECT
pickup_datetime,
dropoff_datetime,
passenger_count,
trip_distance,
payment_type,
fare_amount,
tip_amount,
total_amount,
pickup_location_id,
dropoff_location_id
FROM biglake.`public_data.nyc_taxicab`;1293069366 rows in set. Elapsed: 683.687 sec. Processed 1.29 billion rows, 17.55 GB (1.89 million rows/s., 25.67 MB/s.)
Peak memory usage: 2.65 GiB.続いて、このテーブルに対していくつかクエリを実行してみます。
SELECT
toHour(pickup_datetime) AS hour,
avg(trip_distance) AS avg_distance,
avg(total_amount) AS avg_fare,
count() AS trips
FROM nyc_taxi
GROUP BY hour
ORDER BY hour ASC;┌─hour─┬───────avg_distance─┬───────────avg_fare─┬────trips─┐
│ 0 │ 8.111754213915164 │ 15.526378625225163 │ 47880888 │ -- 47.88 million
│ 1 │ 6.785222437788446 │ 15.052749704027802 │ 34934869 │ -- 34.93 million
│ 2 │ 7.407750625736156 │ 14.76697933689647 │ 25650987 │ -- 25.65 million
│ 3 │ 7.657523650630094 │ 15.283234402593072 │ 18652780 │ -- 18.65 million
│ 4 │ 9.31540622346101 │ 17.573114561330925 │ 13776900 │ -- 13.78 million
│ 5 │ 11.588025098571462 │ 19.706420763167998 │ 12637532 │ -- 12.64 million
│ 6 │ 9.745398309303608 │ 15.61424064665526 │ 27208315 │ -- 27.21 million
│ 7 │ 5.029114605823485 │ 14.334673041209152 │ 46858474 │ -- 46.86 million
│ 8 │ 5.997686015180531 │ 14.345667705243487 │ 58135645 │ -- 58.14 million
│ 9 │ 6.3355125177348155 │ 14.340152953723262 │ 60083794 │ -- 60.08 million
│ 10 │ 4.418390507581312 │ 14.416366144054908 │ 59271469 │ -- 59.27 million
│ 11 │ 5.419518100945745 │ 14.62377920076008 │ 61551480 │ -- 61.55 million
│ 12 │ 6.216885853896169 │ 14.697381827240532 │ 64966072 │ -- 64.97 million
│ 13 │ 5.475978455895815 │ 15.154941814778102 │ 64817919 │ -- 64.82 million
│ 14 │ 6.652825409842271 │ 15.684872166503094 │ 67360670 │ -- 67.36 million
│ 15 │ 6.423309499236642 │ 15.801439058909274 │ 64772331 │ -- 64.77 million
│ 16 │ 6.299770010900412 │ 16.67369163194398 │ 56957482 │ -- 56.96 million
│ 17 │ 4.95315626472069 │ 16.038749112293292 │ 67184352 │ -- 67.18 million
│ 18 │ 4.456214572757751 │ 15.188949293837657 │ 79296851 │ -- 79.30 million
│ 19 │ 5.145068671830865 │ 14.685932167610192 │ 80469021 │ -- 80.47 million
│ 20 │ 4.601634515827461 │ 14.8398186781247 │ 75007166 │ -- 75.01 million
│ 21 │ 5.646558343981034 │ 15.039326033758444 │ 73539351 │ -- 73.54 million
│ 22 │ 6.50326126765614 │ 15.357166060024737 │ 70622385 │ -- 70.62 million
│ 23 │ 6.2432607112900405 │ 15.618929242378396 │ 61432633 │ -- 61.43 million
└──────┴────────────────────┴────────────────────┴──────────┘
24 rows in set. Elapsed: 13.578 sec. Processed 1.29 billion rows, 31.03 GB (95.23 million rows/s., 2.29 GB/s.)
Peak memory usage: 26.40 MiB.この比較をご自身で試してみたい場合は、スタートガイドを参照して実際に実行してみてください。
しかし、高速化したデータ自体はどうでしょうか。その集計結果を自社エコシステムの他のツールからも利用したい場合はどうすればよいでしょうか。
相互運用性
データを MergeTree に配置したからといって、そこに閉じ込めておく必要はありません。リバース ETL のシナリオ向けに、結果を Iceberg や Delta Lake に書き戻すことができます。データレイクへ直接書き込む場合でも、一度データを取り込んで高速化し、その結果を書き戻す場合でも、ClickHouse はオープンなエコシステムとの完全な相互運用性を維持します。これは私たちのオープンソースの DNA に組み込まれているものです。ロックインされる心配はありません。
分析チームが ClickHouse でセグメンテーションモデルを実行し、最重要顧客を特定したとします。CSV をエクスポートしてメールでやり取りする代わりに、結果を Iceberg に書き戻せます。これにより、データサイエンスチームは Spark でそのデータを取得し、マーケティングチームは BI ツールからアクセスでき、データはデータレイクの外に出ることすらありません。
たとえば、集計結果を Iceberg テーブルに書き戻したい場合は、以下のように実行できます。
CREATE TABLE output_iceberg (
Url String,
Cnt UInt64
) ENGINE = IcebergS3(‘[https://your-bucket.s3.amazonaws.com/output/](https://your-bucket.s3.amazonaws.com/output/)’, ‘key’, ‘secret’);INSERT INTO output_iceberg
SELECT url, count() AS cnt
FROM hits_accelerated
GROUP BY url
ORDER BY cnt DESC;2026年3月25日現在、カタログへの Iceberg 書き込みサポートはまだ利用できませんが、近日中に追加される予定です。
生成された Iceberg テーブルは、Spark、Trino、DuckDB など、Iceberg と互換性のあるあらゆるエンジンから読み取ることができます。
ClickHouse を使えば、レイクからデータを読み取ってその場でクエリし、MergeTree にロードしてクエリを高速化し、その結果をオープンフォーマットに書き戻すことができます。3 つすべてを利用することも、どれか 1 つだけを利用することも可能です。信頼できる唯一の情報源(Source of Truth)は常にデータレイクであり続けます。
お使いのスタックでも利用できるかどうかが気になるところですが、もちろん動作します。
サポートされている機能
ClickHouse は、すでに利用されている各種フォーマット、カタログ、クラウドストレージと連携します。フォーマット側では、Iceberg、Delta Lake、Parquet、ORC、Avro、Hudi に対応しています。カタログでは、AWS Glue、Unity Catalog、REST Catalog、Polaris などに対応しています。ストレージでは、S3、GCS、Azure Blob Storage に対応しています。また、可能な操作は読み込みだけにとどまりません。書き込み、DML、タイムトラベル、スキーマ進化も利用できます。
詳細な一覧については、サポートマトリクスをご確認ください。
まとめ
オープンフォーマットは、データを一度保存すればどこからでもクエリできる自由をチームにもたらしました。ClickHouse により、そのデータレイクはファーストクラスのデータベースへと進化しました。どのクラウドのどのカタログに向けても、即座にクエリを開始できます。同じ SQL、同じエンジン、そしてオープンエコシステムとの完全な相互運用性が得られます。データを移行したり、パイプラインを再構築したり、スタック構築の基盤となったオープン性をパフォーマンスのために犠牲にする必要はありません。
そして、この重要性は 2 年前よりもさらに高まっています。レイクデータ上でエージェント型アプリケーション、AI 搭載のオブザーバビリティツール、自然言語分析インターフェースを構築するチームが増えるにつれ、求められる要件はリアルタイム分析にきわめて近くなっています。すなわち、高い同時実行性、低レイテンシ、そして忠実度の高い完全なデータへの大規模なアクセスです。プロダクトおよびマーケティング担当 VP である Tanya Bragin は、この AI へのシフトがデータベース市場をどのように塗り替えているか、そして現在行うインフラの選択が将来何を構築できるかを決定づける理由について執筆しています。
私たちは今後の展開に大いに期待しています。ぜひご自身で試してみて、ご意見をお聞かせください。