5万

TL;DR
クラウドオブジェクトストレージ向けの分散キャッシュを構築しました。すべてのコンピュートノードからホットデータへ高速にアクセスできるようにする、低レイテンシの共有レイヤーです。
本記事ではその内部構造を掘り下げます。従来のホットデータキャッシュの仕組み、オブジェクトストレージでキャッシュが難しくなっていた理由、そして新アーキテクチャによるその解決策について解説します。ベンチマーク結果も掲載しています。
→ 現在、分散キャッシュのプライベートプレビューの登録を受け付けています。こちらのフォームからアクセス権を申請してください。
ホットデータが常にホットなままであったら?
キャッシュされたホットデータへのアクセスを失う心配なく、より大規模なコンピュートノードへ切り替えて自由にスケールアップしたり、ノードを追加してスケールアウトしたりできるデータベースを想像してみてください。さらに、あるノードで行われた処理の成果を、他のすべてのノードが即座に活用できる場面を思い描いてみてください。コールドスタートも、ストレージからの重複した読み取りも、無駄な処理も一切ありません。
夢のような話に聞こえるでしょうか。コンピュートとストレージが分離された現代のクラウドデータベースにおいて、ホットデータの連続性を維持することは極めて困難な課題です。
今回、ClickHouse Cloud 向けの分散キャッシュを発表します。ノードがスケールアップ、スケールダウン、あるいは切り替えられたとしても、ホットデータを常にコンピュートの近くに保持するという長年の課題を解決する共有キャッシュレイヤーです。
本記事では、ClickHouse におけるキャッシュの進化、分散キャッシュの仕組み、そしてそれが性能と俊敏性の面でもたらす利点について順を追って解説します。
最後に、SSD を備えた自己管理型(セルフマネージド)サーバーを含む従来のアプローチとのベンチマーク比較を行います。(少し先にお伝えすると、SSD サーバーを上回る結果となりました。コールドスタート時ですら上回っています。)
クエリエンジンの近くにホットデータをキャッシュすることがなぜ重要なのか、そしてなぜ分散キャッシュを構築したのかを理解するために、まずは何がキャッシュされるのかを見ていきましょう。
「ホットなテーブルデータ」とは何か、なぜ重要なのか
ClickHouse には、DNS エントリ、入力ファイルのスキーマ、テーブルメタデータ、スパースプライマリインデックスデータやマークファイル、非圧縮のテーブルデータ、コンパイル済み式、クエリ条件に一致するテーブルデータ、さらには完全なクエリ結果に至るまで、ほぼあらゆるものに対応する組み込みキャッシュが備わっています。これらはそれぞれクエリ実行を高速化する役割を果たしており、今後の記事で取り上げる可能性があります。
本記事では、最も効果的な手法の一つである、メモリ内へのホットなテーブルデータのキャッシュに焦点を当てます。
この機能は、そもそも読み取る必要のあるデータ量を徹底的に最小化する ClickHouse の多層 I/O 最適化と連携して機能します。これらの最適化が適用された後、必要なデータ(すなわちホットなテーブルデータ)のみがメモリへストリーミングされ、クエリエンジンによって処理されます。特に繰り返し実行されるクエリにおいてそのストリーミングを高速化するため、ClickHouse はクエリの実行開始前にホットなテーブルデータをキャッシュします。理想的にはクエリエンジンに最も近いローカル RAM 上に保持します。
なぜこれが重要なのか
メモリからの読み取りは、ディスクからの読み取りに比べて圧倒的に高速です。ミリ秒に対してナノ秒、数 GB/s に対して約 100 GB/s という世界です。レイテンシは 100 万倍改善し、スループットは桁違いに向上します。
これらの具体的な数値については後ほど詳しく解説します。まずは実際の運用において「ホットなテーブルデータ」が何を意味するのかを整理しましょう。
下の図は、テーブルに対して実行されるクエリを簡略化して表したものです。
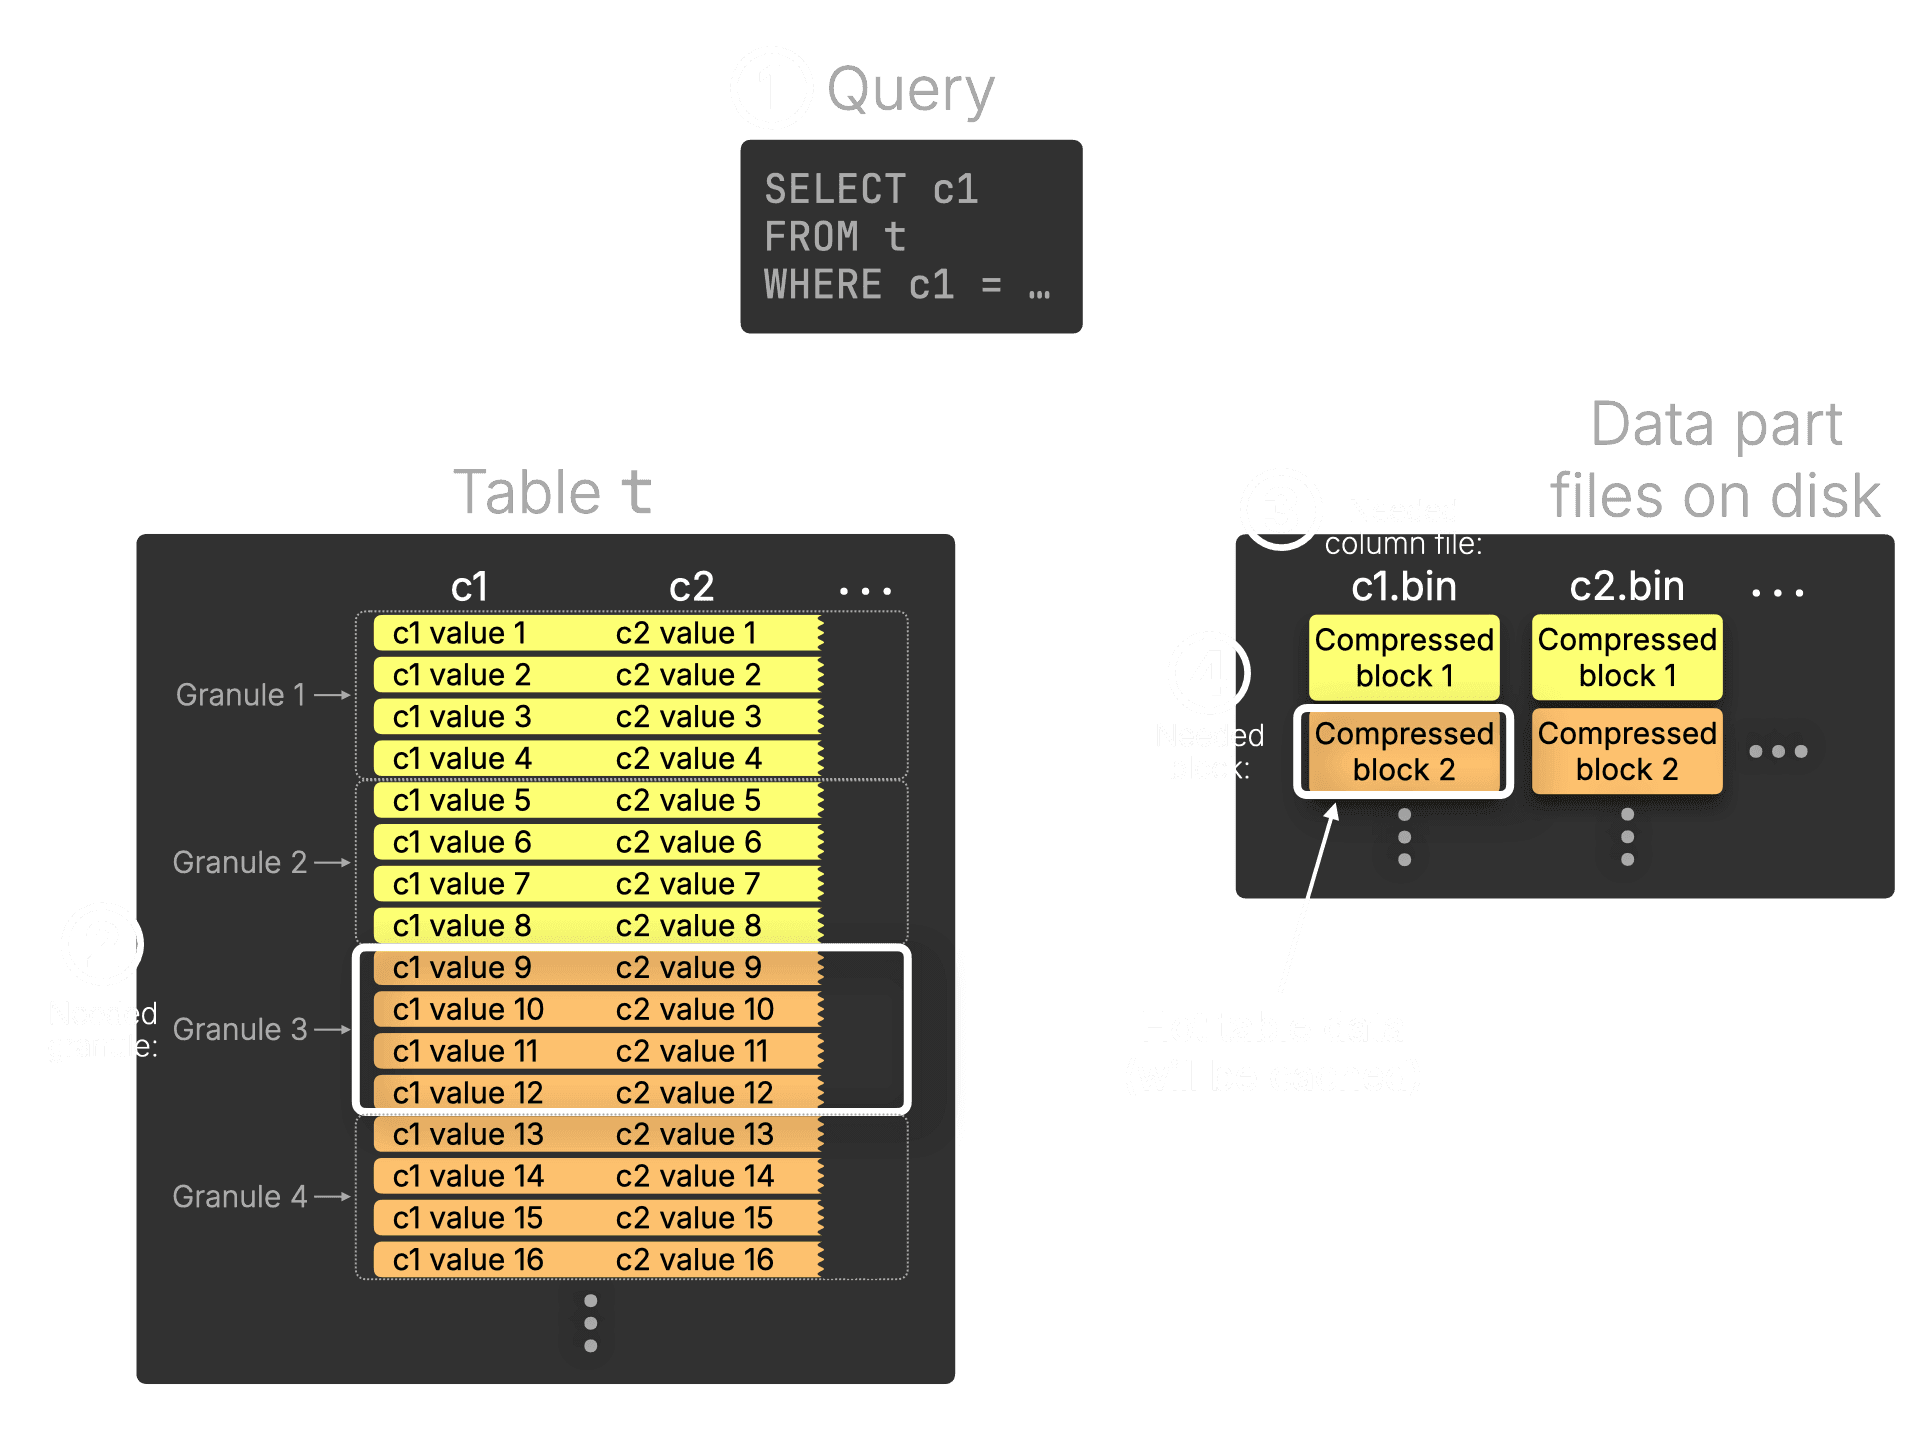
① クエリ
SELECT がカラム c1 を対象とし、WHERE 句で特定の行をフィルタリングします。
② 必要なグラニュール
テーブルは ClickHouse の最小クエリ処理単位であるグラニュールに分割されており、デフォルトでは各グラニュールが 8,192 行を含みます。この簡略図では、1 グラニュールあたり 4 行として示しています。インデックスの解析により、クエリに一致する行を含む可能性がある対象として、グラニュール 3 が選択されます。
③ ④ 必要なカラムファイルとブロック
ディスク上の各カラムは(データパートディレクトリ内の)個別のファイルとして保存され、複数のグラニュールにまたがる圧縮ブロックで構成されます。この例では、各ブロックが 2 つのグラニュールをカバーしています。クエリエンジンは読み取り対象のカラムファイルとして c1.bin を特定し、このファイルのブロック 2 に選択されたグラニュールが含まれていると判断します。したがって、このブロックが本クエリにおけるホットなテーブルデータとなります。
「ホットなテーブルデータ」とは何か
技術的な観点では、クエリに対するホットデータとはカラムファイルセグメントを指します。これは、クエリ処理対象として選択されたグラニュールを含む圧縮ブロックの範囲です。これらのセグメントがディスクから読み取られ、以後のクエリを高速化するためにメモリへキャッシュされます。
Get started today
Interested in seeing how ClickHouse works on your data? Get started with ClickHouse Cloud in minutes and receive $300 in free credits.
Sign upClickHouse におけるホットデータキャッシュの進化
これまで ClickHouse におけるホットなテーブルデータのキャッシュは、大きく 3 つの段階を経て進化してきました。
-
最初はローカルディスク上の OS ページキャッシュから始まりました。シンプルで高速ですが、個々のマシンと密結合していました。
-
クラウド環境において、オブジェクトストレージとインメモリ処理のギャップを埋めるため、ローカルのファイルシステムキャッシュを導入しました。
-
そして今回、さらなる一歩を踏み出しました。そのファイルシステムキャッシュを共有ネットワークサービスへと発展させたのです。新たな分散キャッシュは同一のキャッシュロジックをカプセル化しつつ、すべてのコンピュートノードから利用できるようにすることで、整合性、俊敏な拡張性、ホットデータへの即時アクセスを実現します。
それぞれの段階と、それらがどのように分散キャッシュへとつながっていったのかを見ていきましょう。
第1段階:ローカル OS ページキャッシュ
スケールアウトのためにシャーディングを用いる従来のシェアードナッシング型の ClickHouse クラスターでは、各サーバーがローカルディスク上にある自ノードのデータのみを保持し、アクセスします。この構成では、クエリ処理中にディスクから読み込まれたカラムファイルセグメントを透過的かつ自動的にキャッシュするオペレーティングシステムのページキャッシュを ClickHouse は活用します。
次のアニメーションはその動作を示しています(クリックすると全画面で表示されます)。
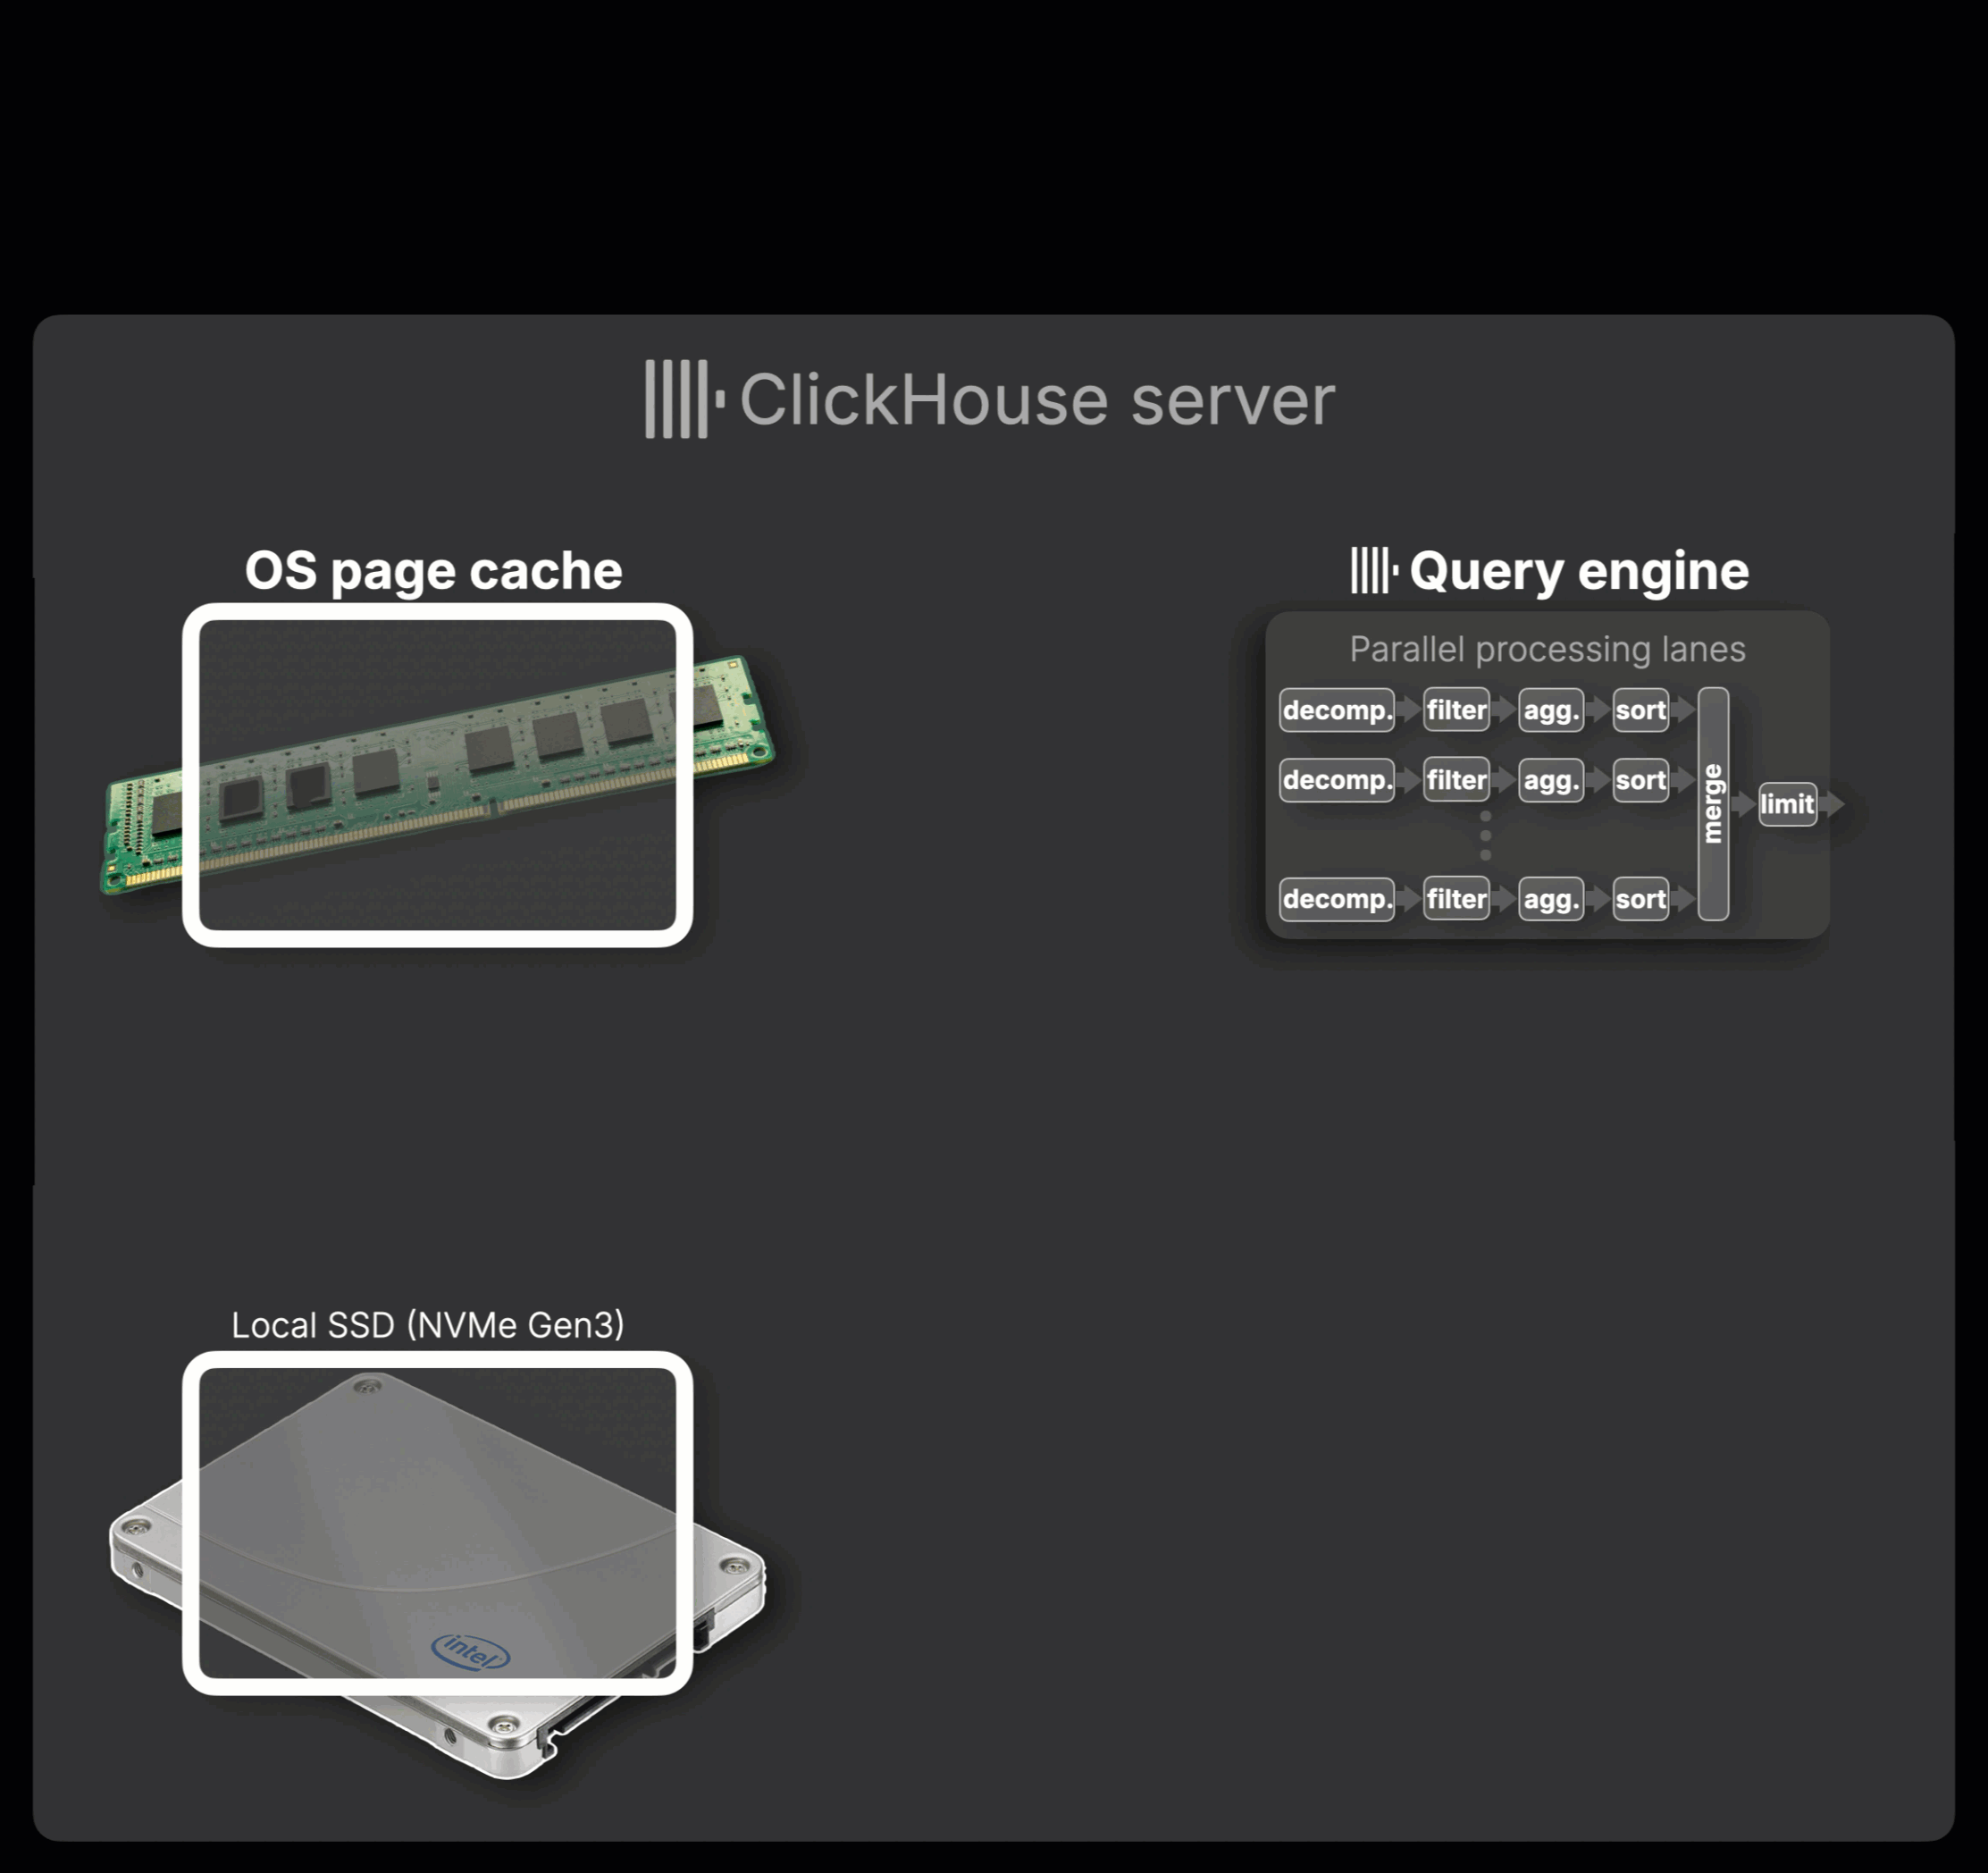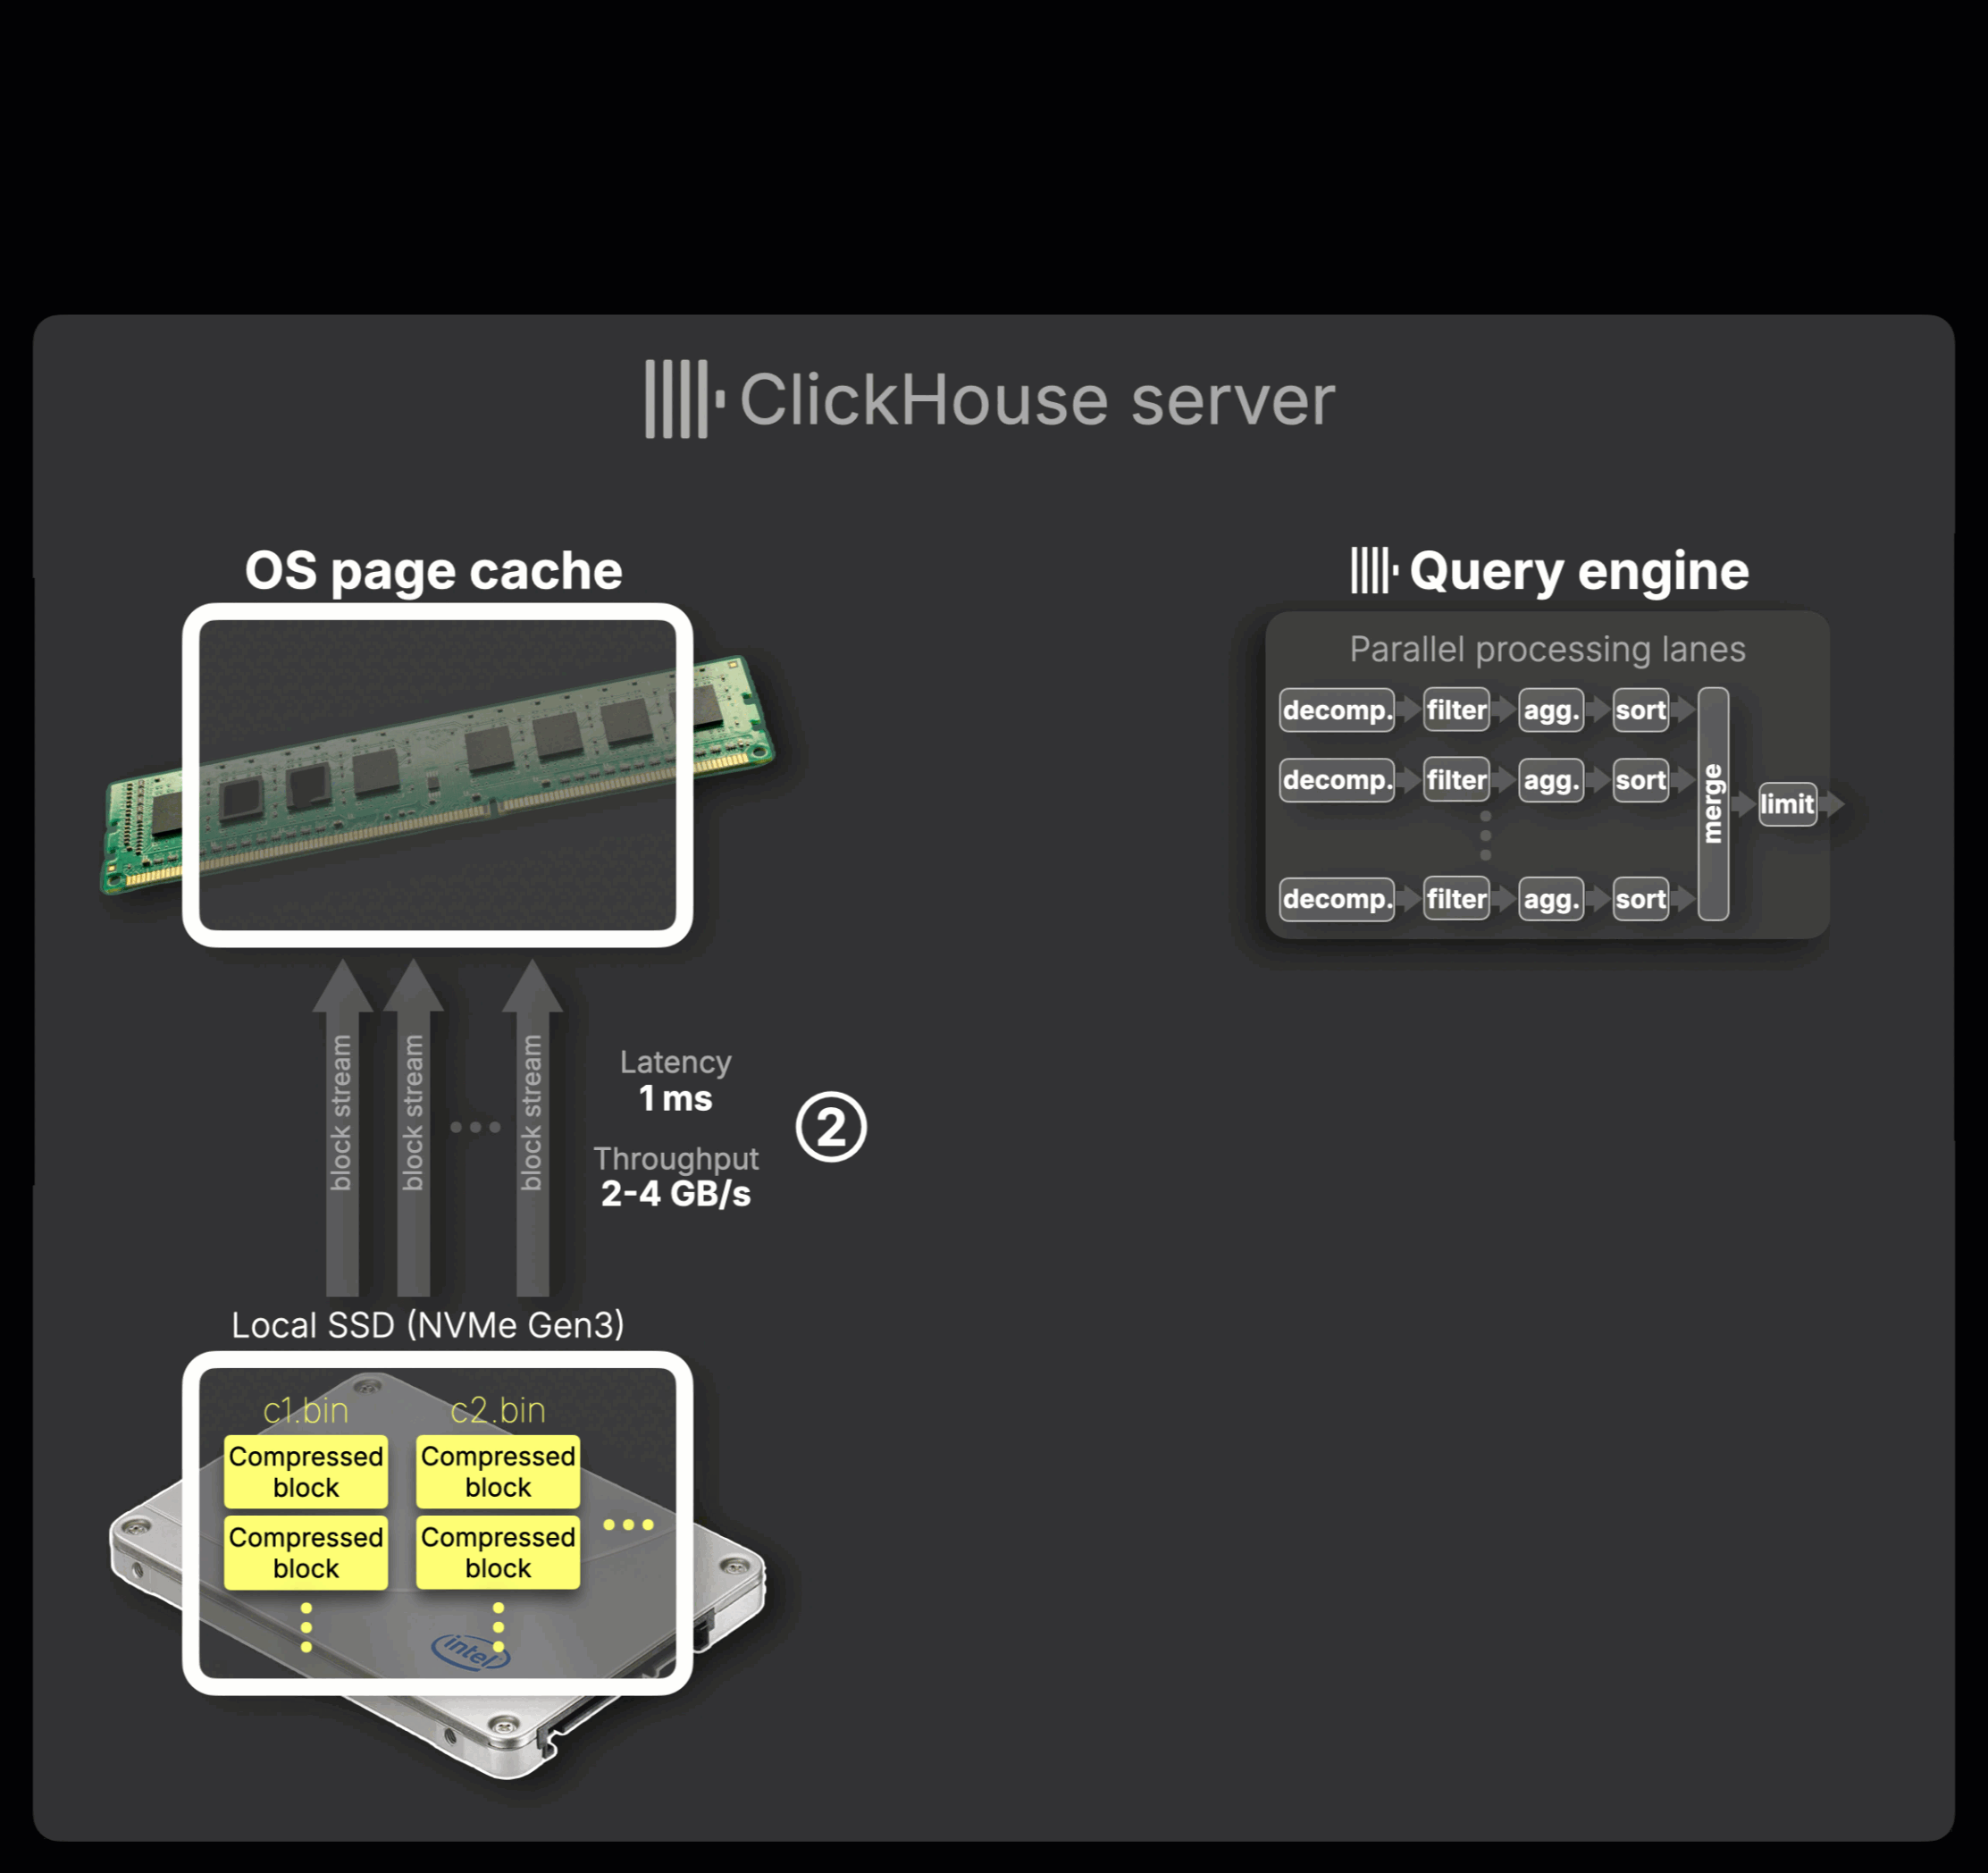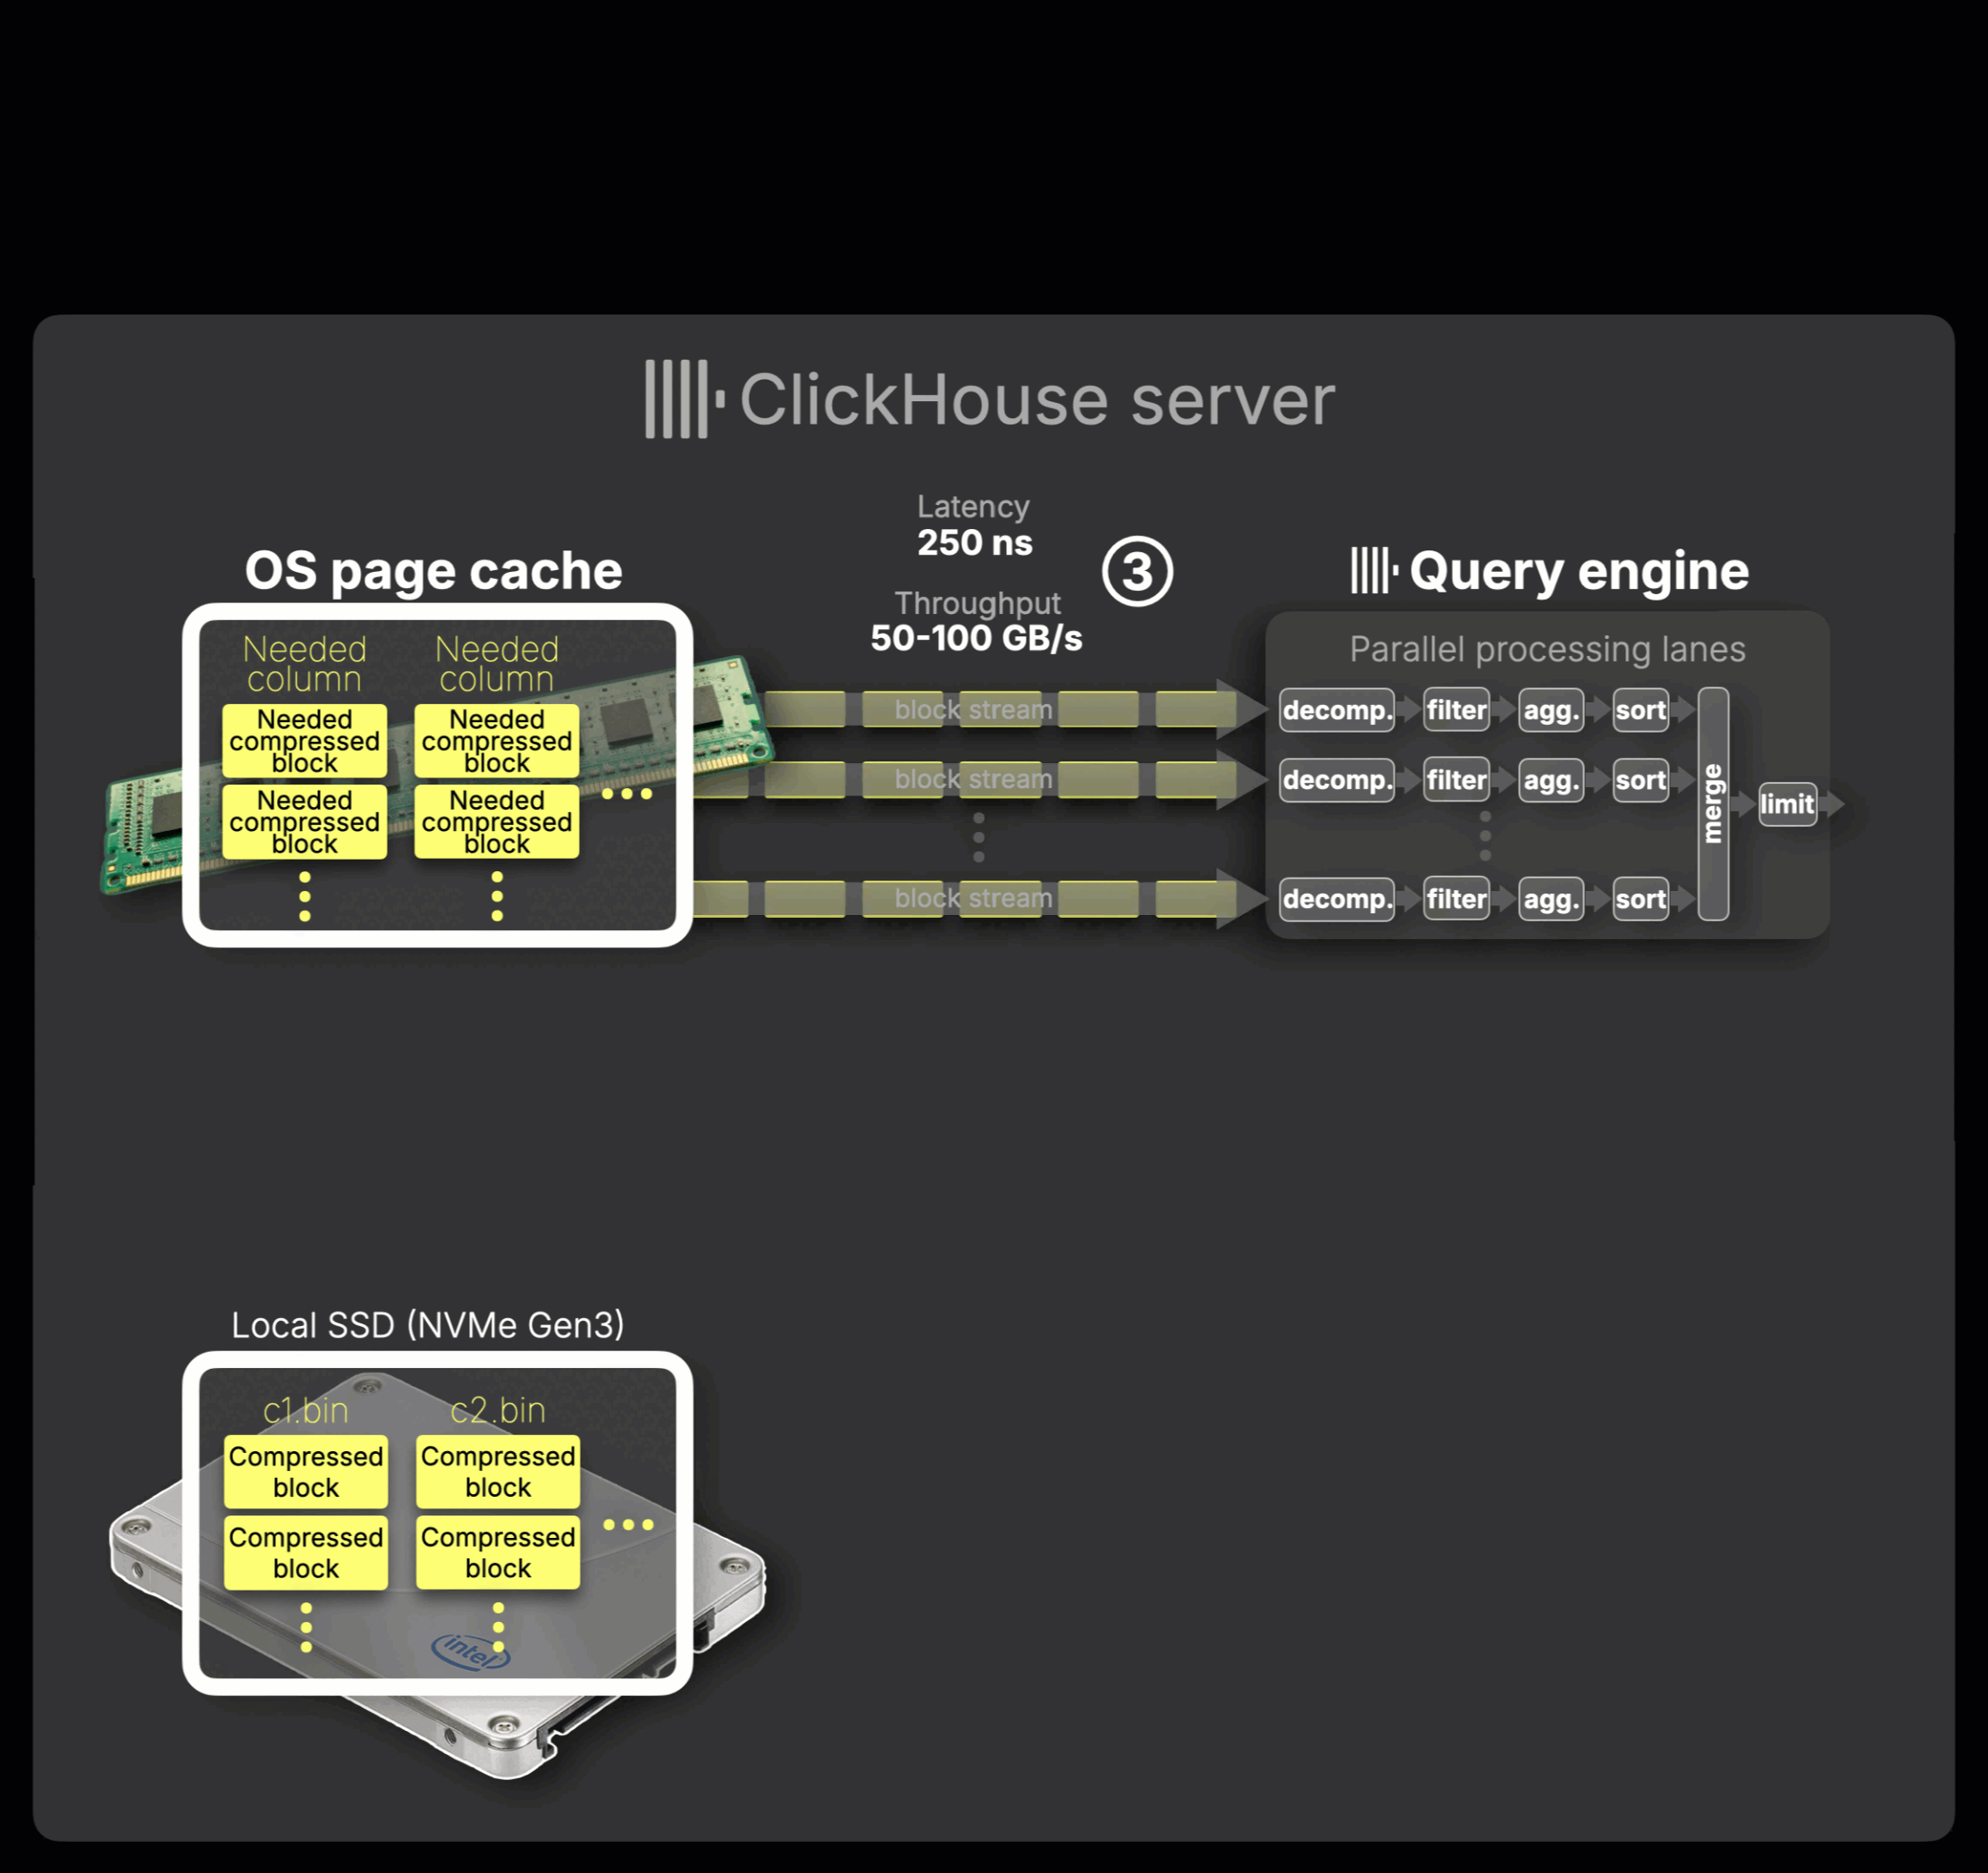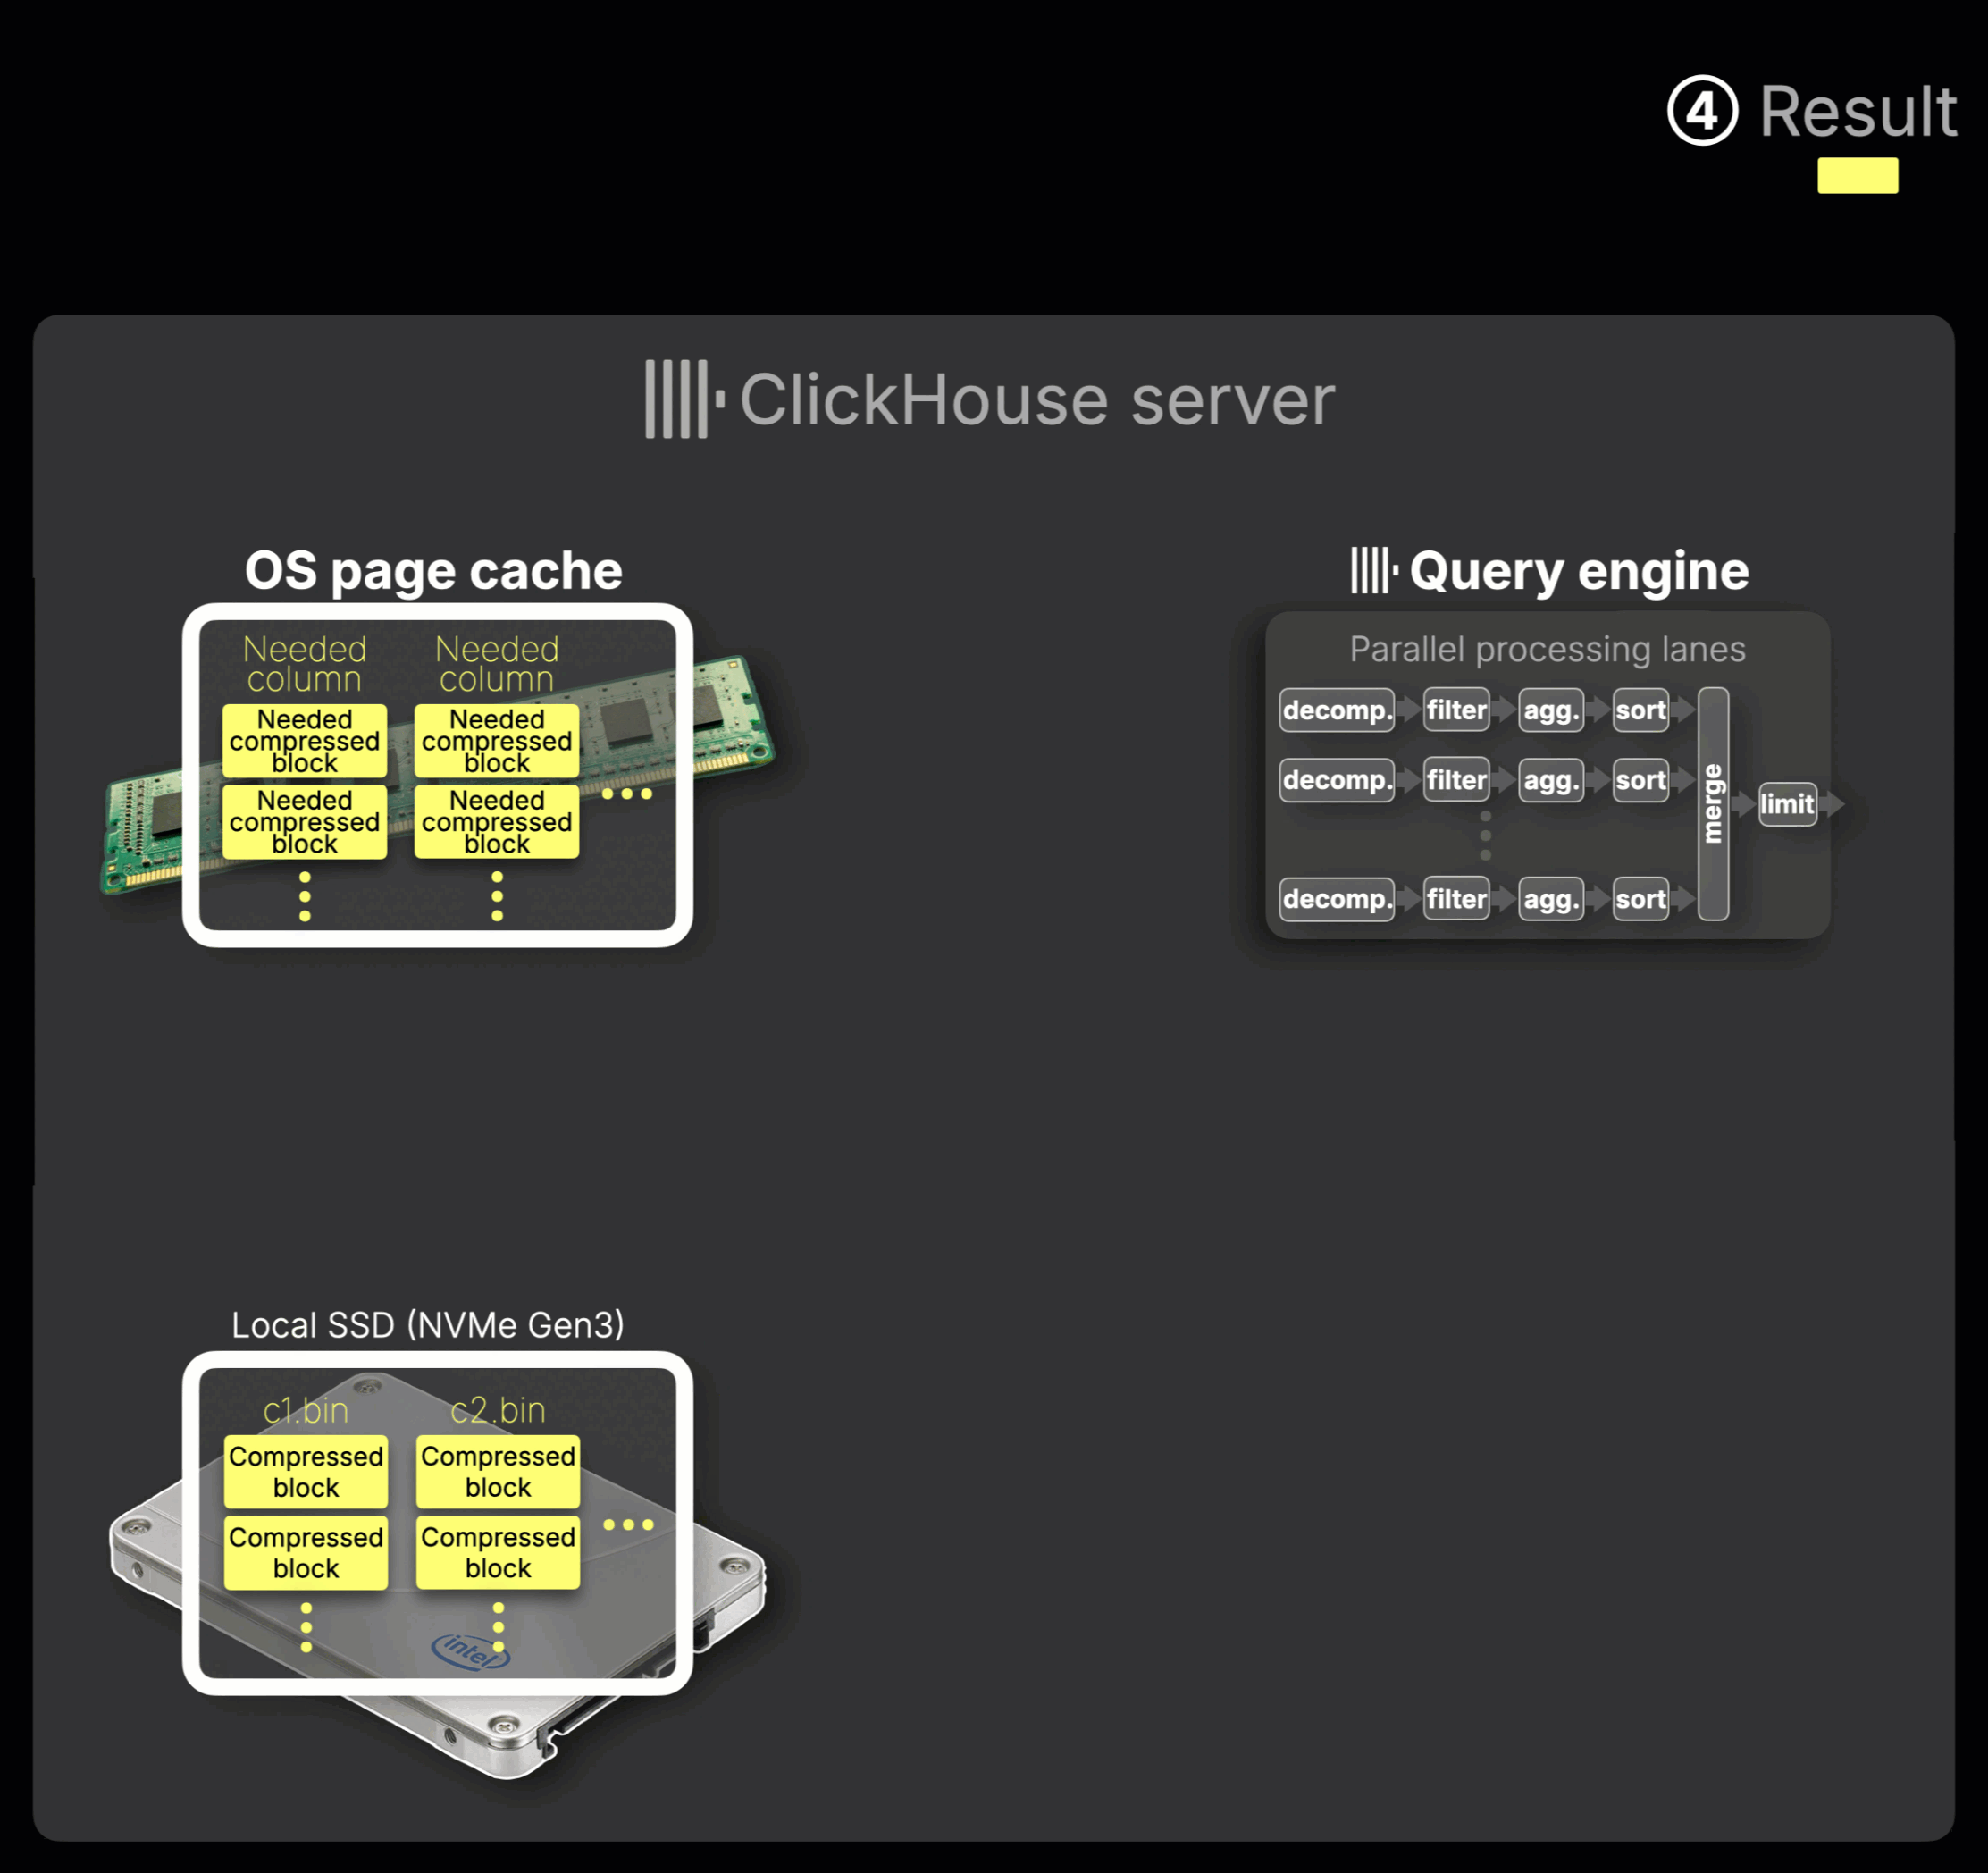
① クエリの到着:
クエリが ClickHouse サーバーに到達します。サーバーはインデックスファイルを解析し、クエリの処理に必要な圧縮カラムブロックを特定します。
② データの読み込み:
必要なブロックがまだキャッシュされていない場合、ローカル SSD(NVMe Gen3 など)から読み出され、自動的に OS ページキャッシュへ格納されます。
③ インメモリ処理:
圧縮ブロックは、ディスクではなくメモリ帯域幅に制約される形で、50〜100 GB/s で OS ページキャッシュからクエリエンジンへストリーミングされます。ClickHouse はストリーミング方式により、ブロック単位ですべてのデータをメモリ内で処理します。複数の独立した並列処理レーンを使用して、データの展開、フィルタリング、集約、ソートを実行します。
これらのレーン数は max_threads 設定によって制御され、デフォルトでは使用可能な CPU コア数と一致します。
アニメーションで示されているように、この同じ設定によって、データがまだキャッシュされていない場合にディスクからデータを読み取る並行ストリーム数も決定され、並列読み込みによるスループットの最大化が図られます。
④ 結果の生成:
処理されたデータは必要に応じてマージおよび制限され、最終的なクエリ結果がクライアントへ返されます。
インメモリキャッシュ戦略
ClickHouse は、読み取りと書き込みの双方で透過的に機能する OS ページキャッシュに依存しています。これにより、読み取った後のデータをメモリに保持するリードスルーキャッシュと、新しく書き込まれたデータを即座にキャッシュしてディスクへアクセスせずにクエリ可能とするライトスルーキャッシュが実現します。データが RAM に収まる限りキャッシュされ続けます。収まらない場合、OS は新しいページ用の領域を確保するために最も長く使われていないページをエビクト(追い出し)します。
レイテンシをさらに短縮するため、ClickHouse はオプションとして**非圧縮ブロックキャッシュ**も提供しています。頻繁にアクセスされるブロックの非圧縮版をメモリ内に保持することで、ホットデータに対する展開処理のオーバーヘッドを排除します。展開処理自体も高速ですが、頻繁に実行される軽量クエリにおいては、展開を完全に省くことでレイテンシの削減とスループットの向上が見込めます。
特に ClickHouse の高い圧縮率を考慮すると、非圧縮ブロックは圧縮ブロックよりも大幅に多くのメモリを消費するため、このキャッシュはデフォルトで無効になっています。
興味深いことに、Alexey Milovidov がこちらのプレゼンテーションで示しているように、多くの場合、圧縮データのインメモリ処理は非圧縮データのインメモリ処理よりも高速に行われます。
これらの最適化は、従来のシェアードナッシング構成でデータがローカルディスク上にある場合には非常に有効に機能します。しかし、ストレージがローカルに存在しなくなった場合はどうなるでしょうか。
第2段階:クラウドコンピュートノード上のローカルキャッシュ
ClickHouse Cloud では、従来のシェアードナッシングクラスターとはキャッシュの動作が異なります。コンピュートとストレージが分離されており、すべてのコンピュートノードが同一の共有オブジェクトストレージから読み取りを行います。個別のシャードを管理するのではなく、実質的に無制限な単一のシャードから読み取りを行うレプリカとして動作します。
しかし、ストレージの共有は、特に性能面において新たな課題をもたらします。
オブジェクトストレージの真のボトルネック:レイテンシ
オブジェクトストレージは十分なスループットを提供できる一方で、アクセスのレイテンシが高い点が実質的な性能のボトルネックになりがちです。これを緩和するため、ClickHouse Cloud では直接アタッチされた SSD を備えるコンピュートノードを使用し、低速だが永続性の高いオブジェクトストレージと、高速だが揮発性のメモリとの中間層として機能するローカルファイルシステムキャッシュを設けています。
各層の比較は以下のとおりです。
| レイヤー | レイテンシ(99.99%) | IOPS | スループット |
|---|---|---|---|
| S3 | 500 ms | 5K | 2 GB/sec |
| SSD | 1 ms | 100K | 4 GB/sec |
| メモリ | 250 ns | 100M | 100 GB/sec |
本記事で解説する分散キャッシュの取り組みとは完全に独立して、さらなる性能向上とコスト最適化の可能性を探るため、AWS で最速のクラウドオブジェクトストレージクラスであり1 桁ミリ秒のレイテンシを誇る Amazon S3 Express One Zone を、プライマリストレージとキャッシュレイヤーの双方へ統合する実験も進めています。詳細はこちら →
表が示すように、テールレイテンシ(99.99 パーセンタイル)においてメモリは S3 よりも数百万倍高速であり、スループットも桁違いです。SSD はその中間に位置し、S3 よりはるかに高速ですが、メモリには依然として遠く及びません。
一般的な EC2 マシン(m7gd.16xlarge など)における S3 と SSD のスループットの差は、ClickHouse Cloud の典型的な構成で 2 GB/s と 4 GB/s であり、一見小さく見えるかもしれませんが、これはすでに高度な最適化が施された結果です。
未最適化の S3 スループットは、通常 1 スレッドあたり数百 MB/s 程度に過ぎません。ClickHouse はマルチスレッド読み取りと非同期プリフェッチを駆使して数 GB/s の性能を達成しています。詳細については、本節で解説しているファイルシステムキャッシュのコア開発者である Kseniia によるディープダイブセッションをご覧ください。
しかしそれでもなお、レイテンシの差は圧倒的です。数百ミリ秒対マイクロ秒あるいはナノ秒の戦いです。スループットとは異なり、レイテンシを隠蔽したり並列化したりすることは極めて困難です。個々の読み取りに数百ミリ秒かかっている状況では、いくらマルチスレッドで読み取りを行っても効果はありません。オブジェクトストレージは、アクセス自体が根本的に遅いのです。
そのため、実際の多くの分析クエリにおいてレイテンシが決定的ボトルネックとなります。遅延を隠せるほど十分に I/O をファンアウトできないためです。
- 短時間で完了するクエリは、多くの場合わずか数個の圧縮ブロックしか参照しません。
- 分散したアクセスパターンでは、細かく分離した読み取りが多数発生します。
どちらの場合も帯域幅の広さは役に立たず、レイテンシがボトルネックになります。
だからこそ、帯域幅だけでなく瞬時と感じられる応答速度を得るためには、クエリエンジンの近くにホットデータをキャッシュすることが極めて重要になります。ファイルシステムキャッシュはまさにその役割を果たし、オブジェクトストレージの高レイテンシからクエリを保護します。
ファイルシステムキャッシュ:ホットデータ以外の用途
ClickHouse Cloud におけるディスクベースのファイルシステムキャッシュは、ホットなテーブルデータのキャッシュにとどまらず、以下の用途にも利用されます。
-
セカンダリデータスキッピングインデックスやマークファイルなどのテーブルメタデータのキャッシュ。
-
集約、ソート、JOIN 処理用の中間クエリデータ(ディスクスピルなど)の一時保存。
-
リモートソースからの外部ファイルのキャッシュ(Parquet ファイルに対するクエリ実行時など)。
ファイルシステムキャッシュの仕組み
ファイルシステムキャッシュは読み取りと書き込みの双方を処理します。
-
ライトスルーキャッシュ: 新しいデータが書き込まれる際、ファイルシステムキャッシュとオブジェクトストレージの両方に保存されます。これには通常の挿入だけでなく、バックグラウンドマージ中に生成されるマージ済みパートも含まれます。これにより永続性は確保されますが、オブジェクトストレージの書き込みレイテンシが隠蔽されるわけではありません。幸いなことに、OS ページキャッシュが最近書き込まれたファイルを自動的にメモリ内に保持するため、SSD + RAM による高速な 2 レベルキャッシュが構成されます。
-
リードスルーキャッシュ: オブジェクトストレージ(S3 など)からデータがストリーミングされると、ローカルのファイルシステムキャッシュへ保存されます。これにより再度のダウンロードが防止され、以後のクエリではローカルディスクと同等の速度でリモートデータへアクセスできるようになります。
キャッシュディスクがいっぱいになった場合、ファイルシステムキャッシュは領域を確保するために最も長く使われていないデータをエビクトします。また、ClickHouse のテーブルパート内のカラムファイルはイミュータブル(不変)であるため、明示的なキャッシュの無効化処理は基本的に不要です。
下のアニメーションは、リードスルーキャッシュが実際にどのように機能するかを示しています(クリックすると全画面で表示されます)。
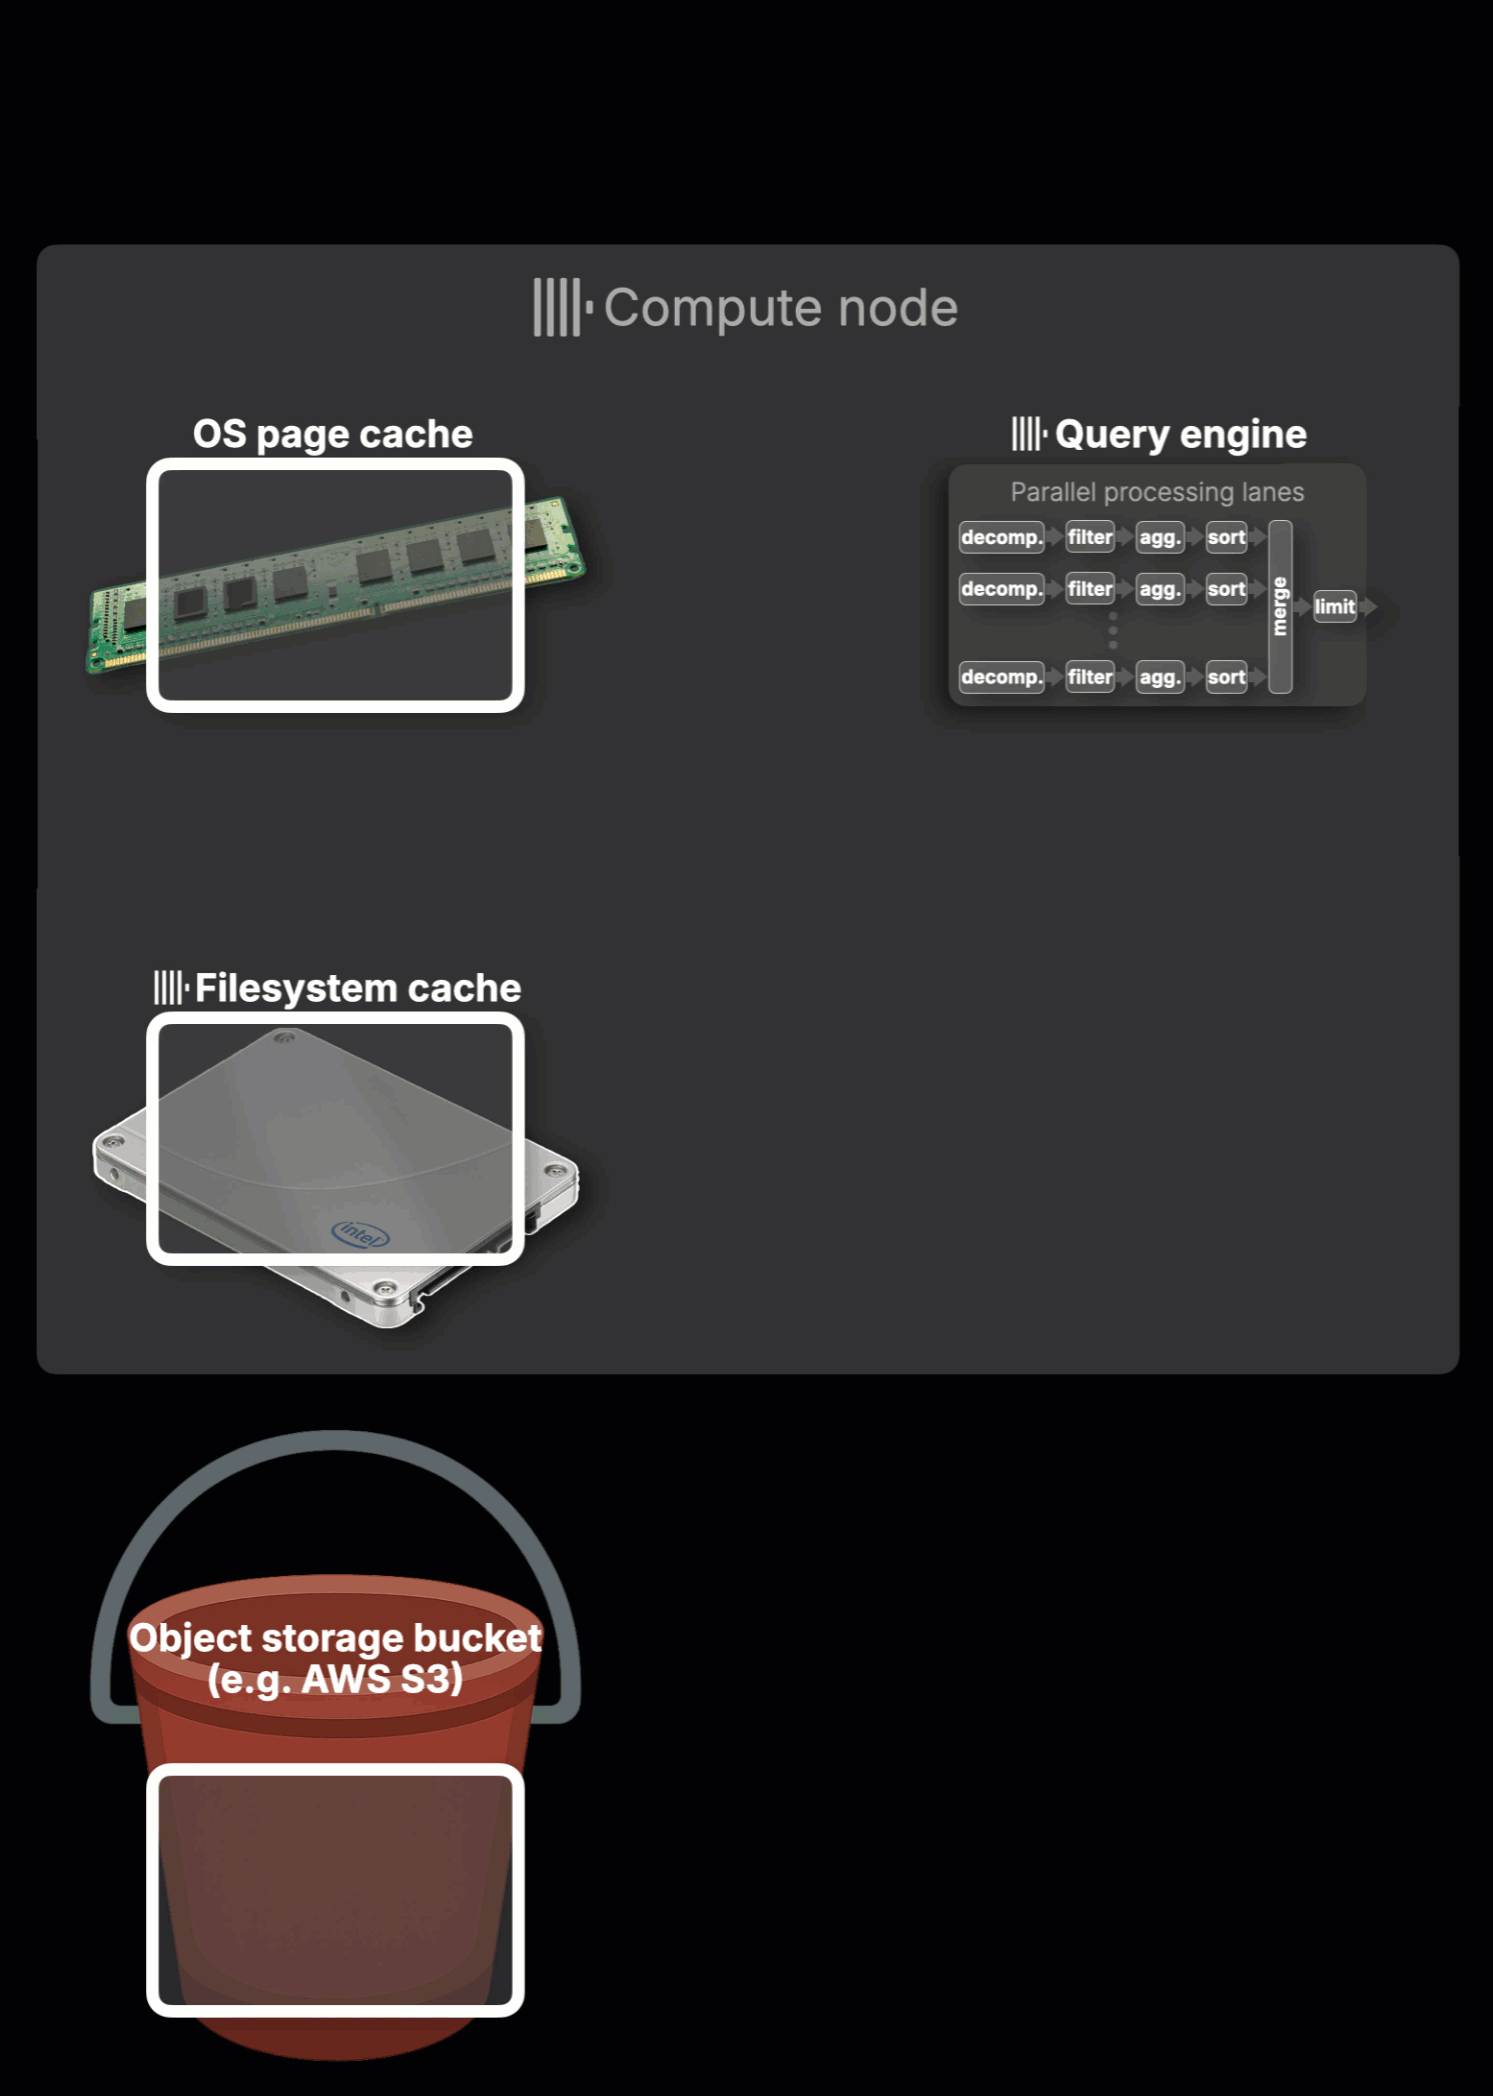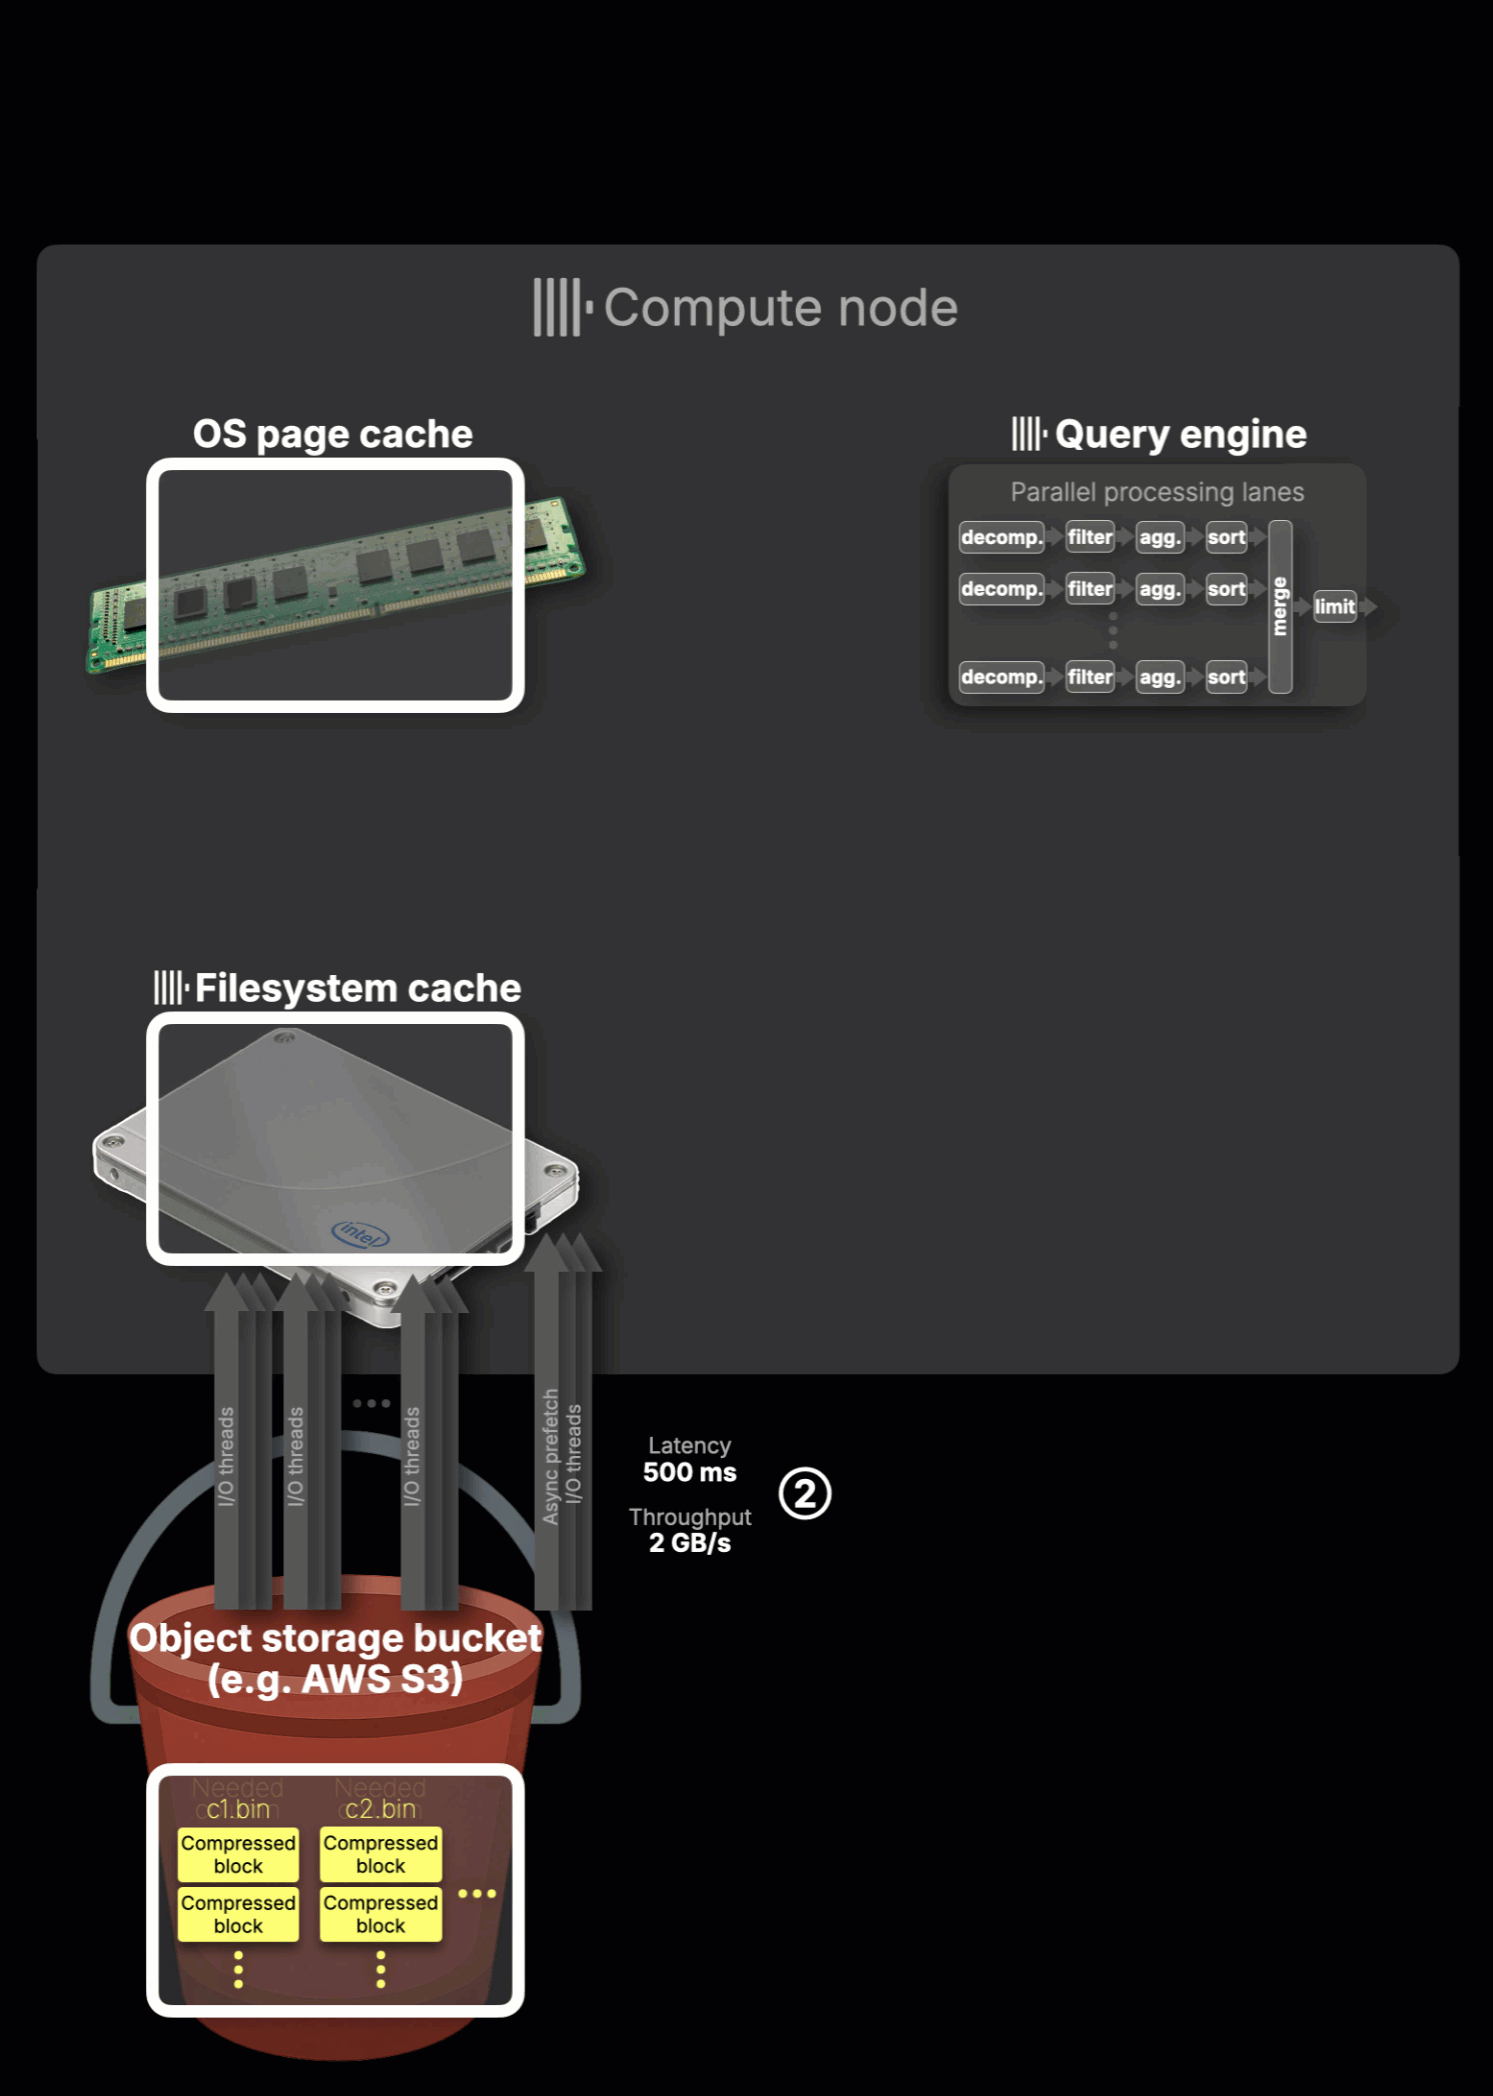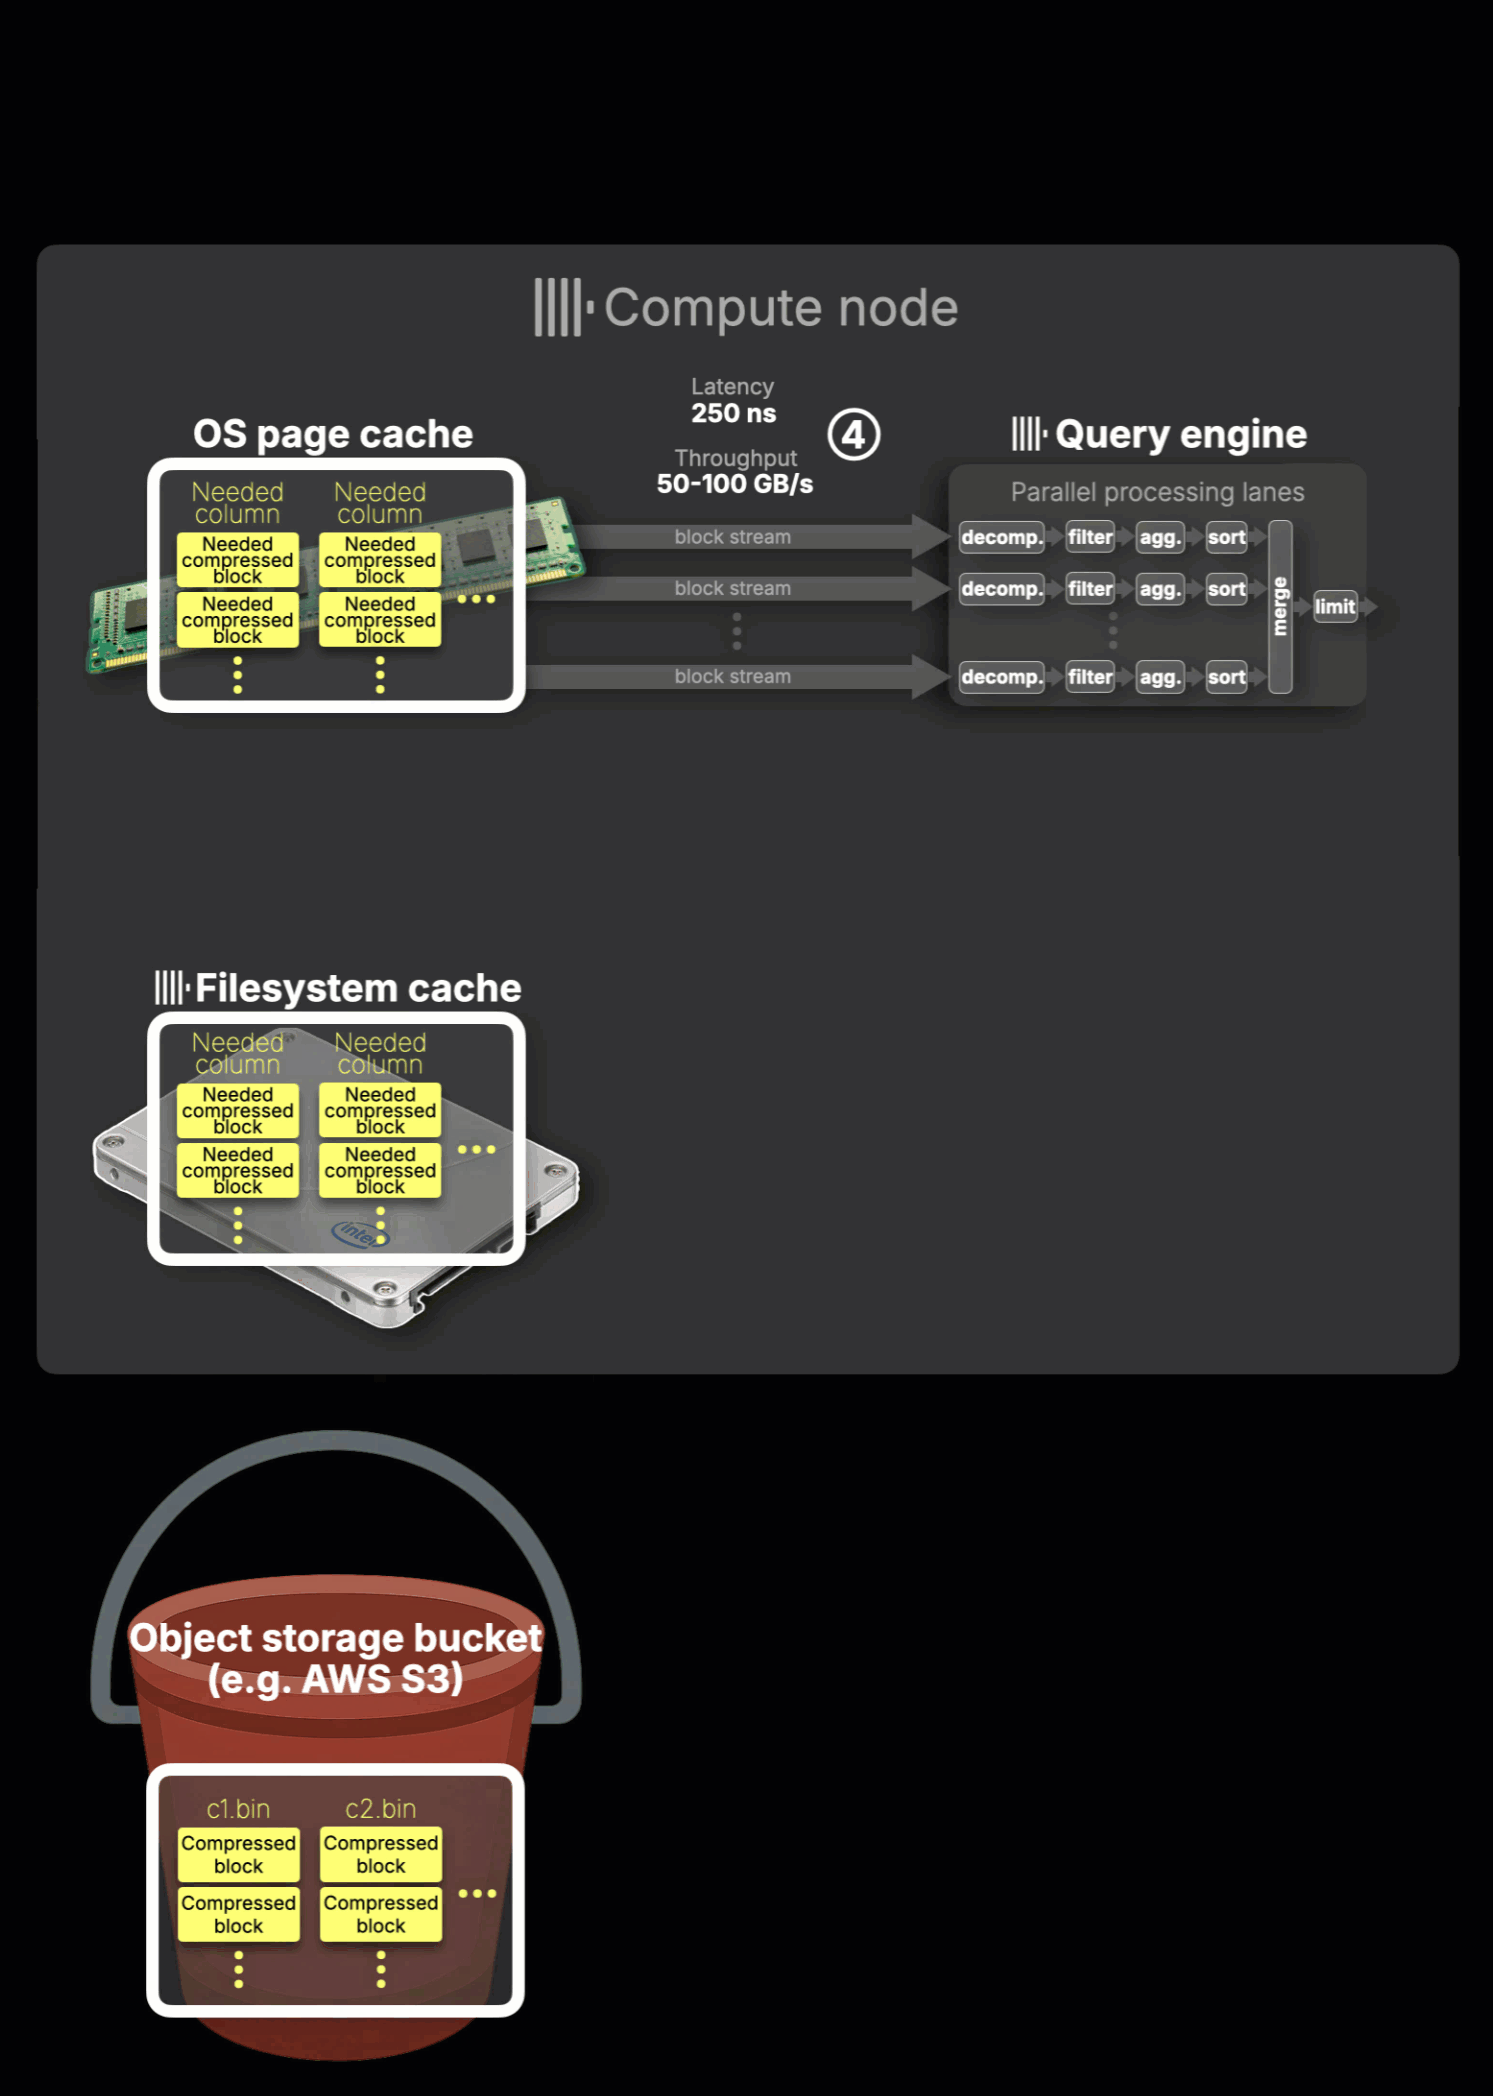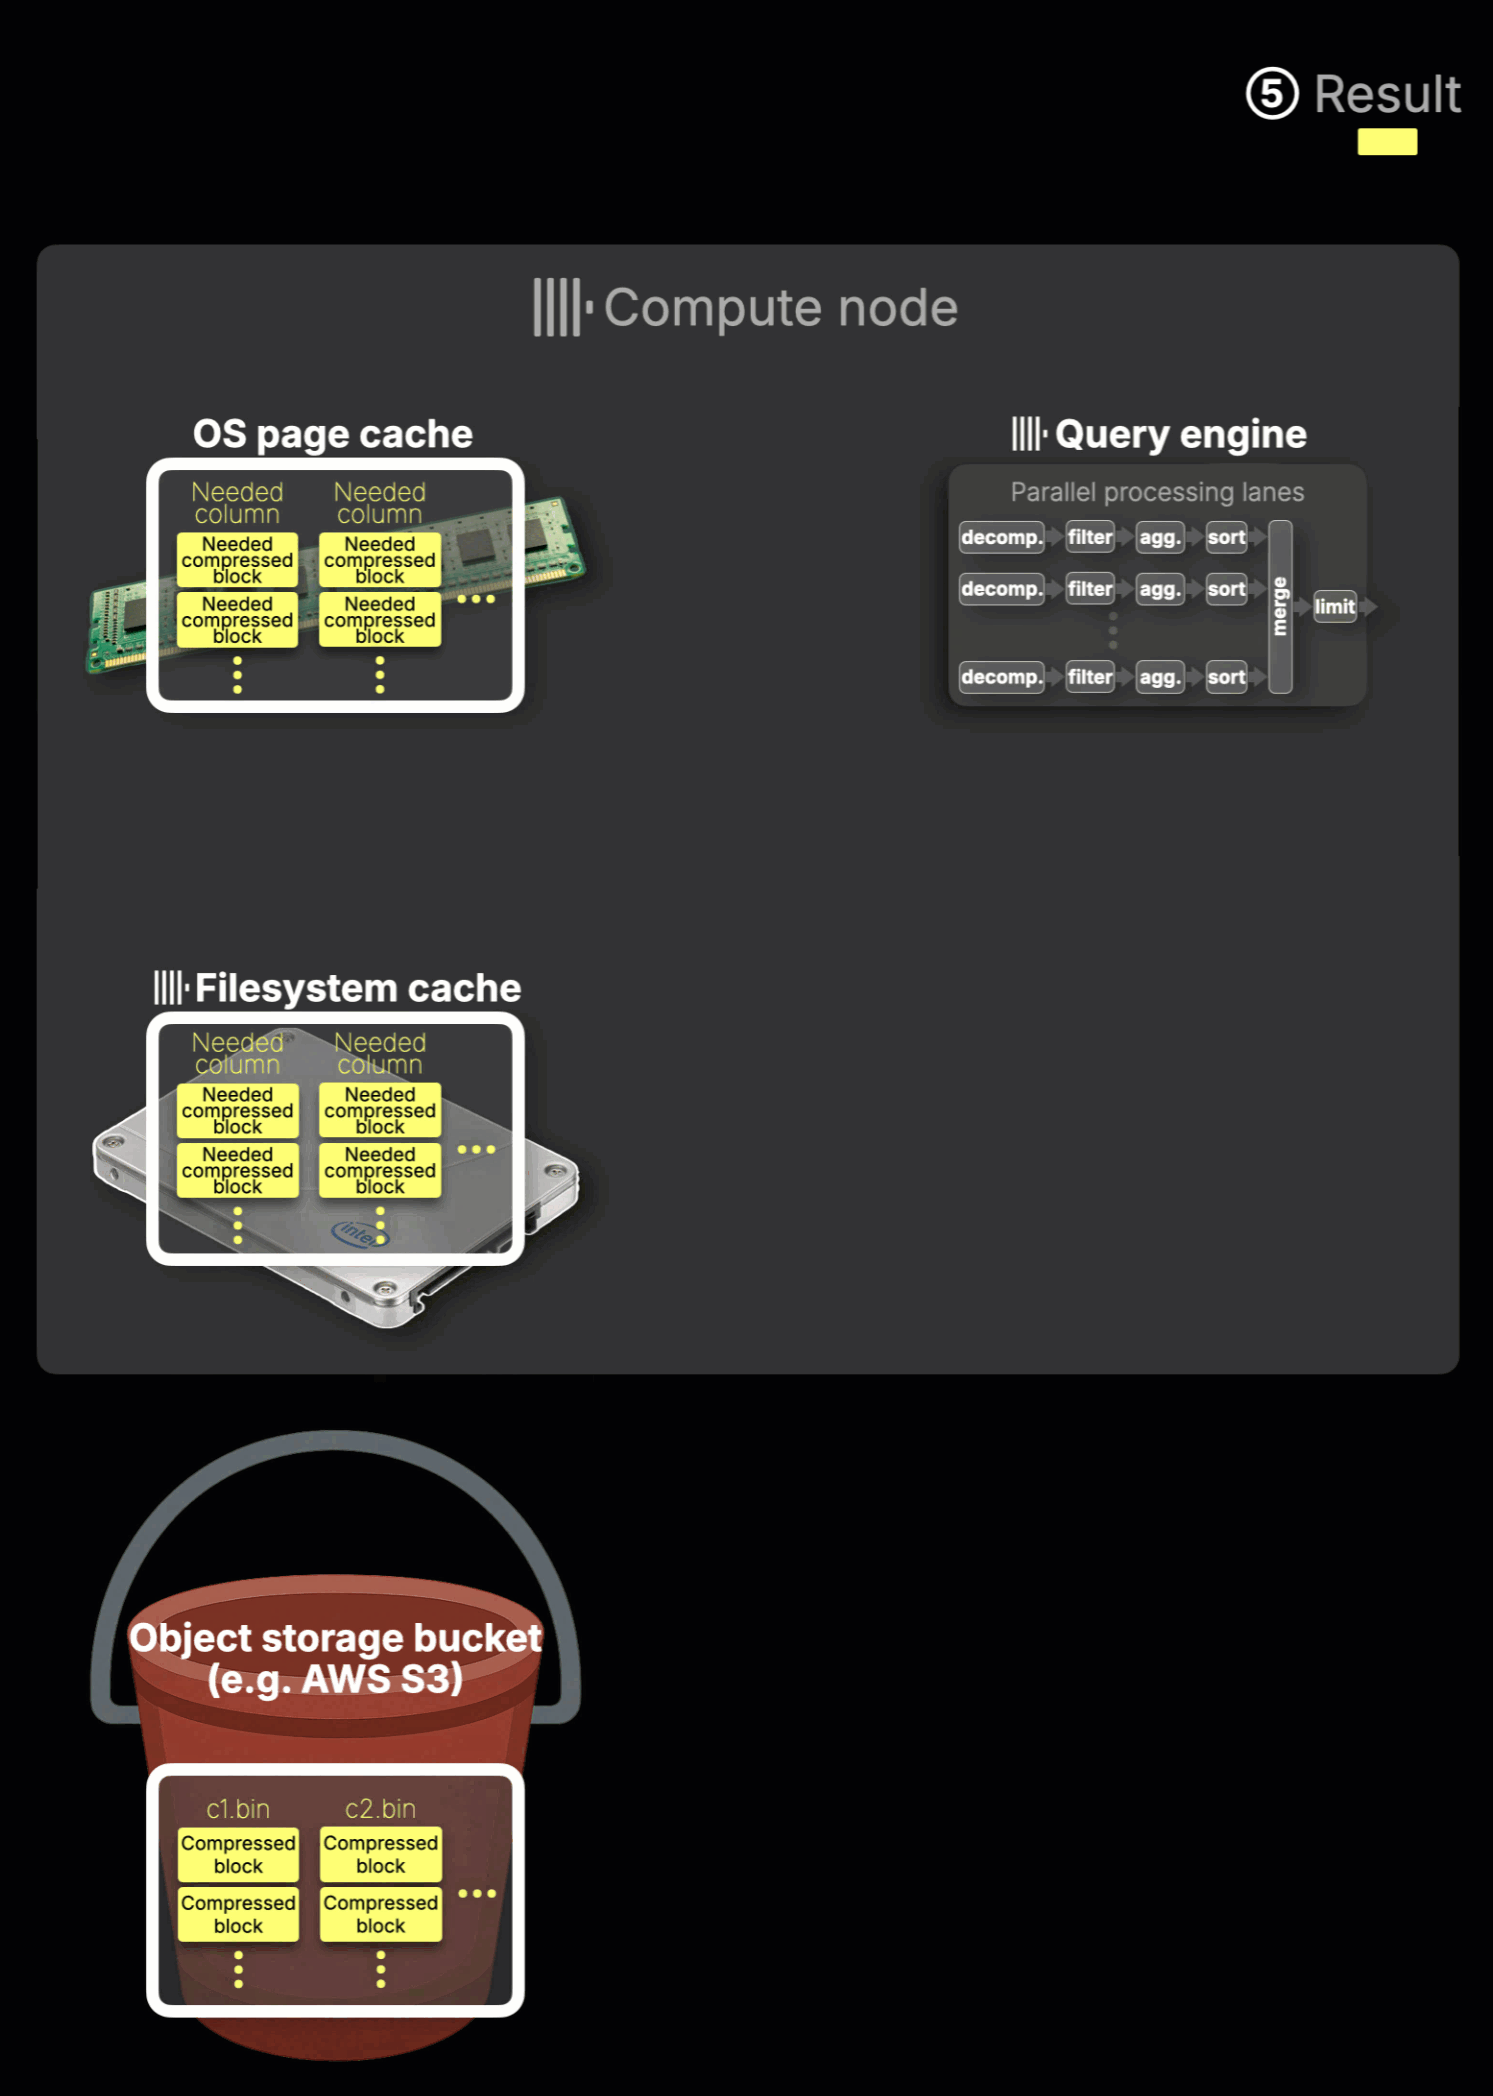
ClickHouse Cloud におけるホットなテーブルデータの全体的なフローは、従来のシェアードナッシングサーバーと似ていますが、重要な違いがあります。
① クエリの到着
クエリが ClickHouse Cloud 内のコンピュートノードへルーティングされます。従来のサーバーとは異なり、このノードはローカルディスクではなくオブジェクトストレージ(S3 など)に保存された共有データへアクセスします。
② オブジェクトストレージからのデータ読み込み
必要なデータがまだキャッシュされていない場合、上記のアニメーションのようにマルチスレッド読み取りと非同期プリフェッチを使用して共有オブジェクトストレージからストリーミングされ、ディスクベースのファイルシステムキャッシュへ書き込まれます。
③ メモリキャッシュ
ファイルシステムキャッシュからブロックがロードされると、従来のローカルディスク構成と同様に、OS ページキャッシュが以後のアクセスを自動的に高速化します。
④ ⑤ インメモリ実行
クエリエンジンはメモリ帯域幅を上限として、OS ページキャッシュから実行レーンへ約 50〜100 GB/s でストリーミングしながら、ブロック単位でデータを並列処理します。
より優れた方式が必要とされた理由
下のアニメーションは、ClickHouse Cloud における従来のホットデータキャッシュの根本的な限界を示しています(クリックすると全画面で表示されます)。
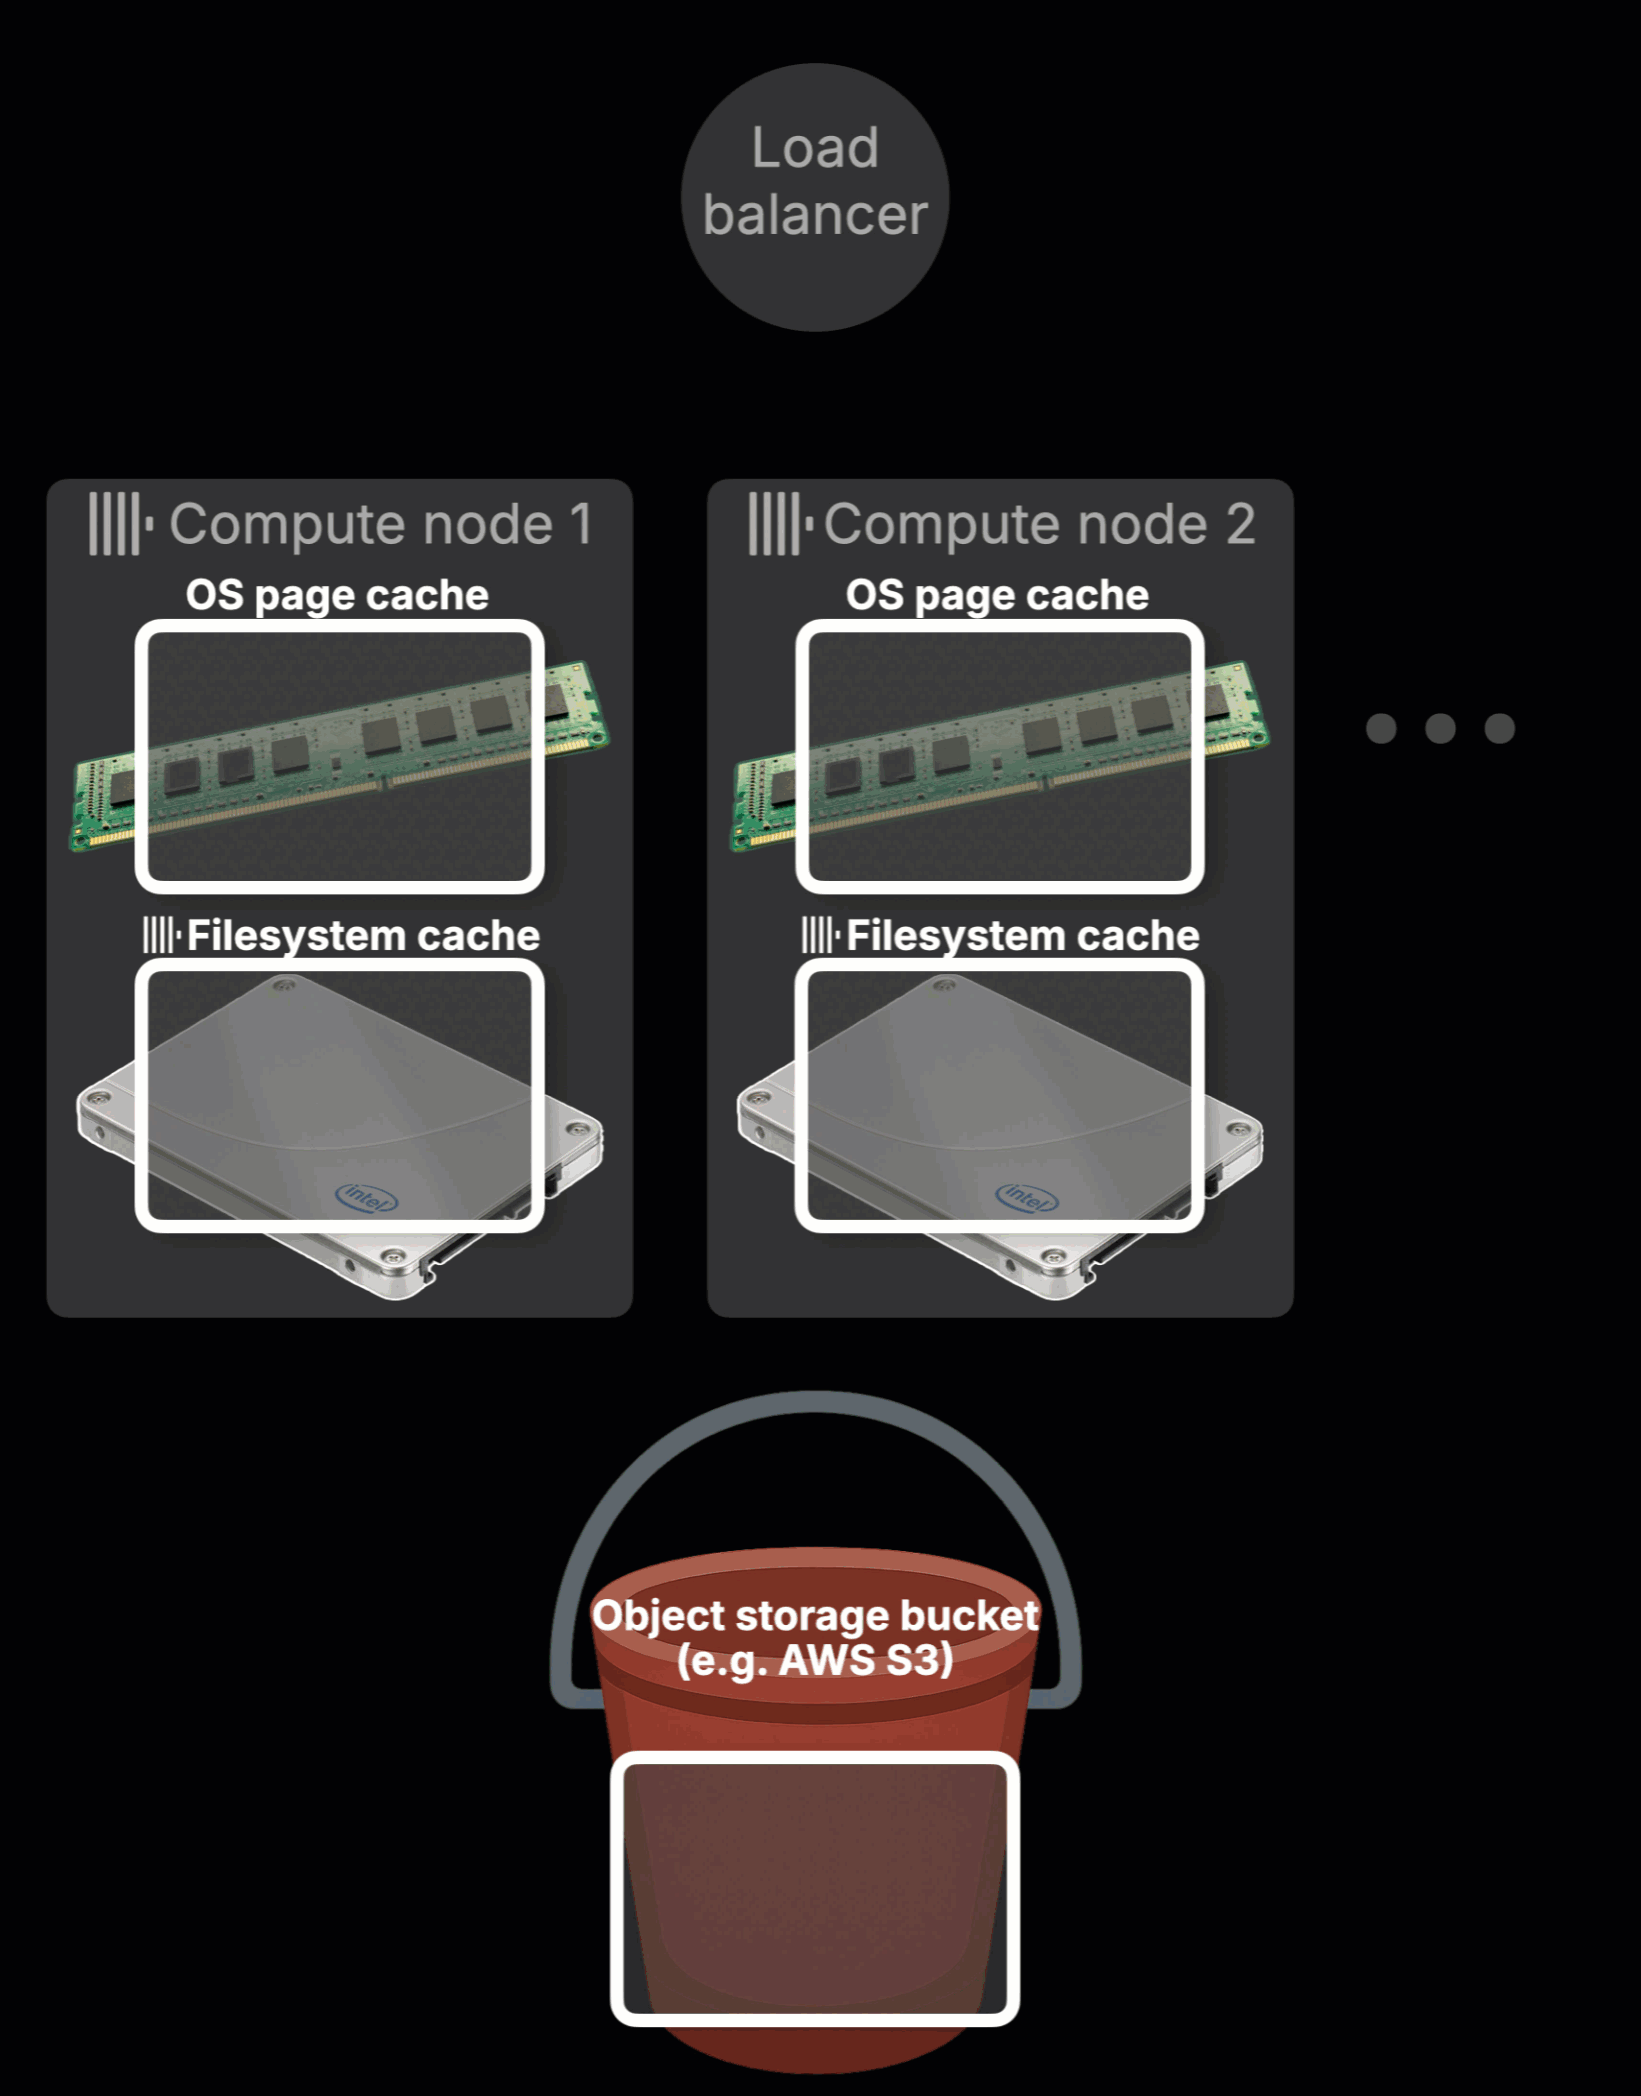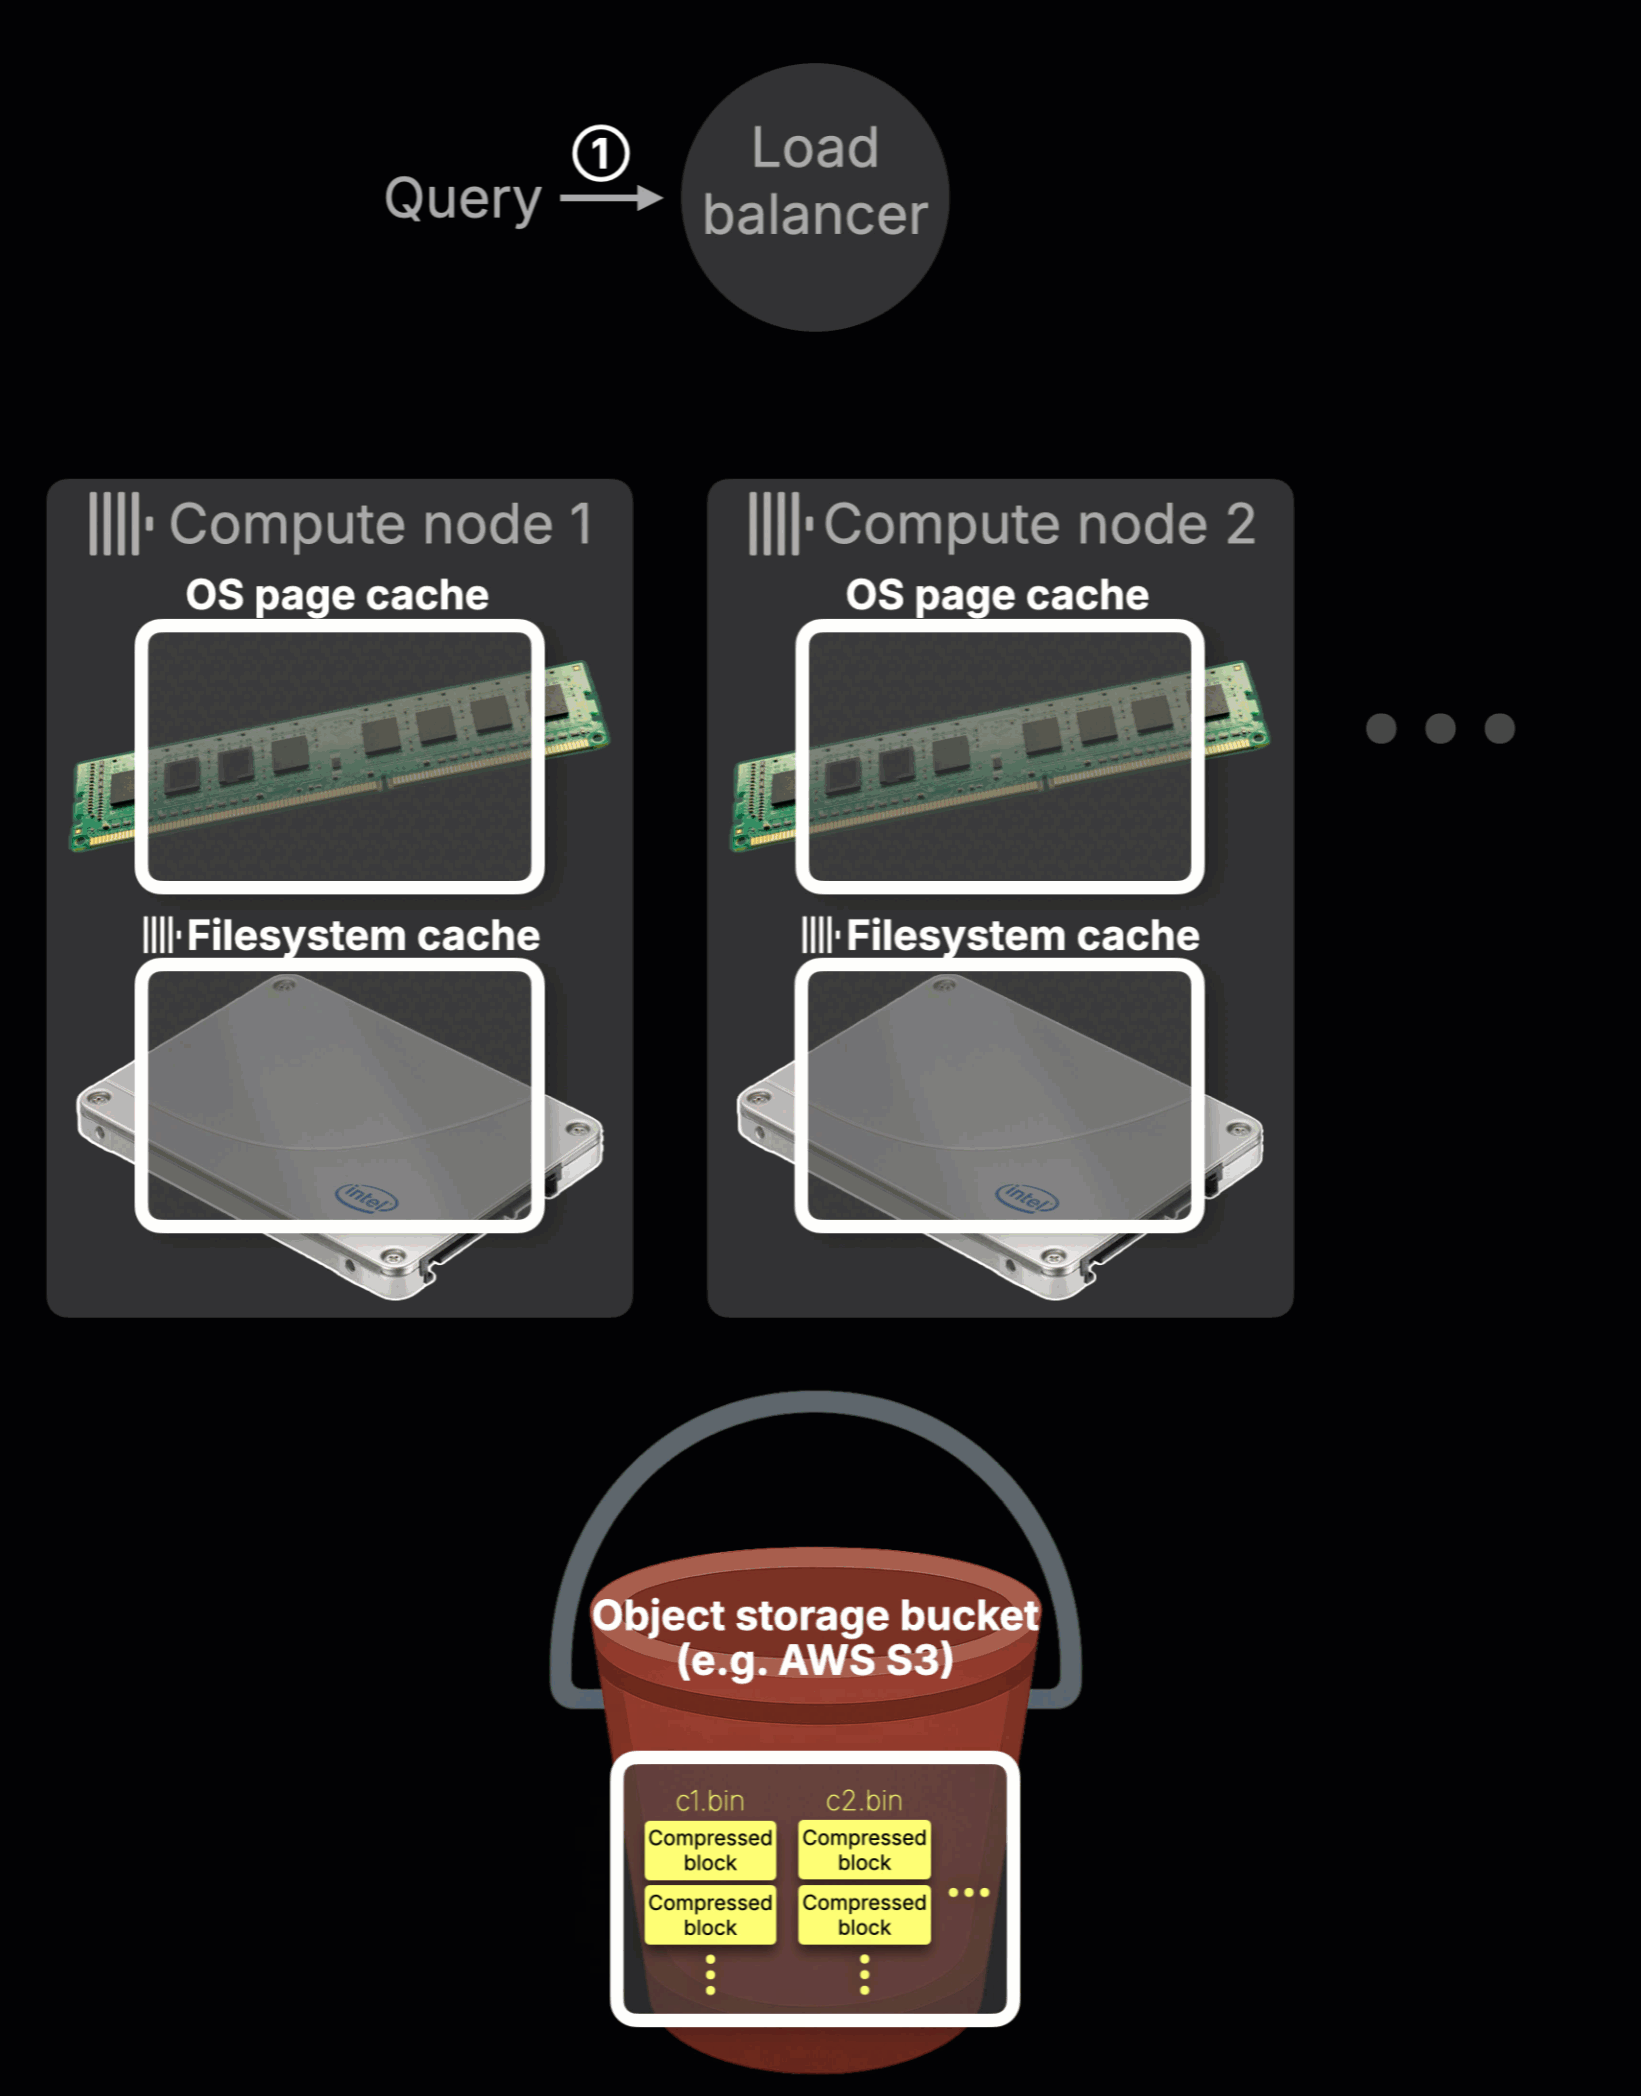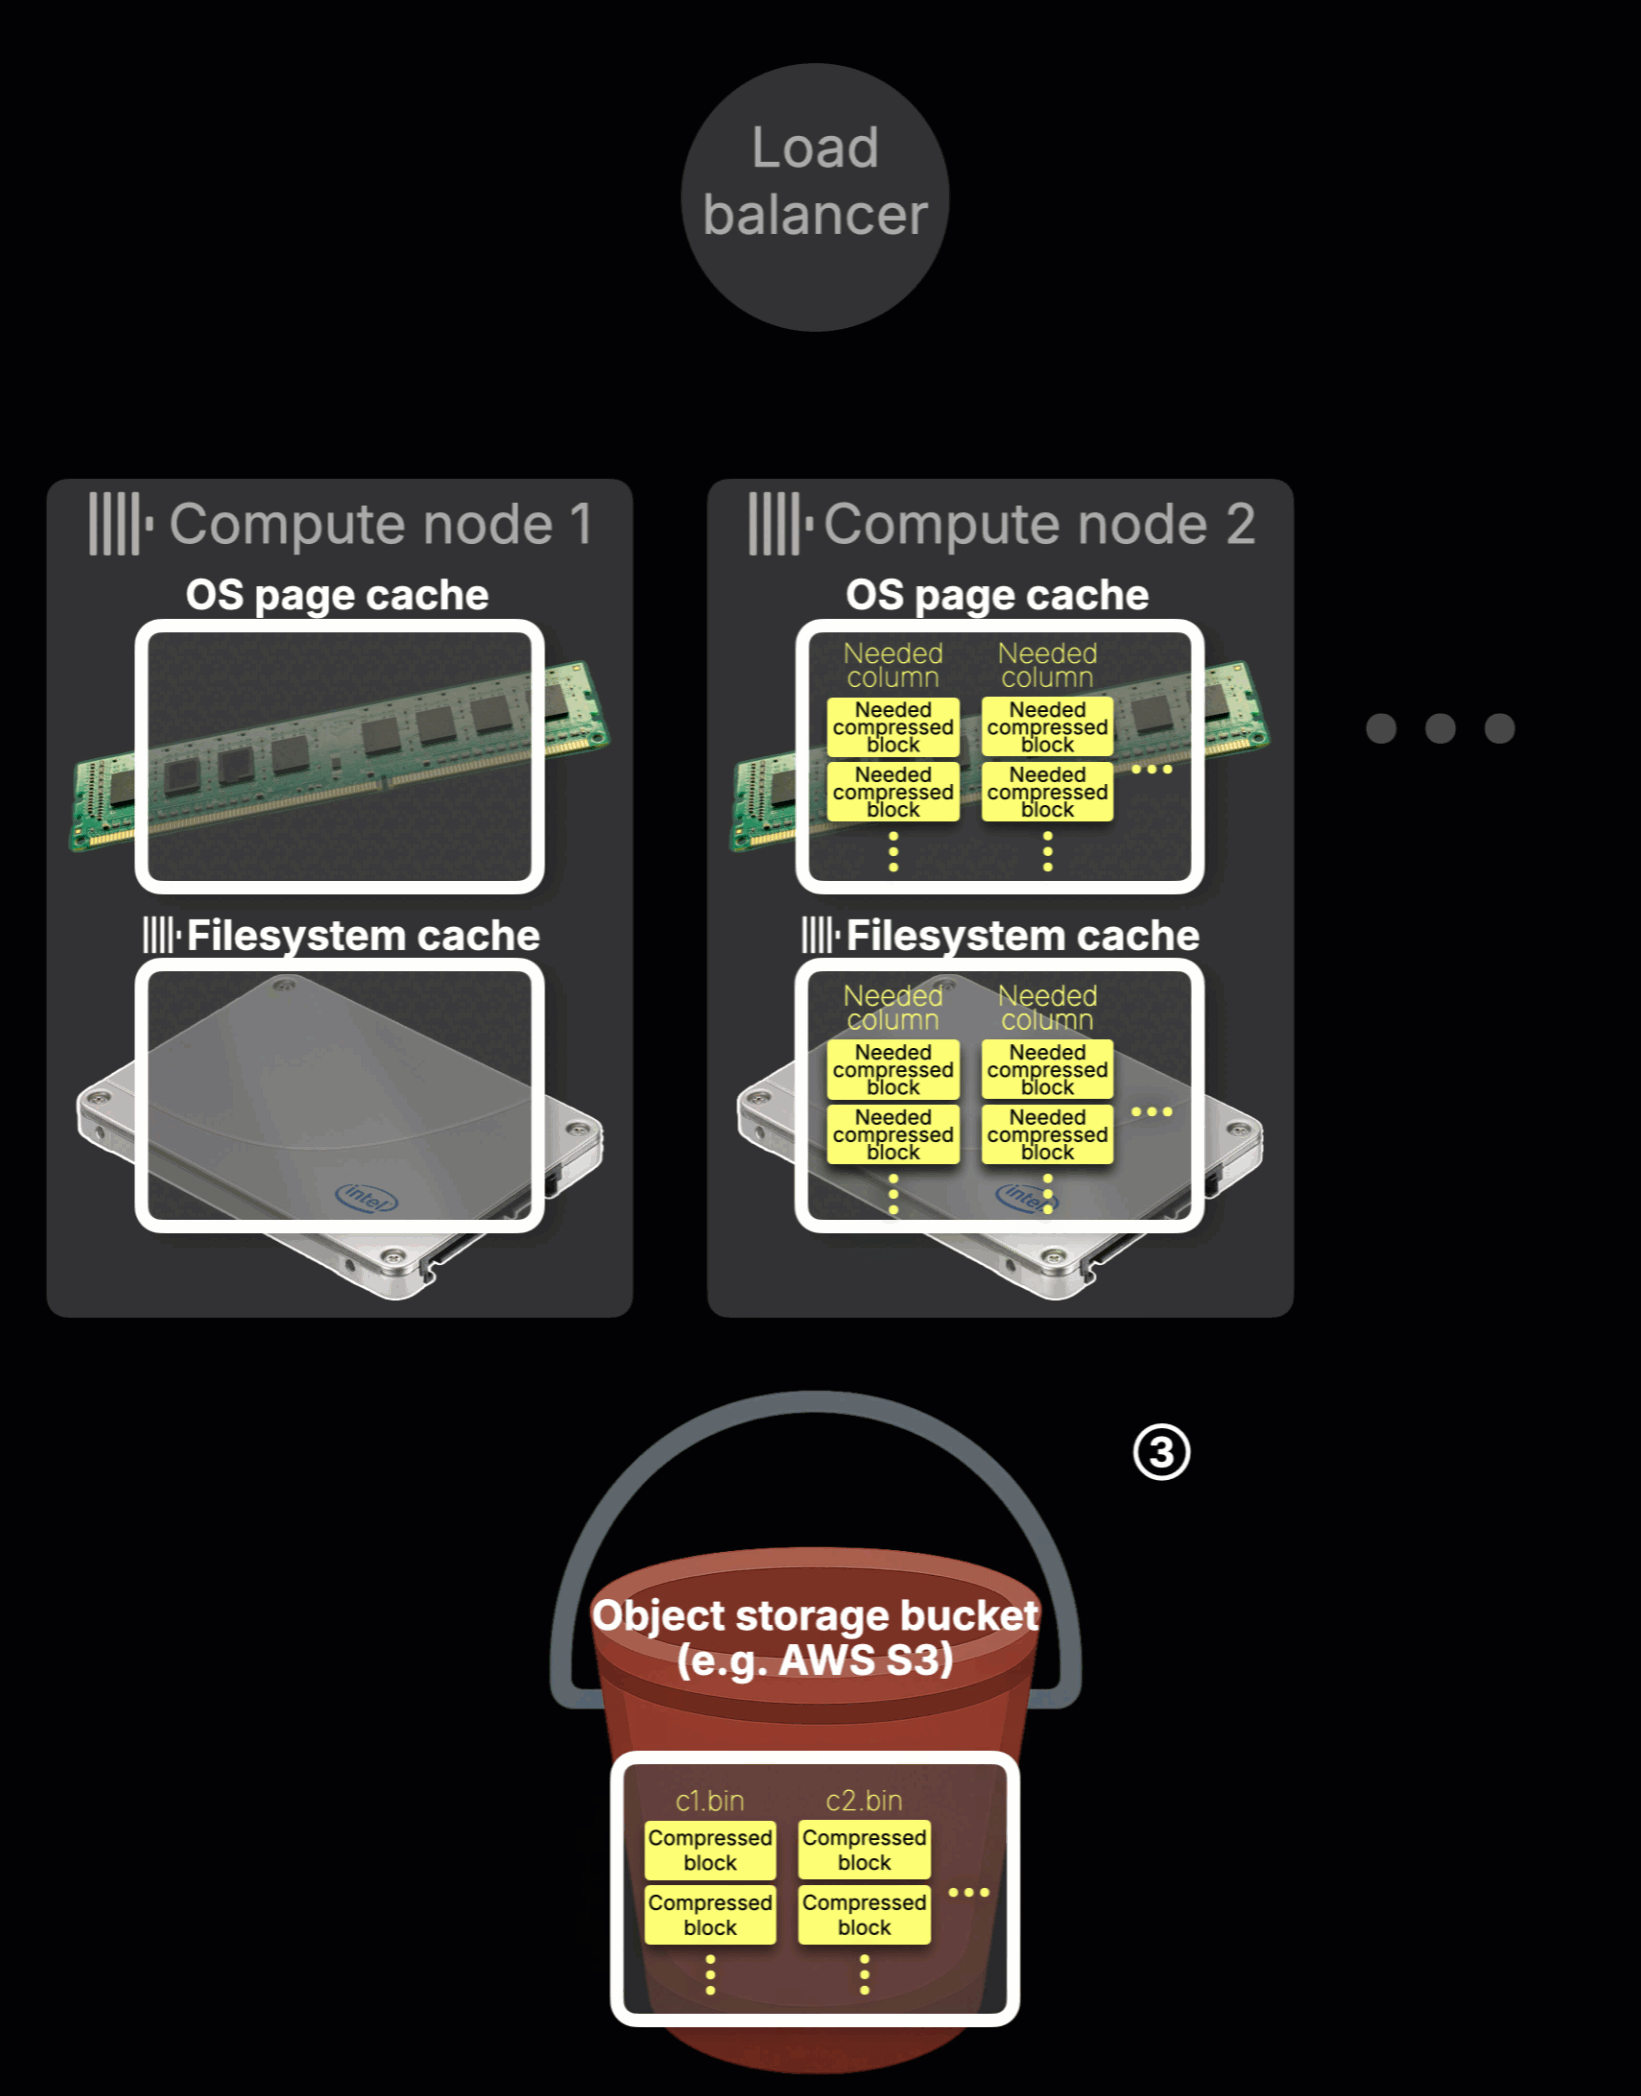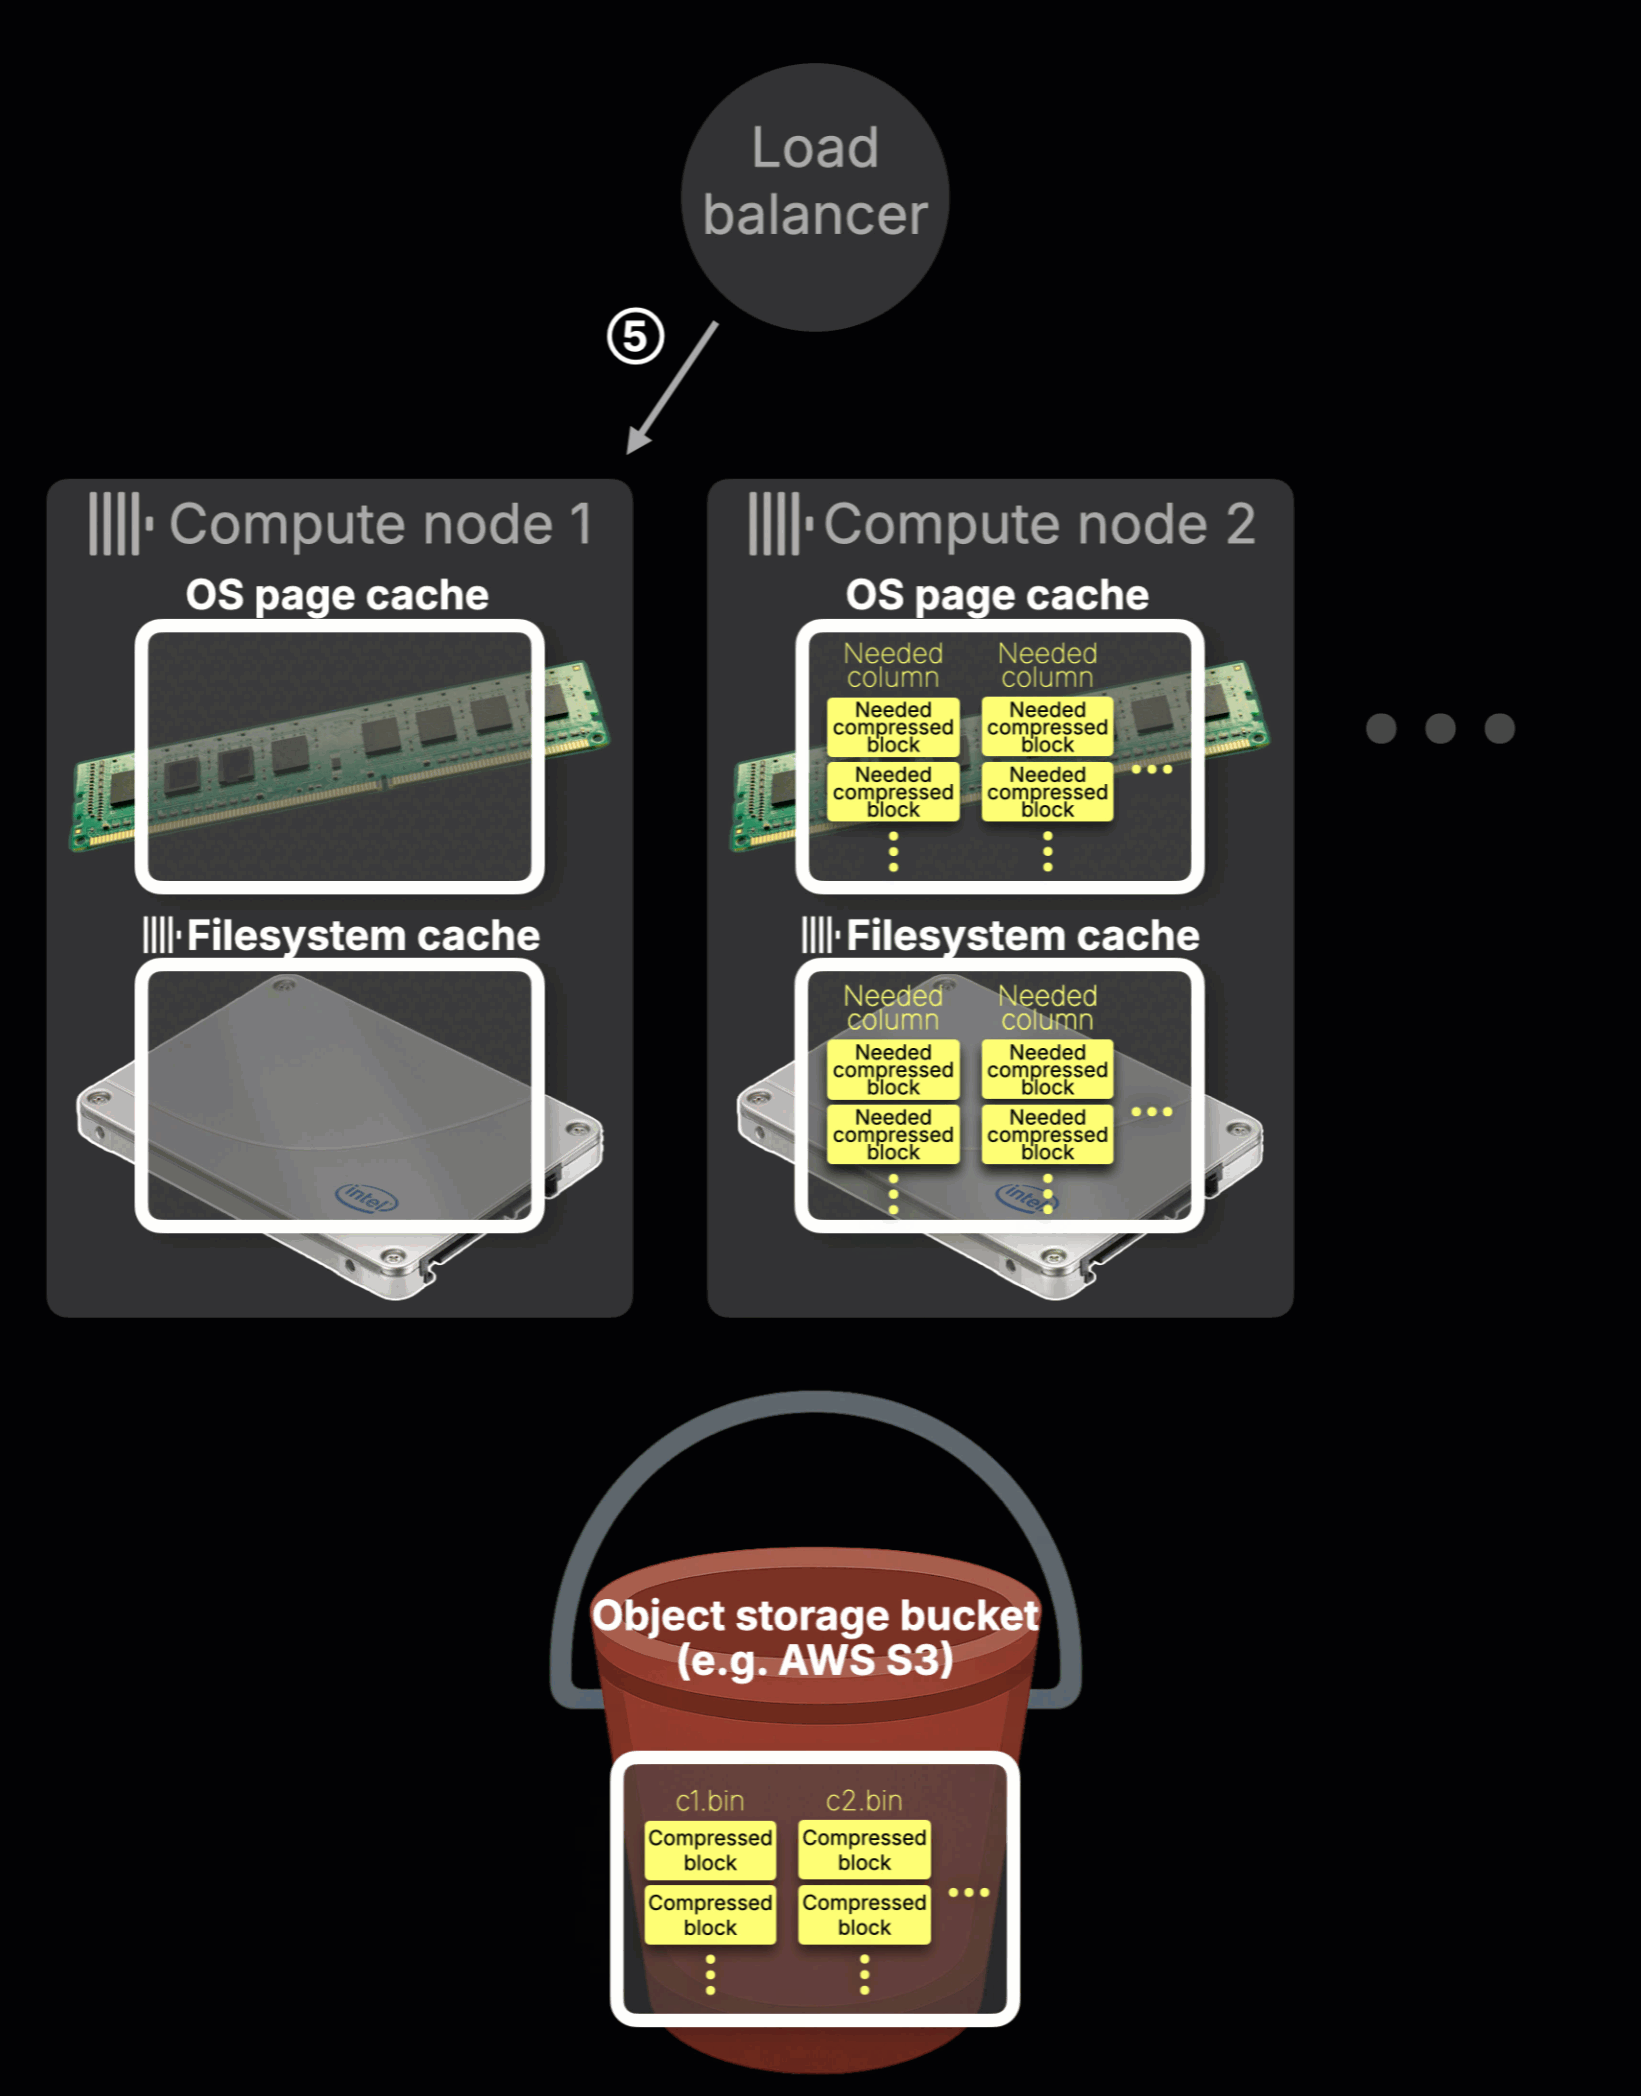
アニメーションの内容は以下のとおりです。
クエリのルーティング(①–②)
クエリが ClickHouse Cloud のロードバランサーに到達し、コンピュートノード(例:ノード 2。ノード 1 もノード 2 も最初は本クエリに対するキャッシュがコールドの状態です)へルーティングされます。
ローカルキャッシュ(③)
ノード 2 がクエリを処理し、必要なホットテーブルデータをオブジェクトストレージから取得して、自身のローカルファイルシステムキャッシュおよび OS ページキャッシュに保存します。
キャッシュの分離
④ その後のクエリが ⑤ ノード 1 へルーティングされた場合、ノード 1 はノード 2 がキャッシュしたデータにアクセスできません。オブジェクトストレージから同じデータを再取得し、自身のキャッシュをゼロからウォームアップする必要があります。
ノードごとのローカルファイルシステムキャッシュは、単一ノードにおける安定性には適しています。しかし、弾力性のあるステートレスなコンピュート環境では限界があります。
- ホットデータにポータビリティがない:各ノードが孤立したキャッシュを持っています。
- キャッシュの成果が共有されない:あるノードで行われた処理が他のノードの役に立ちません。
- スケーリングはリセットを意味する:ノードを追加または交換すると、すべてのホットデータが失われます。
実際には、以下のような問題が生じます。
- より大規模なノードにスケールアップしても、キャッシュデータがないコールドな状態で起動します。
- スケールアウトのためにノードを追加しても、すべてをオブジェクトストレージから再取得しなければなりません。
- 数秒前には高速だったクエリが、データの再ストリーミングを待つ間に失速します。
- コンピュートのトポロジーが変更された瞬間に、ホットデータがコールド化します。
要するに、ローカルキャッシュは再実行時の性能を向上させるものの、それは処理を実行したノード内に限られます。クラウドネイティブな環境でキャッシュを真に有効なものにするためには、共有可能な仕組みが必要でした。
第3段階:分散キャッシュ
キャッシュの分離、作業の重複、そしてコールドスタートは、クラウドネイティブな俊敏性を妨げる要因となっていました。そこで私たちは分散キャッシュを構築しました。ファイルシステムキャッシュをラップし、すべての ClickHouse コンピュートノードからホットデータへの高速アクセスを可能にする共有ネットワークサービスです。ノード側でローカルにキャッシュを再構築する代わりに、単一の共有キャッシュに対して読み書きリクエストを送信するようになります。
分散キャッシュを高速でスケーラブル、かつクラウド対応たらしめている内部構造を見ていきましょう。
スタック内の新たなレイヤー:ネットワーク
ClickHouse Cloud は、ローカルのファイルシステムキャッシュを共有ネットワークサービスへと転換します。これが実現可能なのは、現代のネットワークが備える高帯域幅と低レイテンシのおかげです。
AWS では、同一ゾーン内のネットワークレイテンシはわずか 100〜250 µs に抑えられ、S3 のテールレイテンシ(約 500 ms)と比べて数百倍高速です。ネットワークスループットは通常 1.5〜12.5 GB/s に達し、ローカル SSD の性能と同等かそれを上回ることも少なくありません。高スループットインスタンスでは最大 100 Gbps(12.5 GB/s)に達し、特殊な構成ではさらに高い性能を発揮します。
レイテンシとスループットにおいて、ネットワーク層が他のストレージ層とどのように比較されるかを以下に示します。
| レイヤー | レイテンシ | IOPS | スループット |
|---|---|---|---|
| S3 | 500 ms | 5K | 2 GB/sec |
| SSD | 1 ms | 100K | 4 GB/sec |
| ネットワーク | 100–250 µs | 1.5–12.5 GB/sec | |
| メモリ | 250 ns | 100M | 100 GB/sec |
こうした特性のおかげで、ネットワーク経由でアクセスされる分散キャッシュは、SSD とメモリの中間に位置するレイテンシを実現します。そして従来のローカルファイルシステムキャッシュと同様に、オブジェクトストレージの根本的なボトルネックであるレイテンシを解消します。
スケーラビリティも備えています。 ホットなテーブルデータが複数のキャッシュノードに分散されるようになったため、ClickHouse はブロックを並列に取得し、スループットを最大化できます。十分なノード数があれば、この複合スループットはメモリ速度に匹敵し、数十から数百 GB/s に達します(この仕組みの詳細は後述します)。
従来の仕組みと同様に、分散キャッシュはホットデータをまず SSD へ、そしてコンピュートノードの RAM へ直接配置することでクエリエンジンに近づけ、リアルタイム分析に求められる低レイテンシのクエリ実行を支えます。
ステートレスなコンピュートのための設計
このアーキテクチャにより、ClickHouse のコンピュートノードはディスクを持たないステートレスなマシンとして運用できる一方、分散キャッシュノードはディスクに最適化され、高スループットかつ低レイテンシでホットデータを管理・提供することに特化できます。
アベイラビリティゾーンごとのデプロイ
分散キャッシュは、ゾーン間トラフィックとそのコストを回避するため、アベイラビリティゾーンごとに運用されます。ゾーンローカル(低レイテンシ)として運用することも、クロスゾーン(キャッシュヒット率は高まるがレイテンシとコストが増加)として運用することも可能です。キャッシュは複数の ClickHouse Cloud サービス間で共有されますが、適切な認証と暗号化により各サービスは完全に分離されています。
テーブルデータ以外の用途
分散ファイルシステムキャッシュは、以前のローカルキャッシュと同様の追加機能も担います。テーブルメタデータ(セカンダリデータスキッピングインデックスやマークファイルなど)のキャッシュ、一時データ(ディスクスピルなど)の保存、外部ファイル(データレイクテーブルファイルを含む)のキャッシュなどです。
仕組み
以前のノードごとのローカルファイルシステムキャッシュと同様に、分散キャッシュもリードスルーキャッシュ(クエリ実行時にキャッシュを充填)とライトスルーキャッシュ(挿入処理やテーブルパートのマージ後に、新規データをホットかつクエリ可能な状態に維持)の両方を使用します。
次のアニメーションは、ClickHouse Cloud における分散キャッシュのリードスルーキャッシュの動作を示しています(クリックすると全画面で表示されます)。
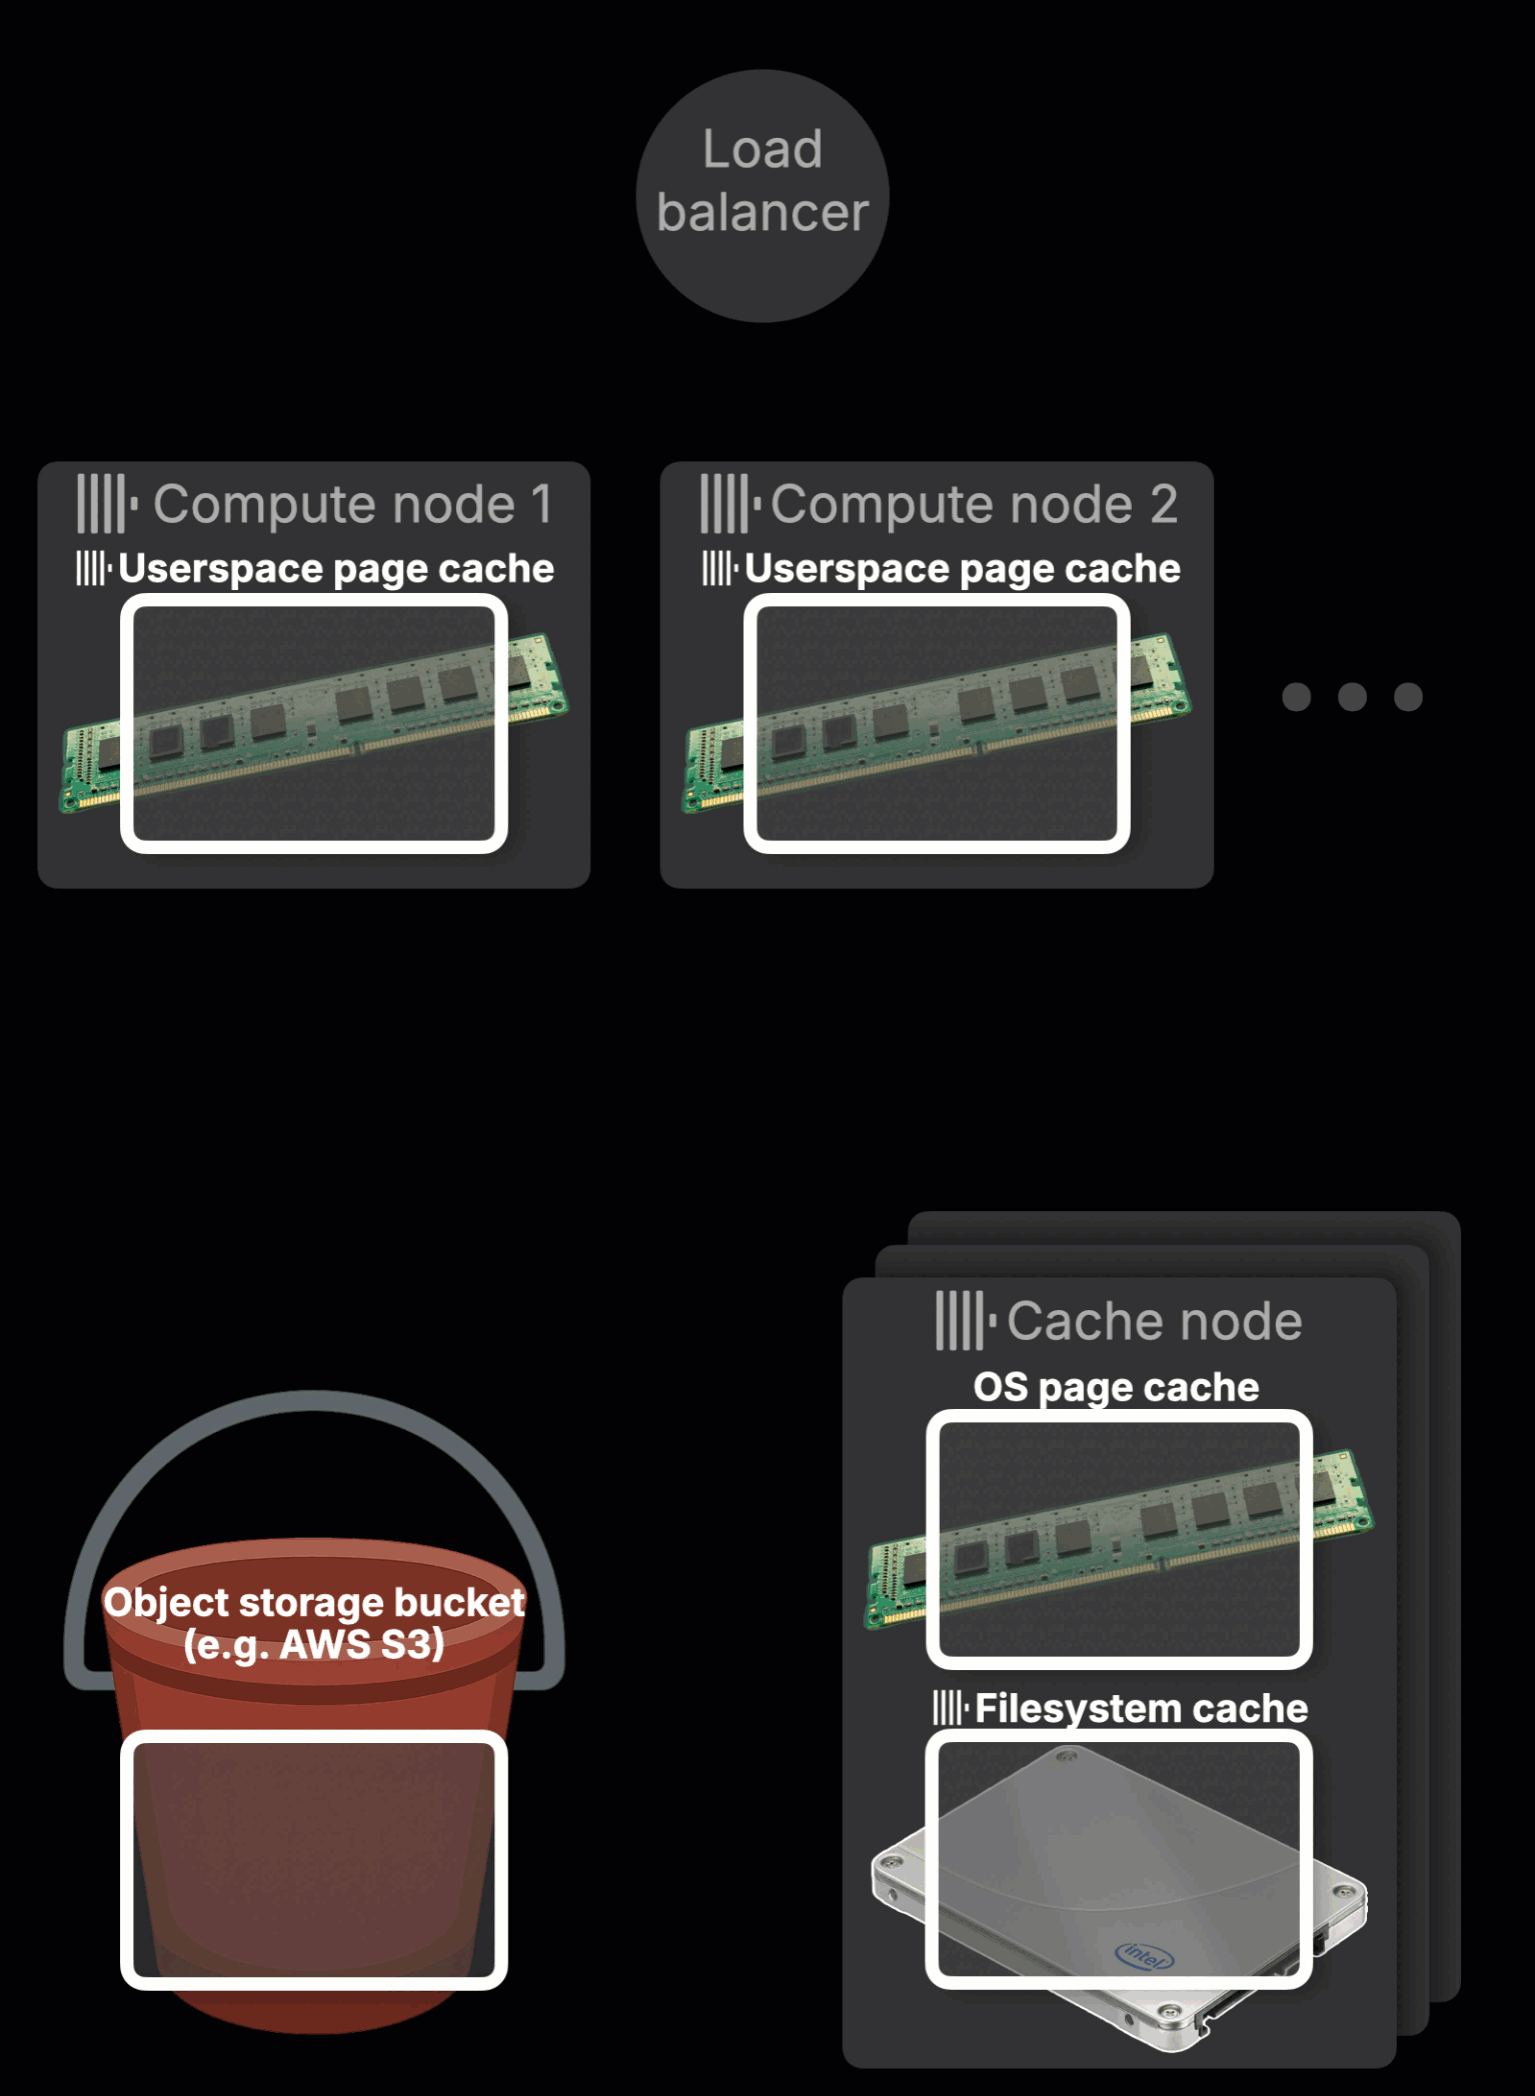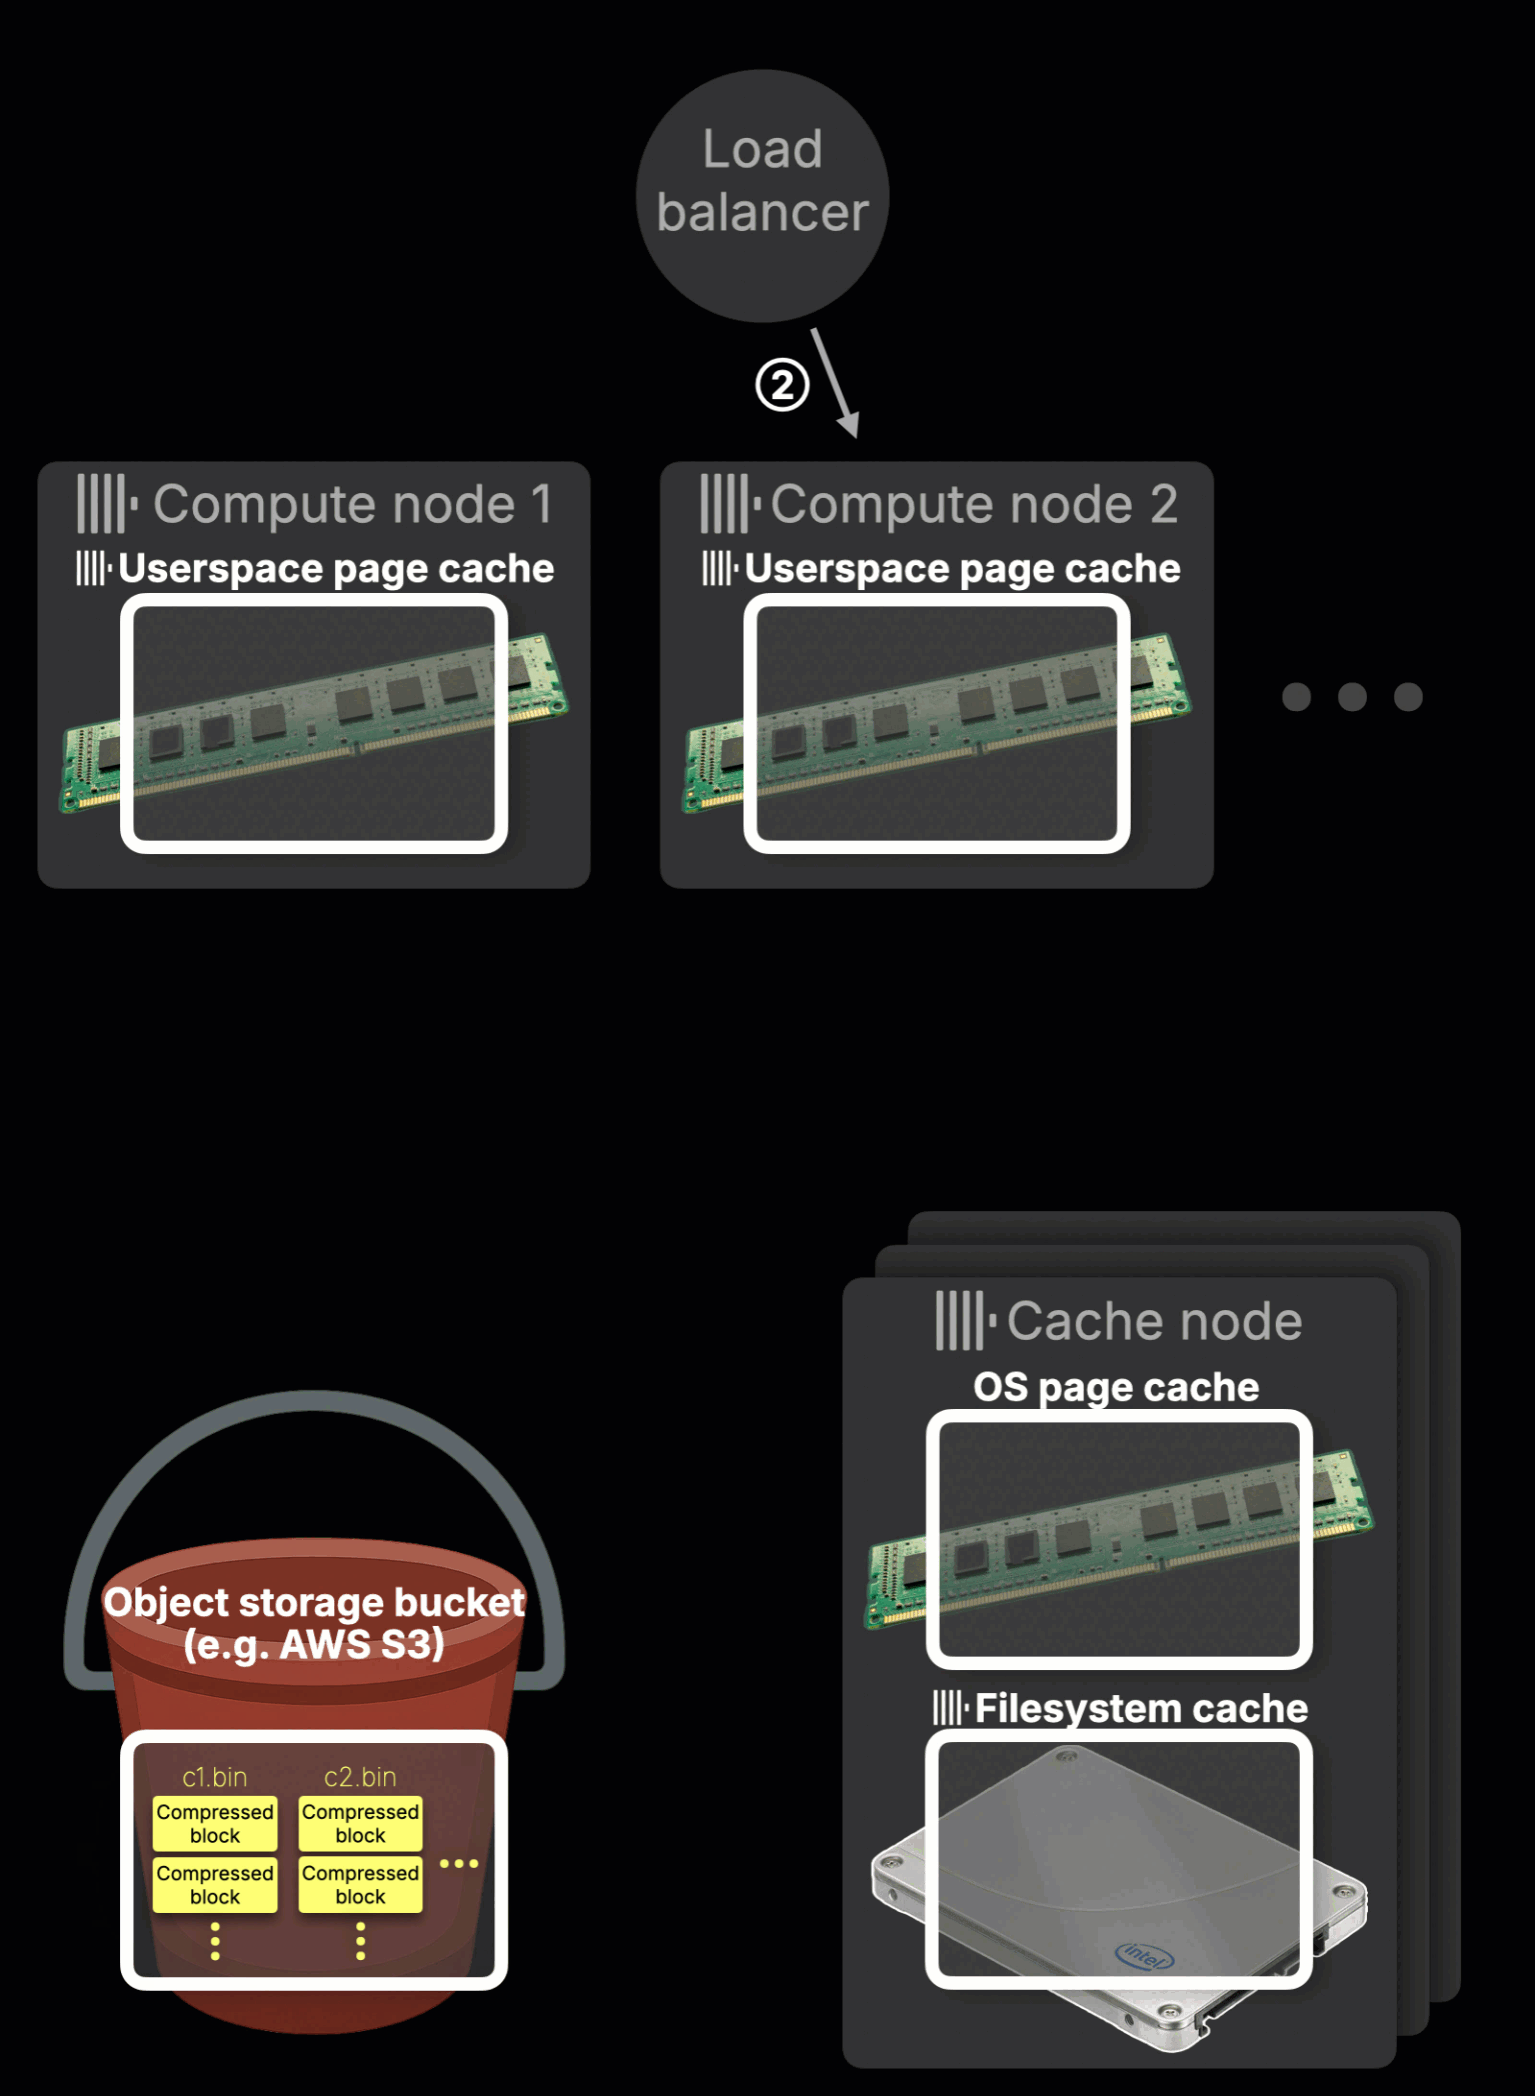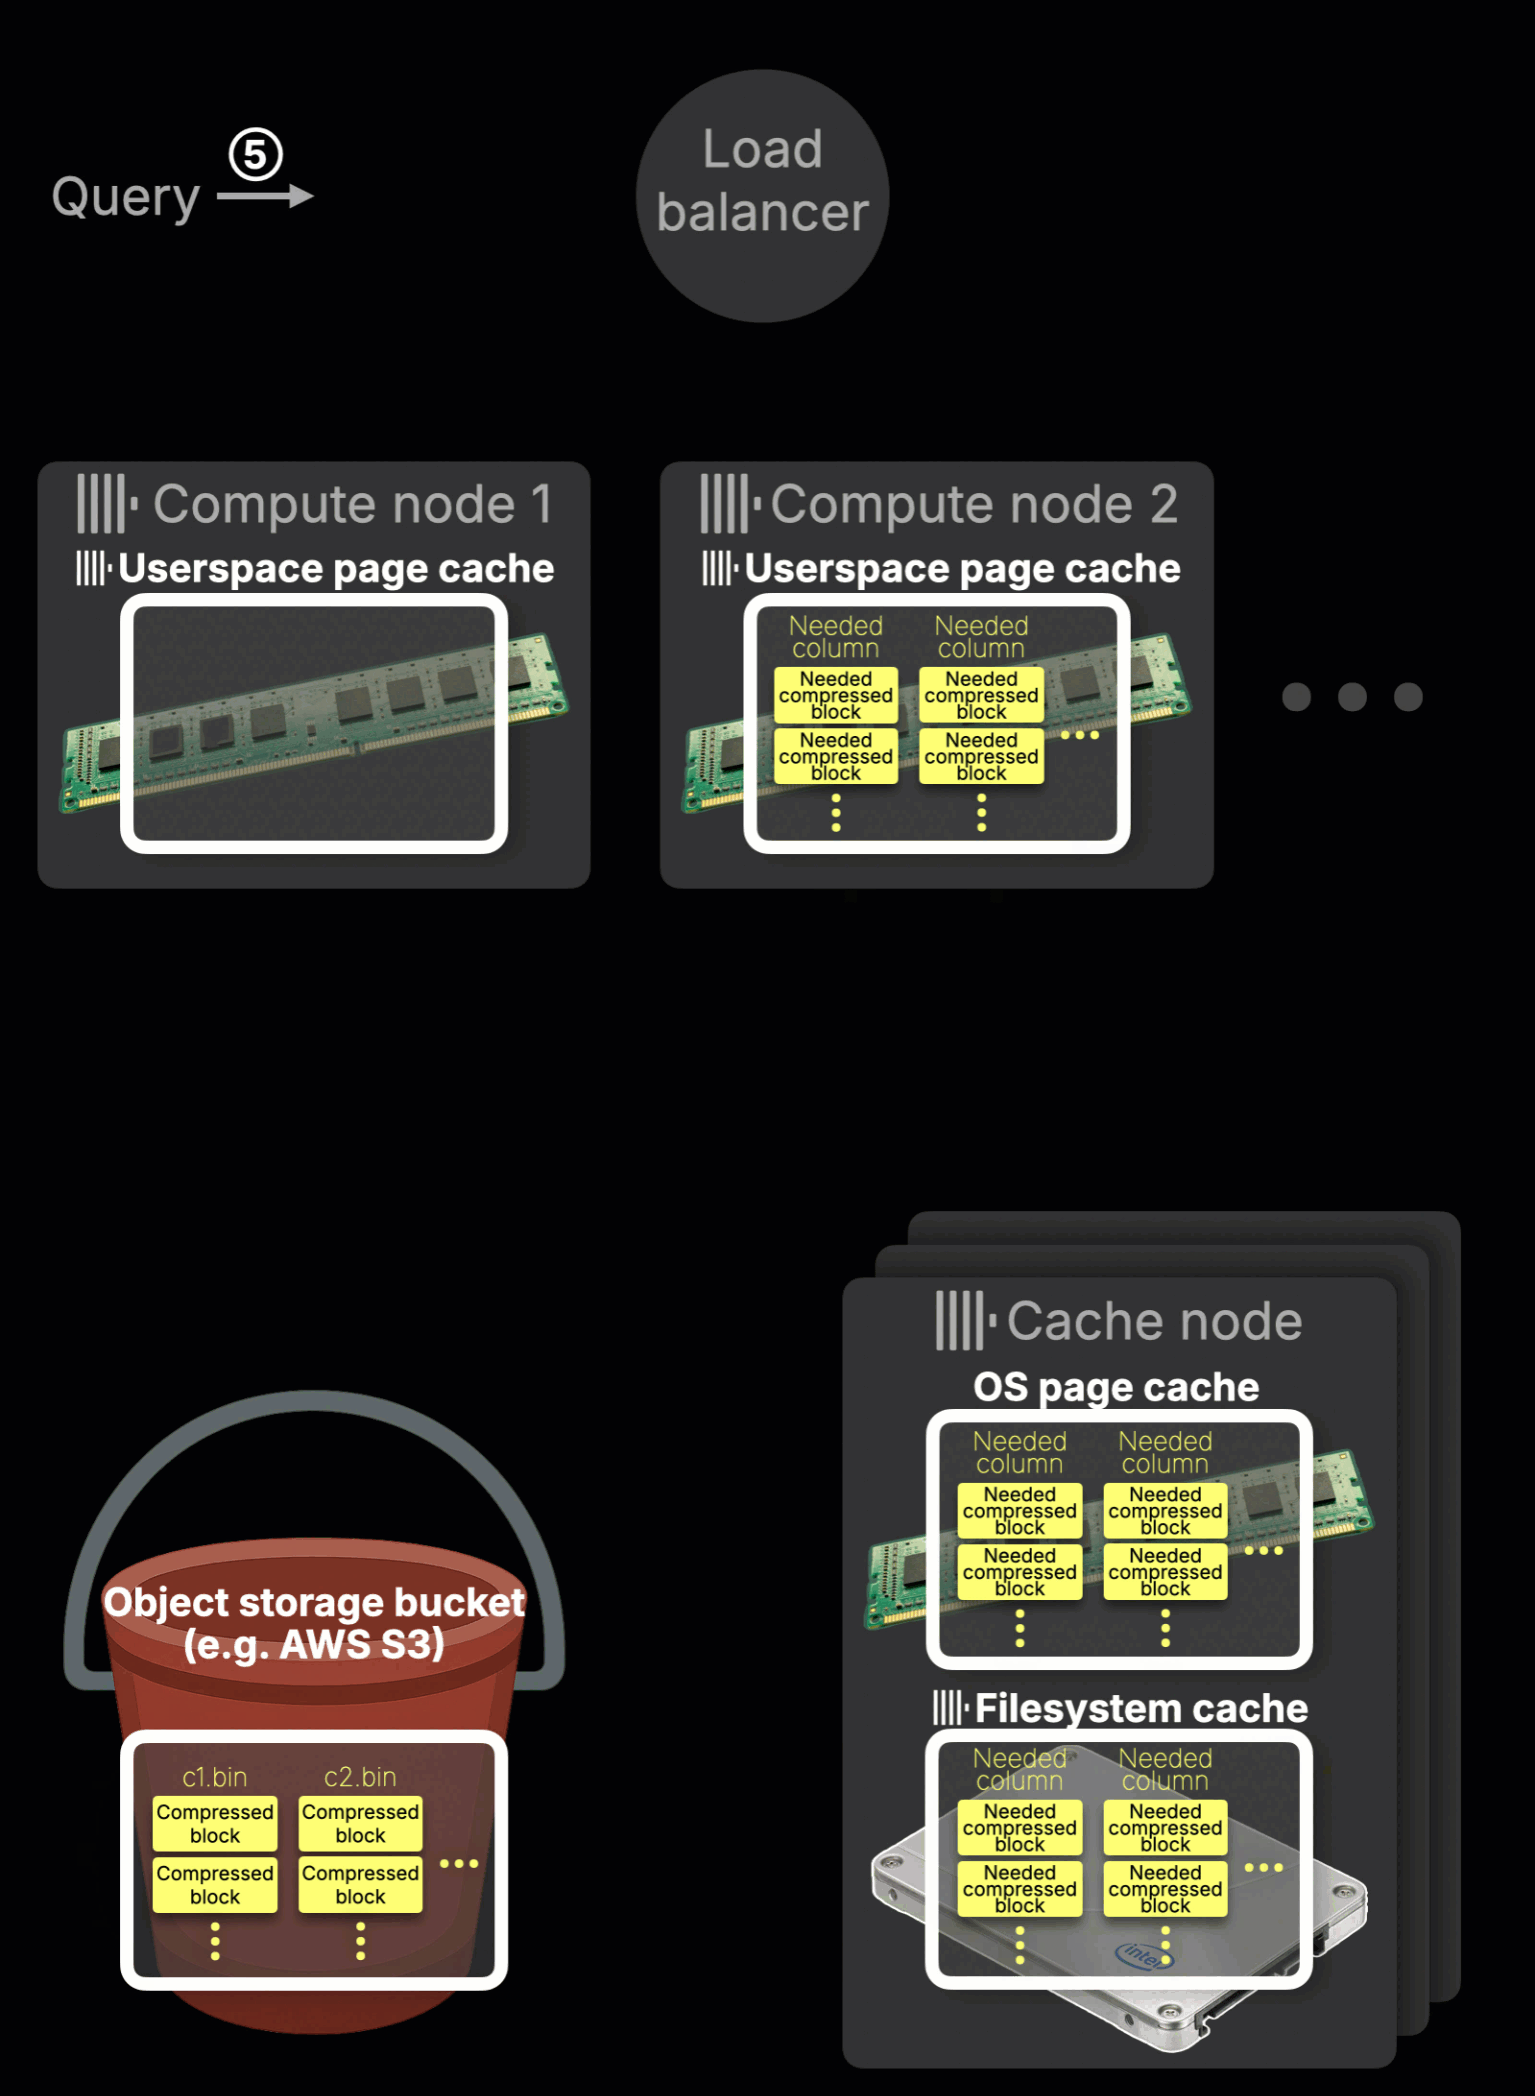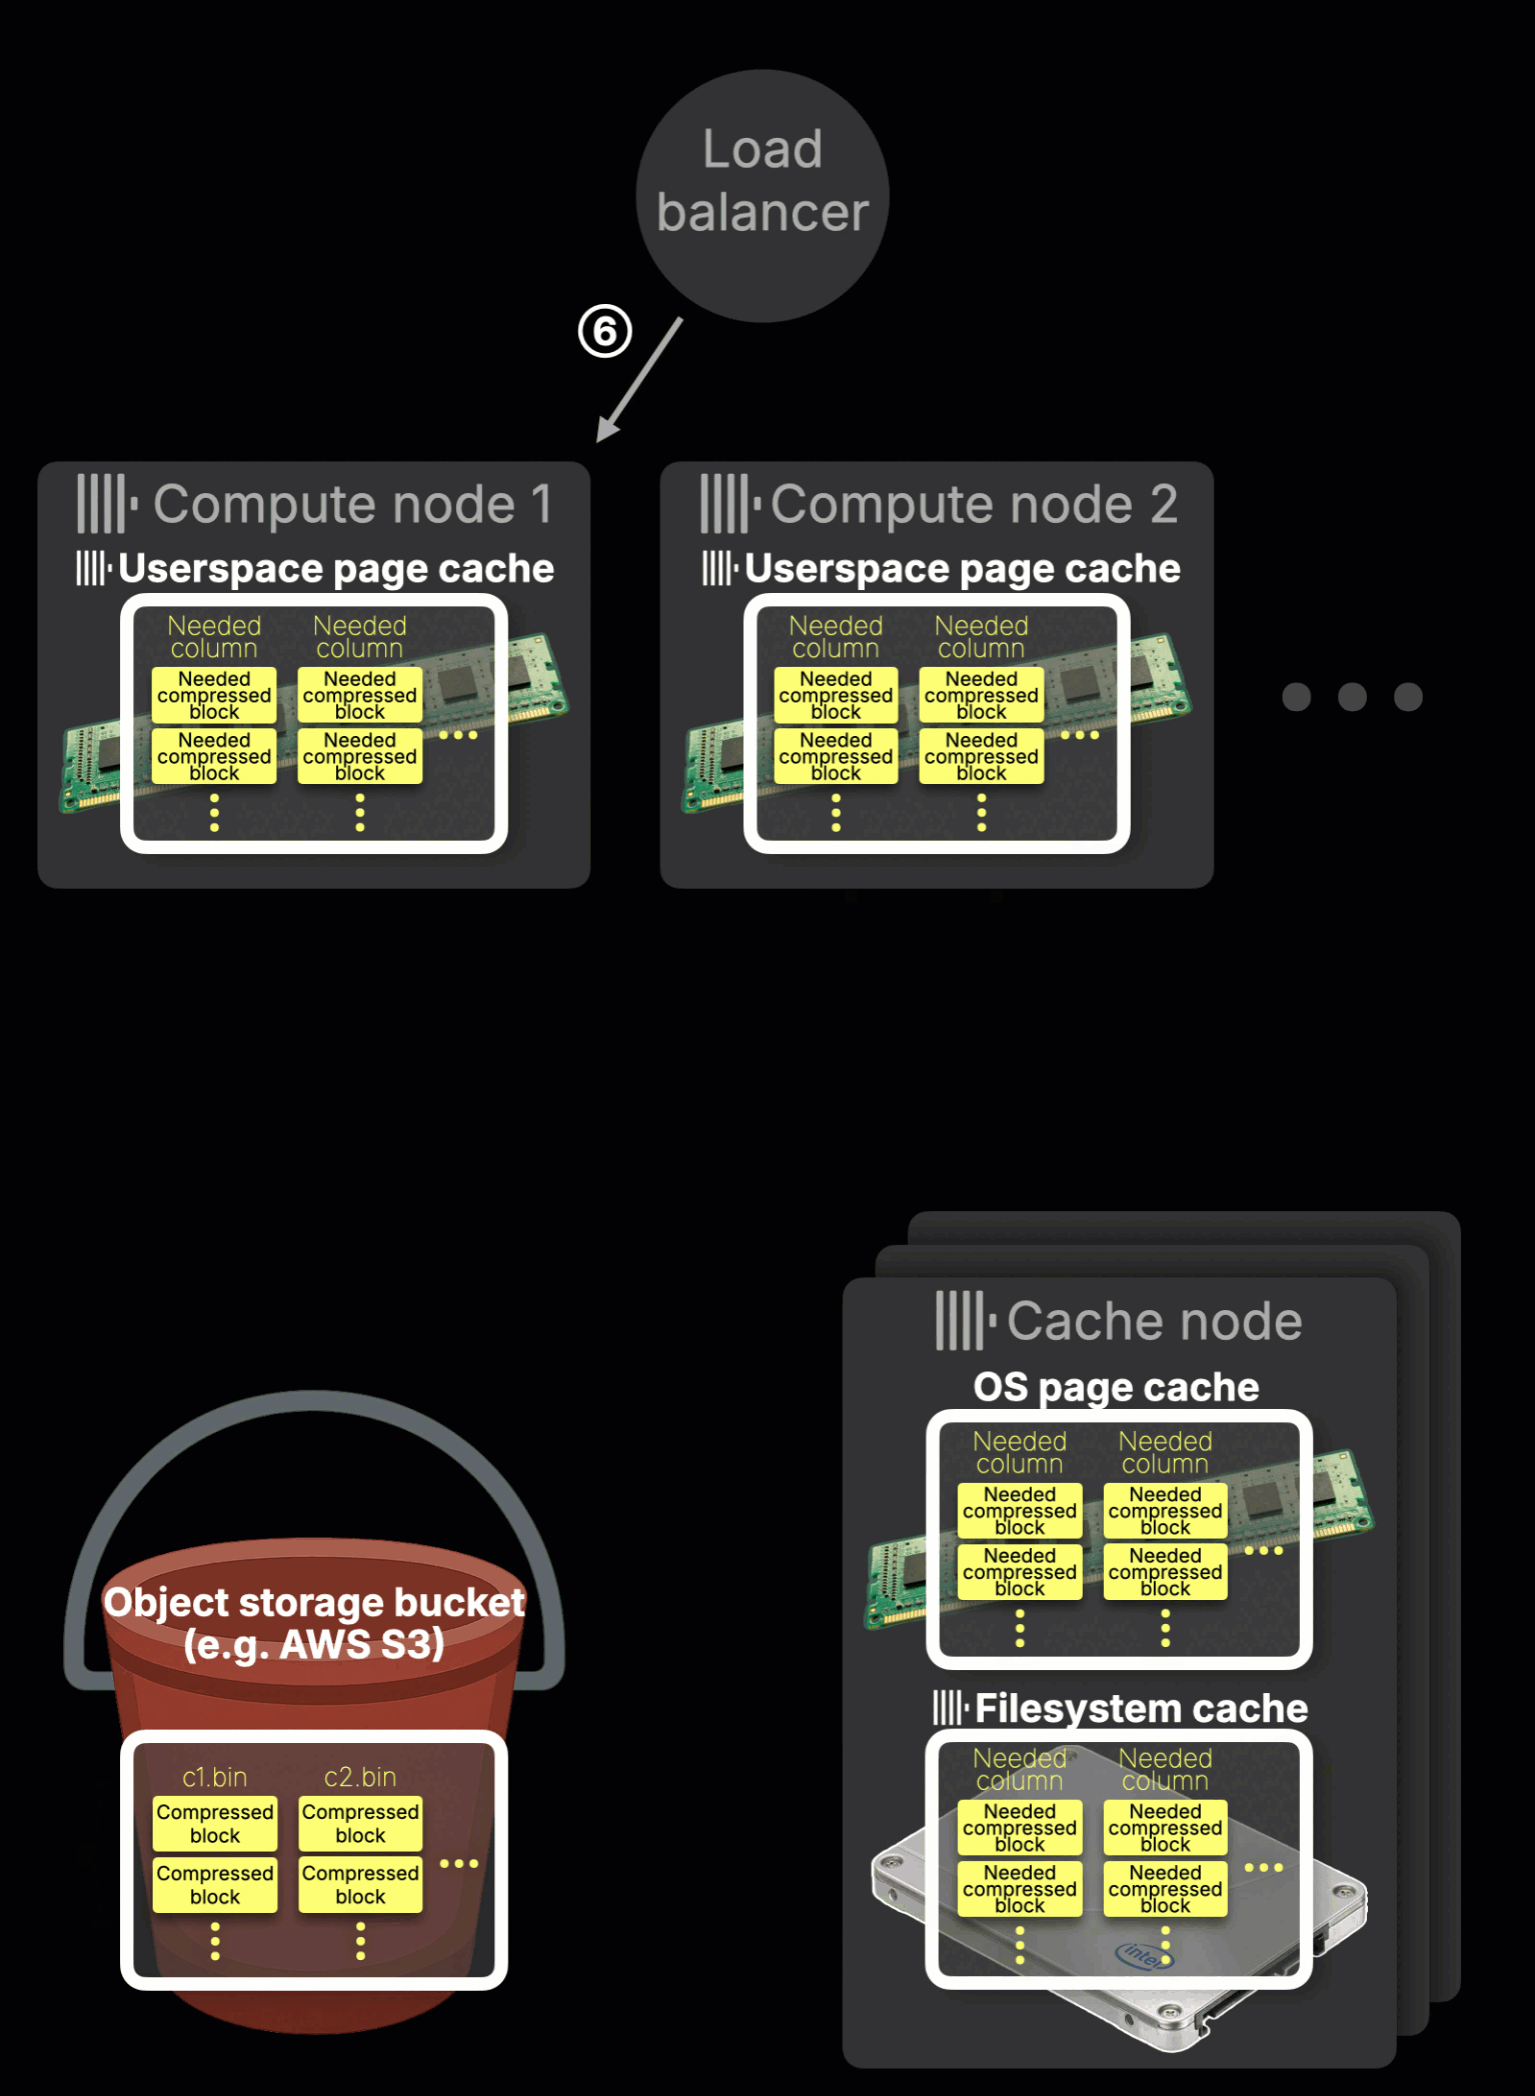
① クエリの到着:
クエリが ClickHouse Cloud サービスに到達します。ロードバランサーが処理を担当するコンピュートノードを選択します。
② ノードの選択:
クエリがコンピュートノード(例:ノード 2)にルーティングされます。ノード 1 もノード 2 も、当初はこのクエリに対するキャッシュがコールドの状態です。
③ キャッシュの検索とロード:
必要なデータがコンピュートノードのメモリ上に存在しない場合(後述の「ユーザー空間ページキャッシュ」を参照)、分散キャッシュから取得されます。このサービスは、同一アベイラビリティゾーン内の複数の専用キャッシュノード上で動作しています。各ノードは(consistent hashing を介して)ホットテーブルデータの一部を保持し、欠落しているブロックをオブジェクトストレージから取得してローカル SSD に保存し、さらに OS ページキャッシュを介して透過的にメモリへ格納します。
④ データの並列取得:
コンピュートノードは、複数のキャッシュノードから必要なブロックを並列に取得します。前述のとおり、ウォームなキャッシュデータは SSD とメモリの中間のアクセスレイテンシで取得でき、集約スループットはローカル SSD を上回り、50〜100 GB/s 以上に達します。
他ノードからの即時キャッシュ再利用
一度ウォームアップされれば、すべてのコンピュートノードがキャッシュされたデータを即座に再利用できることこそが、分散キャッシュの真の強みです。⑤ 次のクエリが ⑥ 別のノード(例:ノード 1)にルーティングされた場合でも、高レイテンシなオブジェクトストレージにアクセスすることなく、低レイテンシな分散キャッシュからホットデータを直接取得できます。
ユーザー空間ページキャッシュによる RAM キャッシュ
依然として RAM が最も高速なレイヤーであるため、クエリ速度の観点からホットデータをメモリにキャッシュすることは不可欠です。ClickHouse Cloud のコンピュートノードはキャッシュ用にローカルディスクを使用しなくなったため、OS ページキャッシュを利用できなくなりました。そこで私たちはユーザー空間ページキャッシュを導入しました。これは、分散キャッシュやリモートファイルから読み書きされるデータをキャッシュするためのインメモリレイヤーです。
これにより全体像が完成します。低レイテンシを実現し、並列性によってスケールし、ステートレスなコンピュートをサポートする、完全に分離されたキャッシュアーキテクチャです。
それでは、この完全なキャッシュスタックが、従来の構成やこれまでの ClickHouse Cloud の各段階と比較してどのような性能を発揮するのかを見ていきましょう。
ClickHouse におけるホットデータキャッシュのベンチマーク
各キャッシュ段階が実際の環境でどのように機能するかをテストしました。
分散キャッシュは現在テスト段階にあり、最適化やスケーリングが完全に完了しているわけではないため、ここに示す結果は最終的な本番環境の性能を反映したものではありません。
同一のデータセットに対して 2 種類のクエリをテストしました。
-
スループット依存のクエリ – 合計読み取り帯域幅をテストする全表スキャン。
-
レイテンシ依存のクエリ – 細かく分散した読み取りを伴い、アクセスレイテンシに負荷をかける軽量クエリ。
これら 3 つのキャッシュ段階すべてにわたってベンチマークを実行しました。
-
SSD を備えたシェアードナッシングの自己管理型サーバー。
-
従来のローカルファイルシステムキャッシュを用いた ClickHouse Cloud。
-
新しい分散ファイルシステムキャッシュを用いた ClickHouse Cloud。
すべての構成で同等のハードウェアを使用しました。
-
自己管理型サーバー:m6i.8xlarge EC2 インスタンス(32 コア、128 GB RAM)。
-
ClickHouse Cloud コンピュートノード:ノードあたり 30 コア、120 GB RAM。
-
分散キャッシュバックエンド:アベイラビリティゾーンあたり 8 つの専用キャッシュノード。
ホットクエリがキャッシュされたデータのみを確実にヒットするように、圧縮状態で完全に RAM に収まる(32 GB)Amazon reviews データセットを使用しました。
SELECT
formatReadableQuantity(sum(rows)) AS rows,
round(sum(data_uncompressed_bytes) / 1e9) AS data_size_gb,
round(sum(data_compressed_bytes) / 1e9) AS compressed_size_gb
FROM system.parts
WHERE active AND database = 'amazon' AND table = 'amazon_reviews';┌─rows───────────┬─data_size_gb─┬─compressed_size_gb─┐
│ 150.96 million │ 76 │ 32 │
└────────────────┴──────────────┴────────────────────┘スループットベンチマーク:全表スキャン
以下のクエリを使用して全表スキャンを実行しました。
SELECT count()
FROM amazon.amazon_reviews
WHERE NOT ignore(*);このスキャンは圧縮されたすべてのカラムにアクセスするため、エンドツーエンドのキャッシュスループットをテストするのに最適です。
次のグラフはその結果を示しています。
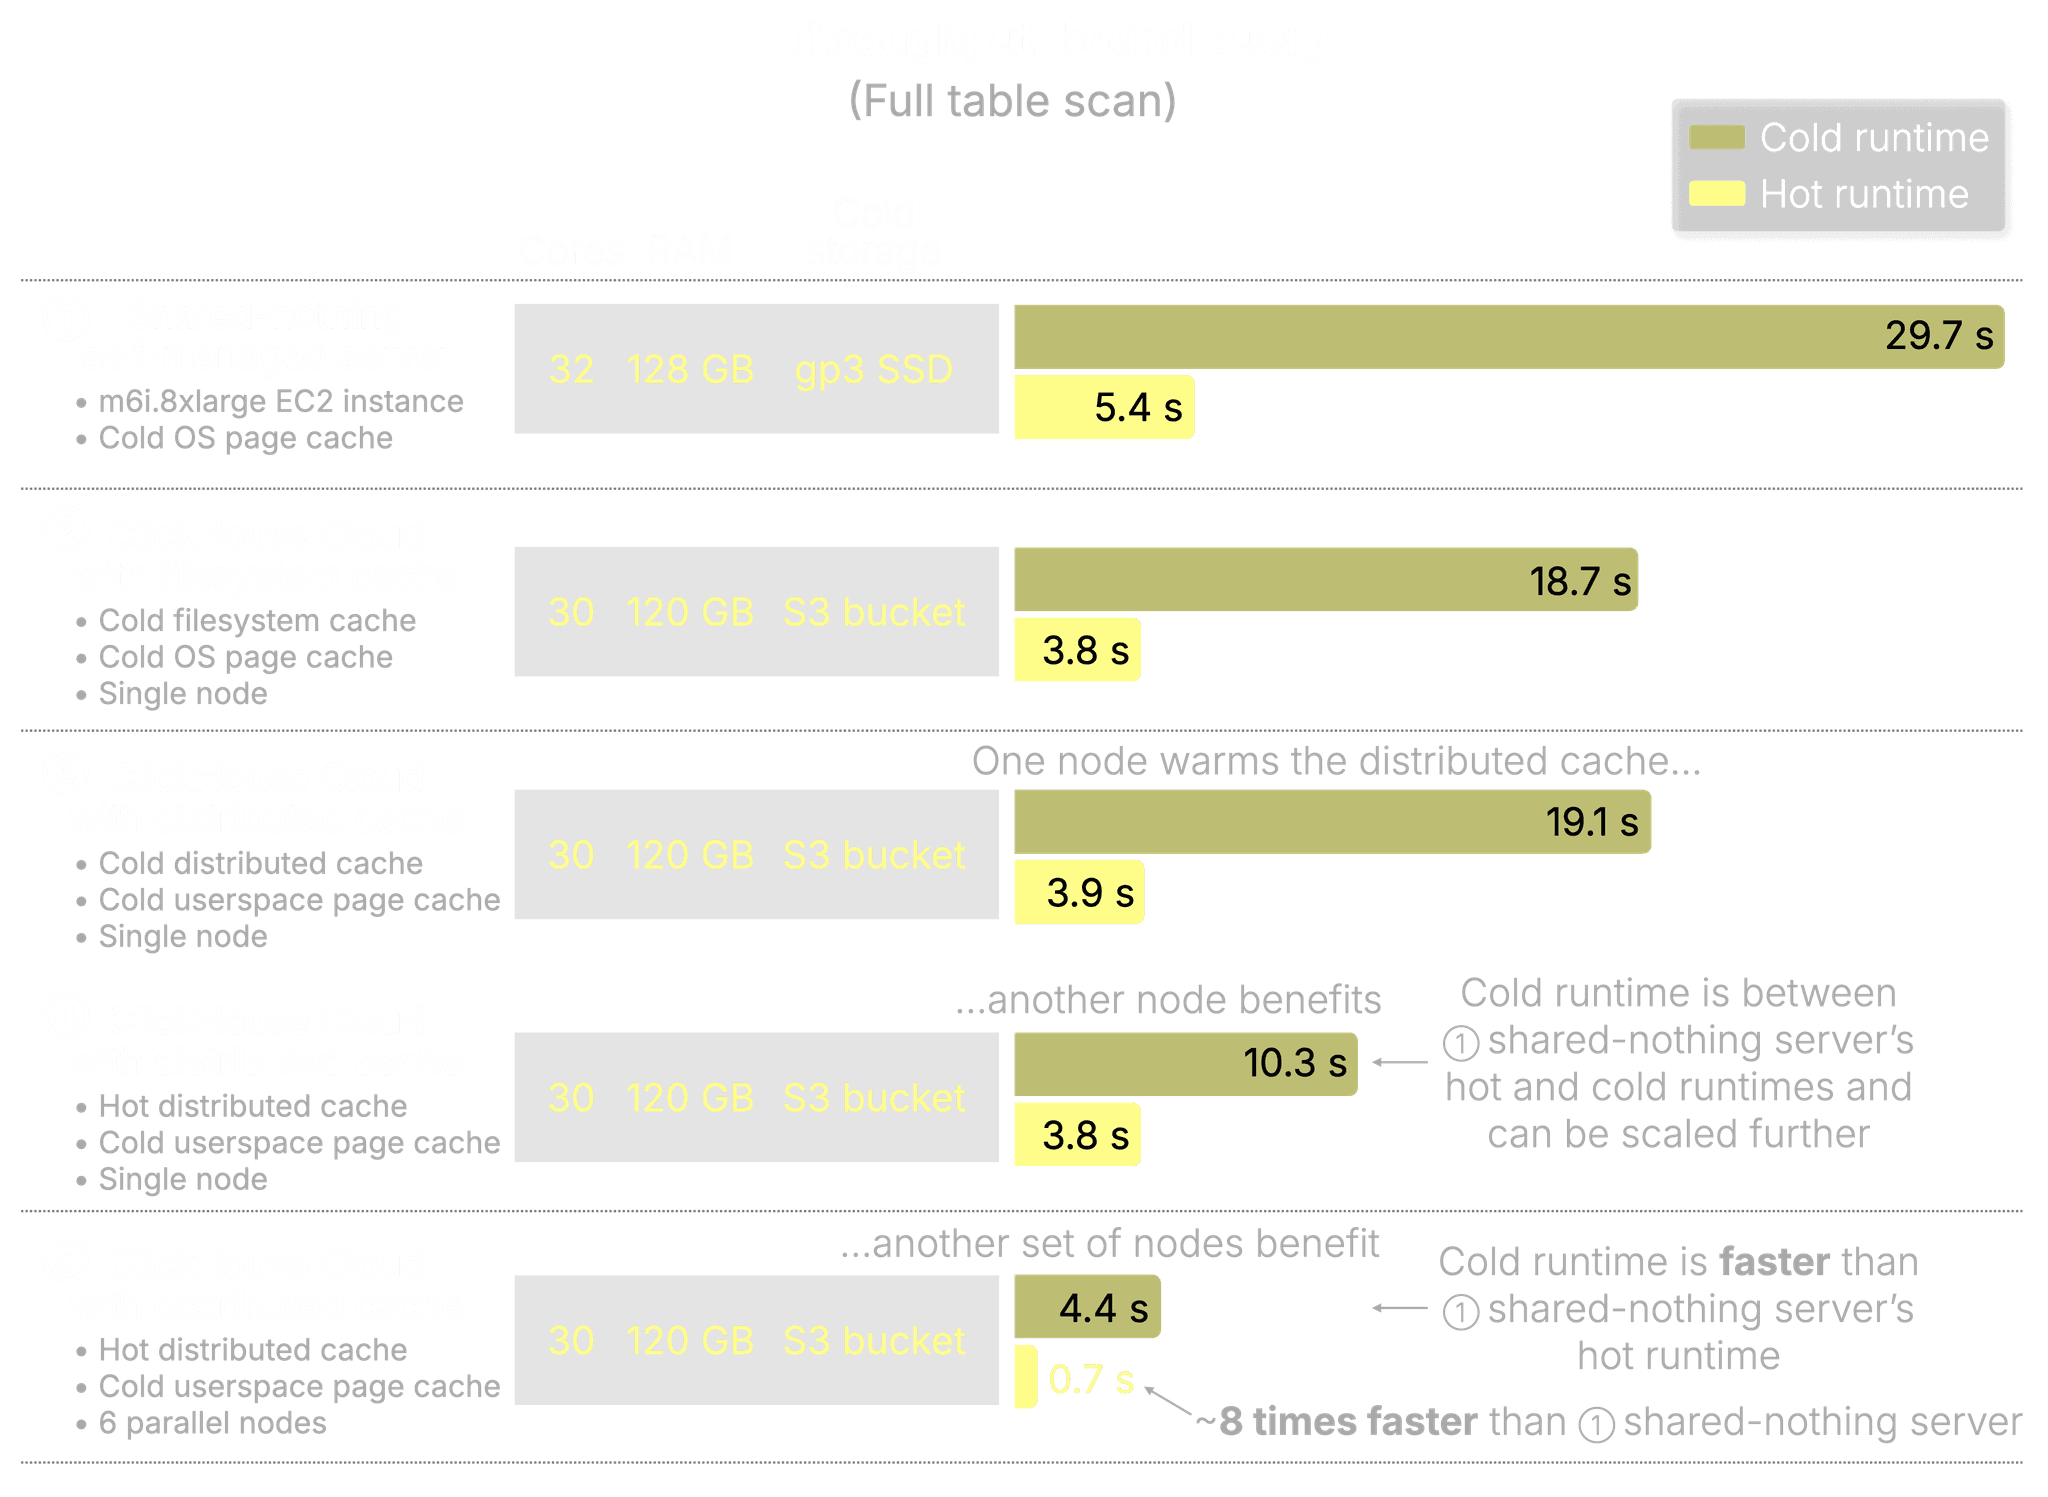
以下の 5 つの構成のそれぞれで、同じ全表スキャンを実行しています。各構成の結果は次のとおりです。
① シェアードナッシングの自己管理型サーバー
SSD と OS ページキャッシュを組み合わせたベースラインです。SSD は 16,000 IOPS、最大スループット 1,000 MiB/s の gp3 EBS ボリュームであり、この m6i.8xlarge EC2 インスタンスで利用可能な最速の EBS オプションです。
② ローカルファイルシステムキャッシュを用いた ClickHouse Cloud
S3 のローカルキャッシュとして機能する直接アタッチされた SSD を備えた、単一のコンピュートノードです。
-
コールド実行:18.7 秒 – オブジェクトストレージからの取得であるにもかかわらず、マルチスレッド読み取りとプリフェッチによって、自己管理型構成の SSD フルスキャンを上回る性能を発揮。
-
ホット実行:3.8 秒 – OS ページキャッシュがホットデータをメモリ内に保持し、高速に実行。 注:コア数は ① と同等ですが、CPU モデルの違いにより若干の性能差が生じています。
③ 分散キャッシュ(初期ウォームアップ)
単一ノードが、コールド状態の分散キャッシュと自身のユーザースペースページキャッシュへデータをロードします。
④ 分散キャッシュ(後続ノード)
コールド状態のユーザースペースページキャッシュを持つ 2 つ目のノードが、すでにホット状態になっている分散キャッシュからホットデータを取得します。
-
コールド実行:10.3 秒 – オブジェクトストレージへアクセスする必要がありません。ネットワーク経由で分散キャッシュから取得します。
特筆すべきは、これが S3 からの取得と比べて約 2 倍高速であり、自己管理型 SSD 構成と比べても約 3 倍高速である点です。この性能は、キャッシュノードの追加、並列度の向上、利用可能なネットワーク帯域幅の最大活用によって、さらにスケールさせることが可能です。 -
ホット実行:3.8 秒 – 先ほどのホット状態のユーザースペースページキャッシュ構成と同等。
⑤ 分散キャッシュ(後続の 6 並列ノード)
コールドスタートした 6 つのコンピュートノードが並列でクエリを実行し、すべてがホット状態の分散キャッシュから読み取ります。
-
コールド実行:4.4 秒 – ① のホット実行よりも高速。
-
ホット実行:0.7 秒 – 並列読み取りと共有キャッシュ状態による超線形(superlinear)スケーリングのおかげで、① のホット実行より 8 倍高速。
クラスターにステートレスなコンピュートノードを追加しただけです。それ以上の作業は不要です。自己管理型のシェアードナッシング構成でこのレベルの並列性を達成するには、ノード間での手動によるデータの再シャーディングと再分散が必要であり、複雑で時間のかかる作業になります。スケールダウンする際にも、まったく同じ作業を繰り返さなければなりません。ClickHouse Cloud では、単純なエラスティックスケーリングだけで済みます。
共有キャッシュ + エラスティックコンピュート = コールドスタート時であってもローカル SSD を凌駕する性能。
レイテンシベンチマーク:細かく分散した読み取り
クエリが小さくなると、スループットではなくレイテンシがボトルネックになります。このベンチマークでは、I/O を飽和させるにはデータ量が少なすぎる、細かく分散した読み取りを伴う軽量クエリを使用しており、レイテンシが支配的な要因になります。
SELECT *
FROM amazon.amazon_reviews
WHERE review_date in ['1995-06-24', '2015-06-24', …]
FORMAT Null;このようなクエリでは、ClickHouse は帯域幅によってレイテンシを隠蔽できるほど十分な I/O リクエストを展開(fan out)できません。性能は、個々の小さな読み取りがどれだけ速く完了するかに左右されます。
結果は以下のとおりです。
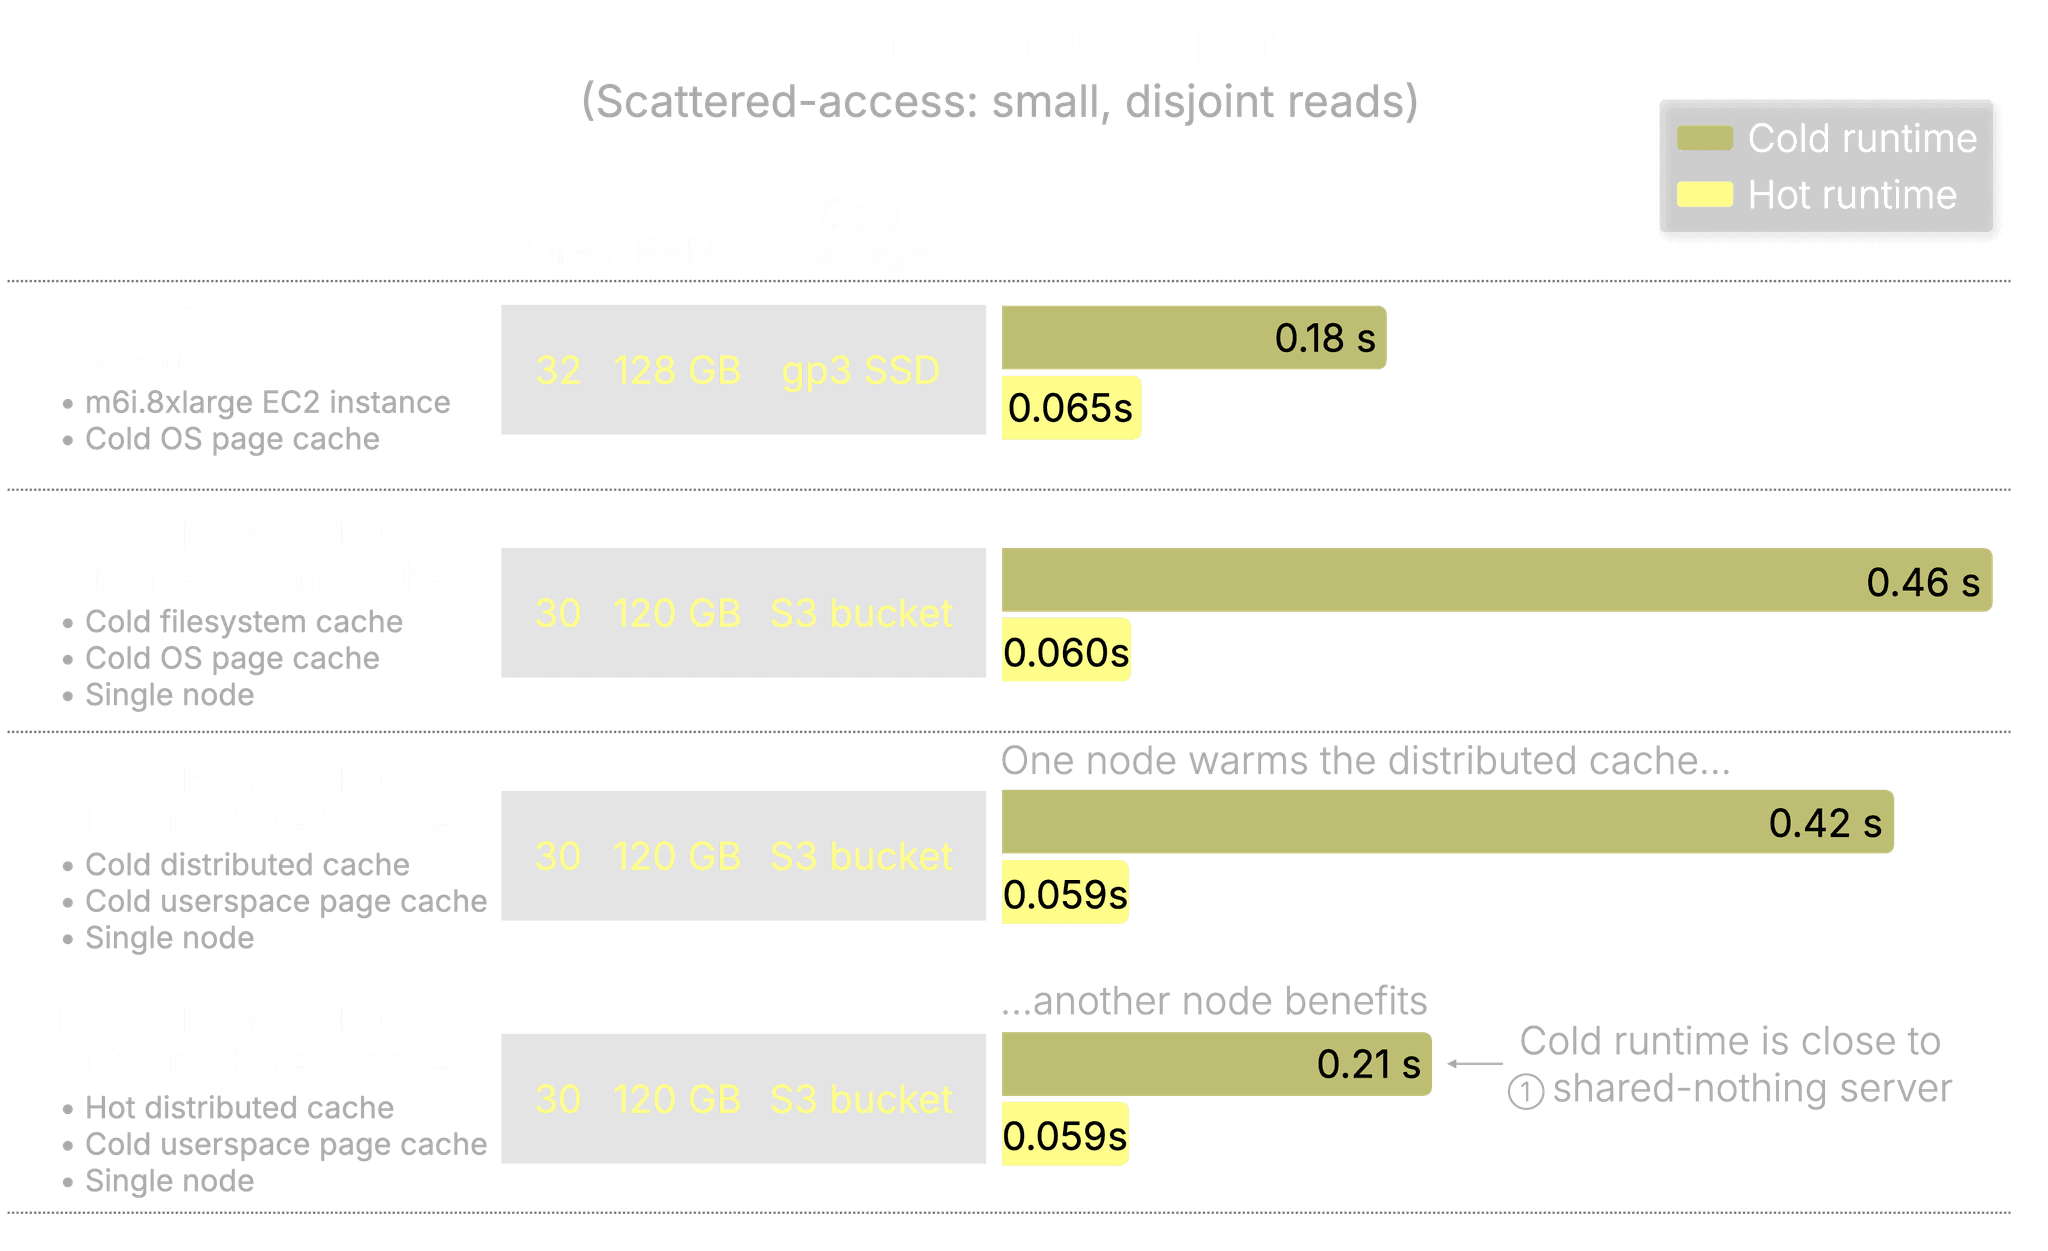
レイテンシ依存のベンチマークで各構成がどのように機能したかを詳しく見ていきます。
① シェアードナッシングの自己管理型サーバー
低レイテンシアクセスのベースライン:SSD + OS ページキャッシュ。
② ローカルファイルシステムキャッシュを用いた ClickHouse Cloud
S3 をキャッシュするローカル SSD を備えた 1 つのコンピュートノードと、OS ページキャッシュ。
- コールド実行:0.46 秒 – 初期の S3 レイテンシにより、① より低速。
S3 から読み取っているにもかかわらず、マルチスレッド読み取りとプリフェッチによって ClickHouse Cloud が SSD ベースのサーバーを上回った上記のスループットベンチマークとは異なり、ここではその利点が失われます。細かく分散した読み取りでは、I/O スレッド全体に効率よく展開できるだけのデータが存在しないことがよくあります。並列で読み取りを発行したとしても、クエリの性能はテールレイテンシ、つまり最も遅い個別の読み取りによって制限されてしまいます。この場合、帯域幅ではなくレイテンシがボトルネックになるため、S3 は SSD よりも遅くなります。
- ホット実行:60 ms – ① とほぼ同等。
③ 分散キャッシュ(初期ウォームアップ)
分散キャッシュとユーザースペースページキャッシュの双方がコールド状態で開始します。
④ 分散キャッシュ(後続ノード)
分散キャッシュはホット状態ですが、このコンピュートノードのユーザースペースページキャッシュはまだコールド状態です。
-
コールド実行:0.21 秒 – データはネットワーク経由で分散キャッシュから取得され、S3 を完全にバイパスします。
これはローカルに一切データを保存することなく、SSD を備えた自己管理型シェアードナッシングサーバーとほぼ同等の速度を実現しています。 -
ホット実行:59 ms – 最速のパスと同等の水準。
ローカルストレージをまったく使わずに、SSD 速度とメモリ速度の双方のレイテンシを達成しました。
影響と今後の展望
キャッシュをコンピュートから切り離すことで、分散キャッシュは ClickHouse Cloud において、エラスティックでステートレスなコンピュートノード全体にわたるホットデータへの高速で一貫したアクセスを実現します。
これにより、以下のメリットがもたらされます。
-
ウォームアップの高速化:どのコンピュートノードも、オブジェクトストレージよりも大幅に低いレイテンシで分散キャッシュからキャッシュデータを取得でき、コールドスタート時にストレージから再ダウンロードする必要がありません。
-
キャッシュ処理の共有:あるノードが行った処理が、他のすべてのノードにも役立ちます。
-
エラスティックスケーリング:キャッシュデータを失うことなく、コンピュートノードを自在に追加、削除、サイズ変更できます。
-
ステートレスコンピュート:ローカルにデータを永続化したり、再起動後にキャッシュを再構築したりする必要がありません。
テストデータセットでのベンチマークは、これが実際の性能向上にどうつながるかを実証しており、特に 2 つの大きな成果が示されています。
-
スループット:全表スキャンにおいて、共有キャッシュとコンピュートノード間での並列取得のおかげで、コールドクエリは自己管理型 SSD 構成より最大 4 倍高速に実行されました。
-
レイテンシ:細かく分散した読み取りにおいて、コールドクエリは SSD の性能に匹敵し、ホットクエリは60 ms 未満というメモリ並みの低レイテンシを達成しました。これらはすべてローカルストレージなしで実現されています。
これらの結果は、クラウドネイティブなキャッシュがローカルディスクに依存することなく、SSD レベル、あるいはそれ以上の性能を発揮できることを示しています。これは ClickHouse Cloud をより高速かつエラスティックにし、特に動的で同時実行数の多い環境において運用をシンプルにする根本的な変革です。
分散キャッシュは現在 S3 と GCS をサポートしています。Azure Blob Storage のサポートも近日対応予定です。
試してみませんか?現在、分散キャッシュのプライベートプレビューへのアクセスを受付中です。早期アクセスに登録して、低レイテンシアナリティクスの未来を一緒に形作っていきましょう。