5万

ダイレクト I/O(Direct I/O)とは何でしょうか。そして、マネージド Postgres がバックアップの際にそれを利用するのはなぜでしょうか。バックアップでは毎日、クエリを処理しているのと同じ NVMe ドライブから、数百 GB に及ぶデータベース全体をコピーしてオブジェクトストレージへ転送します。Linux はこれらの読み取りを他の通常のファイル読み取りと同様に処理します。つまり、誰かが再び要求する場合に備えて、全バイトのコピーをメモリ上のページキャッシュに保持します。しかし、誰もそれを再要求しません。カーネルはそれらのコピー用の空き容量を作るために、Postgres がメモリ上に保持し、まさに使おうとしていたデータを追い出してしまいます。その結果、そのデータを必要とする次のクエリはメモリではなくディスクへアクセスすることになります。
ダイレクト I/O は、これらの読み取りにおいてキャッシュをスキップするようカーネルに指示するフラグです。これを有効にすると、第二の問題が生じます。読み取り時にカーネルの先読み(readahead)も失われるため、4 台でストライピングされた NVMe ドライブ群において、小さな読み取りサイズでは 1 台のドライブだけがビジー状態になり、残りの 3 台はアイドル状態になってしまいます。
概要
バックアップは、稼働中のデータベースの全バイトを、クエリを処理しているのと同じドライブから読み取ります。デフォルトでは、これらの読み取りはカーネルのページキャッシュを経由するため、データベースがメモリ上に保持していたデータを追い出し、クエリ実行中に 1 バイトごとにカーネルによるコピーのオーバーヘッドが発生します。
ダイレクト I/O はキャッシュをスキップします。検証環境のサーバーでは、ウォームなデータをメモリ上に残したまま、バックアップ中のクエリに対するレイテンシの悪化を約 3 分の 1 に抑え、CPU 使用率を約 14% 削減しました。また、先読みが無効になるため、ストライピングされた NVMe では読み取りサイズとリーダー(reader)の数をアレイに合わせて調整する必要があります。
ClickHouse Managed Postgres では、各ダイレクト読み取りのサイズが RAID0 ストライプ全体に及ぶように設定し、ハードウェアに合わせてリーダー数をスケールさせます。48 vCPU、NVMe ドライブ 4 台、稼働中のワークロード下にある 467 GB のデータベースを備えたサーバーにおいて、バッファ付きバックアップではメモリ上でウォームかつアイドル状態だったテーブルの 40 GiB すべてがエビクト(追い出し)されました。一方、ダイレクト I/O バックアップでは何もエビクトされず、71 秒で完了しました。
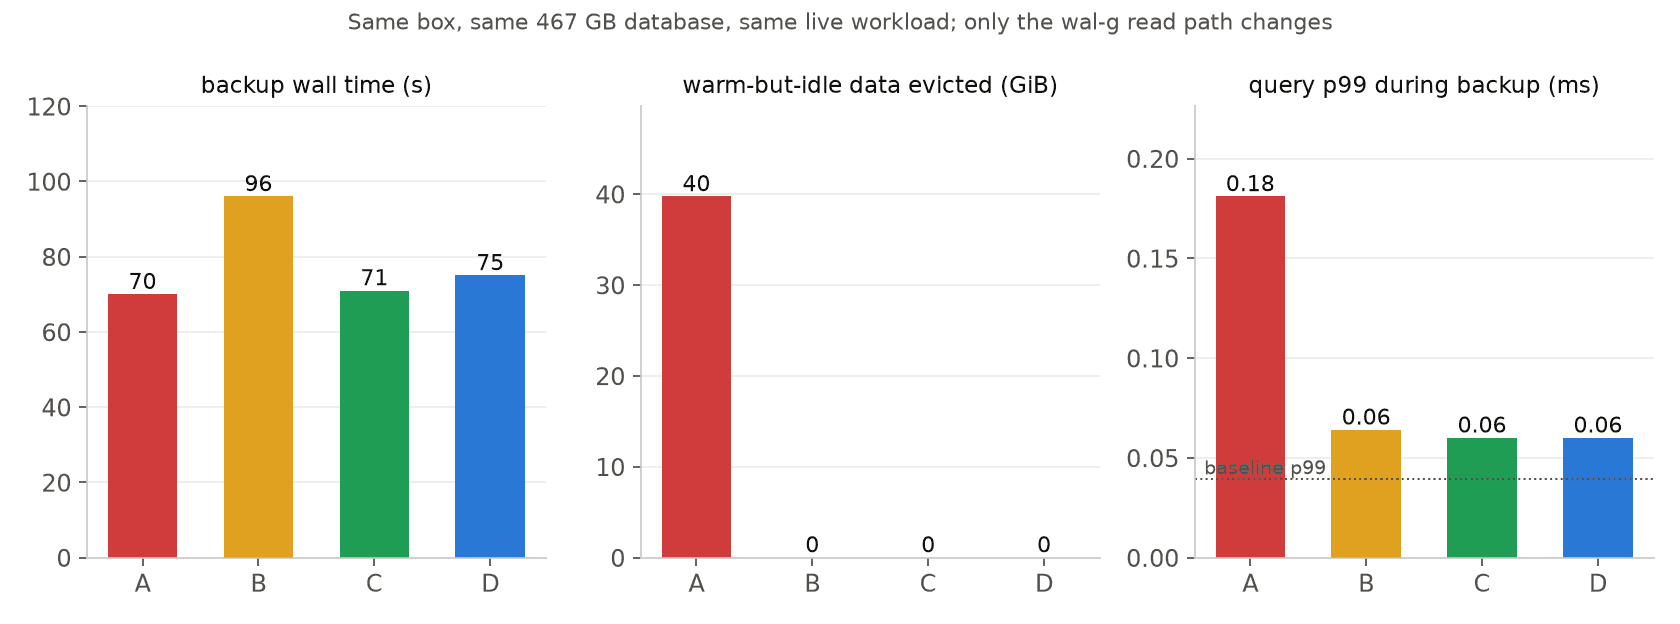
467 GB のデータベースと継続的な読み取りワークロードを備えた同一の i8ge.12xlarge インスタンス上で検証された 4 つの wal-g 構成。A(赤): バッファ付き読み取り、並列ディスクリーダー 24。B(オレンジ): 128 KiB 読み取りのダイレクト I/O、リーダー 24。C(緑): 4 MiB 読み取りのダイレクト I/O、リーダー 48。D(青): 4 MiB 読み取りのダイレクト I/O、リーダー 24。実行間で変更されているのは、バックアップの I/O モード、読み取りサイズ、およびリーダー数のみです。
バックアップはデータベースと同じサーバーを共有する
ClickHouse Managed Postgres では、ローカル NVMe がホットパスとなります。Postgres はヒープ、インデックス、および WAL の読み書きをそこに対して行います。これがそもそも本サービスがローカルディスク上で稼働している理由です。オブジェクトストレージにはベースバックアップとアーカイブされた WAL が保持され、これらによってポイントインタイムリカバリが可能になります。ディスクを枯渇させることなくアーカイブ WAL を転送する仕組みについては、それ自体が1つのテーマとなります。
複数のインスタンスストア NVMe を備えたインスタンスでは、mdadm --level=0 を使用してそれらをストライピングし、/dev/md0 として束ねて /dat にマウントします。Postgres は /dat 上に配置されます。バックアップエージェントである wal-g は、同じディレクトリと、オブジェクトストレージ内のタイムラインごとのバケットを指定します。
ベースバックアップは、アクセスが落ち着く時間を待ってはくれません。データベースの稼働中にデータディレクトリ全体を読み取り、その全バイトはクエリが読み取る全バイトと同じドライブから、同じカーネルを経由して取得されます。
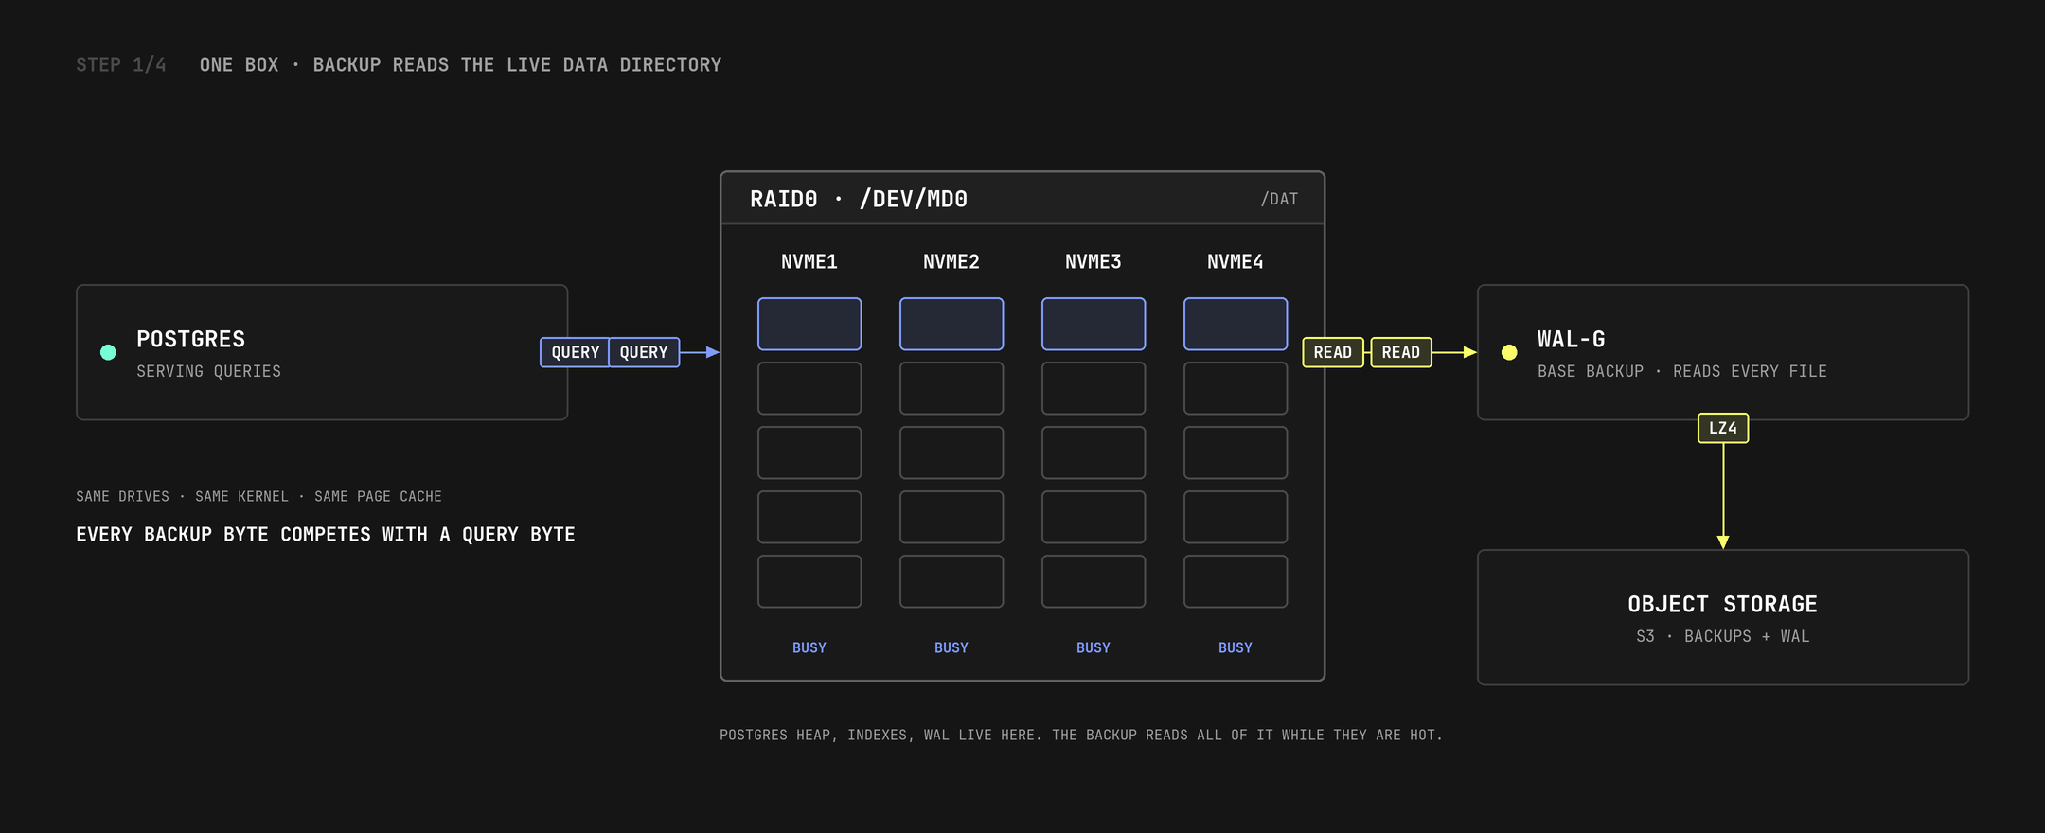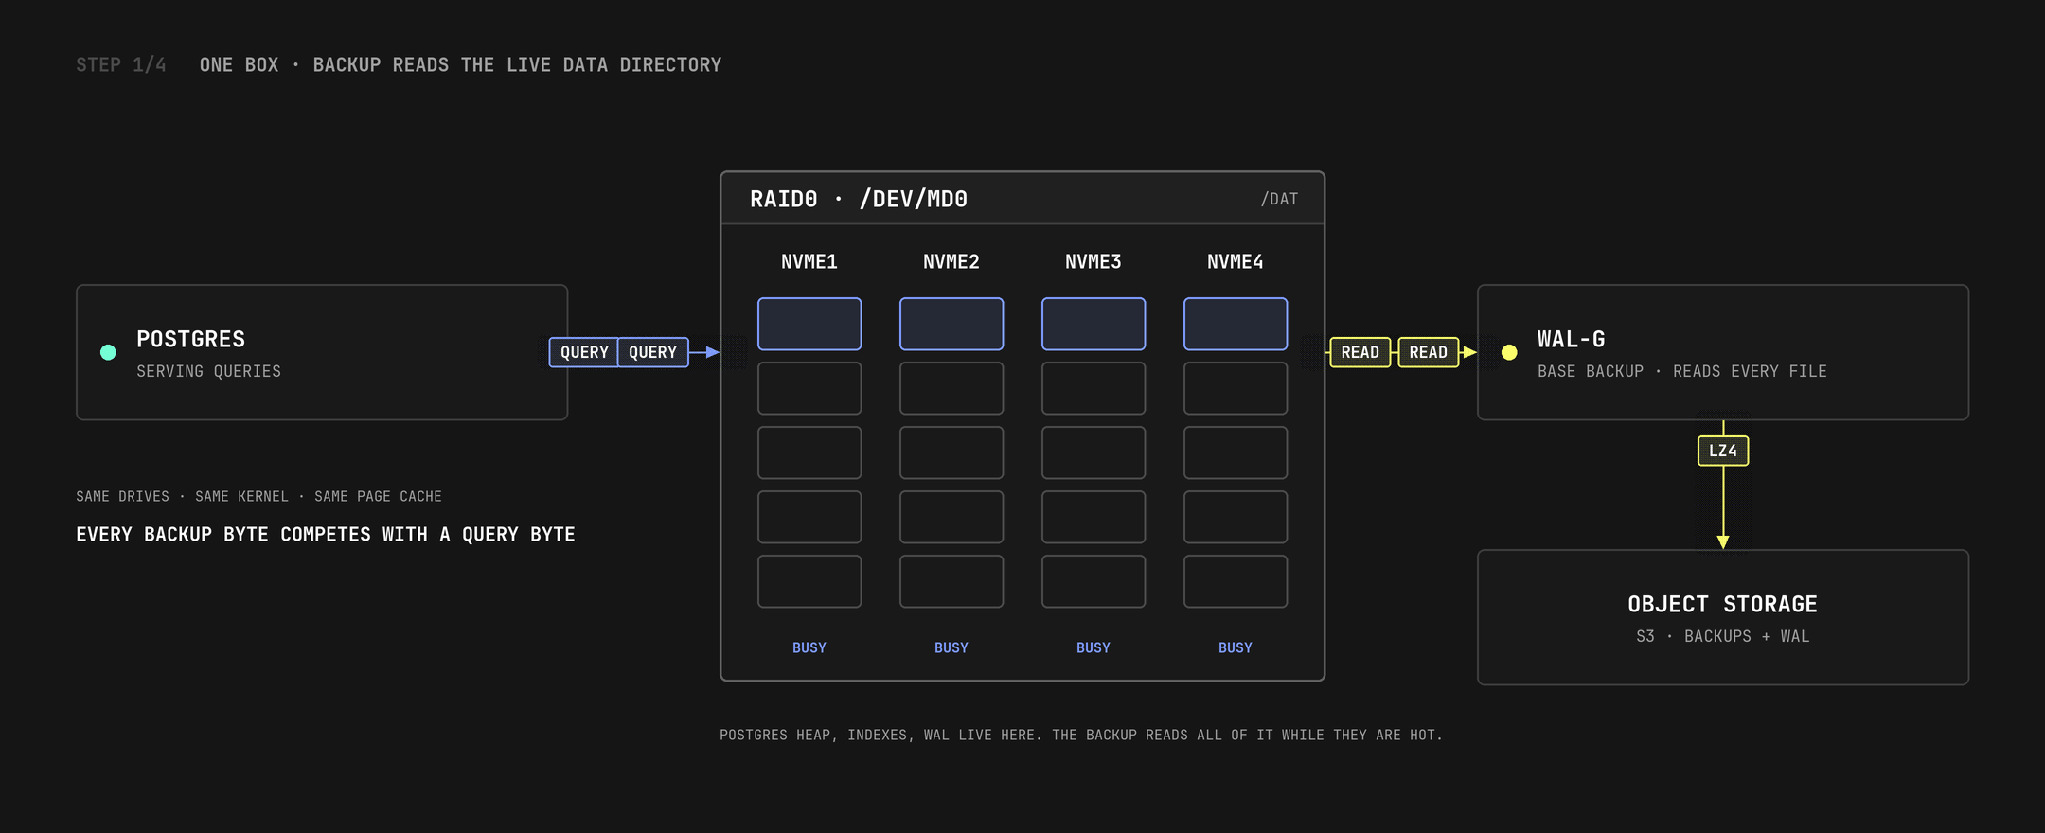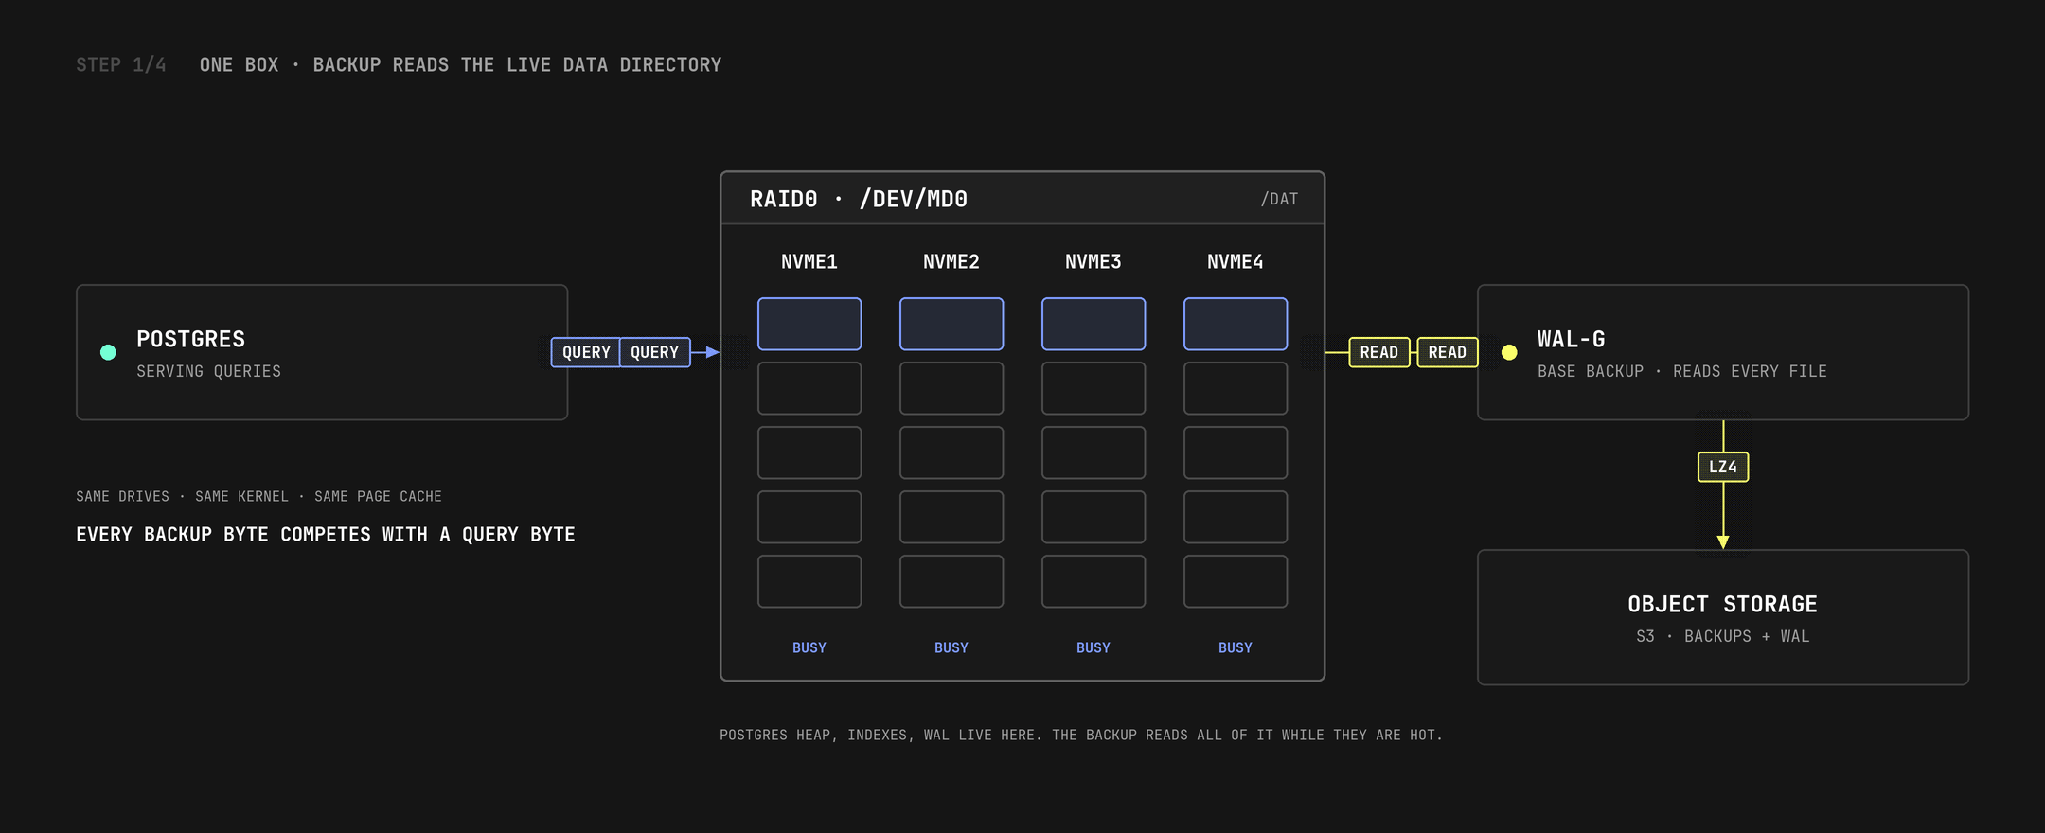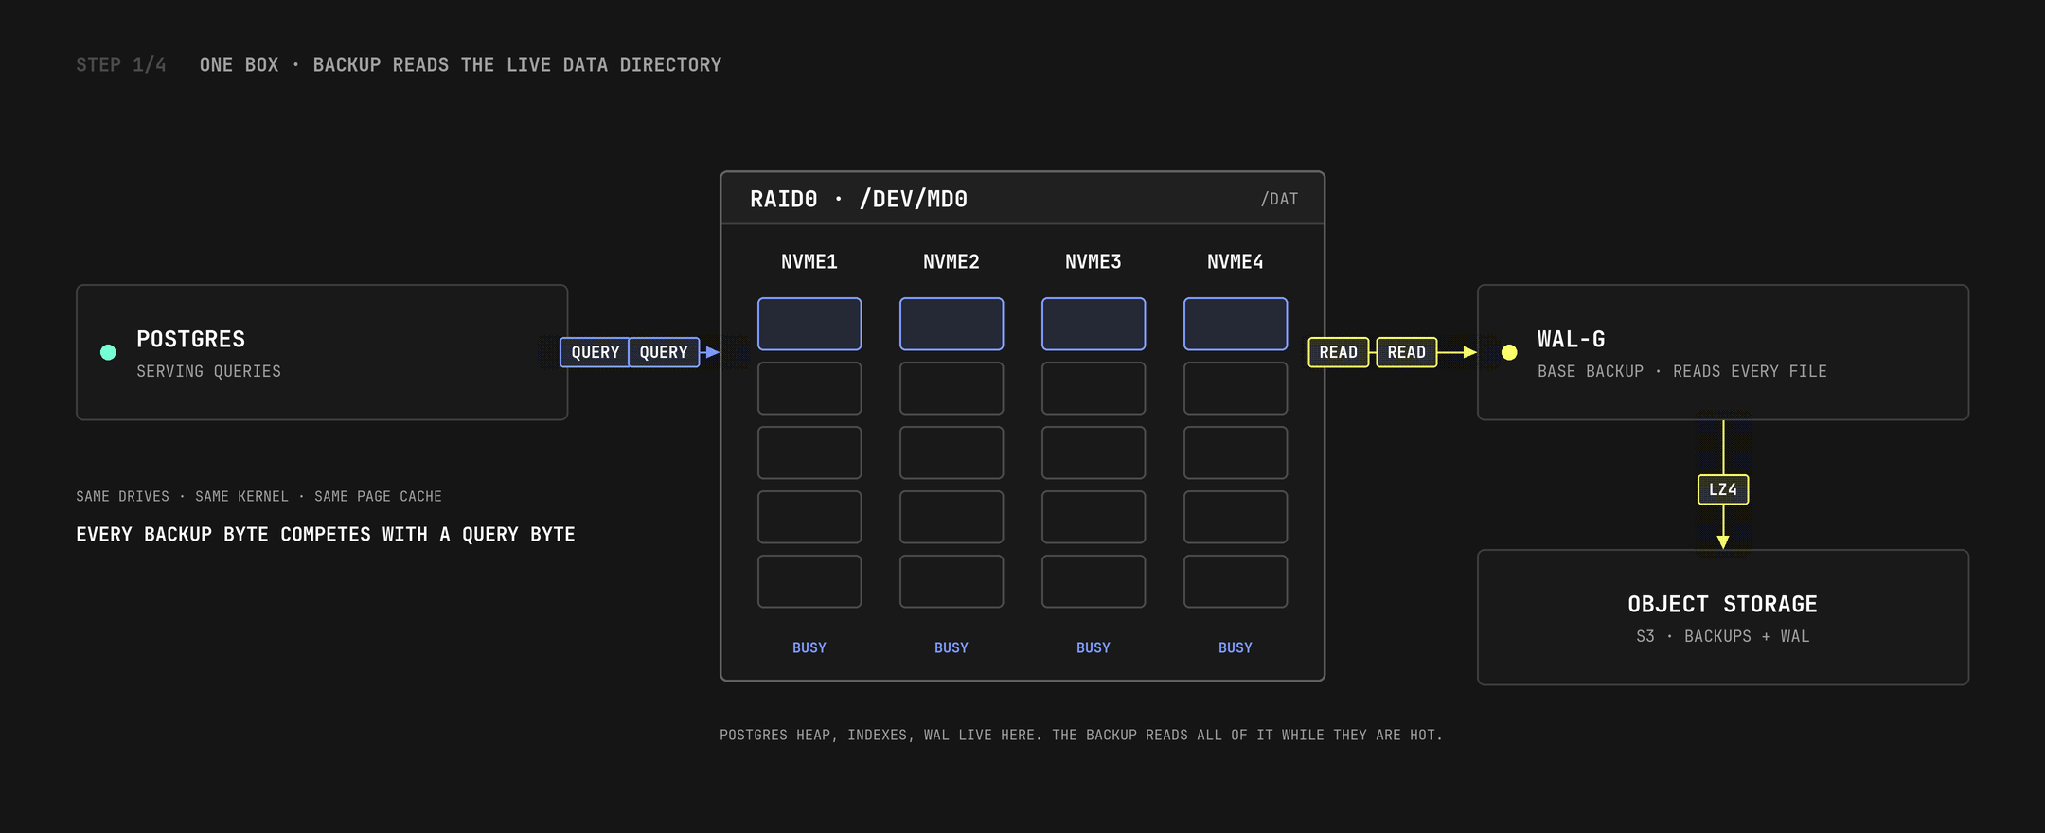
1 台のマシン、1 組のドライブ。クエリとバックアップは同じ RAID0 アレイから同時に読み取ります。
バッファ付き読み取りは Postgres に対する見えない税金
Linux 上でプロセスがファイルを読み取るとき、デフォルトではデータはページキャッシュを経由します。カーネルは、近いうちに誰かがそのデータを再要求した場合に備えてメモリ内にコピーを保持します。これはほぼすべてのプログラムにとって有益です。しかし、各ファイルを 1 回だけ読み取り、アップローダーに渡した後は二度とアクセスしないバックアップにとっては害となります。ページキャッシュは有限であり共有されているため、バックアップが数百 GB ものデータをストリーミングで流し込むと、カーネルは Postgres がメモリ上に保持していたデータを追い出して領域を確保します。
Postgres は shared_buffers 内に独自のキャッシュを持っています。これは検証サーバーの RAM の 4 分の 1 を占め、Huge Pages に固定(ピン留め)されているため、これらのページは保護されます。それ以外のすべては OS のページキャッシュに依存しています。shared_buffers に収まらないリレーションファイル、直近に書き込まれた WAL、一時ファイル、ビジビリティマップなどです。二重バッファ(double-buffered)設計は、OS 側がウォームな状態を保ち続けることを前提としています。
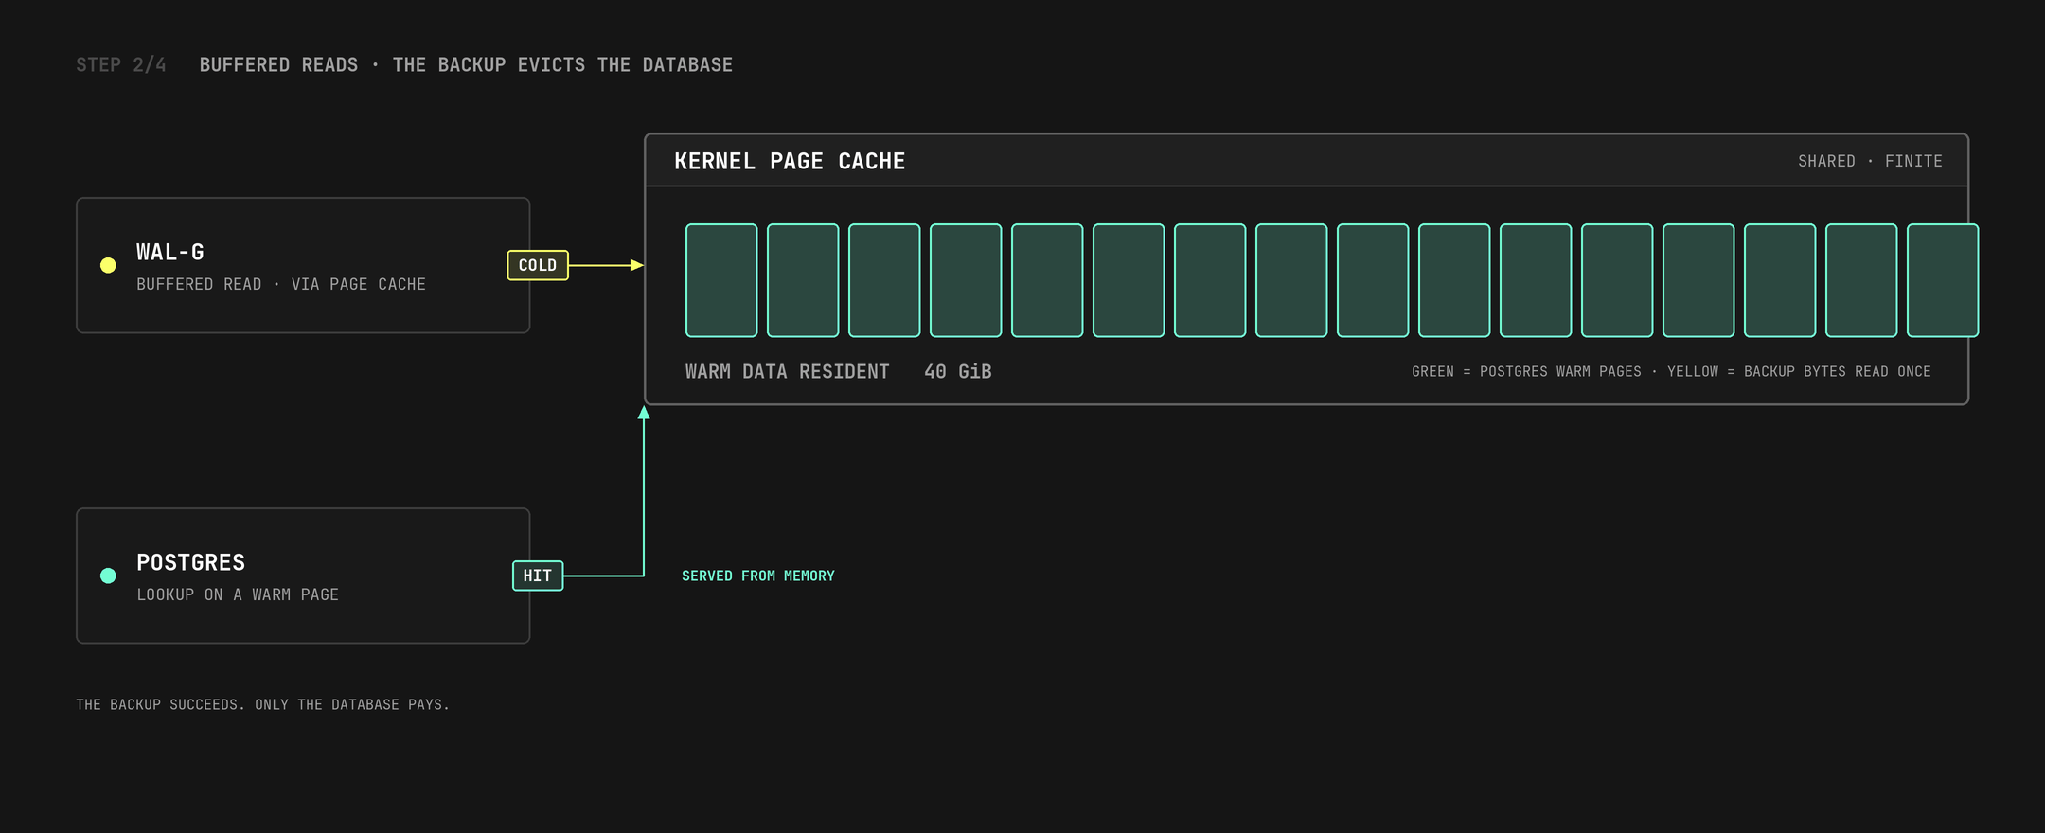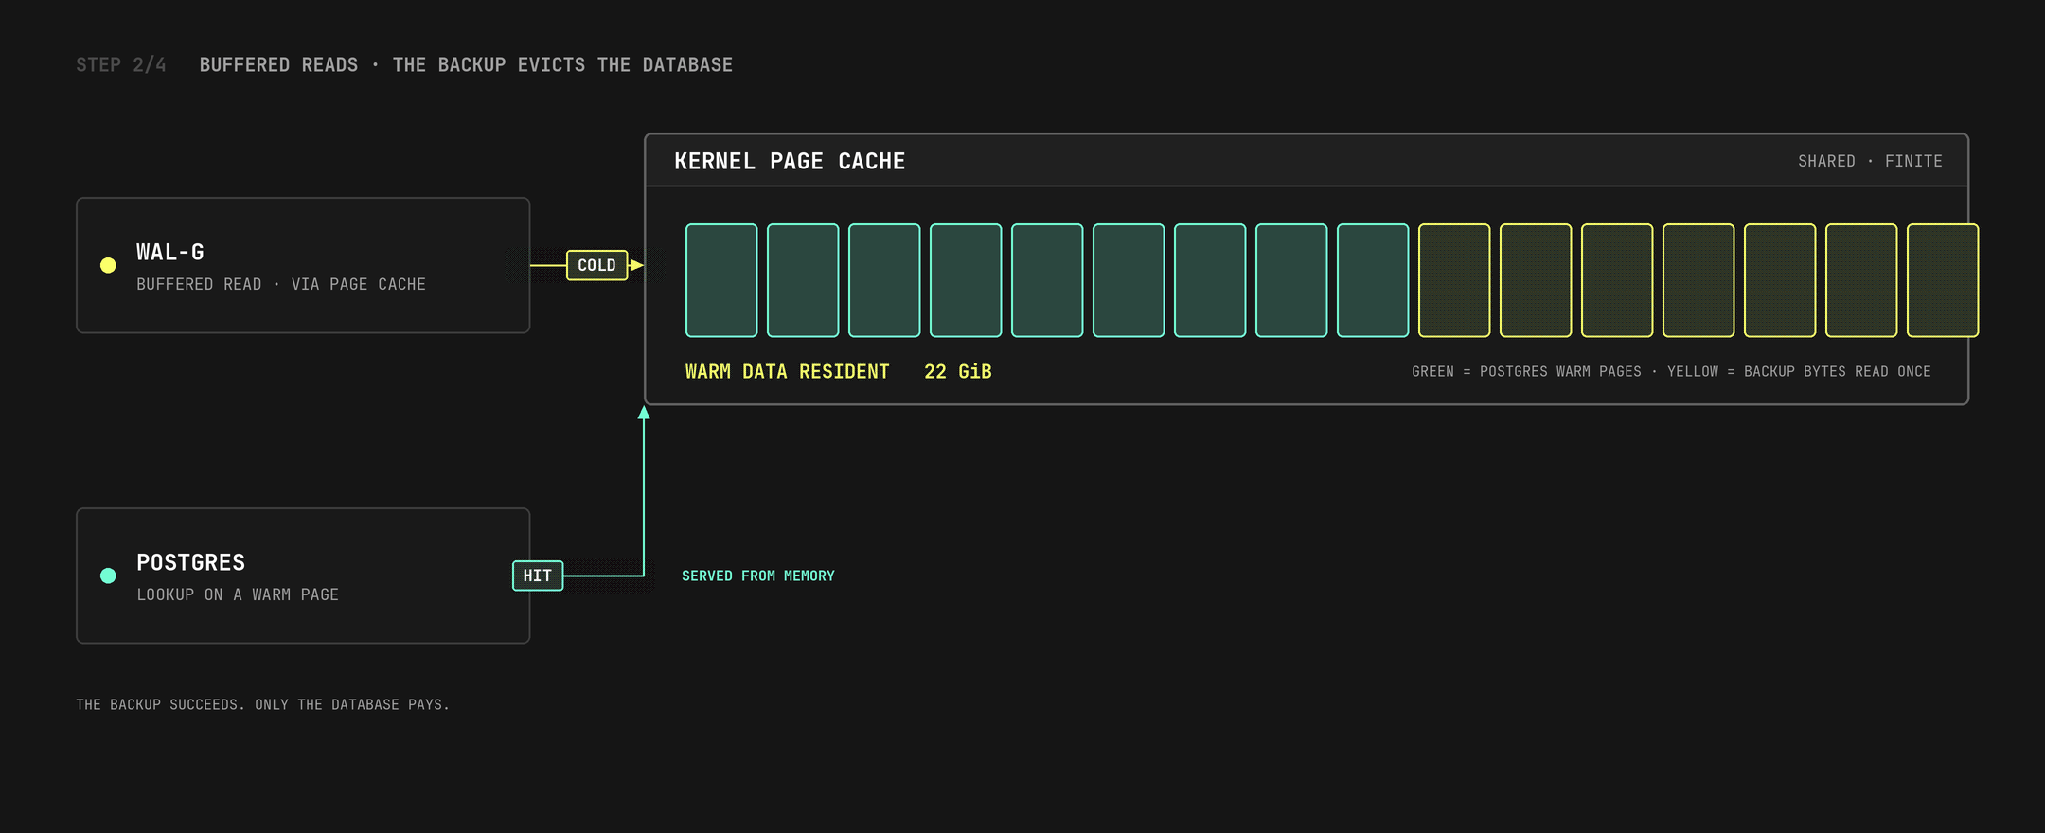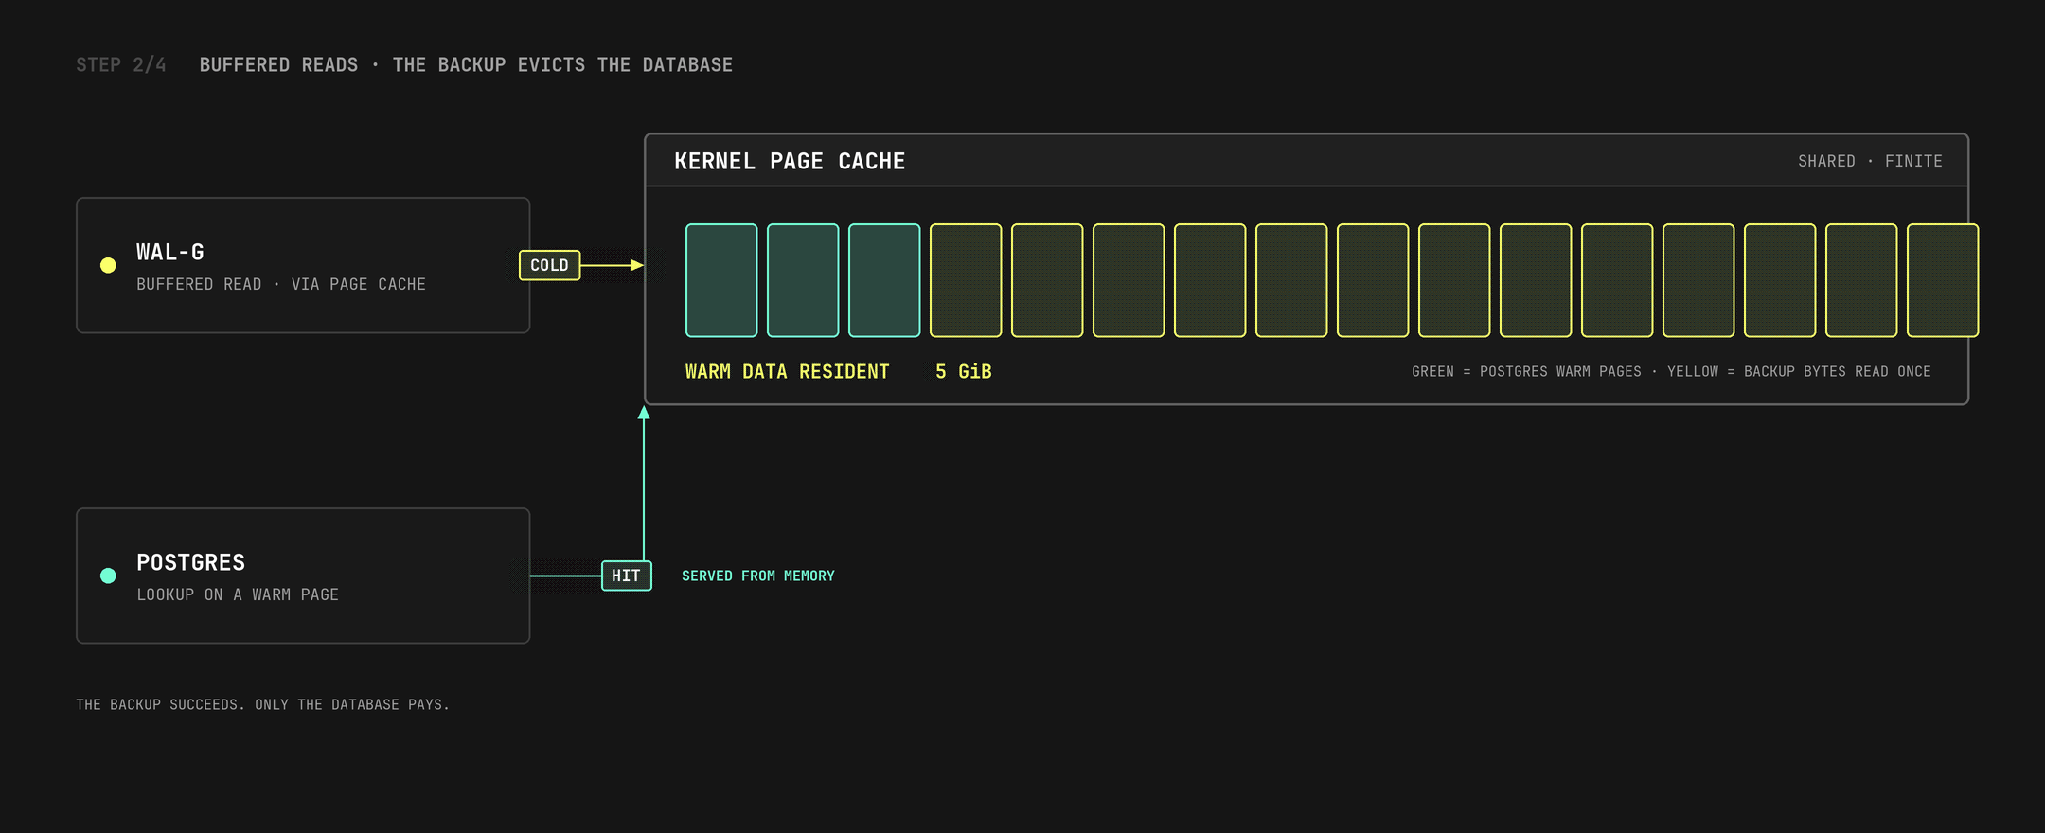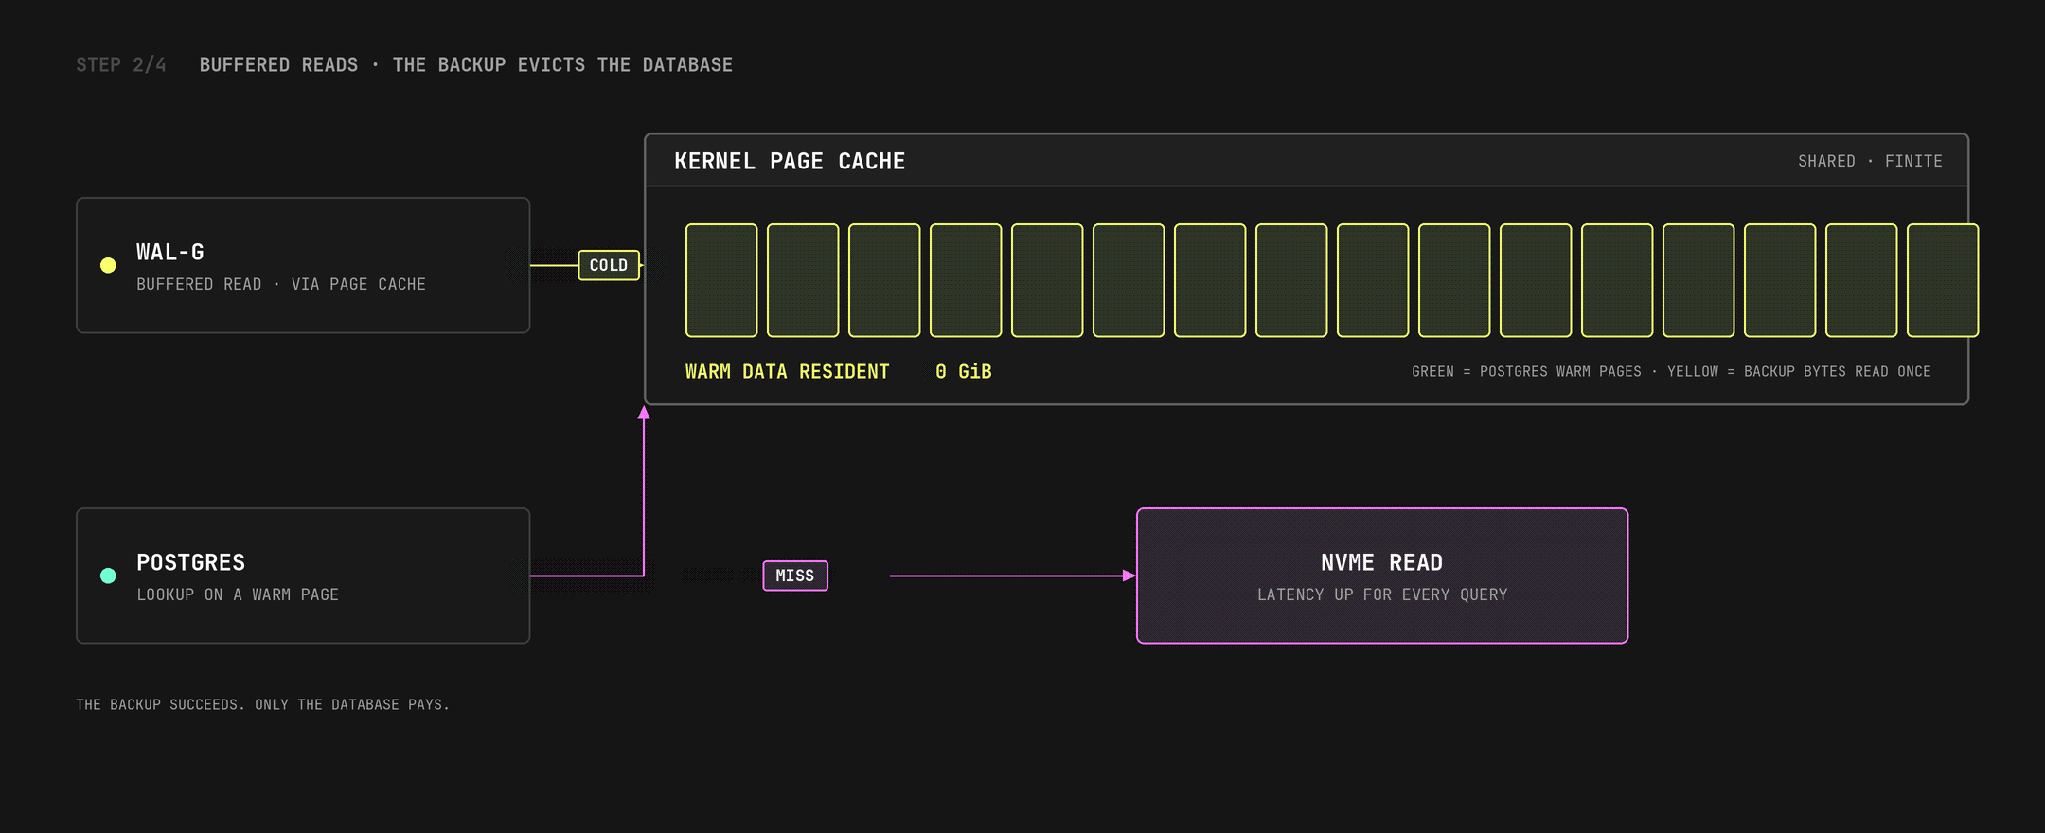
バッファ付きバックアップの読み取りは、誰も二度と読まないバイトデータでページキャッシュを埋め尽くします。それらによって置き換えられたページは、データベースに属していたものです。
カーネルは最も高頻度でアクセスされるページを保護します。絶えずアクセスされているデータはアクティブリストに残り、ストリーミング読み取りが行われても残存するため、アクセスの多いテーブルの最もホットな数 GB は通常そのまま維持されます。しかし、その時点でウォームかつアイドル状態だったものはすべて失われます。1 時間前にレポートでクエリされたテーブル、夜間ジョブが必要とするインデックス、スタンバイがまもなく要求する WAL セグメントなどです。検証環境のサーバーでは、バッファ付きバックアップにより、バックアップ実行の数分前にメモリへ読み込まれ、実行中はアイドル状態だった 40 GiB のテーブルがすべて追い出されてしまいました。
さらに、最もホットなページにさえ影響する、もう 1 つの小さなコストが存在します。バックアッププロセスが参照する前に、すべてのバッファ付きバイトがクエリと同じ CPU とメモリバスを使い、カーネルを経由してページキャッシュへとコピーされます。どちらのコストも見過ごされがちです。バックアップは完了し、アップロードされ、バックアップ一覧に表示されます。しかしその裏でクエリは遅くなり、次のレポート実行はコールドな状態で行われることになります。
改善の試み: ダイレクト I/O でキャッシュをスキップする
ダイレクト I/O は、カーネルにキャッシュを行わないよう指示しながらファイルを読み取る方法です。プロセスは O_DIRECT フラグを指定してファイルをオープンし、データはブロックデバイスからプロセスの独自バッファへと直接転送されます。ページキャッシュにコピーが残ることはありません。wal-g の設定では、これは 1 行で済みます。
WALG_DIRECT_IO=trueこれを設定すると、バックアップの読み取りはページキャッシュを完全にバイパスし、Postgres はウォームなページを維持できます。これによりエビクションの問題は解決しますが、新たな問題が生じます。ダイレクト I/O ではカーネルの先読みも失われる点です。バッファ付き I/O では、プロセスがファイルをシーケンシャルに読み取るとカーネルがそれを検知し、大きなチャンク単位で先読みを行ってデバイスキューを常に満たします。一方、O_DIRECT では、プロセスは要求したバイト数のみを取得し、それ以上は取得しません。
ドライブが 1 台であれば、これは対処可能です。しかし、RAID0 ストライプではスループットが急落します。RAID0 はデータをチャンク(検証環境のアレイでは 512 KiB)に分割し、連続するチャンクを構成ドライブ群に分散配置します。小さな O_DIRECT 読み取りは 1 つのチャンク内に収まり、それは 1 台のドライブ上にしか存在しません。そのリクエストの間、他のドライブはアイドル状態になります。リクエストをまとめる先読みがなければ、小さなダイレクト読み取りを発行するバックアップは、4 台の NVMe を搭載したサーバーであっても 1 台ずつしか駆動できません。
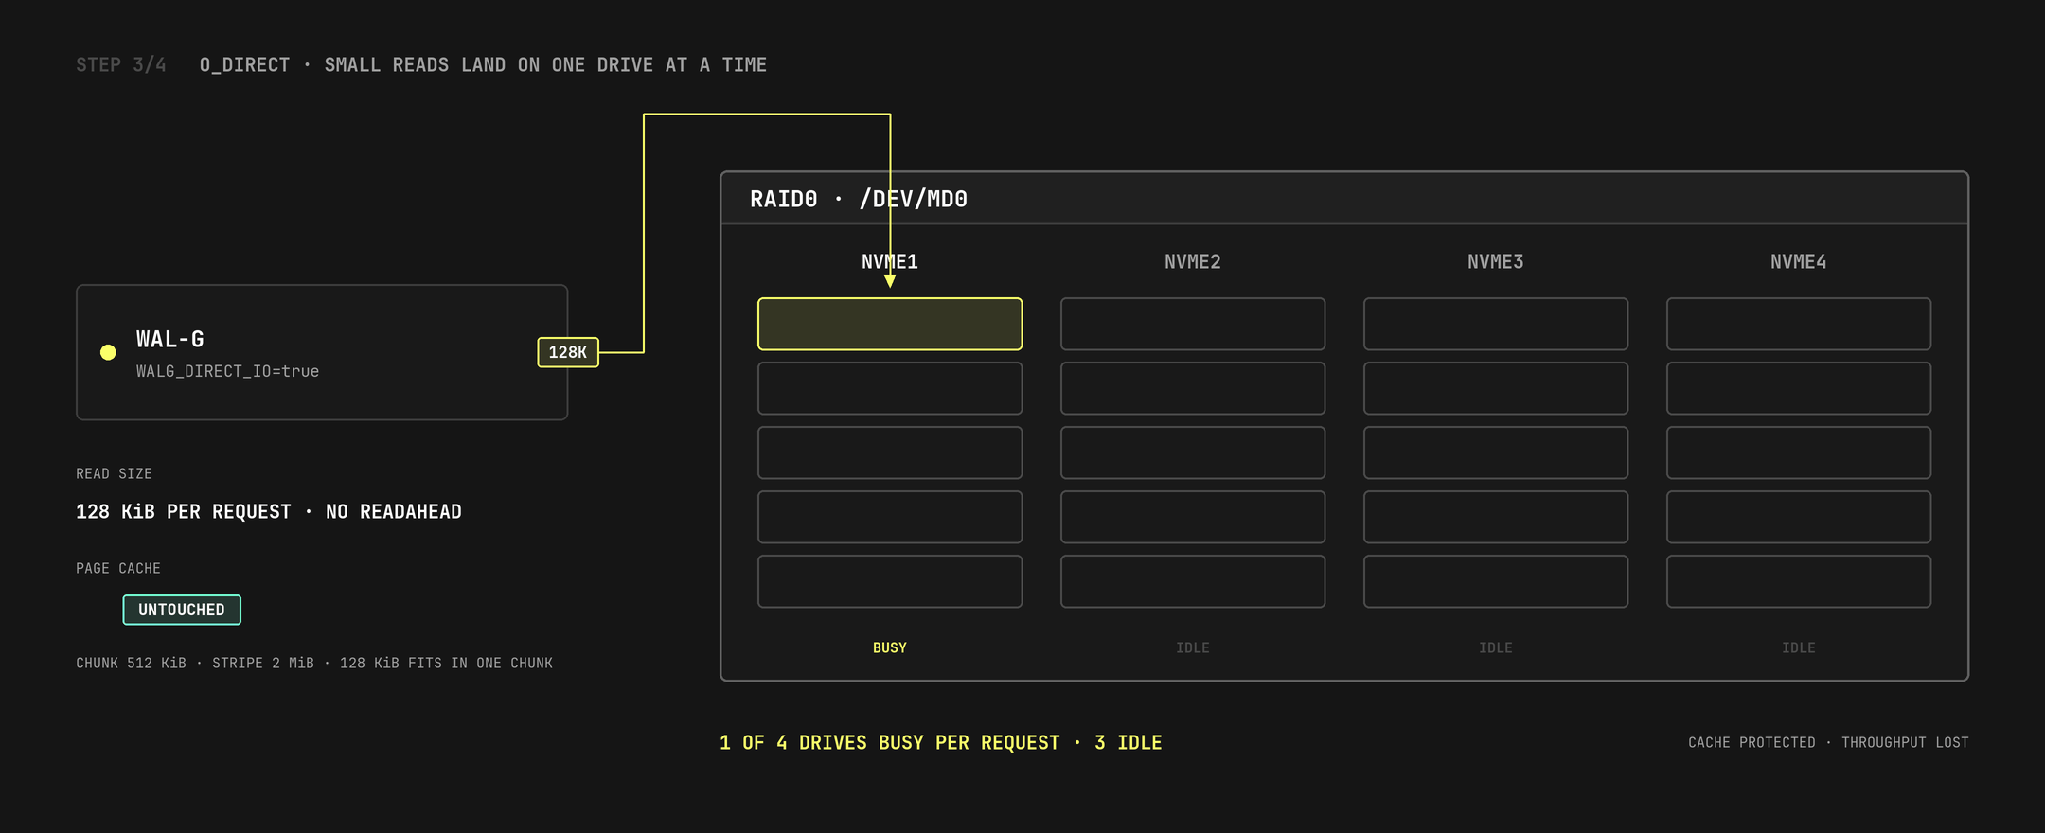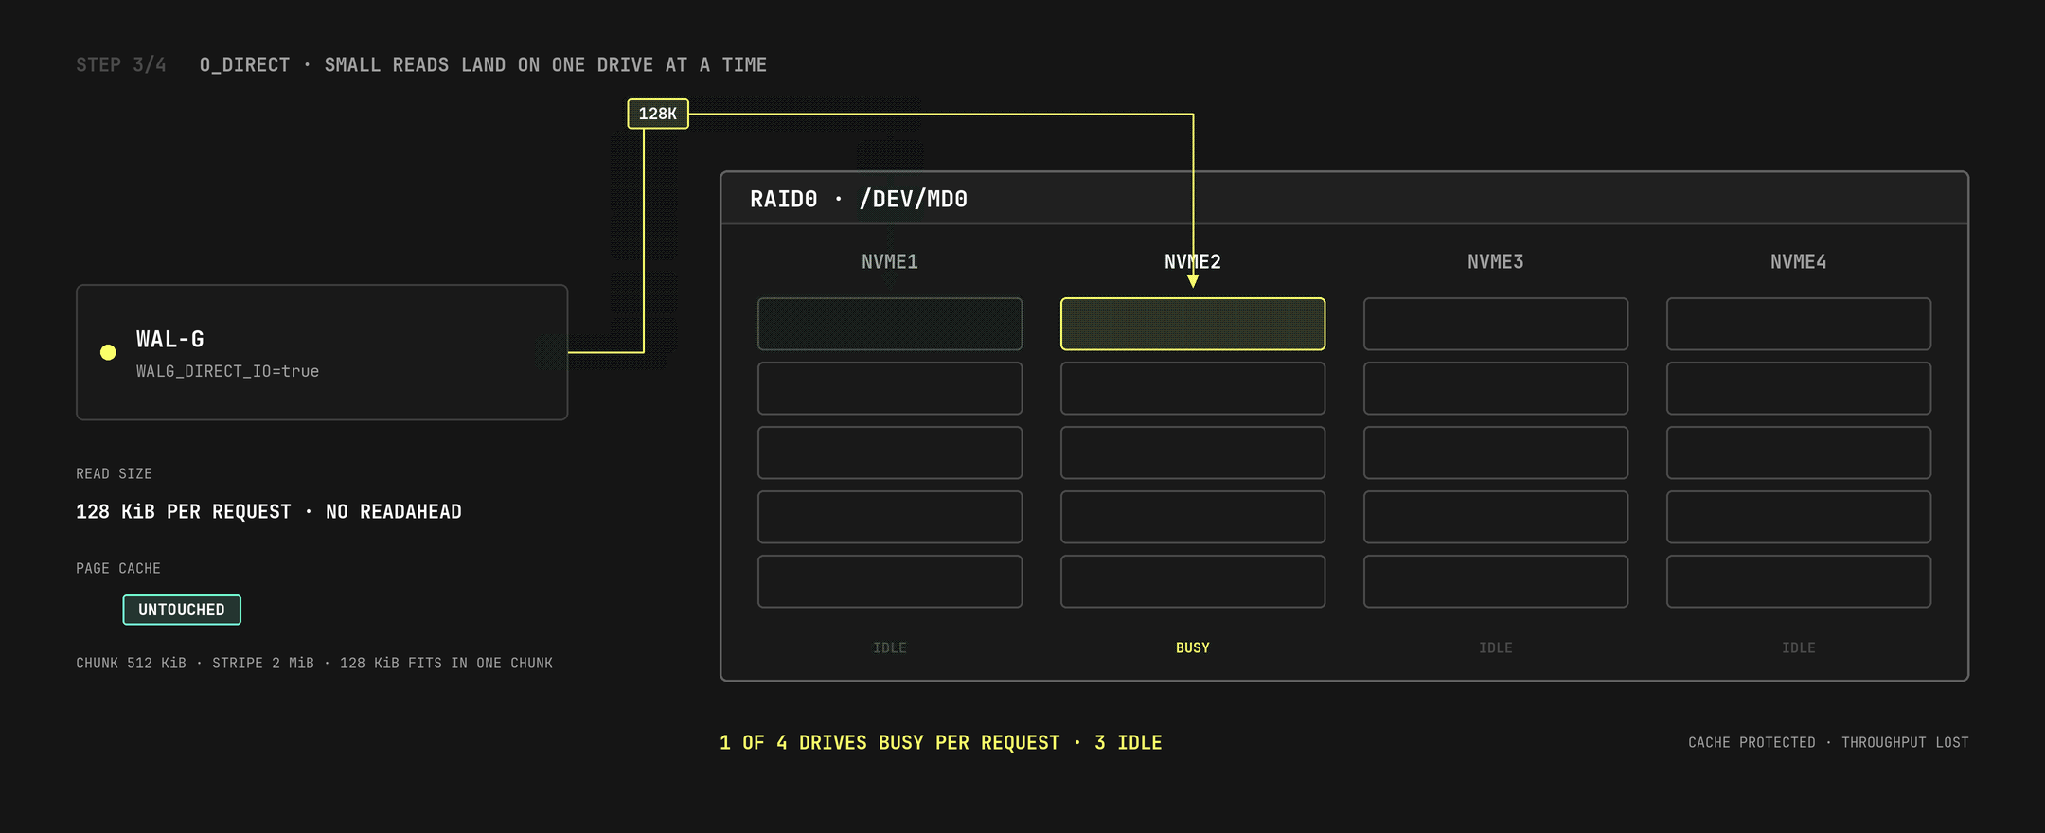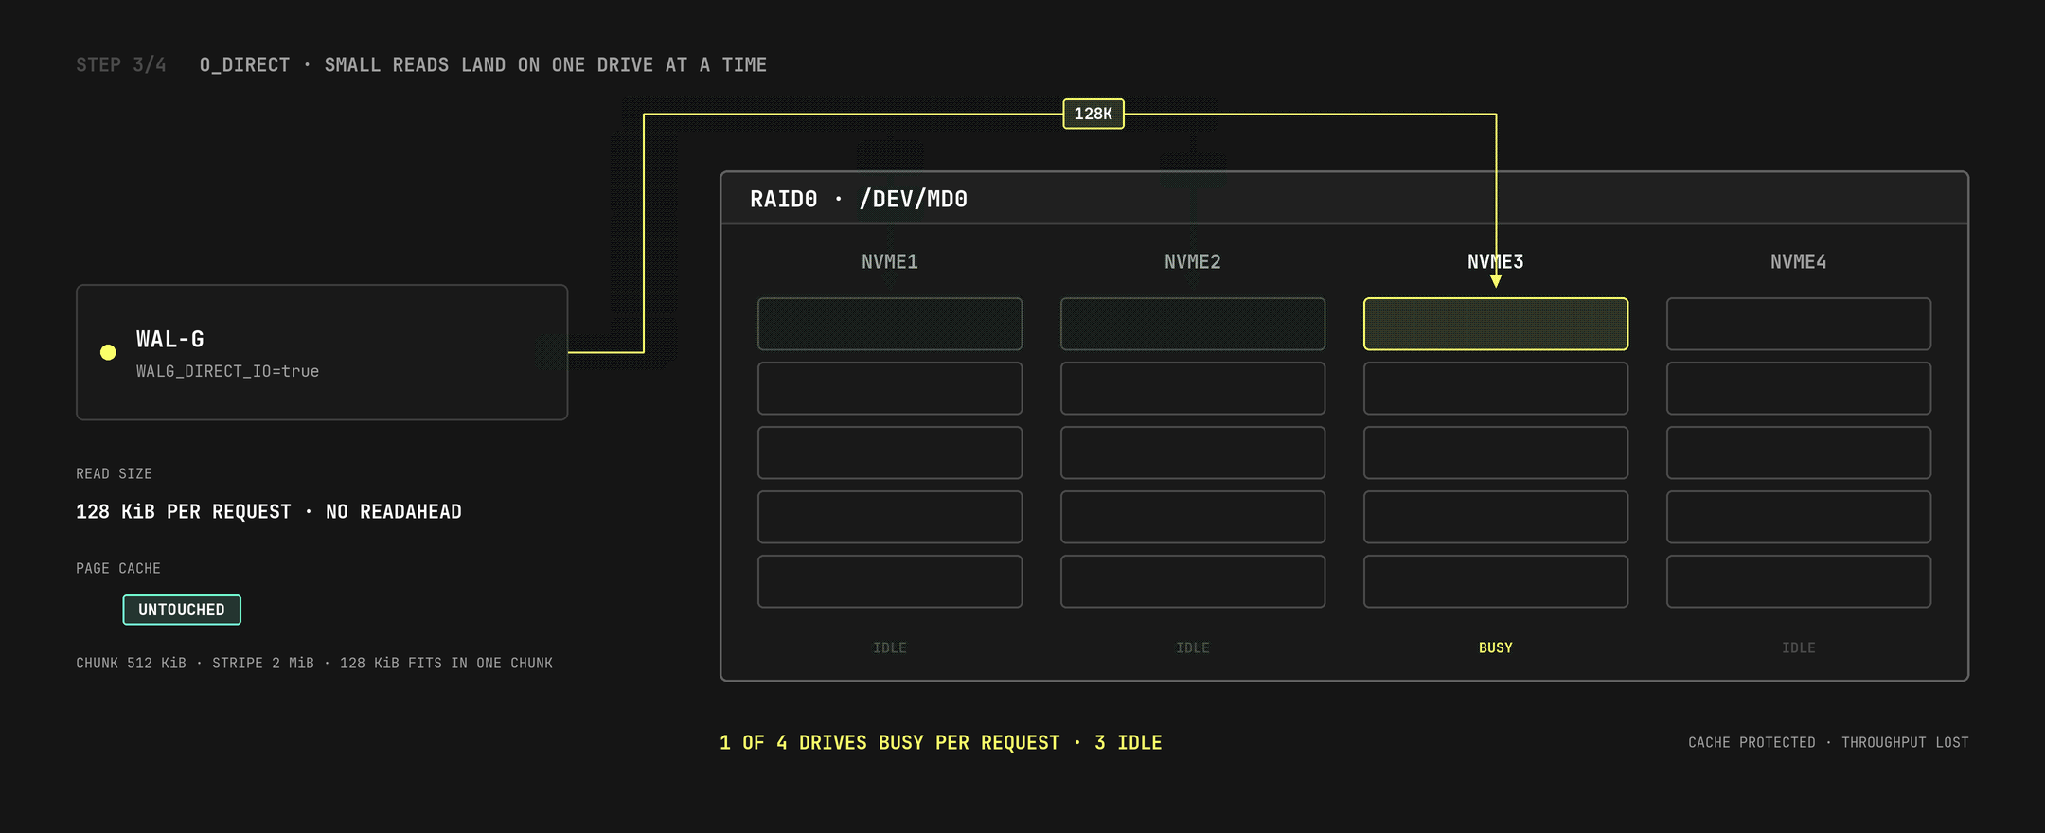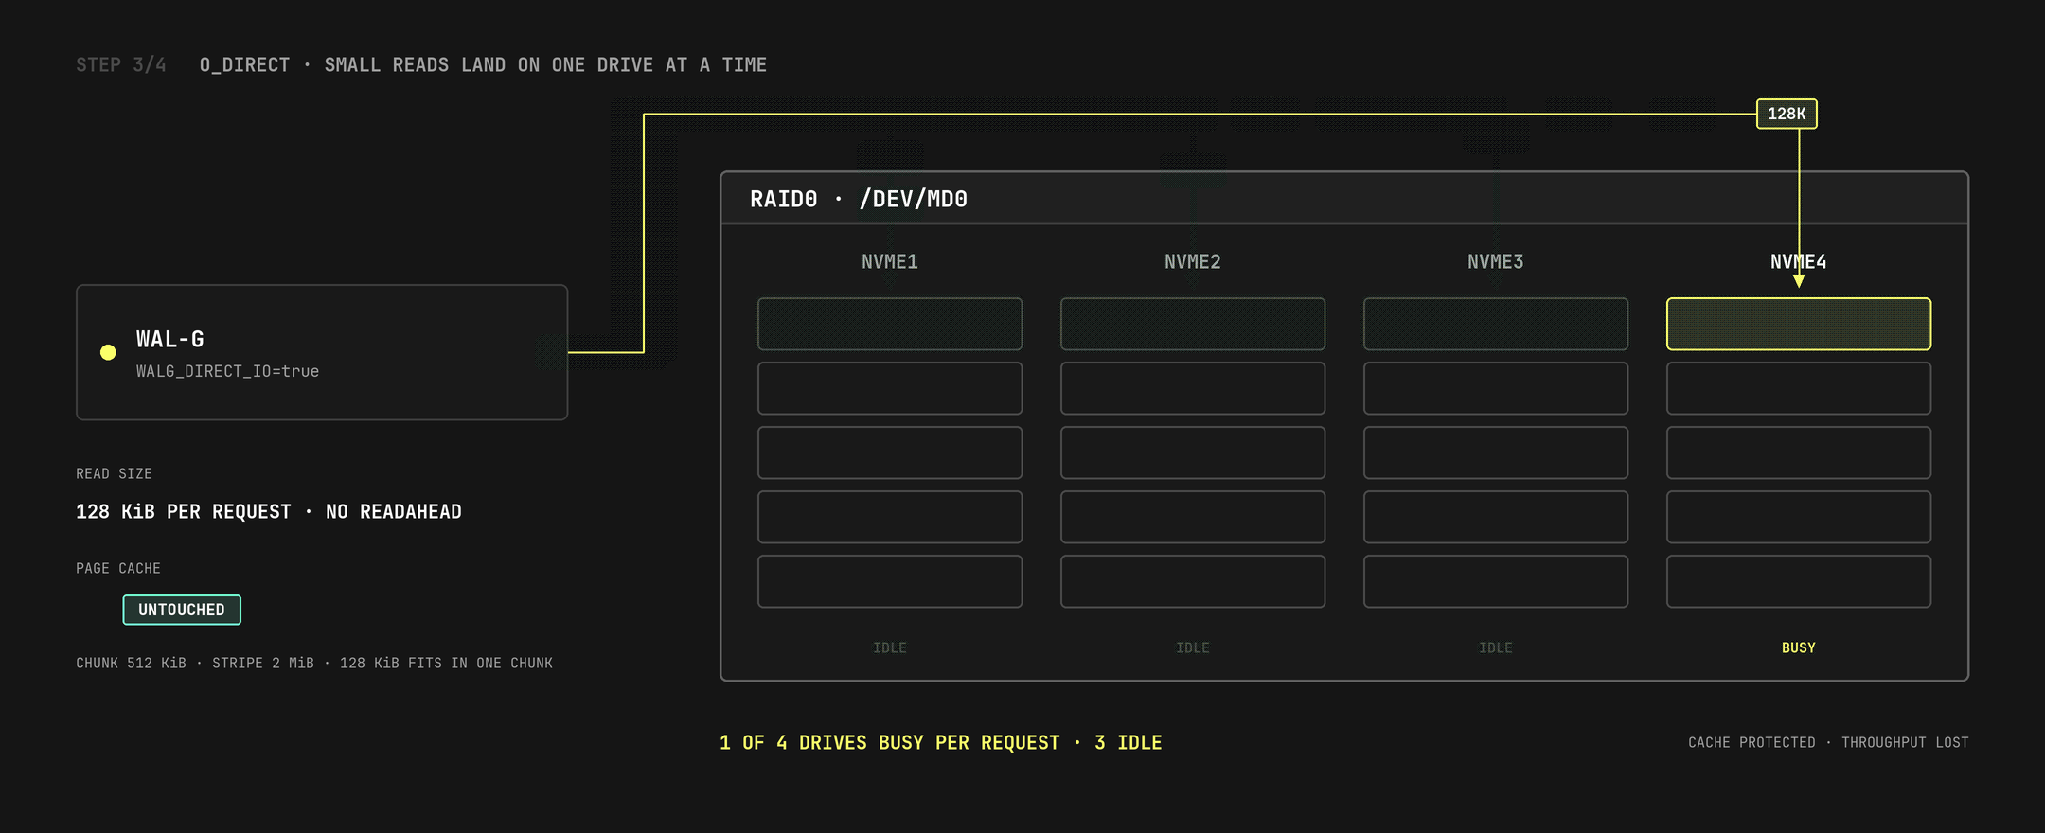
wal-g のデフォルトのダイレクト読み取りは、4 KiB が 32 ブロック、すなわち 128 KiB です。各リクエストは単一の 512 KiB チャンク内に収まるため、1 つのリクエストは 1 台のドライブにしかアクセスしません。
そのため、「ダイレクト I/O を有効にする」という最初のバージョンでは、ページキャッシュは保護されるものの、バックアップ自体が遅くなってしまいます。
ダイレクト I/O の読み取りサイズをストライプに合わせる
解決策は、各ダイレクト読み取りのサイズをストライプ全体に及ぶ十分な大きさにすることです。1 回の読み取りがすべての構成ドライブのチャンクを網羅していれば、すべてのドライブがその一部を処理することになり、アレイは本来の並列デバイスとして動作します。以下は、ClickHouse の設定ジェネレーターの該当部分です。
DIRECT_IO_BLOCKS_PER_DRIVE = 256
if direct_io
# RAID0 arrays attempt to evenly distribute the data blocks across the block devices.
# Therefore, larger block reads get fan out to more devices and produce higher throughput.
direct_io_block_count = direct_io_drive_count * DIRECT_IO_BLOCKS_PER_DRIVE
lines << "WALG_DIRECT_IO=true"
lines << "WALG_DIRECT_IO_BLOCK_COUNT=#{direct_io_block_count}"
endWALG_DIRECT_IO_BLOCK_COUNT は、wal-g がダイレクト I/O リクエストごとに読み取る 4 KiB ブロックの数です。構成ドライブ 1 台あたり 256 ブロック、つまりドライブごとに 1 MiB を割り当てます。
| RAID0 内のドライブ数 | WALG_DIRECT_IO_BLOCK_COUNT | 読み取りサイズ |
|---|---|---|
| 1 | 256 | 1 MiB |
| 4 | 1024 | 4 MiB |
| 8 | 2048 | 8 MiB |
ドライブ数は、サーバーのストレージデバイス一覧から動的に取得されます。AWS では、EBS ブートボリュームを除外した後にサーバーが検出したすべてのインスタンスストア NVMe が対象です。/dev/md0 内のドライブが 4 台の場合は 4 MiB の読み取りとなり、1 台の場合は 1 MiB となります。これより小さなサイズではリクエストごとにストライプの一部がアイドル状態になってしまうため、ダイレクト読み取りは少なくともアレイ幅以上のサイズにする必要があります。
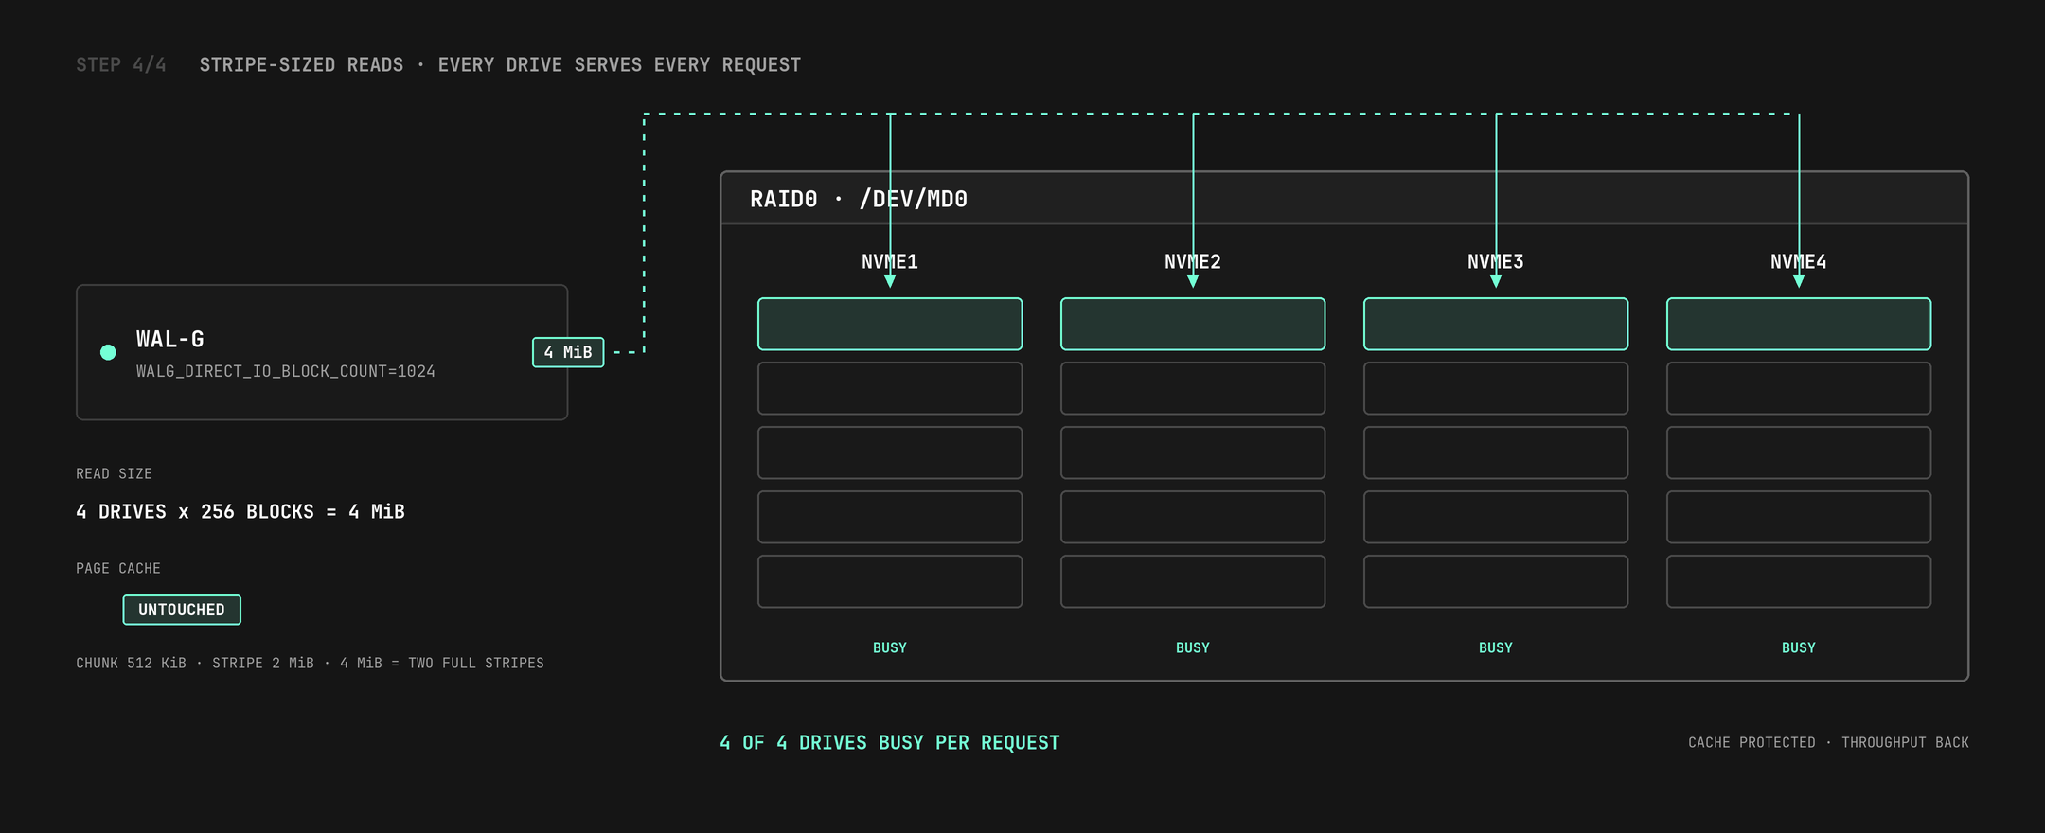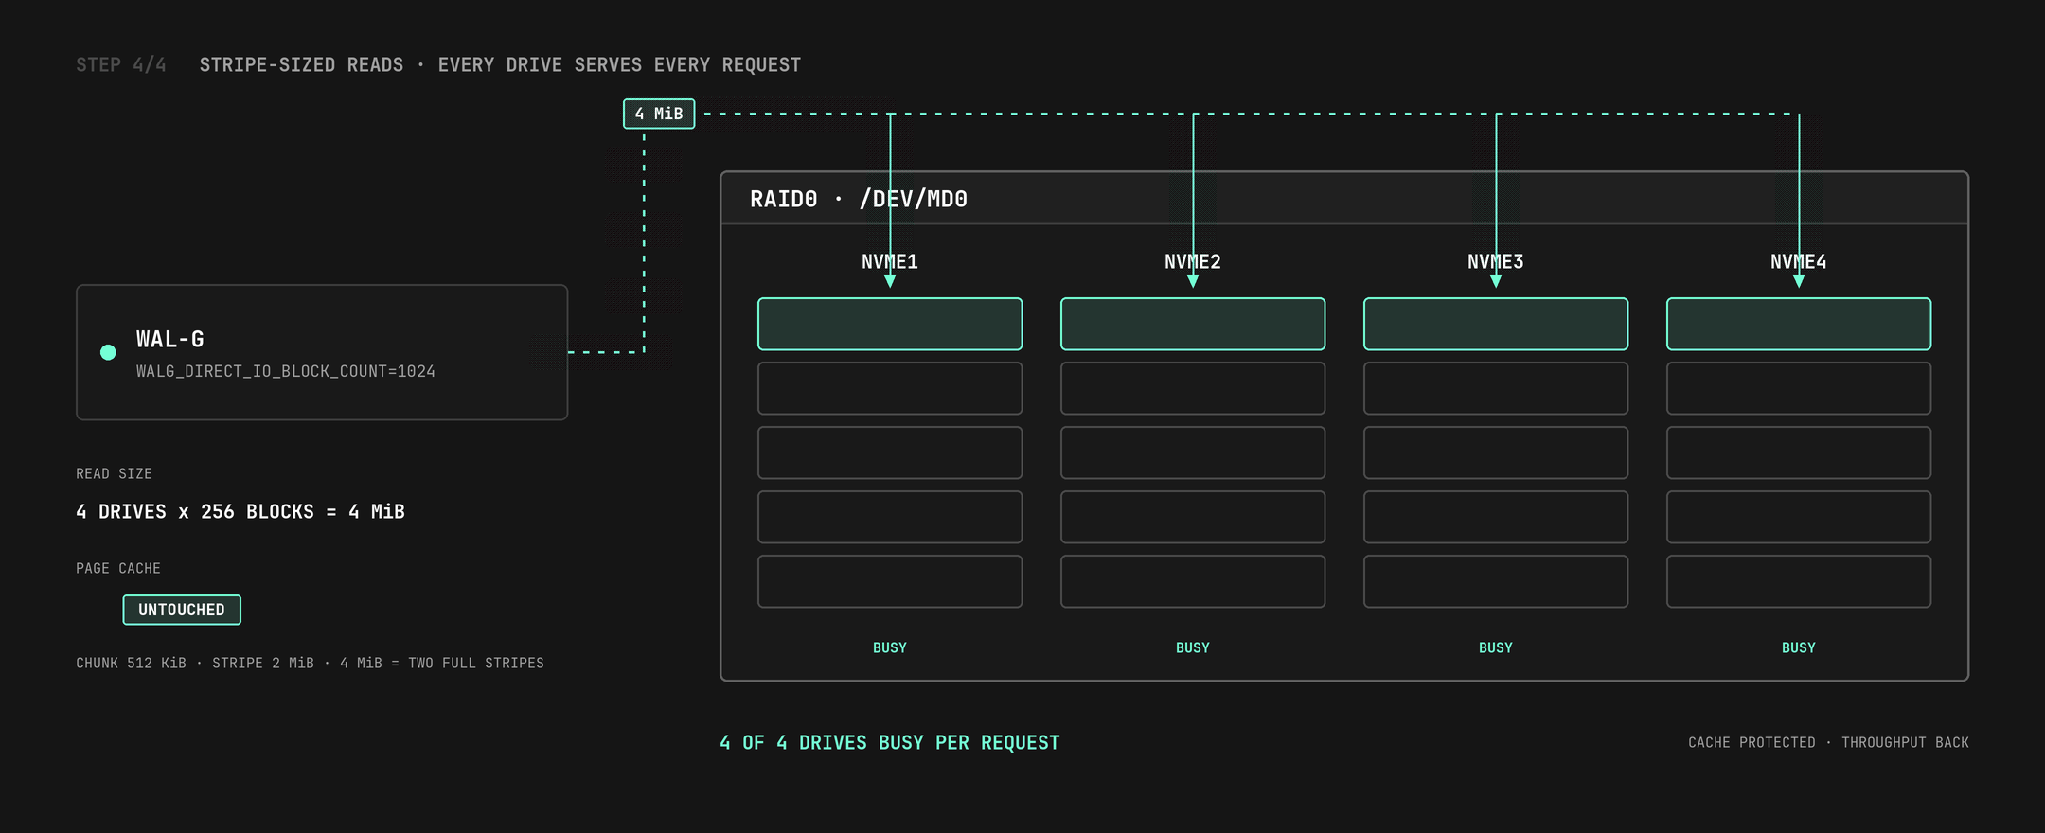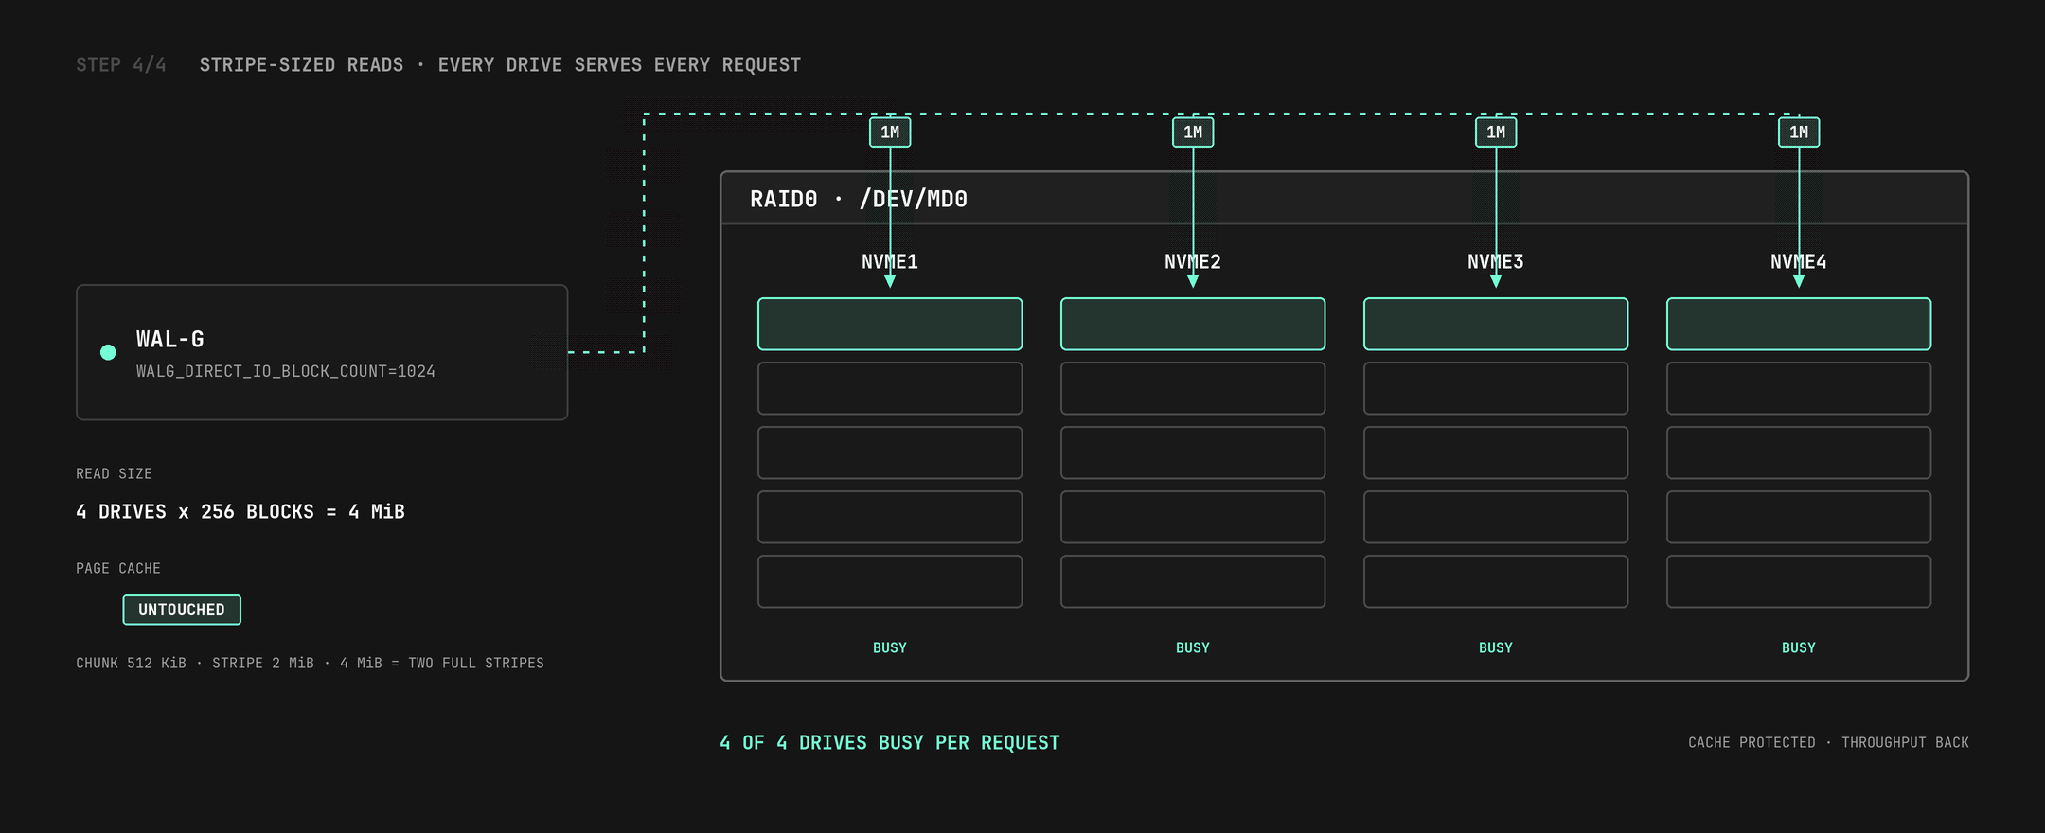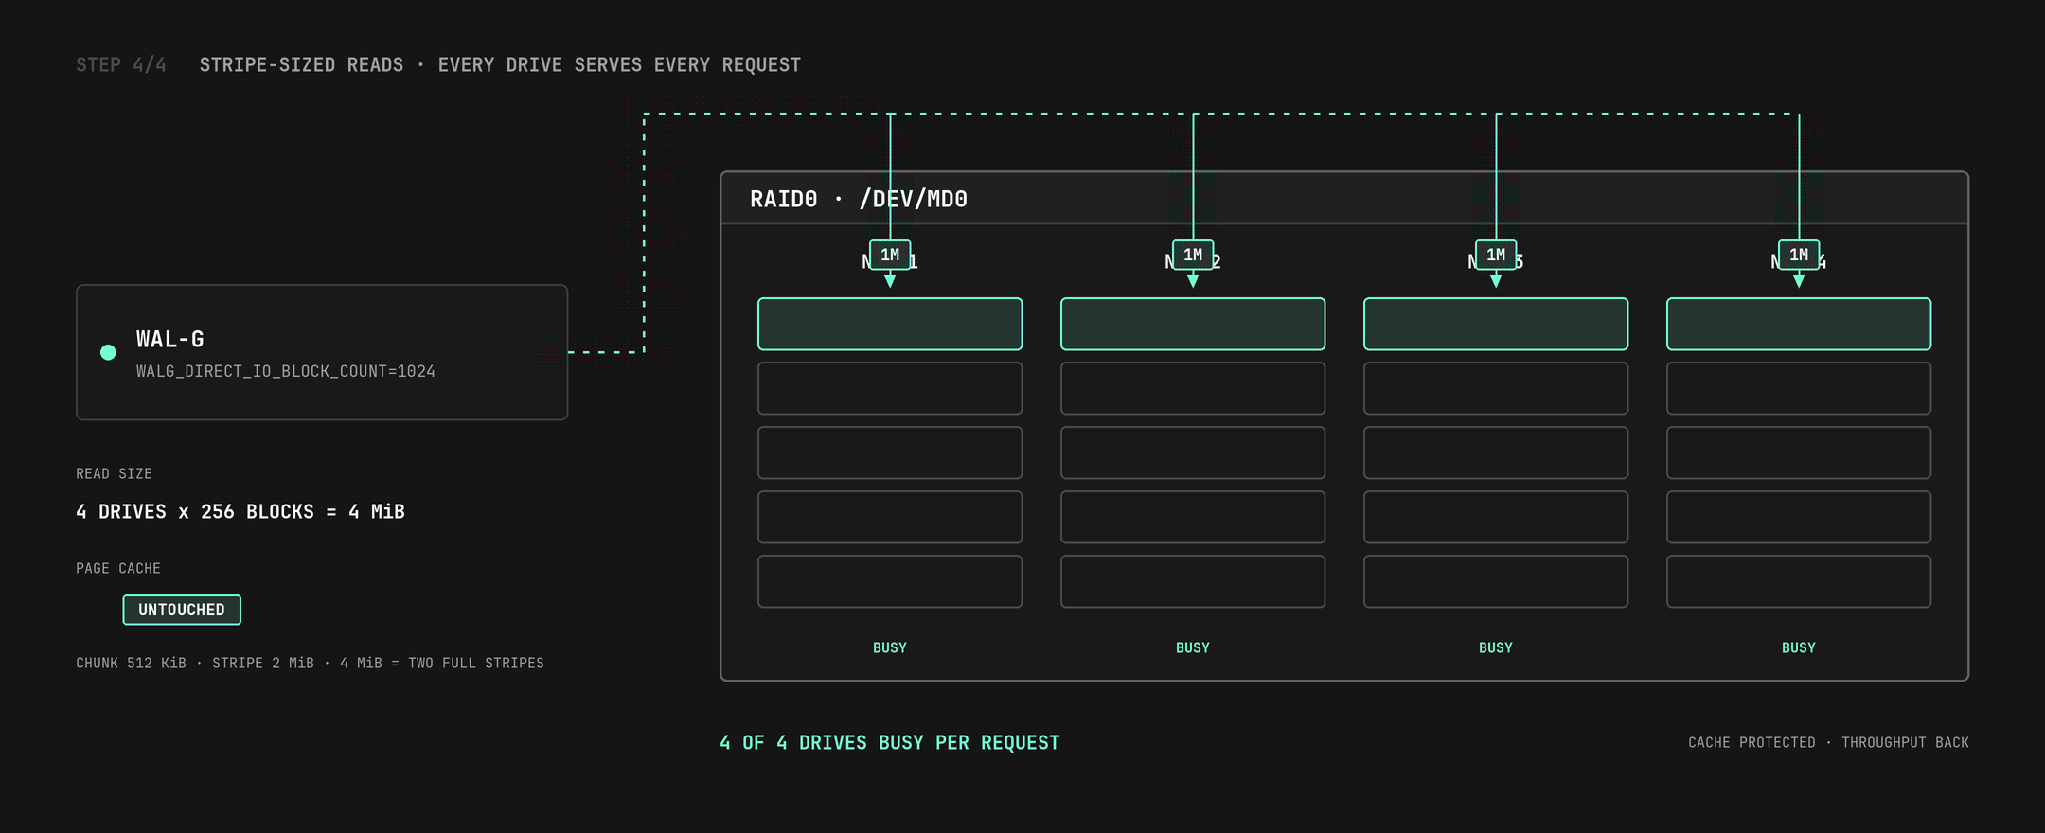
4 MiB の読み取りは 2 つのフルストライプをカバーするため、すべてのドライブがすべてのリクエストの一部を処理し、ページキャッシュも手つかずのまま維持されます。
並列リーダー: CPU 半分の割り当てが誤りとなるケース
読み取りサイズは調整項目の 1 つに過ぎません。もう 1 つの項目は、それらの読み取りを同時に発行するリーダーの数です。WALG_UPLOAD_DISK_CONCURRENCY は、wal-g のアップロードパイプラインにデータを供給する並列ディスクリーダーの数を制御します。適切な数値はボトルネックが CPU かデバイスかによって異なり、ダイレクト I/O はそのバランスを変化させます。
# WALG_UPLOAD_DISK_CONCURRENCY is CPU or Disk bound, hence different thresholds
disk_concurrency =
if direct_io
(dense_nvme || vcpu_count <= 2) ? vcpu_count : (vcpu_count / 2)
else
(vcpu_count / 2).clamp(1, 128)
endバッファ付き I/O では、vCPU の半分を使用します。カーネルに代わって先読みがデバイスをビジーに保つため、控えめなリーダー数で十分であり、残りの CPU は Postgres 用に残されます。ダイレクト I/O では先読みが行われません。各リーダーはリクエストを送信し、それを待ってから次のリクエストを送信するため、デバイスの使用率は処理中のリーダー数に直接依存します。これにより、次の二例で計算が変わります。
-
Dense NVMe ファミリー。 AWS において、ClickHouse では i8g、i8ge、i7i、および i7ie を Dense NVMe として扱います。これらはコンピュートに対して大容量のローカルストレージを搭載しており、各デバイスは多数の未処理リクエストがあって初めて上限に達します。これらにおけるダイレクト I/O では、vCPU 全数を使用します。
-
極小サーバー。 2 vCPU のサーバーでは、vCPU の半分にするとリーダーが 1 つになります。先読みのない同期的なダイレクトリーダーが 1 つだけではデバイスの大半がアイドル状態になってしまうため、2 vCPU 以下の環境でも全数を使用します。
それ以外の環境、すなわち 2 vCPU を超える一般的な NVMe インスタンスでは、リーダー数を vCPU の半分にするのが適切なトレードオフです。これを 2 倍にすると、バックアップスループットのわずかな向上に対して Postgres の CPU を犠牲にすることになります。処理中のリーダー数が増えるとバックアップは早く完了しますが、実行中にデバイスキュー内でデータベース自体の読み取りがより多くのバックアップリクエストの後ろで待たされることになります。後述の測定結果は、その両面を示しています。
48 vCPU、384 GiB RAM、インスタンスストア ドライブ 4 台の i8ge.12xlarge の場合、ジェネレーターは以下を出力します。
| キー | 値 | 理由 |
|---|---|---|
| WALG_COMPRESSION_METHOD | lz4 | CPU 負荷が低く、ヒープページに対して十分な圧縮率 |
WALG_UPLOAD_DISK_CONCURRENCY | 48 | ダイレクト I/O 下の Dense NVMe は vCPU 全数を使用 |
| WALG_UPLOAD_CONCURRENCY | 4 | 固定アップローダー数 |
| WALG_UPLOAD_QUEUE | 2 | 固定キュー深度 |
| WALG_S3_MAX_PART_SIZE | 67108864 (64 MiB) | RAM の 5% のバジェット、上限 64 MiB に制限 |
| WALG_DOWNLOAD_CONCURRENCY | 48 | リストアパス、コアあたり 1 ストリーム |
| WALG_DIRECT_IO | true | ページキャッシュをスキップ |
WALG_DIRECT_IO_BLOCK_COUNT | 1024 | 4 ドライブ x 256 ブロック、読み取りあたり 4 MiB |
ワークロードの保護: cgroups とダイレクト I/O の組み合わせ
バックアップは、CPU、メモリ、ドライブという 3 つのリソースをデータベースと奪い合います。ClickHouse ではそれぞれに境界を設けており、最後のドライブに対する境界となるのがダイレクト I/O です。
-
CPU。 バックアップは独自の cgroup 内で実行され、デフォルトの重み 100 に対し、systemd-run --scope を使用して CPUWeight=25 で起動されます。マシンがビジーなとき、スケジューラーはバックアップの 4 倍の CPU シェアを Postgres に割り当てます。アイドル状態のときは、バックアップは空いているリソースを使用できます。圧縮処理は負荷の高い部分ですが、lz4 を採用することで負荷を抑えています。
-
メモリ。 wal-g のアップロードバッファはマシンに応じてサイズ調整されます。処理中のピークパート数にパートサイズを掛けた値は RAM の 5% に抑えられ、プロセスはプロセスバジェットに関する記事で説明した他のサポートサービスと同じ制限付きスライス内に配置されます。
-
ページキャッシュとドライブ。 ダイレクト I/O を使用します。バックアップの読み取りがページキャッシュに入ることはないため、Postgres がそこに配置したデータは維持され、コンプレッサーに送られる過程でカーネルを経由してコピーされることもありません。
CPU の削減効果は測定可能です。後述の検証では、サーバー全体の CPU 使用率は、バッファ付きバックアップ実行中に 36% から 65% に上昇したのに対し、ストライプサイズに合わせたダイレクト I/O バックアップでは 60% に抑えられました。処理量は約 1,000 コア秒に対して約 860 コア秒であり、同一のバックアップで CPU が約 14% 削減されました。
実機ハードウェアでの検証
稼働中の実機でこれを検証しました。us-east-1 の i8ge.12xlarge、512 KiB チャンクの RAID0 で構成されたインスタンスストア NVMe ドライブ 4 台、shared_buffers = 96GB の Postgres 18.6、アップストリームの wal-g v3.0.9、そしてマシンの RAM(384 GiB)を超える 467 GB の pgbench データベースを使用しています。バックアップは同じリージョンの S3 にアップロードされ、lz4 で約 9 倍に圧縮されます。
実際のワークロードを模倣するため、2 種類の負荷を用意しました。16 クライアントがテスト実行全体を通じて accounts テーブルの 4 分の 1 に対してポイントルックアップを実行します。これは shared_buffers を超えるワーキングセットであるため、各ルックアップの一部は OS のページキャッシュから提供されます。また、実行前に別の 40 GiB テーブルをページキャッシュに読み込んでそのまま放置し、数分前にウォームだったデータを模倣します。fincore を使用して、そのうちのどれだけがメモリ上に残っているかを報告します。
各テストパターン(Arm)は同じ状態から開始します。キャッシュを破棄し、Postgres を再起動し、アイドルテーブルとホットインデックスの範囲をページキャッシュに読み込み、shared_buffers を満たすために 5 分間のワークロードを実行します。その後、ベースラインとして 3 分間測定し、バックアップを実行し、さらにその後の 3 分間を測定します。バックアップは本番環境と同様に、すべての Arm で CPUWeight=25 のもとで実行されます。変更されるのは wal-g の読み取りパスのみです。
| Arm | wal-g の設定 |
|---|---|
| A, バッファ付き | ページキャッシュ読み取り、ディスクリーダー 24(vCPU/2)、ダイレクト I/O 導入前の構成 |
| B, ダイレクト I/O デフォルト | WALG_DIRECT_IO=true、wal-g デフォルトの 32 ブロック(128 KiB)読み取り、リーダー 24 |
| C, 本番構成パラメータ | WALG_DIRECT_IO=true、WALG_DIRECT_IO_BLOCK_COUNT=1024(4 MiB)、リーダー 48(Dense NVMe ルール) |
| D, ストライプサイズ・リーダー少数 | C と同様だがリーダー 24(非 Dense ルール)、読み取りサイズとリーダー数を切り分けて評価 |
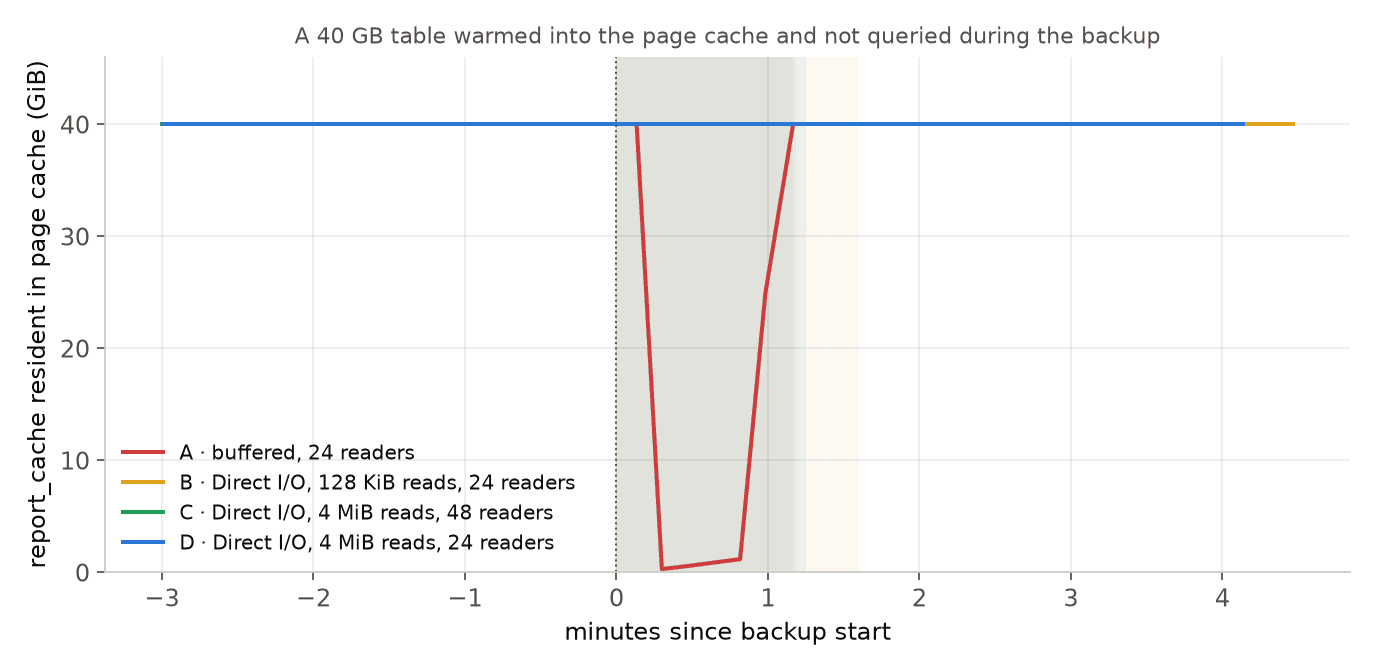
バックアップ開始の瞬間に合わせた、ウォームかつアイドル状態のテーブルの推移。バッファ付き読み取りでは、バックアップ開始から 20 秒以内にテーブルがメモリから完全に消失します。終盤に再び現れるのは、バックアップ自身が 1 分後にそれらのファイルを読み取るためであり、それらのコピーはカーネルの使い捨て(use-once)リストに置かれ、真っ先に再びエビクトされる対象となります。3 つのダイレクト I/O Arm では、このテーブルに一切手が触れられません。
エビクションは完全かつ高速に起こります。バッファ付きバックアップが始まって 20 秒で、40 GiB のテーブルのうちメモリに残っていたのはわずか 0.3 GiB でした。ワークロードが集中的にアクセスしていたページは、カーネルが最も高頻度なページを保持するため比較的良好な状態を保ちました。それでも、バッファ付きバックアップ完了後もワークロードはベースラインの 4 倍の速度でディスクから読み取りを続けており、キャッシュが再び満たされるまでの 2 分半にわたり、p99 は 3 倍高い状態が続きました。ダイレクト I/O の各 Arm では、アイドルテーブルは一貫して 40 GiB のまま維持され、バックアップが終了した瞬間にレイテンシはベースラインへと戻ります。
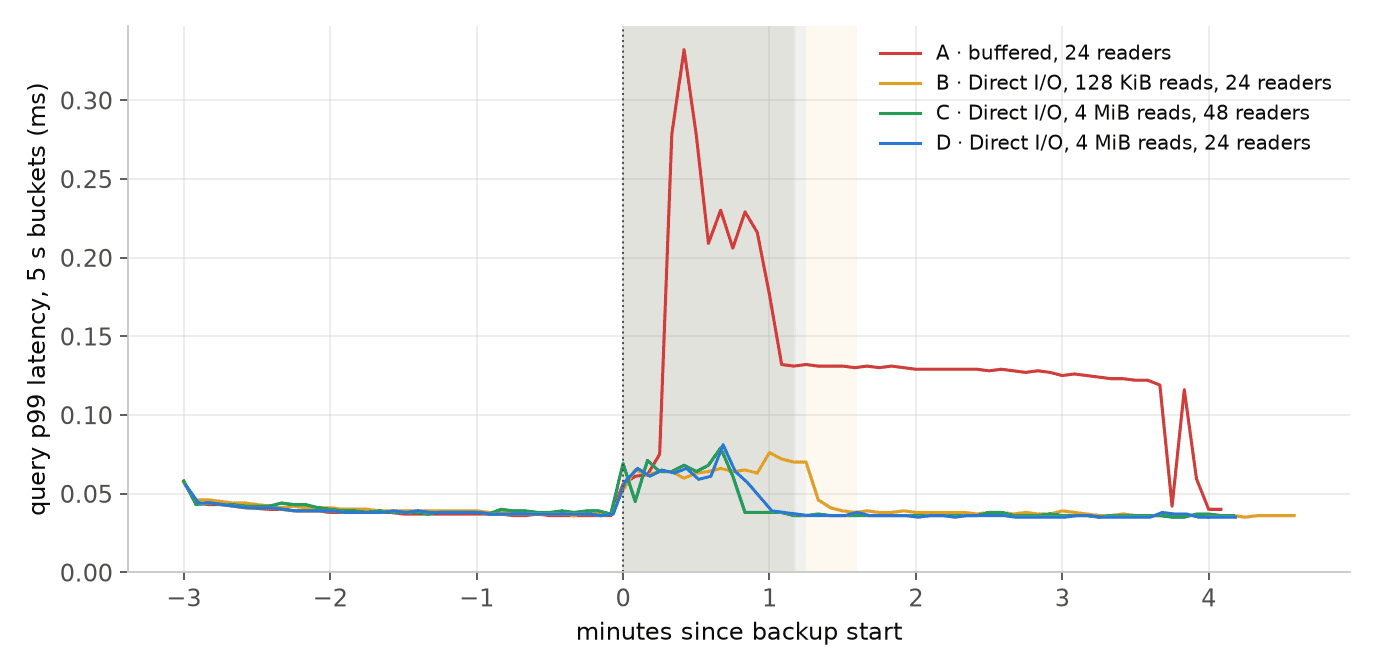
5 秒刻みのバケットにおけるポイントルックアップの p99 レイテンシ。バッファ付きバックアップでは p99 が 0.04 ms からピーク時の 0.33 ms まで跳ね上がり、終了後も数分間にわたって 0.13 ms にとどまります。ダイレクト I/O バックアップでは実行中も 0.06 ms 付近に抑えられ、終了後は即座に元に戻ります。
どのようなバックアップであっても、同じドライブから読み取り、同じ CPU で圧縮を行う以上、実行中はデータベースに一定の負荷をかけます。バッファ付き読み取りでは、バックアップ中の p99 がベースラインの 4.7 倍に達し、その後もコールド読み取りの長いテールが残りました。ダイレクト I/O 読み取りではベースラインの 1.5 倍に抑えられ、終了後に影響を残しませんでした。また、バッファ付きの Arm はより多くの CPU を消費したため(使用率 60% に対し 65%)、レイテンシの悪化はページキャッシュの頻繁な入れ替わりと、それに伴うコールド読み取りに起因しています。
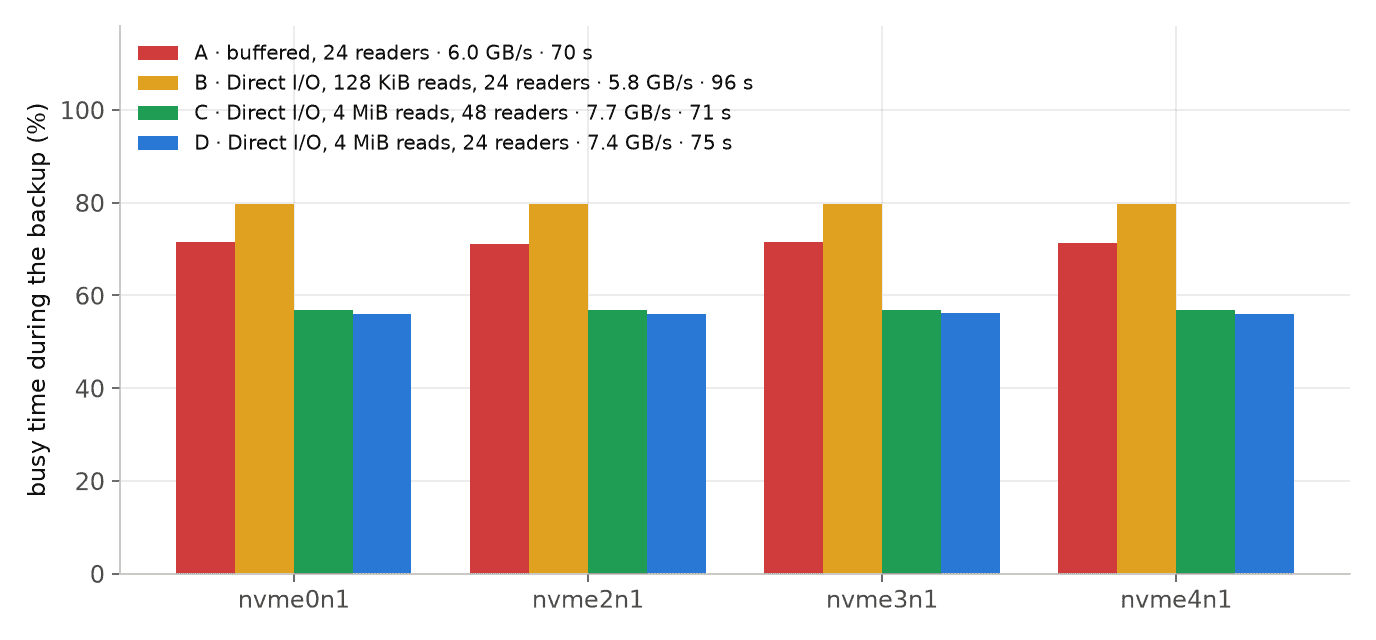
バックアップ期間中における 4 台の NVMe ドライブそれぞれのビジー率、ならびに Arm ごとのアレイ読み取り速度と実時間(wall time)。小さなダイレクト読み取りでは、転送データ量が最も少ないにもかかわらずドライブが最もビジーになります。ストライプサイズに合わせた読み取りではビジー時間あたりのデータ転送量が増えるため、アレイがデータベース用に残せるヘッドルーム(余力)が大きくなります。
24 のリーダーが稼働している場合、128 KiB のダイレクト読み取りであっても 4 台すべてのドライブがビジー状態を維持します。上の図に示した単一ドライブの挙動は、1 つのリーダーから見た挙動です。小さな読み取りのコストは効率の面で現れます。小さな読み取りの Arm ではビジー率 80% で 5.8 GB/s を転送するのに対し、4 MiB の各 Arm ではビジー率 56% で 7.4 〜 7.7 GB/s を転送します。リクエストの数を減らしサイズを大きくすることで、各ドライブの性能をより引き出し、クエリのために割ける空き時間をより多く確保できます。バックアップの所要時間は、デフォルトの読み取りで 96 秒、ストライプサイズ読み取りと 48 リーダーで 71 秒、24 リーダーで 75 秒でした。このサーバーでは読み取りサイズが効果の大半を占めており、Dense NVMe ルールはキュー内のリーダーをわずかに増やすことで、バックアップ時間を数秒短縮しています。
| Arm | バックアップ実時間 | ディスクからの読み取り | エビクトされたアイドルテーブル | バックアップ中のクエリ数/秒 | バックアップ中のクエリ p99 |
|---|---|---|---|---|---|
| A, バッファ付き | 70 秒 | 6.0 GB/s | 40 GiB | 469k | 0.18 ms |
| B, ダイレクト I/O デフォルト | 96 秒 | 5.8 GB/s | 0 GiB | 542k | 0.06 ms |
| C, 本番構成パラメータ | 71 秒 | 7.7 GB/s | 0 GiB | 544k | 0.06 ms |
| D, ストライプサイズ、24 リーダー | 75 秒 | 7.4 GB/s | 0 GiB | 555k | 0.06 ms |
| バックアップ未実行 | 581k | 0.04 ms |
ストライプ効果単体での検証
上記の各 Arm は、読み取りの背後で圧縮とアップロードが行われる wal-g のパイプライン全体を実行しています。RAID0 のファンアウト単体の効果を確認するため、wal-g のダイレクト I/O リーダーが発行するのと同様の同期読み取りを用いて、読み取りサイズとリーダー数のみを変更しながらアレイに対して fio を実行しました。
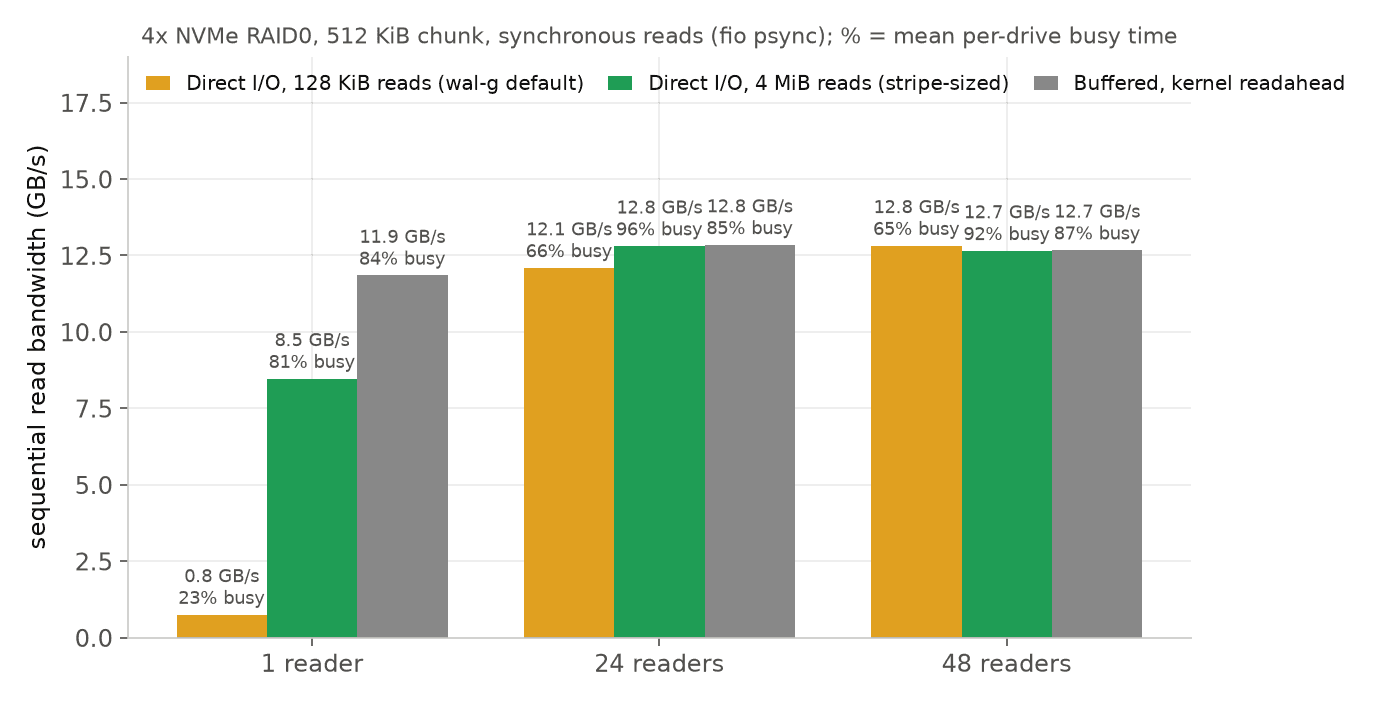
アレイからのシーケンシャル読み取り帯域幅。単一の 128 KiB ダイレクトリーダーでは 0.8 GB/s となり、各ドライブがビジーである時間は約 4 分の 1 です。同じリーダーが 4 MiB で実行されると 8.5 GB/s に達し、すべてのドライブが常にビジーになります。
1 つのリーダーによる結果は、図が示している通りの実態を表しています。128 KiB のダイレクト読み取りは一度に 1 台のドライブにしかアクセスせず 0.8 GB/s にとどまりますが、4 MiB の読み取りはストライプ全体にまたがり、同じドライブ群から 8.5 GB/s を引き出します。バッファ付き読み取りも最上位付近に位置しますが、これはカーネルの先読みがリクエストをまとめてくれるためです。24 または 48 のリーダーが処理中であれば、リクエスト数が大幅に増えてデバイスキューが混雑するという代償を伴いつつも、小さな読み取りであってもアレイを飽和させることができます。読み取りサイズを大きくすれば、控えめなリーダー数でも十分な性能を発揮できます。これこそが、リーダー数ルールが採用しているトレードオフです。
本番環境への適用
これらはすべてサーバーごとに自動生成されます。設定ジェネレーターは、サーバーの vCPU 数、メモリ、ドライブ数、および Dense NVMe ファミリーに該当するかどうかを取得し、その結果をバケットプレフィックスとともに /etc/postgresql/wal-g.env に書き込みます。バックアップおよびリストア用のツール群はこのファイルを読み込みます。
ダイレクト I/O のサポートは wal-g のリリースで導入され、wal-g を搭載したマシンイメージのローテーションに伴い、今年リリースされた他のバックアップ改善機能とともに全環境へ展開されました。新しいイメージから構築されたサーバーは、生成される設定内にダイレクト I/O の行が含まれます。バックアップのスケジュールとリストアパスに変更はありません。
緊急退避用の機能フラグ(feature flag)として、2 つのフラグが用意されています。1 つはダイレクト I/O の設定を無効化し、vCPU/2 リーダーによるバッファ付き読み取りへとフォールバックするフラグです。もう 1 つは、さらに wal-g のデフォルト設定へとフォールバックするフラグです。データベースにこれほど近接した読み取りパスにおいては、カーネル、ドライバー、またはインスタンスタイプが予期せぬ動作をした際に、迅速に元の動作へ戻せる手段を確保しておく必要があるため、双方が用意されています。
次のステップ: 変更分のみのバックアップ
上記の各テストはすべてフルバックアップです。直前のバックアップから 1 行しか変更されていなくても、10 億行が変更されていても、467 GB すべてを読み取り、54 GB の圧縮されたデータを出力してアップロードします。数テラバイト規模のデータベースにとって、これはバックアップ維持コストの中で最大の割合を占めます。現在、私たちは増分バックアップのプロトタイプを作成しています。データディレクトリを読み取って前回のバックアップ以降に変更されたページを見つけ、それらだけをアップロードすることで、1 日分のバックアップコストを 1 日分の変更サイズに抑える仕組みです。
本記事で解説した読み取りパスは、そのまま引き継がれます。増分バックアップでも、変更箇所を特定するために、クエリ処理と並行して同じドライブから稼働中のデータディレクトリを読み取ることに変わりはありません。ダイレクト I/O、ストライプサイズの読み取り、そして cgroup の重み付けにより、アップロード量が 54 GB であっても 500 MB であっても、データベースの処理に影響を与えることなく実行できます。
まとめ
バックアップにおいて最も困難な処理はローカルで発生します。Postgres が稼働しているまさにそのドライブから、稼働中のデータディレクトリの全バイトを読み取ることです。バッファ付き読み取りは、データベースのウォームページをページキャッシュから追い出してしまいます。ダイレクト I/O はキャッシュをバイパスしますが、先読みも行われないため、RAID0 上でのスループットが低下します。ドライブ数に合わせてスケールさせたストライプサイズの読み取りと、Dense NVMe を考慮したリーダー数によって、そのスループットを取り戻すことができました。
その結果、ページキャッシュを Postgres に完全に残し、アレイ内の全ドライブを効率的に稼働させ、従来のバッファ付きバックアップと同等の速さで完了するバックアップが実現しました。すべての ClickHouse Managed Postgres サーバーには、これがデフォルトで導入されています。Postgres をプロビジョニングして、その動作をぜひお確かめください: ClickHouse Managed Postgres
ClickHouse Managed Postgres を今すぐ始める
実際のデータで ClickHouse Managed Postgres の動作を試してみませんか?ClickHouse Cloud はわずか数分で利用開始でき、300 ドル分の無料クレジットも提供しています。
サインアップ