5万

WAL アーカイビングとは何でしょうか。そして、なぜデータベースの書き込みを意図的にスロットリングするのでしょうか。Postgres に対するすべての変更は、テーブルに反映される前に先行書き込みログ(WAL)に記録されます。ClickHouse Managed Postgres では、ポイントインタイムリカバリを可能にするため、完了した各 WAL セグメントをオブジェクトストレージにアップロードします。アップロードが成功するまで Postgres はセグメントを削除できないため、アーカイバーによる転送速度を上回るペースでワークロードが書き込みを行うと、WAL が蓄積されてディスク容量を圧迫します。Postgres では WAL ディスクの枯渇は PANIC 扱いとなり、インスタンスはダウンします。
データプレーンからのバックプレッシャー
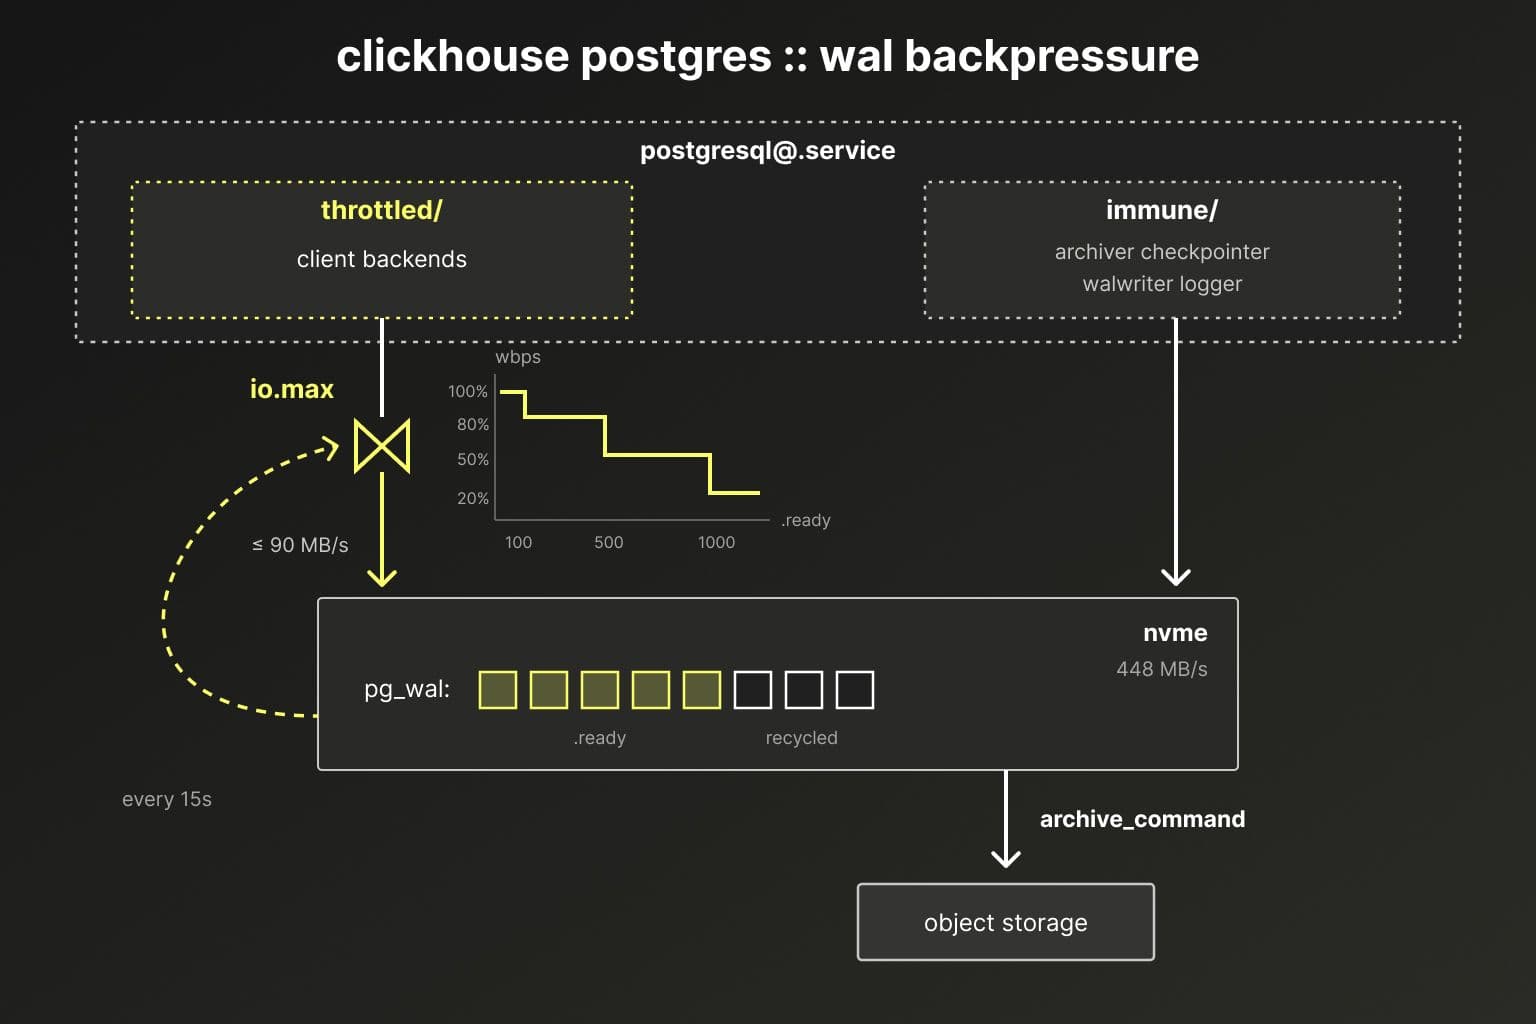
ClickHouse Managed Postgres はバックプレッシャーによってこれに対応します。systemd タイマーが保留中のセグメント数を 15 秒ごとにカウントし、cgroup v2 の I/O コントローラーを使って Postgres の書き込み帯域幅を制限します。この制限値はディスクにプロビジョニングされたスループットに対する割合として設定され、バックログが深くなるほど段階的に引き締められます。
| 保留中のセグメント数 | 書き込み上限 | 500 MB/s のディスクの場合 |
|---|---|---|
| 100 | ベースラインの 80% | 400 MB/s |
| 500 | ベースラインの 50% | 250 MB/s |
| 1,000 | ベースラインの 20% | 100 MB/s |
書き込みが減速すれば毎秒生成される WAL の量も減り、アーカイバーが遅れを取り戻せるようになります。この処理はすべてデータプレーン上で完結するため、コントロールプレーンがダウンしていたりアクセス不能になっていたりしても、データベースは自己防衛を継続できます。
回復処理までスロットリングしない
サービス全体に一律で上限を設けると、キューを消化するアーカイバー、古い WAL の削除を可能にするチェックポインタ、さらにはアーカイバーがログを出力するロガーといった「復旧に必要な処理」まで制限されてしまいます。そこで、このスロットリング機構は cgroup を 2 つに分割しています。各 Postgres プロセスはプロセスタイトルで自身の役割を明示しているため、ドレイン(排出)処理のパスは制限対象外のグループに、各クライアントバックエンドはスロットリング対象のグループにそれぞれ振り分けられます。制限が適用されるのはスロットリング対象のグループのみであり、読み取り処理が制限されることは一切ありません。
実際の動作を確認する
1 台の EC2 インスタンス上でこのメカニズムを実行し、意図的に遅延させたアーカイバーと競合させてみました。検証環境の構成は以下のとおりです。
- インスタンス: m7i.2xlarge (8 vCPU、32 GB)、Ubuntu 24.04、Postgres 16。
- データディスク: スロットリングのベースラインとなる 500 MB/s でプロビジョニングされた専用 gp3 ボリューム。各層の上限値はそれぞれ 400、250、100 MB/s になります。
- スロットラー: 本番環境のスロットルクラスをそのまま使用。15 秒間隔の systemd タイマーで実行し、Postgres ユニットで
Delegate=yesを設定してサブ cgroup を管理可能にしています。 - 遅延させたオブジェクトストア: 毎秒 4 分の 1 セグメントにあたる 4 MB/s にレート制限した
archive_command。開始 20 分後にこの制限を解除し、オブジェクトストレージが復旧した瞬間をシミュレートします。 - ワークロード: pgbench simple-update、48 クライアント、スケール 300、35 分間実行。
時系列での動作は以下のようになりました。
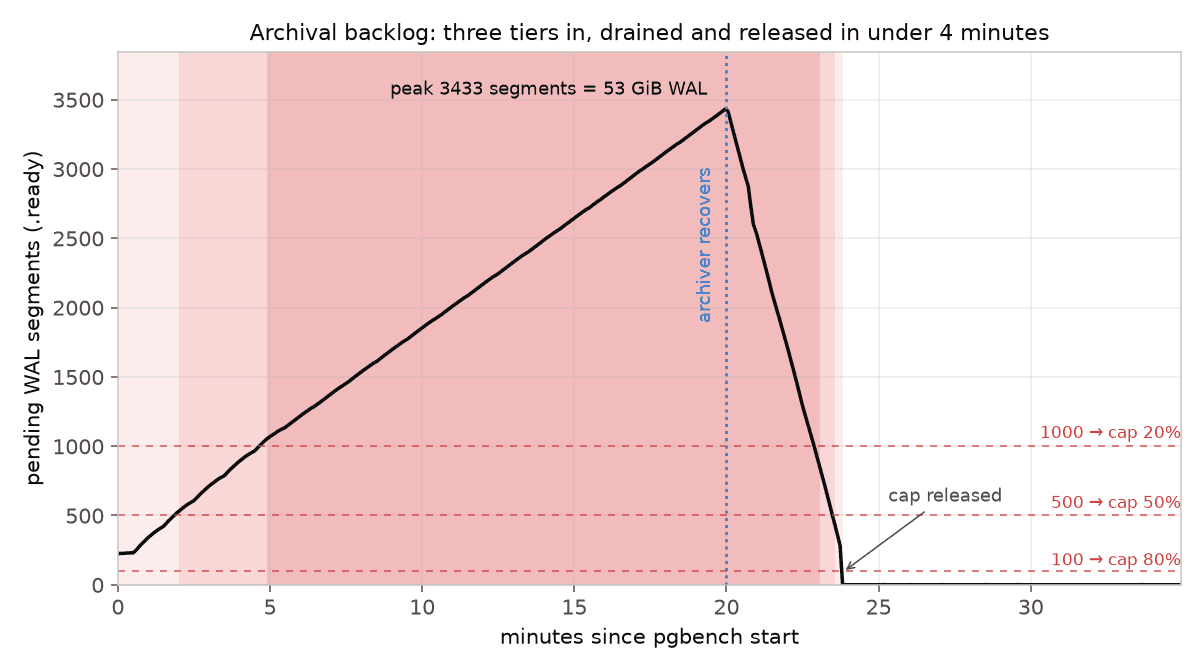
- ベンチマーク開始前: pgbench テーブルの一括ロードの時点でバックログはすでに 100 セグメントを超えており、t=0 の時点で 224 セグメントが保留中となって 80% の上限が適用されていました。一括ロードは、まさにアーカイブ処理が追いつかなくなる代表的なワークロードです。
- 1.9 分: バックログが 500 を超え、上限が 50% に低下。
- 4.7 分: バックログが 1,000 を超え、上限が 20% に低下。バックログは毎分約 170 セグメント(毎秒およそ 45 MB の WAL)のペースで増加していました。
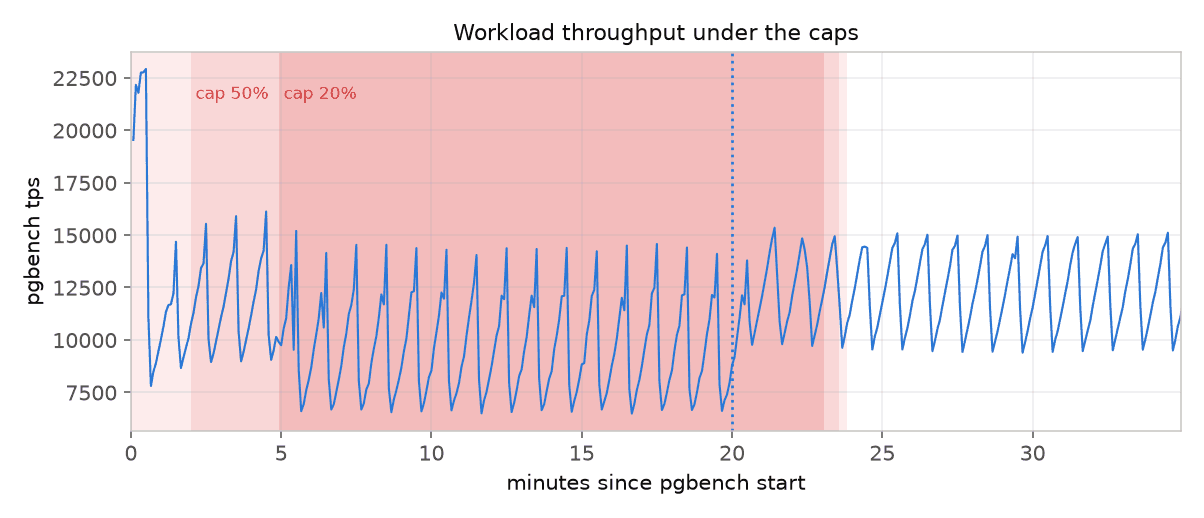
- 0〜20 分: pgbench のスループットは各層の適用に合わせて段階的に低下しました。開始時のバーストで 22,000 TPS、80% 上限下で 12,800 TPS、50% 下で 11,800 TPS、20% 下で 9,600 TPS となりました。
- 20 分: バックログがピーク(3,433 セグメント、保持された WAL は 53 GiB)に達したところで「オブジェクトストレージ」が復旧。
- 20〜23.7 分: ワークロードが上限付きで稼働し続ける中、制限を受けないアーカイバーがディスクの最高速度で毎分約 850 セグメントを消化。
- 23.8 分: バックログが 100 未満に回復。タイマーの次の実行サイクルでスロットリングが解除され、その直後にバックログはゼロになりました。pgbench はアーカイバーが追従できる 12,200 TPS で安定しました。
- 全期間を通じて: データディスクの使用率が 33% を超えることはなく、人手による介入も一切発生しませんでした。
プロセスの分類状況は cgroup ファイルシステムで確認できます。開始 10 分の時点で、制限対象外グループにはアーカイバーが起動した archive_command の子プロセスを含め、プロセスタイトルによってドレイン処理パスに該当するプロセスのみがきれいに集められています。48 個のクライアントバックエンドはスロットリング対象グループに配置され、設定された io.max から 20% の上限が書き込みのみに適用されていることが確認できます。
== immune ==
4679 /usr/lib/postgresql/16/bin/postgres -D /dat/16/data
4680 postgres: 16/main: checkpointer
4681 postgres: 16/main: background writer
4683 postgres: 16/main: walwriter
4685 postgres: 16/main: archiver archiving 00000001000000000000009E
8354 pv -q -L 4m pg_wal/00000001000000000000009E
== throttled ==
4684 postgres: 16/main: autovacuum launcher
4973 postgres: 16/main: postgres bench [local] COMMIT
4974 postgres: 16/main: postgres bench [local] COMMIT
... 46 more client backends ...
$ cat throttled/io.max
259:1 rbps=max wbps=104857600 riops=max wiops=maxこの検証における注意点として、このワークロードで書き出されるバイトデータはほぼすべてが WAL であり、コミットは影響を受けない WAL ライターを経由して行われるため、上限による制限は WAL の生成量よりもスループットに対してはるかに強くかかり、WAL の生成量は約 10% しか減少しませんでした。スロットリングによってディスク枯渇までの猶予時間が得られますが、その長さは書き込み処理がどれほどデータ中心であるかによって異なります。
まとめ
ワークロードを数分間低速化させることで、過剰な書き込みによってインスタンス自体がクラッシュする事態を確実に防げます。段階的な制限は設定された閾値で正確に作動し、ドレイン処理はインシデント全体を通じて最高速度で実行され、バックログが解消された瞬間に上限は自動的に解除されます。すべての ClickHouse Managed Postgres サーバーには、この機能がデフォルトで備わっています。
ClickHouse Managed Postgres を試す
ClickHouse と Postgres の組み合わせは、スケールするアプリケーション向けの統合データスタックとして定着しています。ClickHouse Cloud で Managed Postgres が利用可能になったことで、このスタックは最初から迷わず選べる構成となりました。
サインアップ