5万

Postgres サーバーの VM 上では他に何が稼働していて、それらがデータベースをダウンさせるのをどう防いでいるのでしょうか。私たちの環境では Postgres と並行して、複数の PgBouncer インスタンス、バックアップエージェント、メトリクスエクスポーター、ローカルの Prometheus、ログコレクター、そして少数のウォッチドッグタイマーが動作しています。各プロセスはデータベースを保護する役割を持っています。しかし同時に、メモリリークを起こしたり、CPU を消費し尽くしたり、ディスクを圧迫したりするリスクも孕んでいます。
そのため、これらすべてのプロセスがデータベースの障害モデルに含まれることになります。監視プロセスが Postgres に必要なメモリを使い果たすこともあれば、バックアップエージェントがクエリ処理に必要な CPU を飽和させることもあります。どちらの障害も、インスタンス全体を停止に追い込む可能性があります。
マシンを共有することは、メモリを共有すること
Postgres には、1つ非常に強固な境界が用意されています。shared_buffers の割り当ては起動時に確保される Huge Pages 上に置かれるため、他のプロセスが徐々に侵食していくことはできません。この割り当てを厳格にする理由については、Postgres 向け Huge Pages の確保に関する記事で説明しました。
一方で、Postgres は shared_buffers 以外のメモリも必要とします。カーネルのページキャッシュ、各バックエンドの作業メモリ、接続状態、その他数多くの細かなメモリ割り当ては、PgBouncer、WAL-G、Prometheus、各種エクスポーター、ログ収集が使用するのと同じマシン全体のプールから取得されます。それらのプロセスのいずれか1つでもリークを起こすと、すべてのデータベースバックエンドが依存しているヘッドルームを使い果たしてしまう可能性があります。
ClickHouse Managed Postgres では、サポートプロセスに対して明示的なリソース制限を設定しています。Prometheus、WAL-G バックアップエージェント、postgres_exporter、node_exporter の 4 つの Go サービスは、単一の cgroup v2 スライスで実行されます。systemd の MemoryHigh プロパティと MemoryMax プロパティが、このスライスの memory.high および memory.max の制御値を書き込みます。また、各サービスには個別の Go ヒープ予算の合計が memory.high を下回るように調整された GOMEMLIMIT も設定されています。
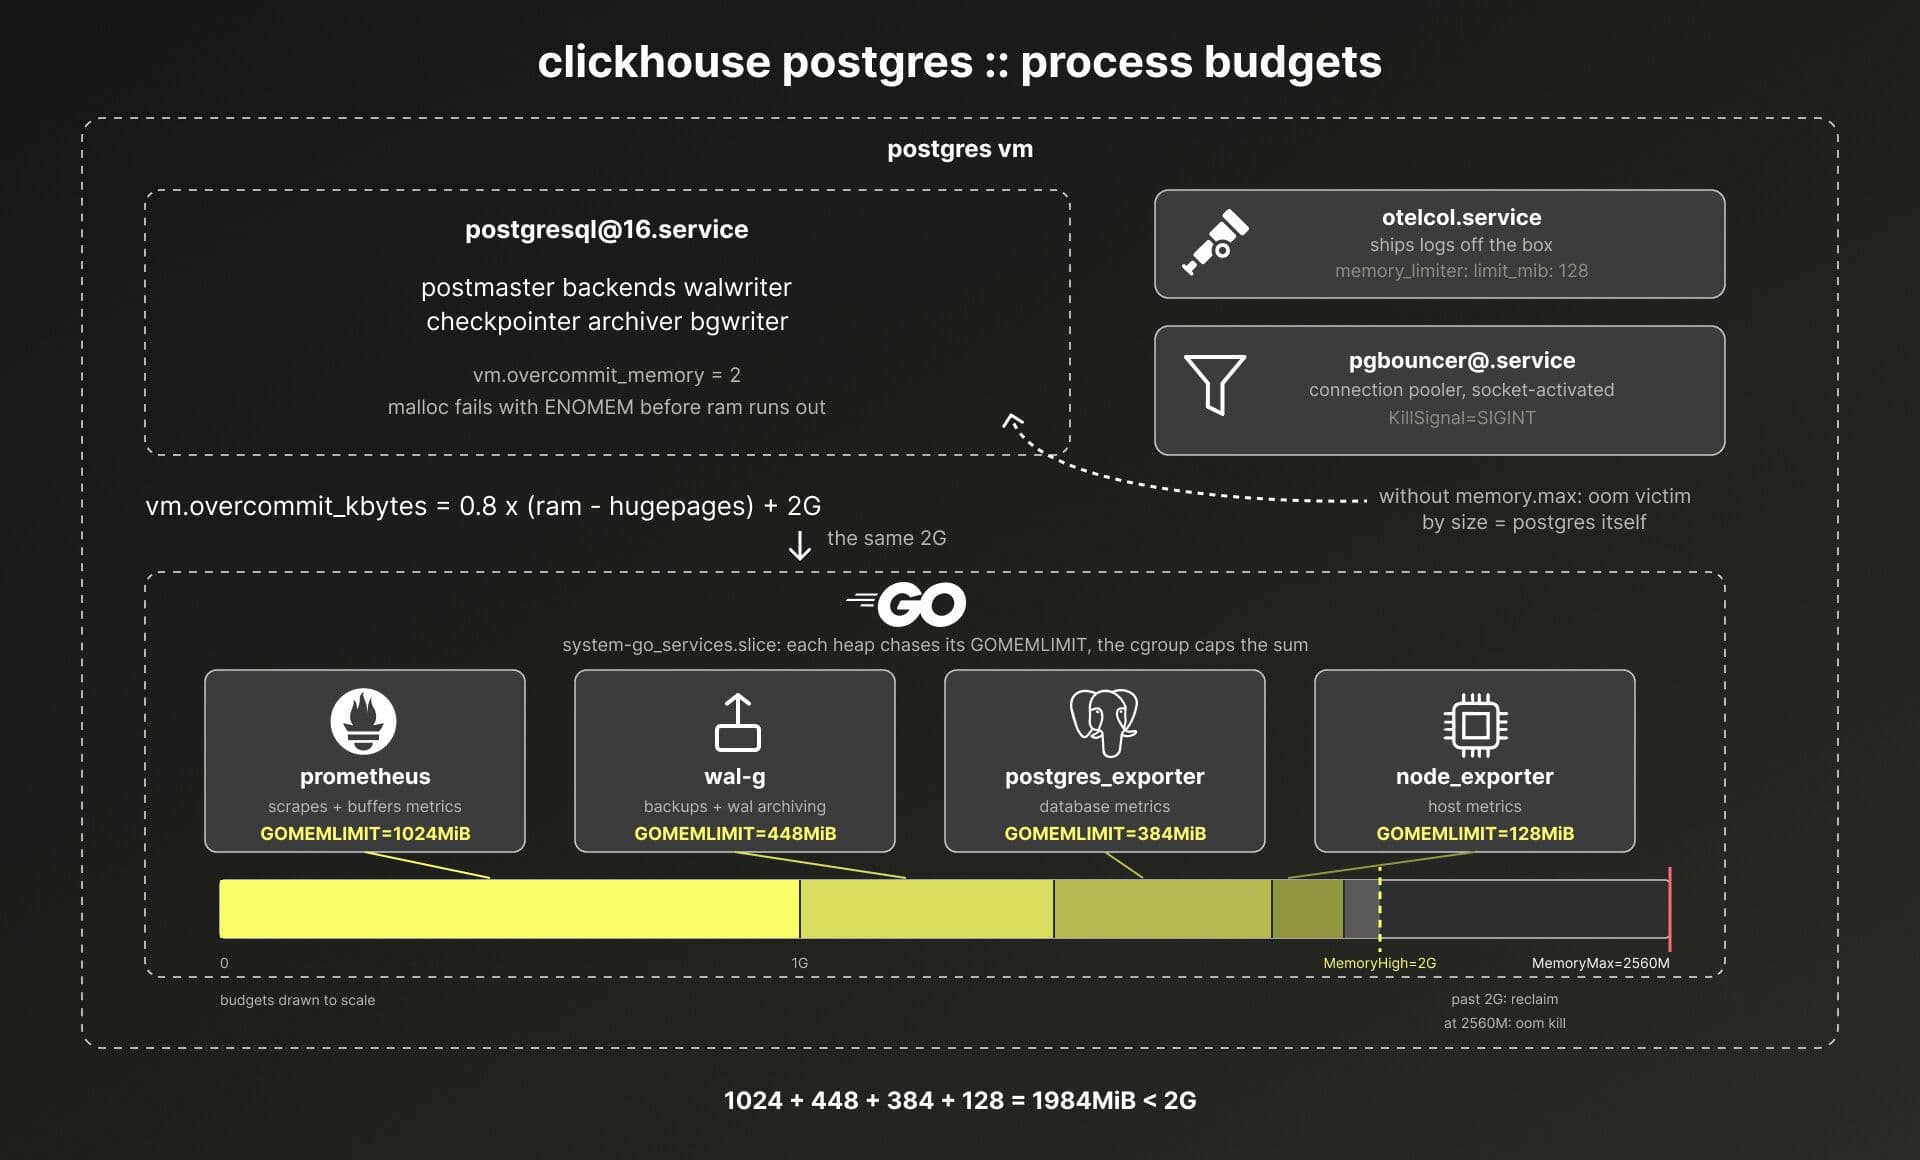
ランタイムと cgroup による強制
これらの境界は異なる役割を担っています。
| 境界 | 動作 | 存在する理由 |
|---|---|---|
GOMEMLIMIT | ヒープが設定された目標値に近づくにつれて、Go ランタイムによるガベージコレクションをより積極的に実行します。 | cgroup がカーネル強制の閾値に達する前に、ヒープの増加に伴って GC の頻度を引き上げます。 |
memory.high | ダイレクトリクレイムを強制し、cgroup にチャージされたメモリ割り当てをスロットリングします。 | cgroup のメモリ使用量に責任を持つプロセスに対してプレッシャーをかけます。 |
memory.max | cgroup のハードリミットを設定します。リクレイムで使用量を減らせない場合、カーネルはその cgroup 内で OOM イベントを発生させます。 | OOM の対象選定が、サポートサービス用 cgroup にチャージされたプロセス内に限定されます。 |
GOMEMLIMIT は、意図的に第1防衛線として配置されています。Go はカーネルよりもはるかに多くのコンテキストを把握した上で対応できます。何がヒープで、何が生存オブジェクトであり、いつ追加のガベージコレクションサイクルを実行すれば有効かを理解しています。予算に近づいたサービスはコレクション処理を増やし、通常は自律的に制限の範囲内に収まります。
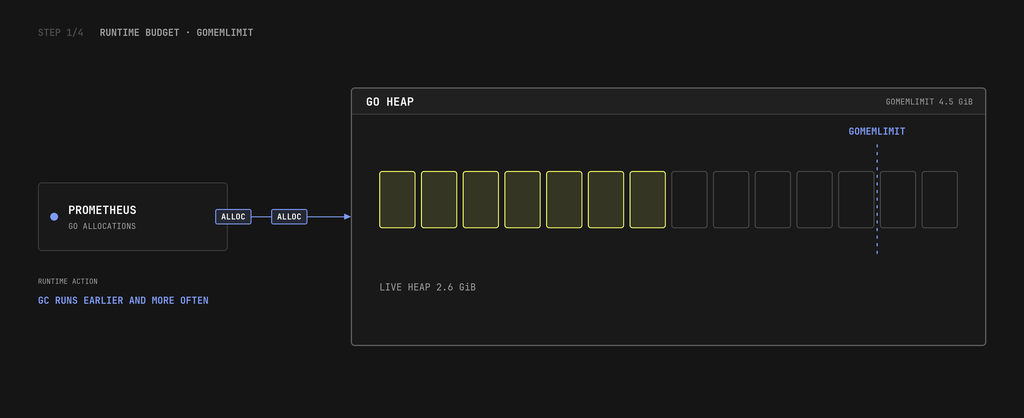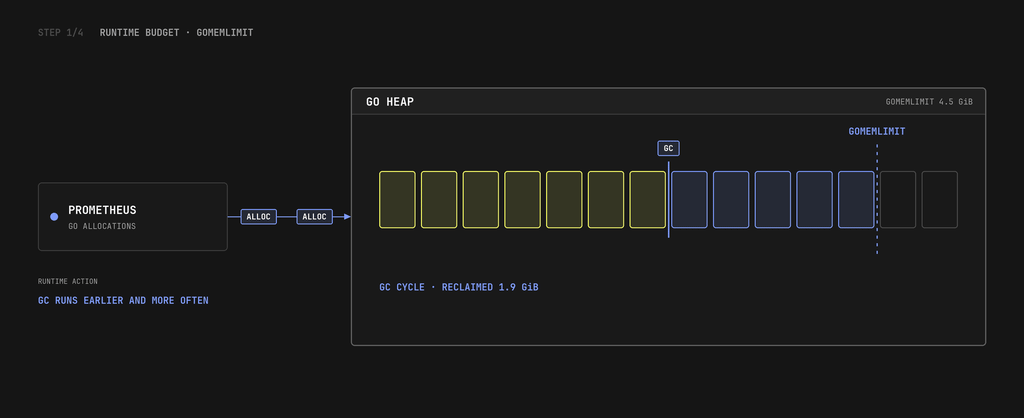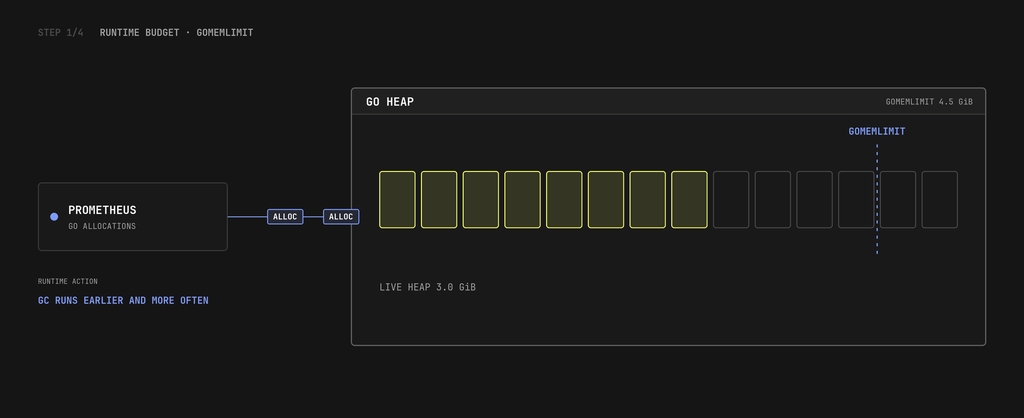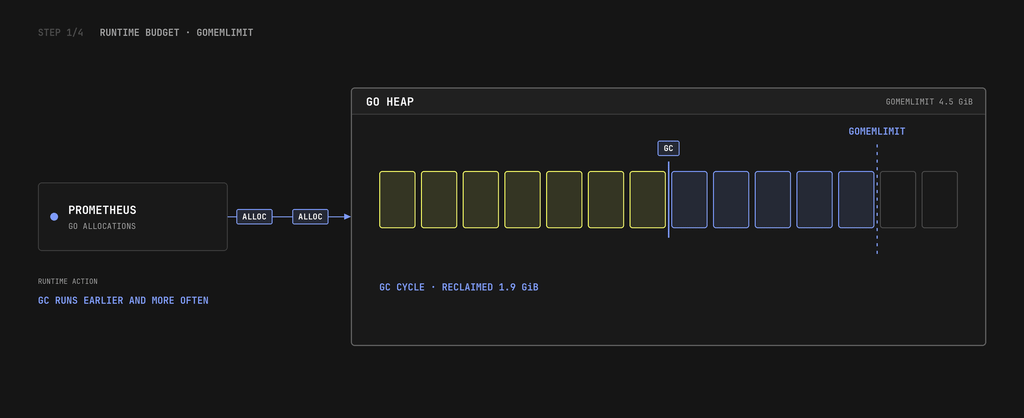
GOMEMLIMIT はあくまでランタイムの目標値です。ネイティブメモリの割り当て、保持されたオブジェクト、あるいは本格的なリークによって、プロセスが制限を超えてしまうことがあります。そこで cgroup がカーネルレベルの強制力を提供します。memory.high を超えた割り当てには、リクレイムとスロットリングが適用されます。
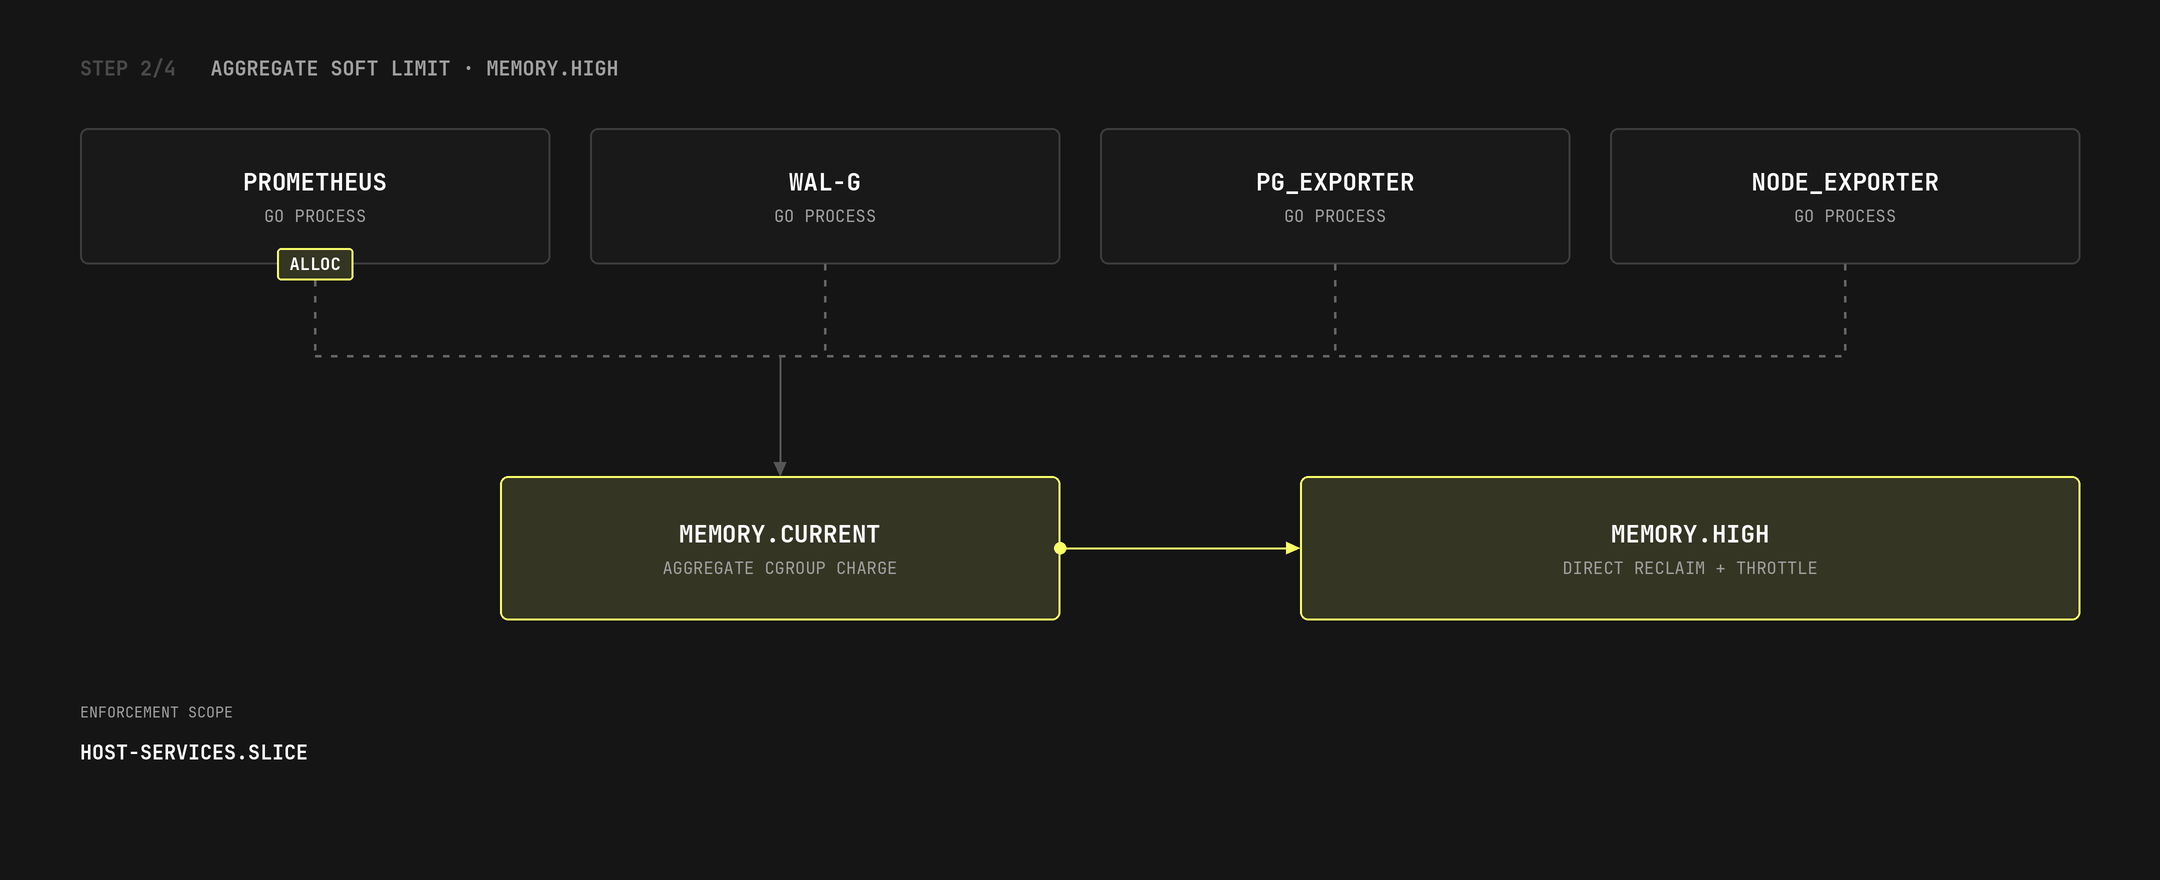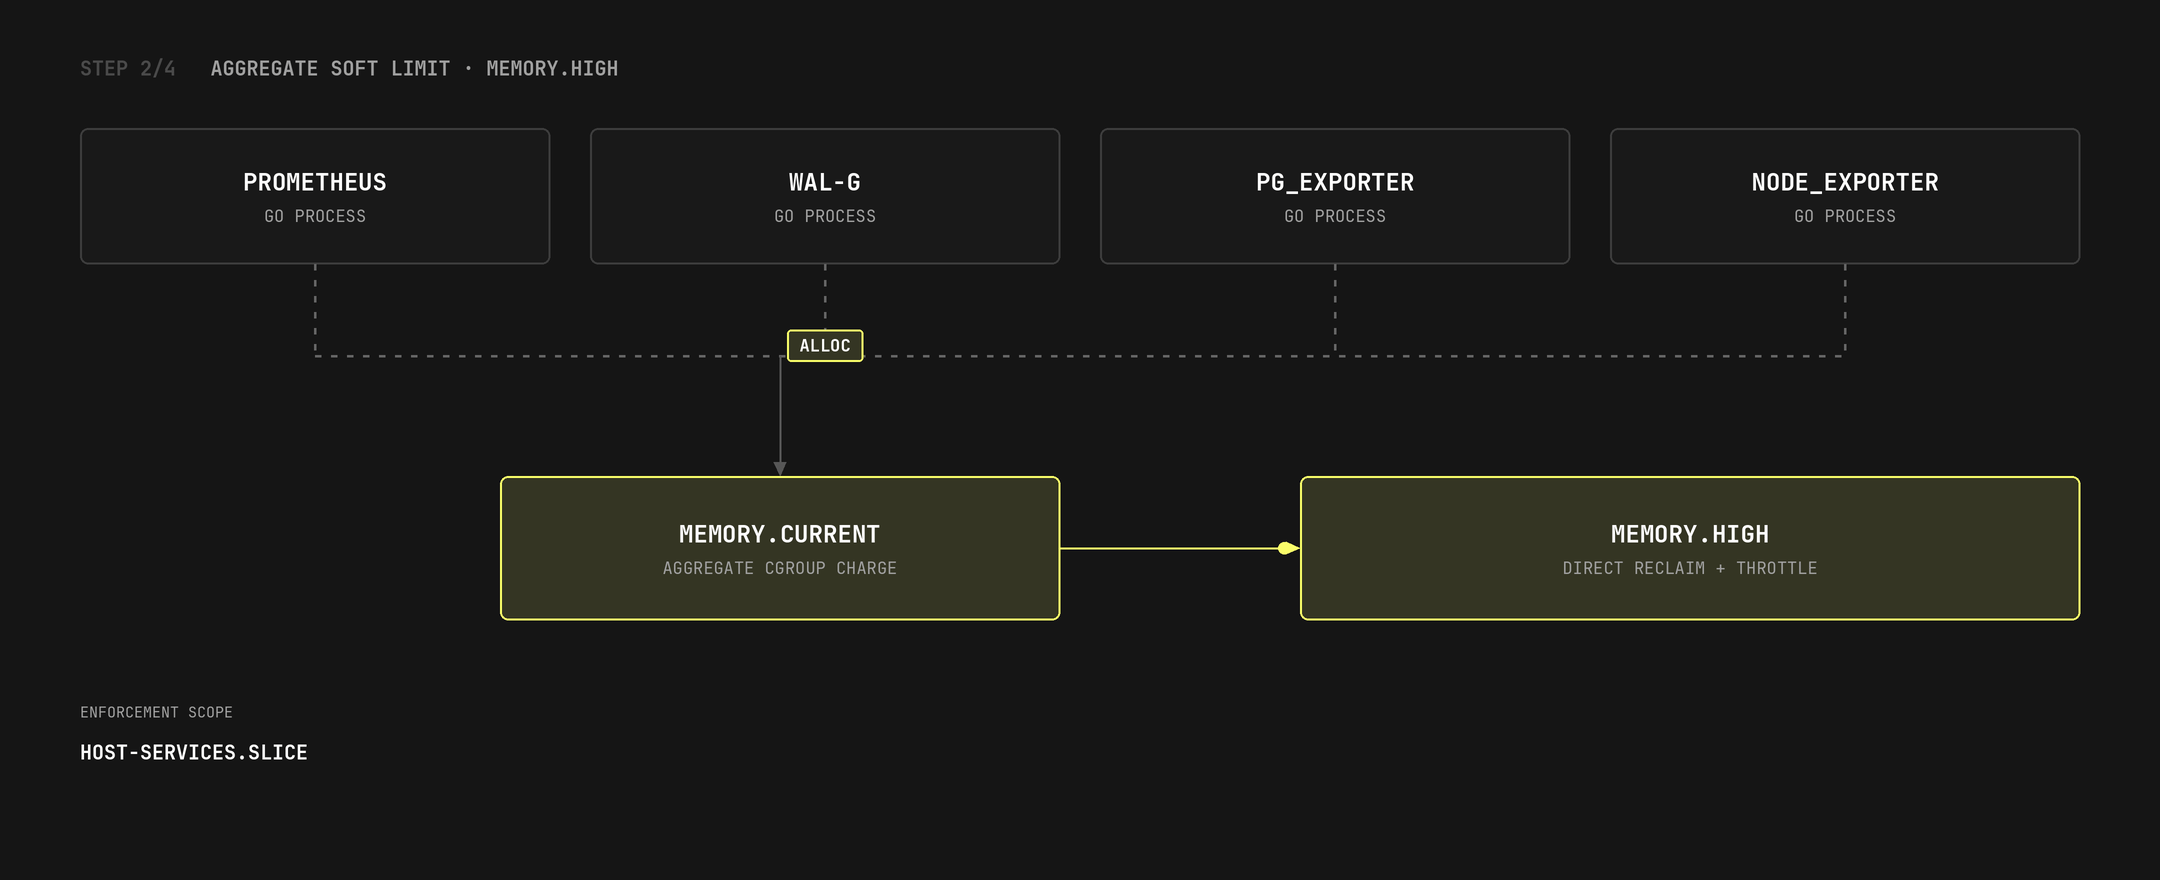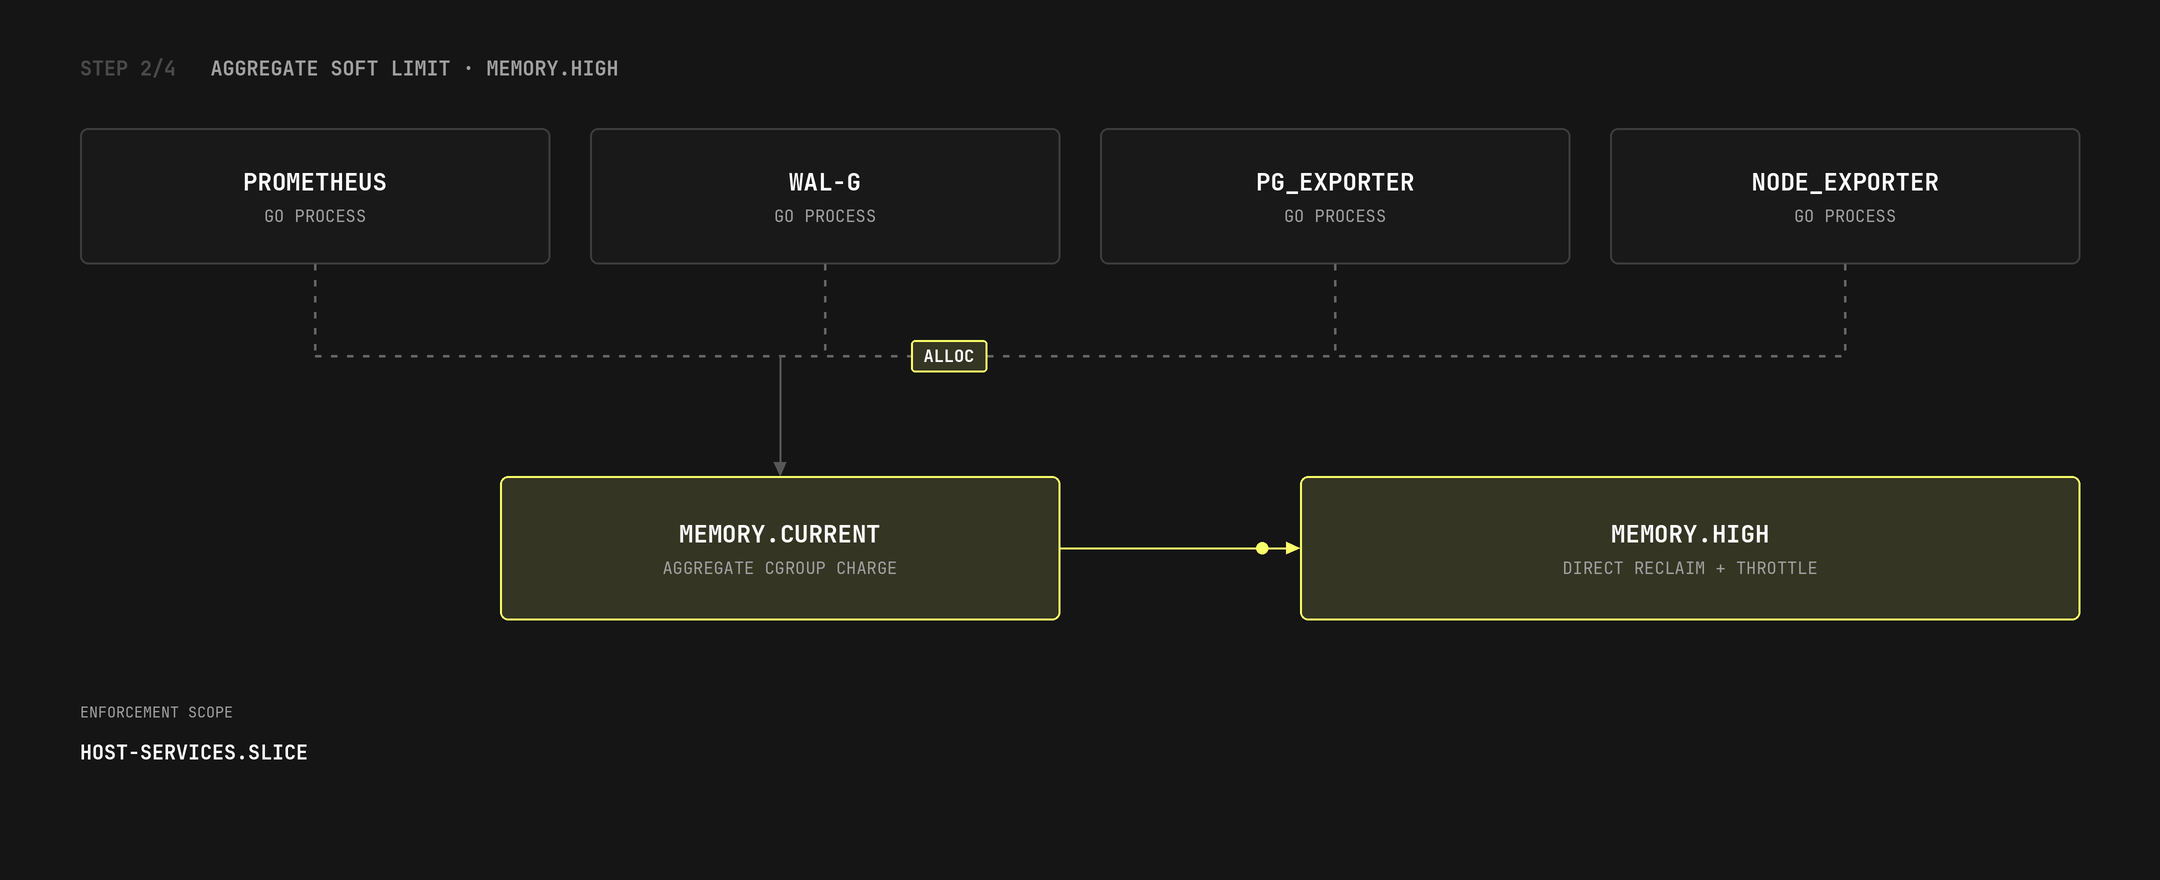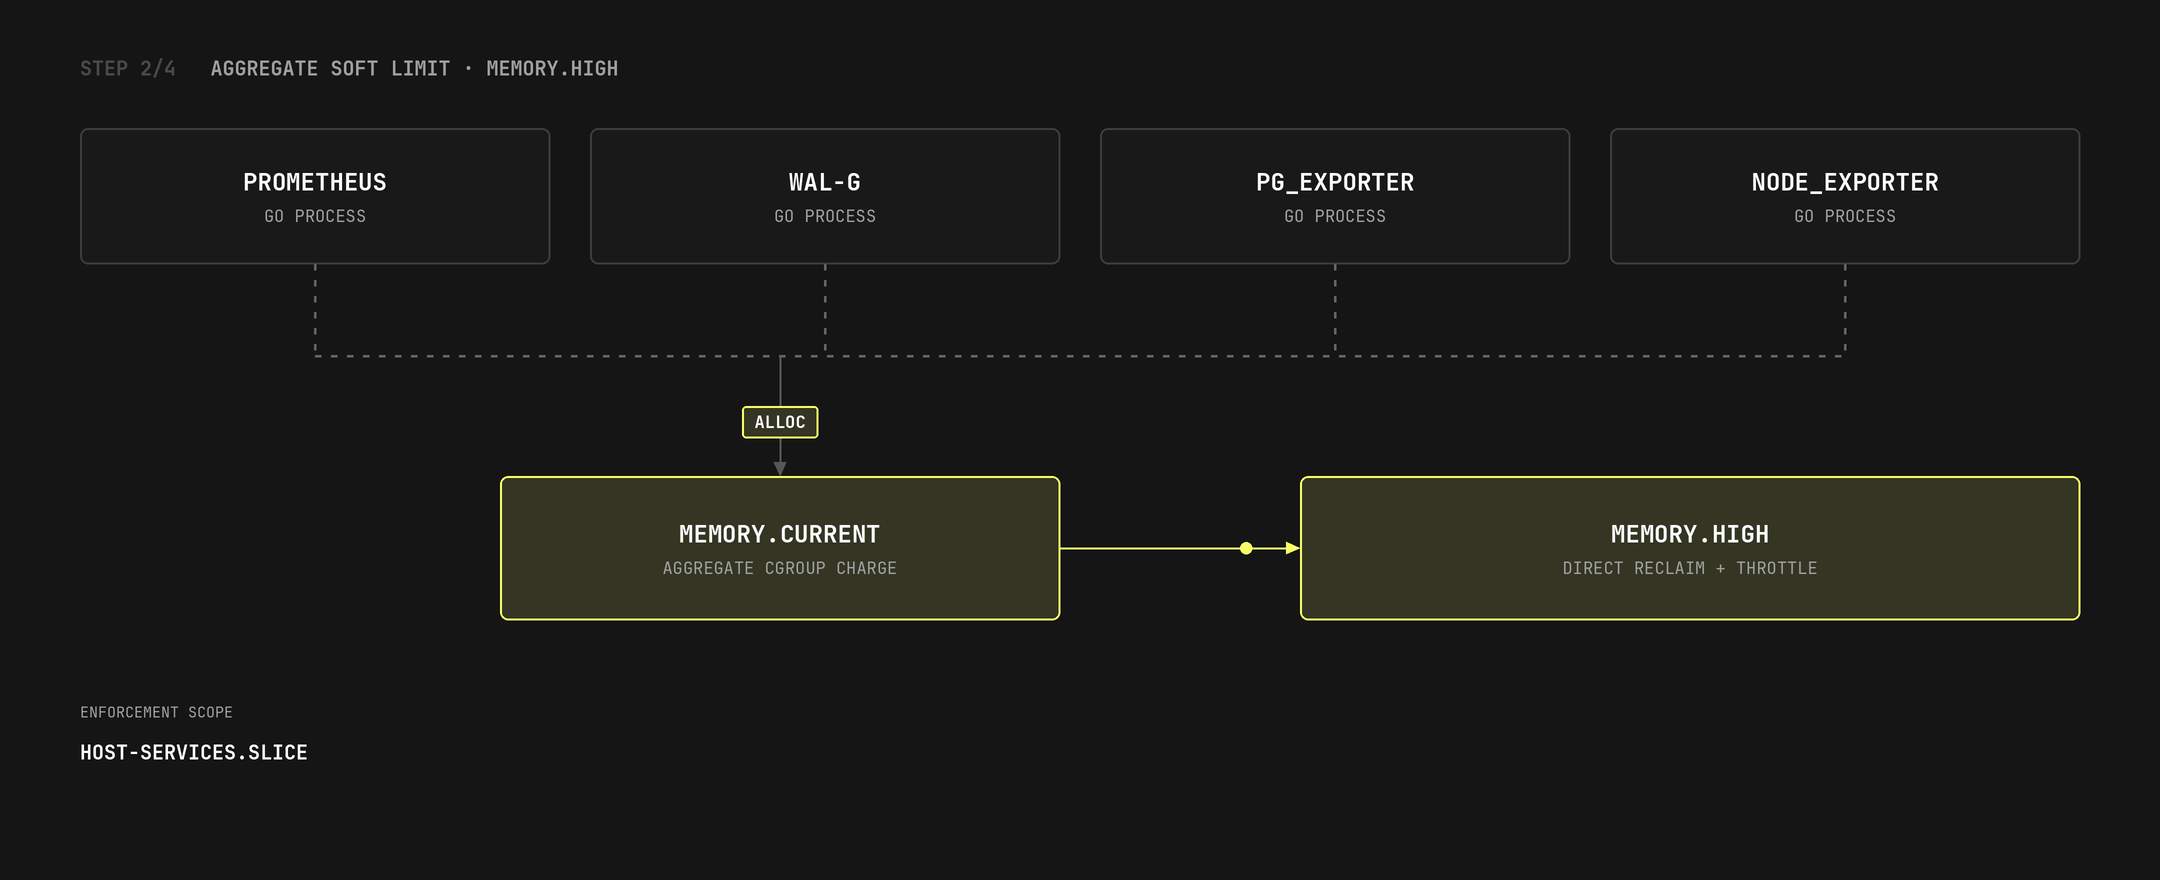
リクレイムによっても memory.max を下回るまで減らせない割り当ては、cgroup の OOM イベントをトリガーします。
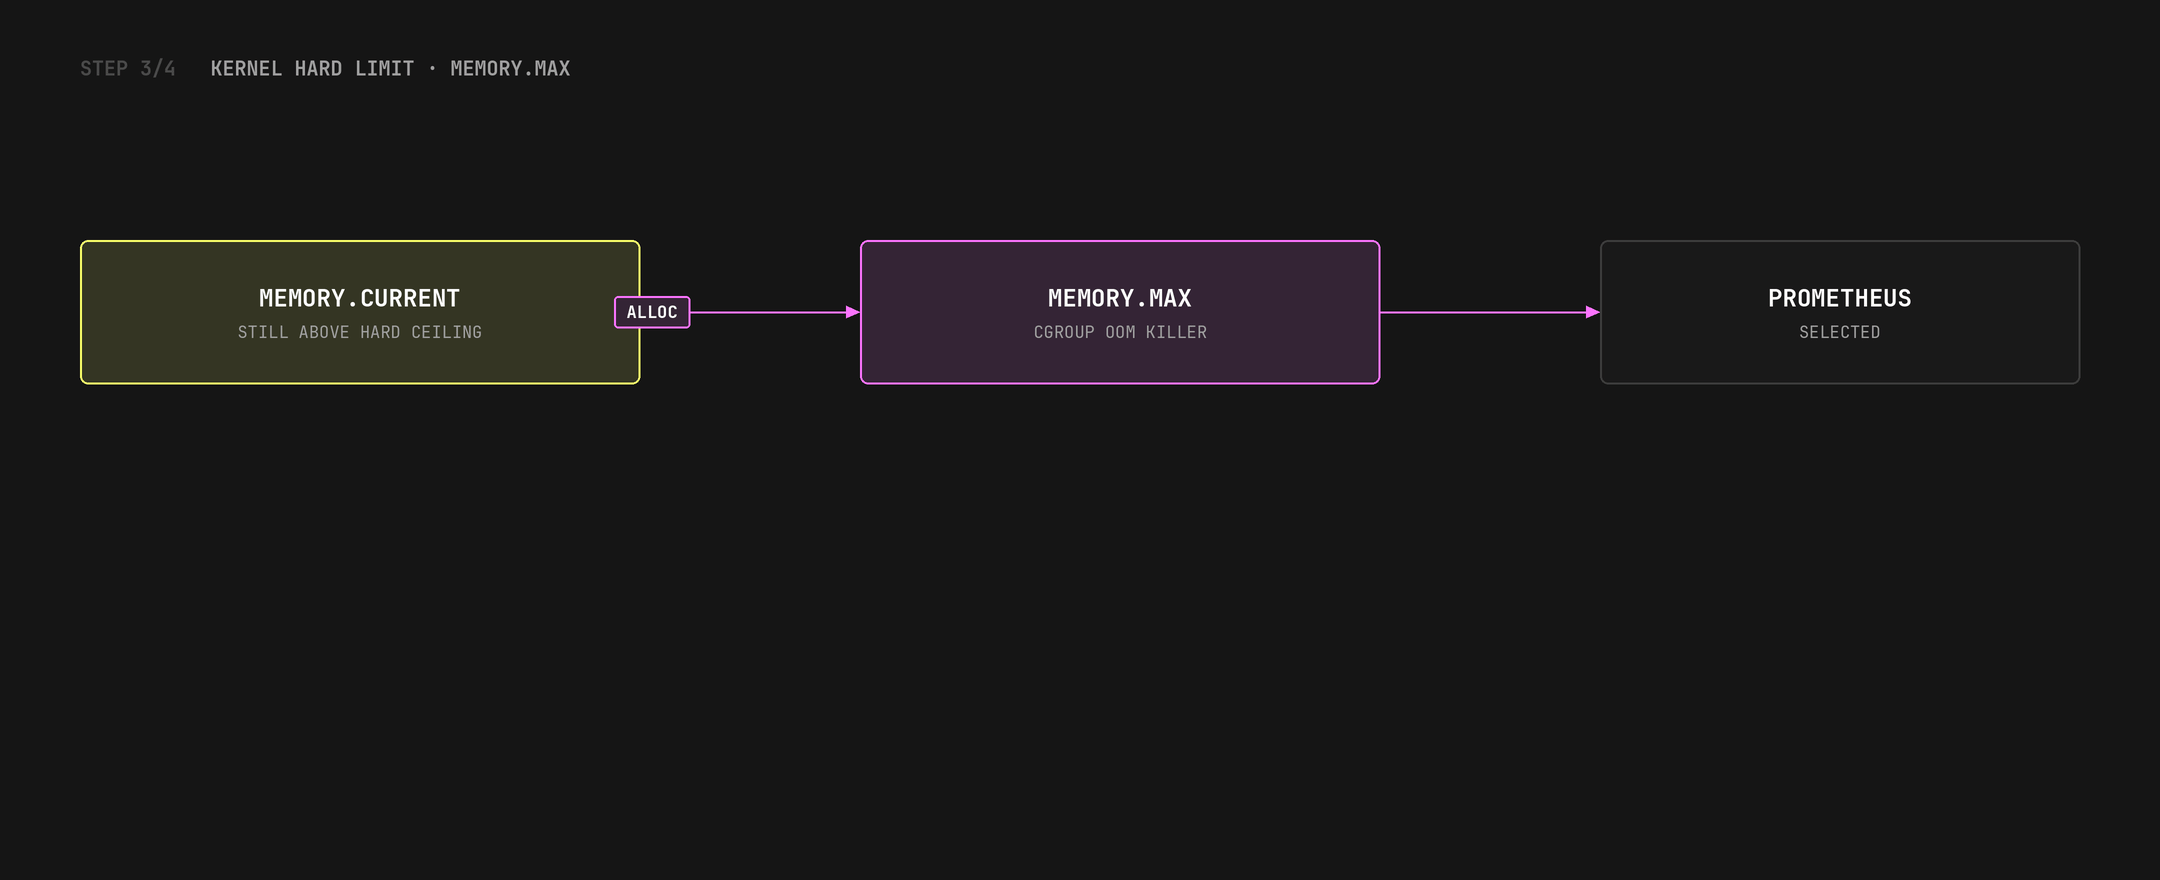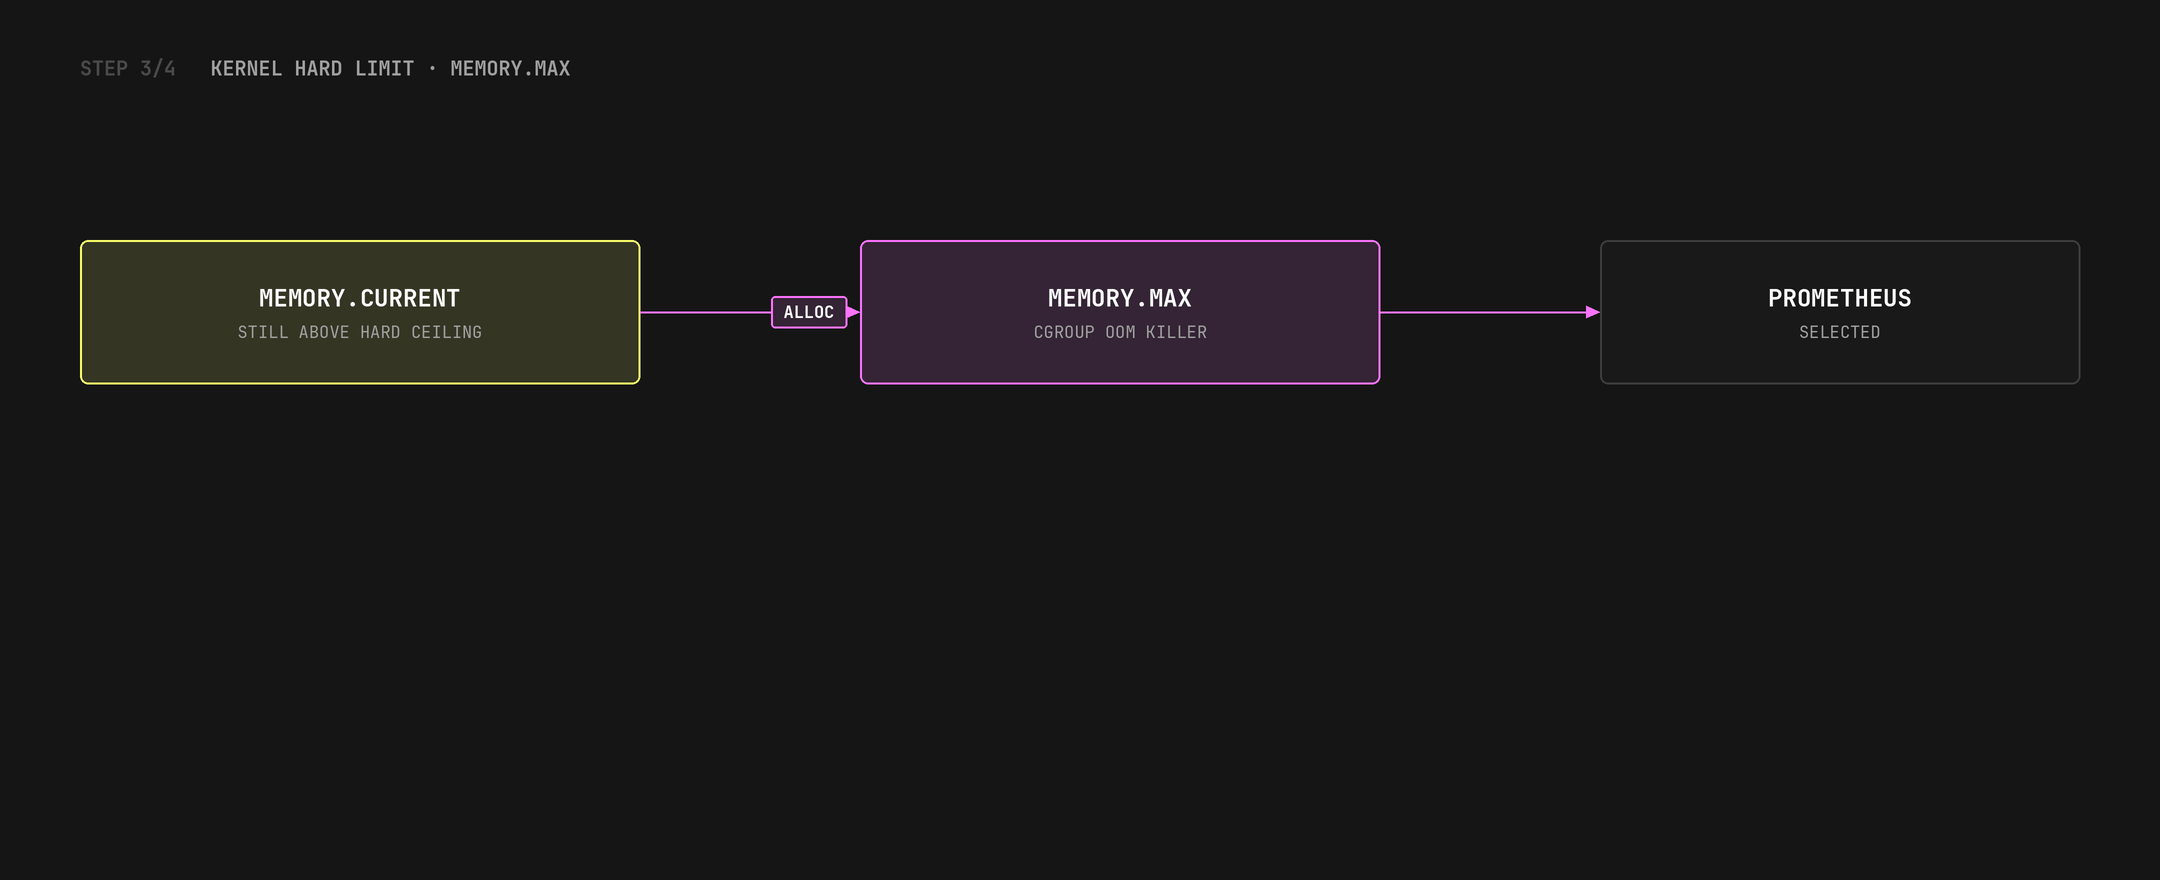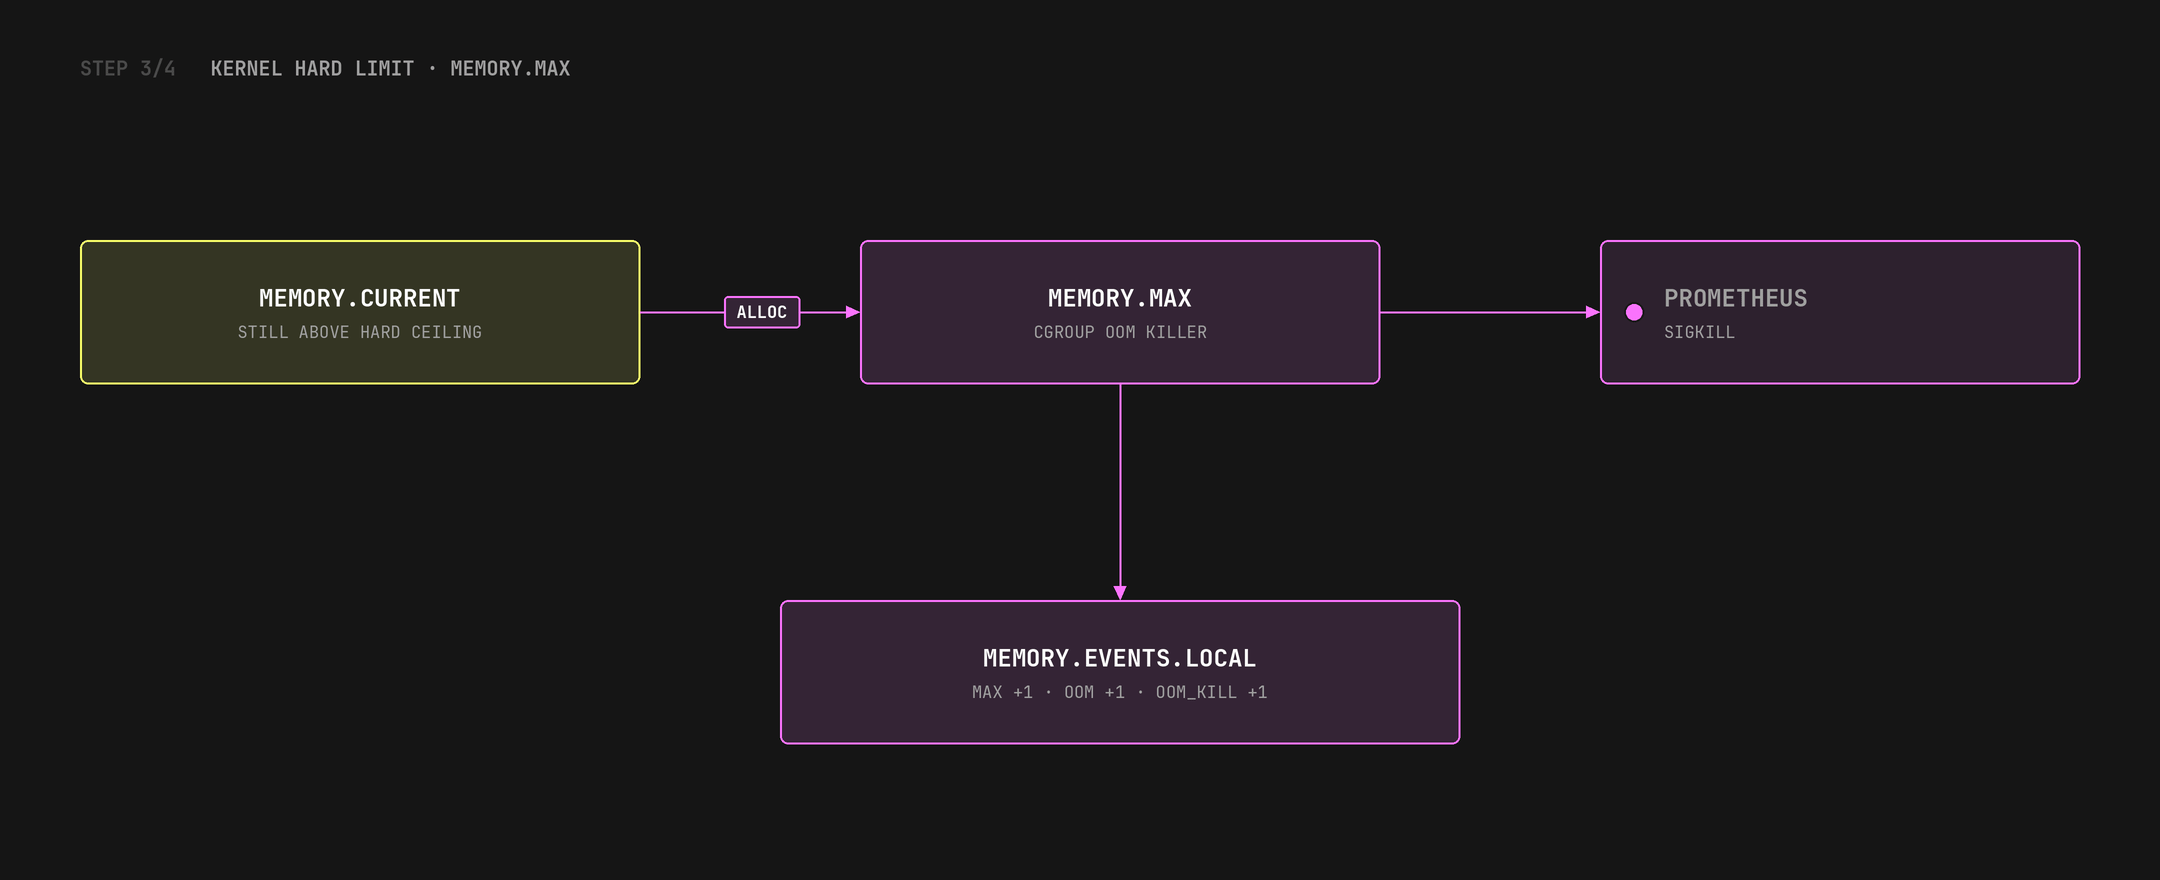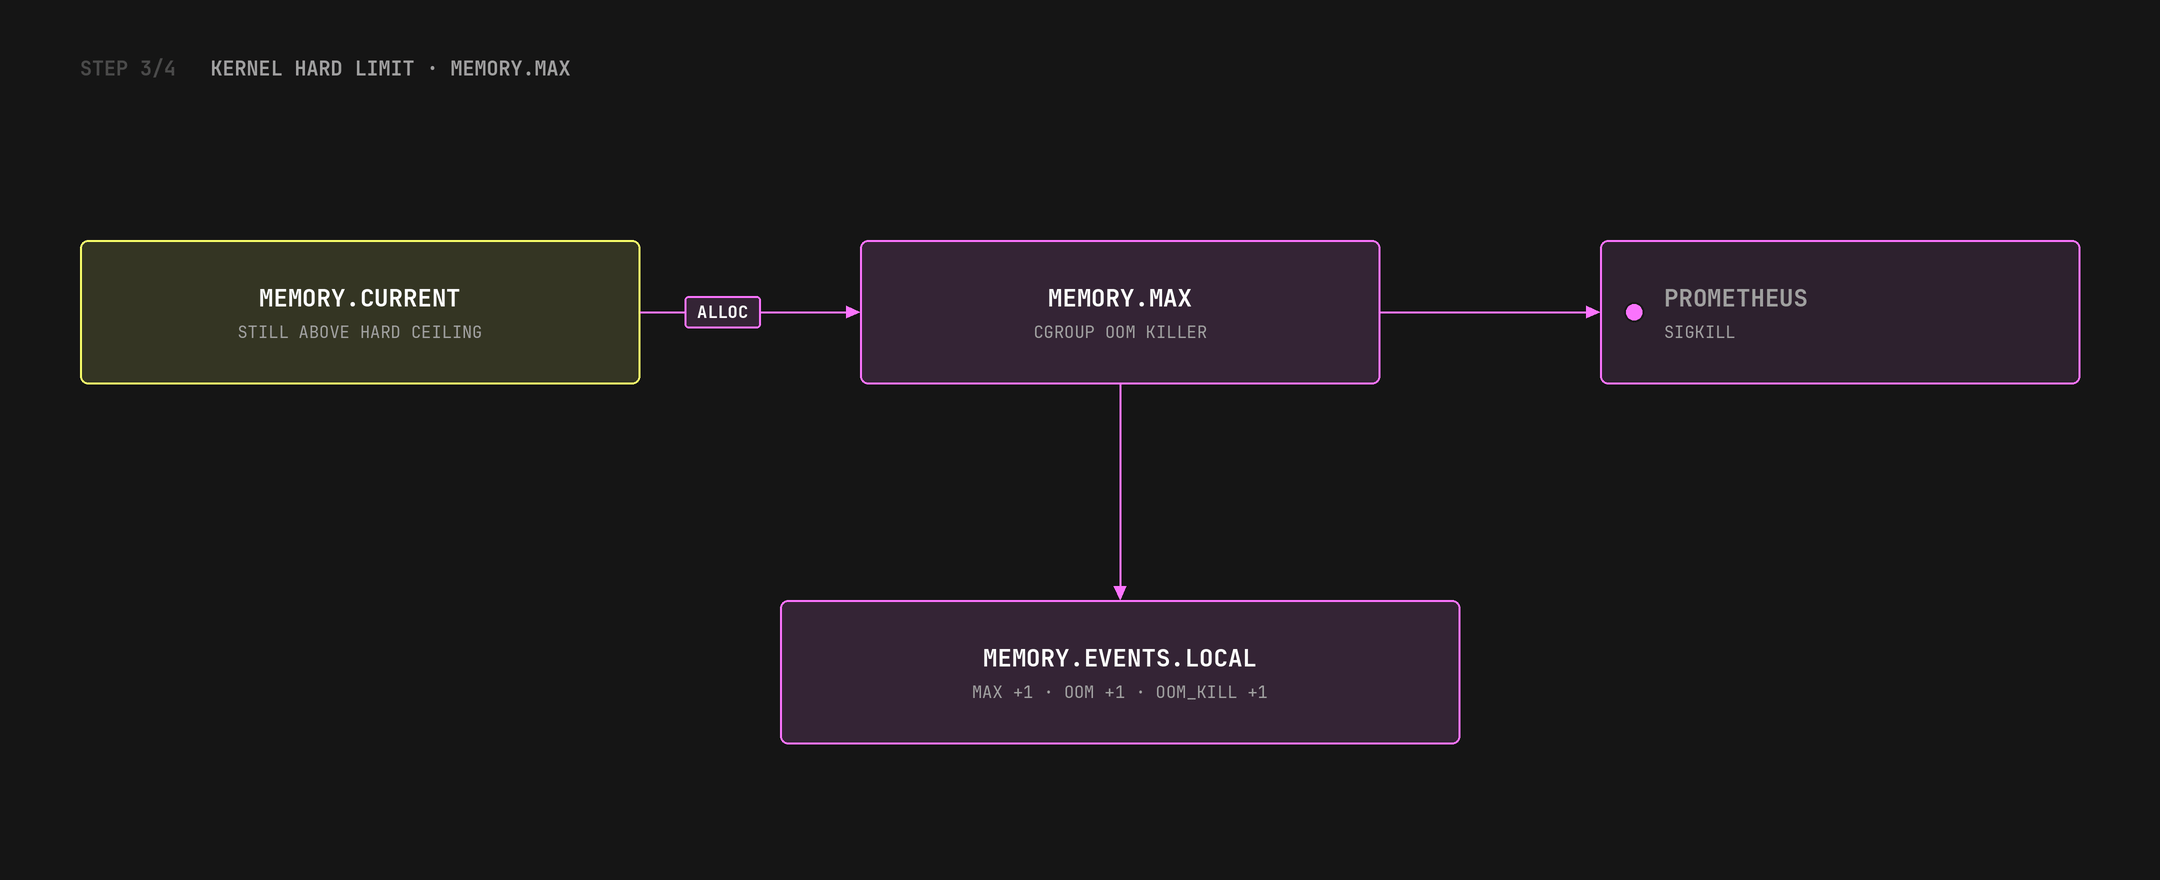
Postgres のメモリは別の cgroup にチャージされるため、サポートサービス用 cgroup で memory.max イベントが発生しても、Postgres のプロセスが選ばれることはありません。
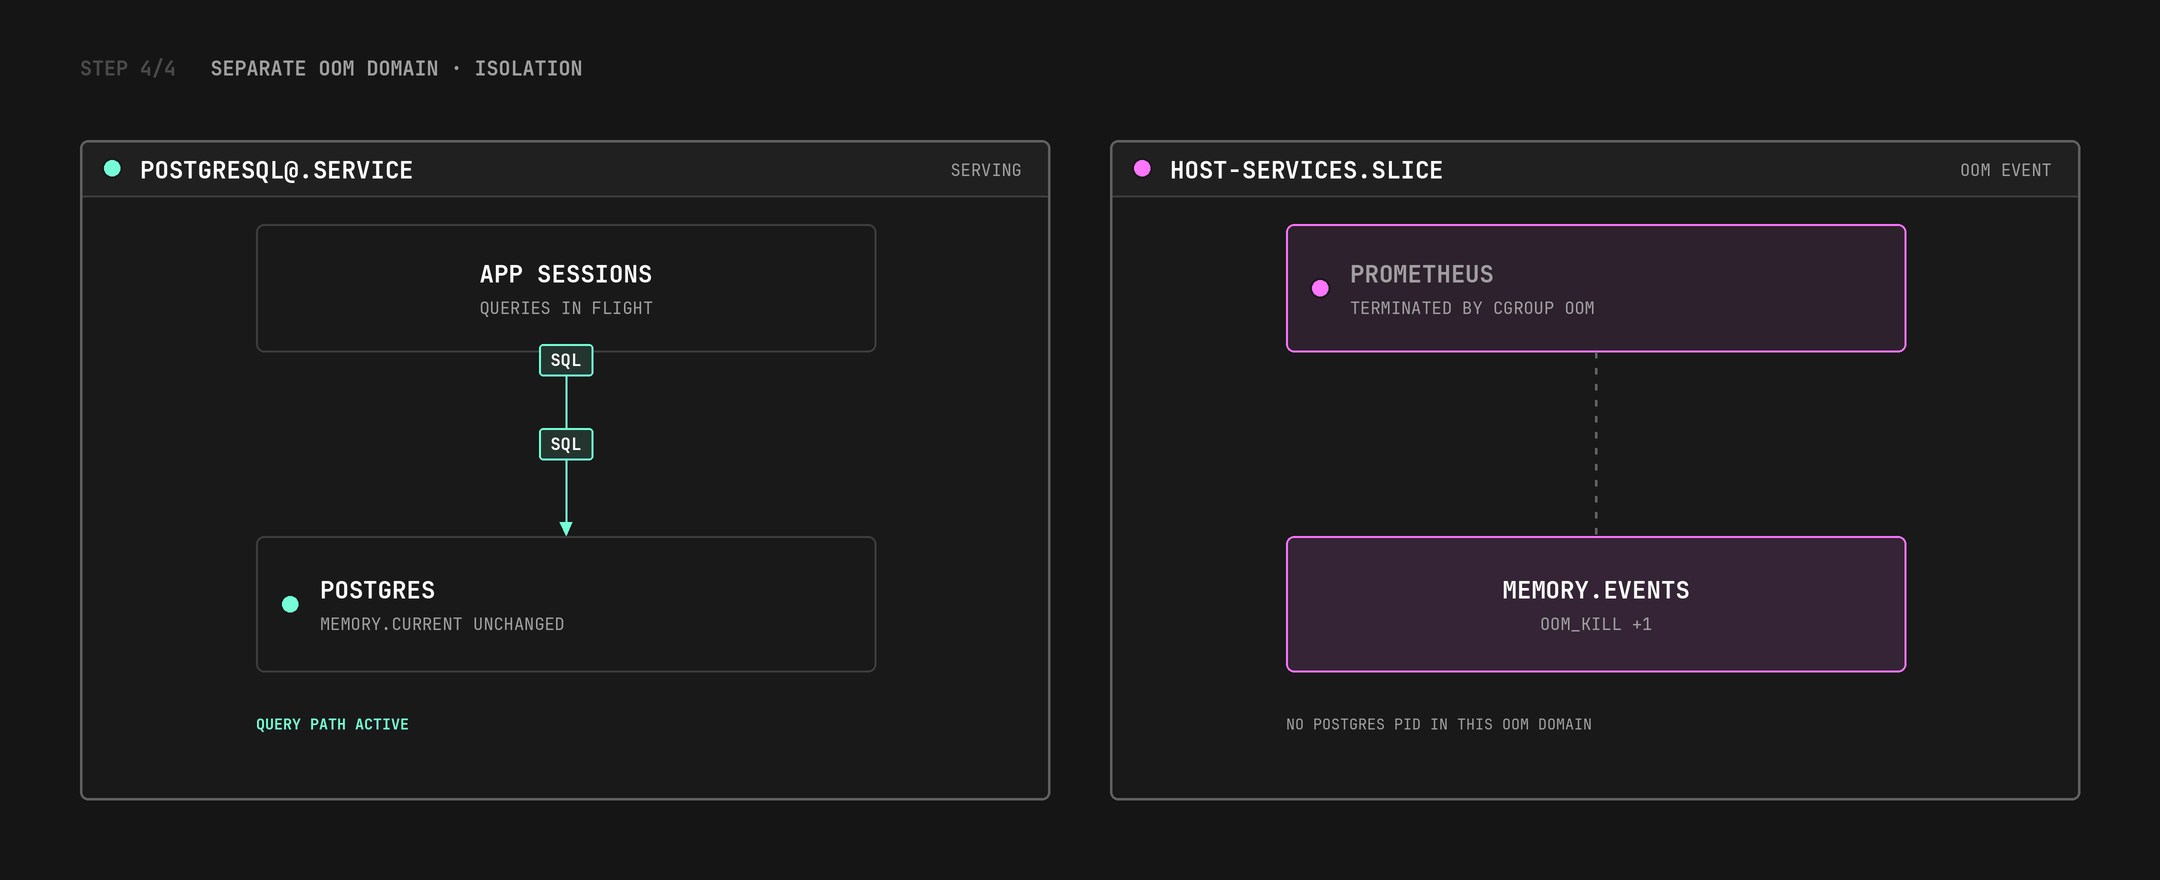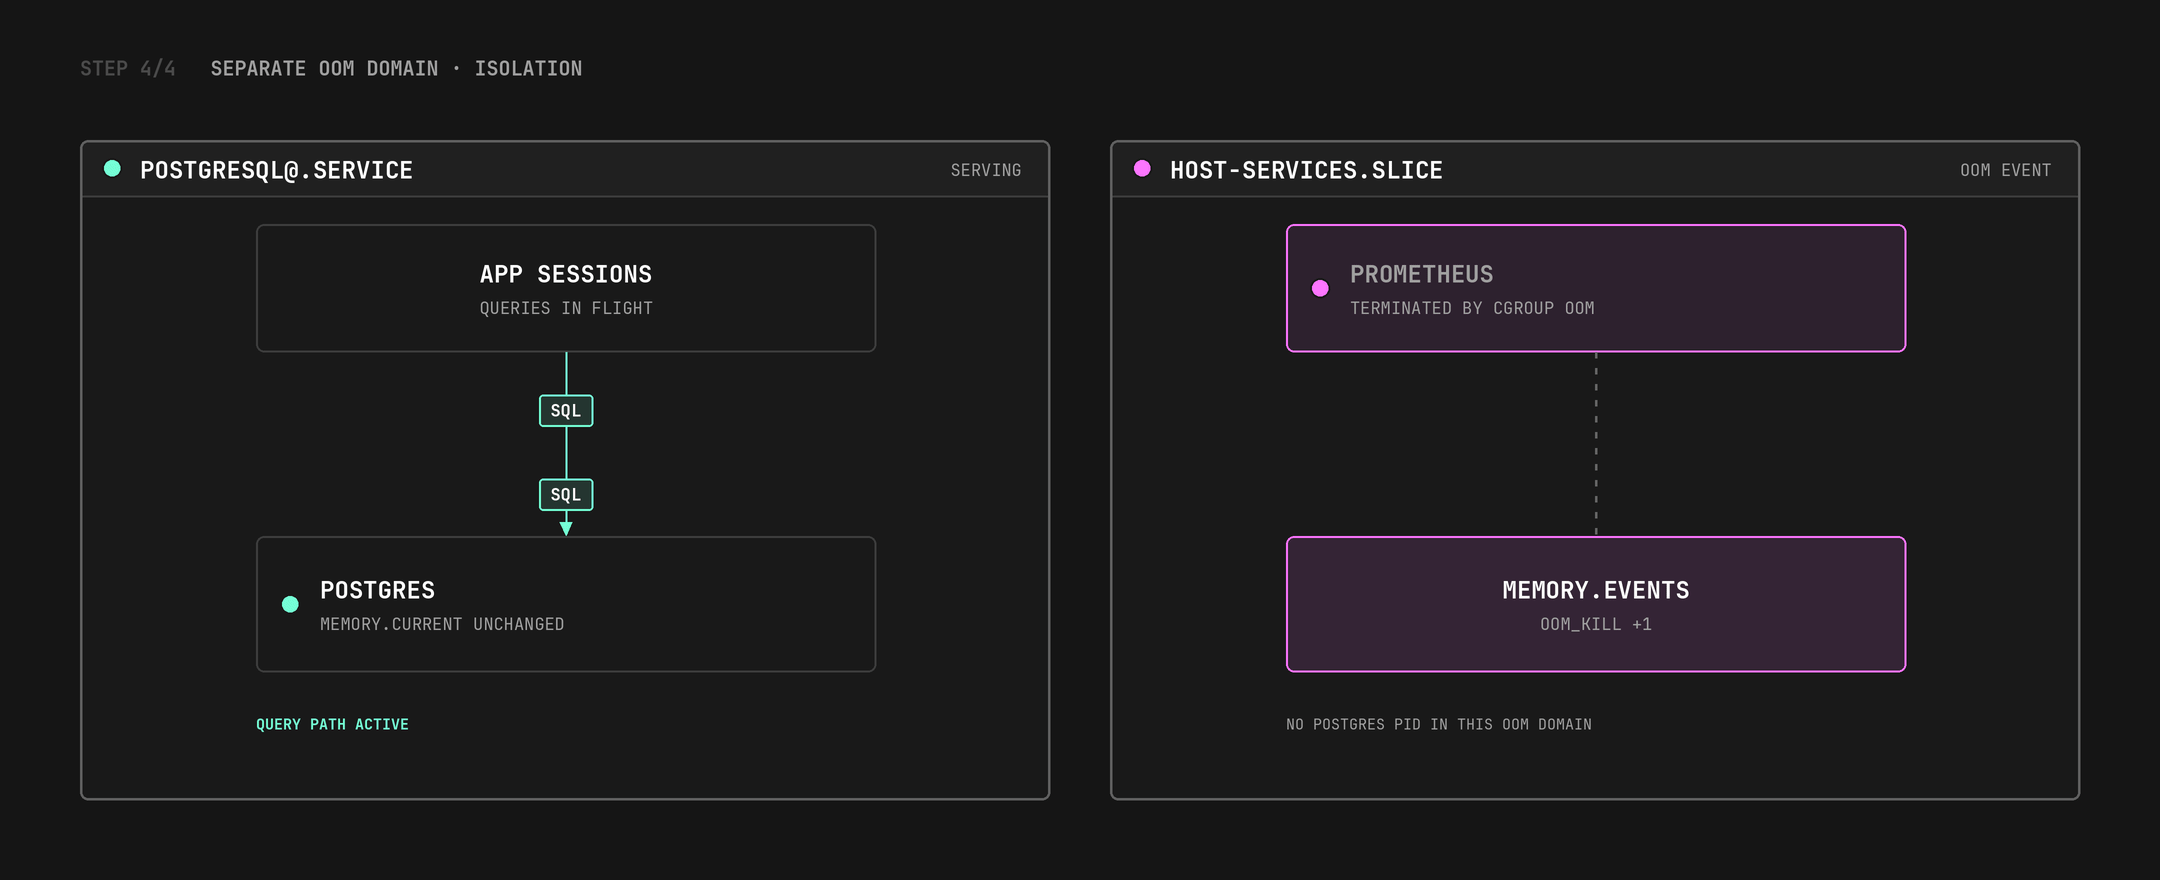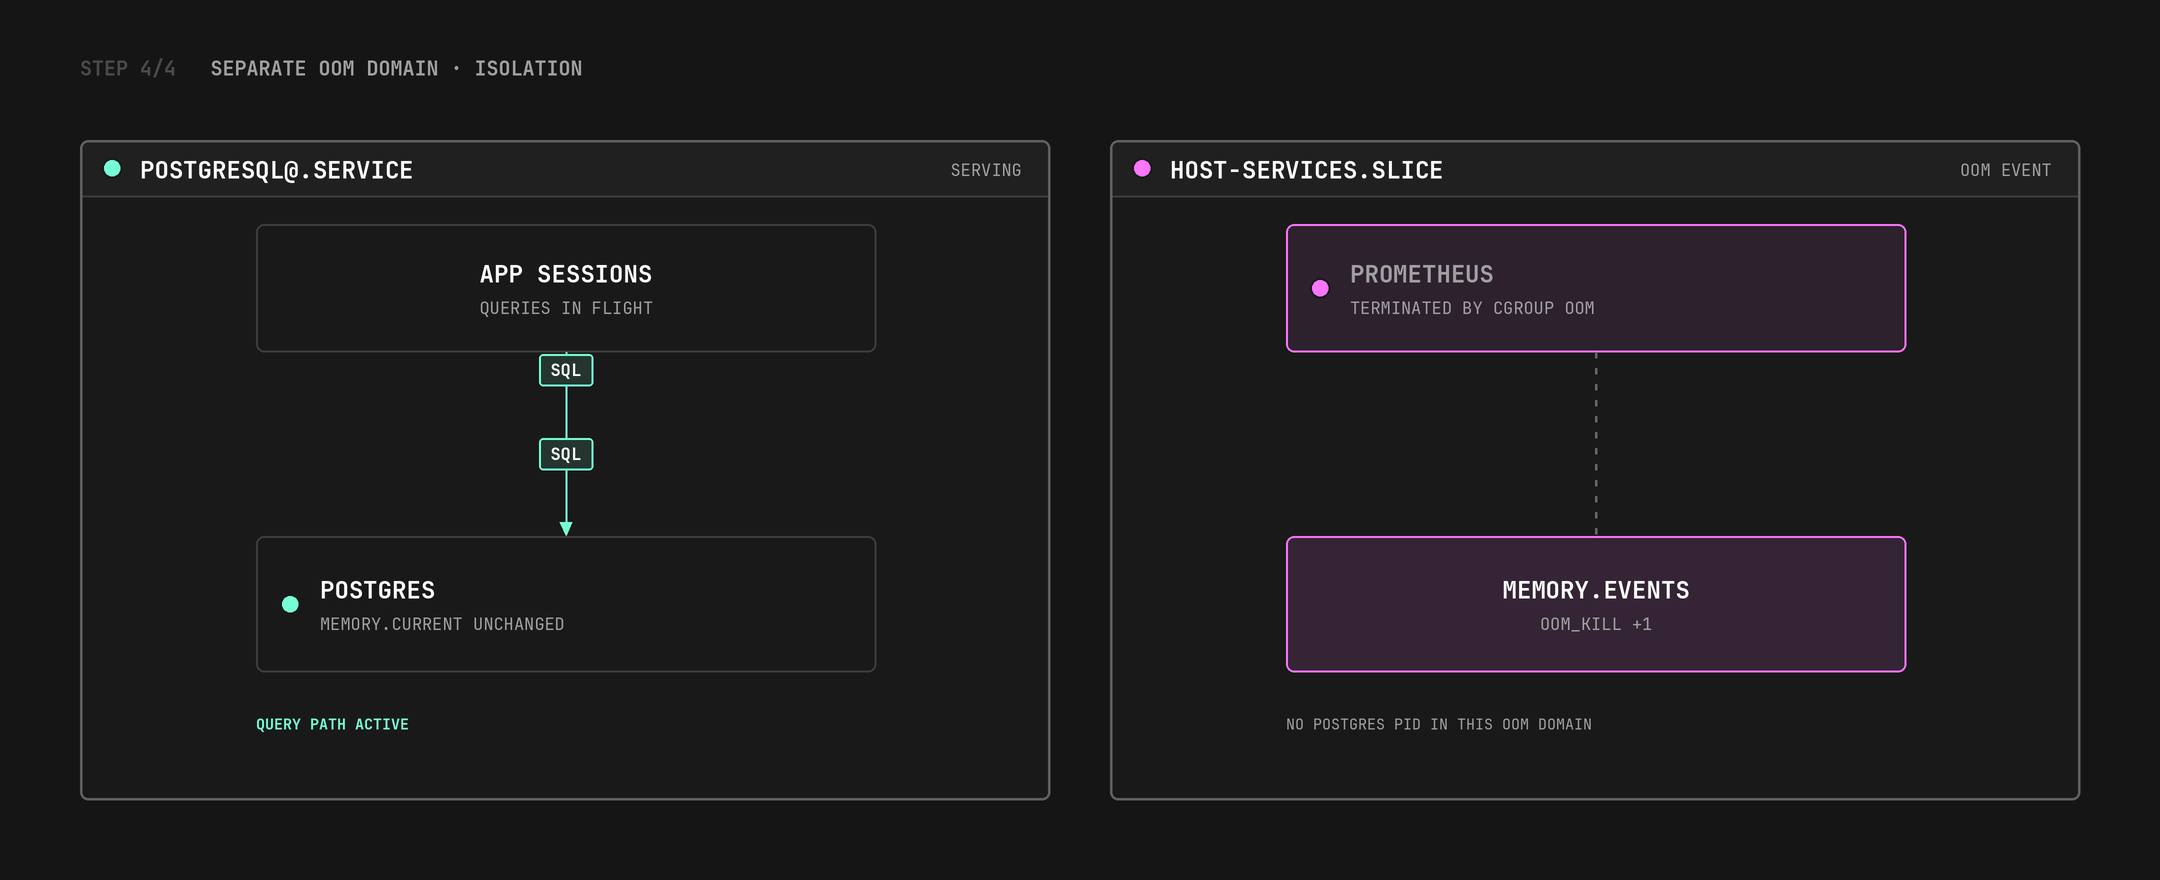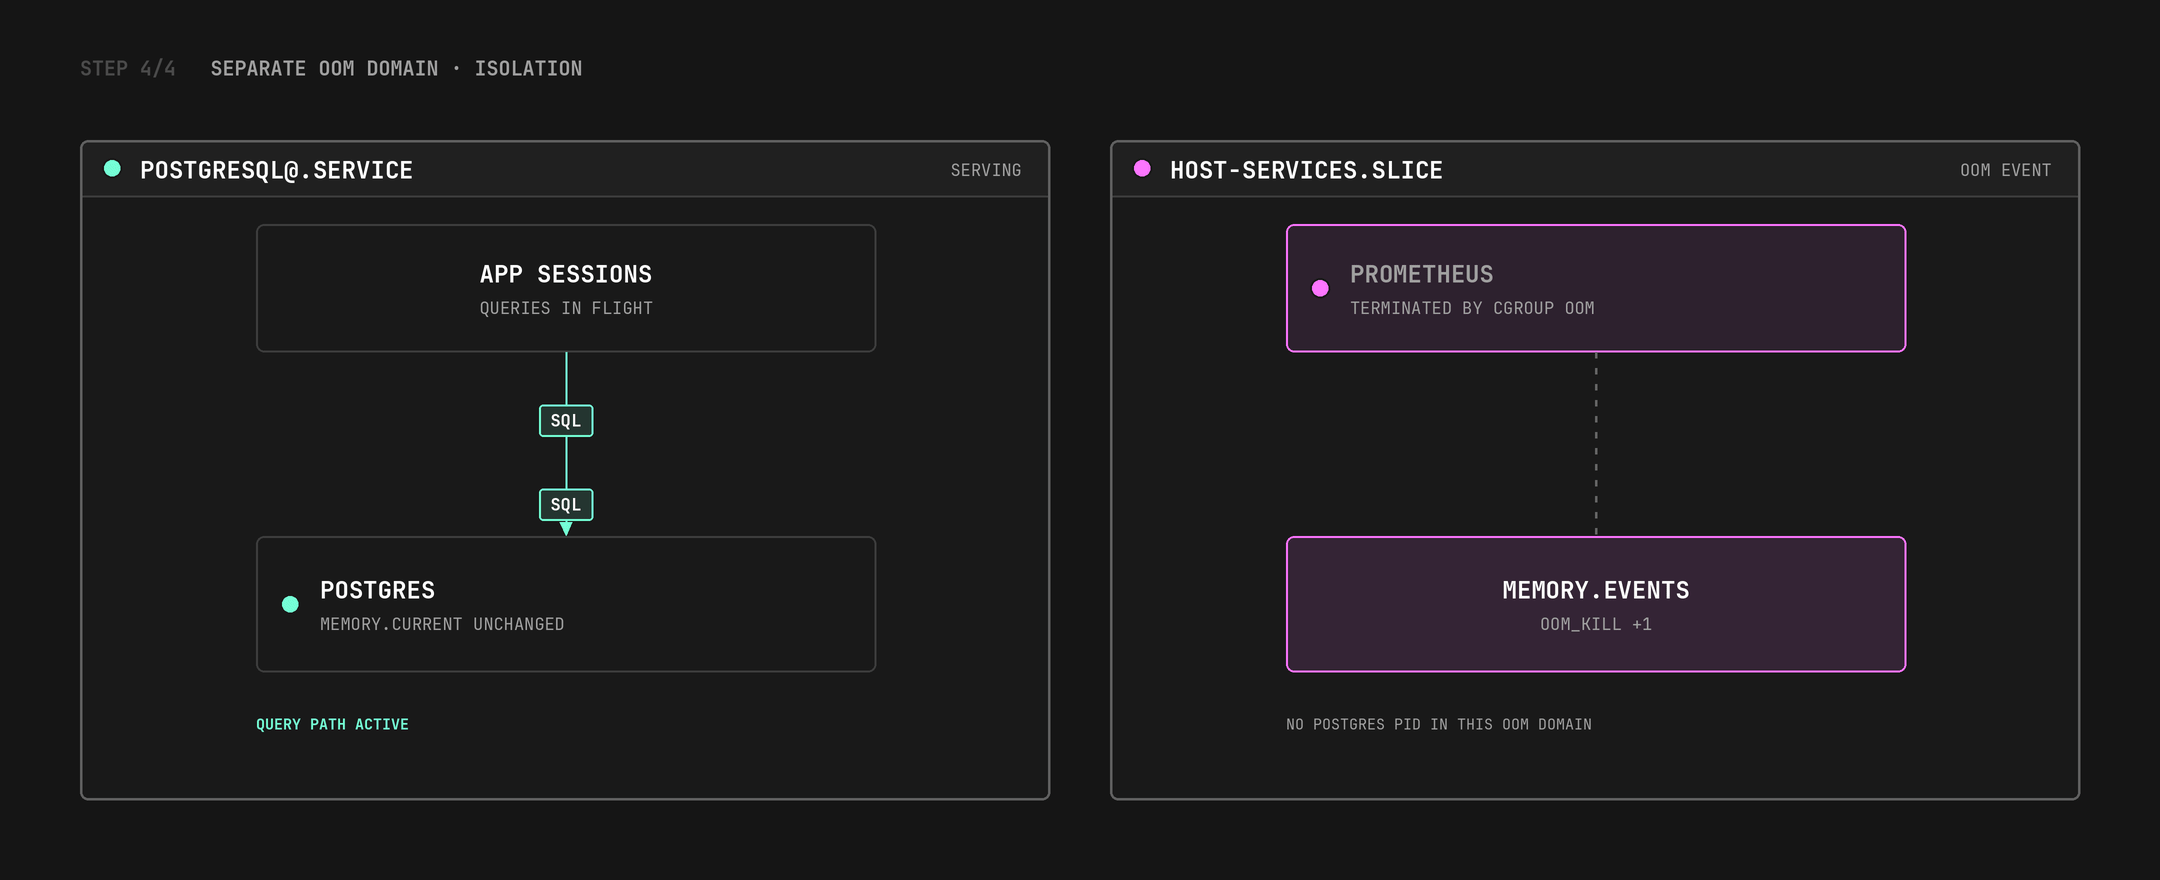
このスライスの許容量は、私たちの厳格なオーバーコミットポリシーが Postgres の割り当て分の上に確保しているヘッドルームと同じものです。コミット予算がメモリを確保し、cgroup がプロセスをその枠内に留めます。この2つの制御は、同じキャパシティを逆の方向から規定しています。
あらゆるリソースにわたる予算管理
あるプロセスのヒープ使用量が完璧に振る舞っていたとしても、別の部分でデータベースに悪影響を及ぼす可能性があります。そのため、同様の規律を VM 全体に適用しています。
- バックアップはデフォルトの CPU 重み付けのわずかな割合で実行されるため、マシンが高負荷な場合でもフォアグラウンドのデータベース処理が優先されます。
- WAL-G のバッファは RAM の固定割合に設定されており、ワークロードが増加してもメモリ使用量は一定の範囲に抑えられます。
- ログコレクターには独自のメモリリミッターが備わっており、ログが急増しても二次的なインシデントに発展するのを防ぎます。
- ホスト外に出力されるメトリクスは厳選されているため、新しいラベルによって気付かないうちにメモリ、CPU、ネットワークトラフィックのカーディナリティコストが跳ね上がることはありません。
現在、各リソースには強制ポイントが設けられています。CPU にはスケジューラの重み付け、メモリには固定バッファサイズ設定と cgroup、ディスクにはローカルの閾値、そしてエクスポートされるメトリクスシリーズには許可リストが適用されています。
ディスク容量枯渇時のセッション除外
Postgres が処理を進めるにはディスクの空き容量が必要であり、データボリュームが満杯になると通常のワークロードであっても即座に可用性インシデントへと発展しかねません。緊急閾値に達すると、ディスクフルのウォッチドッグがセッションを強制終了して書き込みプレッシャーを低減します。その際、レプリケーションと監視という2つのユーザー名が強制終了から除外されます。
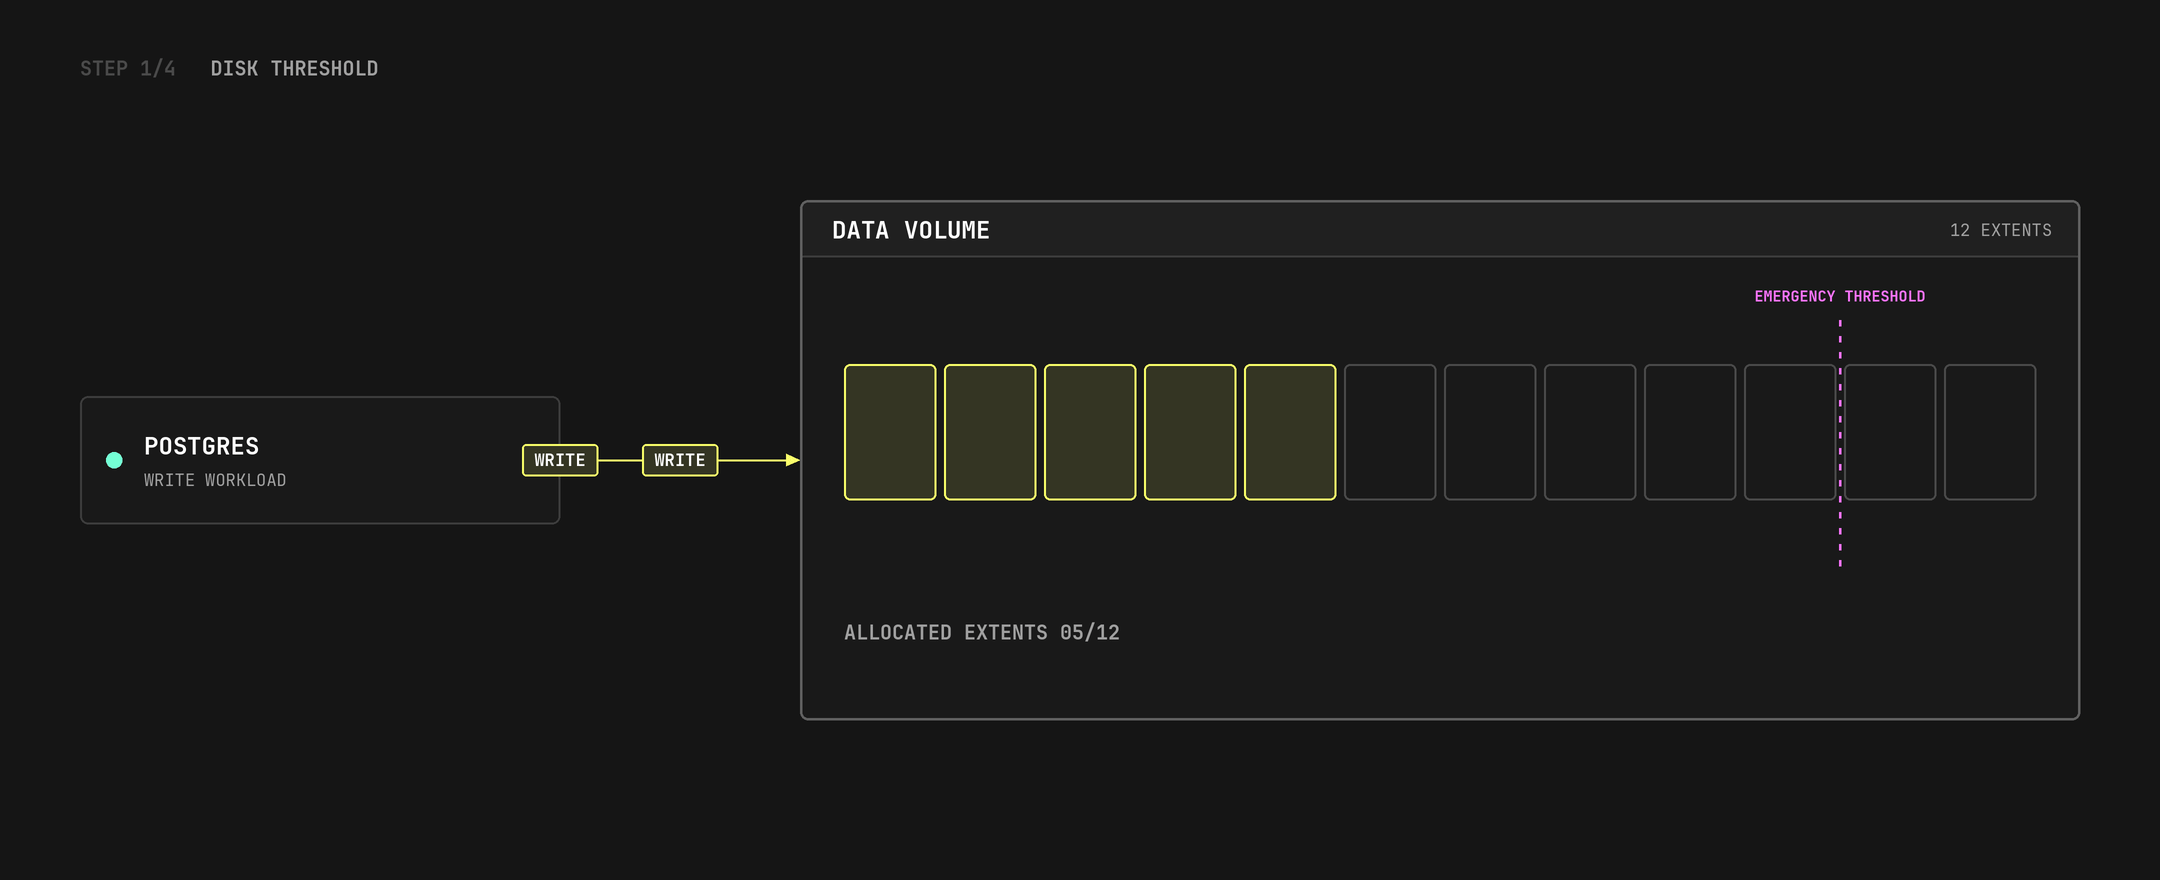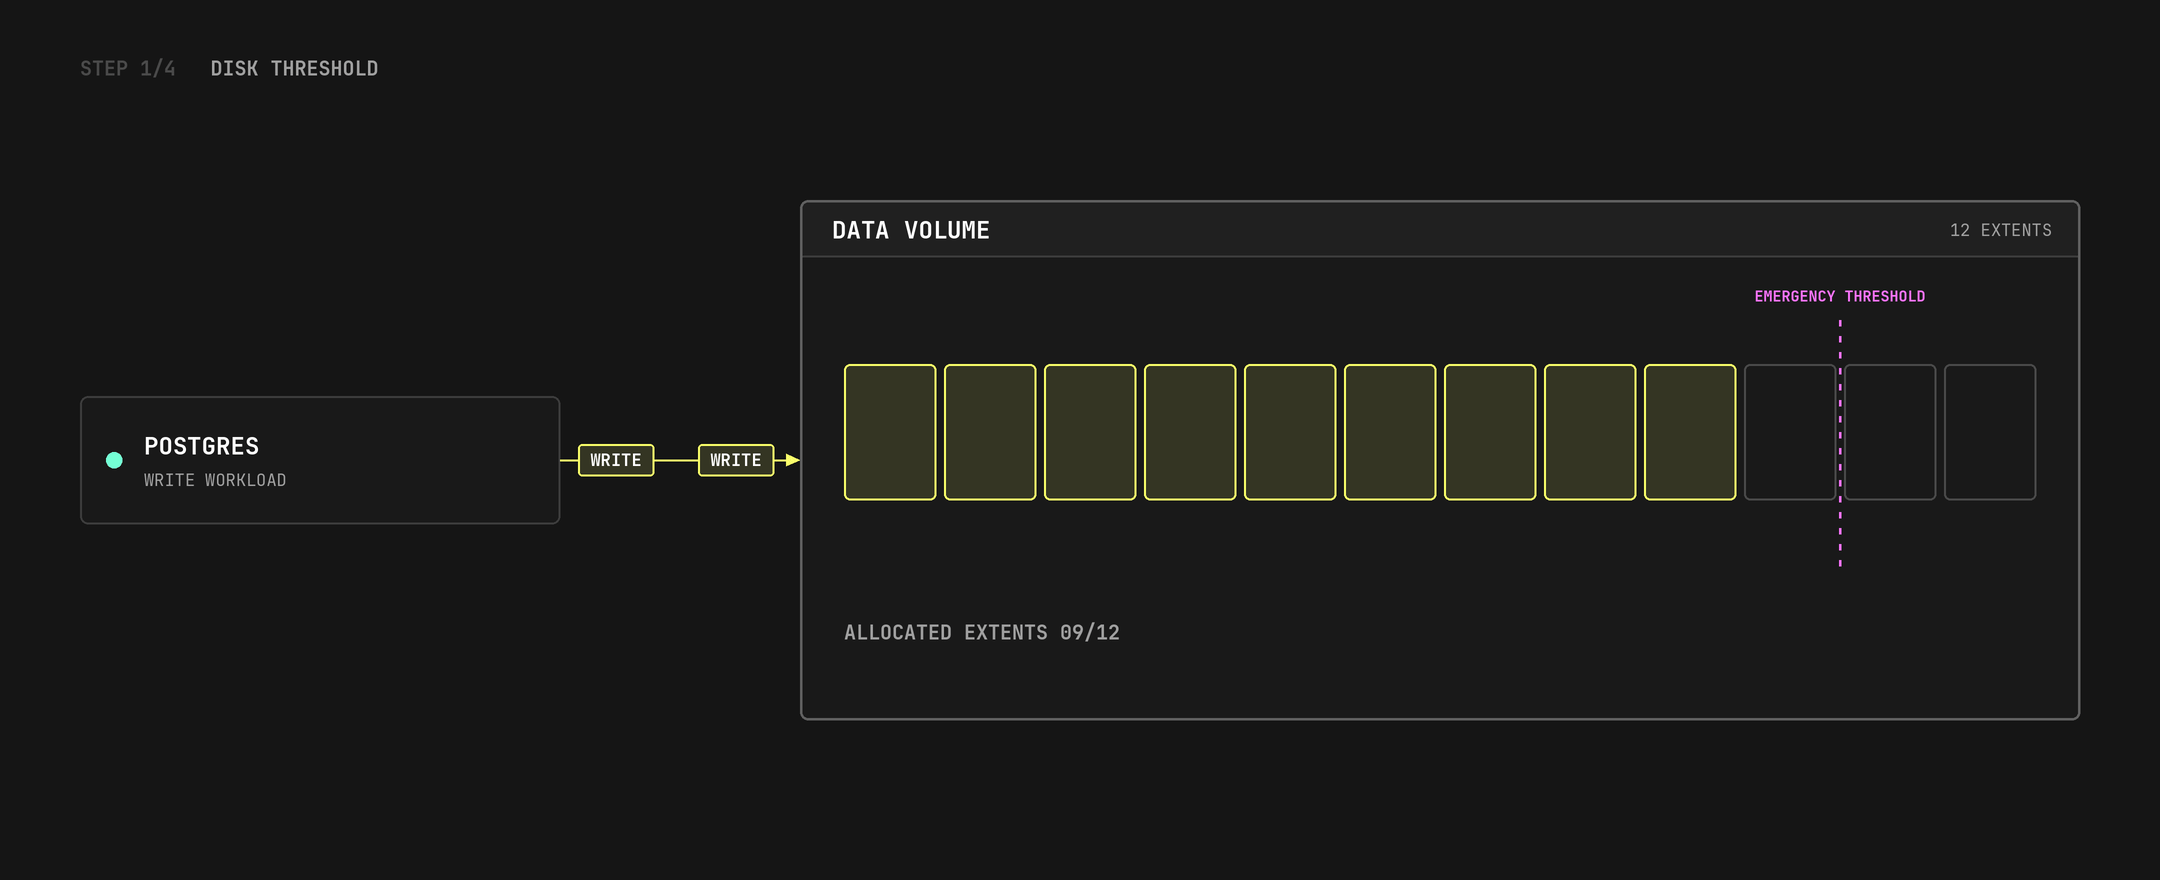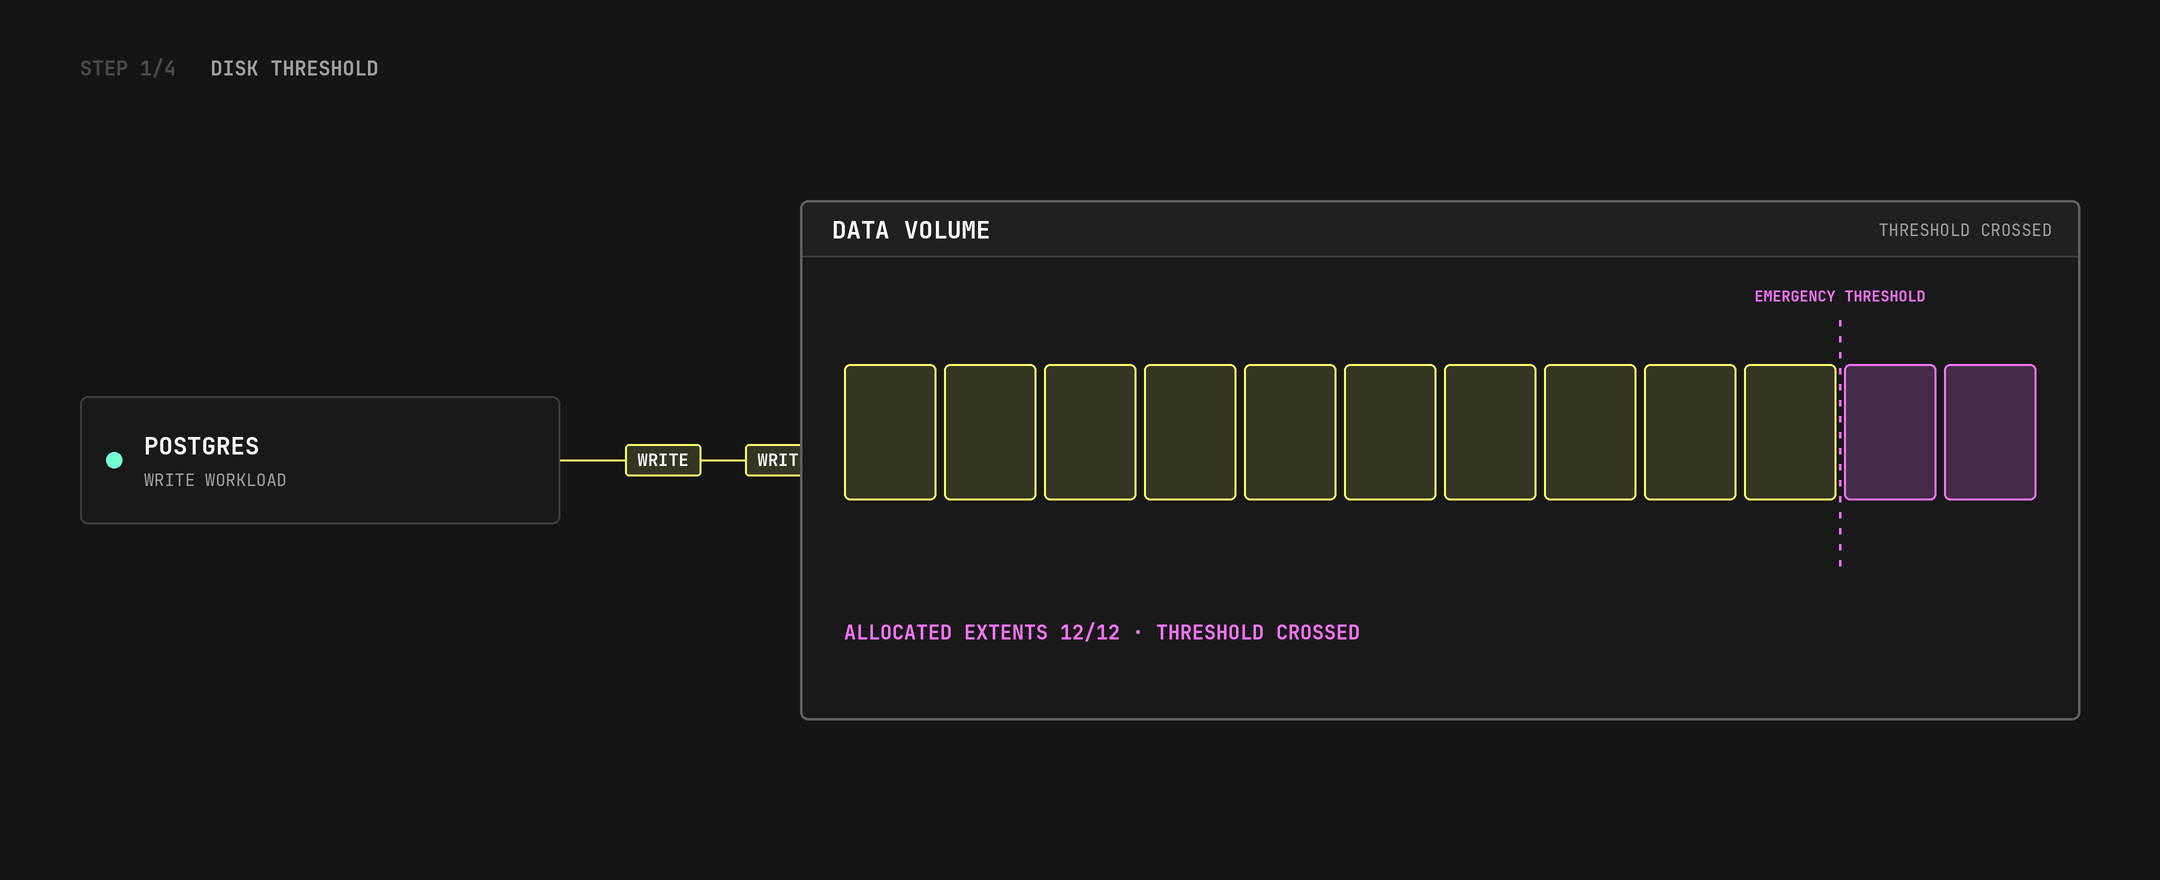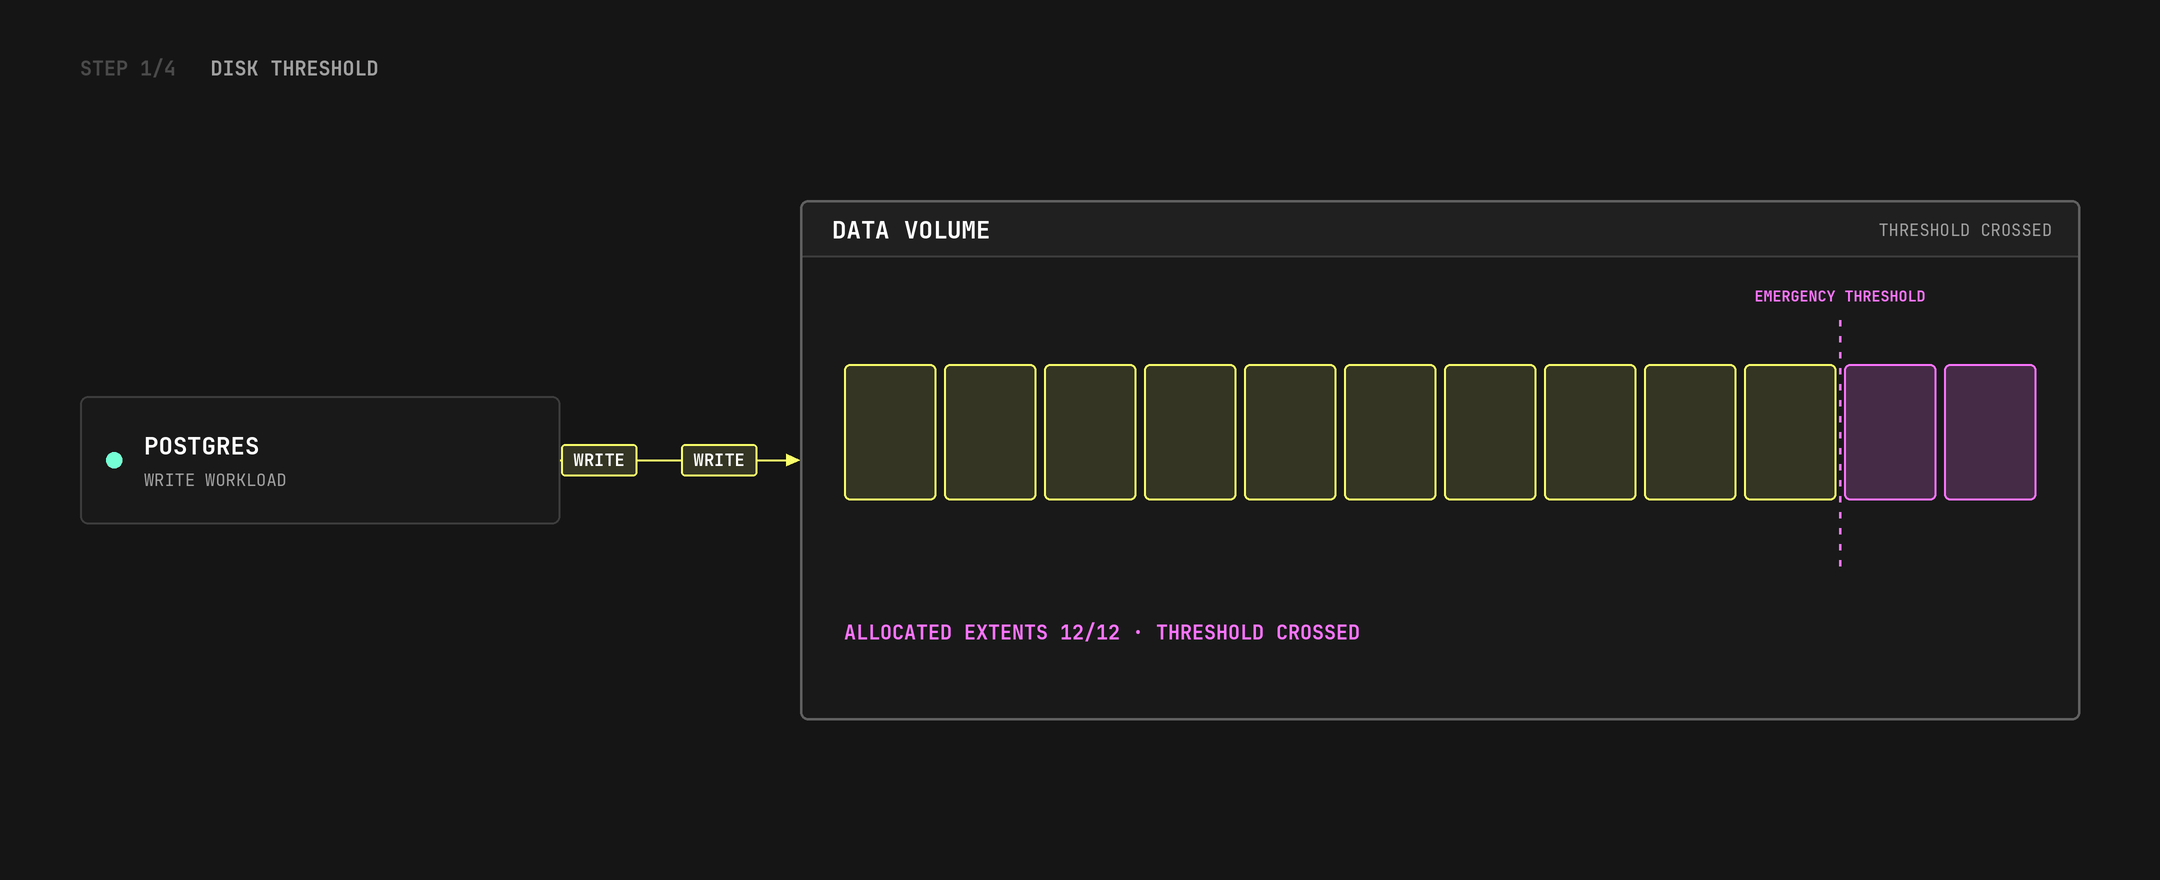
強制終了は無差別に実行されるわけではありません。ウォッチドッグは pg_stat_activity を読み取り、各バックエンドのデータベースユーザー名に基づいて、維持するか強制終了するかを判定します。
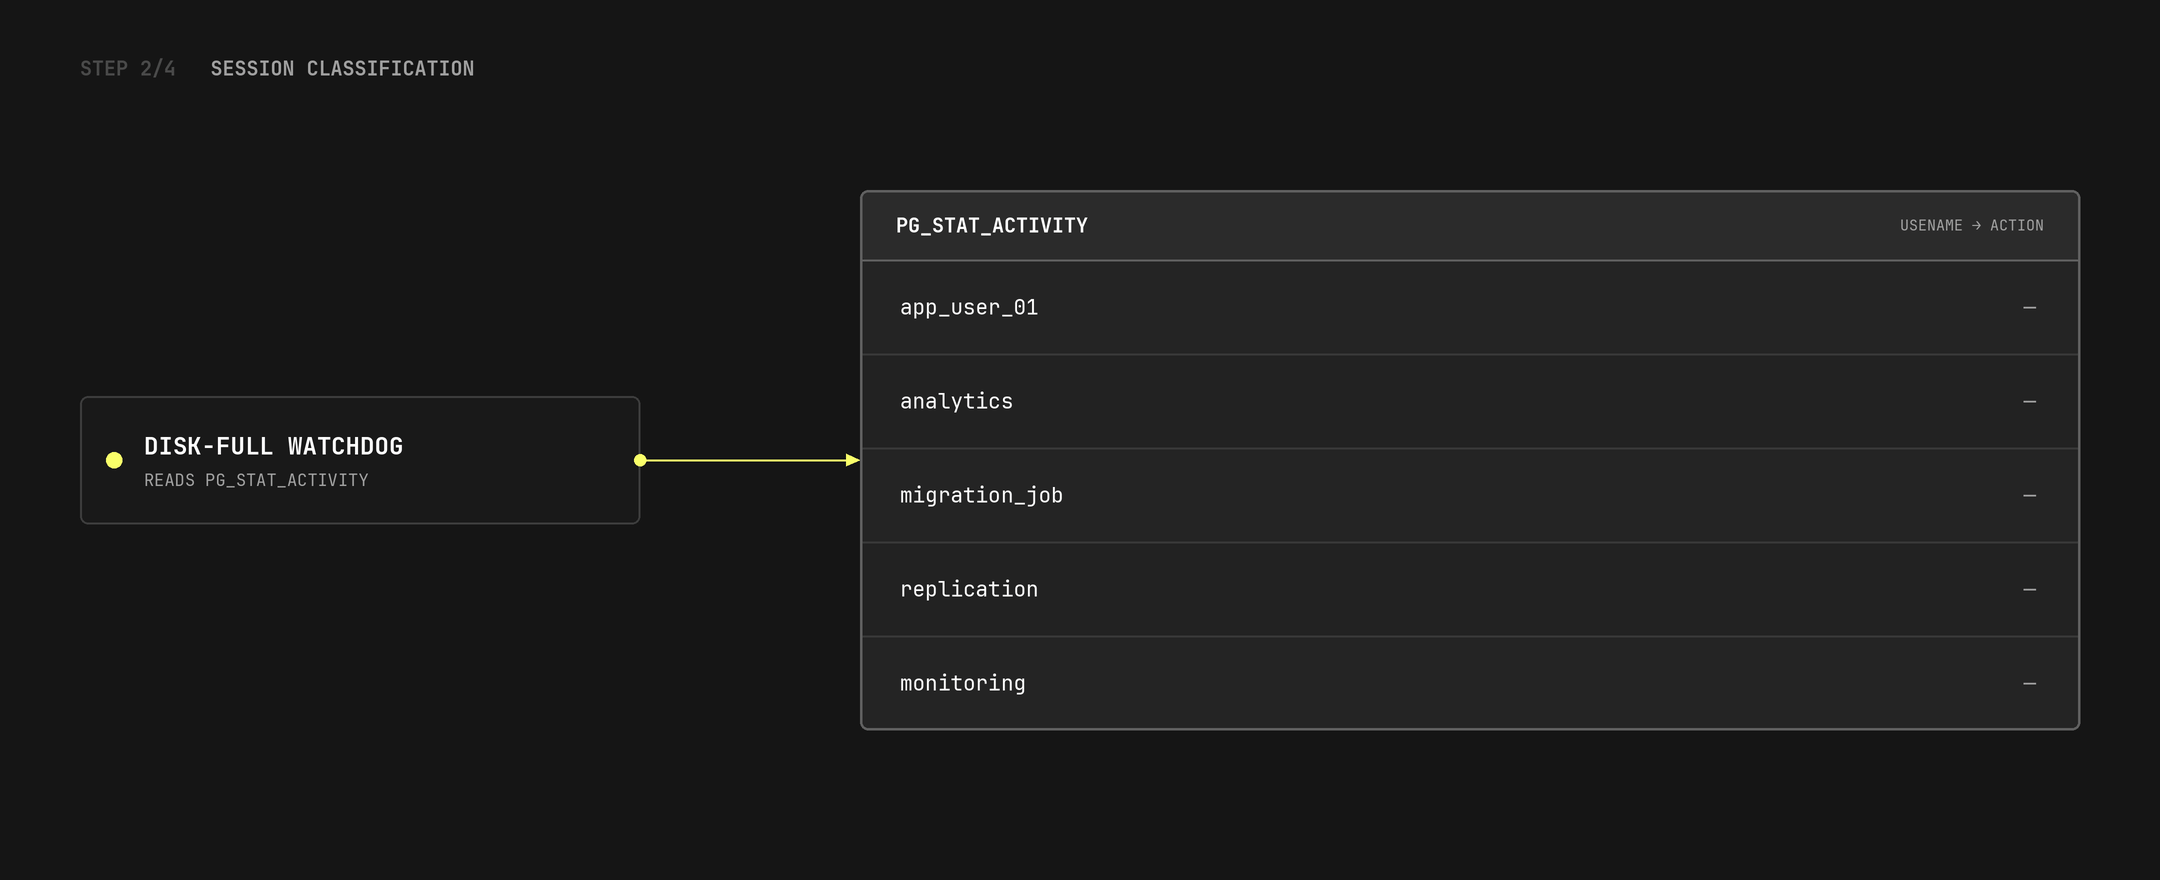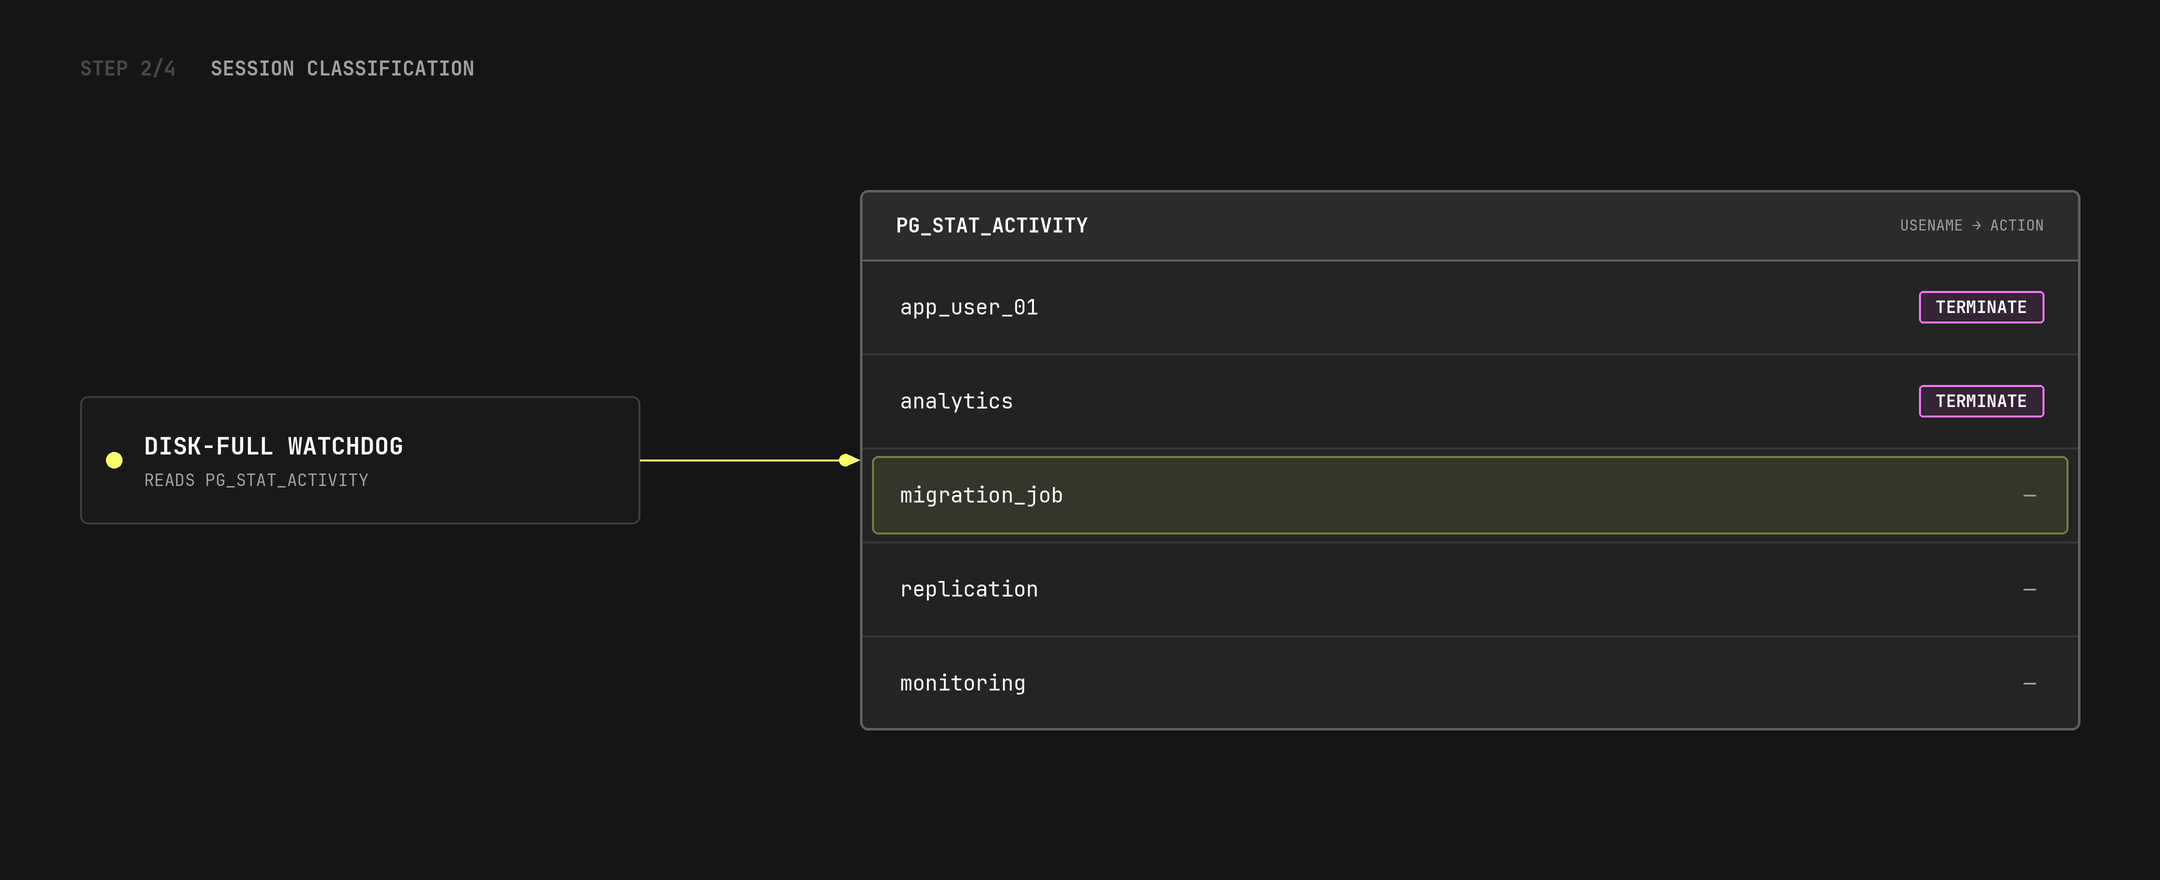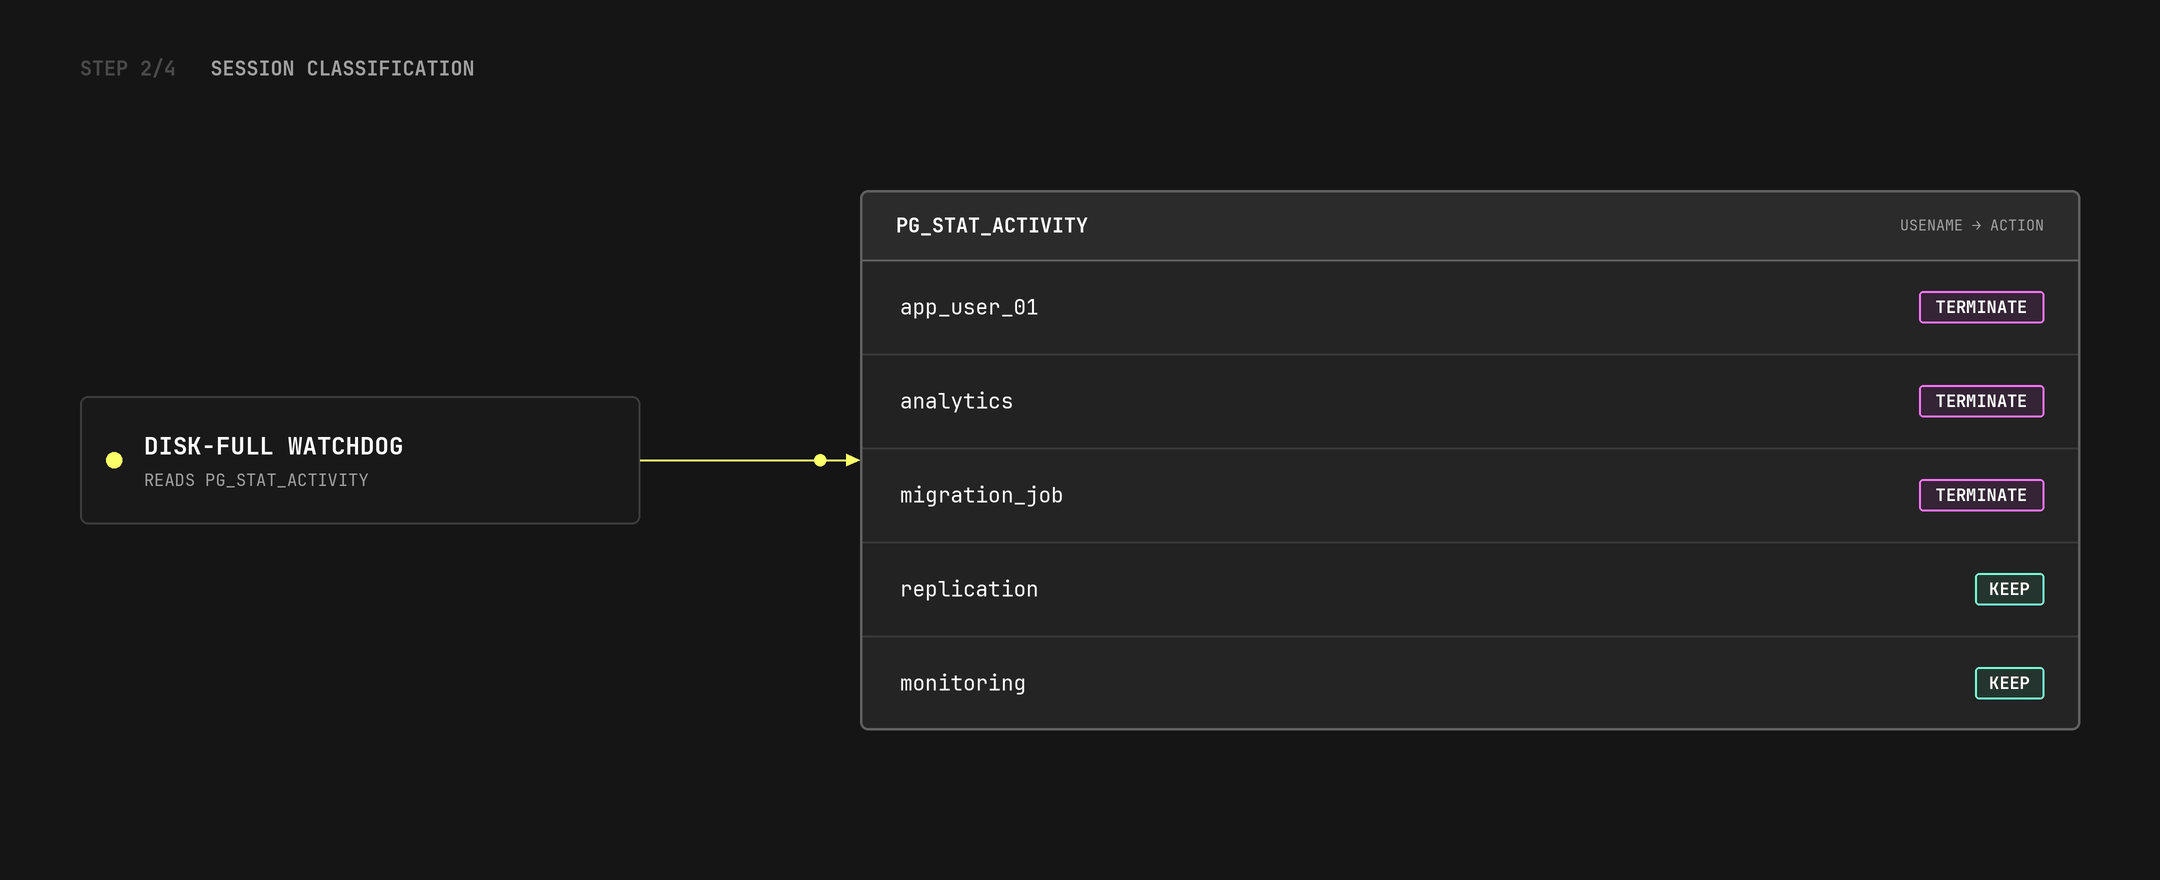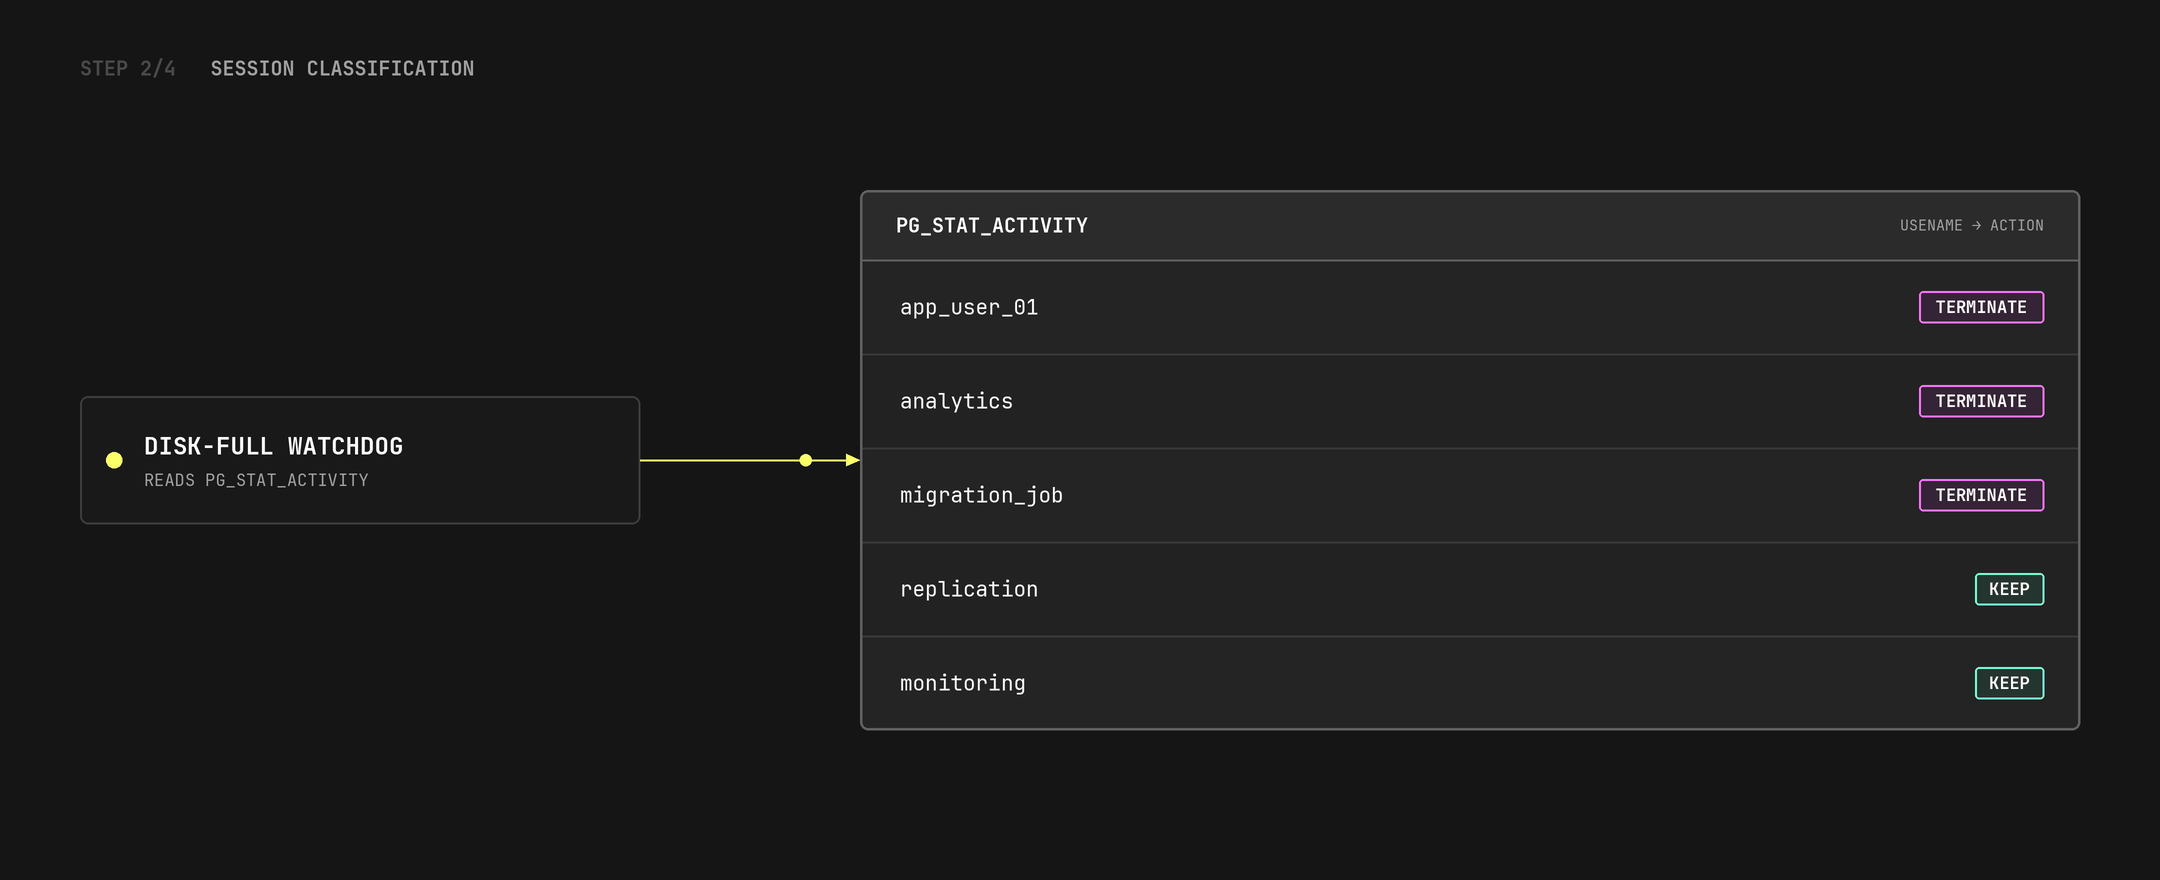
その後、通常のアプリケーションユーザー名のセッションが強制終了され、それらによる書き込み経路が即座に遮断されます。
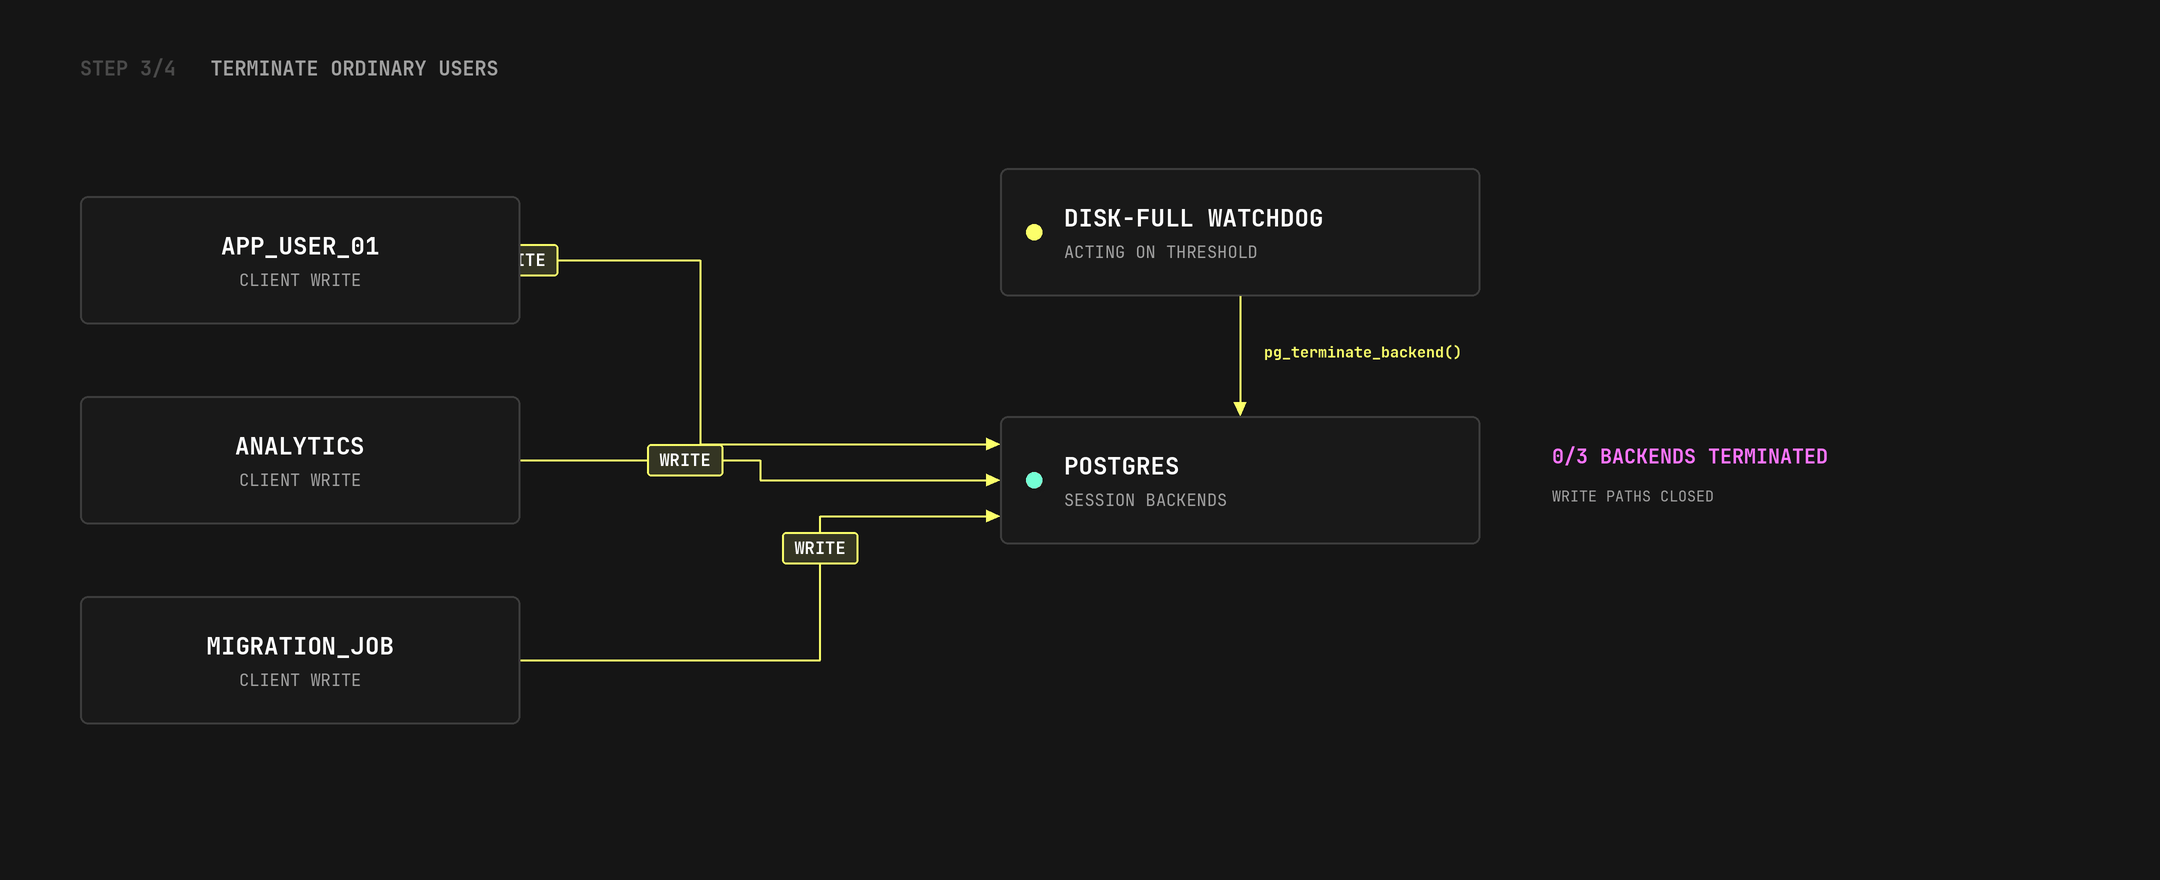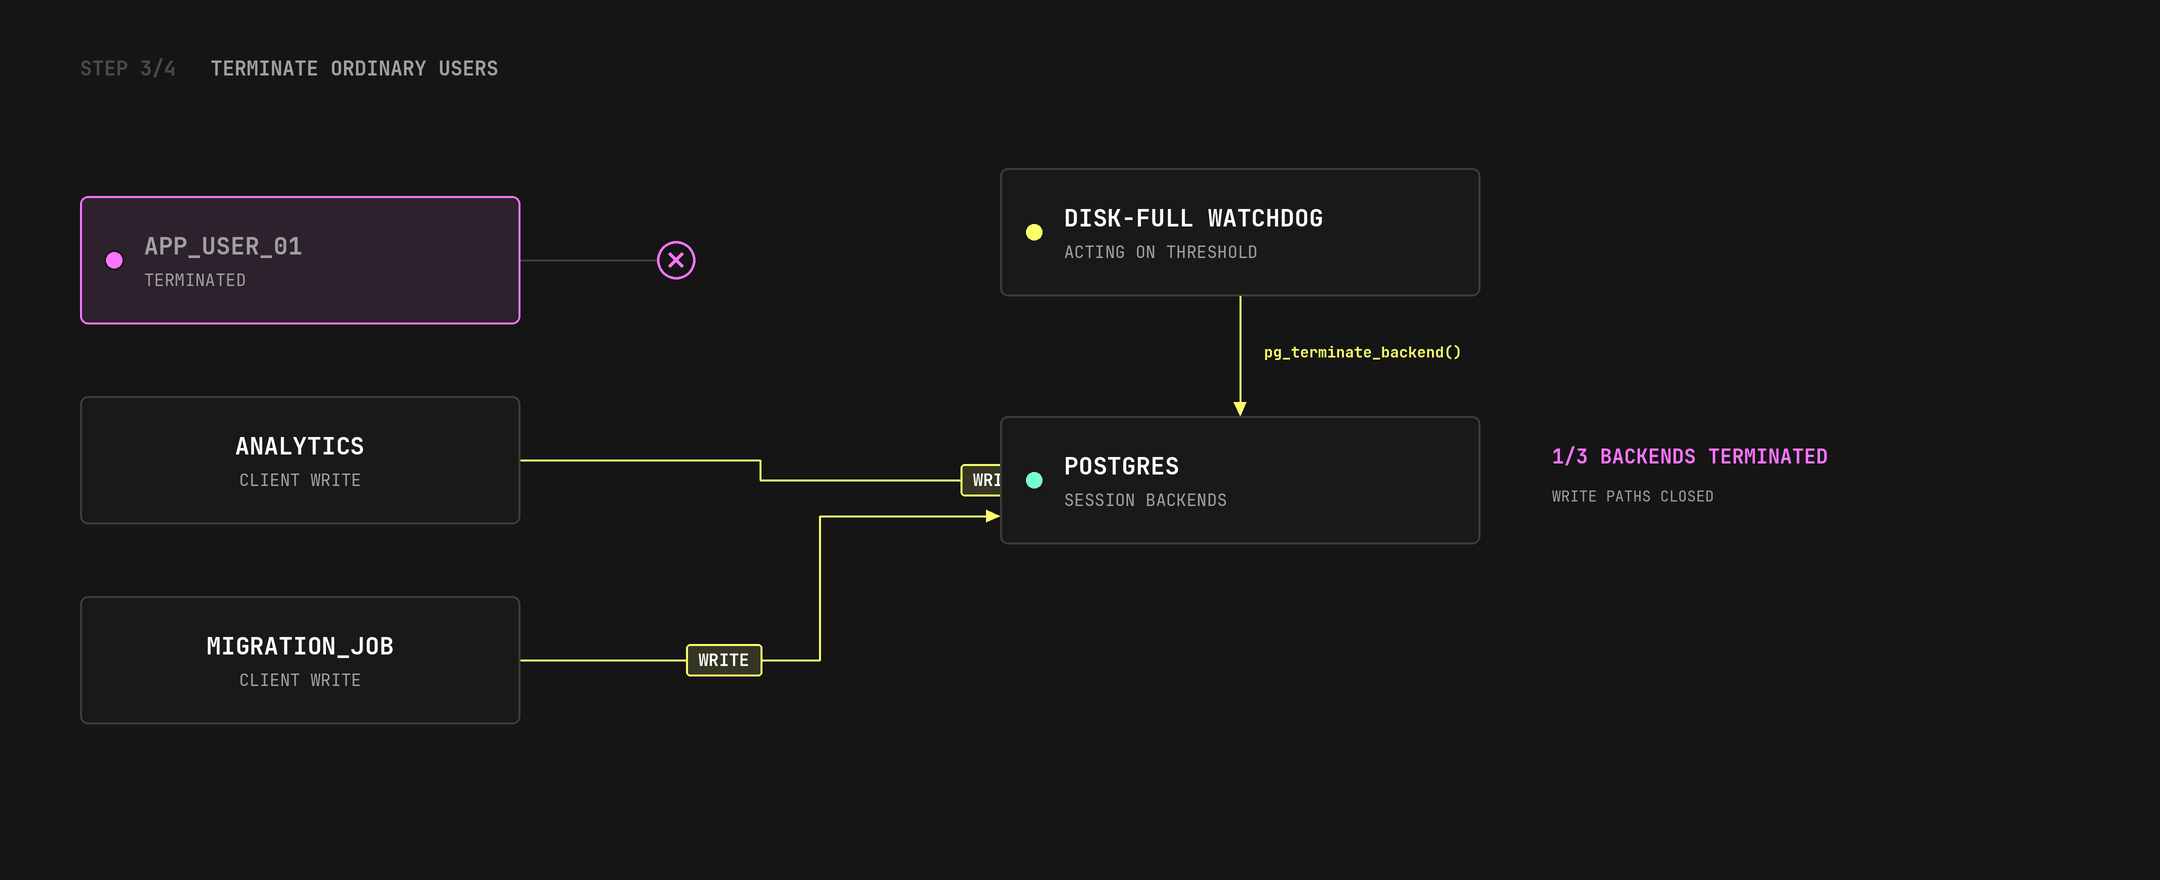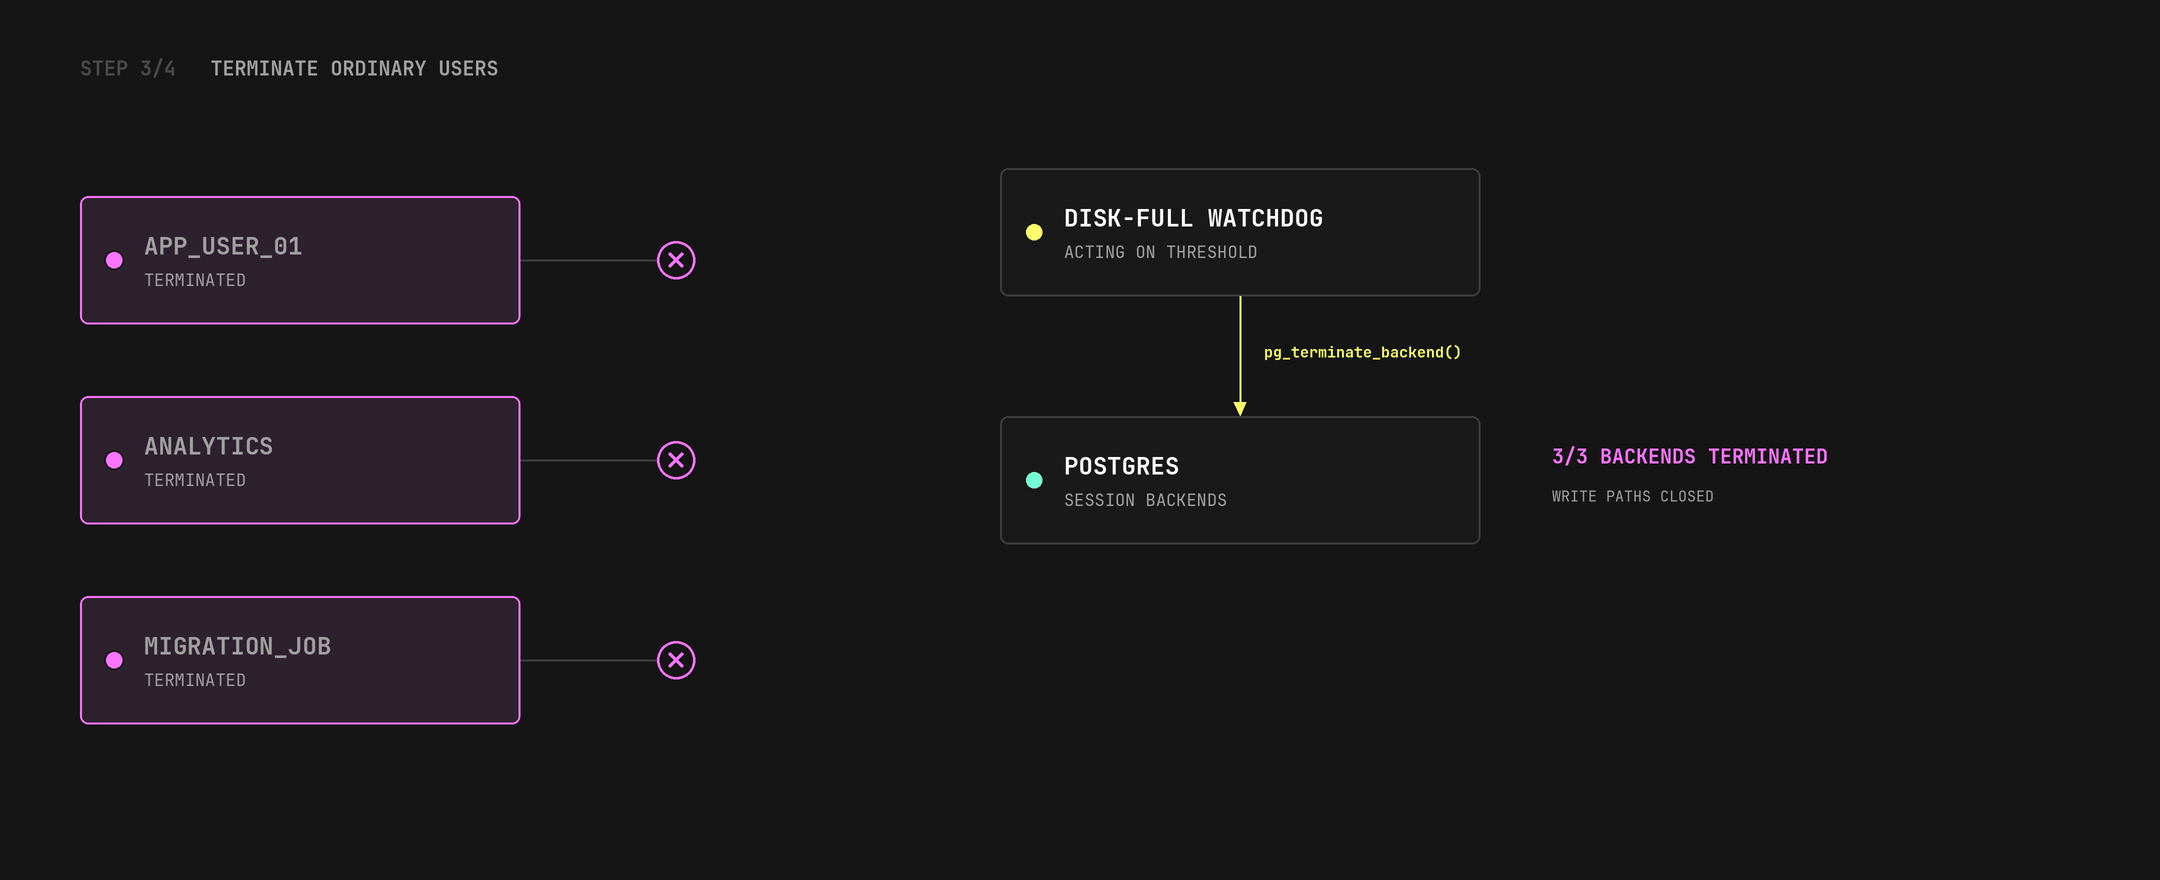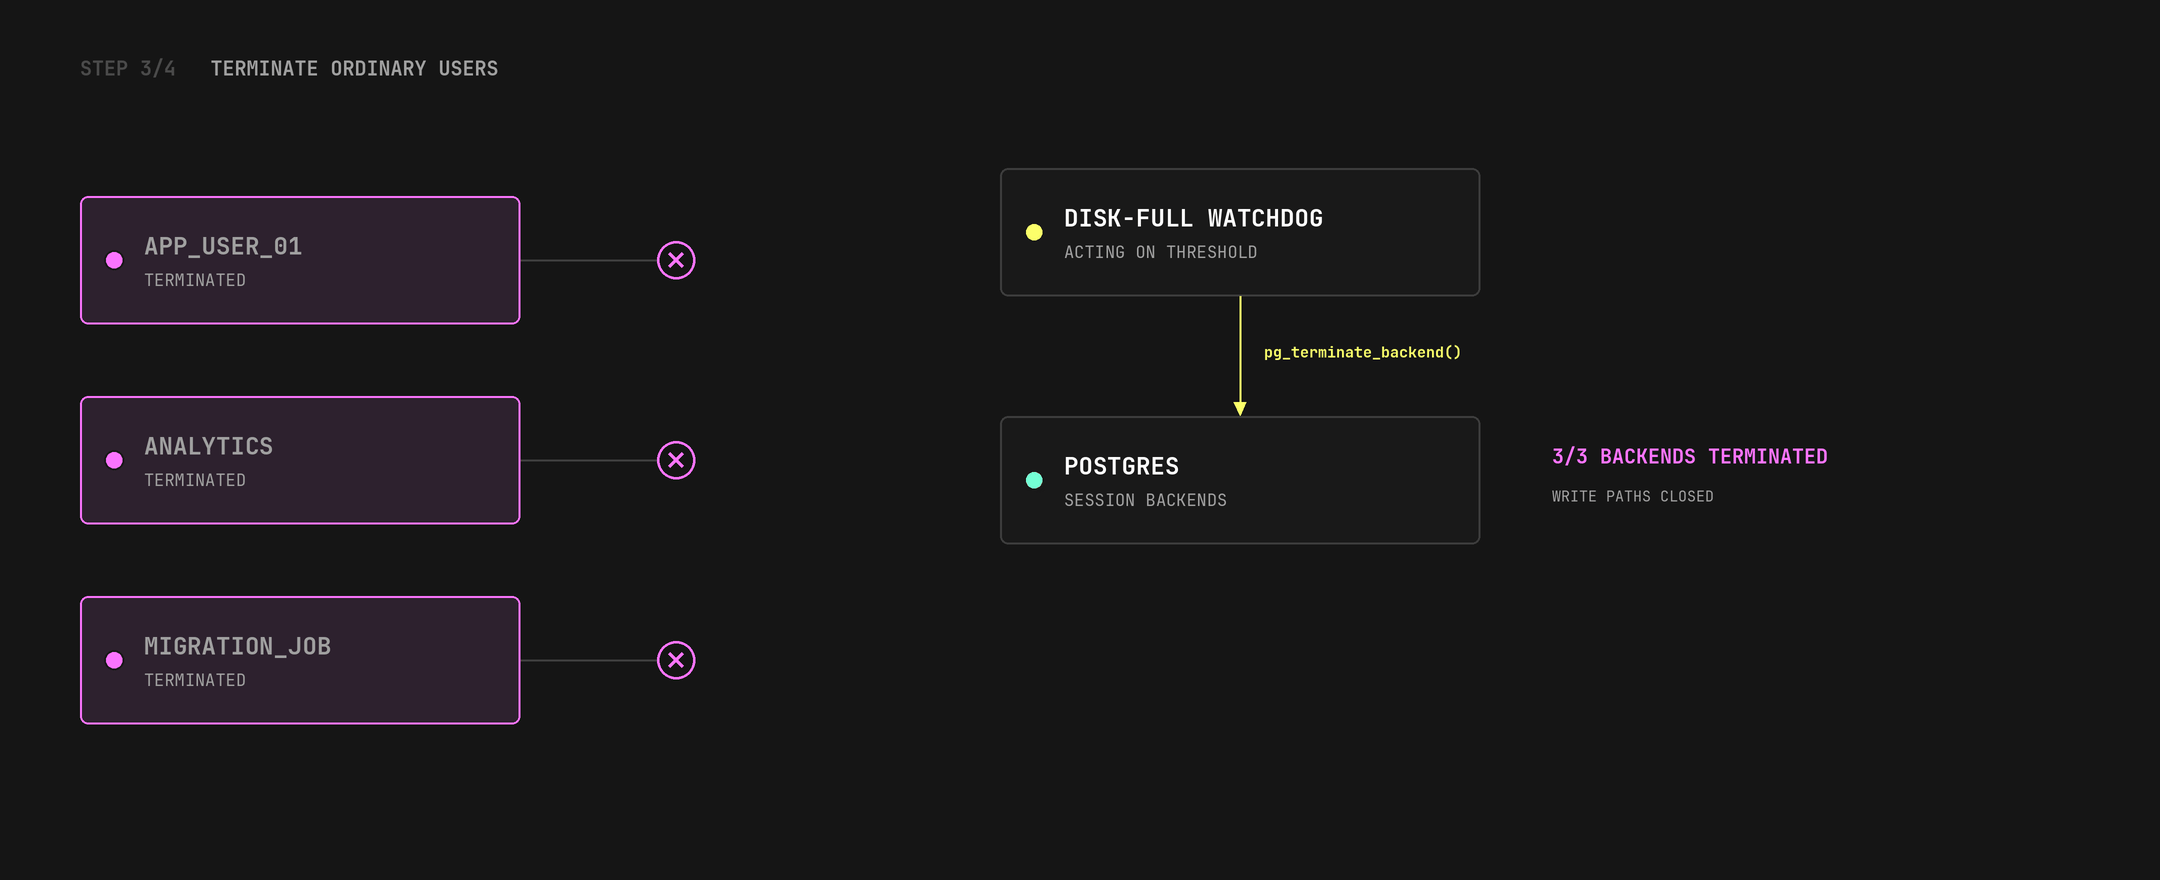
レプリケーションを除外することで、スタンバイへの WAL ストリーミングを維持します。監視を除外することで、インシデント中もオペレーターや自動化システムがデータベースメトリクスを取得し続けられるようにします。
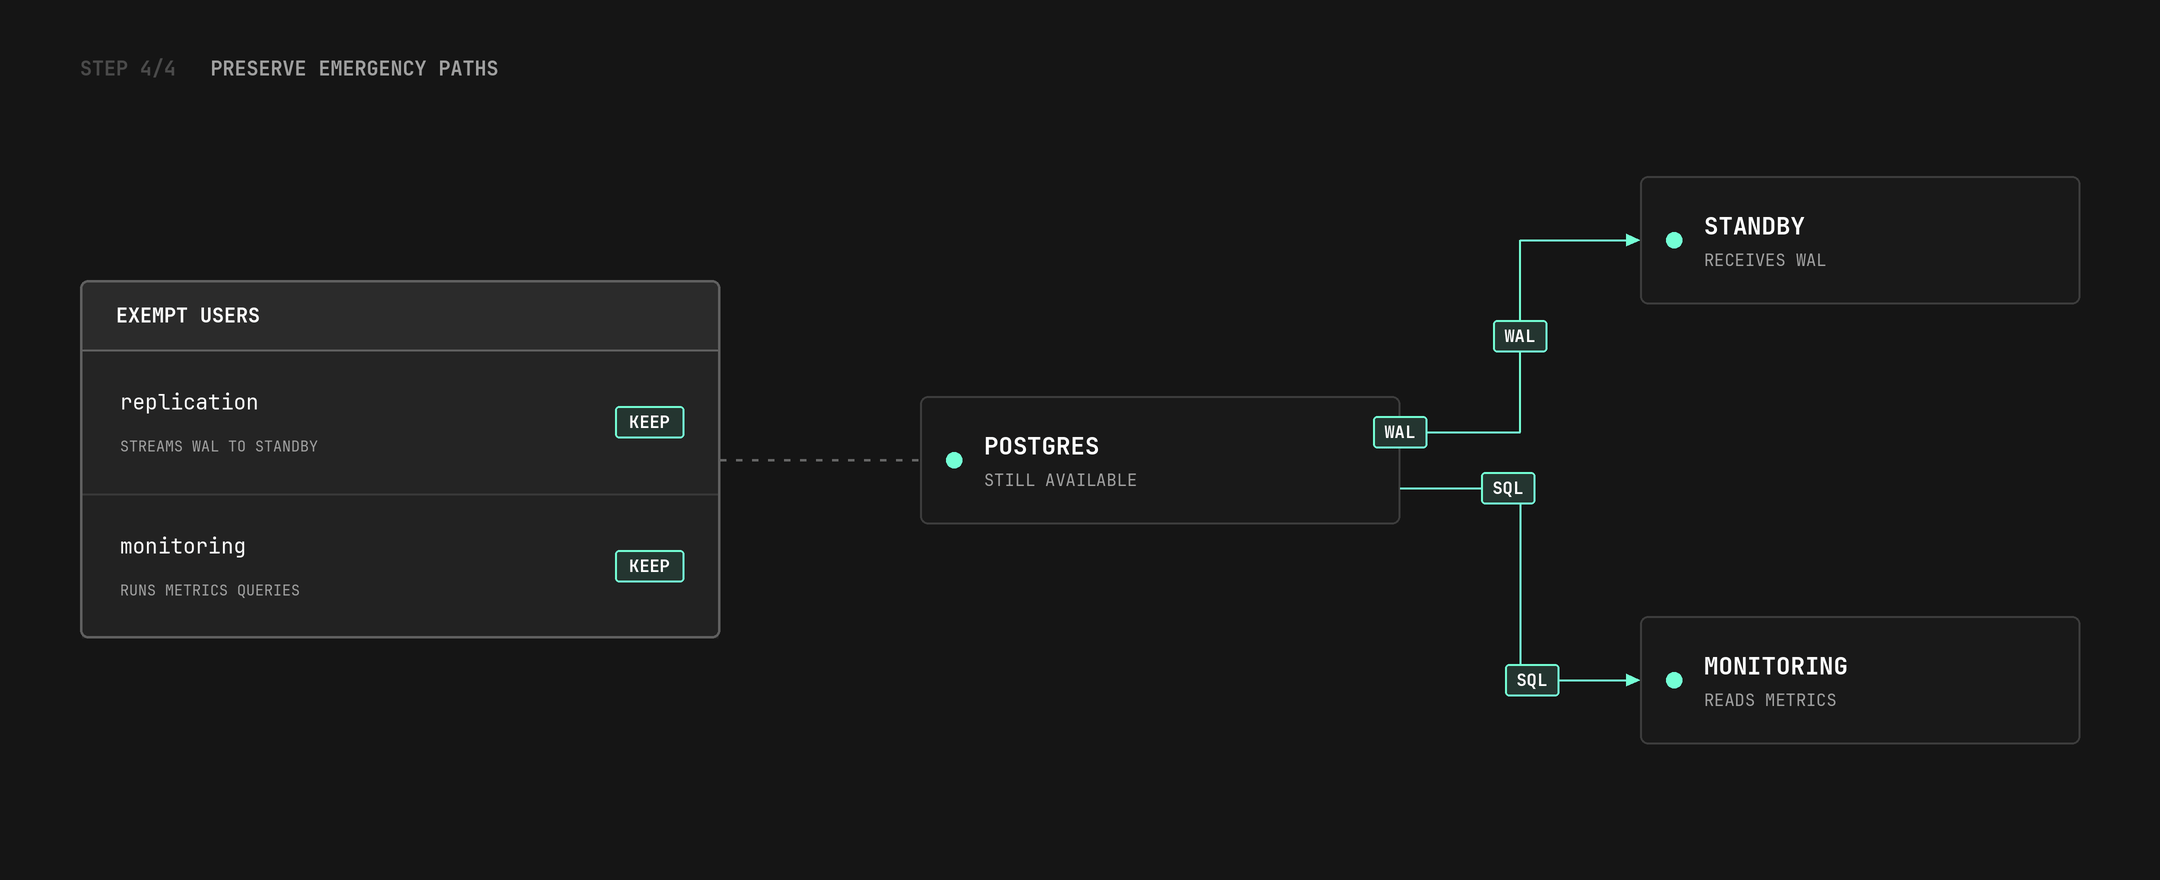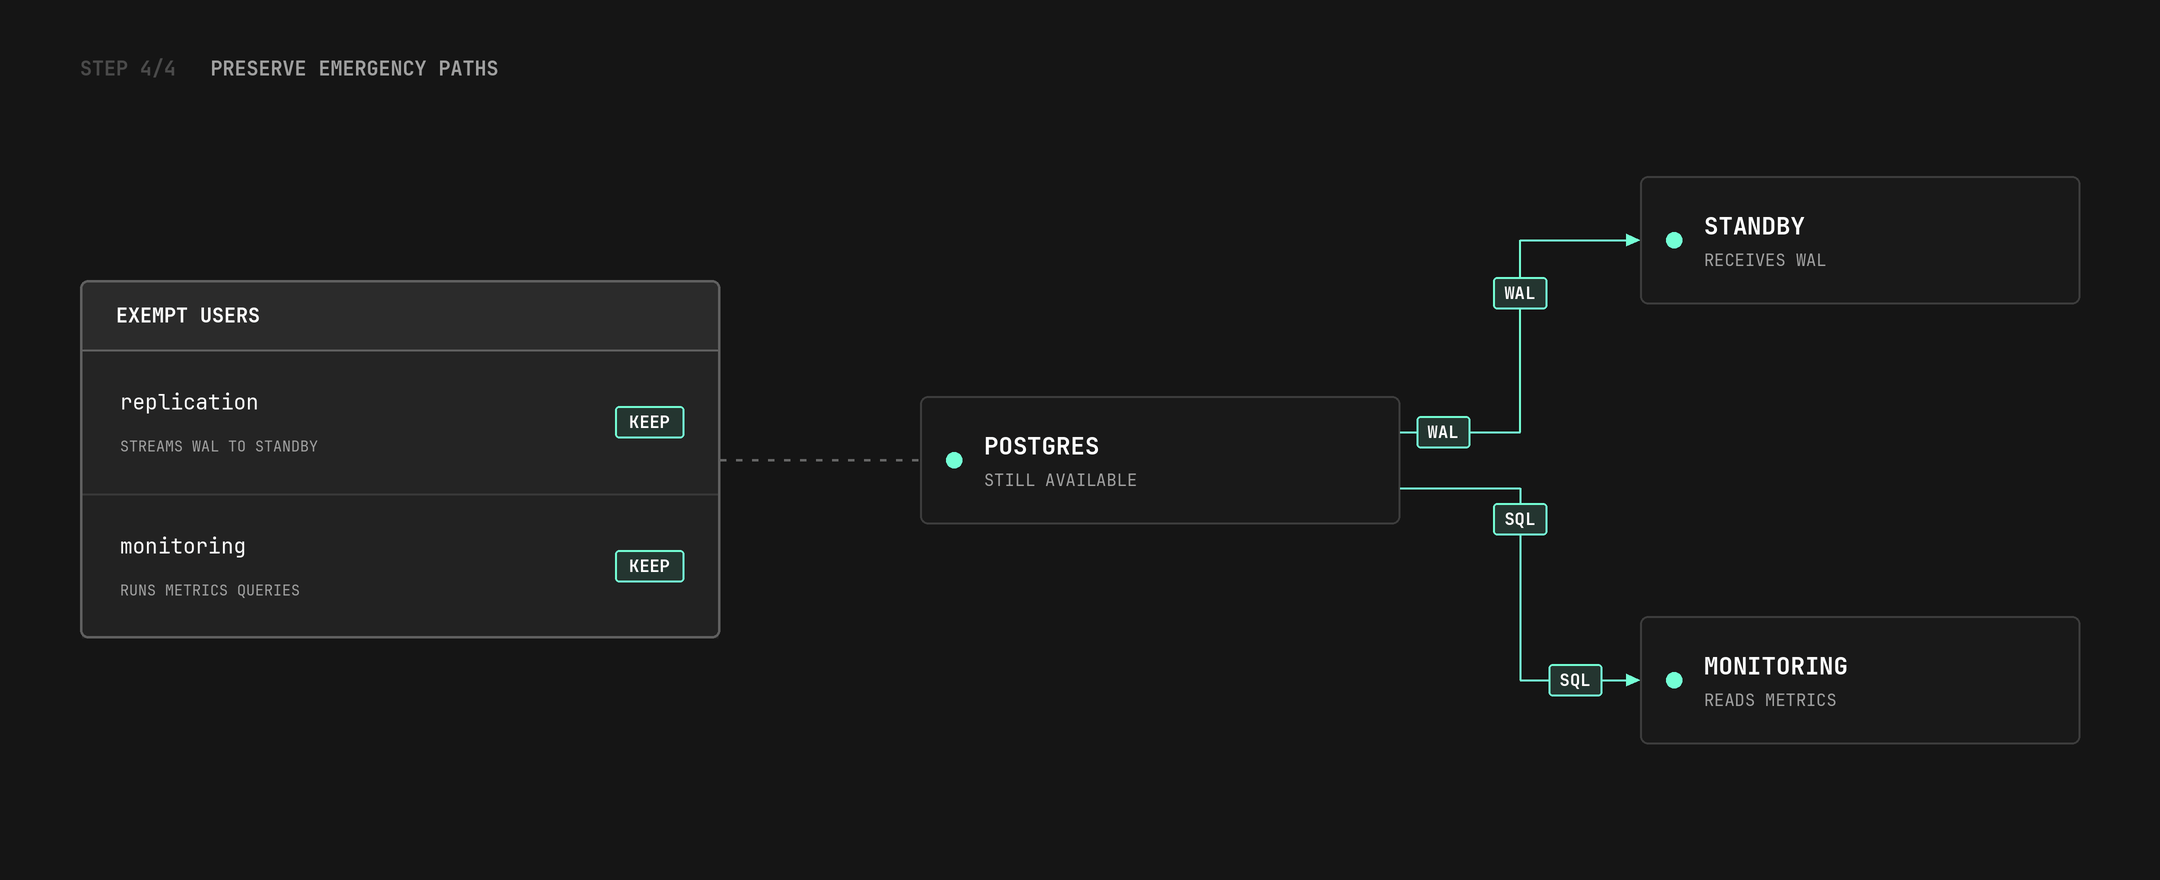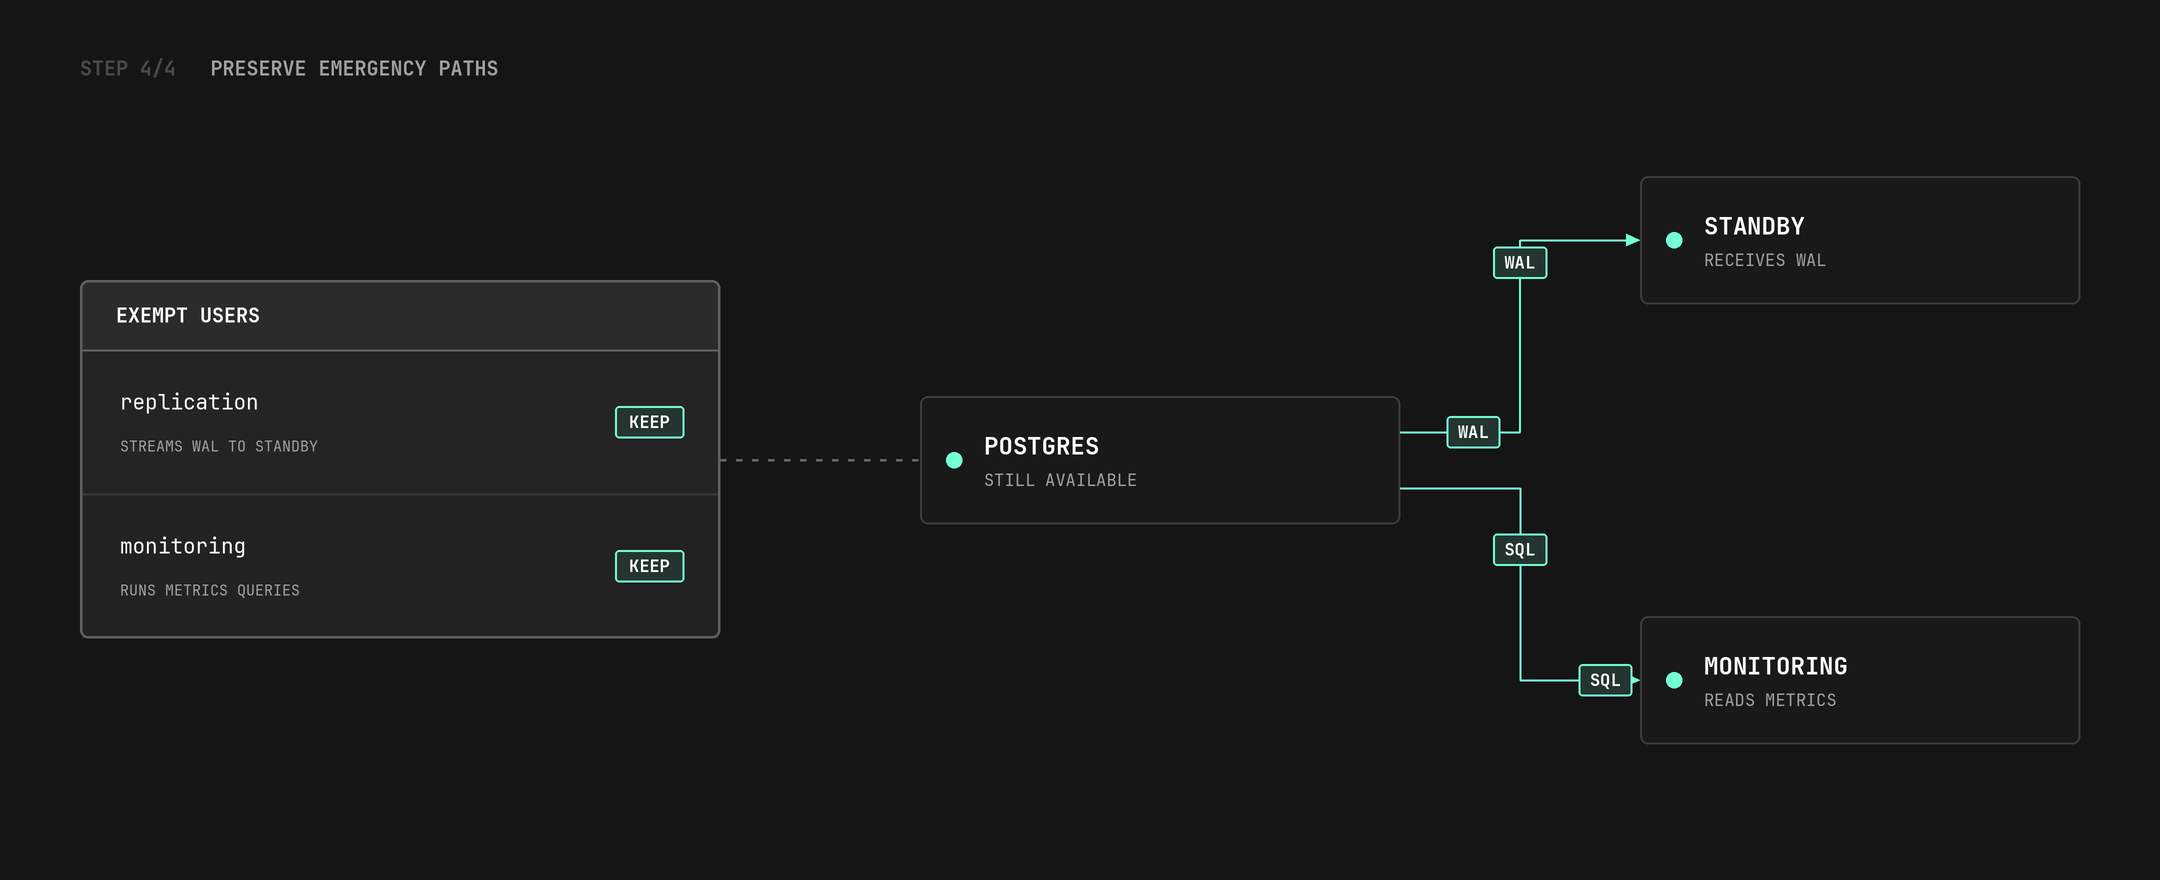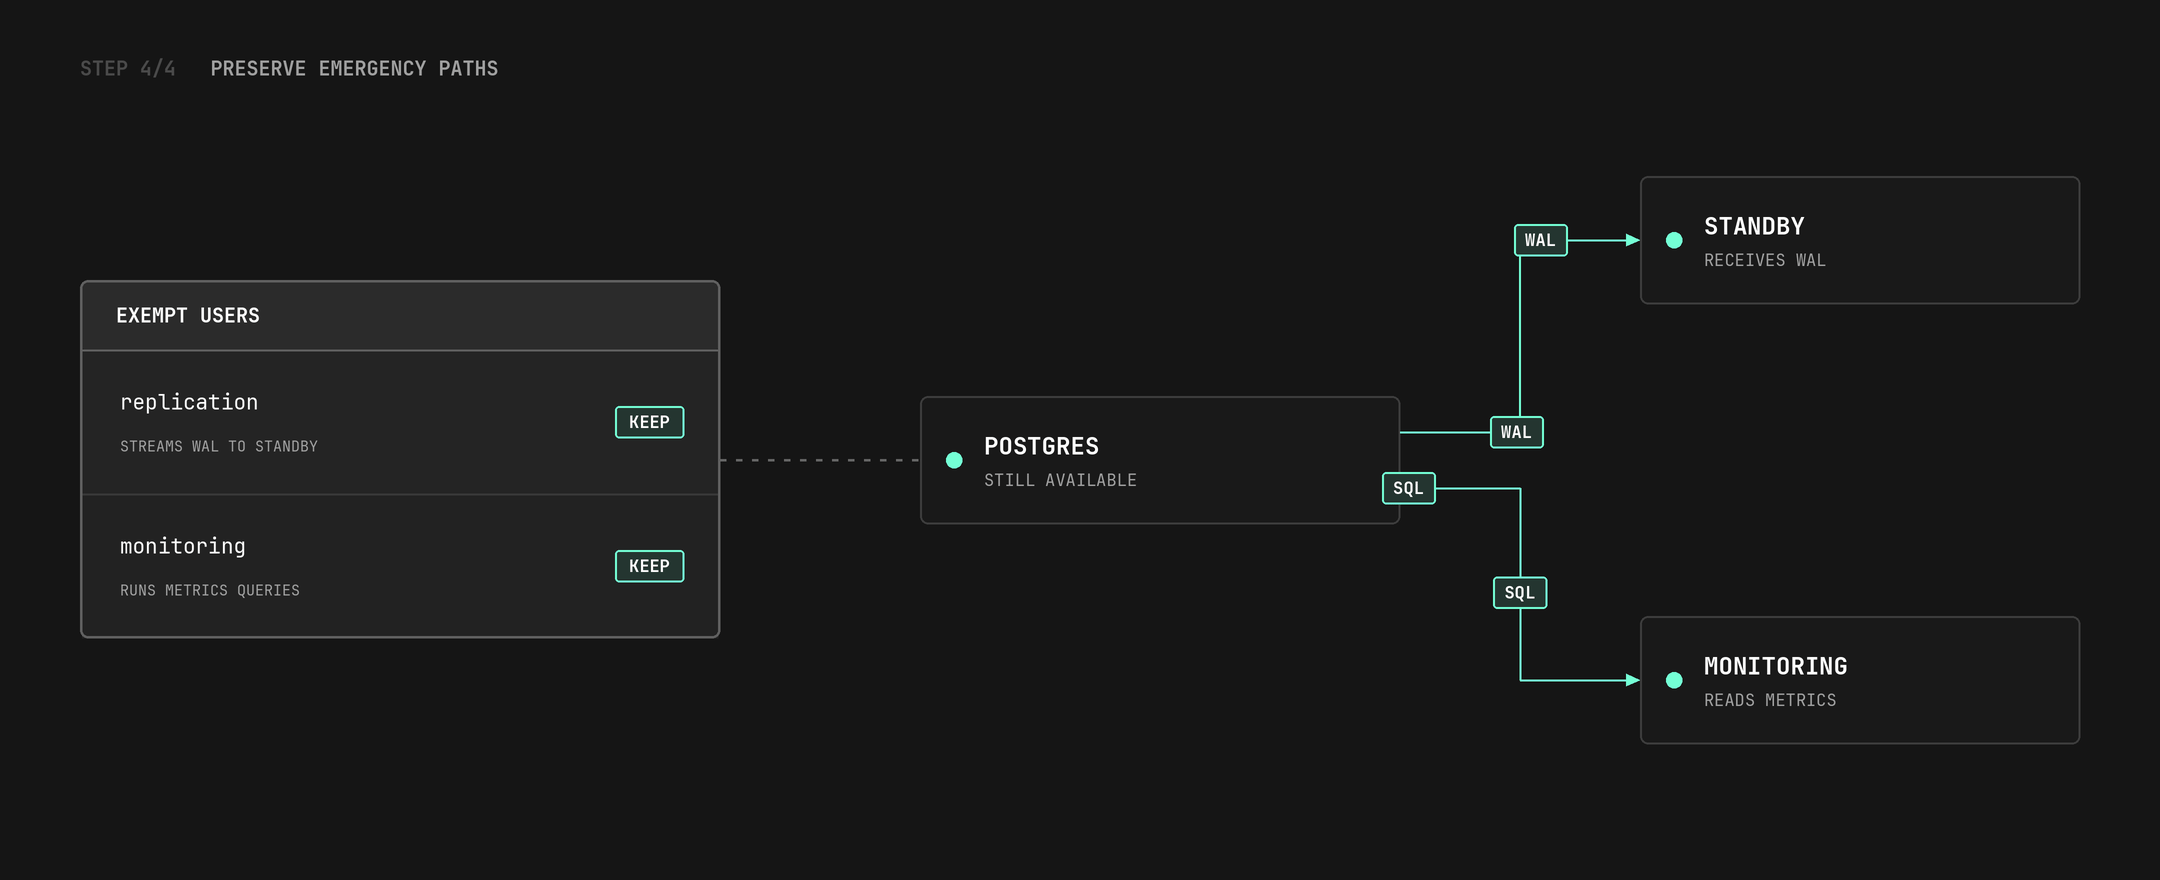
バックアップエージェントには上限付きのメモリ割り当てと低い CPU 重み付けが設定されます。Prometheus はホストサービス用 cgroup にチャージされます。ディスクウォッチドッグはレプリケーションと監視のロールを明示的に保護します。これらの制御により、定義されたリソース制限の範囲内で、バックアップ、レプリケーション、オブザーバビリティの可用性を維持しています。
実現される隔離モデル
マネージドな Postgres サーバーは、協調して動作するプロセスからなる小さなシステムです。信頼性を確保できるかどうかは、すべてのサポートサービスを保護機能であると同時にプレッシャーの潜在的要因としても扱うことにかかっています。ランタイムには理解可能な予算を与え、カーネルには強制力のある上限を与え、緊急時の経路は対処対象となる障害の影響を受けない場所に維持するのです。
これらの制御は、すべての ClickHouse Managed Postgres サーバーでデフォルトで有効化されています。
ClickHouse Managed Postgres を今すぐ始める
ClickHouse Managed Postgres が自社のデータでどのように機能するか試してみませんか?数分で ClickHouse Cloud を使い始めることができ、300 ドル分の無料クレジットも進呈されます。
サインアップ