5万

新しい Postgres 拡張 chdb を発表できることをうれしく思います。この拡張は、インプロセスの ClickHouse エンジンである chDB ライブラリ を使って、Postgres の インポートとエクスポートの機能を広げます。お使いのクラウドストレージにある多様な データ形式 を、 効率的かつ柔軟に相互変換できます。
ベンチマーク
ここで言う 効率的 は、誇張ではありません。いくつかのデータ形式で NYC タクシーデータセット(100 万行、列数の多いテーブル)をインポートし、 chdb とほかの 3 種類の Postgres 拡張の性能を比較しました。いずれも同じリージョンに配置した AWS S3 バケットから読み込んでいます。では結果のグラフを見てみましょう。
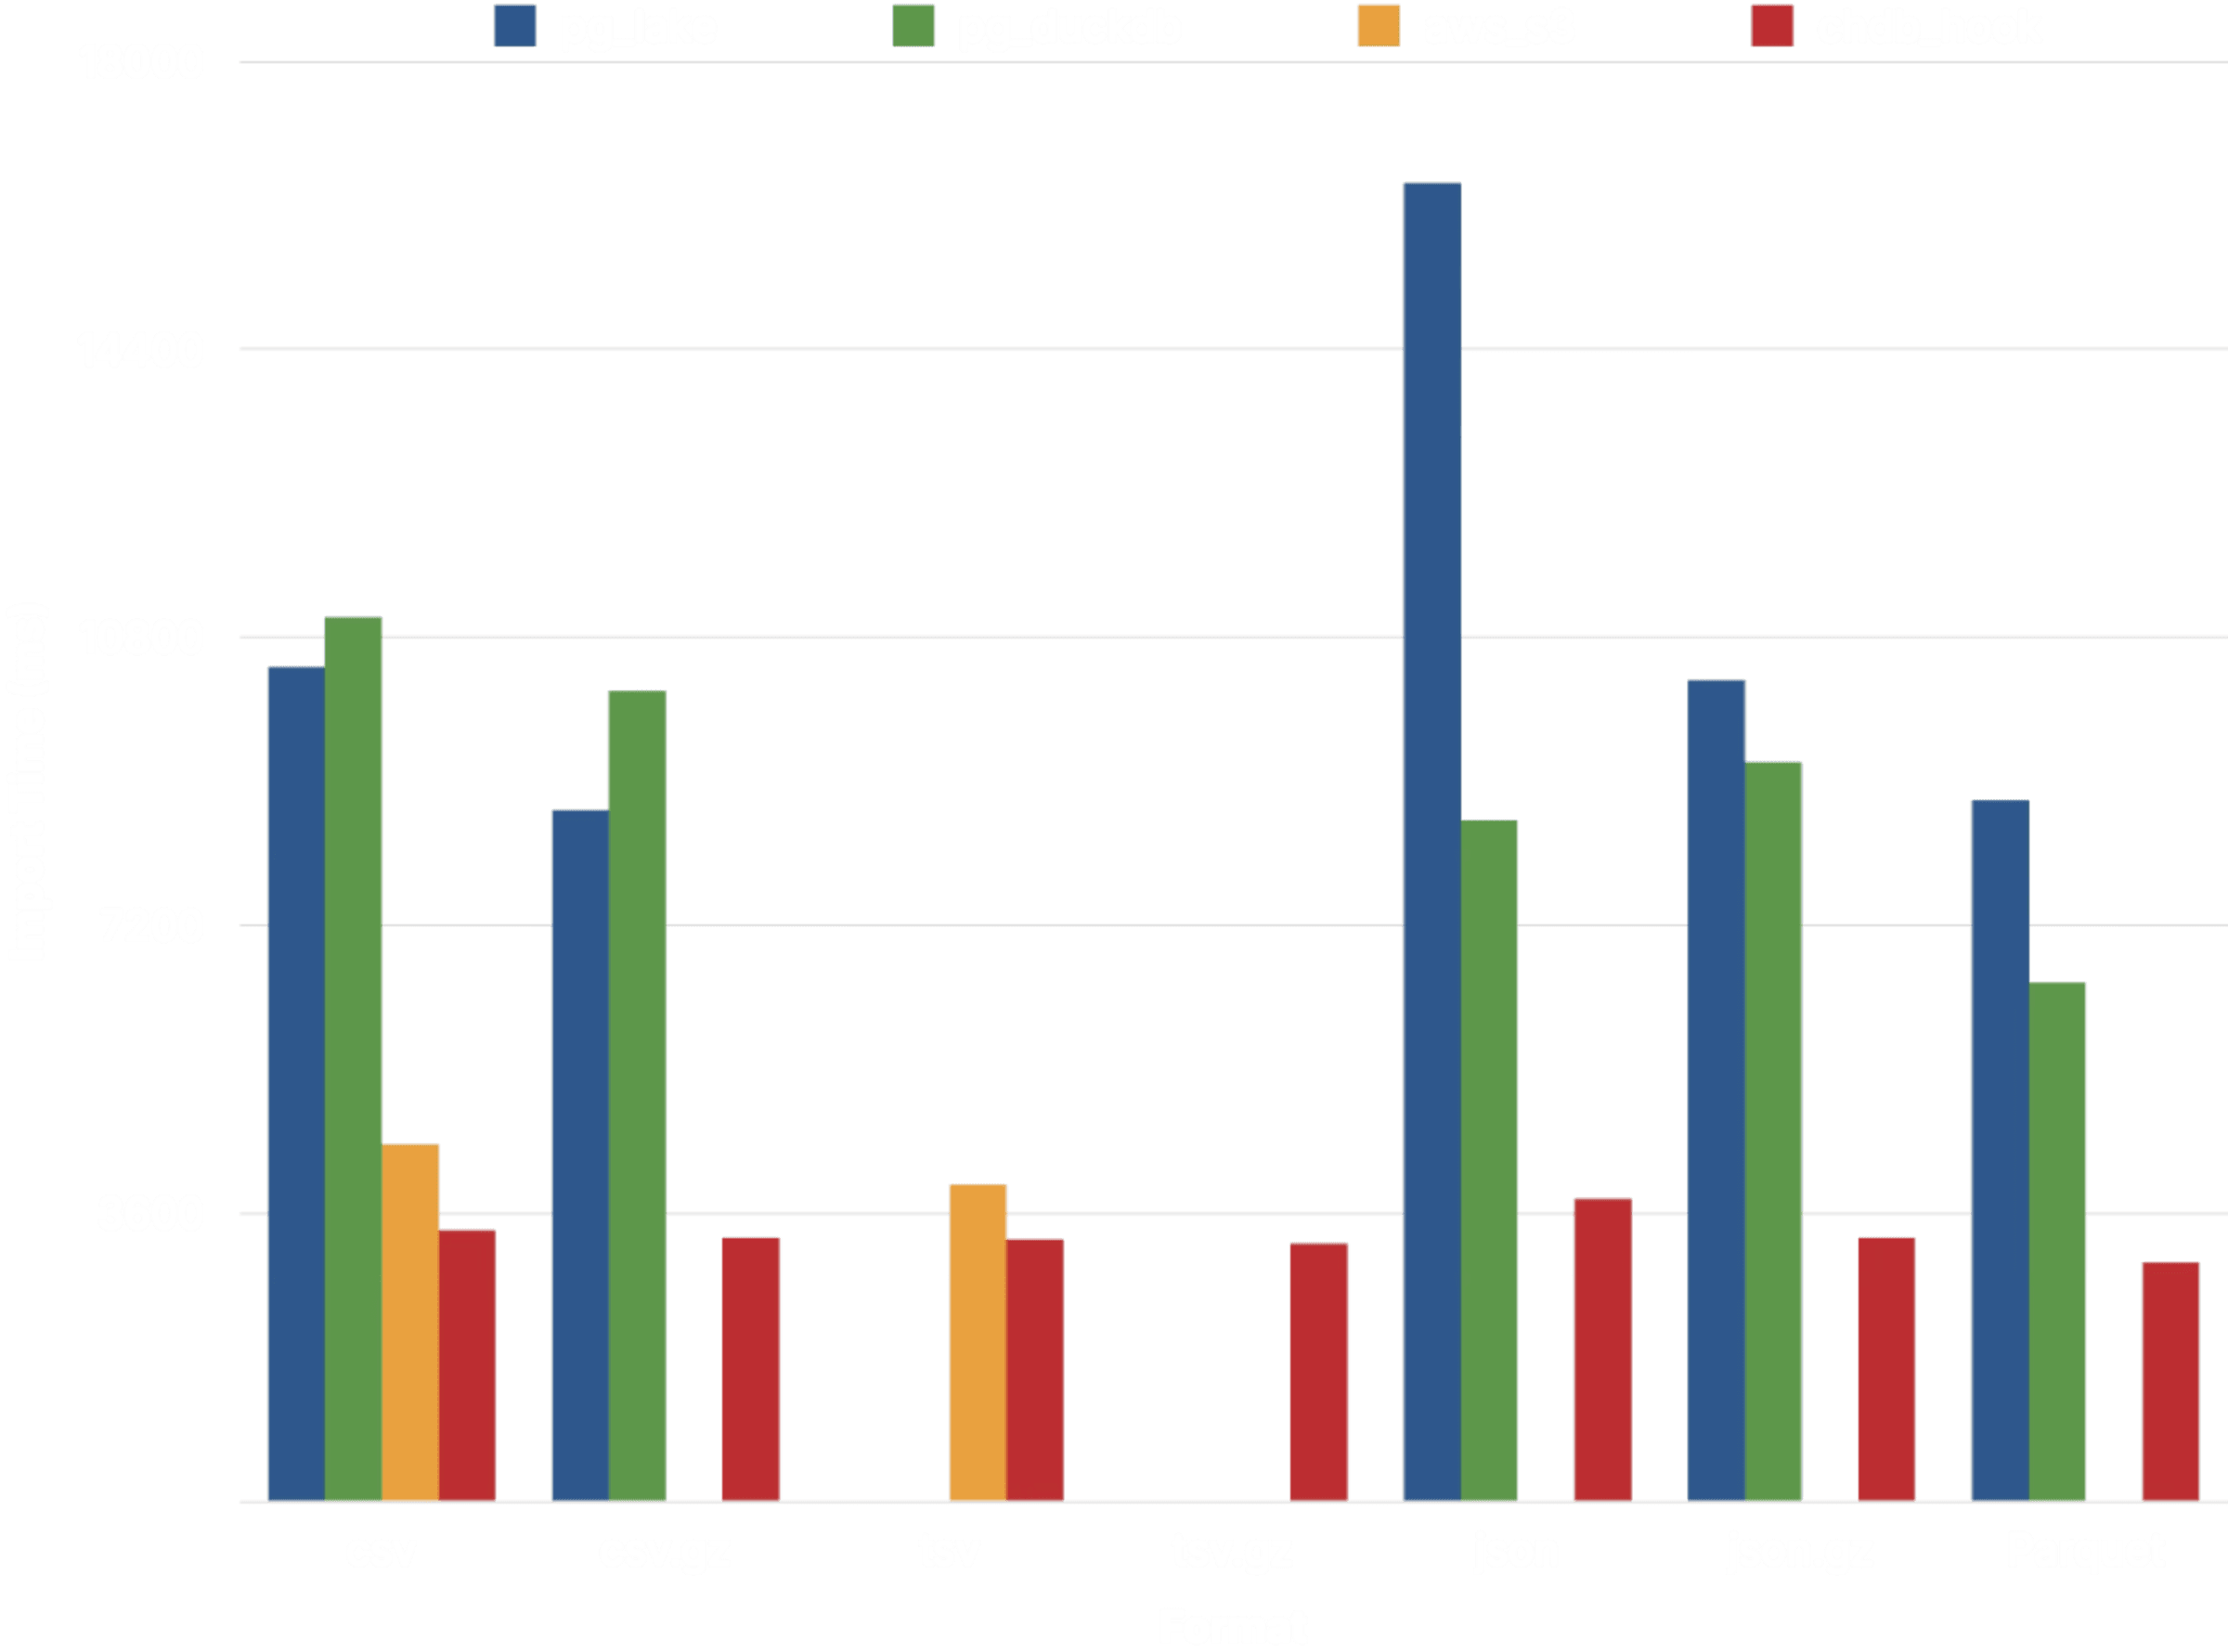
条件の差を小さくし、インフラではなく拡張自体の性能を測れるようにするため、 chdb、pg_lake、 pg_duckdb のベンチマークは、ClickHouse Managed Postgres の
r8id.xlargeサービス(4 vCPU、32 GB RAM)で実行しました。aws_s3 のベンチマークは、 AWS RDS のdb.r8g.xlargeホスト(こちらも 4 vCPU、32 GB RAM)で実行しました。 各インポートの結果は 3 回の平均です。詳細は ベンチマークのソースコード を参照してください。
比較した 4 種類の拡張のうち、最も安定した性能を示したのは chdb です。 いずれも DuckDB を基盤とする pg_duckdb と pg_lake は、CSV、JSON、Parquet からの インポートに、およそ 2〜3 倍の時間がかかります。chdb に近い性能を出すのは aws_s3 だけですが、 aws_s3 が対応するデータ形式はかなり限られます。
データ形式
データ形式と言えば、chdb 拡張は非常に多くの形式を読み書きできます。 ClickHouse 自体が対応する形式のすべてです。次の表は、 比較した各拡張が対応するデータ形式と圧縮アルゴリズムをまとめたものです。表中の chdb の形式は、 実際に対応する形式の一部にすぎません。
| 拡張 | 圧縮 | データ形式 |
|---|---|---|
| aws_s3 | なし | Text (TSV), CSV, Postgres Binary |
| pg_lake | gzip, zstd, snappy (Parquet のみ) | CSV, JSON, Parquet |
| pg_duckdb | gzip, zstd, snappy (Parquet のみ) | CSV, JSON, Parquet |
| chdb | gzip, zstd, lz4, bz2, snappy, brotli | TSV, CSV, JSON, BSON, Prometheus, Protobuf, Avro, Parquet, Arrow, XML, CapnProto, Markdown, MsgPack, ORC、ほかにも多数! |
ClickHouse と chDB ライブラリ が対応形式を増やせば、chdb 拡張は 実装を変えることなくそれを利用できます。
これらの形式のいくつかについても、NYC タクシーデータセット を読み込む chdb の性能を測定しました。結果はかなり安定していました。
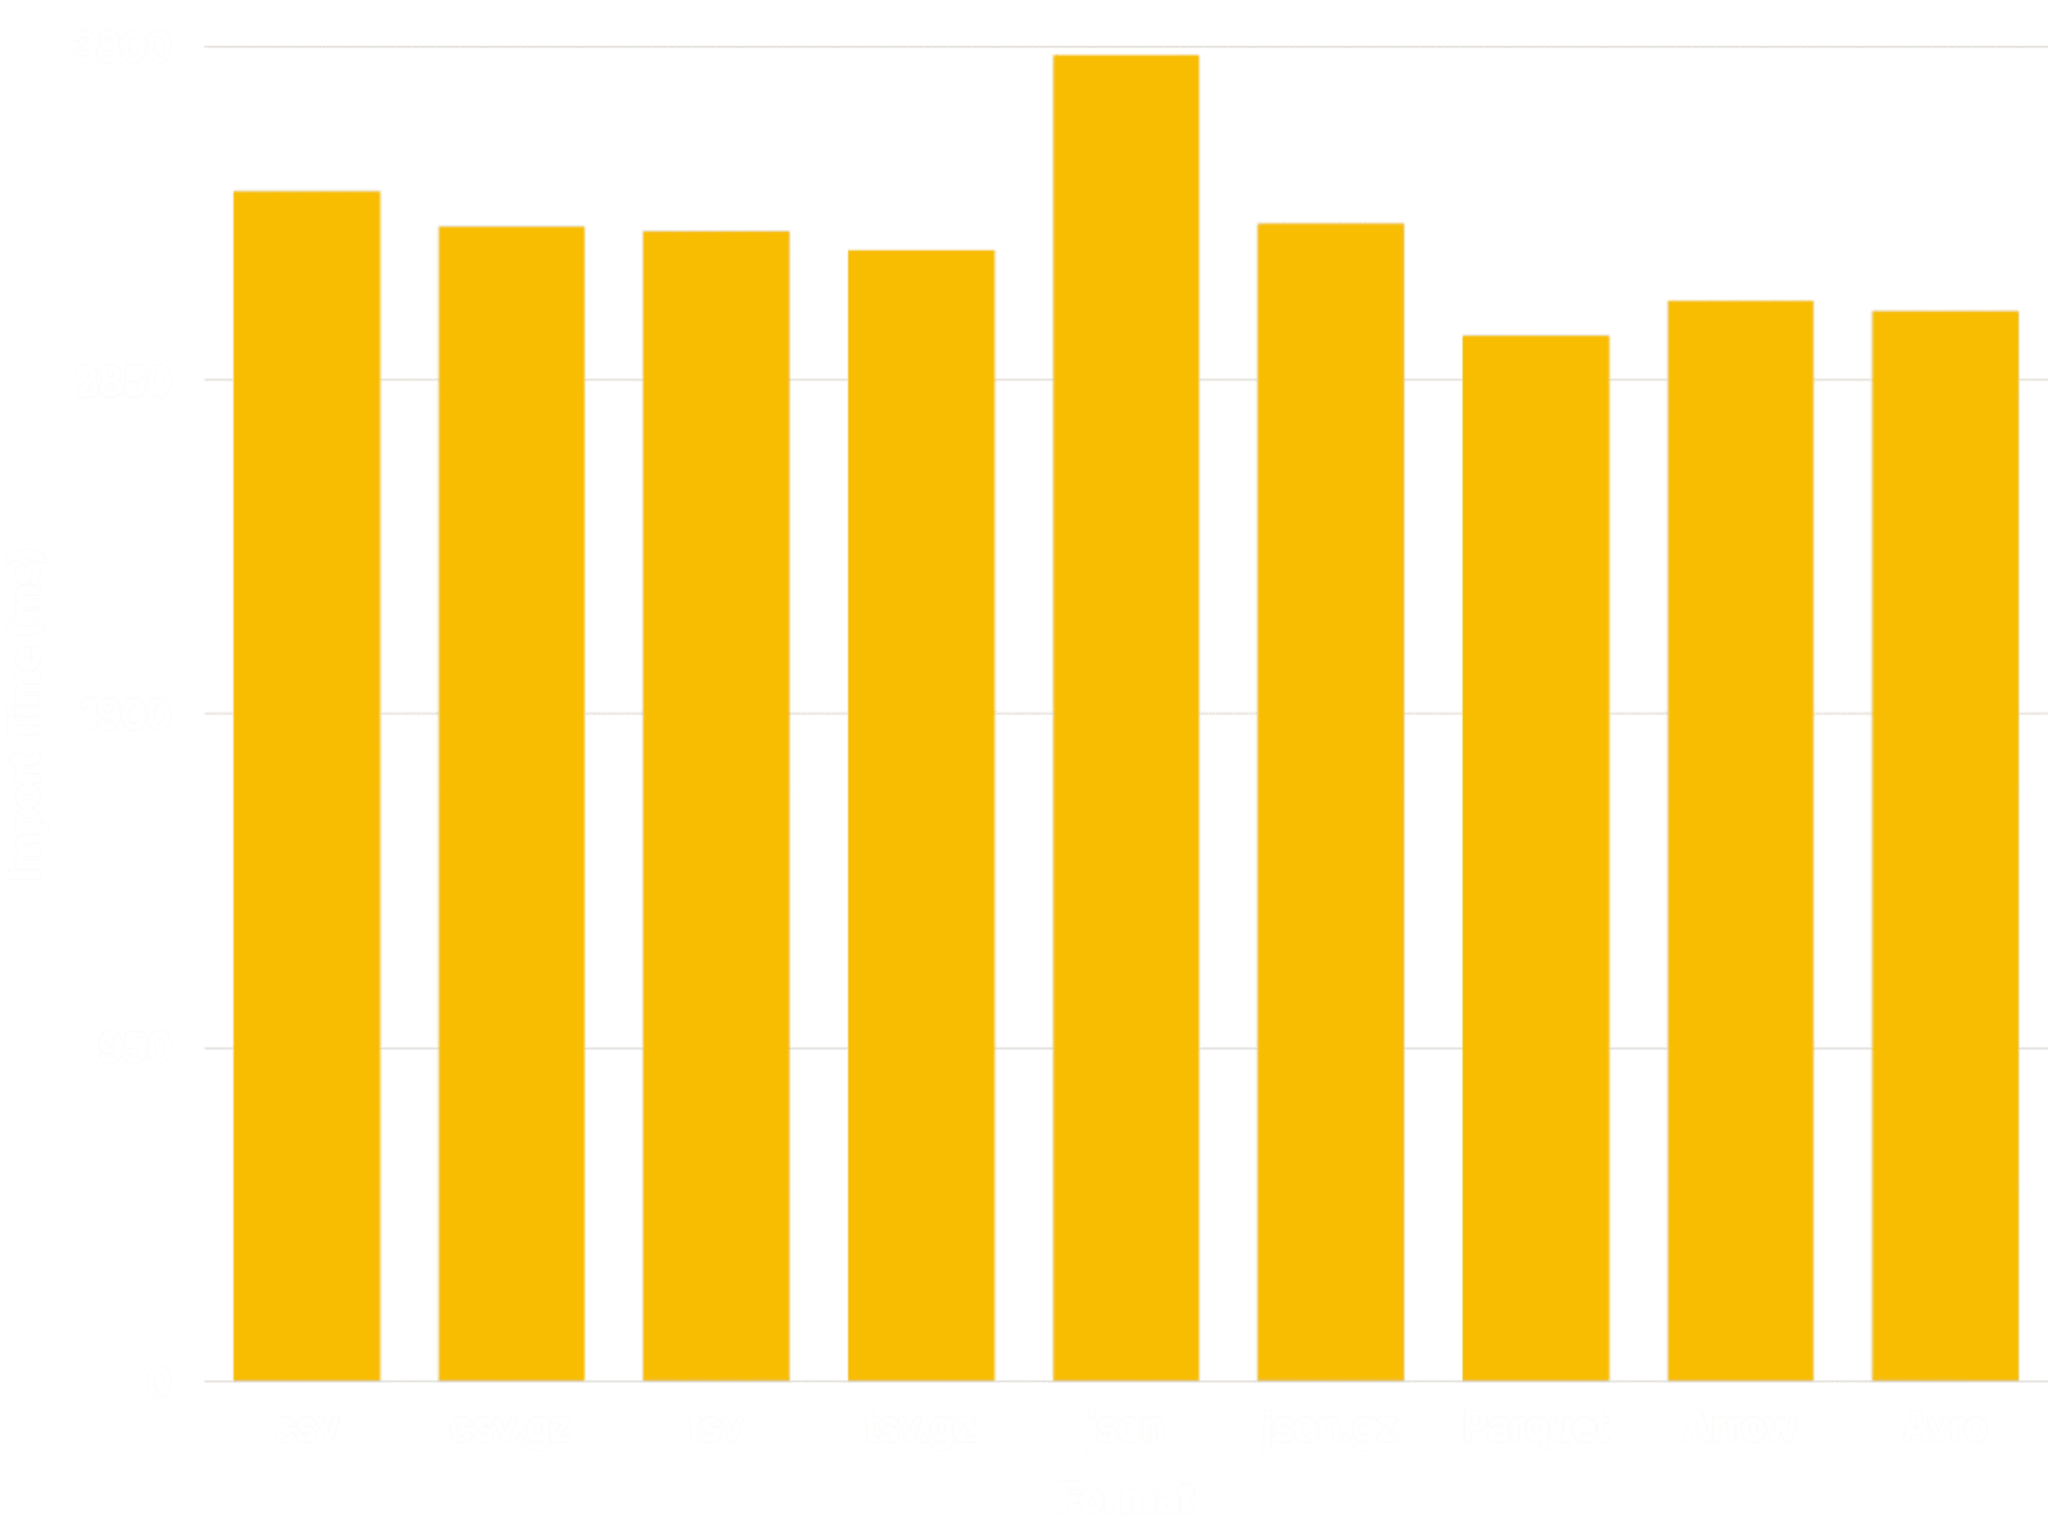
比較対象の拡張との互換性を保つため、JSONCompact 形式を使いました。 JSONCompactEachRow のような別の JSON 形式であれば、 ほかのデータ形式で得られた結果により近づきます。
使い方
chdb パッケージには 2 種類の拡張が含まれます。CREATE EXTENSION で導入する chdb という拡張と、chdb_hook という フックモジュール です。
chdb 拡張
chdb 拡張(ドキュメント)は chdb_query() 関数を提供します。
この関数は chDB のクエリを 1 つ実行します。たとえば、次のクエリは
SELECT * FROM chdb_query($$
SELECT * FROM s3('s3://datasets-documentation/my-test-bucket-768/some_prefix/some_file_1.csv');
$$) AS (id int, months int, days int);次のように出力します。
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(3 rows)chdb_hook モジュール
chdb_hook モジュール(ドキュメント)は COPY コマンドにフックし、
AWS S3、Google Cloud Storage、Azure Blob Storage、ファイル、http URL との間でデータをコピーします。次の例は、S3 上の CSV ファイルからレコードを読み込みます。
CREATE TABLE times (
id INT NOT NULL,
months INT NOT NULL,
days INT NOT NULL
);
LOAD 'chdb_hook';
COPY times FROM 's3://datasets-documentation/my-test-bucket-768/some_prefix/some_file_1.csv';実行すると、times テーブルにはファイルのレコードが入ります。
# SELECT * FROM times;
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(3 rows)CREATE TABLE コマンドで、こうした URL から列の定義を導き出し、行を読み込むこともできます。 次の例を試してみてください(この記事に出てくる URL は、すべて実在するデータファイルを指しています)。
CREATE TABLE reviews () WITH (
copy_from = 's3://datasets-documentation/amazon_reviews/amazon_reviews_2015.snappy.parquet'
);できあがったテーブルは、データがすべて読み込まれた状態で次の構造になります。
| 列 | 型 |
|---|---|
| review_date | integer |
| marketplace | text |
| customer_id | numeric(20,0) |
| review_id | text |
| product_id | text |
| product_parent | numeric(20,0) |
| product_title | text |
| product_category | text |
| star_rating | smallint |
| helpful_votes | bigint |
| total_votes | bigint |
| vine | boolean |
| verified_purchase | boolean |
| review_headline | text |
| review_body | text |
データ型
pg_clickhouse と同じく、chdb は ClickHouse から Postgres への値の変換に、
ヘッダーのみで構成されたライブラリ pg-clickhouse-c を利用します。上の CREATE TABLE の例のように、
その 型マッピング も利用します。現在のリリースでは、ClickHouse のほぼすべての型が Postgres の型に、
またその逆にも対応付けられます。このマッピングで足りる場面がほとんどです。合わない場合は、structure オプションで
使用する型を chdb に指定します。
たとえば pg-clickhouse-c は、Postgres の JSON 値を ClickHouse の String に対応付けます。ClickHouse の JSON が現時点では JSON の オブジェクト しか認識せず、 Postgres の JSON はオブジェクト、配列、JSON のスカラー値に対応しているためです。ただし、次のような CHECK 制約が あれば、JSON 列にオブジェクトしか入らないと確信できます。
CREATE TABLE projects (
name TEXT PRIMARY KEY,
meta JSON NOT NULL CHECK (json_typeof(meta) = 'object')
);
INSERT INTO projects
VALUES ( 'chdb', '{"status": "release"}' ),
( 'walrus', '{"status": "revise"}' );Parquet JSON のようにオブジェクトを認識できるストレージ形式では、柔軟性が高まり、格納の面でも利点があります。
これを活かすには、structure オプションで ClickHouse の JSON に対応付けます。
COPY projects to 'file:///tmp/projects.parquet' (
structure 'name String, meta JSON'
);クラウドストレージの URL
chdb_hook 拡張は、主要なストレージプラットフォームとの間でデータを読み書きできます。 URL のスキームから、使用するプロトコルを判断します。
| スキーム | 対象 |
|---|---|
file | Postgres サーバー上の絶対パス |
http, https | HTTP URL |
s3 | AWS S3 |
gs, gcs, oss | Google Cloud Storage |
az, azure, abfss, abfs | Azure Blob Storage または Azure ABFS |
hdfs | Hadoop Distributed File System |
URL にはいくつかの ワイルドカード も使えるため、複数のファイルを並行して取得できます。
先ほどの CREATE TABLE の例に戻ると、次のコマンドは S3 から 6 個のファイルを見つけてインポートします。
CREATE TABLE times () WITH (
copy_from = 's3://datasets-documentation/my-test-bucket-768/{some,another}_prefix/some_file_{1..3}.csv'
);実行すると、times テーブルには読み込んだ各ファイルのレコードが入ります。
SELECT * FROM times;
c1 | c2 | c3
----+----+----
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(18 rows)アーキテクチャ
これほど多くのデータ形式とクラウドプラットフォームに対応するには、大量の依存関係が必要になります。 私たちはその管理を chDB ライブラリ に委ね、自分たちでは抱えていません。 とはいえ、このライブラリを Postgres のバックエンドにロードするのは過剰です。1 日 1 回データソースから データを読み込むような、ときどき実行する処理や定期的に実行する処理では特にそうです。
そのため、データを読み込む拡張は、こうしたライブラリの大きさと複雑さを扱うために、 さまざまな方法を採っています。
- aws_s3 はファイルをローカルファイルシステムにダウンロードし、 あとの処理を COPY に任せます。そのため、対象は AWS S3 のソースと、 Postgres の COPY が対応する形式に限られます
- pg_duckdb は DuckDB エンジンを Postgres のバックエンドに組み込みます。 たまに COPY を使うだけなら過剰です
- pg_lake は DuckDB を利用する別のサービスを動かし、 libpq プロトコル 経由で通信します。このサービスは Postgres ホストの リソースを常に消費し続けます
chdb 拡張 は、独自のアーキテクチャを採っています。chDB ライブラリ を
別のヘルパーアプリに組み込む方式です。拡張本体も chdb_hook も chDB をリンクしません。
代わりに、必要になった時点でヘルパーアプリを起動し、メモリ上の効率的な経路であるファイルディスクリプタ
(STDIN、STDOUT、STDERR、および設定情報用のもう 1 つ)を通じて通信します。
この設計により、chDB ライブラリ が 1 つのコマンドの実行に必要な以上のリソースを 消費することはありません。また、PostgreSQL クラスター自体が メモリ不足 の影響を受けないようにします。 バックグラウンドワーカー で共有メモリを使う方式では、このメモリ不足が起こり得ます。
ヘルパーアプリは、コマンドの実行を終えてすべての結果をバックエンドに引き渡すと、後片付けをして終了し、 サーバーのリソースを、最も重要なサービスである PostgreSQL に明け渡します。結果は ClickHouse Native 形式で、ソースから直接流します。
+-------------+
| helper |
+----------+ | app | +------+
| Postgres | | +---------+ | | chDB |
| Backend |<---->| | chDB | |<---->| Data |
+----------+ | | Library | | +------+
| +---------+ |
+-------------+今後の予定
私たちは chdb の改善を続けます。ロードマップの候補には次の項目があります。
- 型マッピングの完成。Postgres と ClickHouse のデータ型の差を少しずつ埋めており、 chdb と pg_clickhouse の 両方に役立ちます。
- 資格情報チェーンによるオブジェクトストレージへのアクセス制御。現在、オブジェクトストアの読み書きに 必要な資格情報は、chdb の呼び出しごとに明示的に渡す必要があります。 サーバー側で設定した資格情報を透過的に使えるようにもしたいと考えています。
COPY (query) TOへの対応- COPY での
WHERE条件への対応 - 既存の COPY オプションすべてへの対応
- Iceberg 形式への対応
- ストレージ上のファイルを直接クエリする機能
試してみる
chdb 拡張 は GitHub や PGXN など、おなじみの配布先から入手できます。
ClickHouse Managed Postgres では、より広範な pg_clickhouse
パッケージの一部としても提供しています。既定の設定に chdb_hook を追加したい場合は、サポート担当者に
お問い合わせください。あるいは psql やお使いのクライアントでスーパーユーザーのアカウントに接続し、
CREATE EXTENSION chdb; または LOAD 'chdb_hook'; を実行すれば、すぐに始められます。
ClickHouse Managed Postgres を今すぐ始める
ClickHouse Managed Postgres が自社のデータでどう動くかを試してみませんか。ClickHouse Cloud なら数分で始められ、$300 分の無料クレジットを利用できます。
サインアップ