5万

はじめに
ClickHouse は、最新のオブザーバビリティにおいて選ばれるストレージエンジンとなっています。列指向アーキテクチャと実行モデルにより、大規模なログ、トレース、ワイドなイベントデータを極めて高速に処理できます。Netflix、Tesla、Anthropic、OpenAI などの企業は、要求の厳しいテレメトリワークロードを支える基盤として ClickHouse を利用しています。
しかし、データベース単体の速度だけではオブザーバビリティのパフォーマンスは保証されません。高負荷かつ高カーディナリティのワークロード下で一貫して低レイテンシなクエリを提供するには、エンジンの内部構造に合わせてクエリを構成する必要があります。ClickStack は、UI と ClickHouse を密接に統合し、クエリの生成および実行方法に最適化のベストプラクティスを直接組み込むことで、このギャップを埋めています。
本記事では、この統合が現在どのようにオブザーバビリティを高速化しているのか、そしてこれらの最適化を今後さらにどのように拡張していく予定なのかを探ります。
真の速度には綿密な計画が必要
ClickHouse は設計レベルで高速です。そのパフォーマンスは、ストレージ層とクエリ処理層の双方における技術革新から生まれています。
しかし、こうしたアーキテクチャ上の利点は、クエリがそれを活かすように書かれて初めて実環境での速度につながります。オブザーバビリティのワークロードは負荷が高く、クエリの構成が不適切だと、プルーニングをバイパスし、中間状態を肥大化させ、CPU やメモリを無駄に消費してしまいます。ClickHouse 上にオブザーバビリティソリューションを構築するには、単に任意の SQL を実行できるようにするだけでは不十分です。エンジンがどのようにデータを保存、プルーニング、処理するかに合わせてクエリを調整する必要があります。
成熟したクエリアナライザーを備えていても、最適化は依然として重要です。あらゆるクエリが自動的に最も効率的な形式へと書き換えられる段階には、まだ達していません。
ClickStack は、オブザーバビリティ UI と ClickHouse 自体を密結合させることでこの問題に対処します。ユーザーが生成した SQL を単にパススルーするのではなく、クエリを慎重に構築・書き換えて、可能な限り最も効率的な方法で実行されるようにします。これには、複雑なクエリを小さなステージに分割する、プルーニングを最大化するようにクエリを再構成する、CPU やメモリの使用量に配慮しながら読み取るデータ量を最小限に抑えるといった手法が含まれます。その目的は、エンジンの強みに合わせてクエリパターンを一貫して最適化することです。
以下では、これらの最適化のいくつかを取り上げ、将来的にはそれらを独自の API として公開し、ClickStack インターフェースの外部でも同様のクエリ策定戦略を活用できるようにする計画について説明します。
検索向けのプログレッシブな時間枠ページネーション
ClickStack で最も一般的なアクセスパターンの 1 つが単純な検索です。ユーザーは検索ダイアログを開き、通常は直近 15 分や直近 1 時間のログやトレースを閲覧します。場合によっては、その範囲を数日、あるいは数週間に広げることもあります。すべてを取得することが目的であるケースはほとんどありません。多くの場合、ユーザーはシグナルやパターン、特定のイベントを探してスキャンしています。
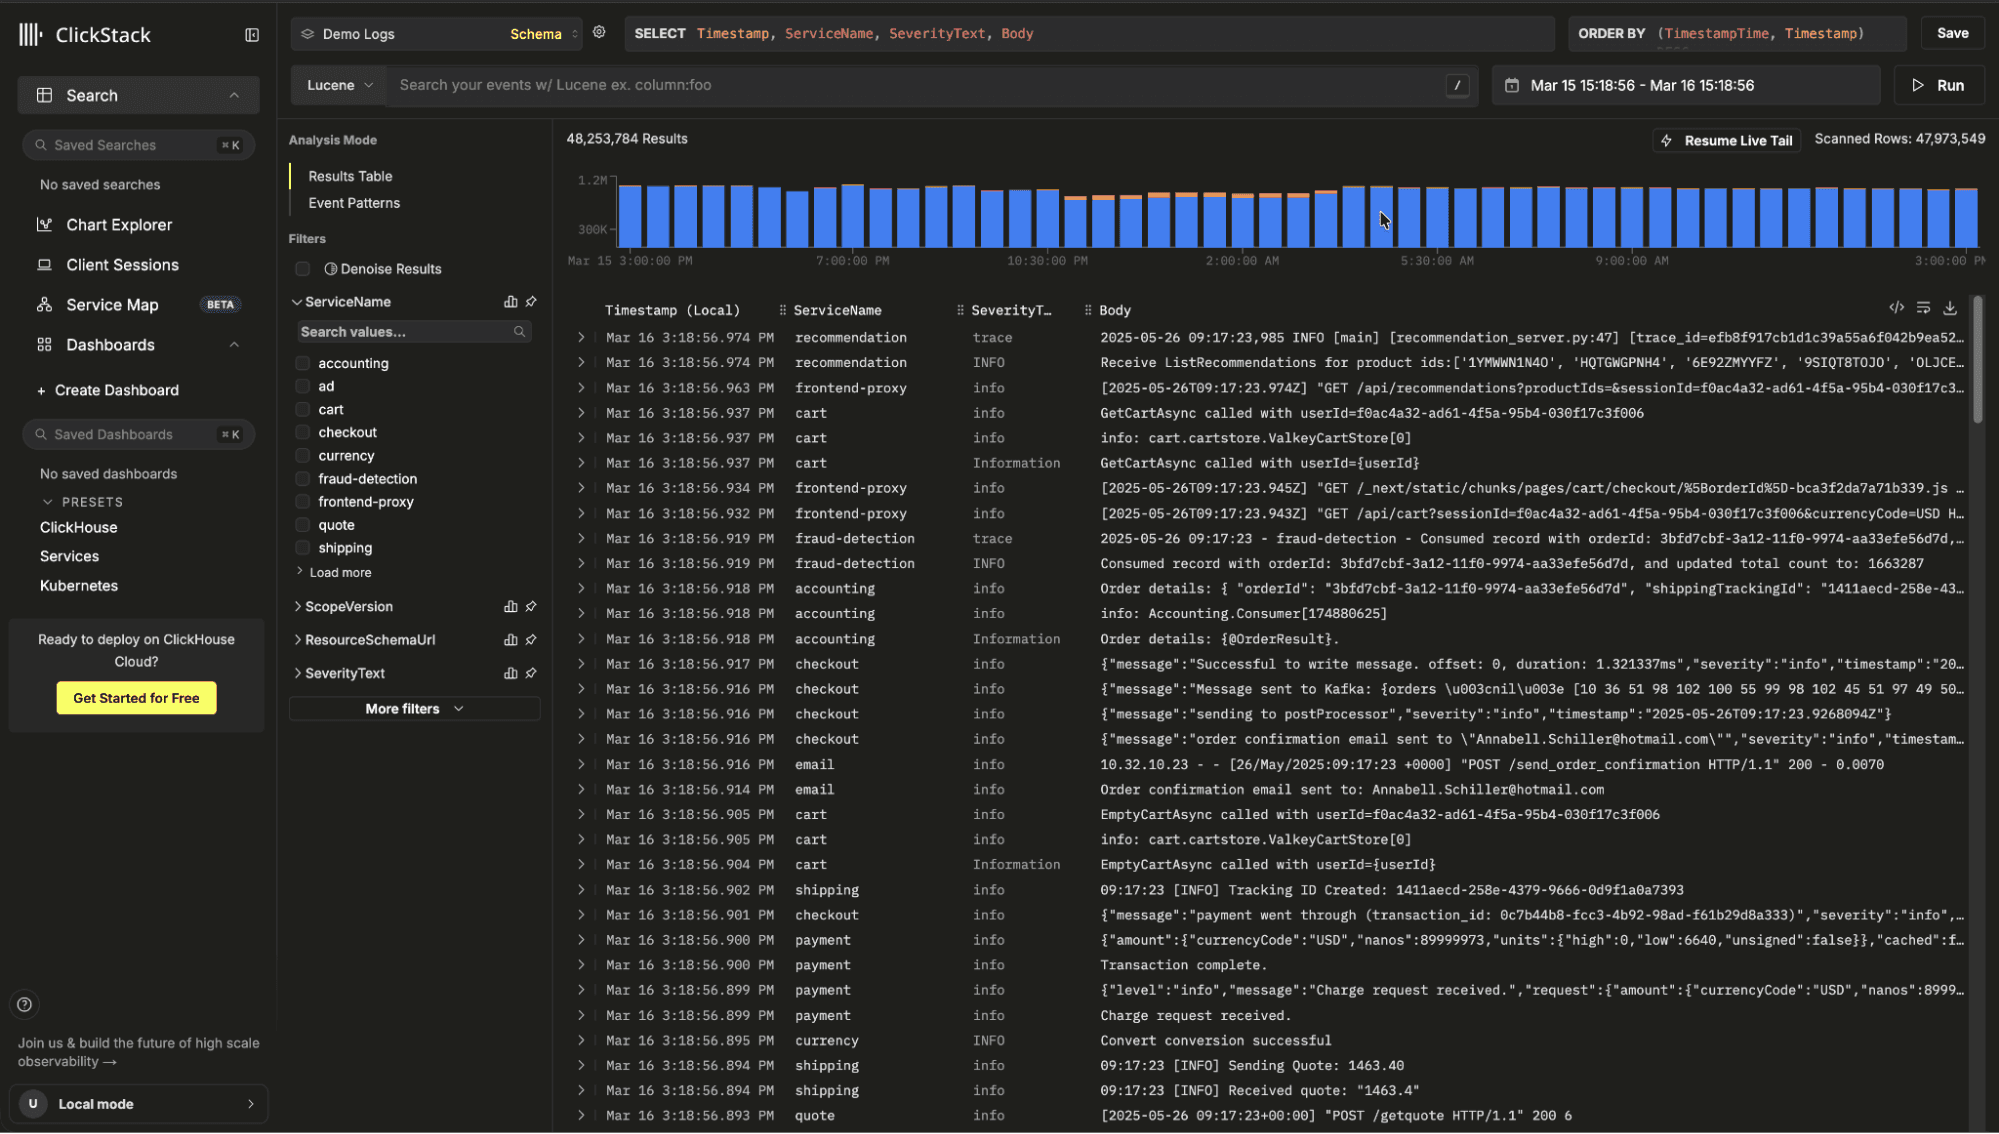
重要な着眼点は、データを返す前に完全な結果セットを揃える必要はないということです。最初のページを表示するのに十分な行数さえあれば足ります。段階的に結果を返すことで、ユーザーはほぼ瞬時にデータを確認して調査を開始できます。実際、ほとんどのユーザーは過去のデータを深くページングする前にクエリを絞り込みます。この挙動を利用することで、全範囲の網羅性ではなく、最初の結果が得られるまでの時間の短縮を重視した最適化が可能になります。素朴な実装では、リクエストされた全範囲に対して単一のクエリを発行するかもしれません。
SELECT *
FROM logs
WHERE timestamp BETWEEN now() - INTERVAL 30 DAY AND now()
ORDER BY timestamp DESC
LIMIT 500;これでは、ClickHouse はオフセットを適用する前に 30 日間の全範囲をスキャンしてソートせざるを得ず、必要以上のデータを読み取る可能性があります。
代わりに ClickStack は、最も新しい時間枠から段階的に検索を進めます。
SELECT *
FROM logs
WHERE timestamp >= now() - INTERVAL 6 HOUR
ORDER BY timestamp DESC
LIMIT 500;十分な行数が見つからない場合は、直前の 6 時間、次は 12 時間、その次は 24 時間というように古い時間枠へと範囲を広げ、制限された各時間枠内でのみページネーションを適用します。十分な結果が集まった時点で、それ以上のスキャンを終了できます。
このアプローチは、ClickHouse の optimize_read_in_order 機能と自然にかみ合います。ORDER BY 句がテーブルの主キーと一致している場合、ClickHouse は個別のグローバルソートを行うことなく、キー順にデータを読み取れます。ClickStack では、OpenTelemetry テーブルを toStartOfMinute(timestamp) のような時間ベースのキーでソートできるため、降順の時間クエリが物理レイアウトと合致することになります。これを制限された時間枠と組み合わせることで、ClickHouse は余計なソートやスキャンを最小限に抑えつつ、最新の行を素早く返せます。
クエリのチャンク分割
グラフ描画でも同様の技術が使われますが、目的が異なります。検索では最初の結果が得られるまでの時間の短縮を重視し、途中で処理を終了することもあります。一方、グラフの場合、ユーザーは指定した全時間範囲の完全な可視化を期待します。1 つの大きな集計クエリを実行する代わりに、対象範囲を粒度に合わせた時間枠に分割し、それぞれを個別に実行します。
たとえば、5 分単位の解像度で 30 日間のグラフを描画する場合、通常であれば数十億行に対する 1 回の集計が必要になることがあります。ClickStack はこれを 1 つの巨大なクエリとして実行するのではなく、時間範囲をバケット単位の時間枠に分割します。各時間枠は個別のクエリとなり、より小さなパーティションのスライスをスキャンします。
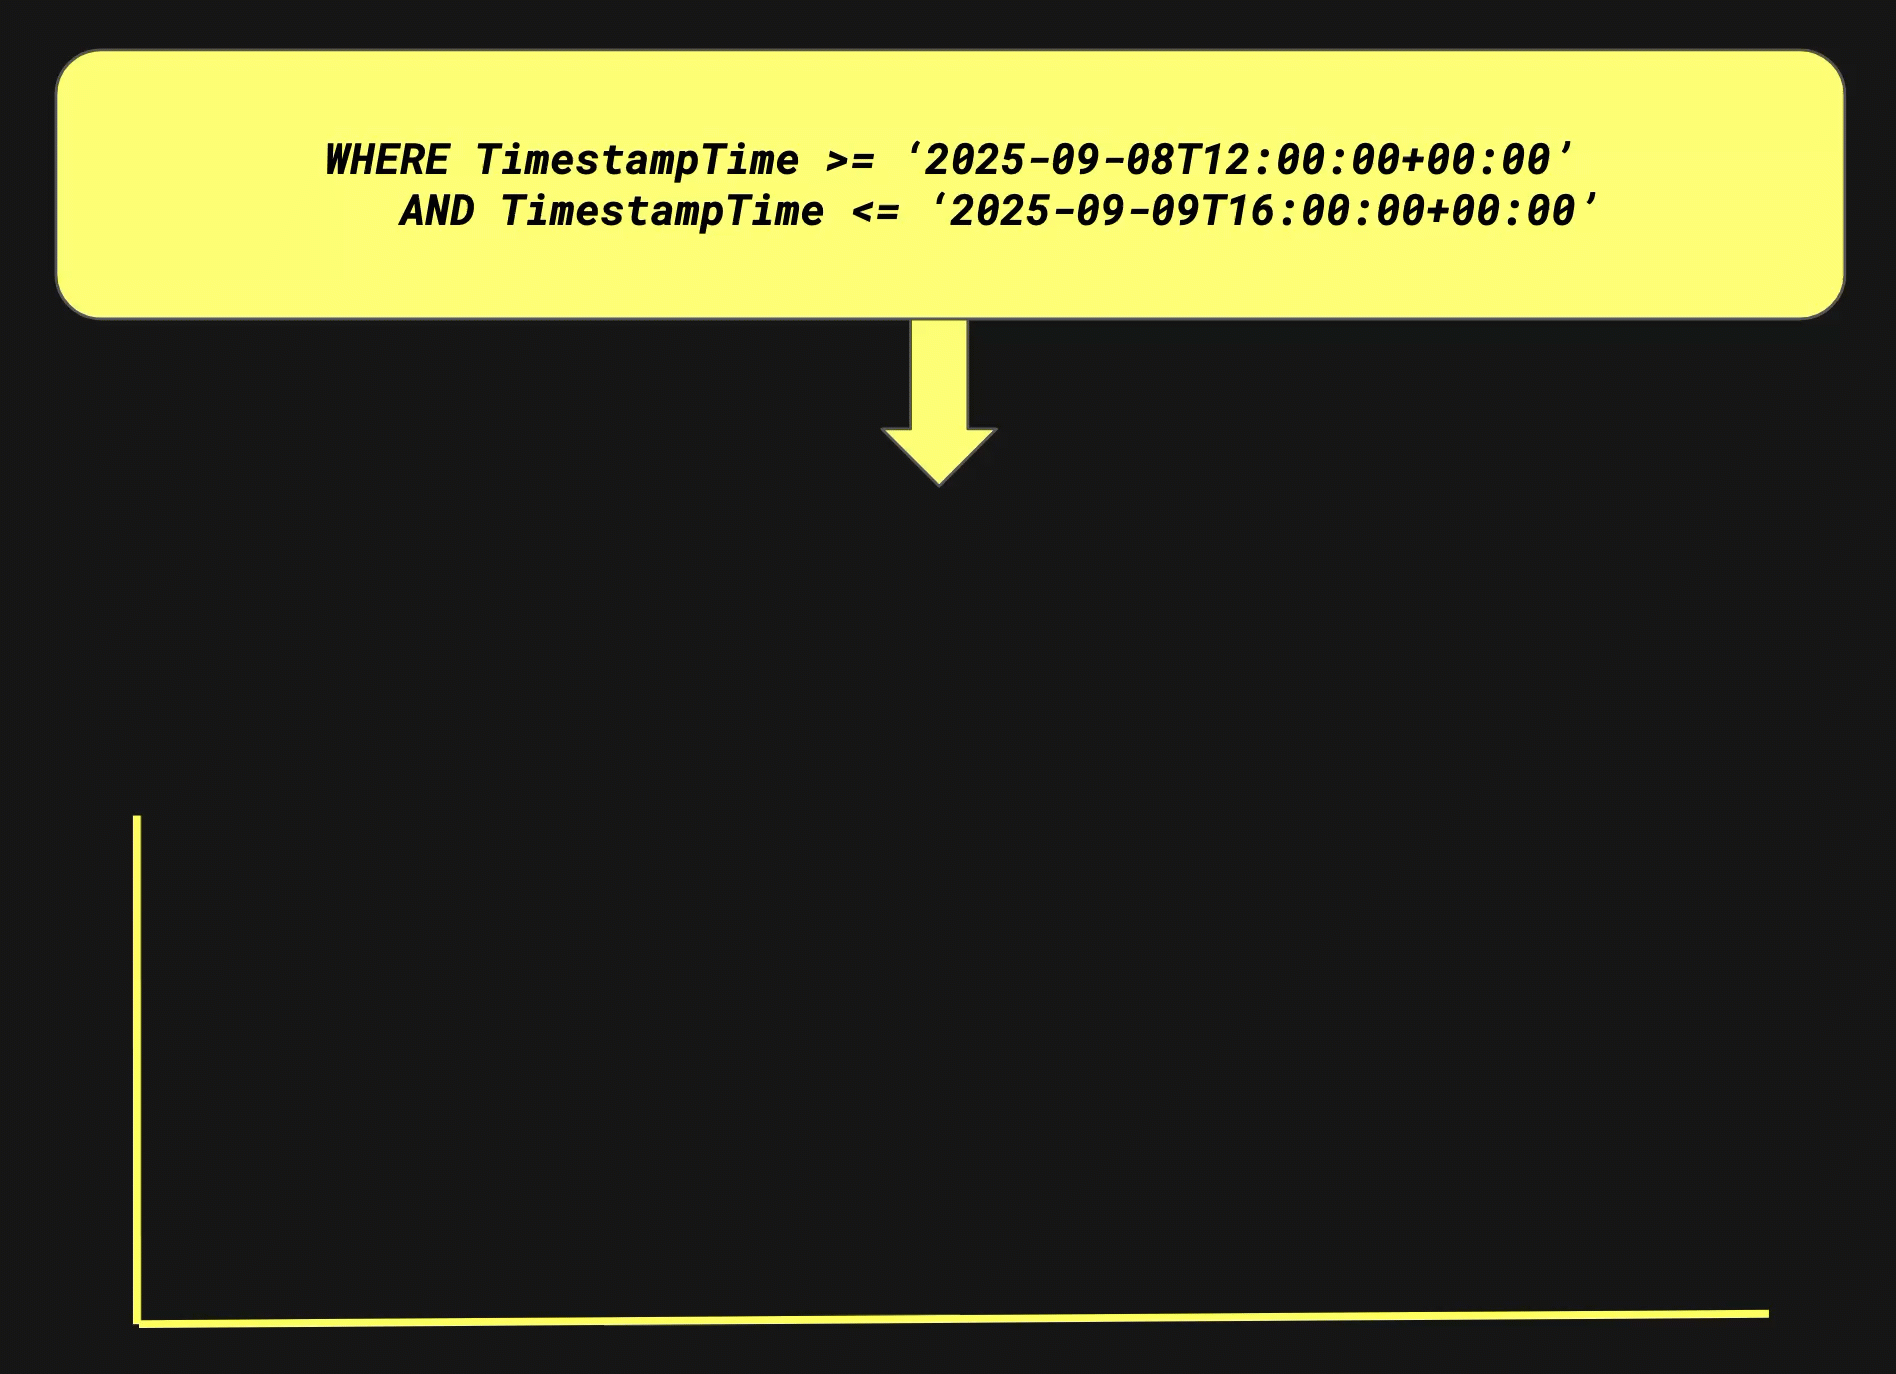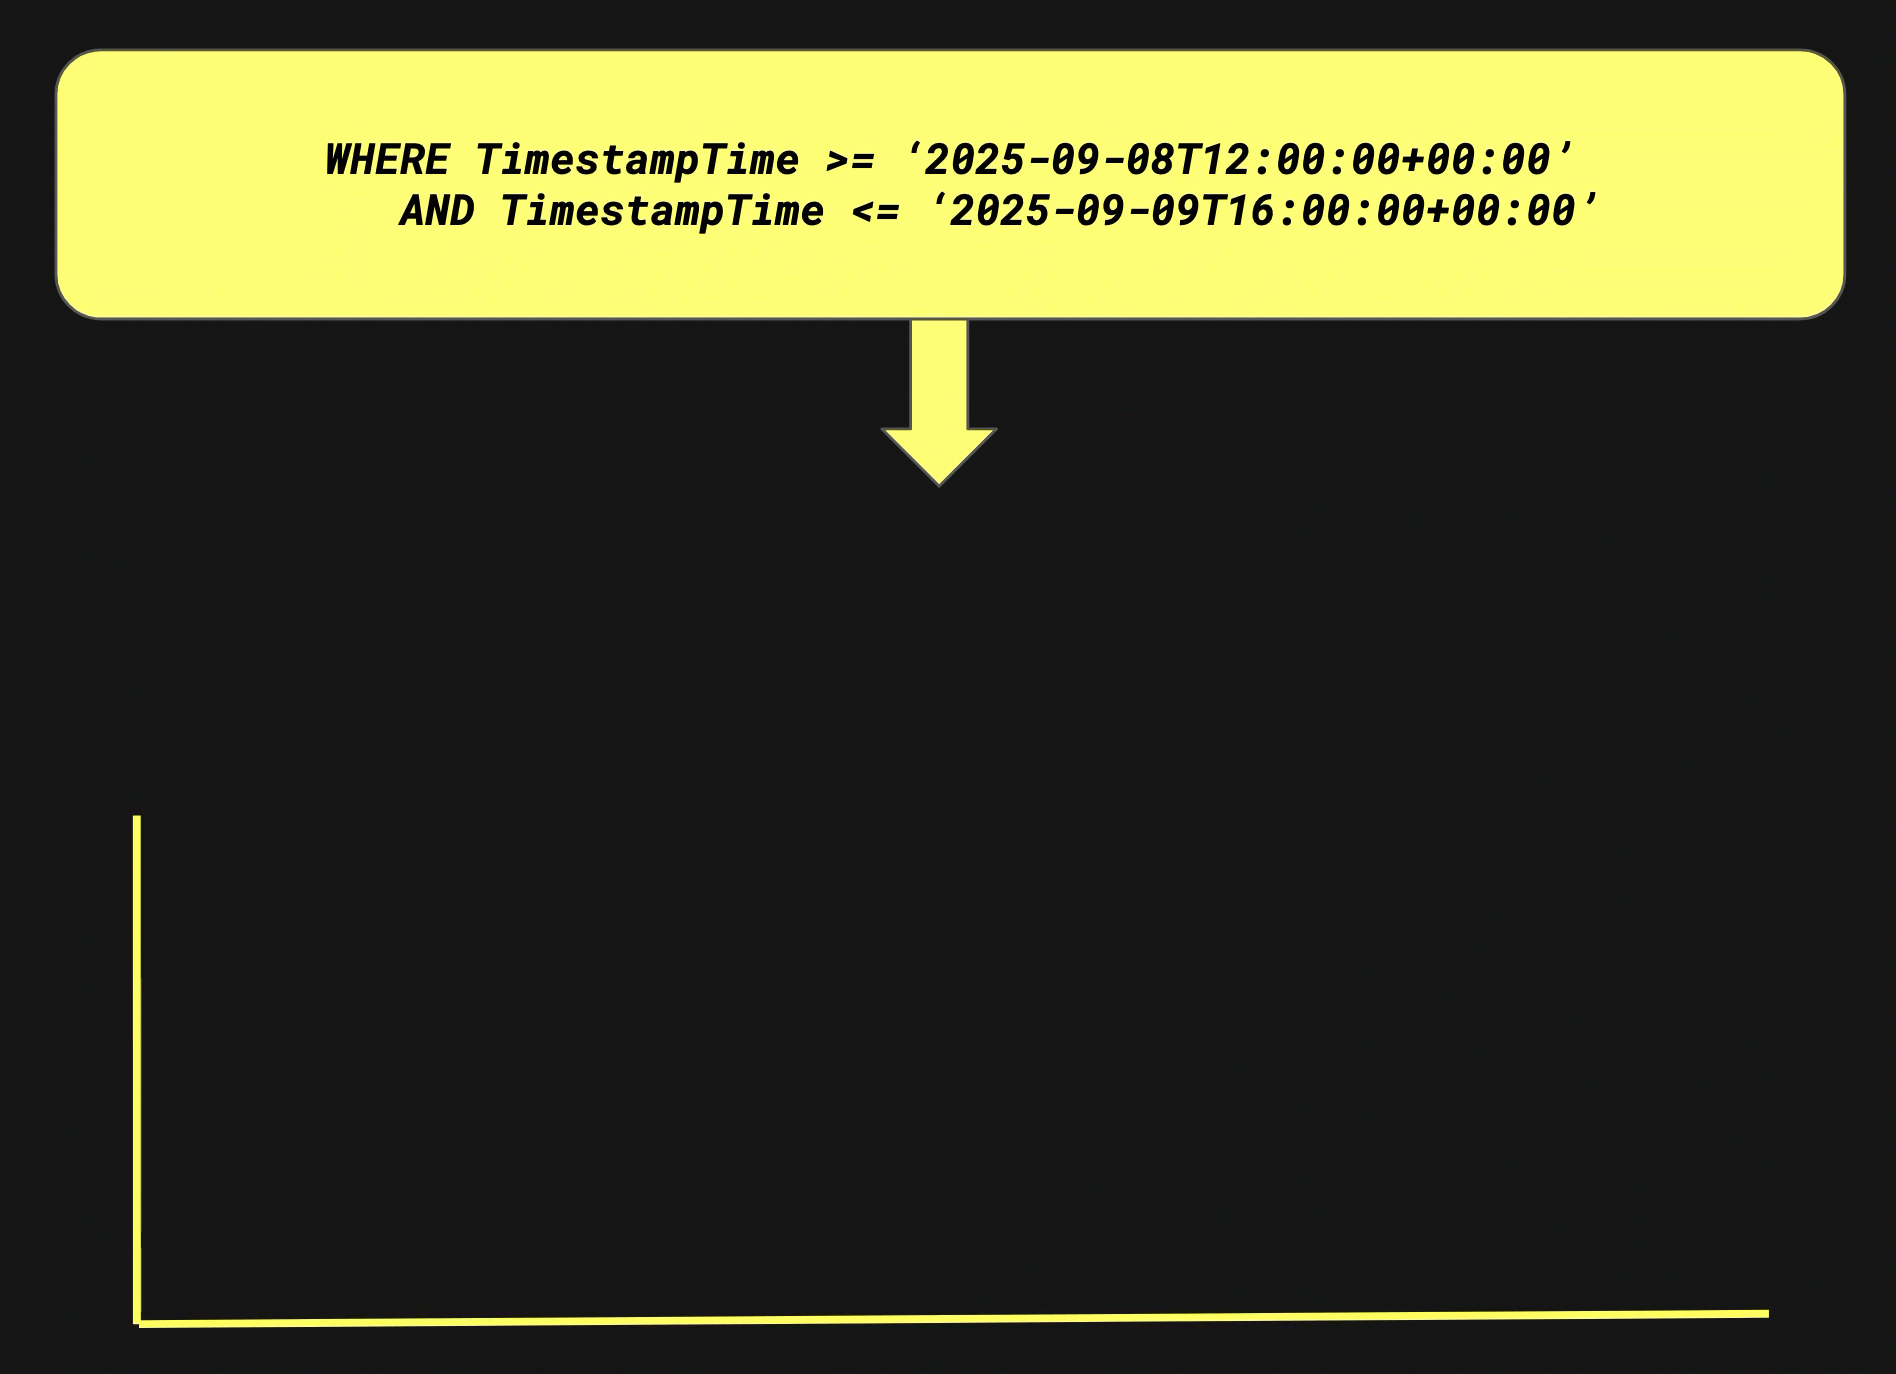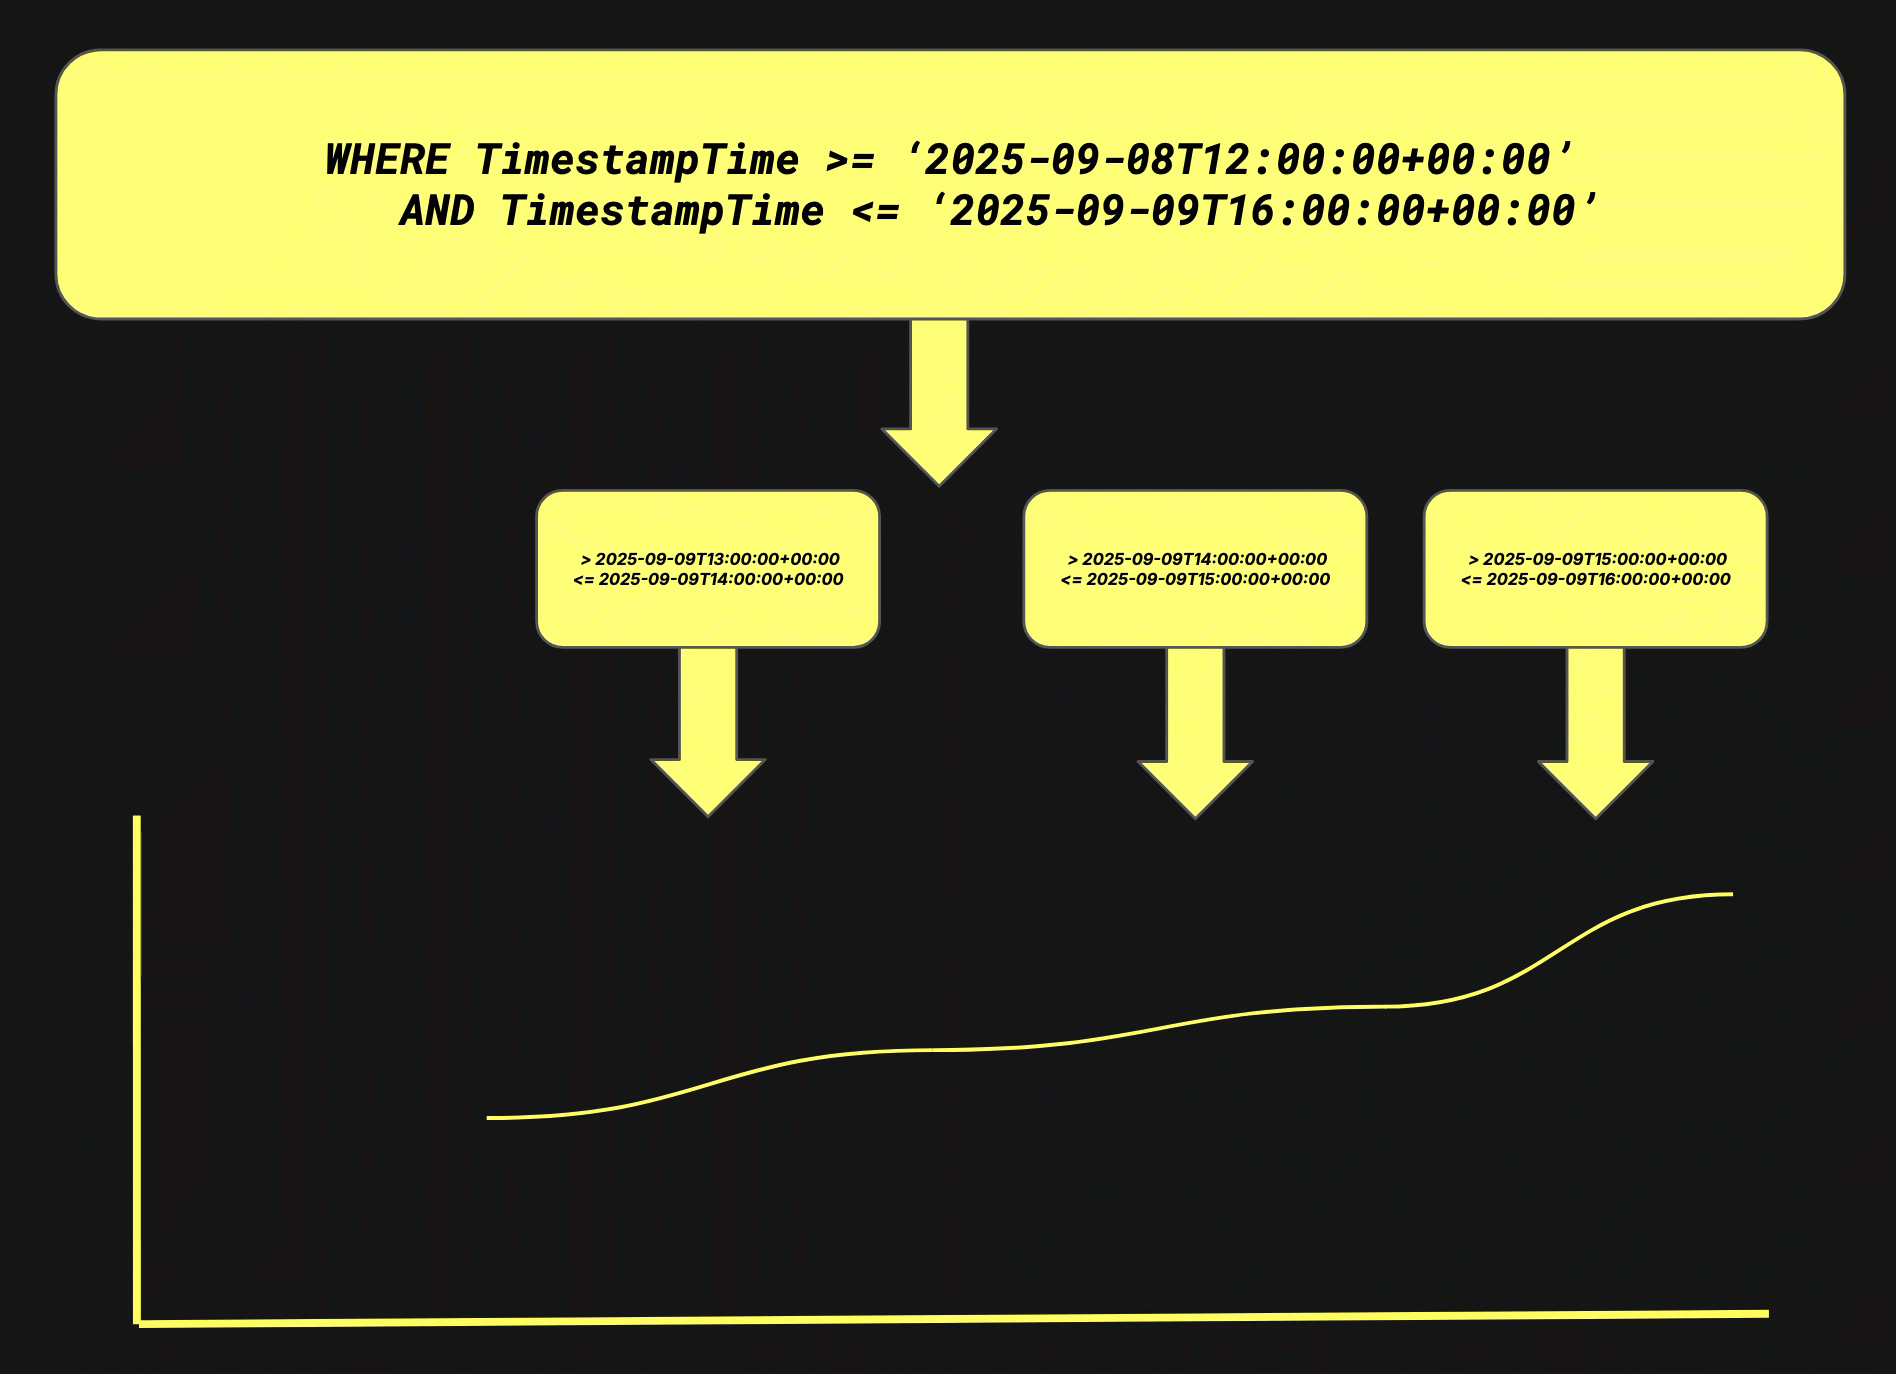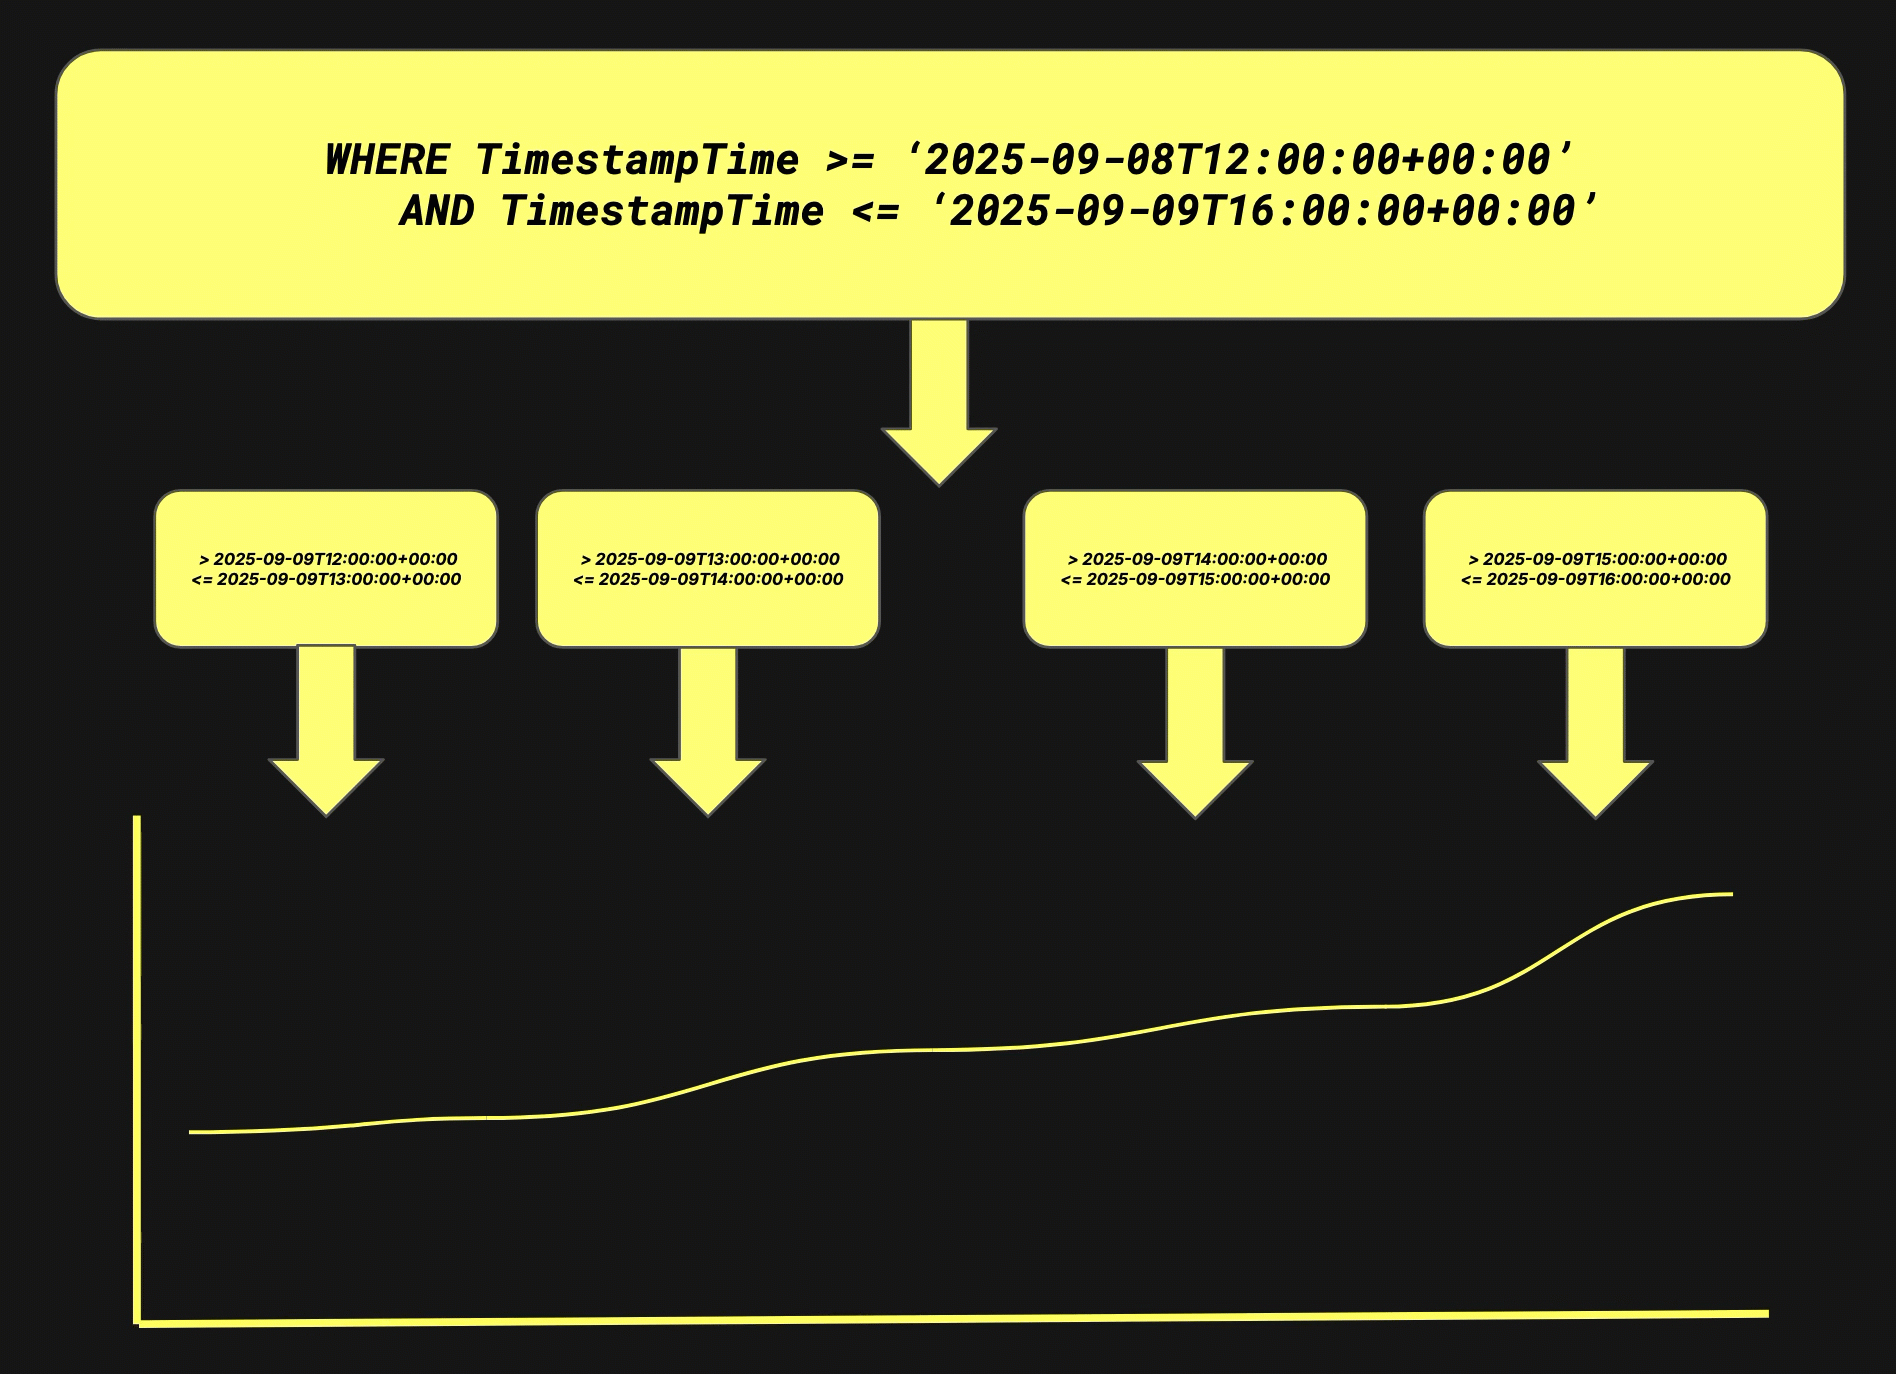
これらのクエリは並列実行可能で、その結果はクライアント側で順番に連結されます。時間枠はバケットの境界に合わせて調整されるため、集計バケットが途中で分割されることはありません。これにより、段階的な読み込み効果が得られます。
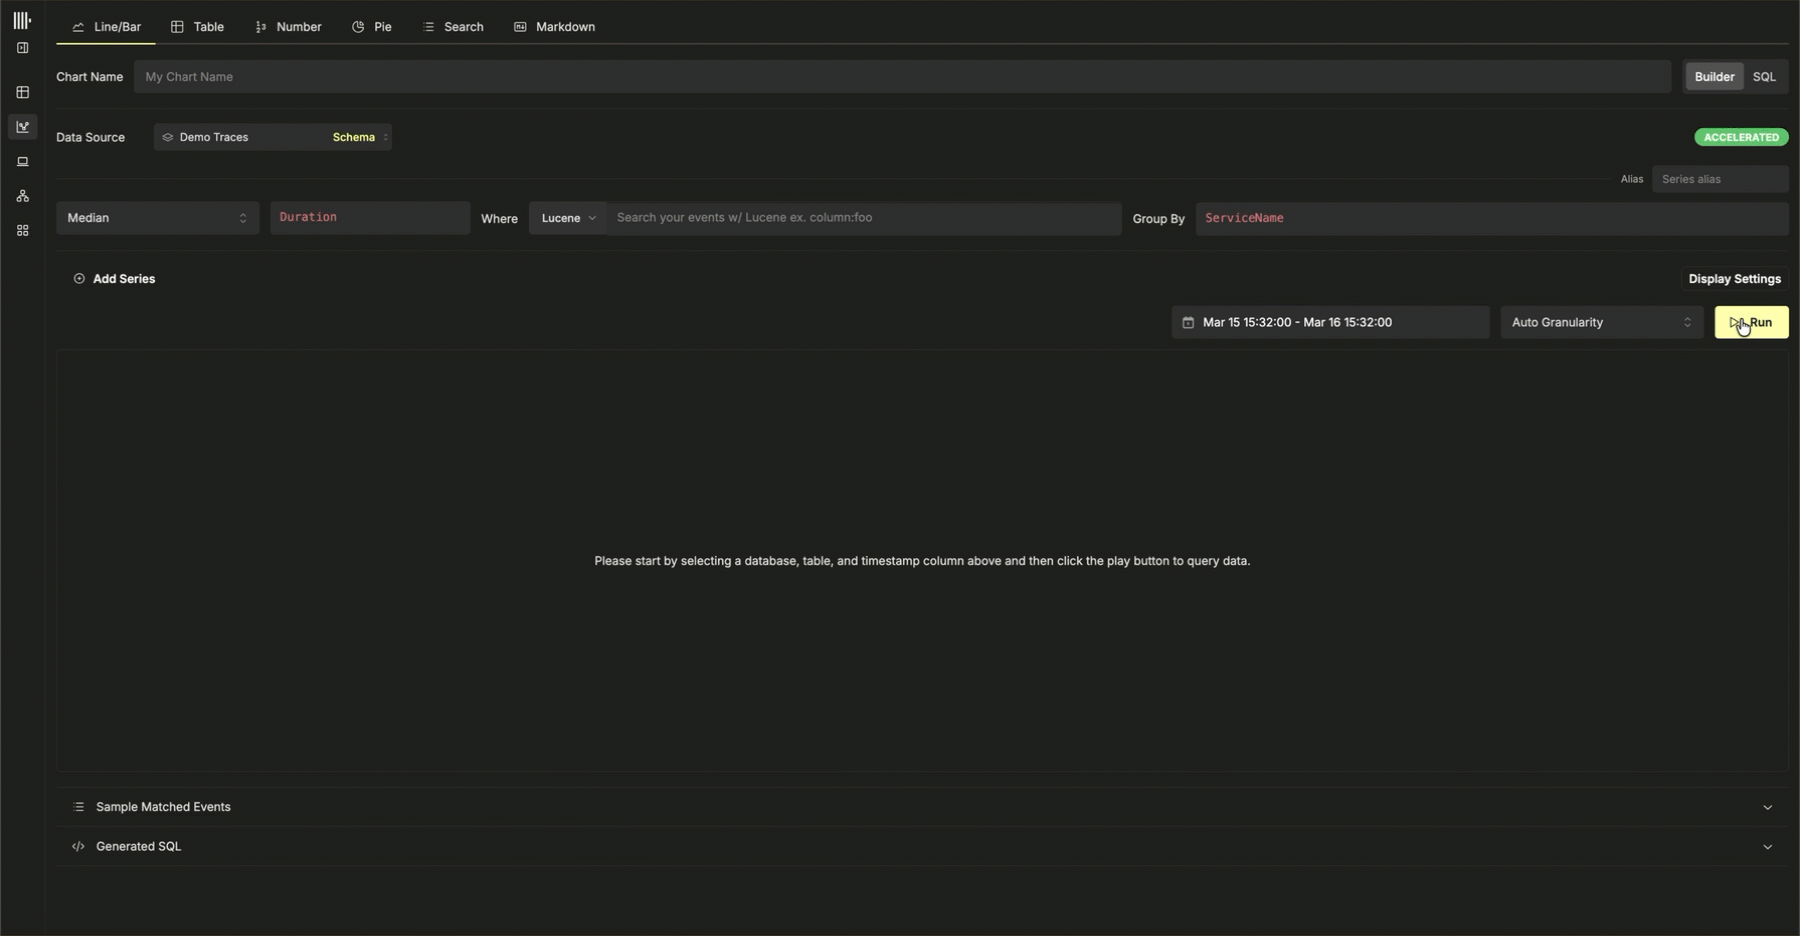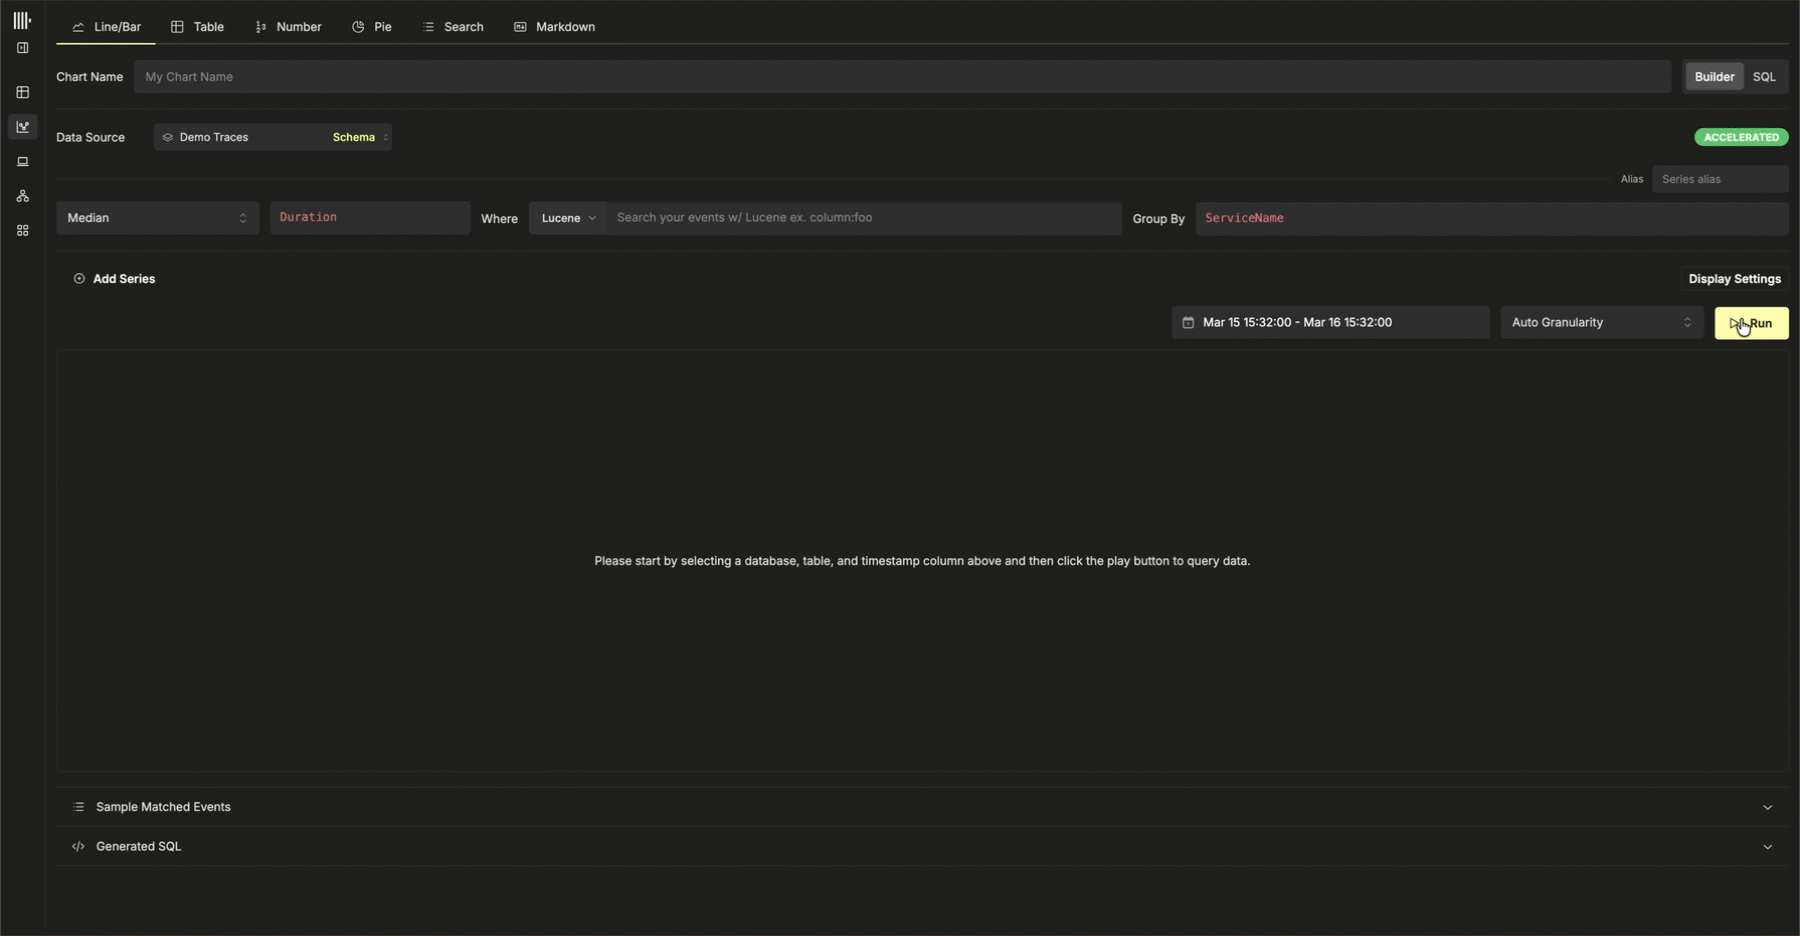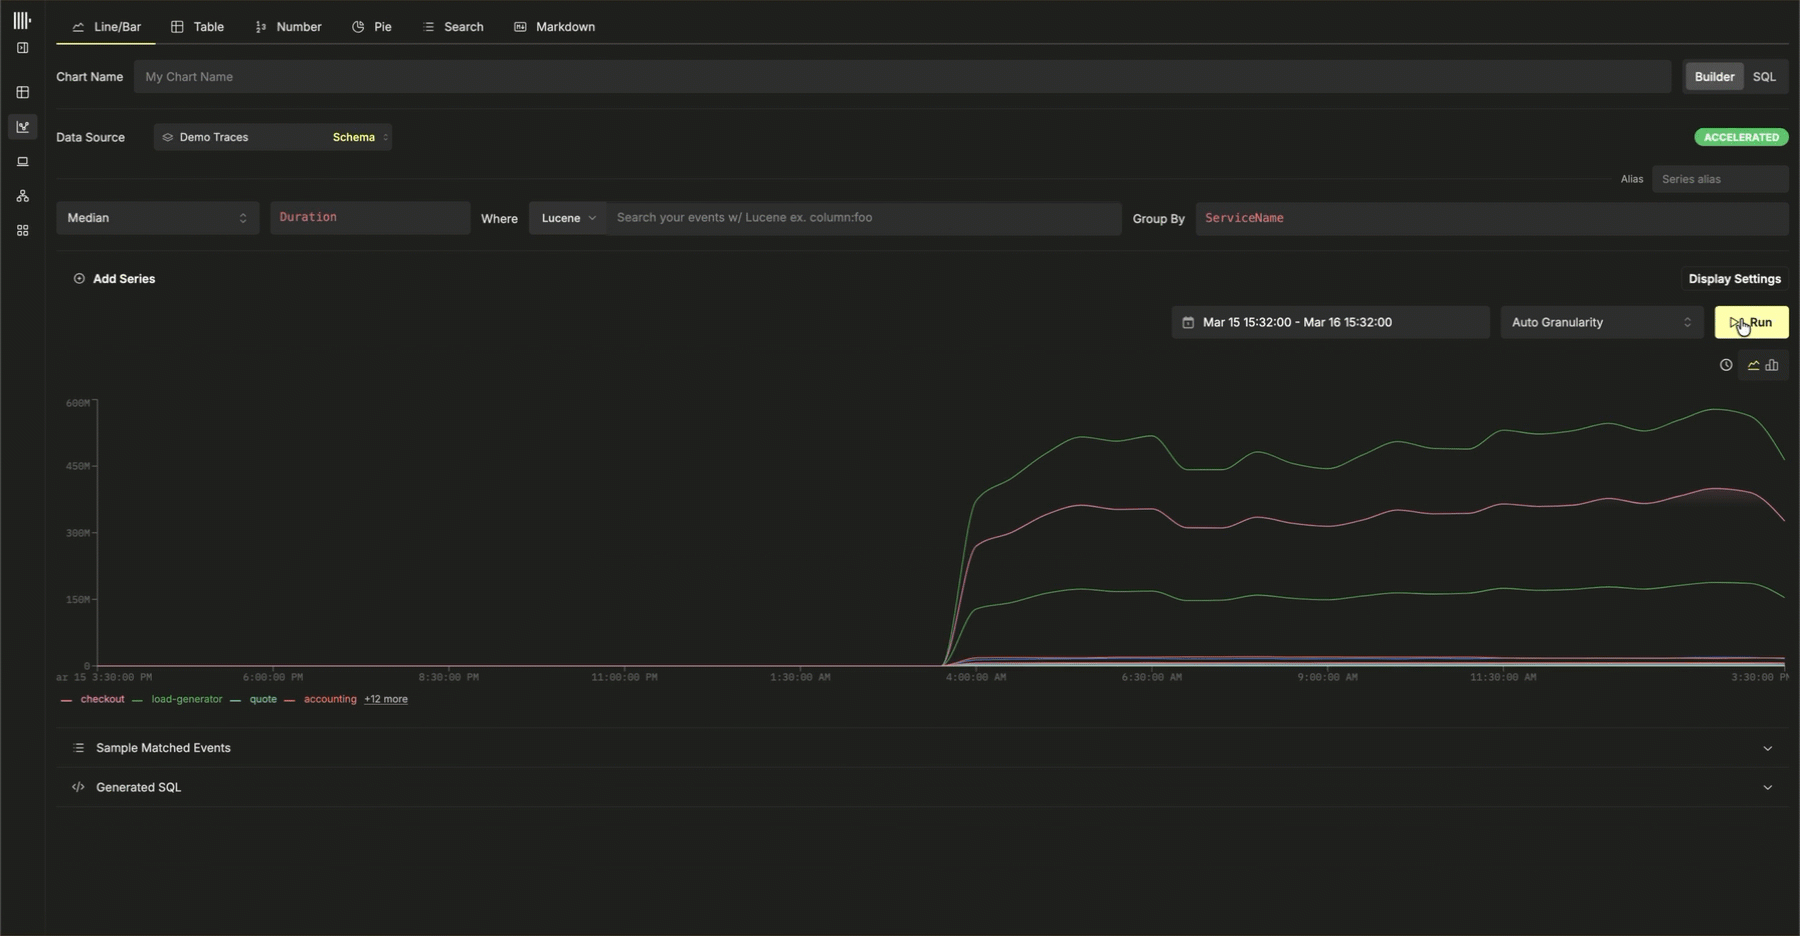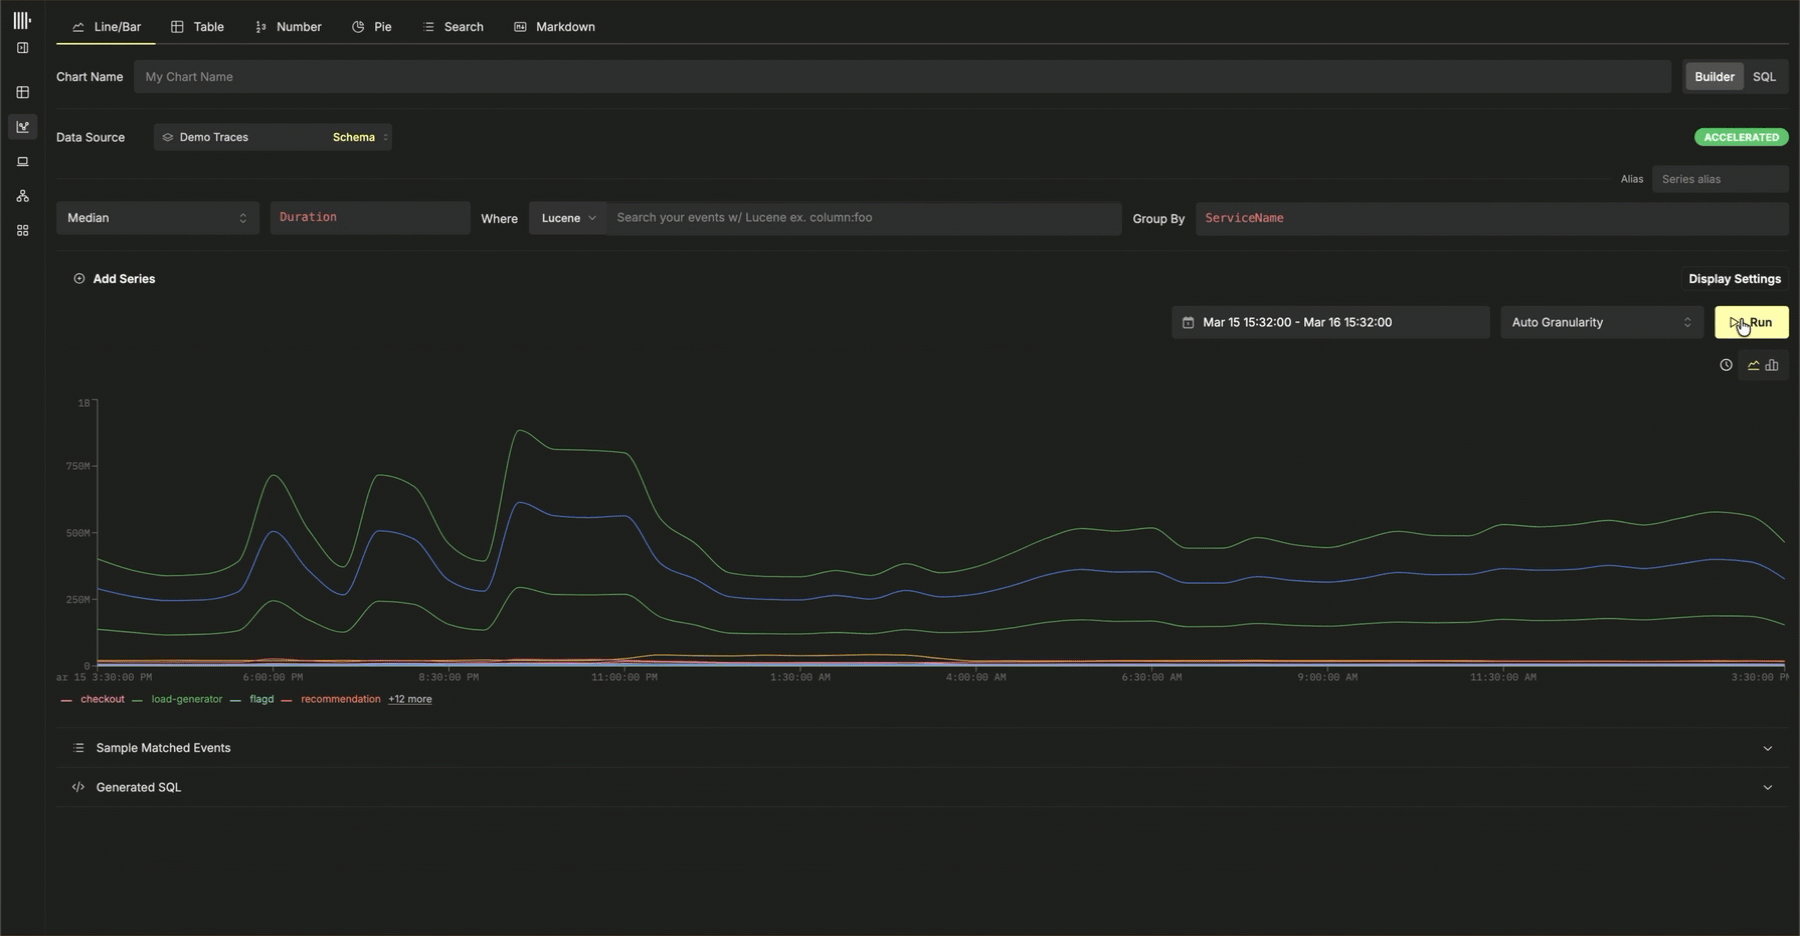
数十億行に及ぶ単一の大規模集計は、クラスターのリソースを独占したり、タイムアウトを引き起こしたりする可能性があるため、この工夫は重要です。チャンク分割によって各スキャンの負荷が抑えられ、メモリ消費量が削減されるとともに、プログレッシブレンダリングが可能になります。
マテリアライズドカラムの自動活用
ClickStack における初期の最適化の 1 つに、Map 属性に対するマテリアライズドカラムの自動活用がありました。
オブザーバビリティデータは本質的に半構造化されています。Kubernetes のラベルやスパン属性などのリソース属性は、通常、Map 型を使用して任意のキー・バリューのペアとして保存されます。これにより、事前にあらゆるカラムを定義しておく必要がなく、柔軟な取り込みが可能になります。しかし、実行時に Map のキーをクエリするのは高コストです。ClickHouse は Map 構造全体を読み取って内部の全キーを処理しなければならず、I/O と CPU の使用量が増加します。
最近では、各属性に対して専用の型付きサブカラムを作成する JSON 型の利用も始まっています。これにより Map 型の欠点は緩和されますが、挿入時のオーバーヘッドという独自のコストが発生します。
簡略化したトレーステーブルのスキーマを見てみましょう。
CREATE TABLE otel.otel_traces
(
`Timestamp` DateTime64(9) CODEC(Delta(8), ZSTD(1)),
`TraceId` String CODEC(ZSTD(1)),
`SpanId` String CODEC(ZSTD(1)),
`ServiceName` LowCardinality(String) CODEC(ZSTD(1)),
`ResourceAttributes` Map(LowCardinality(String), String) CODEC(ZSTD(1)),
`SpanAttributes` Map(LowCardinality(String), String) CODEC(ZSTD(1)),
`Duration` UInt64 CODEC(ZSTD(1)),
-- Materialized column extracted at ingest time
`PodName` String MATERIALIZED ResourceAttributes['k8s.pod.name'],
INDEX idx_res_attr_key mapKeys(ResourceAttributes) TYPE bloom_filter(0.01) GRANULARITY 1,
INDEX idx_res_attr_value mapValues(ResourceAttributes) TYPE bloom_filter(0.01) GRANULARITY 1,
INDEX idx_duration Duration TYPE minmax GRANULARITY 1
)
ENGINE = MergeTree
PARTITION BY toDate(Timestamp)
ORDER BY (ServiceName, SpanName, toDateTime(Timestamp));マテリアライズドカラムを使用しない場合、フィルターは次のようになります。
ResourceAttributes['k8s.pod.name'] = 'payments-7f9d8c'マテリアライズドカラムを使用すると、クエリは次のようになります。
PodName = 'payments-7f9d8c'取り込み時に属性を物理カラムへ抽出しておくことで、実行時の Map 展開を回避できます。ClickHouse は Map 構造全体をスキャンしてデコードする代わりに、必要なカラムのみを読み取ることが可能になります。通常リカラムは、圧縮率の向上やより効果的なプルーニングといったメリットも享受できます。
ClickStack は、よく使われる属性がマテリアライズドカラム化されているかどうかを自動検出します。ユーザーが k8s.pod.name でフィルタリングすると、生成されるクエリは透過的に PodName カラムを対象とします。ユーザー自身でスキーマ最適化を管理することなく、頻出属性に対する高速なフィルタリングと、大量データ下での安定したパフォーマンスを得られます。
コスト選択を伴うマテリアライズドビューの自動活用
ClickStack における比較的最近の最適化が、マテリアライズドビューの自動活用です。ClickStack では、ユーザーはソースからダッシュボード、グラフ、検索機能、セッションリプレイ、サービスマップを構築します。各ソースは基盤となる ClickHouse テーブルに対応しています。2026 年初めより、ソースに 1 つ以上の増分マテリアライズドビューを関連付けられるようになり、集計負荷の高い代表的な可視化データを事前に集約できるようになりました。
ClickHouse における増分マテリアライズドビューは、静的なスナップショットではありません。常時稼働するトリガーに近く、ソーステーブルに新しいデータが挿入されると、挿入されたブロックごとにビューが集計を実行し、その結果の集計状態を別のターゲットテーブルに書き込みます。これらの部分的な状態はバックグラウンドで段階的にマージされ、クエリ実行時に生データを集計するのと同じ結果を、ごくわずかなコストで算出します。
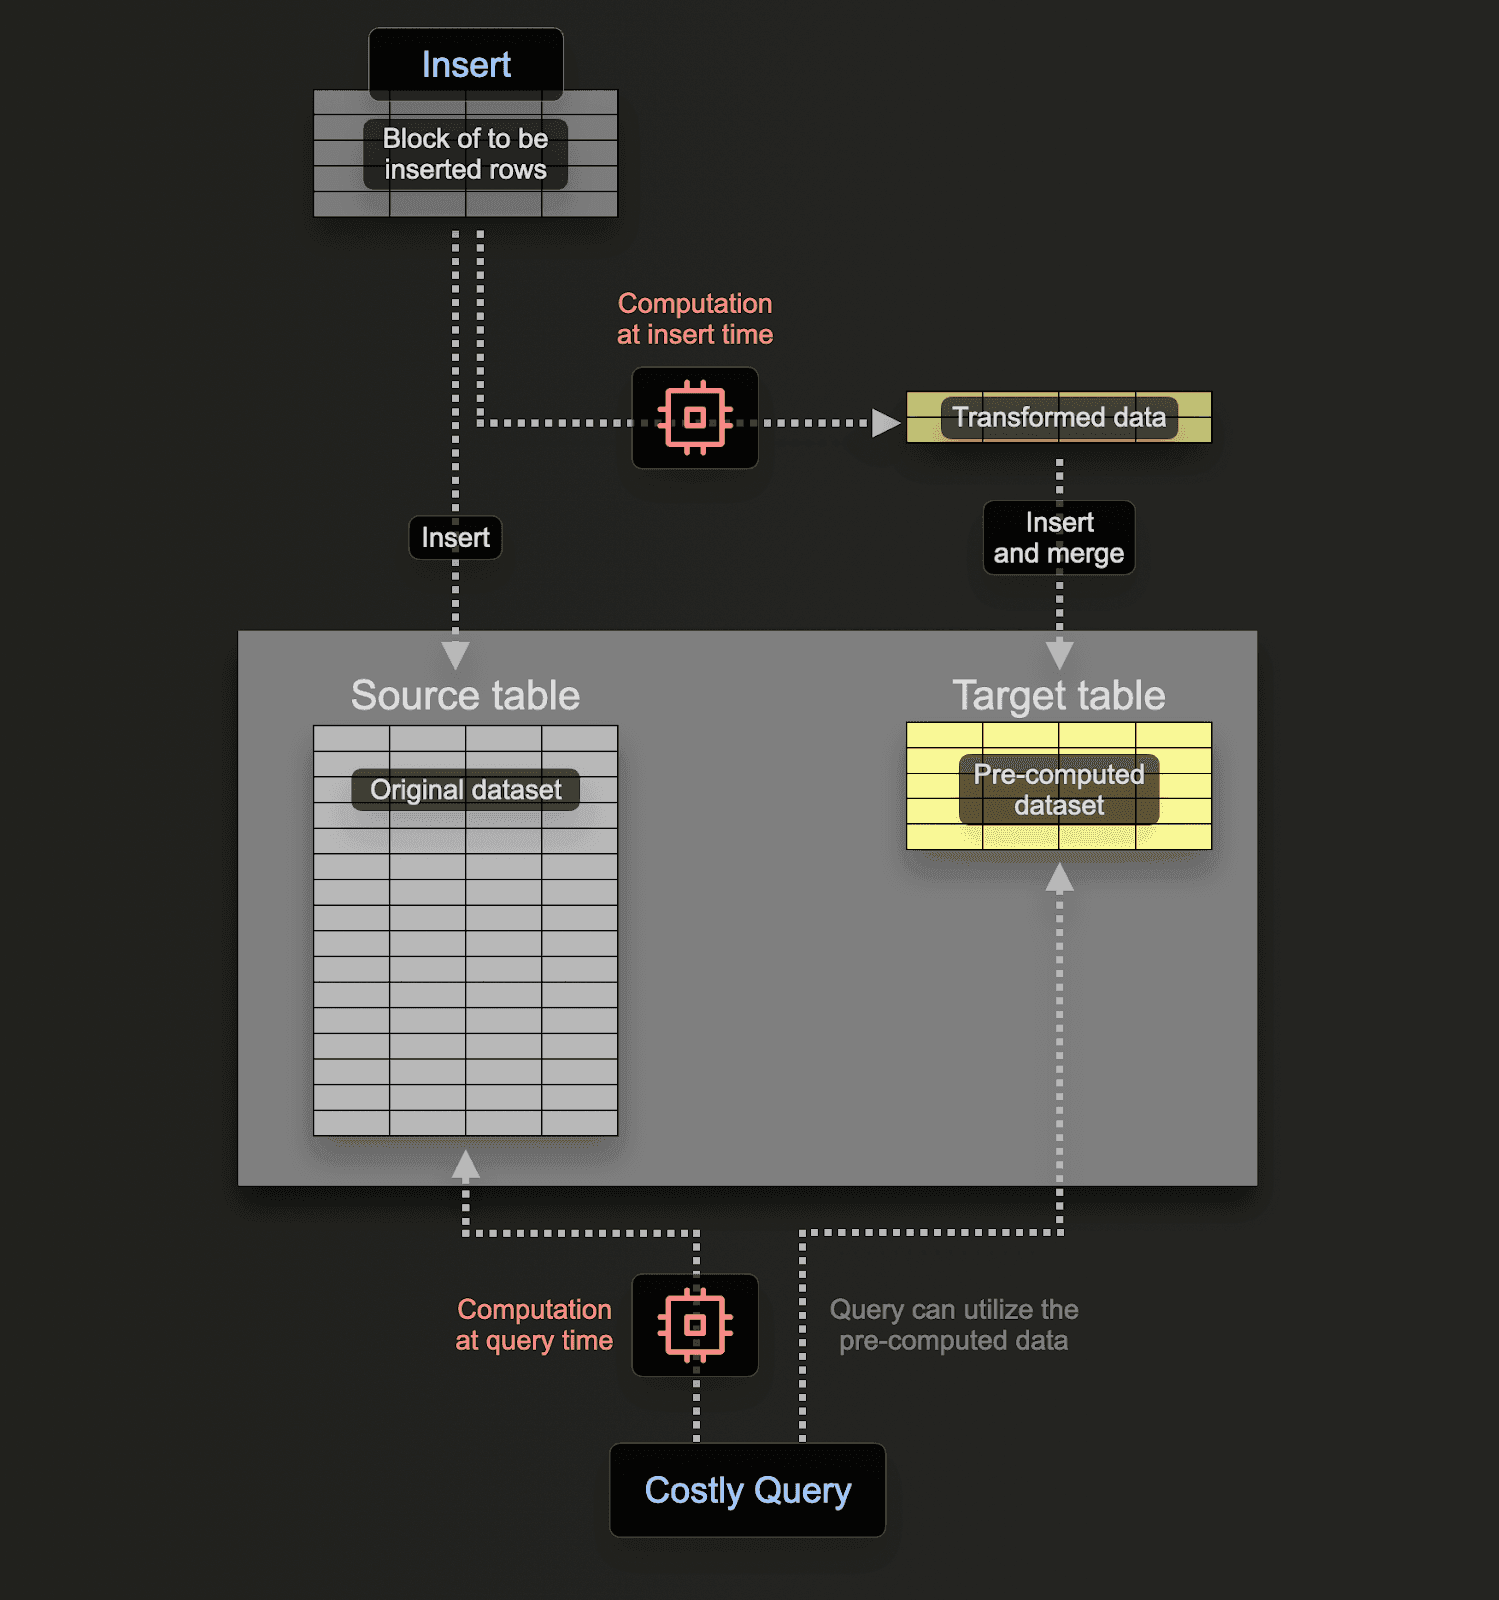
実質的に、ユーザーはクエリのコストをクエリ実行時から挿入時へとシフトさせ、そのコストをすべての挿入処理全体に分散(償却)させることで、読み取り時のパフォーマンスを軽量かつ高速に保っています。
具体的な例を考えてみましょう。ある一般的な可視化で、「サービスおよびステータスコード別にグループ化した、1 分あたりのリクエスト数と平均所要時間」が必要だとします。
SELECT
toStartOfMinute(Timestamp) AS time,
ServiceName,
StatusCode,
count() AS count,
avg(Duration) AS avg_duration
FROM otel.otel_traces
WHERE Timestamp >= now() - INTERVAL 24 HOUR
GROUP BY time, ServiceName, StatusCode
ORDER BY time;-- results omitted for brevity
38210 rows in set. Elapsed: 0.790 sec. Processed 166.45 million rows, 2.99 GB (210.65 million rows/s., 3.79 GB/s.) Peak memory usage: 598.18 MiB.ダッシュボードが読み込まれるたびに生のトレースからこれを再計算する代わりに、集計状態を保持するターゲットテーブルを作成します。
CREATE TABLE otel.otel_traces_1m
(
`Timestamp` DateTime,
`ServiceName` LowCardinality(String),
`StatusCode` LowCardinality(String),
`count` SimpleAggregateFunction(sum, UInt64),
`avg__Duration` AggregateFunction(avg, UInt64)
)
ENGINE = AggregatingMergeTree
ORDER BY (Timestamp, ServiceName, StatusCode);続いて、データが挿入されるたびにそれらの状態を継続的に維持する増分マテリアライズドビューを定義します。
CREATE MATERIALIZED VIEW otel_v2.otel_traces_1m_mv
TO otel.otel_traces_1m
AS
SELECT
toStartOfMinute(Timestamp) AS Timestamp,
ServiceName,
StatusCode,
count() AS count__,
avgState(Duration) AS avg__Duration
FROM otel.otel_traces
GROUP BY Timestamp, ServiceName, StatusCode;事前集約されたテーブルへのクエリは軽量になり、消費リソースも少なくなります。
SELECT
toStartOfMinute(Timestamp) AS time,
ServiceName,
StatusCode,
sum(count) AS count,
avgMerge(avg__Duration) AS avg_duration
FROM otel_v2.otel_traces_1m
WHERE Timestamp >= now() - INTERVAL 24 HOUR
GROUP BY time, ServiceName, StatusCode
ORDER BY time;38246 rows in set. Elapsed: 0.027 sec. Processed 41.22 thousand rows, 1.57 MB (1.52 million rows/s., 57.80 MB/s.) Peak memory usage: 21.34 MiB.この例では、クエリが 30 倍高速化し、メモリ使用量は 28 分の 1 に削減されました。
マテリアライズドビューを作成したら、ユーザーはそれをソースに登録するだけです。
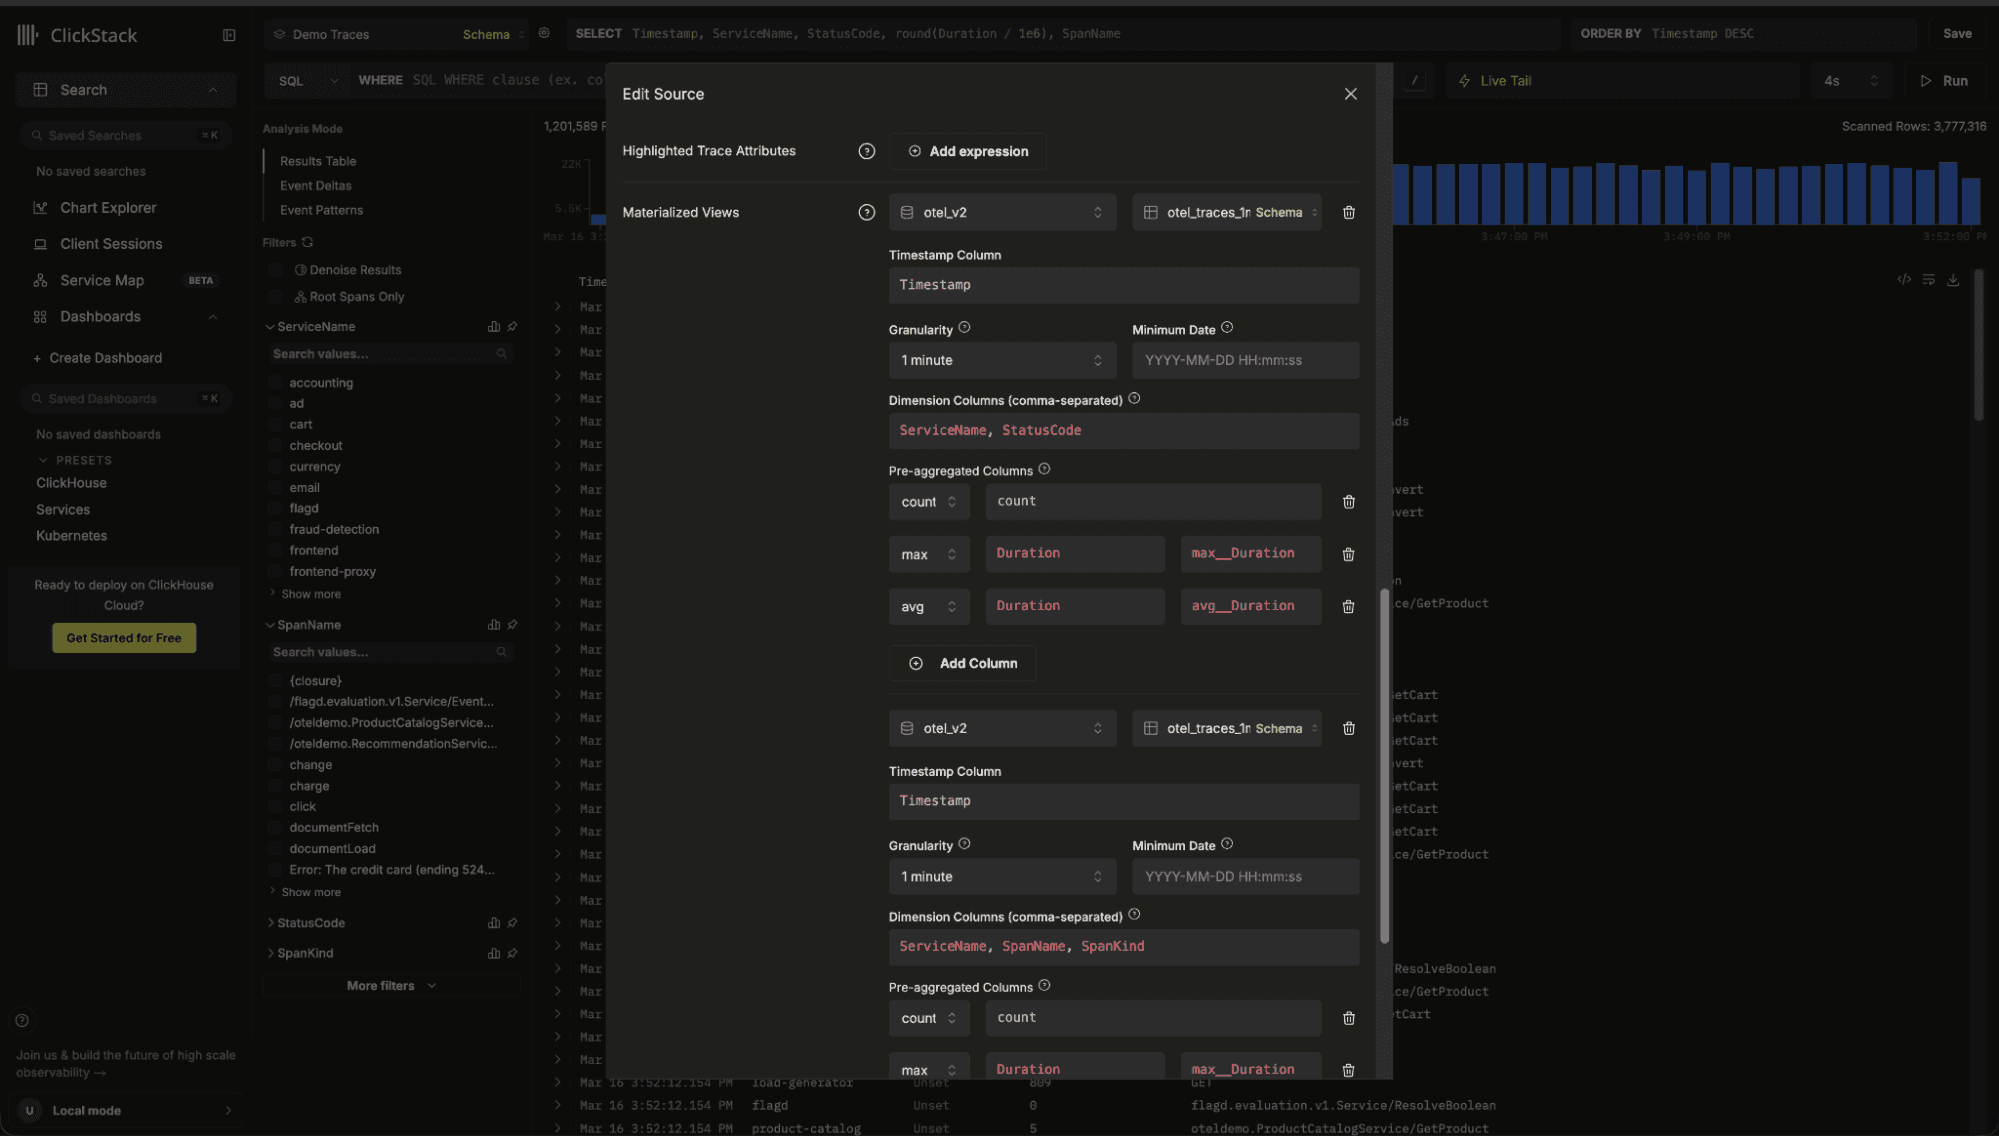
可視化やアラートが実行される際、ClickStack はベーステーブルと登録されているすべてのビューを評価し、適合する各候補に合わせてクエリを書き換えた上で、ClickHouse の EXPLAIN ESTIMATE に基づくコストモデルを用いて最適な選択肢を選出します。これにより、クエリが読み取る必要のある行数が示されます。
EXPLAIN ESTIMATE
SELECT
toStartOfMinute(Timestamp) AS time,
ServiceName,
StatusCode,
sum(count) AS count,
avgMerge(avg__Duration) AS avg_duration
FROM otel.otel_traces_1m
WHERE Timestamp >= (now() - toIntervalHour(24))
GROUP BY
time,
ServiceName,
StatusCode
ORDER BY time ASC┌─database─┬─table──────────┬─parts─┬──rows─┬─marks─┐
1. │ otel_v2 │ otel_traces_1m │ 1 │ 41220 │ 5 │
└──────────┴────────────────┴───────┴───────┴───────┘
1 row in set. Elapsed: 0.006 sec.クエリを満たせるマテリアライズドビューが複数存在する場合、ClickStack はスキャンする行数とグラニュール数を最小限に抑えられるビューを自動的に選択します。適合するビューがない場合はソーステーブルへとフォールバックするため、ダッシュボードを変更することなくそのまま動作させながら、可能な限り高速化の恩恵を受けられます。
エンドユーザーの視点から見れば、この高速化は完全に自動で行われます。ユーザーはこれまでとまったく同じようにダッシュボードの構築やデータの探索を続けられます。クエリを書き換えたり、グラフの定義を変更したり、特定のテーブルを選択したりする必要はありません。適合するマテリアライズドビューが存在する場合、ClickStack が透過的にクエリをルーティングします。
目に見える違いは、パフォーマンスの向上と、UI に控えめに表示される高速化インジケーターだけです。稲妻のアイコンは、可視化がマテリアライズドビューから提供されていることを示します。ユーザーはこのアイコンをクリックして、どのビューが選択されたかを確認し、クエリが高速化されたことを確かめられます。それ以外は使い勝手も変わらず、大規模環境でも単にパフォーマンスが向上するだけです。
インデックスを活用するためのクエリ書き換え
ClickHouse は、MinMax、set、Text、Bloom フィルターなど、いくつかの種類のデータスキッピングインデックスを提供しています。これらのインデックスは、通常 1 グラニュールあたり約 8,192 行というグラニュール単位でメタデータを保持します。個々の行にインデックスを付けるのではなく、グラニュールを読み込む前にその全体をスキップできるかどうかを ClickHouse が判断できるようにします。最も高速に処理できるデータとは、そもそも一度も読み込まないデータです。
ユーザーは、数値カラムに MinMax インデックスを付与したり、文字列カラムに Bloom フィルターを付与したり、トークン化された全文検索向けにテキストインデックスを付与したりできます。ただし、これらのインデックスを効果的に使用するには、インデックスの式に一致する形でクエリを記述する必要があります。すべての関数がすべてのインデックスタイプを活用できるわけではありません。これは、正確性と予測可能な動作を保証するための ClickHouse の意図的な設計上の選択です。
ClickStack はテーブルに定義されたスキッピングインデックスを検出し、アナライザーがその使用を正しく推論できるようにクエリを書き換えます。これにより、インデックスに対応した適切な関数が確実に使用され、I/O が最小限に抑えられて不要なグラニュールのスキャンが回避されます。
ユーザーが Lucene スタイルのクエリ文字列を使用してログを検索する、よくあるケースを考えてみましょう。この場合、ユーザーは SQL を記述していません。
全文ログスキーマを考えてみましょう:
CREATE TABLE otel_logs (
Body String,
...
INDEX idx_body_text Body TYPE text(tokenizer = splitByNonAlpha)
)ユーザーが特定の期間にわたって「error」という語を検索するとします。単純な実装では次のようなクエリを発行する可能性があります:
SELECT *
FROM otel_logs
WHERE (Timestamp >= '2026-01-01')
AND (Timestamp < '2026-03-14')
AND (Body ILIKE '% error %');1 row in set. Elapsed: 0.708 sec. Processed 91.56 million rows, 14.91 GB (129.37 million rows/s., 21.06 GB/s.)これは動作しますが、テキストインデックスを活用していません。しかし ClickStack はインデックスが利用可能であることを検出し、テキストインデックスを活用するために特別に設計された hasAllTokens() 関数を使用します:
SELECT *
FROM otel_logs
WHERE (Timestamp >= '2026-01-01')
AND (Timestamp < '2026-03-14')
AND hasAllTokens(Body, 'error');1 row in set. Elapsed: 0.029 sec. Processed 2.86 million rows, 22.92 MB (97.87 million rows/s., 784.96 MB/s.)「connection refused」のような複数語のフレーズの場合、ClickStack は順序の意味論を保持するために、インデックスの使用と確認フィルターを組み合わせます:
SELECT *
FROM otel_logs
WHERE (Timestamp >= '2026-01-01')
AND (Timestamp < '2026-03-14')
AND hasAllTokens(Body, 'connection refused')
AND (lower(Body) LIKE lower('%connection refused%'));その結果、テキストインデックスに対する単一のマルチトークン検索となり、スキャンされるグラニュールが大幅に削減されます。
Bloom フィルターを活用する場合も同様の注意が必要です。この場合、ClickStack は Bloom フィルターインデックスに使用されている式を検出し、マッチングに適した関数と適切に結合されるようにします。ログの以下の (簡略化した) スキーマを考えてみましょう:
CREATE TABLE otel_logs (
Body String,
INDEX idx_body_bloom tokens(lower(Body))
TYPE bloom_filter(0.001)
GRANULARITY 8
)大小文字を区別しないマッチングを実現するために body を lower にしていることに注意してください。
ユーザーが「error」を検索する場合、hasToken 関数を使用する必要がありますが、インデックスが確実に使用されるように lower 関数と組み合わせる必要もあります。ClickStack は式を検出し、トランスパイル後の最終的な SQL にこれを反映します:
SELECT *
FROM otel_logs
WHERE (Timestamp >= '2026-01-01')
AND (Timestamp < '2026-03-14')
AND hasAll(
tokens(lower(Body)),
tokens(lower('error'))
);重要なのは、左辺が保存されたインデックス式と完全に一致している点です。これにより ClickHouse は Bloom フィルターを有効化し、そのトークンを確実に含まないグラニュールをスキップできます。
デフォルトの OTel テーブルにおける LogAttributes や ResourceAttributes などの Map ベースのカラムにも同じ原則が適用されます。これらには、属性キーまたは値が存在しない場合にグラニュールをスキップできるように設計された、mapKeys(...) および mapValues(...) 上の Bloom フィルターインデックスが設定されていることがよくあります。
ユーザーが次を検索したとします:
LogAttributes.error.message:"Failed"ClickStack はこれを単に次のように変換するだけでは不十分です:
LogAttributes['error.message'] ILIKE '%Failed%'mapKeys(LogAttributes) 上の Bloom フィルターを有効化するために、ClickStack はプランナーにそのキーがアクセスされていることを通知するインデックスヒントを追加します:
AND indexHint(mapContains(LogAttributes, 'error.message'))このヒントはクエリの正確性を変えるものではありません。単にフィルターに一致するグラニュールを返すが、それらを読み取らない (Map の I/O アクセスを節約する) ように ClickHouse に指示するだけです。これにより ClickHouse は、そのキーをまったく含まないグラニュール全体をスキップできます。カーディナリティの高い半構造化データの場合、行レベルの評価が行われる前にデータセットの大部分を除外できます。
ClickHouse のスキッピングインデックスは強力ですが、クエリがインデックス定義と正確に一致している場合にのみ機能します。関数の使い方におけるわずかな違いが、グラニュールをスキップするかスキャンするかの違い、ひいては高速なクエリか低速なクエリかの違いにつながる可能性があります。
スキーマを検査し、インデックス式を正確に反映するようにクエリを書き換えることで、ClickStack は定義されたインデックスが実際に使用されるようにし、ユーザーが手動で SQL を調整することなく予測可能なパフォーマンスを提供します。
主キーの認識
ClickHouse では、主キーがデータのプルーニングにおいて中心的な役割を果たします。主キーが一意性を強制する従来のデータベースとは異なり、ClickHouse の主キーはデータの物理的なソート順を定義します。主キーに沿った式を使用してフィルター処理や順序付けを行うクエリにより、エンジンはデータをスキャンすることなく大規模な範囲を素早く除外できます。
ClickStack では、ユーザーは独自のスキーマと主キーを自由に定義し、一般的なアクセスパターンに合わせることができます。ただし、一般的なオブザーバビリティワークロード向けに最適化された OpenTelemetry のログ、トレース、メトリクス向けの適切なデフォルト値も用意されています。これらは通常、Timestamp と時間的コンポーネントを組み合わせたものです。たとえば、一般的なキーは次のようになります:
ORDER BY (toStartOfMinute(Timestamp), ServiceName)この構造により、クエリは時間とサービスの両方で効率的にデータをプルーニングできます。
主キーを最大限に活用するために、ClickStack はタイムスタンプフィルターを書き換えて、キーで使用されている式と一致させます。たとえば、ユーザーが時間範囲でフィルターする場合、単純なクエリは次のようになります:
SELECT *
FROM otel_logs
WHERE Timestamp >= '2026-03-14 10:00:00'
AND Timestamp < '2026-03-14 11:00:00'
ORDER BY Timestamp DESC;テーブルが toStartOfMinute(Timestamp) でソートされている場合、ClickStack はキー式と一致するようにフィルターを拡張します:
SELECT *
FROM otel_logs
WHERE toStartOfMinute(Timestamp) >= toStartOfMinute('2026-03-14 10:00:00')
AND toStartOfMinute(Timestamp) < toStartOfMinute('2026-03-14 11:00:00')
AND Timestamp >= '2026-03-14 10:00:00'
AND Timestamp < '2026-03-14 11:00:00'
ORDER BY toStartOfMinute(Timestamp) DESC;フィルターに主キー式を含めることで、ClickHouse はパーティションとグラニュールをはるかに積極的にプルーニングできます。実際には、これによりスキャンされるデータ量を大幅に削減できます。
同じ最適化は、主キーが toStartOfDay(Timestamp) などの粗い式を使用している場合にも適用されます。ClickStack は派生式と生のタイムスタンプの両方に自動的にフィルターを追加し、効率的なインデックスプルーニングを可能にしながら、狭い時間枠にわたる正確なフィルター処理を保証します。社内テストでは、このアプローチによりクエリレイテンシが約 25% 削減され、複雑なクエリではさらに大きな効果が得られました。
インテリジェントサンプリング
ClickStack の機能の一部では、視覚的なインサイトを生成するために非常に大規模なデータセットを分析する必要があります。数十億行にわたってこれらのクエリを実行すると計算コストが高くなり、レイテンシとリソース消費が大幅に増加する可能性があります。インターフェースの応答性を維持しながら正確なインサイトを提供し続けるために、ClickStack は代表的な結果を維持しつつ読み取りデータ量を削減するインテリジェントサンプリング手法を適用しています。
サンプリングの目的は、単にデータセットのサイズを小さくすることだけではありません。必要に応じてサンプルが確定的であり、より大きなデータセットを統計的に代表していることも保証しなければなりません。機能に応じて、ClickStack は精度とパフォーマンスのバランスを取るさまざまなサンプリング戦略を適用します。
以下は、ClickStack 全体でサンプリングがどのように使用されているかのいくつかの例です。
Event Deltas - 確定的パートオフセットサンプリング
Event Deltas 機能は、選択した時系列領域内のイベント (「外れ値」) の属性分布を、領域外のイベント (「インライア」) と比較します。これには、各グループから代表的なイベントの小さなセットについて完全な行を取得する必要があります。
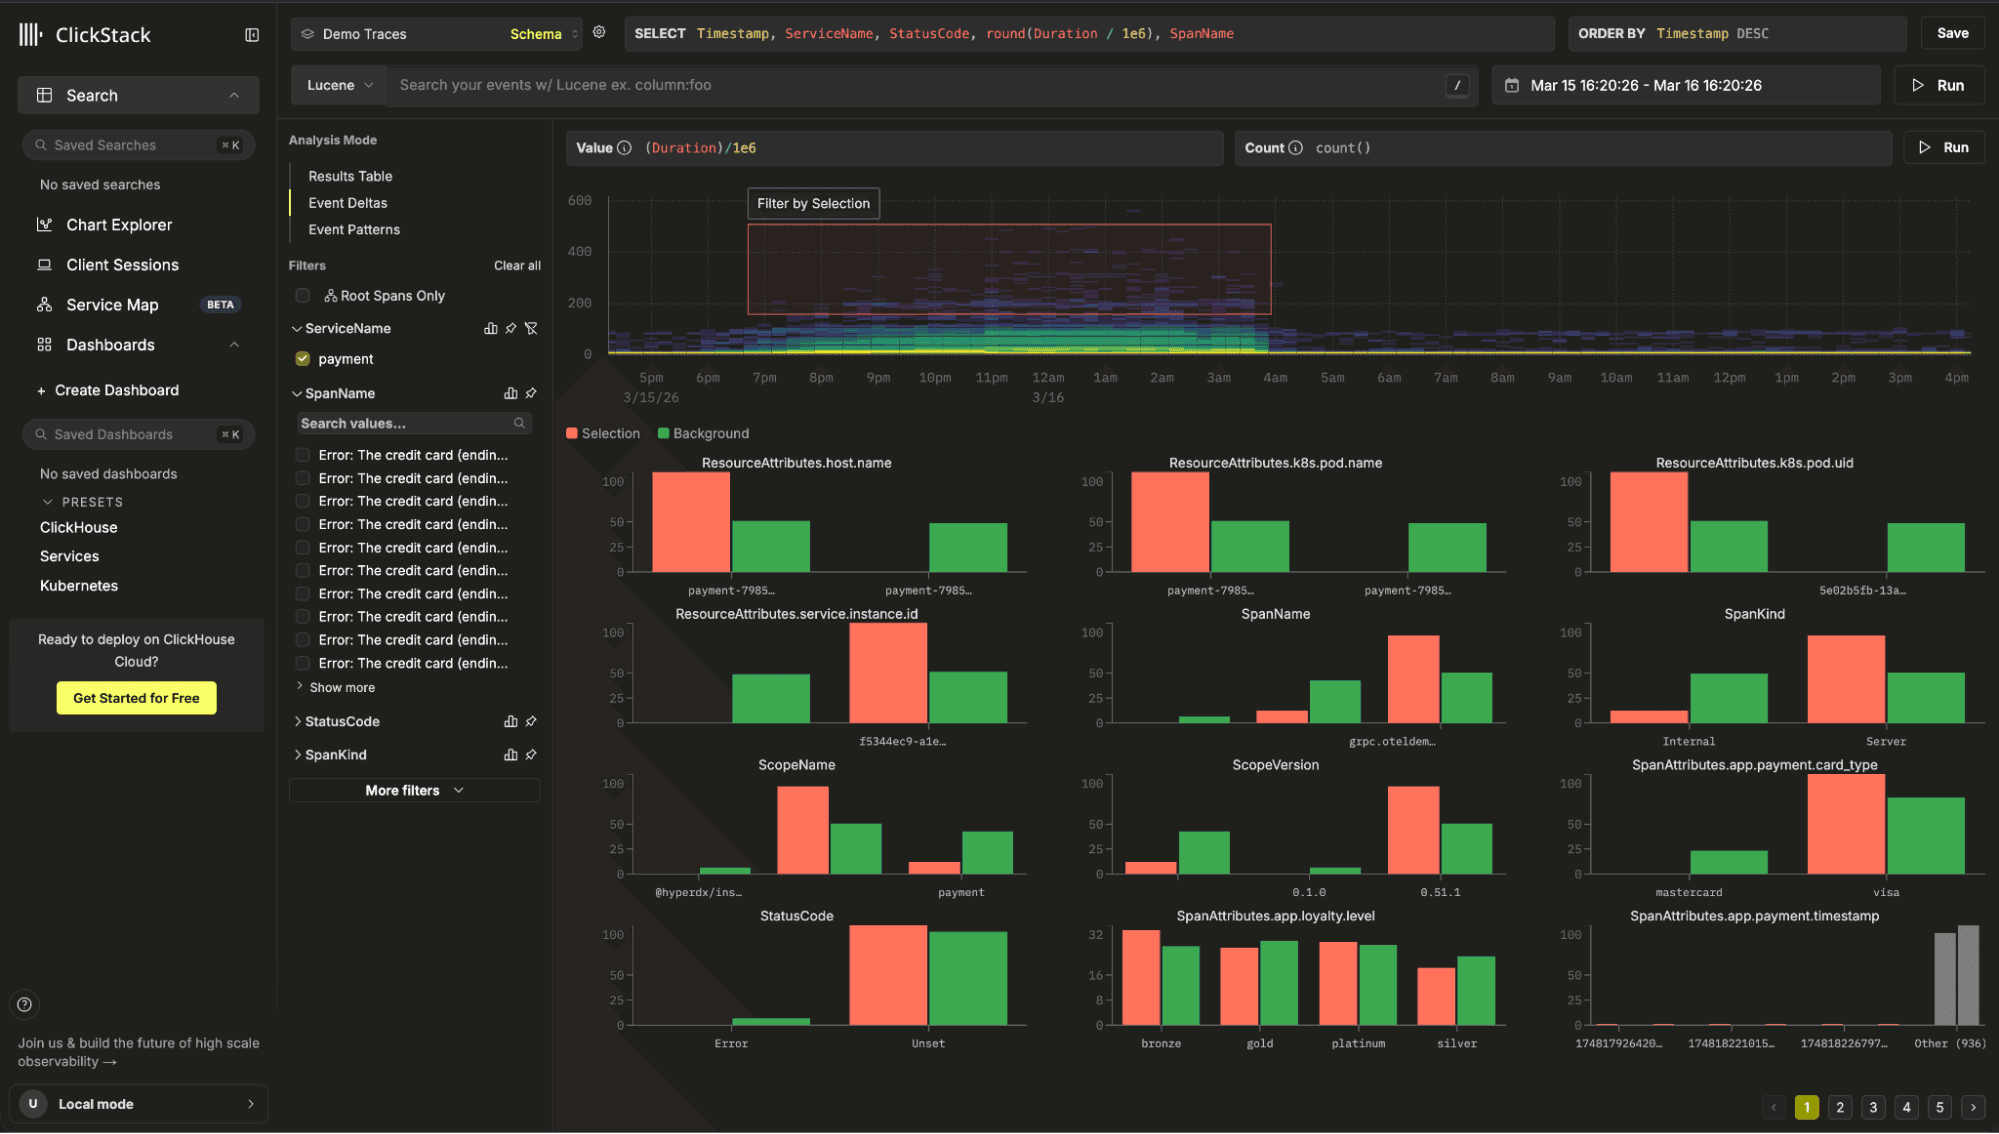
たとえば、あるユーザーが特定の期間で Duration が 500 から 1000 の間であるサブセットをインライアとして選択したとします。単純なサンプリングアプローチでは、次のように行を取得しようとする可能性があります:
SELECT *
FROM otel_traces
WHERE Timestamp >= 1700000000
AND Timestamp <= 1700003600
AND Duration >= 500
AND Duration <= 1000
ORDER BY rand()
LIMIT 1000;ただし ClickHouse では、行が読み取られてフィルター処理された後に LIMIT が適用されます。ORDER BY rand() と組み合わせると、フルスキャンとグローバルソートが発生します。
ClickStack は代わりに、内部の行アドレスに基づいた 2 パスの確定的サンプリング手法を使用します。
WITH PartIds AS (
SELECT tuple(_part, _part_offset)
FROM otel_traces
WHERE Timestamp >= 1700000000
AND Timestamp <= 1700003600
AND Duration >= 500
AND Duration <= 1000
ORDER BY cityHash64(SpanId) DESC
LIMIT 1000
)_part カラムと _part_offset カラムは、ClickHouse パート内における行の内部ストレージ位置を表します。クエリ間でサンプルを安定させるため、ClickStack は cityHash64(SpanId) を使用して行を並べ替えます。スパン ID はランダムに生成される識別子であるため、そのハッシュは行を均一に分散させます。これにより、rand() に依存せずに安定したサンプルが生成されます。有効なサンプルサイズも適応的です (例: sampleSize = clamp(500, ceil(totalRows * 0.01), 5000))。
このクエリから返されたオフセットは、行のサブセットを選択するために使用されます。
SELECT *
FROM otel_traces
WHERE Timestamp >= 1700000000
AND Timestamp <= 1700003600
AND Duration >= 500
AND Duration <= 1000
AND indexHint((_part, _part_offset) IN PartIds)
ORDER BY cityHash64(SpanId) DESC
LIMIT 1000;これらのアドレスを indexHint() 内にラップすることで、プランナーはデータの読み取りを回避しながら、選択された行を含まないグラニュールをプルーニングできます。その結果、データセット全体をスキャンすることなく確定的サンプルが得られます。
ファセット向けの値分布サンプリング
もう 1 つの一般的なワークフローは、フィルター処理されたデータセット内で上位の属性値を表示することです。ClickStack で検索すると、存在するフィールドを示し、それらのフィールドの値の代表的なサンプルを提供するために、ファセットが結果とともに表示されます。これにより、ユーザーはデータの形状を素早く把握し、フィルターの絞り込みに役立てることができます。
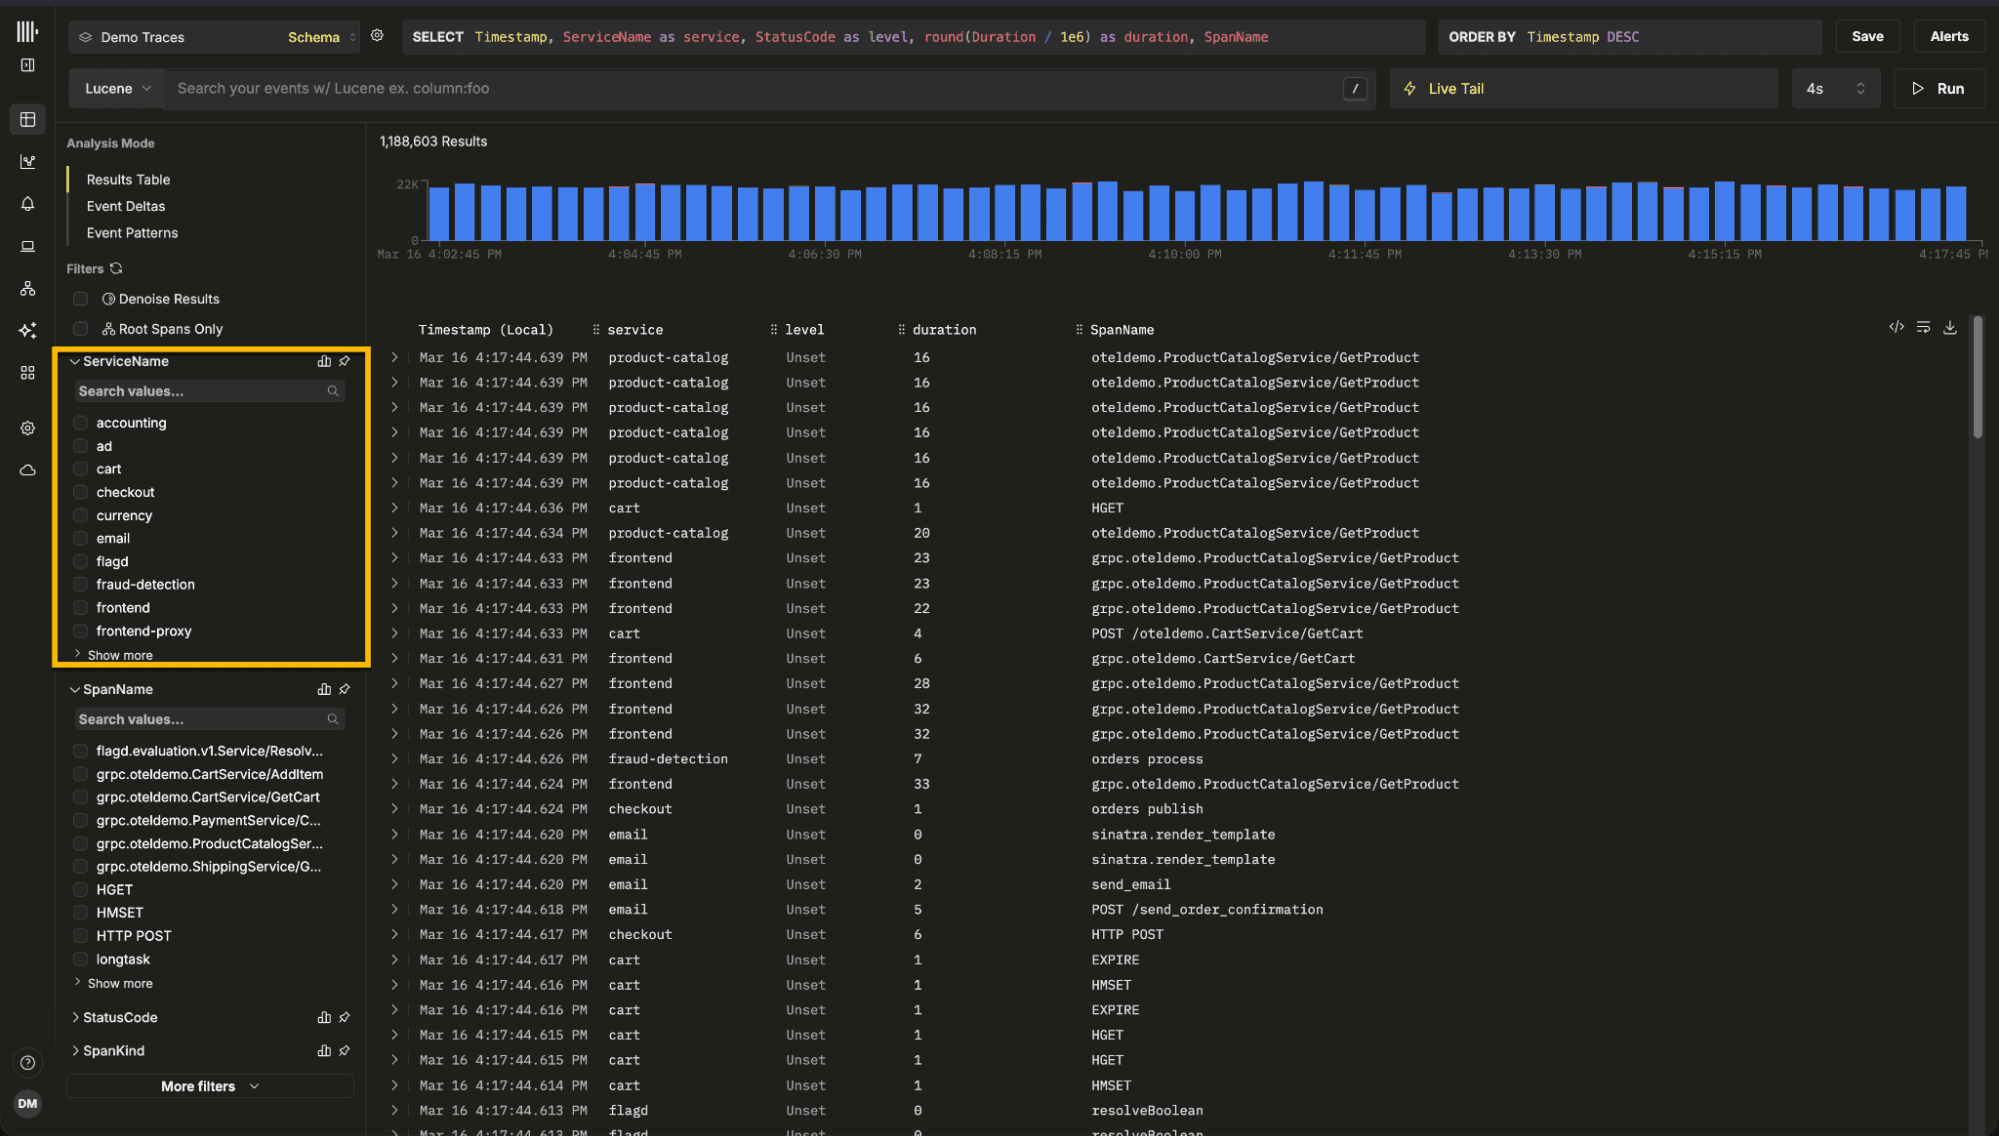
数十億行にわたって正確な分布を計算するとコストが高くなります。代わりに ClickStack は適応型モジュロサンプリングを実行します。たとえば、リソース属性 http.status_code の値を生成したいとします。
WITH tableStats AS (
SELECT
count() AS total,
greatest(CAST(total / 100000 AS UInt32), 1) AS sample_factor
FROM otel_logs
WHERE Timestamp >= '2024-01-01'
AND Timestamp < '2024-03-01'
)
SELECT
SpanAttributes['http.status_code'] AS value,
count() AS count
FROM otel_logs
WHERE Timestamp >= '2026-01-01'
AND Timestamp < '2026-03-01'
AND cityHash64(Timestamp, rand()) %
(SELECT sample_factor FROM tableStats) = 0
GROUP BY value
ORDER BY count DESC
LIMIT 100;sample_factor はサンプリングレートを動的に調整するため、データセットのサイズに関係なく約 10 万行が処理されます。これにより、代表的な分布を生成しながらクエリの高速性を維持できます。
デルタサンプリング手法とは異なり、このクエリは一致する行をスキャンしますが、計算コストの大部分が発生する GROUP BY に渡される行数を大幅に削減します。
カラムの完全な値セットを取得したい場合は、「Show More」を選択してデータセット全体の完全な分析を実行できる点に留意してください。
Event Patterns 向けサンプリング
ClickStack は Event Patterns も提供しており、ユーザーが繰り返し発生するログテンプレートや異常を特定できるようにします。
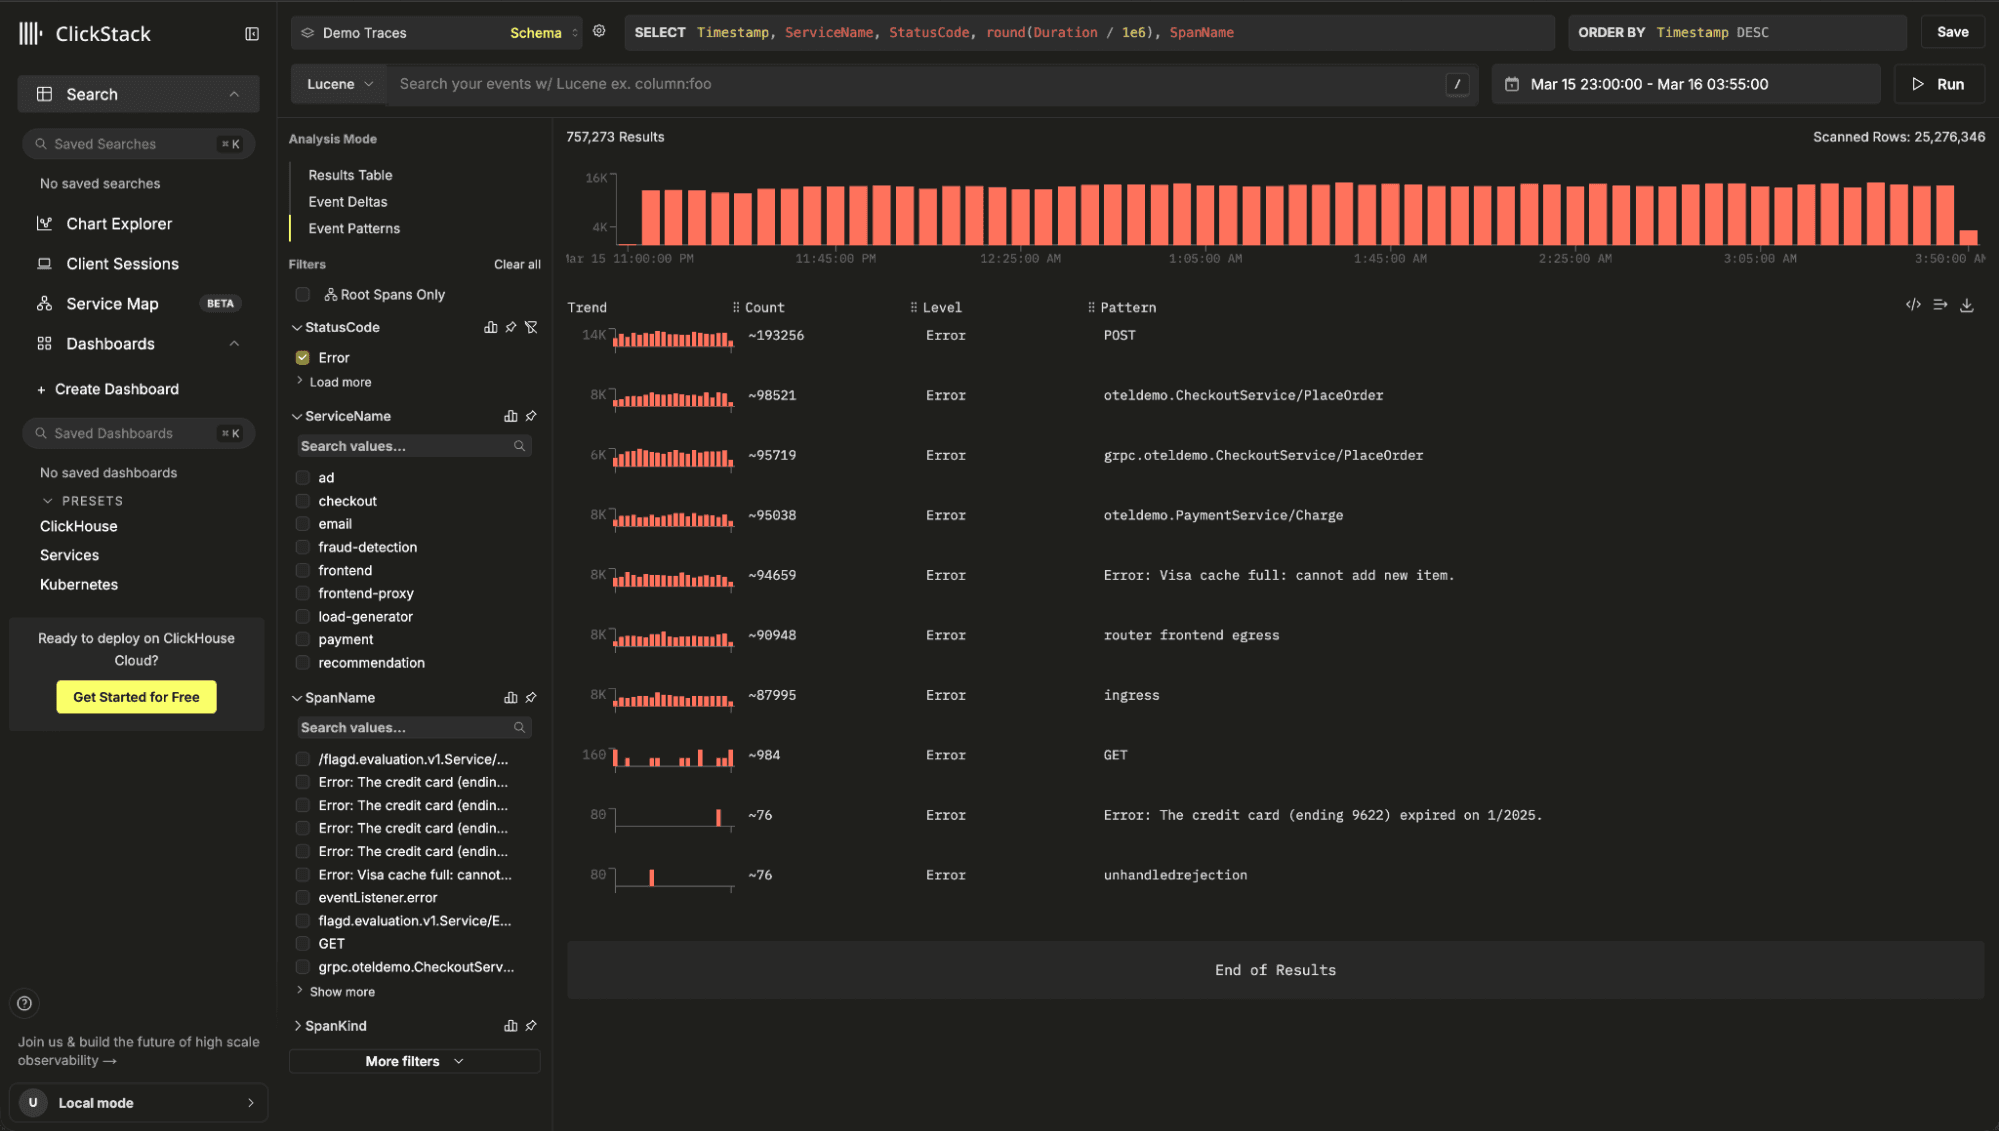
内部では、この機能は高性能なログテンプレートマイニングアルゴリズムである Drain3 を使用しています。Drain3 は固定深度のパースツリーを使用して類似のログメッセージのクラスターを段階的に構築するため、大規模なデータセットでもパターンを素早く特定できます。
ClickStack は取り込み時にクラスタリングを実行するのではなく、クエリ時に実行します。これにより、ユーザーはフィルター処理された任意のデータのサブセット内で動的にパターンを分析できます。数ペタバイトのデータに対して毎秒数ギガバイトに達する可能性がある ClickStack の取り込みレートにおいて、取り込み中にクラスタリングを実行すると大幅なオーバーヘッドが生じます。
Event patterns の詳細については、専用のブログ記事をご覧ください。
分析のインタラクティブ性を維持するため、ClickStack はクラスタリングの前にイベントの代表的なサブセットをサンプリングします:
WITH
now64(3) AS ts_to,
ts_to - INTERVAL 900 SECOND AS ts_from,
tableStats AS (
SELECT count() AS total
FROM otel_logs
WHERE TimestampTime >= ts_from
AND TimestampTime <= ts_to
)
SELECT
Body,
TimestampTime,
SeverityText,
ServiceName
FROM otel_logs
WHERE TimestampTime >= ts_from
AND TimestampTime <= ts_to
AND if(
(SELECT total FROM tableStats) <= 10000,
1,
cityHash64(TimestampTime, rand()) % greatest(CAST((SELECT total FROM tableStats) / 10000, 'UInt32'), 1) = 0
)
LIMIT 10000;このクエリは最大 1 万件のイベントを適応的にサンプリングし、支配的なパターンや異常なパターンを捉えつつ、クラスタリングが数秒で完了するようにします。
これらのサンプリング戦略は、ClickStack の設計における共通のテーマを浮き彫りにしています。それは、インタラクティブなオブザーバビリティには精度、パフォーマンス、リソース使用量のバランスが必要であり、多くの機能が基盤となるデータベースエンジンの慎重な活用に依存しているということです。
設定の重要性
上記で説明した最適化の多くには、意図的なクエリの書き換えやアルゴリズムの手法が含まれています。しかし、ClickStack のパフォーマンスのかなりの部分は、ClickHouse で適切な設定が使用されていることを保証することから得られています。
ClickHouse は進化し続けるシステムであり、ほぼすべてのリリースで新しいパフォーマンス機能や実行の最適化が導入されています。これらの改善点を活用するには、それらがいつ適用されるかを理解し、効果的に使用されるように適切な設定を有効化する必要があります。ClickStack はこれらの進展を継続的に追跡し、それに応じてクエリ設定を調整することで、ユーザーが手動で設定を行うことなく、新しい最適化がオブザーバビリティワークロードにもたらされるようにします。
その一例が Top-N クエリの最適化です。「最新のログを表示する」、「上位のエラーメッセージ」、「最も遅いリクエスト」などのクエリは、通常 ORDER BY … LIMIT N の形式をとります。最近の ClickHouse リリースでは、use_skip_indexes_for_top_k 設定を介してスキッピングインデックスを活用した Top-N フィルタリングが導入されました。これにより、エンジンはスキッピングインデックスのメタデータを使用して、行を読み取る前にグラニュール全体を除外できます。テーブルをスキャンして後からソートする代わりに、ClickHouse は事前にデータの大部分をプルーニングできます。一般的な ClickStack のログ検索ワークロードを使用したテストでは、これだけで 2 〜 3 倍のパフォーマンス向上が実現し、データの分布によってはさらに大きな向上が得られました。
もう 1 つの最近の改善点は、スキッピングインデックスのストリーミング評価です。従来、ClickHouse はテーブルデータを読み取る前にスキッピングインデックスを評価していたため、特にインデックス自体が大きい場合に起動遅延が発生することがありました。最新のバージョンでは、インデックスの評価とデータの読み取りをインターリーブして行うようになり、エンジンは実行中にグラニュールを動的にスキップできるようになりました。
① インデックススキャン、グラニュールの選択、および ② クエリ実行が並行して行われます
これによりクエリの起動時間が大幅に短縮され、十分な行が見つかった時点でエンジンがインデックスの評価とデータの読み取りの両方を停止できるため、LIMIT を伴うクエリのパフォーマンスが向上します。詳細はこちらをご覧ください。
最後に、ClickStack はクエリプランで実際に必要になるまで必須ではないカラムのロードを延期する新しい最適化である 遅延マテリアライゼーション (lazy materialization) を活用しています。たとえば、次のようなクエリを実行する場合です:
ORDER BY Timestamp DESC
LIMIT 100;ClickHouse はまず順序付けカラムのみを使用して上位の行を特定し、その後にのみそれらの行の残りのカラムを取得できます。これにより、多くの属性を含むワイドなオブザーバビリティテーブルにおいて、特に I/O とメモリの使用量が削減されます。
デフォルトでは、ClickHouse は結果セットが比較的小さい場合にのみこの最適化を適用します。典型的な ClickStack のアクセスパターンに基づくと、大幅に大きな結果セットでもこの動作の恩恵を受けることがわかりました。そのため ClickStack では閾値 (query_plan_max_limit_for_lazy_materialization) を引き上げ、遅延マテリアライゼーションがより広範なクエリに適用されるようにしています。
個々に見れば、これらの改善はわずかなものに見えるかもしれません。しかし総合すると、高性能なオブザーバビリティプラットフォームを構築する上での重要な原則を表しています。パフォーマンスとは、スタック全体にわたる小さな最適化を一貫して活用することなのです。
すべての人のための高速なオブザーバビリティに向けた ClickStack API の公開
上記で説明したすべての最適化が存在する理由は単純です。オブザーバビリティデータを分析するために完璧な SQL クエリを作成する方法をユーザーが考える必要をなくすためです。ClickStack はこれらの詳細を抽象化します。
現在、上記の最適化はすべて主に ClickStack のインターフェース自体を通じて公開されています。UI がクエリを生成し、適切な設定を適用し、述語を書き換え、最も効率的な実行戦略を選択します。ユーザーは単にデータに対して問いかけるだけです。
私たちの長期的な目標は、専用に構築された API セットを通じて、これらの最適化を UI を超えて利用できるようにすることです。生の SQL エンドポイントを公開するのではなく、これらの API は一般的なオブザーバビリティタスクを焦点を絞った操作として表現します。たとえば、あるエンドポイントはサービスの最新のエラーを取得し、異常なトレースを特定し、または時間の経過に伴うレイテンシの傾向を計算するかもしれません。内部的には、これらの操作に複数のクエリ、最適化された実行戦略、慎重に調整された設定が含まれる場合がありますが、外部からは単純な高レベルの関数として見えます。
このアプローチにはいくつかの利点があります。開発者は、深い ClickHouse の専門知識を必要とすることなく、独自のオブザーバビリティワークフローやアプリケーションに ClickStack を直接組み込むことができます。また、自動化や AI 主導の分析のためのより信頼性の高いインターフェースも提供します。
現在プライベートプレビュー中である、最近導入された Notebooks エクスペリエンス では、すでにこれらの内部ツールが使用されています。複雑な SQL クエリを生成するために LLM に依存する代わりに、ノートブックは特定の分析タスク用に設計された特殊なエンドポイントを呼び出します。これらのエンドポイントは ClickStack の最適なクエリ戦略をカプセル化し、より優れたパフォーマンスとより予測可能な結果を提供します。大規模言語モデルは高度に最適化された ClickHouse SQL を一貫して生成することにはまだ適していないため、実際にはこれにより信頼性も向上します。
今後、これらのツールを一般に公開していく予定です。外部アプリケーションはこれらを直接呼び出したり、Model Context Protocol (MCP) などのプロトコルを介して接続したりして、AI 主導のオブザーバビリティエクスペリエンスを強化できるようになります。これにより開発者は、ClickStack インターフェースと同じパフォーマンス特性を継承するカスタムツール、アシスタント、ワークフローを構築できるようになります。
これは進行中の取り組みです。適切な抽象化を定義し、安定した API を構築し、認証とアクセス制御を導入することが含まれます。しかし目標は明確です。ClickStack のパフォーマンスの利点をあらゆる場所で利用できるようにし、誰もが ClickHouse 上で高速でスケーラブルなオブザーバビリティソリューションを構築できるようにすることです。