5万

2026年9月初め、Moniepoint のエンジニアリングチームとのウェビナーに参加しました。そこで取り上げたのは、私が PeerDB 時代からずっと考えてきたテーマです。「Postgres をローカル NVMe 上で稼働させると何が変わり、何が変わらないのか?」という問いです。
答えの前半はストレージに関するものです。Postgres のワーキングセットがメモリを超えると、一見データベースの問題に見えるボトルネックの正体が、実はストレージレイテンシであるケースが生じます。
答えの後半はアーキテクチャに関するものです。ストレージを高速化すれば、トランザクションワークロードにおける Postgres の処理速度は劇的に向上します。しかし、行指向ストレージの物理配置そのものが変わるわけではありません。ある規模を超えると、分析ワークロードには別の仕組みが必要になります。
本記事は、その対談の要点をまとめたものです。
Postgres が遅いのではありません。ストレージが遅いのです。
Postgres は本来非常に粘り強く動作します。しかし、データセットが数百 GB から数 TB へと拡大し、同時実行数やスループットが高まるにつれて、おなじみのパフォーマンス問題が浮上し始めます。
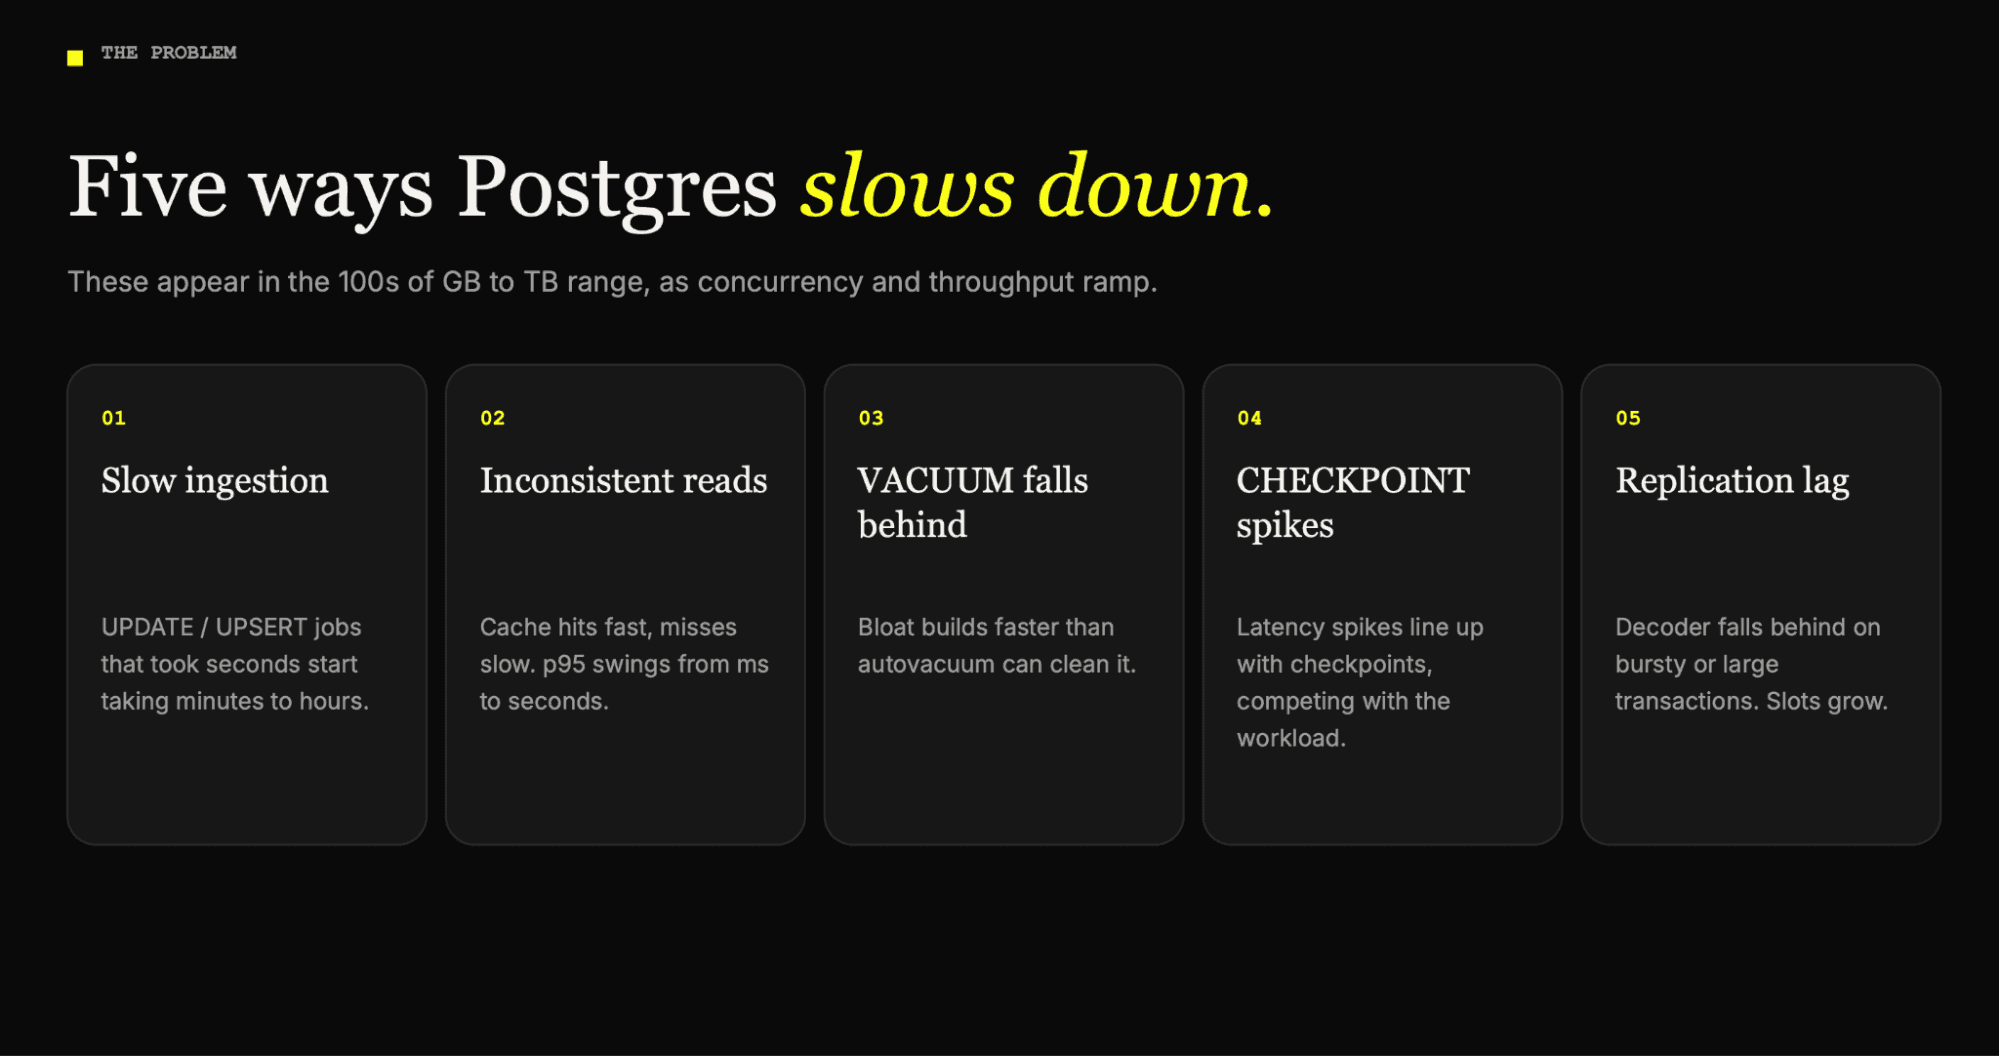
現場で繰り返し見られるのは、次の 5 つの課題です。
- 取り込み速度の低下: 数秒で終わっていた UPDATE や UPSERT のジョブが、数分から数時間かかるようになる。
- 読み取り性能のばらつき: キャッシュヒット時は高速なものの、ミスヒット時は急激に遅くなり、p95 や p99 レイテンシがミリ秒単位から秒単位へと跳ね上がる。
- VACUUM の遅延: autovacuum によるクリーンアップが追いつかないペースで不要タプルが蓄積する。
- チェックポイントによる負荷増大: 書き込みと fsync がアプリケーションと I/O を奪い合う。
- ロジカルレプリケーションの遅延: デコーダーが追いつかず、レプリケーションスロットが肥大化し、下流のシステムに遅れが生じる。
Moniepoint のような決済企業では、こうした事象がトランザクションの遅延、残高照会の遅れ、消し込み処理や不正検知パイプラインの滞りに直結します。この規模のシステムにおいて、そのような影響は許容できません。
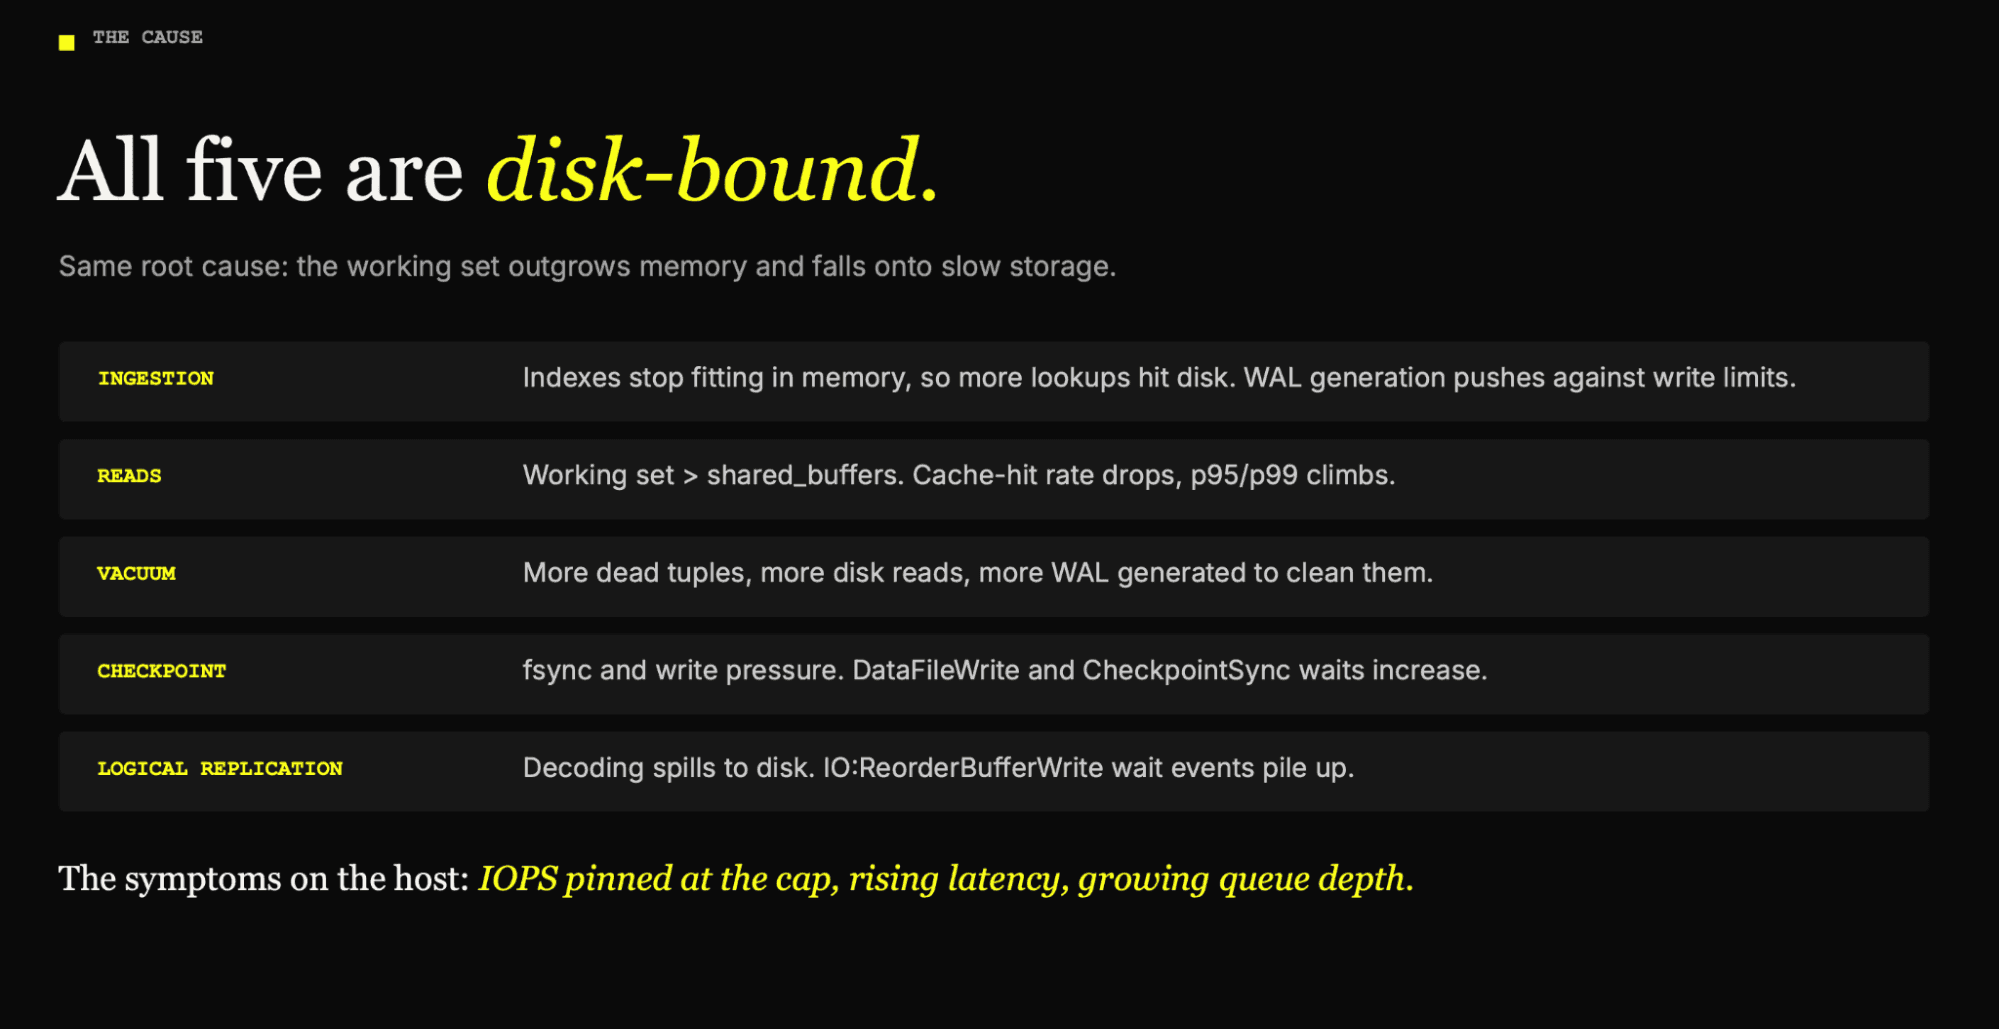
これらの問題は現れ方こそ異なりますが、根底にある原因は共通している場合があります。ワーキングセットがメモリサイズを超え、あふれたデータがディスクへと押し出されている点です。
メモリ上にキャッシュされなくなったインデックスはディスク読み取りの増加を招きます。キャッシュミスにより読み取りレイテンシの予測が難しくなります。VACUUM が読み込んでクリーンアップすべきページ数が増えます。チェックポイントが書き込みと fsync に負荷をかけます。ロジカルデコーディングがディスクへスピルすることもあります。
ホスト上で観測される兆候は共通しています。IOPS が上限に近づき、レイテンシが跳ね上がり、キューの深さが増加します。
ディスクが第 2 のメモリのように機能したらどうなるか?
CPU キャッシュはナノ秒単位です。shared_buffers が置かれる DRAM はおよそ 100 ナノ秒程度です。EBS のようなネットワーク接続型 SSD は 1 〜 10 ミリ秒を要します。ローカル NVMe はその中間に位置し、数十マイクロ秒で動作します。RAM と比べると 2 桁遅いものの、EBS と比べればおよそ 100 倍高速です。
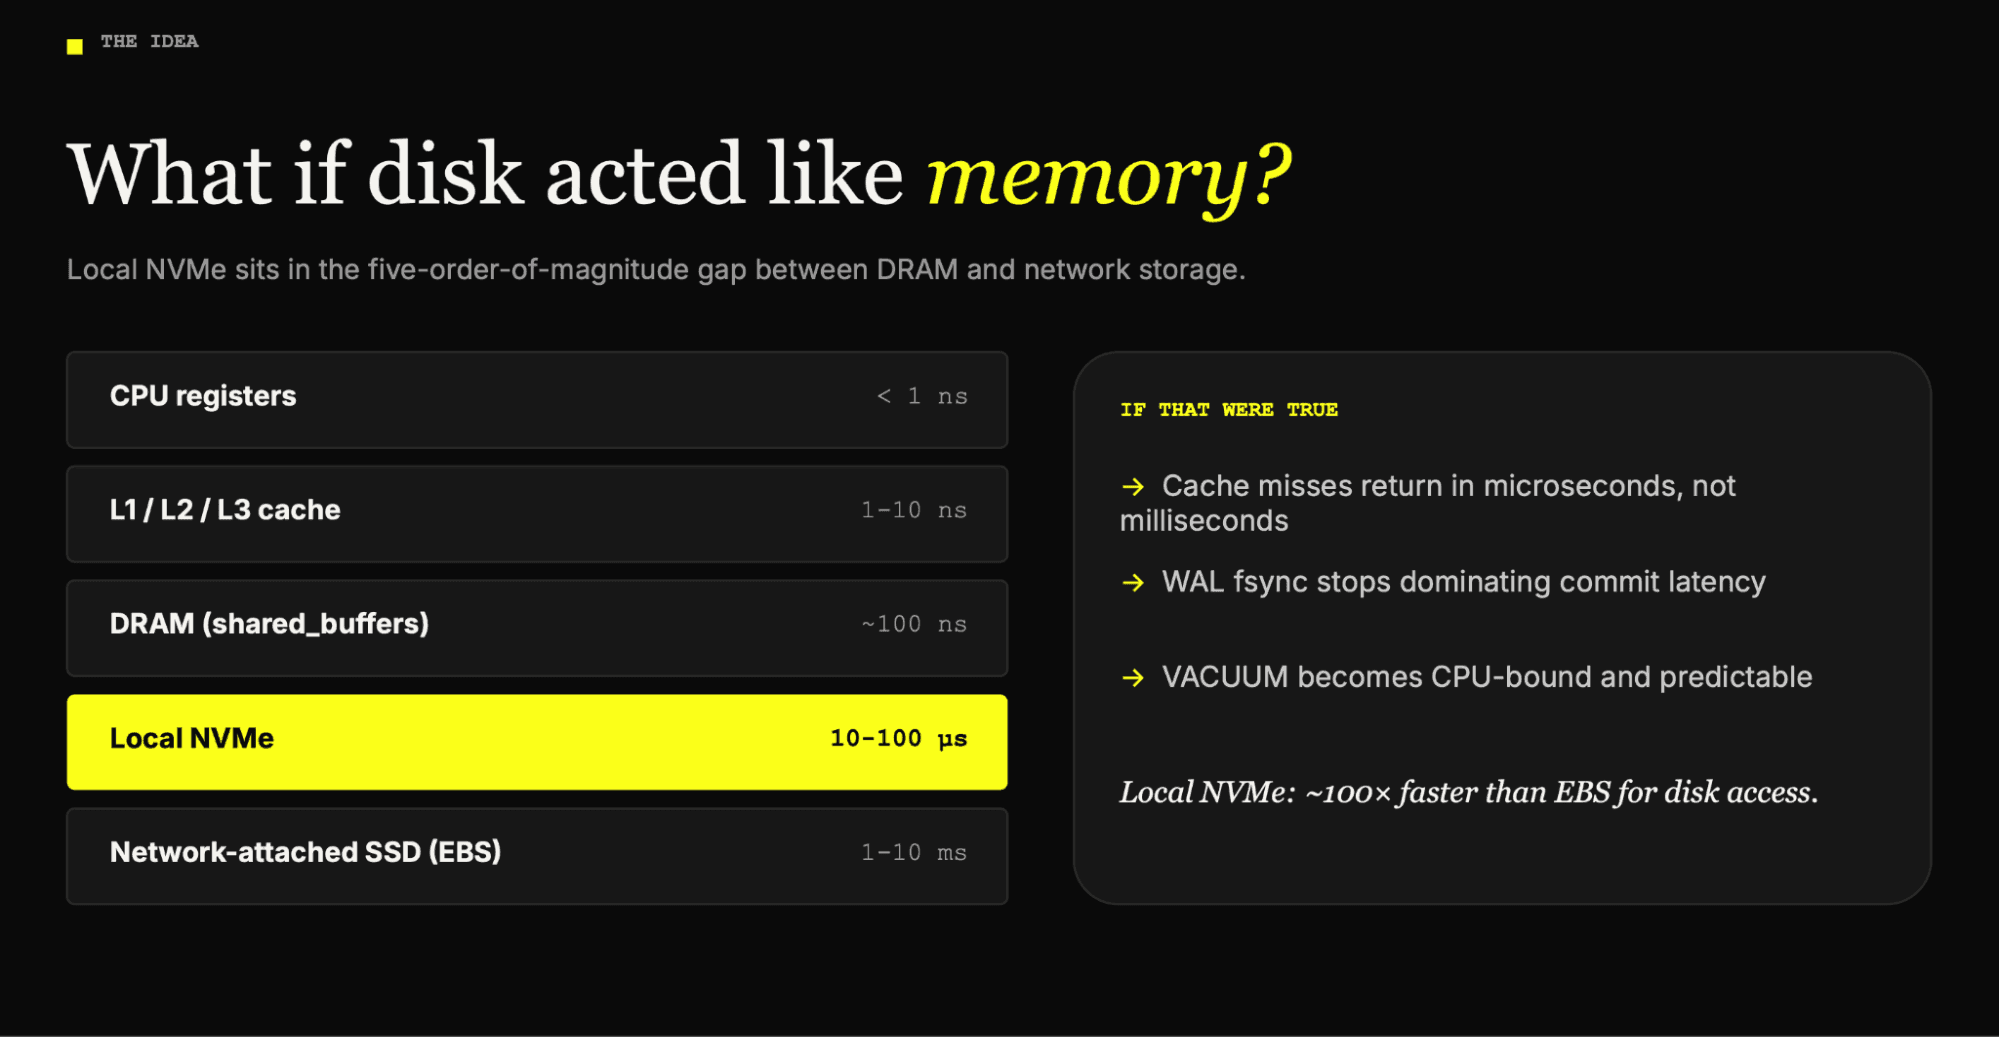
キャッシュミスの所要時間をミリ秒からマイクロ秒へと縮小できれば、システムは実際の搭載量以上の RAM を持っているかのように振る舞います。レイテンシ悪化の原因となっていたコールドリードが極めて低コストになるため、テールレイテンシが改善します。WAL の fsync がコミットレイテンシの大半を占めることもなくなります。VACUUM のボトルネックは CPU へと移行し、処理時間は予測しやすくなります。
ベンチマーク検証
データボリュームのストレージクラスのみを変更した、同一構成のクラスターを 8 つ用意しました。インスタンスは m6id.4xlarge (16 vCPU、64 GiB RAM)、ソースビルドした Postgres 18.3、shared_buffers = 16 GB、チェックサム有効という構成です。
4 つのクラスターにはインスタンスストアの NVMe を、残る 4 つにはベースライン 3,000 IOPS の gp3 EBS を使用しました。データセットにはスケールファクター 33,000 の pgbench を採用し、ヒープサイズ 482 GiB、33 億行という、メモリ容量の約 30 倍に及ぶデータを投入しました。これは本格運用されている実環境の Postgres に近い姿であり、すべてがキャッシュに収まるベンチマークよりもはるかに実態を反映しています。
ワークロードは、16 スレッド・64 クライアントで 5 分間実行し、各トランザクションが全 33 億行の中からランダムな 1 行を更新する構成としました。8 台すべてのホストを並行して稼働させ、各ホストで継続的プロファイリング (eBPF を用いた Parca、1 Hz でサンプリングする pg_stat_activity) を実施しました。
結果は、NVMe でスループットが 9.2 倍に向上しました。EBS の中央値が 1,734 TPS であったのに対し、NVMe は 16,030 TPS を記録しました。さらに重視すべき指標はレイテンシです。1 回の UPDATE あたりの所要時間は、EBS の 36.9 ms に対して NVMe は 4.0 ms でした。この差は、ワークロードの挙動を予測できる状態と、再現が難しい「一部のユーザーで動作が重い」という問い合わせに追われる状態の分かれ目となります。
37 ms はどこで消費されているのか
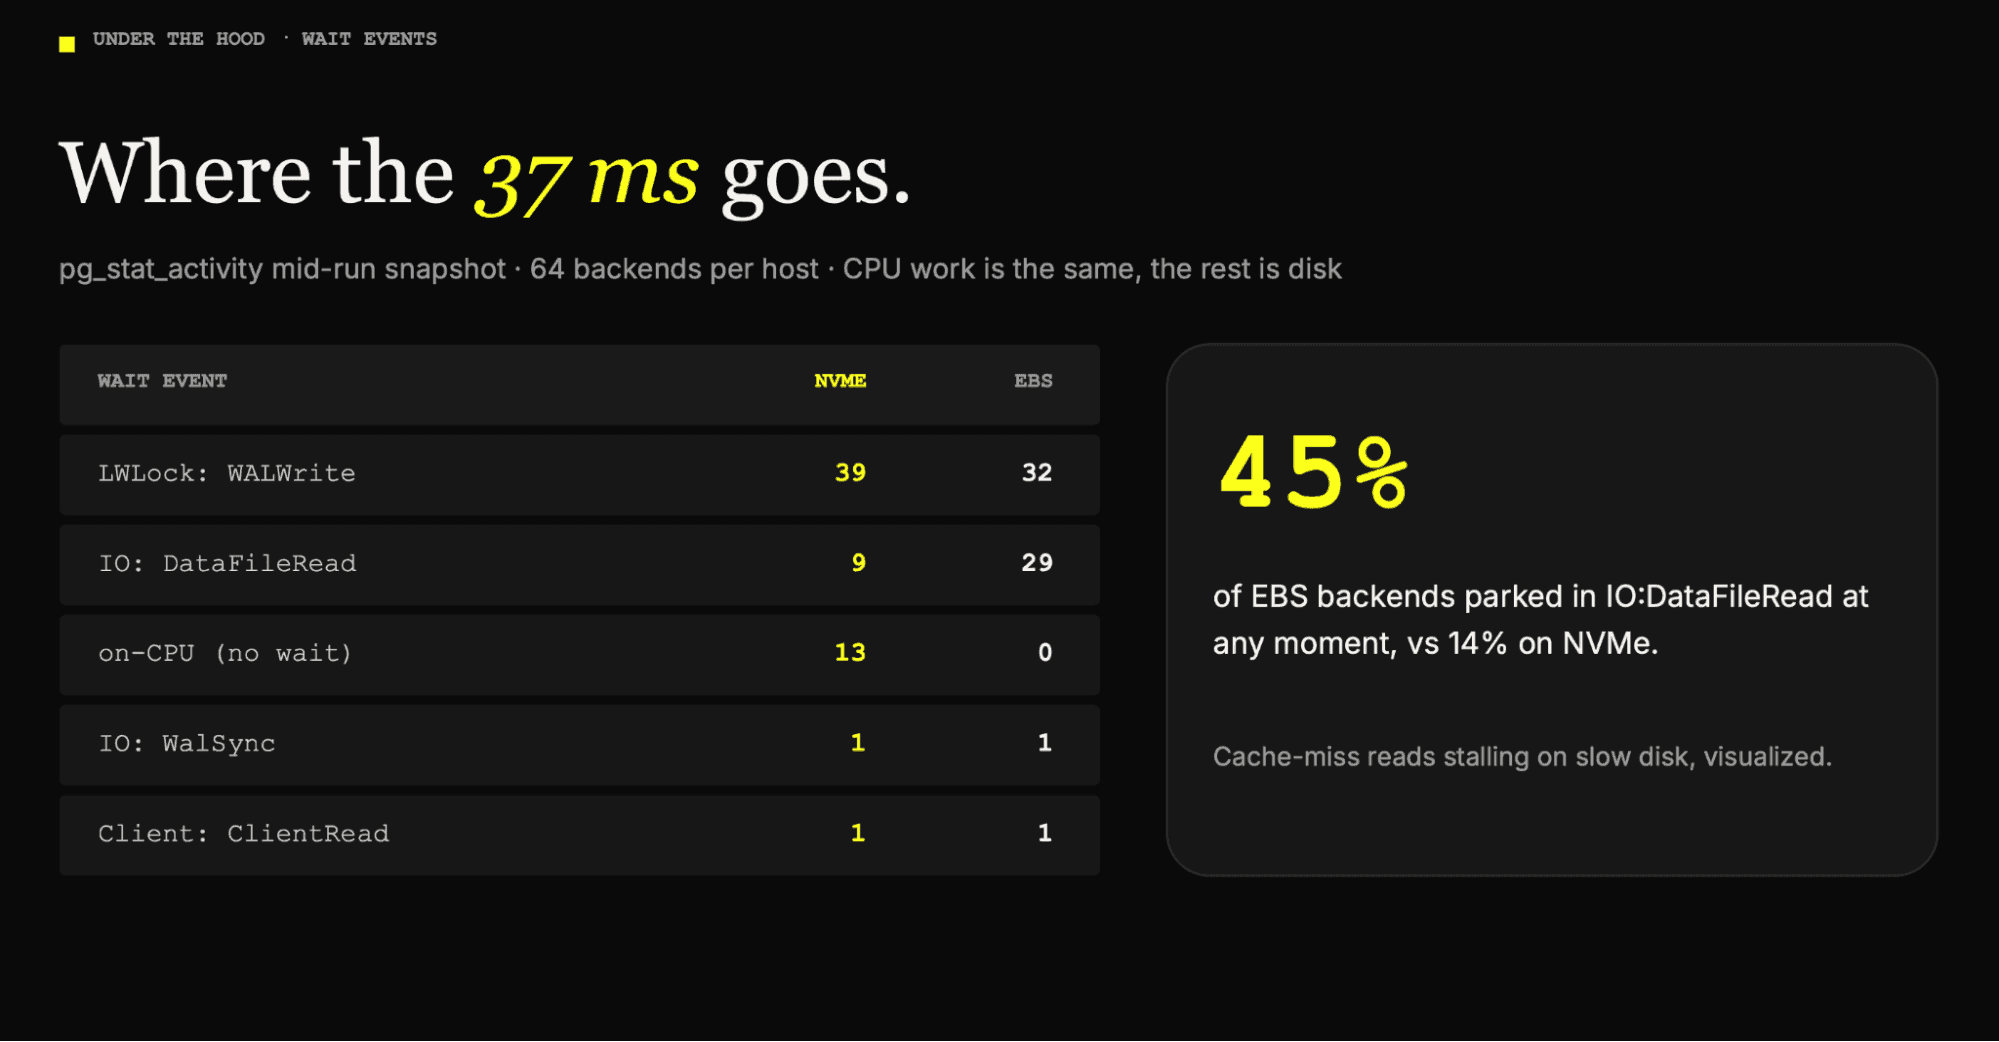
実行中の pg_stat_activity のスナップショットを確認すると、内部の挙動が見えてきます。
EBS では、各ホストの 64 バックエンドのうち 29 (45%) が常に IO:DataFileRead で待機状態にあり、待ち時間なしで CPU 上で処理を実行しているプロセスは皆無でした。一方の NVMe では、IO:DataFileRead で待機していたバックエンドは 9 (14%) にとどまり、13 のバックエンドが CPU 上で実処理を実行していました。両環境とも、残りのプロセスの大半は LWLock:WALWrite 状態であり、CPU 側の処理内容はどちらも同等でした。
直感に反する結果が現れたのは、CPU プロファイルです。EBS はリソースを使い切っておらず、パイプライン処理の工夫で差を縮められるのではないか、と考えるかもしれません。しかしそれは不可能です。テスト期間中の CPU 時間の消費量は、EBS が 251 秒 (およそ 1 コア相当の稼働) であったのに対し、NVMe ホストは約 2,253 秒 (およそ 9.4 コア相当の稼働) に達しました。関数ごとの CPU 使用率の割合を見ると EBS の方が高く見えますが、これは単なる比率の話であり、スループットの高さを示すものではありません。Postgres が実行している作業自体は両者同じです。EBS では、実稼働時間の 89% を CPU を離れて I/O 待ちに費やしていました。EBS は忙しいのではなく、ブロックされていたのです。
他のサブシステムでも同様の傾向が確認されました。VACUUM による 10 GB の肥大化 (テーブルブロート) の解消にかかった時間は、EBS の 964 秒に対し NVMe は 366 秒 (2.6 倍高速) で、I/O 待ち時間は 387 秒から 3 秒へと激減しました。約 10 GB のスロットのロジカルデコーディングは、EBS の 52 MB/s に対して 89 MB/s となりました。伸びが 1.7 倍にとどまったのは、デコーダーがシングルスレッド構成であり、WAL を逐次読み込む仕様であるためです。
反論: ローカル NVMe はエフェメラル (揮発性) である
データベース管理者が高耐久なネットワークストレージを今すぐローカル NVMe へ全面的に置き換えないのには、もっともな理由があります。
インスタンスストアの NVMe は、インスタンスのライフサイクルと運命を共にします。インスタンスや基盤となるハードウェアに障害が発生すれば、ローカルボリュームのデータは失われます。切り離して別の場所へ再アタッチすることもできません。
また、多くの現場で運用が定着しているブロックストレージのスナップショット機能は利用できず、ストレージ容量もインスタンスタイプによって固定されます。
したがって、真に検討すべき問いは「ローカル NVMe が高速かどうか」だけではありません。「その低レイテンシを活かしつつ、耐久性をいかに別のレイヤーで設計するか」にあります。
クォーラム構成によるストリーミングレプリケーションの高可用性
解決策の 1 つ目の柱は、アベイラビリティゾーン (AZ) を跨ぐ同期ストリーミングレプリケーションです。各ノードにローカル NVMe を備えたプライマリ 1 台とスタンバイ 2 台を、複数の AZ に分散配置する構成を採ります。PostgreSQL のクォーラム同期レプリケーションは、synchronous_standby_names = 'ANY 1 (standby1, standby2)' で設定できます。
コミットは最も応答が速いスタンバイの承認のみを待ち、遅いノードを待つことはありません。そのため、ノード 1 台や AZ 1 つが停止しても、承認済みのトランザクションが失われることはありません。フェイルオーバーについても、Patroni や repmgr といったツールで確立された運用手順が存在します。
この手法では、レプリケーションの責務をストレージ層から、LSN やトランザクションを正しく認識してより適切に処理できる Postgres 自体へと移行させます。
継続的な WAL アーカイビング
2 つ目の柱は、継続的な WAL アーカイビングです。
定期的なベースバックアップに加え、WAL-G を用いてすべての WAL セグメントをリアルタイムに S3 へ転送します。これにより、数秒単位の RPO と「イレブンナイン (99.999999999%)」の耐久性を実現し、コンピュート環境の外側に、ノード、AZ、さらにはリージョンの障害からも独立したアーカイブを維持できます。NVMe ボリュームは常に復旧可能なステートキャッシュとして位置づけられます。ノードを喪失しても、アーカイブを再生すれば復元できます。同一のアーカイブから、PITR (ポイントインタイムリカバリ)、プライマリに負荷をかけないリードレプリカの構築、任意の LSN からのブランチ作成も可能になります。
高速ディスクは限界値を押し上げる。だが、構造は変えられない。
ローカル NVMe によってこれほど多くの I/O 待ちが解消されるのであれば、すべてのワークロードを超高速な Postgres 1台で処理すればよいのではないか、と思われるかもしれません。しかし、ストレージレイテンシの解消は問題の半分にすぎません。NVMe はランダムアクセスを劇的に低コスト化しますが、行指向ストレージを列指向ストレージへと変貌させるわけではありません。トランザクションワークロードと分析ワークロードがストレージエンジンに求める要件は、根本的に異なります。
Postgres は、完全な行データを 8 KB のページ単位で格納します。ポイントリードは 1 ページにアクセスするだけで済み、MVCC によって行バージョンがその場で管理されるため書き込み処理が読み取り処理をブロックしません。また、B-tree インデックスにより選択的な検索を低コストで実行できます。その代償として、10 億行に及ぶ集計処理を実行する際は、対象のカラムが必要かどうかにかかわらず、全行の全ページを読み込むことになります。sum(amount) GROUP BY country は、各ページがマイクロ秒単位で返ってきたとしても、依然として行全体をロードし続けます。
ClickHouse は、データをカラム単位で格納し処理します。各カラムは個別のファイルとして保持され、集計処理では参照されたカラムのみが読み出されます。実行処理はキャッシュサイズに最適化されたバッチ単位でベクトル化され、類似した値はカラム単位のコーデックによって高効率に圧縮されます (10 分の 1 への圧縮は日常的です)。MergeTree は、挿入のたびにページを即座に実体化するのではなく、バックグラウンドでのマージ処理を通じて追記主体の取り込みをスムーズに処理します。
変化したのは、システムがこの限界壁に直面するタイミングです。かつてデータが 10 GB から 100 GB へ成長するには 12 〜 18 か月を要していましたが、現在では 1 〜 3 か月しかかかりません。AI ネイティブなプロダクトは初日から推論ログやエージェントの実行履歴を記録し、初日からそれらの分析を必要とします。セキュリティプラットフォームは追記専用のイベントストリームを取り込み、瞬く間に数 TB のデータ規模に達します。プロダクトアナリティクス SaaS は顧客へダッシュボードを提供しますが、表示に 30 秒かかるダッシュボードは誰からも信頼されません。
1 つのアーキテクチャ、2 つのエンジン
現場で頻繁に目にするアーキテクチャのパターンは極めて明快です。アプリケーションは、トランザクション、ACID 特性、ポイントルックアップを維持したまま、これまでどおり Postgres への書き込みを継続します。Change Data Capture (CDC) が、すべての挿入・更新・削除を秒単位の鮮度で ClickHouse へストリーミングします。そしてオープンソースの Postgres 拡張機能である pg_clickhouse を利用することで、アプリケーションは既存の Postgres 接続を介して ClickHouse 側のデータを参照できます。これにより、ClickHouse はあたかも分析専用のリードレプリカであるかのように機能します。
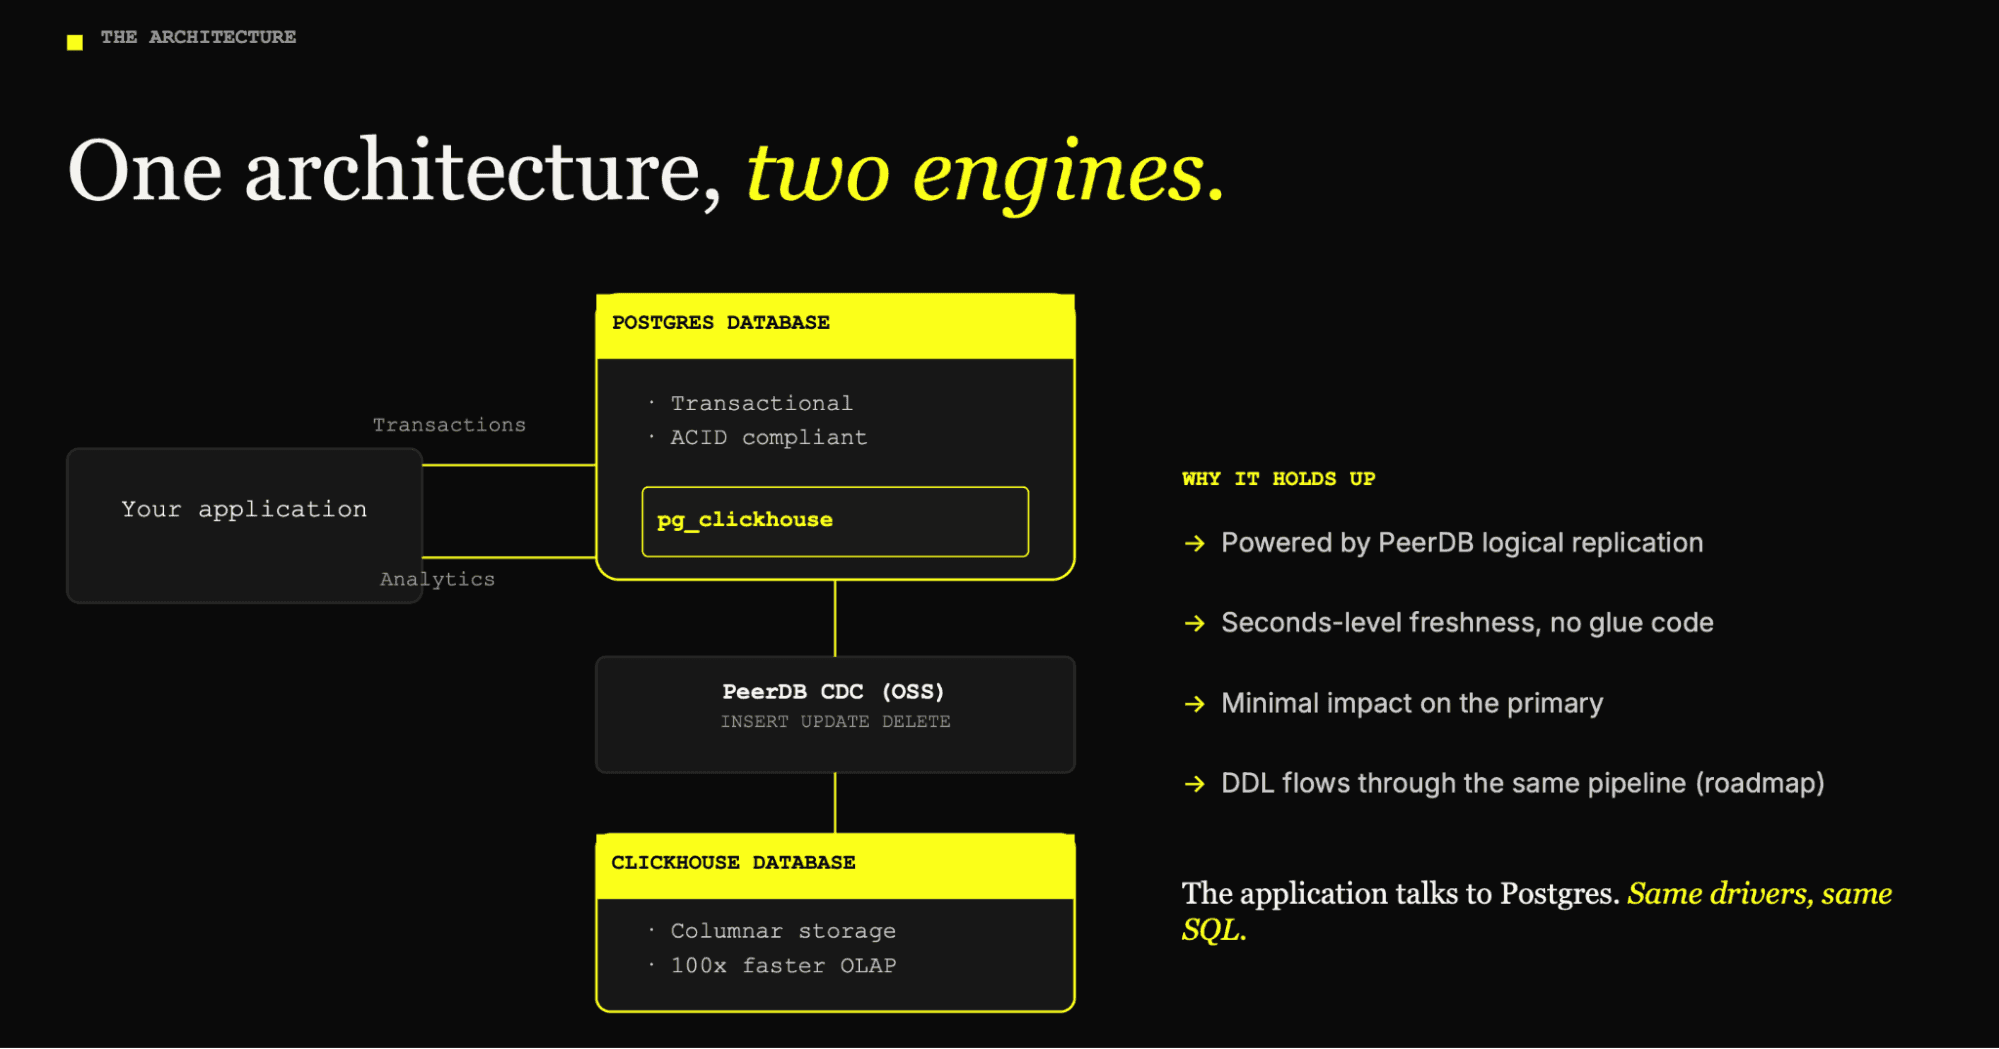
この構成を支えるのが 3 つの要素です。WAL ベースの CDC: ここでは本番環境で月間約 200 TB のレプリケーション実績を持つ PeerDB (オープンソース版。マネージドサービスは ClickPipes) を採用し、プライマリへの影響を最小限に抑えながら ReplacingMergeTree へ更新・削除を反映します。クエリプッシュダウン: 拡張機能側には深いクエリ解釈能力が求められ、Postgres の実行計画を ClickHouse の SQL へ書き換える必要があります (JOIN 構文の違いなどへの対応を含む)。プッシュダウンの対応範囲は入念な検証が必要なポイントです。スキーマ同期: データと同一のパイプラインを介して DDL を流し、Postgres 側で追加されたカラムが ClickHouse 側にも自動的に反映されるようにします。
新機能: Postgres から ClickHouse へのサブ秒レプリケーションを実現する WalShadow
本ウェビナーの収録以降、新たなオープンソースのレプリケーションエンジン WalShadow を発表しました。現在は ClickHouse Managed Postgres のプライベートプレビューにてご利用いただけます。PeerDB や ClickPipes による論理 CDC とは異なり、WalShadow は Postgres の物理 WAL を直接読み取り、変更差分を ClickHouse ネイティブのブロックへと変換します。これにより、ロジカルレプリケーションスロットを使用することなくサブ秒単位のレプリケーションが可能となり、挿入、更新、削除、およびサポート対象のスキーマ変更を常に同期状態に維持できます。
このアプローチがもたらす実質的なメリットは、数 TB に及ぶ分析用履歴データのために Postgres のサイジングを肥大化させる必要がなくなる点です。トランザクションのホットパス用にはコンパクトで高速な Postgres を維持し、フルスキャンを伴う重いクエリは ClickHouse 側へと逃がす運用が実現します。
まとめ
高速な OLTP はストレージの課題です。ローカル NVMe は、マイクロ秒単位のキャッシュミス、低負荷な fsync、予測可能な VACUUM といった前提条件を一変させます。クォーラムレプリケーションと WAL アーカイビングを組み合わせることで、ネットワークストレージのレイテンシに悩まされることなく、ネットワークストレージ同等の耐障害性を獲得できます。
高速な OLAP はアーキテクチャの課題です。どれほど高速なストレージを導入しても、行指向ストレージが 10 億行のスキャン処理に向くようになることはありません。それを可能にするのは列指向のレイアウトです。CDC と列指向ストレージを組み合わせることで、処理の構造そのものを変えることができます。
ここで紹介した要素はすべてオープンソースです。Postgres、WAL-G、repmgr、PeerDB、pg_clickhouse、そして ClickHouse。このスタック全体をお手元のノート PC 上でそのまま稼働させることができます。自身での運用を避けたい場合は、ClickPipes CDC を統合した ClickHouse Managed Postgres として、まったく同じ構成のマネージドスタックを提供しています。
ClickHouse Managed Postgres を今すぐ始める
自社データで ClickHouse Managed Postgres がどのように動作するか試してみませんか? 数分で ClickHouse Cloud を使い始めることができ、300 ドル分の無料クレジットも進呈されます。
サインアップ