5万

概要
-
混沌から構造を見出す: ClickStackのEvent Patternsは、類似したログやトレースを自動的にクラスタリングし、事前定義されたルールなしで主要な挙動や異常を浮き彫りにします。
-
クエリ時に分析: Drain3をベースに構築されたClickStackは、任意の検索結果セットに対してブラウザ上で動的なパターン分析を直接実行します。
-
効率的な作業を実現: パターンを活用してノイズを除去し、繰り返し発生する問題を特定し、稀なシグナルを発見することで、オブザーバビリティ分析を加速させます。
大規模なログの分析は、オブザーバビリティにおいて最も根強い課題の 1 つです。現代のシステムは膨大な量の非構造化データを出力しますが、それらは往々にして反復的でノイズが多く、エンジニアが対応するのに必要なコンテキストを欠いています。その結果、ノイズの中にシグナルが埋もれたログ行の海ができあがり、そこから意味を見出す作業は時間がかかりコストも高くつくプロセスになってしまいます。
イベントパターンは、このノイズに対処するのに役立ちます。既存のデータから意味を抽出し、重要なイベントを浮き彫りにする手段を提供します。
本記事では、ログ分析が本質的に難しい理由、イベントパターンが何を解決するのか、ClickStack がそれをどのように実装しているのか、そしてなぜ私たちがクエリ時に実行する選択をしたのかを掘り下げます。また、現在イベントパターンを最大限に活用するための実践的なガイダンスを共有し、この技術が将来どのように圧縮率やパフォーマンスをさらに向上させ得るのかについても展望します。
課題: なぜログ分析は難しいのか
何らかの障害が発生した際、多くはアラートやトレースから調査を始めますが、これは理想的な形です。すでにある程度の方向性とコンテキストが把握できているためです。しかし、「何かがおかしい」ということしか分からず、生のログから調査を始めなければならない探索的なシナリオでは、難易度は何倍にも跳ね上がります。
特に規律の行き届いていないシステムやチームから出力されるログは、極めて冗長になりがちです。貴重なシグナルと圧倒的な量のノイズが混ざり合い、類似したメッセージが頻繁に繰り返されたり、無関係な詳細が記録されたりします。このように冗長であるため、すべてのイベントをグラフ化したり各行を個別に確認したりすることはほぼ不可能です。エンジニアはパターンのグラフ化、エラーのフィルタリング、クエリの調整を何度も繰り返す探索的な分析を余儀なくされ、ノイズの底に隠された実態が徐々に浮かび上がってくることを期待するしかありません。
イベントパターンは万能薬ではありません。ログの大部分はノイズであり、根本的な解決策は上流で、そもそも何をログに記録すべきかについての適切な意思決定から始まります。しかし現実には、すべてのチームやシステムが完璧にログを記録できているわけではなく、イベントパターンはノイズの中から重要なシグナルを浮き彫りにするのに依然として役立ちます。
Lucene スタイルの検索は、探しているものが分かっている場合には役立ちますが、分からない場合にはほとんど役に立ちません。このような状況では、繰り返し発生する動作や異常値を見つけ出すために大規模なデータセットをスキャンする、「パターンの発見」というプロセスになります。これは本質的に困難な問題であり、干し草の山から一本の針を探すようなものです。しかも、その干し草の山は毎秒増え続けています。
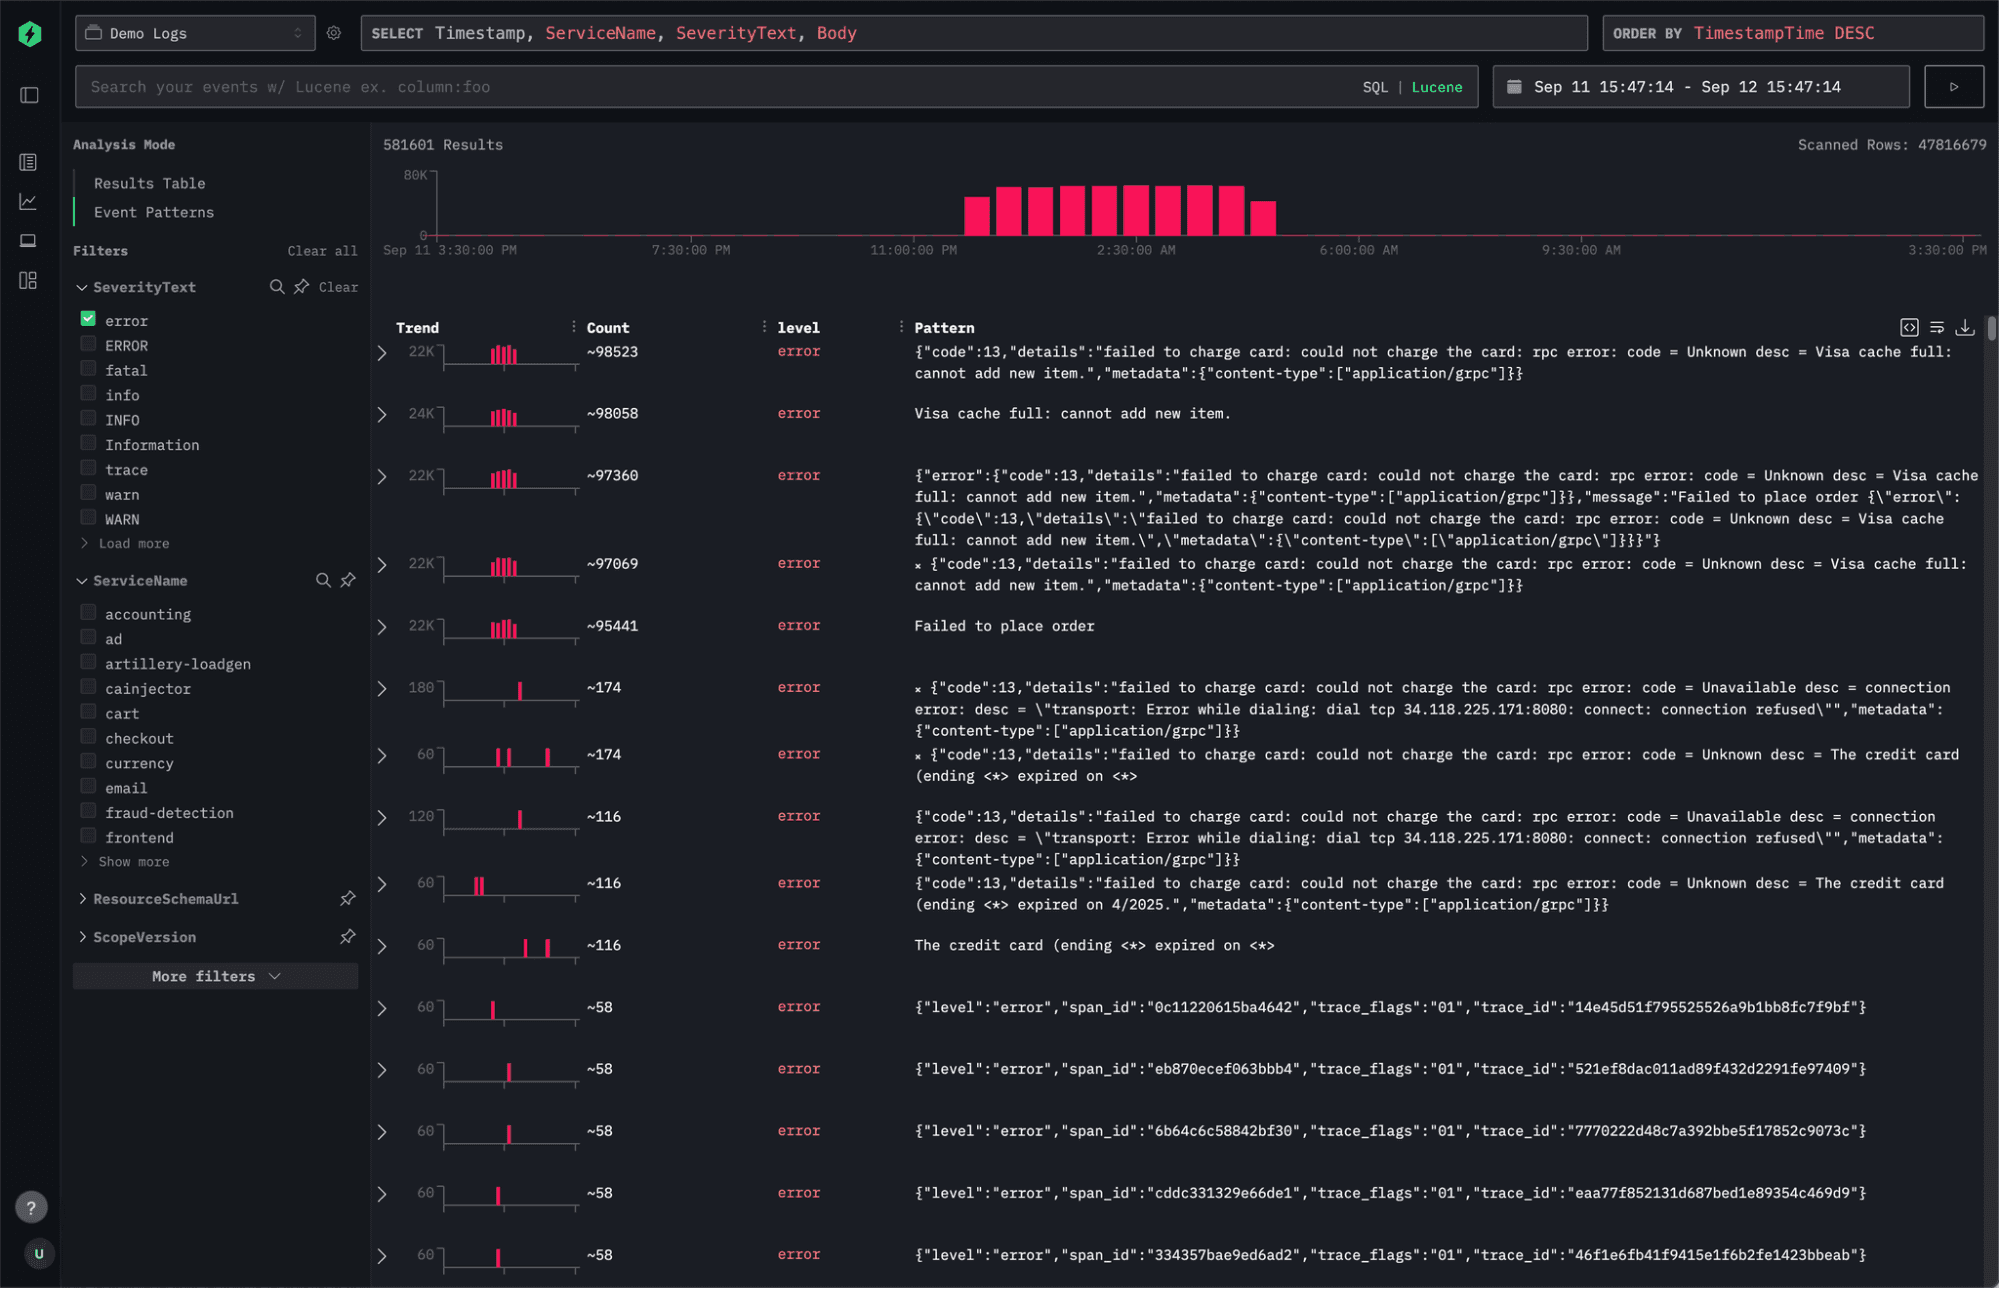
Lucene(自然言語クエリ)は、探しているものが分かっている場合に干し草の山から針を見つけるのに役立ちます。
イベント分析はログにとどまらずトレースやメトリクスにも及びますが、同じ課題が当てはまります。データが非構造化かつ大容量である場合、迅速に洞察を抽出することはコンピュートリソースの面でも負荷が高く、精神的にも負担の大きい作業になります。
イベントパターンがログ分析を支援する仕組み
ClickStack のイベントパターンは、圧倒的なノイズを明瞭で構造化されたインサイトに変えることで、ログやイベントの分析をシンプルにします。何百万件もの未加工イベントを一つひとつ精査する必要はありません。反復する構造を自動的に検出し、類似したメッセージをクラスターへまとめます。各クラスターは、動作の汎用化された「パターン」を表します。
これらのクラスターにより、手元のデータをコンパクトかつ大局的に把握できます。どのパターンが最も頻繁に発生しているか、どれが新規または異常なものか、そしてそれらの頻度が時間の経過とともにどのように変化しているかを即座に確認できます。
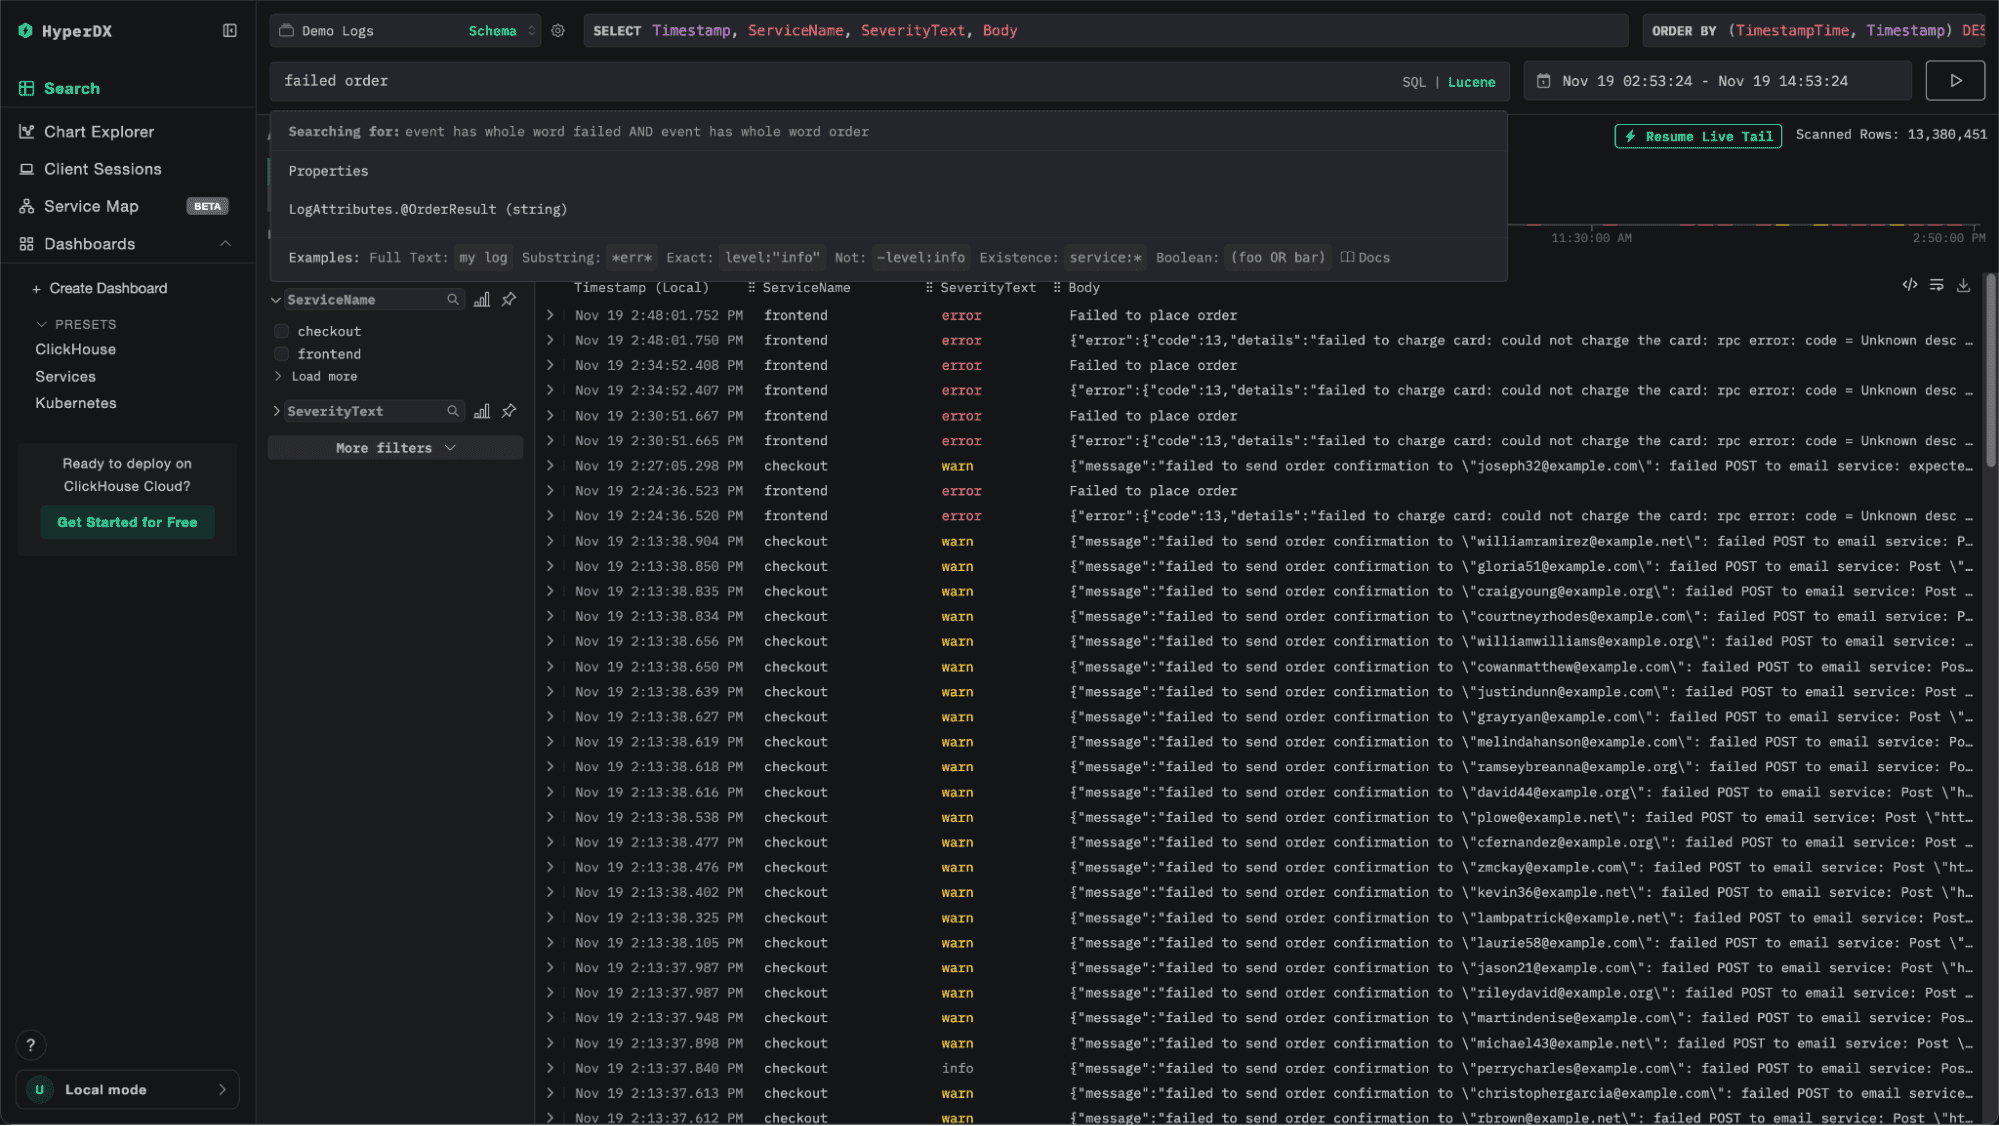
頻出するパターンは健全または想定通りのシステム動作を表すことが多く、出現頻度の低いパターンは異常や発生しつつある問題を明らかにする傾向があります。
イベントパターンは動的に生成されるため、正規表現を定義したり壊れやすいパースルールを維持管理したりする必要がありません。構造化データであれフリーテキストであれ、ClickStack はシステムが生成するあらゆるデータに自動的に適応します。この柔軟性により、検索対象についての予備知識がなくても、繰り返し発生するエラーの特定、ノイズの多いソースの検出、サービスが出力するログの種類の把握が容易になります。
インシデント対応にとどまらず、イベントパターンはチームのオブザーバビリティの健全性向上にも役立ちます。どのログがログ量を支配しているかを可視化することで、削減すべき冗長または価値の低いメッセージを特定できます。これにより、取り込み前にイベントをフィルタリングするためのパターンをパイプラインに追加したり、開発者へロギング規律の周知徹底を図ったりできます。
ClickStack でのイベントパターンの活用
ClickStack のイベントパターンは、従来の検索を置き換えるのではなく、補完するように設計されています。ワークフローは一般的な手順から始まります。検索クエリを実行し、コーパス全体から関連するイベントのサブセットへと絞り込みます。そのサブセットには、直接確認するには多すぎる何百万件もの結果が依然として含まれている場合があります。未加工ログの巨大なテーブルを表示する代わりに、画面左側の “Event Patterns” を選択して、返されたイベントの構造化分析を実行できます。
選択すると、ClickStack は一致するデータの分析を開始し、繰り返し発生するメッセージ構造を特定します。重要なのは、すべての結果をクラスタリングしようとはしない点です。そうした処理は計算コストが高く、不要でもあります。代わりに ClickStack はデータの代表的なサブセットをサンプリングし、そのサンプルが統計的に有意で、結果セット全体に均等に分散されるようにします。
分析が完了すると、類似性によってグループ化されたイベントの要約ビューが表示されます。各クラスターは個別のログパターンまたはイベントパターンに対応しており、どの種類のメッセージがサンプル内で大半を占めているか、あるいは詳しく調査すべき稀なメッセージはどれかを即座に把握できます。
上の例では、まず payment service に絞り込み、続いて error filter を適用しています。数秒のうちに、イベントパターンによって興味深い繰り返しエラーが浮かび上がります。生のログをスクロールしたり、検索クエリを何度も調整したりしていては、特定するのにはるかに長い時間がかかっていたはずです。
ClickStack におけるイベントパターンの実装方法
内部的には、ClickStack のイベントクラスタリングは、オープンソースの高性能ログテンプレートマイニングライブラリである Drain3 を利用しています。Drain3 は、ログメッセージのストリームからテンプレート(「パターン」)を効率的に抽出するオンラインログクラスタリングアルゴリズムです。固定深度の構文木を使用してロググループの形成を誘導し、他のアルゴリズムで処理速度の低下やメモリ消費の増大を招くような、深くて不均衡なツリー構造を回避します。このアプローチにより、大規模なログデータセット上でも対話的に動作できるほどの高速性を実現しています。
私たちは Drain3 を、挿入時ではなくクエリ実行時に統合するという明確な決定を下しました。この設計により、ユーザーは手元のデータの任意のサブセット内でパターンを動的に発見・分析できるようになり、検索体験を直接補完できます。取り込み時にクラスタリングを実行すればログパターンの事前タグ付けが可能になりますが、特にペタバイト規模のデータに対して毎秒数ギガバイトという ClickStack の取り込み規模では、極めて大きなオーバーヘッドが生じます。分析をオンデマンドで実行することで取り込み処理を軽量に保ち、インサイトが常にコンテキストに沿った最新の状態であることを保証できます。
Drain3 は Python で記述されているため、ブラウザ内で直接実行するために Pyodide を使用しています。Pyodide は WebAssembly にコンパイルされた完全な Python ランタイムであり、バックエンドでの処理を一切必要とせず、完全にクライアント側で動作します。Python の標準ライブラリの多くと、numpy、pandas、matplotlib などの主要なデータサイエンスパッケージをサポートしています。Pyodide を使用することで、ClickStack は可視化や UI 更新のために JavaScript と連携しながら、ブラウザ環境内で Drain3 をシームレスに実行できます。
Drain3 のような軽量なアルゴリズムであっても、クエリ実行時に数十億行に対してクラスタリングを実行することは現実的ではありません。精度とパフォーマンスのバランスを取るため、ClickStack はサンプリングを適用し、数秒以内にクラスターを返すことを目指して、分析対象として統計的に代表性のある 10,000 件のイベントのサブセットを選択します。このサンプリングはランダムですが、クエリの対象時間範囲やサービス全体を網羅できるように均等に分散されます。
たとえば、上記の例でログを分析する場合、ClickStack は次のようなクエリを発行することがあります。
WITH
now64(3) AS ts_to,
ts_to - INTERVAL 900 SECOND AS ts_from,
tableStats AS
(
SELECT count() AS total
FROM otel_v2.otel_logs
WHERE TimestampTime >= ts_from
AND TimestampTime <= ts_to
)
SELECT
Body AS __hdx_pattern_field,
TimestampTime AS __hdx_timestamp,
SeverityText AS __hdx_severity_text,
TimestampTime,
ServiceName
FROM otel_v2.otel_logs
WHERE
TimestampTime >= ts_from
AND TimestampTime <= ts_to
AND if(
(SELECT total FROM tableStats) <= 10000,
1,
cityHash64(TimestampTime, rand()) %
greatest(
CAST((SELECT total FROM tableStats) / 10000, 'UInt32'),
1
) = 0
)
LIMIT 10000;このクエリは、単に rand() で並べ替える単純なアプローチに比べ、サンプリングを効率化するための工夫を取り入れています。
実際には、このサンプルサイズで支配的なパターンと異常なパターンの両方を高い確信度で特定するのに十分であり、コンピュートリソースやユーザーに過度な負担をかけることなく、何が起きているかの迅速かつ正確なスナップショットを提供できます。
ログパターンを最大限に活用する
イベントパターンは、大まかな検索と正確なデバッグの間の橋渡しとして、反復的な探索プロセスの一部として使用したときに最も真価を発揮します。ClickStack でこれらを最大限に活用するための実践的な方法をいくつか紹介します。
広く開始し、徐々に絞り込む
最近のアクティビティの代表的な状況を把握するために、まずサービスや重大度によるフィルタリングなど、広範な検索から始めます。次に、Event Patterns を使用して支配的な挙動を素早く特定し、普段と異なるシグナルや新たに発生したシグナルへと絞り込みます。関心のあるパターンが見つかったら、従来の検索やトレースに戻して詳細な調査を進めます。
構造化フィルターと組み合わせる
イベントパターンは、ServiceName、SeverityText、deployment_id などの意味のあるフィルターと組み合わせたときに真価を発揮します。これによりサンプリングが関連データに集中し、パフォーマンスと精度の両方が向上します。たとえば、パターン分析を実行する前に error ログでフィルターをかければサービス全体の障害の種類が浮き彫りになり、warn でフィルターをかければ重大な問題になる前の機能低下を発見できる可能性があります。
稀なパターンをシグナルとして捉える
大半のシステムにおいて、稀にしか発生しないパターンは、頻出するパターンよりも興味深い場合があります。新しいエラー経路、エッジケースの障害、あるいは最近混入したリグレッションを示している可能性があるためです。イベントパターンビュー内で頻度順にソートやフィルタリングを行うと、こうした価値ある外れ値を素早く浮き彫りにできます。
まとめると、パターン分析はなぜ起きているのかをピンポイントで突き止めるためではなく、高レベルで何が起きているのかを理解するのに最も適しています。全体像を素早く把握し、手がかりを見つけるために使用し、根本原因の分析には生の検索、トレース、メトリクスへと切り替えてください。
最後に、イベントパターンを利用したとしても、より適切なログを出力する必要性がなくなるわけではないという点にご留意ください。しかし、不完全な現実のノイズをかき分けることははるかに容易になります。
今後の展望
今後に向けて、ClickStack エコシステム全体でイベントパターンを活用する方法をさらに拡張できる可能性がいくつか見えています。最近のブログ記事では、Drain3 アルゴリズムを ClickHouse 内でユーザー定義関数 (UDF) として直接呼び出し、より大規模なデータセットを分析できるようにする方法を検証しました。これは、クエリ実行時により大きなサンプルを扱えるようにするだけでなく、他にも興味深い可能性をもたらします。
たとえば、単一のサービスやコンポーネントに属するログなど、特定のログソース内の共通構造を特定するためにイベントパターンを使用できます。学習したこれらのテンプレートを正規表現ベースの抽出ルールにコンパイルすることで、ClickHouse が取り込み時に構造化フィールドを自動的に取得できるようになります。クエリの高速化や読み取り時スキーマ適用 (schema-on-read) 処理の回避にとどまらず、この構造化によって圧縮効率も大幅に向上できます。私たちは、圧縮率を最大 170 倍に高めることができた最近のブログ記事でこの概念を実証しました。
私たちは引き続きこれらの方向性を探求しており、ご自身のワークフローで潜在的なユースケースを見出したユーザーからのフィードバックをお待ちしています。ClickStack でイベントクラスタリングを試している場合や、ClickHouse で Drain3 を UDF として使用している場合は、どのような活用法をしているか、また次にどのような機能が欲しいかをぜひお聞かせください。
まとめ
イベントパターンは、チームがノイズの多い非構造化データを明瞭かつ迅速に探索できるように支援することで、ClickStack のオブザーバビリティに強力なインテリジェンス層をもたらします。類似したイベントをグループ化し、クエリ実行時にコンテキストに応じた異常を表面化させることで、インサイトを得るまでの時間を短縮し、探索的なログ分析をはるかに身近なものにします。規律あるロギング手法に完全に取って代わるものではありませんが、複雑なシステムにおいて意味のあるシグナルを発見するための実用的な方法を提供します。ClickStack が進化を続けるなか、イベントパターンは、どれほど乱雑なデータであっても実用的な理解へと変える、よりスマートで適応性の高いアナリティクスの基盤を築きます。