5万

まとめ
- Avrideは、自動運転車両と配送ロボットのフリートを支えるデータの基盤としてClickHouse Cloudを活用し、全社規模のインデックス作成、メトリクス管理、分析を支えています。
- Apache Icebergからの移行後、インデックス検索のレイテンシは20秒から100ミリ秒未満に短縮され、取り込みのレイテンシも数時間や数日単位から数秒へと大幅に短縮されました。
- AvrideにはClickHouseの豊富な経験があったにもかかわらず、運用のシンプルさとストレージとコンピュートの分離を重視して、セルフホストではなくClickHouse Cloudを選択しました。
Avride の自動運転車は、わずか 1 分の間にカメラやライダー、温度センサー、自動運転プロセスなどから数千ものデータポイントを生成します。拡大を続ける自動運転の旅客車両や配送ロボットのフリート全体で、このデータを収集・保存し、エンジニアが素早く利用できるようにすることは、日々の大きな課題となっています。
2025年12月、同社はテキサス州ダラスのダウンタウンにおいて、Uber アプリ経由で予約可能な商用ロボタクシーサービスを開始し、世界でいち早く自動運転配車サービスを運行する企業の 1 つとなりました。現在までに、Avride のロボットは全米の Uber Eats や Grubhub を通じて数十万件の注文を完了しています。
ClickHouse は Avride のデータインフラストラクチャの中核に位置し、全走行データのインデックス層、分析用データウェアハウス、社内全体で使われるさまざまな内部ツールの基盤を支えています。ここに至るまでのストーリーは、レガシーシステムからの脱却、難度の高いエンジニアリング課題の解決、そして会社全体が依存するシステムの構築の歩みそのものです。
私たちは、Avride のデータチームおよびアナリティクスチームの Andrey Mironov 氏、Dmitry Kaluzhny 氏、Kirill Konchenko 氏に話を伺い、この移行をどのように成し遂げたのか、そして世界屈指の ClickHouse 経験を持つチームでありながら、なぜ AWS 上の ClickHouse Cloud での運用を選択したのかを取材しました。
フリートデータの基盤
Avride のデータパイプラインは車両から始まります。自動車や配送ロボットが生成するセンサーの読み取り値、ハードウェアのテレメトリ、イベントストリームは、継続的にオブジェクトストレージへとアップロードされます。
そこからデータは、仮想環境で走行を再現・分析するシミュレーションパイプラインと、実際の走行で起きた内容から現実世界のメトリクスを抽出する処理パイプラインへと流れます。この 2 つの経路でそれぞれオフラインおよびオンラインのメトリクスが生成され、Grafana などの可視化ツールへと送られます。
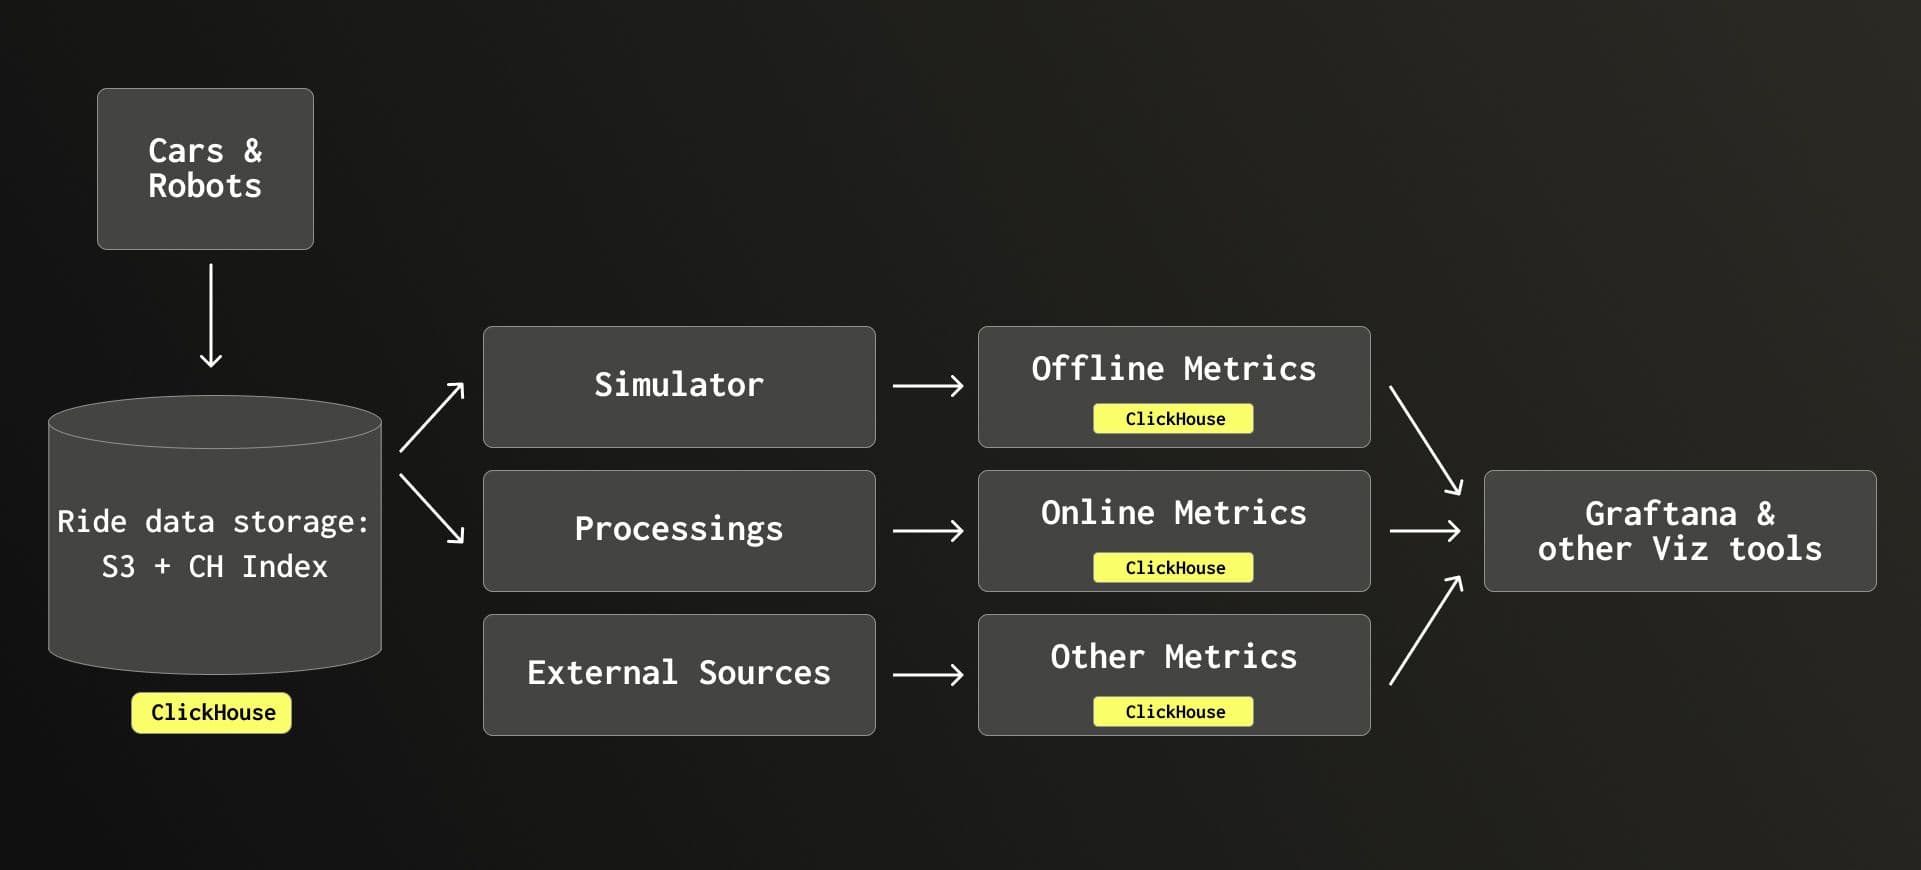
Avride のデータパイプライン。インデックス作成とメトリクスに ClickHouse を採用。
現在、ClickHouse はこのアーキテクチャのほぼすべてのステージで使われています。全走行データの所在を追跡するインデックス層として、またそこから得られるメトリクスを保存するデータウェアハウスとして稼働しています。この選択には深い背景があります。Andrey 氏、Dmitry 氏、Kirill 氏は、ClickHouse と Avride の技術の原点である Yandex 在籍時も含め、約 10 年にわたり ClickHouse に携わってきました。
しかし、最初からそうだったわけではありません。チームがデータインフラストラクチャの新たな基盤を必要としたとき、ClickHouse は極めて論理的な解決策でした。
Iceberg が抱えていた課題
Avride は数年間にわたり、Parquet ファイルに対するメタデータおよびインデックス層として Apache Iceberg を使用していました。ローバーとタイムスタンプによるインデックスクエリは、特定のタイムスタンプにおける特定ローバーのデータを含む Parquet ファイルを漏れなく特定する必要がありました。同社の従来のインフラストラクチャの多くが Spark、PyArrow、AWS を中心に構築されていたことから、Andrey 氏は「すでに実績のあった技術を選ぶのは自然なことでした」と語ります。
しかし、Avride のフリートが拡大するにつれ、この構成は限界を露呈し始めました。「問題は、Iceberg で分析ができないことではありませんでした」と Andrey 氏は振り返ります。「メタデータ層のせいで、会社全体の成長やデータを迅速に見つけ出す作業が制約を受け始めたことが課題だったのです」。ロボットフリートの裏側で、Avride はエンジニアによる ML のトレーニング、シミュレーションの再現、デバッグを行うためのレイテンシを改善する必要があり、それが ClickHouse への転換の契機となりました。
根本的な問題は、Iceberg の取り込みモデルが並列ではなくシーケンシャルなデータ書き込みを想定していた点にありました。「Iceberg は楽観的並行性と呼ばれるモデルを採用しています」と Andrey 氏は説明します。「これは誰も並行してデータを挿入しないことを前提としていますが、実際には並列で書き込むのが一般的であり、スケールしませんでした」。一方、ClickHouse のコンセンサスモデルは並列書き込みを標準で処理できます。稼働する車両が増え、インデックスを同時にクエリする必要のあるエンジニアが増加するにつれて、取り込みがボトルネックとなりました。数分以内に分析可能になるはずのデータに、数時間、場合によっては数日もかかるようになっていたのです。
検索パフォーマンスも深刻な課題でした。特定の時間枠(チームが「シーン」と呼ぶもの)における特定のローバーのデータを見つけるのに、10 秒から 20 秒もかかることがありました。単独で見れば許容できるように思えるかもしれませんが、走行データを絶えずクエリする必要のある数十のチームを抱えるエンジニアリング組織全体では、このレイテンシが積み重なっていきます。各チームは対策として、インデックスの上に独自のキャッシュ層を構築していきました。「それぞれが少しずつ異なり、メンテナンスの負担も個別に発生していました」と Andrey 氏は語ります。結果として断片化が進み、管理が難しい環境となり、フリートの成長とともに事態は悪化する一方でした。
また、Iceberg がデータの所有権を扱う方法にも構造的な問題がありました。Iceberg は追加されたあらゆるデータの全管理権限を持つため、元データを個別に保持したい Avride にとっては、すべてを複製するしかありませんでした。ローバーが増えるたびにデータが増加し、Iceberg の下ではそのデータを 2 重に保存しなければならなかったのです。ペタバイト規模において、この複製のコストは Avride が車両を走らせるたびに膨らみ続けていました。
ClickHouse によるスケーラブルなソリューション
Iceberg を何に置き換えるかという問いに対し、Andrey 氏が語るように「考えるまでもない明白な選択肢」がありました。
Dmitry 氏は、単に ClickHouse をそのまま導入したわけではないと指摘します。Avride は、ClickHouse をストレージおよびクエリエンジンとして使用し、基盤となるオブジェクトストレージに S3 を組み合わせたカスタムインデックスソリューションを構築しました。「私たちは Iceberg を、ClickHouse とオブジェクトストレージの上に構築した独自のソリューションに置き換えました」と Dmitry 氏は語ります。
この新たな構成により、従来は 10 秒から 20 秒かかっていた「最悪のケース」のインデックス検索が 1 秒未満で完了するようになり、ウォームな接続では 100 ミリ秒未満に短縮されました。各チームが回避策として構築していたキャッシュ層は、ほぼ不要になりました。「以前と比べて桁違いに高速になりました」と Andrey 氏は述べています。
データが生成されてから利用可能になるまでの時間である取り込みレイテンシも「劇的に低下しました」と Andrey 氏は話します。「Iceberg での数時間、あるいは数日から、ClickHouse ではわずか数秒へと短縮されました」。チームが常に走行データをクエリするエンジニアリング組織において、節約されたこれらすべての時間は大きな効果をもたらします。
また、ClickHouse は複製の課題も解消しました。Iceberg のように基盤となるペイロード自体の管理権限を持たないため、Avride はオブジェクトストレージ内の元データを複製することなく、メタデータとインデックスの信頼できる単一の情報源(Single Source of Truth)を維持できます。このコスト削減効果は、フリートに新たな車両が加わるたびに積み上がっていきます。
さらにもう 1 つのメリットは、マルチロケーションのサポートでした。Iceberg 環境では、Avride は特定のデータがどこにあるかを把握するために、ストレージの場所ごとに個別のテーブル環境をクエリする必要がありました。ClickHouse により、インデックスは一元化されました。「今では『データはどこに保存されているか?』に即座に答えられます」と Andrey 氏は言います。「データが複数の場所に保存されている場合でも、地理的に近い場所や、他の基準で最適な場所を選択できます」。
Avride が ClickHouse Cloud を選んだ理由
Andrey 氏、Dmitry 氏、Kirill 氏は、ClickHouse を大規模に運用するために何が必要かを熟知しています。3 人を合わせると、約 30 年に及ぶ実践的な ClickHouse の経験があります。だからこそ、セルフホストではなく ClickHouse Cloud を選択した決断には強い説得力があります。
Andrey 氏が Yandex にいた頃は、クラスターの保守を担当する専任の DevOps エンジニアチームが存在していました。「ClickHouse を大規模に運用することは非常に大きな挑戦です」と同氏は語ります。「当社の規模の企業にとって、それを自前で抱えるのは持続可能ではありません」。Avride においては、クラスターの管理に割かれるエンジニアのリソースは、ビジネスを実際に差別化する課題に投じる方が賢明です。「より上手く運用してくれる人たちがいるのは、純粋にありがたいことです」と同氏は付け加えます。
運用オーバーヘッドの削減に加えて、2 つの技術的機能が ClickHouse Cloud を特に魅力的なものにしました。1 つ目はコンピュートとストレージの分離です。これは単一サーバーで ClickHouse を運用していた際には不可能だった構成です。稼働する車両やデータソースが増え、クエリ負荷が増大しても、Avride は両者を個別にスケーリングでき、固定容量に縛られることなくコストとパフォーマンスを最適化できます。
2 つ目は、ClickHouse Cloud の SQL コンソールです。「Web UI が本当に優れています」と Kirill 氏は話します。「私自身も毎日使っていますし、多くの開発者が日常的な調べ物に日々利用しています」。全社にまたがるデータツールにおいて、この使いやすさは重要です。クエリへのハードルが下がるほど、チームが引き出せる価値も大きくなります。
エンジニアから経営陣に至るインパクト
現在、ClickHouse は Avride の事実上すべてのチームで利用されています。認識、動作計画、自己位置推定、マッピングを担当する各エンジニアリングチームは、すべて ClickHouse ベースのインデックス経由で走行データをクエリしています。シミュレーションチームはそれを通じてオフラインメトリクスを実行し、運用チームはフリートの健全性をリアルタイムに監視するために活用しています。事業開発チームのセールスやマーケティングから Avride の CEO に至るまで、意思決定を支えるインサイトの起点はすべて ClickHouse に行き着きます。
「ClickHouse をまったく使っていないチームを見つけるのは難しいほどです」と Kirill 氏は言います。
最も興味深いユースケースの中には、標準的なアナリティクスの枠を大きく超えるものもあります。Avride には「Aviz」という社内ツールがあり、エンジニアが走行の一部を再現して車両の挙動をデバッグできるようになっています。これは実質的に、車がある瞬間に何を検知したかを再現するタイムマシンのような役割を果たします。走行や配送の割り当てに関するスケジュールデータもここに保存・クエリされ、注文のライフサイクル全体を再構成することが可能です。
極めて特徴的なユースケースの 1 つが、C++ のパフォーマンスプロファイリングです。Avride の車両上で稼働するすべての処理は実行トレースを生成し、どのコードパスが、いつ、どれだけの時間実行されたかを記録します。そのデータは ClickHouse に送られ、パイプライン開発者がそれをクエリして、自動運転システムにおけるパフォーマンスの低下を特定したりレイテンシの課題をデバッグしたりしています。これは型破りなユースケースですが、高速な取り込み、高速な検索、高カーディナリティのデータを効率的に処理する列指向ストレージフォーマットという、同じ特性の恩恵を十分に受けています。
これらすべてのユースケースにおいて、データ量は膨大です。各車両は、ハードウェアセンサーの読み取り値から自動運転イベント、スケジュールの更新に至るまで、毎分何千ものデータポイントを生成し、一部のメトリクスは毎秒複数回収集されます。複数の都市で運行する拡大中のフリート全体を掛け合わせると、そのデータ量は瞬く間に膨らみます。
成長に向けた標準の選択肢
今後を見据え、チームは利用の拡大に伴って本番ワークロードを保護するためにクエリクォータの導入を計画しています。フリートは拡大を続けており、データ量の増加、クエリを実行するエンジニアの増加、そして全体を支えるシステムへの負荷増大を意味します。
ClickHouse Cloud により、その成長を受け止める基盤は整っています。メタデータと取り込みの課題に対する局所的な解決策として始まったものは、全社のデータプラットフォームへと成長し、リアルタイムのフリート運用から C++ プロファイリング、経営陣向けダッシュボードに至るまで信頼を寄せられる存在となりました。新たな課題やユースケースが登場しても、スピード、信頼性、スケーラビリティを確保できるパートナーとして、Avride には馴染み深い ClickHouse があります。Dmitry 氏が言うように、「ClickHouse は私たちの標準の選択肢です」。