5万

私たちは先日、PostgreSQL と ClickHouse を単一の統合データスタックとして提供するマネージドサービスを発表しました。その目的はシンプルです。複数のシステムをつなぎ合わせたり、複雑なパイプラインを運用したりすることなく、トランザクション処理と分析処理のワークロードを並行して実行できるようにすることです。このリリースは、私たちが本番環境で繰り返し目にしてきたパターンを反映したものです。PostgreSQL を正統なデータソース(system of record)として維持しつつ、大規模な分析を ClickHouse が担います。
PostgreSQL で始め、ClickHouse でスケールする。
本記事ではマネージドサービスから一歩離れ、そのオープンソースの基盤に焦点を当てます。オープンソースのコンポーネントを使って同じ統合データスタックを構築する方法、実際の連携の仕組み、そしてアプリケーションの書き直しやパイプラインの再構築を行うことなく分析処理を ClickHouse にオフロードする方法を紹介します。
オープンソースデータスタックのご紹介
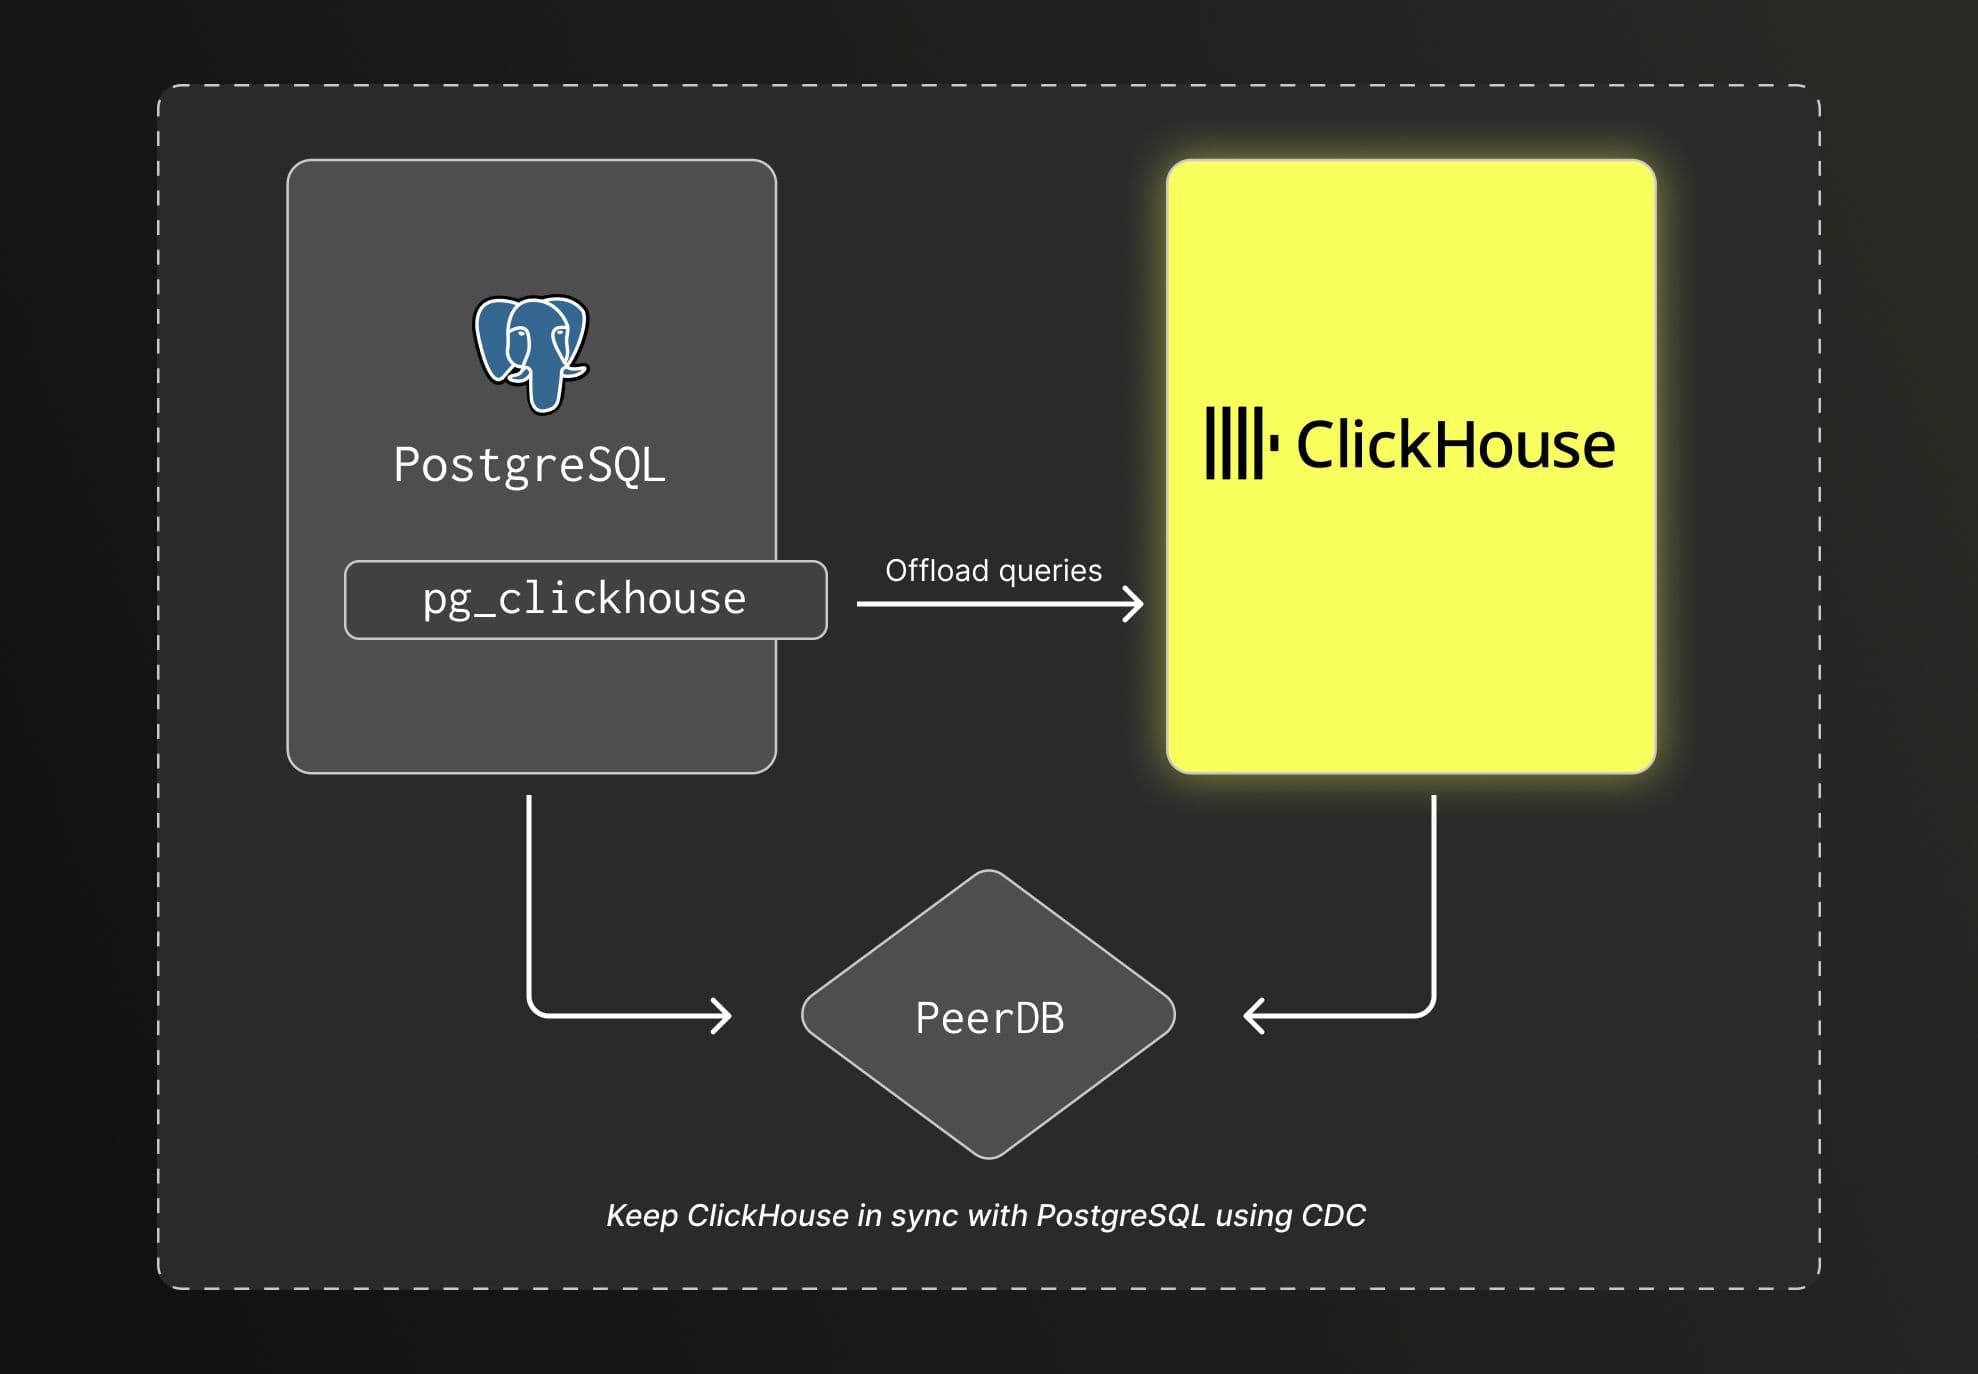
GitHub で公開されているオープンソースの統合データスタックはシンプルで、4 つのオープンソースコンポーネントで構築されています。
-
Postgres は、本データスタックのプライマリデータベースであり、正統なデータソースとして機能し、すべてのトランザクションワークロードを処理します。
-
ClickHouse は、本データスタックの分析専用に構築されたオープンソースのデータベースです。データ量が増加するにつれて、分析ワークロードの処理に最適なデータベースとなります。
-
PeerDB は、PostgreSQL から ClickHouse を含むデータウェアハウスへデータをストリーミングするためのオープンソースツールです。CDC(Change Data Capture)を使用して、挿入、更新、削除をほぼリアルタイムで ClickHouse にレプリケーションします。
-
pg_clickhouse は、SQL を書き直すことなく PostgreSQL から直接 ClickHouse 上で分析クエリを実行できるようにするオープンソースの Postgres 拡張機能です。
これら 4 つのコンポーネントが組み合わさることで、オープンソースの統合データスタックが構成されます。スタックの全体概要は以下のとおりです。
スタックの実装方法
PostgreSQL と ClickHouse を並行して運用する手法は、十分に確立されたパターンです。多くのチームがこのアーキテクチャを本番環境で採用しており、GitLab は 2022 年の時点でこの構成について公開しています。ワークロードに応じて、実装方法は主に CDC(Change Data Capture)または書き込みの分割(スプリットライト)の 2 つのパターンに分かれます。
CDC(Change Data Capture)
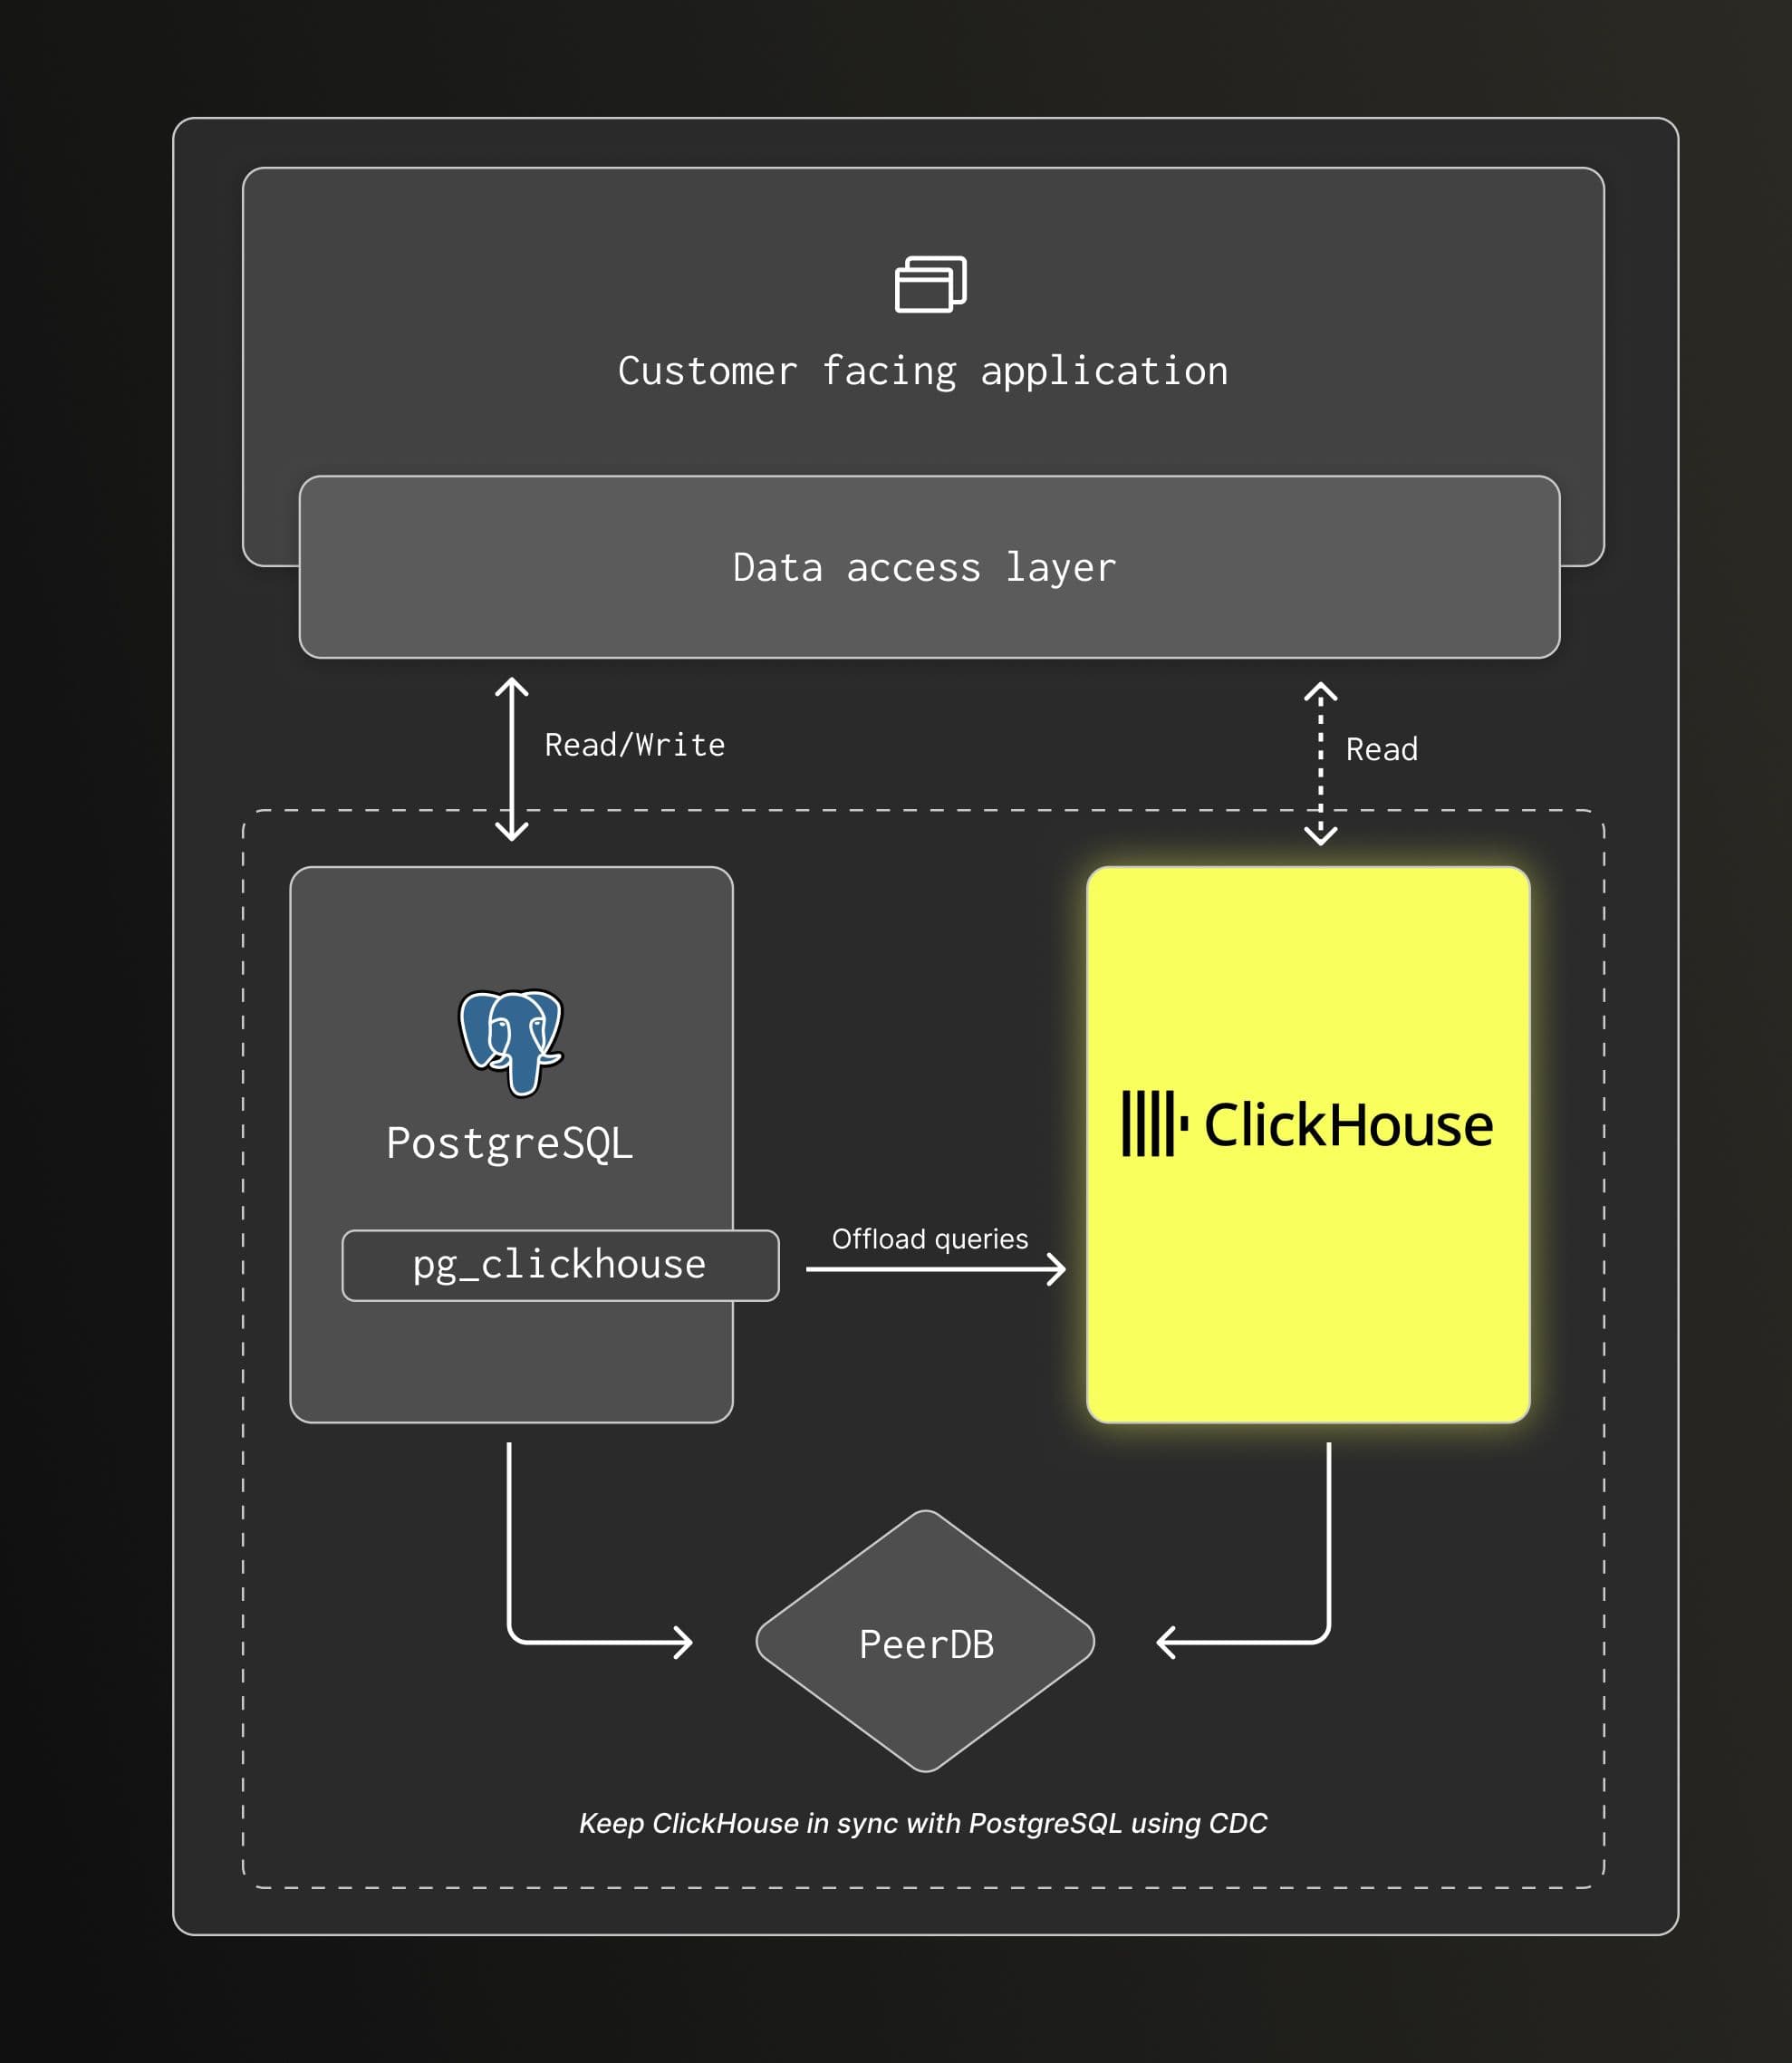
コンポーネント: Postgres、ClickHouse、PeerDB、pg_clickhouse(オプション)。
このアプローチは、アプリケーションデータに対して直接分析を実行するオペレーショナルなリアルタイム分析ワークロードに適しています。代表的なユースケースとしては、小売プラットフォーム、金融システム、CSM(カスタマーサクセスマネジメント)や CRM のアプリケーションなどが挙げられます。
PostgreSQL が正統なデータソースであり続けます。すべての書き込みは PostgreSQL に送信され、PeerDB が CDC を使って挿入、更新、削除を ClickHouse にストリーミングします。ClickHouse はデータのほぼリアルタイムのコピーを保持するため、トランザクションデータベースに追加の負荷をかけることなく、最新の状態に対して分析クエリを実行できます。
アプリケーションは、トランザクションクエリと分析クエリの両方を PostgreSQL に送信し続けることができます。pg_clickhouse が分析クエリを透過的に ClickHouse へオフロードするためです。これにより、アプリケーション側の変更を最小限に抑えられます。また、必要に応じてアプリケーションから ClickHouse へ直接クエリを実行することも可能です。
ユーザー事例: Seemplicity、Sewer AI
書き込みの分割(スプリットライト)
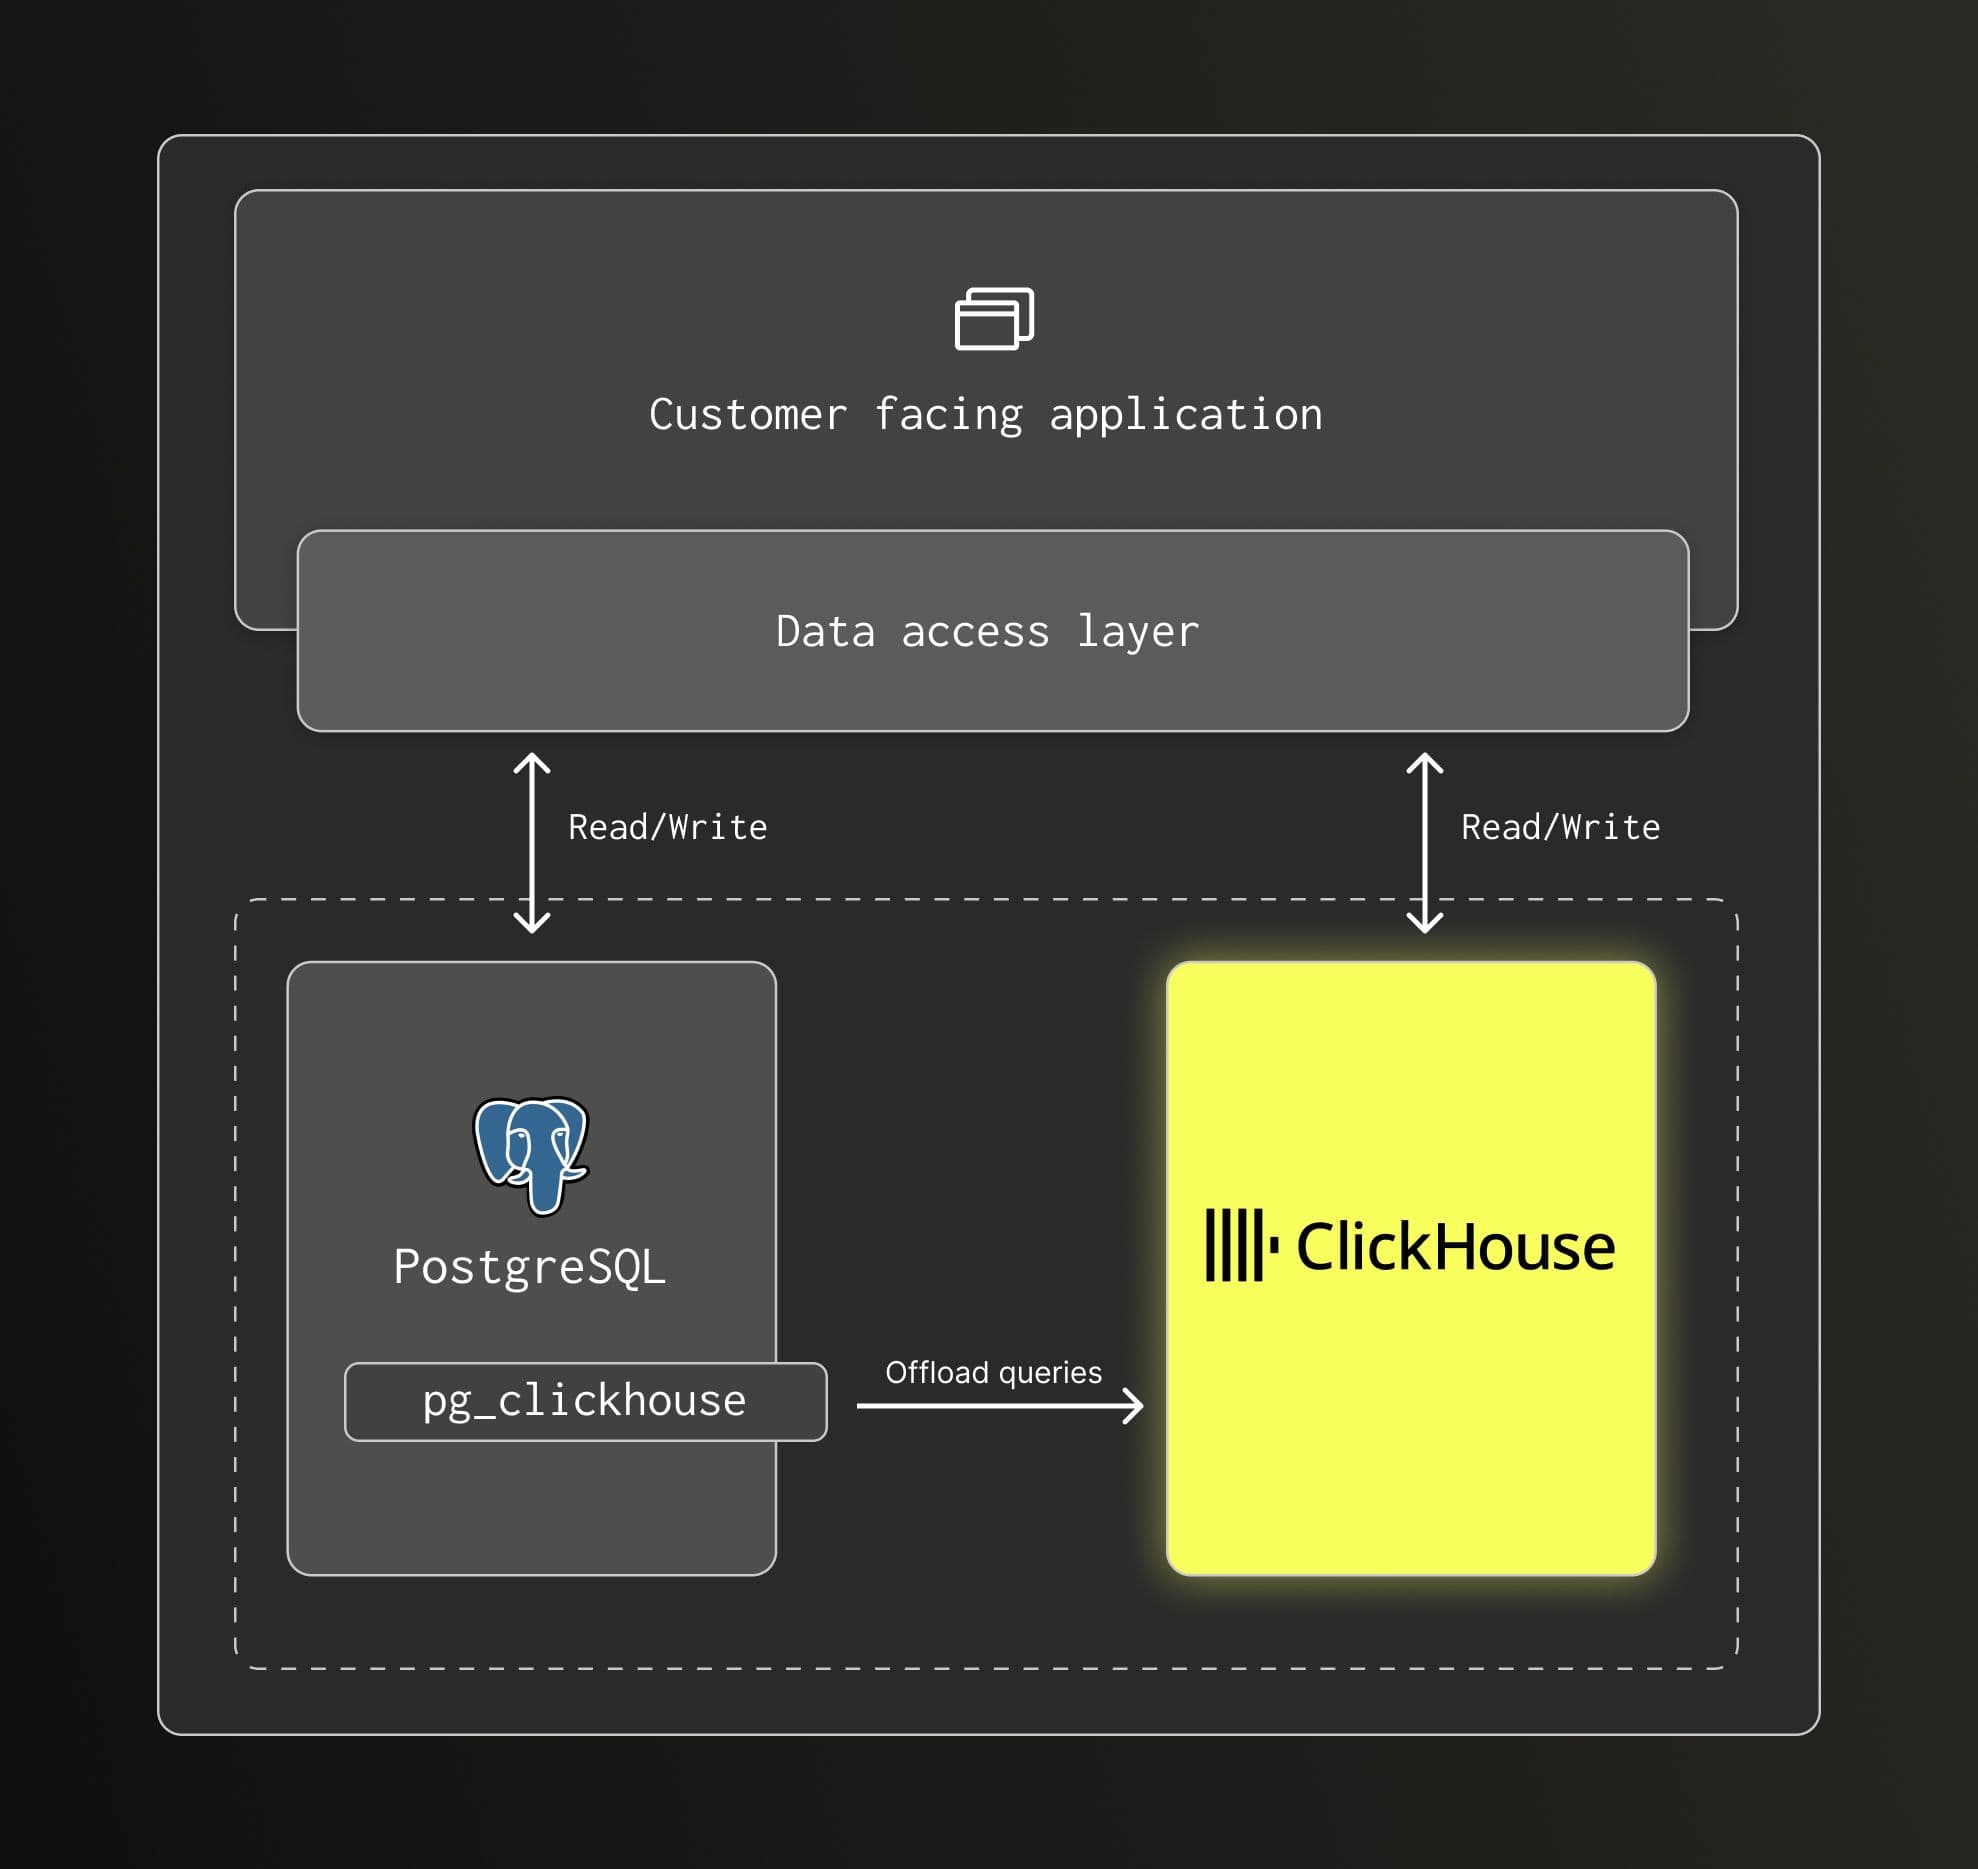
コンポーネント: PostgreSQL、ClickHouse、pg_clickhouse(オプション)。
このパターンは、分析データがログ、メトリクス、イベントで構成されるオブザーバビリティやイベント駆動型のワークロードでよく使われます。これらのデータセットはトランザクションのサポートを必要とせず、大量に書き込まれます。
この場合、分析データを ClickHouse へ直接書き込むか、アプリケーションの変更を最小限に抑えたい場合は pg_clickhouse を介して PostgreSQL 経由でルーティングできます。PostgreSQL はこのデータの正統なデータソースではなく、分析データセット全体を保存する必要もありません。
クエリの実行は CDC アプローチと同じモデルに従います。分析クエリは ClickHouse 上で実行され、pg_clickhouse を介して PostgreSQL から透過的にオフロードされるか、ClickHouse に対して直接発行されます。
ローカル環境で始める
新しいアプリケーションを実装する場合でも、既存の PostgreSQL アプリケーションを拡張する場合でも、ローカル環境で簡単に始められます。スタートガイドでは、ローカルでスタックを実行する方法を説明しています。ローカルで起動したら、アプリケーションを公開された PostgreSQL データベースインスタンスに接続するだけです。
この時点では、独自に PostgreSQL インスタンスを実行しているのと変わりません。アプリケーションが PostgreSQL 単体で問題なく動作している間は、ここで留めておいても構いません。そして、分析ワークロードのパフォーマンスを向上させる必要が生じたときは、次の非常にシンプルな手順で対応できます。
- レプリケーション対象テーブル用に ClickHouse にデータベースを作成します。
- PeerDB を使用して PostgreSQL からデータをレプリケーションします。
- pg_clickhouse 拡張機能を設定します。
- PostgreSQL 接続文字列経由で、クエリを pg_clickhouse テーブルに向けます。
アプリケーションは引き続きプライマリデータベースとして PostgreSQL を利用するため、アプリケーションコードに必要な変更は新たな接続オプションの追加程度と、ごくわずかです。なお、都合がよければ、アプリケーションを ClickHouse に直接接続することも可能です。
本プロジェクトでは、最初はワークロード全体を PostgreSQL で実行するサンプルアプリケーションを含むエンドツーエンドの例を提供しています。用意されたスクリプトを使えば、わずか数ステップで分析ワークロードを移行できます。
本スタックを採用すべきタイミング
この構成の導入は、以下のような状況で有効です。
- PostgreSQL がプライマリデータベースである
- 分析クエリが単なるオフラインレポートではなく、プロダクトの一部となっている
- データ量やクエリの複雑さの増大が見込まれる
成長のサイクルが短期化するなか、PostgreSQL の「限界を迎える」まで待つことは、負荷に追われて後手に回る対応になりがちです。最初から PostgreSQL と ClickHouse を組み合わせて導入しておけば、サービスに影響を与えるような無理な移行作業を避けられます。また、後からこのスタックを採用する場合でも、PostgreSQL がメインのインターフェースであり続けるため、改修範囲を限定できます。
オープンソースから本番対応へ
オープンソースのデータスタックは強力な基盤を提供しますが、多くの本番環境では、運用の境界線が明確で予測可能な挙動を備えたマネージドサービスが求められます。アーキテクチャそのものよりも、データベースの運用やアップグレード、レプリケーションパイプラインの管理、障害対応がボトルネックになるケースは少なくありません。
私たちは先日、同一のアーキテクチャを単一の ClickHouse Cloud アカウント下で統合されたエクスペリエンスとして提供する、統合データスタックのマネージド版をリリースしました。
デプロイ、スケーリング、アップグレード、信頼性の確保はプラットフォーム側で処理されるため、クラスターやデータパイプラインを手動で運用する必要がなくなります。PostgreSQL by ClickHouse は、PeerDB のマネージド代替機能である ClickPipes を通じて ClickHouse に直接接続されます。また、Managed PostgreSQL には pg_clickhouse 拡張機能が事前インストールおよび設定済みで提供されるため、アプリケーションを書き直すことなく分析クエリを ClickHouse にオフロードできます。
ネイティブ Postgres サービスを始める
ClickHouse のネイティブ Postgres サービスをお試しいただくには、こちらのリンクからプライベートプレビューにお申し込みください。
サインアップ新たな基準
PostgreSQL と ClickHouse は競合するデータベースではありません。それぞれ異なるワークロード向けに設計された、相互に補完し合うシステムです。
成熟した CDC やクエリオフロードのツールを使えば、最初から両方を併用するのに複雑なパイプラインや重複したアプリケーションロジックはもはや不要です。PostgreSQL はトランザクションのシステムオブレコード(信頼できる情報源)として機能し続け、データ量が増加しクエリが複雑になっても、ClickHouse が分析クエリを効率的に処理します。
オープンなデータスタックの標準は、もはや単一のデータベースではありません。トランザクションには PostgreSQL、分析には ClickHouse を用い、その間をシンプルで明確に定義されたブリッジでつなぐ構成です。