5万

本日、ClickHouse On-Demand Compute のプライベートプレビューを発表できることをうれしく思います。これは ClickHouse Cloud の新しいインフラ機能です。ClickHouse ワーカーの共有プールは自分のクラスターのコンピュートの外にあり、サービスはそのプール上でクエリを実行できます。
本番のワークロードを妨げずに計算負荷の高いアドホッククエリを実行したい、オートスケーリングの発動を待たずにコンピュートを追加したい、Athena で行うようにデータレイクへクエリを実行したい、と思ったことはないでしょうか。On-Demand Compute では、使用する ClickHouse ワーカーの数をクエリに指定するだけで、あとは ClickHouse Cloud が引き受けます。
それだけではありません。On-Demand Compute は、ClickHouse の主要な2つの機能を基盤としています:
- 新しい分散クエリ実行フレームワーク。ClickHouse のマルチステージクエリ実行を利用して、複雑なクエリを複数のノードにまたがって実行できます。
- 新しいコストベースオプティマイザ(CBO)。複数の実行プランを評価し、クエリをより効率的に実行する方法を選びます。
プライベートプレビューのウェイトリストから登録できます。
ClickHouse On-Demand Compute のウェイトリストに登録
ClickHouse On-Demand Compute のプライベートプレビューへのアクセスをお申し込みください。
なぜ開発したのか
ClickHouse Cloud を開発したとき、主要な目標の1つは、コスト効率が高くスケーラブルなストレージの上で ClickHouse の力をユーザーに届けることでした。SharedMergeTree によってコンピュートとストレージをネイティブに分離でき、サービスは両者を独立してスケールできるようになりました。
その後、需要に応じてコンピュートを増減できるようにオートスケーリングを追加しました。ただし、メトリクスに基づくオートスケーリングは事後対応型です: サービスはスケールする前に、まず需要を観測する必要があります。ほとんどのワークロードでは、それがまさに望ましい動作です。しかし、より多くのリソースが必要だと最初から分かっている、計算負荷の高いクエリはどうでしょうか。最初からそのコンピュートを要求できるなら、オートスケーリングを待つ理由はありません。
とはいえ、言うほど簡単ではありません。追加のコンピュートは通常、クエリが使えるようになる前にプロビジョニングして稼働させる必要があります。そのため、どれも完全ではない3つの選択肢が残ります。ピーク需要に合わせて過剰にプロビジョニングするか、オートスケーリングを待つか、重いクエリを重要なワークロードと競合させるかです。
そこで開発したのが ClickHouse On-Demand Compute です。サービス全体をスケールするのではなく、クエリ自体をスケールします。条件を満たすクエリは、ClickHouse が管理するプールから追加のワーカーを要求できます。これにより、プライマリサービスのサイズを恒久的に増やすことなく、そのサービス上でのリソース競合を抑えられます。
そのため On-Demand Compute は、いくつかのワークロードのパターンで役立ちます:
- アドホッククエリ。 探索的なクエリや単発のクエリを追加のワーカーで実行します。
- ワークロードのオフロード。 選んだ読み取りワークロードを追加のワーカーに移し、重要なワークロードとの競合を減らします。
- データレイクのワークロード。 サポートされている Apache Iceberg と Delta Lake のデータに対して、条件を満たすクエリを追加のワーカーで実行します。
仕組み
On-Demand Compute の使い方は単純で、クエリに設定をいくつか追加するだけです:
SELECT
l_returnflag,
l_linestatus,
sum(l_quantity) AS sum_qty,
avg(l_extendedprice) AS avg_price
FROM lineitem
GROUP BY l_returnflag, l_linestatus
SETTINGS
make_distributed_plan = 1,
distributed_plan_workers_num = 3,
enable_parallel_replicas = 0;On-Demand Compute は次のものに対応しています:
- SharedMergeTree
- Iceberg
- Delta
ワーカーとリース
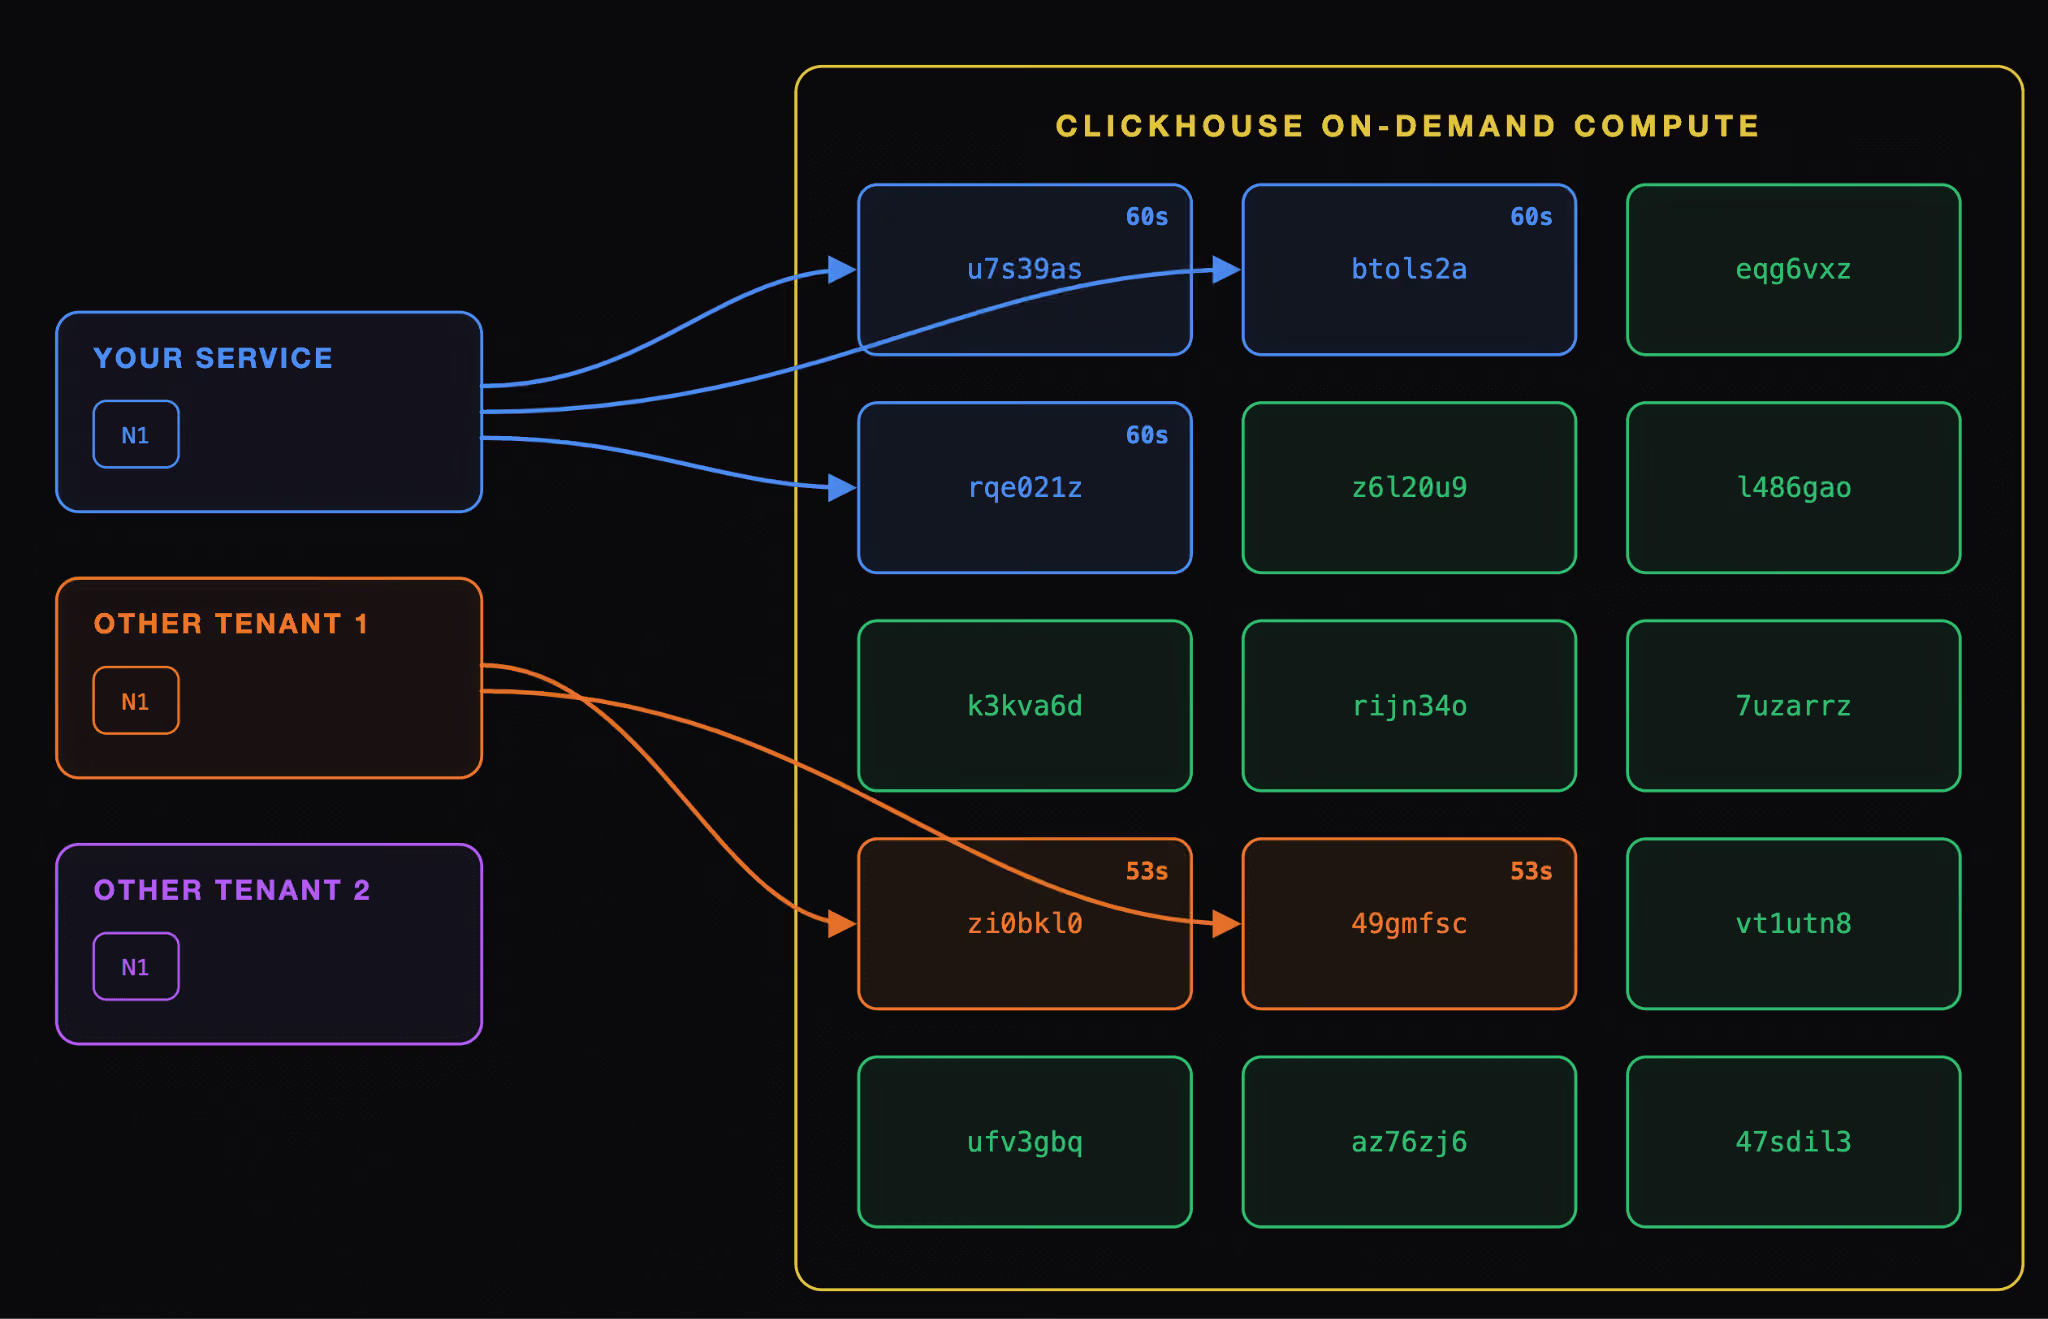
上のクエリを実行すると、On-Demand Compute はプールからワーカーを3台要求します。各ワーカーのリース期間は最低60秒で、クエリの実行が60秒を超える場合はリースが自動的に延びます。
クエリが完了すると、ワーカーはリースされたまま、非アクティブな状態になります。
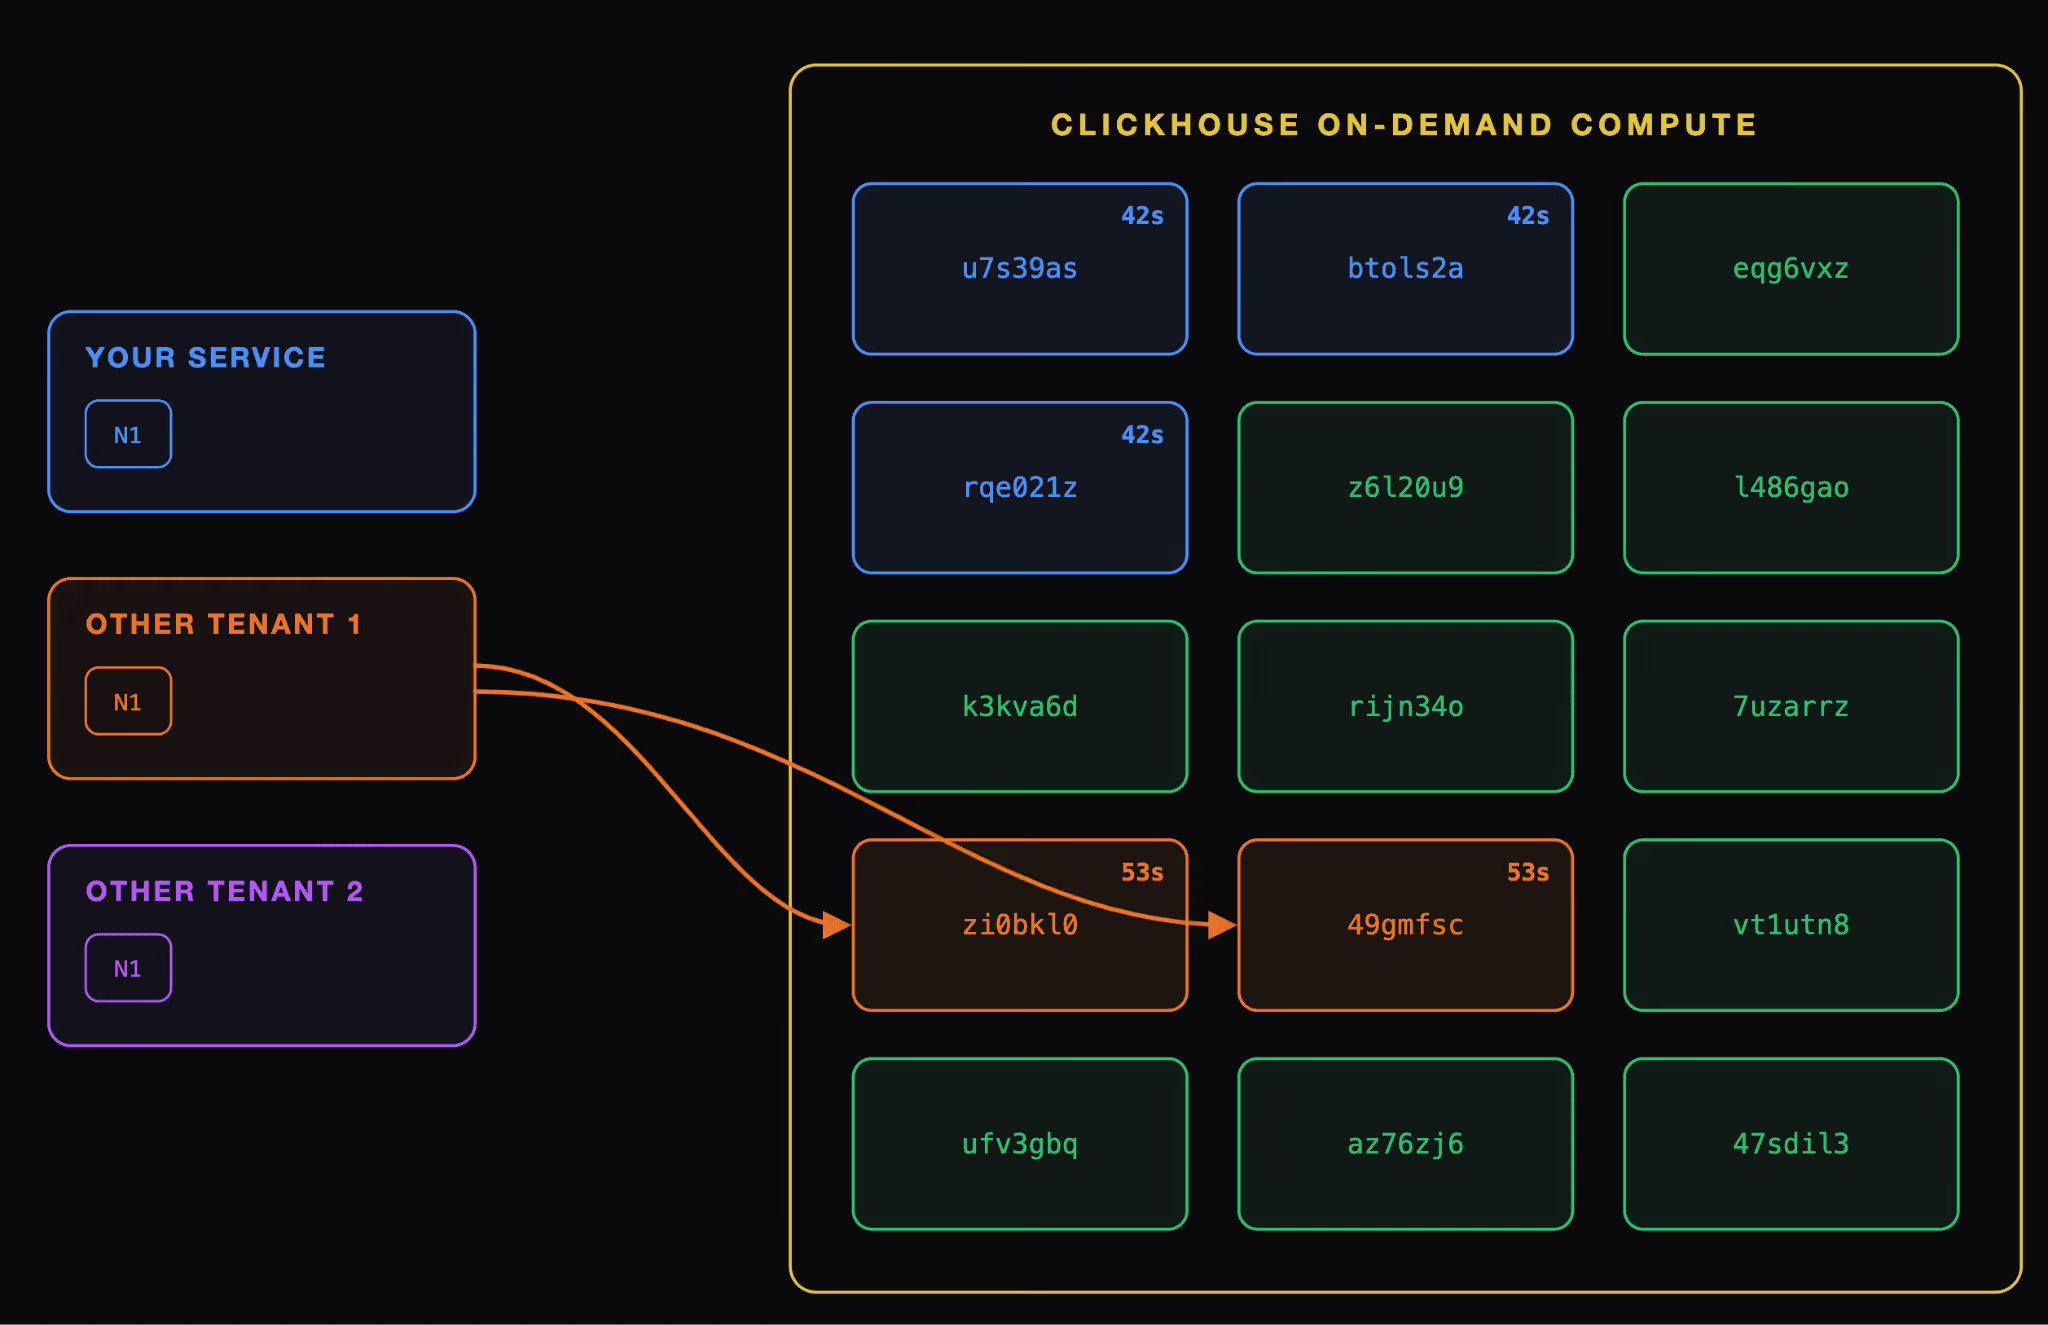
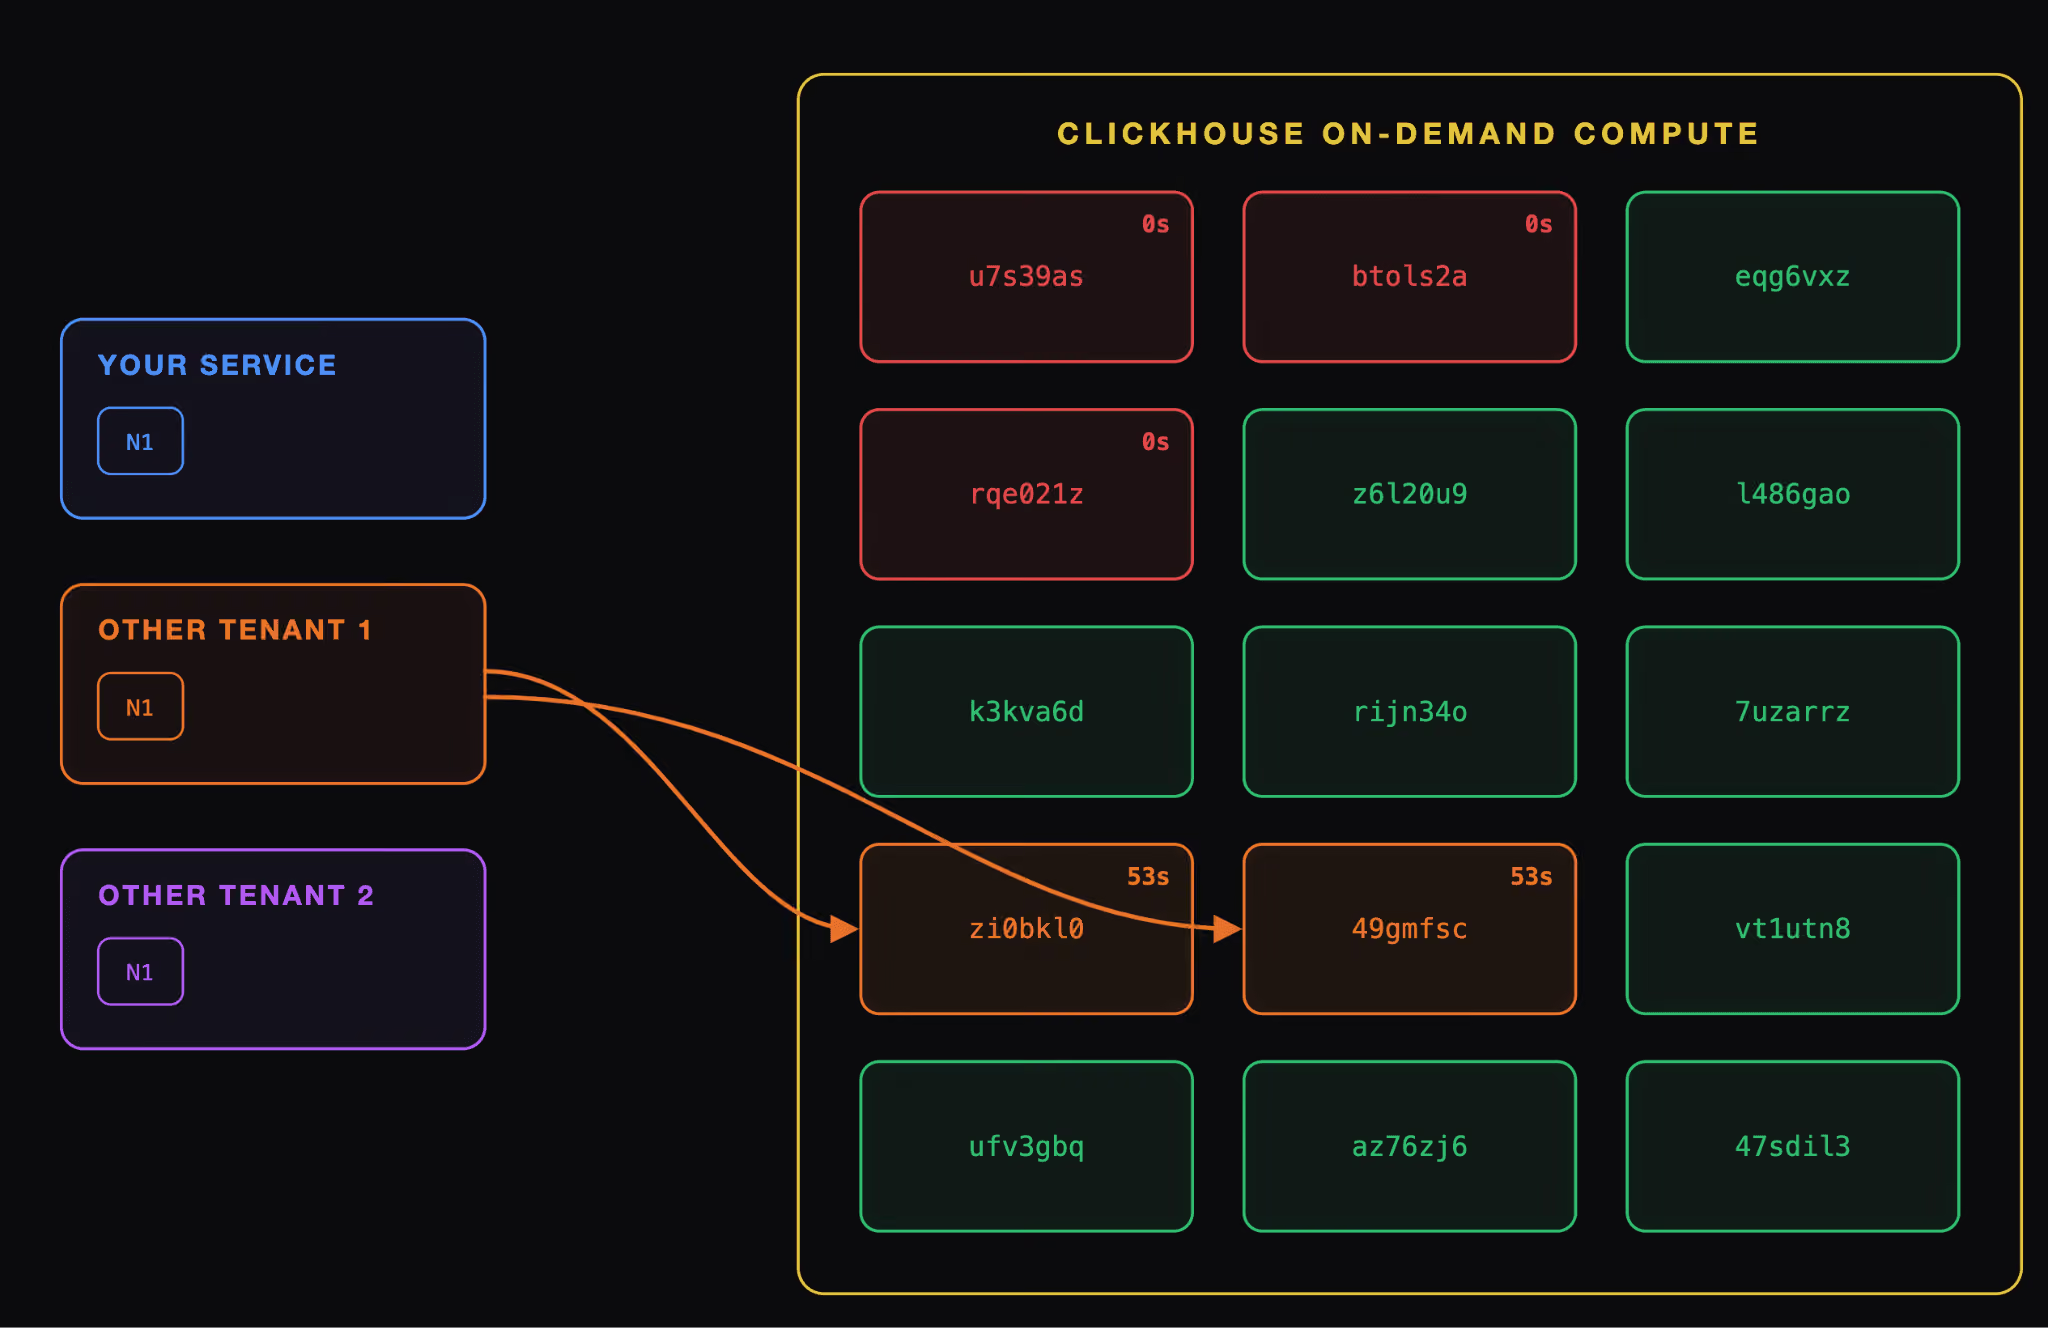
ここが興味深い点です: リースが有効なうちに新しいクエリを送ると、そのワーカーは即時に、コールドスタートもディスカバリの遅延もなく再利用されます。リースが期限切れになると、ワーカーは返却されて終了します。リースが有効な間に届いたクエリは、新しいワーカーの起動を待たずにすぐ開始できるため、ClickHouse はさらに高速になります。
注意すべき挙動が1つあります。同時に実行されるクエリは、それぞれ専用のワーカーを確保するのではなく、ワーカーを共有します。たとえば、同時に実行される2件のクエリがそれぞれワーカーを3台要求した場合、この2件は同じワーカー3台を共有します。さらに3件目のクエリがワーカーを5台要求すると、そのクエリは同じ3台に加えて2台を追加で使います。つまり、確保されるワーカーの台数は、各クエリの要求を足し合わせた数ではなく、最も大きな要求に合わせて増えます。
ワーカープールが足りなくなったら
プライベートプレビューの期間中は、プールのオートスケーリングを調整している段階のため、プールが提供できる数を超えるワーカーを要求してしまうことがあります。その場合でも、クエリはその時点で利用可能なワーカーを使って実行されます。たとえば、ワーカーを5台要求して3台しか利用できない場合、クエリはその3台で実行されます。
On-Demand Compute を実際に動かす
セットアップ
On-Demand Compute をワークロードに活用する方法を見ていきます。
このシナリオでは、ストレージとして SharedMergeTree を、データセットとして TPC-H SF10 を使用します。
次の2つのクラスターを使用します:
On-Demand Compute クラスター:
- 1ノード
- 32 GB/8 CPU の固定サイズ
- 最大15台のワーカー(32 GB/8 CPU)を使用可能
オートスケーリングクラスター:
- 5ノード
- ノードの最小サイズは 32 GB/8 CPU
- ノードの最大サイズは 64 GB/16 CPU
実験はかなり単純です: 各クラスターで、同時実行数を変えながらベンチマークを複数回実行します。On-Demand Compute クラスターでは、クエリの同時実行数が上がるにつれてワーカー数を増やします:
| 試行 | クエリ同時実行数(両クラスター) | On-Demand Compute のワーカー数 |
|---|---|---|
| 1 | 1 | 5 |
| 2 | 3 | 5 |
| 3 | 5 | 10 |
| 4 | 10 | 10 |
| 5 | 20 | 10 |
| 6 | 25 | 15 |
これは、想定より多くのコンピュートを ClickHouse が使えるかどうかを試すものです。
結果
CPU 使用量
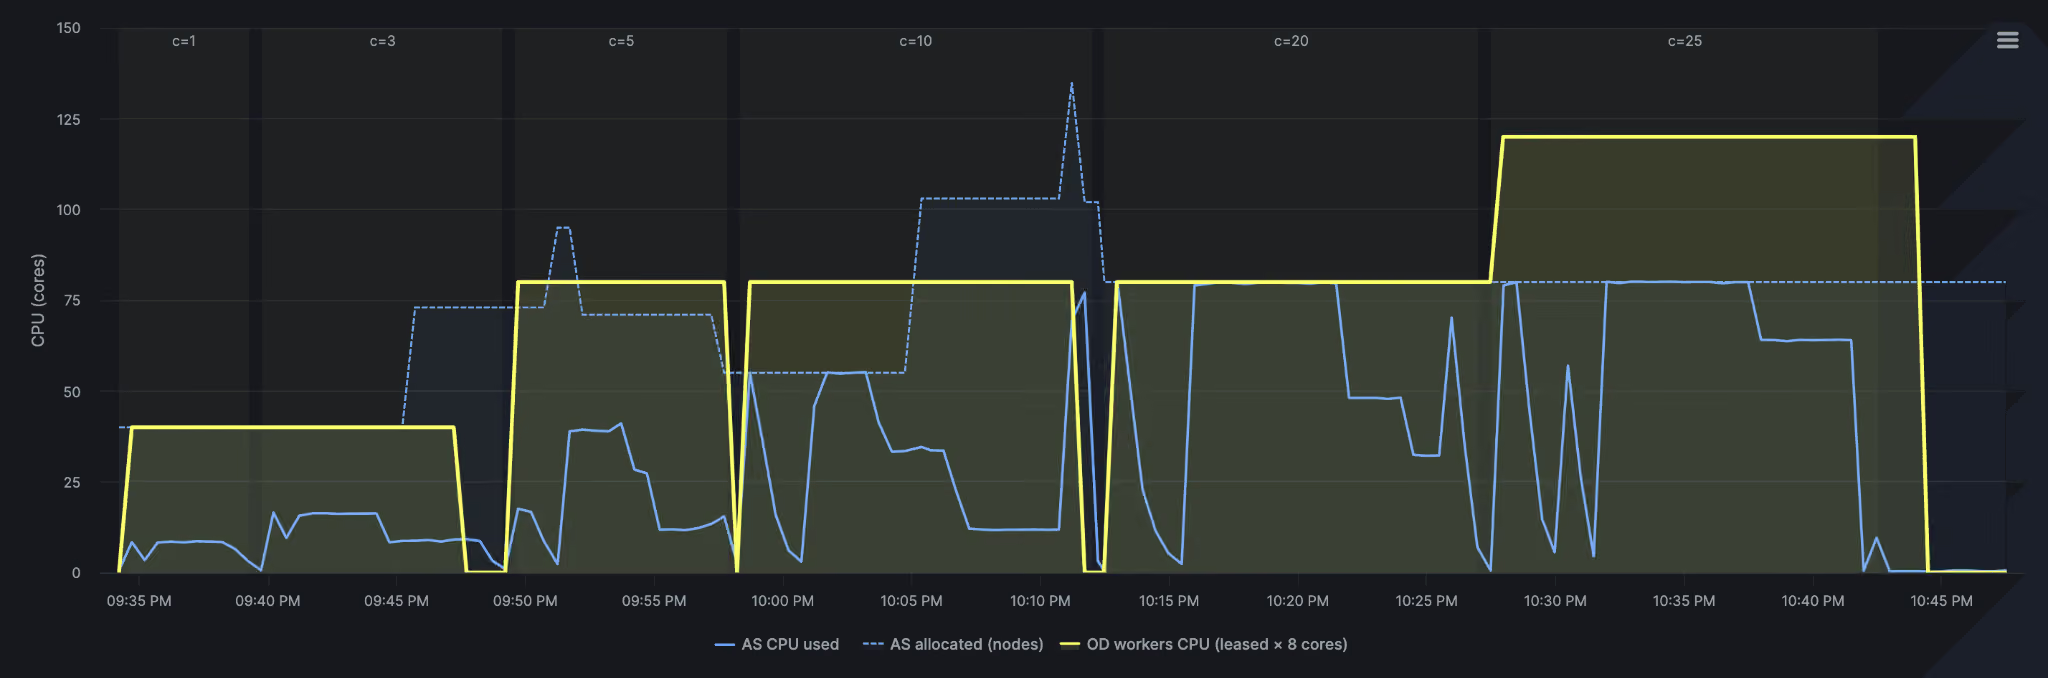
まず、両クラスターの CPU 使用量を見てみます。下の1つ目のグラフは、On-Demand Compute とステートフルなオートスケーリングクラスターの CPU 使用量を比較したものです。同時実行数が1と3のときは、どちらもほぼ同じ量の CPU を使用しています。
2回目の試行の終わり近くで、オートスケーリングクラスターはスケールアップを始めます。ここで使われるのは「make-before-break」方式で、古いキャパシティを削除する前に新しいキャパシティを稼働させます。そのため、使用量が CPU 80 コア付近に落ち着く前に急激に増加します。
オートスケーリングクラスターと比べると、On-Demand Compute(黄色)は異なる挙動を示します。落ち込みが生じるのは、ClickHouse のワーカーがリースされている期間だけ割り当てられるためです。実行の合間の停止中にリースが期限切れになると、そのワーカーは解放され、ワークロードがアイドルの間は CPU 使用量が下がります。つまり、バーストの合間も余分なキャパシティを動かし続けるのではなく、クエリが必要とするときに(まさにオンデマンドで!)コンピュートを使うことになります。
オートスケーリングには時間もかかります。ベンチマークが終わってから数時間が経っても、バーストは終わっているのに、オートスケーラーは依然として CPU 80 コアを推奨していました。クラスターのスケールアップは速い一方で、追加したキャパシティはより長く保持されます。
クエリ性能
2つ目のグラフはベンチマークの性能を比較したものです。この特定のワークロードでは、On-Demand Compute のほうが高速でした。
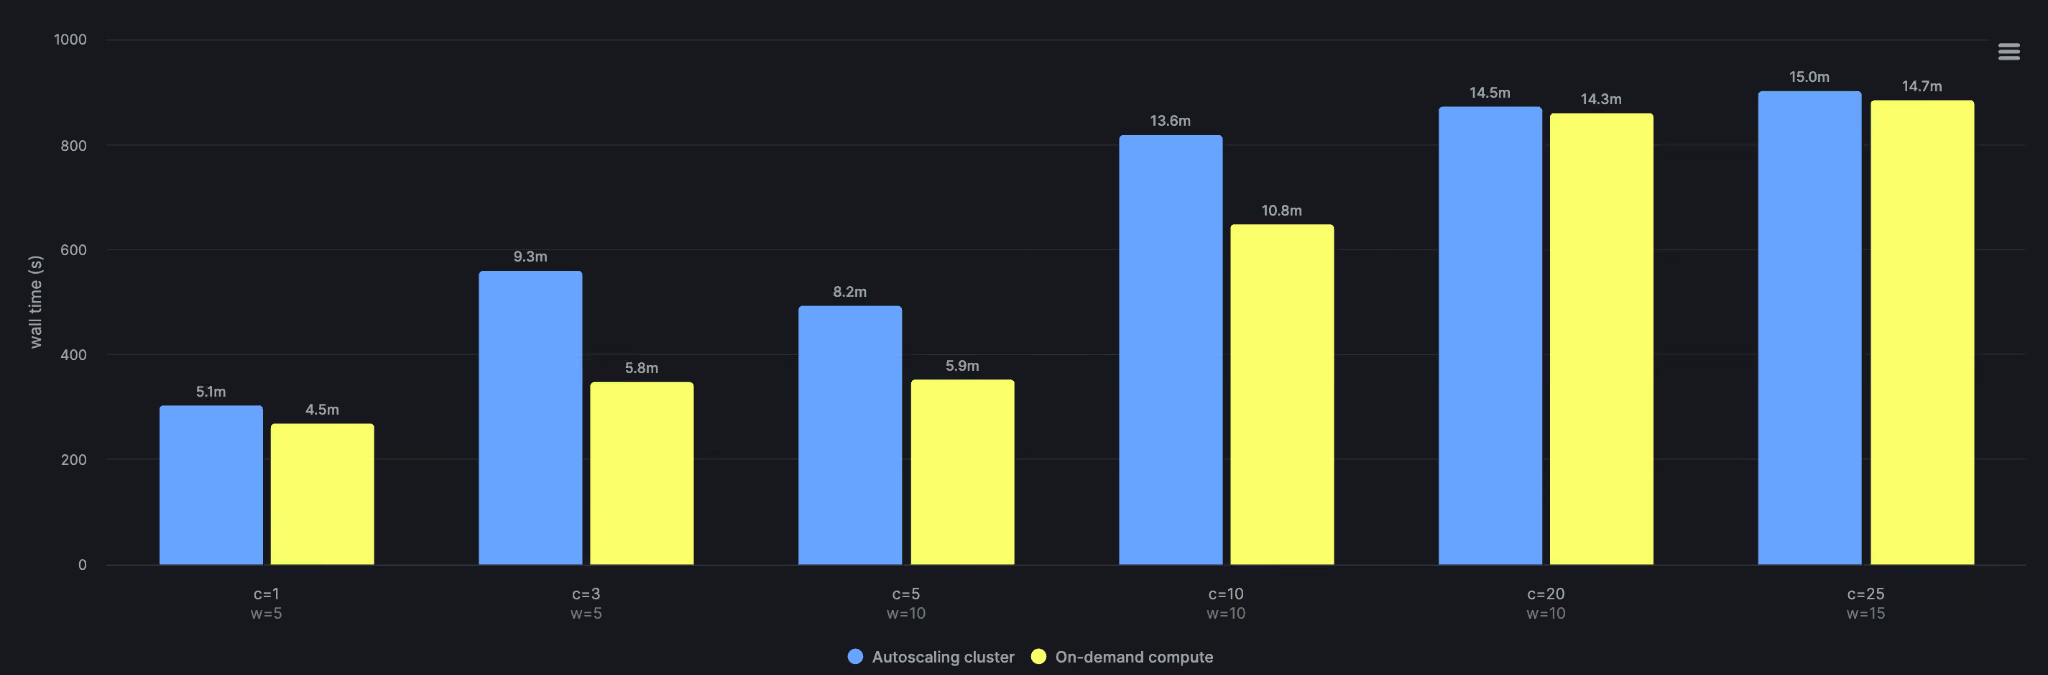
この差の大部分は、新しい分散クエリプランとコストベースオプティマイザ(CBO)によるものです。どちらもステートフルクラスターではまだ有効になっていません。両者が組み合わさることで、より効率的な実行プランが選ばれ、処理が利用可能なワーカーに分散されます。
同時実行数が増えるにつれて、新しい分散クエリ実行フレームワークの性能面の優位は小さくなります。同時クエリ25件、ワーカー15台では、コンピュート量は半分でありながら、ステートフルクラスターの単一ノード実行と同程度の性能を発揮します。
なお、こうした結果はベンチマークごとに変わります。一般に、複雑な JOIN や GROUP BY、ORDER BY を伴うクエリは、新しい分散プランのほうが高速です。一方、単純な読み取りと分析が中心で短時間で終わるクエリは、ステートフルクラスターのほうが高速になる可能性が高いです。
次に予定していること
これは On-Demand Compute の最初のリリースです。第一弾の機能が扱う範囲が限られていることは承知しています。それでも、できるだけ早く皆さんの手元に届けたいと考えました。ぜひ試して、この機能を使った開発を始めてください。そして、改善すべき点や優先すべき点についてフィードバックをお寄せください。
プライベートプレビューへの登録は今すぐ受け付けています。機能の提供開始は、2026年9月24日のウェビナーの後になります。登録はこちらのイベントページからお願いします。機能をさらに詳しく知りたい場合は、ドキュメントをご覧ください: On-Demand Compute のドキュメント。