5万


TL;DR
Apache Iceberg や Delta Lake のようなオープンテーブルフォーマットを用いたレイクハウスは、Parquet の列指向の圧縮やフィルタリングと、スキーマ進化、スナップショット、カタログを組み合わせることで、オブザーバビリティ用途にも実用的になりつつあります。
しかし、大規模なテレメトリにおいては課題も存在します。パーティショニングのトレードオフ、メタデータの肥大化、同時書き込み、半構造化データやポイントルックアップに対する Parquet の制約、そしてオブジェクトストレージのレイテンシなどです。リキッドクラスタリング(liquid clustering)や Parquet の新しい VARIANT 型、Lance のような新興フォーマットといった最近の取り組みによって、このギャップは埋まりつつあります。
オブザーバビリティのためのレイクハウス
過去5年間にわたり、組織がデータを管理・分析する方法において革命が起きています。Apache Iceberg や Delta Lake などのオープンテーブルフォーマットは、かつて混沌としていた分析やウェアハウス向けデータレイクの世界に構造をもたらしました。これらは、オブジェクトストレージのスケーラビリティと低コスト性をデータベースのセマンティクスと両立させるデータレイクハウスを実現します。

かつてデータレイクは柔軟性と構造のどちらかを選択することをユーザーに強いていましたが、オープンフォーマットは単純なファイルの上にテーブルのような抽象化レイヤーを提供し、データの集まりをよりデータベースシステムらしく動作するものへと変えました。これにより、データの重複を減らし、ベンダーロックインを排除し、これまで非構造化だった大規模なデータセットにデータベースレベルのガバナンスと整合性をもたらします。決定的な点は、ストレージとコンピュートを分離し、あらゆるクエリエンジンが接続できる中立的なストレージレイヤーを作り出すことです。これにより、ユーザーは単一のベンダーや実行エンジンに縛られることなく、ワークロードごとに最適なツールを選択できます。
私たちと同じように、オブザーバビリティを「単にもうひとつのデータの問題」と捉えるなら、当然次のような疑問が浮かびます。「オープンテーブルフォーマットを用いたレイクハウスを、オブザーバビリティのワークロードに利用できるだろうか?」
具体的には、オブザーバビリティのユースケースで求められる**「高速な読み取り、半構造化イベントに対する柔軟なスキーマ、優れた圧縮率、低コストな長期保持、そして高スループットな取り込み」**といった特性を、レイクハウスは提供できるのでしょうか。
本記事では、レイクハウスで利用されるオープンテーブルフォーマットとその基盤技術の強みと弱点を探るとともに、将来的にこれらのフォーマットがオブザーバビリティのワークロードにおいて不可欠な要素になると期待される有望な進化についても取り上げます。
オブザーバビリティにおいてレイクハウスが機能する領域
すでに多くのチームが、低コストで長期保持するためにログ、トレース、メトリクスを直接オブジェクトストレージに書き込んでいます。オープンテーブルフォーマットを導入するとデータベースのようなセマンティクスが加わり、ベンダーロックインや、専用のオブザーバビリティシステムへデータをコピー・再処理する必要なしに、ClickHouse などの多様なエンジンからこのデータをクエリできるようになります。理論上、このアプローチはコンピュートコストの削減、データの重複(およびデータの移動に伴うネットワークコスト)の抑制、そして低コストな長期保持を実現する道筋となります。まずは基盤となるファイルフォーマットである Parquet から、オブザーバビリティのワークロードに適したオープンテーブルフォーマットの特性を見ていきましょう。
Parquet - 堅牢な列指向の基盤
Apache Parquet は、大規模なデータセットに対する効率的な分析処理向けに設計された列指向のファイルフォーマットです。従来のデータベースのように行をまとめて保存するのではなく、Parquet はカラムごとにデータを格納するため、クエリは必要なフィールドのみを読み取ることができます。これは、オブザーバビリティのワークロードにおける集計やチャート描画に最適です。また、この列指向のレイアウトは、特に値がソートされている場合や重複している場合に極めて効率的な圧縮を可能にします。各カラム内では、冗長性を削減し、よりコンパクトに値を格納するために、ランレングス符号化、辞書エンコーディング、デルタエンコーディングといったデータに適したエンコーディングが適用されます。
 Parquet ファイルとしての Web アナリティクスデータセットの例
Parquet ファイル内の各カラムは、そのカラムのデータを保持するカラムチャンク (2) に分割されます。これらのカラムチャンクは、読み取り時の I/O 単位となる通常数メガバイトのページ (3) にさらに分割されます。その後、各ページは Zstandard (ZSTD) や Snappy などのアルゴリズムを用いてブロックレベルで圧縮され、ストレージフットプリントと読み取り時の I/O 量の両方を削減します。このように階層化された設計は、ClickHouse 独自の列指向 MergeTree エンジンと同様の原則に基づき、圧縮効率、高速で選択的な読み取り、管理可能なメタデータのバランスを取ることを目指しています。
最後に、Parquet はデータセットの水平方向のスライスを表す行グループ (1) にカラムチャンクをまとめます。多くの場合、これらの行グループが並列処理の鍵となります。大半のクエリエンジンは、複数のスレッドやノードにわたって行グループを個別に処理します。各行グループのサイズはライターによって定義されます。多くのエンジンは行グループ単位で並列化しますが、より新しい実装(ClickHouse の v2 リーダーなど)では、ページ内のカラム間や複数ファイル間でも並列化でき、特にワイドテーブルにおいてさらに優れたパフォーマンスを発揮します。
また、Parquet には、下図のようにデータを読み取る前に効率的なフィルタリングを可能にする豊富なメタデータと統計情報のレイヤーが含まれています。各ファイルはこの情報をフッター (4) に保存し、スキーマ、エンコーディング、カラムレベルの最小値・最大値の統計情報を記述します。カラムチャンクレベル (1) では、カラム値のエンコードや圧縮率の向上、存在確認の高速化に用いられる辞書を含めることができます。これらのチャンク内の個々のページ (2) も最小値・最大値の統計情報を保持できるため、きめ細かなプルーニングによって高速な読み取りが可能になります。最後に、特定の値が存在するかどうかを効率的にチェックするための Bloom フィルタが行グループレベル (3) でサポートされています。これらのメタデータ構造により、クエリエンジンはファイルのどの部分が関連しているかを素早く特定し、I/O と CPU の使用を最小限に抑えることができます。

Parquet の列指向レイアウト、統計情報、最新の圧縮アルゴリズムの採用により、高い圧縮率と効率的なフィルタリングの双方が可能になります。これらの機能により、選択的なフィルタリングと大規模なスキャンや集計を組み合わせるオブザーバビリティのワークロードに極めて適しています。
オープンテーブルフォーマット - 強固な基盤の上に構築する
Parquet は大半のレイクハウスシステムに物理ストレージの基盤を提供しますが、それはファイルフォーマットにすぎず、変更の管理やライターの調整を行うことなくデータレイアウトを定義しているだけです。Apache Iceberg や Delta Lake といったテーブルフォーマットは、Parquet の上に構築され、スナップショット、スキーマ進化、タイムトラベル、アトミックコミットなどの不可欠なテーブルセマンティクスを追加します。これらは、テーブルの場所、バージョン、スキーマ履歴を追跡するメタデータサービスであるカタログ(Unity、AWS Glue、Nessie など)を導入します。これにより、ばらばらなファイルの集まりが、一貫性のある変更可能なテーブルへと変わります。
本記事では、トランザクションの保証がそこまで重要ではなく、データがほぼ不変であるオブザーバビリティに最も関連する機能に焦点を当てます。テーブルフォーマット間で実装の違いはあるものの、その目的は共通しています。説明の都合上、主に Apache Iceberg を中心に取り上げます。
 カタログを備えた Iceberg テーブルフォーマット
スキーマ進化
テーブルフォーマットがもたらす最も価値ある機能の1つが、スキーマの管理と進化です。テレメトリの構造が頻繁に変わり、時間の経過とともに新しい属性が登場するオブザーバビリティにおいて、この柔軟性により過去のファイルを書き直したり、独自のメタデータレイヤーでスキーマ管理を手動で行ったりすることなくデータを進化させることができます。テーブルフォーマットなしでこれを管理するには、クエリエンジン(またはユーザー)がスキーマの差異を把握し、クエリを適応させる必要があります。テーブルフォーマットはメタデータにスキーマのバージョンを記録するため、スキーマが拡張または変更されても古いデータをクエリ可能な状態に保てます。要するに、これは「単なる Parquet ファイルの集まり」と比べて、オブザーバビリティにおけるクエリをよりシンプルで信頼性の高いものにします。

パーティショニング
テーブルは時間、サービス、またはその他のディメンションでパーティショニングでき、エンジンが関連するパーティションのみを読み取れるようにすることでクエリの効率を高められます。ファイルレベルやカラムレベルの統計情報などの追加のメタデータと組み合わせることで、これらのフォーマットはメタデータに基づくプルーニングを可能にします。エンジンは Parquet データをスキャンする前にパーティションやファイル全体をスキップでき、I/O とレイテンシの両方を削減します。
コンパクションとソート
レイクハウスシステムにおいて高速な読み取りを維持するには、データをソートした状態に保つことと、小さなファイルの数を最小限に抑えることという、関連する要因に左右されます。ソートにより似た値が近くに書き込まれるため、圧縮率が向上し、ファイルレベルおよびカラムレベルの統計情報によるフィルタリングがより効果的になります。しかし、小さなファイルが多すぎると、メタデータと I/O のオーバーヘッドが大幅に増加します。各ファイルは独自のフッターを持ち、個別にオープン、読み取り、クエリ計画を行わなければならず、レイテンシが増加してスキャン効率が低下します。一貫した順序付けとファイルの統合がなければデータは断片化し、プルーニングの効果が薄れ、クエリは必要以上のデータを読み取ることを余儀なくされます。
書き込み時にこの順序付けを実現することは、原理的には単純ですが実際には複雑になる場合があります。受信データは書き込まれる前にバッチ処理およびソートされ、各 Parquet ファイルにタイムスタンプやサービス名などのパーティションキーで揃えられた値が含まれるようにする必要があります。このプロセスでは多くの場合、書き込み前のバッファリングとソートを担う Kafka、Flink、Spark などの外部システムを介した調整が必要になります。
ファイルが順序通りに書き込まれたとしても、新しいデータが届いたり遅延イベントが取り込まれたりすると、その順序は時間の経過とともに崩れます。局所性を維持するには定期的なコンパクションが必要であり、多数の小さなファイルや乱れたファイルを、適切にソートされた大きなファイルへとマージします。コンパクションはメタデータのオーバーヘッドを減らし、削除や更新を統合し、良好な圧縮率とクエリ性能を支えるデータの局所性を維持します。レイクハウス環境では、これは通常 Spark や Athena などの外部エンジンによって実行されるか、Databricks のようなマネージドシステム内で継続的なバックグラウンドプロセスを通じて自動的に処理されます。
 パフォーマンスとリソース効率のバランスを取るために、コンパクション時に使用されるファイル数、最小・最大サイズ、各ファイルグループの合計バイト数を設定する必要があります。
ClickHouse は、バッチ処理とコンパクションの両方をネイティブに処理します。エッジエージェントやテレメトリコレクターからの小さな挿入は、書き込まれる前に自動的にバッチ処理およびソートされ、最適な圧縮と効率的なフィルタリングのために値が近接して配置されるようにします。その後、バックグラウンドのマージプロセスが、小さなデータパートを順序付けされた大きなファイルへと継続的に結合します。これはユーザーから見て完全に透過的です。
スナップショット
スナップショットやタイムトラベルなどの機能は、テーブルフォーマットを運用上のオブザーバビリティパイプラインにとって魅力的なものにしています。スナップショットはデータセットの特定の時点のバージョンを記録し、大規模で分散された書き込み全体にわたって一貫したビューを提供します。これにより、取り込みジョブが失敗した場合や再処理が必要になった場合でも、再現性のある分析や安全なロールバックがサポートされます。
テーブルフォーマットとオブジェクトストレージ
オブジェクトストレージはレイクハウスのスケーラビリティを支えています。これらのテーブルは理論上ローカル SSD 上に配置することも可能ですが、ほぼ常に Amazon S3、Azure Blob Storage、Google Cloud Storage などのシステム上にホストされています。これは、実質的に無限のデータ保持を低コストで提供するレイヤーです。ClickHouse を含む最近の大半のクエリエンジンは、Parquet ファイルとそれに関連するテーブルフォーマットの両方をオブジェクトストレージから直接ネイティブに読み取ることができ、オープンフォーマットとクラウドネイティブなインフラストラクチャの組み合わせを極めて強力なものにしています。
ファイルフォーマットとテーブルフォーマットの双方がオブジェクトストレージとうまく統合されている一方で、このアーキテクチャにはいくつかの実践的な制約も生じます。これらについて次に見ていきましょう。
オブザーバビリティにオープンテーブルフォーマットを使用する際の課題
パーティショニング戦略の選択
オープンテーブルフォーマットを扱う際、適切なパーティショニング戦略を選択することは極めて重要です。パーティションはデータが物理的にどのように配置されるかを決定し、高速な読み取りのためにクエリが関連するサブセットをどれほど効率的に絞り込めるかを左右します。ClickHouse もパーティショニングをサポートしていますが、主キーも設定できるため、はるかに細かい粒度での順序付けとフィルタリングが可能です。過剰なパーティショニング(過度の分割)は小さなファイルの急増を招き、不十分なパーティショニングは不必要に広範なスキャンを強いることになります。これらの問題を軽減するには、外部プロセスで手動対処するか、Databricks や AWS S3 Tables などのマネージドソリューションを使用する必要があります。この問題は、遅延データが小さなファイルを含むパーティションの断片化を引き起こし、パフォーマンスを回復するために後から明示的なコンパクションが必要になる場合に特に顕著です。これに対し、多くの分析データベースにはこれらの問題に透過的に対処するマージプロセスが組み込まれています。
メタデータのスケーリング
メタデータのスケーリングとスナップショットの管理も、レイクハウスシステムにおけるもうひとつの課題です。Iceberg のようなフォーマットでは、書き込み、スキーマ変更、コンパクションを行うたびに、マニフェスト、スナップショット、ファイル一覧などテーブルの状態を記録する新しいメタデータファイルが作成されます。オブザーバビリティのような高頻度に取り込みが発生する環境では、これらの構造が数百万ものエントリに膨らむことがあり、クエリ計画のレイテンシやメモリ使用量が増加し、挿入パフォーマンスが低下します。この肥大化を抑えるために、エンジンは定期的にマニフェストをマージし、スナップショットを期限切れにし、ガベージコレクションを実行しなければならず、これには連携とコンピュートリソースが必要となります。これらのメンテナンス作業は手法としては確立されているものの、大規模環境では考慮しなければならない運用上の複雑さをもたらします。
並列書き込み
テーブルフォーマットは楽観的同時実行制御を通じて堅牢な書き込みセマンティクスを提供し、複数のライターが同じテーブルに同時に安全にコミットできるようにします。各ライターはテーブルの最新のスナップショットに対して処理を行い、コミットはカタログによってアトミックに処理されます。別のライターが先にテーブルを更新した場合、後続のライターは新しい状態でリトライします。このモデルはオブジェクトストレージにデータベースのような分離性をもたらすため魅力的ですが、オブザーバビリティのワークロードで一般的な極めて高い取り込みレートでは、テーブルのメタデータポインタへの競合がボトルネックとなり、頻繁なリトライやコミットスループットの低下につながる可能性があります。ユーザーは書き込みをバッチ処理したり、各ライターが別々のパーティションやバケットを処理するようにパーティションレベルの並列処理を用いたり、小さなファイルを定期的にコンパクションしたりすることでこれを軽減できます。しかし、これらの手法を用いてもなお、同時書き込みのスケーリングには、ストレージエンジン自体がそうした調整を透過的に処理する従来のデータベースよりも多くのオーケストレーションとチューニングが必要になります。
潜在的な制約としての Parquet
オープンテーブルフォーマットに関して前述した課題の大半は、適切なツールやマネージドサービスによって軽減できますが、Parquet ファイルフォーマット自体には、オブザーバビリティにとってより根本的な課題が存在します。
半構造化データのサポート
これらの制約の一部は、Parquet が動的なデータベースエンジンではなく、静的な列指向ストレージフォーマットとして設計されたという目的に起因しています。Parquet は構造化された分析データに対しては非常に効率的ですが、データ型と物理レイアウトが密結合しているため型の進化が難しく、最新のデータベースシステムと比較してサポートされる型の種類も限られています。オブザーバビリティで見られる動的なデータに求められる半構造化データの扱いには限界があります。
大半のエンジンにおいて、Parquet で半構造化データを扱う場合は単一のフィールドにアクセスするためだけにエンコードされたデータのページ全体を読み取って解凍しなければならないことがよくあります。これは、ネストされた構造(struct、LIST など)が定義レベルと反復レベルを使用して格納されており、階層を再構築するためにこれらを順次デコードしなければならないためです。このアプローチでは、特に階層の奥深くにある少数の属性のみが必要な場合に、JSON のようなデータに対するクエリが遅くなり、リソース消費が激しくなる可能性があります。さらに重要なのは、struct や LIST を使用する場合、各フィールドが一貫した型を持つことを担保しつつ、事前にスキーマを把握しておく必要がある点です。その上、新しいフィールドが出現するたびにフォーマットのテーブルスキーマを更新しなければならず、大規模環境では負荷の大きいメタデータ操作となります。別の方法として JSON をバイト配列としてエンコードすることもできますが、クエリ時にすべての値をデコードして読み取る必要があり、大規模環境では現実的でなく低速になります。
最近、Parquet には
VARIANT型が導入されました。これはこれらの課題の解決に有望視されています(詳細は後述)。
 Parquet の JSON と ClickHouse の JSON の比較
対照的に、ClickHouse などの分析データベースは半構造化データに対するより高度なサポートを提供しています。JSON フィールドを挿入時に型固有のカラムへと自動的に展開できるため、オブジェクト全体をスキャンまたはパースすることなく個々のキーをクエリでき、ネイティブな列指向ストレージの持つ圧縮、インデックス作成、フィルタリングのメリットをすべて維持できます。
小規模な読み取りではなく、大規模スキャン向け
Parquet は根本的に、ポイント読み取りではなく大規模なシーケンシャルスキャン向けに最適化されています。その設計はレイテンシよりもスループットを重視しています。データは行グループ内の大きな圧縮ページに保存され、多くの場合数十〜数百メガバイトに及びます。1件のレコードを読み取るだけでも、クエリエンジンは適切な行グループを特定し、対応するカラムチャンクを取得し、ページ全体(辞書を含む)を解凍して必要な値を抽出しなければなりません。このプロセスはオーバーヘッドを生じさせ、単一レコードの取得を低速かつコスト高にします。これとは対照的に、ClickHouse のようなデータベースは値を含む正確なブロックを特定できるインメモリインデックスを保持しています。
この非効率性は、ポイントクエリが多用されるオブザーバビリティのワークロードにおいて特に問題となります。特定のトレースやログイベントを調査する際、アナリストは trace_id や span_id などの一意の識別子でクエリすることがよくあります。これらの検索は極めて選択性が高い(高選択性)のですが、Parquet の構造は単にこうしたアクセスパターン向けに作られていません。
いくつかの回避策は存在しますが、どれもトレードオフを伴います。Elasticsearch や Key-Value ストアなどの外部インデックスは検索を高速化できますが、インフラ、複雑さ、整合性のリスクが増加します。カーディナリティの高いキーでパーティショニングすると選択性は向上しますが、多くの小さなファイルが作成され圧縮効率が低下します。Bloom フィルタは検索範囲を絞り込めますが、依然としてページ全体の読み取りと解凍が必要です。まとめると、ポイント読み取りの高いレイテンシは、オブザーバビリティにレイクハウスを使用する上での制約となっています。
メタデータのオーバーヘッド
Parquet の大きな課題として、メタデータのオーバーヘッドと行グループサイズの管理が挙げられます。各ファイルのフッターには、すべてのカラムと行グループに関するスキーマ、エンコーディング、圧縮、統計情報が保存されます。データセットのカラム数が増加したり(ワイドテーブル化)、多数の小さな行グループを使用したりすると、このメタデータはファイルあたり数十メガバイトにまで肥大化することがあります。フッターはデータへアクセスする前に読み取ってパースする必要があるため、メタデータの肥大化はクエリプランニングを直接的に遅延させ、レイテンシを増加させます。幅が広いデータセットや細かくパーティショニングされたデータセットでは、特にオブジェクトストレージ経由で多数のファイルを並列スキャンする際、エンジンがデータを読み取る時間よりもメタデータの処理に多くの時間を費やす可能性があります。
適切な行グループサイズを選択することは、パフォーマンスのバランスを取る上で極めて重要です。グループを小さくするとより詳細な統計情報が得られ、データスキッピングと並列性が向上しますが、グループごとに追加されるメタデータによってフッターサイズが増大し、プランニングが遅くなります。グループを大きくするとメタデータが削減されスキャン効率は向上しますが、プルーニングが制限され、並列性が低下し、幅の広いデータを解凍する際のメモリ使用量が増加する可能性があります。最適なサイズはワークロードとデータに依存するため、判断は決して容易ではありません。
こうした種類の最適化は低レイヤーのものであり、正しく調整するには極めて多くの時間がかかることがよくあります。一般に「ただ問題なく動く」ストレージエンジンを求めている大半のオブザーバビリティチームにとって、これは関心事や責務の範囲を大きく超えています。
オブジェクトストレージ向けの最適化
Parquet はローカルや分散ファイルシステム上では極めて優れた性能を発揮しますが、S3 などのオブジェクトストレージ上で直接使用すると、その設計上の弱点が露呈します。このフォーマットのメタデータ主導の構造では、(1) スキーマと行グループを検出するためのフッター、関連する (2) ページグループメタデータ、(3) ページメタデータ、(4) カラムメタデータ、そして最後にデータページ自体という、一連の読み取りが必要になります。

各ステップは複数のネットワークラウンドトリップリクエストへと変換されます。そして S3 のリクエストは比較的レイテンシが高いため、小規模なクエリであっても、データが処理される前に数十回もの連続した HTTP レンジリクエストがトリガーされる可能性があります。この「リクエスト増幅」効果により、Parquet はオブジェクトストア上で本質的に「おしゃべり(chatty)」になります。この状況は巨大なメタデータブロックによってさらに悪化します。詳細な統計情報やページインデックスはプルーニングを向上させますが、クエリプランニング中にダウンロードしてパースしなければならない非データバイトの量を膨らませてしまいます。ClickHouse のようなエンジンは非同期 I/O、積極的なプリフェッチ、メタデータキャッシュによってこの影響を緩和しますが、オブザーバビリティ向けの高速な読み取りを実現するには、オブジェクトストレージの高レイテンシ・高スループットという特性に起因する根本的な課題が依然として残ります。
課題を解決する技術革新
上記で述べた課題の多くは複雑で管理が難しく見えるかもしれませんが、業界は急速に進化を遂げています。
テーブルフォーマットの革新
最も注目すべき進展の一つが、コンパクションとクラスタリングに関する改善です。最新のエンジンではこれらのタスクの自動化が進んでおり、かつて専用の Spark ジョブを必要としていた手動運用のオーバーヘッドの多くが解消されつつあります。Databricks が導入し、現在より広いエコシステムの開発にも影響を与えている Liquid Clustering は特に有望です。コストのかかるフルテーブルの書き換えを実行する代わりに、バックグラウンドでインクリメンタルにデータを再クラスタリングし、書き込み増幅を最小限に抑えながらソート順を維持します。これにより、継続的な手動介入なしにデータの整理状態と高い圧縮効率が維持され、最近書き込まれたデータに対するクエリのパフォーマンスが保たれます。
設計上、Iceberg には ClickHouse がよりきめ細かいプルーニングに使用しているような、スパースなプライマリインデックスや転置インデックスのネイティブサポートはありません。一部のプロプライエタリな実装では、外部インデックスや補助インデックスのレイヤーを追加して他のアクセスパターンを高速化することでこのギャップを埋めていますが、これらは特定ベンダー独自のものであり、オープンソースの標準としては利用できません。最近では、この課題への対応を目指すオープンソースプロジェクトも登場しています。
Parquet の改善と次世代フォーマット
ファイルフォーマットのレベルでも、Parquet は半構造化データをより適切に扱えるよう進化しています。VARIANT 型の導入により、オブジェクト、配列、スカラーなどの柔軟でネストされた値を単一のカラム内で統一された構造として保存できるようになりました。これにより、スキーマの変更、オプションのフィールド、同一フィールド名に対する異なる型などが混在する JSON のような半構造化データを表現しやすくなります。このフォーマットは構造メタデータを記録するため、エンジンはネストされた各要素を完全にデコードすることなく、レコードの関連する部分に直接アクセスできます。フィールドと値はメタデータカラムと値カラムに個別にエンコードされ、メタデータには辞書エンコーディングが使用されます。これは、イベント間で共通の JSON フィールドが多く存在するケースで効果的です。また、この型ではより詳細な新しい型とともに「シュレッディング(shredding)」の概念も導入されており、クエリパフォーマンス向上のためにネストされたフィールドや繰り返しフィールドが独立したカラムへと実体化されます。これは ClickHouse の JSON 型が半構造化データ内の個々のキーへの効率的な列指向アクセスを実現している仕組みと似ています。普及はまだ初期段階ですが、この機能により不要なページ読み取りが削減され、従来 Parquet ではフィルタリングが高コストだったスパースな半構造化データに対するクエリ効率が向上する可能性があります。

Variant 型は 2 レベルの辞書エンコーディングを使用します。フィールド名はメタデータとして辞書エンコードされます。これにより、同一のフィールド名を持つオブジェクトのストレージが最適化されます。オリジナル図版のクレジット: Andrew Lamb - https://andrew.nerdnetworks.org/speaking/
もっとも、これらの改善によっても Parquet 固有の制約の一部は解決されません。ローカルファイルシステム上の大規模なシーケンシャルスキャン向けに最適化されており、きめ細かなポイント読み取りや S3 などの高レイテンシなオブジェクトストレージ向けに最適化されていない点に加え、ClickHouse などのデータベースが備えている S3 リクエストの削減・最小化を目的とした数々の最適化や、高速な読み取りのためにカラムを独立して保存する手段(ClickHouse の Wide パートなど)を欠いています。
オブザーバビリティのように、リアルタイムの検索と広範な分析スキャンが混在するワークロードでは、Parquet の行グループ構造とメタデータモデルがボトルネックになり得ます。
その結果、業界では Parquet の強みを活かしつつその弱点に対処する新しいファイルフォーマットの模索が始まっています。登場しつつある新たな選択肢には、Vortex、FastLanes、BtrBlocks、Lance などがあり、それぞれがデータの保存、圧縮、アクセスの方法を再考しています。これらの中でも、Lance は特に力強い勢いを見せています。

Lance はレイアウトとアクセスに対して異なるアプローチを採用しています。固定サイズの行グループに依存するのではなく、独立してフラッシュされるフラグメントにデータを保存することで、効率的なスキャンときめ細かなランダム読み取りの両方を可能にし、事実上行グループの概念を排除しています。各カラムはページを個別にフラッシュできるため、更新や追加の頻度が高いカラムであっても、データセットの他の部分と同期を維持する必要がなくなります。また、レンジリクエストを最適化するために、基盤となるストレージメディアに合わせてサイズを調整することも可能です。この設計は、パイプライン並列処理に依存することで同時実行性を向上させ、大きな連続ブロックを解凍することなくデータの小さなサブセットを読み取りやすくするだけでなく、グループサイズやメタデータサイズ、それらを効率化するための最適化手法を把握する必要性をなくします。
 Credit: LanceDB benefits. Original images are from https://blog.lancedb.com/lance-v2
Lance はまた、Parquet の固定的なエンコーディングシステムをプラグインベースのアーキテクチャへと置き換えています。エンコーディングと統計情報は拡張機能として定義され、データは単なるバイト列として保存されプラグインによってエンコードおよびデコードされます。これにより、ファイルリーダーやフォーマット仕様を変更することなく、新しい(デ)コーダーを書くだけで、新たな圧縮方式やインデックス作成戦略を簡単に追加できます。辞書やスキップテーブルなどのメタデータもカラムレベルまたはページレベルで保存でき、前者はポイントルックアップクエリにより適していることがよくあります。
 Credit: LanceDB benefits. Original images are from https://blog.lancedb.com/lance-v2
Lance が最終的にオブザーバビリティ向けのフォーマットになるかどうかは分かりませんが、他の新しいアプローチとともにいくつかの有望なアイデアをもたらしています。これらのフォーマットはすべてライフサイクルの初期段階にあり、本番環境のオブザーバビリティパイプラインの規模や複雑さで十分に検証されたものはありません。重要なのは、クエリエンジンがオープンで特定のフォーマットに依存しない状態を維持し、ストレージの革新が独立して進むことを可能にしながら、最も優れたフォーマットがその技術的メリットに基づいて成功できるようにすることです。
ClickHouse とオープンテーブルフォーマット
私たちは、オープンテーブルフォーマットが最終的にオープンでコスト効率の高いオブザーバビリティアーキテクチャの中心的なコンポーネントとなり、大規模なテレメトリデータセットの長期保存を担うようになると確信しています。ClickHouse はこの移行をサポートする上で極めて有利な位置にあります。オブザーバビリティデータの保存とクエリにおいてすでに大規模な実績を持つデータベースとして、高速な取り込み、効率的な圧縮、低レイテンシの分析といった性能特性を兼ね備えており、オープンテーブルフォーマットとの統合に自然に適合します。
ClickHouse は長年にわたり Parquet ファイルのクエリをサポートしており、Parquet リーダーの継続的な改善を通じて性能面をリードし続けています。最近のアップデートでは行グループ内のカラム間の並列化が導入され、同一行グループ内の異なるカラムを同時に読み取れるようになりました。このアプローチは最新のマルチコアシステムをフル活用し、ワイドテーブルでのスループットを大幅に向上させます。また、この新しいリーダーは I/O リクエストをマージし、小さな隣接する読み取りをより大きく効率的な操作へとまとめます。これは高レイテンシなオブジェクトストレージにおいて特に効果的であり、ClickHouse は予想されるバイト範囲を事前に登録し、より少ない回数の大きな読み取りリクエストを発行することで、シーケンシャルスループットを最大化できます。

Clickbench はテストデータセットに対する分析データベースの性能を評価する独立したベンチマークです。この図では Parquet に対する性能のみを示しています。
Parquet 自体にとどまらず、ClickHouse はテーブルカタログやオープンテーブルフォーマットとの統合を拡大してきました。現在では、AWS Glue、Unity Catalog、LakeKeeper、Nessie などのカタログを介して管理されているデータをクエリし、通常のテーブルを持つ ClickHouse データベースとして直接公開できます。
CREATE DATABASE unity
ENGINE = DataLakeCatalog('https://.cloud.databricks.com/api/2.1/unity-catalog/iceberg')
SETTINGS catalog_type = 'rest', catalog_credential = ':', warehouse = 'workspace',
oauth_server_uri = 'https://.cloud.databricks.com/oidc/v1/token', auth_scope = 'all-apis,sql'Iceberg や Delta Lake のテーブルを ClickHouse 内の「単なる通常のテーブル」として公開することで、ClickStack などの既存の ClickHouse オブザーバビリティツールが追加設定なしでそのまま動作します。
最近のリリースでは Iceberg と Delta Lake の書き込みサポートも導入され、統計情報やパーティションを使用したプルーニング、同時実行読み取り、タイムトラベル、DELETE 操作など、対応機能の範囲が広がっています。これにより、ClickHouse はオープンテーブルフォーマットに対するクエリエンジンとしてもライターとしても機能し、オープンで相互運用可能なフォーマットで保存されたデータにデータベースクラスのパフォーマンスをもたらします。
実際のオブザーバビリティ運用環境では、デュアルライト(二重書き込み)アーキテクチャを採用しているユーザーもいます。オブザーバビリティデータは、ホットでリアルタイムな分析のために ClickHouse の MergeTree テーブルに書き込まれると同時に、コールドな長期保持のためにオープンテーブルフォーマットにも書き込まれます。
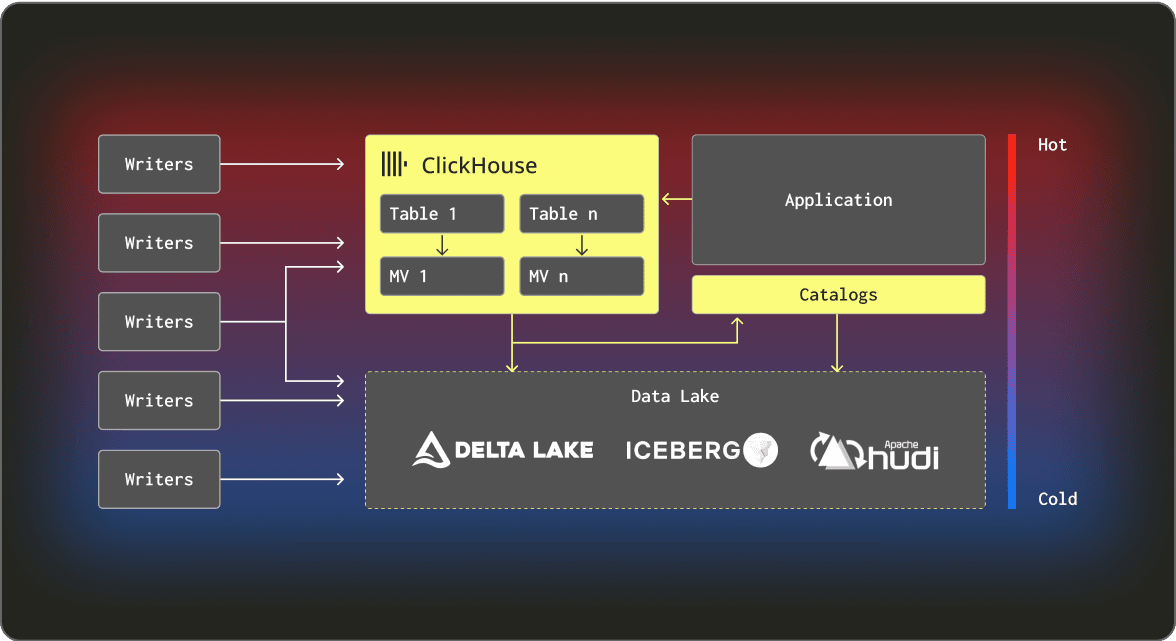
MergeTree エンジンは、レイクハウスやオープンテーブルフォーマットの強みの多くを兼ね備えつつ、オブザーバビリティのユースケースにおける課題を解決し簡素化します。データの局所性を維持するための自動バックグラウンドマージ、高速な読み取りのためのスパースインデックス、JSON をサポートする書き込み時スキーマ適用(schema-on-write)、ライフサイクル管理などの機能を単一のシステム内に統合しています。これにより、ユーザーはコンパクション、メタデータ、ファイル最適化を管理する必要がなくなります。その列指向構造は優れた圧縮を提供し、S3 のネイティブサポートによって低コストな長期保持が可能になります。同時に、挿入と読み取りの間の組み込みの分離により、クエリパフォーマンスに影響を与えることなく高スループットの取り込みが保証されます。
一方で、オープンテーブルフォーマットはオブジェクトストレージの耐久性とコスト面のメリットを提供します。Netflix などの組織で使用されているこのデュアルライトパターンは依然として人気がありますが、データを 2 回書き込み別々に管理しなければならないという非効率性をもたらします。
将来を見据えると、ClickHouse のビジョンはオープンテーブルフォーマットとデータベーステーブルを単一の統合モデルへと収束させることです。この将来像では、オープンフォーマットで保存されたテーブルが他の ClickHouse テーブルと同じように動作し、ユーザーがオブザーバビリティデータの保存に ClickHouse を導入する際に多用しているマテリアライズドビューなどの機能の恩恵を受けることができます。
ユーザーはオープンデータフォーマットの相互運用性と、データベースエンジンのパフォーマンスおよび管理しやすさの両方を手に入れることができます。これはデータベースの世界とレイクハウスの世界の融合を意味します。ストレージフォーマットは実装の詳細となり、ClickHouse が水面下でパフォーマンスとレイアウトを透過的に管理します。大規模なオブザーバビリティワークロードにおいて、このモデルはオープンでコスト効率の高いストレージと、PB スケールでリアルタイム分析を提供する ClickHouse の確かな実績という、双方の長所を兼ね備えた環境を約束します。
まとめ
要約すると、オープンテーブルフォーマットはオブザーバビリティデータの保存とアクセスのあり方において魅力的な進化を示しています。オープンでスケーラブルであり、さまざまなクエリエンジン間での相互運用性がますます高まっています。パフォーマンス、メタデータ管理、運用のシンプルさには依然として課題が残るものの、ファイルフォーマット、テーブル標準、クエリエンジンにわたるイノベーションは急速に進んでいます。これらのエコシステムが成熟するにつれて、ClickHouse のようなデータベースは、オブジェクトストレージの圧倒的なスケーラビリティとオブザーバビリティが要求する低レイテンシ性能との間のギャップを埋める上で有利な立場にあります。データベースとオープンテーブルフォーマットの融合は、最終的にユーザーへ双方の長所をもたらすでしょう。それは、データレイクのオープン性とコスト効率、そして専用の分析エンジンが持つスピード、信頼性、シンプルさです。
レイクハウスとオブザーバビリティにおける最近の最も注目すべき動向の一つが、Cloudflare による R2 オブジェクトストレージ上のデータをクエリするための SQL サポートの発表です。Cloudflare はこれを拡張して Logpush と統合し、ユーザーが自社プラットフォーム内でログをネイティブに変換、保存、クエリできるようにすることを計画しています。