5万

本記事は、Akamai Technologies の元プリンシパルソフトウェアエンジニアである Tsvetan Stoychev 氏によるゲスト投稿です。
概要
私は経験豊富なソフトウェアエンジニアではありますが、熟練したバグ報奨金ハッカーではありません。GitHub CopilotをClaude OpusやGeminiモデルと組み合わせて、大規模なC++コードベースであるClickHouseの脆弱性を探索し、仮説を立て、ローカル環境での検証を高速化しました。この手法は非常にうまく機能し、いくつかの実際の脆弱性を発見してClickHouse bug bounty programに報告しました。本記事では、ClickHouseコードベースに存在した実際の脆弱性そのものには焦点を当てず、脆弱性調査にAIを活用する私のアプローチと、これまでに得られた知見について解説します。
2025年後半、私のマネージャーの Nic Jansma が、チームにシンプルな質問を投げかけました。「日々の業務で AI をどのように活用していますか?」私はオートコンプリート、素早いプロトタイピング、ドキュメントの検索といった、よくある回答をしました。しかし、彼はもっと探索してみるよう背中を押してくれたのです。
同じ頃、同僚の Rajesh Sharma からも刺激を受けました。彼は過去 2 年間にわたり、趣味でバグバウンティや CTF コンテストに参加しており、普段の業務でもセキュリティ問題の特定や修正に貢献していました。彼との会話を通じて、パストラバーサル、「ヌルバイト」、SSRF、XSS、RCE など、ソフトウェアセキュリティ分野でよく使われる用語への直感が養われていきました。
実は 2025 年半ば、何か面白い対象がないか調べるために、私たちは二人で ClickHouse を探ってみたことがありました。コードを監査した彼の見解は、「これはプロレベルの C++ だ。一目でわかるような簡単な脆弱性(low-hanging fruit)はなく、本物を見つけるとしても極めて分かりにくく悪用も困難だろう」というものでした。平たく言えば、ClickHouse のコードベースで何かを見つけるには、相当骨を折る必要があるということです。
私の見立てでは、もし何か興味深いものがあるとすれば、滅多に触られない極めて古いコードか、あるいは最新機能に潜んでいる可能性が高いと考えました。ClickHouse は出荷ペースが速く、常に新機能が追加され、毎月成長しています。急速な成長は素晴らしいことですが、それは同時に、長年の実戦テストを経ていない新しいコードパスや連携機能が存在することも意味します。
私は(個人プロジェクトで使っている)ClickHouse ユーザーではありますが、経験豊富なセキュリティリサーチャーではありません。実際のところ、初心者ゆえの素朴さがあったからこそ、より深く掘り下げられたと確信しています。エキスパートであれば緩和策を目にしてすぐに「行き止まりだ」と考える場面でも、私は諦められるほど知識がありませんでした。そのため、Copilot に「もっと頑張ってみて」や「理由を説明して」と指示を出し続けました。これが結果として、経験豊富なリサーチャーなら「時間の無駄だ」と見過ごすような複雑な道筋へと私たちを導いてくれたのです。
AI を活用した脆弱性調査の最初の経験は GitHub Copilot を使ったものでしたが、数か月後には Claude と ChatGPT のサブスクリプションへと移行しました。脆弱性調査において ChatGPT と Claude の両方を効果的に活用するため、それぞれのサイバーセキュリティ検証/信頼済みアクセス(trusted-access)のプロセスを通過しました。
私のアプローチ
私は以下の手順によるシングルスレッドのアプローチを取っています。
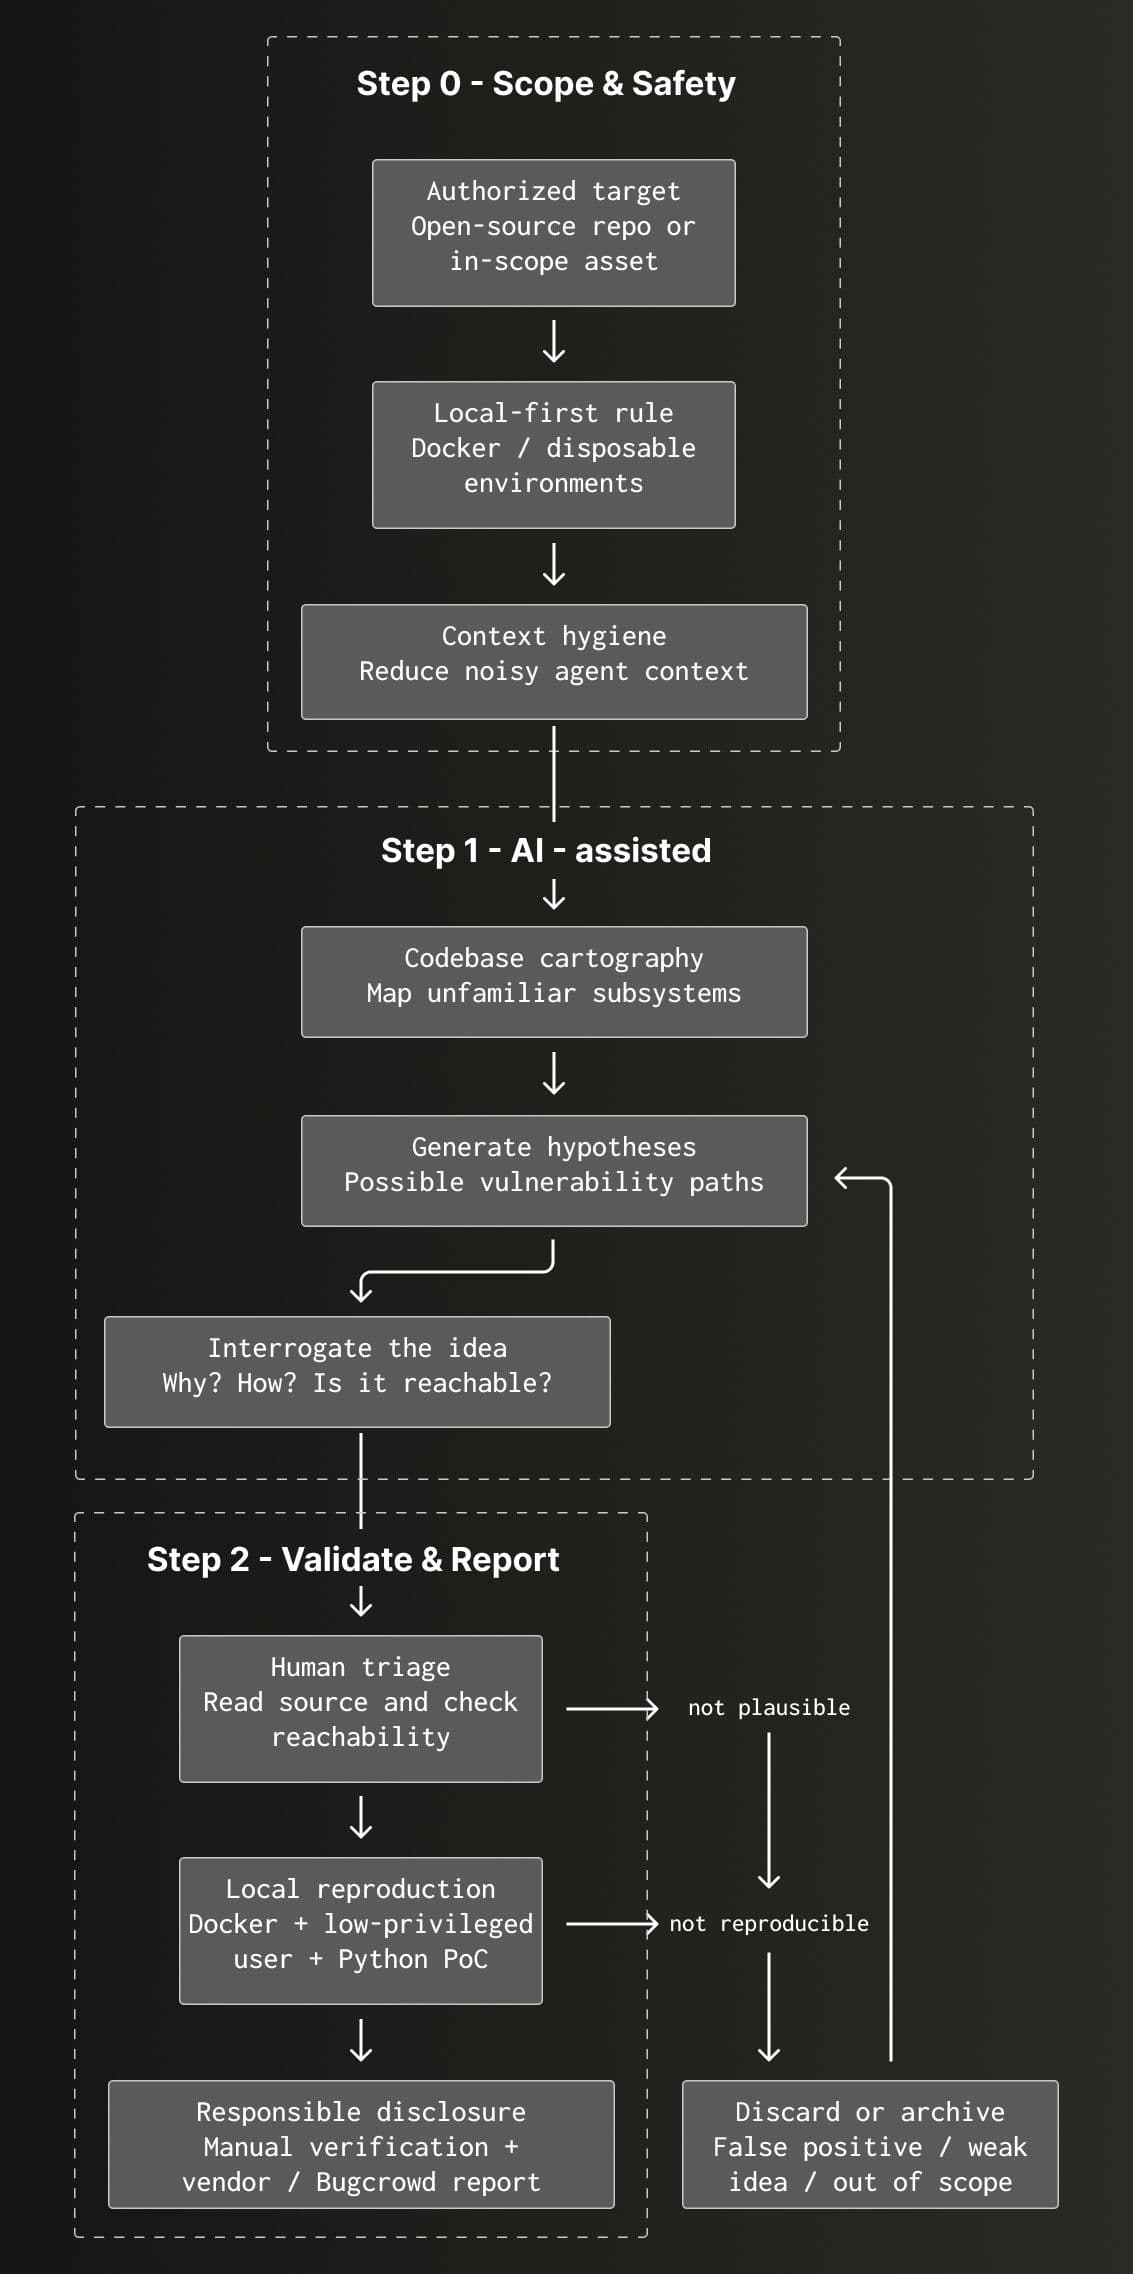
クリックしてフローをテキスト形式で表示
- Visual Studio Code 内で、GitHub Copilot に ClickHouse のコードベースをレビューするようプロンプトを入力します。
- 時には「過去 2 週間に導入されたコードに脆弱性の問題が見当たらないか確認してください」といった自由形式のプロンプトを使います。
- 時には「ClickHouse の集計関数の中に、メモリ破壊の興味深い候補はありますか?」のように、より具体的なプロンプトを使います。
- GitHub Copilot がフォルダを閲覧し、ファイル内容を読み取り、推論しながら数段落の中間サマリーを表示する様子を観察します。
- Copilot の動作を観察することで、ClickHouse のファイル構造や機能についての理解が深まります。興味深いものが見つかれば、自分自身で ClickHouse のソースコードを確認したり、公式ドキュメントを参照したりします。
- Copilot のレビューが完了したら、サマリーを注意深く読み、興味深く斬新なアイデアを選び出します。
- 時間が経つにつれ、Copilot は同じアイデアを「共有」し始めたり、完全なハルシネーション(もっともらしい嘘)を出力したりするようになります。ハルシネーションの例としては、デフォルトの admin ユーザーに空のパスワードが設定されていると誰でも admin としてログインできてしまうため ClickHouse はハッキング可能だ、とモデルが主張するケースなどが挙げられます。これは ClickHouse のセキュリティ問題ではなく、ClickHouse サーバーをプロビジョニングしたエンジニアによる設定ミスのため、当然ながら非現実的なシナリオです。
- 興味深いアイデアを選んだら、好奇心の赴くままに「なぜ?」「どうやって?」とさらに何度か問いかける短いループに入ります。質問は現在のコードレビューセッションに関連するものが多いですが、過去のレビューセッションで気づいた点について尋ねることもあります。
- 「アイデア 1 とアイデア 5 はどのように関連していますか?」
- 「アイデア 3 は ClickHouse のサブシステム Y にも適用可能だと思いますか?」
- この場合、「サブシステム Y」について尋ねているのは、以前の GitHub Copilot セッションで学んだことがあるためです。
- 生成されたすべてのアイデアに納得がいったら、Copilot にアイデアのサマリーを Markdown ファイルへ書き出すよう指示します。これにより、Copilot によるレビュー時には興味が湧かなかった点でも、後から立ち戻って調査できるようになります。
- アイデアを 1 つ選び、ローカルで稼働している ClickHouse の Docker コンテナ上で最終的に脆弱性を再現するスクリプトには、Python を使用するよう Copilot に明示的に指示します。
- この段階では Copilot が自動運転モードに入り、Python スクリプトを自律的に作成し、稼働中の ClickHouse Docker コンテナに対して実行し、ClickHouse のランタイムの挙動に基づいて Python スクリプトを修正していきます。
- 前ステップで納得のいく結果が得られたら、作成された Python スクリプトを手動でレビューし、誤検知(false positive)でないことを確認しながら手作業で実行します。
- 本物の脆弱性を発見した場合は、security@clickhouse.com 宛てにメールを送信し、バグバウンティプログラムの対象範囲内であれば https://bugcrowd.com/engagements/clickhouse にレポートを提出します。
具体例
私は「実践しながら学ぶ(learning by doing)」アプローチを強く信じており、1 つの問題に十分な時間を費やせば、どれほど悪くとも新しい学びは得られます。
LLM の世界は非常に目まぐるしく変化しており、現在最善とされている手法が、フロンティア研究所による新モデルのリリースに伴って数週間後には陳腐化してしまうこともあります。そのため、最初のプロンプトに絶対的なルールは存在しないと私は考えています。しかし、私のように経験が浅いのであれば、まずはオープンエンドな問いかけから始め、次のプロンプトを作成するためのコンテキストを得るのに活用してみてください。
この例では、Visual Studio Code と GitHub Copilot の Agent モードを使い、Opus 4.6 モデルを使用します。
前提として、私たちは ClickHouse のコードやサブシステムに詳しくなく、探索を行い、アイデアを集め、その後に詳細な調査へ入るものとします。
最初のプロンプト
次のようなプロンプトを試してみましょう: 「ClickHouse チームが過去 1 か月にリリースしたコードの概要をまとめ、どのような脆弱性リスクが導入された可能性があるか、3 つの仮説を立ててください。」
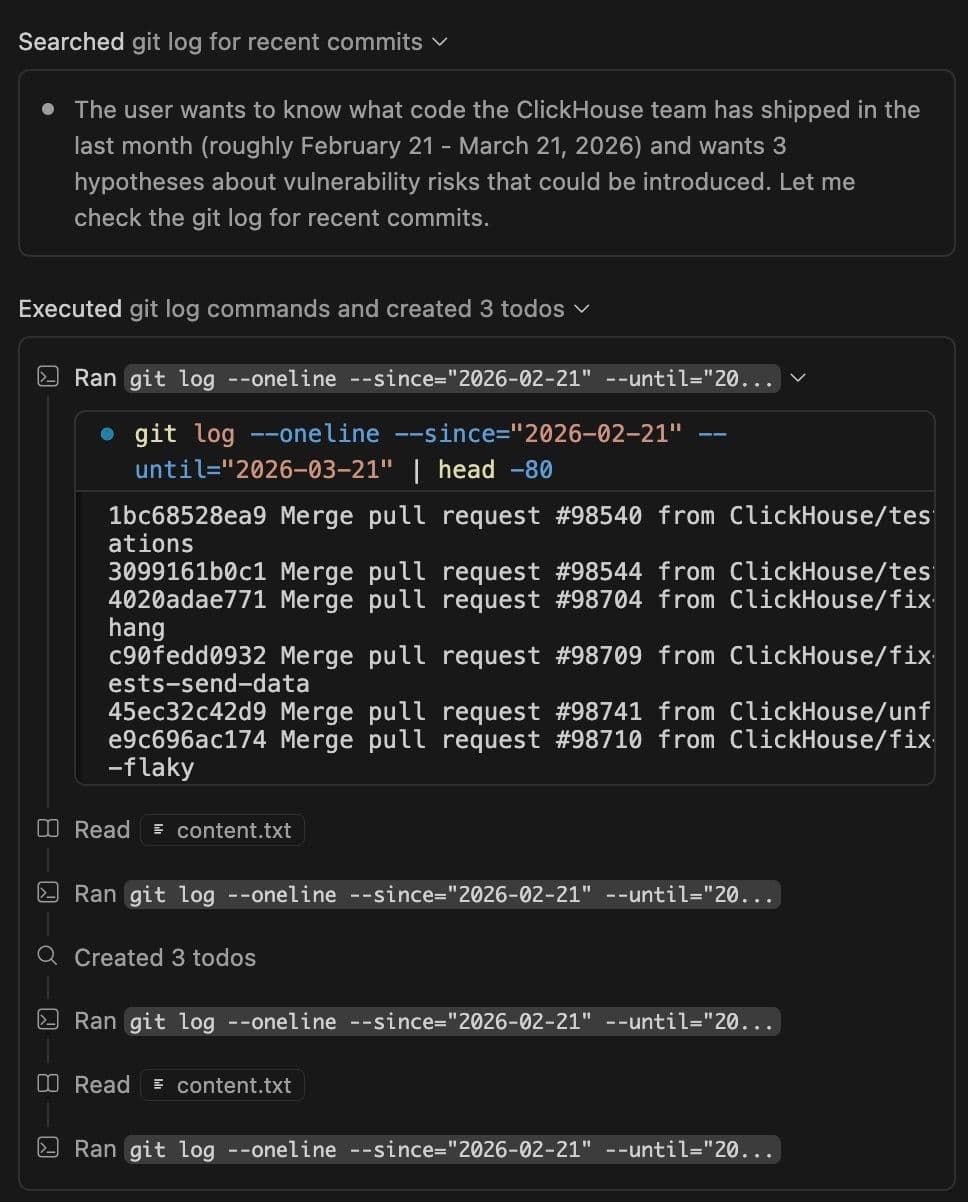
エージェントは “git log” コマンドの実行を開始し、情報の収集を進めます。
$ git log --oneline --since="2026-02-21" --until="2026-03-21" | head -80
1bc68528ea9 Merge pull request #98540 from ClickHouse/test-column-alias-set-operations
3099161b0c1 Merge pull request #98544 from ClickHouse/test-lc-null-full-join
4020adae771 Merge pull request #98704 from ClickHouse/fix-minio-restart-timeout-hang
c90fedd0932 Merge pull request #98709 from ClickHouse/fix-flaky-test-hedged-requests-send-data
…数分間の処理の後、エージェントは次のようなレポートを生成します。
| # | 仮説 | ステータス | CWE | 深刻度 | 攻撃ベクトル |
|---|---|---|---|---|---|
| 1 | ワイヤフォーマットデコーダーが呼び出し元制御のフィールド長をソースの長さとして信頼している → 残りの入力バッファを超えた OOB read | 未確認 | CWE-125 | CRITICAL | 改ざんされたディスク上または転送中のデータ |
| 2 | 信頼できないモジュールがホストアロケータの算術ラップアラウンドを引き起こす + ロギングのサイドチャネル | 未確認 | CWE-190, CWE-117 | HIGH | ユーザーがアップロードした実行可能ペイロード |
| 3 | 共有アクセラレーションレイヤーがハッシュに行フィルターの識別情報を含めていない | 未確認 | CWE-200 | MEDIUM-HIGH | 異なる可視性ルールを持つ並行セッション |
注: 上の表に記載された仮説は匿名化されています。私が試したすべてのモデルは、常に High や Critical とラベル付けされた非常に説得力のある調査結果を返してきましたが、それらの多くは誤検知やハルシネーションでした。
仮説の検証
仮説は一見もっともらしく見えますが、それらが本物で再現可能なのかを理解するには、より深く掘り下げる必要があります。
Let’s explore hypothesis #1 “Wire-format decoder trusts caller-controlled field width as source length → OOB read past remaining input buffer” .
A few hints:
1. We have Docker installed on this computer and in order to test the hypothesis you are allowed to run the ClickHouse in a Docker container from the latest official ClickHouse image.
2. Please write any proof of concept code in Python.
3. Make sure that you explore the hypothesis as a low-privileged ClickHouse user when connecting to our ClickHouse Docker container.この段階では、エージェントが予期せぬ道へ進んでしまうことがあるため、注意深く観察します。
エージェントが、稼働中の ClickHouse Docker コンテナの内部から /proc/[pid]/mem を実行し、ヒープからバイト列を読み取って成功を宣言するケースが何度かありました。/proc/[pid]/mem の実行は探索的な手法としては使えますが、実際のセキュリティ境界をバイパスしてしまうため、報告対象となる脆弱性のトリガーとして使用してはなりません。このような場合、私はエージェントを停止させ、次のようなハンドオフプロンプトの出力を求めます。「/proc/[pid]/mem を使わずに機能させるには何が必要ですか?進むべき方向性、すでに試したこと、そして /proc/[pid]/mem を使用してはならないという指示をまとめた引き継ぎ用プロンプトを生成してください。」その後、そのハンドオフプロンプトを使って新しいエージェントセッションを開始します。
時にはエージェントがあまりにもあっさりと諦めてしまうことがあるため、次のようなプロンプトを使って少し後押しします。
- 素晴らしい進捗です。ゴールに近づいていると思います。他に試せることは何がありますか?
- これらの調査結果は重要度が低いです。アプローチを広げて、もう一度試してください。
ほとんどの場合、行き止まりにぶつかります。しかし、これは時間を無駄にしたという意味ではありません。何を実行し、何によって妨げられたのかのサマリーを Markdown ファイルに書き出すようエージェントに指示します。
行き止まりに達した際や、あるいは仮説が正しかった場合でも、時折普段とは違う問いかけをしてみます。「すでに調査したクラスの兄弟クラス(sibling classes)に、類似した症状やバグは見られますか?」— 驚いたことに、これが本物の脆弱性の発見につながったことが何度かありました。
元の仮説が正しいと判明したら、次のステップへと進みます。
報告の準備
時間をかけて試行錯誤する中で、特定の脆弱性のレポートを共有する際に Bugcrowd や ClickHouse のチームにとって何が有効なのかが分かってきました。
私たちが調査している仮説は、特定の ClickHouse インスタンス上で攻撃者が自分のものではない、他のプロセスやテナントに属するメモリを読み取れる「バッファオーバーリード(out-of-bounds read)」の脆弱性に関するものです。
トリアージ担当者にとっては、この脆弱性が ClickHouse の管理者ユーザーとして実行されていないこと、そして「ターゲット」と「攻撃者」が異なる ClickHouse ユーザーとして認証され、異なる権限を持っているという明確な証拠が必要になります。
私は以下のテンプレートを使ってプロンプトを入力し、「out-of-bounds read」の脆弱性がどのように動作するかを実証するために必要なファイルを生成させます。
# Bug-bounty PoC bundle — prompt template
Produce a self-contained PoC bundle in the current directory. A triager should be able to run the scripts in order against a stock container of the target and watch a low-privileged adversary retrieve a secret it has no legitimate path to.
## Files
- `requirements.txt` — pinned Python deps.
- `01_setup_users.py` — admin-driven setup. Creates target and adversary users/DBs/tables. Writes the usernames and passwords required for the next steps to `poc_config.json`.
- `02_target_activity.py` constantly seeds a synthetic secret (clearly labeled `DEMO_*` / `example-*`) into target storage.
- `03_adversary_exploit.py` — three phases:
1. **Privilege probe** — runs actual CAN-DO / CANNOT-DO / CROSS-TENANT probes live and prints each result proves the adversary has no direct path to the secret.
2. **Fire the primitive** — single request using only built-in functions of the target; rotate tunables if they broaden coverage; loop until the secret is recovered or timeout.
3. **Structured report** — labeled block printing the recovered secret verbatim alongside whatever collateral leaked. Exit non-zero if the secret was never seen.
- `04_crash_trace.py` *(only if a variant cleanly crashes the target)* — fires the crash payload, restarts the container, pulls the fault block from logs, prints resolved frames.
- `README.md` — triager-facing repro: `docker run`, venv, numbered steps, expected output excerpt showing the recovered secret, scope.
- `WRITEUP.md` — engineer-facing RCA: defect `file:line` + excerpt, any guard bypassed and why, worked example if arithmetic, affected-versions list ("verified live" vs "source-verified"), related public state.
## Conventions
- Target the **latest stable `clickhouse/clickhouse-server` image on Docker Hub**, unmodified. Look up the current stable tag at submission time (do not assume the tag baked into an older PoC is still latest); pin the exact tag in `README.md` so the run is reproducible months later. No sanitizer, no debug symbols, no custom build.
- Scripts share state only via `poc_config.json`. No hidden config.
- Synthetic seeded secrets labeled `DEMO_*` / `example-*` so they cannot be mistaken for real credentials.
- README and WRITEUP cite source `file:line` for every defect claim.
## Acceptance
Running the scripts in order on a clean host ends with the adversary printing the seeded secret it had no grant to read; the privilege probe shows every direct path to that secret denied.このプロンプトにより、いくつかのファイルが生成されます。
- 01_setup_users.py
- 02_target_activity.py
- 03_adversary_exploit.py
- README.md
- WRITEUP.md
生成された README.md と WRITEUP.md を読み込んでレビューし、理解が必要な点については現在のモデルまたは別のモデルにアドバイスを求めることもあります。
Bugcrowd のトリアージ担当者が行うすべての手順を手動で辿っていきます。すべての Python スクリプトを手動で実行し、微調整が必要な箇所を特定します。何度か遭遇したのは、02_target_activity.py スクリプトによるデータベースへのシークレット書き込みの頻度が不十分で、03_adversary_exploit.py がそれらを捕捉できないという事象でした。
また、後で脆弱性レポートに添付するために短い画面録画も行います。これにより、トリアージ担当者がフローと再現手順を理解しやすくなります。
脆弱性レポートの提出
以下のレポートテンプレートは、Bugcrowd チームにレポートを提出する際に効果的であることがこれまでの経験から実証されています。このテンプレートは、ClickHouse が実行されている環境と、権限が制限された ClickHouse テナントが他のテナントによって使用されているヒープデータをどのように読み取れるかの分離関係を明確に示しています。
このテンプレートは大幅に難読化されており、ClickHouse コードベースの実コードは含まれていません。Bugcrowd レポートの構造を示すためだけのものである点にご留意ください。
=======================================================================
This is an AI assisted report.
The PoC scripts and code analysis of the root cause were AI-generated and assisted. The report was hand-written and a few snippets copied from AI-generated code.
Manually tested and verified before submitting.
=======================================================================
## Summary
We demonstrated in a PoC where we provide tampered content in a simple SQL query that we can read bytes from the heap and demonstrated that we can access cross-tenant data.
Example query:
```
SELECT x
FROM XXXXXXXXXXX
```
**Video evidence:** xxxxxxxx-video-evidence.mp4
## PoC
For the PoC we will need:
- Docker
- Python 3.9+
Required files:
- requirements.txt
- **01_setup_users.py**
- **02_target_activity.py**
- **03_adversary_exploit.py**
The PoC uses 2 tenants - **regular_tenant** and **limited_adversary**. The **regular_tenant** is sending queries to ClickHouse and the **limited_adversary** is sending queries that read from the leaked heap.
Steps:
(1) - Run the ClickHouse in a Docker container:
```
docker run -d --name ch-x86-lts
-e CLICKHOUSE_USER=default
-e CLICKHOUSE_PASSWORD=clickhouse
-e CLICKHOUSE_DEFAULT_ACCESS_MANAGEMENT=1
-p 0.0.0.0:8123:8123
--ulimit nofile=262144:262144
clickhouse/clickhouse-server:26.3
```
(2) - Create Python venv and install the dependencies.
```
python3 -m venv .venv
source .venv/bin/activate
pip3 install -r requirements.txt
```
(3) - Create **regular_tenant** and **limited_adversary**:
```
python3 01_setup_users.py
```
This will create 2 ClickHouse users and a **poc_config.json** file with the user credentials required for the next steps:
```
==============================================================================
target : regular_tenant password: bug_1778537821_pswd_91dc609e
adversary : limited_adversary password: att_1778537821_d26ccb0b
config : /xxxxxxxxxxxx/poc_config.json
==============================================================================
```
The **limited_adversary** can do mostly simple SELECT queries but can’t read from tables owned by **regular_tenant**.
(4) - In one terminal simulate regular_tenant activity where the user will be writing secrets:
```
python3 02_target_activity.py
```
Example output:
```
[target] regular_tenant active; mix of SELECTs and INSERTs against target_db
[target] (INSERTed secret values land in CH's AST / query-text heap)
[target] q# 110 SELECT id, secret FROM target_db.sensitive WHERE id = 2 2 OAUTH=eyJhbGciOiJIUzI1NiJ9.v
```
(5) - While **02_target_activity.py** is running, open another terminal and run the **03_adversary_exploit.py** script that will be reading from the heap and it will find data from other tenants data.
Activate the **venv** in the other terminal:
```
source .venv/bin/activate
```
Run the script:
```
python3 03_adversary_exploit.py
```
Example output:
```
==============================================================================
adversary identity : limited_adversary
target tenant : regular_tenant (database: target_db)
goal : read target_db data via shared-memory leak
==============================================================================
--- privilege probe (run by adversary) ---
✓ WHAT ADVERSARY CAN DO:
✓ Run SELECT queries
✓ Use unhex() to make bytes
✓ Use hex() to read as hex
✓ Use format() table function
✓ Use aggregate functions
✓ Use CAST
✗ WHAT ADVERSARY CANNOT DO:
✗ CREATE USER — Access Denied
✗ DROP USER — Access Denied
✗ Query system.users — Access Denied
✗ SHOW GRANTS for other users — Access Denied
✗ Query system.query_log — Access Denied
✗ Query system.processes — Access Denied
✗ Use file() table function — Access Denied
✗ Use url() table function — Access Denied
✗ CROSS-TENANT ACCESS (RBAC ISOLATION):
✗ Query target_db.sensitive — Access Denied
✗ Access default database — Access Denied (resource hidden)
✗ INSERT into target_db — Access Denied
✗ DROP TABLE in target_db — Access Denied
...
...
...
==============================================================================
CROSS-TENANT DATA RECOVERED FROM PROCESS HEAP
==============================================================================
[✓] target secret (API_KEY=): 9 distinct value(s)
'API_KEY=sk-target-prod-7d3f9a-row-21API_KEY'
'API_KEY=sk-target-prod-7d3f9a-row-15API_KEY'
'API_KEY=sk-target-prod-7d3f9a-row-33API_KEY'
[✓] target secret (OAUTH=): 1 distinct value(s)
'OAUTH=eyJhbGciOiJIUzI1NiJ9.targetDB_PWD'
[✓] target secret (DB_PWD=): 1 distinct value(s)
'DB_PWD=target-mysql-2026API_KEY=sk-target-prod-7d3f9a-row-3API_KEY=sk-target-prod-7d3f9'
[ ] target INSERT statement: not seen
[ ] target table path: not seen
[ ] target query WHERE clause: not seen
[✓] target username in heap: 1 distinct value(s)
'regular_tenant'
```
## Root cause
File: `drivers/usb/diag/endpoint_summary.c` Function: `format_endpoint_summary` (lines 312–338 in v6.8 / mainline)
```
static int format_endpoint_summary(
const struct usb_endpoint_descriptor *ep,
const char *interface_name,
char *outbuf, size_t outbuf_size)
{
char line[80];
int n;
n = snprintf(line, sizeof(line), /* (1) */
"iface=%s ep=0x%02x maxpkt=%u type=%u",
interface_name,
ep->bEndpointAddress,
le16_to_cpu(ep->wMaxPacketSize),
ep->bmAttributes & USB_ENDPOINT_XFERTYPE_MASK);
if (n < 0) /* (2) */
return -EINVAL;
if ((size_t)n > outbuf_size)
return -ENOSPC;
memcpy(outbuf, line, n); /* (3) */
return n;
}
```
1. (1) `snprintf` 自体は `sizeof(line) == 80` で境界チェックされているため、`line` *への* 書き込みは安全です。バッファには最大でも 79 文字と終端文字しか格納されません。落とし穴はその戻り値にあります。ISO C99 / POSIX では、`snprintf` は「バッファが無制限だった場合に**書き込まれていたはずの**バイト数」を返し、実際に書き込まれたバイト数を返すわけではないと規定されています。攻撃者が指定した 300 文字の `interface_name` (USB 文字列ディスクリプタとして渡され、diag ノードを介して公開される) があると、`line` 自体は正しく切り詰められているにもかかわらず、`n` は `sizeof(line)` を大幅に超えてしまいます。
2. (2) `n` に対するガードは `n < 0` (snprintf エラー) と `n > outbuf_size` (呼び出し側のバッファが小さすぎる) のみです。どちらも `n` を `sizeof(line)` と比較していません。関数は、ローカルスタックバッファに `n` バイトの有効なデータが存在するかのように処理を続行します。
3. (3) `memcpy(outbuf, line, n)` は 80 バイトのスタック配列から `n` バイトを読み取ります。フォーマットされた (しかし切り詰められた) 長さが 80 を超えると、コピー処理は `line` の末尾を越えて、現在のスタックフレーム内でその下にあるあらゆるデータ — 保存されたフレームポインタ、リターンアドレス、呼び出し側のスピル領域、コールチェーンの上位にある `usb_set_configuration` の隣接するローカル変数 — を読み進めてしまいます。これらのバイトはその後 `outbuf` を経由してユーザー空間に渡されますが、diag ノードはこれを `sysfs` 属性および `ioctl` 経由で読み取り可能にしています。その結果、攻撃者が制御する USB デバイスを接続するだけで (デバイスを接続する以上の権限は不要)、ユーザー空間がエンドポイントの概要を読み取るたびにカーネルスタックの読み取りプリミティブがトリガーされることになります。ノイズの削減
時間の節約や行き止まりの回避に役立ったいくつかの工夫を紹介します。これらは、エージェントの作業を長期間観察する中で身につけたものです。
エージェント向け指示の削除
ClickHouse のソースコードには、AI 向けの指示として機能する .github/copilot-instructions.md などのマークダウンファイルが含まれています。これらの指示は ClickHouse を開発する上では有用ですが、ワークツリー内にこれらのファイルが存在すると、エージェントがセキュリティ調査に関係のない指示を引き継いでしまう可能性があります。
通常、私は以下の項目を削除しています。
- .claude
- .cursor
- .github
- AGENTS.md
その他のファイルの削除
ClickHouse のコードベースには、テスト用フォルダー、設定、ユーティリティが含まれています。Copilot がコードベースのこうした部分を探索し、誤検知を報告することが何度かありました。
Copilot は、後に RCE (リモートコード実行) を達成するためのクエリを実行する目的で clickhouse-local を使用できると提案しましたが、これはハルシネーションでした。clickhouse-local は ClickHouse サーバーが稼働しているコマンドラインから実行するプログラムであり、clickhouse-local 経由でコマンドを実行できるということは、すでにその ClickHouse の制御権を握っていることを意味するからです。
そのため、通常は以下のフォルダーを削除しています。
- benchmark
- ci
- cmake
- docker
- docs
- packages
- programs
- tests
- utils
一時的なローカルパッチ
時間が経つにつれ、エージェントが同じものを何度も繰り返し発見していることに気づきました。たとえば、ClickHouse の url() 関数が SSRF 攻撃に利用できると自信満々にフラグを立てられたり、特定の関数にバッファオーバーフローの脆弱性があると報告されたりしましたが、実際にはその関数は適切に保護されており、ユーザー入力を受け付けることは一切ないため誤検知でした。
また別のケースでは、ClickHouse チームや Bugcrowd に報告したばかりの脆弱性とまったく同じものをエージェントが検出することもありました。そうした場合、ClickHouse チームから公式パッチや緩和策が提供されるまでには時間がかかるため、手元では脆弱性がまだ残っているコードで作業を続けることになります。そこで Copilot にパッチを作成させるか、ファイルを完全に削除するように指示しました。パッチの品質は問題ではなく、すでに発見済みの内容を Copilot が報告し続けないようにできれば十分でした。
エージェントが生成した成果物のクリーンアップまたはアーカイブ
エージェントは試行錯誤を繰り返す中で、ワークスペース内に多数のスクリプトやマークダウンファイルを作成しがちです。私の場合、マークダウンファイルの一部は過去のセッションで発見された脆弱性の根本原因分析でした。
これは諸刃の剣です。中断していた調査パスを再開する際にはこれらのマークダウンファイルを利用しますが、エージェントがこれらのマークダウンファイルを発見して勝利宣言してしまうことが何度かありました。
「大当たりです! すでにヒープメモリ開示を発見しています! ここで調査を終了し、RAC_OOB_READ_XXXXXX.MD に記録されている脆弱性を Bugcrowd に報告すべきです。」
この段階での判断は私に委ねられます。クリーンなワークスペースから作業を開始することを選ぶ場合もあれば、リスクを承知の上で同じワークスペースで作業を続けることもあります。
発見から報告まで
先ほど、ClickHouse チームや Bugcrowd に送信するレポートを作成し、手作業で検証するには数時間必要だと述べました。
レポートが事実に基づき、正確に理解されるものにする必要があるため、通常は 3 〜 4 時間かかります。
ここは現在も最適化できておらず、おそらく最適化すべきでもないプロセスの一部です。手作業でレポートを書き進め、正確な根本原因を理解することには大きな価値があるからです。数か月前は、個人プロジェクトで修正経験のあったパストラバーサルなど、理解しやすい単純なバグばかり見つかっていました。時間が経つにつれ、単純なバグの多くは ClickHouse チームや他のセキュリティ研究者によってすでに発見され尽くし、現在残っているのはより興味深いバグ、すなわち Out-of-bounds Write (境界外書き込み) や Out-of-bounds Read (境界外読み取り) だと考えています。
Out-of-bounds Write や Out-of-bounds Read は非常に興味深い一方で、極めて複雑です。これらを引き起こすには巧妙な手法が求められ、メモリアロケーターの仕組みに関する深い理解や、CPU アーキテクチャおよび命令に関する知識が必要になります。経験豊富な C++ エンジニアであれば、この種の脆弱性を理解して報告するのも容易でしょうが、私自身はコンピューターメモリの仕組みに関する深い理解を要しないプログラミング言語を普段使っています。
Out-of-bounds Write や Out-of-bounds Read のバグには最も多くの時間を取られます。難易度は高いですが、知的好奇心を刺激され続けています。これらを理解し、ClickHouse コードベースの他の部分に同様の問題がないかを調査する機会として活用しています。
実際、この踏み込んだ調査のおかげで、ClickHouse が使用しているサードパーティ製ライブラリにバグがあることを発見しました。もちろん、そのバグはベンダーに報告済みです。
質の高いレポートを作成することは、AI を活用した脆弱性調査においておそらく最も重要な部分です。Bugcrowd チームや、脆弱なコードのパッチ適用に取り組むエンジニアに良い印象を与えることができます。
最後の工程として、最近ワークフローに追加したのが、Opus モデルと GPT モデルを組み合わせてレポートが事実に基づいているかをチェックさせるステップです。毎回、一方のモデルが、もう一方の見落とした点を提案してくれます。
PoC の作成が容易に
脆弱性調査において、PoC (概念実証: Proof of Concept) は脆弱性を実証するプログラムです。PoC は単純なプログラムで済むこともあれば、数百行から数千行に及ぶ複雑で長いコードになることもあります。
バイナリプロトコルを「話す」必要があったり、まったく知識のないバイナリファイル形式を改ざんするペイロードを用意しなければならなかったりする PoC に取り組んだことも何度かありました。
最新のフロンティアモデルは、AI の支援がなければファイル形式の研究やコーディングに数日を要したであろうこうした PoC を、わずか数分で作成してくれました。
PoC 作成において、AI の支援は大幅な時間節約になります。調査作業に充てられる時間が大幅に増え、AI 支援コーディングの時代になって脆弱性調査に興味を持った私のような研究者にとっては、間違いなく大きな後押しとなっています。
時間を節約するために変更した点の 1 つは、エージェントに PoC を Python で書くよう指示することでした。2025年12月から2026年1月にかけては Node.js で PoC を書くよう指示していましたが、構文エラーのあるコードが頻繁に出力されました。そこで Python に切り替えたところ、それ以降は問題が起きていません。現在ではモデルが改善され、Node.js でも構文エラーを起こす問題は減っていると思われますが、エージェントが構文エラーのある PoC を生成する場合は、一般的なアドバイスとして別のプログラミング言語を試してみることをお勧めします。
フロンティアラボのサービス停止
ほぼ毎月、フロンティアラボのデータセンターで数回のサービス停止が発生しています。停止時間は数分程度の短いこともあれば、数時間に及ぶこともあります。
2026年6月4日時点のステータスページに基づくと、以下の通りです。
- Claude: 過去 90 日間のアップタイム 98.82%
- ChatGPT: 過去 30 日間のアップタイム 99.89%
また別のときには、モデルの応答が遅くなったり、短期間能力が低下したように感じられたりして、AI を活用した脆弱性調査には実質的に使えなくなることもありました。
以前はフロンティアラボの 1 つからサブスクリプションを契約していたため、障害が発生した際は休憩を取るか、手作業で ClickHouse コードベースの探索を続けていました。
現在は ChatGPT と Claude の両方のサブスクリプションを利用しており、一方のプロバイダーで障害が発生した場合は、もう一方のプロバイダーに切り替えています。
これが現時点での現実ですが、ローカル LLM の実験や OpenRouter への登録、他のモデルの試用も検討しています。
まとめ
最後に、他の研究者や、AI を活用した脆弱性調査を試してみたいと考えている方々に役立つヒントをいくつか共有したいと思います。
スモールスタートで徐々にツールを拡張する
約 6 か月前は 39 ドルの GitHub Copilot Pro+ を使っていましたが、現在では利用頻度が増えたため、200 ドルの Claude Max 20x と 200 ドルの ChatGPT Pro を利用しています。この投資は間違いなく私にとって元が取れましたが、最初からこの構成だったわけではなく徐々に到達しました。AI を活用した脆弱性調査を試してみたい方には、100 ドルの Claude や ChatGPT のサブスクリプションから始めるのが良い出発点になると思います。
セキュリティ調査には信頼されたアクセスが重要
脆弱性調査にモデルを使用するため、ChatGPT と Claude の両方で認証プロセスを経る必要もありました。その過程では、過去の脆弱性発見の実績を提示することが役立ちました。幸いにも、私はすでに GitHub Copilot の助けを借りていくつかの脆弱性を発見していました。現在この認証プロセスを通過するのがどれほど容易かはわかりませんが、もし難しい場合は、OpenRouter で利用可能な AI ベンダーを試してみることをお勧めします。
指示を与えながらの単一エージェントワークフローが最も効果的だった
エージェント型ワークフローでさらなる自動化や異なるモデルの連携を試行した結果、いくつかの新しい発見はあったものの、劇的なブレークスルーには至りませんでした。自動化の改善には今後も取り組みますが、これまでのところ、重大度の高い問題を発見できた最も生産的なアプローチは、1 つのエージェントに人間が指示を与えながら進める方法でした。
ツールの変化が速いため柔軟性を保つ
AI 分野の変化は急速であり、私自身、物事を固定的に考えないようにしています。今日構築した仕組みも、フロンティア AI ラボから新しいハーネスや新しいモデルが登場すれば、数週間で時代遅れになる可能性があります。エージェント型ワークフロー用の独自メモリシステムを構築したエンジニアがいたものの、数か月後にはフロンティアラボから MEMORY.MD という形でメモリシステムが一般提供された事例を私は実際に目の当たりにしました。特定のフロンティアラボだけに固執せず、利用可能になった新しい機能やモデルはすべて試してみるべきだと、私自身も受け入れる必要がありました。
エキサイティングな進化のスピード
セキュリティ業界にとって、間違いなく刺激的な時代です。新しいリリースが出るたびに、新たな脆弱性を発見できていると実感しています。Claude Mythos Preview のようなサイバーセキュリティに特化した強力なモデルが、審査を通過した組織や研究者へと利用可能になりつつある現状は、少し恐ろしくもあり、同時に非常にエキサイティングでもあります。
継続は力なり
私は ClickHouse のコードベースを 6 か月間探索し続けています。調査開始から 2 週間後に最初の発見をしましたが、バグバウンティプログラムの対象外であることが判明しました。しかし、これによりかえって好奇心が刺激され、探索を続けました。数週間後、「Out-of-bounds Read」のバグを発見しました。これは本物の成果であり、ClickHouse のバグバウンティプログラムから報奨金を受け取ることができました。その後も調査を継続し、時間をかけるにつれて手応えを感じ、ClickHouse コードベースの全体像を頭の中に描けるようになりました。現在では脆弱性をより頻繁に発見できるようになりましたが、このレベルに達するまでには、粘り強く時間を投じる必要がありました。
信頼を築くのは手作業による検証
そして最後に、AI が生成した脆弱性レポートには事実に基づかない情報が含まれている可能性や、AI の完全なハルシネーションである可能性があります。AI が生成した誤った報告が多すぎたために、公開バグバウンティプログラムを終了した有名なソフトウェアプロジェクトの事例もすでにいくつか存在します。手作業で作成し検証したレポートこそが、知見を深め、確かな評判を築くための鍵であると強く信じています。