5万

TL;DR
ClickHouse はこれまで、クエリ実行前にセカンダリインデックスを完全にスキャンしていました。
ストリーミングセカンダリインデックス(Streaming secondary indices)により、インデックスの評価が増分かつオンデマンドで行われるようになり、事前の不要な処理を排除してレイテンシとメモリ使用量を改善します。
これまで: シーケンシャルなインデックススキャン
ClickHouse 25.9 より前は、テーブルデータの読み取りを始める前に、セカンダリインデックス(minmax、set、Bloom filter、vector、text など)が評価されていました。
インデックスエントリを事前にスキャンして、クエリの WHERE フィルターに一致する行が含まれる可能性のあるグラニュール(ClickHouse における最小処理単位で、通常は各 8,192 行)を決定します。
このプロセスを示したのが次のアニメーションです。
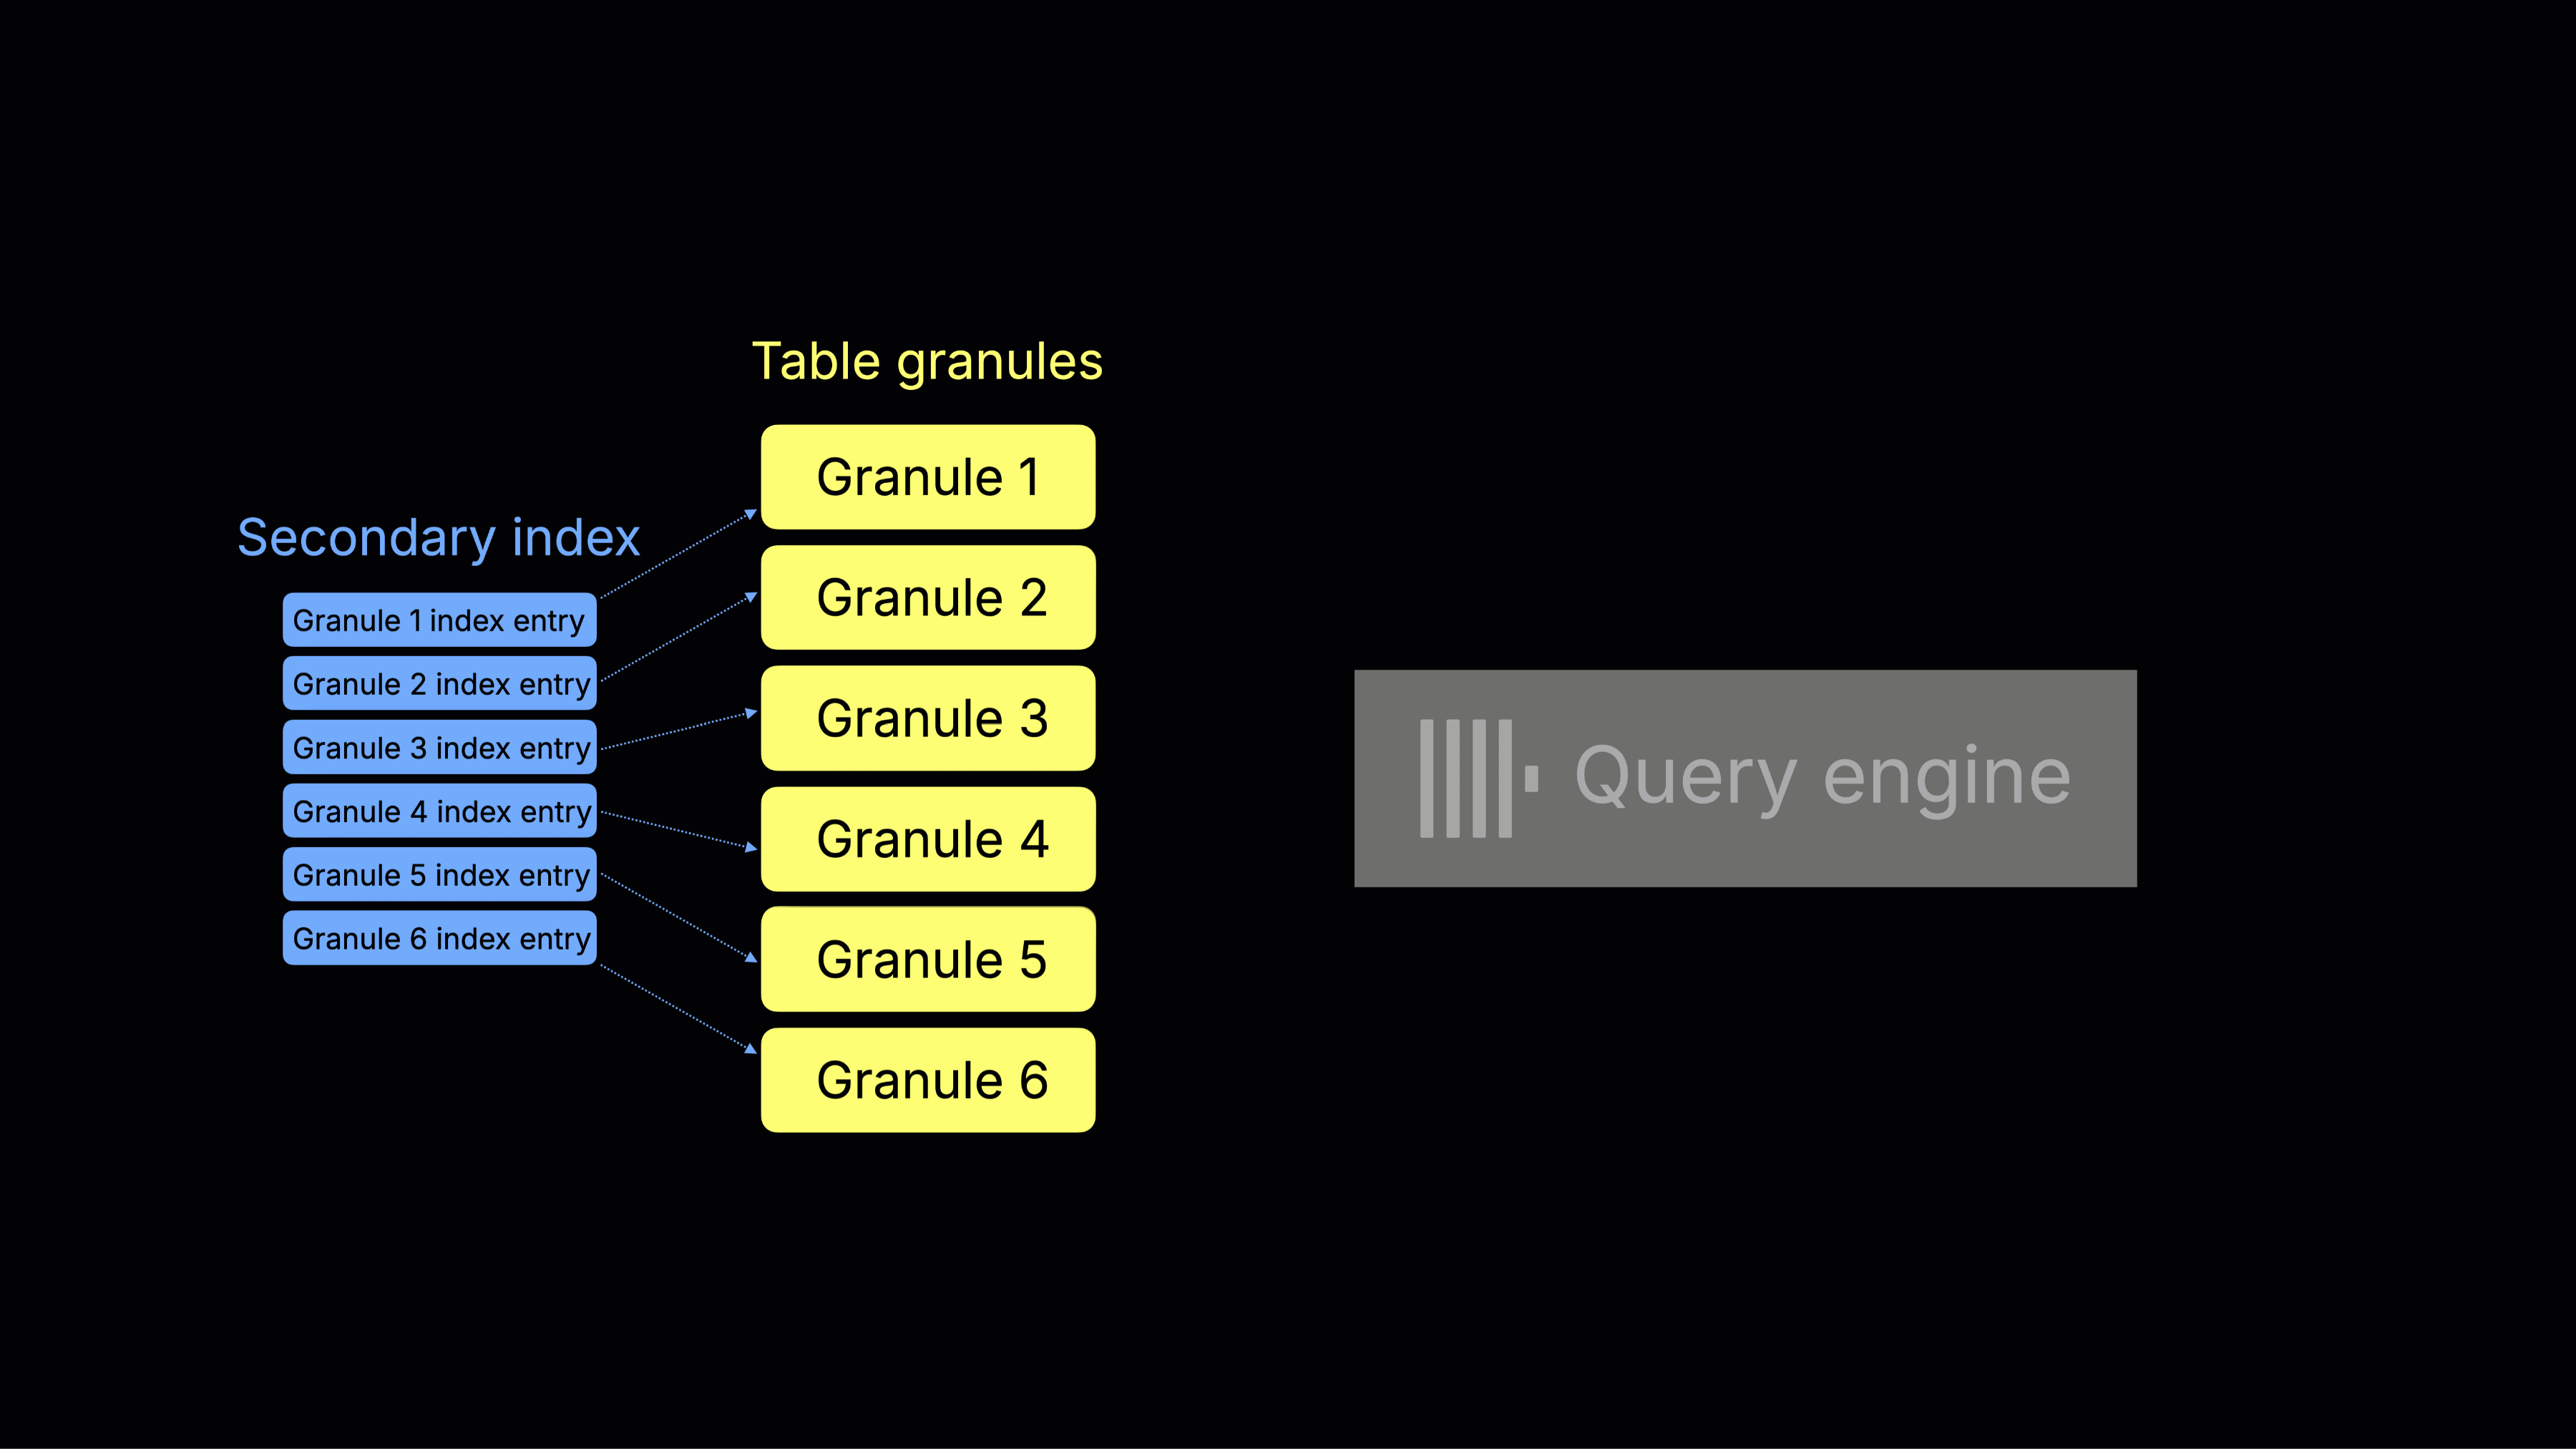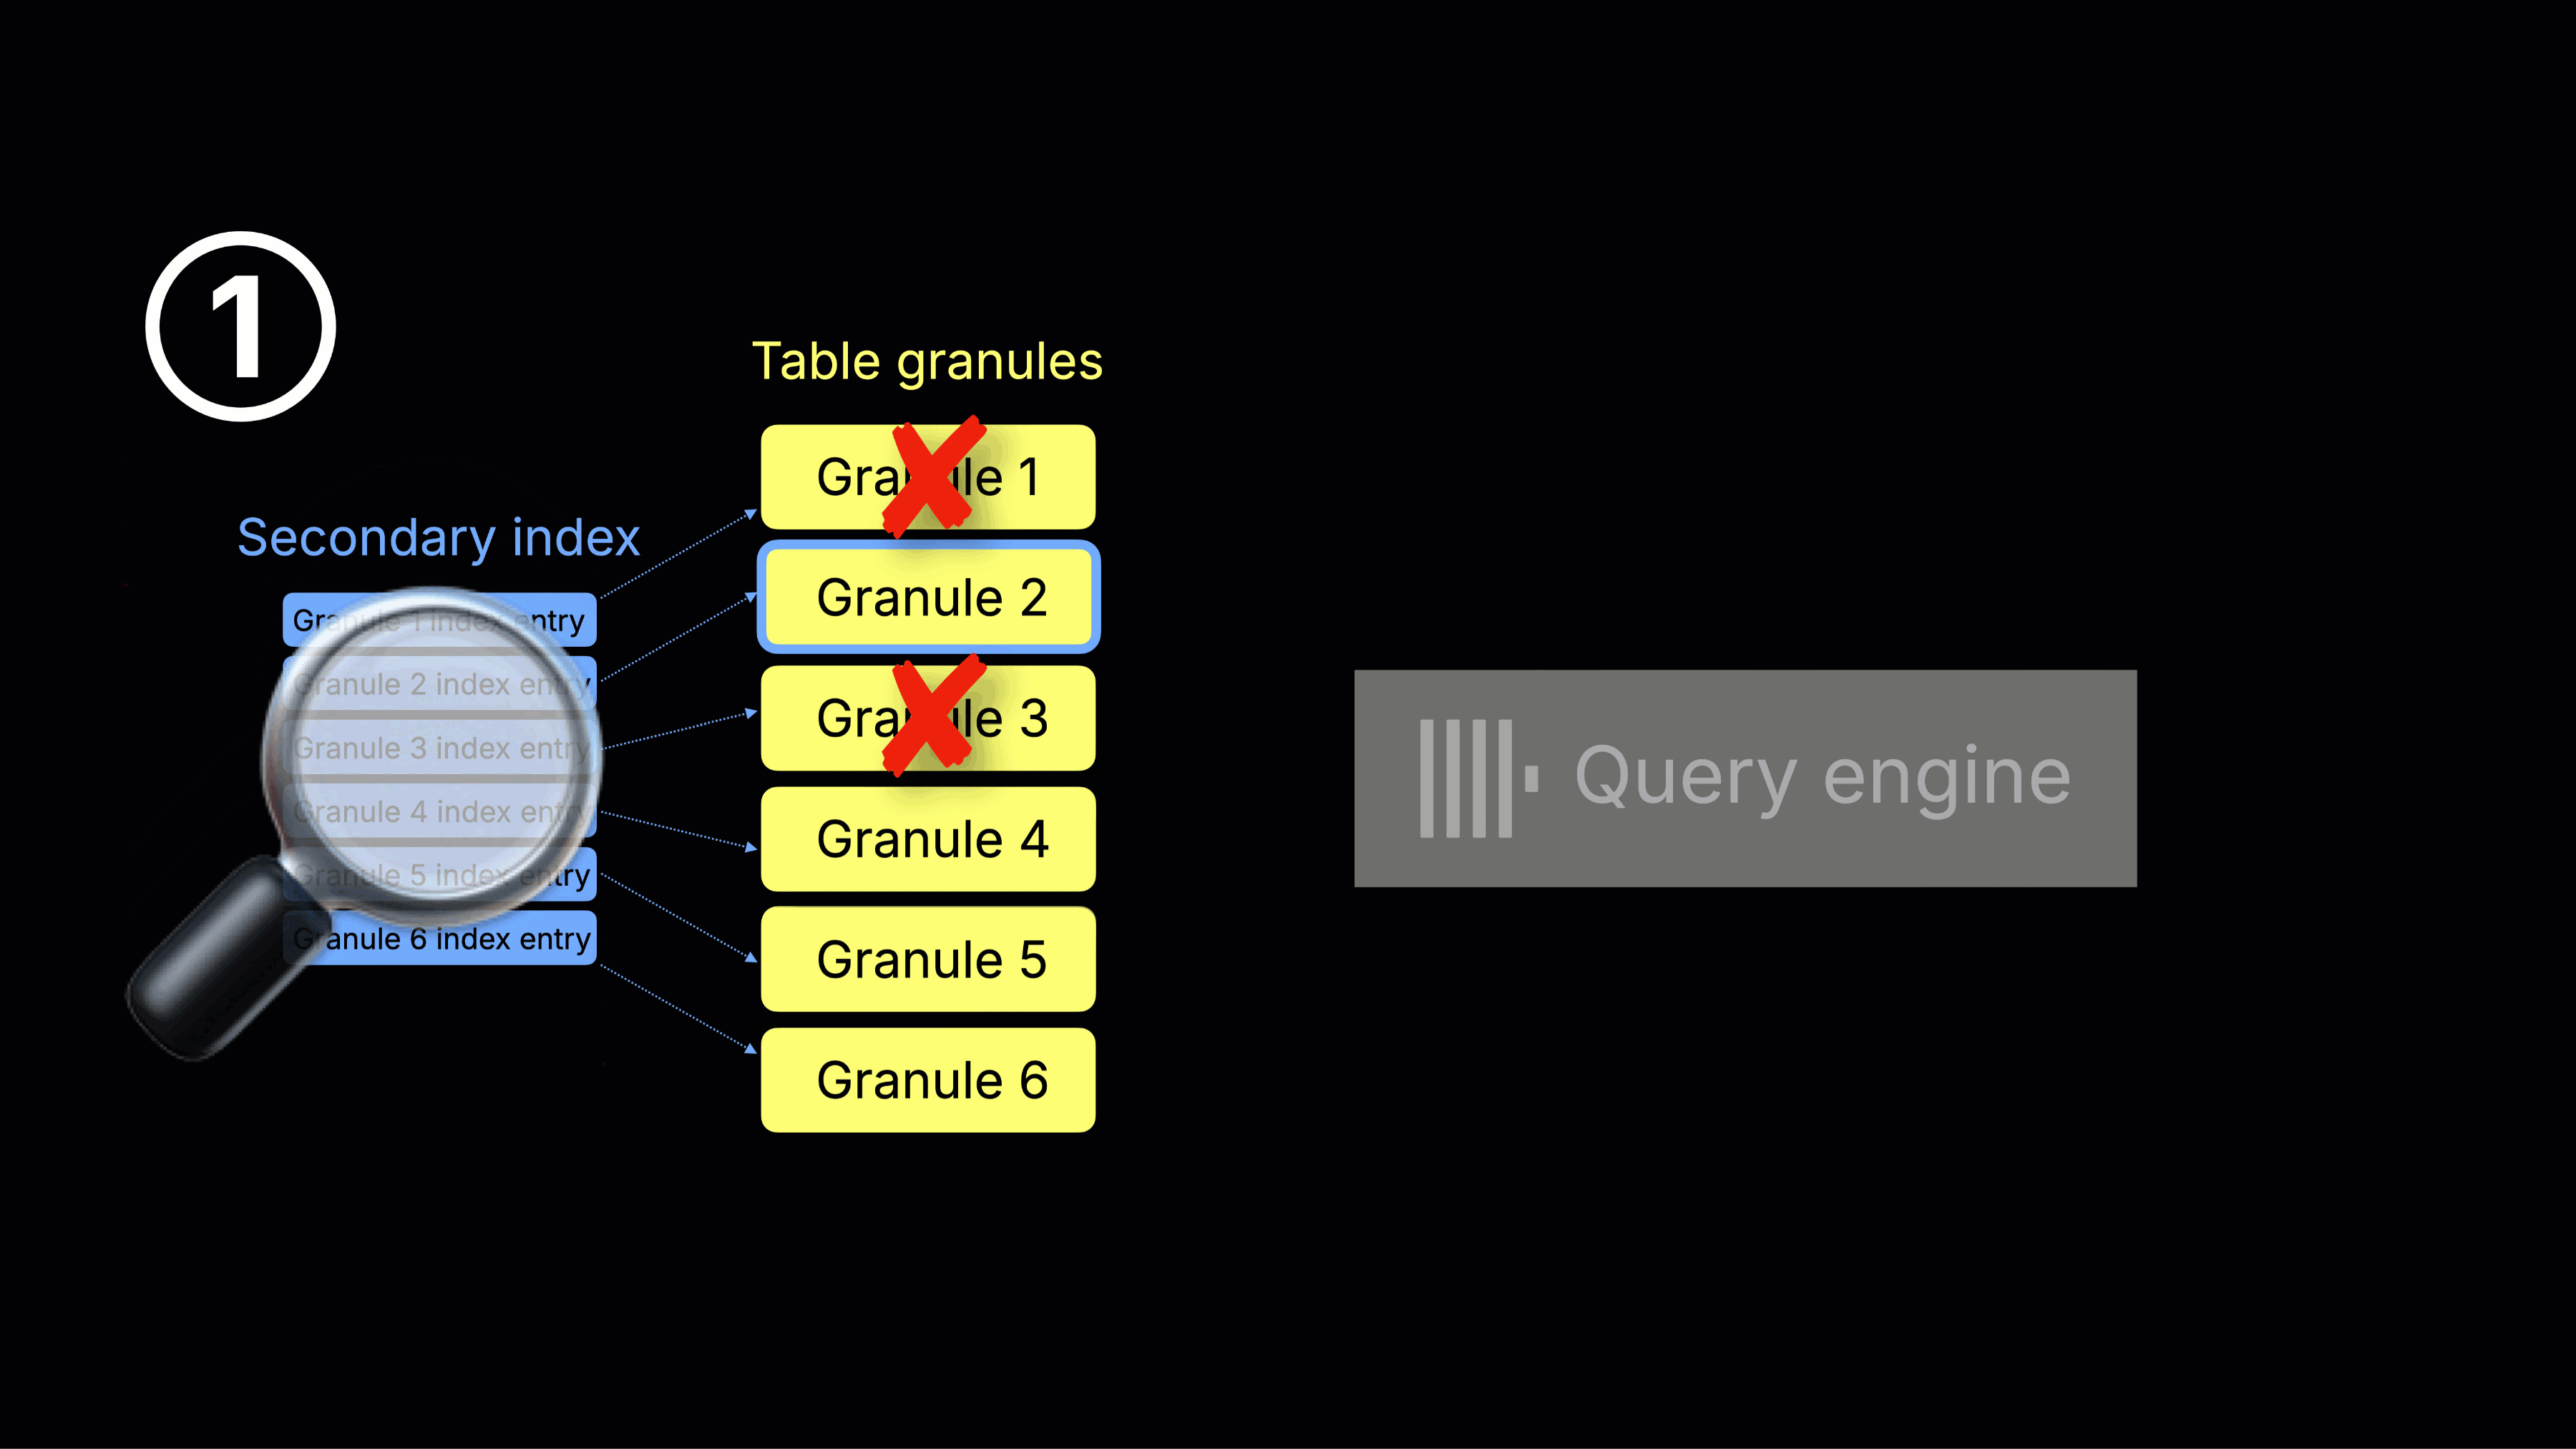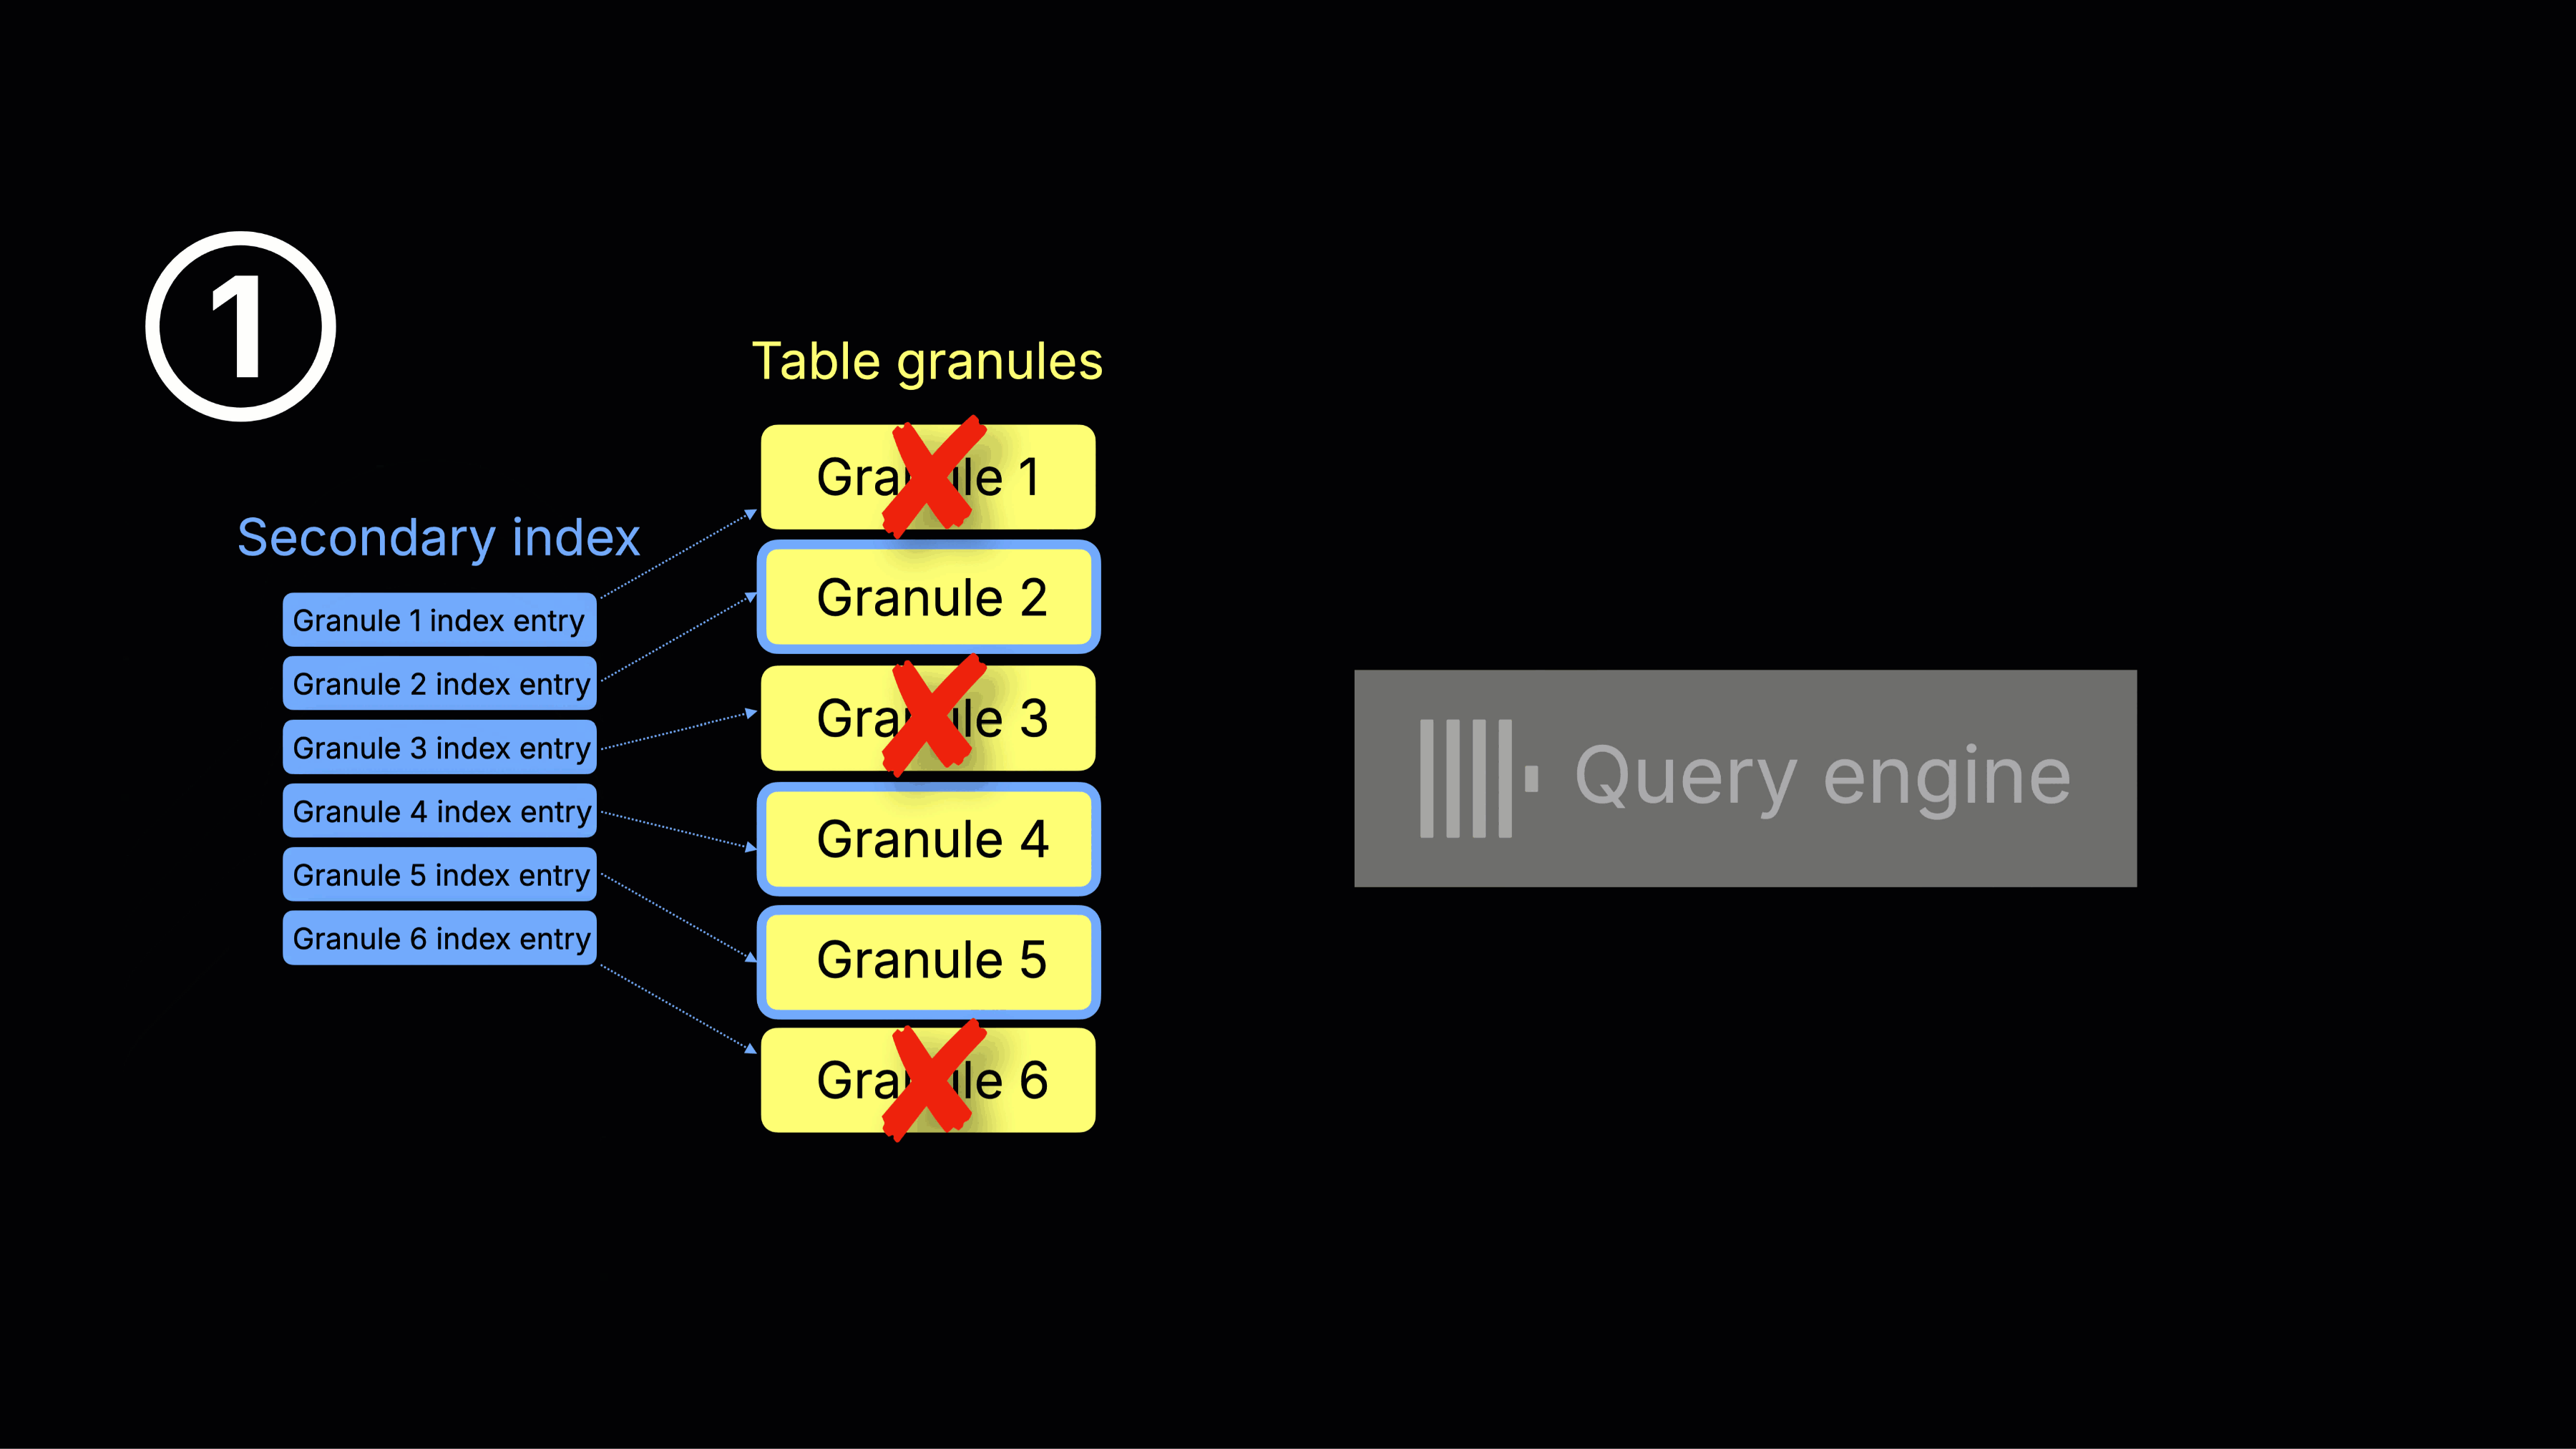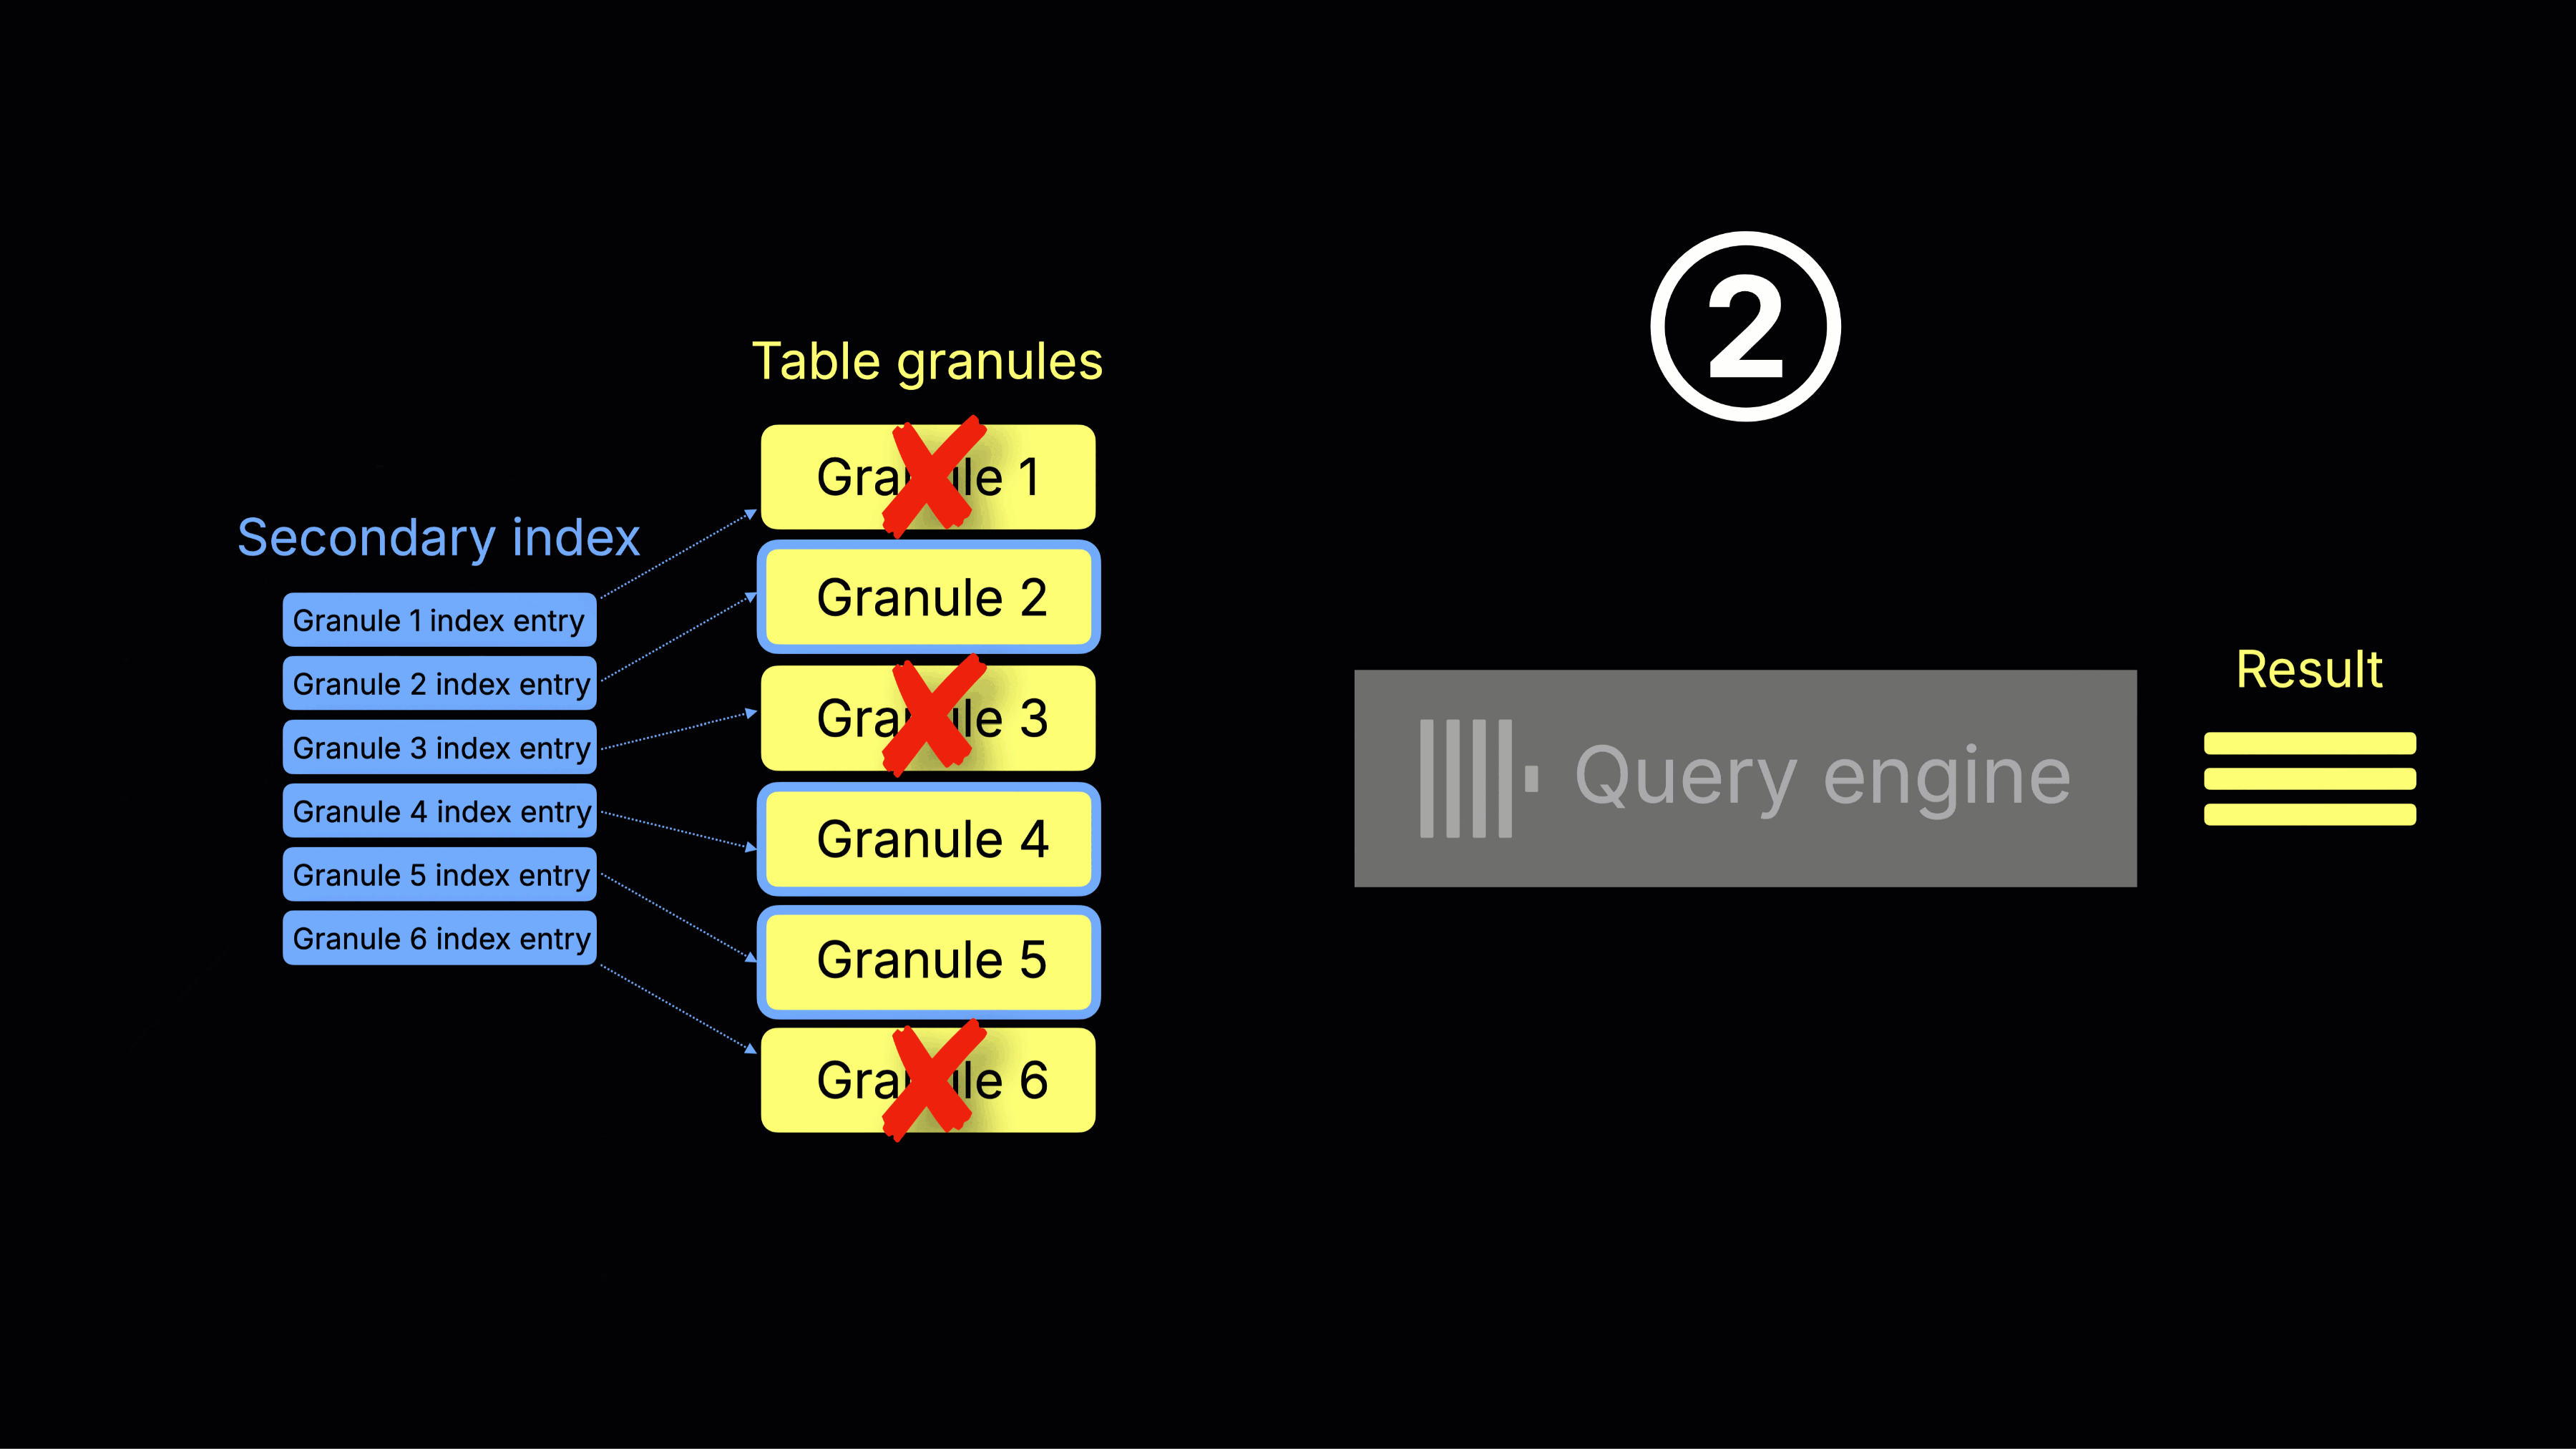
① インデックススキャンとグラニュールの選択 - ClickHouse は各インデックスエントリをチェックして、読み取るべきグラニュールを決定します。一致するグラニュールのみが選択され、その他はスキップされます。
② クエリ実行 - 選択されたグラニュールはクエリエンジンにストリーミングされ、最終結果へと処理されます。
このように事前にインデックスを評価する方式には、いくつかの欠点があります。
-
起動の遅延: 実際のクエリ実行が始まる前にインデックスの解析が行われます。
-
負荷の高いインデックススキャン: 巨大なテーブルに対して選択性の高い WHERE フィルターを指定するクエリなど、場合によっては、選択されたデータ自体のスキャンや処理よりもインデックスのスキャンのほうが高コストになることがあります。
-
LIMIT 使用時の非効率性: LIMIT によってクエリが途中で終了する場合であっても、ClickHouse は事前にインデックス全体をスキャンしなければなりません(そして必要以上のデータを選択してしまう可能性があります)。
ストリーミングセカンダリインデックスの仕組み
ClickHouse 25.9 では、下のアニメーションに示すように、データの読み取りとインデックスチェックをインターリーブ(交互に実行)させることで、これらの欠点を解消しています。
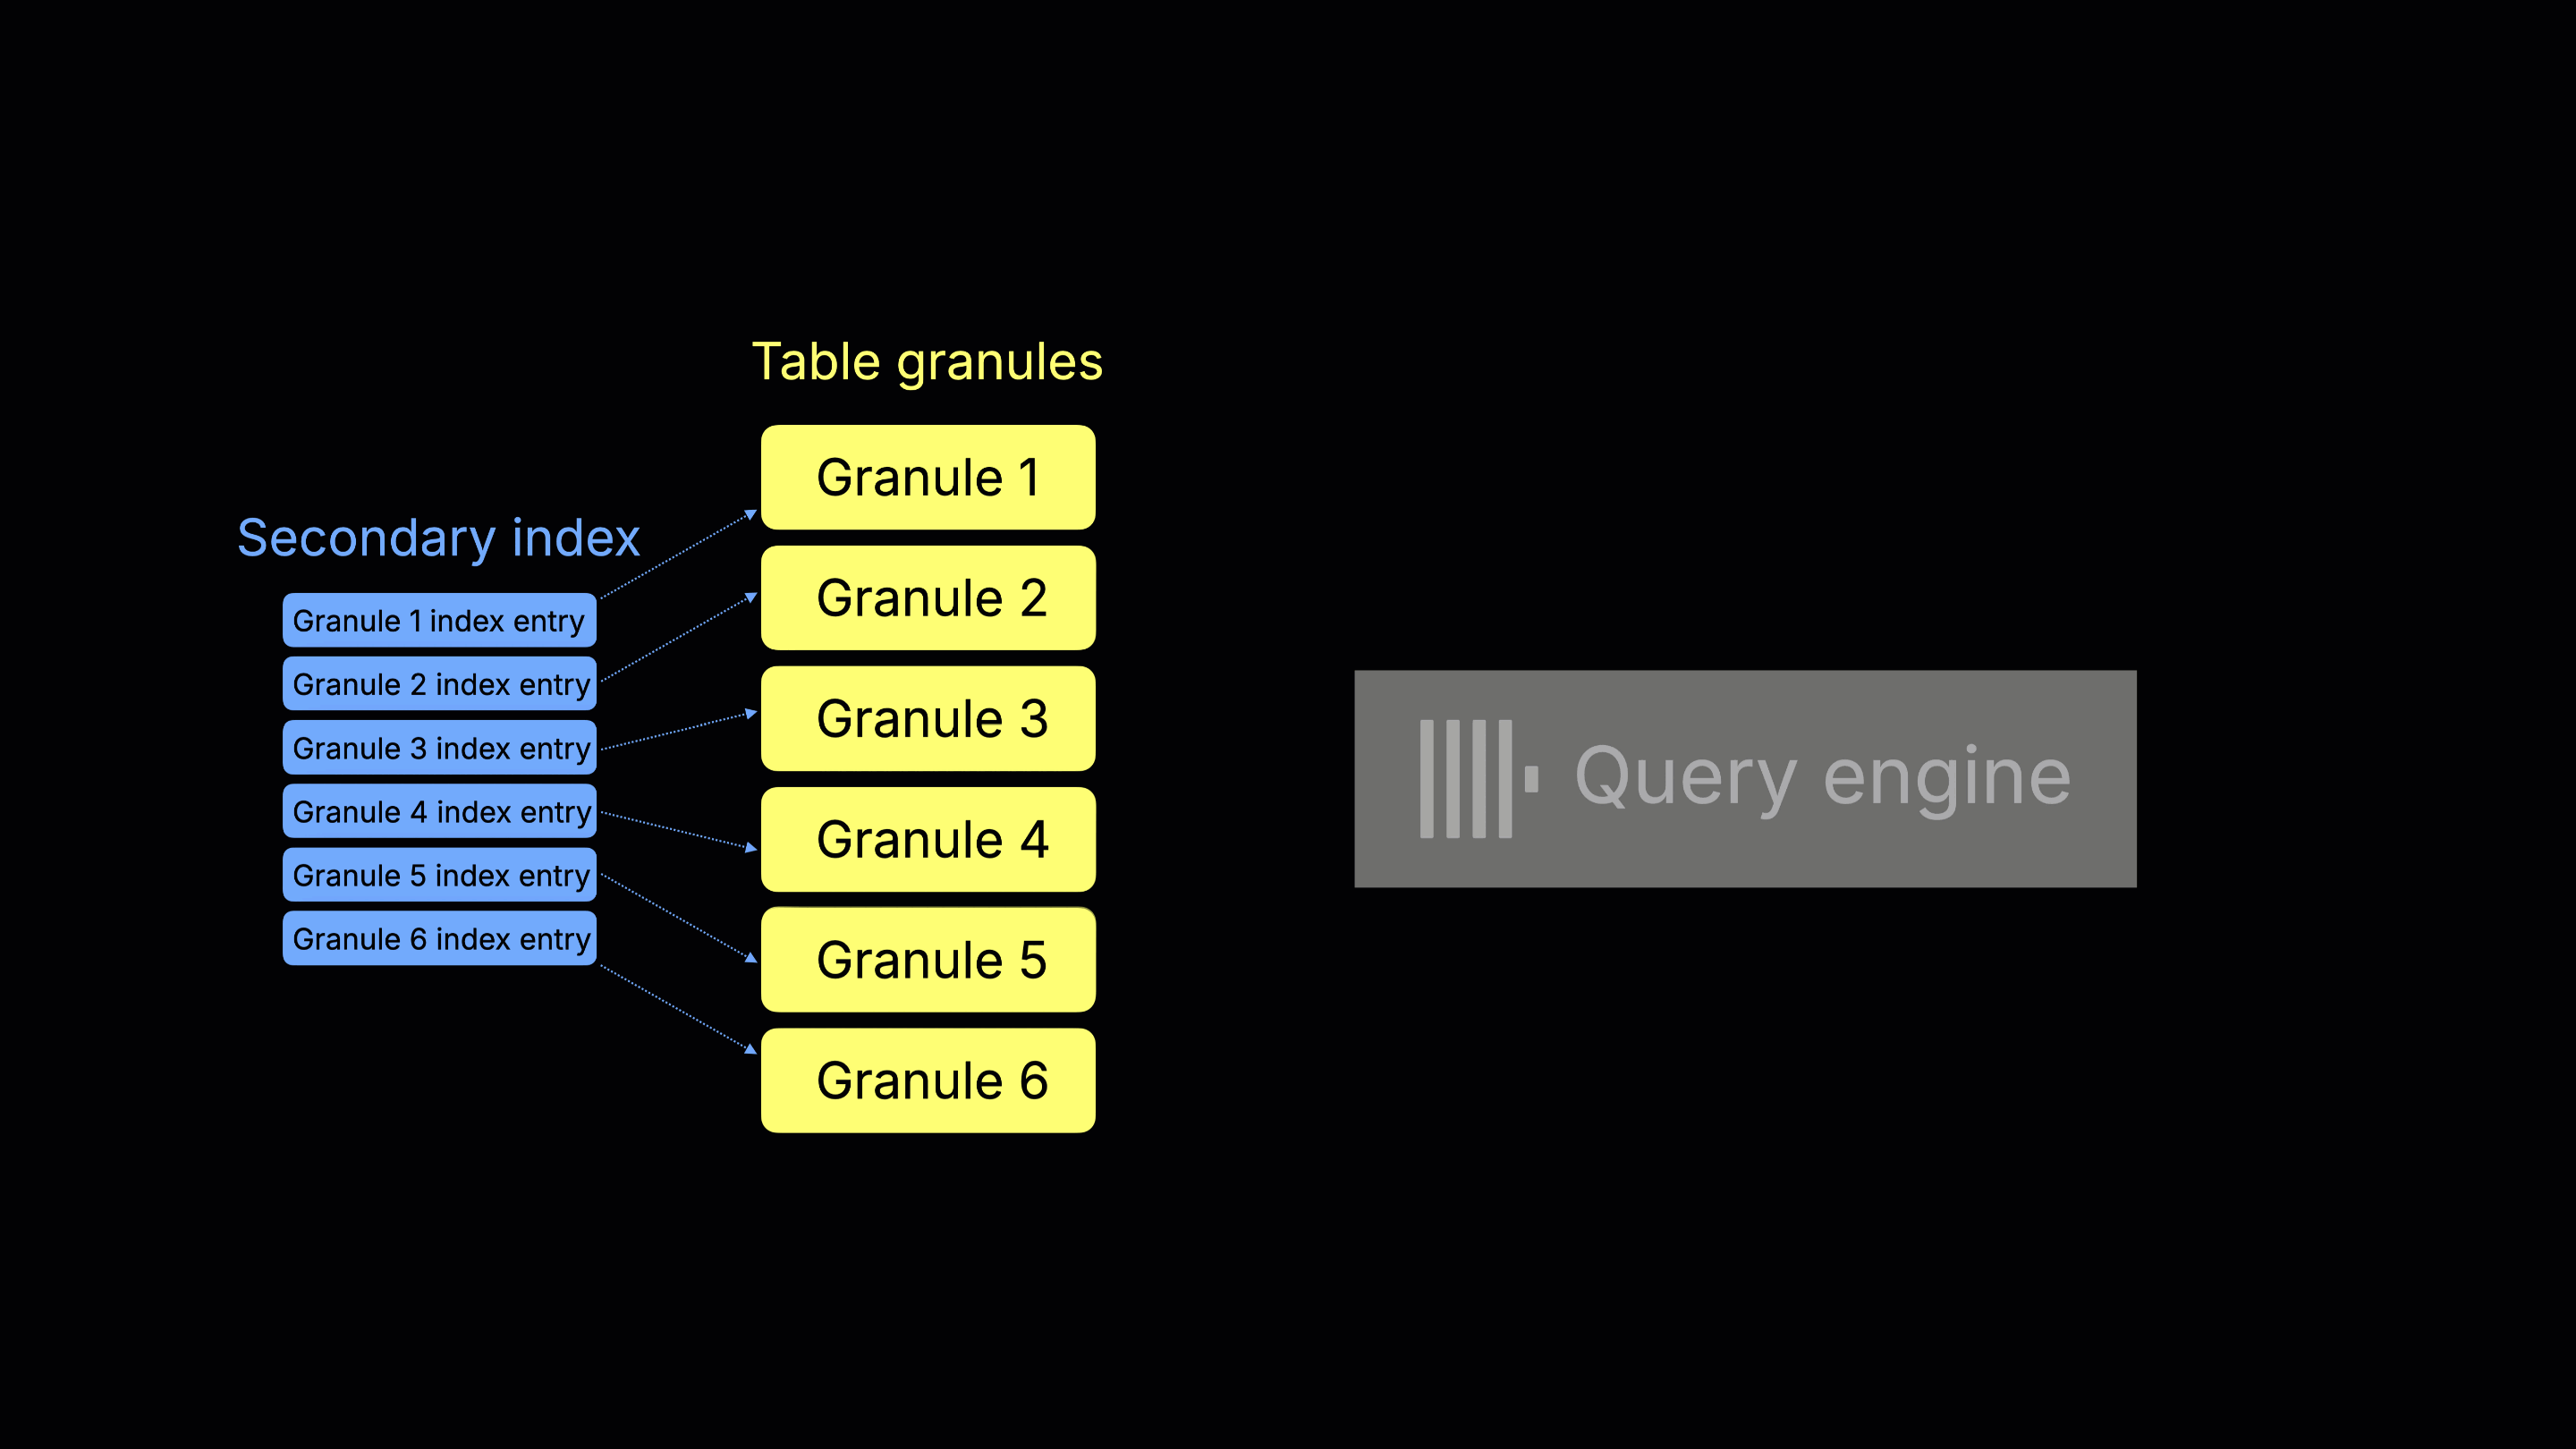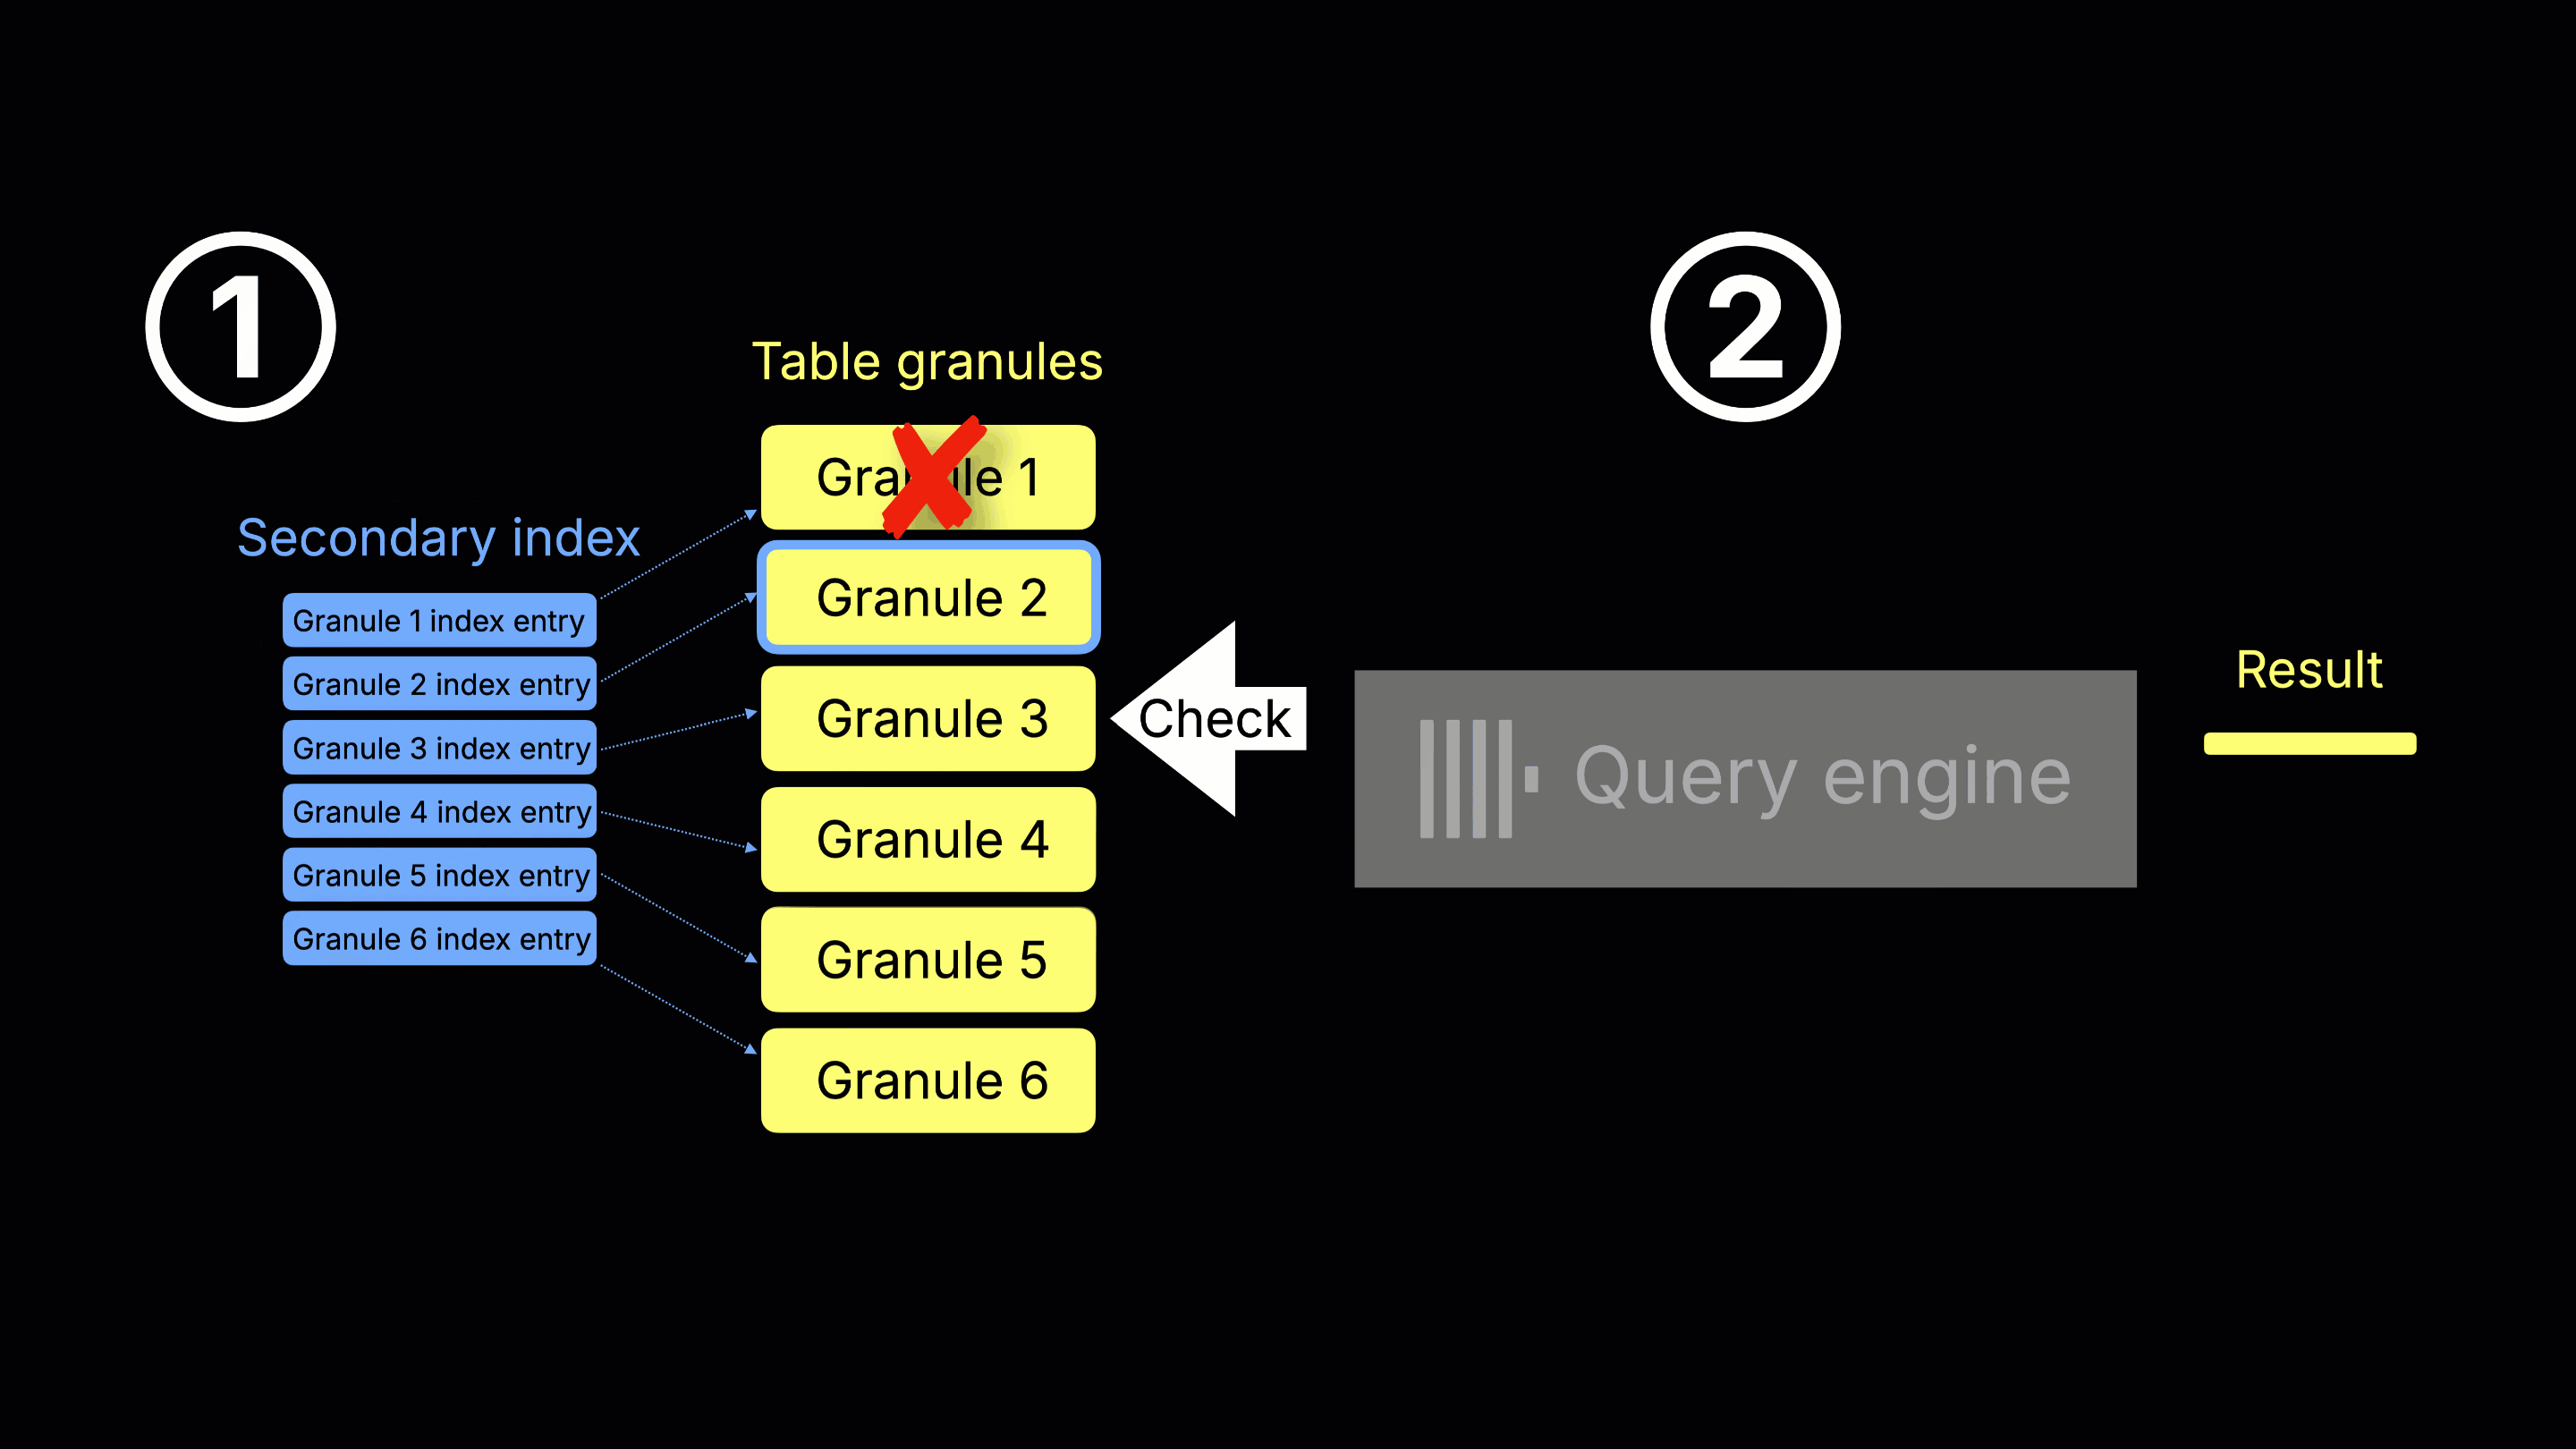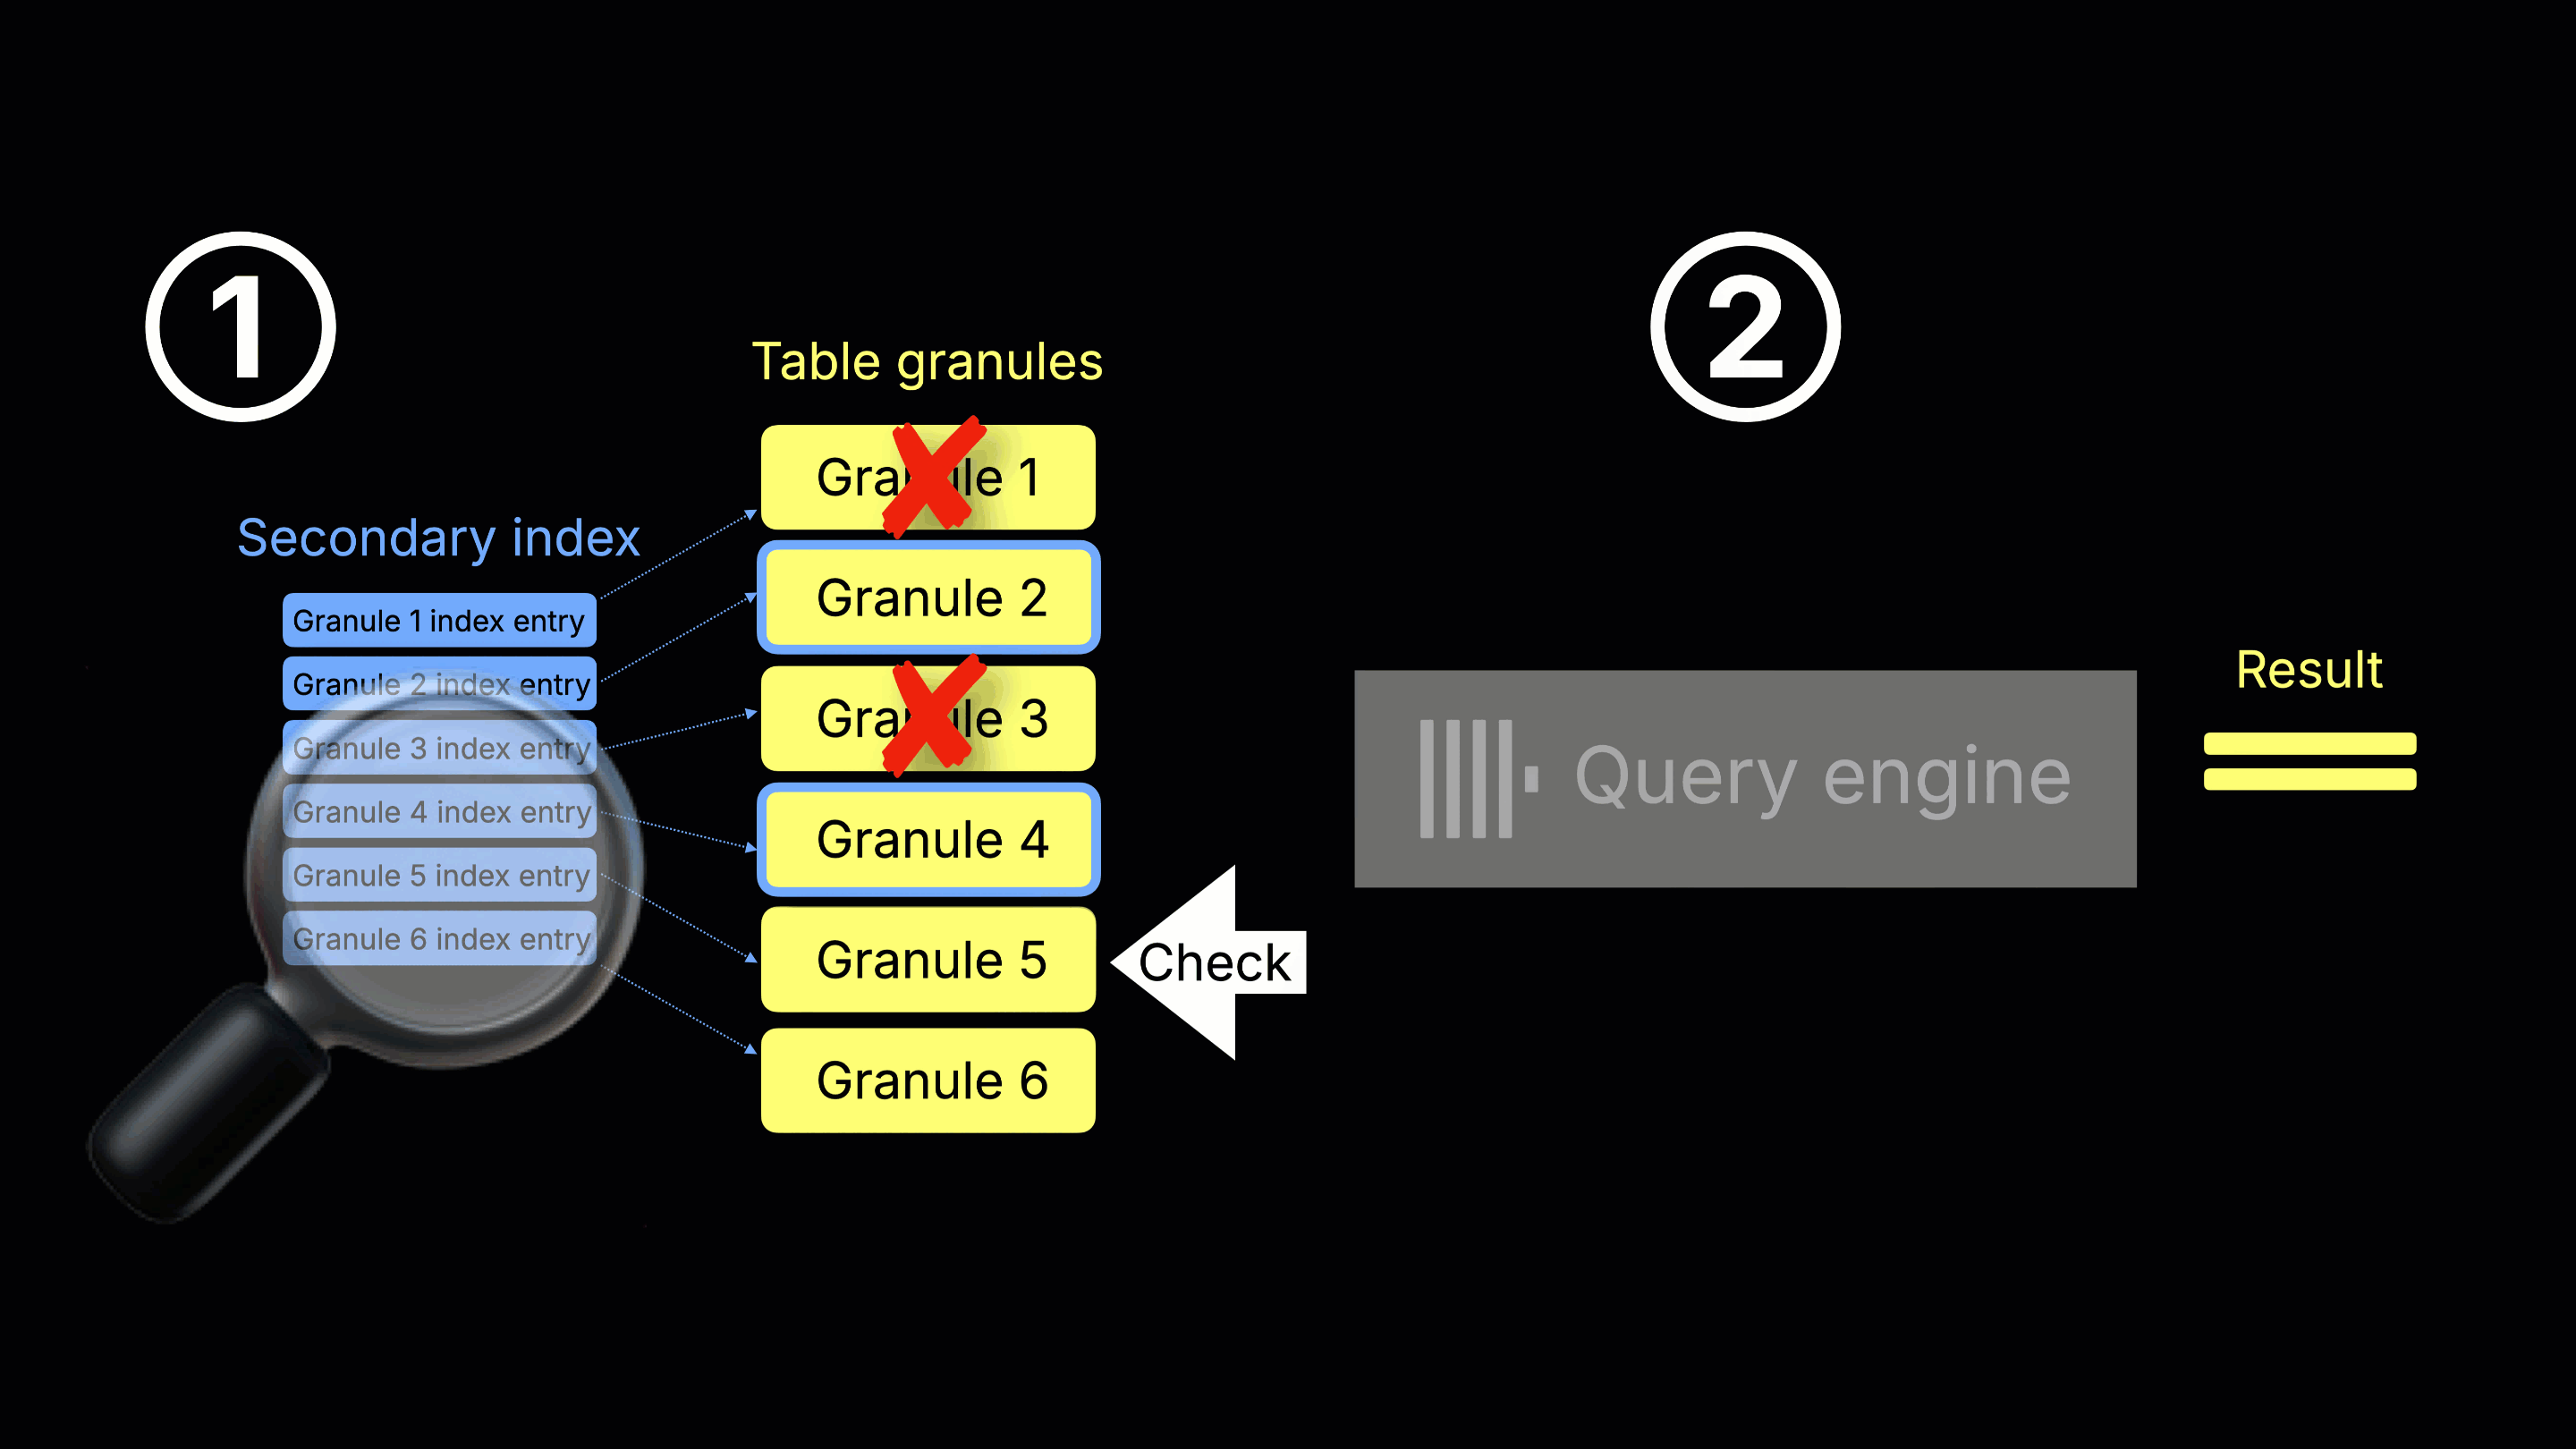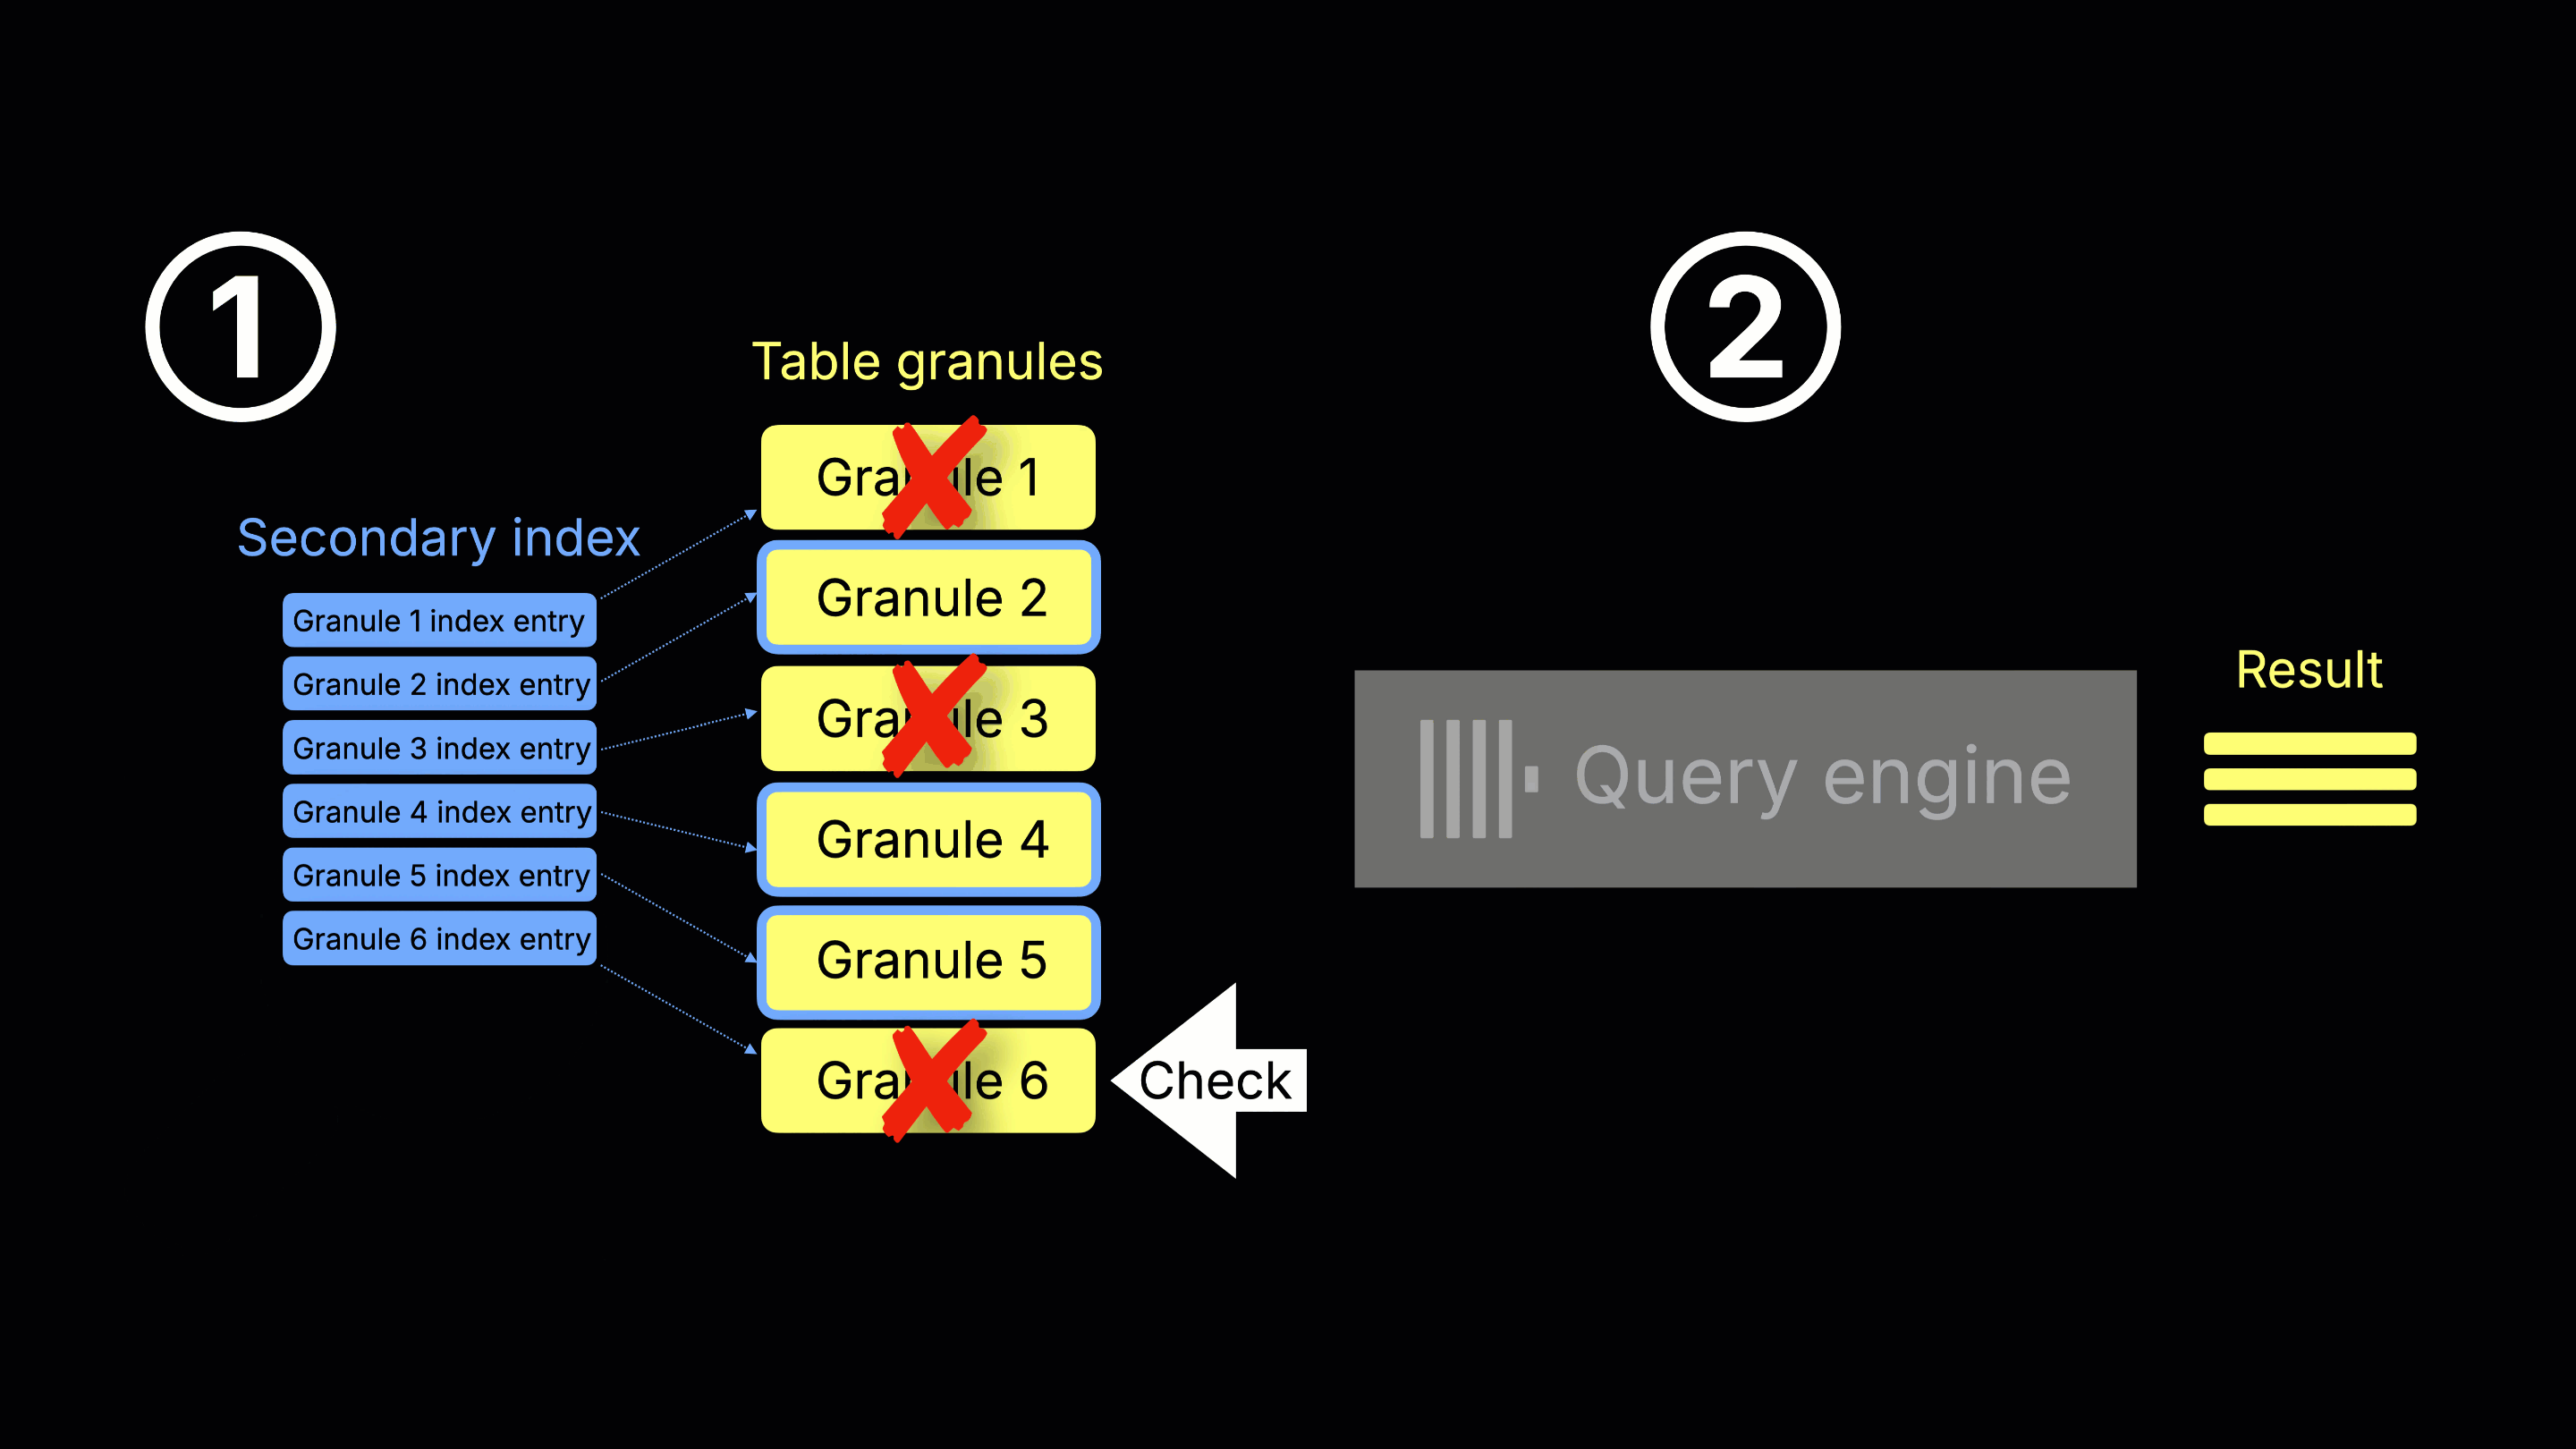
① インデックススキャン、グラニュール選択、および ② クエリ実行(同時並行) – ClickHouse はテーブルデータのグラニュールを読み取ろうとする際(例: プライマリインデックスの解析によって選択された場合)、まず対応するセカンダリインデックスエントリが存在すればそれをチェックします。セカンダリインデックスによってテーブルグラニュールをスキップできると判断された場合、そのグラニュールは読み取られません。スキップできない場合は、グラニュールが読み取られてクエリエンジンで処理される一方、後続のグラニュールのスキャンも並行して継続されます。
このように、テーブルグラニュールの読み取りとセカンダリインデックスエントリのチェックを並行して行う増分的な2ストリームのプロセスであることから、この機能をストリーミングセカンダリインデックス(設定 use_skip_indexes_on_data_read で制御)と呼んでいます。
(注: アニメーションではわかりやすくするためにシングルスレッドのクエリエンジンを示していますが、実際には複数のスレッドが多数のグラニュールを同時に並列処理します。)
この同時並行実行によって起動遅延が解消され、無駄な処理が回避されます。 たとえば、LIMIT によって早期終了するクエリでは、結果が揃った時点で ClickHouse はインデックスチェックとグラニュールの読み取りを即座に停止します。
デモ: ストリーミングセカンダリインデックスによる高速化
リリースのウェビナーで、Alexey はプルリクエストやコミットに対するテスト実行から得られた数兆件ものログレコードを含む大規模な ClickHouse テーブルを使って、ストリーミングセカンダリインデックスのデモを行いました。これらのデータセットでは、個別のセカンダリインデックスだけで圧縮後 6 TB を超えるものもあります。
その規模を再現するのは現実的ではないため、手元で実行できる簡略化した人工的な例を使用します。
この検証は、AWS EC2 の m6i.8xlarge インスタンス(32 vCPU、128 GiB RAM)で実行しました。
まず、String カラムを持つテーブルを作成し、そのカラムに Bloom filter インデックスを追加します。
CREATE TABLE test (
s String,
index s_idx s type bloom_filter(0.0001) granularity 1
)
ENGINE = MergeTree
ORDER BY ()
SETTINGS index_granularity = 1024;次に、10 億行を挿入します。
INSERT INTO test
SELECT if(number % 1024 == 0, 'needle', randomPrintableASCII(64))
FROM numbers_mt(1_000_000_000);Bloom filter インデックスのサイズが 2 GiB を超えていることを確認できます。
SELECT
name,
type_full,
formatReadableSize(data_uncompressed_bytes) AS size
FROM system.data_skipping_indices
WHERE database = 'default' AND table = 'test';┌─name──┬─type_full────────────┬─size─────┐
1. │ s_idx │ bloom_filter(0.0001) │ 2.21 GiB │
└───────┴──────────────────────┴──────────┘公平に比較するため、後述の2つのテストクエリを実行する前に、毎回 OS のページキャッシュをクリアしました。
echo 3 | sudo tee /proc/sys/vm/drop_caches >/dev/nullストリーミングインデックスなし(use_skip_indexes_on_data_read = 0)の場合、LIMIT 1 で1行を見つけるのに約 10 秒かかりました。
なお、セカンダリインデックス処理の影響のみを切り出して確認できるように、max_threads = 1 に設定し、クエリ条件キャッシュを無効にしています。
SELECT * FROM test WHERE s = 'needle' LIMIT 1
SETTINGS
max_threads = 1,
use_query_condition_cache = 0, use_skip_indexes_on_data_read = 0;┌─s──────┐
1. │ needle │
└────────┘
1 row in set. Elapsed: 10.173 sec. Processed 29.70 thousand rows, 2.14 MB (2.92 thousand rows/s., 210.00 KB/s.)
Peak memory usage: 8.90 MiB.ストリーミングインデックスあり(use_skip_indexes_on_data_read = 1)の場合、同じクエリが約 2.4 秒で完了し、メモリ使用量を抑えつつ 4 倍以上高速になりました。
SELECT * FROM test WHERE s = 'needle' LIMIT 1
SETTINGS
max_threads = 1,
use_query_condition_cache = 0, use_skip_indexes_on_data_read = 1;┌─s──────┐
1. │ needle │
└────────┘
1 row in set. Elapsed: 2.471 sec. Processed 29.70 thousand rows, 2.14 MB (12.02 thousand rows/s., 864.57 KB/s.)
Peak memory usage: 4.48 MiB.実際の環境で高速になる理由
改めて整理すると、今回の高速化は ① と ② の仕組みによるものです。
-
ストリーミングインデックスなし: クエリ処理が始まる前に、ClickHouse はインデックスを完全にスキャンして処理し、一致するすべてのグラニュールを特定する必要があります。
-
ストリーミングインデックスあり:
① ClickHouse は、インデックスのスキャンとクエリエンジンでの一致グラニュールの処理を同時に並行して実行します。
② そして、最初の一致行(LIMIT 1)が見つかった瞬間に、それ以降のインデックスエントリやグラニュールのスキャンを即座に停止し、無駄な処理を排除します。
まとめ
インデックスのチェックとデータの読み取りをシーケンシャルではなく同時並行で行うことで、ClickHouse は起動遅延をなくし、LIMIT 条件が満たされた際に即座に停止できるようになり、クエリ実行時間とメモリ使用量の両方を削減します。 これは、大規模テーブルに対する早期終了(early-exit)クエリで特に効果的です。