5万

また 1 か月が経ち、新しいリリースの時期がやってきました。
ClickHouse 26.5 リリースには、38 個の新機能 🌹、51 件のパフォーマンス最適化 🦋、224 件のバグ修正 🐞 が含まれています。
今回のリリースでは記録的な数のパフォーマンス最適化が行われました。注目すべき機能として、JOIN を経由する ORDER BY … LIMIT のプッシュダウン (最大 20 倍高速化)、不要なグループの構築を回避する新しい GROUP BY … LIMIT ショートカット、ローカルファイルシステムに対して SQL を直接実行できる新しい filesystem テーブル関数などが追加されています。
新しいコントリビューター
26.5 のすべての新しいコントリビューターを心より歓迎します。ClickHouse コミュニティの成長にはいつも身が引き締まる思いであり、ClickHouse をこれほど支持される存在にしてくれた皆さんの貢献に深く感謝しています。
新しいコントリビューターの皆様は以下のとおりです。
Abhinav Agarwal, Ahaan, Alex Kuleshov, Ashrith Bandla, Asish Kumar, Callum C, Felix Bernhard, Flavio Malavazi, Ian Rakhmatullin, Ilya Perstenev, JackFielding, Joe Redfern, Larry Snizek, Luc Leray, Rahul Nair, Roy Sindre Norangshol, Venkata Vineel, Vincent Voyer, Yue, Yue Ni, functioncrafter, ibrahim karimeddin, mohaidoss, perst20, peter15914, sayondeep, zhangzhibiao, zxuhan7
ヒント: このリストをどのように生成しているか興味がある方は、こちらをご覧ください。
プレゼンテーションのスライドもご覧いただけます。
JOIN を経由する ORDER BY … LIMIT のプッシュダウン
貢献者: Alexey Milovidov
「ClickHouse はすべてのバージョンで最適化されており、さらに最適化を進めています。最適化に終わりはありません」 – Alexey Milovidov (ClickHouse リリース 26.5 ウェビナーにて)
より多くの処理を JOIN の前へ移動
最近のリリースにおいて、ClickHouse は JOIN を通過するデータ量を減らすため、より多くの処理を着実に JOIN の前へ移動させてきました。たとえば、ClickHouse はすでに JOIN クエリ内の複雑な OR 条件をプッシュダウンして JOIN が発生する前により早い段階で各テーブルをフィルタリングします。また、JOIN の右側から作成され、JOIN が実行される前に左側に適用されるランタイムフィルターもサポートしています。
今回のリリースはそのテーマを引き継ぎつつ、異なる種類の処理をプッシュダウンします。WHERE 述語ではなく、分析ワークロードで頻繁に現れるパターンである ORDER BY … LIMIT 句です。
「結合してから制限」から「制限してから結合」へ
LEFT JOIN クエリの最も外側の SELECT が ORDER BY … LIMIT で終わり、かつソートキーが左側テーブルのカラムのみに依存している場合、ClickHouse はその ORDER BY … LIMIT を JOIN の下へプッシュできます。
同じことが、ソートキーが右側テーブルのカラムのみに依存している場合の RIGHT JOIN クエリにも適用されます。
たとえば、TPC-H テーブルに対して実行される次のクエリは、顧客情報が付加された直近 100 件の注文を要求します。
SELECT
o_orderkey,
o_orderdate,
o_totalprice,
c_name,
c_mktsegment
FROM orders
LEFT JOIN customer ON o_custkey = c_custkey
ORDER BY
o_orderdate DESC,
o_orderkey DESC
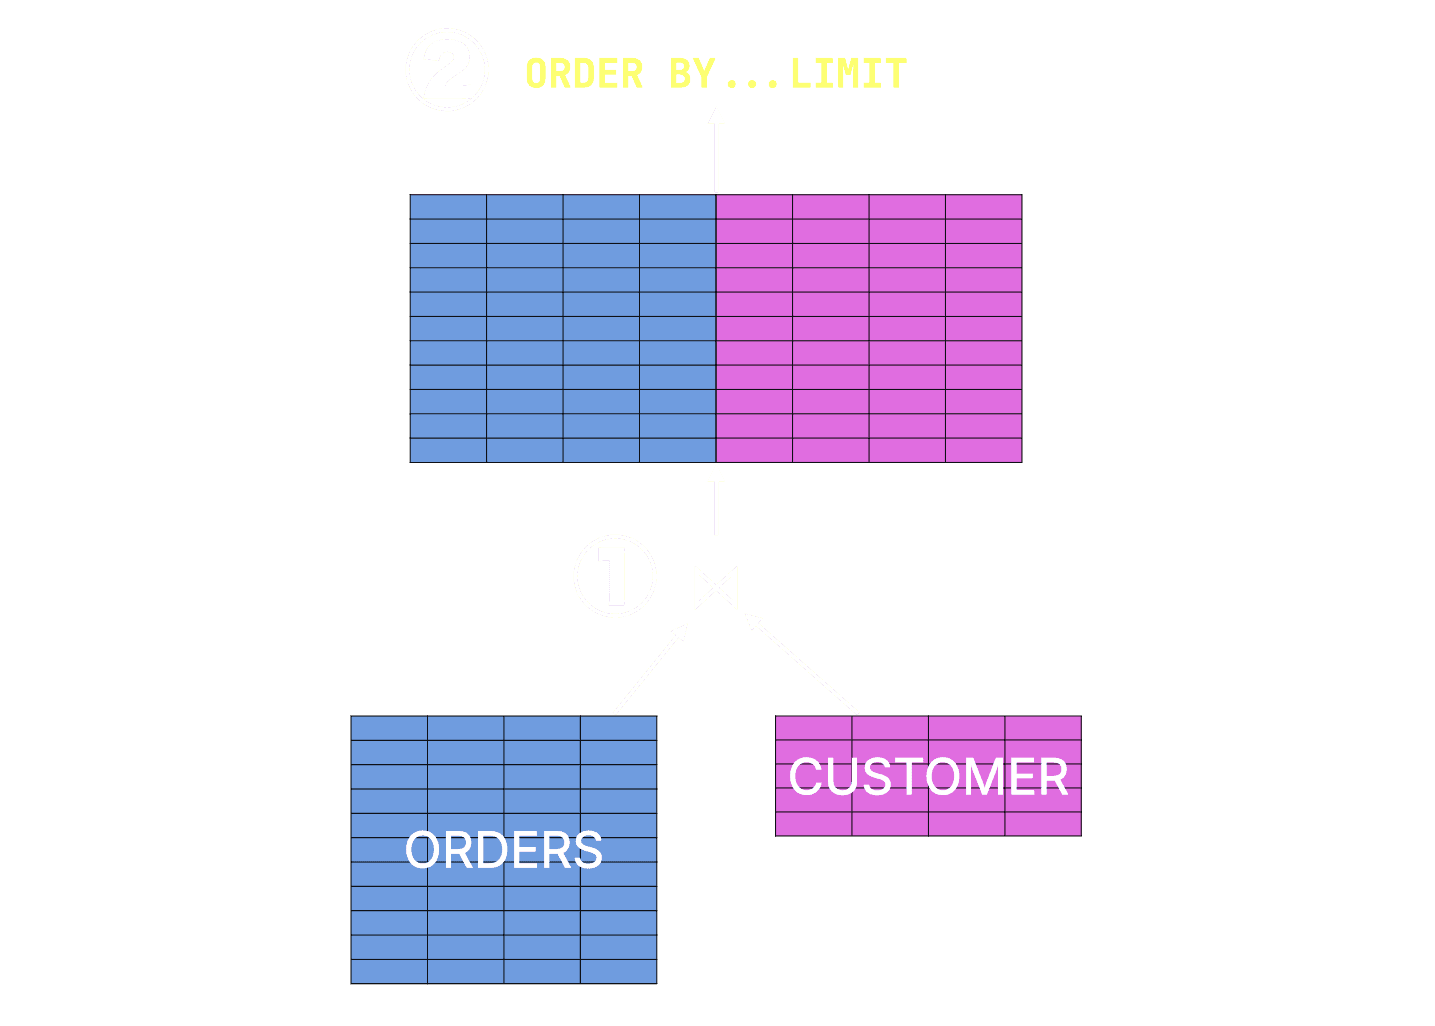
LIMIT 100;ここで ORDER BY は、LEFT JOIN で保持される側の orders のカラムのみを使用しています。つまり、ClickHouse は制限を適用する前に、すべての注文を顧客と結合する必要がありません。
最適化がない場合、プランはコストの高い結合を先に実行せざるを得ません。
新しい最適化により、ClickHouse は処理の順序を逆にできます。まず orders から上位 100 行を特定し、そのわずかな行のみを customer と結合します。
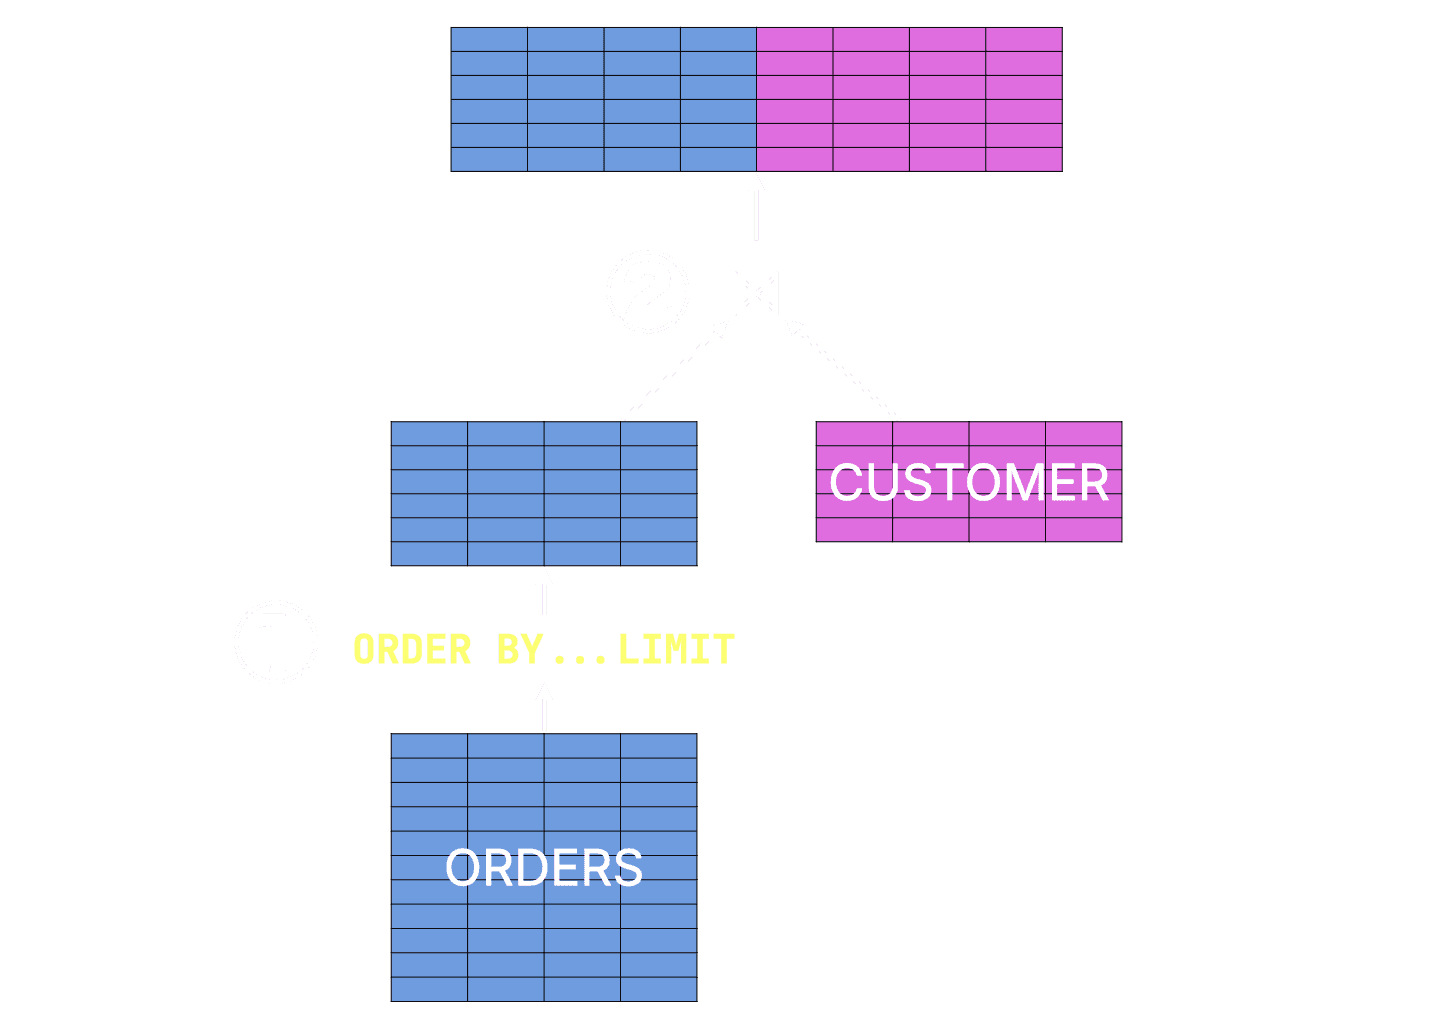
この変化は、EXPLAIN で取得したクエリプランでも確認できます。最適化を有効にすると、customer テーブルとの結合の前に、orders テーブル側で Limit と Sorting のステップがプランに含まれます。
Join
...
Limit
Sorting
ReadFromMergeTree (sf100.orders)
...
ReadFromMergeTree (sf100.customer)嬉しい副次効果として、ClickHouse はプッシュダウンされた ORDER BY … LIMIT の部分をすでにファーストクラスのクエリパターンとして扱います。Top-N 最適化に関する解説記事で取り上げたように、ClickHouse はこのパターンのためのエンジンレベルの最適化をいくつも蓄積してきました。
この最適化は、デフォルトで有効になっている新しい query_plan_top_k_through_join 設定によって制御されます。
ベンチマーク: 20 倍高速化、メモリ消費量は 175 分の 1
その効果を評価するため、32 vCPU と 128 GiB の RAM を備えた AWS EC2 m6i.8xlarge インスタンス上で スケールファクター 100 の TPC-H スキーマを作成してロードしました。
まず、query_plan_top_k_through_join = 0 を設定して新しい ORDER BY … LIMIT プッシュダウンを無効にした状態でクエリを実行しました。クエリを 3 回実行し、最も速かった実行をベースラインとして使用しました。
Elapsed: 2.153 sec. Processed 165.00 million rows, 3.23 GB (76.65 million rows/s., 1.50 GB/s.)
Peak memory usage: 1.87 GiB.
Elapsed: 1.878 sec. Processed 165.00 million rows, 3.23 GB (87.87 million rows/s., 1.72 GB/s.)
Peak memory usage: 1.88 GiB.
Elapsed: 2.197 sec. Processed 165.00 million rows, 3.23 GB (75.10 million rows/s., 1.47 GB/s.)
Peak memory usage: 1.87 GiB.次に、query_plan_top_k_through_join = 1 を設定して最適化を有効にし、同じクエリを実行しました。
Elapsed: 0.093 sec. Processed 165.22 million rows, 2.18 GB (1.78 billion rows/s., 23.45 GB/s.)
Peak memory usage: 11.46 MiB.
Elapsed: 0.092 sec. Processed 165.22 million rows, 2.18 GB (1.80 billion rows/s., 23.70 GB/s.)
Peak memory usage: 13.72 MiB.
Elapsed: 0.092 sec. Processed 165.22 million rows, 2.18 GB (1.79 billion rows/s., 23.53 GB/s.)
Peak memory usage: 10.98 MiB.各設定の最速の実行結果を比較すると、その差は歴然です。
| 設定 | 最速実行時間 | ピークメモリ | 読み取りデータ量 |
|---|---|---|---|
| プッシュダウン無効 | 1.878 秒 | 1.88 GiB | 3.23 GB |
| プッシュダウン有効 | 0.092 秒 | 10.98 MiB | 2.18 GB |
| 改善度 | 20.4 倍高速 | メモリ約 175 分の 1 | 読み取りデータ量 1.5 分の 1 |
このベンチマークではすでに、実行時間が 20.4 倍改善し、ピークメモリ使用量が約 175 分の 1 に削減されています。
これらの数値は固定の上限ではありません。得られる恩恵は、入力テーブルのサイズ、結合される行の幅、選択されたカラム、および LIMIT 値によって左右されます。
ORDER BY なしの GROUP BY … LIMIT
貢献者: Amos Bird
Top-N 最適化を GROUP BY に拡張
ClickHouse はすでに Top-N クエリをファーストクラスのクエリパターンとして扱っています。Top-N 最適化に関する解説記事で取り上げたように、ClickHouse はストリーミング実行、インオーダー読み取り、遅延読み取り、データスキッピングに基づく Top-N プルーニングなど、ORDER BY … LIMIT を伴うクエリ向けのエンジンレベルの最適化をいくつも蓄積してきました。
今回のリリースでは、同じアイデアを別の形状、すなわち ORDER BY のない GROUP BY … LIMIT クエリにまで拡張しています。
キーでグループ化してから LIMIT を適用するものの、ORDER BY も HAVING 句もウィンドウ関数も持たないクエリを考えてみてください。この場合、クエリは最小のキー、最大のキー、最も頻出するキー、あるいは特定の順序のキーを求めているわけではありません。単に重複しない任意の N 個のグルーピングキーを求めているだけです。
たとえば、前のセクションのベンチマーク用に TPC-H データセットをすでにロードしているため、ここでも再利用できます。次のクエリは、lineitem テーブルから重複しない任意の 100 個の注文キーを要求します。
SELECT l_orderkey
FROM lineitem
GROUP BY l_orderkey
LIMIT 100;「すべてをグループ化してから制限」から「N グループのみを保持」へ
TPC-H スケールファクター 100 では、lineitem には 6 億行と、1 億 5,000 万個の異なる l_orderkey の値が含まれています。
新しい最適化がない場合、ClickHouse はこのクエリを通常の GROUP BY として扱います。入力をスキャンする際、新しい l_orderkey が現れるたびに 集約ハッシュテーブル に新しいエントリが作成されます。集約結果が構築された後に初めて、LIMIT 100 によって出力が 100 行に削減されます。
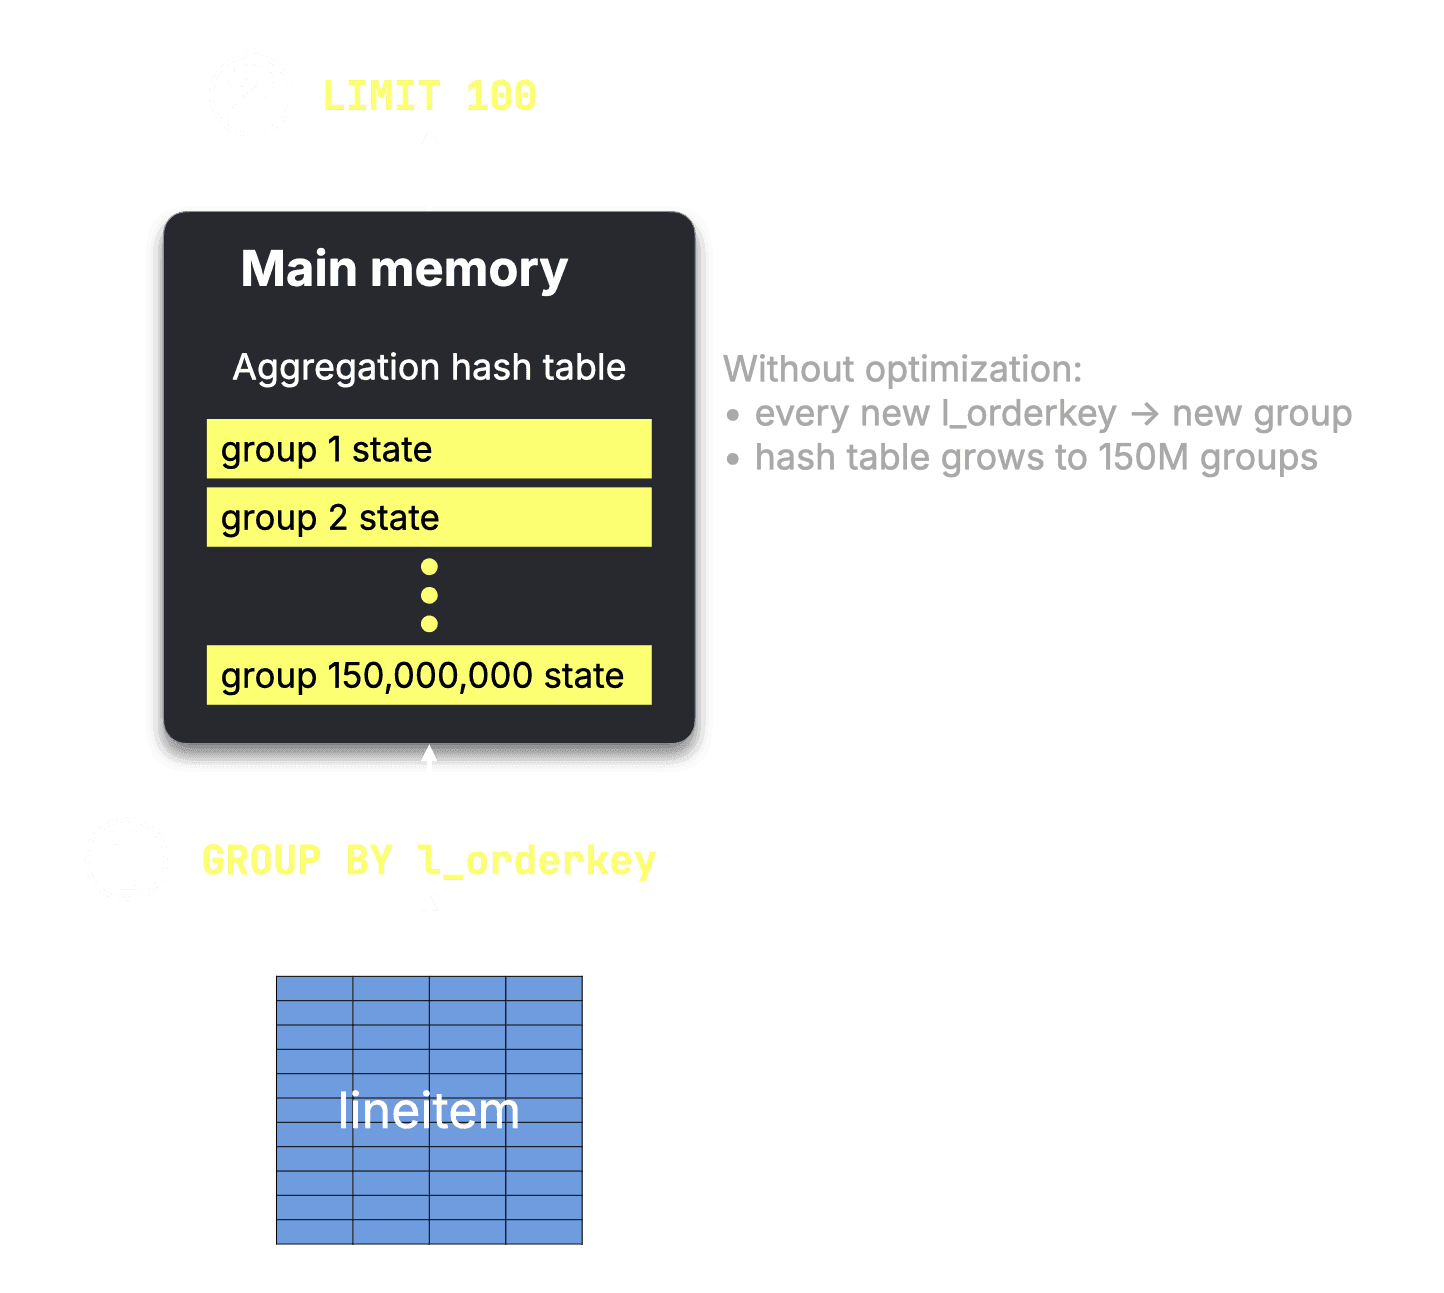
今回のリリースにより、ClickHouse はこの特別なパターンを認識し、結果に影響を与えないグループの構築を回避します。この最適化は、デフォルトで有効になっている新しい optimize_trivial_group_by_limit_query 設定によって制御されます。
対象となるクエリに対して、ClickHouse は内部的に集約制限を LIMIT + OFFSET に設定し、group_by_overflow_mode = 'any' を使用します。実際には、集約ハッシュテーブルに最初の 100 個の重複しない l_orderkey 値が含まれると、新しいキーは新しいグループとして追加される代わりに無視されます。
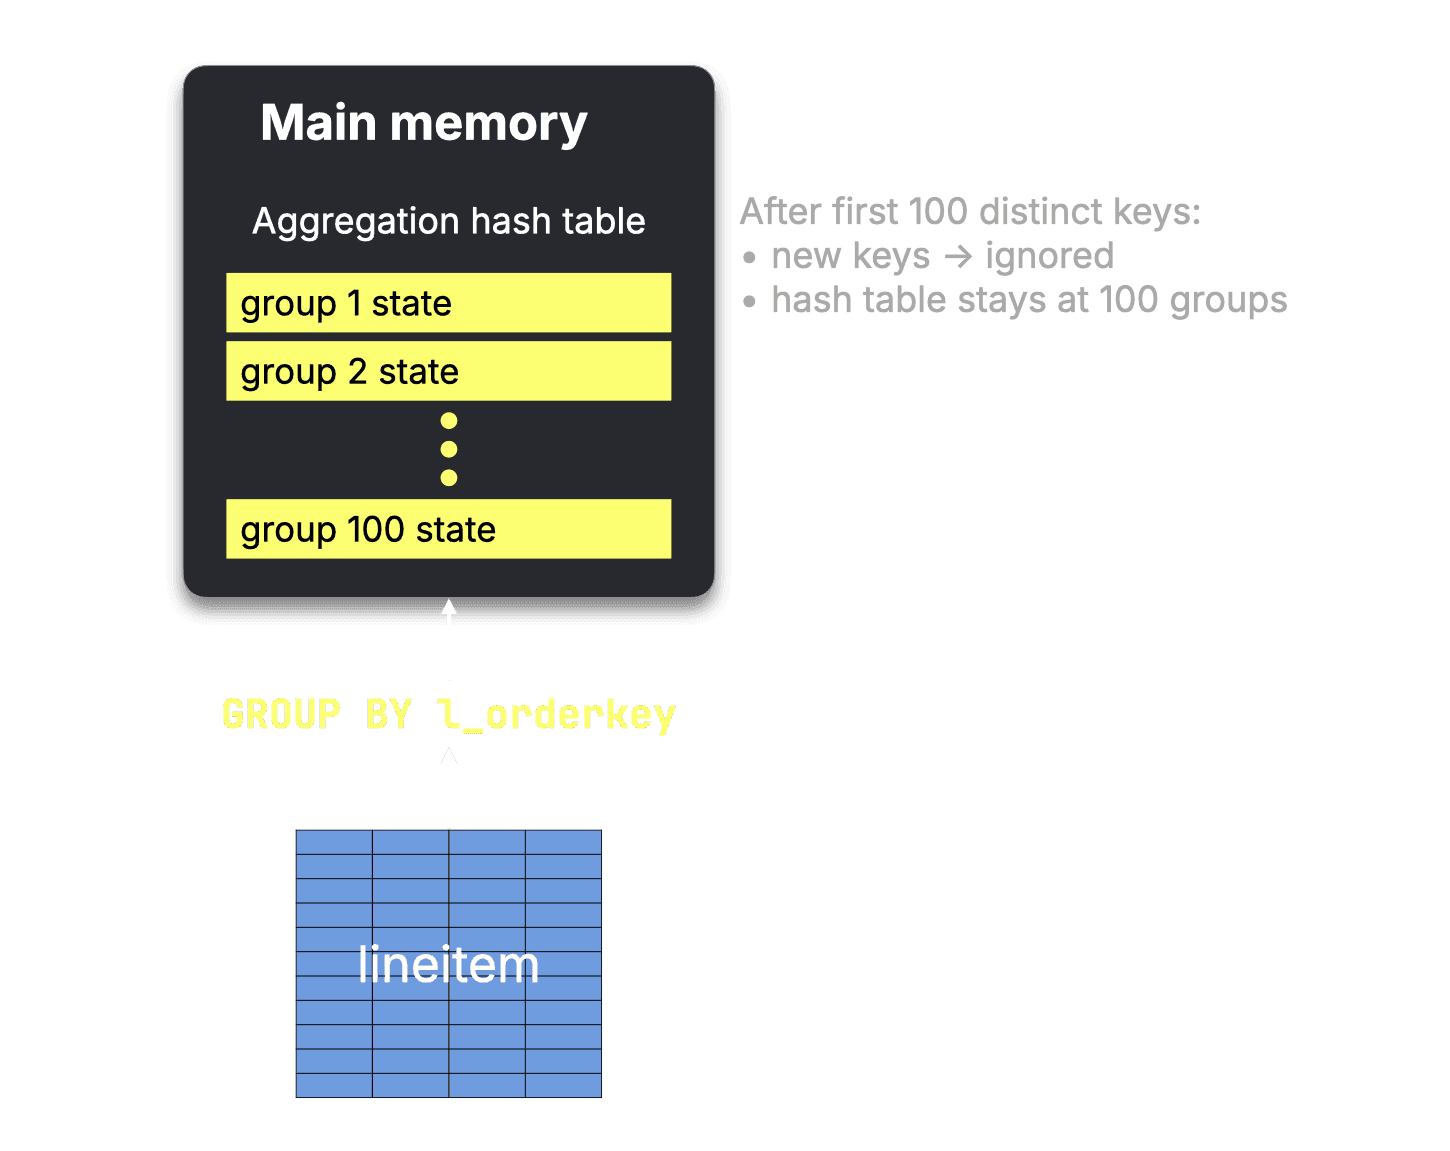
スキャン自体は入力を処理し続けますが、メインメモリ内の集約状態は極めて小さなまま保たれます。1 億 5,000 万個に向かって肥大化することなく、100 グループにとどまります。
ベンチマーク: 11.9 倍高速化、メモリ消費量は 185 分の 1
その効果を評価するため、32 vCPU と 128 GiB の RAM を備えた AWS EC2 m6i.8xlarge インスタンス上でクエリを再度実行しました。まず、optimize_trivial_group_by_limit_query = 0 を設定して最適化を無効にし、3 回の実行のうち最も速かったものをベースラインとして使用しました。
Elapsed: 0.853 sec. Processed 600.04 million rows, 2.40 GB (703.29 million rows/s., 2.81 GB/s.)
Peak memory usage: 8.60 GiB.
Elapsed: 0.806 sec. Processed 600.04 million rows, 2.40 GB (744.07 million rows/s., 2.98 GB/s.)
Peak memory usage: 8.58 GiB.
Elapsed: 0.809 sec. Processed 600.04 million rows, 2.40 GB (742.06 million rows/s., 2.97 GB/s.)
Peak memory usage: 8.57 GiB.次に、optimize_trivial_group_by_limit_query = 1 を設定して最適化を有効にし、同じクエリを実行しました。
Elapsed: 0.069 sec. Processed 600.04 million rows, 2.40 GB (8.76 billion rows/s., 35.03 GB/s.)
Peak memory usage: 47.54 MiB.
Elapsed: 0.070 sec. Processed 600.04 million rows, 2.40 GB (8.54 billion rows/s., 34.16 GB/s.)
Peak memory usage: 47.54 MiB.
Elapsed: 0.068 sec. Processed 600.04 million rows, 2.40 GB (8.79 billion rows/s., 35.17 GB/s.)
Peak memory usage: 47.55 MiB.各設定の最速の実行結果は次のとおりです。
| 設定 | 最速実行時間 | 処理行数 | 読み取りデータ量 | ピークメモリ |
|---|---|---|---|---|
| 最適化無効 | 0.806 秒 | 6 億 4 万行 | 2.40 GB | 8.58 GiB |
| 最適化有効 | 0.068 秒 | 6 億 4 万行 | 2.40 GB | 47.55 MiB |
| 改善度 | 11.9 倍高速 | 同等 | 同等 | メモリ約 185 分の 1 |
最適化されたクエリは 11.9 倍高速 であり、ピークメモリ使用量は 約 185 分の 1 に抑えられています。
filesystem テーブル関数
貢献者: Ilya Perstenev, Ilya Yatsishin, Alexey Milovidov
ClickHouse 25.6 では filesystem テーブル関数も導入され、ディレクトリをクエリ可能なテーブルとして一覧表示および分析できるようになりました。
filesystem によって公開される完全なスキーマは、ファイルシステムの内省に期待される項目を網羅しています。
DESCRIBE filesystem();┌─name──────────────┬─type───────────────────────────────────────────────┐
│ path │ String │
│ name │ String │
│ type │ Enum8('none' = 0, 'not_found' = 1, 'regular' = 2, ⋯│
│ size │ Nullable(UInt64) │
│ depth │ UInt16 │
│ modification_time │ Nullable(DateTime64(6)) │
│ is_symlink │ Bool │
│ content │ Nullable(String) │
│ owner_read │ Bool │
│ owner_write │ Bool │
│ owner_exec │ Bool │
│ group_read │ Bool │
│ group_write │ Bool │
│ group_exec │ Bool │
│ others_read │ Bool │
│ others_write │ Bool │
│ others_exec │ Bool │
│ set_gid │ Bool │
│ set_uid │ Bool │
│ sticky_bit │ Bool │
│ file │ String │
└───────────────────┴────────────────────────────────────────────────────┘clickhouse-local を使用して引数なしで呼び出すと、カレントディレクトリ内のファイルが一覧表示されます。
SELECT path, name FROM filesystem();┌─path──────────────────────────────────────────────┬─name──────────────────────┐
│ /Users/markhneedham/projects/release-posts/26.5 │ clickhouse │
│ /Users/markhneedham/projects/release-posts/26.5 │ .claude │
└───────────────────────────────────────────────────┴───────────────────────────┘この関数は、ClickHouse を起動したユーザーと同じファイルシステム領域へのアクセス権を持ちます。ClickHouse Server 経由で呼び出すと、user_files ディレクトリ内のファイルが一覧表示されます。
私のマシンには大きな動画ファイルがたくさんあり、それらを見つけるために普段は私 (というか Claude!) が大量の Unix コマンドを実行しなければなりませんでした。この新しい関数を使えば、以下のようなシンプルなクエリで済みます。
SELECT path, name, formatReadableSize(size), modification_time
FROM filesystem('/Users/markhneedham/projects/videos')
WHERE type = 'regular' AND name LIKE '%.braw'
ORDER BY size DESC
LIMIT 3
FORMAT Vertical;Row 1:
──────
path: /Users/markhneedham/projects/videos/20260212-Sample
name: A001_10150625_C183 2.braw
formatReadableSize(size): 26.75 GiB
modification_time: 2025-10-15 06:25:08.529999
Row 2:
──────
path: /Users/markhneedham/projects/videos/20260217-AsyncInserts
name: A001_09290151_C176.braw
formatReadableSize(size): 21.70 GiB
modification_time: 2025-09-29 01:51:47.820000
Row 3:
──────
path: /Users/markhneedham/projects/videos/20260123-PGCHStack
name: A001_08021314_C119.braw
formatReadableSize(size): 21.54 GiB
modification_time: 2025-08-02 13:14:33.260000そして、容量を空けるために削除すべきファイルをより素早く見つけられるよう、このクエリを Claude が使用できるスキルとしてまとめました。
url テーブル関数向けの url_base
貢献者: Alexey Milovidov
url テーブル関数を頻繁に使っている方なら、同じベース URL を何度も入力した経験があるはずです。新しい url_base 設定を使用すると、一度設定するだけで、以降はすべて相対パスを使用できるようになります。
Amazon カスタマーレビューデータセット を使用する場合、ベース URL を次のように設定できます。
SET url_base = 'https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/';これで、2014 年のレビューを次のようにクエリできます。
SELECT
count(),
round(avg(star_rating), 2) AS stars,
round(avg(helpful_votes), 2) AS votes
FROM url('amazon_reviews_2014.snappy.parquet')┌──count()─┬─stars─┬─votes─┐
│ 44127569 │ 4.23 │ 0.96 │
└──────────┴───────┴───────┘また、2015 年のデータをクエリしたい場合も同様です。
SELECT
count(),
round(avg(star_rating), 2) AS stars,
round(avg(helpful_votes), 2) AS votes
FROM url('amazon_reviews_2015.snappy.parquet')┌──count()─┬─stars─┬─votes─┐
│ 41905631 │ 4.25 │ 0.74 │
└──────────┴───────┴───────┘負の LIMIT BY
貢献者: Nihal Z. Miaji
26.5 リリースでは負の LIMIT BY も追加され、各グループの先頭からではなく末尾から行を取得できるようになりました。
動作を確認するために、お気に入りの 英国不動産価格データセット を使用します。まず、Yorkshire という文字列を含むすべてのカウンティについて、地区ごとの価格の中央値を求める次のクエリから始めます。
SELECT county, district, median(price)
FROM uk_price_paid
WHERE county ILIKE '%Yorkshire%'
GROUP BY ALL
ORDER BY median(price) DESC;┌─county───────────────────┬─district─────────────────┬─median(price)─┐
│ NORTH YORKSHIRE │ NORTH YORKSHIRE │ 263000 │
│ NORTH YORKSHIRE │ HARROGATE │ 185000 │
│ NORTH YORKSHIRE │ HAMBLETON │ 170000 │
│ NORTH YORKSHIRE │ RYEDALE │ 160000 │
│ NORTH YORKSHIRE │ RICHMONDSHIRE │ 150000 │
│ NORTH YORKSHIRE │ CRAVEN │ 149250 │
│ NORTH YORKSHIRE │ SELBY │ 144995 │
│ EAST RIDING OF YORKSHIRE │ EAST RIDING OF YORKSHIRE │ 132000 │
│ WEST YORKSHIRE │ LEEDS │ 129997 │
│ NORTH YORKSHIRE │ SCARBOROUGH │ 120000 │
│ SOUTH YORKSHIRE │ SHEFFIELD │ 115000 │
│ WEST YORKSHIRE │ KIRKLEES │ 114950 │
│ WEST YORKSHIRE │ WAKEFIELD │ 112997.5 │
│ SOUTH YORKSHIRE │ ROTHERHAM │ 102500 │
│ WEST YORKSHIRE │ CALDERDALE │ 101000 │
│ WEST YORKSHIRE │ BRADFORD │ 100000 │
│ SOUTH YORKSHIRE │ DONCASTER │ 98500 │
│ SOUTH YORKSHIRE │ BARNSLEY │ 95000 │
│ WEST YORKSHIRE │ EAST YORKSHIRE │ 94950 │
└──────────────────────────┴──────────────────────────┴───────────────┘これまでも、カウンティのグループごとに最初の 2 行、つまり各カウンティ内で価格の中央値が最も高い上位 2 地区を選択できました。
SELECT county, district, median(price)
FROM uk_price_paid
WHERE county ILIKE '%Yorkshire%'
GROUP BY ALL
ORDER BY median(price) DESC
LIMIT 2 BY county┌─county───────────────────┬─district─────────────────┬─median(price)─┐
│ NORTH YORKSHIRE │ NORTH YORKSHIRE │ 262000 │
│ NORTH YORKSHIRE │ HARROGATE │ 185000 │
│ EAST RIDING OF YORKSHIRE │ EAST RIDING OF YORKSHIRE │ 130972.5 │
│ WEST YORKSHIRE │ LEEDS │ 130000 │
│ WEST YORKSHIRE │ KIRKLEES │ 115000 │
│ SOUTH YORKSHIRE │ SHEFFIELD │ 115000 │
│ SOUTH YORKSHIRE │ ROTHERHAM │ 105000 │
└──────────────────────────┴──────────────────────────┴───────────────┘しかし、負の LIMIT BY を使うことで、カウンティのグループごとに最後の 2 行、すなわち各カウンティ内で価格の中央値が最も低い 2 地区を選択することも可能になりました。
SELECT county, district, median(price)
FROM uk_price_paid
WHERE county ILIKE '%Yorkshire%'
GROUP BY ALL
ORDER BY median(price) DESC
LIMIT -2 BY county;┌─county───────────────────┬─district─────────────────┬─median(price)─┐
│ NORTH YORKSHIRE │ SELBY │ 145000 │
│ EAST RIDING OF YORKSHIRE │ EAST RIDING OF YORKSHIRE │ 132500 │
│ NORTH YORKSHIRE │ SCARBOROUGH │ 122000 │
│ SOUTH YORKSHIRE │ DONCASTER │ 99000 │
│ WEST YORKSHIRE │ BRADFORD │ 97500 │
│ SOUTH YORKSHIRE │ BARNSLEY │ 94950 │
│ WEST YORKSHIRE │ EAST YORKSHIRE │ 94950 │
└──────────────────────────┴──────────────────────────┴───────────────┘マルチパス SQL/JSON
貢献者: Kevinyhzou, Alexey Milovidov
JSON_VALUE および JSON_QUERY 関数を使用する際、パスのタプルまたは配列を渡して文字列のタプルまたは配列を受け取れるようになり、JSON のパースが 1 回だけで済むようになりました。
新しい prettyPrintJSON 関数で出力した、Open House カンファレンスを表す JSON 文字列を使って試してみましょう。
WITH '{
"name": "Open House 2026",
"tagline": "The real-time database for AI conference",
"dates": {
"workshops": "2026-05-26",
"conference": ["2026-05-27", "2026-05-28"]
},
"venue": {
"name": "Convene 100 Stockton",
"address": "40 O''Farrell St, San Francisco, CA 94108"
}
}' AS conf
SELECT prettyPrintJSON(conf)
FORMAT Raw;{
"name": "Open House 2026",
"tagline": "The real-time database for AI conference",
"dates": {
"workshops": "2026-05-26",
"conference": [
"2026-05-27",
"2026-05-28"
]
},
"venue": {
"name": "Convene 100 Stockton",
"address": "40 O'Farrell St, San Francisco, CA 94108"
}
}
1 row in set. Elapsed: 0.003 sec.文字列を返す場合、たとえば名前と会場を含むタプルを返したいときは、JSON_VALUE 関数を使用します。
WITH '{
"name": "Open House 2026",
"tagline": "The real-time database for AI conference",
"dates": {
"workshops": "2026-05-26",
"conference": ["2026-05-27", "2026-05-28"]
},
"venue": {
"name": "Convene 100 Stockton",
"address": "40 O''Farrell St, San Francisco, CA 94108"
}
}' AS conf
SELECT JSON_VALUE(conf, ('$.name', '$.venue.name'));┌─JSON_VALUE(conf, ('$.name', '$.venue.name'))─┐
│ ('Open House 2026','Convene 100 Stockton') │
└──────────────────────────────────────────────┘JSON パスは、タプルではなく配列として渡すこともできます。
WITH '{
"name": "Open House 2026",
"tagline": "The real-time database for AI conference",
"dates": {
"workshops": "2026-05-26",
"conference": ["2026-05-27", "2026-05-28"]
},
"venue": {
"name": "Convene 100 Stockton",
"address": "40 O''Farrell St, San Francisco, CA 94108"
}
}' AS conf
SELECT JSON_VALUE(conf, ['$.name', '$.venue.name']);┌─JSON_VALUE(conf, ['$.name', '$.venue.name'])─┐
│ ['Open House 2026','Convene 100 Stockton'] │
└──────────────────────────────────────────────┘ただし、dates.conference は配列であるため、JSON_VALUE を使って取得しようとすると空文字列が返されます。
WITH '{
"name": "Open House 2026",
"tagline": "The real-time database for AI conference",
"dates": {
"workshops": "2026-05-26",
"conference": ["2026-05-27", "2026-05-28"]
},
"venue": {
"name": "Convene 100 Stockton",
"address": "40 O''Farrell St, San Francisco, CA 94108"
}
}' AS conf
SELECT JSON_VALUE(conf, ('$.name', '$.dates.conference'));┌─JSON_VALUE(c⋯nference'))─┐
│ ('Open House 2026','') │
└──────────────────────────┘0 始まりの配列インデックスを使用すれば、その配列から個々の値を読み取ることができます。
WITH '{
"name": "Open House 2026",
"tagline": "The real-time database for AI conference",
"dates": {
"workshops": "2026-05-26",
"conference": ["2026-05-27", "2026-05-28"]
},
"venue": {
"name": "Convene 100 Stockton",
"address": "40 O''Farrell St, San Francisco, CA 94108"
}
}' AS conf
SELECT JSON_VALUE(conf, ('$.dates.conference[0]', '$.dates.conference[1]'));┌─JSON_VALUE(co⋯ference[1]'))─┐
│ ('2026-05-27','2026-05-28') │
└─────────────────────────────┘あるいは、日程を配列として、会場全体をオブジェクトとして返したい場合は、代わりに JSON_QUERY を使用する必要があります。
WITH '{
"name": "Open House 2026",
"tagline": "The real-time database for AI conference",
"dates": {
"workshops": "2026-05-26",
"conference": ["2026-05-27", "2026-05-28"]
},
"venue": {
"name": "Convene 100 Stockton",
"address": "40 O''Farrell St, San Francisco, CA 94108"
}
}' AS conf
SELECT JSON_QUERY(conf, ('$.dates.conference', '$.venue'))
FORMAT Raw;読みやすくフォーマットした出力を以下に示します。
(
'[["2026-05-27","2026-05-28"]]',
'[{"name":"Convene 100 Stockton","address":"40 O\'Farrell St, San Francisco, CA 94108"}]'
)JSON_QUERY は常に結果を [] で囲むため、配列の値は二重にラップされる点に注意してください。
Web ターミナル
貢献者: Alexey Milovidov
26.5 リリースでは、ブラウザ内で動作する実験的な clickhouse-client も導入されました。設定ファイルに以下を追加することで有効にできます。
config.d/webterminal.yaml
allow_experimental_webterminal: trueその後、http://localhost:8123/webterminal にアクセスすると、次のような画面が表示されます。
サブクエリのクエリキャッシュ
貢献者: Nikita Barannik, Vincent Voyer
サブクエリ単位でクエリキャッシュを制御できるようになりました。
これまでも、最も外側のクエリに対しては use_query_cache 設定を使用して次のようにクエリキャッシュを有効にできました。
SELECT * FROM (SELECT * FROM table)
SETTINGS use_query_cache = 1;サブクエリに対してクエリキャッシュを有効にしたい場合、26.5 からはその設定をサブクエリの末尾に付加できます。
SELECT *
FROM (
SELECT *
FROM table
SETTINGS use_query_cache = 1
);また、use_query_cache_for_subqueries 設定を使用して、すべてのサブクエリへのクエリキャッシュの伝播を有効にすることもできます。
SELECT * FROM (SELECT * FROM table)
SETTINGS use_query_cache_for_subqueries = 1;あるいは、すべてのサブクエリへのクエリキャッシュの伝播を有効にしつつ、そのうちの 1 つだけ無効にすることも可能です。
SELECT *
FROM (SELECT * FROM table1) t1
NATURAL JOIN (SELECT * FROM table2 SETTINGS use_query_cache = 0) t2
SETTINGS use_query_cache_for_subqueries = 1;