5万

また1か月が経ち、新たなリリースの時期がやってきました。
ClickHouse Winter Release には、25 件の新機能 🧤 43 件のパフォーマンス最適化 🛷 183 件のバグ修正が含まれています ⛄
本リリースでは、テキストインデックスと QBit データ型が本番環境で利用可能になりました。また、「無制限」の挿入を時間基準でバッチ処理できるようになり、JOIN、JSON パース、min-max インデックスを使用した挿入のパフォーマンスも向上しています。
新規コントリビューター
26.2 の新規コントリビューターの皆さんを心から歓迎します。ClickHouse コミュニティの成長にはいつも身が引き締まる思いであり、ClickHouse がここまで広く使われるようになった原動力である貢献の数々に、深く感謝しています。
新規コントリビューターの皆様のお名前は以下のとおりです。
4ertus2,Aaron Knudtson,AlyHKafoury,Andre Hora,Andrey Tarasov,Ashwath,Ben Wu,Christoph Viebig,Dan McCombs,Dmitry Kovalev,Dmitry Plotnikov,Federico Ginosa,Gerald Latkovic,Hasyimi Bahrudin,Ivan Gorin,Kien Nguyen Tuan,Mostafa Mohamed Salah,MyeongjunKim,Padraic Slattery,Rahul,Raquel Barbadillo,Visakh Unnikrishnan,daun-gatal,dimbo4ka,dk-github,jayvenn21,murphy-4o,phulv94,sunyeongchoi,vanchaklar,Álvaro Niño
ヒント: このリストをどのように生成しているか気になる方は、こちらをご覧ください。
プレゼンテーションのスライドもご覧いただけます。
「無制限」挿入の時間基準バッチ処理
Mostafa Mohamed Salah による貢献
私が気に入っているリアルタイムデータセットの1つに、Wikimedia の最近の更新フィードがあります。これは、Wikimedia の各種プロパティにおける変更をストリーミング配信するものです。
動作を確認するには、https://stream.wikimedia.org/v2/stream/recentchange にアクセスしてみてください。イベントの例を以下に示します。
event: message
id: [{"topic":"eqiad.mediawiki.recentchange","partition":0,"offset":-1},{"topic":"codfw.mediawiki.recentchange","partition":0,"timestamp":1772536525049}]
data: {"$schema":"/mediawiki/recentchange/1.0.0","meta":{"uri":"https://commons.wikimedia.org/wiki/Category:Taken_with_Nikon_D3100","request_id":"55711a7f-6053-4592-97c4-45d54e6319f7","id":"9106b913-64f9-4dff-a325-ac43492cc81d","domain":"commons.wikimedia.org","stream":"mediawiki.recentchange","dt":"2026-03-03T11:15:25.048Z","topic":"codfw.mediawiki.recentchange","partition":0,"offset":2029032842},"id":3219900521,"type":"categorize","namespace":14,"title":"Category:Taken with Nikon D3100","title_url":"https://commons.wikimedia.org/wiki/Category:Taken_with_Nikon_D3100","comment":"[[:File:Ferrari 550 Maranello - Flickr - Alexandre Prévot (3).jpg]] added to category","timestamp":1772536523,"user":"Rkieferbot","bot":true,"notify_url":"https://commons.wikimedia.org/w/index.php?diff=1175166536&oldid=1019467923&rcid=3219900521","server_url":"https://commons.wikimedia.org","server_name":"commons.wikimedia.org","server_script_path":"/w","wiki":"commonswiki","parsedcomment":"File:Ferrari 550 Maranello - Flickr - Alexandre Prévot (3).jpg added to category"}各イベントには次のプロパティがあります。
event- イベントタイプ。ほぼ常にmessageです。id- イベントの識別子。data- 変更自体を表す JSON オブジェクト。
ターミナルで cURL を使用して、各イベントの data 部分のみをストリーミングできます。
curl -sS --globoff \
-H 'Accept: application/json' \
--no-buffer \
"https://stream.wikimedia.org/v2/stream/recentchange"このデータを ClickHouse にロードするには、まずテーブルを作成する必要があります。データを個々のカラムに分割することもできますが、ここでは JSON データ型を試す絶好の機会です。
CREATE table wiki (
json JSON
);続いて cURL コマンドを更新し、データをストリーミングで流し込みます。
curl -sS --globoff \
-H 'Accept: application/json' \
--no-buffer \
"https://stream.wikimedia.org/v2/stream/recentchange" |
./clickhouse client --query="INSERT INTO wiki FORMAT JSONAsObject"別のタブを開いて ClickHouse サーバーに接続してみると、データがまったく取り込まれていないことがわかります。これは、min_insert_block_size_rows と min_insert_block_size_bytes のデフォルト値がそれぞれ 1,000,000 行と 268 MB に設定されているためです。Wikimedia の変更データセットは毎秒 10 行ほどしか生成されないため、相当な時間待つことになります。
この問題を回避するために、これらのパラメータを小さい値に設定できます。設定方法は以下の動画で紹介しています。
この方法でも動作しますが、データがどの頻度でテーブルにフラッシュされるかがわかりません。ClickHouse 26.2 では、ブロックのフラッシュ間隔をサイズではなく時間で定義できる新しい設定 input_format_max_block_wait_ms が導入されました。この設定は、input_format_connection_handling と併用した場合にのみ機能します。後者を有効にすると、接続が予期せず切断された場合でも、バッファ内に残っているデータがエラーとして扱われず、パースされて処理されます。
したがって、3 秒ごとにデータを取り込みたい場合は、取り込みコードを以下のように更新できます。
curl -sS --globoff \
-H 'Accept: application/json' \
--no-buffer \
"https://stream.wikimedia.org/v2/stream/recentchange" |
./clickhouse client --query="INSERT INTO wiki FORMAT JSONAsObject" --min_insert_block_size_rows=0 \
--min_insert_block_size_bytes=0 \
--input_format_max_block_wait_ms 3000 \
--input_format_connection_handling 1別のタブで、クエリの実行ごとに 1 秒スリープしながら、取り込まれたレコード数を確認できます。
while true; do
./clickhouse client "SELECT now(), count() FROM wiki FORMAT TabSeparated"
sleep 1
done以下のような出力が表示され、およそ 3 行ごとに行数が更新されることが確認できます。
2026-03-03 11:47:11 13898
2026-03-03 11:47:12 13898
2026-03-03 11:47:13 14008
2026-03-03 11:47:14 14008
2026-03-03 11:47:15 14008
2026-03-03 11:47:17 14128
2026-03-03 11:47:18 14128
2026-03-03 11:47:19 14128
2026-03-03 11:47:20 14213下のアニメーションは、input_format_max_block_wait_ms 設定の仕組みを示しています。 この設定は、サーバーが受信データを処理する際に構築するインメモリブロックに対して、時間基準のフラッシュ間隔を定義します。タイムアウトに達すると、現在のブロックが新しいデータパートに書き込まれ、挿入された行がクエリから参照できるようになります。
ClickStack の組み込み
ClickStack は、ログ、トレース、メトリクス、セッションを単一の高性能なソリューションに統合するオブザーバビリティプラットフォームです。ClickHouse、OpenTelemetry、ClickStack UI(旧称 HyperDX)で構成されています。
ClickHouse 26.2 より前では、ClickStack を利用するには、Docker コンテナを立ち上げるか、Managed ClickStack を利用するかの 2 つの選択肢がありました。
ClickHouse 26.2 からは、新たな配布方式として、ClickHouse に組み込まれた ClickStack UI を導入します。ClickStack UI が ClickHouse のバイナリに直接組み込まれて配布されるようになり、ClickHouse を使ったオブザーバビリティデータの探索がこれまでになく容易になりました。https://localhost:8123 にアクセスし、「ClickStack」を選択するだけで探索を開始できます。
詳細は ClickHouse に組み込まれた ClickStack のご紹介をご覧ください。
本番対応:テキストインデックスと QBit データ型
テキストインデックスは 2022 年から開発が進められ、ClickHouse 25.9 で実験的ステータスとなり、ClickHouse 25.12 でベータ版になりました。ClickHouse 26.2 でテキストインデックスが本番対応(production-ready)となりましたので、ぜひお試しいただき、フィードバックをお寄せください。
テキストインデックスとともに本番対応となったのが、検索精度のランタイム調整を可能にするベクトル埋め込み向けの QBit データ型です。ClickHouse 25.10 で導入され、26.1 でベータ版へ昇格した QBit は、26.2 で完全に本番対応となりました。
テーブル関数 primes
Nihal Miaji 氏による貢献
ClickHouse 26.2 リリースでは、新しい system.primes テーブルも導入されています。名前のとおり、このテーブルは素数を返します。
以下のクエリは、最初の 10 個の素数、それらの素数の合計、そして 10 番目の素数を返します。
SELECT groupArray(prime), max(prime), sum(prime)
FROM primes(10);Row 1:
──────
groupArray(prime): [2,3,5,7,11,13,17,19,23,29]
max(prime): 29
sum(prime): 129この関数は非常に高速です。以下のクエリは、最初の 10 億個の素数の最小値、最大値、合計を計算します。
SELECT min(prime), max(prime), sum(prime)
FROM primes(1000000000);┌─min(prime)─┬──max(prime)─┬───────────sum(prime)─┐
│ 2 │ 22801763489 │ 11138479445180240497 │
└────────────┴─────────────┴──────────────────────┘
1 row in set. Elapsed: 36.444 sec. Processed 1.00 billion rows, 8.00 GB (27.44 million rows/s., 219.51 MB/s.)
Peak memory usage: 348.15 KiB.そして、かかった時間はわずか 36 秒強でした! 🤯
円周率の日(Pi Day)から数日経ちましたが、バーゼル問題に対するオイラーの解が素数と π を結びつけていることをご存じでしょうか。オイラーは ∑ 1/n² = π²/6 を証明し、これはすべての素数にわたる無限乗積としても表現できます。ClickHouse の primes テーブル関数を使って、これを近似できます。
SELECT sqrt(6 * exp(sum(log(pow(prime, 2) / (pow(prime, 2) - 1)))))
FROM primes(10000000)┌─sqrt(multipl⋯), 1)))))))─┐
│ 3.141592653079655 │
└──────────────────────────┘
1 row in set. Elapsed: 0.415 sec. Processed 10.00 million rows, 80.00 MB (24.10 million rows/s., 192.78 MB/s.)
Peak memory usage: 141.38 KiB.RIGHT JOIN および FULL JOIN の高速化
Yarik Briukhovetskyi 氏による貢献
本リリースでは、ClickHouse がサポートする多くの結合タイプのうち、RIGHT OUTER JOIN と FULL OUTER JOIN のパフォーマンスが向上しています。
おさらいとして、左テーブルと右テーブルを結合する場合を考えます。
SELECT...
FROM left_table JOIN right_table ON ...RIGHT OUTER JOIN では、左側に一致するものがない right_table の行も返され、左テーブルのカラムにはデフォルト値が埋められます。
FULL OUTER JOIN では、両方のテーブルから一致しなかった行が返され、不足しているカラムにはそれぞれの側でデフォルト値が埋められます。
これらの結合タイプは内部結合や左外部結合に比べて追加の処理が必要となるため、本リリースにおける最適化を理解するには、まず ClickHouse が内部でどのように結合を実行しているかを見る必要があります。
ClickHouse における結合パイプライン
ClickHouse は、デフォルトで並列ハッシュ結合アルゴリズムを使用して結合を実行します。その物理クエリプラン(「クエリパイプライン」)の概要は以下のとおりです。
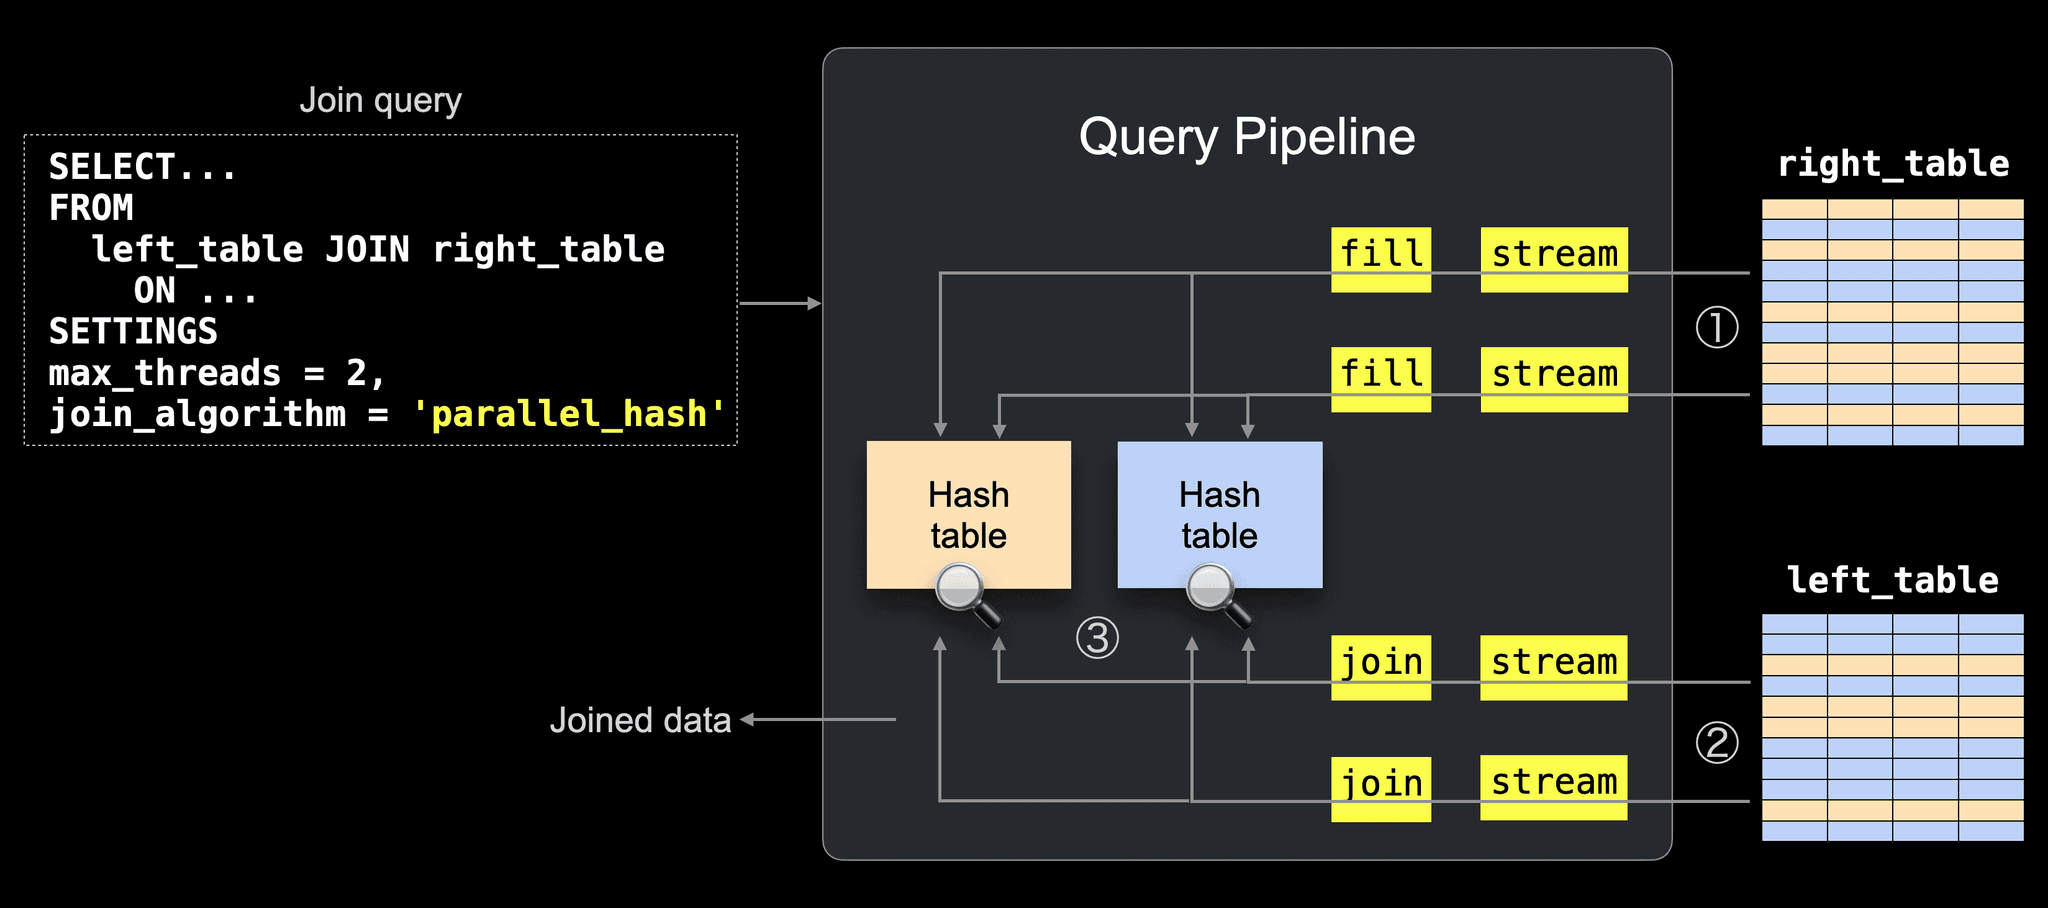
① 右テーブルは N 個のバケットに分割され、N 個のスレッドによって並列処理されます(N = max_threads、デフォルトでは CPU コア数、この例では 2)。バケットごとに 1 つのインメモリハッシュテーブルが構築されます。
② 左テーブルも同様に分割されて並列処理されるため、一致する行は対応するハッシュテーブルに到達します。
③ 一致するハッシュテーブルを探索(プローブ)して行を結合し、最終結果を生成します。
この実行モデルを念頭に置くと、さまざまな OUTER JOIN タイプの動作が理解しやすくなります。
LEFT OUTER JOIN のコストが低い理由
LEFT OUTER JOIN では、一致しなかった行はパイプライン内で自然に取得できます。
左テーブルのすべての行がストリーミングされ(②)、ハッシュテーブルに対して探索されます(③)。
一致するものが見つからない場合、その行は右テーブルのカラムにデフォルト値を入れて直ちに出力できます。
RIGHT / FULL OUTER JOIN がより難しい理由
RIGHT OUTER JOIN と FULL OUTER JOIN では状況が異なります。
これらの結合では、左側のどの行にも一致しなかった右テーブルの行も返す必要があります。
しかし、右テーブルはハッシュテーブルの構築時(①)にすでに消費されているため、それらの行はメインのパイプラインフローでは見えなくなっています。
最終結果を生成するために、ClickHouse は右テーブルのデータを反復処理して、一致しなかった行を生成しなければなりません。
一致しなかった行の並列生成(26.2)
従来、この後処理ステップはシングルスレッドで実行されていました。
26.2 からは、右テーブルの一致しなかった行が、右テーブルのバケットごとに 1 スレッドを使用して並列に生成されます。
これは、新しい parallel_non_joined_rows_processing 設定(デフォルトで有効)によって制御されます。
パフォーマンスの向上
その効果を示すため、gp3 EBS ボリュームを備えた AWS m6i.8xlarge インスタンス(32 コア、128 GB RAM)にロードした匿名化された Web アナリティクスデータセットを使用します。
以下のクエリは、ページ間の遷移や入口・出口の訪問を含む、ユーザーのナビゲーションステップをカウントする FULL OUTER 自己結合を実行します。
SELECT count()
FROM hits AS t1
FULL JOIN hits AS t2
ON t1.URL = t2.Referer
AND t1.UserID = t2.UserID
AND t1.URL != ''
AND t2.Referer != '';まず、以前のリリースの挙動を再現するため、parallel_non_joined_rows_processing = 0 で同じクエリを 3 回実行します。
以下は clickhouse-client が出力した実行統計です。
1 row in set. Elapsed: 35.367 sec. Processed 199.99 million rows, 17.91 GB (5.65 million rows/s., 506.30 MB/s.)
Peak memory usage: 19.53 GiB.
1 row in set. Elapsed: 35.128 sec. Processed 199.99 million rows, 17.91 GB (5.69 million rows/s., 509.74 MB/s.)
Peak memory usage: 19.53 GiB.
1 row in set. Elapsed: 35.538 sec. Processed 199.99 million rows, 17.91 GB (5.63 million rows/s., 503.86 MB/s.)
Peak memory usage: 19.53 GiB.次に、parallel_non_joined_rows_processing = 1(デフォルト設定)で同じクエリを 3 回実行します。
1 row in set. Elapsed: 11.226 sec. Processed 299.98 million rows, 18.11 GB (26.72 million rows/s., 1.61 GB/s.)
Peak memory usage: 19.66 GiB.
1 row in set. Elapsed: 11.133 sec. Processed 299.98 million rows, 18.11 GB (26.94 million rows/s., 1.63 GB/s.)
Peak memory usage: 19.64 GiB.
1 row in set. Elapsed: 11.210 sec. Processed 299.98 million rows, 18.11 GB (26.76 million rows/s., 1.62 GB/s.)
Peak memory usage: 19.67 GiB.実行時間は約 35 秒から約 11 秒に短縮され、3.2 倍の高速化となりました。
その他のパフォーマンス向上
Pavel Kruglov 氏および Raúl Marín 氏による貢献
高速化されたのは OUTER JOIN だけではありません。
本リリースには、JSON パース、uniq の計算、minmax インデックス作成の最適化も含まれています。
JSON パースの高速化
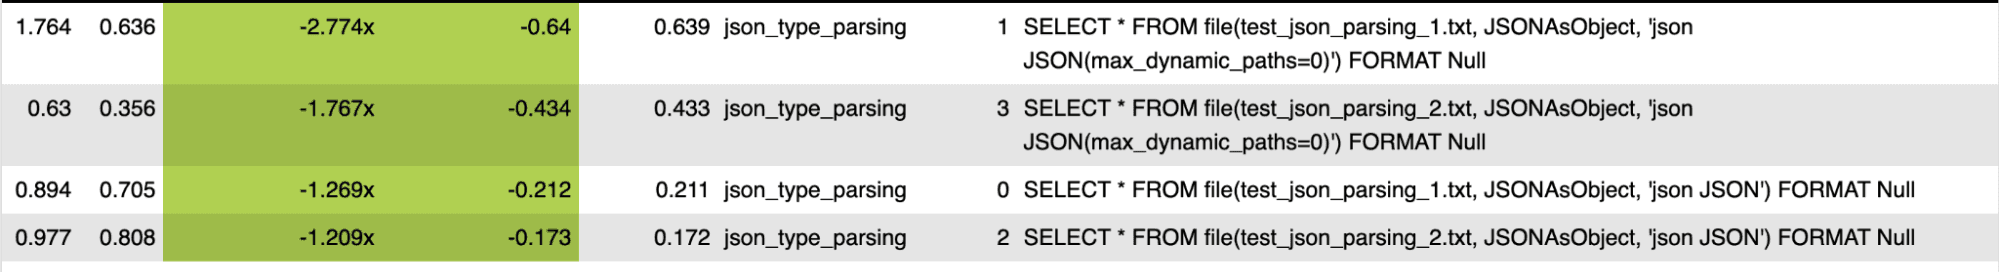
JSON データ型のパースが最適化されました。
PR のテストスクリーンショットの各バーは旧バージョンと新バージョンのパフォーマンスを比較しており、およそ 1.2 倍〜 2.8 倍の高速化を示しています。
uniq 計算の高速化
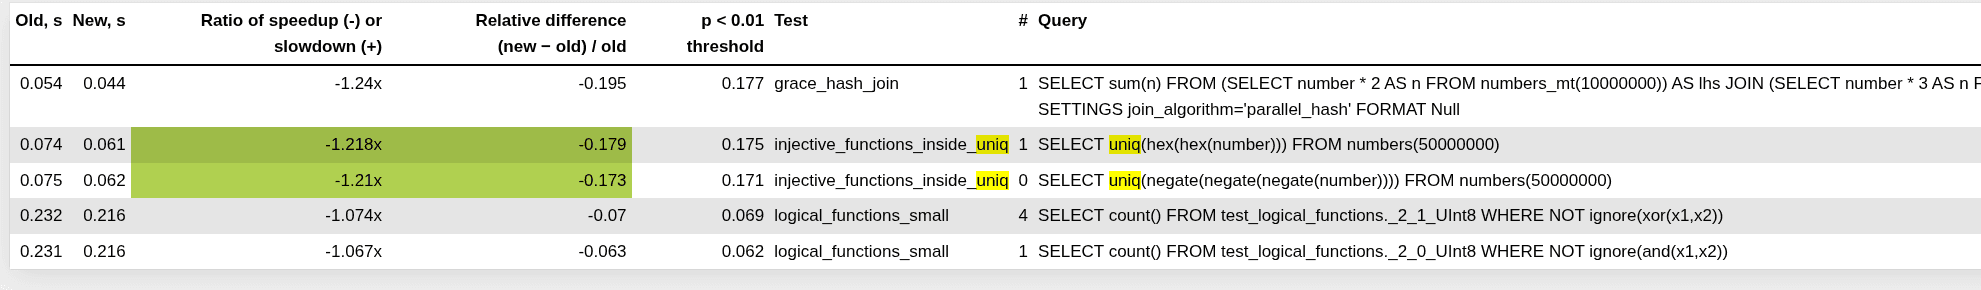
GROUP BY のないクエリにおいて、数値型に対する uniq で可能な場合に挿入のバッチ処理が行われるようになり、CPU オーバーヘッドが削減されてパフォーマンスが向上しました。
PR のパフォーマンステストでは一貫した改善が見られ、約 1.15 倍の高速化が示されています。
minmax インデックス適用時の INSERT の高速化
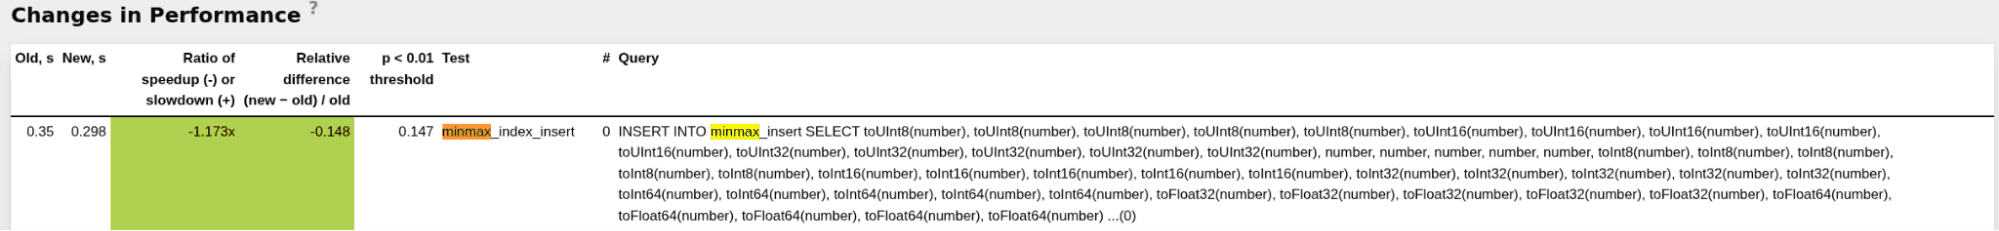
INSERT 時の minmax インデックス計算がより効率的になり、不要なデータコピーが排除され、数値カラムに対する min/max 値のベクトル化計算が使われるようになりました。これにより、インデックス付きカラムが多数存在する場合の挿入レイテンシが短縮されます。
PR のパフォーマンステストでは、minmax インデックスを持つテーブルへの挿入が約 1.2 倍高速化されたことが示されています。
minmax インデックスに関して言えば、本リリースでは使い勝手も向上しています。
minmax インデックスの自動有効化
Michael Jarrett 氏による貢献
本リリースでは、時間関連カラムに対してテーブルレベルで minmax インデックスを自動的に有効化する、よりシンプルな方法が導入されました。
minmax インデックスは、スパースなプライマリインデックスや軽量なプロジェクションと並び、インデックス付きカラムでフィルタリングするクエリにおいて ClickHouse が早期にデータをプルーニング(不要データの刈り取り)するために使用する主要メカニズムの 1 つです。
構文を見る前に、ClickHouse でのプルーニングの仕組みと minmax インデックスの位置づけを簡単におさらいしましょう。
ClickHouse におけるプルーニングのおさらい
最も高速な分析クエリとは、読み込むデータ量が最も少ないクエリです。
分析ワークロードでは通常、連続した範囲の行をフィルタリングしてから結果を集約するため、パフォーマンスは可能な限り多くのデータをスキップできるかどうかに依存します。
ClickHouse は、下図の C1 のようにデータを主キー順にソートして保存し、行をグラニュール(g1〜g4)に編成することでこれを実現しています。グラニュールは ClickHouse における最小の処理単位であり、デフォルトでそれぞれ 8,192 行をカバーします(図ではわかりやすくするため、グラニュールあたり 3 行のみで示しています)。
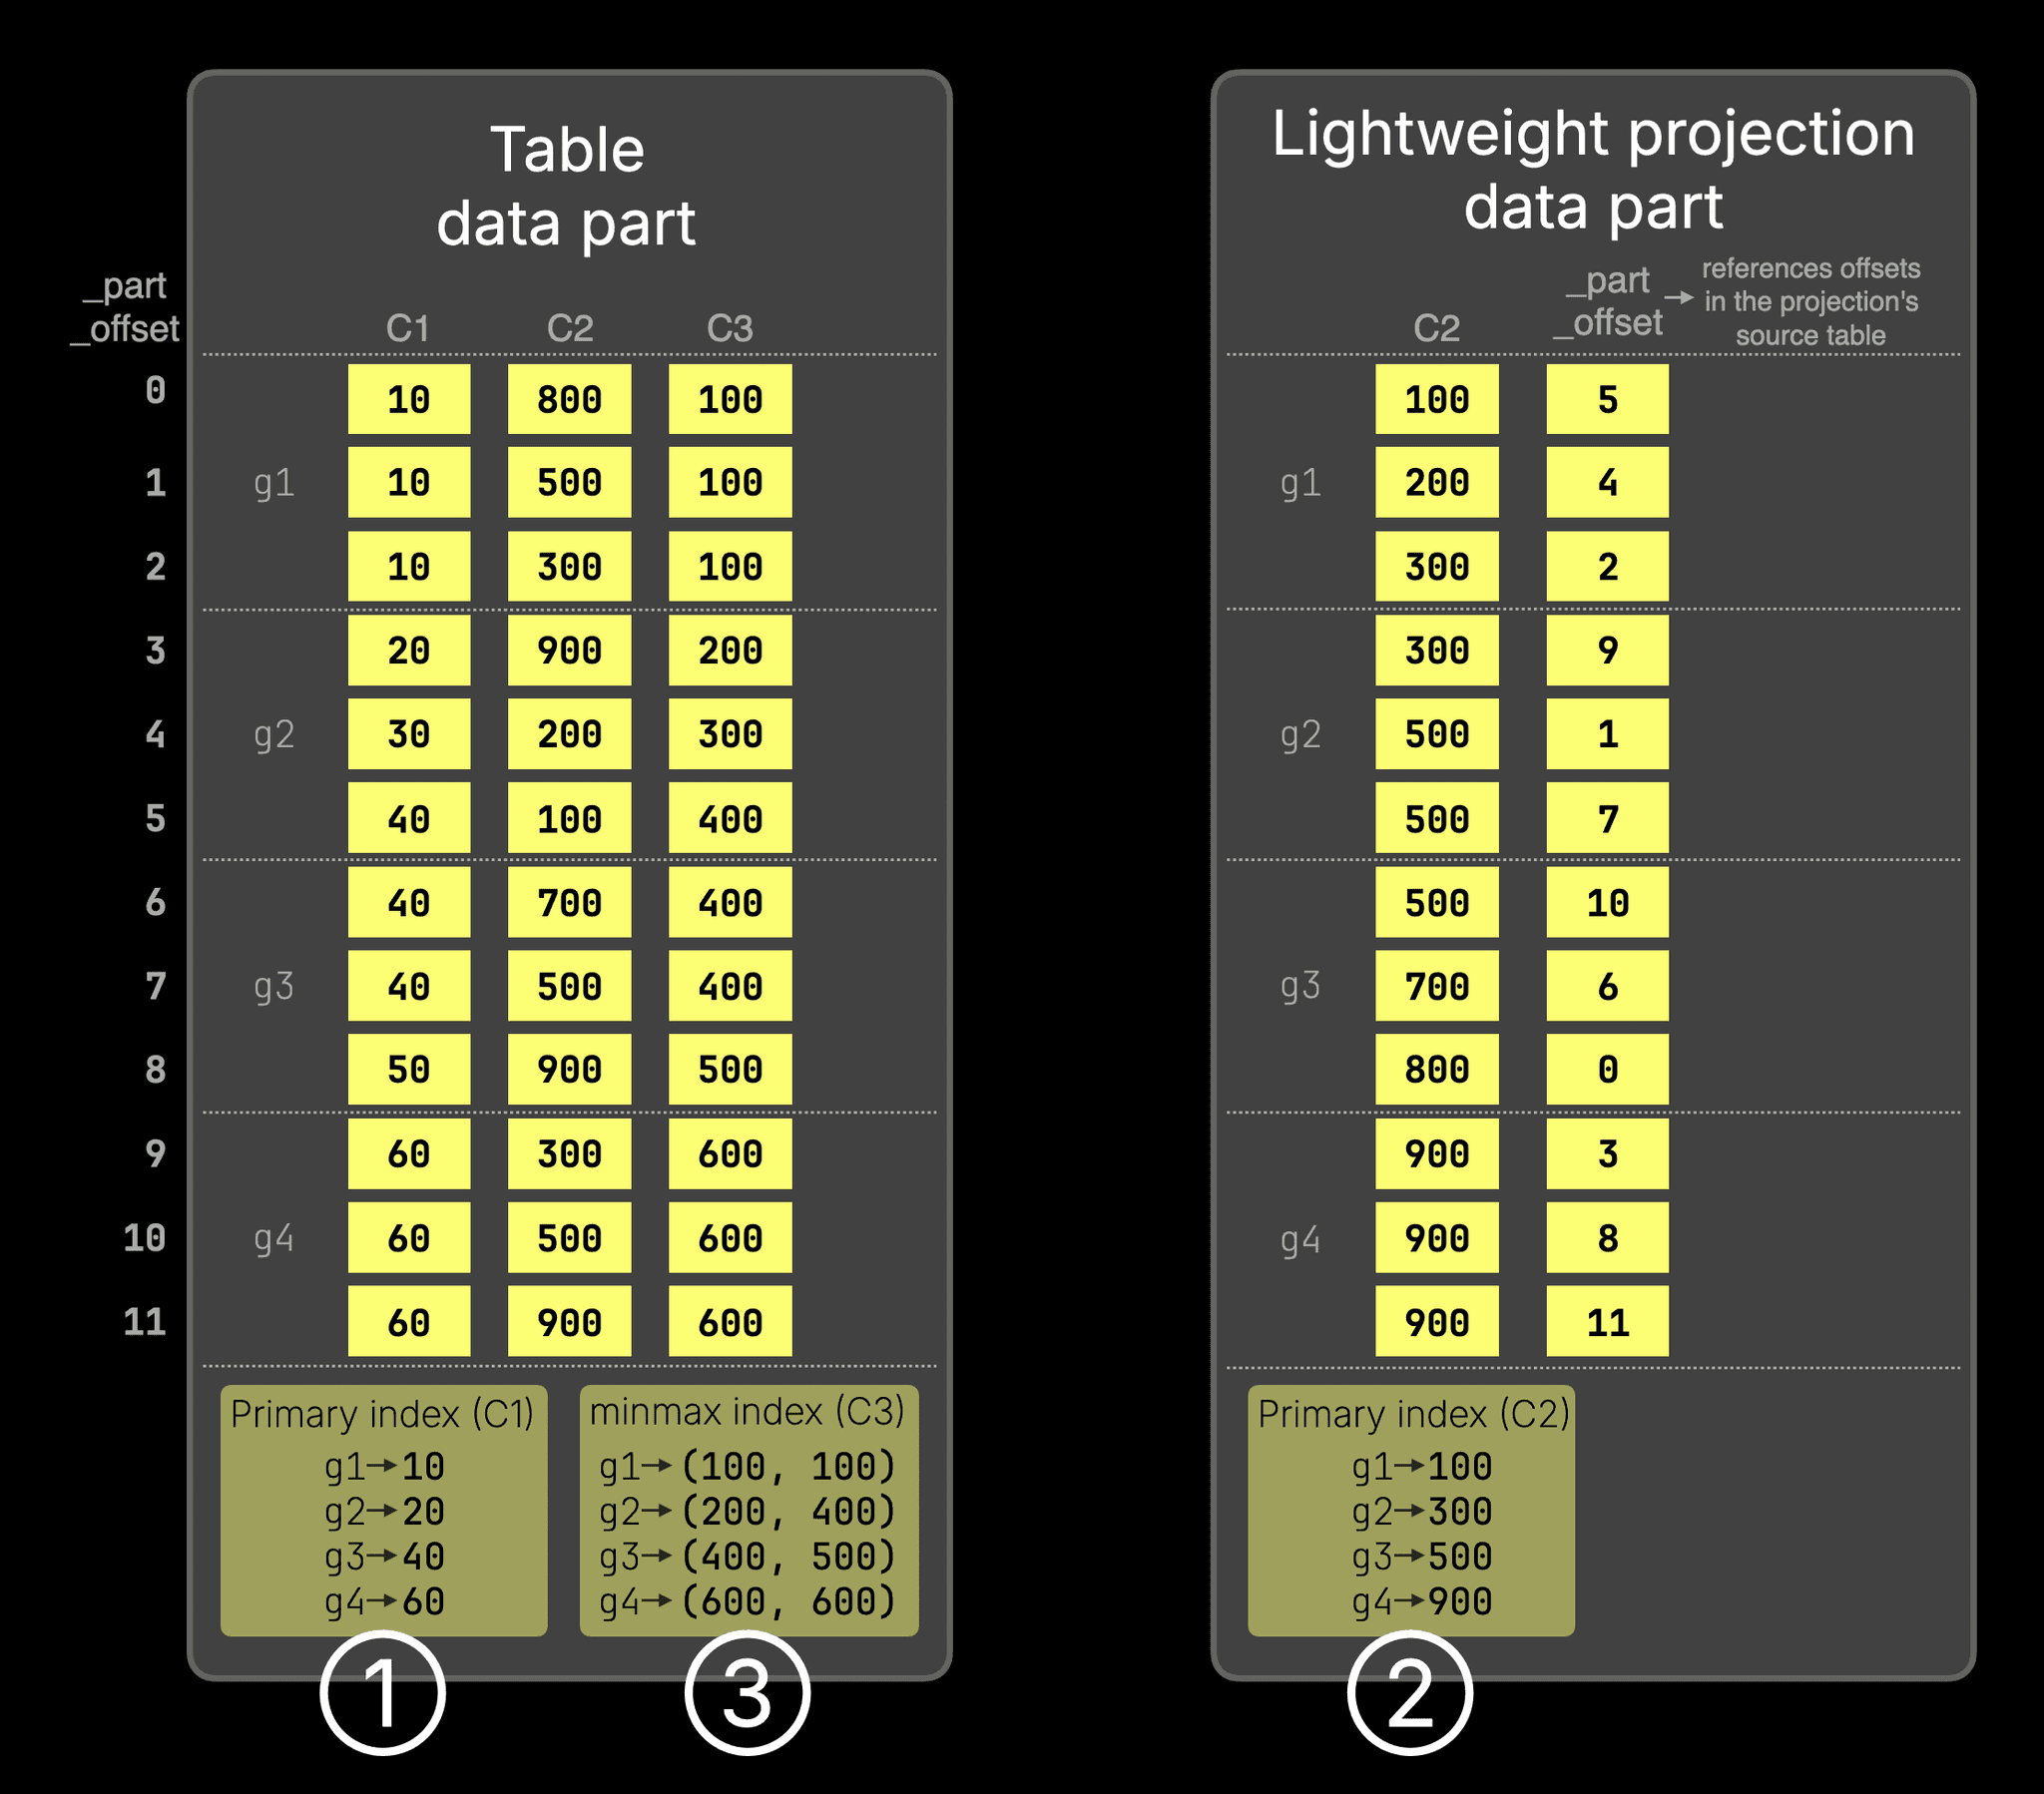
このグラニュール構造に基づき、ClickHouse はさまざまなプルーニング技術を適用して、インデックス付きカラムでフィルタリングするクエリに対してグラニュール全体をスキップできます。
① プライマリインデックス
プライマリインデックス(①)は、各グラニュールの最初の主キーカラム値を格納し、主キーに対するフィルタ条件に基づいて、グラニュールを読み込む前に丸ごとスキップできるようにします。
たとえば WHERE C1 > 60 の場合、インデックスを使用してグラニュール g1 と g2 がプルーニングされるため、残りのデータのみが読み込まれます。
② 軽量プロジェクション
WHERE C2 > 900 のように主キーの一部ではないカラムに対するフィルタの場合、ClickHouse は軽量プロジェクションを使用できます。これはソートされたプロジェクションキー(C2)の値に加えて _part_offset の値を保存し、独自のプライマリインデックス(②)を提供することで、プロジェクションキーに対するフィルタでグラニュールをプルーニングできるようにします。
③ minmax インデックス
ただし、軽量プロジェクションであっても、プロジェクションキーのカラム値がディスク上で重複することになります。
フィルタ対象のカラム(たとえば C3)が主キーの並び順と相関している場合、ClickHouse はプロジェクションの代わりに minmax インデックスを使用してグラニュールをプルーニングできます。
上図では、minmax インデックス(③)がグラニュールごとに C3 の最小値と最大値を記録しています。
WHERE C3 > 600 のようなフィルタの場合、グラニュール g1〜g3 は最大値が 600 未満であるためスキップでき、g4 のみを読み込めば済みます。
この同じ minmax メタデータは、SELECT * FROM T ORDER BY C3 DESC LIMIT 3 のような Top-N クエリの高速化にも利用でき、結果に影響を与えないグラニュールを ClickHouse がスキップできるようにします。
minmax インデックスの自動有効化
minmax インデックスは非常に有用であるため、ClickHouse にはカラムごとに手動で定義することなく、特定のカラム種別全体に対して自動的に有効化するシンプルな方法が用意されています。
バージョン 25.1 では、以下の MergeTree テーブル設定が導入されました。
• add_minmax_index_for_numeric_columns
• add_minmax_index_for_string_columns
バージョン 26.2 では、以下の設定によってこれが時間関連カラム(Date / DateTime / Time 型)にも拡張されました。
• add_minmax_index_for_temporal_columns
例:
CREATE TABLE pageviews (
event_time DateTime,
...
)
SETTINGS add_minmax_index_for_temporal_columns = 1;event_time は時間関連カラムであるため、この設定を有効にすると、ClickHouse は明示的なインデックス定義を必要とせずに、自動的に minmax インデックスを作成します。
このアプローチにはいくつかの利点があります。
- どのカラムに minmax インデックスを持たせるべきか考える必要がない
- カラムごとに手動でインデックスを定義する必要がない
- minmax インデックスはコンパクトであり、クエリが該当のカラムでフィルタリングする場合にのみロードされるため、オーバーヘッドがほとんどなく、必要なときにクエリを大幅に高速化できる
タイムベースのワンタイムパスワード(TOTP)
Denis Kamenskii 氏、Vladimir Cherkasov 氏による貢献
Google Authenticator、1Password、Okta などを使用した、安全な対話型認証が clickhouse-client で利用できるようになりました。
まず、TOTP 互換のシークレットを生成する必要があります。
base32 -w32 < /dev/urandom | head -15RN2JMUDXJARFMPUYKXGH3N35DPGRCSU次に、これを使用して認証アプリでスキャンできる QR コードを生成します。
qrencode -t ansiutf8 'otpauth://totp/ClickHouse?issuer=ClickHouse&secret=5RN2JMUDXJARFMPUYKXGH3N35DPGRCSU'これにより、認証アプリでスキャン可能な QR コードが生成されます。
続いて、ClickHouse でユーザーを設定します。
config.d/users.yaml
users:
totp_user:
password_sha256_hex: 1464acd6765f91fccd3f5bf4f14ebb7ca69f53af91b0a5790c2bba9d8819417b
time_based_one_time_password:
secret: 5RN2JMUDXJARFMPUYKXGH3N35DPGRCSU
period: 30
digits: 6
algorithm: SHA1
networks:
ip: '::/0'
profile: default
quota: defaultこれで、作成したユーザーを使って ClickHouse に接続できるようになります。
./clickhouse client --user totp_userパスワードの入力が求められ、続いて認証アプリの TOTP コードの入力が求められます。