5万

2026年現在、Postgres プロバイダーの選択肢には事欠かず、次のアプリケーションを支えるデータベースをどこにデプロイすべきか迷うこともあるでしょう。もちろん、性能(この点では当社もかなり健闘しています)や価格設定、拡張機能のサポートといった側面から検討することもできます。しかし、そうした議論であまり前面に出てこない側面が信頼性です。
データベースの信頼性には多くの側面があります。Postgres 自体は非常に頑健で信頼性があります。ハードウェアの信頼性も興味深い懸念事項ですが、今回検証するすべての Postgres の選択肢は、ハイパースケーラーが提供しているか、その上でホストされています。そのため、ハードウェア面に関しては、どの選択肢もハードウェアとして可能な限り信頼性の高い性能を発揮します。
私にとって信頼できる製品とは、本来耐えるべきではないワークロードの下でも持ちこたえる製品です。当社では Postgres サービスのバグを洗い出すためにストレステストを実施していますが、Postgres のメモリチューニングは完全に解決された問題ではないため、ユーザーが意図せずデータベースに負荷をかけてしまうことがあります。また、プロビジョニングから操作まで完全にエージェントが行う Postgres データベースの割合が増加しているため、この「意図しない」ルートによる負荷は今後さらに増える一方です。
メモリ管理とクエリチューニングの落とし穴
残念ながら、Postgres には「1 つのクエリが使用する RAM を最大でも X MB に抑えてほしい」と指示する設定はありません。存在するのは work_mem(デフォルトは 4MB)であり、これはクエリ単位ではなく「操作」単位で適用される上限です。メモリを必要とする実行計画内のクエリノードには、それぞれ個別の work_mem バジェットが割り当てられ、1 つの計画内にそうしたノードが同時に複数存在することもあります。ハッシュベースのノードには、さらに hash_mem_multiplier によるバジェットの乗数が加算されます。Postgres のドキュメントには、実際のメモリ使用量が「work_mem の値の何倍にもなる可能性がある」と明記されています。
クエリチューニングがいかに厄介であるかを示すために、すべての Postgres 設定がデフォルトのデータベース上にあるシンプルなスキーマを考えてみましょう。架空の LLM 推論サービスを支える、わずか 2 つのテーブルです。
CREATE TABLE wm_api_keys (
api_key_id uuid PRIMARY KEY,
tier smallint NOT NULL,
scopes text[] NOT NULL,
expires_at timestamptz,
created_at timestamptz NOT NULL
);
CREATE TABLE wm_api_calls (
call_id bigint PRIMARY KEY,
api_key_id uuid NOT NULL,
called_at timestamptz NOT NULL,
model_id smallint NOT NULL,
tokens integer NOT NULL,
cost_usd numeric(10,6) NOT NULL,
latency_ms integer NOT NULL
);API ゲートウェイからの OLTP トラフィックと並行して、ユーザーはコンソールのキーごとの詳細表示画面に頻繁にアクセスします。この画面は以下の SELECT 文によって支えられています。
SELECT c.api_key_id,
sum(c.cost_usd) AS total_cost_usd,
sum(c.tokens) AS total_tokens,
count(*) AS n_calls,
max(c.called_at) AS last_active_at,
avg(c.latency_ms)::int AS avg_latency_ms
FROM wm_api_calls c JOIN wm_api_keys k USING (api_key_id)
WHERE k.tier IN (0, 1, 2)
GROUP BY c.api_key_id
ORDER BY total_cost_usd DESC;サービス開始から少し経つと、API キーは 2,000 個に達し(おめでとうございます!)、これまでに合計 30,000 回の呼び出しが行われました。EXPLAIN (ANALYZE, BUFFERS, VERBOSE) の実行計画には特に目立った点はなく、該当する行は以下のとおりです。
Sort
Sort Method: quicksort Memory: 87kB
-> HashAggregate
Batches: 1 Memory Usage: 689kB
-> Hash Join
-> Seq Scan on wm_api_calls c
-> Hash
Buckets: 2048 Batches: 1 Memory Usage: 68kBメモリを消費しているノードは、Hash(ビルド側、68 kB)、HashAggregate(689 kB)、Sort(87 kB)の 3 つです。これらを合計しても約 0.8 MB であり、デフォルトの work_mem のしきい値内に余裕で収まっています。
メモリ計算に関する注意点: 本セクションで「合計メモリ」と言う場合、メモリを使用する各ノードのピーク値の合計を指します。Postgres は通常、クエリの終了までノードのメモリを保持するため、これで十分に実態に近い近似値になると判断しています。
数か月後、製品は正式に大ヒットしました。API キーは 55,000 個、API 呼び出しは 900 万回に達しています。このクエリを実行するコンソール画面の動作が重くなり始めたため、実行計画を確認します。
Sort
Sort Method: quicksort Memory: 2926kB
-> Finalize GroupAggregate
-> Gather Merge
Workers Planned: 2
Workers Launched: 2
-> Sort (loops=3)
Sort Method: external merge Disk: 4256kB
Worker 0: external merge Disk: 4256kB
Worker 1: external merge Disk: 4248kB
-> Partial HashAggregate (loops=3)
Batches: 5 Memory Usage: 8241kB Disk Usage: 3408kB
Worker 0: Batches: 5 Memory Usage: 8241kB Disk Usage: 3400kB
Worker 1: Batches: 5 Memory Usage: 8241kB Disk Usage: 3392kB
-> Hash Join
-> Parallel Seq Scan on wm_api_calls c
-> Hash
Buckets: 32768 Batches: 1 Memory Usage: 1671kB処理するデータ量が増えただけで、2 つの変化が生じました。wm_api_calls はディスク上で 1 GB を超え、min_parallel_table_scan_size(デフォルト 8 MB)を大幅に上回ったため、プランナーはクエリ実行を高速化するために 2 つのバックグラウンドワーカーを投入しました。現在、Gather Merge の下にある部分サブツリーは、2 つのワーカーに加えて、デフォルトでワーカーとしても動作するリーダーの計 3 プロセスで実行されています。各プロセスは、結合の Hash(1671 kB × 3 プロセス = 合計 5 MB)を含め、Gather Merge の下にあるすべてのノードの独自のコピーを構築します。ここで留意すべき点は、各ワーカーが独自のメモリ使用ノードを持ち、それぞれに個別のメモリバジェットがあるということです。そのため、並列ワーカーを追加したことで、メモリ使用量に目に見えにくい形で約 3 倍の倍率がかかりました。
次にスピル(ディスクへの溢れ)です。Partial HashAggregate では、各ワーカーで Memory Usage: 8241kB Disk Usage: 3408kB と表示されています。ワーカーごとの Sort には external merge Disk: 4256kB とあります。プロセスごとに 2 つのメモリ使用ノードがあり、いずれも work_mem によるノード上限に達したため、一時ファイルに書き込んでいます。Postgres のデフォルトの work_mem は 4 MB です。しかし、ハッシュ系のノードはスピルする前に work_mem * hash_mem_multiplier(デフォルト 2.0)を取得するため、Partial HashAggregate の上限は 8 MB になります。上限がなければ、HashAggregate はワーカーごとに自然と約 14 MB を使用しますが、8 MB には収まらないため、代わりに 5 つのバッチに分けてディスクにパーティショニングします。Sort は約 5 MB を必要としますが、4 MB に収まらないため、外部マージに移行します。
3 つのプロセス全体で合計すると次のようになります。
- RAM:
3 × (8.2 MB Partial HashAgg + 1.7 MB Hash) + 2.9 MB 外側 Sort ≈ 33 MB - ディスク:
3 × (3.4 MB HashAgg パーティション + 4.3 MB Sort) ≈ 23 MB
この比較的シンプルなクエリに対して、work_mem の 8 倍以上を消費しているだけでなく、コンソール画面を読み込むたびに 23 MB のディスク I/O が発生しています。EXPLAIN 内の Disk Usage や external merge の表示に対する第一の解決策は、work_mem を各ノードのワーキングセットを超える値に引き上げることです。
8 MB に引き上げるとスピルは解消されますが、調整可能な要素が重なり合うため、クエリを実行する並列プロセス全体でその 8.5 倍の量(約 68 MB)を消費することになります。プランナーは wm_api_calls テーブルのサイズから workers + 1 を決定し、クエリとデータからメモリ使用ノードの数を決定しましたが、hash_mem_multiplier はノードごとの修飾子であり、クエリ全体の上限ではありません。存在するのは、ノードごと、プロセスごとに適用され、ハッシュ系ノードに乗数がかかる work_mem だけです。
メモリを大量に消費するすべてのクエリがこのモデルに従っていれば、この記事はここで終わることができます。しかし、そうではありません。
すべてがスピルするわけではない
エグゼキューターのメモリ割り当ての中には、この整然とした work_mem モデルの枠外にあるものもあります。これは単に設定値を高くしすぎたり、並列ワーカーによって乗算されることを忘れていたりするだけの問題ではありません。一部のデータ構造にはディスクを活用したフォールバック手段がまったく存在せず、クエリが終了するかバックエンドのメモリが枯渇するまで増大し続ける可能性があるのです。
エグゼキューターの任意の実行状態をディスクにスピルさせる処理は複雑で厄介であり、実装が稚拙であれば性能を完全に破壊してしまいます。Postgres はトレードオフが見合う部分のスピルには多大な労力を注いできましたが、一部の構造は意図的にメモリ上に保持しています。これが実際に何を意味するかというと、極端な条件下では、メモリチューニングパラメータを無視するクエリを実行できてしまうということです。当社のテストワークロードを構成するクエリはこのパターンを示しており、詳しく調べる価値があります。
Postgres で有向グラフを表現することを考えてみましょう。最も単純なパターンは、次のようなエッジテーブルです。
CREATE TABLE edges (
src bigint NOT NULL,
dst bigint NOT NULL,
PRIMARY KEY (src, dst)
);ノード 0 から到達可能なすべてのノードを検索するには、再帰 CTE を記述します。グラフには循環が含まれる可能性があるため、再帰を終了させるには(UNION ALL ではなく)UNION を使用する必要があります。そうしないとノードを無限に再訪してしまうためです。UNION を使用すると、エグゼキューター内に行の重複排除用のハッシュテーブルが作成されます。このハッシュテーブルは、クエリの存続期間全体にわたって、到達可能なすべてのノードのエントリを保持しますが、そのメモリコンテキストはディスクにスピルするための work_mem を考慮しません。
WITH RECURSIVE walk(n) AS (
SELECT 0::bigint
UNION
SELECT e.dst
FROM walk
JOIN edges e ON e.src = walk.n
)
SELECT n
FROM walk;ハッシュテーブルは BuildTupleHashTable という関数によって構築されますが、この関数自体にはディスクにスピルするロジックがありません。同じ関数が、本記事の前半にある GROUP BY の例で使用した HashAggregate の基礎にもなっています。では、なぜあちらのハッシュテーブルはきれいにスピルし、こちらはスピルしないのでしょうか。それは、ハッシュテーブルの目的の違いに行き着きます。
HashAggregate において、ハッシュテーブルは1回限りのアキュムレーターであり、入力が終わると終了します。このように終了地点が定まっているため、Postgres はテーブルのサイズを監視し、work_mem * hash_mem_multiplier を超えた時点で、インメモリテーブルをそれ以上大きくする代わりに、新しいグループのタプルをディスクにルーティングし始めることができます。入力が尽きると、Postgres はディスク上の各パーティションを読み戻し、個別に集約します。
一方、WITH RECURSIVE … UNION では、ハッシュテーブルは**クエリ全体を通じて重複排除用の集合を必要とします。**各イテレーションからのすべての候補行を、それまでに確認されたすべてのキーと照合しなければなりません。テーブルの一部をディスクに送ると、要素が含まれているか確認するたびにディスクから読み戻す必要が生じ、スループットにとって致命的です。そのため、到達可能な集合が完全に実体化されるまで、クエリの存続期間中はテーブルがメモリ上に残り続けます。
ベンチマーク
メモリ使用量に大きな負荷をかけるワークロードの下で、4 つの Postgres プロバイダーをテストしました。評価基準は、データベースができる限り多くの負荷を処理し、クラッシュすることなく残りを適切に切り離せるかどうかです。
先ほどの循環グラフに対する再帰 UNION クエリを約 1,260 万ノードのグラフに対して実行し、重複排除ハッシュテーブルで約 1 GiB の RAM を消費させました。このクエリは CROSS JOIN を使用してエッジを実行時に動的生成するため、ストレージやキャッシュの性能によるブレを排除できます。各ノードから、クエリは 2 つの出力エッジを作成します。1 つは次のノードへ、もう 1 つは 251 個先のノードへのエッジです。「次のノード」へのエッジにより、すべてのノードが 0 から到達可能であることが保証されます。2 つ目のエッジによってほとんどのノードに複数の到達パスが与えられるため、UNION はイテレーションごとに重複を排除しなければならず、再帰のステップ数が数百万回から数万回に短縮されます。
WITH RECURSIVE walk(n) AS (
SELECT 0
UNION
SELECT (walk.n + step.s) % 12600000
FROM walk
CROSS JOIN (VALUES (1), (251)) AS step(s)
)
SELECT n FROM walk;メモリ計算に関する注意点: Postgres は CTE の出力を tuplestore にも実体化しました。これは work_mem を考慮して超過分を一時ファイルにスピル(このグラフでは約 200 MB)するため、複数のバックエンド間で一定の I/O 負荷が生じますが、同時にかかるメモリ負荷に比べれば小さい割合です。
テスト対象のプロバイダーは以下のとおりです。
- ClickHouse Managed Postgres[r8gd.large、AWS us-west-2、118GB ローカル SSD、Postgres 18.6]
- Google Cloud SQL[db-c4a-highmem-2、us-west1、118GB Hyperdisk Balanced、Postgres 18.6]
- PlanetScale Postgres[r8gd.large、AWS us-west-2、118GB ローカル SSD、Postgres 18.6]
- Amazon RDS[db.r8g.large、us-west-2、118GB gp3、Postgres 18.6]
ClickHouse Managed Postgres と PlanetScale はどちらもローカル接続の SSD を使用しているため、他のプロバイダーの耐久性保証に合わせる目的で、同期 HA(スタンバイ 2 台)を設定しました。
各プロバイダーに対して、同じクエリを実行する n 個の同時接続を開きました(n は 7 から 23 の範囲)。各 n の値で 60 秒間のクールダウンを挟みながらこれを 10 回繰り返し、テスト全体を通じて接続ごとのメモリ使用量をサンプリングしました。各接続には 120 秒の statement_timeout を設定しています。単一のクエリは通常 5 秒未満で終了するため、2 分を超えたものはすべて失敗とみなされます。また、エラーを返した接続や強制終了された接続も失敗として記録しました。接続されているすべてのクライアントが一度にセッションを失った実行は、全面的な障害として分類しました。テストドライバーには、すべてのクラスターと同じリージョンにある単一の Amazon EC2 インスタンスを使用しました。
結果
ここでの障害モードには、クエリの障害、セッションの障害、クラスターの障害の 3 つがあります。Postgres が行える優れた対応は、アロケーターが失敗を検知し、呼び出し元がそれを確認することです。SQLSTATE 53200(out_of_memory)のエントリがログに記録され、失敗したトランザクションはロールバックされ、接続は維持され、プールはそのスロットを保持し、その接続での次のクエリは正常に動作します。クラスター上の他のバックエンドや他のクライアントは、何が起きたかに気づくことすらありません。テストしたプロバイダーの中でこれを行っているのは、ClickHouse Managed Postgres のみです。当社ではカーネルのメモリオーバーコミットを無効にし、コミット済みメモリに上限を設けています。バックエンドが全体の上限を超えるメモリを要求すると、割り当ては失敗します。Postgres はこれを捕捉し、クラッシュするのではなく SQL ERROR で応答します。
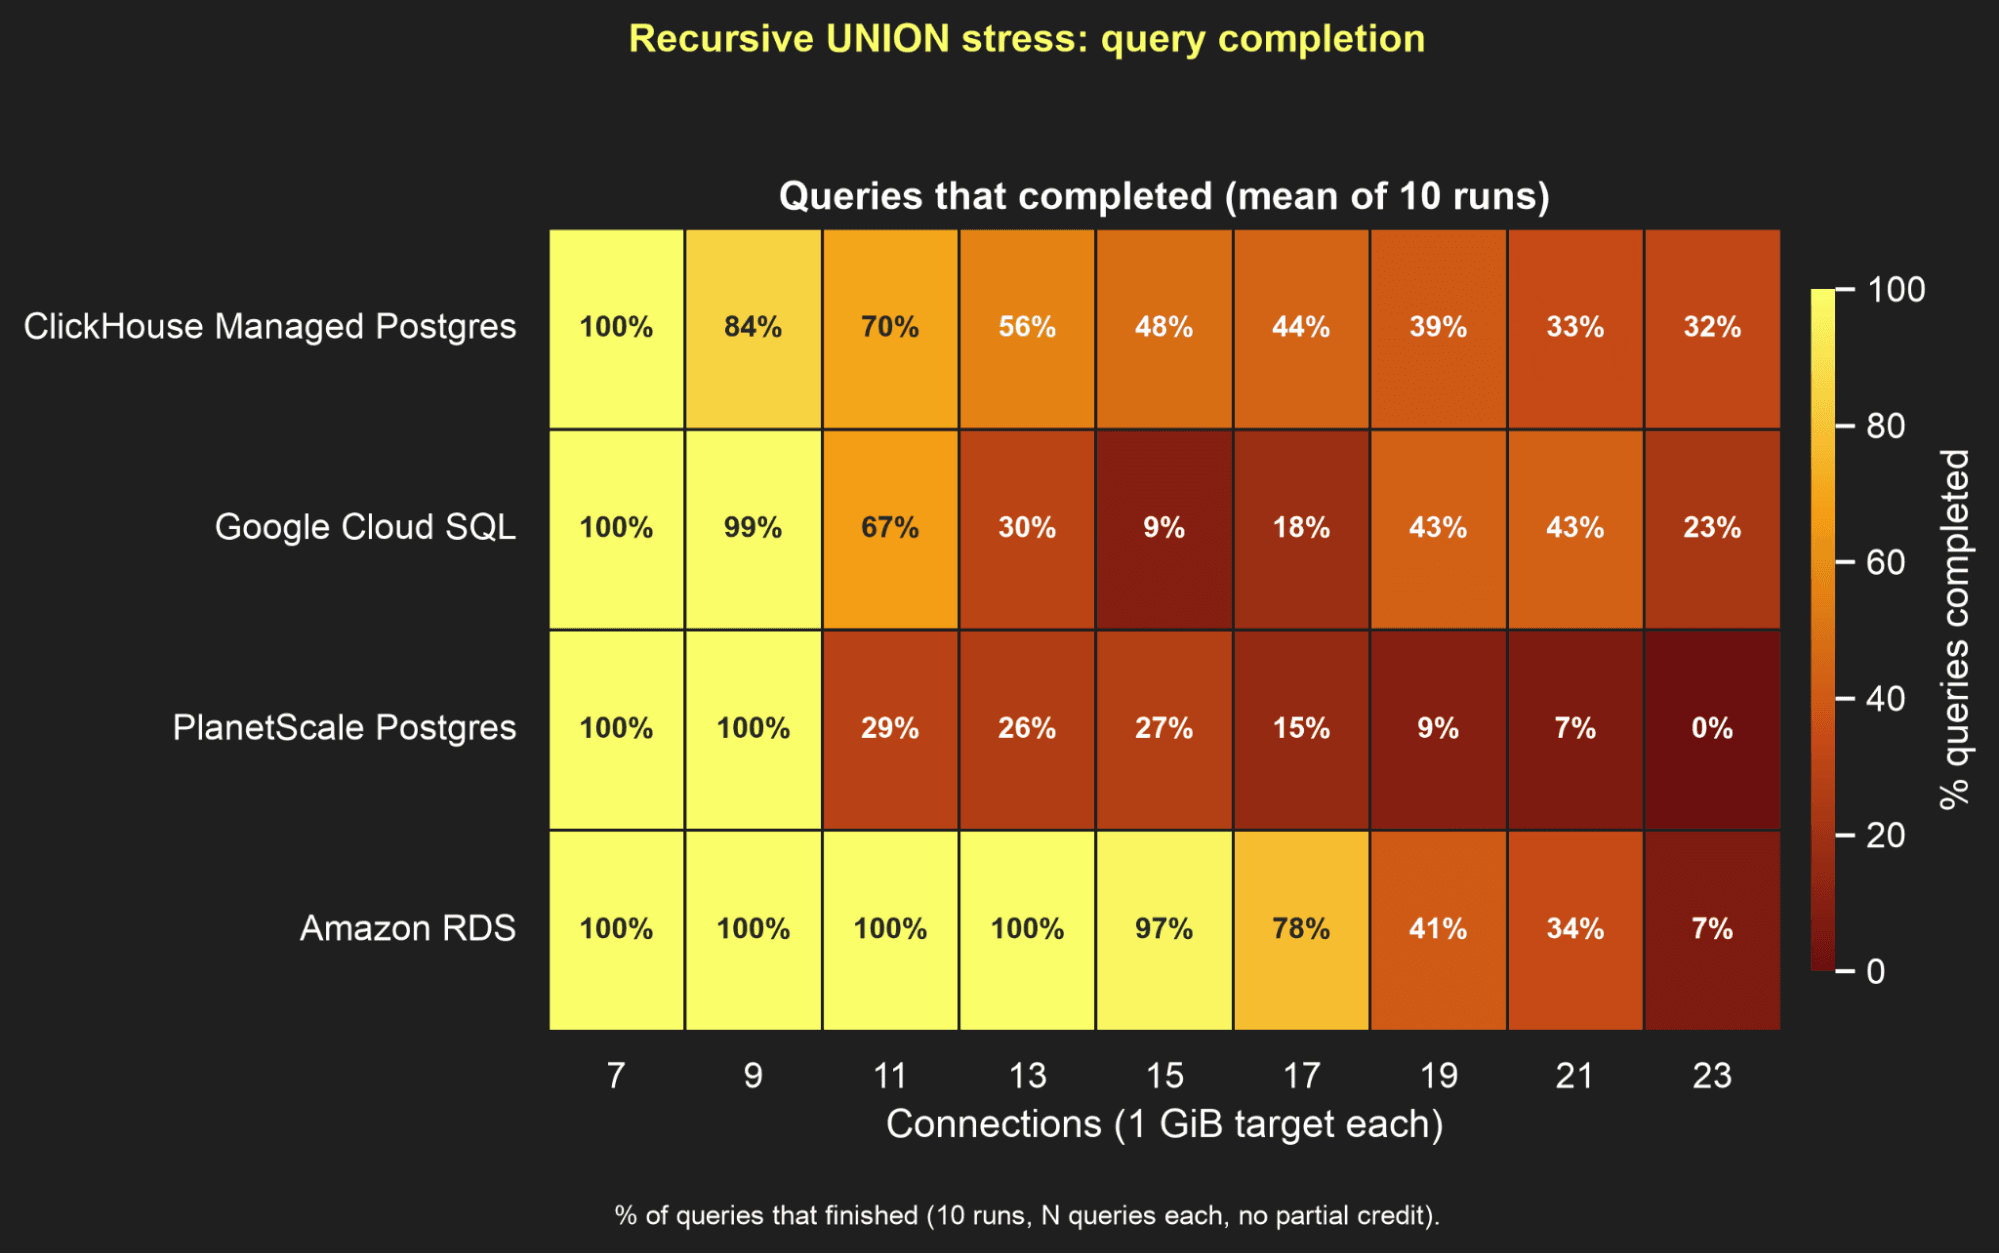
メモリ負荷が適切なタイミングで捕捉されない場合、Linux の OOM キラーが作動し、いずれかのバックエンドを選択して SIGKILL を送信します。Postgres はこの異常終了を共有メモリが破損した可能性があると判断し、クラスター全体を再起動してクラッシュリカバリに入ります。その結果、高負荷のシステムでは数分間にわたる利用不可状態が発生します。RDS はこのパターンを示し、ワークロードがクラスターの持つメモリを大幅に超える 19 接続の時点でクラッシュリカバリに入り始めます(クラッシュ直前にごく一部の接続がワークロードを完了できることも時折ありました)。それ以前の時点では、RDS 自身がクエリを停止することはありませんが、15 接続および 17 接続の時点で一部のクエリが 120 秒の statement_timeout を超過してエラーになります。これは深刻なメモリ負荷によるスラッシングの兆候ですが、この仮説を確定することはできませんでした。
Cloud SQL と PlanetScale は異なるアプローチを採用しており、メモリ負荷を監視して OOM キラーが作動する前にクエリを強制終了するスーパーバイザーを実行しています。クライアントには FATAL: terminating connection due to administrator command が返されます。説明なしに接続自体が切断されるため ERROR ほど親切ではありませんが、postmaster は稼働し続け、クラスターはリクエストの処理を継続します。もっとも、これは完璧な解決策ではありません。11 接続以上になると、PlanetScale のテストの大部分はクラッシュで終了します。Cloud SQL は高負荷への対処力は優れているものの、中程度の負荷ではより不安定でした。また、Cloud SQL は復旧に数分かかることがあり、その後のテストが開始できずに途中でエラー終了することもありました。
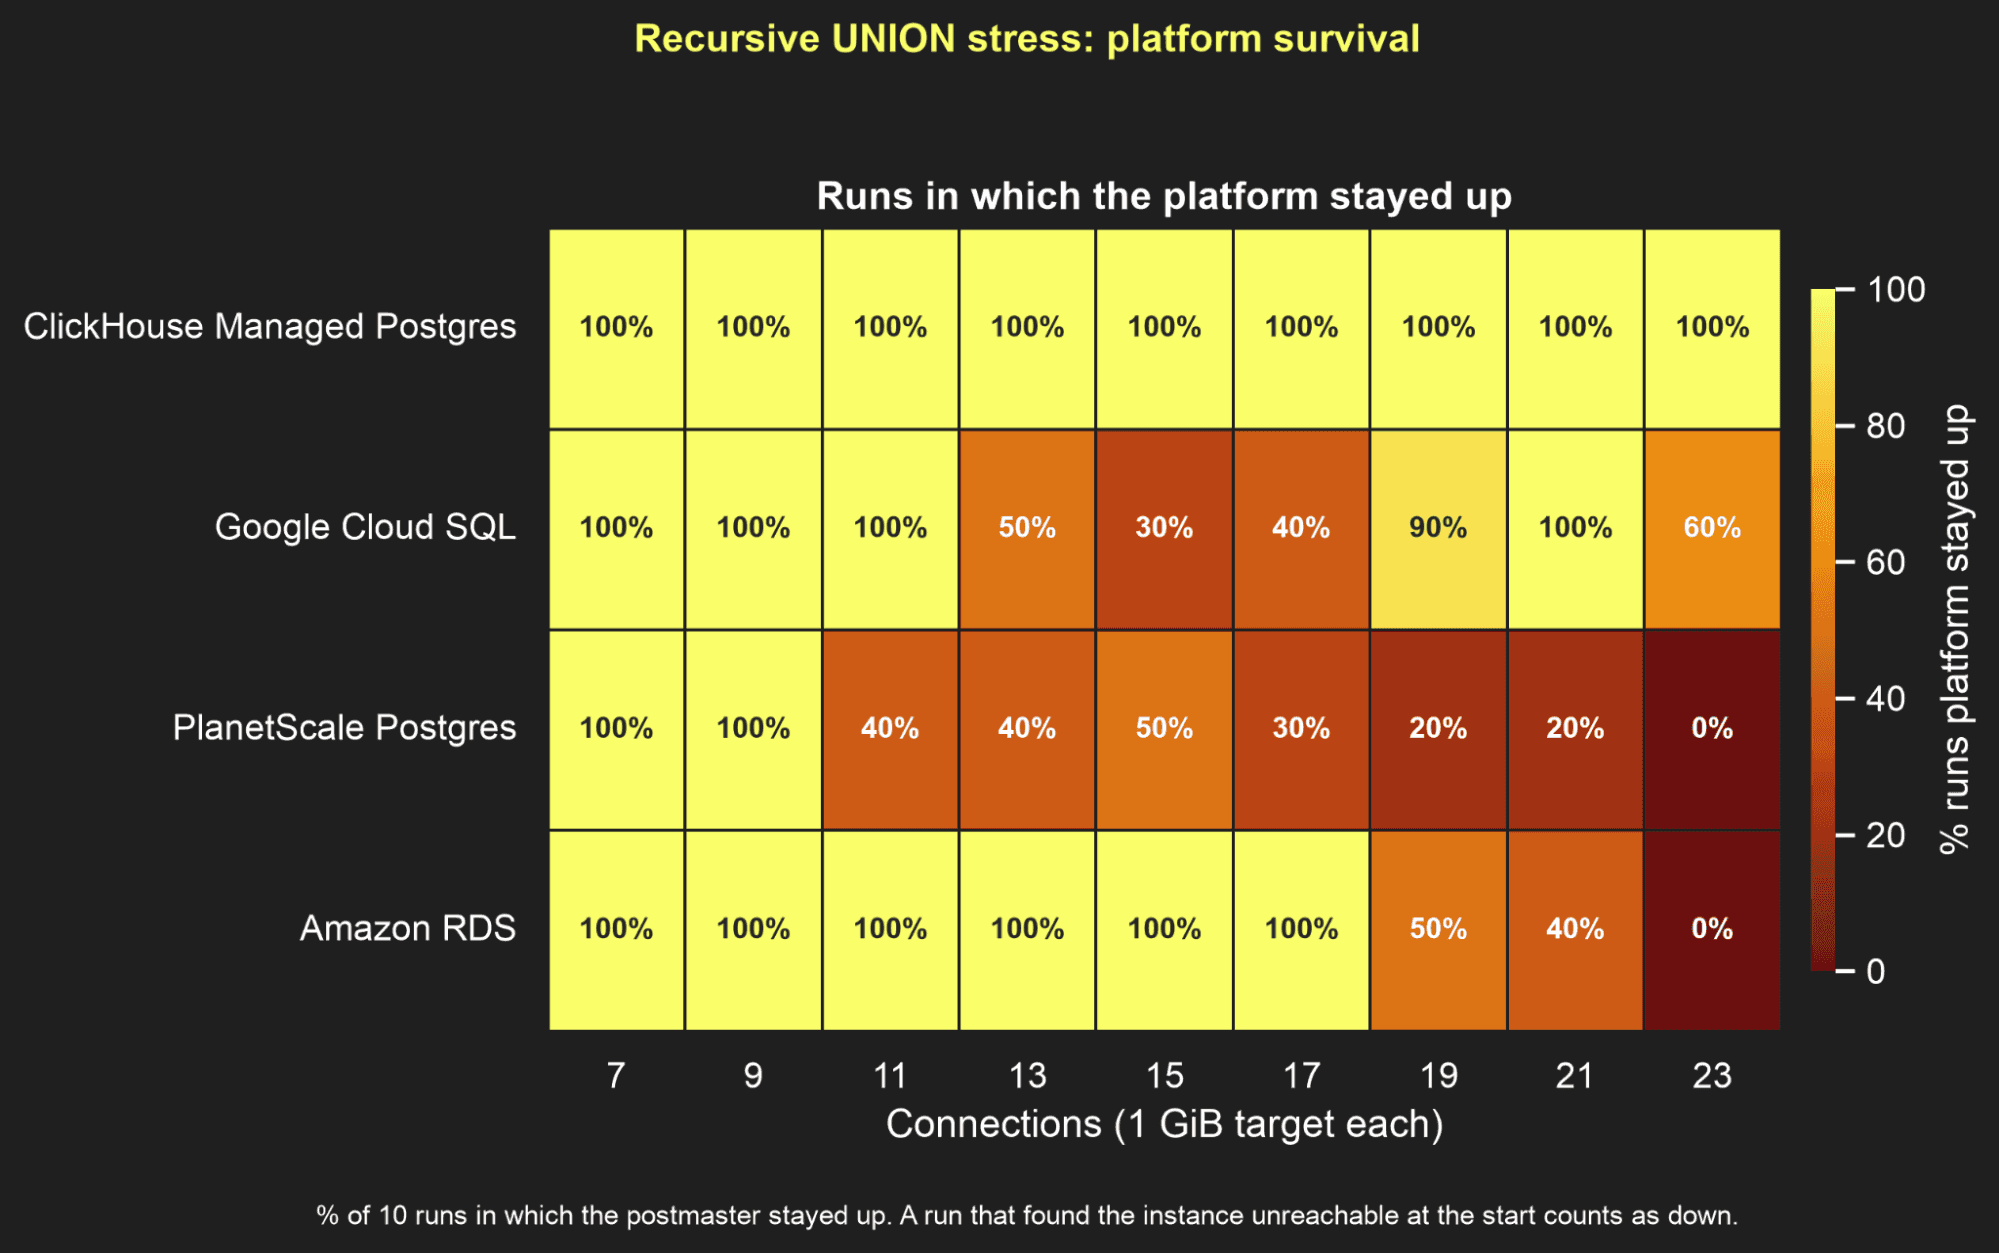
これら 2 つのヒートマップは、対応する各セルについて異なる状況を示しています。1 つ目はクエリを完了できた個々のクエリの割合を示し、2 つ目はクラスター自体が稼働し続けた実行の割合を示しています。23 接続において、ClickHouse Managed Postgres のクエリ完了率は 32% でしたが、クラスターの生存率は 100% でした。メモリ上限によって約 70% のクエリが ERROR で停止されたものの、クラスターは終始正常な状態を維持しました。対照的に、23 接続での RDS はクエリ完了率が 7%、クラスター生存率は 0% でした。すべての実行で postmaster がクラッシュし、ホストがダウンする直前に運良くクエリを完了できた接続はごくわずかでした。
このベンチマークにおいて、ClickHouse Managed Postgres はホストの枯渇を招く前に暴走したクエリを停止することで、テストしたすべての接続数でクラスターの稼働を維持しました。この構成にはトレードオフが伴います。Postgres のバックエンドは、ワークロードを限界近くまで実行させるプロバイダーほど、ホストの RAM を消費することができません。次のヒートマップは、そのトレードオフを端的に示しています。ClickHouse Managed Postgres のメモリ割り当ては、ホスト RAM の 57%、つまりこれらの 16 GiB インスタンスで約 9 GiB で頭打ちになります。Cloud SQL と PlanetScale も同様のメモリ上限を設けていますが、RDS は障害が発生するまでバックエンドメモリをはるかに高く上昇させます。
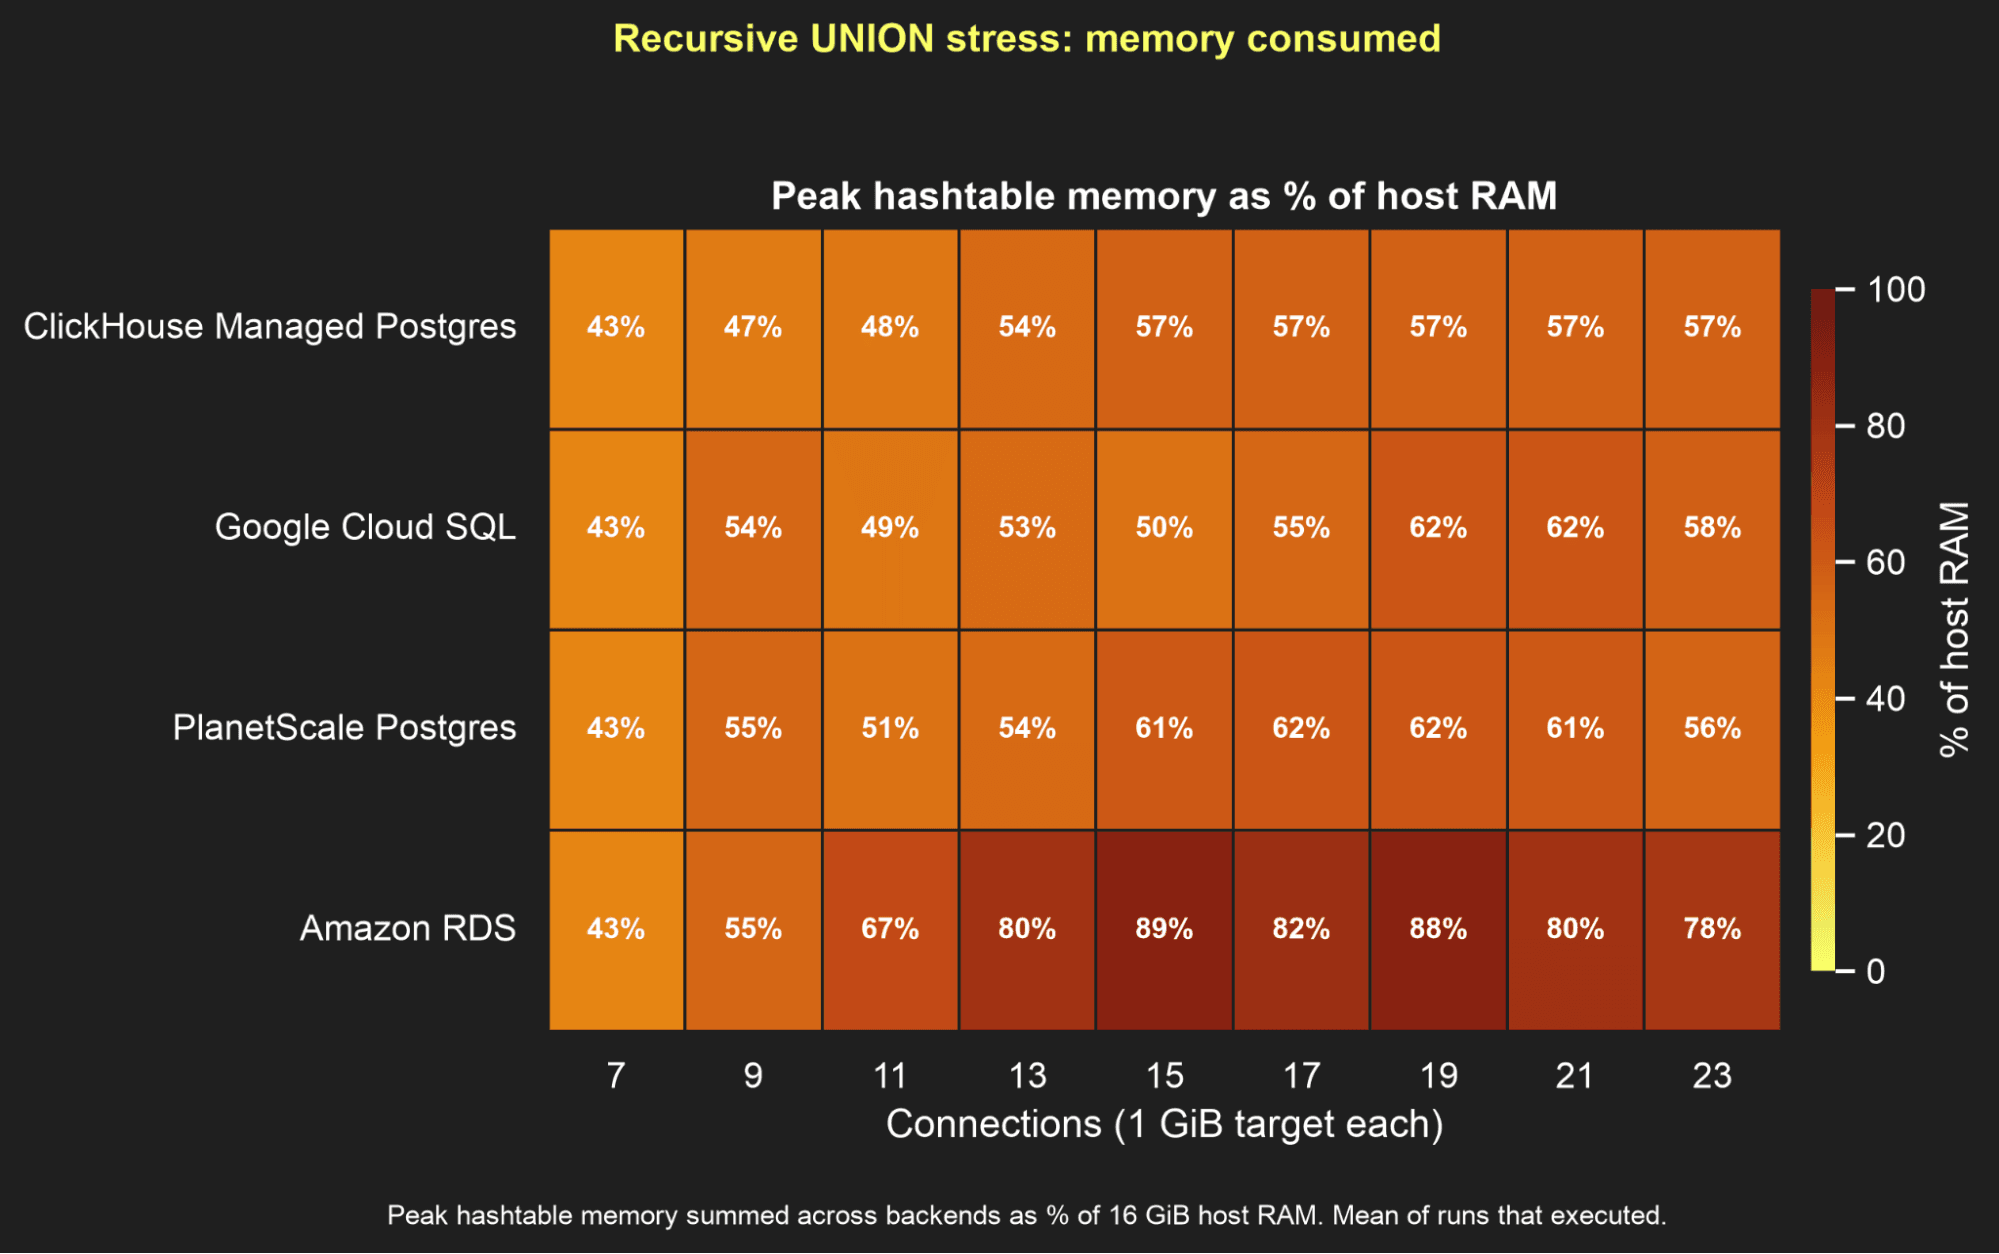
これはメモリの無駄遣いのように思えるかもしれませんが、Postgres の性能が Postgres の shared_buffers と OS のページキャッシュの双方によるキャッシュに大きく依存していることは周知の事実です。ClickHouse Managed Postgres は両方のキャッシュに専用のメモリを確保しており、デフォルトで 4GB(25%)を完全に Postgres の shared_buffers に割り当て、ページキャッシュを含む Linux カーネルのオーバーヘッド用にも少量を確保しています。
ClickHouse Managed Postgres は、より放任主義的なアプローチをとる RDS よりもメモリ負荷の高いワークロードを制限します。中程度の負荷において RDS の方が ClickHouse Managed Postgres よりも多くのクエリを完了できるのはこれが理由です。当社の制限では、ワークロードが上限に達する 9 接続の時点でクエリの拒絶を開始しますが、RDS はホストが力尽きるまで受け入れ続けます。しかし、RDS のアプローチはクラッシュ以上のコストをもたらします。メモリの暴走的な消費に対する保護がなければ、バックエンドがキャッシュと競合し、システム全体の処理を低下させる可能性があるためです。
まとめ
低めのメモリ上限を設定しているのは、稼働率を優先した意図的なトレードオフであり、どのアプローチが優れているかはサービスにおいて何を最適化したいかによって決まります。ワークロードを完全に制御できており、不適切な実行計画や極端なクエリによってインスタンスがダウンすることを許容できるのであれば、バックエンドに利用可能な RAM をほぼすべて消費させる手法も有用でしょう。上限を低く設定すると、最良の条件下では一部のメモリが未使用のまま残りますが、データベース全体を落とすのではなく、個々のクエリのみを失敗させることができます。エグゼキューターのメモリが暴走した際には、postmaster が消失してすべてのクライアントがクラッシュリカバリを強いられるよりも、クエリ単体の障害として適切にエラーを返す方を私たちは選びます。
当社では、各 VM 上で稼働する Postgres や付随するコンポーネントのメモリプロファイルをさらに安定させ、将来的にユーザーのクエリにより多くのメモリを割り当てられるようにするための手法への投資を続けています。
ClickHouse Managed Postgres を今すぐ始める
自社のデータで ClickHouse Managed Postgres がどのように動作するか試してみませんか?ClickHouse Cloud は数分で使い始めることができ、300 ドル分の無料クレジットも進呈されます。
サインアップ