5万

私たちは長年にわたり、高速なシステムの構築に注力してきました。ClickHouse はその注力を象徴する一例です。パフォーマンスは後から付け足す機能ではなく、最初からの核となる設計目標です。
マネージド Postgres サービスの構築にあたっても、同様のアプローチを適用しました。その結果、極めて高速なマネージド Postgres サービスをユーザーに提供できるようになりました。Postgres がトランザクション処理のワークロードを担い、ClickHouse が分析ワークロードを担います。両者が組み合わさることで統一されたデータスタックが形成され、SaaS や AI アプリケーション向けの「best-of-breed」な基盤が実現します。
この考えに基づき、ClickHouse を評価するのと同じ方法、すなわち公開された再現可能なベンチマークで評価を行うのは自然な流れでした。
マネージド Postgres サービスを比較するためのベンチマークである PostgresBench を構築したのはそのためです。
ClickBench から PostgresBench へ
ClickBench は広く参照されている OLAP ベンチマークです。透明性と再現性のある手法を用いて、40 以上のデータベースをベンチマークしています。すべてのクエリ、データセット、結果が公開されており、誰でも数値を検証したり、改善案を提出したりできます。
PostgresBench は、トランザクションの Postgres ワークロードに同じ手法を適用します。ルールは明快です。
- 広く理解されている標準的なワークロードを使用する
- テスト対象の全サービスでインフラストラクチャの一貫性を保つ
- 結果を再現できるよう、すべての設定を公開する
- 誰でも結果の提出や問題の指摘を行えるようにする
数値が正しくないように見えれば検証できます。設定が不公平であれば修正できます。それこそが目的です。
ベンチマークの設計
ワークロード
PostgresBench は、標準的な Postgres ベンチマークツールである pgbench をベースに構築されています。標準で付属している TPC-B 風のワークロードを使用しており、頻繁な書き込みや更新を伴う短いトランザクションの同時実行をシミュレートします。これは、決済、注文処理、在庫更新など、小さく頻繁な書き込みでデータベースに高い負荷をかける一般的なトランザクションパターンを適切に再現するものです。
私たちは意図して pgbench を選びました。sysbench や Percona TPCC のようなツールは、元々 MySQL のワークロード向けに設計されています。Postgres のベンチマークには pgbench のほうが自然であり、Postgres に同梱されているため、追加のツールを用意することなく誰でも簡単に結果を再現できます。
実行パラメータ
ベンチマークの各実行では、以下のパラメータを使用します。
pgbench -c 256 -j 16 -T 600 -M prepared -P 30 \
-s $SCALE_FACTOR \
-h $PGHOST -p $PGPORT -U $PGUSER -d $PGDATABASE本番環境のトランザクションワークロードにおける現実的な同時実行性を反映し、256 クライアント、16 スレッドで各ベンチマークを実行しました。各テストの実行時間は 10 分間で、ウォームアップ段階を越えて安定したスループットを捉えるのに十分な長さです。
スケールファクターは 6849 (約 100 GB) と 34247 (約 500 GB) の 2 つをテストしました。これらは、実際の Postgres デプロイで典型的なデータセットサイズに対応しています。一方は、アプリケーションが立ち上がって急速に成長しており、ワーキングセットがキャッシュに収まりやすい規模です。もう一方は、一定の規模に達して成長を続け、ワーキングセットがディスクへあふれ始める規模です。これら 2 つのサイズにおける結果の差から、データ増加に伴うストレージの負荷に各サービスがどのように対処しているかについて有益な知見が得られます。
取得メトリクス
設定ごとに 3 回実行し、その全体の平均 TPS、平均レイテンシ、P95 レイテンシ、P99 レイテンシを報告します。最良と最悪の実行結果のランキングを公開しており、各回の詳細な結果はリポジトリで確認できます。
ネイティブ Postgres サービスを始める
ClickHouse のネイティブ Postgres サービスをお試しいただくには、こちらのリンクからプライベートプレビューにお申し込みください。
サインアップ公平性
完全に中立なベンチマークは存在しません。インスタンスタイプから Postgres の設定に至るまで、あらゆる選択が特定のシステムに有利に働く可能性があります。ここでは各決定の背景にある考え方を説明し、各システムで使用した正確な設定は結果とともにベンチマークリポジトリに記録しています。
クライアントマシンのセットアップ
ベンチマーククライアントを実行するため、us-east-2 リージョンに 16 vCPU、64 GB のインスタンスをプロビジョニングしました。これはクライアントがボトルネックにならないようサイズを決めています。すべてのサービスは同じリージョン内でテストされたため、結果にはクロスリージョンのネットワークレイテンシではなく、データベース自体の性能のみが反映されます。また、すべてのサービスがアベイラビリティゾーン (AZ) の指定に対応しているわけではないため、クライアントとデータベースを同一 AZ に配置していません。ただし、対応しているサービスの公平性を確保するため、将来的にはこの設定を追加することも検討しています。コントリビューションを歓迎します。
インスタンスの選定
ほとんどのサービスでは、CPU と RAM の比率 1:4 を目標とし、4 vCPU / 16 GB RAM と 16 vCPU / 64 GB RAM の 2 つのサイズでテストしました。Aurora はこの比率を提供するインスタンスクラスを提供していないため、同様に 4 vCPU / 32 GB RAM と 16 vCPU / 128 GB RAM の 2 つのサイズで 1:8 の比率を使用しました。
AWS RDS や Aurora を含む、サポートしているすべてのサービスで NVMe キャッシュを備えた Graviton インスタンス を使用しました。これにより、これらのサービスにおいて NVMe がプライマリストレージではなくキャッシュとして使用されている場合でも、競合他社に同等のハードウェア上の利点が与えられます。
シングルノード
すべてのサービスが高可用性 (HA) を提供していますが、その基礎となるアーキテクチャは異なります。スタンバイレプリケーションを使用するものもあれば、共有ストレージ層や分散ストレージ層を使用するものもあります。今回はシングルノードのコンピュートおよびストレージ性能に焦点を当てているため、それを切り離して測定できるよう HA を無効にしてテストしました。将来的に HA 構成を別の評価軸として追加する可能性があります。
デフォルトの Postgres 設定
サービス間でデフォルトの PostgreSQL 設定は変更していません。各システムはそのままの設定 (out-of-the-box) でテストされています。これは、大半のユーザーがチューニングなしでの性能を期待するという、典型的なユーザー行動を反映したものです。将来的には Postgres の設定を別の評価軸として組み込む可能性があります。
料金に関する注記
価格の比較は行っていません。テスト時点では ClickHouse Managed Postgres はまだリリースされていませんでした。類似のハードウェア構成において競争力のある価格設定になると見込んでおり、提供開始後は本結果からコストパフォーマンスを推計できるようになります。
第 1 回のテスト対象
対象システム
PostgresBench の初回リリースでは 5 つのサービスを対象としており、それぞれ 2 つのインスタンス構成でテストしました。小型の 4 vCPU / 16 GB 構成と、大型の 16 vCPU / 64 GB 構成 (または同等の構成) です。これにより、単一のスペックでの性能だけでなく、リソースの増加に伴って各サービスがどのようにスケールするかも確認できます。
すべてのサービスは、各プロバイダーがサポートしているバージョンに応じて Postgres 17 または 18 を使用し、HA を無効にした状態で us-east-2 でテストされました。テスト時点で Postgres 17 のままだったサービスは、今回のグループでは Aurora のみです。
| System | T-shirt size | Instance | vCPUs | RAM | Instance storage | Primary storage |
|---|---|---|---|---|---|---|
| ClickHouse Managed Postgres | Small | m8gd.xlarge | 4 | 16 GB | 237 GB - NVMe | NVMe |
| ClickHouse Managed Postgres | Large | m8gd.4xlarge | 16 | 64 GB | 950 GB - NVMe | NVMe |
| AWS Aurora PostgreSQL | Small | db.r6gd.xlarge | 4 | 32 GB | 237 GB - NVMe | Aurora storage |
| AWS Aurora PostgreSQL | Large | db.r6g.4xlarge | 16 | 128 GB | 950 GB - NVMe | Aurora storage |
| AWS RDS for PostgreSQL | Small | db.m8gd.xlarge | 4 | 16 GB | 237 GB - NVMe | 1000 GB - GP3 (16K IOPS) |
| AWS RDS for PostgreSQL | Large | db.m8gd.4xlarge | 16 | 64 GB | 950 GB - NVMe | 1000 GB - GP3 (16K IOPS) |
| Neon | Small | Serverless | 4 | 16 GB | N/A | N/A |
| Neon | Large | Serverless | 16 | 64 GB | N/A | N/A |
| Crunchy Bridge | Small | Standard-16 | 4 | 16 GB | N/A | 6,000 Baseline IOPS / 40,000 Maximum IOPS |
| Crunchy Bridge | Large | Standard-64 | 16 | 64 GB | N/A | 20,000 Baseline IOPS/ 40,000 Maximum IOPS |
結果
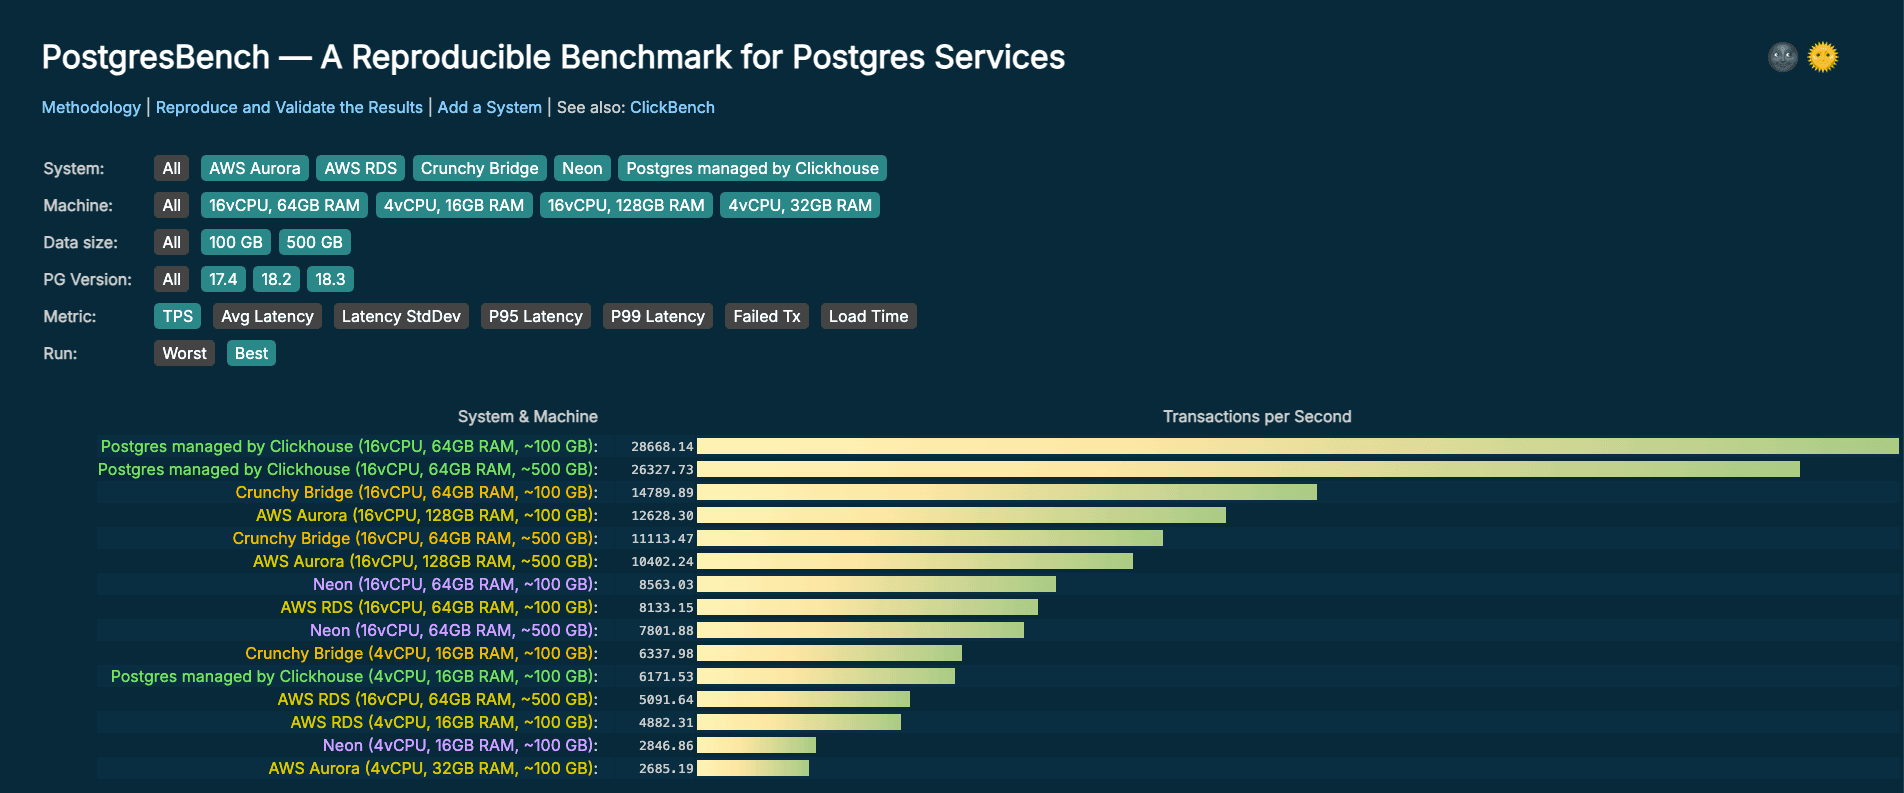
すべてのシステムで同一のスクリプトを使用し、同一のベンチマークを実行しています。各実行は独立して行われ、マシンやデータベース上で他のプロセスが同時に実行されることはありません。以下は結果のサマリー表です。すべての結果は PostgresBench で確認できます。
スケールファクター 6849 (約 100 GB)
| Service | T-shirt size | TPS | Avg Latency (ms) | P95 (ms) | P99 (ms) |
|---|---|---|---|---|---|
| ClickHouse Managed Postgres | Small | 6172 | 41.466 | 64.027 | 80.89 |
| ClickHouse Managed Postgres | Large | 28668 | 8.908 | 10.231 | 11.683 |
| AWS Aurora | Small | 2685 | 95.297 | 165.546 | 298.391 |
| AWS Aurora | Large | 12628 | 20.242 | 30.972 | 39.044 |
| AWS RDS | Small | 4882 | 52.419 | 98.005 | 124.198 |
| AWS RDS | Large | 8133 | 31.435 | 72.509 | 97.688 |
| Neon | Small | 2847 | 89.907 | 106.145 | 116.473 |
| Neon | Large | 8563 | 29.832 | 41.423 | 49.213 |
| Crunchy Bridge | Small | 6338 | 40.376 | 66.109 | 85.837 |
| Crunchy Bridge | Large | 14790 | 17.269 | 28.322 | 34.61 |
スケールファクター 34247 (約 500 GB)
| Service | T-shirt size | TPS | Avg Latency (ms) | P95 (ms) | P99 (ms) |
|---|---|---|---|---|---|
| ClickHouse Managed Postgres | Large | 26328 | 9.703 | 11.402 | 13.197 |
| AWS Aurora | Large | 10402 | 24.581 | 36.178 | 46.493 |
| AWS RDS | Large | 5092 | 50.239 | 88.656 | 117.905 |
| Neon | Large | 7802 | 32.804 | 47.539 | 56.302 |
| Crunchy Bridge | Large | 11113 | 22.996 | 36.402 | 41.683 |
ClickHouse Managed Postgres がこのベンチマークでトップに立つ理由
TPC-B ワークロードは読み取りと書き込みの両方の操作を組み合わせたものであり、WAL レコードを生成する継続的な DML (UPDATE) アクティビティによって I/O 集中型になり得ます。このパターンは急成長する OLTP ワークロードに典型的なものであり、持続的な書き込みアクティビティによって WAL が生成され、ディスク性能が Postgres の性能を左右する極めて重要な要素となります。
ClickHouse Managed Postgres は、コンピュートと物理的に同じ場所に配置された NVMe ストレージを採用しています。これにより、ミリ秒単位ではなくマイクロ秒単位のディスクアクセスレイテンシを実現するとともに、テナント間で共有されることもネットワーク帯域幅に制約されることもない、一貫して高い IOPS を提供します。その結果、可用性や耐久性を損なうことなく、EBS やオブジェクトストレージなどの共有ストレージ上に構築されたアーキテクチャよりも大幅に優れたパフォーマンスを発揮できます。
対照的に、EBS ベースのボリュームなどの代替手段では、I/O パスにネットワークレイテンシが生じます。読み取りはカーネルのページキャッシュの恩恵を受ける可能性がありますが、トランザクションコミットを含むすべての fsync は、依然としてリモートストレージ層による確認応答を待つ必要があります。このベンチマークで使用されたような書き込み負荷の高いワークロードでは、コミットごとのオーバーヘッドが急速に蓄積され、パフォーマンスに直接影響を与えます。
TL;DR: ほとんどの場合、遅いのは Postgres ではなくストレージです。このトピックに関する詳細な技術解説も近日公開予定ですので、ご期待ください。
以下の画像は、ディスクバウンドなワークロードにおいて、従来の Postgres から NVMe を利用した Postgres に移行した際の P99 レイテンシの削減を示しています。
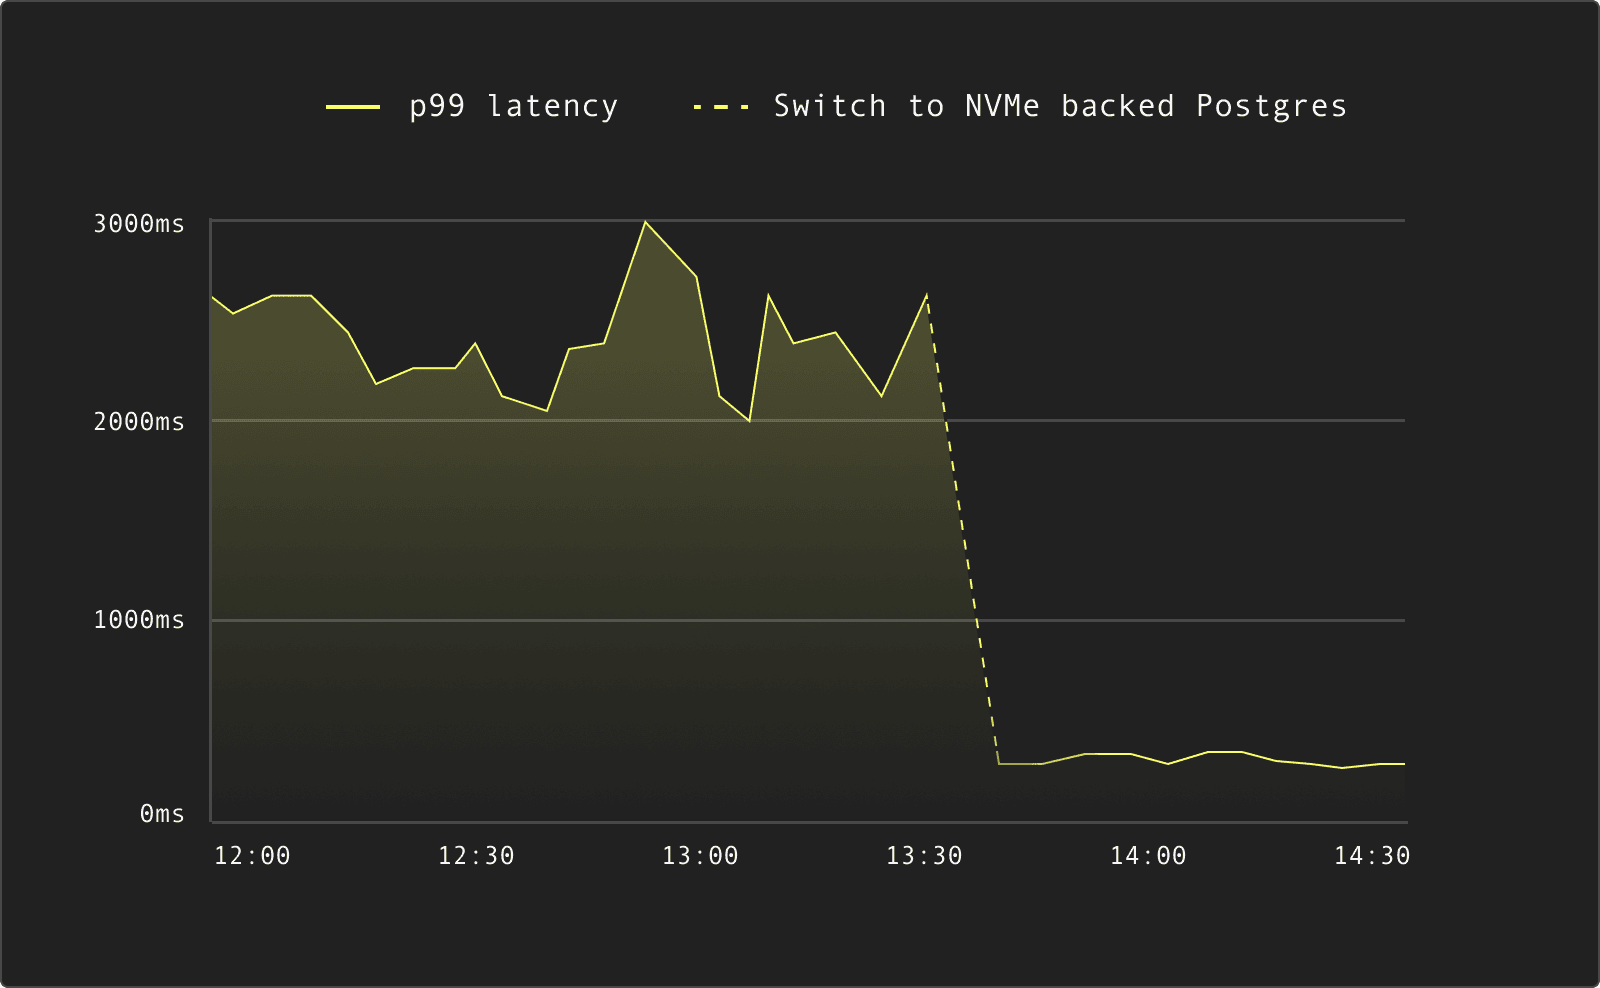
ディスク IOPS とレイテンシが主なボトルネックとなっている Postgres ワークロードにとって、このアーキテクチャの違いは決定的な要因となります。ベンチマーク結果にもそれが直接反映されています。
検証可能に設計
ベンチマークのリポジトリ全体はオープンソースとして公開されています。
実行ごとに構造化された JSON を公開することで、視覚的な比較だけでなくプログラムによる結果の比較も可能になります。リポジトリには、ベンチマークを実行するためのスクリプトやすべての生データが含まれています。設定が誤っていたり、いずれかのサービスに不当に有利に働いていたりする場合は、オープンな場で確認および修正できます。
リポジトリは github.com/ClickHouse/PostgresBench で入手できます。
結果の投稿
ご自身のインスタンスに対してベンチマークを実行するには、以下のコマンドを実行するだけです。実行には 30 分から 40 分ほどかかります。
# Set connection parameters
export PGHOST="your-database-host"
export PGPORT=5432
export PGUSER="postgres"
export PGPASSWORD="your-password"
export PGDATABASE="postgres"
# Required: instance hardware details
export VCPUS=16
export RAM_GB=64
# Required: instance metadata
export SYSTEM_NAME="Postgres by ClickHouse"
export INSTANCE_TYPE="m8gd.4xlarge"
export INSTANCE_STORAGE="950 GB - NVMe"
export PRIMARY_STORAGE="NVMe"
# Optional: output
export OUT_JSON="results.json" # Output file name (default: oltpbench_result.json)
# Run the benchmark
./run.shこのスクリプトはデータの初期化を処理し、ベンチマークを 3 回実行して、結果を JSON ファイルに書き込みます。
対象システムを追加する手順は以下のとおりです。
- ベンチマークリポジトリをクローンする
- ドキュメントに記載されたインフラのセットアップ手順に従い、テスト対象のインスタンススペックに合わせる
- 公開されているパラメータを指定して
run.shを実行する - 結果を提出するために Pull Request を作成する
- ClickHouse が設定をレビューし、結果を公開します
PostgresBench 公開中
PostgresBench が公開され、すべてのベンチマーク結果を自由に確認・比較できるようになりました。
ボードに対象システムを追加してみませんか? コントリビューションを歓迎しています。リポジトリをクローンし、ベンチマークを実行して結果を提出し、最も網羅的な Postgres パフォーマンスリファレンスの構築にご協力ください。
ネイティブ Postgres サービスを始める
ClickHouse のネイティブ Postgres サービスをお試しいただくには、こちらのリンクからプライベートプレビューにお申し込みください。
サインアップ