5万

編集者注
ClickHouse 25.11 では、parallel merge for small GROUP BY を導入しました。これは、FixedHashMap ベースの集計においてマージフェーズを並列化することで、8 ビットおよび 16 ビットキーに対する集計を大幅に高速化する最適化です。この機能については、25.11 リリースのブログ記事で簡単に紹介しています。
本稿は、この最適化を実装した Jianfei Hu によるオリジナルのエンジニアリング記事です。Jianfei は当初、問題に取り組む過程での個人的な徹底解説としてこれを執筆し、試行錯誤や ClickHouse の集計内部の仕組み、そして関わってくる微妙な並行処理やメモリ管理の課題について探求しました。
リリースノートでは伝えきれない以下の内容が克明に描かれているため、ほぼ原文のままお届けします。
この最適化の構築が実際にどのような体験であったか、そしてその過程で何が学べたのか。
背景
私は最近、https://github.com/ClickHouse/ClickHouse/pull/87366 の実装に取り組みました。アイデア自体はシンプルですが、ClickHouse の集計について多くの知見を得られたため、書き残しておきたいと思います。
発端となったイシューでは明確に示されていましたが、ほぼ同一のクエリを実行しても、パフォーマンスに大きな差が生じていました。
SELECT
number % 10000 AS k,
uniq(number) AS u
FROM numbers_mt(1000000000.)
GROUP BY k
ORDER BY u DESC
LIMIT 10┌────k─┬──────u─┐
1. │ 4759 │ 101196 │
2. │ 4587 │ 101079 │
3. │ 6178 │ 101034 │
4. │ 6567 │ 101032 │
5. │ 9463 │ 101013 │
6. │ 298 │ 101009 │
7. │ 2049 │ 100993 │
8. │ 8167 │ 100989 │
9. │ 5530 │ 100973 │
10. │ 1968 │ 100973 │
└──────┴────────┘
10 rows in set. Elapsed: 62.793 sec. Processed 1.00 billion rows, 8.00 GB (15.93 million rows/s., 127.40 MB/s.)
Peak memory usage: 11.30 GiB.SELECT
0 + (number % 10000) AS k,
uniq(number) AS u
FROM numbers_mt(1000000000.)
GROUP BY k
ORDER BY u DESC
LIMIT 10┌────k─┬──────u─┐
1. │ 4759 │ 101196 │
2. │ 4587 │ 101079 │
3. │ 6178 │ 101034 │
4. │ 6567 │ 101032 │
5. │ 9463 │ 101013 │
6. │ 298 │ 101009 │
7. │ 2049 │ 100993 │
8. │ 8167 │ 100989 │
9. │ 5530 │ 100973 │
10. │ 1968 │ 100973 │
└──────┴────────┘
10 rows in set. Elapsed: 8.547 sec. Processed 1.00 billion rows, 8.00 GB (116.99 million rows/s., 935.95 MB/s.)
Peak memory usage: 10.09 GiB.- 唯一の違いは、2 つ目のクエリが GROUP BY の値
kに0 + (number % 10000)を使用している点だけです。 - ClickHouse は 1 つ目のクエリの k を UInt16 として扱い、2 つ目のクエリでは UInt64 として扱います。
しかし、なぜこれが重要なのでしょうか。ClickHouse における集計の技術的な詳細を少し掘り下げてみましょう。
集計の仕組み
UInt16 より小さい数値で GROUP BY を行う場合、ハッシュマップの代わりに配列を使用できます。
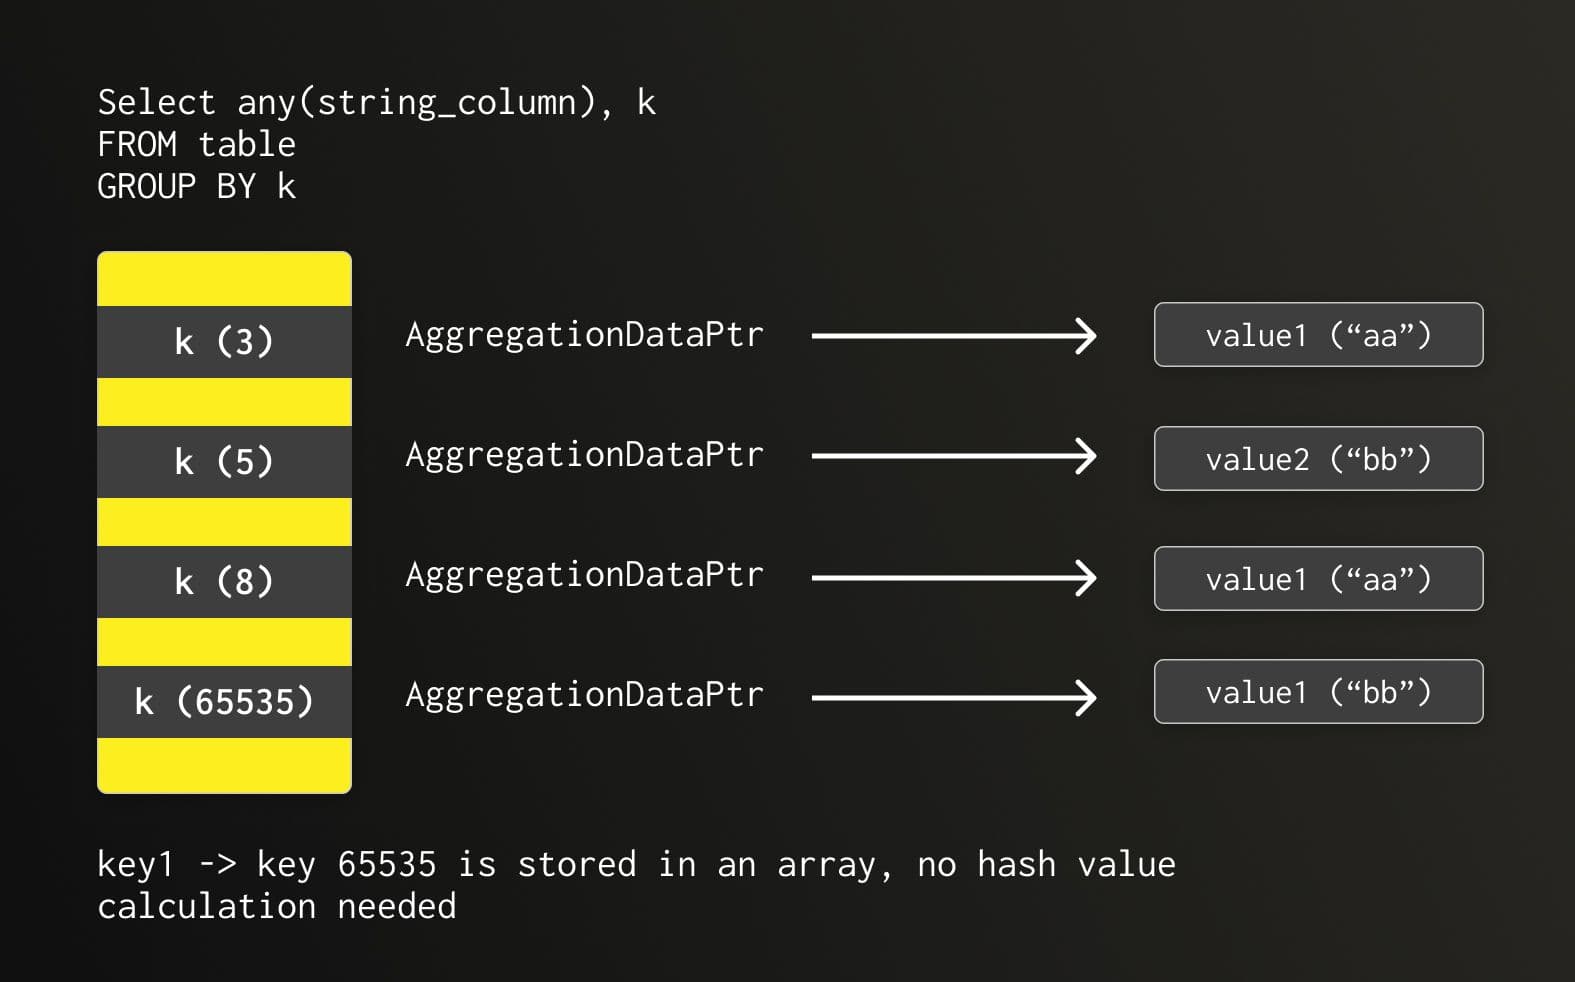
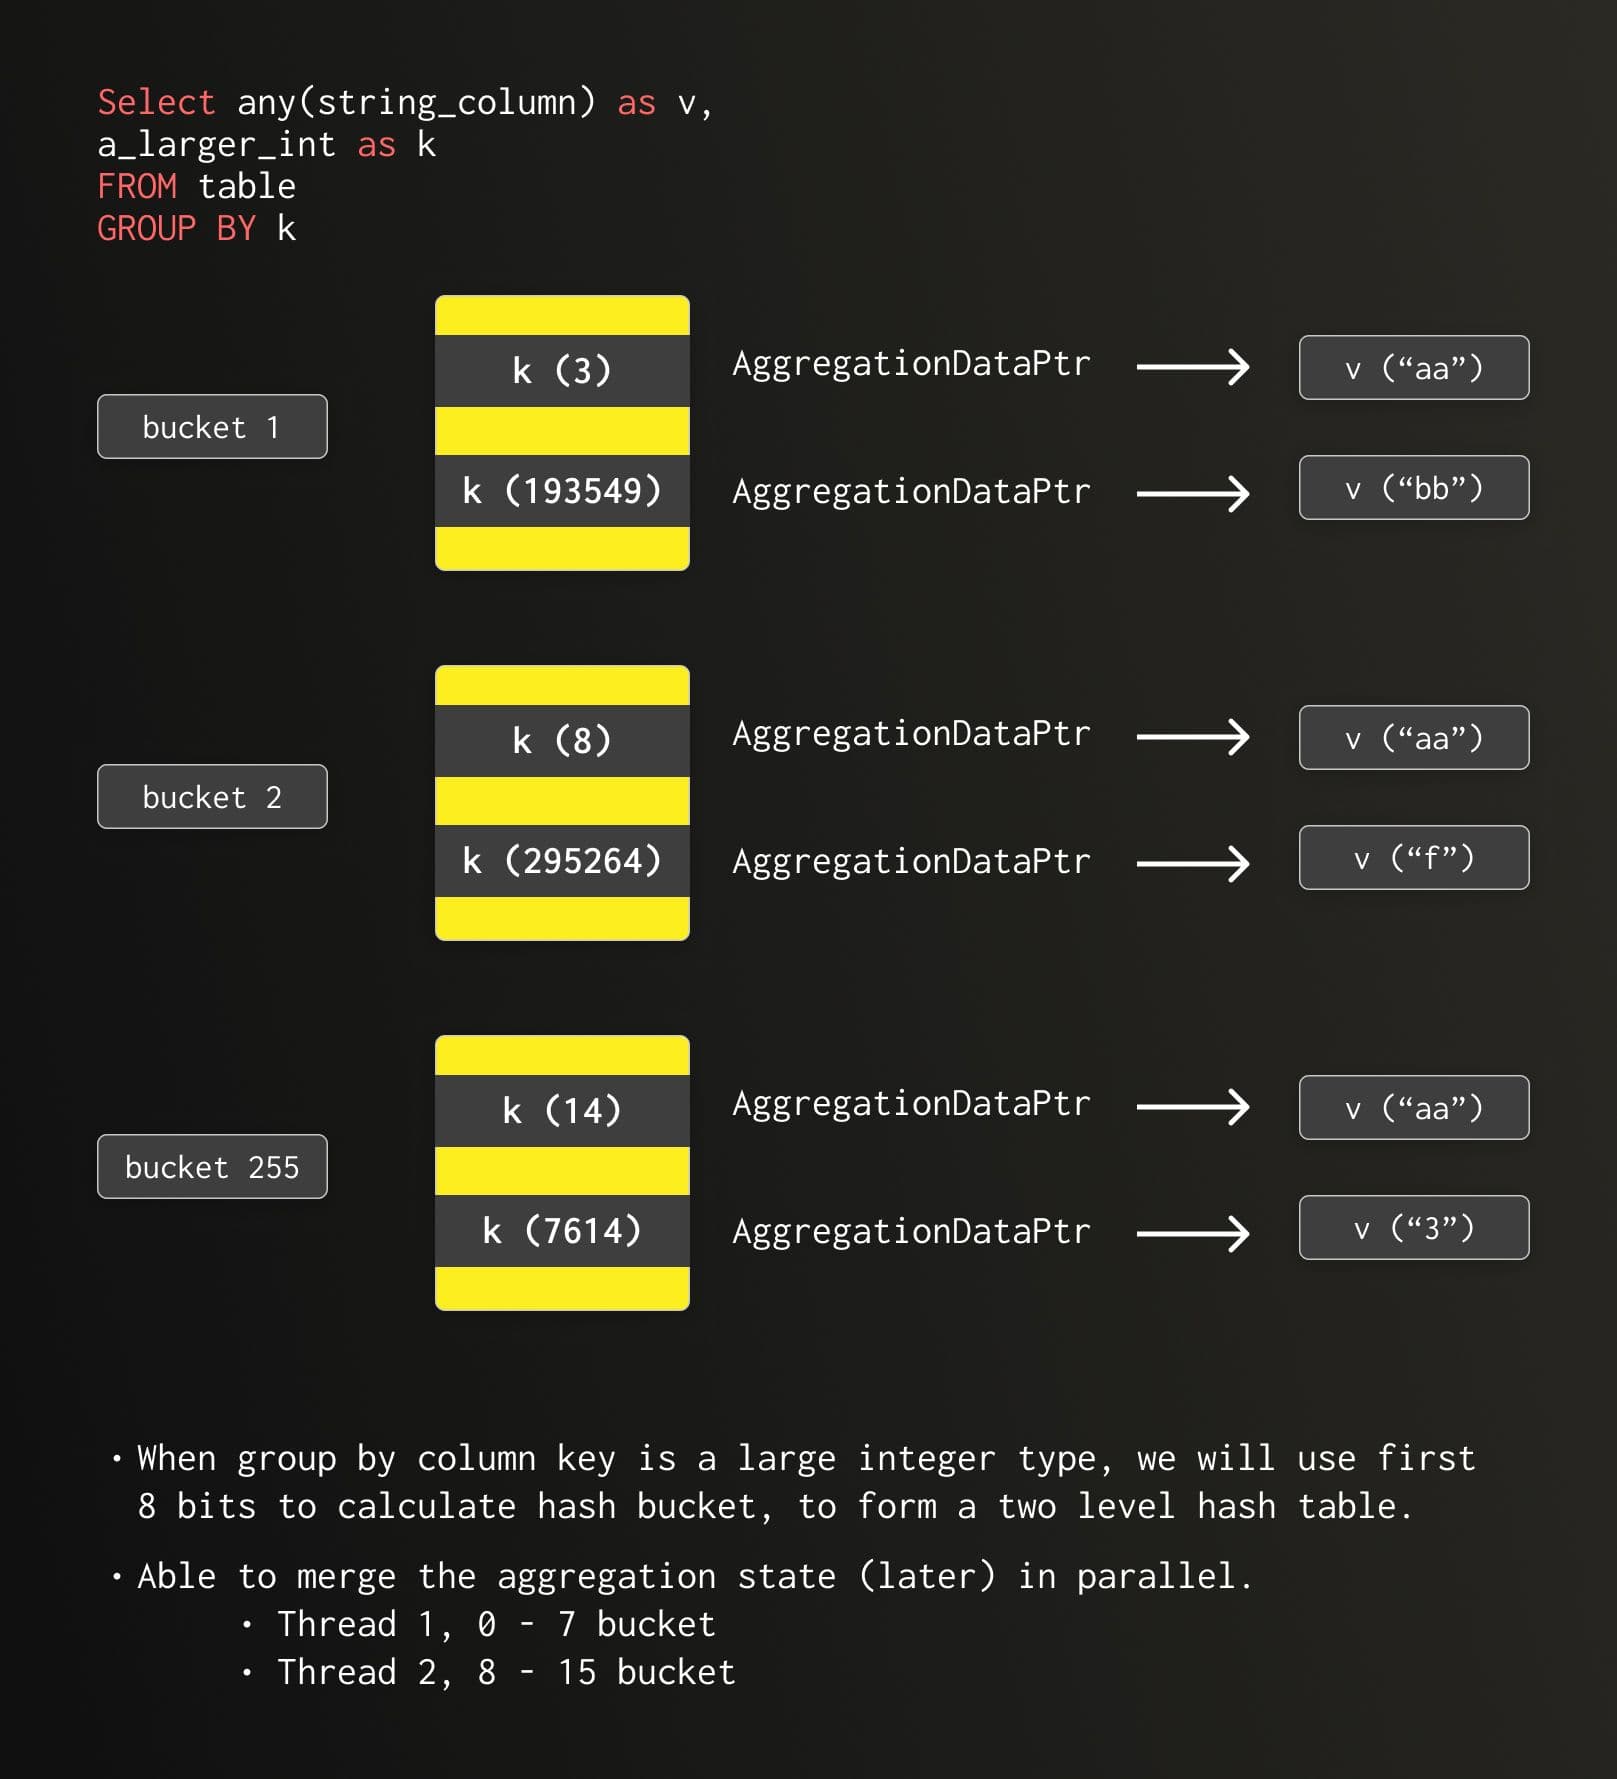
それ以外の場合は標準のハッシュマップが使われ、状況に応じて 2 レベルハッシュマップに変換されます。
これが集計状態のマージにおいて何を意味するのでしょうか。
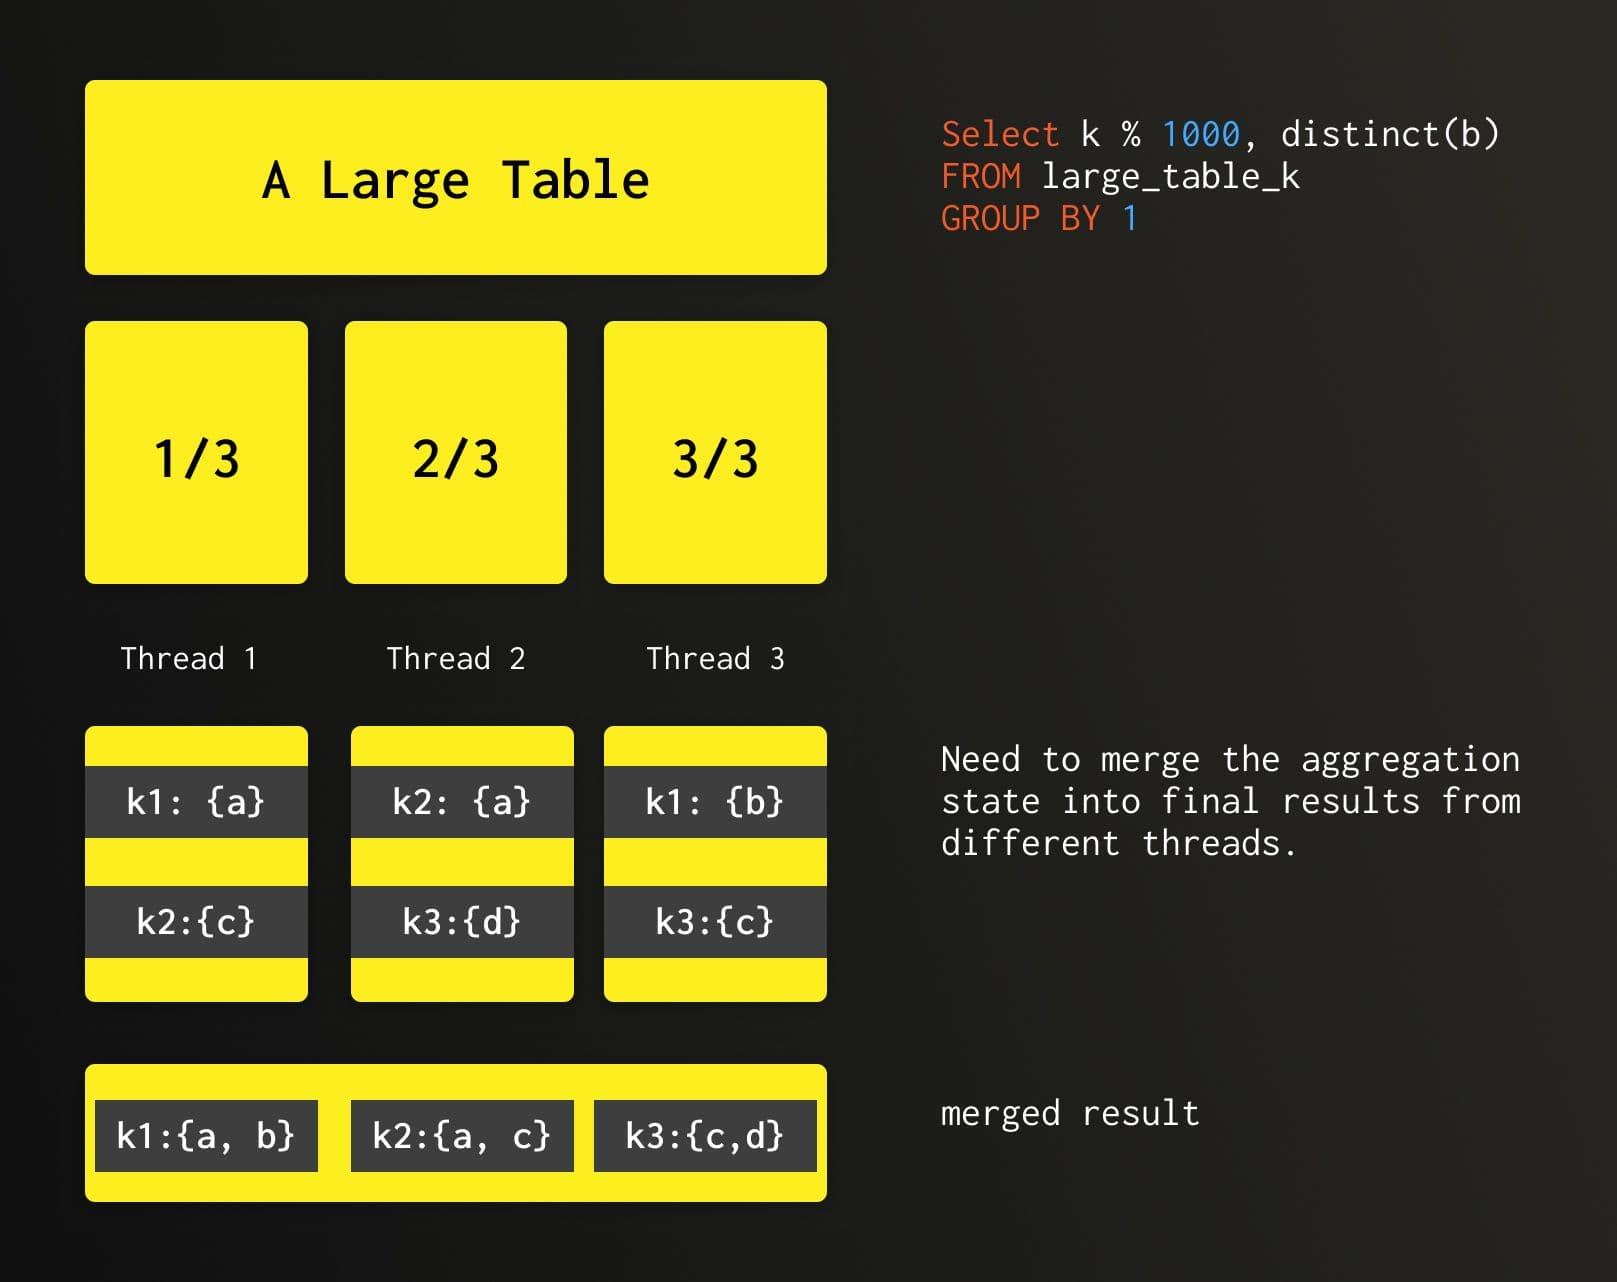
これで、1 つ目のクエリが遅い理由が明らかになりました。
- 各スレッドが 2 レベルハッシュテーブルを持つ場合、マージは並列化できます。T1 はバケット 0〜7 を処理し、T2 は 8〜15 を処理する、といった形です。
- 固定ハッシュマップ(FixedHashMap)が使われる場合、すべての集計状態は単一の 1 次元配列に格納されます。そのため、このようなバケットベースの並列マージができません。
改善
-
当初のアイデアは、1 次元配列を 2 レベルに変換することでしたが、これでは遅いことが判明しました。
-
Nikita T. が次のアイデアを提案してくれました。各マージワーカースレッドが、互いに素な GROUP BY キーの部分集合をインプレースで処理するようにすれば、競合状態も発生せず、変換も不要になるというものです。
-
こうして私の実装が始まりました。ただし、学ぶべきことはまだたくさんありました。
範囲ベースの分割がうまく機能しない
直感的に最初に思いついたのは、キーを異なる範囲に分割することでした。
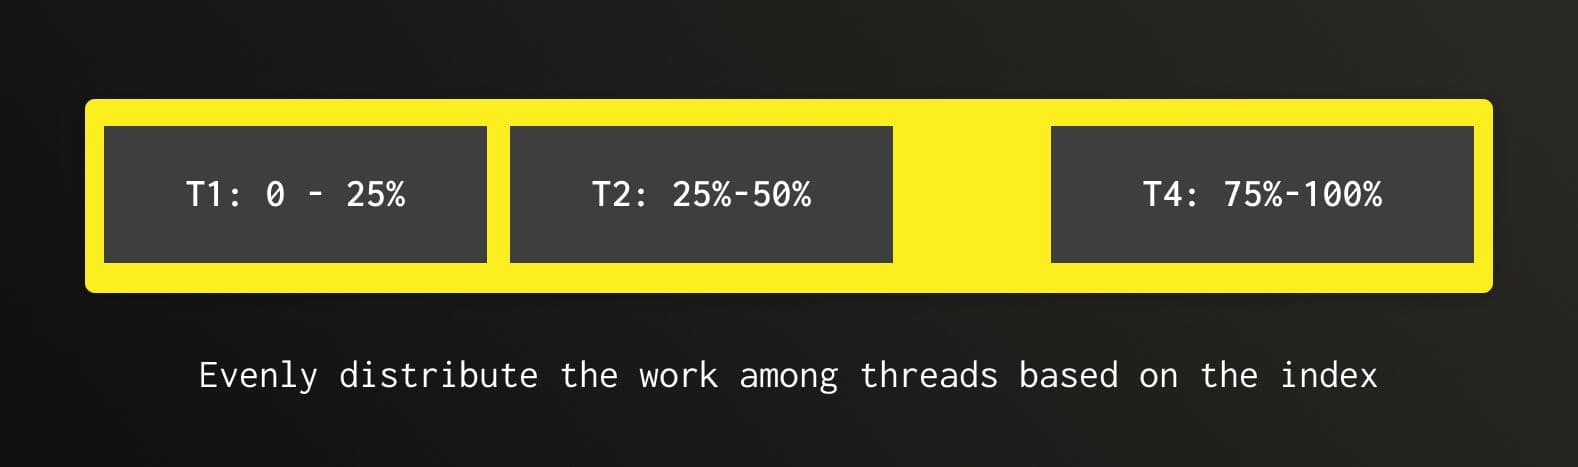
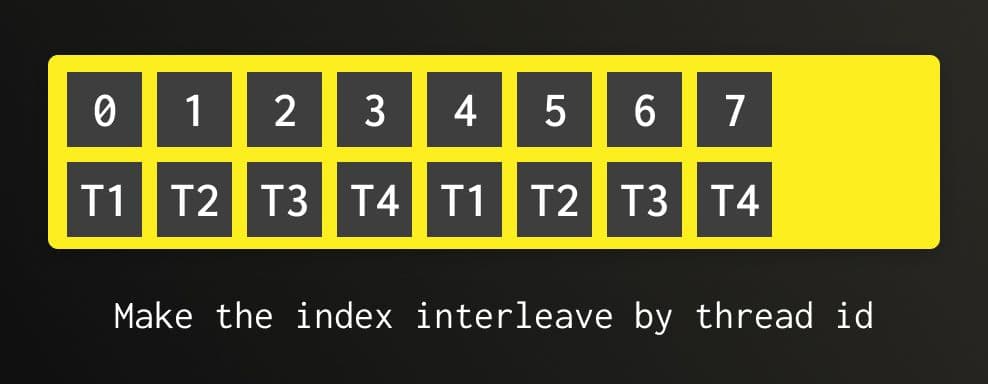
高速化はしたものの、それほどでもありませんでした。フレームグラフは変わりませんでした。並列化によって経過時間(ウォールクロック時間)は変化しても、スタックトレースの CPU 時間は同じだからです。スタックトレースを見るだけでは原因を把握できません。ログ出力と、スレッド ID ごとの所要時間の確認によってこれに気づきました。
これがわかったため、マージ作業の分散方法を変更することにしました。
奇妙なメモリ破壊エラー
ある時点で、メモリ解放時のエラーにより CI が失敗しました。サイズに関する特定のアサーションチェックが失敗したのです。
2025.09.22 01:04:58.132587 [ 906517 ] {} <Fatal> BaseDaemon: 10. /home/incfly/workspace/github.com/ClickHouse/ClickHouse/src/Common/Exception.h:58: DB::Exception::Exception(PreformattedMessage&&, int) @ 0x000000000b549785
2025.09.22 01:04:58.243209 [ 906517 ] {} <Fatal> BaseDaemon: 11. /home/incfly/workspace/github.com/ClickHouse/ClickHouse/src/Common/Exception.h:141: DB::Exception::Exception<unsigned long&>(int, FormatStringHelperImpl<std::type_identity<unsigned long&>::type>, unsigned long&) @ 0x000000000bce6cab
2025.09.22 01:04:58.248715 [ 906517 ] {} <Fatal> BaseDaemon: 12.0. inlined from /home/incfly/workspace/github.com/ClickHouse/ClickHouse/src/Common/Allocator.cpp:119: (anonymous namespace)::checkSize(unsigned long)
2025.09.22 01:04:58.248738 [ 906517 ] {} <Fatal> BaseDaemon: 12. /home/incfly/workspace/github.com/ClickHouse/ClickHouse/src/Common/Allocator.cpp:144: Allocator<false, false>::free(void*, unsigned long) @ 0x000000001272c82e
2025.09.22 01:04:58.265559 [ 906517 ] {} <Fatal> BaseDaemon: 13. /home/incfly/workspace/github.com/ClickHouse/ClickHouse/src/Common/Arena.h:94: DB::Arena::MemoryChunk::~MemoryChunk() @ 0x000000000c8858a2
2025.09.22 01:04:58.281901 [ 906517 ] {} <Fatal> BaseDaemon: 14.0. inlined from /home/incfly/workspace/github.com/ClickHouse/ClickHouse/contrib/llvm-project/libcxx/include/__memory/unique_ptr.h:80: std::default_delete<DB::Arena::MemoryChunk>::operator()[abi:se190107](DB::Arena::MemoryChunk*) const
2025.09.22 01:04:58.281922 [ 906517 ] {} <Fatal> BaseDaemon: 14.1. inlined from /home/incfly/workspace/github.com/ClickHouse/ClickHouse/contrib/llvm-project/libcxx/include/__memory/unique_ptr.h:292: std::unique_ptr<DB::Arena::MemoryChunk, std::default_delete<DB::Arena::MemoryChunk>>::reset[abi:se190107](DB::Arena::MemoryChunk*)自分の変更がどのようにメモリ管理の問題を引き起こしているのか、見当もつきませんでした。コードを読むうちに、DB::Arena がメモリ管理において非常に興味深い手法であることに気づきました。
クエリ実行中に、中間結果(今回の集計状態など)のために多数の小さな文字列を作成する必要があるとします。これらは短命で、すべて一括して削除されます。これに対処する従来の方法は、空き領域を維持し、リンクリストを使用して割り当て済みメモリ領域と空きメモリ領域を管理することです。
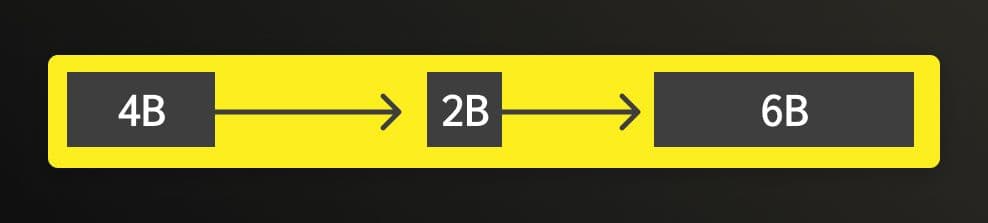
しかし DB::Arena では、単一のオフセットインデックス変数を使用して次の空きメモリ位置を記録するだけです。サイズ M バイトを割り当てるたびに、Arena は単に offset をポインタとして返し、M を加算します。
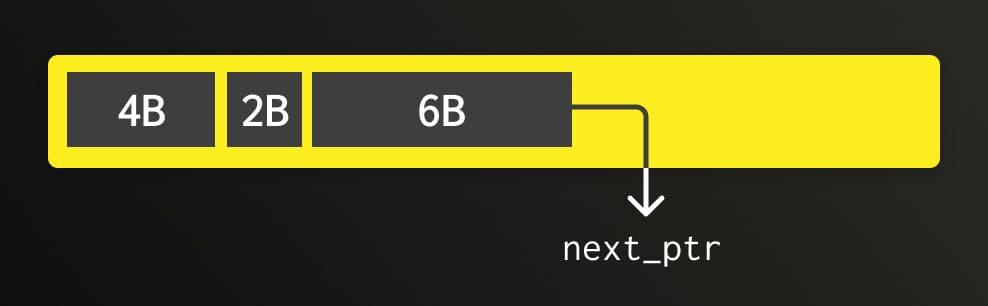
- スロットを見つけるための走査がないため、極めて高速です。
- 個別のメモリを解放することはできませんが、すべてのオブジェクトが一度に解放されるこのユースケースでは問題ありません。Arena 領域全体を解放するだけです。
私の直面した問題に戻ります。いくつか異なる、しかし関連する失敗が見られました。
- 大量の集計を実行するとセグメンテーション違反で終了することがあり、スタックトレースも関連する Arena のコードを示していました。
- クエリ結果が時折誤ることもありました。
これらすべてが、メモリ割り当ての競合状態を示していました。コードを再確認したところ、Arena はスレッドセーフではなく、既存の 2 レベル集計ではマージ中にスレッドごとに 1 つの Arena を使用していました。同一の Arena を誤って共有していた問題を修正したことで、このエラーは解決しました。
単純な count/select でのパフォーマンス低下
上記のサンプルクエリで集計関数を count/sum/min/max などの単純なものに置き換えると、高速化しないどころか、かえって遅くなることがわかりました。マージ処理自体が極めて単純である場合、並列マージのオーバーヘッドがメリットを上回ってしまうからだと考えました。そのため、これらのケースでは最適化を無効化しました。
しかし、レビュー担当者から慎重に理由を解明すべきだと指摘されました。
- 固定ハッシュマップは、反復処理などの操作を高速化するために min / max インデックスを記録します。競合状態を避けるために、これを無効化していました。
- つまり、
k % 100のようにデータが入っている要素だけでなく、配列全体を走査しなければならなくなっていたのです。 - 処理速度が低下したすべてのクエリは、例外なく同じ時間(3 ms)遅くなっていました。
解決策:並列マージの前に min/max インデックスを抽出しておき、走査範囲を制限するようにしました。
その他の技術的詳細
ClickHouse の CI パフォーマンステストでは、差分フレームグラフが提供されます。これにより、新たに生じた小さなパフォーマンスペナルティを特定できます。以下の例をご覧ください。

-
FixedHashMap.h:123# Aggregator::mergeDataImplでわずかな増加が確認されました。これはisZero関数を指しています。しかし、なぜ Aggregator の関数として注釈が付いているのでしょうか。同じ関数内にインライン展開されていても、元のソースコードが別のファイルにあることをコンパイラが認識する仕組みによるものです。 -
新しい関数
mergeSingleLevelDataImplFixedMapなどがなぜ白く表示されているのかについては、まだ完全には理解できていません。フレームグラフの差分計算に何らかの工夫があるのだと思われます。