5万


前回の記事では、Prometheus をはじめとするシリーズ指向の時系列データベースにおいて、高カーディナリティがなぜ課題を引き起こすのかを解説しました。ラベルの一意な組み合わせごとに独立した時系列が作成される基盤のストレージモデルが、次元数やチャーンの増加に伴い、メモリオーバーヘッド、書き込み増幅、運用上の複雑さ、クエリ時のトレードオフをどのようにもたらすかを見てきました。
ClickHouse はオブザーバビリティのワークロードに利用した際、高カーディナリティの影響を大きく受けないと私たちが述べるのをよく耳にするかもしれません。これは私たちが通常想定しているワークロードには当てはまりますが、補足が必要です。ClickHouse でもカーディナリティのコストは発生しており、それは主に取り込み時ではなくクエリ時に生じます。
本記事では、ClickHouse、ひいては列指向データベース全般が、高カーディナリティのオブザーバビリティデータを Prometheus のようなシステムと比べてなぜこれほど異なって処理できるのかを解説します。
また、このモデルが Prometheus よりも劣る点についても取り上げます。ClickHouse は Prometheus の完全な代替品(ドロップインの置き換え)ではなく、このアプローチを採用するには、テレメトリ、計装、集約に関する考え方を根本から変える必要があります。
ClickHouse におけるカーディナリティの違いの理由
ClickHouse で高カーディナリティが異なる挙動を示す理由を理解するには、まずオブザーバビリティデータのモデル化の方法を見直す必要があります。ClickHouse では、テレメトリを独立して管理される数百万もの時系列として扱うのではなく、属性と測定値を含み、後からクエリ時に集約できるテーブルの行としてメトリクスを表現する形へのシフトを推奨しています。
これはよく「ワイドイベント(wide events)」アプローチと呼ばれ、Charity Majors 氏などの実務家によって広く普及しました。わかりやすく言えば、メトリクスが付属したログと捉えることもできます。まずは、これが従来の Prometheus スタイルのメトリクスモデルとどう異なるのかを見てみましょう。
ワイドイベントとしてのメトリクス
強調しておきたいのは、私たちは ClickHouse 内で Prometheus のメトリクス、メトリクス型、PromQL のセマンティクスを直接モデル化しようとしているわけではないという点です(この分野の取り組みは進行中であり、このモデルには確かに利点もありますが、それらについては後ほど取り上げます)。そうではなく、ワイドイベントのアプローチが促すのは、従来の Prometheus のメトリクスモデルから脱却し、オブザーバビリティデータ全般をイベントスタイルのモデルへとより大きくシフトさせることです。
このモデルでは、テレメトリは独立して管理される時系列としてではなく、ディメンション、属性、数値の測定値を含むタイムスタンプ付きイベントとして表現されます。メトリクスを固有の ID やライフサイクルを持つ個別のシリーズとして保存する代わりに、各イベントにはコンテキストに応じた属性と 1 つ以上の数値の測定値が併せて格納されます。クエリは、読み取り時にこれらのイベントを動的に集約し、目的のビュー、レート、サマリー、タイムバケットへと変換します。
重要なのは、これが多くの場合、テレメトリを生成するためのより柔軟で自然な方法だということです。厳格なメトリクススキーマを事前に定義する代わりに、アプリケーションは数値を含む構造化イベントを出力するだけで済みます。ClickHouse を用いたオブザーバビリティ構成で一般的なパターンは、otel_logs などのワイドイベントスキーマを使用して、ログと一緒にメトリクスを直接保存することです。
例えば、レスポンス時間、リクエスト数、ステータスコード、ホストに対して複数の独立したメトリクスを定義する代わりに、サービスからは以下のようなイベントを出力するだけで済みます。
logger.Info("request completed",
zap.String("host", "host-42"),
zap.String("application", "checkout-service"),
zap.String("request_path", "/api/payments"),
zap.Uint16("status", responseStatus),
zap.Uint64("response_time", responseTime),
zap.Uint64("size", responseSize),
)ワイドイベントを用いると、リクエストそのものがテレメトリの自然な単位となります。すべてのコンテキストディメンションと測定値は、同一のイベントに関連付けられたまま保持されます。Prometheus スタイルのモデルでは、これと同じ情報が通常、複数のメトリクス定義、カウンター、ゲージ、ヒストグラム、ラベルの組み合わせへと分解されます。このようにいったん集計値へと圧縮されてしまうと、個々のシグナルは失われ、復元できなくなります。ワイドイベントはこれを反転させます。集計値は生イベントを置き換えるのではなく、生イベントから導き出されるため、グラフ上のどのような急増(スパイク)であっても、それを引き起こした正確なリクエストまで遡って追跡できます。
今すぐ始める
自社のオブザーバビリティデータで ClickHouse を試してみませんか?ClickHouse Cloud の Managed ClickStack は数分で利用開始でき、300 ドル分の無料クレジットも進呈されます。
サインアップ列指向ストレージ
ワイドイベントモデルを採用する際、まずは従来の分析ワークロードに倣って、各ラベルを専用のカラムとしてモデル化しようと考えるかもしれません。これは安定したスキーマであればうまく機能しますが、オブザーバビリティにおいては実用的であることは稀であり、ワイドイベントスキーマとも言えません。ラベルは動的で高カーディナリティ、かつ予測不能であることが多いため、厳密なスキーマをあらかじめ定義して維持するのは難しく、現実世界のテレメトリデータには適していません。
CREATE TABLE metrics
(
`time` DateTime CODEC(Delta(4), ZSTD(3)),
`host` LowCardinality(String),
`application` LowCardinality(String),
`request_path` String,
`remote_addr` IPv4,
`remote_user` LowCardinality(String),
`request_type` LowCardinality(String),
`request_protocol` LowCardinality(String),
`status` UInt16,
`domain_referer` LowCardinality(String),
`browser` LowCardinality(String),
`device` LowCardinality(String),
`response_time` UInt16,
`size` Decimal(7, 1)
)
ENGINE = MergeTree
ORDER BY (host, toStartOfMinute(time), status, application, request_path, remote_addr)上記のスキーマはラベルごとにカラムを設けて最適化されていますが、新しいメトリクスが頻繁に追加される非常に動的な環境では現実的ではありません。これは推奨されるワイドイベントスキーマではありません。
このような動的な構造を扱うため、ClickHouse では Map 型の使用を推奨しています。
公式ドキュメントで詳しく解説している理由から、オブザーバビリティのワークロードには JSON 型よりも Map 型の使用をお勧めします。
Map 型はラベルをキーと値のペアとして保存し、キーがラベル名、値がラベル値を表します。主な制限は、すべてのキーと値がそれぞれ同一の型を共有しなければならない点であり、マップは Map<String, type> として定義されます。実際には、値は文字列として保存されるのが一般的です。これは柔軟である一方、値を数値やその他の厳密に型定義されたデータとして解釈する必要がある場合には、クエリ実行時の型キャストが求められることがあります。
歴史的には、Map には読み取り時にも大きなデメリットがありました。1 つのラベルを読み取るだけでも、マップ構造全体とそれに関連するすべてのラベルを読み取る必要があり、大きな I/O オーバーヘッドが発生していました。しかし、最近導入された Sharded Map のサポートにより、マップコンテンツへのより選択的なアクセスが可能になり、この問題は大幅に緩和されています。
先ほどの例を踏まえると、ワイドイベントのテーブルスキーマは以下のようになります。
CREATE TABLE events
(
`time` DateTime CODEC(Delta(4), ZSTD(3)),
`labels` Map(LowCardinality(String), String),
`response_time` UInt16 MATERIALIZED toUInt16(labels['response_time']),
`host` LowCardinality(String) MATERIALIZED labels['host'],
`status` LowCardinality(String) MATERIALIZED labels['status'],
`application` LowCardinality(String) MATERIALIZED labels['application'],
INDEX idx_labels_keys mapKeys(labels) TYPE text(tokenizer = array),
INDEX idx_labels_vals mapValues(labels) TYPE text(tokenizer = array)
)
ENGINE = MergeTree
ORDER BY (host, toStartOfMinute(time), status, application)
SETTINGS
map_serialization_version = 'with_buckets',
max_buckets_in_map = 32,
map_buckets_strategy = 'sqrt';ここでの設定により Map のシャーディングが強制されている点にご注意ください。詳細はこちらを参照してください。
原則として、このスキーマは大幅に簡略化されてはいるものの、ClickStack が OpenTelemetry ログ用に使用しているスキーマと非常によく似ています。ClickStack では、リソースおよびスコープ属性が実質的に動的なラベル Map として機能します。
このスキーマは、後述する Map のキーや値に対するテキストインデックスなど、同様の技術を活用しています。そのため、「シリーズオブジェクト」という観点で考えるのではなく、ClickHouse はタイムスタンプ、シャーディングされたラベルの Map、およびメトリクス値用の通常の数値カラムを含むデータ行を単に保存します。
また、頻繁にフィルタリングやアクセスが行われると予想されるラベル Map のキーをマテリアライズし、ディスク上に専用カラムとして存在させられるようにしました。このマテリアライズは挿入時に自動的に行われ、ClickHouse はクエリ時にラベル Map へアクセスすることなく、これらのディメンションを直接フィルタリング、プルーニング、読み込みできるようになり、一般的なアクセスパターンにおける I/O が削減されます。
同じアプローチは、頻繁にクエリされる数値にも適用できます。上記の例では、response_time は定期的に集計されることが予想されるため、Map から専用の型付きカラムへとマテリアライズされています。これにより、avg(response_time) などの演算やパーセンタイル計算を実行する際に、Map への繰り返しのアクセスやクエリ時の型キャストを回避できます。
重要な点として、マテリアライズドカラムはデータがすでに取り込まれた後からでも追加できます。新しく挿入される行ではマテリアライズドカラムがディスク上に物理的に保存される一方、古い行でもクエリ実行時に元の Map から間接的に値を解決できます。たとえば、後から labels['region'] が頻繁に使われるフィルターになったと判断した場合、次のように追加できます。
ALTER TABLE events
ADD COLUMN region LowCardinality(String)
MATERIALIZED labels['region'];新しいデータは、テーブル全体の書き換えを必要とすることなく、直接的なカラムアクセス、プルーニング、圧縮率の向上の恩恵をすぐに受けられる一方で、過去の行も region 経由で引き続きクエリ可能です。
内部的には、Map はキーと値のペアの配列として表現され、ラベル名のハッシュに基づいてキーを複数の独立したバケットに分散させるバケット化シリアライゼーションを採用しています。これにより、特定のラベルを読み取るクエリは、完全な Map 構造ではなく、そのキーを含むバケットにのみアクセスすれば済みます。メトリクスカラム自体は個別に保存され、ラベルとは別に圧縮されます。
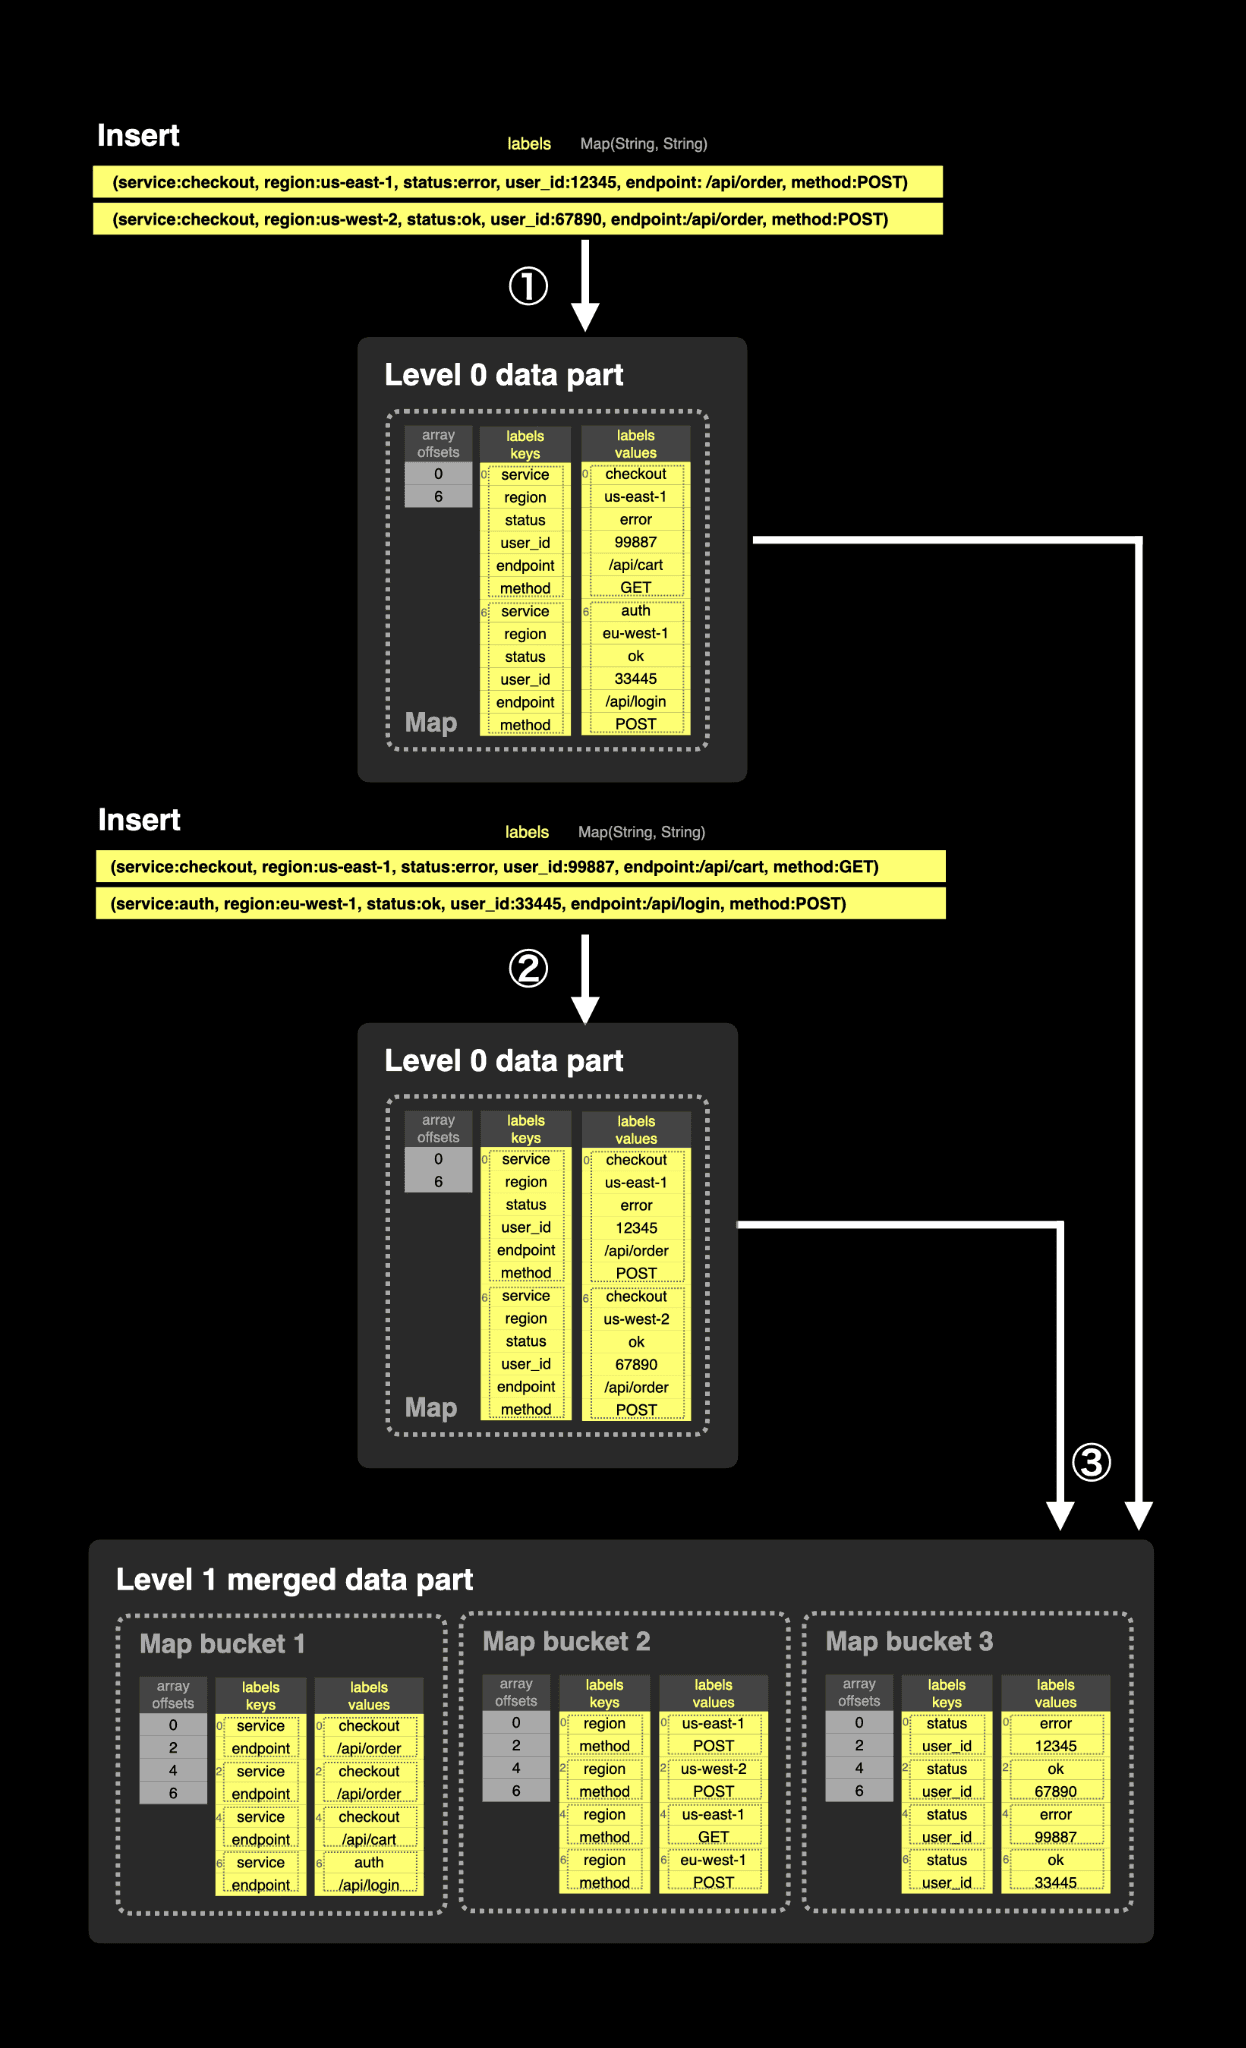
① 各挿入では、初期状態としてデフォルトの
Mapレイアウトを使用したレベル 0 のパートが作成され、キーと値はバケット化されずにフラットな配列として保存されます。 ② 追加の挿入によって、同じ形式のレベル 0 パートがさらに作成されます。これらのパートは小さいため、通常、キーと値の配列全体をスキャンするコストはわずかです。 ③ バックグラウンドマージの際、ClickHouse はキーをハッシュ化してより小さな独立したバケットに分割することで、Mapをバケット化ストレージに書き換えます。labels['status']のようなキーにアクセスする際、ClickHouse はキーのハッシュを計算し、Map 全体ではなく該当するバケットのみを読み取るため、読み取り時の I/O を大幅に削減します。実際には、Map のサイズに応じて単一キーのルックアップ性能が 2〜49 倍向上します。
Prometheus はその逆です。Prometheus では、新しいラベルの組み合わせごとに独自のメタデータ、チャンク、インデックス作成のオーバーヘッドを伴う新しいシリーズオブジェクトが作成されます。ClickHouse では、ラベル値の新しい組み合わせを追加しても、新しい構造オブジェクトやインメモリのシリーズ表現が作成されることはありません。異なるラベル値のセットを含む別の行が単に追加されるだけです。 行が挿入されると、対象テーブルの主キー(この場合はホスト、1 分精度のタイムスタンプ、ステータス、アプリケーション)でソートされたパートとしてディスクに書き込まれます。読み取り時の将来の I/O を最小限に抑えるため、ZSTD 圧縮の前に各カラムにコーデックを適用できます。
テーブルごとのパート数を管理するために、バックグラウンドのマージジョブが、指定されたソート順を維持しながら、設定可能な圧縮サイズ(通常は約 150 GB)に達するまで、定期的に小さなパートを大きなパートへと結合します。時間の経過とともに、このプロセスによってマージされたパートの階層構造が作られます。
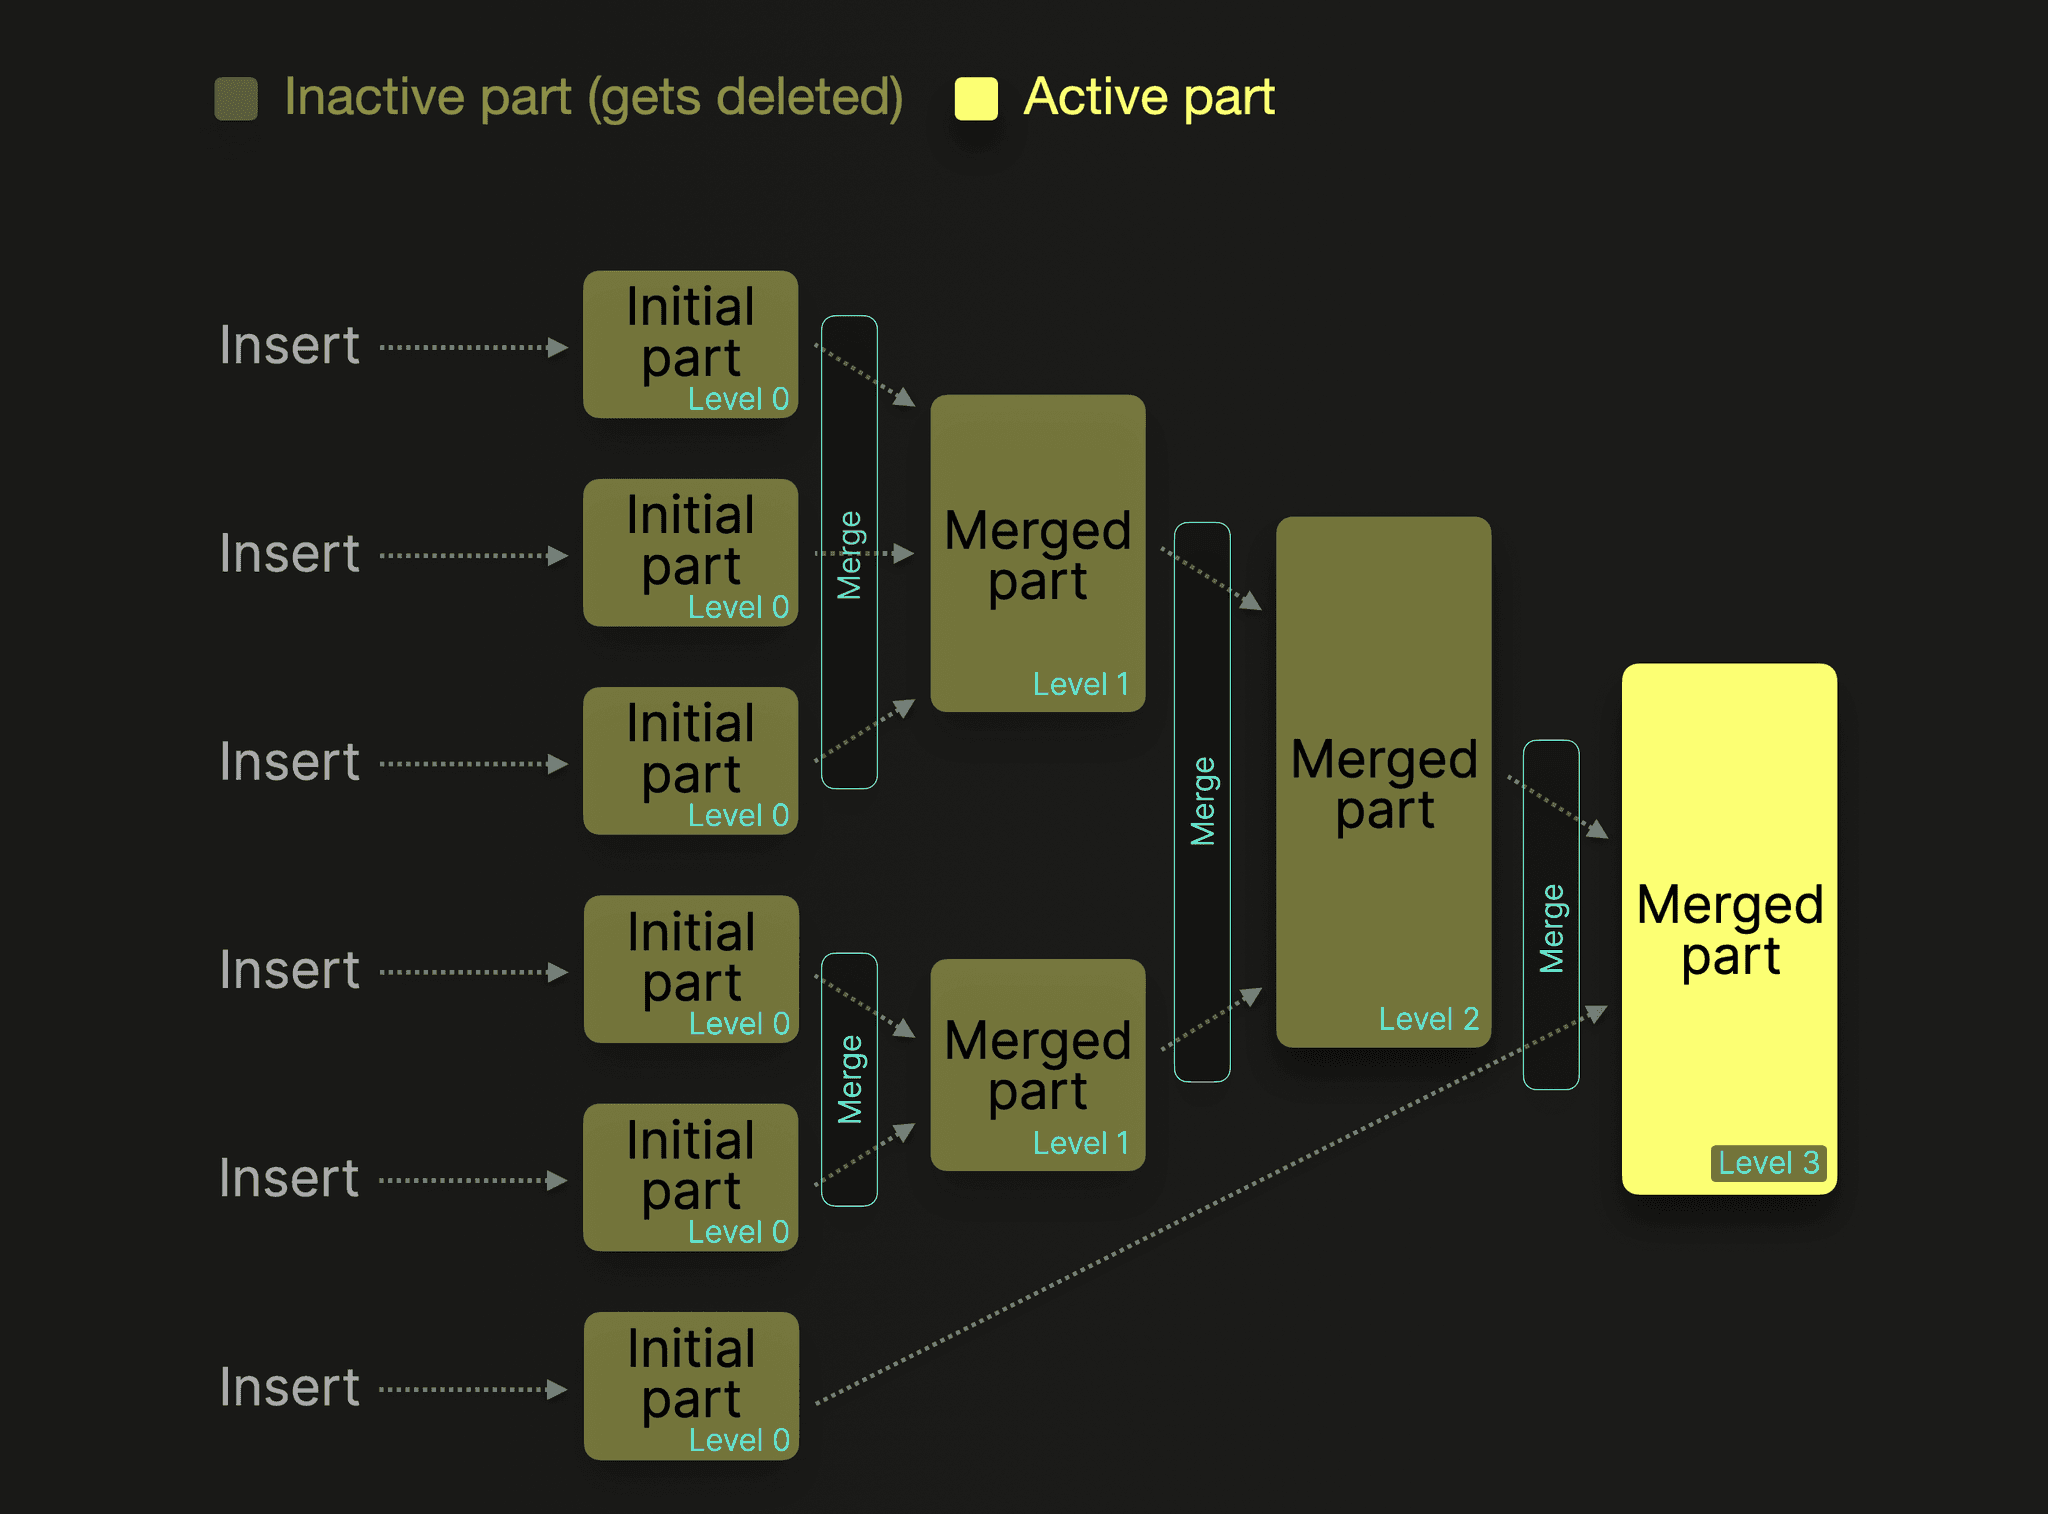
挿入時、ClickHouse はシリーズオブジェクトではなく行を書き込みます。
列指向ストレージのメリット
ラベル自体を完全に独立したカラムとしてではなく Map に格納している場合でも、テーブルの列指向とソートによっていくつかの重要なメリットが得られます。
-
データプルーニングによる高速なフィルタリング - テーブルのソートキーに対してスパースインデックスが構築されます。この場合、ソートキーはラベルの Map からマテリアライズされた頻繁にフィルタリングされるディメンションと、それに続くタイムスタンプで構成されます。
上記の例では、host、status、application などのラベルが専用のカラムにマテリアライズされ、ソートキーに含まれています。データはパートに格納され、各パートは約 8,000 行のグラニュールに分割されます。ClickHouse はすべての行にインデックスを付けるのではなく、各グラニュールについてソートキーのカラムの最初の値を記録します。これが、インデックスがスパース(疎)と呼ばれる理由です。
データは頻繁にクエリされるディメンション、そして時間の順で物理的に並べ替えられるため、類似した値を持つ行はディスク上で自然にグループ化されます。これにより、クエリが host、application、status などの一般的なラベルや時間範囲でフィルタリングを行う際に、ClickHouse はグラニュールを効率的にプルーニング(不要なデータの読み飛ばし)できます。データセット全体をスキャンする代わりに、無関係なデータの大部分をスキップし、一致する行が含まれる可能性が高いグラニュールのみを読み取ることができるため、I/O が大幅に削減され、クエリパフォーマンスが向上します。
mapKeys(labels)およびmapValues(labels)に対するセカンダリインデックスが、これをさらに補完します。これらの転置インデックスにより、ClickHouse は専用のカラムにマテリアライズされていないラベルでフィルタリングする場合でもグラニュールをプルーニングできるため、変動の激しいディメンションに対する柔軟性を維持できます。
-
圧縮 - ラベルを Map 内に保存している場合でも、ClickHouse はオブザーバビリティのワークロードに対して優れた圧縮率を実現します。データは、host、status、application といった頻繁にフィルタリングされるディメンションで物理的にソートされ、その後に時間が続きます。これにより、似たラベルセット、メトリクス値、繰り返される文字列を持つ行が自然とまとめられ、圧縮アルゴリズムが効果的に活用できる強力な局所性が生まれます。
頻繁にクエリされるラベルを専用カラムにマテリアライズすると、圧縮率はさらに向上します。同じ値を持つ行がディスク上に連続して保存されるため、辞書エンコーディングや圧縮コーデックが大幅に効果を発揮するようになります。
上記の例における
response_timeのようにマテリアライズされたメトリクスカラムは、完全に列指向のままであり、型固有のコーデックと ZSTD などの汎用圧縮アルゴリズムの両方を使用して個別に圧縮されます。数値カラムはさらに、Delta などのコーデックや Gorilla の恩恵も受けることができます。Map 構造自体も効率的に圧縮されます。ラベルキーは行をまたいで高い頻度で繰り返される一方、実際のワークロードにおいて多くのラベル値は強い時間的局所性を示します。主キー内でマテリアライズされた Map ラベルを使用することは、この局所性に役立ちます。シャーディングされた Map のシリアライゼーションと組み合わせることで、ClickHouse は極めて動的なラベルセットであっても強力な圧縮特性を維持できます。
-
I/O の削減 - I/O の削減 - クエリは、処理を満たすために必要なグラニュール、カラム、および Map バケットのみを読み取るだけで済みます。
host、response_time、statusなどの頻繁にフィルタリングされるラベルやメトリクスは専用カラムにマテリアライズされるため、一般的なクエリの多くはラベル Map へのアクセスを完全に回避できます。これらのマテリアライズされたカラムはソートキーの一部であるため、ClickHouse はメトリクスデータを読み取る前にグラニュールを効率的にプルーニングできます。シャーディングされた
Map内にのみ保存されているラベルについて、ClickHouse は完全なラベル構造ではなく、リクエストされたキーを含むバケットのみを読み取ります。これにより、動的ラベルの柔軟性を維持しながら、初期の Map 実装と比較して I/O を大幅に削減します。このスキーマでは、
mapKeys(labels)およびmapValues(labels)に対する転置インデックスも定義されています。これらのインデックスにより、マテリアライズされていないラベルでクエリがフィルタリングを行う場合にも ClickHouse はグラニュールをさらにプルーニングでき、要求されたラベル名やラベル値を含み得ないグラニュールの読み取りを回避します。これにより、すべてのラベルを専用カラムにすることなく、container_idやpod_idなどの極めて動的なディメンションに対しても効率的なフィルタリングが可能になります。メトリクスカラムはディスク上に独立かつ連続して保存されるため、ClickHouse はベクトル化クエリ実行も効率的に適用でき、高い分析スループットを得るために大量の値のバッチをメモリへ連続的に読み込むことができます。
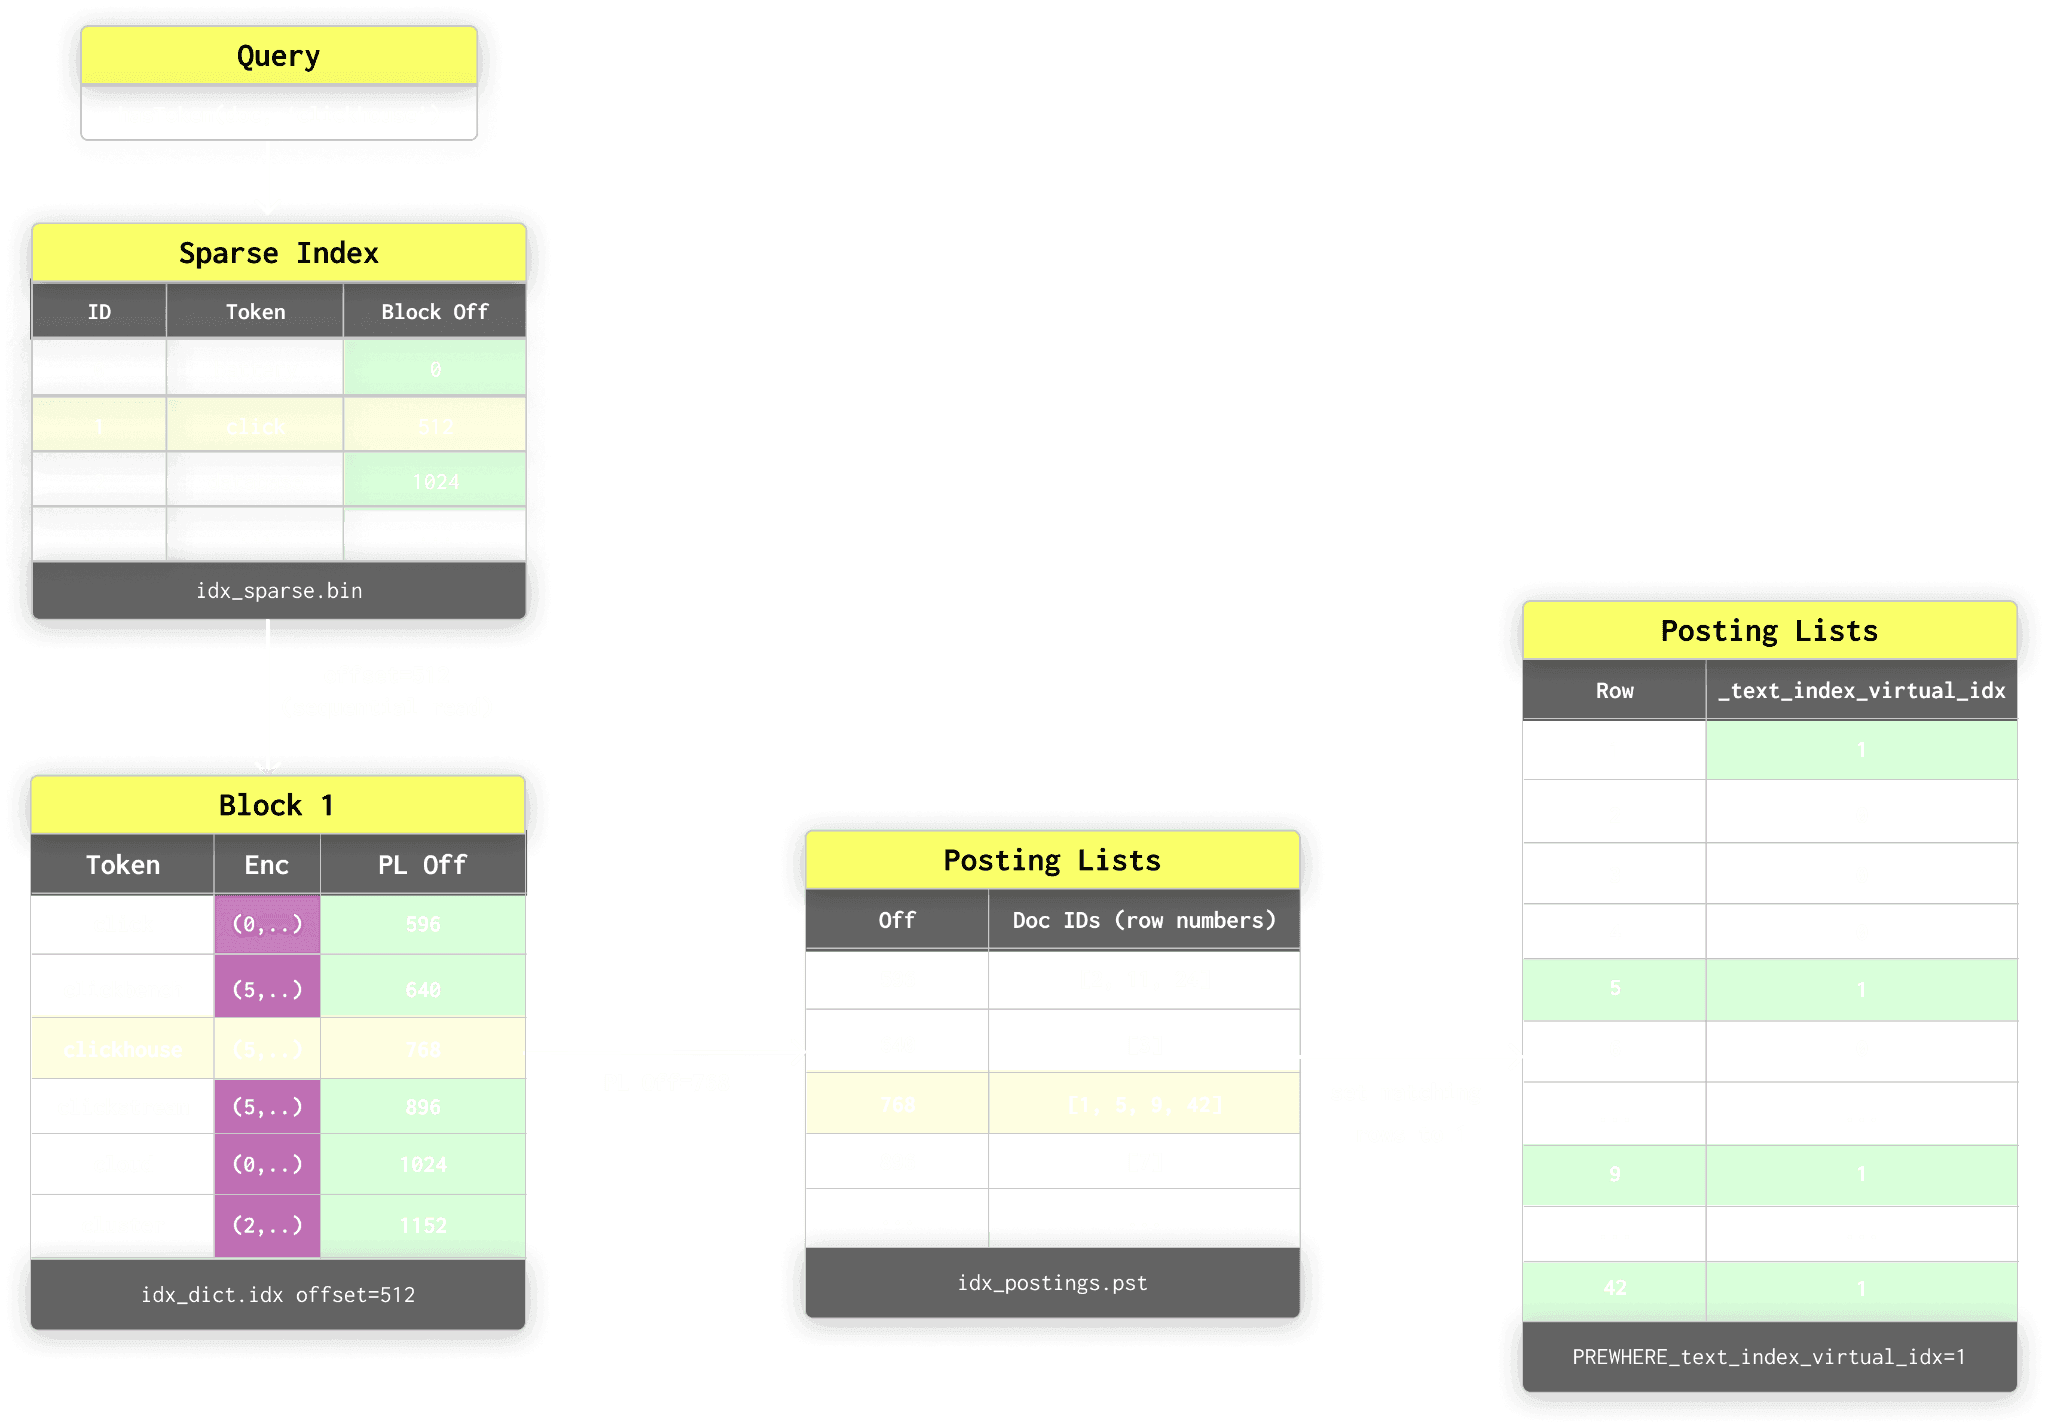
クエリ実行時、テキストインデックスはスパースインデックス、辞書ブロック、ポスティングリストを使用して、データセット全体をスキャンすることなく一致する行を効率的に解決する多層ルックアッププロセスを採用しています。詳細については、専用の記事を参照してください。
ブルームフィルターインデックスもこの目的で使用でき、多くのワークロードで十分な場合があります。実際には、最適な選択はラベルの分布、クエリパターン、および適用されるフィルターの選択度によって決まります。
-
分析の集計 - このモデルでは、メトリクスは
response_timeなどの数値カラムとして表されます。集計は単純かつ効率的になります。avg(response_time)のような計算を行う場合、ClickHouse はクエリのフィルターに一致する行のresponse_timeカラムのみを読み取るだけで済みます。スパースインデックスとセカンダリフィルターのおかげで、エンジンはフィルターを満たす特定のグラニュール範囲を特定し、それらの範囲のみをディスクから読み取ることができます。これらの範囲は、クラスター内のすべての CPU コアとサーバーにわたって並列処理できます。これにより、ストレージレベルで効果的な述語プッシュダウンが実現します。結果として、集計パフォーマンスは時系列ベースのモデルのようにカーディナリティに直接左右されることはありません。クエリフィルターに一致する行数により密接に関連します。一致する行に対して関連するメトリクスカラムのみを読み取る必要があります。高カーディナリティのカラムに対するフィルターは、スキャンされる行数を減らす傾向があるため、多くの場合有利に働きます。対照的に、フィルターのないクエリや低カーディナリティのカラムに対するフィルターは、一般により多くのデータを読み取る必要があり、パフォーマンスを得るには並列読み取りが必要になります。
例
前述の metrics テーブルを考えてみましょう。この例では、アプリケーションのレスポンスタイムとサイズが 50 億行保存されています。このデータ内の一部のカラムは自然と高カーディナリティになっており、Prometheus のような従来の時系列データベースであればラベルとしての使用を避けるようなものです。
SELECT count()
FROM events
┌────count()─┐
│ 5339783200 │ -- 5.34 billion
└────────────┘
1 row in set. Elapsed: 0.004 sec.以下は、各カラムのカーディナリティと、これを時系列モデルで表現した場合の合計カーディナリティを示しています。
SELECT
uniq(host),
uniq(application),
uniq(labels['request_path']),
uniq(labels['remote_addr']),
uniq(labels['remote_user']),
uniq(labels['request_type']),
uniq(labels['request_protocol']),
uniq(status),
uniq(labels['domain_referer']),
uniq(labels['browser']),
uniq(labels['device'])
FROM events
FORMAT Vertical
Row 1:
──────
uniq(host): 100
uniq(application): 1000
uniq(arrayEl⋯est_path')): 881432
uniq(arrayEl⋯ote_addr')): 258115
uniq(arrayEl⋯ote_user')): 995890
uniq(arrayEl⋯est_type')): 5
uniq(arrayEl⋯protocol')): 7
uniq(status): 15
uniq(arrayEl⋯_referer')): 369
uniq(arrayEl⋯'browser')): 9
uniq(arrayEl⋯ 'device')): 11
SELECT uniq(host, application, labels['request_path'], labels['remote_addr'], labels['remote_user'], labels['request_type'], labels['request_protocol'], status, labels['domain_referer'], labels['browser'], labels['device']) AS total_time_series
FROM events
┌─total_time_series─┐
│ 5239274309 │ -- 5.24 billion
└───────────────────┘明らかに、ここでの時系列数は膨大であり、行数である 52 億行とほぼ同じです。
行は時系列と同じではありません。既存の系列に対してさらに多くのデータポイントを追加できるため、個別の系列数を増やすことなく行数を増やすことができます。ほとんどのデータセットでは、総行数は時系列数をはるかに上回ります。この例では、各行にレスポンスタイムとサイズという 2 つのメトリクスが格納されているため、行、サンプル、系列の関係が 1 対 1 になることは稀です。
ここで、32 コアのマシン上でミリ秒単位で実行される以下のクエリについて考えてみましょう。このクエリは上記のテーブルに対してレスポンスタイムの平均を計算し、1 分間隔でグループ化し、ステータスごとにバケット化して、特定の日付に絞り込みます。
SELECT
toStartOfMinute(time) AS minute,
labels['status'] as status,
avg(response_time)
FROM metrics
WHERE (time >= '2025-02-23 08:00:00') AND (time <= '2025-02-23 12:00:00')
GROUP BY
minute,
status
ORDER BY minute ASC
┌──────────────minute─┬─status─┬─avg(response_time)─┐
│ 2025-02-23 08:00:00 │ 403 │ 5065.290909090909 │
│ 2025-02-23 08:00:00 │ 500 │ 5327.543933054393 │
│ 2025-02-23 08:00:00 │ 302 │ 5119.796687088722 │
..
3084 rows in set. Elapsed: 0.122 sec. Processed 49.21 million rows, 340.04 MB (404.24 million rows/s., 2.79 GB/s.)
Peak memory usage: 726.64 MiB.これは、Prometheus では実行が難しいクエリの例です。これを計算するには、多くの独立したシリーズにアクセスする必要があります。
このクエリは、固定の 1 分バケットにグループ化されたイベント形式のデータに対する単純平均を計算している点に注意してください。これは、前述の
avg_over_time(...[5m])の例と意味的に同一ではありません。グラフ上では結果が似て見えるかもしれませんが、基礎となる計算モデルが異なります(「Prometheus が依然として適しているケース」を参照)。
絞り込んで対象の「シリーズ」を減らすと、読み取る必要があるデータ量が削減されます。例えば次のようになります。
SELECT
toStartOfMinute(time) AS minute,
avg(response_time)
FROM events
WHERE application = '603' AND host = '3' AND status = '200' GROUP BY minute
ORDER BY minute ASC
┌──────────────minute─┬─avg(response_time)─┐
│ 2025-01-24 00:00:00 │ 3680.4615384615386 │
│ 2025-01-24 00:01:00 │ 5515.153846153846 │
..
5 rows in set. Elapsed: 0.078 sec. Processed 53.40 million rows, 479.93 MB (681.97 million rows/s., 6.13 GB/s.)
Peak memory usage: 613.54 MiB.後者のケースでは、転置インデックスのおかげで読み込むデータ量が大幅に減少し、それがクエリの実行時間にも反映されています。特定のシリーズに絞り込むには、すべてのカラムに対してフィルターを追加するだけです。
マテリアライズするほど頻繁にはクエリされないメトリクスについては、labels マップ内に残したまま、クエリ時に動的にアクセスすることも可能です。response_time のような頻繁に集計されるメトリクスは一般にマテリアライズを推奨しますが、オブザーバビリティのワークロードには、たまにしかクエリされない低頻度の測定値が多数含まれることがよくあります。このような場合、マップからメトリクスへ直接アクセスするのが極めて合理的です。
たとえば、イベントに応答ペイロードのサイズを表す size 属性も含まれているとします。時間の経過に伴う総トラフィック量を計算したいのは、たまにだけかもしれません。別の専用カラムをマテリアライズする代わりに、マップから直接値にアクセスしてキャストできます。
SELECT
toStartOfMinute(time) AS minute,
sum(toDecimal32(labels['size'], 1)) AS total_traffic
FROM events
WHERE application = '603'
GROUP BY minute
ORDER BY minute ASC
┌──────────────minute─┬─total_traffic─┐
│ 2025-01-24 00:00:00 │ 89167 │
│ 2025-01-24 00:01:00 │ 352724 │
│ 2025-01-24 00:02:00 │ 284684 │
…
4 rows in set. Elapsed: 1.138 sec. Processed 53.31 million rows, 13.60 GB (46.84 million rows/s., 11.95 GB/s.)この柔軟性は、ワイドイベントモデルの利点の 1 つです。頻繁にクエリされるディメンションやメトリクスは最適化されたカラムとして実体化できる一方、使用頻度の低い属性にも動的にアクセスでき、厳密なスキーマ定義を事前に決めておく必要がありません。
ClickHouse においても高カーディナリティにコストがかかるケース
ClickHouse でもカーディナリティが完全に無料になるわけではありません。
特に大規模な GROUP BY 操作では、一部のコストが読み取り時に移ります。
request_path でグループ化したい場合を考えてみましょう。この場合、読み取り時に高カーディナリティなカラムでグループ化し、Map にアクセスすることになります。
SELECT
toStartOfMinute(time) AS minute,
labels['request_path'] as request_path,
avg(response_time)
FROM events
WHERE toDate(time) = '2025-01-24'
GROUP BY
minute,
request_path
ORDER BY minute ASC
-- we'll omit the results :)
0 rows in set. Elapsed: 9.433 sec. Processed 153.23 million rows, 63.85 GB (16.24 million rows/s., 6.77 GB/s.)
Peak memory usage: 22.82 GiB.そのコストは、メモリ使用量と経過時間の両方に現れます。
集計状態をメモリ上に構築する必要があるため、カーディナリティが非常に高いカラムで高速なグループ化を行うと、確かにメモリのオーバーヘッドが発生します。ただし、ClickHouse は閾値を超えた場合のディスクへのスピル(退避)をサポートしているため、こうしたワークロードでも破綻することなく処理を維持できます。さらに、性能と引き換えにメモリ消費量を制限する制御を行うことで、高カーディナリティ環境下でも驚くほど高いパフォーマンスを発揮できます。
SELECT
toStartOfMinute(time) AS minute,
labels['request_path'] as request_path,
avg(response_time)
FROM events
WHERE toDate(time) = '2025-01-24'
GROUP BY
minute,
request_path
ORDER BY minute ASC
-- Start external aggregation around 10 GB
SETTINGS max_bytes_before_external_group_by = 10000000000
0 rows in set. Elapsed: 13.930 sec. Processed 153.23 million rows, 63.85 GB (11.00 million rows/s., 4.58 GB/s.)
Peak memory usage: 9.57 GiB.しかし、より現実的な問題として、オブザーバビリティダッシュボード上で 100 万本近くもの個別のラインをそもそもどのように可視化するのでしょうか。
ワークロードにおいて何百万もの個別シリーズを実際に描画することがどうしても必要な場合、ClickHouse は理想的なツールではないかもしれません。しかし、それらの何百万ものシリーズにまたがる合計や平均などの集計を計算する必要があるなら、ClickHouse は極めて適しています。
ClickHouse が適しているケース
ClickHouse は、メトリクスによって強化されたログやトレースのような、高カーディナリティが偶発的ではなくごく自然に生じるイベント形式のオブザーバビリティデータに特に適しています。また、長期的なトレンド分析、SLI、KPI、および長期間にわたる分析を必要とする広範なビジネスメトリクスにも優れています。メトリクスがイベントから導出され、時間やディメンションに基づく柔軟な集計を必要とする場合は常に、列指向モデルが ClickHouse の強みを発揮します。
重要な点として、ClickHouse は、container_id や pod_id、その他の現代的な環境で一般的な動的生成識別子のような、短寿命でエフェメラルなディメンションによる構造的な影響を受けません。これらは単なるカラム値に過ぎないからです。
このことの実践的なメリットは非常に大きなものです。純粋にカーディナリティを抑えるためだけに過度なサンプリング、事前集計、ラベルの削除を行うことなく、完全な精度のメトリクスデータを ClickHouse に保存できます。カーディナリティの爆発を避けるためのスキーマ設計に頭を悩ませる代わりに、データを自然な形でモデル化し、クエリパターンに応じて読み取る対象を決定させることができます。
それでも Prometheus が適しているケース
Prometheus は、その広範なエコシステムサポート、成熟した運用ツール、そして密接に統合されたアラート機能など、多くのシナリオにおいて依然として間違いなく最適な選択肢です。
Prometheus は、サンプルが個別のタイムシリーズへとスクレイプされるメトリクスファーストのモデルを中心に構築されており、カウンター、ゲージ、ヒストグラム、サマリーという複数のメトリクスタイプをサポートしています。それぞれのタイプには、データの解釈方法に関する前提が組み込まれています。カウンターはレートやリセットを処理し、ヒストグラムとサマリーはレイテンシや分布の分析をサポートします。これらのセマンティクスは、PromQL や周辺のエコシステムに深く根付いています。
ClickHouse のイベント形式モデルでは、通常、メトリクスはイベント上の数値カラムとして保存され、クエリ実行時に集計されます。実際には、これらの値は厳密な Prometheus スタイルのカウンターというよりもゲージのように振る舞うことが多くなります。Prometheus と同様に、ClickHouse も本質的には数値(ヒストグラムを除く)を保存しており、セマンティクスはストレージレイヤー自体ではなくクエリロジックから生まれます。
対照的に、Prometheus は定期的にサンプリングされるシリーズを前提としており、カウンター、レート、ヒストグラム、レンジベクターに対するファーストクラスのセマンティクスを提供します。一方の ClickHouse はタイムスタンプ付きのイベントを対象に動作するため、厳密なタイムシリーズのセマンティクスよりも、高カーディナリティなオブザーバビリティデータに対する柔軟なイベント形式の集計に適しています。
ピンポイントな単一シリーズの検索やプロットにおいては、Prometheus が極めて高い性能を発揮することがよくあります。その転置インデックスはラベルの積集合を迅速に解決し、圧縮された単一シリーズを効率的に読み取ります。ClickHouse もソートキーがフィルターと一致していれば同様のパフォーマンスを達成できますが、場合によってはより多くのデータをスキャンすることもあります。その差が極端に大きくなることは滅多にありませんが、これは Prometheus が非常に強みを持つシナリオです。
Prometheus は、カーディナリティが抑制され、予測可能な場合にも極めてうまく機能します。長寿命なシリーズが適度な数に収まっている環境や、リアルタイムアラート、従来の監視ワークフローにおいて非常に効果的です。また、LGTM のようなスタックともシームレスに統合されており、そこでは Prometheus や Mimir などの分散対応の後継システムがファーストクラスとして扱われています。分散システムはスケーラビリティの課題を解決するものの、基礎となるシリーズベースのモデルは維持されるため、カーディナリティの意図的な管理は依然として必要です。
Prometheus メトリクス向けの ClickHouse
ClickHouse のオープンソースオブザーバビリティスタックである ClickStack は、Prometheus スタイルのメトリクス (OpenTelemetry メトリクス) をサポートしていますが、Prometheus や長年確立されてきた Prometheus 互換システムの完全な代替と見なすべきではありません。基盤となるストレージとクエリモデルは根本的に異なり、ClickStack は厳密なタイムシリーズモデルよりもイベント指向のアプローチを重視しています。
その結果、ClickStack での Prometheus スタイルのメトリクスに対するクエリは、現在のネイティブな PromQL よりも機能が限定された、より高レベルなクエリビルダーや抽象化を通じて提供されています。これは主に、Prometheus のセマンティクス、特にカウンター、ヒストグラム、レンジベクター、および広範な PromQL 実行モデルを完全に再現することの複雑さに起因しています。
ダッシュボード、アラート、運用ワークフローに深く統合された、成熟し実戦で鍛え上げられた PromQL サポートが必要な場合、Prometheus が依然として明白な選択肢です。とはいえ、ClickHouse における PromQL サポートも進化を続けており、最近では期待の持てる進展も見られます。複雑な PromQL クエリを手動で SQL に変換することも、特にヒストグラムやレンジベクター関数に関しては簡単ではありませんが、LLM の助けを借りれば可能です。
適度なカーディナリティのメトリクス、PromQL 中心のソーティング、そして特定のシリーズに絞った検索においては、Prometheus の方が依然として適しています。
まとめ
高カーディナリティは ClickHouse において「無料」ではありませんが、従来のタイムシリーズシステムと比較すると、そのコストが発生する場所が大きく異なります。シリーズ指向のモデルから列指向テーブルに格納されたワイドイベントへと移行することで、ClickHouse は、Prometheus などのシステムでカーディナリティを困難にしているシリーズ単位の書き込み増幅、メモリオーバーヘッド、運用の脆さを回避しています。その代わりに、トレードオフは主にクエリ時の集計やデータモデリングの決定へと移りますが、これらは ClickHouse の列指向実行モデル、圧縮、プルーニング、並列化が特に強みを発揮する領域です。