5万


オブザーバビリティのワークロードにおいて、ClickHouse はハイカーディナリティの影響を大きく受けない、と私たちが話すのを耳にすることがよくあるはずです。この主張は方向性としては正しいものの、従来の時系列システムにおいてそもそもなぜハイカーディナリティが問題になるのかを理解して初めて、真に納得できるものになります。 本記事は、ClickHouse などの列指向データベースにおいてハイカーディナリティの挙動がなぜ異なるのかを探る次回記事の背景情報として書かれています。ここでは主に Prometheus に焦点を当てます。Prometheus はオブザーバビリティ分野における支配的なメトリクスストアであり続けており、シリーズ指向のストレージモデルにおけるトレードオフを明確に示してくれるためです。 シリーズの作成、メモリ使用量、クエリ実行、そして短命なインフラによるチャーンにおいて、カーディナリティのコストがどこに発生するのかを明らかにしていきます。
ハイカーディナリティ、Prometheus の内部構造、シリーズチャーン、そして時系列システムでカーディナリティが引き起こす運用上の課題についてすでに熟知している場合は、ClickHouse がこれらのワークロードをどのように異なる形で処理するのかを解説するパート 2 へ読み進めていただいて構いません。
オブザーバビリティにおけるハイカーディナリティとは?
オブザーバビリティシステムにおいて、ハイカーディナリティとは通常、ユニークなラベルの組み合わせが多数存在することを意味します。
ここでは参照モデルとして Prometheus を取り上げます。Prometheus はオブザーバビリティ分野で支配的なメトリクスストアであり続けているためです。また、Prometheus の代替となるシステムが存在するものの、それらも通常は同じ基本的なデータモデルをベースに構築されています。
すべての時系列データベースが Prometheus と同じ方法で実装されているわけではなく、それぞれが独自の内部アーキテクチャとストレージエンジンを持っています。ただし、以下で説明するようにデータを個別の時系列としてモデル化する多くのシステムは、カーディナリティが増大した際に同様の課題に直面します。
時系列データベースにおいて、カーディナリティとはユニークなラベルの組み合わせの数を指します。これを理解するためには、一歩戻ってメトリクス、ラベル、そして時系列を定義する必要があります。
ラベルとは何かを定義するには、まずメトリクスとは何かを定義するとわかりやすくなります。メトリクスとは、実質的には観測可能な数値プロパティであり、たとえば「HTTP リクエスト数」や「現在の温度」などが挙げられます。メトリクスには、ラベルと呼ばれる追加の次元を持たせることができます。これらの文字列値は、そのメトリクスが何に関するものなのかを実質的に表しており、各ラベルはあらかじめ定まった集合から値を取ります。
時系列とは、ユニークなラベルの組み合わせを持つメトリクスのインスタンスです。 一連のタイムスタンプと値を保持します。
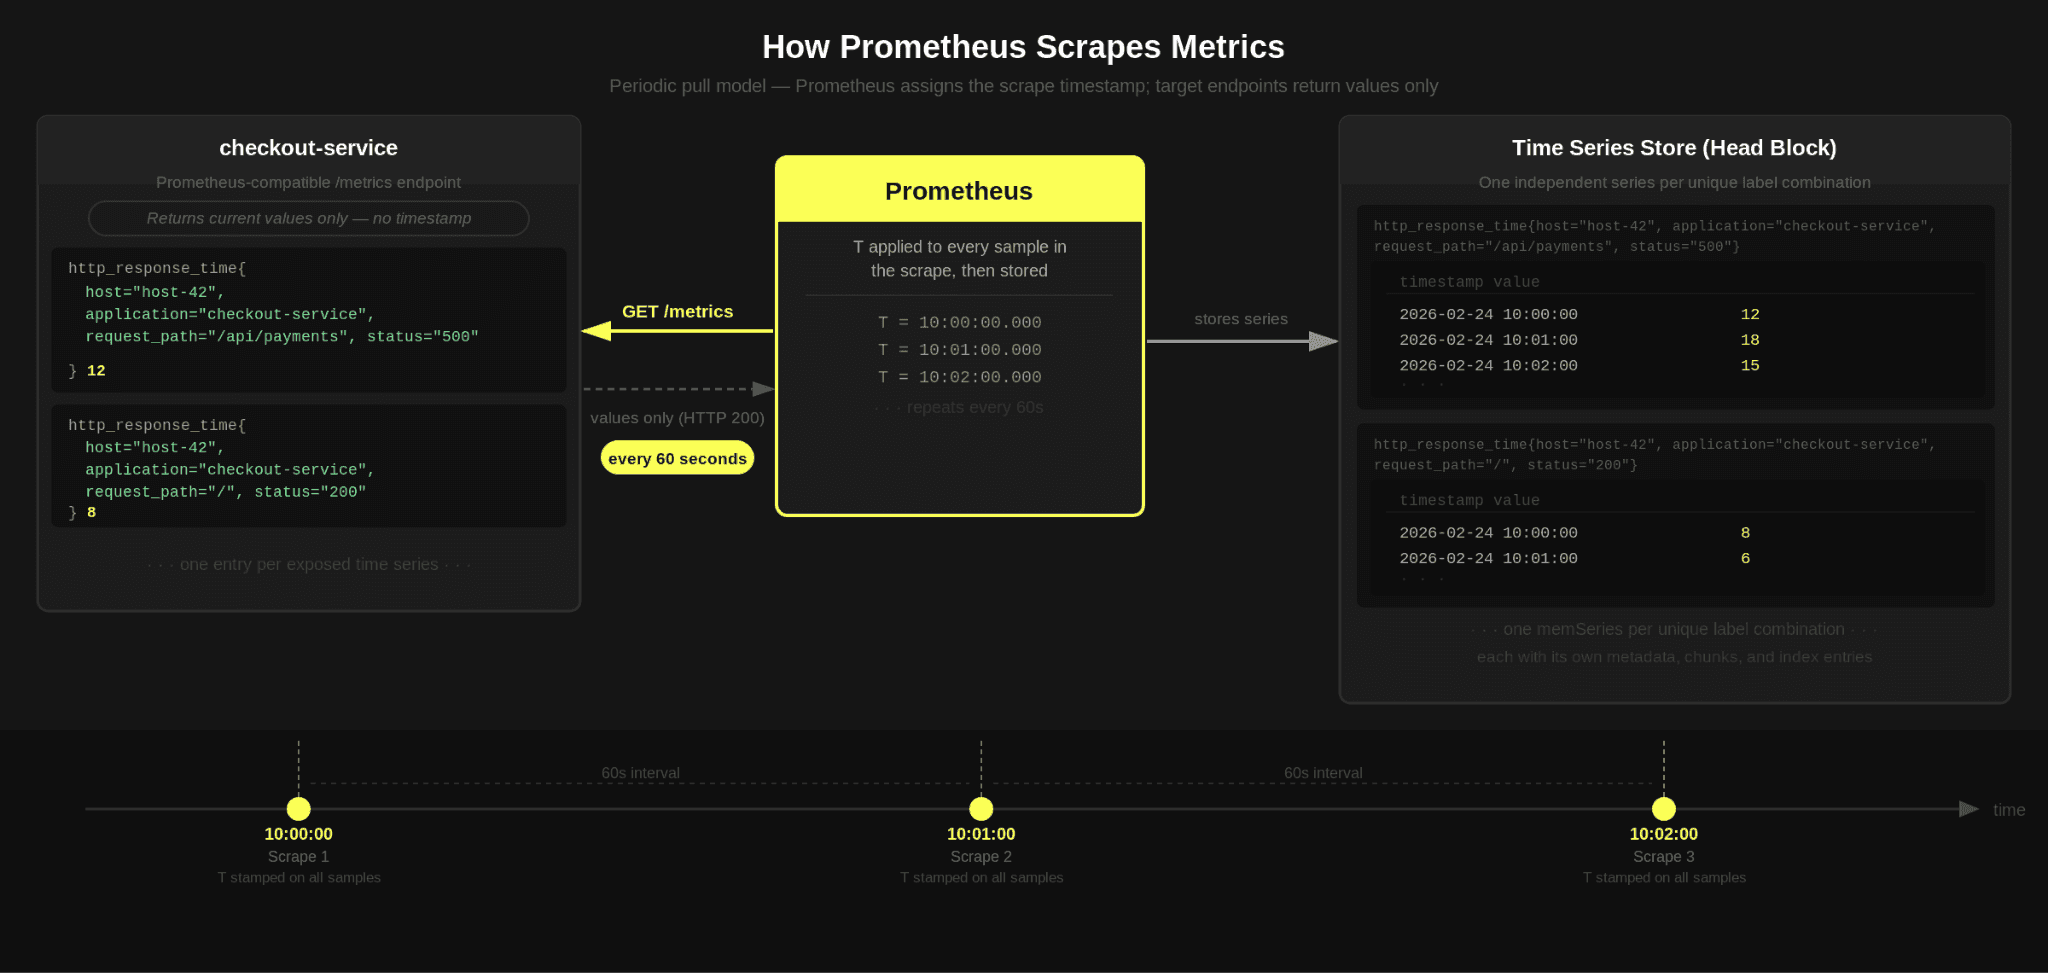
直近で観測されたレスポンスタイムを表す http_response_time というゲージメトリクスがあり、host、application、request_path、status といったラベルが付与されているとします。この場合、1 つのシリーズは以下のようになります。
http_response_time {
host="host-42",
application="checkout-service",
request_path="/api/payments",
status="500"
}このシリーズは、例えば次のようなタイムスタンプと値のセットを持ちます。
(2026-02-24 10:00:00, 12)
(2026-02-24 10:01:00, 18)
(2026-02-24 10:02:00, 15)
...実質的に、ラベルは何が観測されているかを示し、タイムスタンプと値はそれが時間とともにどのように変化したかを示します。これらのタイムスタンプと値は、チャート上でシリーズとして描画できます。したがって、1つのメトリクスは1つ以上の時系列を持つことができます。その正確な数は、一意のラベル値の数に依存します。
Prometheus は通常、スクレイプ時点での各時系列の現在値**(サンプル)を明示的なタイムスタンプなしで公開している Prometheus 互換の HTTP エンドポイントをスクレイプすることでデータを収集します。Prometheus は、記録するすべてのサンプル**のタイムスタンプとしてスクレイプ時刻を割り当てます。実質的には、公開されているすべてのメトリクスのスナップショットを定期的に取得し、そのインターバル中に返された各時系列の値にスクレイプのタイムスタンプを関連付けます。
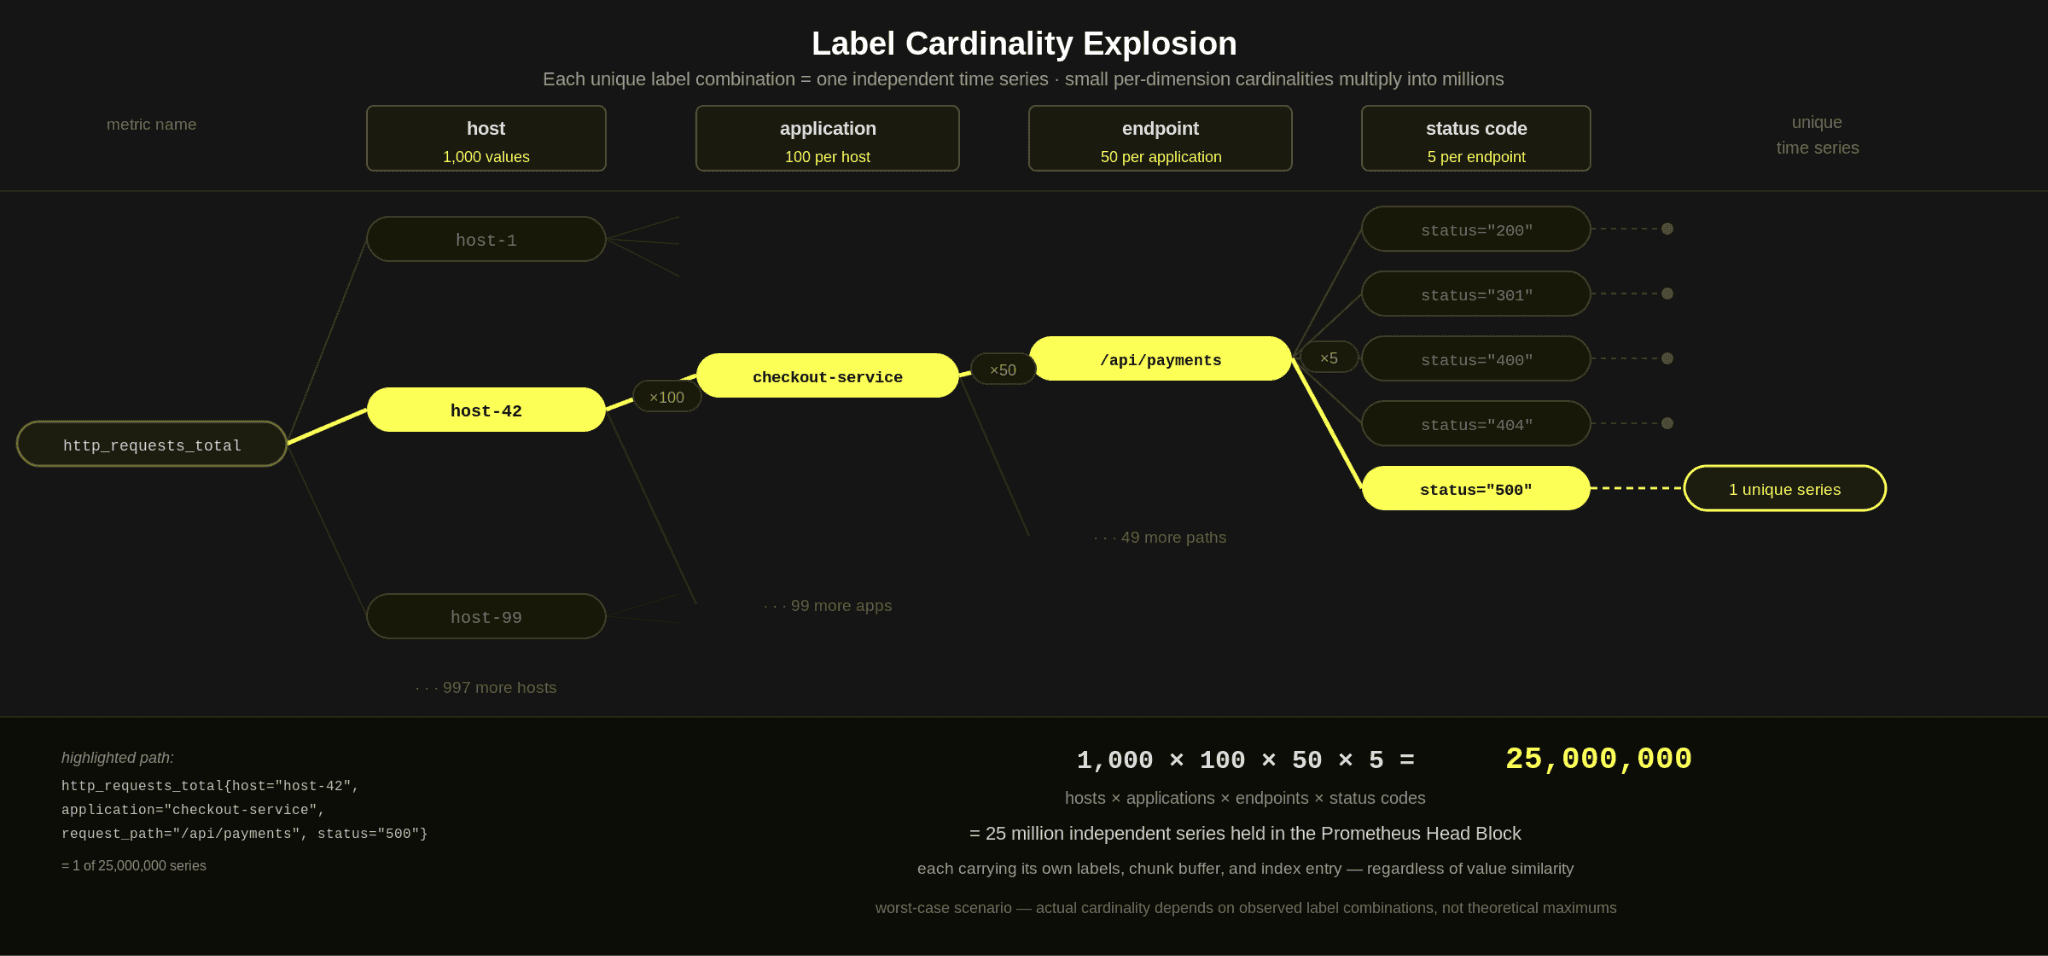
このように、シリーズは単体ではシンプルに見えますが、全体としては複雑さをもたらします。カーディナリティとは、単に1つのラベルに多くのユニークな値があることだけを指すのではありません。すべてのラベルにわたるユニークな組み合わせの総数、すなわちユニークな時系列の数を意味します。
例えば、前述の http_requests_total メトリクスを考えてみましょう。host のカーディナリティが 1,000、application が 100、endpoint が 50、status code が 5 であり、それぞれのユニークな値に対してメトリクスを取得した場合、潜在的には次のような時系列数になります。
1,000 × 100 × 5 × 50 = 25,000,000 ユニーク時系列
これは明らかにワーストケースのシナリオです。すべてのアプリケーションがすべてのホストで実行され、各アプリケーションに対してエンドポイントが存在することを前提としています。しかし、これはリージョン、環境、バージョン、コンテナ ID といった現実的なディメンションが追加される前の話です。
カーディナリティとはユニークな時系列の数であり、ハイカーディナリティとはそれが大量に存在する状態のことです。
最後に、複合的な乗算の問題により、メトリクスにラベルを1つ追加するだけで時系列の数が大幅に増加する(新しいラベルのカーディナリティの積に達する)可能性がある点に注意が必要です。
Prometheus と時系列データモデル
Prometheus を例として話を続けると、ストレージの基本単位はシリーズそのものです。メトリクスにおけるラベルのユニークな組み合わせごとに新しいシリーズが作成され、すべてのシリーズが独自のオーバーヘッドを抱えます。前述のとおり、時系列にラベルを追加すると、そのカーディナリティが大幅に増加する可能性があります。
では、なぜ時系列ごとにこれほど大きなオーバーヘッドが発生するのでしょうか。
その答えは、Prometheus サーバーがこれらのシリーズを内部でどのように処理しているかにあります。
データ構造とメモリーオーバーヘッド
Prometheus はサンプルをスクレイプする際、まずそのシリーズが過去に確認されたものかどうかをチェックする必要があります。シリーズは、メトリクス名とユニークなラベル値のセットによって識別されます。そのため、ラベルセットとメトリクス名がハッシュ化されてユニークなシリーズ識別子が生成され、シリーズが検索されます。この検索は高速かつ予測可能であり、実質的にはインメモリのシリーズインデックスに対するハッシュテーブル検索です。
時系列が存在する場合、新しいサンプルは既存のインメモリ構造体である memSeries に追加される必要があります。これはラベル値に加えて、すべてのサンプルとそれぞれのタイムスタンプを保持します。この追加(append)操作は低コストであり、一般的なホットパスに該当します。
シリーズが存在しない場合は、memSeries を作成して内部構造に登録する必要があります。この作成処理は書き込みパス上で行われるため、取り込みのレイテンシに直接影響します。
memSeries 内のサンプルがどのように管理されるかについても、重要な注意点があります。デフォルトでは、Prometheus は Head ブロックと呼ばれる領域のメモリ上に最大 2 時間分の最近のデータを保持します。Head 内では、アクティブな時系列ごとに、memSeries が参照する圧縮チャンク(個々のポイントとしてではなく)にサンプルが保存されます。これらのチャンクは通常、デフォルトで 120 サンプルを保持するサイズに設定されています。
メトリクスが 1 分に 1 回スクレイプされる場合、Head ブロック内の各シリーズにおいて、1 つのチャンクが 2 時間分のデータをカバーすることを意味します。サンプルがより高い頻度で収集されると、チャンクはより早く満杯になり、同じ 2 時間のウィンドウ内に追加のチャンクが割り当てられます。結果として、スクレイプ頻度が高くなるとシリーズあたりのインメモリチャンク数が増加し、メモリー消費量が増大します。
したがって、各シリーズの実際のオーバーヘッドはいくつかの要因に依存します。
- memSeries 構造体とそれが必要とするフィールド:それ自体で約 200 バイト
- ラベルの数とサイズ
- 各シリーズのサンプル数と、それによって生成されるチャンク。注:各チャンクにはメタデータのオーバーヘッドもあります。
要約すると、Head ブロックのメモリー使用量を左右する要因は2つあります。それは「シリーズの数」と「シリーズあたりのサンプル数」です。
各シリーズを個別に保存するという決定は、各シリーズが自身、そのラベル、およびチャンクに対して本質的にメタデータのオーバーヘッドを抱えることを意味します。
Prometheus は通常の float サンプルを XOR ベースのエンコーディングで保存します。このエンコーディングでは、各値が前の値に対する XOR として保存され、タイムスタンプにはコンパクトな「delta-of-deltas」エンコーディングが使用されます。タイムスタンプのデルタと XOR 値の双方が、可変長ビットエンコーディングを使用してパックされます。この圧縮手法は、一定の間隔でスクレイプされ、サンプルが急激に変化しない、長期間存続する時系列データに適しています。
これは、ラベルセレクターによるシリーズの検索を可能にする転置インデックスのようなシステム全体の追加構造を考慮する前の話です。この転置インデックスは実質的に、各ラベル名と値に対して、そのラベルペアを含むすべてのシリーズへの参照リストを保存します。カーディナリティが増加すると、これらのポスティングリストが肥大化し、さらなるメモリーオーバーヘッドをもたらすとともに、多くのラベルの組み合わせにまたがるクエリを評価するために必要な作業量が増加します。
構造体のディスクへの保存
前述のように、Head ブロックは約 2 時間分の最近のデータをメモリに保持します。メモリーの無制限な増加を防ぐため、Prometheus は定期的に Head をディスク上の永続ブロックに切り出します。
実際には、これは約 2 時間ごとのブロック境界で行われ、直近に書き込まれたチャンクはトランケーション(切り捨て)が行われるまで Head に残ります。その時点で、この時間範囲の圧縮チャンクが新しいブロックの一部としてディスクに書き込まれます。
最近のデータはメモリ内に存在し、2、3時間ごとに封印されて永続化されます。ディスクに書き込まれると、その時間範囲のインメモリチャンクデータは Head から解放されます。その後、データは指定された保持期間にわたってディスク上に保持されます。
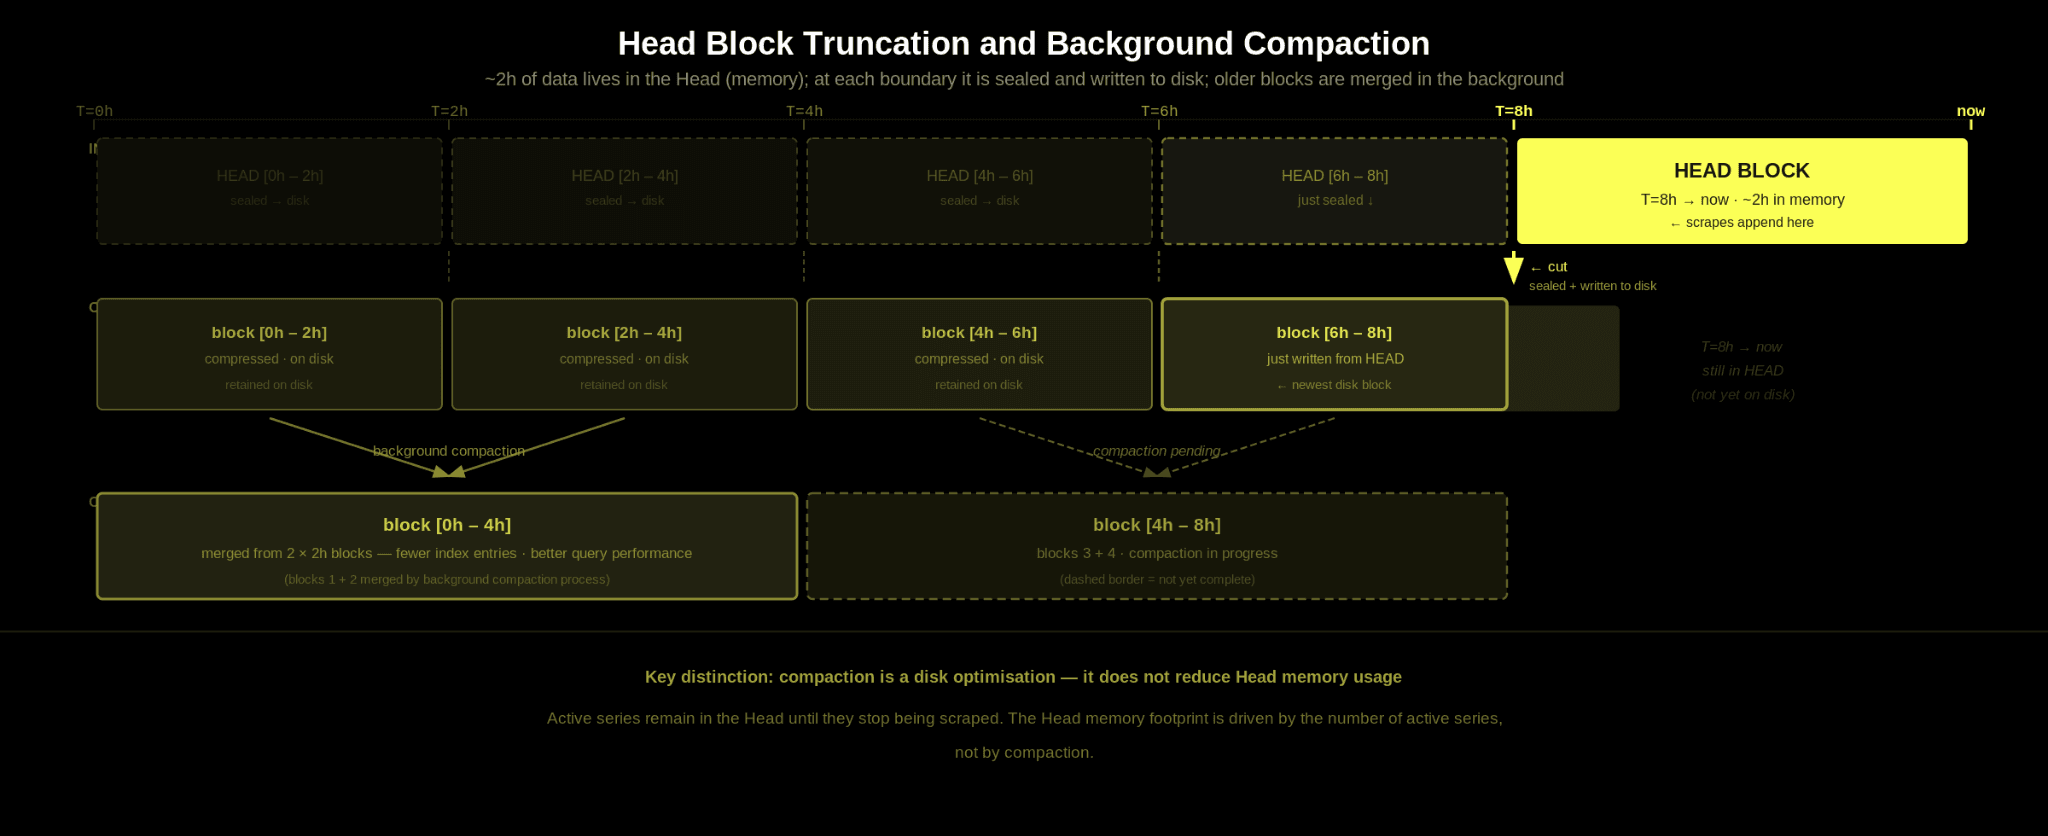
Prometheus は、他の LSM スタイルのストレージシステムと似た思想のバックグラウンドコンパクションプロセスも実行します。小さなブロックは、より長い時間範囲にまたがる大きなブロックにマージされます。これにより、ディスク上のブロックインデックスの数が減り、ブロックごとのオーバーヘッドが削減されてクエリの効率が向上します。コンパクションは主にディスクレイアウトと長期ストレージ効率の最適化を目的としています。Head 内のアクティブなシリーズに関連するメモリーオーバーヘッドを直接削減するものではありません。
メモリーのクリーンアップ
チャンクがディスクに書き込まれた後も、ほとんどの memSeries は依然として最近のチャンクをメモリ内に保持しています。前述のとおり、Head ブロックは約 2 時間分のデータを保持し、ブロック切り出しプロセスは時間ベースで 2 時間の境界からオフセットされています。そのため、サンプルの受信を継続しているシリーズは、最新のウィンドウをカバーするインメモリチャンクを自然に保持し続けます。
ただし、メモリ内にチャンクが残っていない memSeries が存在する場合もあります。これは、例えば Pod が再起動され、Pod ID がラベルに含まれていた場合などに発生します。この場合、シリーズは一時的なもの(エフェメラル)であり、データの受信が停止し、ブロックの切り出しによってチャンクが書き出された後は、インメモリのサンプルが存在しなくなります。
ブロックが切り出された後、Prometheus は Head のトランケーションとクリーンアップパスを実行します。このプロセスにおいて、メモリ内にチャンクがなくなり、最近サンプルを受信していないシリーズを検出し、それらをインメモリインデックスから削除します。これが事実上、孤立した時系列がクリーンアップされるタイミングです。
これにより一般的には、短命なシリーズが無期限にメモリーを消費し続けるのを防ぐことができます。とはいえ、ブロックの切り出しと Head のトランケーションは、シリーズがデータ受信を停止した正確な瞬間ではなく時間ベースの周期で動作するため、短時間しか存在しなかったシリーズであっても、最終的にクリーンアップされるまでに数時間メモリに残り続ける可能性があります。
Prometheus の強み
上記のデータモデルは、適切に使用された場合に効果を発揮します。より具体的には、次のような環境です。
- 適度な数の長期存続するシリーズがある
- 一定の間隔でスクレイプされている
- シリーズのサンプル間で値が極端に変化しない
このシナリオでは、Prometheus のチャンク圧縮、XOR エンコーディング、デルタベースのタイムスタンプストレージが極めてうまく機能します。
既存のシリーズへの新しい値の追加は低コストで予測可能です。同じシリーズのセットを繰り返しスクレイプし、ラベルセットが適切なサイズに収まっている限り、このストレージモデルは効率的で高いパフォーマンスを発揮します。これらの理由から Prometheus は広く普及し、低カーディナリティのメトリクスデータにおいて成功を収めているストレージエンジンであり続けています。
ハイカーディナリティにおける書き込み時の問題
このモデルの弱点は、ハイカーディナリティと高いチャーン(入れ替わり)の条件下で現れます。
第一に、シリーズごとに実質的なオーバーヘッドが存在します。すべての時系列が、ラベル、チャンク、転置インデックスのエントリなど、独自のインメモリ構造を持っています。このオーバーヘッドはシリーズ数が安定していれば管理可能ですが、ユニークなシリーズの数が増えるにつれて線形にスケールします。ラベルが増えれば可能な組み合わせが増え、組み合わせが増えればシリーズも増えます。その1つひとつがこのオーバーヘッドを抱えます。カーディナリティの急増により、Head が数十から数百 GB の RAM を消費することは珍しくなく、メモリー逼迫やクラッシュを引き起こすことすらあります。
container_id のようなラベルは、Kubernetes のような環境では特に有用です。オペレーターが特定の Pod やコンテナインスタンスの問題を特定し、精度の高い完全な運用コンテキストを維持できるためです。問題は、これらのラベルがハイカーディナリティであり、かつ極めて一時的(エフェメラル)である点です。
ワークロードがスケール、再起動、終了するにつれて、新しいシリーズが絶え間なく作成される一方で、古いシリーズはクリーンアップされるまでメモリに残り続けます。Prometheus では、これによりメモリーオーバーヘッドが増加し、低コストな追加パスではなく、より高コストなシリーズ作成パスをシステムに繰り返し通らせることになります。結果として、多くのチームはカーディナリティの急増を防ぐために、これらのディメンションを削除したり、過度なサンプリングを行ったり、完全に避けたりすることを余儀なくされます。例えば、こちらの記事では、Cloudflare がカーディナリティの爆発を抑えるために、新しいシリーズの作成に制限を設けている方法が詳しく説明されています。
これらすべての要因が複合的に作用し、モデルが本来最適化されていた想定を超えるカーディナリティに直面したとき、Prometheus のパフォーマンス維持を難しくしています。
Prometheus におけるカーディナリティの技術的課題に加え、オブザーバビリティベンダーを利用している場合には商業的な影響もあります。シリーズベースの時系列データモデルを使用する多くのベンダーは、カーディナリティに基づいて、多くはアクティブなシリーズごと、または 1 分あたりに取り込まれるデータポイント数に応じて課金します。これは、ハイカーディナリティがベンダーのインフラストラクチャコストを直接引き上げ、それをユーザーに転嫁せざるを得ないためです。
書き込み時の妥協策
ユーザーは通常、ラベル、スクレイプ頻度、または取り込み量を制限することで対処します。チームは監視したい対象だけでなく、カーディナリティの急増から Prometheus をいかに保護するかについても考えなければなりません。
ラベル名の長さやメトリクスごとのラベル数を制限するようなアプローチのほかに、Prometheus はスクレイプごとの制限もサポートしています。これにより、1 回のスクレイプで受け入れるサンプルの総数に上限を設けることができます。このとき、各サンプルは異なるシリーズに属している可能性があります。
これはカーディナリティの急激なスパイクを防ぐのには役立ちますが、根本的なリスクを排除するものではありません。エンドポイントが毎回のスクレイプで設定された上限未満を出力していたとしても、時間の経過とともに新しいユニークなシリーズを導入し、全体的なカーディナリティを押し上げて着実にメモリを消費していく可能性があります。さまざまな手法を用いたより中央集権的な制限によってこの問題に対処する[1][2]提案もなされています。
カーディナリティの上限でデータを破棄するシステムは、リリース時における危険も生み出します。よりカーディナリティの高いメトリクスを出力する新しいバージョンが登場すると、既存のシリーズが取り込みから押し出され、前日まで機能していたダッシュボードやアラートが破損するおそれがあります。
これらの対策は、データをドロップするか取り込みを制限することによって Prometheus を保護します。上限に達した場合、Prometheus は単にサンプルを破棄するか、新しいシリーズの受け入れを拒否します。システムの安定性を維持するために、設計上データが失われることになります。
結局のところ、最も安全なアプローチは最初からカーディナリティを慎重に管理することです。ユーザーは多くの場合、メトリクスの解像度やカーディナリティを下げることで対応します。これは実質的に以下を意味します。
- メトリクスの収集頻度を下げるためにスクレイプ間隔を広げる。
- リベリリングルールを使用して、スクレイプ時に特定のメトリクスをドロップする。
- ユニークなシリーズの生成を抑えるためにラベルのディメンションを削減する。
- 余剰なシリーズを事実上破棄するためにスクレイプあたりのサンプル数を制限する。
Prometheus におけるカーディナリティ管理を扱ったブログやガイドは数多く見つかります。しかし実際には、新しいデプロイ、メトリクス、あるいはラベルが突然十分なシリーズの入れ替わりを引き起こしてシステムを不安定にするのではないかと常に心配しなければならず、SRE チームに認知的および運用上の負担を生じさせます。さらに重要なのは、こうした妥協策によって、個々のコンテナ、一時的なワークロード、あるいはその他の忠実度の高い運用ディメンションといった、チームが最も観測したい対象に対する可視性が低下してしまうことが多い点です。
読み取り時の課題
このモデルには、読み取り時にもトレードオフが存在します。Prometheus がブロックをディスクに切り出す際、それらのブロックはメモリマップされます。これは効率的な手法です。OS はページがアクセスされたときにのみメモリに読み込むため、アイドル状態の履歴データが即座にヒープ領域を消費することはありません。ほとんどのワークロードにおいて、これはうまく機能し、メモリーフットプリントを予測可能な状態に保ちます。
特定のシリーズをクエリする場合、Prometheus は極めて効率的です。転置インデックスがラベルをシリーズにマッピングするため、正確なラベル一致を迅速に解決し、結果を少数のシリーズに絞り込んで、関連するチャンクのみを読み取ることができます。例えば、次のような PromQL クエリを考えてみましょう。
rate(http_response_time_sum{
host="host-42",
application="checkout-service",
request_path="/api/payments",
status="500"
}[5m]) /
rate(http_response_time_count{
host="host-42",
application="checkout-service",
request_path="/api/payments",
status="500"
}[5m])これは、合計レスポンスタイムのレートをリクエスト数のレートで除算することで、特定の host、application、request path、status における過去 5 分間の平均レスポンスタイムを計算します。
この場合、インデックスルックアップは高精度です。交差されるポスティングリストはごくわずかであり、ディスクから読み取られるチャンクも少数にとどまります。これは高速なパスです。課題が生じるのは、クエリがより広範になったり、集計度が高くなったりしたときです。たとえば、次のように問い合わせたとします。
sum(rate(http_response_time_sum{
application="checkout-service",
request_path=~".+",
status=~"2..|5.."
}[5m]))
/
sum(rate(http_response_time_count{
application="checkout-service",
request_path=~".+",
status=~"2..|5.."
}[5m]))これは、すべてのホスト、エンドポイント、および広範なステータスコードにわたる checkout-service の全シリーズに一致します。正規表現が多数のラベル値候補へと展開される可能性があるため、Prometheus は endpoint と status_code に対して大きな転置インデックス集合(posting set)を取得し、それらをアプリケーションの制約条件と組み合わせます。
述語プッシュダウン(Predicate Pushdown)の欠如
さらに、Prometheus は任意の数値述語を圧縮されたチャンクストレージへプッシュダウンできません。一連のシリーズが選択されると、エンジンはそのチャンクを読み取り、指定された時間範囲内のサンプルをスキャンする必要があります。「X を超える値のみを返す」と指定して、シリーズの残りの読み取りを回避することはできません。関連するのが一部だけであっても、チャンク全体をデコードする必要があります。 対象を絞った検索は効率的ですが、高カーディナリティのラベルに対する広範な集計では、多数のシリーズがロードされ、多数のチャンクがデコードされるため、大量のデータを処理しなければならなくなります。
読み取り時の妥協点
高カーディナリティのディメンションに対する広範なクエリは避けるのが賢明です。主要なラベルフィルターを省略したり、正規表現によるマッチングに大きく依存したり、一度に数百万ものシリーズにまたがって集計したりするクエリは、転置インデックスの大規模な共通集合演算(intersection)を強いられ、多数のチャンクのデコードが必要になります。
特に、pod_id、container_id、エンドポイントなどのディメンションにまたがるワイルドカード形式のクエリは、変動が激しい環境では急速にコストが高くなります。ラベルの組み合わせを絞り込んだピンポイントのクエリは良好に動作しますが、カーディナリティの大きいセット全体にわたる広範で大まかな集計において、通常パフォーマンスが低下します。
まとめ
Prometheus で高カーディナリティが問題になるのは、一意なラベルの組み合わせごとに独自のメモリ、インデックス、ライフサイクルのオーバーヘッドを伴う独立した時系列が作成されるためです。ディメンション数や変動が増加するにつれて、取り込み、クエリ実行、運用の安定性に影響が及び、ユーザーは可視性、コスト、システムの信頼性の間でトレードオフを迫られることになります。 次回の記事では、ClickHouse でこれらの同じワークロードがまったく異なる動作をする理由を探ります。特に、ワイドイベントモデル、列指向ストレージ、動的属性、および分析用クエリ実行によって、カーディナリティのコストが発生する場所が根本的にどのように変わり、なぜ実際の運用でそれらをはるかに管理しやすくなるのかを見ていきます。