5万

TL;DR
ClickHouse のテーブルにはかつて主キーに対応するプライマリインデックスが 1 つ しかありませんでした。
現在では、データを複製することなくプライマリインデックスのように動作する軽量なプロジェクションとして、複数のインデックスを持てるようになっています。
手短に概要を把握したいですか?
Mark が ClickHouse でプロジェクションをセカンダリインデックスとして機能させる方法を解説した動画をご覧ください。
プロジェクションが重要である理由
プライマリインデックスは、フィルター処理を伴うクエリを高速化するために ClickHouse が使用する最も重要なメカニズムです。テーブルのソートキーの順序でディスク上に行を格納することで、エンジンは該当するデータ範囲を素早く特定できるスパースインデックスを維持します。しかし、このインデックスはテーブルの物理的なソート順に依存するため、各テーブルに設定できるプライマリインデックスは 1 つだけです。
単一のインデックスと一致しないフィルター条件を持つクエリを高速化するために、ClickHouse はプロジェクションを提供しています。これは、異なるソート順、すなわち異なるプライマリインデックスで保存される、自動的に保守される非表示のテーブルコピーです。この代替レイアウトにより、その並び順の恩恵を受けられるクエリを高速化できます。従来、この手法の難点はストレージコストにありました。プロジェクションによってベーステーブルのデータがディスク上で複製されていたためです。
セカンダリインデックスとしての軽量プロジェクション
しかし、リリース 25.6 以降、ClickHouse は行全体を複製することなく、セカンダリインデックスのように動作するはるかに軽量なプロジェクションを作成できるようになりました。完全なデータコピーを保存する代わりに、ソートキーとベーステーブルへのポインターである _part_offset のみを保存するため、ストレージのオーバーヘッドが大幅に削減されます。
適用可能な場合、ClickHouse はこのようなプロジェクションのプライマリインデックスをセカンダリインデックスのように使用して一致する行を特定し、実際の行データ自体はベーステーブルから読み取ります。複数の軽量プロジェクションを連動させることも可能なため、複数のフィルターを持つクエリでは適用可能なすべてのプロジェクションを活用できます。さらに、いずれかのフィルターがベーステーブルのプライマリインデックスとも一致する場合、そのインデックスも処理に参加します。
パートレベルからグラニュールレベルのプルーニングへ
これまで、このメカニズムでプルーニングできるのはパート全体のみであり、グラニュールレベルのプルーニングには対応していませんでした。
今回のリリースにより、_part_offset ベースのプロジェクションはグラニュールレベルのプルーニングを備えた真のセカンダリインデックスとして動作するようになり、はるかにきめ細かなフィルタリングと劇的なクエリの高速化が実現します。
例:複数のプロジェクションインデックスの組み合わせ
これを実証するために、今回も UK price paid(イギリスの住宅取引価格)データセットを使用します。今回は、by_time と by_town という 2 つの軽量な _part_offset ベースのプロジェクションを含むテーブルを定義します。
CREATE OR REPLACE TABLE uk.uk_price_paid_with_proj
(
price UInt32,
date Date,
postcode1 LowCardinality(String),
postcode2 LowCardinality(String),
type Enum8(
'terraced' = 1, 'semi-detached' = 2, 'detached' = 3, 'flat' = 4, 'other' = 0),
is_new UInt8,
duration Enum8('freehold' = 1, 'leasehold' = 2, 'unknown' = 0),
addr1 String,
addr2 String,
street LowCardinality(String),
locality LowCardinality(String),
town LowCardinality(String),
district LowCardinality(String),
county LowCardinality(String),
PROJECTION by_time (
SELECT _part_offset ORDER BY date
),
PROJECTION by_town (
SELECT _part_offset ORDER BY town
)
)
ENGINE = MergeTree
ORDER BY (postcode1, postcode2, addr1, addr2);次に、こちらの手順に従ってデータをロードします。
下図は、ベーステーブルと 2 つの軽量な _part_offset ベースのプロジェクションの概要を示しています。
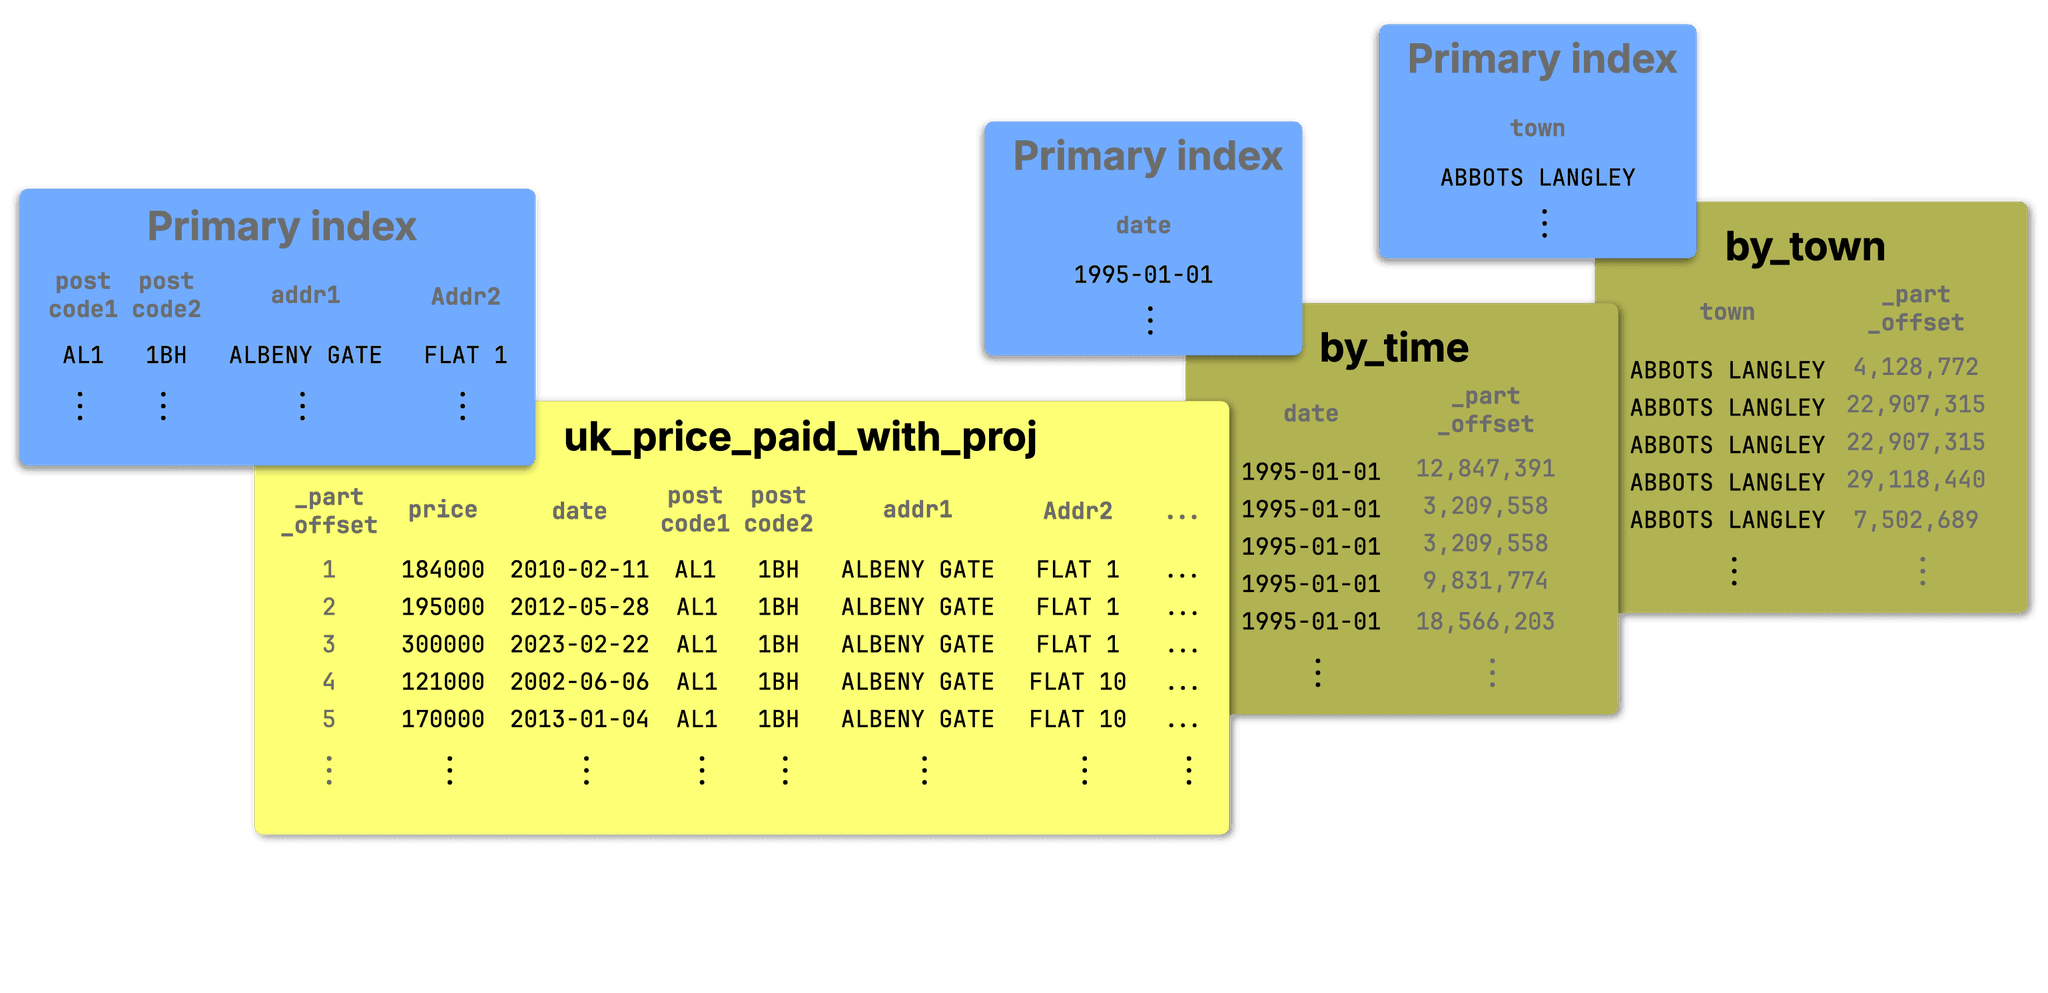
① ベーステーブルは (postcode1, postcode2, addr1, addr2) でソートされています。これによりプライマリインデックスが定義され、これらのカラムでフィルター処理するクエリを高速かつ効率的に実行できます。
② by_time プロジェクションと ③ by_town プロジェクションは、ソートキーと _part_offset のみを保存してベーステーブルを参照するため、データの重複が大幅に削減されます。これらのプライマリインデックスはベーステーブルのセカンダリインデックスとして機能し、date や town でフィルター処理するクエリを高速化します。
ベンチマークは、AWS m6i.8xlarge EC2 インスタンス(32 コア、128 GB RAM)および gp3 EBS ボリューム(16,000 IOPS、最大スループット 1,000 MiB/s)で実施しました。
date カラムと town カラムでフィルタリングするクエリを実行します。これらのカラムはベーステーブルの主キーには含まれていない点に注意してください。
まず、ベースラインの性能を確認するため、プロジェクションのサポートを無効にしてクエリを実行します。なお、インデックスによるデータプルーニングのみを分離して測定するため、クエリ条件キャッシュと PREWHERE は無効にしています。
SELECT *
FROM uk.uk_price_paid_with_proj
WHERE (date = '2008-09-26') AND (town = 'BARNARD CASTLE')
FORMAT Null
SETTINGS
use_query_condition_cache = 0,
optimize_move_to_prewhere = 0,
optimize_use_projections= 0;3 回の実行のうち最も速い結果は 0.077 秒 でした。
0 rows in set. Elapsed: 0.084 sec. Processed 30.73 million rows, 1.29 GB (363.92 million rows/s., 15.26 GB/s.)
Peak memory usage: 129.07 MiB.
0 rows in set. Elapsed: 0.076 sec. Processed 30.73 million rows, 1.29 GB (406.96 million rows/s., 17.07 GB/s.)
Peak memory usage: 129.29 MiB.
0 rows in set. Elapsed: 0.077 sec. Processed 30.73 million rows, 1.29 GB (398.51 million rows/s., 16.71 GB/s.)
Peak memory usage: 129.27 MiB.テーブル全体(約 3,000 万行)を読み込むフルテーブルスキャンが発生している点に注目してください。
次に、プロジェクションのサポートを有効にしてクエリを実行します。
SELECT *
FROM uk.uk_price_paid_with_proj
WHERE (date = '2008-09-26') AND (town = 'BARNARD CASTLE')
FORMAT Null
SETTINGS
use_query_condition_cache = 0,
optimize_move_to_prewhere = 0,
optimize_use_projections= 1; -- default value3 回の実行のうち最も速い結果は 0.010 秒 でした。
0 rows in set. Elapsed: 0.010 sec. Processed 16.38 thousand rows, 644.86 KB (1.60 million rows/s., 63.06 MB/s.)
Peak memory usage: 4.89 MiB.
0 rows in set. Elapsed: 0.010 sec. Processed 16.38 thousand rows, 644.86 KB (1.69 million rows/s., 66.36 MB/s.)
Peak memory usage: 4.88 MiB.
0 rows in set. Elapsed: 0.011 sec. Processed 16.38 thousand rows, 644.86 KB (1.54 million rows/s., 60.57 MB/s.)
Peak memory usage: 4.89 MiB.結果は 0.077 秒に対して 0.010 秒となり、およそ 90% の高速化が確認できました。
また、今回は約 3,000 万行全体ではなく、約 1 万 6,000 行のみがスキャンされたことにも注目してください。
EXPLAIN を実行すると、ClickHouse が両方のプロジェクションのプライマリインデックスをセカンダリインデックスとして使用し、ベーステーブルのグラニュールをプルーニングしていることが確認できます。
EXPLAIN projections = 1
SELECT *
FROM uk.uk_price_paid_with_proj
WHERE (date = '2008-09-26') AND (town = 'BARNARD CASTLE')
SETTINGS
use_query_condition_cache = 0,
optimize_move_to_prewhere = 0,
optimize_use_projections= 1; -- default value┌─explain────────────────────────────────────────────────────────────┐
1. │ Expression ((Project names + Projection)) │
2. │ Filter ((WHERE + Change column names to column identifiers)) │
3. │ ReadFromMergeTree (uk.uk_price_paid_with_proj) │
4. │ Projections: │
5. │ Name: by_time │
6. │ Description: Projection has been analyzed... │
7. │ Condition: (date in [14148, 14148]) │
8. │ Search Algorithm: binary search │
9. │ Parts: 5 │
10. │ Marks: 7 │
11. │ Ranges: 5 │
12. │ Rows: 57344 │
13. │ Filtered Parts: 0 │
14. │ Name: by_town │
15. │ Description: Projection has been analyzed... │
16. │ Condition: (town in ['BARNARD CASTLE', 'BARNARD CASTLE']) │
17. │ Search Algorithm: binary search │
18. │ Parts: 5 │
19. │ Marks: 5 │
20. │ Ranges: 5 │
21. │ Rows: 40960 │
22. │ Filtered Parts: 0 │
└────────────────────────────────────────────────────────────────────┘EXPLAIN 出力の 10 行目を見ると、by_time プロジェクション(具体的にはそのプライマリインデックス)によって、まず検索対象が 7 グラニュール(「Marks」)に絞り込まれていることがわかります。1 つのグラニュールには 8,192 行が含まれるため、スキャン対象は(12 行目に示されるように)7 × 8,192 = 57,344 行に相当します。これら 7 つのグラニュールは 5 つのデータパートにまたがっているため(9 行目)、エンジンは**対応する 5 つのデータ範囲(11 行目)**を読み取る必要があります。
続いて 14 行目から、by_town プロジェクションのプライマリインデックスが適用されます。これにより、事前に by_time プロジェクションで選択されていた 7 グラニュールのうち 2 つが除外されます。最終的な結果として、クエリの時間と町の条件に一致する行が含まれる可能性のある、ベーステーブルの 5 つのパートにまたがる 5 つのデータ範囲に位置する 5 グラニュールのみをエンジンがスキャンすれば済むようになります。
この最適化を制御するために、新たに 2 つの設定が導入されています。
-
max_projection_rows_to_use_projection_index: プロジェクションから読み取ると推定される行数がこの値以下である場合、プロジェクションインデックスを適用できます。
-
min_table_rows_to_use_projection_index: テーブルから読み取ると推定される行数がこの値以上である場合、プロジェクションインデックスの使用が検討されます。
26.1 におけるより簡潔な構文
ClickHouse 26.1 以降、こうした軽量な _part_offset プロジェクションの定義がさらにシンプルになりました。
これまでの記述形式:
PROJECTION by_time (
SELECT _part_offset ORDER BY date
),
PROJECTION by_town (
SELECT _part_offset ORDER BY town
)今後は、よりコンパクトな構文で定義できます。
PROJECTION by_time INDEX date TYPE basic,
PROJECTION by_town INDEX town TYPE basicこの構文も同じ意味を表します。指定されたカラムに対するセカンダリインデックスのように動作するプライマリインデックスを備えたプロジェクションを定義しています。
機能面での変更はありません。プロジェクションには依然としてソートキーと _part_offset のみが保存され、前述のとおりまったく同様にグラニュールレベルのプルーニングに寄与します。
まとめ
かつての ClickHouse テーブルには、プライマリインデックスが 1 つ しかありませんでした。
現在では、それぞれがプライマリインデックスのように動作するインデックスを複数保持できるようになり、クエリに複数のフィルターが含まれている場合、ClickHouse はそのすべてを活用します。