5万


数か月前、ClickHouse は PostgresBench を公開しました。これは 透明性があり再現可能な測定手法 を用いて、各ベンダーのマネージド Postgres の性能を比較するオープンソースのベンチマークです。Postgres コミュニティ からも大きな反響をいただき、その中で最も多く寄せられたフィードバックが、なぜ高可用性 (HA) 構成のベンチマークを実施していないのかという点でした。今回、その課題に対応し、前回と同じベンダー各社における HA 構成のベンチマーク結果を公開します。
1点重要な補足として、今回の結果はベンダー間の高可用性機能そのものを網羅的に比較したものではありません。さまざまな Postgres マネージドサービスにおいて、同等の可用性とデータの耐久性を実現した際に生じる性能面でのコストのみを測定しています。
ClickHouse Managed Postgres を今すぐ始める
自社データで ClickHouse Managed Postgres の動作を試してみませんか?数分で ClickHouse Cloud を利用開始でき、300 ドル分の無料クレジットも受け取れます。
サインアップ各 Postgres サービスの HA 構成
マネージド Postgres サービスでは、高可用性を実現するために通常 2 つの異なるアーキテクチャが採用されています。
シェアードナッシング型サービス (ClickHouse Managed Postgres、AWS RDS、Crunchy Bridge) は、ユーザーのインスタンスごとに独立したコンピュートとシングルテナントのストレージ環境をデプロイします。ネイティブの PostgreSQL レプリケーションを利用し、1 つ以上の物理ストリーミングスタンバイを配置して、プライマリが利用不可になった場合は自動フェイルオーバーを行います。
共有ストレージ型サービス (Postgres のフォークである AWS Aurora と Neon) はコンピュートとストレージを分離します。コミット経路上でレプリケーションされたストレージ層に WAL の複数コピーを書き込むことで耐久性を確保し、従来のストリーミングレプリカに依存することなく、障害が発生したコンピュートノードを置き換えます。
今回の比較では、高可用性を「プライマリの障害発生から 2 分以内に復旧し、データ損失ゼロを保証できるというシステムの公称値」と定義しました。比較の公平性を可能な限り維持しながら、各マネージドサービスが提供する中で最も同等な HA 構成を選択しています。以下のセクションでは、各ベンダーにおいてベンチマークを実施した構成について説明します。
公平に比較できるよう、すべてのベンダーでプライマリのコンピュートリソース (CPU および RAM) を可能な限り揃えました。共有ストレージ型サービスについては、ストレージバックエンドのハードウェア構成や冗長化設定が公開されていないため、これだけでは全容を把握できませんが、それらもシステムのパフォーマンスや信頼性に影響します。
ClickHouse Managed Postgres
ClickHouse Managed Postgres は、高性能な OLTP ワークロード向けに最適化された、ローカル NVMe をバックエンドとする Postgres サービスです。ローカル NVMe ストレージはコンピュート障害時にデータが失われるエフェメラルなストレージであるため、このサービスでは耐久性レベルの異なる複数の高可用性 (HA) 構成を提供しています。
シングルスタンバイ構成では非同期レプリケーションが使用され、わずかな目標復旧時点 (RPO) を許容できる (つまり、数ミリ秒分のトランザクション損失を許容できる) ワークロードに最適です。2 スタンバイ構成では同期クォーラムレプリケーションが使用され、データ損失ゼロ (RPO = 0) を実現します。すべての耐久性と高可用性は、レプリケートされたディスクではなく PostgreSQL のレプリケーションと WAL のアップロードによって実現されているため、現在、マルチ AZ による高可用性でデータ損失ゼロを達成するには、この 3 インスタンスによるクォーラムが必要です。なお、3 台目のインスタンスなしで同様の耐久性を保証する仕組みにも取り組んでいます。
これは、ワークロードのミッションクリティカル度に応じて最適な HA 構成 (スタンバイ 0 台、1 台、または 2 台) を選択できる制御性と柔軟性をユーザーに提供するための、意図的な設計上の選択です。どちらの構成も迅速なフェイルオーバーを実現するように設計されており、ホットスタンバイによってプライマリが利用不可になった際の目標復旧時間 (RTO) を最小限に抑えます。
Crunchy Bridge
Crunchy Bridge (Snowflake Postgres) は、単一の物理ストリーミングスタンバイレプリカを使用して高可用性を提供します。デフォルトではレプリケーションは非同期です。同期レプリケーションを設定すること (synchronous_commit の調整) はできず、RPO ゼロを保証するオプションも見当たりませんでした。もしサポートされている構成や設定を見落としている場合は、ぜひお知らせください。本記事の内容を適宜更新いたします。
AWS RDS Postgres
AWS RDS (および Crunchy Bridge) は、AZ 内の耐久性をマネージドディスクのレプリケーションに依存し、高可用性とマルチ AZ 耐久性をホットスタンバイの PostgreSQL インスタンスに依存しています。RDS は 1 台または 2 台のスタンバイに対応しており、どちらのオプションも常に同期レプリケーションを行うため、フェイルオーバー時のデータ損失はありません。今回は、マルチ AZ DB インスタンス (スタンバイ 1 台) と マルチ AZ DB クラスター (スタンバイ 2 台、クォーラム) の両方をテストしました。
AWS Aurora Postgres
Aurora Postgres は AWS がメンテナンスする Postgres のフォークであり、Postgres ネイティブのストリーミングレプリケーションではなく共有ストレージアーキテクチャを通じて高可用性を提供します。データは複数のアベイラビリティゾーンにまたがる複数のストレージノードへ同期レプリケーションされ、リーダーインスタンスはライターと同じストレージボリュームを共有します。共有ストレージシステムにおけるホットスタンバイは耐久性の面では必須ではありませんが、フェイルオーバーの高速化や読み取りトラフィックのスケールアウトには依然として有用です。AWS は、高可用性のために少なくとも 1 台の Aurora レプリカ (リーダー) をデプロイすることを推奨しています。このレプリカにより、プライマリインスタンスが利用不可になった場合の自動フェイルオーバーと迅速な復旧が可能になります。今回は、ライター 1 台と Aurora レプリカ 1 台で構成されたクラスターをベンチマークしました。
Neon
Neon もまた、ストレージとコンピュートを分離するアーキテクチャを採用した Postgres のフォークです。読み取りスループットは、コンピュートインスタンス上のローカルキャッシュと、一般に「ページサーバー」と呼ばれる独立した分散システムからのリモート読み取りの組み合わせに依存します。Neon はさらにプラットフォームのマルチテナント化を進め、サーバーレスのコンピュートクラスターや接続ゲートウェイを備えています。これらのコンポーネントは柔軟性やコスト削減の可能性をもたらす一方で、ビジネスクリティカルなワークロードにはさらなるトレードオフを生じさせます (参考)。
Neon は、フェイルオーバー時に新しいコンピュートノードを極めて迅速に立ち上げて既存のストレージにアタッチすることで、スタンバイノードの必要性を排除している点を高可用性 (HA) の特徴として位置付けています。同社はこれをコスト面での優位性として提示しています。多くの顧客に影響を与えた Neon の可用性と信頼性の問題の実績を考慮すると、スタンバイノードが不要であるという主張には疑問が残ります。ただし、本ベンチマークでは、ドキュメントに記載されたアーキテクチャと位置付けに基づいて Neon の HA を評価しています。
ベンチマーク結果
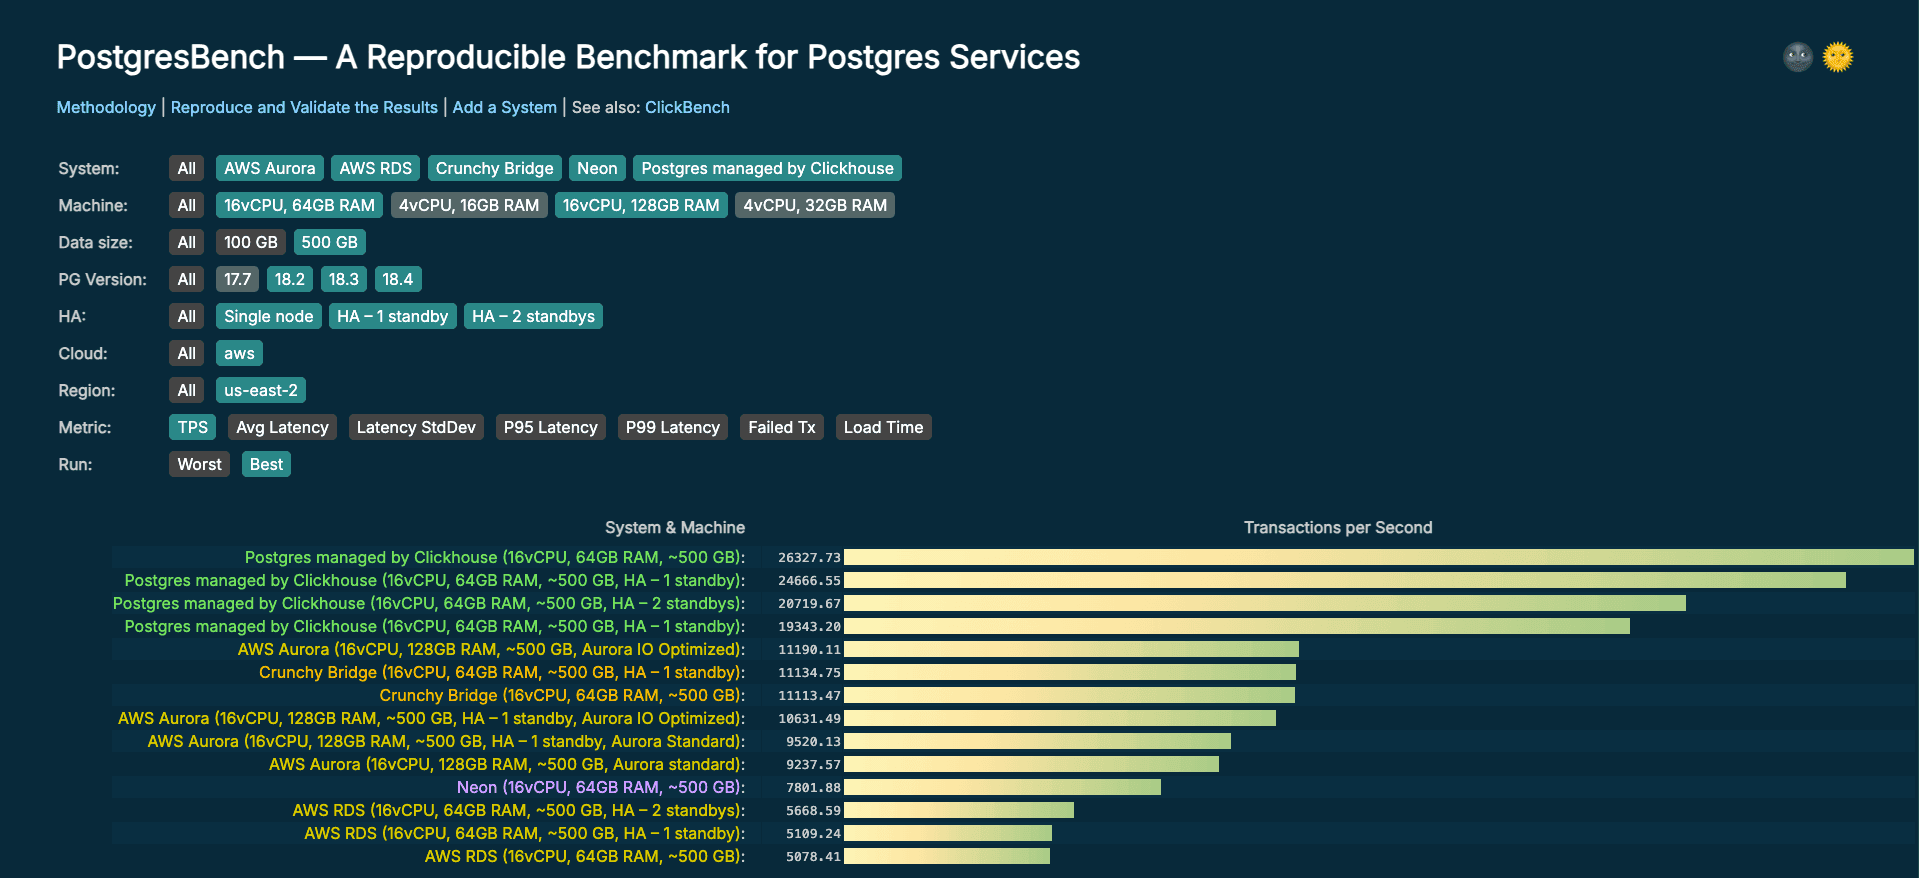
各構成について、データベースのインスタンスサイズとデータセットサイズを幅広く変えてベンチマークを実施しました。すべての結果は PostgresBench で公開されています。以下では、最大インスタンスサイズ (16 vCPU、64 GB RAM) かつ最大データセット (500 GB) において、各テストを 10 分間実行した結果を紹介します。平均秒間トランザクション数 (TPS) と p99 トランザクションレイテンシを報告します。
下表には、各ベンダーの Single node 行も含まれています。これは PostgresBench の第 1 弾ですでに公開された単一ノードのベースラインです。この表の Aurora と Neon の結果は、実質的に単一ノードデプロイメントのものです。
| Vendor | Configuration | Avg TPS | TPS vs own Single node | Avg latency | Avg latency vs own Single node | p99 latency | p99 vs own Single node |
|---|---|---|---|---|---|---|---|
| ClickHouse Managed Postgres | Single node | 26,328 | 100% | 9.70 ms | 100% | 13.20 ms | 100% |
| ClickHouse Managed Postgres | 1 standby, async | 24,667 | 94% | 10.37 ms | 107% | 24.17 ms | 183% |
| ClickHouse Managed Postgres | 2 standbys, sync (quorum) | 20,720 | 79% | 12.34 ms | 127% | 33.49 ms | 254% |
| Crunchy Bridge | Single node | 11,113 | 100% | 23.00 ms | 100% | 41.68 ms | 100% |
| Crunchy Bridge | HA (1 standby, async) | 11,135 | 100% | 23.00 ms | 100% | 41.89 ms | 101% |
| RDS by AWS | Single node | 4,399 | 100% | 58.14 ms | 100% | 130.15 ms | 100% |
| RDS by AWS | Multi-AZ instance (1 sync) | 4,461 | 101% | 57.35 ms | 99% | 221.69 ms | 170% |
| RDS by AWS | Multi-AZ cluster (2 sync, quorum) | 4,659 | 106% | 54.92 ms | 94% | 816.63 ms | 627% |
| AWS Aurora | Single node | 9,238 | 100% | 27.69 ms | 100% | 39.81 ms | 100% |
| AWS Aurora | HA (1 standby, async) | 9,520 | 103% | 26.87 ms | 97% | 39.92 ms | 100% |
| Neon | Single node | 7,802 | 100% | 32.80 ms | 100% | 56.30 ms | 100% |
シェアードナッシングアーキテクチャ
スタンバイレプリカに依存するベンダーについて、コンピュートを揃え、同等の耐久性レベルで比較すると以下のとおりです。
- RDS Postgres: 高速フェイルオーバー (数秒〜数分の RTO) を備えた RPO 0 の設定において、同期スタンバイ 2 台 (クォーラム) の ClickHouse Managed Postgres は、単一レプリカおよび 2 レプリカ構成の Amazon RDS Multi-AZ と比べて、約 4 倍高い TPS、約 3 分の 1 の p50 レイテンシ、約 7 分の 1 の p99 レイテンシを示しました。
- Crunchy Bridge: Crunchy Bridge の最も近い比較対象となる HA 構成 (非同期スタンバイ 1 台、ごくわずかな非ゼロの RPO を伴う高速フェイルオーバー) と比べると、ClickHouse Managed Postgres (非同期スタンバイ 1 台) は、約 2.2 倍高い TPS、約 3.5 分の 1 の p50 レイテンシ、約 1.75 分の 1 の p99 レイテンシを示しながら、より強固な耐久性保証も提供しています。
共有ストレージアーキテクチャ
共有ストレージサービスについて、プライマリのコンピュートサイズを揃えて比較すると以下のとおりです。
- Aurora Postgres: 同等に構成された PostgreSQL プライマリコンピュートサイズにおいて、スタンバイ 1 台の構成で、ClickHouse Postgres はスループットとレイテンシで 2 倍以上の優位性を示しました。
- Neon: 同等に構成された PostgreSQL プライマリコンピュートサイズにおいて、ClickHouse Postgres はスループットとレイテンシで 3 倍以上の優位性を示しました。
まとめ
今回、HA のサポートを追加できたことを嬉しく思います。これにより、本番環境に対応した Managed Postgres デプロイメントがより正確に反映され、データの耐久性の実装の違いがパフォーマンスに与える影響をユーザーが把握しやすくなります。
取り組みはこれで終わりではなく、PostgresBench の次の展開について多くのアイデアを持っています。今後投資を計画している領域としては、Managed Postgres プロバイダーの追加、ベンチマーク実行時間のカスタマイズ対応、TPC-C や TPROC-C などの追加ワークロードの導入、PostgreSQL の設定パラメータを含む各種構成オプションの拡充などが挙げられます。また、ClickHouse 向けに CostBench で行ってきたのと同様に、Managed Postgres プロバイダー間のコストパフォーマンスのトレードオフを分析することも計画しています。Managed Postgres サービスの標準となる、完全に再現可能なベンチマークへと PostgresBench を育てていくにあたり、皆様からのフィードバックが今後の方向性を形作ることになります。
PostgresBench はオープンソースであり、GitHub で公開されています。測定方法をご確認いただき、ベンチマークを再現の上、追加ベンダーへのサポート提供にもぜひご協力ください。
ClickHouse Managed Postgres を今すぐ始める
自社データで ClickHouse Managed Postgres の動作を試してみませんか?数分で ClickHouse Cloud を利用開始でき、300 ドル分の無料クレジットも受け取れます。
サインアップ