5万


今回のブログ記事は、高パフォーマンスかつリソース効率に優れた OpenTelemetry コレクションを実現するオープンソースの Rust プロジェクト「Rotel」をメンテナンスしている、Streamfold の Mike Heffner 氏と Ray Jenkins 氏によるゲスト投稿です。
概要
- 大規模環境では効率が鍵: リソース使用率のわずかな削減が、コストと効率に極めて大きな影響を与えます
- OTel + ClickHouse のベンチマーク: トレースデータを ClickHouse へストリーミング取り込みするパイプラインを構築して検証します
- Rotel で 4 倍にスケール: コアあたり毎秒 13.7 万トレーススパン(OTel Collector)から毎秒 46.2 万トレーススパン(Rotel)へと性能を引き上げた方法を、主要な改善点とともに詳しく解説します
- ツールとリソース: ベンチマーク評価に使用したツール群を紹介します
はじめに
ペタバイト規模でオブザーバビリティプラットフォームを運用するには、リソース効率への継続的かつ計画的な注力が欠かせません。コアあたりの性能やメモリ消費量がわずかに改善するだけでも、インフラコストの大幅な削減につながります。

この記事は、私たちがデンバーで開催された ClickHouse ミートアップで行った講演をもとに作成しました。この講演では、大規模システムにおける高いパフォーマンスを目的として設計された OpenTelemetry データプレーンである Rotel に関する取り組みを紹介しました。
ClickHouse は、その高い圧縮率とコスト効率の良さから、大規模な OpenTelemetry ワークロードでの採用が進んでいます。その一方で、パイプラインの中で最もコストのかかる部分として OTel Collector が浮上することがよくあります。
最近、ClickHouse は大規模環境における効率性の重要性と、同社の社内プラットフォーム LogHouse で OTel を運用した経験に関する記事を公開しました。
その投稿の中で、ある詳細が目を引きました。
「OTel Collector: 毎秒 200 万件のログを転送するために 800 個以上の CPU コアを使用。」
コアあたり毎秒約 2,500 件のログという数値は、平均的なログ行サイズで考えると 8 コアマシン上で毎秒わずか 10 MB にすぎず、現代のハードウェアが維持できる性能を大幅に下回っています。ClickHouse は 1 コアあたり毎秒 12,500 件以上の OTel イベントを処理でき、これは取り込み速度の 5 倍以上にあたります。そのため、ボトルネックはストレージではなく取り込み側になります。ClickHouse 独自の社内プラットフォームを再現することはできませんが、最新の OpenTelemetry パイプラインをベンチマークする価値はあると考えました。そこで講演に向けて、私たちはある中心的な疑問を検証したいと考えました。ClickHouse にトレースデータを送信する際、異なる OpenTelemetry データプレーンの間でパフォーマンスにはどのような差が出るのか?
本記事では、Kafka 経由でトレーススパンをストリーミングして ClickHouse に書き込む合成トレースパイプラインを使用し、OpenTelemetry Collector と Rotel を比較したベンチマークについて詳しく解説します。OTel Collector で毎秒 110 万スパンを記録したベンチマーク結果をもとに、JSON バイナリシリアライゼーションの実装、Tokio タスク管理の perf 分析、および強化された LZ4 圧縮の活用によって、同じハードウェア上で Rotel をスケールさせ、最大毎秒 370 万スパンを処理できるようにした方法を紹介します。
ベンチマークフレームワークとツールについては記事の最後で紹介します。
ClickStack でオブザーバビリティ向け ClickHouse を試す
大規模な OpenTelemetry 向けに構築されたオープンソースのオブザーバビリティスタックを、わずか 1 コマンドで使い始められます。
今すぐ始めるベンチマークフレームワーク
結果を見ていく前に、OpenTelemetry コレクターと Rotel を何を基準にどのように評価しようとしているのかについて、少し説明します。すぐにテスト結果を確認したい場合は、こちらから直接移動できます。
トレーシングパイプライン
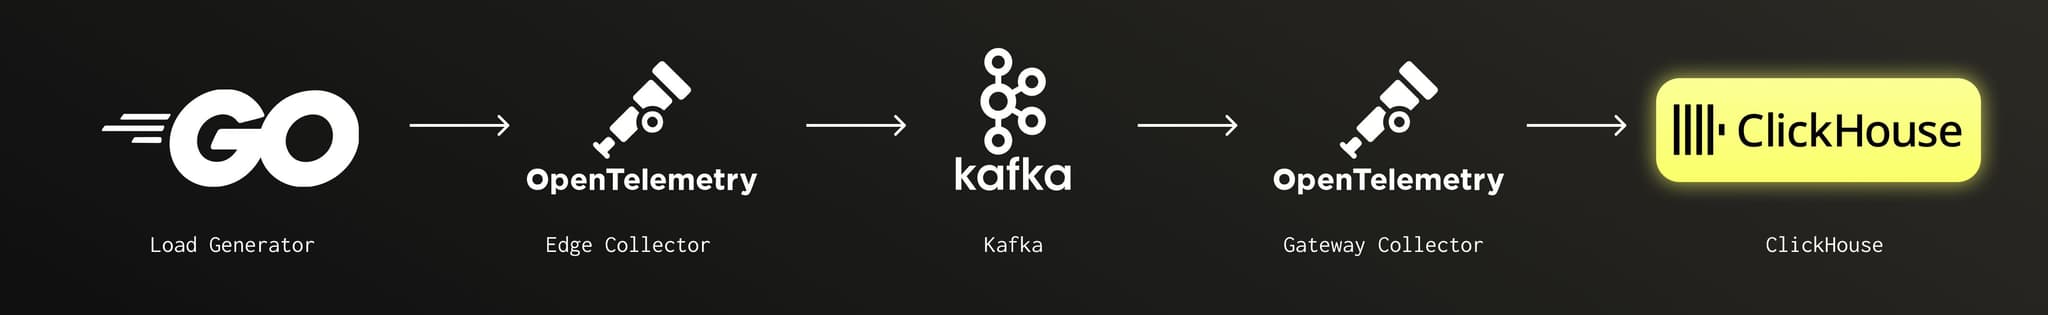
大規模システムではトレースデータが急速に増加するため、今回のベンチマークでは ClickHouse へのトレーススパン書き込みに焦点を当てました。ログストリーミング層として Kafka を使用し、信頼性の高いストリーミングパイプラインをモデルにしたベンチマークを設計することにしました。多数のエッジコレクターがデータをストリームに発行し、それを少数のコレクターが消費してバッチデータを ClickHouse へ効率的に書き込むシステムを再現することが目的です。このパイプラインでは、Rotel と OTel Collector の双方が同一の Kafka Protobuf エンコーディングをサポートしているため、相互に置き換えが可能です
評価アプローチ
私たちの目標は、スケールアップやスケールアウトではなく効率性に焦点を当て、固定されたハードウェア上で単一のコレクターが維持できる最大スループットを明らかにすることでした。評価予算の範囲内に収めつつ、性能が低下するまでに1つのノードをどこまで追い込めるかを確認したいと考えました。また、ClickHouse は大きなバッチ挿入で最大のパフォーマンスを発揮するため、直接 ClickHouse へエクスポートするゲートウェイコレクターを中心にテストを行いました。バッチ処理の効率を最大化するには、大規模なゲートウェイコレクターを少数実行する構成が適しているため、このコンポーネントを最適化および測定の対象としました。
飽和状態の検出
コレクターが処理可能な最大容量に達したことを示すシグナルとして、次の2点を特定しました。
- メモリの増加 - コレクターはダウンストリームコンポーネントからのバックプレッシャーを受けると内部でペイロードをバッファリングするため、メモリ使用量が急激に増加します。
- Kafka コンシューマーラグ - コレクターが着信メッセージを処理しきれなくなると、Kafka コンシューマーラグ(最後に読み取られたメッセージと現在の実時間との時間差)が増大します。
テスト構成
各テストでは、パイプラインを飽和寸前の状態で合計 15 分間実行し、次の2つのメトリクスを記録しました。
- ロードジェネレーターによって記録されるトレーススパン数/秒
- AWS CloudWatch で測定される ClickHouse への取り込み MB/秒
環境によってトレーススパンのサイズに大きな差が生じる可能性があるため、総帯域幅を見ることで正規化されたスループットメトリクスを把握できます。今回のパイプライン構成では、単一のエッジコレクターが最適化されたバッチを Kafka に送信するため、メッセージ全体の件数が減る一方で、個々のメッセージサイズは大きくなります。
テストごとに、Rotel と ClickHouse の平均 CPU 使用率を計測します。
OpenTelemetry の ClickHouse スキーマ
ベンチマークには、OpenTelemetry Collector と Rotel の両方に互換性がある単一の ClickHouse データスキーマを使用しました。このスキーマは、ClickHouse およびオブザーバビリティソリューションである ClickStack において、OTel のメトリクス、ログ、トレースを扱う際に推奨されているものです。
OTel データモデルは、分析に不可欠なインフラやアプリケーション環境の固有プロパティを表現するため、キー/バリュー属性に大きく依存しています。従来の ClickHouse スキーマでは、これらのフィールドは Map カラム型を使用して格納されていましたが、OTel Collector の最近の機能フラグにより、新しい JSON カラム型を使用するようにスキーマが更新されました。JSON カラム型は ClickHouse の CPU 負荷が高くなるものの、より柔軟で表現力豊かなクエリを実行できます。今回の評価では、この新しい JSON カラム型を採用しました。使用した完全な ClickHouse トレーススキーマはこちらで確認できます。
私たちの構成において重要だったのは、ClickHouse の Null テーブルエンジンを採用した点です。これによりベンチマークからディスク I/O の影響を排除できました。Null エンジンは書き込みを受け付けますが直ちに破棄するため、ストレージのレイテンシを排除した状態で取り込みスループットを測定し、スキーマの正確性を検証できます。パイプラインのピークスループットを特定した後は、実際のディスク書き込みを処理するための ClickHouse のスケーリングに注力できます。
負荷生成
ベンチマークに必要なデータ量を telemetrygen CLI で送り込むことはできませんでした。そのため、OpenTelemetry やその他のテレメトリパイプラインをテストするために以前構築した社内製ロードジェネレーターを使用しました。このプロジェクトは otel-loadgen GitHub リポジトリで公開されています。エンドツーエンドのデータ到達を検証するための追加機能も備わっており、これについては今後の記事で取り上げる予定です。
トレースあたり約 100 スパンを生成し、属性やメタデータに変化を持たせました。他の合成負荷テストと同様に、このデータセットが本番環境の実際のトラフィックと完全に一致するわけではありません。
評価用ハードウェア
すべてのベンチマークは AWS EC2 インスタンス上で実施しました。評価パイプラインの各層は個別のインスタンスで実行され、すべてのインスタンスは同一のアベイラビリティゾーン内に作成されました。
| インスタンス | vCPU | メモリ (GiB) | |
|---|---|---|---|
| ロードジェネレーター | m8i.8xlarge | 32 | 128 |
| エッジコレクター | m8i.4xlarge | 16 | 64 |
| Kafka | i3.xlarge | 4 | 30.5 |
| ゲートウェイコレクター | m8i.2xlarge | 8 | 32 |
| ClickHouse | i3.4xlarge | 16 | 122 |
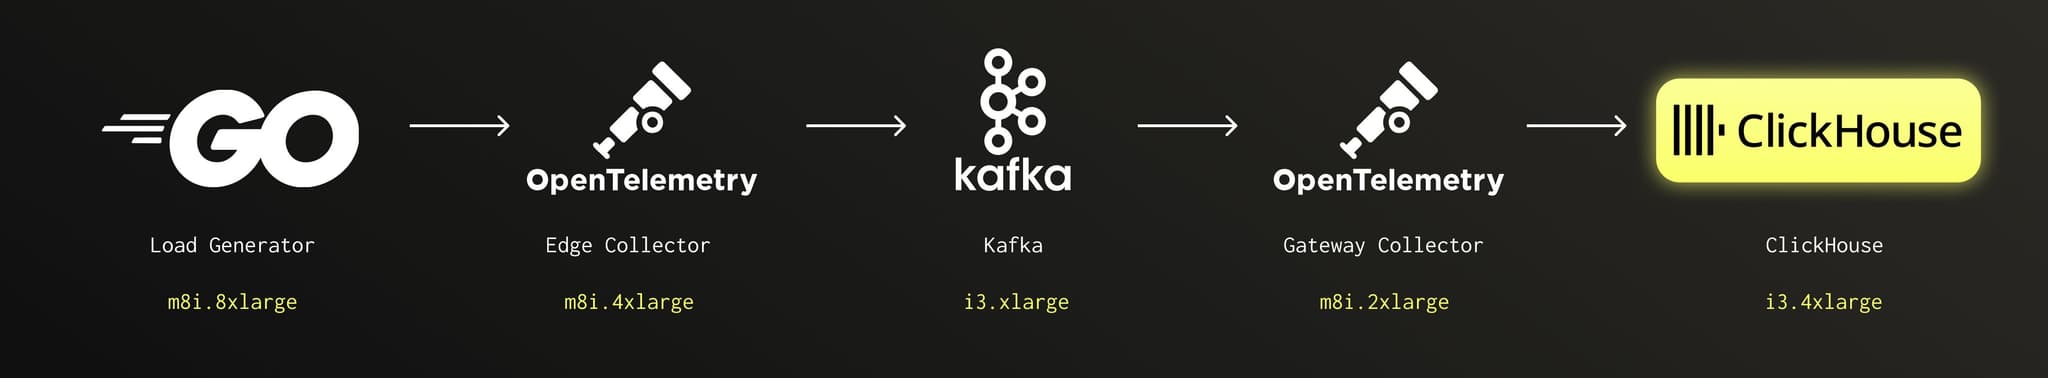
Kafka と ClickHouse については、ディスクスループットを最大化するためにデータボリュームをインスタンスストレージの NVMe ドライブにマウントしました。OS には Amazon Linux 2023 を使用し、Docker Compose で各コンポーネントを実行しました。
これらのベンチマークの目的は、単一のゲートウェイコレクターマシンで処理できる最大スループットを見極めることでした。インスタンスタイプは 8 コア、32 GB メモリを備えた m8i.2xlarge を選択しました。規模の拡大に伴いパイプライン内の他のマシンは拡張する必要がありましたが、ゲートウェイコレクターは一貫して m8i.2xlarge のまま維持しました。
OpenTelemetry Collector のテスト
ベンチマークはまず OpenTelemetry Collector から開始し、エッジコレクターとゲートウェイコレクターの双方として実行しました。
セットアップ
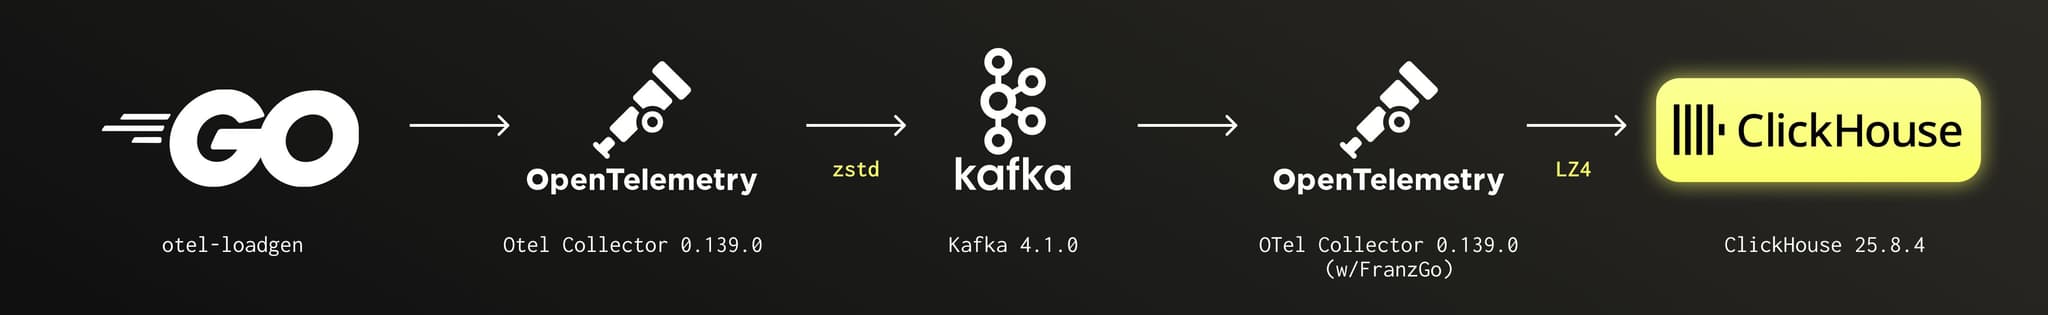
docker-compose の設定はこちらで確認できます。
結果
| OTel Collector | トレーススパン | トレーススパン / コア | ClickHouse ネットワーク受信 (圧縮) |
|---|---|---|---|
| 単一コレクタープロセス | 毎秒 70 万 | 毎秒 8.75 万 | 40 MB/s |
| デュアルコレクタープロセス | 毎秒 110 万 | 毎秒 13.75 万 | 69 MB/s |
コレクターの単一インスタンスを実行したところ、最初は毎秒約 70 万スパン (40 MB/s) 付近で限界に達しました。その時点を超えると、CPU 使用率は 50% 程度にとどまっていたにもかかわらず、コレクターのメモリ使用量が着実に増加し始めました。
OpenTelemetry の Kafka レシーバーは単一の goroutine でメッセージを処理するため、処理可能なトラフィック量に制限が生じたと考えられます。メッセージサイズパラメータを含むいくつかの Kafka 設定オプションを試行しましたが、スループットに目立った改善は見られませんでした。そのため、同じマシン上で 2 番目のコレクターインスタンスを実行し、水平方向にスケールさせました(Docker Compose 設定での scale: 2)。
2 つのコレクタープロセスを実行し、それぞれが Kafka パーティションの半分を消費するようにしたところ、飽和前に維持できた最高スループットは毎秒 110 万トレーススパン (69 MB/s) でした。これを超えると送信キューが満杯になり始め、メモリ使用量が急激に増加しました。送信キューが完全に満杯になると、Kafka レシーバーはメッセージの読み取りを継続するものの、即座に破棄する状態に陥りました。つまり、コンシューマーラグは増大しない一方で、データが失われていたのです。
テスト中のゲートウェイコレクターの CPU 使用率は 83% 強でピークに達し、これが制限要因となっていたようです。ClickHouse の CPU 使用率は約 23% で推移しました。
| Rotel | ClickHouse | |
|---|---|---|
| CPU | 83.1% | 23.8% |

Rotel のテスト
セットアップ
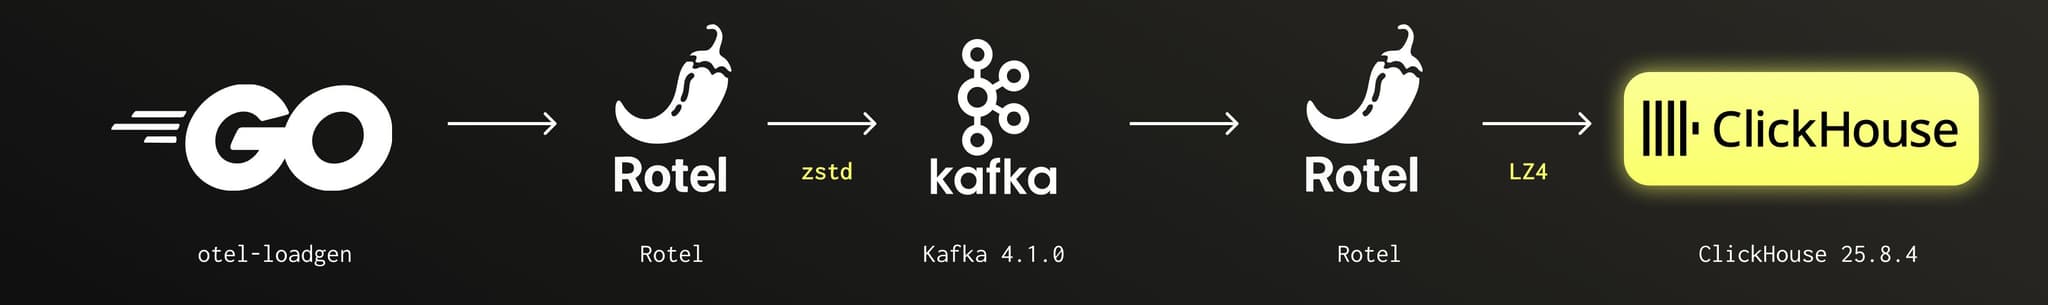
docker-compose の設定はこちらで確認できます。
結果
| Rotel | トレーススパン | トレーススパン / コア | ClickHouse ネットワーク受信 (圧縮) |
|---|---|---|---|
| 単一 Rotel プロセス | 毎秒 75 万 | 毎秒 9.375 万 | 41 MB/sec |
| デュアル Rotel プロセス | 毎秒 145 万 | 毎秒 18.13 万 | 76 MB/sec |
Rotel には、OTel Collector と同様に Kafka からメッセージを取得する単一のレシーバーループがあります。そのため直列処理によるボトルネックが存在すると考えられましたが、Rotel プロセスを2インスタンス実行してインスタンスの CPU をフル活用できたことで、当初の想定が裏付けられました。
デュアル Rotel プロセスでは、毎秒最大 145 万トレーススパン (76 MB/sec) を達成し、OTel Collector と比較して総スループットが約 1.3 倍向上しました。毎秒 145 万スパンを超えると Kafka コンシューマーラグが徐々に増加し、Kafka からの消費が追いつかなくなっていることが示されました。
毎秒 145 万トレーススパンの時点でゲートウェイコレクターインスタンスの CPU がボトルネックとなり、ClickHouse の CPU 使用率も約 60% まで上昇しました。
| Rotel | ClickHouse | |
|---|---|---|
| CPU | 91.3% | 60.4% |

私たちはさらなる最適化の余地を探求し続け、その結果、JSON カラム型の送信方法に注目することになりました。
RowBinary JSON の改善
Rotel では、公式の Rust ClickHouse クレートである clickhouse-rs を修正したバージョンを使用しています。clickhouse-rs クレートは、HTTP 経由で送信される行指向のバイナリシリアライズ形式である RowBinary を使用して ClickHouse との間でデータの読み書きを行います。対照的に、OTel Collector の Go ドライバーや ClickHouse の内部サーバー間通信では、列指向のネイティブプロトコルが使用されます。
JSON カラム型を扱う際、clickhouse-rs クレートでは、ネットワーク経由で送信する前に値を JSON 文字列にシリアライズすることが推奨されています。ClickHouse は JSON カラムを生の文字列としては保存しないため、この文字列化ステップは単に転送用に行われるものですが、それでもオーバーヘッドが生じます。クライアント側で JSON をシリアライズし、サーバー側でそれを再度パースしなければなりません。これには引用符やバックスラッシュなどの文字をエスケープするために JSON のキーと文字列値を走査する必要があり、高スループット環境で大きな文字列を扱う場合には負荷が非常に高くなります。
ClickHouse の Slack コミュニティの協力により、JSON カラムは代わりにネイティブの RowBinary 形式でエンコードできることが分かりました。JSON カラムは、キーとバリューのペアのシーケンスとしてエンコードされます。文字列のキーを書き出し、その後に値の型タグ、そして生の値自体を書き込みます。これにより JSON のシリアライズコストが回避され、構造化データを ClickHouse に直接ストリーミングできるようになります。
たとえば、次のようなシンプルな JSON オブジェクトを考えてみます。
{
"a": 42,
"b": "dog",
"c": 98
}これに対する RowBinary エンコーディングは次のようになります。
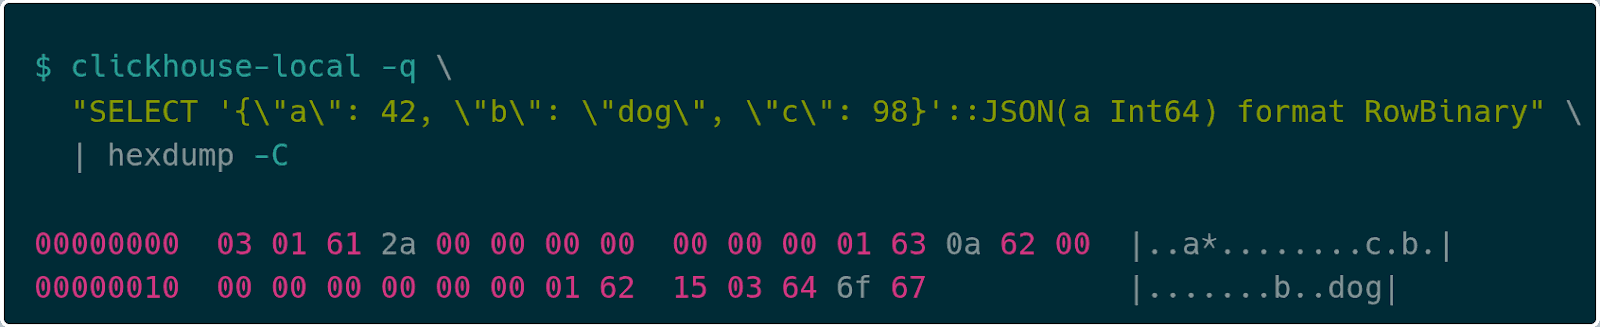
JSON RowBinary では、まずキー/値ペアの数を可変長整数 (varint) としてエンコードするため、ここでは 03 ペアとなり、その後に各キー/値ペアのエンコーディングが続きます。各キー/値ペアのエンコーディングでは、キーの長さに varint を使用し(ここでは 01 )、その後に文字列のバイト列、最後に値のエンコーディングが続きます。上記の例の a のように、JSON 型宣言内で値の型が判明している場合は、その型を直接エンコードし、値 42 に対して 2a 00 00 00 00 00 00 00 となります。型が宣言されていない場合は、Dynamic 型エンコーディングを使用します。たとえば、キー c では Int64 を表すエンコーディング 0a を使用し、その後に値 98 (62 00 00 00 00 00 00 00) が続きます。最後に、キー b の後には値が文字列型であることを表す 15、文字列の長さである 03、そして文字列「dog」が続きます。
これにより効率が大幅に向上し、クライアントとサーバーの双方でシリアライズ/デシリアライズの時間を削減できます。この JSON エンコーディングは clickhouse-rs クレートでまだサポートされていませんが、近日中にサポートへの貢献を行う予定です。
テストの再実行
この改良されたエンコーディング方式を使用するように Rotel を更新した後、その影響を測定するためにテストを再実行しました。結果として、前回のピークである毎秒 145 万スパンを超えることはできませんでしたが、ClickHouse サーバー側でCPU 使用率がおよそ 10% 削減され、ゲートウェイコレクター側でも CPU がわずかに削減されていることが確認できました。この削減は複数回の実行全体で一貫して現れており、サーバー側でのデシリアライズコストの低下が実際のメリットをもたらしたことを示唆しています。
今回の検証で使用した合成負荷には大きな文字列値が含まれておらず、スパンあたりの属性数も本番環境のワークロードとは異なる可能性があります。クライアント側では大幅な改善が見られなかったものの、より大きな属性セットを含むスパンでは、JSON のシリアライズおよびデシリアライズパスの高速化がより顕著に現れると考えています。
| Rotel | ClickHouse | |
|---|---|---|
| CPU | 88.5% | 50.7% |

ひとつの工夫でスループットを倍増させる(アロケータのロック競合の発見と解決)
テストのこの時点では、ホストの 8 vCPU を飽和させ、ClickHouse への毎秒 145 万イベントを達成するために、ゲートウェイコレクター上で Rotel のインスタンスを 2 つ実行する必要がありました。Rotel の Kafka レシーバーは単一の Tokio タスク内で動作しており、簡略化すると次のようになっていました。
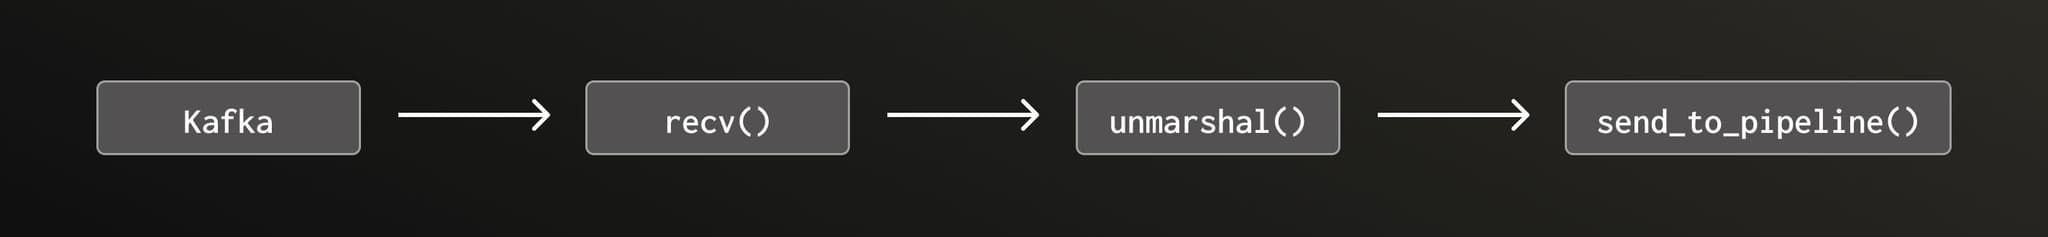
このアプローチには 2 つの問題があります。
- 各ステップを順次実行しなければならず、並列性がない。
- アンマーシャリングは CPU バウンドで負荷の高い計算であり、Tokio エグゼキュータスレッドをブロックする可能性がある。
Tokio は Rust プログラミング言語向けの非同期ランタイムであり、協調的スケジューリングに依存しています。つまり、タスクは .await ポイントやその他の yield ポイントで、自発的に制御をランタイムへ戻すことが期待されます。この規約の重要性と、それを無視した場合に起こり得る破滅的な影響を解説した記事は数多く存在します。しかし、一言で言えば、Tokio タスクは「.await ポイントから決して離れすぎてはならず」、各 .await 間に費やす時間を 10〜100 マイクロ秒以内に抑えることが優れた経験則です。
Rotel のエクスポーター全体では、送信リクエストのペイロードをマーシャリングして圧縮するという CPU 負荷の高い処理に、別のスレッドプールを使用しています。Kafka レシーバーの場合、ペイロードは recv() 呼び出しに到達する前に、rust-rdkafka ライブラリのバックグラウンドスレッドで解凍されます。初期の Kafka レシーバー実装では、受信ペイロードをアンマーシャリングする処理を Tokio の非同期タスク内にとどめていました。このアンマーシャリングが高負荷な CPU 処理であると判断した後、Kafka レシーバーを更新し、ブロッキングタスクの実行にエクスポーターと同じスレッドプールを使用するようにしました。
リファクタリング後のレシーバーのメイン処理ループは次のようになります。
loop {
select! {
message = recv() => {
unmarshaling_futures.push(spawn_blocking(unmarshal(message)))
},
unmarshaled_res = unmarshaling_futures.next() => {
send_to_pipeline(unmarshaled_res)
}
}
}続いて、ゲートウェイコレクター上で単一の Rotel プロセスを使用してテストを再実行しました。負荷ジェネレーターを前回の最大値である毎秒 145 万トレーススパンで再起動したところ、以前と同じスループットを処理できました。しかし驚いたことに、CPU 負荷が 40% 低下していました。
以前は vCPU を飽和させるのに 2 つの Rotel インスタンスが必要であり、Kafka レシーバーが直列処理のボトルネックに達していることを示唆していました。マーシャリング処理を別スレッドに移して並列性を高めることで、その制限は解消されるはずでした。ボトルネックが解決されれば、単一の Rotel インスタンスでも 2 つのインスタンスと同じスループットに達し、CPU 使用率も同程度になると予想していました。
CPU 負荷が以前よりも大幅に低下したため、さらにスループットを引き上げ続けました。その結果、スループットを毎秒 145 万から毎秒 360 万トレーススパンへと 2 倍以上に増やすことができました。
| Rotel | トレーススパン | トレーススパン / コア | ClickHouse Network In (圧縮後) |
|---|---|---|---|
| 単一の Rotel プロセス | 毎秒 360 万 | 毎秒 45 万 | 204 MB/秒 |
毎秒 360 万トレーススパンの時点で、再び CPU 使用率が約 93% と飽和状態に達しました。
| Rotel | ClickHouse | |
|---|---|---|
| CPU | 93.7% | 55.7% |

性能向上が確認できたため、次のステップはこの CPU 効率向上の要因を明らかにすることでした。そのために詳細なプロファイリングを行い、Linux Perf とフレームグラフを使って新旧のビルドを比較し、CPU 時間がどこで消費されているかを可視化しました。
フレームグラフによる Rotel の Kafka レシーバーのプロファイリング
Rotel の Kafka レシーバーの新旧バージョンに対してテストを再実行し、今回はフレームグラフをいくつか採取しました。一見したところでは、すぐにわかるような違いは目に入りませんでした。お気づきでしょうか。どちらのバージョンでも、ClickHouse へのトレースの準備とエクスポートが実行時間の大半を占めており、レシーバー側でのメッセージのアンマーシャリングにもかなりの時間を費やしていることがはっきりとわかります (アンマーシャリングは prost::message::Message::decode ルーチン内で発生します)。このワークロードは短命なオブジェクトを大量に生成するため、メモリの割り当てと解放に多くの時間が費やされています。
旧バージョン:
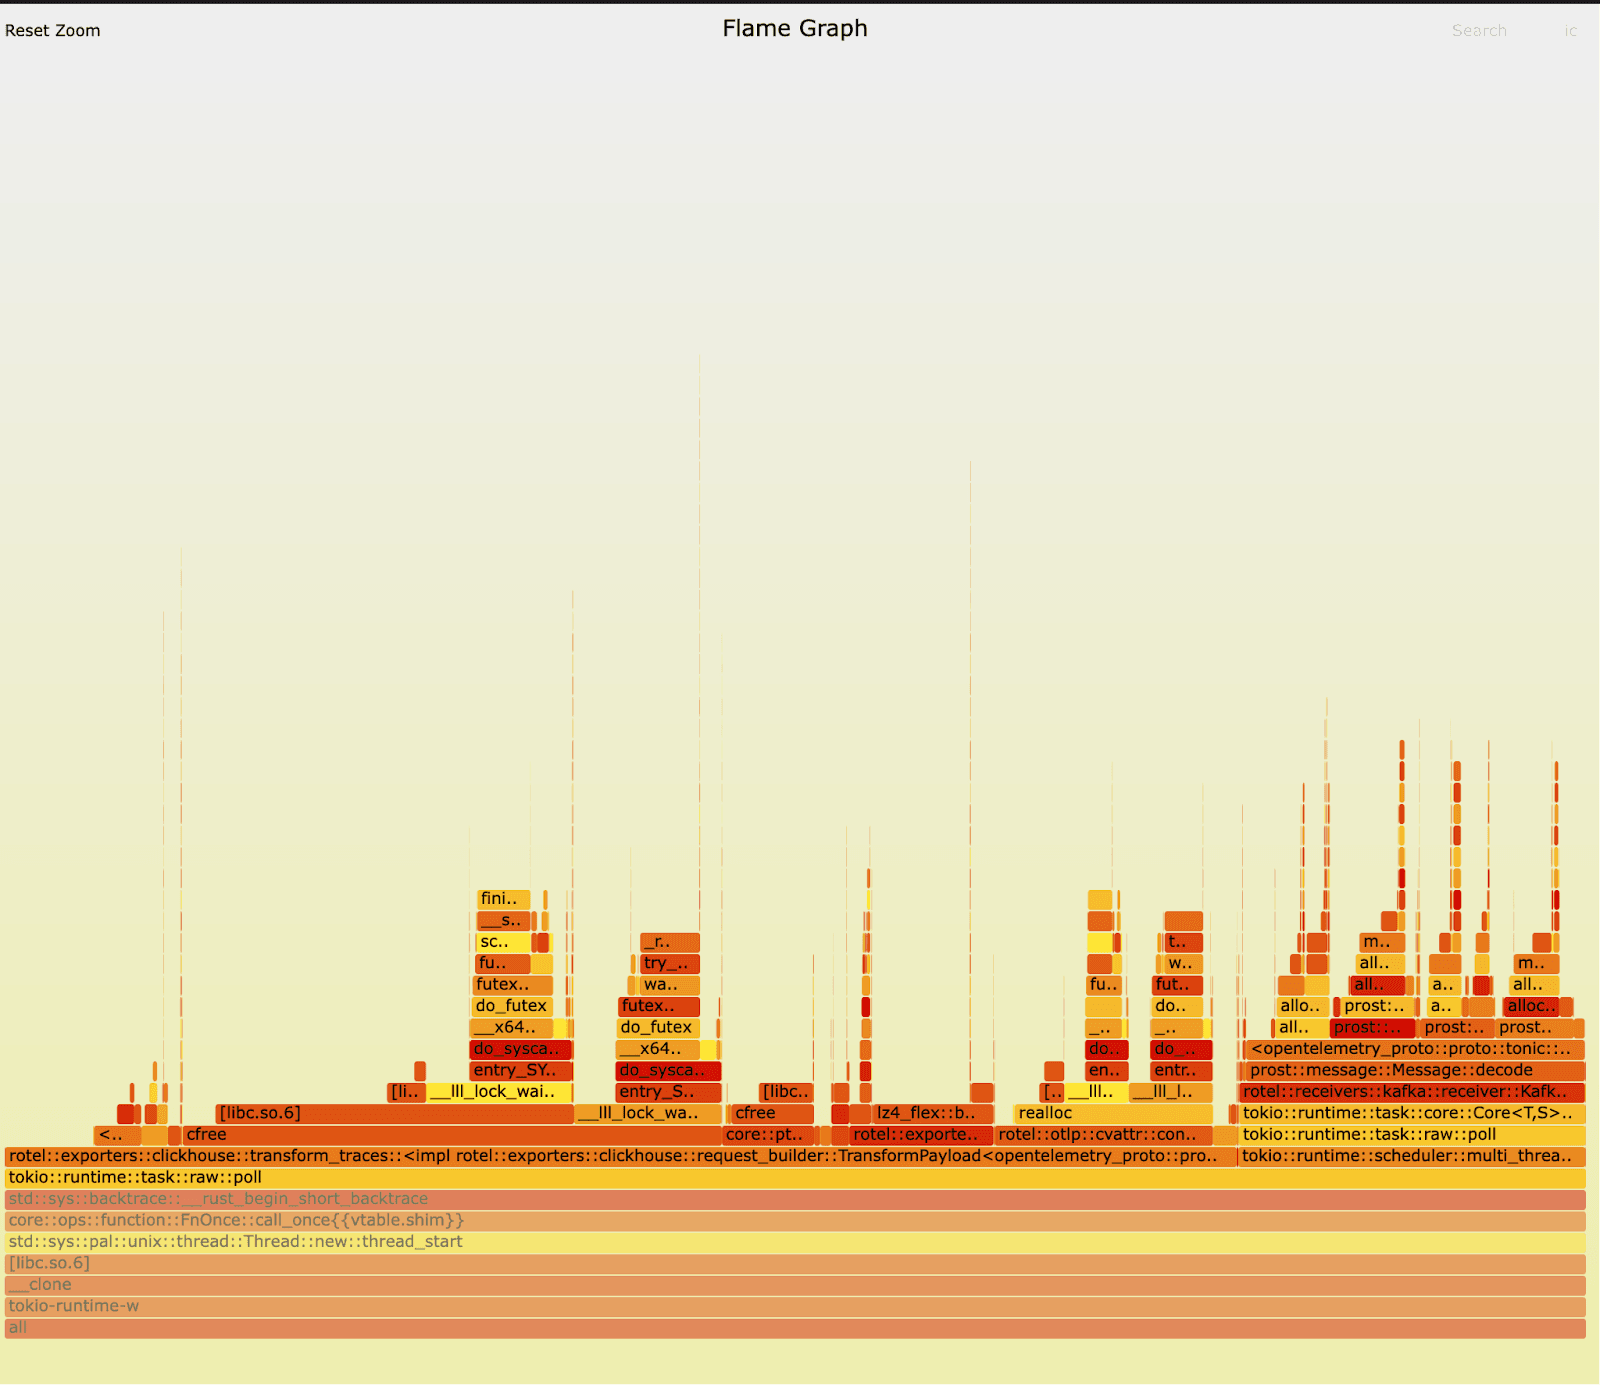
新バージョン:
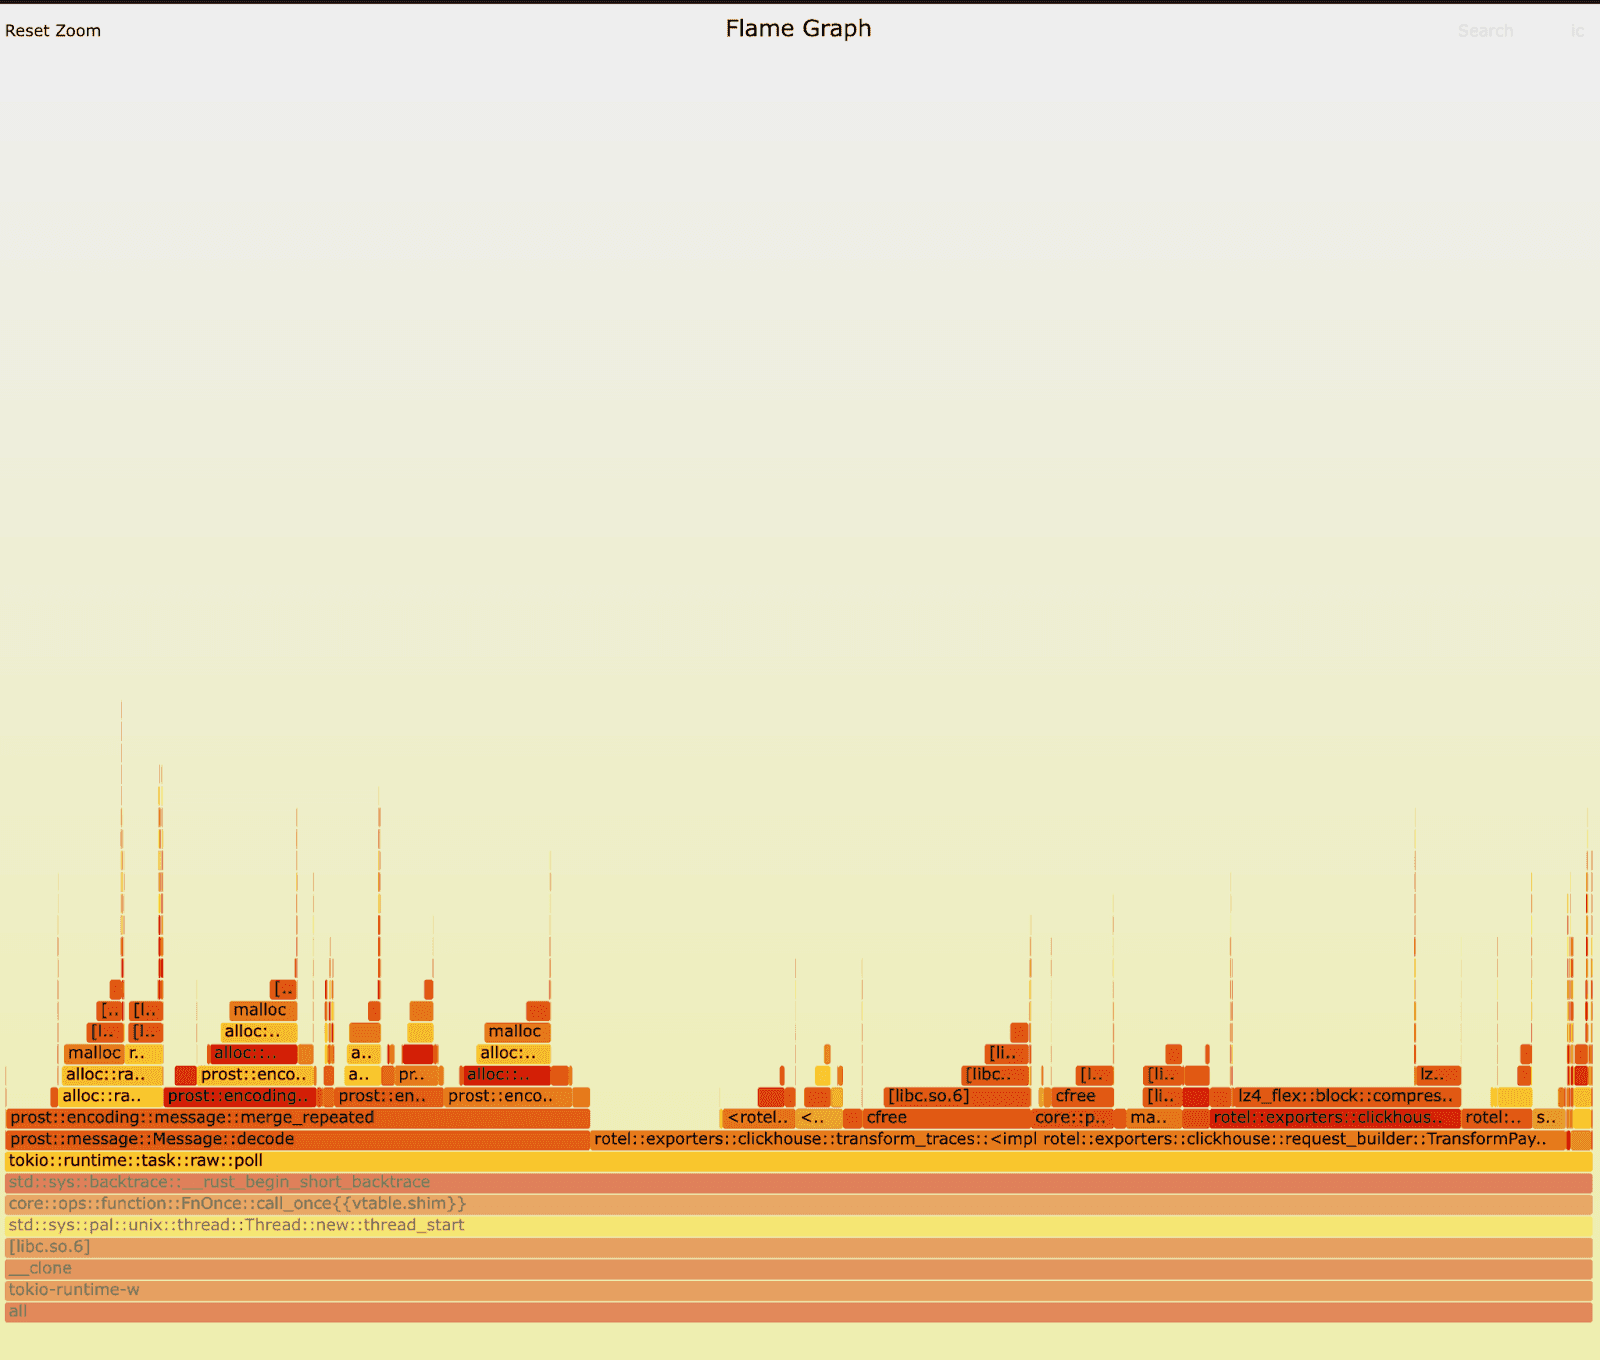
Linux Perf による Kafka レシーバーの変更点のプロファイリング
Linux perf stat を実行したところ、ビルド間で顕著な違いがいくつか確認できました。
perf stat -c cycles,instructions,cache-misses,cache-references,context-switches,cpu-migrations以前の構成:
295612663445 cycles
264853636815 instructions # 0.90 insn per cycle
615670230 cache-misses # 32.963 % of all cache refs
1867733351 cache-references
1224819 context-switches
1230 cpu-migrations
50.296446757 seconds time elapsed新規:
150590256805 cycles
287007890213 instructions # 1.91 insn per cycle
598469068 cache-misses # 51.429 % of all cache refs
1163669589 cache-references
37675 context-switches
43 cpu-migrations
43.716966122 seconds time elapsed新しいビルドは平均 1.9 IPC (instructions per cycle) を記録し、コンテキストスイッチは毎秒わずか 862 回でした。命令レベルの並列性 (ILP) としては驚くほどではないものの、悪くありません。以前のバージョンは平均 0.9 IPC、コンテキストスイッチは毎秒 24,350 回という驚異的な数値であり、新しいビルドではコンテキストスイッチが 32.5 分の 1 に減少しました。 以前は事実上 ILP が得られず、スレッドの退避 (park) と再開 (unpark) を絶えず繰り返していたことになります。さらに、新しいバージョンでは CPU 移行が平均 1 回/秒と優れたキャッシュ親和性を示したのに対し、以前のバージョンは平均 24.5 回/秒でした。新しいビルドで 24.5 分の 1 に減少したことは、以前のビルドではスケジューラがスレッドを同じコアに保持できなかったことを示しています。
新しいバージョンでは並列化の特性が大幅に改善され、スループットを以前よりもさらに引き上げることが可能になりました。しかし、実際に行ったことは一部の処理を別のスレッドへ移動しただけです。
以前のバージョンの性能低下は、おそらく Tokio エグゼキュータのスレッドをブロックしたことでポーリング、スピン、ワークスティーリングの試行に伴うオーバーヘッドが生じたためだと推測できます。しかし、perf report の結果を詳しく調べたところ、実際にはさらに複雑な原因があることが判明しました。
Linux Perf Report によるプロファイルの掘り下げ
perf record でテストを再度実行したところ、新旧のビルドについてより詳細な状況が把握できました。新しいバージョンは非常に健全に見えます。処理時間の大半は、エクスポート用のデータ圧縮、OTLP から ClickHouse 用の行データへの変換、およびメモリの割り当てと解放に費やされています。
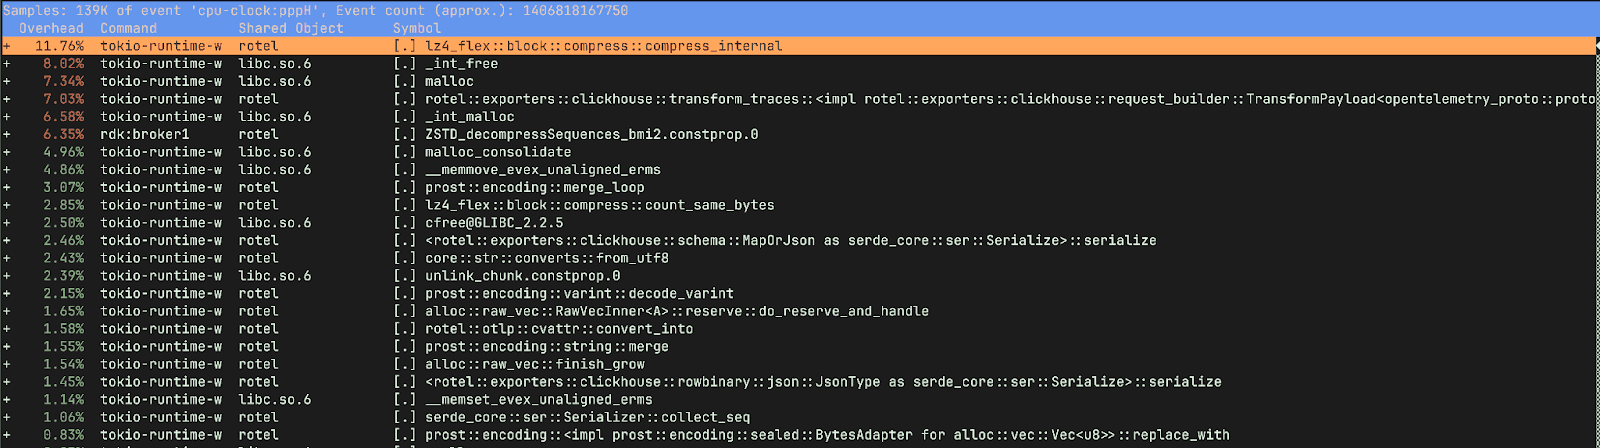
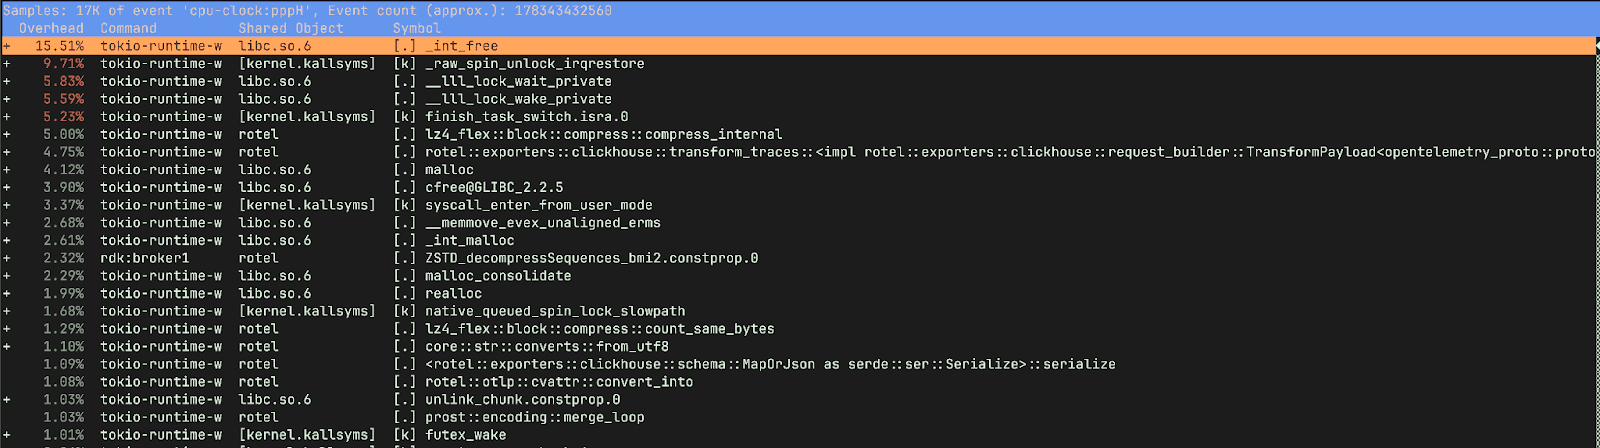
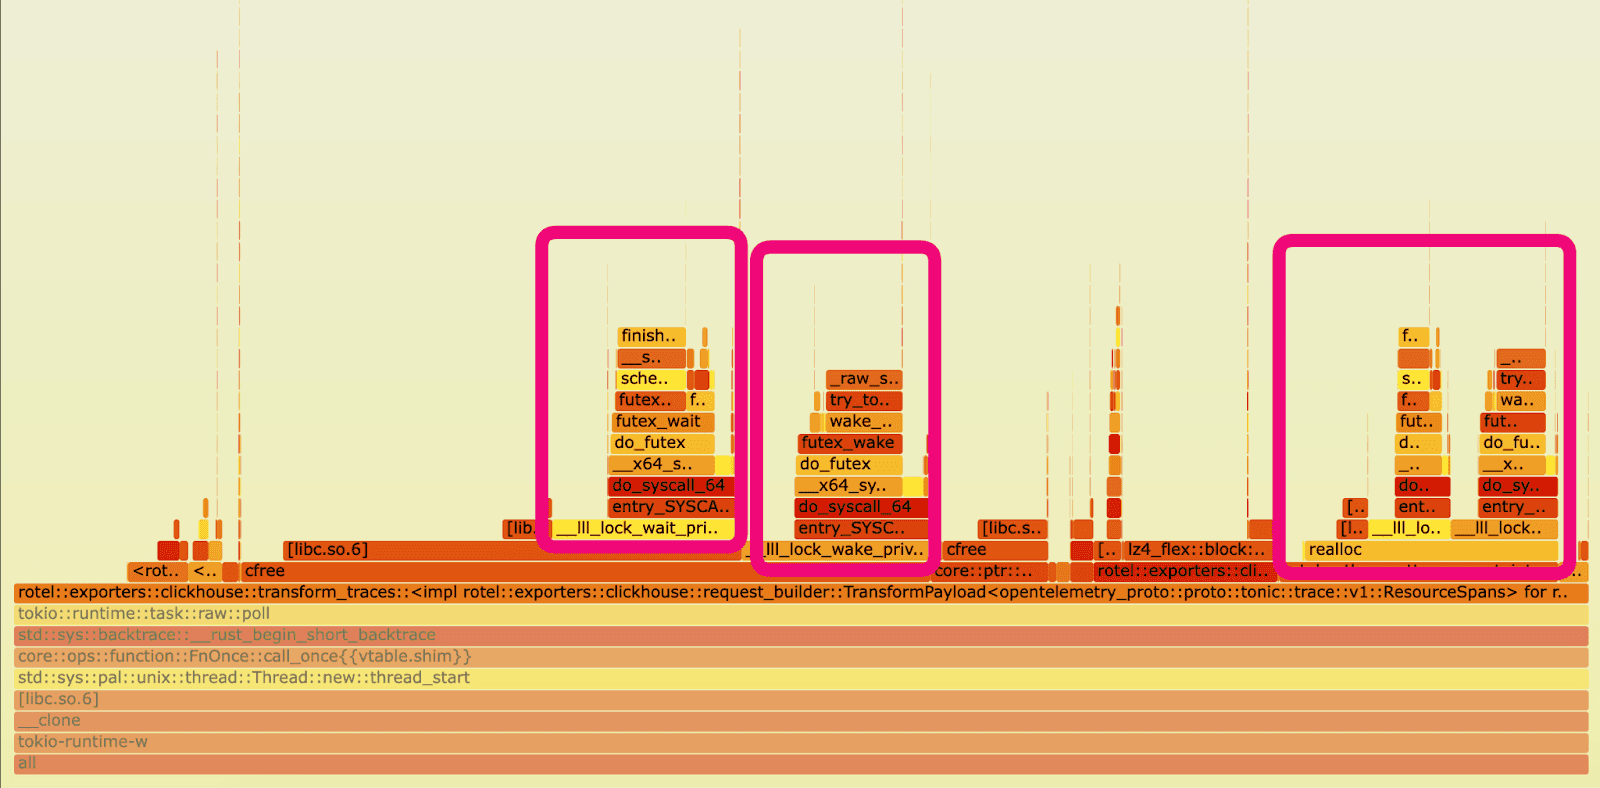
しかし、以前のバージョンの状況はまったく異なっていました。新しいバージョンではデータ圧縮と ClickHouse 用のデータ準備に約 20% を費やしていたのに対し、以前のバージョンではメモリ解放に 15% を費やし、圧縮と準備にはわずか 9.75% しか使われていませんでした。また、_raw_spin_unlock_irqrestore、finish_task_switch.isra.0、__lll_lock_wait_private、__lll_lock_wake_private にも多くの時間が費やされていました。
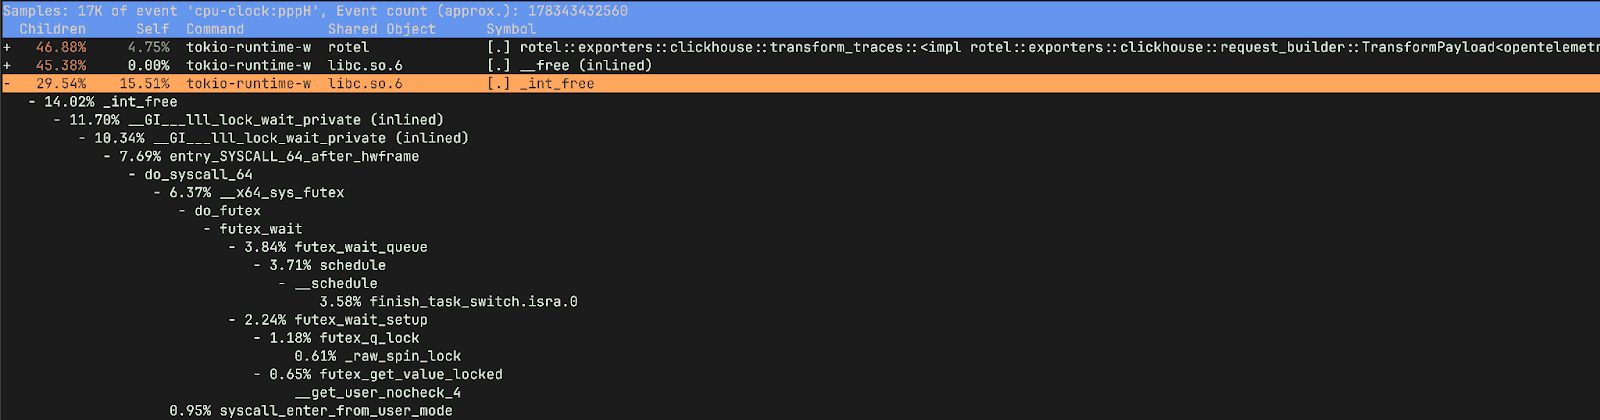
レポートを子関数を含めて表示すると、メモリを解放しようとした際にロックの待機時間が発生していたことが分かります。
では、これらの関数は何をしているのでしょうか?
_raw_spin_unlock_irqrestore は、割り込みを再度有効にしてスピンロックを解放し、対応する _raw_spin_lock_irqsave の呼び出し前の状態に割り込みコンテキストを復元する Linux カーネル関数です。さらに重要な点として、_raw_spin_unlock_irqrestore はタスクがプリエンプトされようとしているときに呼び出され、スケジューラがコンテキストスイッチを実行できるようにします。一方、finish_task_switch.isra.0 は finish_task_switch のコンパイラ最適化版であり、クリーンアップやコンテキストスイッチ後の処理を実行します。これらの関数は、以前のバージョンで観察されたコンテキストスイッチの大幅な増加に対応しています。
__lll_lock_wait_private と __lll_lock_wake_private は glibc 内部の低レベル関数であり、ミューテックスなどの同期プリミティブの実装に関連しています。ここで興味深いのは、メモリを解放しようとするときにロックが発生している点です。
振り返ってみると、以前のバージョンのフレームグラフを見れば問題は明白でした。理想的には、differential flame graphs のようなツールを使用して 2 つのフレームグラフを並べて比較し、違いを特定しやすくすべきでした (使いやすいフレームグラフのツールがもっとあれば良いのですが)。幸いにも、perf stat と perf record によって根本原因をすぐに突き止めることができました。競合は Kafka レシーバーではなく、ClickHouse エクスポーターのマーシャリング関数 (TransformPayload) で発生していたのです。
Glibc のマルチスレッドメモリ割り当て
これで、今回の変更によってスループットが向上しながら CPU 使用率が低下した理由が明らかになりました。以前のバージョンも多くの処理を行っていましたが、本来行うべき処理ではなかったのです。要するに、以前のバージョンはメモリを解放しようとしてスピンロックにかかっていました。
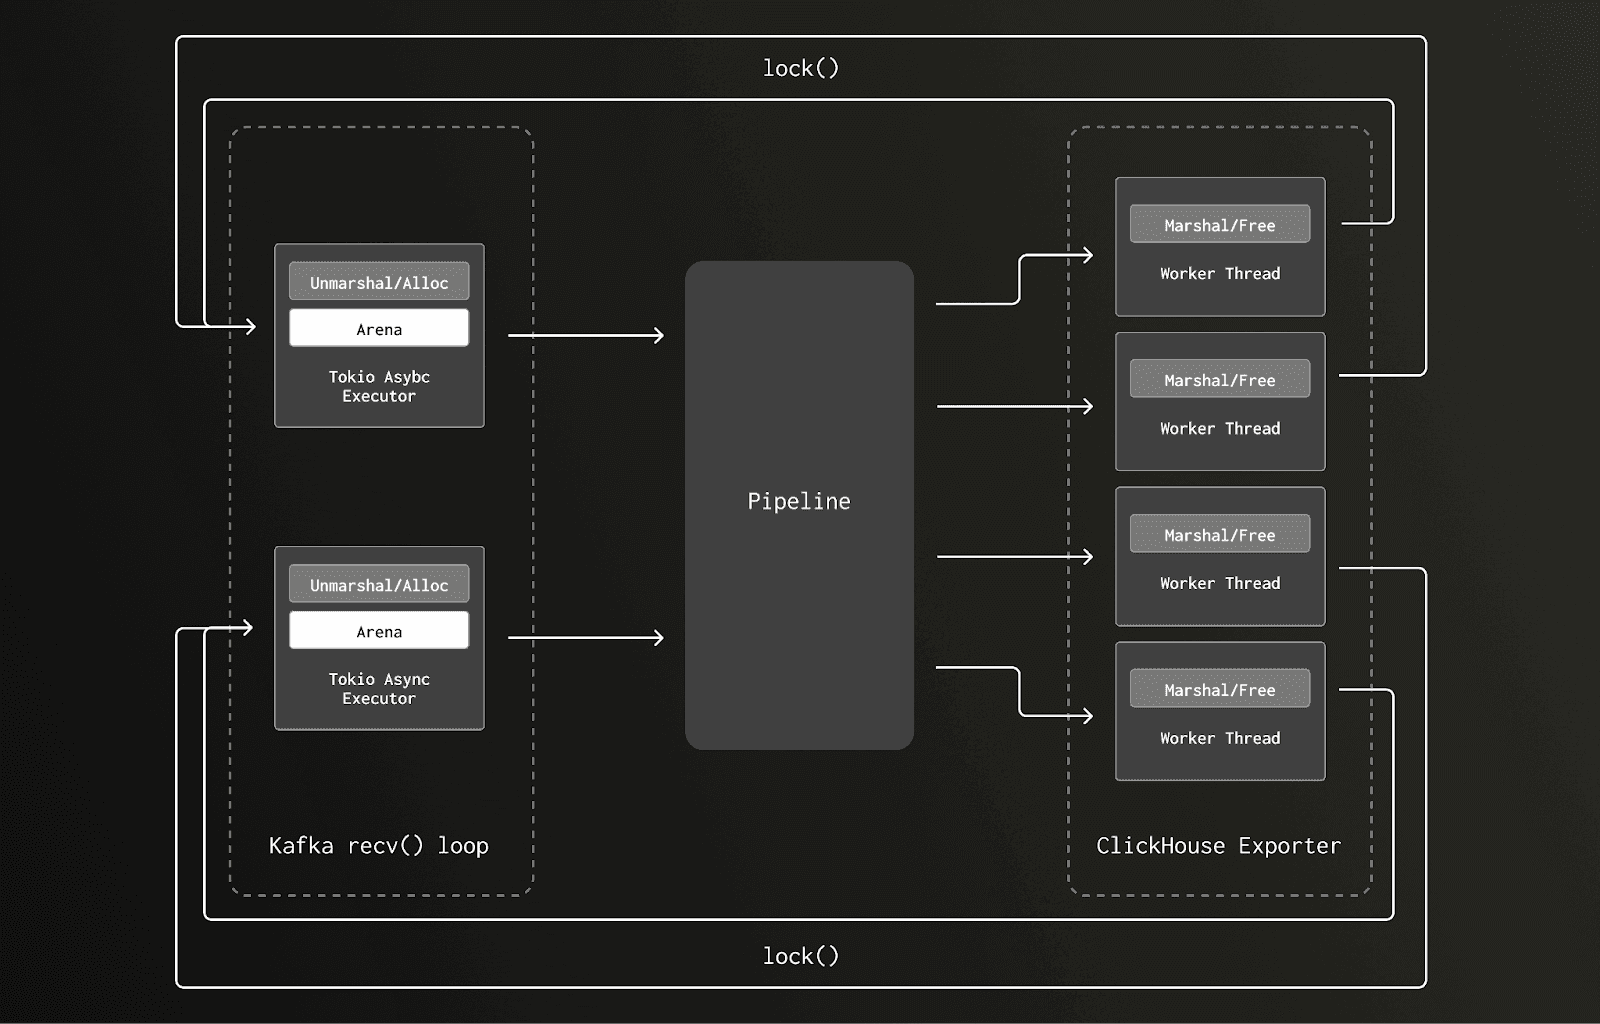
何が起きていたのかを理解するには、glibc アロケータの動作を簡単に把握する必要があります。メモリは「アリーナ (arena)」と呼ばれる領域に分割され、各アリーナには割り当てと解放の両方を保護するミューテックスロックがあります。スレッドはロック競合を回避するために可能な限り別々のアリーナを作成しようとし、スレッドプールが拡大するにつれて割り当てられるアリーナの数も増加します。しかし、メモリの割り当てを実行したスレッドとは異なるスレッドで解放が行われると、解放を行うスレッドはそのアリーナを所有する側のロックを取得しなければならず、他のスレッドが待機することになり競合が発生します。
以前のバージョンでは、Kafka レシーバーのアンマーシャリングルーチンにおいて、Tokio エグゼキュータの I/O タスク上でトレースデータ処理用のメモリを割り当てていました。この処理は限られた数の Tokio 非同期エグゼキュータスレッド (ゲートウェイコレクターノード上ではコアあたり 1 つ、計 8 スレッドのみ) にスケジューリングされていました。その後パイプラインの後半で、ClickHouse エクスポーターのリクエストマーシャリングの一環としてそのメモリが解放されていましたが、これは数十から数百スレッドというはるかに大きなスレッドプール上のブロッキングタスクとして実行されていました。
以下は、2 つの Tokio 非同期エグゼキュータスレッドのみを備えた 2 コアマシンで実行した場合の、データフローとロッキングパターンの図です。
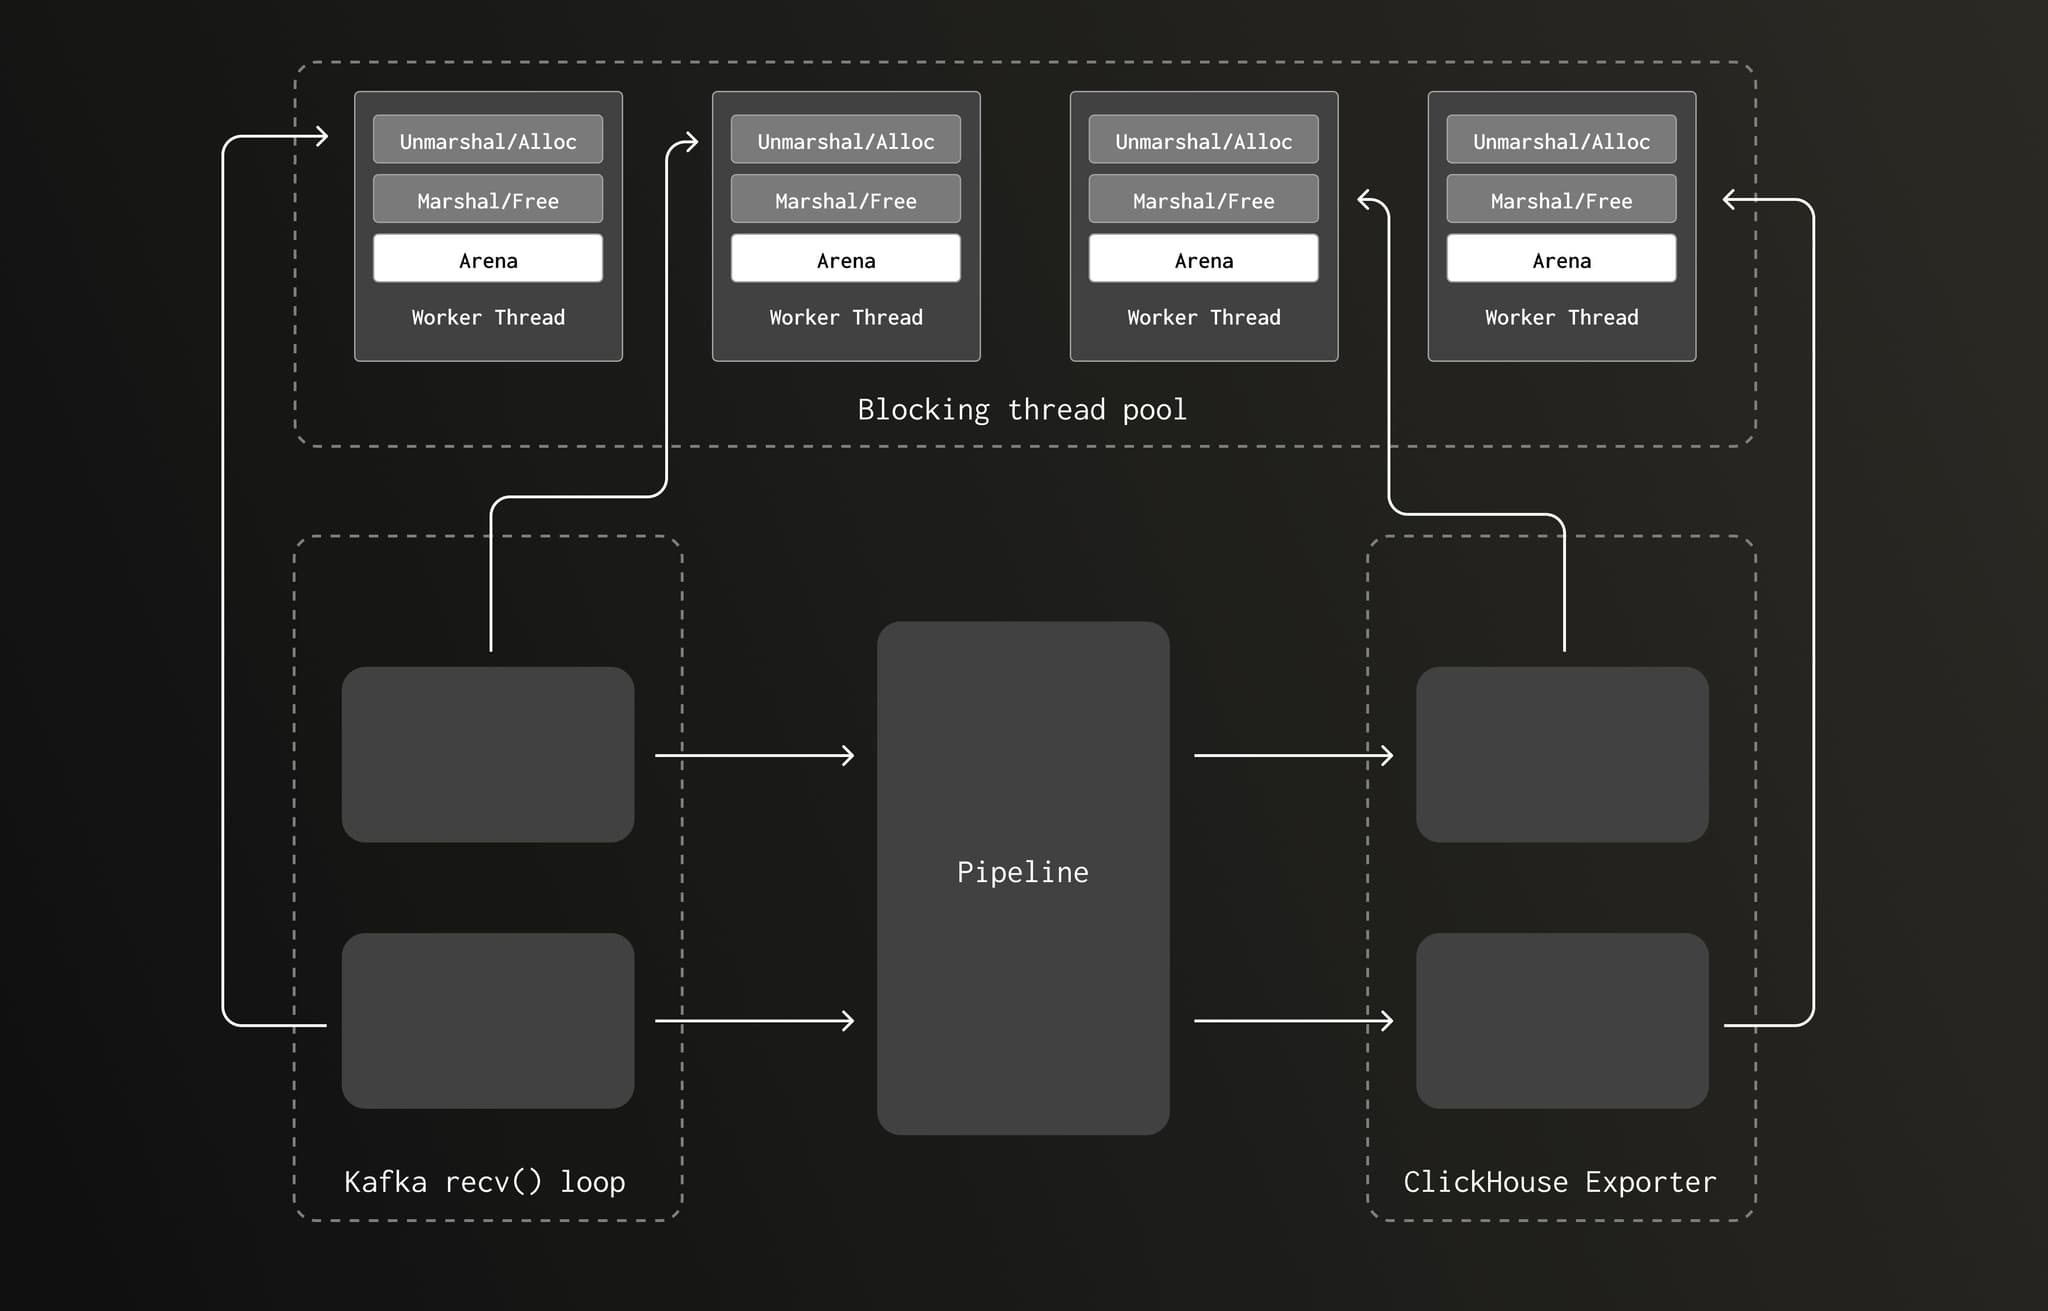
新しいバージョンでは、CPU バウンドな Kafka レシーバーのアンマーシャリングルーチン中に行われるメモリ割り当てが、メモリ解放が行われていたのと同じ、はるかに大きなスレッドプール上で実行されます。パイプラインのデータ量が増加してアンマーシャリング/マーシャリングの量が増えると、ブロッキングスレッドプールが拡張されます。これによりアリーナの数が増加し、ロック競合の発生確率が低下します。
パイプラインは現在、以下のようになっています。
jemalloc によるアリーナロック競合の確認
本記事の初期ドラフトをレビューしてくれた方から、「この現象は jemalloc でも再現するのか気になります」という有益な質問が寄せられました。jemalloc は、マルチプロセッサシステム上のスレッド化されたプログラムにおけるロック競合を軽減するように特別に設計された、汎用の malloc 実装です。以前 Rotel を jemalloc でテストした際には、大きなパフォーマンス向上は見られませんでした。しかし、ClickHouse エクスポーターのワークロードと最近追加された Kafka レシーバーが組み合わさることで、明らかにメモリ割り当てに負荷がかかっていたため、新旧両方のバージョンを jemalloc でテストしてみることにしました。
旧タスクスケジューリングモデルを採用した以前のバージョンを jemalloc を使用するように変更したところ、CPU 使用率が 93% から 40% へと低下しました。この低下幅は、アンマーシャリングを共有スレッドプールに移行した際に見られた結果と一致しており、私たちの分析結果を裏付けるものとなりました。
jemalloc によって以前のバージョンの CPU 使用率は低下したものの、最大スループット時において Kafka の遅延 (ラグ) が増大しました。さらに、jemalloc がもはやアクティブに保守されていないという事実も踏まえ、これをデフォルトのアロケータとして採用する予定はありません。必要に応じてユーザーが jemalloc や mimalloc などのカスタムアロケータを選択できるよう、機能フラグを追加する可能性があります。
高速な LZ4 圧縮によるさらなる向上
Rotel は、ネットワーク経由のデータ転送量を削減するために、ClickHouse ペイロードに推奨されている LZ4 圧縮設定を使用しています。clickhouse-rs が使用しているのと同じ lz4_flex クレートを活用していますが、私たちはこれを直接インポートしていました。lz4-flex クレートに依存する圧縮サポートを導入した際、Cargo.toml のインポート時の機能設定を見落としていました。
lz4-flex クレートには unsafe 実装と safe 実装の両方が用意されており、unsafe 版を使用するとパフォーマンスがわずかに向上します (Rust の unsafe についてはこちらを参照してください)。lz4-flex では、より高速なライブラリの unsafe バリアントを明示的に有効化 (opt-in) する必要があります。
clickhouse-rs クレートは lz4-flex の unsafe バリアントを有効にしていますが、私たちはそれを見落としていました。これを有効にしたことでスループットがわずかに向上し、ゲートウェイコレクターのスループットは 毎秒 360 万から 370 万トレーススパン、および 209 MB/秒 に達しました。
| Rotel | トレーススパン | トレーススパン / コア | ClickHouse ネットワーク受信 (圧縮時) |
|---|---|---|---|
| 単一の Rotel プロセス | 毎秒 3.7 M | 毎秒 462.5 K | 209 MB/秒 |
ゲートウェイコレクターの CPU 使用率もわずかに低下しました。
| Rotel | ClickHouse | |
|---|---|---|
| CPU | 90.8% | 57.8% |

完全なエンドツーエンドの評価
Rotel の複数の最適化に取り組み、ClickHouse の Null テーブルエンジンに対して評価を行った結果、Rotel の単一インスタンスのスループットを当初の毎秒 110 万トレーススパンから、合計で毎秒 370 万トレーススパン、すなわちコアあたり毎秒 462.5 K トレーススパンまでスケールさせることができました。これは、OTel コレクターのテスト時に確認された元のスループット (毎秒 1.1 M) の約 4 倍近くに達します。
次に、データを ClickHouse に恒久的に取り込み、ディスクへ完全にコミットするという最後のステップに着手しました。ClickHouse のスケーリングでは、受信する書き込みと読み取りクエリの両方に対してスキーマを最適化することが重要になる場合がよくあります。今回のケースではデフォルトの OTel スキーマを使用しているため、達成した書き込み負荷を維持できるマシンの選定に主眼を置きました。
今回のテストにおける膨大な書き込み負荷に対応するため、ClickHouse インスタンスをアップグレードしました。最終的に以下の AWS インスタンスを採用することに決定しました。ディスク使用率の上限に達する可能性をさらに排除するため、4 つのインスタンスストアディスクにわたって RAID0 マウントを構築しました。
| i4i.16xlarge | 64 コア | 512 MB | 4 x 3,750 AWS Nitro SSD |
|---|
ClickHouse への完全なディスク書き込みをテストする際、書き込みパフォーマンスを向上させるために Rotel の非同期挿入の利用を無効にし、バッチサイズを大幅に増やしました。Rotel の設定を --clickhouse-exporter-async-inserts=false および --batch-max-size=102400 に更新したことで、ゲートウェイコレクターの以前のスループット上限である毎秒 370 万トレーススパンを達成できました。
ClickHouse の CPU 使用率は約 50% で、最大 210 MB/秒の圧縮トラフィックを処理しました。
| Rotel | ClickHouse | |
|---|---|---|
| CPU | 86.2% | 52% |

目視による確認
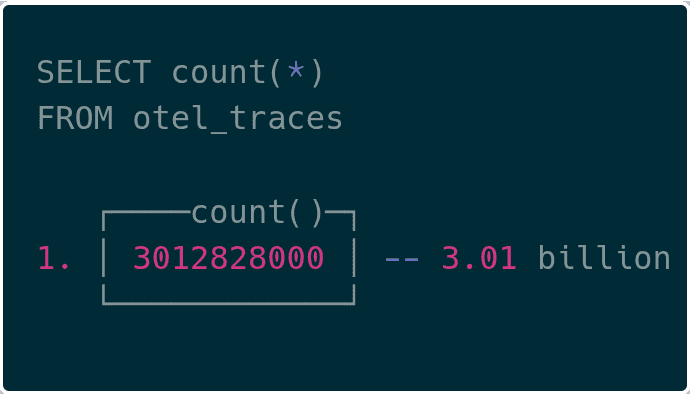
ClickHouse 内で 30 億を超えるトレーススパンを確認できるようになりました。
まとめ
極限の大規模環境における効率性
ClickHouse が社内プラットフォーム LogHouse を運用しているペタバイト規模では、効率性は現実的な必須要件となります。同社はパイプラインのスループットを 20 倍に向上させながら、必要なキャパシティフットプリントを以前のわずか 10% に抑えました。従来のペースのまま運用を続けていれば、法外なコストがかかっていたはずです。Netflix や OpenAI などの他の組織も同様の結論に達しています。すなわち、このレベルのデータ量に達すると、効率性はビジネスにとって極めて重要になるということです。これこそが、私たちが OpenTelemetry の収集効率の向上を目指し、Rotel を開発した背景です。
4 倍近くの効率改善
今回の取り組みを通じて、Rotel は OpenTelemetry のトレースデータを ClickHouse へストリーミングするための高スループットパイプラインへと最適化されました。テストにおいて、Rotel は同一ハードウェア上で OpenTelemetry Collector のほぼ 4 倍のスループットを達成しました。これは、大規模環境において大幅なリソース節約につながります。Rotel は OpenTelemetry のトレース、メトリクス、ログをネイティブにサポートしており、今回の投稿ではトレースに焦点を当てましたが、今後のベンチマークの一環としてログやメトリクスのワークロードも評価する予定です。
また、私たちはこの規模のデータ量を扱う際にどの機能が最も重要になるかについての知見も深めたいと考えています。アイデアがある方や、ご自身のスケーリングにおける課題を共有したい方は、Discord のコミュニティに参加するか、GitHub でコントリビュートしてください。
今後の課題
今回の取り組みを経て、今後さらに探求したいテーマをいくつか紹介します。
Kafka の信頼性に関する深掘り
本記事では簡潔に触れただけですが、Rotel はエンドツーエンドのメッセージ確認応答 (acknowledgement) による信頼性の高い配信保証をサポートしており、データ損失につながりやすい自動コミットに依存するのではなく、Kafka からデータをストリーミングする際の At-least-once (少なくとも 1 回) の配信を保証します。このサポートを実現するには、パイプラインに対する多くの変更と、重複配信を減らしつつ Rotel がデータをドロップしないことを保証するための厳密なテストが必要でした。信頼性の高い配信とは何を意味するのか、それをどのように構築したのか、そしてテストのために構築した検証ツールについて深く掘り下げたいと考えています。これに関する続報をお待ちください。
ClickHouse ネイティブプロトコルの探求
Rotel の ClickHouse 連携は clickhouse-rs Rust クレート上に構築されており、HTTP 経由の RowBinary プロトコルを使用しています。OpenTelemetry Collector は Go の ClickHouse ドライバを使用しており、ネイティブの ClickHouse プロトコルを使用して通信します。ネイティブプロトコルは ClickHouse 間の内部転送に使用されるものと同じであり、ベンチマークでは RowBinary より 20% 以上高速であることが示されています。また、ClickHouse は Apache Arrow Flight のサポートも追加しており、効率的な転送のために Arrow のインメモリフォーマットを使用しています。行指向の RowBinary フォーマットから列指向フォーマットのいずれかへの移行を評価する予定です。これにより Rotel のスループットがさらに向上する可能性があります。テスト結果は今後のアップデートで共有する予定です。
Tokio におけるブロッキングタスクのさらなる調査
ペイロードのデシリアライズなどのブロッキングタスクは、Tokio のパフォーマンスに大きな影響を与える可能性があります。今回のベンチマークに取り組むまで、それがどれほどの影響を与えるかを把握できていなかったため、他に潜在的な影響がないかを調査したいと考えています。Rotel の OTLP レシーバーが、接続の非同期タスク処理中に高負荷な Protobuf のデシリアライズをインラインで実行していることはすでに判明しています。これは tonic クレートに組み込まれているため、これをどのように切り離すのが最善かを検討したいと考えています。perf ツールによる初期分析から、ここには大きな改善の余地があると考えています。
メモリ割り当てによる影響の軽減
Rust にはガベージコレクターがありませんが、データ量が多い場合、メモリの割り当てと解放は依然としてパフォーマンスに大きな影響を与えます。Rotel では、パイプラインを通過する短命なオブジェクトのために、メモリの割り当てが頻繁に繰り返されています。一般的に再利用されるバッファに対してアロケータをバイパスできるメモリフリーリスト方式を採用すれば、パフォーマンスオーバーヘッドを大幅に削減できるはずです。もちろん、その実装は複雑になる可能性があり、注意しないとメモリ使用量が急増するリスクがあります。これも、必要な変更を加えるために tonic クレートの内部を詳しく調べる必要があるかもしれない領域の 1 つです。
本記事の初期ドラフトをレビューしてくださった Sujay Jayakar 氏、Ben Sigelman 氏、Rick Branson 氏、Vlad Seliverstov 氏、Rory Crispin 氏、Achille Roussel 氏に感謝いたします。
補足
検討したプロジェクト
これらのベンチマークを作成するにあたり、OpenTelemetry をサポートする他のデータプレーンも含めたいと考えていましたが、本ベンチマークとは互換性がないことがわかりました。今回の評価で分散トレースを選択したのは、それが OTel 導入の強力な推進力であり、大規模環境ではデータ量が急速に増大する可能性があるためです。しかし、ロギングとメトリクスはより古典的な監視テレメトリであるため、多くのツールでは依然としてトレースのサポートが限られています。今回の投稿にそれらを含める余裕はありませんでしたが、今後はロギングやメトリクスのベンチマークも調査していきたいと考えています。
Vector
Vector は、高性能なテレメトリパイプラインを構築するために作られた軽量ツールです。多数のソースと宛先シンクを幅広くサポートしており、多くのサービスやプロジェクトと統合できます。開発は現在 DataDog が主導しており、Vector は同社のオブザーバビリティパイプライン製品の提供を支えています。
Vector での OpenTelemetry のサポートは比較的新しく、多くの宛先と互換性がありません。Vector のデータモデルはもともとトレースをネイティブにサポートしていなかったため、特に OTel トレースのサポートは限定的です。これらを考慮すると、Kafka シンクと ClickHouse シンクの双方でトレースがサポートされていなかったため、Vector を評価できませんでした。
Fluent Bit
Fluent Bit は、性能を重視して C 言語で書かれた Fluentd の代替ツールです。Fluent Bit は OpenTelemetry データの入力と出力を備えており、ログ、メトリクス、トレースをサポートしています。Fluent Bit は Kafka へのデータの出力および入力が可能で、信頼性の高いストリーミングパイプラインを構築できます。ただし評価を進める中で、OpenTelemetry 入力を Kafka 出力に接続する場合、ならびに ClickHouse に使用される HTTP 出力を経由する場合、メトリクスとトレースがまだサポートされていないことが判明しました。
簡単な OTel ClickHouse 移行
ClickHouse のドキュメントでは、エクスポーターでのスキーマ自動作成を無効にし、事前にスキーマを用意しておくことが推奨されています。これらのスキーマ移行は OTel エクスポーターに同梱されているため、どのようにデプロイするのが最適なのかが明確ではありません。
Rotel では、これらの移行を容易にデプロイできるよう、DDL 管理を別の CLI ユーティリティに切り離すことにしました。clickhouse-ddl ツールは、Rotel および OTel コレクターと互換性のあるスキーマを作成します。
これを Docker コンテナとして提供しているため、OpenTelemetry データを取り込むために必要なテーブルを簡単に作成できます。以下は、トレーススパンを保存するために必要なテーブルを作成する例です。
docker run streamfold/rotel-clickhouse-ddl create \
--endpoint https://abcd1234.us-east-1.aws.clickhouse.cloud:8443 \
--traces --enable-json本記事のベンチマークで行ったように、Null テーブルエンジンを使用して移行を作成することもできます:
docker run streamfold/rotel-clickhouse-ddl create \
--endpoint https://abcd1234.us-east-1.aws.clickhouse.cloud:8443 \
--traces --enable-json \
--engine Null参考資料
- ベンチマークフレームワーク: https://github.com/streamfold/rotel-clickhouse-benchmark
- Rotel: https://rotel.dev
- OTel loadgen: https://github.com/streamfold/otel-loadgen