5万

概要
本記事では、Drain3 と ClickHouse の UDF を活用したログクラスタリングによって、未加工のアプリケーションログを自動的に構造化する方法を紹介します。ログテンプレートを特定し、主要フィールドをカラムとして抽出することで、クエリ実行や完全なログ復元を可能にしたまま、約 50 倍の圧縮率を達成しました。
最近のブログ投稿では、Nginx のアクセスログのサンプルデータセットに対して 170 倍以上のログ圧縮を達成しました。これは、生ログを構造化データに変換し、列指向データベースへ効率的に保存できるようにしたことで実現しています。最大限の圧縮率を得るため、各カラムを最適化してソートしました。
Nginx ログの形式は明確に定義されているため、この作業は比較的簡単でした。各行が一貫したパターンに従っているため、主要なフィールドを抽出して構造化フォーマットへマッピングするのが容易だったからです。
本記事では、圧縮率を高めるために ClickHouse でログクラスタリングを自動化するアプローチを検討します。技術的には実現可能ですが、本番環境で利用できる機能に仕上げるには別の課題があり、ClickStack チームは今後の製品開発に向けて検討を進めています。
構造化ログの先へ: アプリケーションログ
そこで生じる次の疑問は、「オブザーバビリティプラットフォームが取り込むあらゆる種類のアプリケーションログに、同じアプローチをどう適用できるか?」という点です。Nginx のようなサードパーティシステムは予測可能なログフォーマットを使用しますが、カスタムアプリケーションログが一貫していることはほとんどありません。形式は多種多様で、事前に定義された構造を持たないことも多々あります。
課題は、大量の非構造化ログからパターンを自動的に検出し、意味のある情報を抽出して、列指向フォーマットへ効率的に保存することです。興味深いことに、ログクラスタリングはそうしたパターンを大規模に特定するための強力な手法となります。
本記事では、ログクラスタリングを使用して非構造化ログを列指向ストレージに適した構造化データへと変換する方法と、そのプロセスを本番環境向けに自動化する方法を解説します。
ログクラスタリングとは?
ログクラスタリングとは、構造と内容に基づいて類似したログ行を自動的にグループ化する手法です。事前に定義されたパースルールに頼ることなく、大量の非構造化ログの中から繰り返し現れるパターンを見つけ出すことを目的としています。
具体的な例を見てみましょう。以下は、カスタムアプリケーションからのログの一部です:
AddItemAsync called with userId=ea894cf4-a9b8-11f0-956c-4a218c6deb45, productId=0PUK6V6EV0, quantity=4
GetCartAsync called with userId=7f3e16e6-a9f9-11f0-956c-4a218c6deb45
AddItemAsync called with userId=a79c1e20-a9a0-11f0-956c-4a218c6deb45, productId=LS4PSXUNUM, quantity=3
GetCartAsync called with userId=9a89945c-a9f9-11f0-8bd1-ee6fbde68079これらを見ると、それぞれ特定のパターンに従う、ログの 2 つの明確なカテゴリが存在することが分かります。
1 つ目のパターン: AddItemAsync called with userId={*}, productId={*}, quantity={*}
2 つ目のパターン: GetCartAsync called with userId={*}
各パターンが 1 つのクラスターを定義し、可変部分({*} の内側)は構造化ストレージ用の独立したカラムとして抽出可能な動的フィールドを表します。この手法は今回の実験に非常に有望に見えます。これを大規模に実装し、自動化する方法を見ていきましょう。
ログクラスタリングには、圧縮以外にもいくつかのメリットがあります。類似のイベントをグループ化することで、異常なパターンの早期検出に役立ち、トラブルシューティングを迅速化できます。ただし、本記事では反復的なログを効率的なストレージ用の構造化データへ変換することで、圧縮率を向上させる点に焦点を当てます。
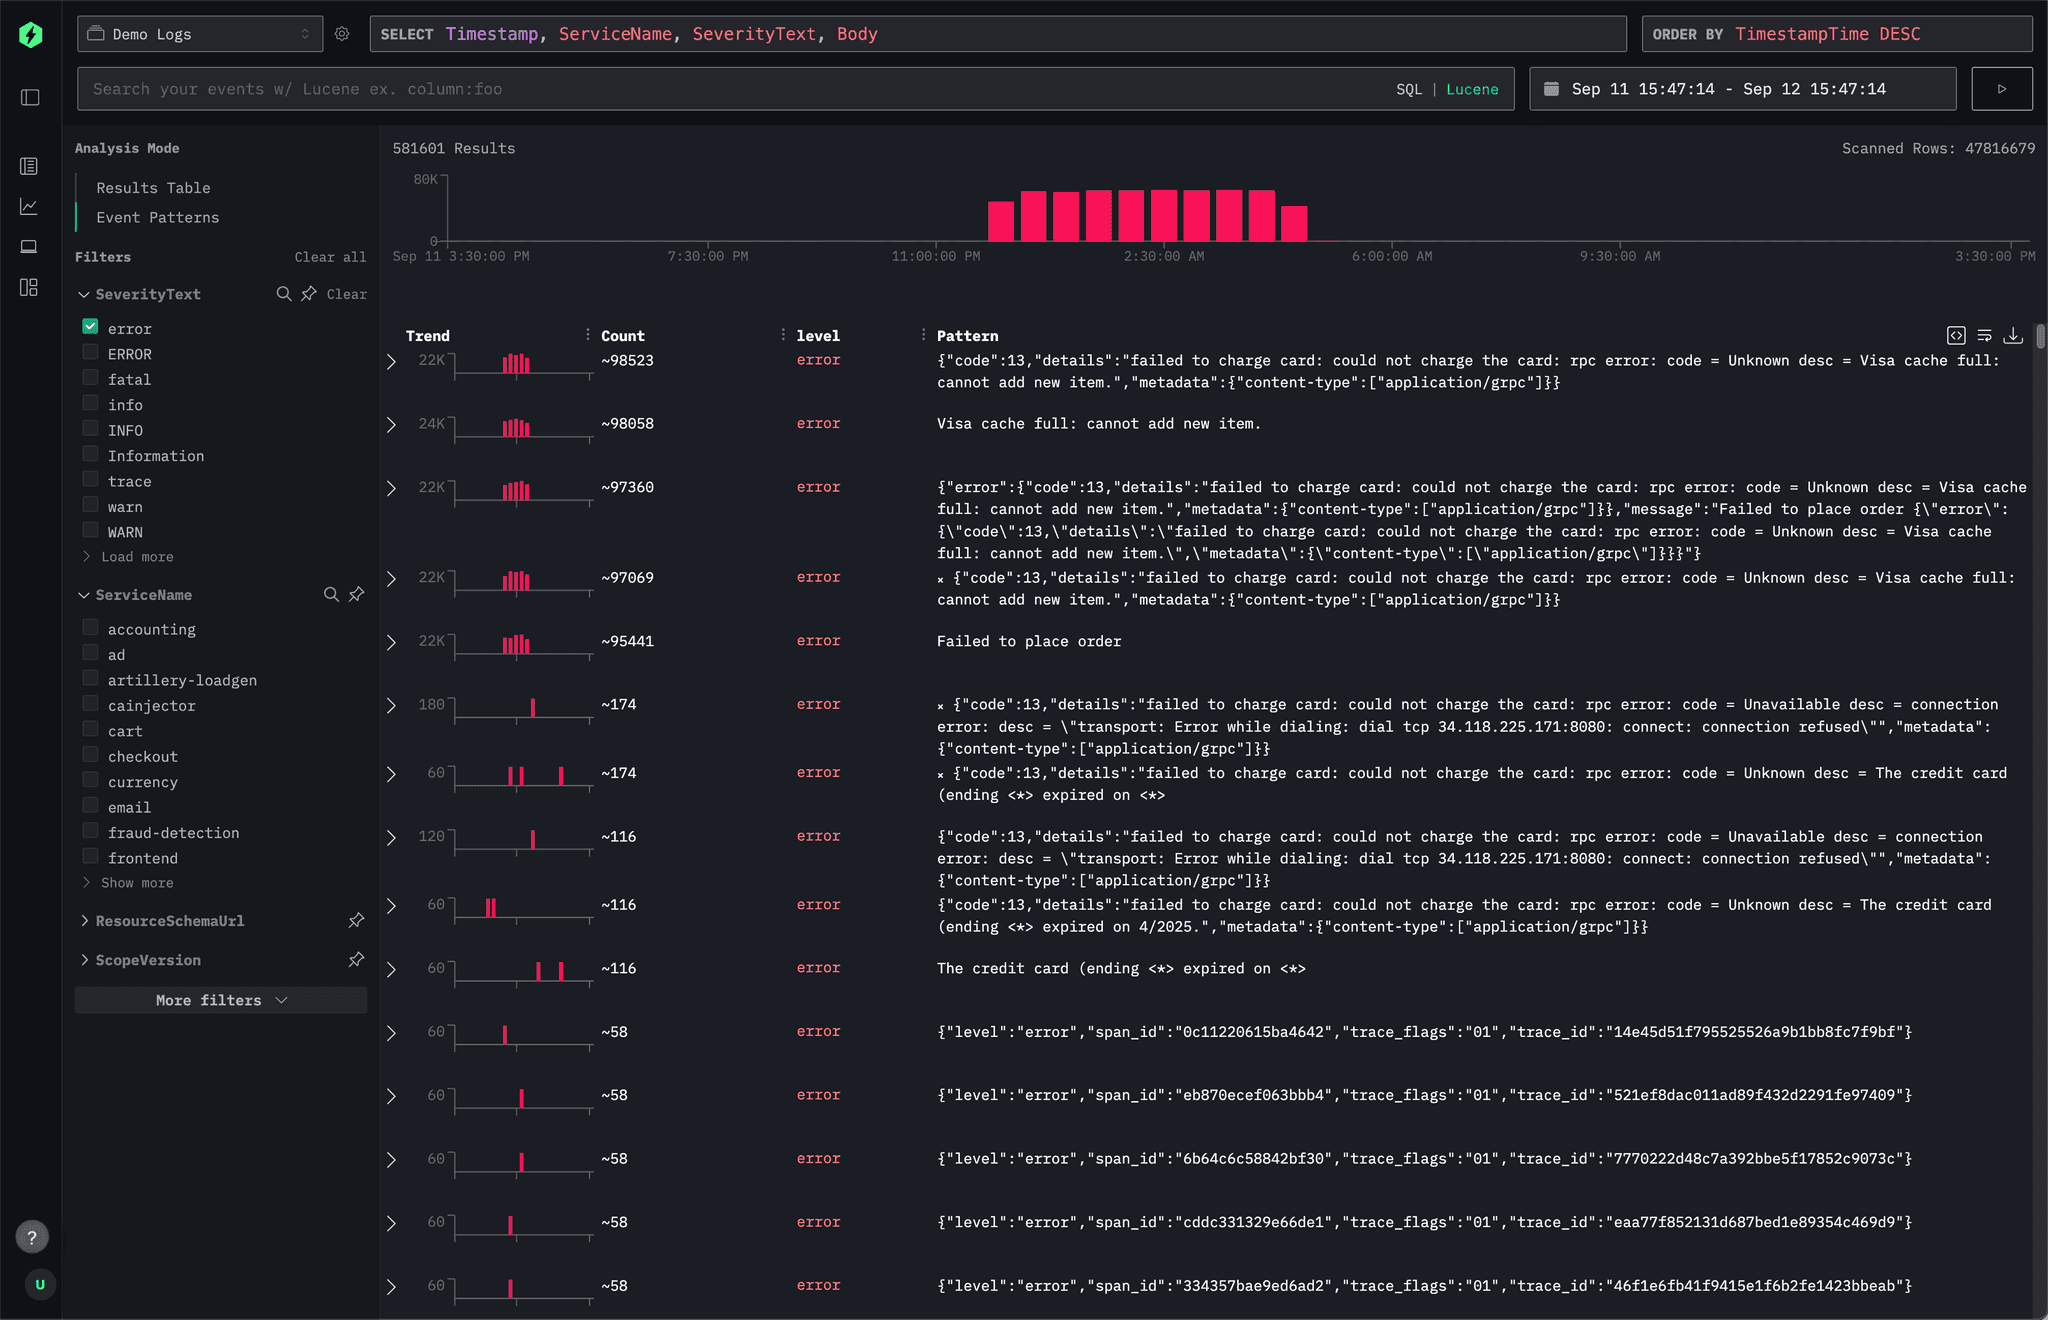
ClickStack はすでに、根本原因分析を支援するためにイベントパターン特定を採用しています。類似したログを自動的にグループ化し、それらのクラスターが時間の経過とともにどのように変化するかを追跡することで、再発する問題を特定しやすくなり、異常がいつどこで発生したかを把握しやすくなります。これによりログ分析を迅速化できます。
以下は、HyperDX におけるイベントパターン特定のスクリーンショットです。
Drain3 によるパターンのマイニング
ユースケースによっては、ログクラスタリングの実装に、意味論的・構文的な比較、感情分析、パターン抽出を実行する完全なログ取り込みパイプラインの構築が必要になる場合もあります。今回の場合、ストレージ用にログを効率的に構造化するためのパターンを特定することだけに関心があります。Python パッケージの Drain3 は、この作業にうってつけのツールです。Drain3 はストリーミングログテンプレートマイナーであり、ログメッセージのストリームからテンプレートを大規模に抽出できます。ClickStack でイベントパターン特定を実装するために使われているのも、このパッケージです。
Drain3 が一連のログからどれほど迅速にログテンプレートを抽出できるか、ローカルマシンでテストできます。
使用するログサンプルをダウンロードしましょう。これらのログ行は OpenTelemetry デモを使用して生成されたものです。
wget https://datasets-documentation.s3.eu-west-3.amazonaws.com/otel_demo/logs_recommendation.sample次に、標準入力からログをマイニングするために Drain3 を使用するシンプルな Python スクリプトを作成します。
#!/usr/bin/env python3
import sys
from collections import defaultdict
from drain3 import TemplateMiner
from drain3.template_miner_config import TemplateMinerConfig
def main():
lines = [ln.strip() for ln in sys.stdin if ln.strip()]
cfg = TemplateMinerConfig(); cfg.config_file = None
miner = TemplateMiner(None, cfg)
counts, templates, total = defaultdict(int), {}, 0
for raw in lines:
r = miner.add_log_message(raw)
cid = r["cluster_id"]; total += 1
counts[cid] += 1
templates[cid] = r["template_mined"]
items = [ (cnt, templates[cid]) for cid, cnt in counts.items() ]
items.sort(key=lambda x: (-x[0], x[1]))
for cnt, tmpl in items:
cov = (cnt / total * 100.0) if total else 0.0
print(f"{cov:.2f}\t{tmpl}")
if __name__ == "__main__":
main()それでは、ログサンプルを使用して Python スクリプトを実行してみましょう。
$ cat logs_recommendation.sample | python3 drain3_min.py
50.01 2025-09-15 <*> INFO [main] [recommendation_server.py:47] <*> <*> resource.service.name=recommendation trace_sampled=True] - Receive ListRecommendations for product <*> <*> <*> <*> <*>
49.99 Receive ListRecommendations for product <*> <*> <*> <*> <*>出力結果には 2 つのログテンプレートと、それぞれがカバーするログの割合が表示されています。ローカルでうまく動作することが確認できたので、ClickHouse 上への実装に進みましょう。
ClickHouse 内でのログのマイニング
ローカルで Drain3 を実行することはテストには便利ですが、理想としては、ログがすでに存在する ClickHouse 内でパターン特定を直接実行したいところです。
ClickHouse は、ユーザー定義関数(UDF)を介して、Python コードを含むカスタムコードの実行をサポートしています。
以下の例ではローカルの ClickHouse Server を使用していますが、同じアプローチが ClickHouse Cloud でも機能します。
UDF のデプロイ
ローカルに UDF をデプロイするには、XML ファイル(例: /etc/clickhouse-server/drain3_miner_function.xml)で定義します。以下の例は、Drain3 を使用した Python ベースのログテンプレートマイナーを登録する方法を示しています。この関数は文字列の配列(生ログ)を入力として受け取り、抽出されたテンプレートの配列を返します。
<functions>
<function>
<type>executable_pool</type>
<name>drain3_miner</name>
<return_type>Array(String)</return_type>
<return_name>result</return_name>
<argument>
<type>Array(String)</type>
<name>values</name>
</argument>
<format>JSONEachRow</format>
<command>drain3_miner.py</command>
<execute_direct>1</execute_direct>
<pool_size>1</pool_size>
<max_command_execution_time>100</max_command_execution_time>
<command_read_timeout>100000</command_read_timeout>
<send_chunk_header>false</send_chunk_header>
</function>
</functions>次に、Python スクリプトを /var/lib/clickhouse/user_scripts/drain3_miner.py にコピーします。このスクリプトは先ほどの例よりも完成度の高いバージョンであり、ここに掲載するには長すぎます。完全なソースコードはこちらのリンクにあります。
Drain3 Python パッケージが ClickHouse サーバーにインストールされていることを確認してください。すべてのユーザーが利用できるように、システム全体にインストールする必要があります。ClickHouse Cloud では、必要な依存関係を記載した requirements.txt ファイルを提供するだけで済みます。
# Install drain3 for all users
sudo pip install drain3

# Verify the clickhouse user has access to it
sudo -u clickhouse python3 -c "import drain3"生ログの取り込み
今回の例を説明するために、サンプルログを取り込みましょう。Nginx のアクセスログと、OpenTelemetry デモで稼働している各種サービスからのログを組み合わせたサンプルデータセットを用意しました。以下は、シンプルなテーブルにログを取り込むための SQL 文です。
-- Create table
CREATE TABLE raw_logs
(
`Body` String,
`ServiceName` String
)
ORDER BY tuple();
-- Insert nginx access logs
INSERT INTO raw_logs SELECT line As Body, 'nginx' as ServiceName FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/http_logs/nginx-66.log.gz', 'LineAsString')
-- Insert recommendation service logs
INSERT INTO raw_logs SELECT line As Body, 'recommendation' as ServiceName FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/otel_demo/logs_recommendation.log.gz', 'LineAsString')
-- Insert cart service logs
INSERT INTO raw_logs SELECT line As Body, 'cart' as ServiceName FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/otel_demo/logs_cart.log.gz', 'LineAsString')ログテンプレートのマイニング
UDF の準備が整い、異なるサービスからの生ログが単一のテーブルに取り込まれたので、実験を開始できます。以下の図は、パイプラインの概要を示しています。
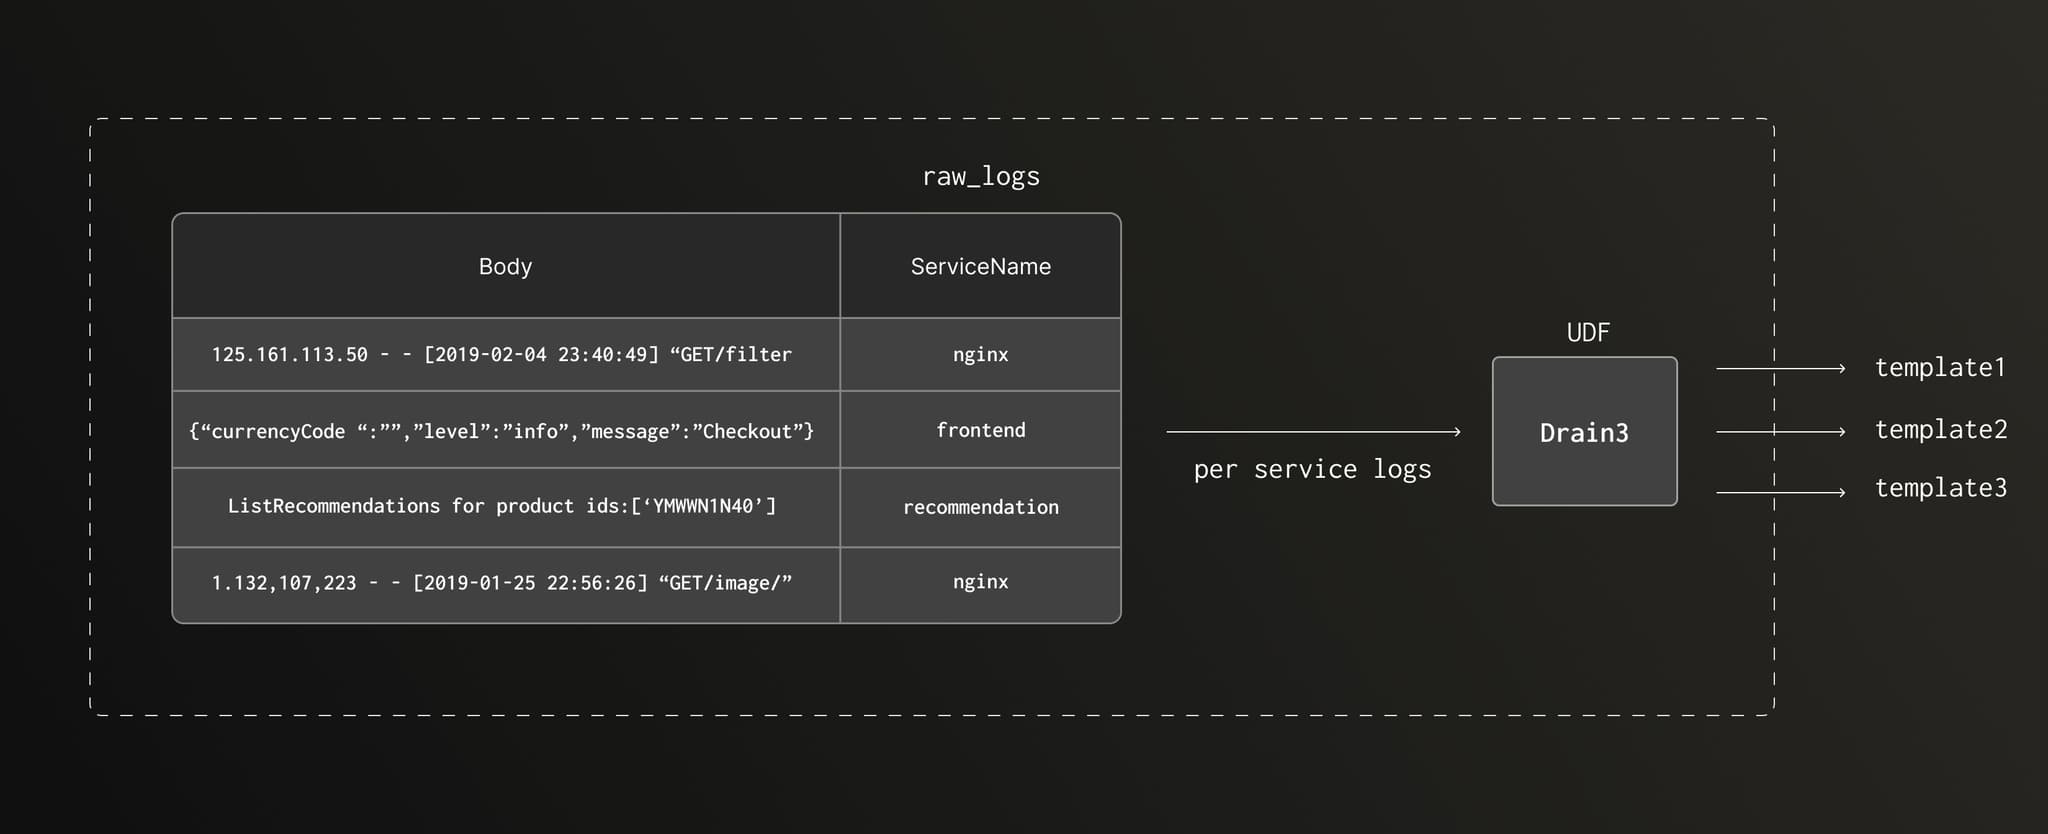
これをどのように実行するかを見てみましょう。以下は、recommendation サービスのログテンプレートを抽出する SQL 文です。
WITH drain3_miner(groupArray(Body)) AS results
SELECT
JSONExtractString(arrayJoin(results), 'template') AS template,
JSONExtractUInt(arrayJoin(results), 'count') AS count,
JSONExtractFloat(arrayJoin(results), 'coverage') AS coverage
FROM
(
SELECT Body
FROM raw_logs
WHERE (ServiceName = 'recommendation') AND (randCanonical() < 0.1)
LIMIT 10000
)
FORMAT VERTICALRow 1:
──────
template: <*> <*> INFO [main] [recommendation_server.py:47] <*> <*> resource.service.name=recommendation trace_sampled=True] - Receive ListRecommendations for product <*> <*> <*> <*> <*>
count: 5068
coverage: 50.68
Row 2:
──────
template: Receive ListRecommendations for product <*> <*> <*> <*> <*>
count: 4931
coverage: 49.31
Row 3:
──────
template: 2025-09-27 02:00:00,319 WARNING [opentelemetry.exporter.otlp.proto.grpc.exporter] [exporter.py:328] [trace_id=0 span_id=0 resource.service.name=recommendation trace_sampled=False] - Transient error StatusCode.UNAVAILABLE encountered while exporting logs to my-hyperdx-hdx-oss-v2-otel-collector:4317, retrying in 1s.
count: 1
coverage: 0.01recommendation サービスのログデータセットの 99.99% をカバーする 2 つのログテンプレートが得られたことが分かります。これら 2 つのログテンプレートを使用しましょう。ログテンプレートでカバーされないロングテールのログは、そのまま保持できます。
オンザフライでのログの構造化
保存されたログからログテンプレートを特定する方法が分かったので、これらを利用して、受信した生ログを自動的に構造化データへ変換し、より効率的に保存できます。
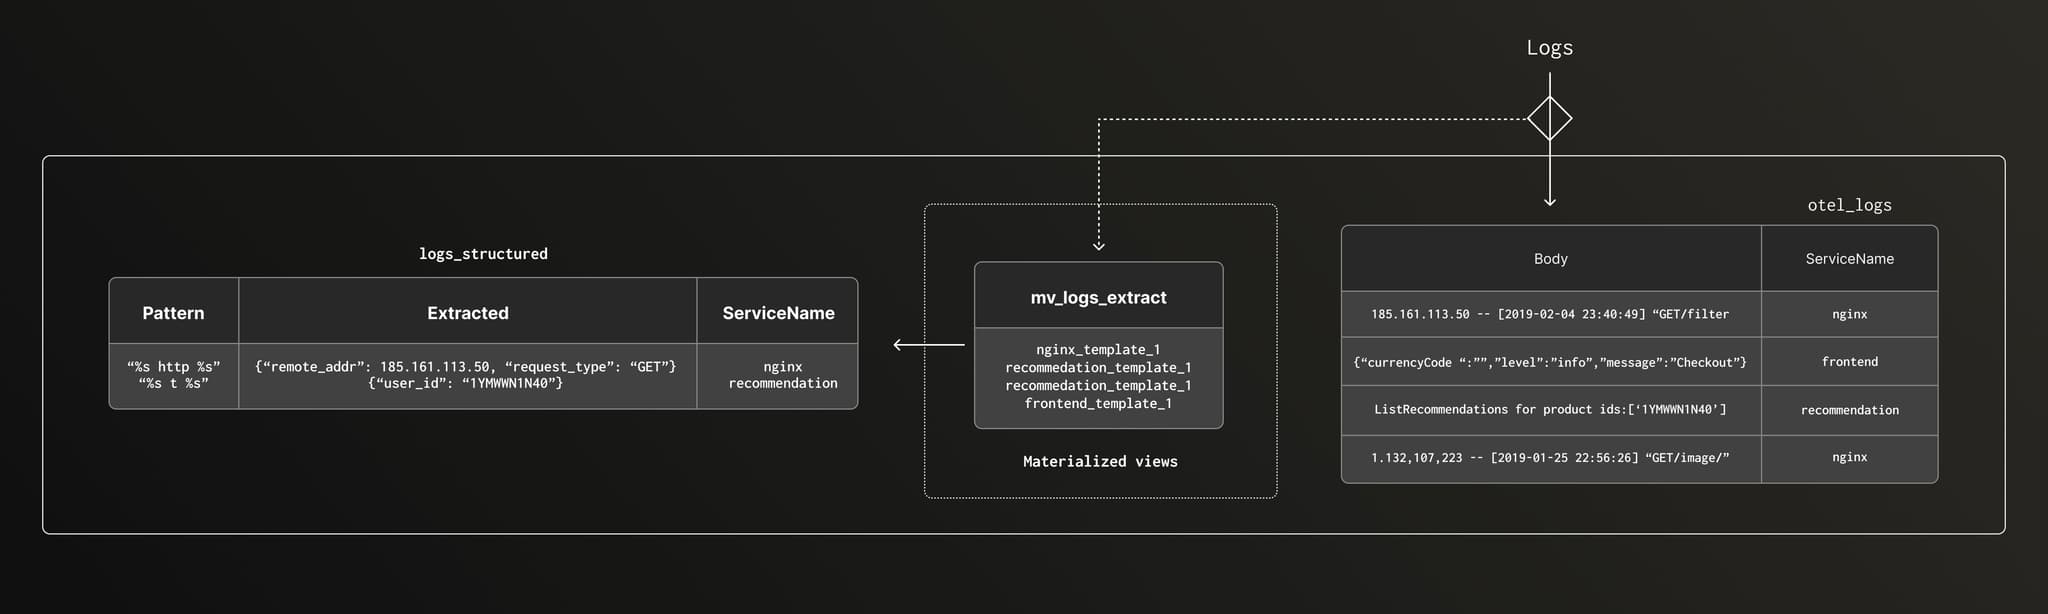
以下は、これを大規模に実現するために使用する取り込みパイプラインの概要です。
ログテンプレートの適用
生のテーブルに新しいログが取り込まれるたびに自動的に実行されるマテリアライズドビューを定義します。このマテリアライズドビューは、先ほど特定したログテンプレートを使用して各ログから値のグループを抽出し、個別のフィールドに保存します。この例では、すべての構造化ログが同じテーブルに書き込まれ、抽出された値は Map(K,V) 内に保持されます。
ビューを作成する前に、ターゲットテーブルである logs_structured を作成しましょう。
CREATE TABLE logs_structured
(
`ServiceName` LowCardinality(String),
`TemplateNumber` UInt8,
`Extracted` Map(LowCardinality(String), String)
) ORDER BY (ServiceName, TemplateNumber)これでビューを作成できます。以下は 1 つのサービスのみをサポートする最小限のバージョンです。すべてのサービスをカバーする SQL 文については、こちらのリンクを参照してください。
CREATE MATERIALIZED VIEW IF NOT EXISTS mv_logs_structured_min
TO logs_structured
AS
SELECT
ServiceName,
/* which template matched */
multiIf(m1, 1, m2, 2, 0) AS TemplateNumber,
/* extracted fields as Map(LowCardinality(String), String) */
CAST(
multiIf(
m1,
map(
'date', g1_1,
'time', g1_2,
'service_name', g1_3,
'trace_sampled', g1_4,
'prod_1', g1_5,
'prod_2', g1_6,
'prod_3', g1_7,
'prod_4', g1_8,
'prod_5', g1_9
),
m2,
map(
'prod_1', g2_1,
'prod_2', g2_2,
'prod_3', g2_3,
'prod_4', g2_4,
'prod_5', g2_5
),
map() -- else: empty map
),
'Map(LowCardinality(String), String)'
) AS Extracted
FROM
(
/* compute once per row */
WITH
'^([^\\s]+) ([^\\s]+) INFO \[main\] \[recommendation_server.py:47\] \[trace_id=([^\\s]+) span_id=([^\\s]+) resource\.service\.name=recommendation trace_sampled=True\] - Receive ListRecommendations for product ids:\[([^\\s]+) ([^\\s]+) ([^\\s]+) ([^\\s]+) ([^\\s]+)\]$' AS pattern1,
'^Receive ListRecommendations for product ([^\\s]+) ([^\\s]+) ([^\\s]+) ([^\\s]+) ([^\\s]+)$' AS pattern2
SELECT
*,
match(Body, pattern1) AS m1,
match(Body, pattern2) AS m2,
extractAllGroups(Body, pattern1) AS g1,
extractAllGroups(Body, pattern2) AS g2,
/* pick first (and only) match’s capture groups */
arrayElement(arrayElement(g1, 1), 1) AS g1_1,
arrayElement(arrayElement(g1, 1), 2) AS g1_2,
arrayElement(arrayElement(g1, 1), 3) AS g1_3,
arrayElement(arrayElement(g1, 1), 4) AS g1_4,
arrayElement(arrayElement(g1, 1), 5) AS g1_5,
arrayElement(arrayElement(g1, 1), 6) AS g1_6,
arrayElement(arrayElement(g1, 1), 7) AS g1_7,
arrayElement(arrayElement(g1, 1), 7) AS g1_8,
arrayElement(arrayElement(g1, 1), 7) AS g1_9,
arrayElement(arrayElement(g2, 1), 1) AS g2_1,
arrayElement(arrayElement(g2, 1), 2) AS g2_2,
arrayElement(arrayElement(g2, 1), 3) AS g2_3,
arrayElement(arrayElement(g2, 1), 4) AS g2_4,
arrayElement(arrayElement(g2, 1), 5) AS g2_5
FROM raw_logs where ServiceName='recommendation'
) WHERE m1 OR m2;完全なバージョンでは、一致する可能性がない場合でもすべてのログに対して各パターンが評価されるため、このアプローチは効率的にスケールしない可能性があります。後ほど、この問題に対処する最適化されたアプローチを紹介します。
マテリアライズドビューを実行するため、データを raw_logs テーブルに再取り込みします。
CREATE TABLE raw_logs_tmp as raw_logs
EXCHANGE TABLES raw_logs AND raw_logs_tmp
INSERT INTO raw_logs SELECT * FROM raw_logs_tmp完全なマテリアライズドビューを使用すると、logs_structured テーブルで結果を確認できます。各サービスについて、大部分のログをパースできました。TemplateNumber=0 のログは、パースできなかったものです。これらは個別に処理することも可能です。
SELECT
ServiceName,
TemplateNumber,
count()
FROM logs_structured
GROUP BY
ServiceName,
TemplateNumber
ORDER BY
ServiceName ASC,
TemplateNumber ASC┌─ServiceName────┬─TemplateNumber─┬──count()─┐
│ cart │ 0 │ 66162 │
│ cart │ 3 │ 76793139 │
│ cart │ 4 │ 61116119 │
│ cart │ 5 │ 41877952 │
│ cart │ 6 │ 1738375 │
│ nginx │ 0 │ 16 │
│ nginx │ 7 │ 66747274 │
│ recommendation │ 0 │ 5794 │
│ recommendation │ 1 │ 10537999 │
│ recommendation │ 2 │ 10565640 │ └────────────────┴────────────────┴──────────┘クエリ時における生ログの再構成
自動化された方法でログから重要な値を抽出できましたが、その過程で元のメッセージが失われてしまいました。これは好ましくありません。幸いなことに、ClickHouse は ALIAS と呼ばれる機能をサポートしており、これがここで非常に役立ちます。
エイリアスカラムは、クエリ実行時にのみ評価される式を定義します。ディスク上には一切データを保存せず、その値はクエリ時に計算されます。
この機能を活用し、ログのパースに使用したのと同じログテンプレートを使って、クエリ時に元のログメッセージを再構成する方法を見てみましょう。
既存の logs_structured テーブルにエイリアスカラムを追加できます。
ALTER TABLE logs_structured
ADD COLUMN Body String ALIAS multiIf(
TemplateNumber=1,
format('{0} {1} INFO [main] [recommendation_server.py:47] resource.service.name={2} trace_sampled={3}] - Receive ListRecommendations for product {4} {5} {6} {7} {8}',Extracted['date'],Extracted['time'],Extracted['service_name'],Extracted['trace_sampled'],Extracted['prod_1'],Extracted['prod_2'],Extracted['prod_3'],Extracted['prod_4'],Extracted['prod_5']),
TemplateNumber=2,
format('Receive ListRecommendations for product {0} {1} {2} {3} {4}',Extracted['prod_1'],Extracted['prod_2'],Extracted['prod_3'],Extracted['prod_4'],Extracted['prod_5']),
TemplateNumber=3,
format('GetCartAsync called with userId={0}',Extracted['user_id']),
TemplateNumber=4,
'info: cart.cartstore.ValkeyCartStore[0]',
TemplateNumber=5,
format('AddItemAsync called with userId={0}, productId={1}, quantity={2}', Extracted['user_id'], Extracted['product_id'], Extracted['quantity']),
TemplateNumber=6,
format('EmptyCartAsync called with userId={0}',Extracted['user_id']),
TemplateNumber=7,
format('{0} - {1} [{2}] "{3} {4} {5}" {6} {7} "{8}" "{9}"', Extracted['remote_addr'], Extracted['remote_user'], Extracted['time_local'], Extracted['request_type'], Extracted['request_path'], Extracted['request_protocol'], Extracted['status'], Extracted['size'], Extracted['referer'], Extracted['user_agent']),
'')これで、当初と同じようにログをクエリして、同様の結果を得ることができます。
SELECT Body
FROM logs_structured
WHERE ServiceName = 'nginx'
LIMIT 1
FORMAT verticalRow 1:
──────
Body: 66.249.66.92 - - [2019-02-10 03:10:02] "GET /static/images/amp/third-party/footer-mobile.png HTTP/1.1" 200 62894 "-" "Googlebot-Image/1.0"そして、これを生ログと比較してみます。
SELECT Body
FROM raw_logs
WHERE Body = '66.249.66.92 - - [2019-02-10 03:10:02] "GET /static/images/amp/third-party/footer-mobile.png HTTP/1.1" 200 62894 "-" "Googlebot-Image/1.0"'
LIMIT 1
FORMAT verticalRow 1:
──────
Body: 66.249.66.92 - - [2019-02-10 03:10:02] "GET /static/images/amp/third-party/footer-mobile.png HTTP/1.1" 200 62894 "-" "Googlebot-Image/1.0"圧縮結果
エンドツーエンドのプロセスが完了しました。生ログが構造化データに変換され、元のログを透過的に再構成できるようになりました。ここで問題となるのは、圧縮への影響はどうなっているかという点です。
取り組みの成果を把握するため、logs_structured テーブルと raw_logs テーブルを確認してみましょう。
この例ではごくわずかなログ(約 0.03%)がパースされませんでしたが、圧縮結果には有意な影響を与えないと見なすことができます。
SELECT
`table`,
formatReadableSize(sum(data_compressed_bytes)) AS compressed_size,
formatReadableSize(sum(data_uncompressed_bytes)) AS uncompressed_size
FROM system.parts
WHERE ((`table` = 'raw_logs') OR (`table` = 'logs_structured')) AND active
GROUP BY `table`
FORMAT VERTICALRow 1:
──────
table: raw_logs
compressed_size: 2.00 GiB
uncompressed_size: 37.67 GiB
Row 2:
──────
table: logs_structured
compressed_size: 1.71 GiB
uncompressed_size: 29.95 GiB正直なところ、期待外れな結果となりました。データを列指向フォーマットで保存できたものの、圧縮の改善はわずかです。数値を詳しく見てみましょう。
Uncompressed original size: 37.67 GiB
Compressed size on raw logs: 2.00 GiB - (18x compression ratio)
Compressed size on structured logs: 1.71 GiB - (22x compression ratio)圧縮比の改善は 3 倍程度にとどまり、目指していた結果とは言えませんが、まったく予期せぬ結果というわけでもありません。以前のブログで示したとおり、最も大きな圧縮ゲインは、ログフィールドに適切なデータ型を選択し、データを効率的にソートすることによってもたらされるからです。
サービスごとに1つのテーブルを用意する
実験をさらに進め、前回学んだ内容をここに適用してみましょう。そのためには、パースされたログをサービスごとに別々のテーブルに格納し、サービス単位でデータ型とソートキーをカスタマイズできるようにする必要があります。
手順は、すべての構造化ログを単一のテーブルに格納する場合と似ていますが、サービスごとに1つのテーブルと1つのマテリアライズドビューに分割する点が異なります。このアプローチでは、すべてのログ行にすべてのパターンを適用するのではなく、各サービスのログをそのサービス固有のパターンセットに対してのみ処理するため、スケーラビリティの向上にもつながります。
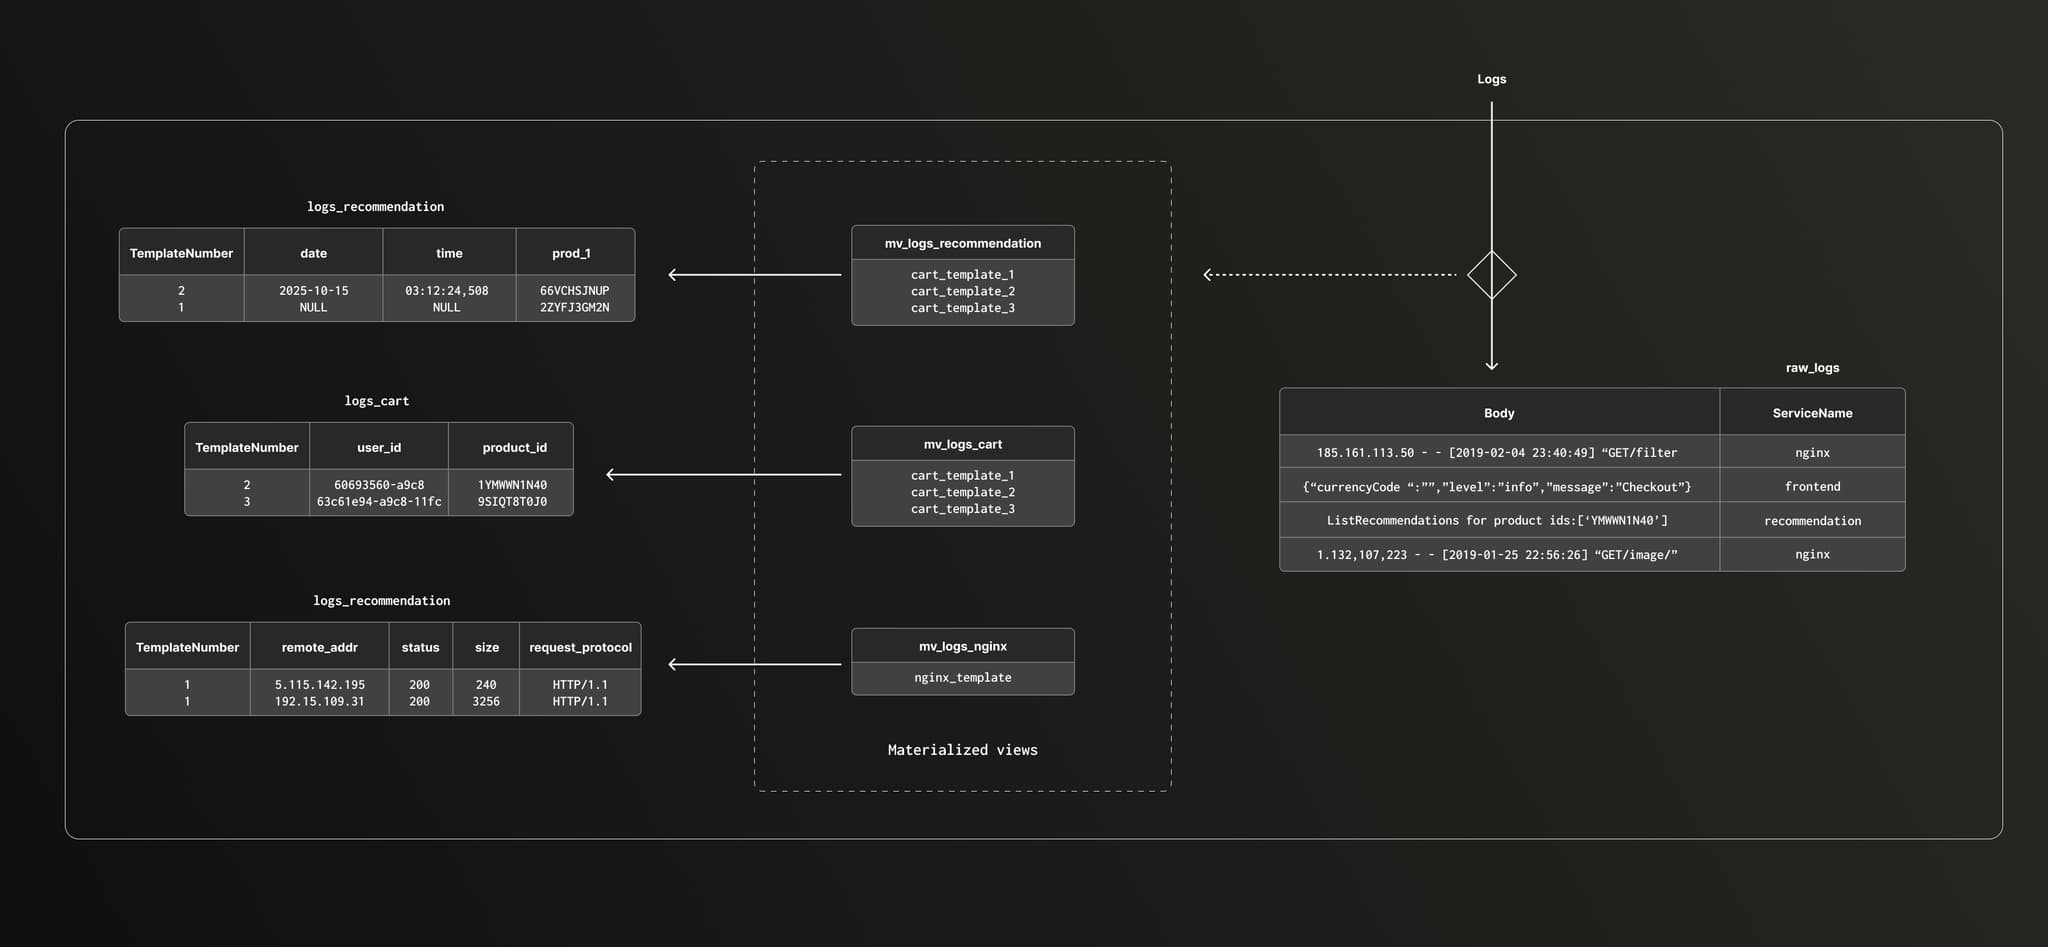
cart サービスのテーブルとマテリアライズドビューを見てみましょう。
-- Create table for cart service logs
CREATE TABLE logs_service_cart
(
TemplateNumber UInt8,
`user_id` Nullable(UUID),
`product_id` String,
`quantity` String,
Body ALIAS multiIf(
TemplateNumber=1, format('GetCartAsync called with userId={0}',user_id),
TemplateNumber=2, 'info: cart.cartstore.ValkeyCartStore[0]',
TemplateNumber=3, format('AddItemAsync called with userId={0}, productId={1}, quantity={2}', user_id, product_id, quantity),
TemplateNumber=4, format('EmptyCartAsync called with userId={0}',user_id),
'')
)
ORDER BY (TemplateNumber, product_id, quantity)
-- Create materialized view for cart service logs
CREATE MATERIALIZED VIEW IF NOT EXISTS mv_logs_cart
TO logs_service_cart
AS
SELECT
multiIf(m1, 1, m2, 2, m3, 3, 0) AS TemplateNumber,
multiIf(m1, g1_1, m2, Null, m3, g3_1, m4, g4_1, Null) AS user_id,
multiIf(m1, '', m2, '', m3, g3_2, '') AS product_id,
multiIf(m1, '', m2, '', m3, g3_3, '') AS quantity
FROM
(
WITH
'^[\\s]*GetCartAsync called with userId=([^\\s]*)$' AS pattern1,
'^info\: cart.cartstore.ValkeyCartStore\[0\]$' AS pattern2,
'^[\\s]*AddItemAsync called with userId=([^\\s]+), productId=([^\\s]+), quantity=([^\\s]+)$' AS pattern3,
'^[\\s]*EmptyCartAsync called with userId=([^\\s]*)$' AS pattern4
SELECT
*,
match(Body, pattern1) AS m1,
match(Body, pattern2) AS m2,
match(Body, pattern3) AS m3,
match(Body, pattern4) AS m4,
extractAllGroups(Body, pattern1) AS g1,
extractAllGroups(Body, pattern2) AS g2,
extractAllGroups(Body, pattern3) AS g3,
extractAllGroups(Body, pattern4) AS g4,
arrayElement(arrayElement(g1, 1), 1) AS g1_1,
arrayElement(arrayElement(g3, 1), 1) AS g3_1,
arrayElement(arrayElement(g3, 1), 2) AS g3_2,
arrayElement(arrayElement(g3, 1), 3) AS g3_3,
arrayElement(arrayElement(g4, 1), 1) AS g4_1
FROM raw_logs where ServiceName='cart'
);これで、このテーブルに格納されるログの種類に合わせてデータ型とソートキーをカスタマイズできるようになりました。複数のログテンプレートを持つサービスの場合、ソートキーの先頭カラムは常にテンプレート番号にします。これにより類似したログがまとめられ、圧縮効率が向上します。
サービスごとのテーブルとそれに対応するマテリアライズドビューを作成するための完全な手順は、こちらのリンクで確認できます。
すべての構造化ログをそれぞれのテーブルに格納したら、圧縮率を改めて確認してみましょう。
WITH (
SELECT sum(data_uncompressed_bytes)
FROM system.parts
WHERE (`table` = 'raw_logs') AND active
) AS raw_uncompressed
SELECT
label AS `table`,
formatReadableSize(sum(data_uncompressed_bytes)) AS uncompressed_bytes,
formatReadableSize(sum(data_compressed_bytes)) AS compressed_bytes,
sum(rows) AS nb_of_rows,
toUInt32(round(raw_uncompressed / sum(data_compressed_bytes))) AS compression_from_raw
FROM
(
SELECT
if(match(`table`, '^logs_service_'), 'logs_service_*', `table`) AS label,
data_uncompressed_bytes,
data_compressed_bytes,
rows
FROM system.parts
WHERE active AND ((`table` IN ('raw_logs', 'logs_structured')) OR match(`table`, '^logs_service_'))
)
GROUP BY label
ORDER BY label ASC┌─table───────────┬─uncompressed─┬─compressed─┬─nb_of_rows─┬─compression_from_raw─┐
│ logs_service_* │ 16.58 GiB │ 865.16 MiB │ 269448454 │ 45 │
│ logs_structured │ 29.95 GiB │ 1.71 GiB │ 269448470 │ 22 │
│ raw_logs │ 37.71 GiB │ 2.01 GiB │ 269448470 │ 19 │ └─────────────────┴──────────────┴────────────┴────────────┴──────────────────────┘圧縮率は大幅に改善しました。このケースでは、最大 45 倍の圧縮率を達成できています。
さらに、ClickHouse では merge 関数を使用して、これらのテーブルを透過的にクエリできます。
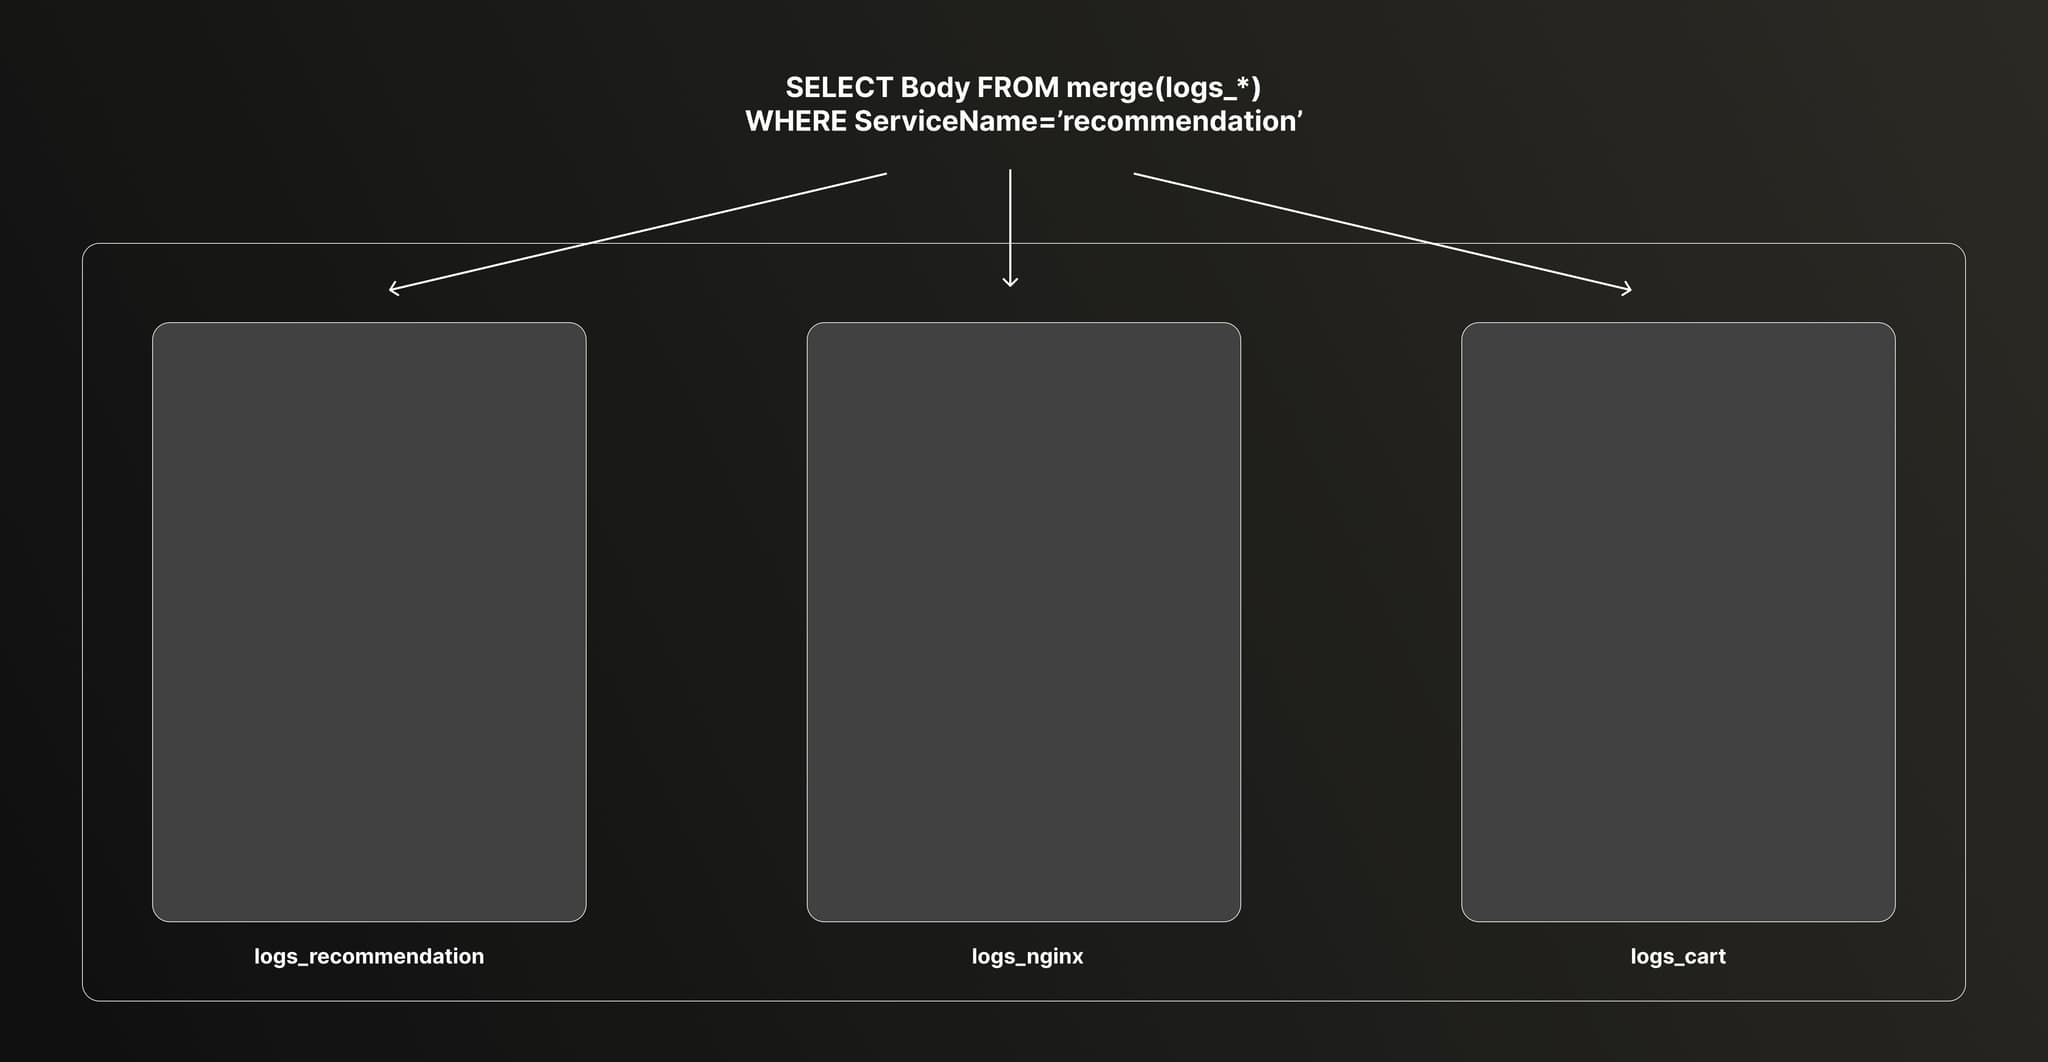
以下はデータをクエリする SQL 文です。各テーブルにそれぞれ Body カラムが含まれているため、任意のサービスの元のログを簡単に取得できます。
SELECT Body
FROM merge(currentDatabase(), '^logs_service_')
ORDER BY rand() ASC
LIMIT 10
FORMAT TSVinfo: cart.cartstore.ValkeyCartStore[0]
AddItemAsync called with userId={userId}, productId={productId}, quantity={quantity}
AddItemAsync called with userId=6dd06afe-a9da-11f0-8754-96b7632aa52f, productId=L9ECAV7KIM, quantity=4
info: cart.cartstore.ValkeyCartStore[0]
GetCartAsync called with userId=c6a2e0fc-a9e5-11f0-a910-e6976c512022
info: cart.cartstore.ValkeyCartStore[0]
GetCartAsync called with userId=0745841e-a970-11f0-ae33-92666e0294bc
info: cart.cartstore.ValkeyCartStore[0]
84.47.202.242 - - [2019-02-21 05:01:17] "GET /image/32964?name=bl1189-13.jpg&wh=300x300 HTTP/1.1" 200 8914 "https://www.zanbil.ir/product/32964/63521/%D9%85%D8%AE%D9%84%D9%88%D8%B7-%DA%A9%D9%86-%D9%85%DB%8C%D8%AF%DB%8C%D8%A7-%D9%85%D8%AF%D9%84-BL1189" "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:64.0) Gecko/20100101 Firefox/64.0"
GetCartAsync called with userId={userId}まとめ
ログクラスタリングを使用して生ログを構造化データへと自動変換することは、圧縮率の向上に役立ちます。前回の記事で Nginx ログに対して達成した 178 倍の圧縮率には及ばないものの、アプリケーションログは構造の一貫性がはるかに低いため、同様の結果を得るのはより難しくなります。
それでも、精度を損なうことなく約 50 倍の圧縮を達成しつつ、主要なフィールドをカラムとして抽出してクエリの柔軟性を高められたことは、興味深い成果です。これは、ログを構造化することで、データを完全な状態に保ちながらクエリを大幅に高速化できることを示しています。
Drain3 はログテンプレートを自動的に特定するための効果的なツールです。UDF を使用して ClickHouse 内で直接実行することで、ログの取り込みから構造化ストレージに至るまで、完全に自動化されたパイプラインを構築できます。
とはいえ、このプロセスはまだ簡単とは言えません。今回はパースされなかったロングテールのログに対処していませんが、これらは構造化データセットに影響を与えずに可視性を維持できるよう、専用のテーブルに格納するなどの方法で別個に処理できます。
今回の取り組みは非常に実験的なものでしたが、圧縮率を向上させるための大規模なログクラスタリングの自動化に向けた強固な基盤となりました。これは、将来の ClickStack におけるコンポーネントの基礎となり得ます。