5万

ClickHouse のエンジニアはパフォーマンスに強いこだわりを持っています。毎回のリリースごとに、基盤となるハードウェア上で ClickHouse をさらに高速に動作させ、より適切にスケールさせる新しい方法を模索しています。先日、NVIDIA から登場予定の Vera CPU プラットフォームの早期アクセスサーバーの提供を受けた際、私たちは当然のことを行いました。人気の分析用ベンチマークである ClickBench を実行したのです。ウェブサイトから入手できる標準の ClickHouse バイナリを使用し、NVIDIA Vera 向けにデータベースの最適化やカスタマイズは一切行いませんでした。その結果は一目瞭然です:
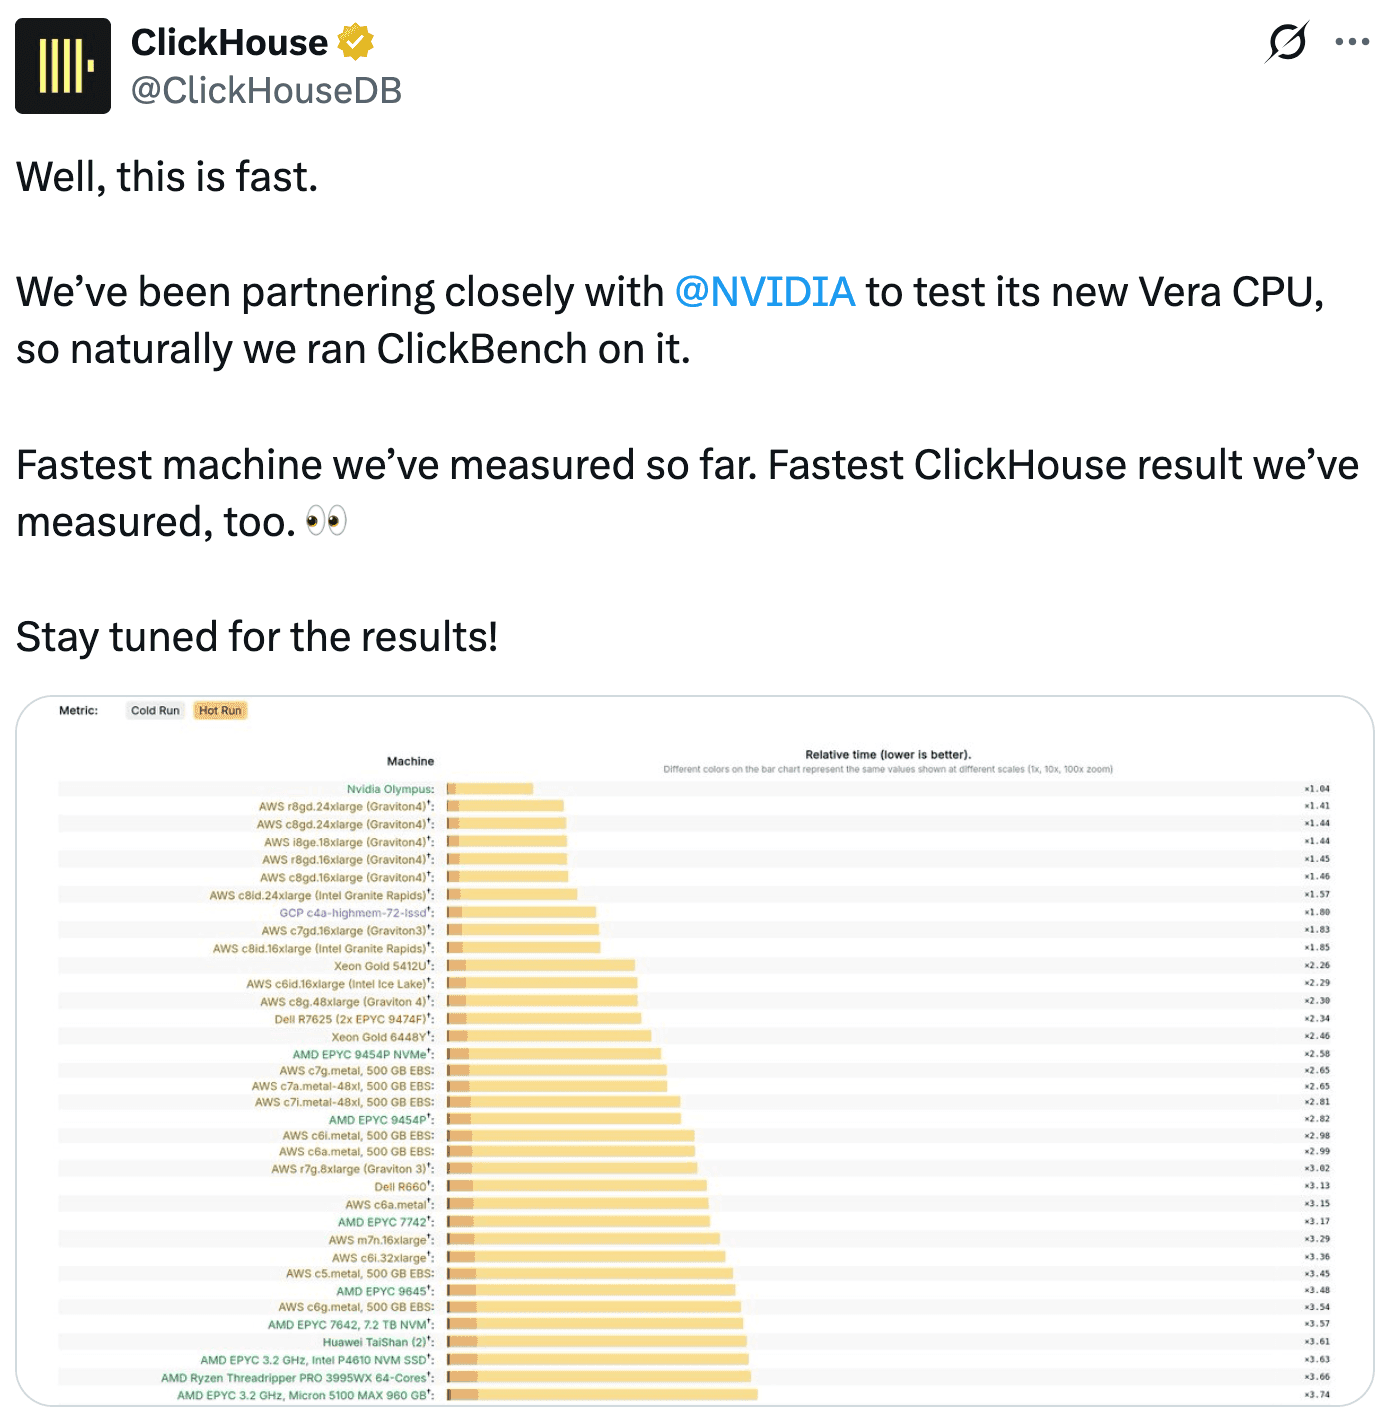
NVIDIA Vera は、ClickBench のハードウェアリーダーボードで大差をつけて即座に首位に立ちました。
どのデータベースエンジニアも、Vera が真に圧倒的なプラットフォームであることを認めるはずです。Arm-v9.2 と完全に互換性のある 88 個の NVIDIA Olympus コアを搭載しています。2 ソケットシステムでは、NVIDIA Spatial Multithreading により 352 のハードウェアスレッドを備えた合計 176 コア構成となります。各コアは 96/64 kB の L1 データ/命令キャッシュ、2 MB の L2 キャッシュ、164 MB の共有 L3 キャッシュにアクセスできます。最大メモリ帯域幅は、システム内の DRAM 容量に応じて 1.0 TB/s から 1.2 TB/s の範囲となります。
CPU コア数が増え、キャッシュが増加し、メモリ帯域幅が広くなれば、当然どのベンチマークも高速化すると主張する人もいるかもしれません。それも一理ありますが、真の課題はマシンのリソースに応じてデータベースのパフォーマンスを線形にスケールさせることにあります。基本的に、マシンが 2 倍強力になった場合、つまり CPU コア数が 2 倍、キャッシュが 2 倍、メモリ帯域幅が 2 倍などになった場合、クエリは単に 2 倍未満で速くなるのではなく、2 倍高速に実行されることが期待されます。データがディスク上でどのように編成され、メモリ内でどのように表現され、どのように処理されるか、これらすべてがデータベースのスケーラビリティに影響を与えます。すべてのレイヤーで綿密なエンジニアリングが行われていなければ、データベースは Vera の膨大なコア数とメモリ帯域幅を活かしきれず、パフォーマンスを潜在的なまま残してしまうことになります。
より強力なハードウェアは、リアルタイム分析、データウェアハウス、オブザーバビリティ、機械学習における、データ集約的かつコンピュート集約的な新しいユースケースを処理するのに役立ちます。従来はクエリの大半がダッシュボード (例: Grafana、Superset) や BI ツール (例: Tableau、Looker) から生成されていましたが、ClickHouse Cloud ではデータの問いに自律的に答えるエージェントがますます増えています。データベースの観点から見ると、エージェント型のクエリには 3 つの特徴があります。第 1 に、通常のクエリよりもはるかに「アドホック」な性質を持ち、例えば複雑な形状をしており、クエリ間でもその形状が大きく変化します。第 2 に、予測不可能なタイミングで、かつバースト的に到達することがよくあります。そして第 3 に、エージェントが並列に動作するサブエージェントを生成するため、通常は大量のエージェント型クエリが並列に実行されます。
Vera 上での ClickHouse のスケーラビリティを検証したかったため、一般的な通常クエリおよびエージェントベースのクエリにおける基本的なデータベース操作をシミュレートする 3 つのマイクロベンチマークを開発しました。
- フィルター評価 (SQL WHERE 句)
- 集計 (SQL GROUP BY 句)
- 結合 (SQL JOIN 句)
ディスク I/O (オブジェクトストレージやローカル SSD) が不自然なボトルネックにならないよう、合成データセットはすべてメモリ上に保持することにしました。幸いにも、ClickHouse にはこの用途専用の Memory テーブルエンジン が用意されています。ClickHouse のクエリ処理レイヤーは、ストレージレイヤーから完全に分離されています。十分なストレージ帯域幅があると仮定すれば、このベンチマーク結果は ClickHouse Cloud や ClickHouse オープンソース における通常の MergeTree テーブルにも当てはまります。
テーブルのセットアップ
テスト用テーブルは、5〜10 文字のランダムな ASCII 文字列 625 億行からなる単一のカラムで構成されています。テーブルサイズはちょうど 1 TB です。文字列は圧縮なしの raw 形式で保存されます (Memory テーブルエンジンでは圧縮は任意です)。
CREATE TABLE default.strings
(
`s` String
)
ENGINE = Memory;
INSERT INTO strings SELECT randomPrintableASCII(5 + (rand() % 6))
FROM numbers_mt(62500000000);マイクロベンチマーク 1: フィルター評価
最初に実行したマイクロベンチマークは、単純な LIKE クエリです。
SELECT count()
FROM strings
WHERE s LIKE '%ab%'; -- 部分文字列 ‘ab’ を含む文字列の数異なるスレッド数 (設定 max_threads) でクエリの実行時間を測定しました。
| max_threads | time | speedup | efficiency |
|---|---|---|---|
| 1 | 50.44 sec | 1.00x | 100.00% |
| 4 | 13.19 sec | 3.82x | 95.60% |
| 16 | 3.25 sec | 15.52x | 97.00% |
| 64 | 1.23 sec | 41.01x | 64.08% |
| 256 | 1.11 sec | 45.44x | 17.75% |
「time」はクエリの実行時間です。「speedup」は max_threads = 1 と比較してクエリ実行時間がどれだけ高速化したかを示します。「efficiency」は、期待される高速化に対する実際の高速化の比率です。例えば、32 スレッドを使用した場合、32 倍の高速化が期待されます。高速化の倍率がこれより低いと、効率は 100% 未満になります。
実行時間はクエリのスレッド数に比例して減少していきますが、64 スレッドで頭打ちになります。スレッドをさらに 256 まで増やしても、大幅な追加の高速化は得られません。このような動作は通常、クエリが I/O バウンドであることを示しています。つまり、コアがデータを処理する速度が、メモリバスが DRAM との間で読み書きできる速度を上回っていることを意味します。これは、総データ量 (1 TB) をクエリ実行時間で割ることで簡単に確認できます。
| max_threads | time | speedup | efficiency | throughput |
|---|---|---|---|---|
| 1 | 50.44 sec | 1.00x | 100.00% | 19.83 GB/s |
| 4 | 13.19 sec | 3.82x | 95.60% | 75.82 GB/s |
| 16 | 3.25 sec | 15.52x | 97.00% | 307.69 GB/s |
| 64 | 1.23 sec | 41.01x | 64.08% | 813.01 GB/s |
| 256 | 1.11 sec | 45.44x | 17.75% | 900.90 GB/s |
実際に、クエリのスケーリングが止まる時点でのメモリ I/O は 813 GB/s (64 コア)、および 900 GB/s (256 コア) です。この値は Vera システムの物理メモリ帯域幅とおよそ一致しています。これはクエリがメモリバウンドであることを示しており、コアを追加してもこれ以上の高速化は見込めません。
この限界を超えてもすべての CPU リソースが完全に活用されることを確認するため、クエリを変更してより CPU 集約的な処理にしました。
SELECT count()
FROM strings
WHERE match(s, '[0-9][a-z][A-Z]'); -- この正規表現に一致する文字列の数先ほどのクエリが単純な部分文字列検索を実行したのに対し、このクエリはテーブル内のすべての文字列に対して負荷の高い正規表現を評価します。結果は以下のとおりです。
| max_threads | time | speedup | efficiency |
|---|---|---|---|
| 1 | 1209.7 | 1.00 | 100.00% |
| 2 | 598 | 2.02 | 101.15% |
| 4 | 302.9 | 3.99 | 99.84% |
| 8 | 150.9 | 8.02 | 100.21% |
| 16 | 75.5 | 16.02 | 100.14% |
| 32 | 37.8 | 32.00 | 100.01% |
| 64 | 19.1 | 63.34 | 98.96% |
| 128 | 9.8 | 123.44 | 96.44% |
| 176 | 7.4 | 163.47 | 92.88% |
| 256 | 5.6 | 216.02 | 84.38% |
| 352 | 5.3 | 228.25 | 64.84% |
実行時間は、CPU コア数に応じてほぼ完全にスケールするようになりました。もっとも、ほぼ常に、と言えるのは… Vera マシンの物理コア数である 176 コア以降になると、効率が徐々に低下し始めるためです。このコア数を超えると、追加のソフトウェアスレッドは物理ハードウェアスレッドではなく論理ハードウェアスレッドによって処理されます。論理ハードウェアスレッド (または SMT スレッド) は、物理コアを他の論理ハードウェアスレッドと共有します。論理ハードウェアスレッドは、キャッシュミス、分岐予測ミス、リモートデータアクセスなどのストールを隠蔽するのには優れていますが、フィルタークエリのようなコンピュートバウンドのワークロードに対しては限定的な効果 (例: 10〜30% の高速化) しかありません。ここではまさにその現象が起きています。
クエリ処理は明快な方法で並列化されています。ClickHouse はテーブルを均等なサイズの 352 個の仮想チャンクに分割し、それらを同時に並列フィルタリングします。これは EXPLAIN PIPELINE の出力で確認できます。
EXPLAIN PIPELINE
SELECT count()
FROM strings
WHERE match(s, '[0-9][a-z][A-Z]')
SETTINGS max_threads = 352;┌─explain───────────────────────────┐
│ (Expression) │
│ ExpressionTransform │
│ (Aggregating) │
│ Resize 352 → 1 │
│ AggregatingTransform × 352 │
│ (Expression) │
│ ExpressionTransform × 352 │
│ (Filter) │
│ FilterTransform × 352 │
│ (ReadFromMemoryStorage) │
└───────────────────────────────────┘計画のオペレーターについて詳しく説明することはしませんが、各オペレーターの後の x 352 は、352 個の仮想テーブルチャンクが並列に処理されていることを意味します。最後の Resize オペレーターが、352 個の部分結果を最終結果に統合します。
マイクロベンチマーク 2: 集計
次に、集計クエリをテストしました。
SELECT ascii(s) AS first_char, count(), sum(sipHash64(s))
FROM strings
GROUP BY first_char;このクエリは文字列を先頭文字 (つまり 255 グループ) でグループ化し、グループサイズと各文字列の (sip)hash 値の合計の両方を返します。255 グループは、データベースエンジニアが「低カーディナリティ」集計と呼ぶものです。数百万グループのような高カーディナリティ集計は、データベースの観点からはより大きな課題となりますが、データセットを時間単位でグループ化するなど、実際には低カーディナリティ集計の方がはるかに一般的です。再びメモリバウンドになるのを避けるため、ハッシュ計算によって意図的にクエリをより CPU 集約的なものにしています。
異なるクエリスレッド数での結果は以下のとおりです。
| max_threads | time | speedup | efficiency |
|---|---|---|---|
| 1 | 884.1 | 1.00 | 100.00% |
| 2 | 437.6 | 2.02 | 101.02% |
| 4 | 221.3 | 4.00 | 99.88% |
| 8 | 110.6 | 7.99 | 99.92% |
| 16 | 55.7 | 15.87 | 99.20% |
| 32 | 27.4 | 32.27 | 100.83% |
| 64 | 13.9 | 63.60 | 99.38% |
| 128 | 7.2 | 122.79 | 95.93% |
| 176 | 5.4 | 163.72 | 93.02% |
| 256 | 4.9 | 180.43 | 70.48% |
| 352 | 4.9 | 180.43 | 51.26% |
実行時間は今回もコア数に応じてほぼ完全にスケールしています。Vera のニューラル分岐予測と高度なプリフェッチにより、ClickHouse はハッシュテーブルの効率的な読み書きを行い、スキューによるアクセスレイテンシを隠蔽できています。先ほどのクエリと同様に、コンピュートバウンドのクエリでは SMT のメリットが限定的であるため、物理コア数を超えると効率が低下し始めます。
以下は EXPLAIN PIPELINE の出力です。
EXPLAIN PIPELINE
SELECT
ascii(s) AS first_char,
count(),
sum(sipHash64(s))
FROM strings
GROUP BY first_char
SETTINGS max_threads = 352;┌─explain─────────────────────────┐
│ (Expression) │
│ ExpressionTransform × 352 │
│ (Aggregating) │
│ Resize × 14 26 → 26 │
│ AggregatingTransform × 352 │
│ (Expression) │
│ ExpressionTransform × 352 │
│ (ReadFromMemoryStorage) │
└─────────────────────────────────┘この実行計画は下から上へと理解するのが最適です。ExpressionTransform は、352 の並列ストリームで各テーブル行に対して ascii (グループ化キー) と sipHash (sum の引数) を計算します。次に AggregatingTransform が各ストリーム用のハッシュテーブルを作成し、最後のストリームの処理が完了した時点で、それらを結合されたハッシュテーブルへとマージします。どちらのオペレーターも完全に並列化されており、ハードウェアリソースを最大限に活用しています。計画にはさらに 2 つのオペレーターが含まれています。Resize は結合されたハッシュテーブルを再度分割し、そのエントリを次のオペレーターである ExpressionTransform 群の入力へと分散します。このクエリではハッシュテーブルのエントリはごくわずか (256) ですが、ハッシュテーブルのサイズは実行時まで分からないため、ClickHouse はクエリプランに無条件で resize オペレーターを挿入します。パイプラインの最後にある ExpressionTransform は、SELECT リスト内の追加の式を評価します。このクエリでは、SELECT リストがグループ化式と集計を直接参照しているため、集計後に追加の計算は発生せず、オペレーターは実質的に処理を行いません。ただし何らかの処理を行う必要があったとしても、ExpressionTransform は最大限の並列度で実行されます。
マイクロベンチマーク 3: 結合
3 つ目の最後のマイクロベンチマークは、小さなテーブルとの結合です。これは、ファクトテーブルとディメンションテーブル間の結合という一般的なユースケースを表しています。元のテーブルからサンプリングを行い、62.5 万行 (元のテーブルの 0.001%) のディメンションテーブルを作成しました。
CREATE TABLE strings_tiny
(
s String
)
ENGINE = Memory;
INSERT INTO strings_tiny
SELECT s FROM strings
WHERE rand() % 99999 = 0
LIMIT 625000;次に、単純な結合クエリを実行しました。
SELECT count()
FROM strings AS big JOIN strings_tiny AS small ON big.s = small.s;結果は以下のとおりです。
| max_threads | time | speedup | efficiency |
|---|---|---|---|
| 1 | 1132.6 | 1.00 | 100.00% |
| 2 | 554 | 2.04 | 102.22% |
| 4 | 286.1 | 3.96 | 98.97% |
| 8 | 138.7 | 8.17 | 102.07% |
| 16 | 71.2 | 15.91 | 99.42% |
| 32 | 35.9 | 31.55 | 98.59% |
| 64 | 17.8 | 63.63 | 99.42% |
| 128 | 9.3 | 121.78 | 95.14% |
| 176 | 7.3 | 155.15 | 88.15% |
| 256 | 6.1 | 185.67 | 72.53% |
| 352 | 6.1 | 185.67 | 52.75% |
実行時間はクエリスレッド数にほぼ比例して短縮されています。言い換えれば、ClickHouse は完璧にスケールしています。
このクエリの EXPLAIN PIPELINE の出力はかなり複雑なため、ここでは割愛します。この結合では こちら で解説されている ClickHouse の parallel_hash 結合アルゴリズムが使用されており、すべてのクエリスレッドで並列にハッシュテーブルを構築できるようになっています。また、ハッシュテーブルのプローブ処理を高速化するための ランタイムフィルター も構築されます。実際には、結合カラムはファクトテーブルの主キーの一部であることが一般的です (「外部キー結合」)。今回の実験ではどのテーブルにも主キーがありませんでしたが、もし主キーがあれば、私たちが最近導入した もう 1 つのパフォーマンス最適化 も活用できるようになります。
おまけ: SIMD ベクトル化
上記の 3 つのマイクロベンチマークは、クエリ処理を高速化するために主にマルチスレッドに依存していました。データ処理を並列化するもう 1 つの直交する方法が、SIMD (単一命令複数データ) です。ClickHouse は、コンパイラの自動ベクトル化 や 組み込み関数 (intrinsics) を活用してホットループを高速化し、ハードウェアの SIMD 機能をフル活用します。こうした頻繁に繰り返されるコードセクションでは、CPU は各値を個別に処理する代わりに、複数の値を一度に処理します。
そこで、SIMD のメリットを示すためのおまけとして、Vera マシン上で以下のシンプルなフィルタークエリを実行しました。実証を目的として、マルチスレッドは無効にしています。
CREATE TABLE t (x UInt32) ENGINE = Memory;
INSERT INTO t SELECT rand() FROM numbers(2500000000);
SELECT count()
FROM t
WHERE x > 2000000000
FORMAT Null
SETTINGS max_threads = 1;このクエリは 0.42 秒で完了しました。
次に、ClickHouse の C++ コード内の WHERE フィルター実装 を開きました。
/// From src/Functions/FunctionsComparison.h
static void const ContainerA & a, B b, PaddedPODArray<UInt8> & c)
{
size_t size = a.size();
const A * __restrict a_pos = a.data();
UInt8 * __restrict c_pos = c.data();
const A * a_end = a_pos + size;
while (a_pos < a_end)
{
*c_pos = Op::apply(*a_pos, b);
++a_pos;
++c_pos;
}
}))a と b はフィルター条件の左辺と右辺、つまり x と 2000000000 を表します。Op::apply (「演算の適用」) は入力行のバッチに対して a < b を計算し、その結果を c として返します。
強力な SIMD 命令から ClickHouse がいかに恩恵を受けているかを示すため、while ループの直前に Pragma("clang loop vectorize(disable) interleave(disable)”) を挿入して自動ベクトル化を無効化するようコンパイラに指示しました。これにより、ClickHouse は SIMD 命令を適用せずに入力値を順次比較するようになります。その結果、クエリの実行時間は 1.48 秒となり、以前と比べて 3.5 倍遅くなりました。自動ベクトル化が有効な場合、ClickHouse は Vera の 128 ビット NEON 命令を使用して 4 つの 32 ビット整数を同時に比較します (理論上の高速化は 4 倍)。NEON に加えて、Vera は強力な 6x128 ビット SVE2 実装も備えており、実行ユニット全体で大幅に高いベクトル処理スループットを実現できます。ClickHouse におけるこれらの命令のサポートは、現在オープンソースコミュニティと共に進められています: PR #122860。
まとめ
「NVIDIA Vera は信じられないほど高速で強力なサーバープラットフォームであり、私たちがこれまでに目にした中で最も高速です。ClickHouse は、その計り知れないポテンシャルを世界最高水準の分析パフォーマンスへと結びつけることに全力を注いでいます。」
— Alexey Milovidov、ClickHouse CTO
ClickHouse はすでに現在でもコア数の多いマシン上で良好に動作しますが、ClickHouse のエンジニアリングチームは当然ながら現状に常に疑問を投げかけています。クエリ実行中に非効率な点はないか? クエリパイプラインの各ステップでハードウェアの並列性がまだ十分に活かされていない部分はないか? データ構造をよりコンパクトにしてキャッシュ効率を高めることはできないか? データベースは圧縮、非同期処理、バッチ処理、またはキャッシングをさらに活用できないか? ClickHouse での大規模なクエリパフォーマンスの分析、最適化、テストの手法を明らかにする、ClickHouse のパフォーマンスエンジニアリングに関する今後のブログ記事をぜひお楽しみに。
NVIDIA Vera の詳細についてはこちらをご覧ください: https://developer.nvidia.com/blog/nvidia-vera-cpu-boosts-ai-factory-throughput-to-accelerate-agentic-workloads/
今すぐ始める
ご自身のデータで ClickHouse がどのように動作するか試してみませんか?ClickHouse Cloud は数分で使い始めることができ、300 ドル分の無料クレジットも進呈されます。
サインアップ