

JOIN 절 참고를 참조하십시오. 실행 알고리즘과 알고리즘 선택 방법은 테이블 조인을 참조하십시오.
조인 사용 지양
ClickHouse는 매우 다양한 조인 유형과 알고리즘을 지원합니다. 그러나 조인은 본질적으로 단일 비정규화 테이블에서 쿼리하는 것보다 비용이 더 많이 듭니다. 비정규화는 계산 작업을 쿼리 시점에서 삽입 또는 전처리 시점으로 옮기므로, 런타임 지연 시간을 크게 줄이는 경우가 많습니다. 실시간 또는 지연 시간에 민감한 분석 쿼리에는 비정규화를 강력히 권장합니다. 일반적으로 다음과 같은 경우 비정규화를 고려하십시오:- 테이블이 자주 변경되지 않거나 Batch 단위 갱신을 허용할 수 있는 경우
- 관계가 다대다가 아니며 카디널리티가 지나치게 높지 않은 경우
- 쿼리할 컬럼의 부분 집합만 제한적으로 필요한 경우, 즉 일부 컬럼은 비정규화에서 제외할 수 있는 경우
- 실시간 보강이나 평탄화를 Flink와 같은 업스트림 시스템에서 처리할 수 있도록, 처리를 ClickHouse 외부로 옮길 역량이 있는 경우
조인이 필요한 경우
조인 성능을 높이려면 다음 권장 사항을 따르십시오.- 일치 항목이 하나만 필요하면
ANY조인을 사용하십시오. 일반 조인은 일치하는 모든 행을 반환하므로, 키가 중복되면 카테시안 곱이 생성될 수 있습니다. 일치 항목 하나로 충분하다면LEFT ANY JOIN또는ANY INNER JOIN을 사용하여 결과 크기와 메모리 사용량을 줄이십시오. - 조인 전에 양쪽 입력을 모두 줄이십시오.
WHERE및JOIN ON절에 선택도가 높은 조건을 적용하십시오. ClickHouse는 가능한 경우 필터(filter)를 푸시다운하지만, 명시적인 서브쿼리를 사용하면 각 입력이 조인 전에 확실히 필터링되도록 할 수 있습니다. INNER JOIN대신IN을 고려하십시오. 다른 테이블에 키가 존재하는지만 확인하면 되는 쿼리라면,IN서브쿼리로 이 요구 사항을 직접 표현할 수 있으며INNER JOIN결과를 생성하는 것보다 메모리를 적게 사용할 수 있습니다.- 재사용할 조회에는
Join테이블 엔진을 우선 사용하십시오.Join테이블 엔진은 선언된 조인 유형, 엄격성, 키에 맞춰 미리 계산된 인메모리 구조를 저장합니다. ClickHouse Cloud에서는MergeTree백킹 테이블을 사용하는SharedJoin으로 구현되며,Join(ANY, LEFT, key)를 사용하면 키 단위로 업데이트 가능한 조회가 가능합니다. 자세한 내용은 Join 테이블 엔진을 사용한 빠르고 업데이트 가능한 조회를 참고하십시오. - 가능하면 테이블 정렬 키를 기준으로 조인하십시오. 두 테이블이 모두 조인 키 기준으로 물리적으로 정렬되어 있으면
full_sorting_merge가 정렬 단계를 건너뛰고 메모리 사용량을 줄일 수 있습니다. 실행 계획(Execution Plan)을 확인하고, 실제 환경을 대표하는 데이터로 이 알고리즘과 기본 알고리즘을 비교 벤치마크하십시오. - 디스크 유출(spill)되는 조인을 피하십시오. 중간 조인 상태를 디스크 유출(spill)하면 쿼리를 메모리 제한 내에서 실행할 수 있지만, 디스크 I/O 때문에 일반적으로 지연 시간이 늘어납니다. 해시 조인(Hash join)은 설정된 디스크 유출 임계값(spill threshold)에 도달하면 grace hash로 전환할 수 있으며, 병합 조인(merge join)은 외부 정렬을 사용할 수 있습니다. 디스크 유출(spill)에 의존하기 전에 입력 행과 컬럼을 줄이거나 데이터 모델을 변경하십시오. 자세한 내용은 최적의 조인 알고리즘 선택을 참고하십시오.
- 필요에 따라 기본값을 불일치 표시로 활용하십시오. 기본 설정인
join_use_nulls = 0은 외부 조인에서 일치하지 않는 컬럼을 해당 데이터 타입의 기본값으로 채우며Nullable래퍼를 사용하지 않습니다. 쿼리에서 일치하지 않는 행과 기본값을 포함한 일치 행을 구분해야 하는 경우에만join_use_nulls를 활성화하십시오.
최적의 JOIN 알고리즘 선택하기
ClickHouse는 속도와 메모리 사이에서 서로 다른 절충점을 갖는 여러 JOIN 알고리즘을 지원합니다.join_algorithm의 기본값은 direct,parallel_hash,hash,ie_join이며, ClickHouse는 JOIN 유형, 엄격성(strictness), 조건, 테이블 엔진에 맞춰 적용 가능한 첫 번째 알고리즘을 선택합니다. 이 값은 양쪽 입력을 모두 줄인 뒤, 대표성 있는 데이터로 측정한 결과 다른 메모리 전략이나 실행 전략이 필요하다고 확인된 경우에만 변경을 고려하십시오. 알고리즘 실행 세부 사항과 지원되는 JOIN 유형은 JOIN 알고리즘 선택하기를 참조하십시오.
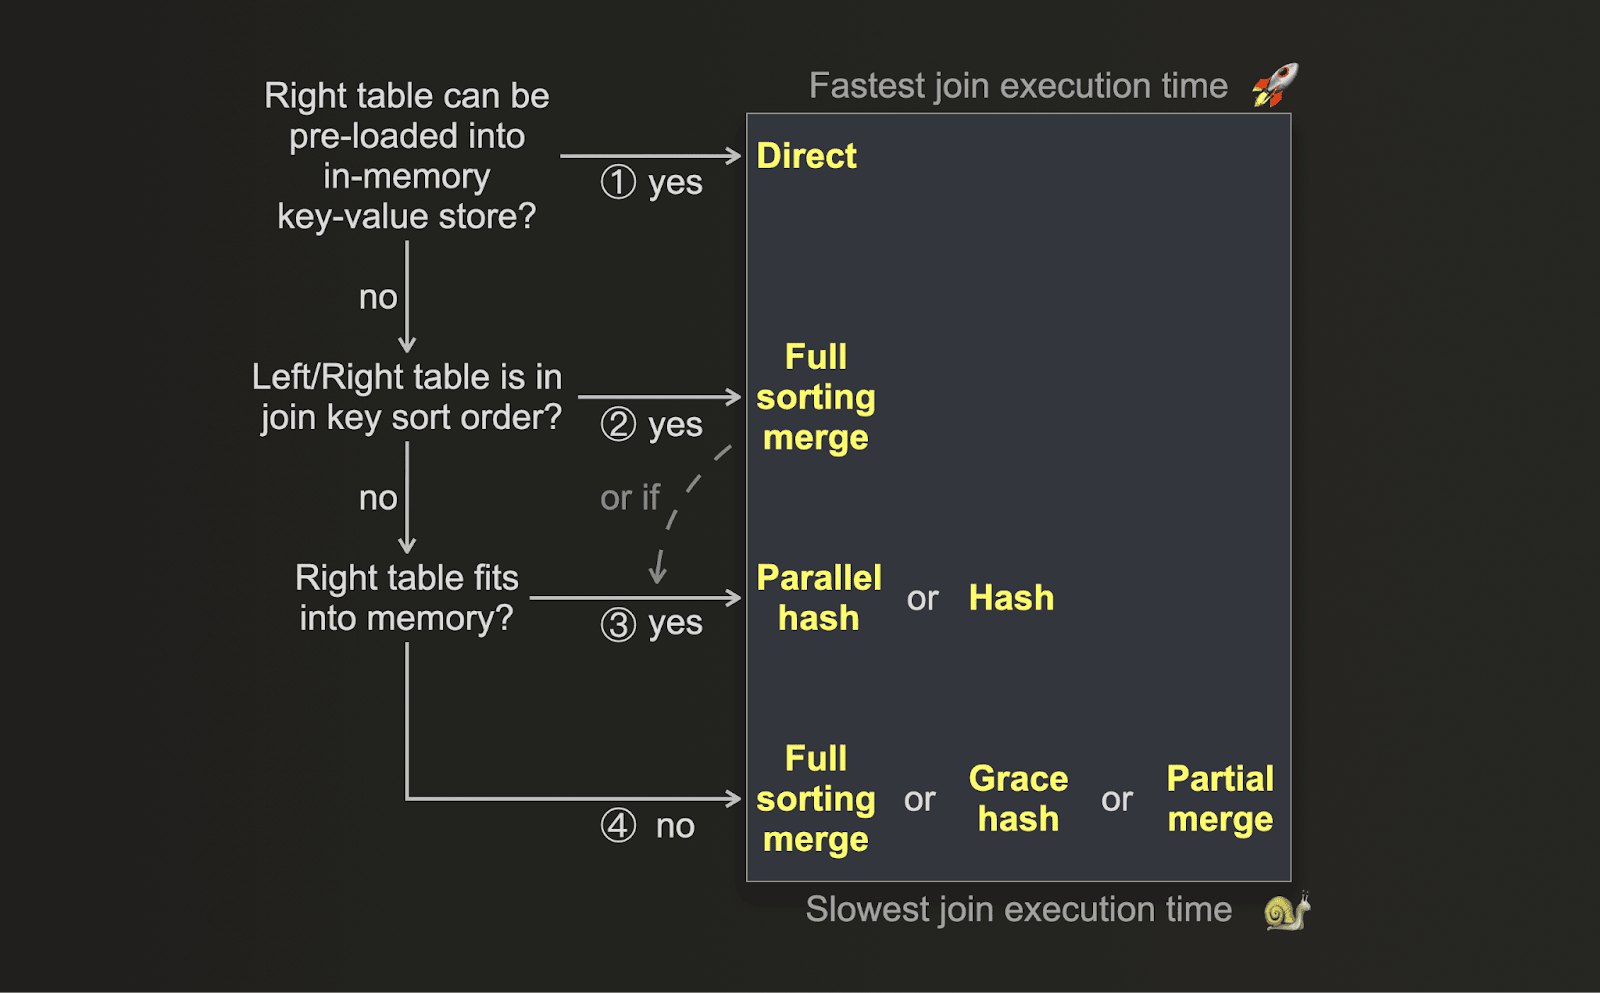
성능이 핵심 최적화 지표이고 조인을 최대한 빠르게 실행하려면, 다음 의사 결정 트리를 참고하여 적합한 조인 알고리즘을 선택할 수 있습니다.
-
(1) 오른쪽 테이블의 데이터를 딕셔너리와 같은 저지연 인메모리 키-값 데이터 구조에 미리 로드할 수 있고, 조인 키가 기반 키-값 저장소의 키 속성과 일치하며,
LEFT ANY JOIN의미 체계로 충분하다면 direct join을 적용할 수 있습니다. 대개 이 방법이 가장 빠릅니다. - (2) 테이블의 물리적 행 순서가 조인 키 정렬 순서와 일치한다면 상황에 따라 다릅니다. 이 경우 **전체 정렬 병합 조인(Full Sorting Merge Join)**은 정렬 단계를 건너뛰므로 메모리 사용량(memory usage)이 크게 줄어들고, 데이터 크기와 조인 키 값 분포에 따라서는 일부 해시 조인(Hash join) 알고리즘보다 실행 속도도 더 빠를 수 있습니다.
- (3) **병렬 해시 조인(parallel hash join)**의 추가 메모리 오버헤드를 감안하더라도 오른쪽 테이블이 메모리에 들어간다면, 이 알고리즘이나 해시 조인(Hash join)이 더 빠를 수 있습니다. 이는 데이터 크기, 데이터 타입, 조인 키 컬럼의 값 분포에 따라 달라집니다.
-
(4) 오른쪽 테이블이 메모리에 들어가지 않으면, 해시 조인(Hash join)과 병렬 해시 조인(parallel hash join)은
max_bytes_before_external_join또는max_bytes_ratio_before_external_join에 도달했을 때 grace hash로 전환하여 데이터를 디스크 유출(spill)할 수 있습니다. 전체 정렬 병합 조인(Full Sorting Merge Join)과 부분 병합 조인도 외부 저장소를 사용할 수 있습니다. 어떤 방식이 가장 빠른지는 데이터 양, 데이터 타입, 조인 키 컬럼의 값 분포에 따라 달라집니다.
grace_hash_join_initial_buckets 설정은 초기 버킷 수를 제어하며, 이를 통해 메모리 사용과 조인 속도 사이에서 균형을 조절할 수 있습니다.
디스크 기반 알고리즘 세 가지 중 어느 것이 가장 빠른지는 데이터 양, 데이터 타입, 조인 키 컬럼의 값 분포에 따라 달라집니다. 가장 빠른 알고리즘을 판단하려면 실제와 비슷한 규모의 데이터로 벤치마크를 실행해 보는 것이 가장 좋습니다.
메모리 최적화
가장 빠른 실행 시간보다 가장 낮은 메모리 사용량(memory usage)을 목표로 조인을 최적화하려면 다음 결정 트리를 참고하십시오.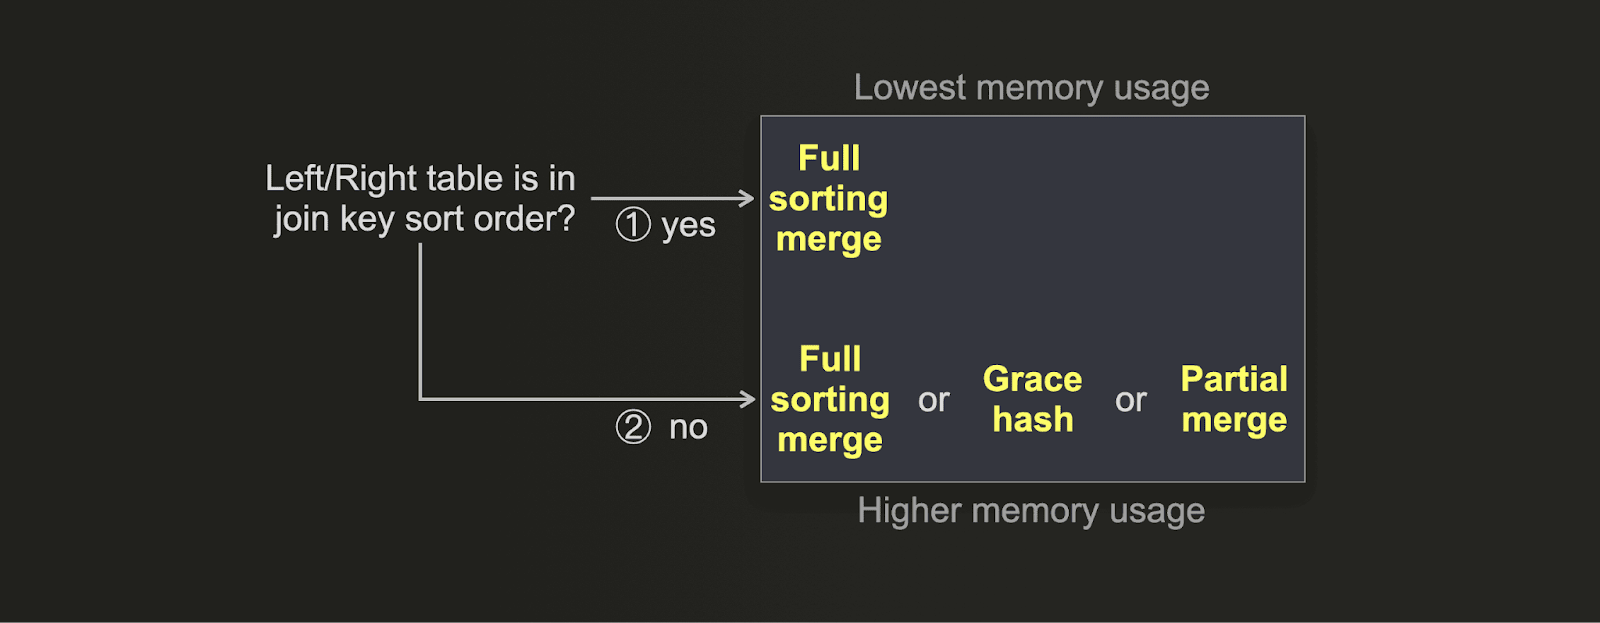
- (1) 테이블의 물리적 행 순서가 조인 키의 정렬 순서(sort order)와 일치하면 전체 정렬 병합 조인(Full Sorting Merge Join)의 메모리 사용량이 최소 수준으로 낮아집니다. 또한 정렬 단계가 비활성화되므로 조인 속도도 우수합니다.
- (2) 그레이스 해시 조인(grace hash join)은
grace_hash_join_initial_buckets값을 늘리면 조인 속도는 떨어지지만 메모리 사용량을 매우 낮게 조정할 수 있습니다. 부분 병합 조인은 설계상 주기억장치를 적게 사용합니다. 외부 정렬이 활성화된 **전체 정렬 병합 조인(Full Sorting Merge Join)**은 행 순서가 키 정렬 순서와 일치하지 않을 때 일반적으로 부분 병합 조인보다 메모리를 더 많이 사용하지만, 조인 실행 시간은 훨씬 짧습니다. 해시 조인(Hash join)과 병렬 해시 조인(parallel hash join)도 구성된 디스크 유출 임계값(spill threshold)에 도달하면 그레이스 해시로 전환하여 메모리 압력을 줄일 수 있습니다.
조인 최적화 예시
다음 예시에서는 Stack Overflow 데이터 세트를 사용하여 권장 사항을 단계적으로 적용합니다. 아래 측정값은 ClickHouse 26.8.1이 실행 중인 ClickHouse Cloud 서비스에서max_threads = 4로 설정하고 5회 실행한 결과의 중앙값입니다. 각 쿼리는 한 번씩 워밍업했고, 쿼리 실행 순서를 번갈아 바꾸었으며, use_query_cache와 use_query_condition_cache는 비활성화했습니다.
ANY INNER JOIN을 IN으로 대체하기
이 테스트에서 IN 쿼리는 2.7배 더 빨랐으며 최대 메모리 사용량은 83% 더 적었습니다.
이 쿼리는 본문에서 ClickHouse를 언급하지 않지만 ClickHouse를 언급하는 댓글이 하나 이상 달린 게시물의 수를 셉니다.
86을 반환합니다. 경과 시간의 중앙값은 27.101초, 최대 메모리 사용량은 970.01 MiB였습니다. 또한 1억 5,020만 개의 행(rows)과 51.77 GiB의 데이터를 읽었습니다.
이 쿼리는 일치하는 댓글이 존재하는지만 확인하면 됩니다. IN 서브쿼리를 사용하면 조인 결과를 생성하지 않아도 됩니다:
IN 쿼리도 86을 반환합니다. 경과 시간의 중앙값은 10.206초, 최대 메모리 사용량은 162.81 MiB였습니다. 이 쿼리는 1억 7,420만 개의 행과 19.02 GiB의 데이터를 읽었습니다.
조인을 대체하기 전에 양쪽 모두 필터링하기
이 테스트에서는 재작성(Rewrite)을 통해 경과 시간의 중앙값이 18%, 최대 메모리 사용량이 14% 감소했습니다. 이 쿼리는 2020년 이후 작성된 Java 관련 게시물의 추천(up-vote) 수를 집계합니다. 날짜 조건은 조인 전에 양쪽 입력 모두에 적용됩니다.261915를 반환합니다. 중앙값 경과 시간은 0.850초였고, 최대 메모리 사용량은 59.96 MiB였습니다. 또한 8,094만 개의 행(rows)과 1.13 GiB의 데이터를 읽었습니다.
각 투표에 대해서는 일치하는 게시물이 존재하는지만 확인하면 되므로, 양쪽 입력의 필터는 그대로 유지하면서 조인을 IN으로 대체할 수 있습니다.
IN 쿼리도 261915를 반환합니다. 경과 시간의 중앙값은 0.696초, 최대 메모리 사용량은 51.70 MiB였습니다. 읽은 데이터는 4,620만 개의 행, 817.49 MiB입니다.