5万

コストを抑えるためだけにトレースをサンプリングしていませんか?
クエリを実行可能にするために、カーディナリティの高いメトリクスをロールアップしていませんか?
すべてを保存するコストがまかなえないという理由だけで、ログの保持期間を制限していませんか?
これらのパターンはオブザーバビリティにおいてあまりにも一般的になり、ベストプラクティスとして扱われることさえあります。ベンダーは自社の欠点を隠すために、これらを機能として売り込んでいます。ClickHouse では、これらは単なる対症療法であり、利用するエンジニアのニーズではなく、背後にあるシステムの制約を反映したものにすぎないと考えています。
なぜ、SRE がどのデータを保持し、破棄し、集計すべきかを厳しく管理しなければならないような世界になってしまったのでしょうか。そしてさらに重要なのは、今後もこのままであり続ける必要があるのか、ということです。
本記事では、現代のオブザーバビリティを形作っている 3 つの制約として、保持期間、サンプリング、ロールアップを検証します。これらは中立的な設計上の選択肢などではなく、スケール、コスト、高カーディナリティデータに苦しむストレージエンジンや、その制約をユーザーに押し付ける SaaS プラットフォームによって課された限界なのです。
かつては、こうしたトレードオフも許容できるものでした。人間の運用担当者は、経験と直感によって失われたデータを補うことができたからです。しかし、その前提は崩れつつあります。実務担当者の少なくとも 90% が、異常の検知や根本原因分析の支援に AI を活用することに価値を見出している一方で、現在のシステムはそれをサポートするようには設計されていません。AI やエージェント主導のワークフローがオブザーバビリティの中核となるにつれ、サンプリング、集計、短い保持期間による弊害ははるかに大きくなります。自動推論に必要なコンテキストが奪われるだけでなく、実務担当者の 95% 以上が求めている、エージェントが自らの結論を根拠立てて説明することも難しくなります。
かつては受け入れられていた妥協が、今では積極的な足かせとなっています。自動診断と推論を支えられるシステムを構築するには、これらの制約を取り除かなければなりません。
これらを取り除くことができれば、トレードオフが減るだけでなく、根本的により優れたオブザーバビリティのモデルが実現します。死角がなくなり、解決までの時間が短縮され、次世代のエージェント主導ワークフローに必要な完全なコンテキストが手に入ります。
今すぐ始める
Managed ClickStack をオブザーバビリティデータにどのように活用できるかご興味はありませんか?数分で利用開始でき、300 ドル分の無料クレジットも受け取れます。
サインアップ保持期間:記憶にかかる税金
保持期間は、オブザーバビリティを利用する誰もが真っ先に考慮を求められる制約の 1 つです。そして、ほぼ機械的に検討されるようになります。ログはどのくらいの期間保管すべきか?トレースはどこまで遡る必要があるか?予算内に収まるか?
ある程度までは、これはもっともな話です。すべてのデータを無期限に保存する必要はありませんし、時間の経過とともにデータを期限切れにする正当な理由もあります。しかし問題は、保持期間の存在そのものではなく、それが最優先の関心事となってしまい、多くのチームが極端に短い期間への制約を強いられている点にあります。ログは 7 〜 14 日間しか保持されないことが多く、トレースはそのデータ量やカーディナリティの高さから、さらに厳しい扱いを受けがちです。
これはユーザーのニーズによるものではなく、システムの限界によるものです。多くのシステムはクエリ性能を確保するために SSD ベースのストレージに依存しており、圧縮率の低さと相まって、長期保持のコストを高騰させています。その結果、これらのコストは提供側で吸収されるか利用者に転嫁され、エンドユーザーは保持期間を予算管理の問題として扱わざるを得なくなっています。
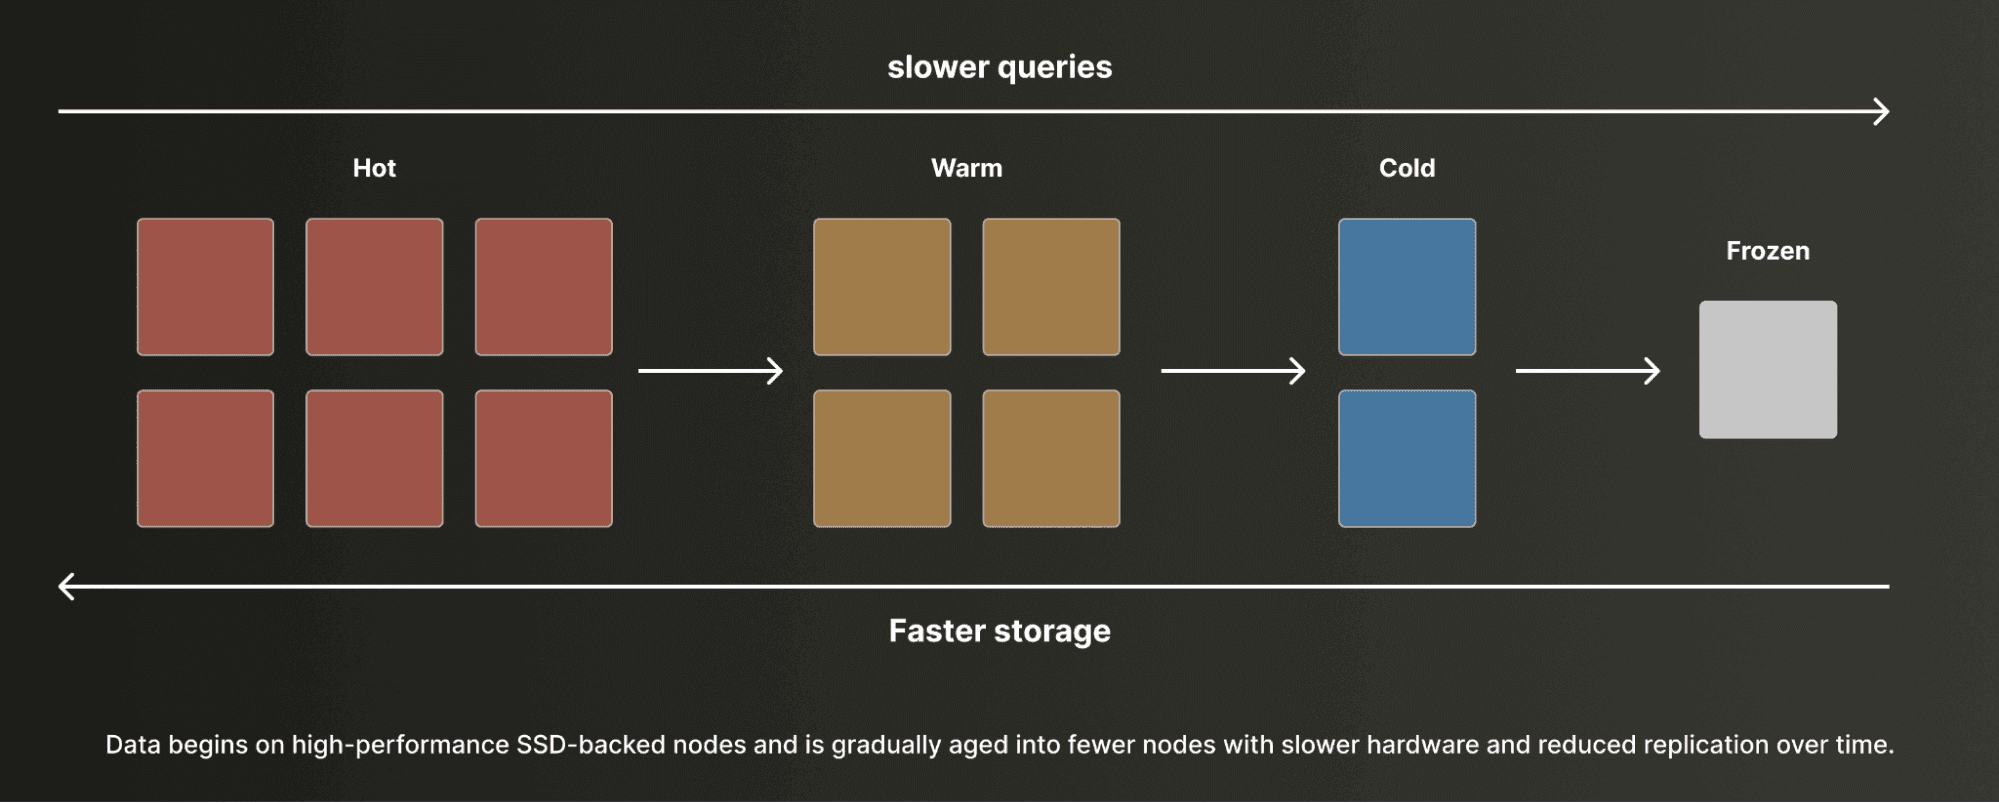
保持期間を延ばすために、チームは階層(ティア)を導入し、データをより安価で性能の低いストレージへと段階的に追い出します。これにより長期保持は可能になるものの、複雑さが増し、過去のデータをクエリする際にリハイドレーションやクエリの遅延が発生します。
しかし、本来そうあるべきではありません。高圧縮とオブジェクトストレージを活用すれば、経済性は一変します。オブジェクトストレージへ 1 GB あたり約 0.025 ドルで保存でき、そこに 50 倍の圧縮を組み合わせられれば、一般的なコストの何分の一かで元データを保持できます。30 日、60 日、あるいは 1 年間の保持がデフォルトであるべきです。データの期限切れは、コストの圧力ではなく、コンプライアンスやポリシーに基づいて判断されるべきです。
オブジェクトストレージの採用が、ストレージ階層の管理を意味するべきではありません。どのデータをホット、ウォーム、あるいはオブジェクトストレージへのアーカイブに回すかをユーザーが判断する必要はないはずです。すべてのデータは平等に取り込まれて扱われ、アクセス頻度の高いデータはクエリパターンに基づいて自動的に高速化されるべきです。階層の導入は根本的な問題を解決しないまま、何をどこに保存すべきかを常に考えさせることになり、複雑さと運用負荷を増やすだけにすぎません。
この制約を取り払うことは、単に運用負荷を減らすだけにとどまりません。まったく新しい働き方を可能にします。長期保持により、季節的なパターンや過去のリグレッション、これまで見落とされていた問題の分析が可能になります。1 つのログパターンを数か月分のデータにわたって遡ることで、バグが最初に発生した時期や影響を受けたユーザーを特定できます。
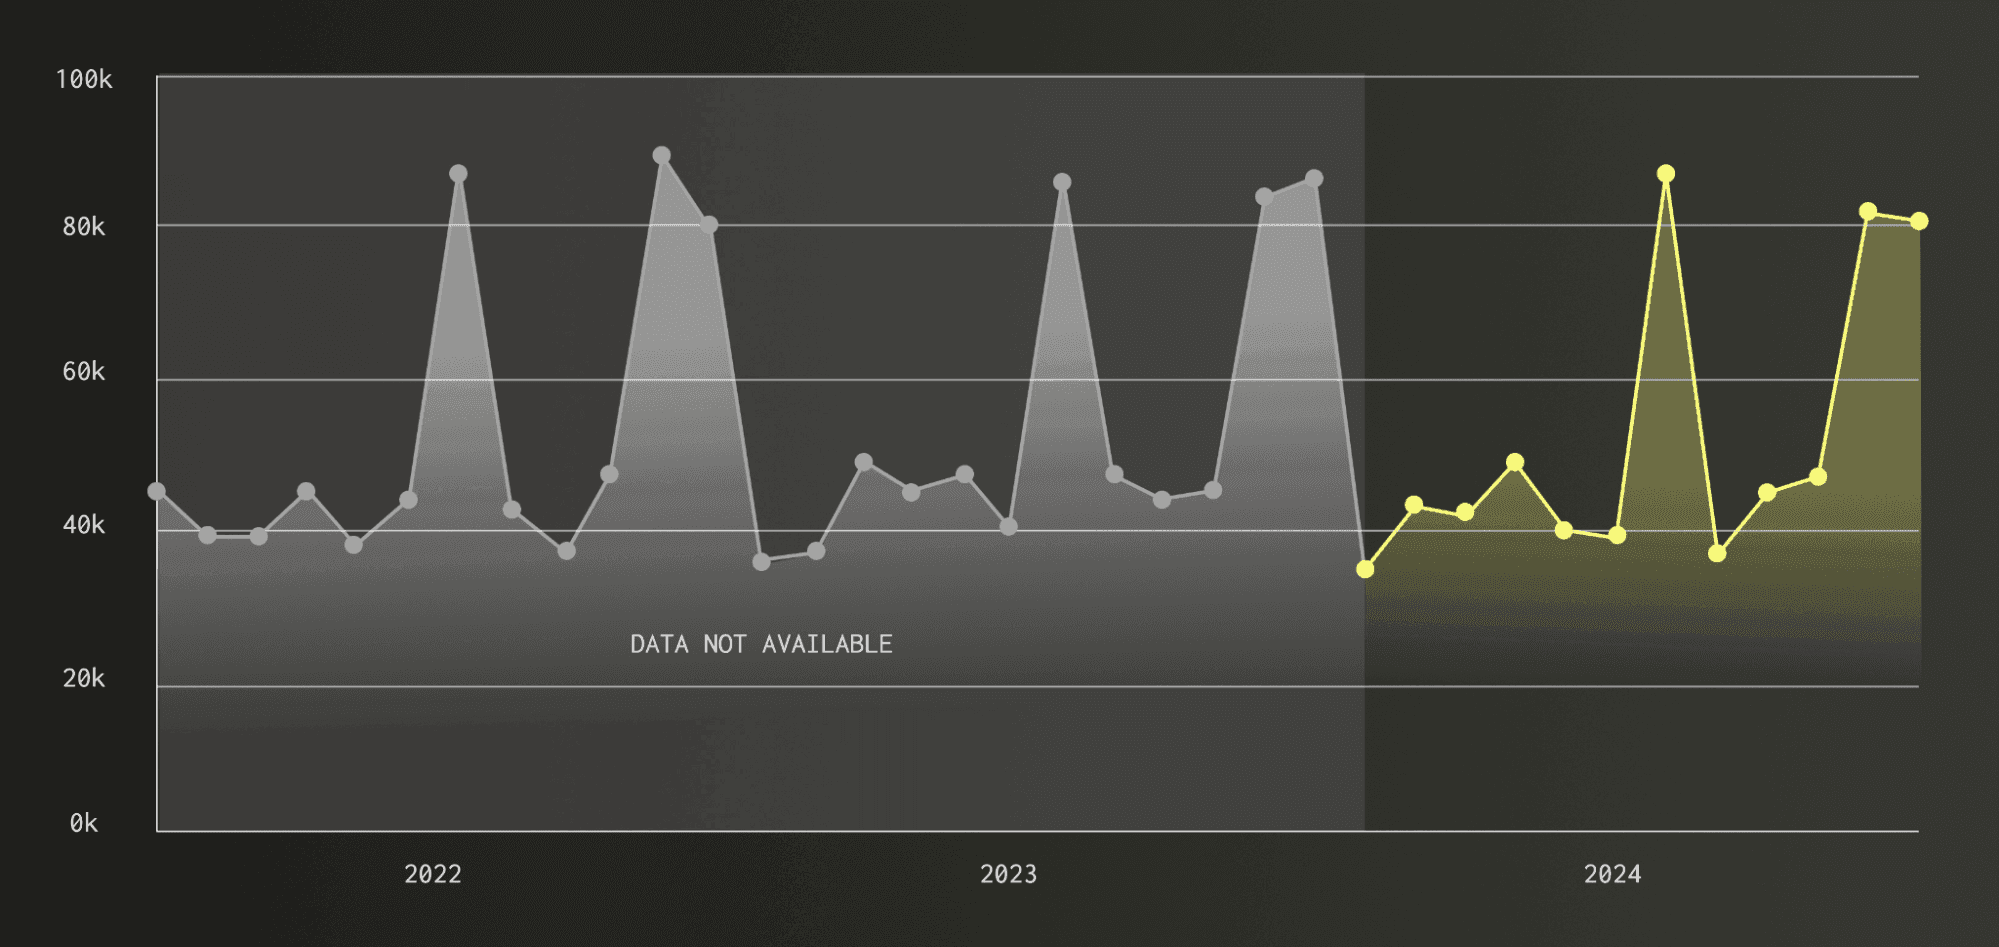
データが存在しない場合、エージェントが周期的なパターンを特定するのは困難です。
エージェントがオブザーバビリティのワークフローに組み込まれるにつれ、過去のコンテキストへのアクセスが極めて重要になります。人間のオペレーターは過去のインシデントやパターンに関する暗黙知を持っていますが、エージェントにはそれがありません。長期的なデータがなければ、異常と正常な動作を区別することも、トレンドを推論することもできません。保持期間を制限することは、可視性を下げるだけでなく、エージェントの機能そのものを制約してしまいます。
こうした理由から、保持期間は私たちの最初の「悪者」です。データを決して期限切れにしてはならないからではなく、基礎となるストレージシステムのコストが原因で、何を保持すべきかを判断する負担がユーザーに押し付けられているからです。
サンプリング:穴だらけのオブザーバビリティ
サンプリングは、意図的にデータを破棄し始める領域です。どこまで遡って確認できるかを制限する保持期間とは異なり、サンプリングは何をそもそも確認できるかを決定づけます。
最も一般的にはトレースに適用され、イベントのサブセットだけを選択的に残すことで機能します。これは通常、ヘッドサンプリングまたはテイルサンプリングのいずれかを使用して行われます。ヘッドサンプリングはトレースの開始時点で判断を下し、トレースが完全に観測される前に保持するか破棄するかを決定します。テイルサンプリングはその判断をトレースが完了するまで保留し、明示的にエラーとラベル付けされたものやレイテンシの高いものなど、特定の基準を満たすトレースをシステムが保持できるようにします。テイルサンプリングの方が多くの情報に基づいているとはいえ、どちらの手法も最終的にはデータを破棄します。たとえば、論理的な問題を示しているもののエラーとして明示的にラベル付けされていないデータを見逃す可能性があります。同じパターンはロギングにも現れ、エラーログは保持される一方で、データ量の多い info ログはサービスごとに選択的に削減されることがあります。
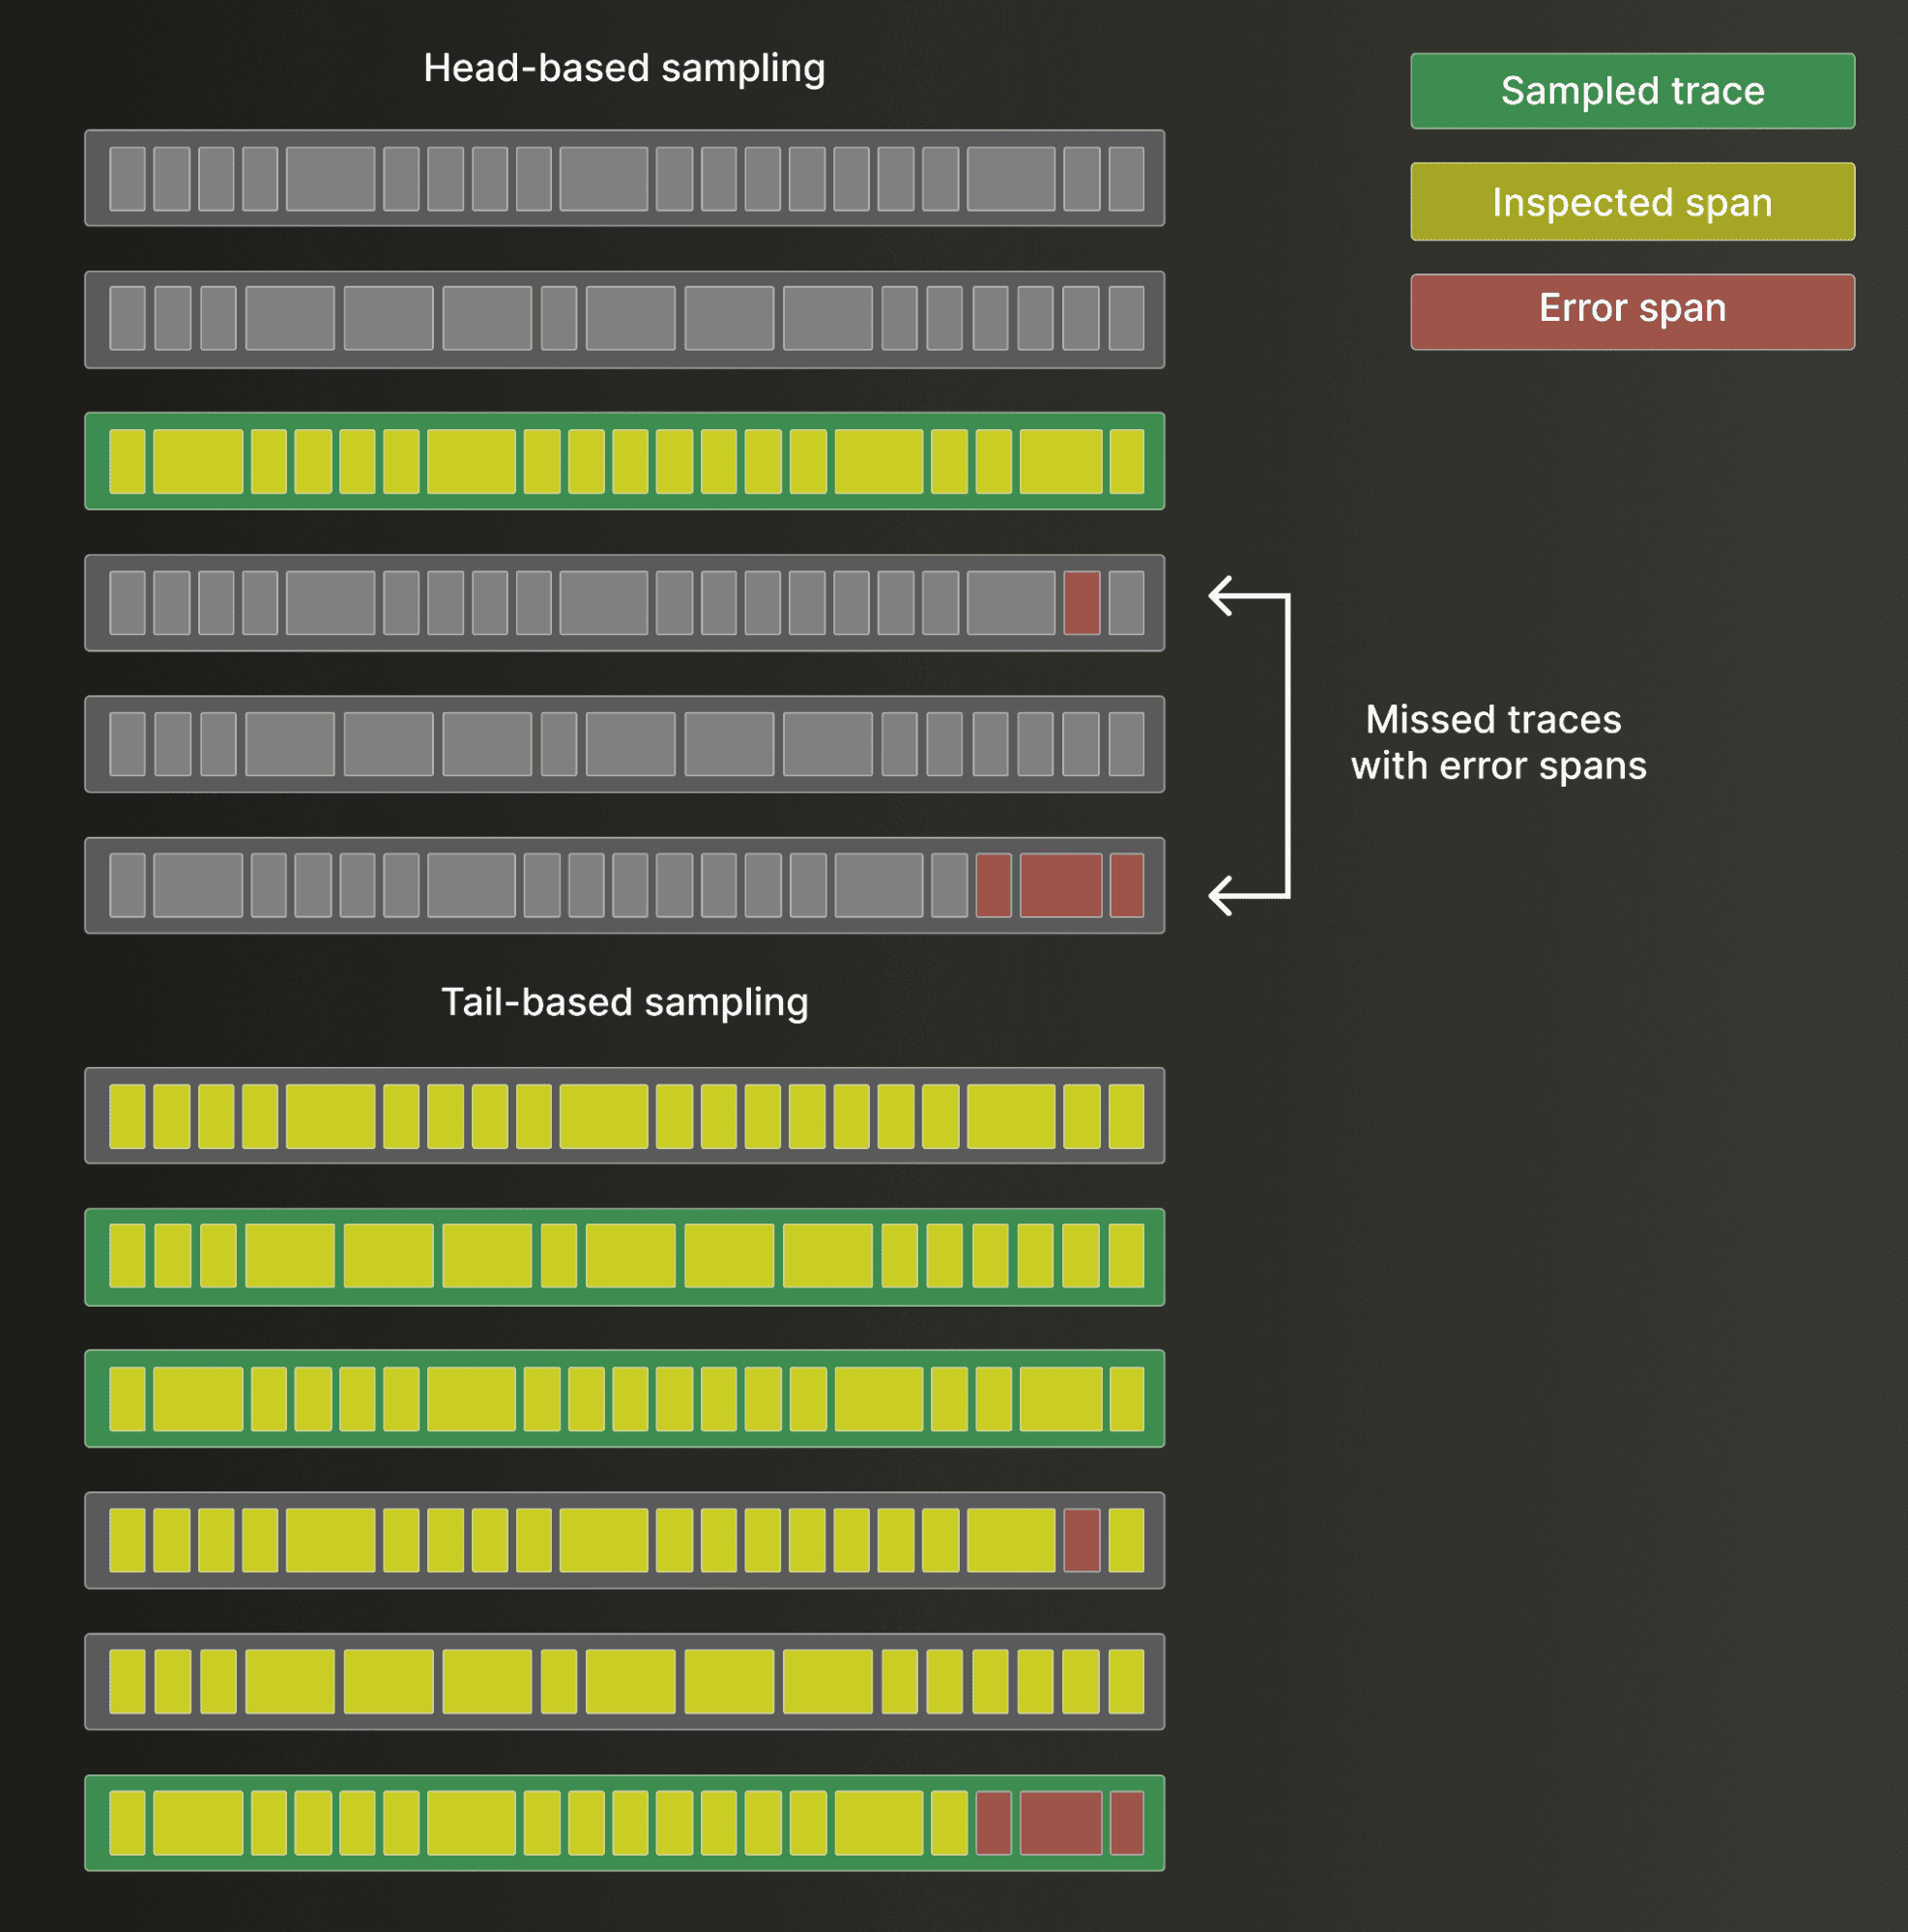
ヘッドベースのサンプリングは事前に(決定論的またはランダムに)トレースを選択するため、重大なエラーを含むトレースを破棄してしまう可能性があります。一方、テイルベースのサンプリングはすべてのスパンを待ってから、問題のあるスパンの保持を優先します。テイルサンプリングの方がより情報に基づいているものの、どちらのアプローチもデータを破棄することに変わりはなく、重要なシグナルを失うリスクを抱えています。
その目的は明快です。サンプリングは書き込まれるデータ量を減らし、ストレージ要件を引き下げ、クエリ時にスキャンされるデータ量を最小限に抑えます。そうすることでコストを抑制します。しかし保持期間と同様に、これはユーザー主導の最適化ではなく、システムによって課された制約であり、何を残す価値があるかを判断する負担が再びユーザーに転嫁されています。
多くの点で、サンプリングは保持期間よりもさらに制約的です。保持期間が短くても、その期間内であれば利用可能なデータは完全です。対照的に、サンプリングは取り込みの時点で忠実性を奪ってしまいます。
この忠実性の喪失は、より広範な影響を及ぼします。現代のオブザーバビリティは、ログ、メトリクス、トレースを統合した「ワイドイベント」と呼ばれる、リッチで高カーディナリティなイベントへの依存度を高めています。これらは、より深い分析やトレンドの検出、時間経過に伴う正確な推論を可能にします。サンプリングはこのモデルを崩してしまいます。イベントを間引くことで、集計結果を歪め、統計的な精度を損ない、有意義な分析を行う能力を制限します。
サンプリングされたメトリクスを外挿することで近似結果を得ることは可能です。多くの単純な集計タイプではこれで十分ですが、他のタイプでは難しく、ユーザーは常に推計値に頼らざるを得なくなります。
保持期間と同様に、これもエージェントの有効性を制約します。完全なデータがなければ、エージェントはパターンを確実に検出することも、シグナルを関連付けることも、異常について推論することもできません。また保持期間と同様、かつては許容できたトレードオフが、今や決定的な制約となっています。
理想的なシステムでは、効率的な圧縮と低コストなストレージによって、すべてのイベントが完全な忠実性で保持されるべきです。これにより、問題が発生した際に完全なコンテキストを確実に利用できるようになります。その結果はエンジニアにとっての迅速な解決にとどまらず、人間にとっても次世代のエージェント主導のワークフローにとっても、より深く正確な分析を支えられるシステムをもたらします。
ロールアップ:集計の罠
ロールアップは、Prometheus などのメトリクスシステムが抱える課題の 1 つである「高カーディナリティ」への現実的な対処法として登場しました。
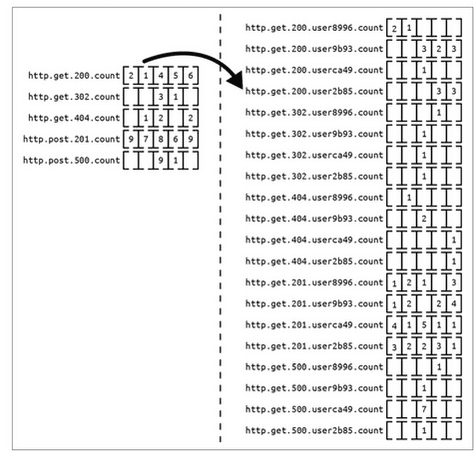
高カーディナリティは系列の爆発(シリーズエクスプロージョン)を引き起こします。 出典:『Observability Engineering: Achieving Production Excellence』第 16 章「Efficient Data Storage」
ここで「高カーディナリティ」という用語を簡単に定義しておきましょう。時系列データベースにおいて、カーディナリティとは
hostなどのラベルの組み合わせによって作成される一意な時系列の数を指します。たとえば HTTP GET リクエスト数のメトリクスには、host、service、endpoint、status_codeなどのラベルが付与されることがあります。それぞれの一意な組み合わせが独立した系列となります。これらのディメンションが増加するにつれて、系列の数は極めて急速に増大する可能性があります。上図のように、ユーザー ID などの高カーディナリティなラベルは、それ単体で系列の爆発を引き起こしかねません。
ここに時系列モデルの限界が現れ始めます。Prometheus のようなシステムは、寿命の長い適度な数の系列であればうまく機能しますが、メモリ上、ディスク上、およびクエリ時において、一意な系列ごとにオーバーヘッドが発生します。container_id や pod_id のように寿命が短く高次元なラベルは、新しい系列とチャーン(頻繁な入れ替わり)を絶え間なく生み出すことで、この問題を増幅させます。
その負荷が、ロールアップへの移行を直接促します。ユーザーは収集するディメンションの数を減らして死角を生じさせるか、あるいは保存やクエリがしやすいように粗い粒度へとメトリクスを事前集計します。ベンダー側もアクティブな系列数に基づいた課金を行うことでこの力学を助長し、データストアのアーキテクチャ上のコストを顧客へ直接転嫁しています。その結果、**チームは自分たちが何を観測したいかよりも、**メトリクスのバックエンドがどこまで耐えられるかを気にするよう追い込まれます。
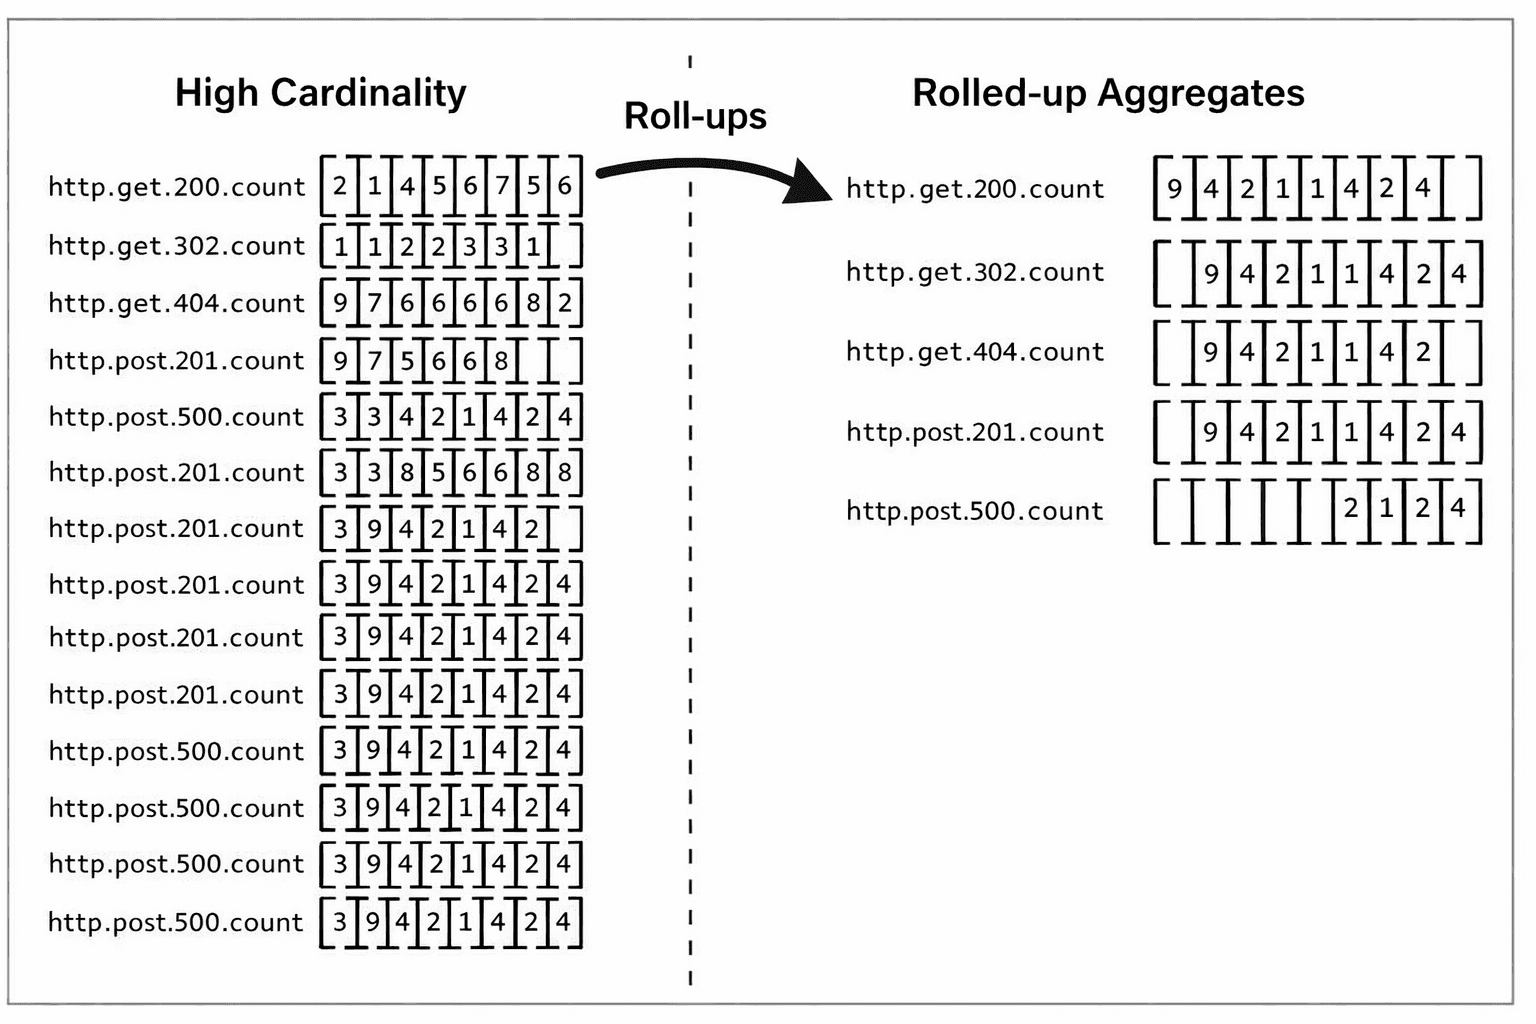
ロールアップは、多数の詳細な系列をより少数の粗いメトリクスへと集計することで高カーディナリティデータを削減し、粒度の細かいコンテキストを失う引き換えに効率を向上させます。
ロールアップはストレージとクエリ性能の両方に役立ち、上位レベルの集計への応答を容易にするため魅力的に映ります。しかし、それには重大な代償が伴います。インシデント時に最も重要となる問いは事前に予測できず ad hoc なものであることが多いにもかかわらず、日常的な想定利用に基づいて、後からどんな質問をしたくなるかを事前に決めておかなければならないのです。一度データがロールアップされてしまうと、元の忠実性は失われます。集計が粗すぎたり、誤ったディメンションを除外してしまったりした場合、それらを取り戻す方法はありません。その結果、計測の不足ではなく、ストレージ層の限界を補う必要性によって生じる、もう 1 つのオブザーバビリティの死角が生まれます。
この問題は、エージェントがワークフローの一部となることでさらに悪化します。顧客 ID ごとにメトリクスをドリルダウンする機能など、重要なディメンションが欠落している場合、エージェントは単に行き詰まってしまいます。問題を切り分けるために必要なシグナルがもはや存在しないためです。人間とは異なり、エージェントには直感も代替手段もありません。
これこそが、ロールアップを「悪者」たらしめている理由です。ロールアップはスマートな最適化として提示されることが多いものの、多くの場合、忠実性を保った大規模データに対処できないバックエンドのための回避策にすぎません。本来であれば、ユーザーはそもそもカーディナリティについてあれこれ頭を悩ませる必要がないはずです。リッチで高次元なテレメトリをそのまま保存し、システムを成立させるための前提条件としてではなく、既知のクエリを高速化するのに真に役立つ場面に限定してロールアップを使用すべきです。
より優れたモデルは実現可能です。ストレージエンジンが高カーディナリティデータを効率的に処理できれば、ロールアップは必須の基盤ではなく、一部のワークフローを選択的に高速化するためのオプションのツールとなります。それは妥協や死角が減ることを意味し、デバッグや分析、そしてエージェント主導の推論に必要な完全なコンテキストを維持できるシステムをもたらします。
悪者たちが手を組むとき
保持期間、サンプリング、ロールアップのそれぞれが、単独でも全体像の一部を削ぎ落とします。そしてデータがサンプリングされ、集計され、最終的に破棄されるにつれて損失は複合化し、残されるのは元のシグナルではなく、過度にフィルター処理された姿にすぎなくなります。システムは単にデータを失っただけでなく、コンテキストを失ってしまったのです。
この重層的な損失は、脆弱なオブザーバビリティモデルを生み出します。事前に予期していなかった問いには、往々にして答えることができません。根本原因の分析は、各段階を運よく生き残ったデータに制約され、推測頼みになります。人間のオペレーターにとっては、調査の長期化を招き、直感やシステムへの理解に頼らざるを得なくなります。解決までの時間は遅れるものの、対応自体は可能です。
しかしエージェントにとっては、はるかに深刻です。頼るべき予備知識を持たないため、コンテキストの欠落は完全な停止を意味します。これら 3 つの制約が重なることで、単に可視性が低下するだけでなく、システムを理解し運用する能力に根本的な限界がもたらされます。
オブザーバビリティのあるべき姿
それでは、保持期間、サンプリング、ロールアップは完全に姿を消すべきなのでしょうか?必ずしもそうではありません。しかし、その役割は根本的に変わる必要があります。それらはシステムの設計やデータ収集を縛る主要な制約ではなく、コストやアーキテクチャの限界によって強いられるデフォルトでもなく、意図的に適用される選択制の最適化であるべきです。
ロールアップは、特定のクエリを高速化したり、一般的な集計へ迅速にアクセスしたりするために使用される場合には価値がありますが、元データの代わりではなく、元データと並行して存在するべきです。パフォーマンスと忠実性の二者択一になってはなりません。完全な解像度のデータは常に保持されるべきであり、ロールアップはシステムの基盤としてではなく最適化レイヤーとして機能すべきです。
同じことがサンプリングにも当てはまります。特定のイベントやログが付加価値をほとんど生まないと分かっており、それらを削減できるケースはあるでしょう。しかしこれはデータ自体に基づいた十分な情報による判断であるべきで、ストレージや処理能力の制約に起因する必然であってはなりません。デフォルトでは、システムは完全なトレースとイベントをキャプチャし、最も重要な瞬間に何も失われないよう完全な忠実性を維持するべきです。
保持期間も同じ原則に従います。長期保存がデフォルトであるべきであり、それが意思決定を左右しないほど低コストであるべきです。保持ポリシーは、ストレージを無理に抑え込む必要性からではなく、コンプライアンスや実際のビジネス要件に基づいて定められるべきです。
カラムで悪者を打ち倒す
悪者たちを打ち倒すには、そもそも完全な忠実性と高カーディナリティを持つデータを経済的に扱えるストレージモデルが必要です。
ここで状況を一変させるのが列指向ストレージです。オブザーバビリティのワークロードは本質的に分析用途(アナリティカル)であり、構造化または半構造化された大規模なイベントストリームを取り込み、時間、サービス、ユーザー、コンテナ、リージョンを横断してフィルタリング、集計、相関分析を行う能力が求められます。
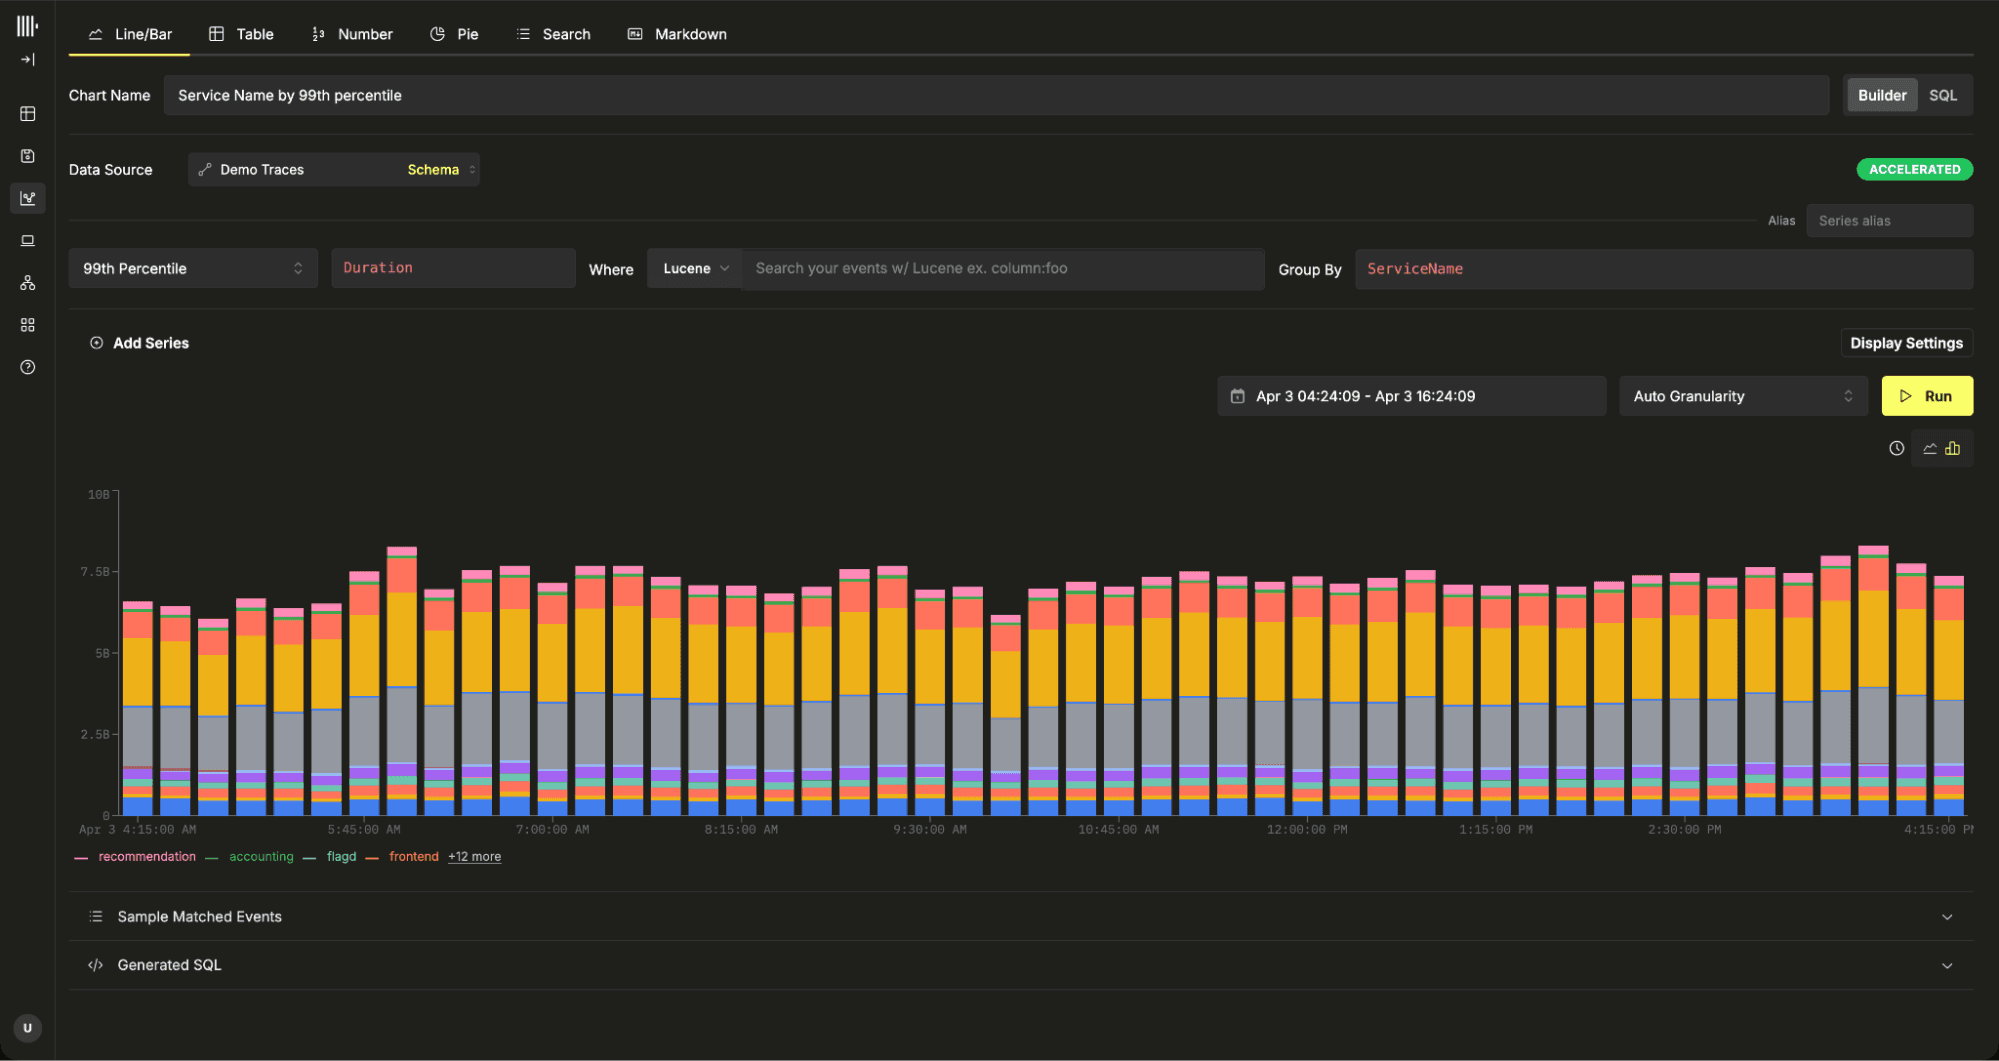
オブザーバビリティは本質的に分析データの課題であり、グラフ作成のための集計を必要とします
列指向ストアは、まさにこのパターンのために作られています。各カラムが個別に保存されるため、クエリは必要なフィールドのみを読み取ります。これにより I/O が大幅に削減され、大規模なデータセットに対する集計が、行指向や検索主導のシステムと比べてはるかに高速になります。
列指向データベースは各カラムを個別に格納し、高い圧縮率を実現するためにそれらをソートします
列指向ストレージは、オブザーバビリティデータを極めて効率的に圧縮します。重複する値や規則的な並びパターンにより、従来のアプローチと比べてはるかに高い圧縮率を実現できます。オブジェクトストレージと組み合わせることで、長期保持が経済的に見合うものになります。チームは保持期間を常に予算との兼ね合いでやりくりする代わりに、未加工のデータをはるかに長く保持できるようになり、システム上の制約からコンテキストの削除を強いられるのではなく、コンプライアンスやガバナンスを理由として期限切れポリシーを運用できるようになります。
各カラムを個別に扱うことで、カーディナリティの高さによる影響を局所化できます
同じアーキテクチャは高カーディナリティの課題にも役立ちます。一意なラベルの組み合わせごとにシリーズ単位の重い構造を作成・保持する時系列システムとは異なり、列指向ストアは各フィールドを個別に分離します。userId のような高カーディナリティなカラムは圧縮効率が低下する可能性がありますが、その影響はそのカラム自体にとどまり、データセットの残りの部分には波及しません。これにより、ユーザー ID、リクエストパス、モデルバージョンといったフィールドを、避けるべき制約ではなくクエリの単なる追加ディメンションとして扱いながら、高次元データ全体で効率的なフィルタリングや集計が可能になります。
列指向システムはカーディナリティを排除するわけではなく、コストの一部をクエリ実行時にシフトさせます。
container_idのような高カーディナリティなディメンションで集計を行うと、数百万ものグループを作成する必要が生じる場合があり、ディスクスピルなどの技術を用いても計算コストが高くなります。ただし、これはオブザーバビリティにおいて一般的なアクセスパターンではありません。実際の運用では、数百万の個別シリーズを可視化したり集計したりする必要はめったにありません。大半のワークフローは、フィルタリングされたサブセット、上位 N 件(top-N)の結果、または集約されたビューを対象とするため、このような最悪のケースのクエリは一般的ではなく例外的なものにとどまります。
このアプローチは、ロールアップとサンプリングの位置づけも変えます。既知のアクセスパターンを高速化する上でロールアップには依然として価値があり、本質的に価値の低いデータに対するサンプリングも理にかなっています。しかし、どちらもシステムの基盤である必要はありません。未加工で忠実度の高い生データを保持し続け、ロールアップやサンプリングはピンポイントの最適化手段としてのみ利用できます。これは、システムを手頃なコストに抑えたり実用的に保ったりするためだけにこれらの手法が必須とされがちな、現代のオブザーバビリティスタックとは根本的に異なるモデルです。
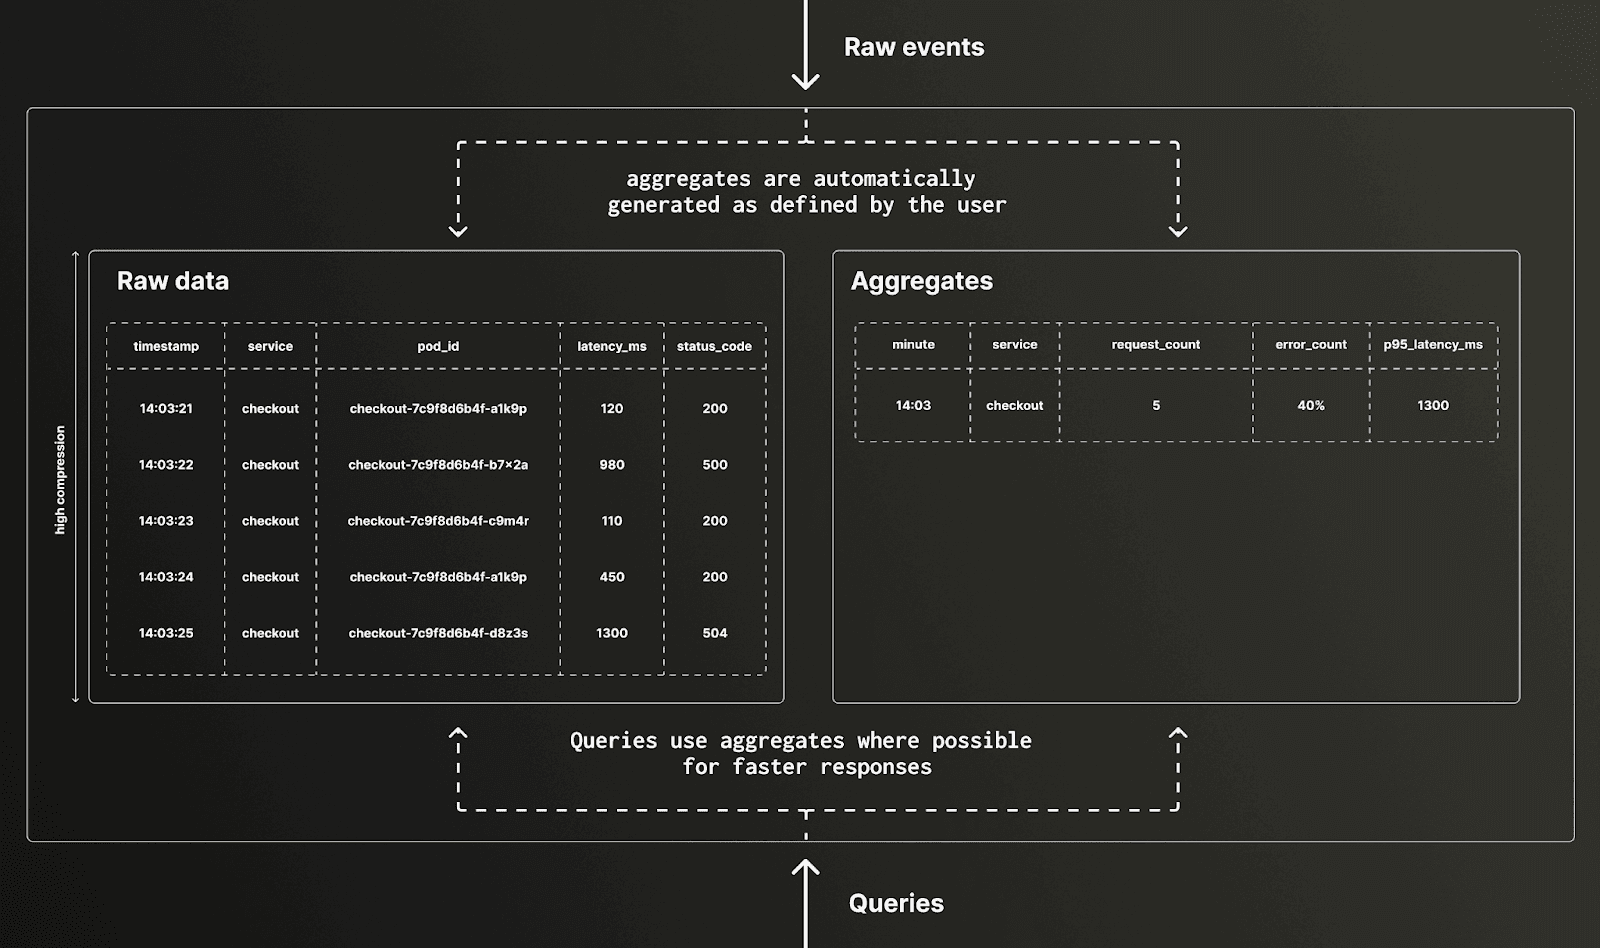
ClickHouse が最も適している理由
これらの課題に対処できる列指向データベースは ClickHouse だけではありません。Apache Pinot や Apache Druid といったシステムもアーキテクチャ上の利点の多くを共有しており、いずれも大規模な分析ワークロードの実行基盤として成功を収めています。しかし、オブザーバビリティの領域において、ClickHouse はリアルタイム性を重視している点で際立っています。
スパースプライマリインデックスにより、オブザーバビリティのアクセスパターンに合致した効率的なフィルタリングが可能となり、並列実行エンジンによって大規模データセットにまたがるクエリをスケールアウトできます。スキッピングインデックスと全文検索のサポートがこれらの機能を拡張し、探索的なワークフローを可能にします。
ClickHouse のスパースなプライマリインデックスは、カラムの整列構造を活用して広範囲のデータをスキップし、スキャンが必要なデータ量を大幅に削減します。
ClickHouse のストレージアーキテクチャは、オブジェクトストレージとコンピュートとストレージの分離をネイティブでサポートしています。列指向の圧縮と組み合わせることで、需要に応じてコンピュートを個別にスケーリングしながら、大量のデータを低コストで保持できます。極めて重要なのは、このモデルによってストレージ階層の必要性が完全に排除される点です。すべてのデータは一律に扱われ、クエリパターンに基づいてキャッシュ経由で頻繁にアクセスされるデータが自動的に高速化されます。これにより、ユーザーがホット、ウォーム、アーカイブのどの階層に配置すべきかを判断することなく、ホットデータが効率的に提供されます。結果として、ユーザーは階層の管理や階層間でのデータ移動という運用のオーバーヘッドなしに、すべてのデータで一貫したパフォーマンスと機能の同等性を享受できます。
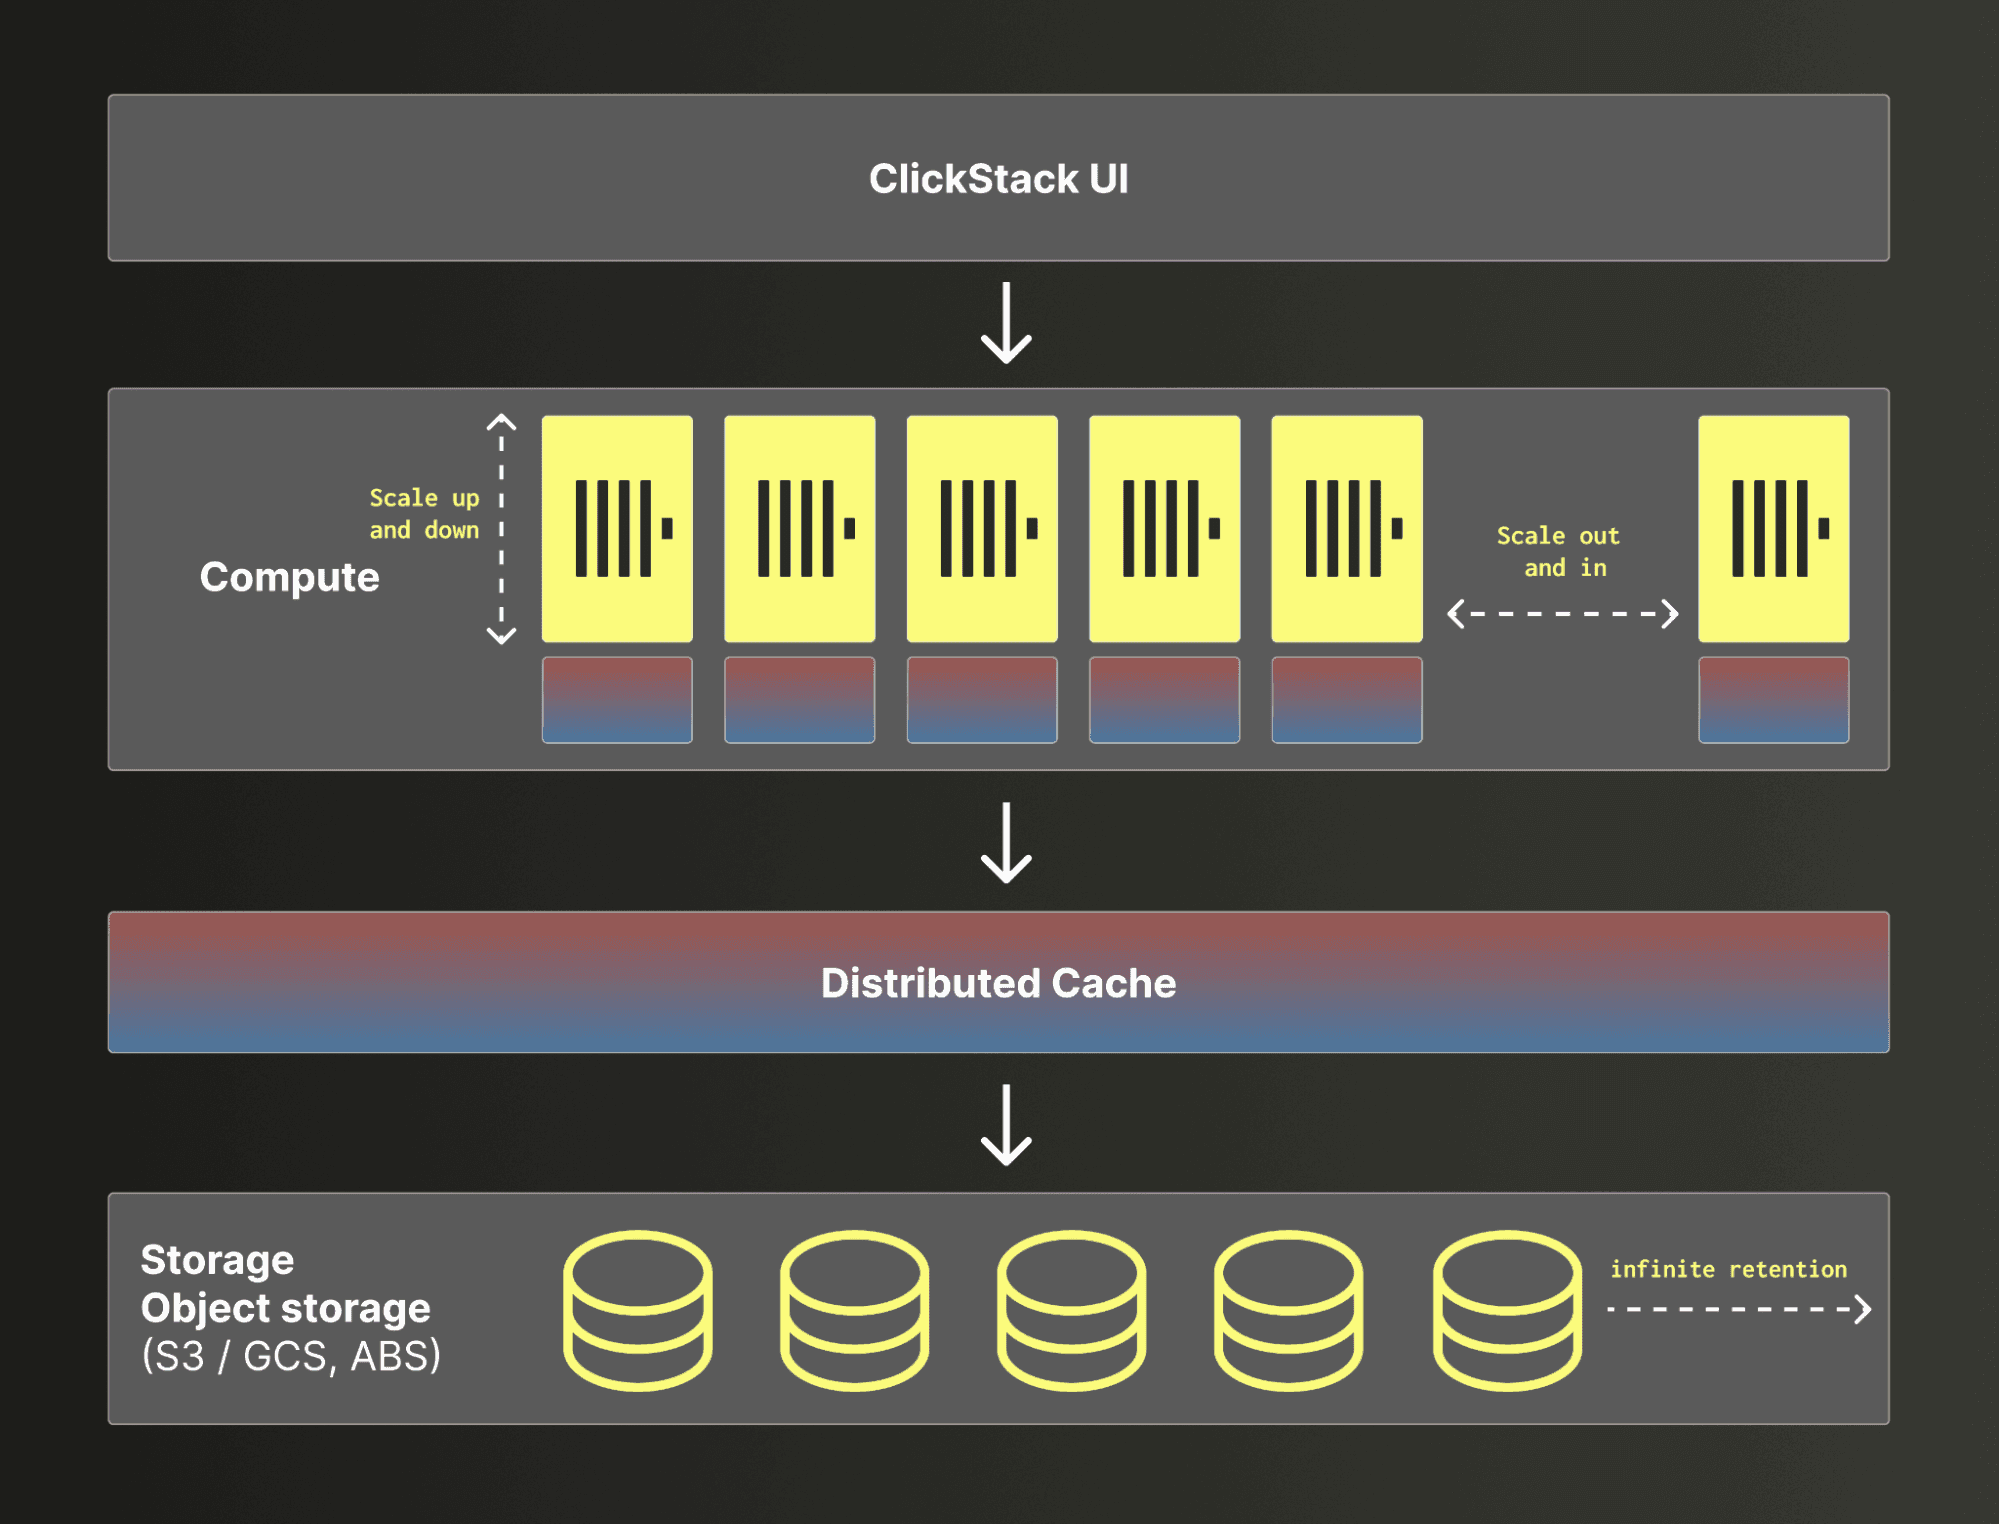
ClickHouse Cloud のインテリジェントな分散型およびノードレベルのキャッシュは、頻繁にアクセスされるデータを自動的に高速化し、時間などの基準に基づく手動のデータ階層化を必要とすることなく、一般的なクエリや重要な調査パスを迅速に処理できるようにします。
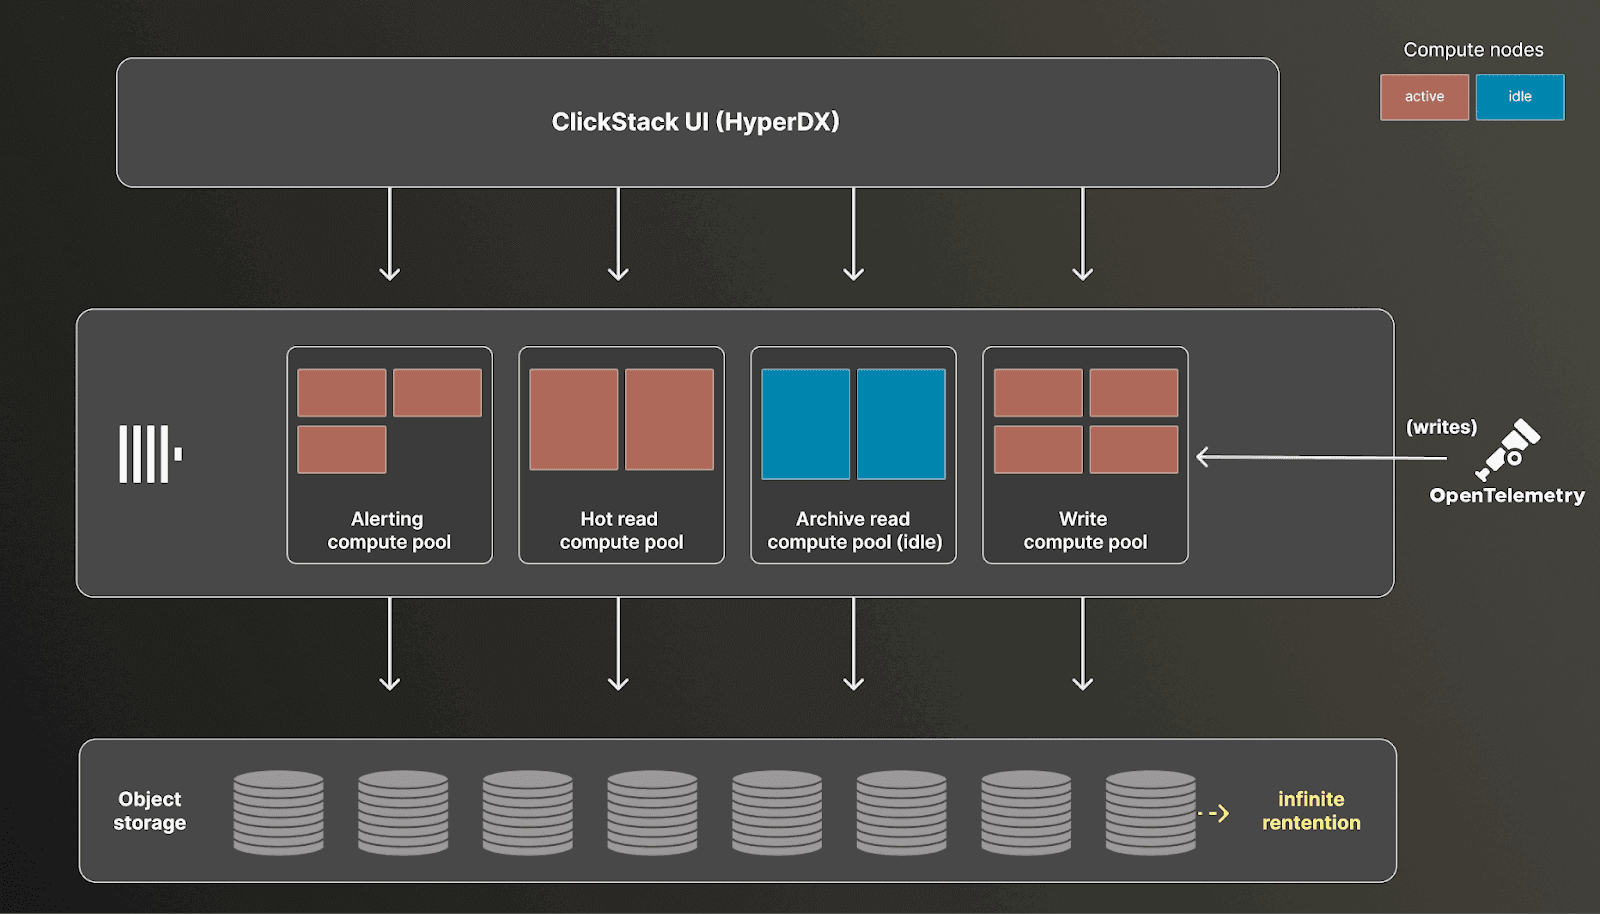
ユーザーは、取り込み、クエリ、調査、アラートなどの特定のワークロード向けに専用のコンピュートプールをプロビジョニングすることもでき、それぞれを個別にサイズ調整および最適化できます。これにより、ピーク時のプロビジョニングではなく実際の使用量に合わせてリソースを調整し、全体的なコストを削減できます。使用していないプールはアイドル状態にしてコストを発生させず、必要なときにだけアクティブにできます。
これらの機能は、大規模なオブザーバビリティの導入ですでに実証されています。Tesla、Anthropic、OpenAI、Character.AI などの企業は、ペタバイト規模のオブザーバビリティデータの分析に ClickHouse を活用しており、現代のワークロードの需要に応えるその能力を証明しています。
今後の展望 - 列指向のパワーによる完全なコンテキストを備えたエージェント
では、長期保存が可能になり、ロールアップが選択的になり、サンプリングが任意になった世界はどうなるでしょうか。
保持できるデータの管理に頭を悩ませる代わりに、データへのアクセス方法と活用方法の最適化に注力できるようになります。特に、エージェントがオブザーバビリティのワークフローに積極的に関与するようになると、高い同時実行性能が不可欠になります。これらのシステムは人間よりもはるかに多くのクエリを発行し、高速で一貫した応答を期待します。極めて重要なのは、エージェントが基盤となるデータストアによってボトルネックに陥らないようにすることです。それどころか、ボトルネックにならずに必要な同時実行性でクエリを処理できるシステムが必要となります。
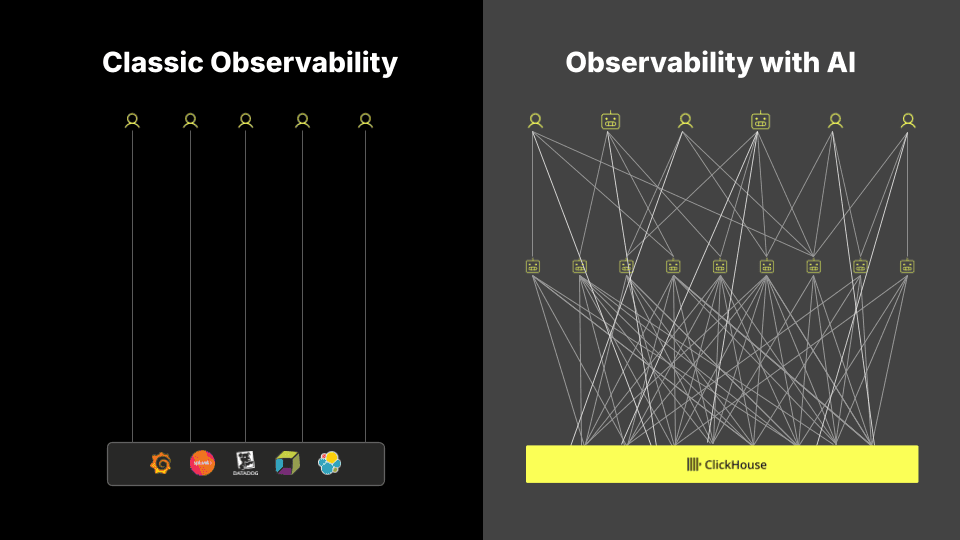
レイテンシも新たな重要性を持ちます。エージェント型のループは、最も遅いステップと同じ速度でしか動作しません。クエリの応答に数秒かかると、推論プロセス全体が遅くなり、インタラクションの応答性と有効性が低下します。オブザーバビリティはインタラクティブなワークフローではなくバッチ処理のようになってしまい、人間とエージェントの双方が求める運用方法と根本的に矛盾します。
同時に、raw データだけでは不十分です。エージェントは、際限のないログやトレースをただ取り込んで効果的に推論することはできません。高速で構造化された要約が必要です。そのため、データベース自体に要約処理をプッシュダウンする手法とともに、強力で低レイテンシな集約が不可欠になります。ログクラスタリング、パターン検出、高速なグループ化といった機能が第一級の要件となり、システムが大量のデータを意味のあるシグナルへ迅速に抽出できるようになります。
同じくらい重要なのがオープン性です。ここでのオープン性とは、SQL などの標準的で表現力豊かなインターフェースを介してデータストアの全機能を公開することを意味します。独自仕様のクエリ言語や制約の多い API に依存するのではなく、ユーザーとエージェントが基盤となるデータモデルと直接やり取りできます。LLM はすでに SQL の生成に非常に長けているため、ドメイン固有の構文を学習するためのカスタムトレーニングや追加のコンテキストの必要性が減るという点で、これは重要です。
同時に、一般的なワークフローにおいては明確に定義されたエンドポイントとツールが引き続き重要であり、頻出クエリに対して安定的かつ効率的なアクセスパターンを提供します。ただし、これらを唯一のインターフェースにすべきではありません。エージェントが生の SQL にフォールバックできる機能は極めて重要なエスケープハッチとして機能し、より詳細な内省や真のアドホックな調査を可能にします。
ここでリアルタイム分析向けに設計されたシステムが強みを発揮し、設計の一部としてこれらの特性を自然と備えています。例えば ClickHouse は、高い同時実行環境で低レイテンシの SQL 集約を提供するように最初から構築されています。保持期間、サンプリング、ロールアップの制約が取り除かれれば、これらの特性が次世代のオブザーバビリティの基盤となり、完全なデータに対する速度、規模、推論を最適化します。
まとめ
オブザーバビリティは、コストとパフォーマンスのために忠実度を犠牲にせざるを得ない制約によって形作られてきました。エージェント主導の未来へと移行する中で、そうしたトレードオフはもはや容認できません。これらの制限を取り除き、完全な忠実度のデータ向けに構築されたアーキテクチャを採用することで、妥協の管理から真の理解の実現へと移行できます。これこそが、システムが完全なコンテキストで推論し、調査し、行動できるエージェント型オブザーバビリティを最終的に切り拓く鍵となります。