5万

概要
本記事では、新しいアプリケーションパターンとして、Postgres のデータの一部を ClickHouse にオフロードするアプローチを探ります。データサイズが増加するにつれて、アプリケーションのユニットエコノミクスを桁違いに改善できます。
まず、Postgres のようなオンライントランザクション処理 (OLTP) データベースが各書き込み・読み取り時に何を行っているか、またトランザクションの ACID 準拠を維持するために生じるコストについて取り上げます。その上で、それらを必要としないデータやクエリに対して、こうしたコストを支払うのをやめる方法を示します。
データセットがかつて爆発したとき
2000年代の Web およびモバイルブームの際、システムが処理しなければならないデータセットのサイズは指数関数的に増加しました。当時、多くの急成長企業は、当時の SQL データベースでは提供できなかったスケーラビリティと効率性を求めて NoSQL データベースに移行しました。
その後の数年間で、業務系データベースのスケーラビリティに関する課題は解決されました。クラウドの進化により、最新のシステムでは単一ライターの OSS PostgreSQL デプロイ環境でも数十テラバイトを処理できるようになっています。また、クローズドソースのフォークの中には、OLTP の保証を損なうことなく 100 TB を超えるストレージまでスケールするものもあります。さらに、Spanner やシャーディングされた MySQL/Postgres のようなシステムにより、Web スケールの企業はグローバル規模でトランザクションの一貫性を実現できるようになりました。
スケーラビリティの向上には、高額なクラウドインフラの請求が伴います。OLTP エンジンをベースとするシステムは、良くても線形にしかスケールしません。Postgres に N 倍の費用を払えば、最大 N 倍のストレージと処理能力が得られます。ClickHouse Managed Postgres の NVMe ベースのアーキテクチャを利用すれば、トランザクションスループットの倍率をさらに高めることができます。
それでもなお、データセットサイズが爆発的に増大するにつれて、コンピュートとストレージのコストは線形に増加していきます。
2026年、エージェント型 AI ブームのおかげで、データサイズとクエリ量はかつてない速度で増加しており、サイクルの早い段階で数十テラバイトのトランザクションデータに達するため、急成長企業にとってより優れた経済性が求められています。
2000年代の Web 企業と同様に、従来の OLTP という枠組みの外に目を向けて解決策を探ることができます。
なぜ PostgreSQL の請求額が高くなるのか
ここでは、新しいアプリケーションで最も広く使われている OLTP データベースとして PostgreSQL を取り上げています。他の業務系データベースシステムも非常によく似た仕組みで動作します。
PostgreSQL は、書き込みおよび読み取りを行うすべてのデータに対して、基本的なトランザクション特性である原子性 (Atomicity)、一貫性 (Consistency)、分離性 (Isolation)、耐久性 (Durability) (ACID) を保証します。
- 原子性 (Atomicity): トランザクションの変更はすべて適用されるか、まったく適用されないかのいずれかです。
- 一貫性 (Consistency): 各トランザクションは、すべての制約が満たされた有効な状態をデータベースに残します。
- 分離性 (Isolation): 同時実行トランザクションは互いに干渉しません。それぞれが単独で実行されたかのように振る舞います。
- 耐久性 (Durability): コミットされた変更は、プロセスのクラッシュやインスタンスの障害が発生しても維持されます。
数千のトランザクションが同時に実行される中で、複雑な複数行のトランザクションに対して ACID を保証することは困難な課題です。Postgres はいくつかのメカニズムでこれを解決していますが、それらは書き込みのたびに処理負荷を増やします。
耐久性を確保するため、Postgres は各 COMMIT を確認する前に、トランザクションの先行書き込みログ (WAL) レコードをディスクにフラッシュします。分離性を確保するためには MVCC を使用します。更新処理で行をその場で変更することは決してありません。代わりに、行の完全な新しい物理コピーを書き込み、古いコピーは VACUUM が回収するまでデッドタプルとして残します。また、書き込み直後の読み取りで新しいデータが確認できるように、挿入や更新を行うたびに影響を受けるすべてのインデックスエントリも変更されます。
これらをすべて合わせると、増幅率は非常に大きくなります。約 100 バイトの行データを変更するために、Postgres はバッファプール内のいくつかの 8 KB ヒープページとインデックスページを変更し、最終的には WAL、フルページイメージ、ページフラッシュとして数十キロバイトをディスクに書き込みます。
これは書き込みパスだけの話ではありません。システムが ACID を完全にサポートしている場合、データフォーマットもそのために構築されているため、読み取りにも追加のコストがかかります。
- ストレージサイズ: Postgres はすべてのタプルを非圧縮の 8 KB ページに保持します。確定した滅多に読み取られないデータも、毎秒更新される行と同じだけのストレージコストがかかります。
- 読み取り I/O: 1行を読み取るたびに、すべてのカラムを含むタプル全体と、その位置を特定するインデックスページがロードされます。データが RAM を超えるサイズになると、それらの 8 KB ページがキャッシュから互いを押し出し続けるため、ディスクへの読み取りがますます増加します。
- インデックスの増幅: フルテーブルスキャンは大規模になるとコストがかかりすぎるため、主キー以外による検索にはインデックスが必要になります。Postgres は書き込みトランザクション内で各インデックスを更新するため、書き込みが遅くなり、ストレージとバキュームのコストが何倍にも膨らみます。
以下は、データセットがメモリバッファを超えた場合の、PostgreSQL データベースにおける書き込みと読み取りの増幅を簡略化して示した図です。
分散Postgresでも解決しない問題
共有ストレージやシャーディングを採用したシステムは、データ規模やワークロードに応じて線形にスケールするよう設計されています。
シャーディングされたPostgreSQLシステムの場合、スキーマ設計に一定の投資を行えば、費用を投じることでデータ規模やトランザクション処理能力をほぼ線形に拡張できます。
しかし実環境では、追加の協調処理や、シャードをまたぐマルチフェーズコミットが時折発生することによるコストが原因で、多くのアプリケーションで投資対効果が低下していきます。
共有ストレージソリューションでは、分散システムの冗長化が必要なコンポーネントが増えるため、ワークロードを処理するためのインフラコストが余計にかかります。この追加コストは、ストレージ側でマルチテナントを極限まで詰め込むことで償却されます。
追加の最適化や低価格なオブジェクトストレージを考慮したとしても、本番ワークロードにおいて、これらのシステムは一般的にシンプルなOSS構成よりも高くつきます。
ほとんどのデータは変更されなくなる。それでもOLTPの請求は減らない。
様々な業務領域の多くのアプリケーションにおいて、頻繁に変更されるデータと確定したデータは別々に扱われます。アクティブな状態のデータや最新の行は、新規トランザクションの書き込みに頻繁に使われ、ユーザーや連携システムからも読み取られます。しかし、特定の期間やアクションの基準を過ぎると、データはほぼ読み取り専用になり、保存しておく必要はあるもののアクセス頻度は低くなります。
各業務アプリケーション領域における例を挙げます。
- 前回の明細確定日より前の金融取引データは、監査や低頻度の参照のために保持されます
- 返品期限を過ぎた小売の購入履歴は、履歴画面用には必要ですが読み取り専用になります
- 変更可能期間を過ぎたソーシャルアクティビティは、閲覧のみ可能な状態のまま残ります
- 非アクティブ化された顧客のテナントメタデータは、読み取り専用になります
これらすべての例において、データが高頻度に変更される状態から確定した状態へ移行すると、ACID特性の必要性は薄れます。それにもかかわらず、OLTPストレージに保持し続ける限り、関連するコストが発生し続けます。
Postgresが書き込み、ClickHouseが記憶する
ClickHouseはSQLデータベースエンジンです。アプリケーションがデータベースに求めるあらゆるSQLワークロードを処理できます。
ClickHouseは高頻度のACIDトランザクション向けには最適化されていませんが、それによって経済性が根本から変わります。
- ストレージ: 列指向の圧縮により、データセットは通常10分の1から30分の1に縮小されます。
- インフラ: Postgres製品は大容量の高性能ディスクやキャッシュレイヤーに依存しており、同等のClickHouse Cloud構成と比べて約5倍のコストがかかります。
- インデックス: インデックスは大規模な行のバッチに対してバックグラウンドで構築されるため、レコードあたりの更新に必要なCPUリソースは桁違いに少なくなります。
- 集計: 特化型のインデックス構造、シンプルな同時実行モデル、書き込みとのキャッシュ競合がない点により、要約クエリや分析クエリの実行コストは約100分の1に抑えられます。
トレードオフも存在します。
- 単一行の読み取りが遅い: カラムデータから完全な行を再構築するには数百ミリ秒かかることがあります。
- 結果整合性: 読み取り時に最大約1秒前の値が返される可能性があります。
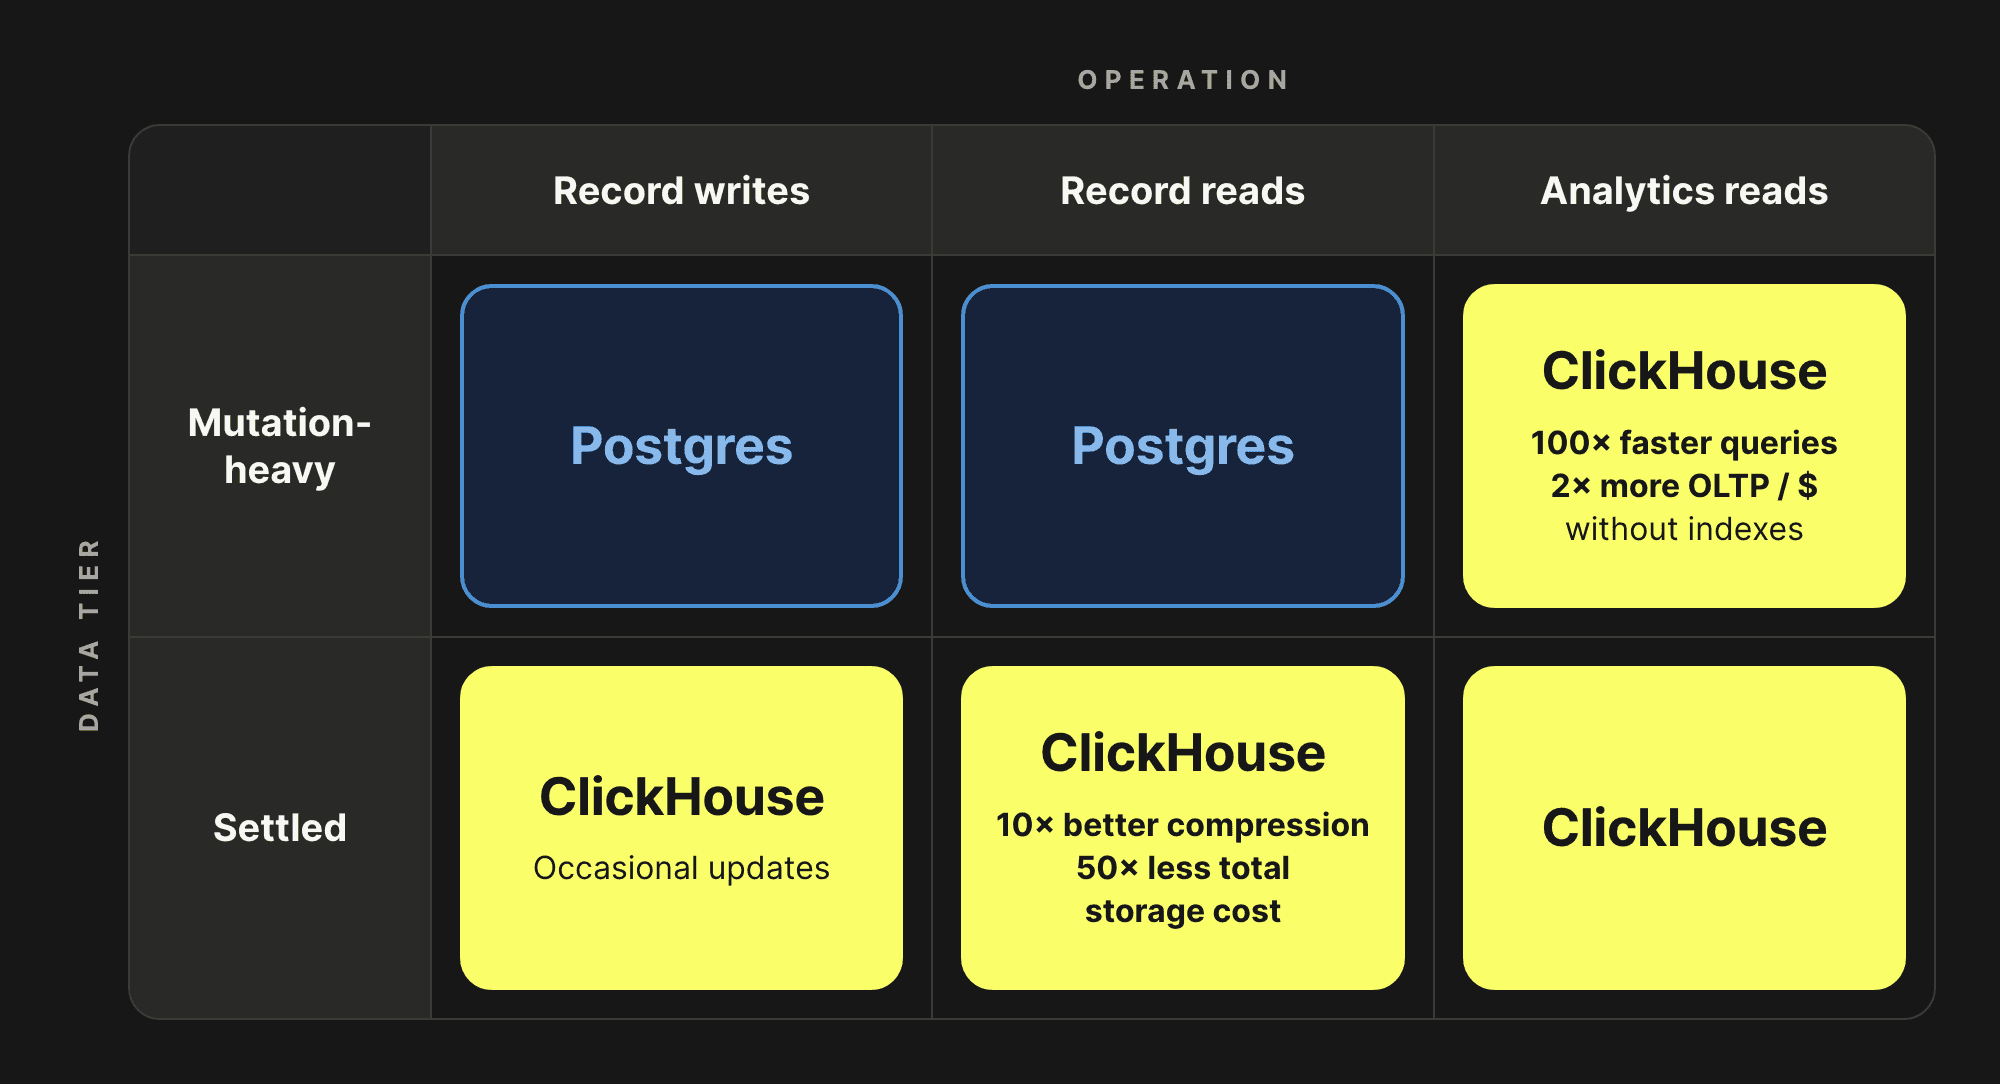
活発に変更されているデータに対して、このような特性を許容できるアプリケーションはほとんどありません。しかし、データが確定した後に、二度と来ない更新に備えるためだけに5〜10倍ものコストを払い続ける理由があるでしょうか。
仕組みは以下のとおりです。
- 書き込みと最新の行の読み取りは引き続きPostgresで行います。
- ClickHouseは、確定したデータの読み取り、集計を必要とするクエリの大部分、および散発的な書き込みを処理します。
- ClickHouseは、どちらのデータ階層に対しても、リアルタイム分析クエリとデータウェアハウス用途において最高の経済性を提供します。
おまけに、インデックスが減ってメンテナンスが軽くなるため、PostgreSQLのコンピュートコストも削減されます。
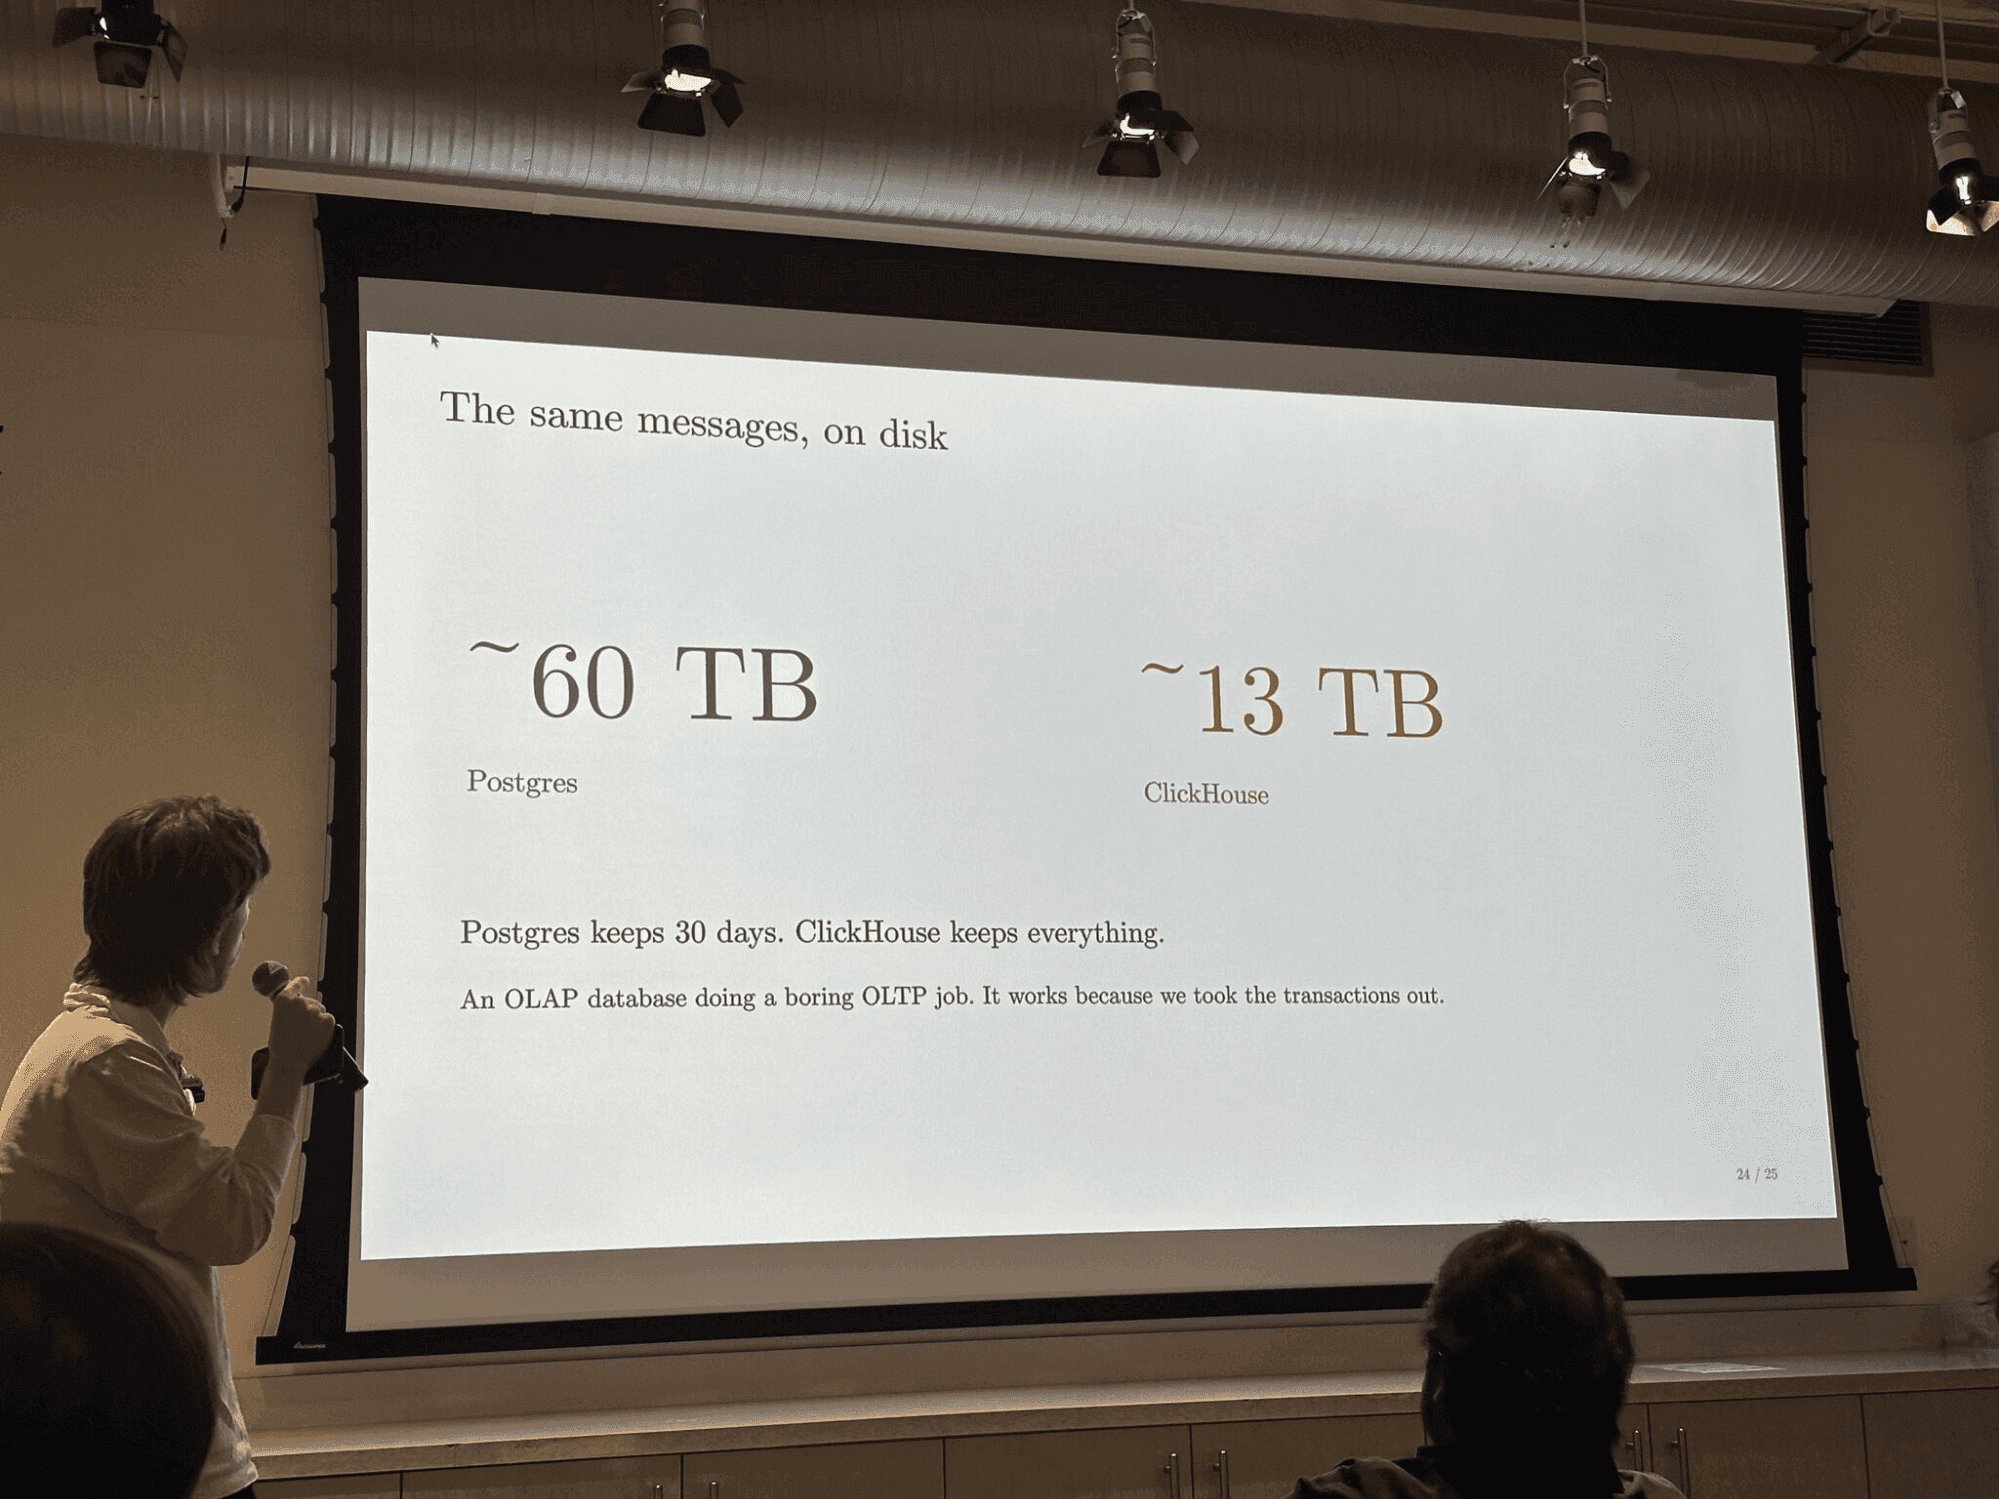
(CH South Bay Meetupにて、Janitor AIのCEOが確定データのClickHouseへのオフロード成功事例を発表)
双方のデータベースを使用してデータを同期させつつ、システムの複雑さを抑えながらアプリケーションを構築するのは難易度の高い作業です。ClickHouse Cloudは、これを簡単にするために設計されています。
ClickHouse Cloud上のPostgres + ClickHouse
ClickHouseにおける私たちの使命は、分析ワークロードとトランザクションワークロードの双方においてクラス最高のコストパフォーマンスを提供することです。
ClickHouse Cloud上の統合OLTP+OLAPスタックは、PostgresとClickHouseの強みを最大限に引き出し、シームレスな統合体験を提供するよう最適化されています。
- Postgresデータ用のローカルNVMeストレージにより、OLTPワークロードにおいて2〜10倍高速なトランザクションと高いスループットを実現します。
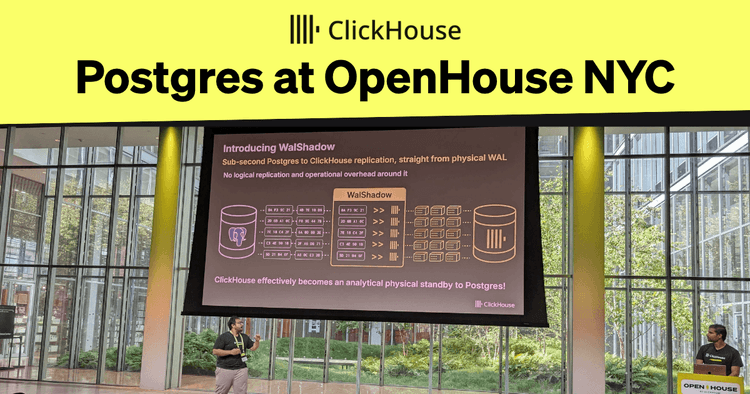
- 私たちの最新のネイティブCDCオプションであるWalShadowにより、Postgresのパフォーマンスや安定性を損なうことなく、ミリ秒単位でClickHouseへのデータレプリケーションが可能になります。
- pg_clickhouseは、Postgres向けのクラス最高峰のFDWです。アプリケーションはPostgresプロトコルを使い続けながら、ClickHouseの経済性を享受できるため、事前のエンジニアリングコストを抑えられます。
このパターンは、今すぐClickHouse Cloud上で構築して確定データの配信コストを10分の1に削減できます。ロードマップにおける次のステップとして、確定データを自動的にClickHouseへオフロードするフルマネージド体験の提供を予定しています。
ぜひお試しください。
今すぐ ClickHouse Managed Postgres を始める
自社データで ClickHouse Managed Postgres の効果を試してみませんか? ClickHouse Cloud は数分で使い始めることができ、300 ドル分の無料クレジットも提供されます。
サインアップ