5.1万

TL;DR: ClickHouse の新しいコストベース結合オプティマイザ(CBO)は、網羅的な動的計画法アルゴリズムである DPsub の効率的な実装に基づいています。最大 12 テーブルのクエリに対して、既存のコストモデルのもとで最も安価なプランを見つけ出します。近日リリースの 26.10 でデフォルトで有効になる予定です。
これまで、結合の並べ替え(reordering)は内部結合(inner join)の間でのみ機能し、それ以外の結合タイプはすべて最適化の障壁(barrier)として働いていました。新しいオプティマイザは、LEFT、RIGHT、FULL外部結合や、SEMI結合、ANTI結合も並べ替えます。これを安全に行うのが*競合検出器(conflict detector)*です。クエリ結果を保持する並べ替えのみを許可し(正当性)、探索空間内のすべての有効なプランを見つけ出します(完全性)。どちらの特性も証明されており、90,000 を超える結合ツリーと 280 万の候補プランでのテストでも、無効なプランや見落とされたプランは検出されませんでした。
データベースにクエリオプティマイザが必要な理由
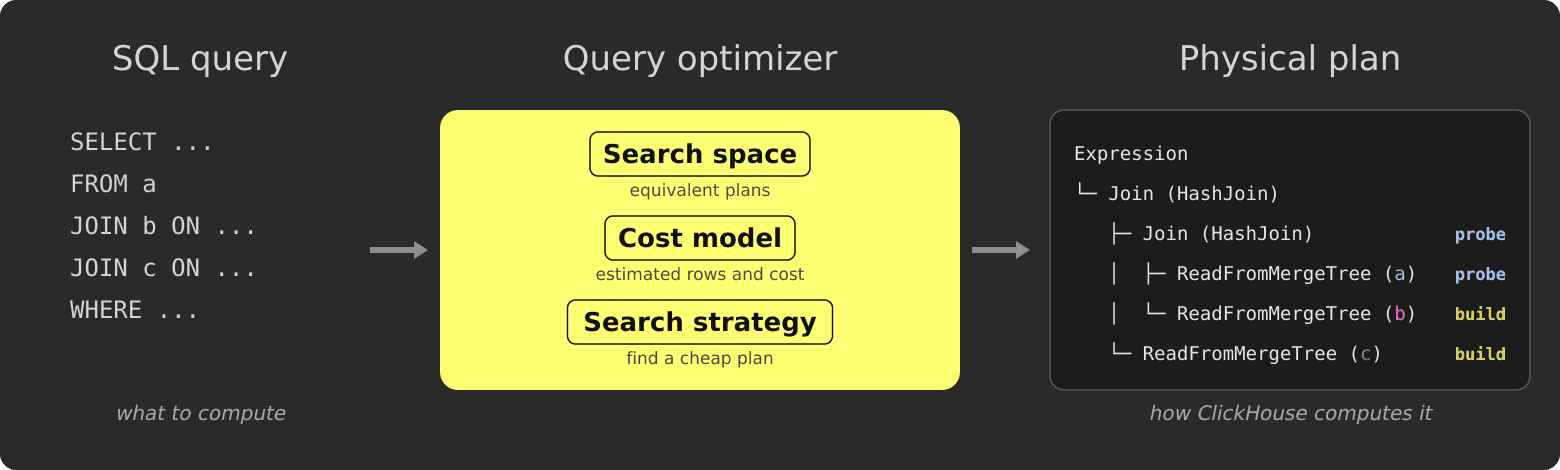
SQL は宣言型言語です。クエリはどのように計算するかではなく、どのような結果が欲しいかを記述します。その両者の間に位置するのがクエリオプティマイザです。オプティマイザはクエリを実行プランへと変換します。実行プランとは、スキャン、フィルタ、結合、集計などの演算子(オペレーター)からなるツリーであり、自明でないクエリであれば、全く同じ結果を計算する論理的に等価なプランが多数存在します。フィルタは結合の前にも後にも適用できますし、結合のハッシュテーブルはどちらの入力からでも構築できます。また、結合を実行する順序やアルゴリズムを変えることもできます。
これらのプランは同じ行を返しますが、パイプラインを通じて移動するデータ量が大きく異なるため、そのコストは桁違いに変わることがあります。オプティマイザの役割は安価なプランを見つけることであり、そのために 3 つのものが必要です。
- 探索空間(search space): クエリと等価なプランの集合
- コストモデル(cost model): 各演算子が生成する行数の見積もり(テーブル統計、インデックス、またはヒューリスティクスから算出)に基づいて、各プランのコストを推定するもの
- 探索戦略(search strategy): すべてのプランをしらみつぶしに試すことなく、その空間から安価なプランを見つける方法
結合順序の決定: すべてを試さずに数十億のプランを探索する
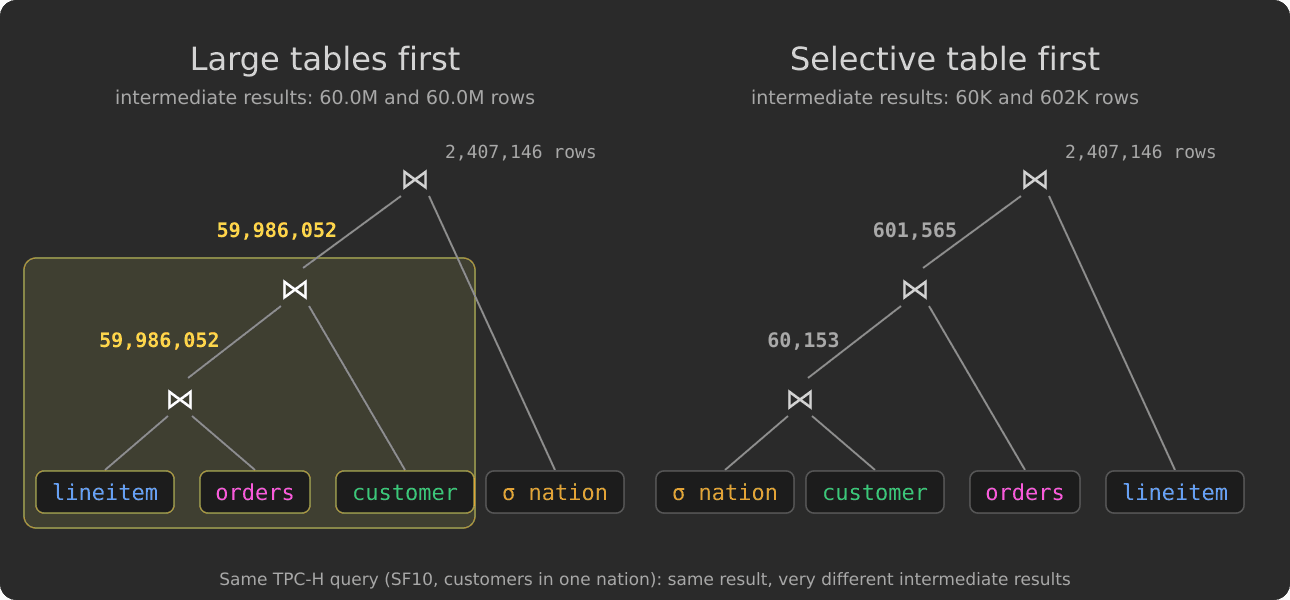
結合の順序ほど重要な決定はありません。順序が異なると、生成される中間結果のサイズが大きく変わります。最大サイズの 2 つのテーブルを最初に結合すると数十億行が実体化(materialize)される可能性がありますが、大きなテーブルを選択性の高い(絞り込み効果の大きい)小さなテーブルと先に結合すれば、コストの高い結合が行われる前に数千行まで縮小できる場合があります。中間結果が小さければ処理量やメモリ消費も少なくなるため、オプティマイザの目標はそのサイズを最小化することにあります。
また、これほど探索空間が大きくなる決定も他にありません。n 個のテーブルを順番に結合するだけでも、すでに n! 通りの順序が存在します。1 つの結合で 2 つの中間結果を組み合わせられる(ブッシー(bushy)プラン)ようになると、取り得る個別の結合ツリーの数は n! · C(n−1) となります。ここで C はツリーの形状を数えるカタラン数です。これは (2n−2)! / (n−1)! と簡約できます。テーブルが 10 個の場合、左深結合(left-deep)の順序だけでも 3,628,800 通りありますが、結合ツリー全体では 176 億を超えます。テーブルが 12 個になると、すでに約 28 兆通りに達します。
この空間を探索する手法には、昔からある 2 つのアプローチが存在します。
貪欲法(Greedy optimization)による最適化: 貪欲法オプティマイザは、結果が最も安価になる 2 つの入力を繰り返し結合していきます。高速で、十分な結果が得られることも多いのですが、早い段階で決定を下して後から選択を見直さないため、局所的に魅力的な 1 つの結合のせいで全体として質の悪いプランに縛られてしまうことがあります。ClickHouse では、これまでデフォルトで貪欲法オプティマイザを使用していました。
動的計画法(Dynamic programming): ボトムアップの DP ベースのオプティマイザは、最も安価な順序を正確に見つけ出します。これはある 1 つの観察に基づいています。それは、「一連のテーブルを結合するための最善のプランは、互いに素な(重複のない)2 つのより小さな部分集合に対する最善のプランから構成される」ということです。階乗的に増加し、わずか十数個のテーブルでも数十億に達する結合ツリーをすべて列挙する代わりに、各部分問題を一度だけ解いてその答えを再利用します。この手順は、部分集合のサイズが小さい順に進められます。
- 基本ケース: 単一の各テーブルについて、最善のプランはそのテーブルにフィルタを適用したスキャンです。
- 結合(Combine): より大きなテーブルの部分集合ごとに、それを空でない互いに素な 2 つの部分に分割するあらゆる方法を検討します。それぞれの分割から候補プランが得られます。左側の部分の最善プランと右側の部分の最善プランを結合し、推定出力サイズと 2 つのサブプランのコストからそのコストを見積もります。
- 最善手の保持: その部分集合に対して最も安価な候補を保存します。どちらの部分も元の部分集合より小さいため、それぞれの最善プランはすでに保存されています。
- 完了: すべてのテーブルを含む部分集合に到達した時点で、そのエントリが最適な結合順序になります。
この系統の列挙アルゴリズムの違いは、主に探索空間をどのように走査するかにあります。DPsub は部分集合駆動型のバリエーションです。テーブルの各部分集合を、テーブルごとに 1 ビットを割り当てたビットマスクとして表現するため、各部分集合は単に 1 から 2ⁿ−1 までの整数になります。すべての部分集合を列挙するということは、これらの整数を上に向かってカウントすることを意味します。各部分集合において、分割の左側の候補はその部分集合自身の部分集合(sub-subset)であり、1 を引いて元の部分集合とビットマスクをかける操作を繰り返すことで生成できます。このテクニックを使えば、重複や抜け漏れなくそのすべてを走査できます。右側は残りの部分であり、左側との単一の XOR 演算で求められます。
この方式が魅力的なのは、列挙処理自体が極めて軽量である点です。カウンタのインクリメント、1 の減算、2 つのマスクの AND 演算、2 つのマスクの XOR 演算、および立っているビットのカウントは、CPU が持つ最も単純な演算の部類に入ります。それぞれ通常は 1 サイクル程度で完了する単一の命令にコンパイルされ、部分集合はレジスタ内に完全に収まります。たどるべきポインタも、確保すべき集合(set)も、ハッシュ処理もありません。各部分集合の最善プランはビットマスクをインデックスとする配列に格納でき、12 テーブルの場合でもわずか 4,096 エントリしかなく、CPU キャッシュに余裕で収まります。分割の数は約 3ⁿ で増加し、12 テーブルでは約 50 万に達するため探索空間自体は依然として大きいものの、各分割を生成するオーバーヘッドはほんの数サイクルにすぎません。だからこそ、オプティマイザは積極的な枝刈りを行わずに、すべての部分集合やすべての分割を網羅的に検証できるのです。
ただし、この単純さには代償もあります。DPsub は、両辺がどの結合述語(join predicate)でも接続されていない分割も生成するため、実用的な実装では直積(デカルト積)を避けるためにこれらをスキップします。また、計算量が指数関数的に増加するため、網羅的な動的計画法が現実的であるテーブル数には限りがあります。ClickHouse の DPsub では、最大 12 テーブルまでの部分集合を列挙します。
コールアウト: ClickHouse の新しい結合並べ替えアルゴリズムは、DPsub の効率的な実装に基づいています。10 テーブルまで(
query_plan_optimize_join_order_limitを引き上げた場合は最大 12 テーブルまで)のクエリに対して、既存のコストモデルのもとで最も安価なプランを見つけ出します。
TPC-H のデータセットを使用した例を確認し、同じ TPC-H クエリに対する 2 つの結合順序の中間結果サイズを比較してみましょう。「選択性の高いテーブルを優先する」アプローチにより、クエリの中間結果が約 100 分の 1 に縮小されていることがわかります。
内部結合を超えて: 競合検出器(Conflict Detector)
しかし、網羅的な探索であっても、その探索が許可されている空間以上の成果を出すことはできません。実際のクエリの多くにおいて、その空間からはある結合の種類全体が抜け落ちていました。
課題
結合順序はクエリの実行時間を桁違いに変化させることがあります。内部結合では、これを活用するのが容易です。内部結合には交換法則(A ⋈ B は B ⋈ A と等しい)と結合法則((A ⋈ B) ⋈ C は A ⋈ (B ⋈ C) と等しい)が成り立つため、どの順序でも同じ結果が返され、オプティマイザは最も安価な順序を見つけるだけで済みます。
多くの実際のクエリでは他の結合タイプも使用されており、その挙動は相手側に一致する行が存在しない行がどれであるかによって左右されます。
| 結合タイプ | 返される内容 |
|---|---|
| Left outer | 左テーブルのすべての行。右側に一致するものがない場合、右側のカラムは NULL で埋められます(join_use_nulls = 1 の場合)。 |
| Full outer | 両方のテーブルのすべての行。一致しない行は、欠落している側が NULL で埋められます。 |
| Semi | 一致した左側の各行が 1 回ずつ、最初に一致した右側の列を含み、右側のカラムは含まれず、重複もありません。これは WHERE EXISTS (...) や IN (...) が意味するものと同じです。 |
| Anti | 右側に一致するものがない左側の行のみが返されます。これは WHERE NOT EXISTS (...) が意味するものと同じです。 |
左外部結合、セミ結合、アンチ結合には交換法則が成り立ちません。A LEFT JOIN B は A のすべての行を保持しますが、B LEFT JOIN A は B のすべての行を保持します。また、結合法則も成り立たないことがよくあります。例として (A LEFT JOIN B) JOIN C ON B.x = C.x を考えてみましょう。B に対応するパートナーを持たない A の行は B.x が NULL になるため、C との内部結合によって破棄されます。もしオプティマイザが代わりに B JOIN C を先に計算し、その結果に A を左結合した場合、それらの A の行は残ってしまいます。この 2 つのプランは異なる結果を返すため、後者は有効な並べ替えではありません。
このような結合を並べ替えるには、オプティマイザは検討する候補結合ごとに「この並べ替えは有効か?」という 1 つの問いに答えられる必要があります。これに答えるコンポーネントが**競合検出器(conflict detector)**です。これは探索空間を 2 つの方向に変化させます。すべての結合を自由に並べ替え可能として扱う場合と比較すると、空間は小さくなります。除外される無効な並べ替えはすべて、探索する必要がなくなった空間の一部だからです。一方、これまでの ClickHouse のように内部結合以外のすべての結合を障壁として扱う場合と比較すると、空間は大きくなります。障壁によって隠されていた有効な並べ替えがすべて利用可能になるためです。オプティマイザは従来よりも多くのプランを探索し、そのすべてが正しい結果を返します。
私たちが解消するギャップ
これまで、ClickHouse は内部結合グラフの外側の別フェーズでセミ結合とアンチ結合を最適化していました。
- オプティマイザは並べ替えを行うために結合ツリーを 1 つのテーブルグラフにフラット化しますが、対象として受け入れるのは通常の内部結合のみであり、子ノードのセミ結合やアンチ結合がフラット化されて組み込まれることはありませんでした。
- 最上位にセミ結合やアンチ結合があると、グラフは 2 つのテーブルまでに制限され、再結合(reassociation)は行われず、2 つの入力を入れ替えることしかできませんでした。
- そのため、すべてのセミ結合やアンチ結合は最適化の障壁となっていました。クエリは内部結合の孤島へと分割され、それぞれが個別に最適化され、セミ結合やアンチ結合はクエリに記述された位置に固定されていました。
その結果、選択性の高いセミ結合やアンチ結合であっても、データを提供する内部結合よりも先に実行するようにプッシュダウンできず、実行プランでは最初に完全な中間結果が構築されてしまっていました。
次のクエリを例に考えてみましょう。
SELECT sum(big.v + mid.v)
FROM big
INNER JOIN mid ON big.k = mid.k
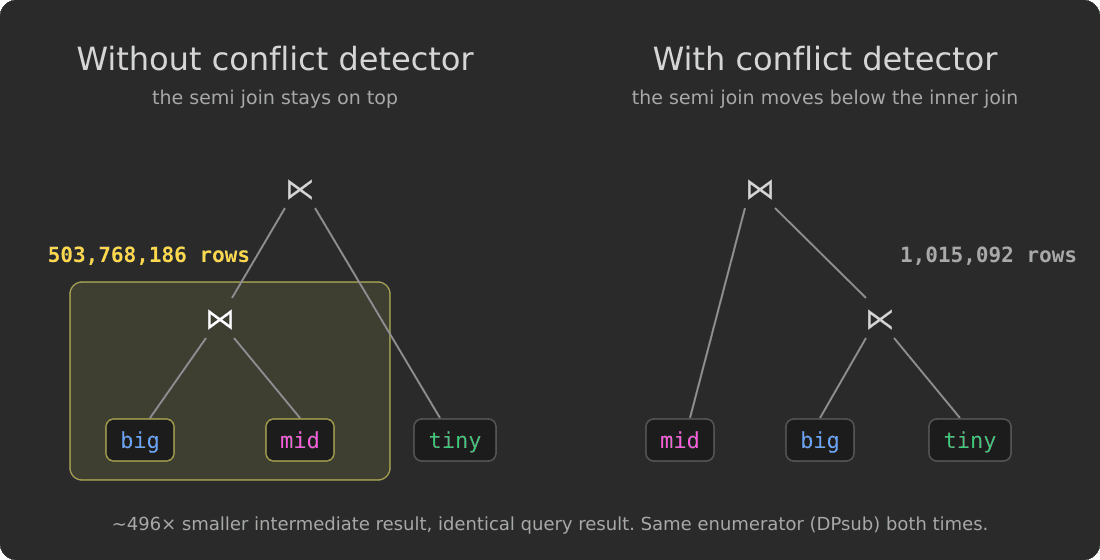
LEFT SEMI JOIN tiny ON big.k = tiny.kbig と mid は結合キーを共有しているため big JOIN mid の結果は膨大になります。一方、tiny はごくわずかなキーしか保持していないため、セミ結合によってそのほとんどが破棄されます。最上位にセミ結合が固定されている場合、プランは最初に big JOIN mid を構築します。セミ結合を結合順序の探索に組み込むことで、オプティマイザは big を先にフィルタリングできるようになります。
| プラン | 最大の中間結果 | |
|---|---|---|
| 競合検出器なし | (big ⋈ mid) ⋉ tiny | 503,768,186 行 |
| 競合検出器あり | mid ⋈ (big ⋉ tiny) | 1,015,092 行 |
これにより、どちらも同じ結合列挙アルゴリズムを使用しているにもかかわらず、中間結果が約 496 分の 1 に縮小されます。唯一の違いは、セミ結合が探索に参加しているかどうかだけです。結果は同一です。
先行研究に基づく構築
私たちの競合検出器は、On the Correct and Complete Enumeration of the Core Search Space(SIGMOD 2013)に基づいています。この論文では、従来のアプローチでは有効なプランを見落としたり、無効なプランを許可してしまったりする可能性があることが示され、正当性と完全性の両方が証明された競合検出器が提示されました。
この論文では、*コア探索空間(core search space)*を「元の結合ツリーから、その演算子に対して有効な代数変換を通じて到達可能なすべてのプラン」と定義しています。この競合検出器は、過不足なくまさにその空間を生成します。私たちが実装したのもこの検出器であり、内部結合、左/右/完全外部結合、および左/右セミ結合とアンチ結合をカバーしています。
検出器の仕組み
4 つのルール
隣接する 2 つの結合を、結果を変えることなく入れ替えたりグループ化し直したりできるかどうかは、それぞれのタイプと、場合によってはその述語が NULL を排除(reject)するかどうかによって決まります。検出器は 4 つの特性をチェックして、どの変換が安全であるかを判断します。以下の式において、∘ᵃ と ∘ᵇ は結合演算子を、e₁、e₂、e₃ はそれらの入力を表します。comm 特性は単一の演算子タイプを説明するものであり、他の 3 つは演算子タイプのペアによってインデックス付けされたマトリックスに保持されます。
- comm: 演算子に交換法則が成り立つか?(
a ⋈ b = b ⋈ a) - assoc:
(e₁ ∘ᵃ e₂) ∘ᵇ e₃ = e₁ ∘ᵃ (e₂ ∘ᵇ e₃)が成り立つか? - l-asscom:
(e₁ ∘ᵃ e₂) ∘ᵇ e₃ = (e₁ ∘ᵇ e₃) ∘ᵃ e₂が成り立つか? - r-asscom:
e₁ ∘ᵃ (e₂ ∘ᵇ e₃) = e₂ ∘ᵇ (e₁ ∘ᵃ e₃)が成り立つか?
customers、orders、payments に対する以下のクエリを考えてみます。
SELECT customers.id, orders.id, payments.order_id
FROM customers
LEFT JOIN orders ON customers.id = orders.customer_id
INNER JOIN payments ON orders.id = payments.order_id
SETTINGS join_use_nulls = 1join_use_nulls = 1 の場合、一致しない行は NULL で埋められます。以下のプラン A はクエリに記述された結合順序に従っています。プラン B は提案された並べ替えですが、検出器によって拒否される必要があります。これらの簡略化された論理プランは結合とスキャンを示しており、最終的なプロジェクションは省略されています。これらは等価ではありません。
プラン A — オリジナル
Inner join [orders.id = payments.order_id]
├── Left outer join [customers.id = orders.customer_id]
│ ├── Scan customers
│ └── Scan orders
└── Scan paymentsプラン B — プラン A の無効な並べ替え
Left outer join [customers.id = orders.customer_id]
├── Scan customers
└── Inner join [orders.id = payments.order_id]
├── Scan orders
└── Scan payments注文のない顧客の場合、プラン A では注文フィールドが NULL の行が作成され、その後の内部結合で支払情報と一致しないため破棄されます。プラン B では先に注文と支払情報を結合し、その後の左結合でその顧客を保持します。結果が変わってしまうため、検出器はプラン A の代替案としてプラン B を拒否しなければなりません。つまり、assoc(⟕, ⋈) は false となります。
次に、結合タイプの順序が逆になっている別のクエリを考えてみましょう。
SELECT customers.id, orders.id, payments.order_id
FROM customers
INNER JOIN orders ON customers.id = orders.customer_id
LEFT JOIN payments ON orders.id = payments.order_id
SETTINGS join_use_nulls = 1このクエリでは、プラン C が記述された順序に従っており、プラン D は有効な並べ替えです。
プラン C — オリジナル
Left outer join [orders.id = payments.order_id]
├── Inner join [customers.id = orders.customer_id]
│ ├── Scan customers
│ └── Scan orders
└── Scan paymentsプラン D — プラン C の有効な並べ替え
Inner join [customers.id = orders.customer_id]
├── Scan customers
└── Left outer join [orders.id = payments.order_id]
├── Scan orders
└── Scan paymentsプラン C とプラン D はどちらも注文のある顧客のみを保持し、支払情報がない場合でも一致した注文をそれぞれ保持します。つまり、assoc(⋈, ⟕) は true です。したがって、検出器はプラン C の代替案としてプラン D を許可できます。
両方の結合が左結合である場合も、同じ等値結合条件であれば再グループ化は安全です。orders.id = payments.order_id は NULL を排除するため、存在しない注文が支払情報と一致することはありません。NULL で埋められた注文に一致し得る条件があると、その保証は無効になります。つまり、assoc(⟕, ⟕) は NULL 排除のもとでのみ成り立ちます。これが、ルールが結合タイプだけでなく、その条件がどのように NULL を処理するかにも依存する理由です。
私たちの実装では、これらのルールを静的データ(comm 用の 1 行と 3 つのマトリックス)として保持し、すべての再グループ化が安全であると想定するのではなく、検出器が提案された変換ごとに検証できるようにしています。
マトリックスから有効性テストへ
列挙が始まる前に、検出器はクエリの元の結合ツリーを走査します。演算子ごとに、左右の入力サブツリー、ON 句が参照するテーブル、およびその句が NULL を排除するテーブルを記録します。次に、マトリックスによって変換が禁止されている演算子のペアごとに、競合を記録します。
各演算子は左右それぞれにおいて、自身の ON 句がそこで参照しているテーブルのみを必要とし、各競合は*「T₁ のテーブルのいずれかがすでに結合されている場合、T₂ のすべてのテーブルも結合されていなければならない」というルールとして個別に記録されます。たとえばプラン A では、内部結合に「orders が結合されている場合は、customers も結合されていなければならない」*というルールが割り当てられ、これによりプラン B の orders ⋈ payments が拒否されます。競合をすべて必須セットにまとめ込んでしまうのではなく、個別の条件付きルールとして保持することが、この検出器の完全性を支えています。競合が実際に適用される場合にのみプランを拒否するからです。この有効性テストは、列挙ルーチンがテーブルのセット S₁ とセット S₂ の結合を検討するたびに適用されます。
required_left ⊆ S₁ ∧ required_right ⊆ S₂ (or mirrored, with LEFT ↔ RIGHT)
∧ every conflict rule of the operator is obeyed by S₁ ∪ S₂テストに合格した場合、その分割で適用された演算子によって、結果として生成される結合の種類と厳密性が決定されます。このテストは数回のビットマスク操作で済むため、列挙処理への負荷はほとんどありません。
DPsub への組み込み
DPsub はテーブルの部分集合をビットマスクとして列挙し、すべての部分集合について、接続された 2 つのより小さな部分集合からそれを構築する最も安価な方法を見つけ出します。検出器が導入されたことで、結合ツリー全体がテーブルの 1 つのグラフとして DPsub に到達するようになります。外部結合、セミ結合、アンチ結合の両側、さらには FULL 結合も含まれます。これにはさらにいくつかの要素が必要でした。
- 直積(Cross products):
CROSS JOINには結合条件がないため、グラフにエッジが追加されません。私たちはその両側を明示的に選択性 1 の結合としてリンクします。これによりグラフの接続性が維持され、DPsub は直積を最も安価な場所へと移動させることができ、実行やレポートは通常通りCROSS JOINとして扱われます。 - ビルド側(Build side): DPsub のコストモデルでは、入力がどちらの順序であっても結合コストは同じとして計算されます。そのため、探索後にハッシュ結合のビルド側に小さい方の入力を配置し、外部結合を
LEFT↔RIGHTで反転させます。ただし、左右の配置によって意味が変わるANY、SEMI、ANTI結合では反転を行いません。 - 制限付き探索: 検出器を備えた DPsub は、セミ結合、アンチ結合、外部結合を含めて最大 12 テーブルまでの結合ツリーをプランニングします。これを超える規模の結合ツリーは貪欲法オプティマイザに委ねられます。
検証 I: 理論との照合
一度でも判定を誤る検出器は誤った結果を返してしまうため、論文と同じ方法で検証を行いました。指定されたテーブル数 n に対して、テストハーネスは以下を実行します。
- 初期結合ツリーをすべて生成(すべてのツリー形状 × すべての演算子の割り当て × すべての二項等値述語)
- 各ツリーのコア探索空間全体を列挙
- 出荷版の検出器、コア探索空間を定義する独立したリファレンス実装、NULL を含むランダムデータベースでの実行という、3 つの独立した方法で各候補プランを検証
このハーネスは、コア探索空間の外側で生成されたプラン(無効(invalid)、0 件であること)、生成に失敗したコアプラン(欠落(missing))、および実行に失敗したプラン(0 件であること)をカウントします。
小規模な演算子セット
内部結合、左外部結合、アンチ結合:
| テーブル数 | 結合ツリー | コアプラン | 無効 | 欠落 |
|---|---|---|---|---|
| 3 | 30 | 94 | 0 | 0 |
| 4 | 495 | 4,696 | 0 | 0 |
| 5 | 11,010 | 377,434 | 0 | 0 |
| 6 | 2,000 | 145,657 | 0 | 0 |
| 7 | 2,000 | 618,710 | 0 | 0 |
大規模な演算子セット
内部結合、左/完全外部結合、セミ結合、アンチ結合:
| テーブル数 | 結合ツリー | コアプラン | 無効 | 欠落 |
|---|---|---|---|---|
| 3 | 80 | 243 | 0 | 0 |
| 4 | 2,080 | 16,207 | 0 | 0 |
| 5 | 72,320 | 1,615,294 | 0 | 0 |
| 6 | 2,000 | 77,194 | 0 | 0 |
| 7 | 2,000 | 228,662 | 0 | 0 |
(6 テーブルおよび 7 テーブルの行は、結合ツリーをサンプリングしたものです。)すべての実験において、検出器は 280 万件のコアプランを 1 つ残らず生成し、無効なプランは 1 件もなく、実行に失敗したプランもありませんでした。
検証 II: 実エンジンでのテスト
差分ファジング(Differential fuzzing)
ファザー(fuzzer)は、INNER、LEFT、RIGHT、FULL、SEMI、ANTI 結合を混在させ、片側のみを参照する ON 句を含め、NULL、重複キー、不一致キーを含む実データに対して、ランダムな複数テーブル結合クエリを生成します。各クエリは 3 つの方法で実行され、ClickHouse 内部で計算された順序非依存・NULL 安全なチェックサムと比較されます。
- base: 記述された順序(並べ替えなし)。正解データ(ground truth)として使用
- greedy: 従来のデフォルトオプティマイザ
- DPsub: 競合検出器を備えた DPsub
最大 7 テーブルのクエリ 1,200 件において、不一致は 0 件でした。
探索空間
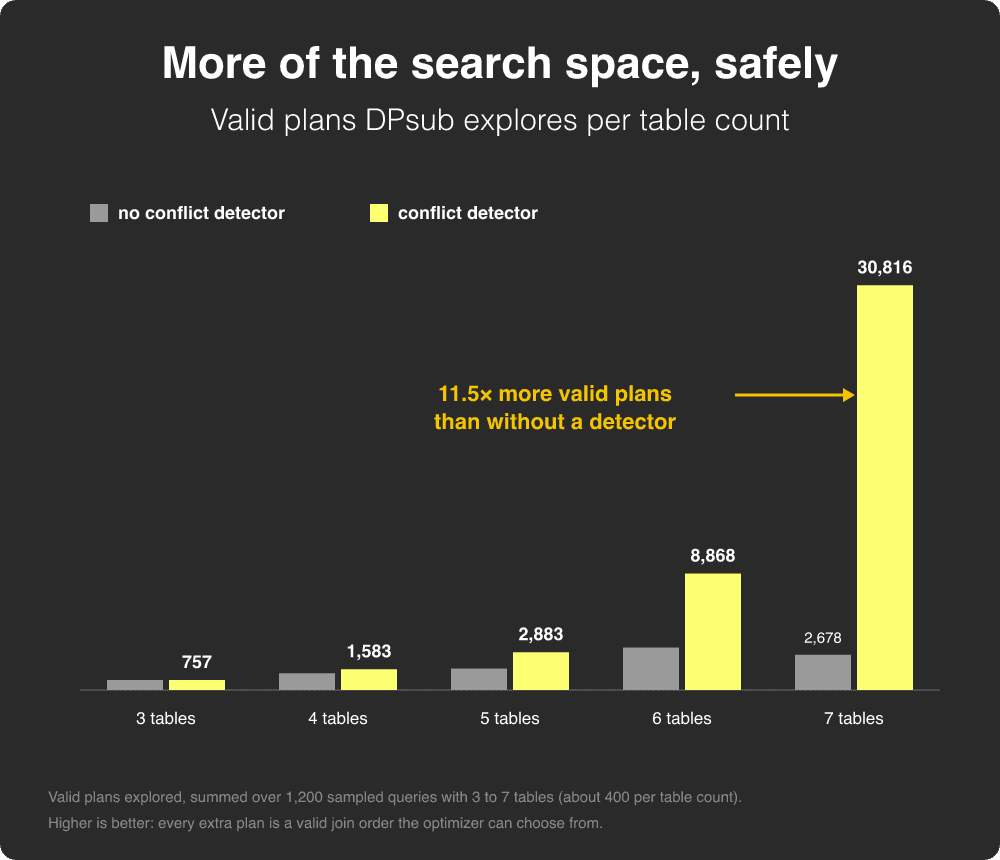
実際のオプティマイザにおいて、検出器によって探索空間はどれほど広がったのでしょうか。3 〜 7 テーブルの 1,200 件のサンプリングクエリに対して、DPsub が探索する有効なプラン数をカウントしました。
| テーブル数 | クエリ数 | 検出器なし | 競合検出器あり | 拡大率 |
|---|---|---|---|---|
| 3 | 389 | 757 | 757 | 1.00 倍 |
| 4 | 403 | 1,283 | 1,583 | 1.23 倍 |
| 5 | 396 | 1,633 | 2,883 | 1.77 倍 |
| 6 | 407 | 3,228 | 8,868 | 2.75 倍 |
| 7 | 405 | 2,678 | 30,816 | 11.51 倍 |
7 テーブルの場合、競合検出器によって DPsub が検討できる有効なプランは 11.5 倍に増加しました。クエリに含まれる結合の数が増えるほど、以前は障壁によって隠されていた優れたプランがより多く解放されることになります。
テスト
CI のステートレステストでは、あらゆる結合種類のペアが結果を変えずに 1 つのグラフとして DPsub に到達すること、ANY/SEMI/ANTI の厳密性(strictness)が維持されること、join_use_nulls、縮退述語(degenerate predicates)、直積(cross products)などを検証しています。
測定結果
先ほどのセミ結合クエリに戻りましょう。
SELECT sum(big.v + mid.v)
FROM big
INNER JOIN mid ON big.k = mid.k
LEFT SEMI JOIN tiny ON big.k = tiny.kただし今回は、以前のデフォルトである greedy オプティマイザと比較して評価します。big と mid に 300 万行、tiny に 100 個のキーを持つデータセットにおいて、greedy はセミ結合を big JOIN mid の上に維持します。
Join (left semi)
├── Join (inner)
│ ├── ReadFromMergeTree (big)
│ └── ReadFromMergeTree (mid)
└── ReadFromMergeTree (tiny)競合検出器を備えた DPsub は、これを内部結合の下に移動させます。
Join (inner)
├── ReadFromMergeTree (mid)
└── Join (left semi)
├── ReadFromMergeTree (big)
└── ReadFromMergeTree (tiny)| greedy | DPsub + 競合検出器 | 高速化 | |
|---|---|---|---|
| 実行時結合フィルタ無効 | 0.133 秒 | 0.035 秒 | 3.8 倍 |
| 実行時結合フィルタ有効 (デフォルト) | 0.044 秒 | 0.037 秒 | 1.2 倍 |
ハッシュテーブルのキーを反対側のスキャンにプッシュダウンする ClickHouse の実行時結合フィルタは、このクエリにおいても不適切な順序による影響をある程度カバーしています。しかし、より優れたプランであればそうしたフィルタに依存する必要はありません。
パフォーマンステストにおける TPC-DS (SF1) および TPC-H (SF1/SF10) クエリで、従来のデフォルトである greedy と比較した結果は以下のとおりです。
| クエリ | greedy | DPsub + 競合検出器 | 変化 |
|---|---|---|---|
| TPC-H Q2 | 143 ms | 65 ms | −55% |
| TPC-DS Q73 | 260 ms | 143 ms | −45% |
| TPC-H Q5 | 574 ms | 320 ms | −44% |
| TPC-DS Q86 | 93 ms | 57 ms | −39% |
| TPC-DS Q65 | 302 ms | 227 ms | −25% |
利用方法
競合検出器を備えた新しい DPsub は、26.10 リリース以降、結合向けコストベースオプティマイザ(CBO)のデフォルトになっています。
SET query_plan_optimize_join_order_algorithm = 'dpsub,greedy'; -- greedy is the fallback for large Joins
SET query_plan_optimize_join_order_conflict_detector = 'c'; -- setting to'' turns it off以前の動作と比較したい場合は、クエリ単位で無効化できます。詳細を確認し、実行される各結合の順序、種類、厳密性を調べるには、EXPLAIN actions = 1 を使用してください。
EXPLAIN actions = 1
SELECT ...
SETTINGS query_plan_optimize_join_order_algorithm = 'greedy',
query_plan_optimize_join_order_conflict_detector = ''