5.1万

TL;DR
- トラフィックさえあれば、レプリカラグは初期状態のままで定説よりも短く、基本的なチューニングで簡単に数秒まで短縮可能。
- 強引な手段やトレードオフを受け入れるなら、驚くほど短いレプリカラグも実現可能。
- リードレプリカのラグを重視し、比較的安全な出発点からチューニングを始めたい場合は、
archive_timeout=5sとwal_retrieve_retry_interval=500msを試すのがおすすめ。 - これらの設定の一部は、同期 HA 構成ではネットワーク請求額の高騰につながる可能性あり。
一見単純な問題ほど、思わぬ驚きをもたらすことがあります。先日、ClickHouse Managed Postgres のユーザーから、リードレプリカの遅延が想定外に大きいという話があり、この機会に詳しく調べてみました。すぐに気づいたのは、Postgres にはここ数メジャーバージョンの間テストしていなかった設定オプションが数多くあり、私自身が常識だと思っていた知識の一部が少し古くなっていたということです。この記事の内容には、読者の皆さんにとっても意外な発見があるのではないかと思います。
リードレプリカは、従来のリレーショナルデータベースを支える定番の柱の 1 つです。読み取りトラフィックと書き込みトラフィックを分離したい場合や、単に読み取りをスケールさせたい場合に導入を検討したことがあるはずですし、このブログの読者の大半は本番環境のどこかで実際に運用しているのではないでしょうか。その仕組みは実にシンプルで、通常のトラフィックを受け付けるプライマリデータベースを用意し、その更新をすべて 1 台以上のリードレプリカにミラーリングして、更新を伴わないトラフィックをそちらで処理します。
これを構築する方法はいくつかあります。定番の構成はストリーミングレプリケーションで、変更が (ほぼ) リアルタイムでレプリカに送信されますが、本記事の末尾で詳しく述べるとおり、私たちが好ましくないと考えている欠点がいくつかあります。もう 1 つのよく使われる方法は、ClickHouse Managed Postgres でもデフォルトとして採用しているもので、バックアップ用にすでに収集している WAL を活用してレプリカの同期を保つ仕組みです。やや低速になりますし、ストリーミング接続なしでは hot_standby_feedback を使えないため、レプリカ上で長時間実行されるクエリは完了するかタイムアウトするまでリプレイをブロックしてしまいますが、私たちは納得のうえでこのトレードオフを受け入れています。
あいにく Postgres は WAL セグメントの切り替えを効率よく行おうとするため、これが思わぬ挙動につながることがあります。私たちが提供しているデフォルト設定では、Postgres は 16 MB の変更が発生するか 60 秒が経過するかのいずれか早い方でセグメントを切り替えます。適度な負荷がかかっている本番システムでは通常 2〜3 秒程度のレプリカラグしか発生しないため、実運用上これは優れたデフォルト値だと考えています。適度な負荷があるシステムでは変更がすぐに 16 MB の目標値に達して待たされることがほとんどなく、またリードレプリカを備えた環境の大半には相応のベースライン負荷があるためです。
問題が生じるのは低スループットのシナリオです。書き込みトラフィックがあまり入ってこない場合、Postgres は変更を転送しないため、レプリカに更新が反映されるまで最長 60 秒かかることになります。私の経験上、これはプラットフォームのテスト初期段階で発覚することが多く、結果として生じるレプリカの遅さに不満の声が上がった企業は今回が初めてではありません。「システムが遅いのは十分な負荷をかけていないせいです」と説明するのはいつも気まずいものですし、私自身、ソフトウェアが壊れる限界までどこまで追い込めるかを知るのが好きなので、この話が出たときに自分でテストしてみることにしました。
ベースラインテスト
ClickHouse Managed Postgres のテストインスタンスをいくつか立ち上げ、負荷をシミュレートするために pgbench をセットアップして検証に取りかかりました。レプリカラグを計測するため、200 ms ごとにプライマリへ 1 行書き込み、レプリカ上の同じテーブルを継続的にポーリングするハートビートツールを追加しました。システムに実際に負荷をかけやすくするため、ハードウェアはかなり小規模に抑えました。プライマリ 1 台とリードレプリカ 1 台の構成で、どちらも 16 GB の RAM、2 vCPU、468 GB のローカル NVMe SSD を備えた i8g.large インスタンスを使用し、PG 18.6 を稼働させました。本番ワークロードをより忠実に反映するため、テストの途中でクォーラム同期コミットの HA スタンバイを 2 台追加しましたが、これによりスループットは約 10% 低下したものの、レプリカラグへの計測可能な影響はありませんでした。これらのテストでは WAL 生成量が最大 120 MB/s (HA 構成時は 105 MB/s) に達したため、コア数は少ないながらも、レプリカの仕組みには多忙な本番環境で見られるようなスループットをかけられたはずです。なお、以下のチャートの「idle」にはハートビートテーブルへのごくわずかなトラフィック (約 200 ms ごとに 1 回の書き込み) が含まれますが、pgbench の負荷はゼロである点にご注意ください。
最初の結果から、あの驚きの原因が裏付けられました。レプリカラグの報告は、やはりシステムに十分な負荷がかかっていなかったことが原因だったのです。デフォルト設定でのレプリカラグはスループットに対して U 字型の曲線を描き、スループットが極端に低い場合と極端に高い場合の両方でラグが大きく跳ね上がります。中央のスイートスポットは、WAL セグメントを即座に転送できる程度には速く、かつどこもパンクさせない程度の速さでデータが入ってくる領域であり、U 字の右側はアーカイブのアップロードが追いつかなくなり始めることで発生します。
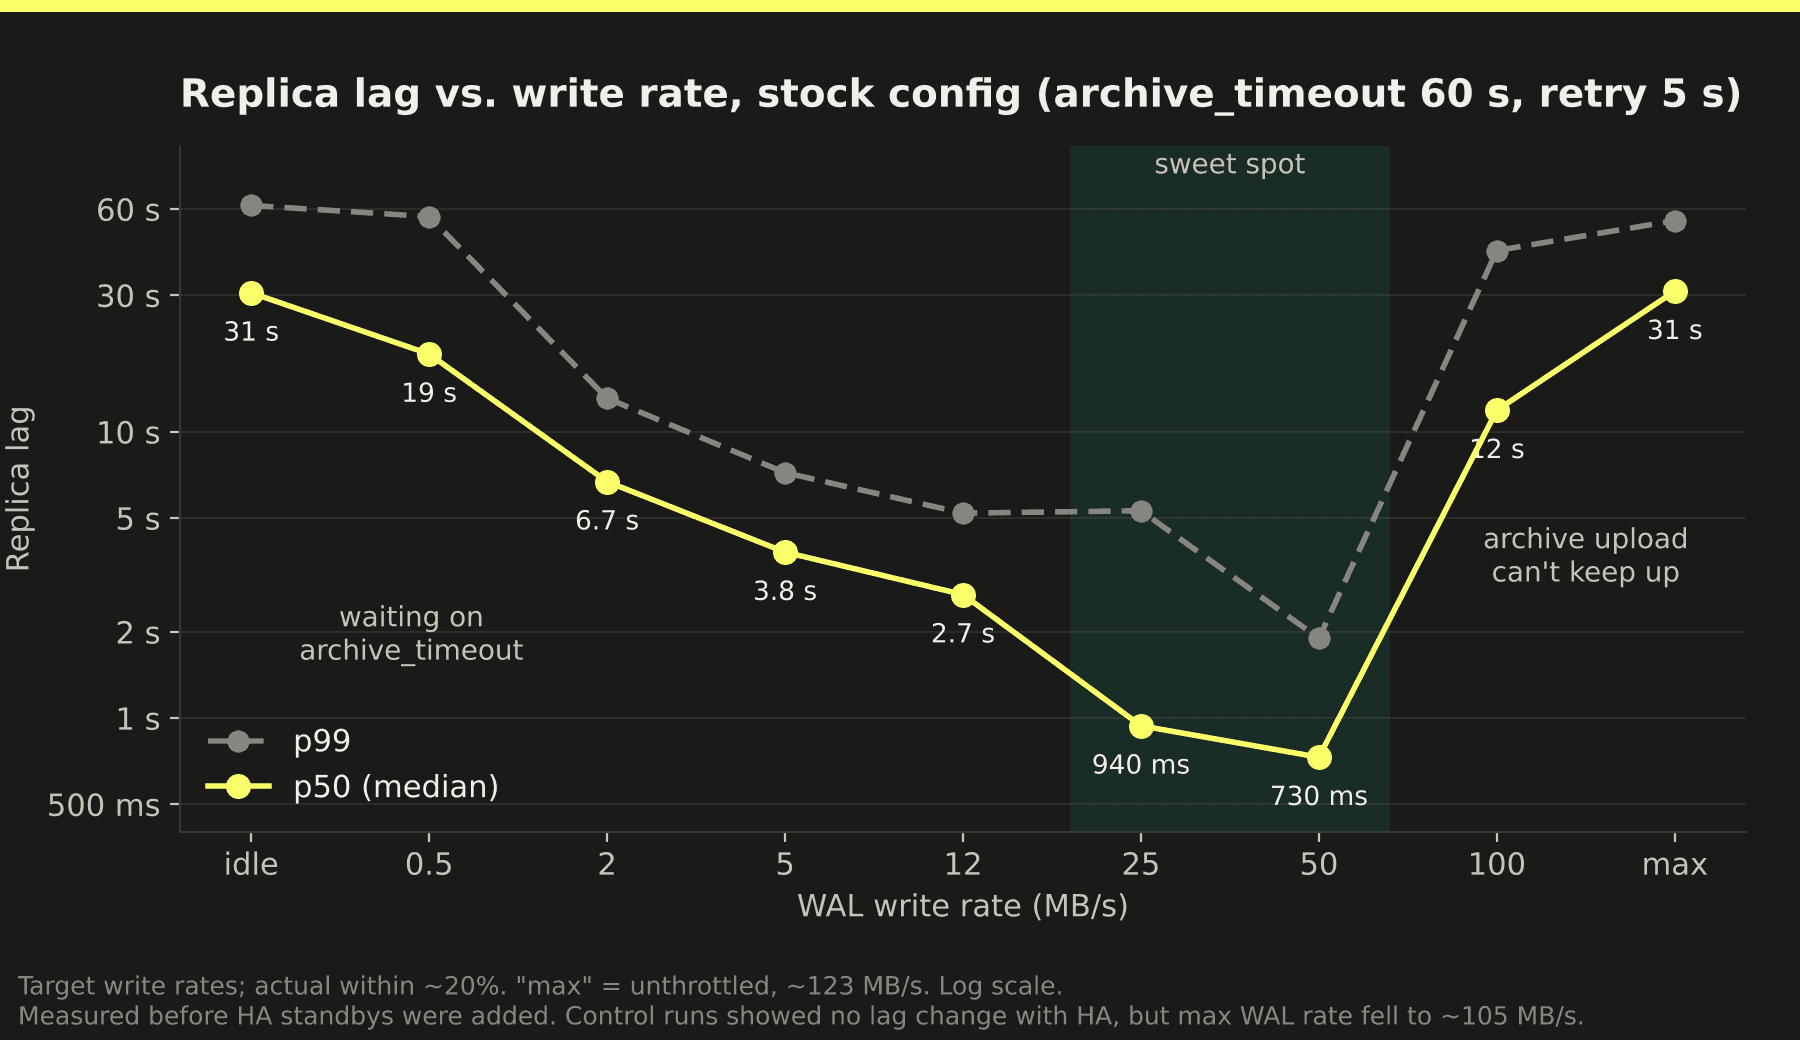
12 MB/s という適度な負荷で約 3 秒のレプリケーション遅延に収まっており、大半のユースケースには十分な性能なので、最初からまずまずの結果でした。本番環境では問題にならないと確認できたのは良い滑り出しでしたが、改善の余地はまだありましたし、手元には徹底的に負荷をかけるべきテスト環境が控えていました。
現実的なチューニング
レプリケーションラグに関係するチューニング項目はそう多くありませんが、いくつか思い当たるものがありました。16 MB の WAL セグメントサイズは、新規データベース構築時に initdb --wal-segsize を使うか、メンテナンスウィンドウ中に pg_resetwal --wal-segsize を使う方法でしか変更できないため、既存環境のチューニングには一般的に向きません。次の有力候補は 60 秒という間隔で、これは archive_timeout パラメータによって制御されます。これは要するに、容量に達していなくても Postgres がセグメントを強制転送するまでの待機時間を制御するものなので、これ以上ないほど今回の目的に直結する設定です。
ここでもう 1 つ関連する設定として、wal_retrieve_retry_interval も関係してくることがわかりました。これは、要求された WAL セグメントが最初の試行で見つからなかった場合に Postgres が再試行するまでの待機時間を制御するもので、実用上はポーリング間隔と捉える方が適切です。
シミュレートする負荷レベルをいくつか変えながら、さまざまな値を試してみました。実用上、レプリケーションラグに対しては同じ働きをしていたため、ここでは wal_retrieve_retry_interval と archive_timeout をひとまとめにしています。
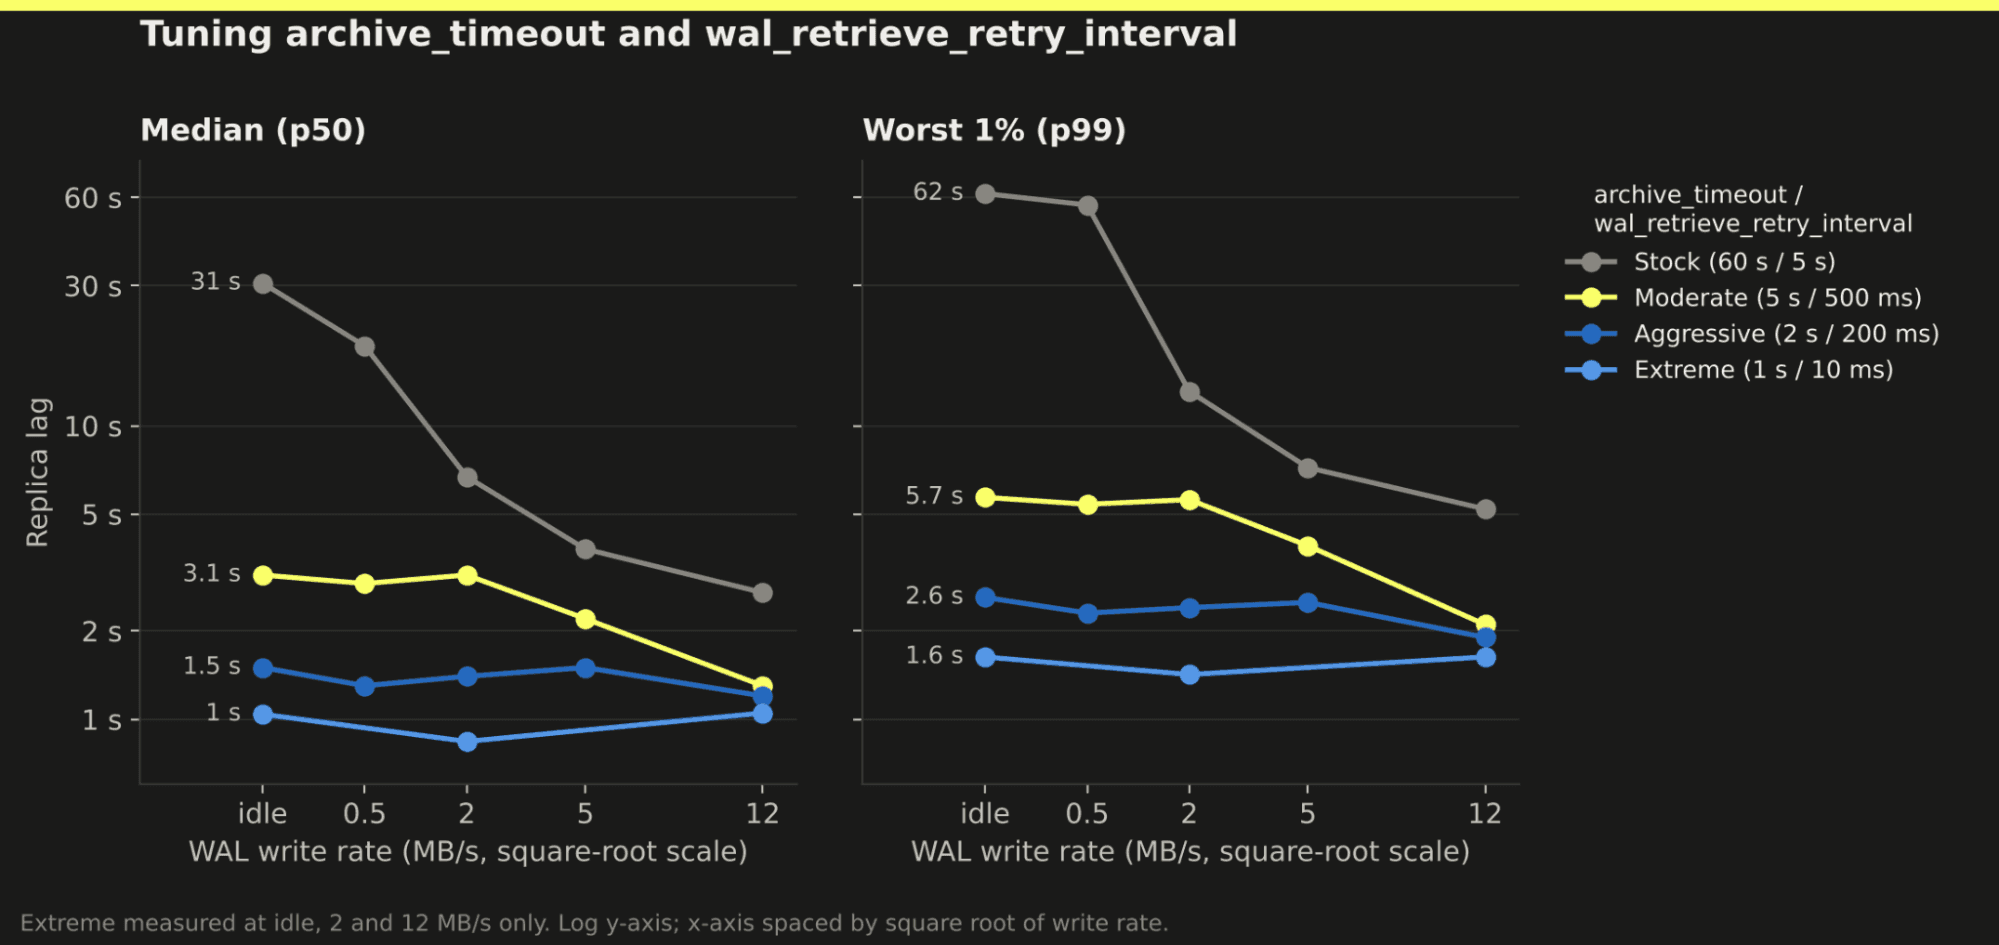
興味深いことに、値を小さくしすぎると改善が見られなくなりました。各ポーリングで WAL-G の順次呼び出しに約 0.8s かかるのが限界となっており、1 秒前後より短くしてもあまり意味がなかったのです。典型的な時間の内訳を示すため、構成例を以下に示します:
t+0.00 restored log file N <- N fetched
t+0.20 Archive N+1 does not exist <- wal-g call (not there yet)
t+0.45 restored log file N (again) <- Postgres re-fetches N from the archive
t+0.70 Archive N+1 does not exist <- wal-g call
t+0.80 Archive 00000002.history ... <- timeline check (recovery_target_timeline=latest)
waiting for WAL ... -> sleep wal_retrieve_retry_interval (5 s), repeat再フェッチが発生するのは、アーカイブからリストアしたセグメントのローカルコピーを Postgres が永続化しないためです。要求時点で次のセグメントがまだアーカイブされていなかったり、何らかの理由でフェッチに失敗したりすると、Postgres は最後の有効なレコードを含むセグメントを再フェッチして再読み込みしてから、次のセグメントの取得を再度試みます。recovery_target_timeline をデフォルト値の latest ではなく固定すれば履歴チェックは省略できると思いますが、そうするとレプリカが HA フェイルオーバーを乗り切れなくなるため、おそらくその代償に見合わないでしょう。
残念ながら、これには無視できないコストも伴います。archive_timeout は同期 HA 構成でのネットワークオーバーヘッドを増加させるため、クロス AZ の HA 構成では高くつく可能性があります。archive_timeout ごとに各スタンバイへ 16 MB を転送すると時間とともに積み重なり、archive_timeout が 2s でスタンバイが 2 台ある場合、17 MB/s を消費して 1 日あたり 1 TB を超える計算になります。また、ポーリングが空振りするたびにオブジェクトストレージから直前のセグメントを再ダウンロードして再展開するため、リードレプリカ側にもいくつか副作用が生じます。
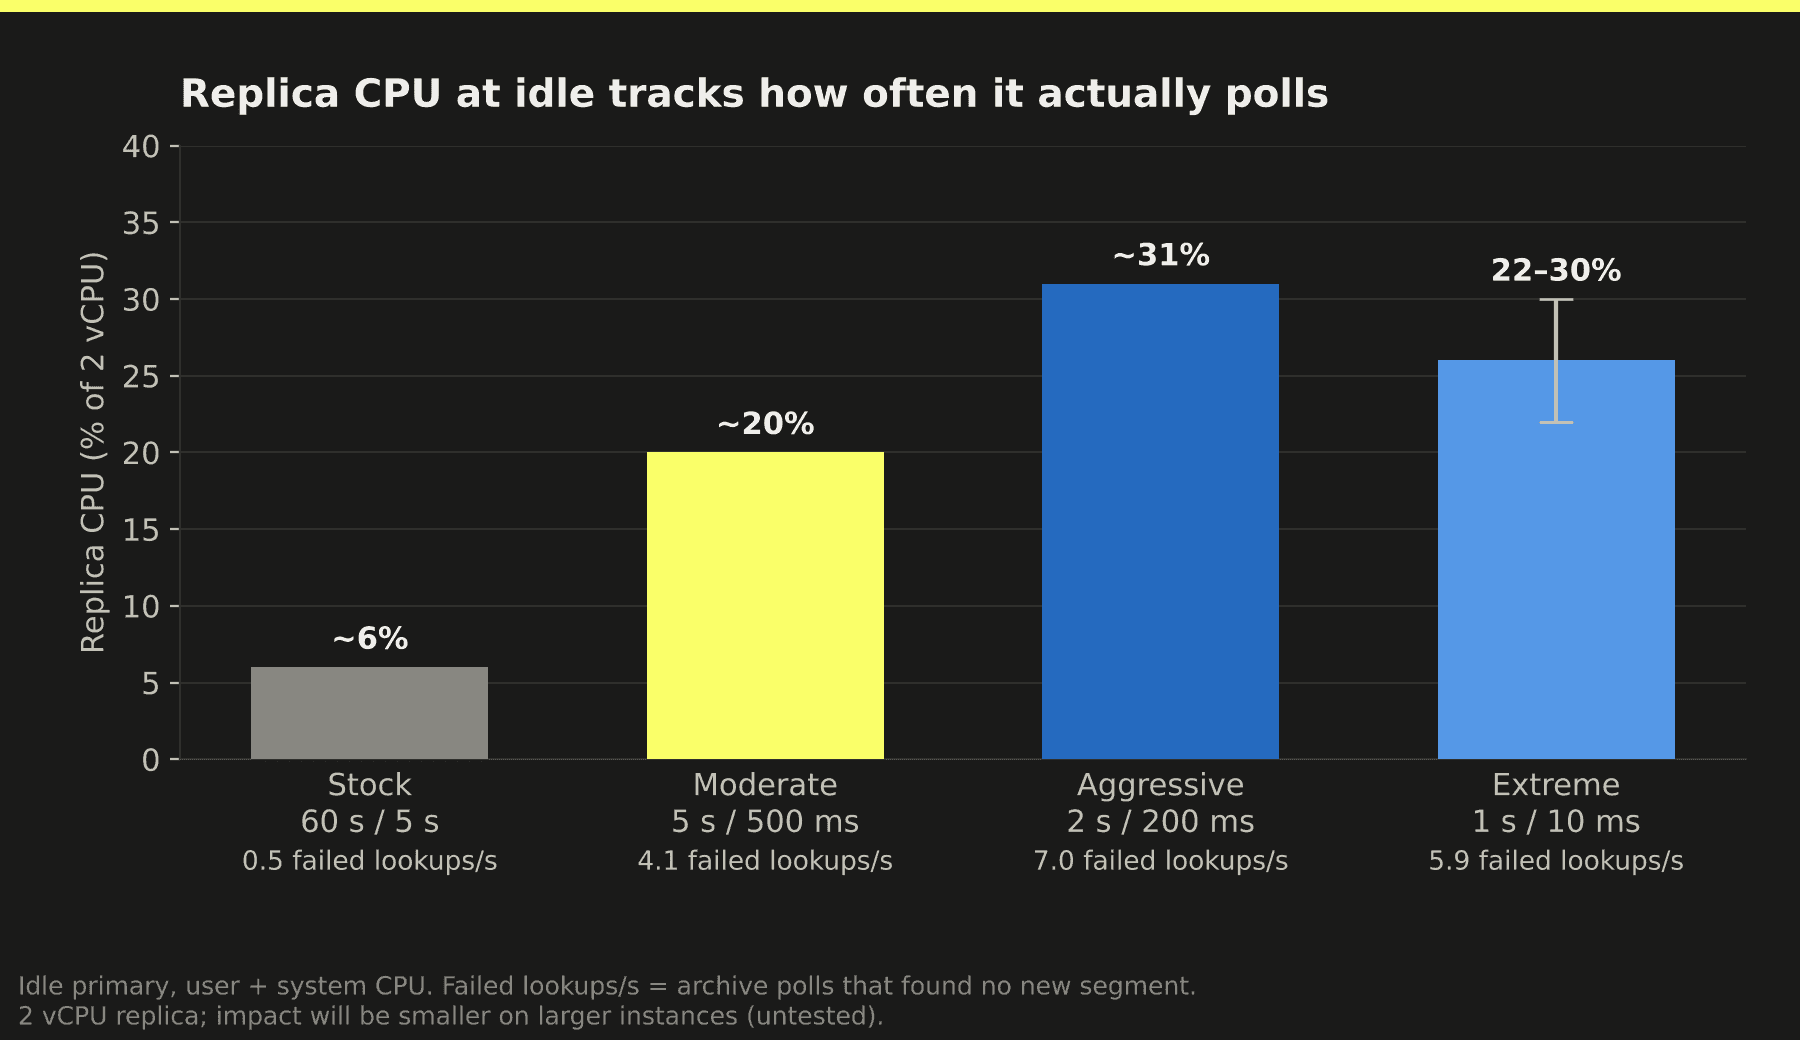
レプリカの CPU 使用率も予想以上に跳ね上がりました。レプリカは 2 vCPU しかなかったため、テストでは相対的な影響が非現実的なほど大きく出ています。私が確認した限りでは、ポーリングのたびに再フェッチと展開が強制され、インスタンスサイズやデータ量に関係なく事実上の固定コストとなるため、CPU 負荷はほぼ完全にポーリング頻度に左右されます。8 コア以上を備えたより現実的な本番グレードのシステムであれば、この負荷のオーバーヘッドはほぼバックグラウンドに紛れて見えなくなるはずです。残念ながら、今回のプロジェクトではそこまでテストする時間が足りませんでした。
あまり現実的ではないチューニング
さらなる改善の余地を探してみたところ、あいにく archive_timeout は整数値のパラメータしか受け付けないため、1 秒未満にするのは現実的ではないことがわかりました。やがて、Postgres には新しい WAL ファイルへの切り替えを強制する pg_switch_wal() という気の利いた仕組みがあることに気づきました。これをさまざまな短い間隔でループ実行し始めたところ、さらに興味深い結果が得られました。比較のため、先ほどの値もあわせて掲載しています:
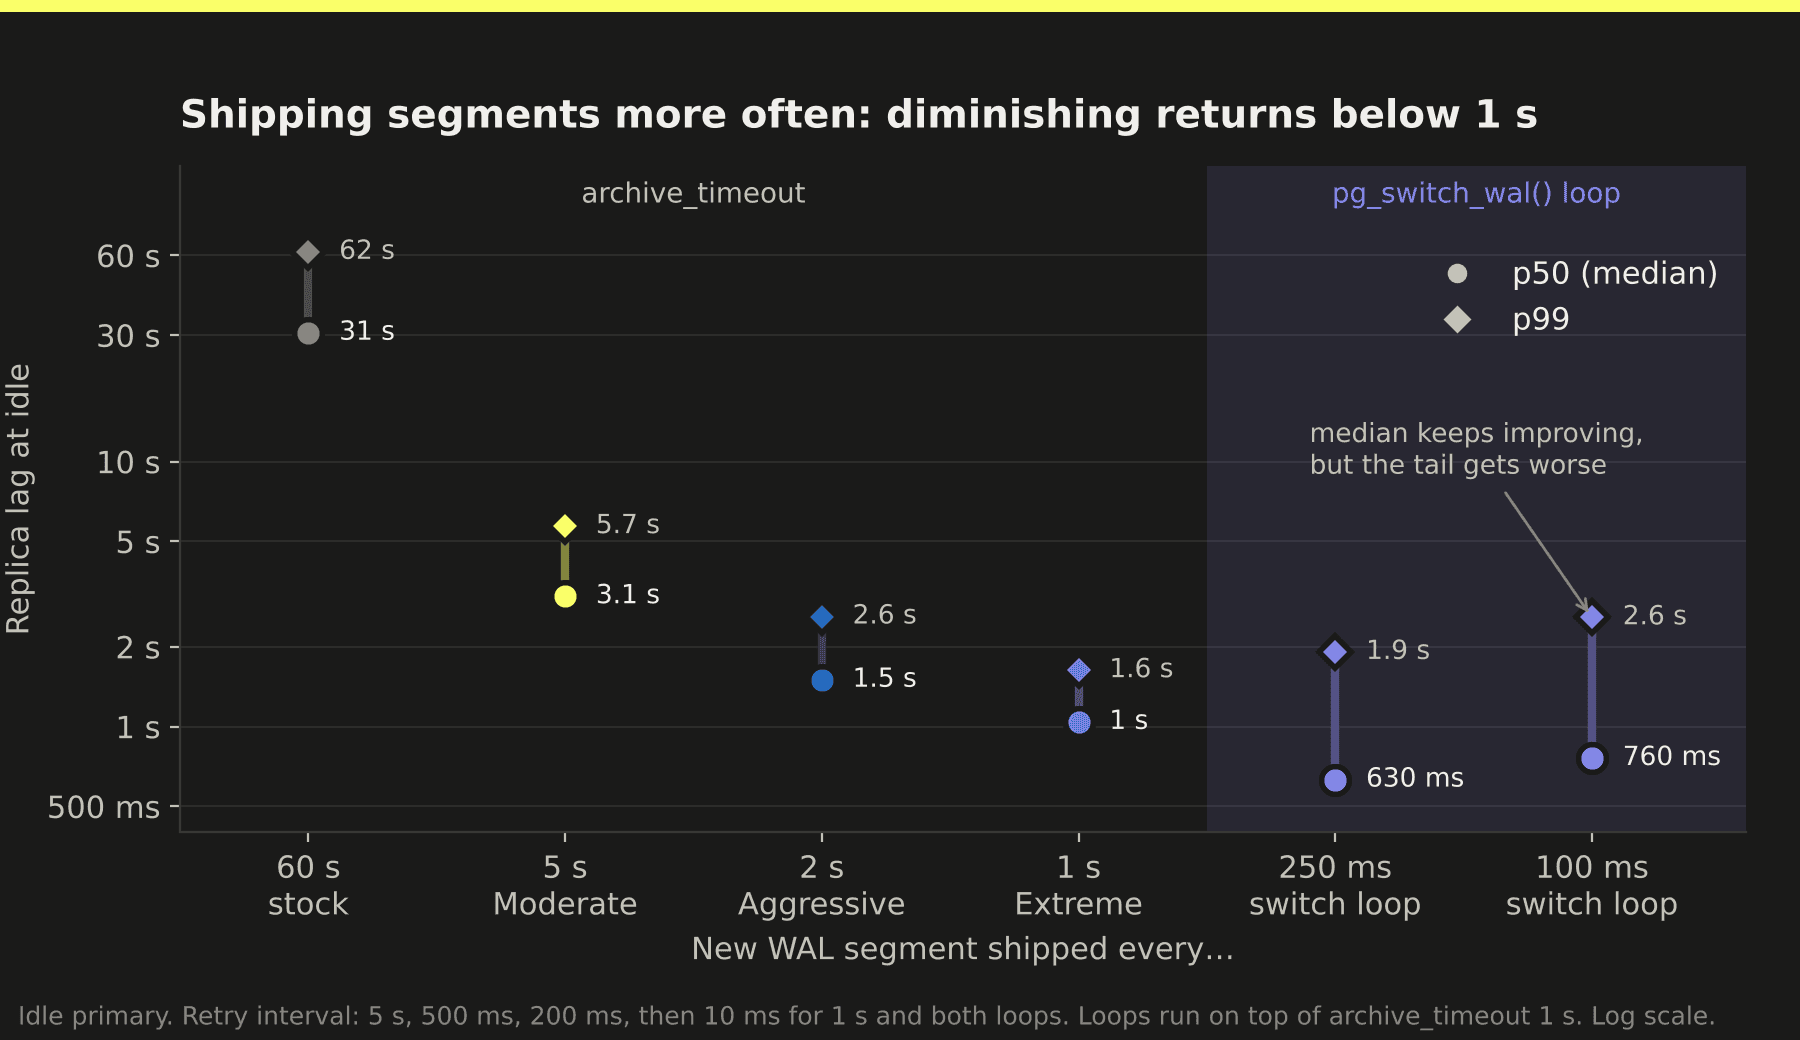
実際には、手間に見合うほどの改善は得られませんでした。セグメントごとに WAL-G のフェッチに伴うオーバーヘッドが発生するため、間隔を短くするにつれてそのオーバーヘッドにますます時間を食われるようになったのです。また、WAL の切り替えをアグレッシブにしすぎたときに p99 が p50 よりもはるかに悪化した理由もこれで説明がつきます。少しでも遅延や失敗が起きると、未処理のセグメントが連鎖的に滞留してしまうためです。
切り替えループはオーバーヘッドにも顕著な影響を及ぼしました。強制的な WAL 切り替えが発生するたびにプライマリは各 HA スタンバイへ 16 MB のセグメントを送信するため、クロス AZ やクロスクラウドのトラフィックを気にする必要がある環境では、あっという間に膨大な量になります。切り替えループの実行中はプライマリのスループットが 15% 前後低下しており、これはかなり大きなトレードオフです。
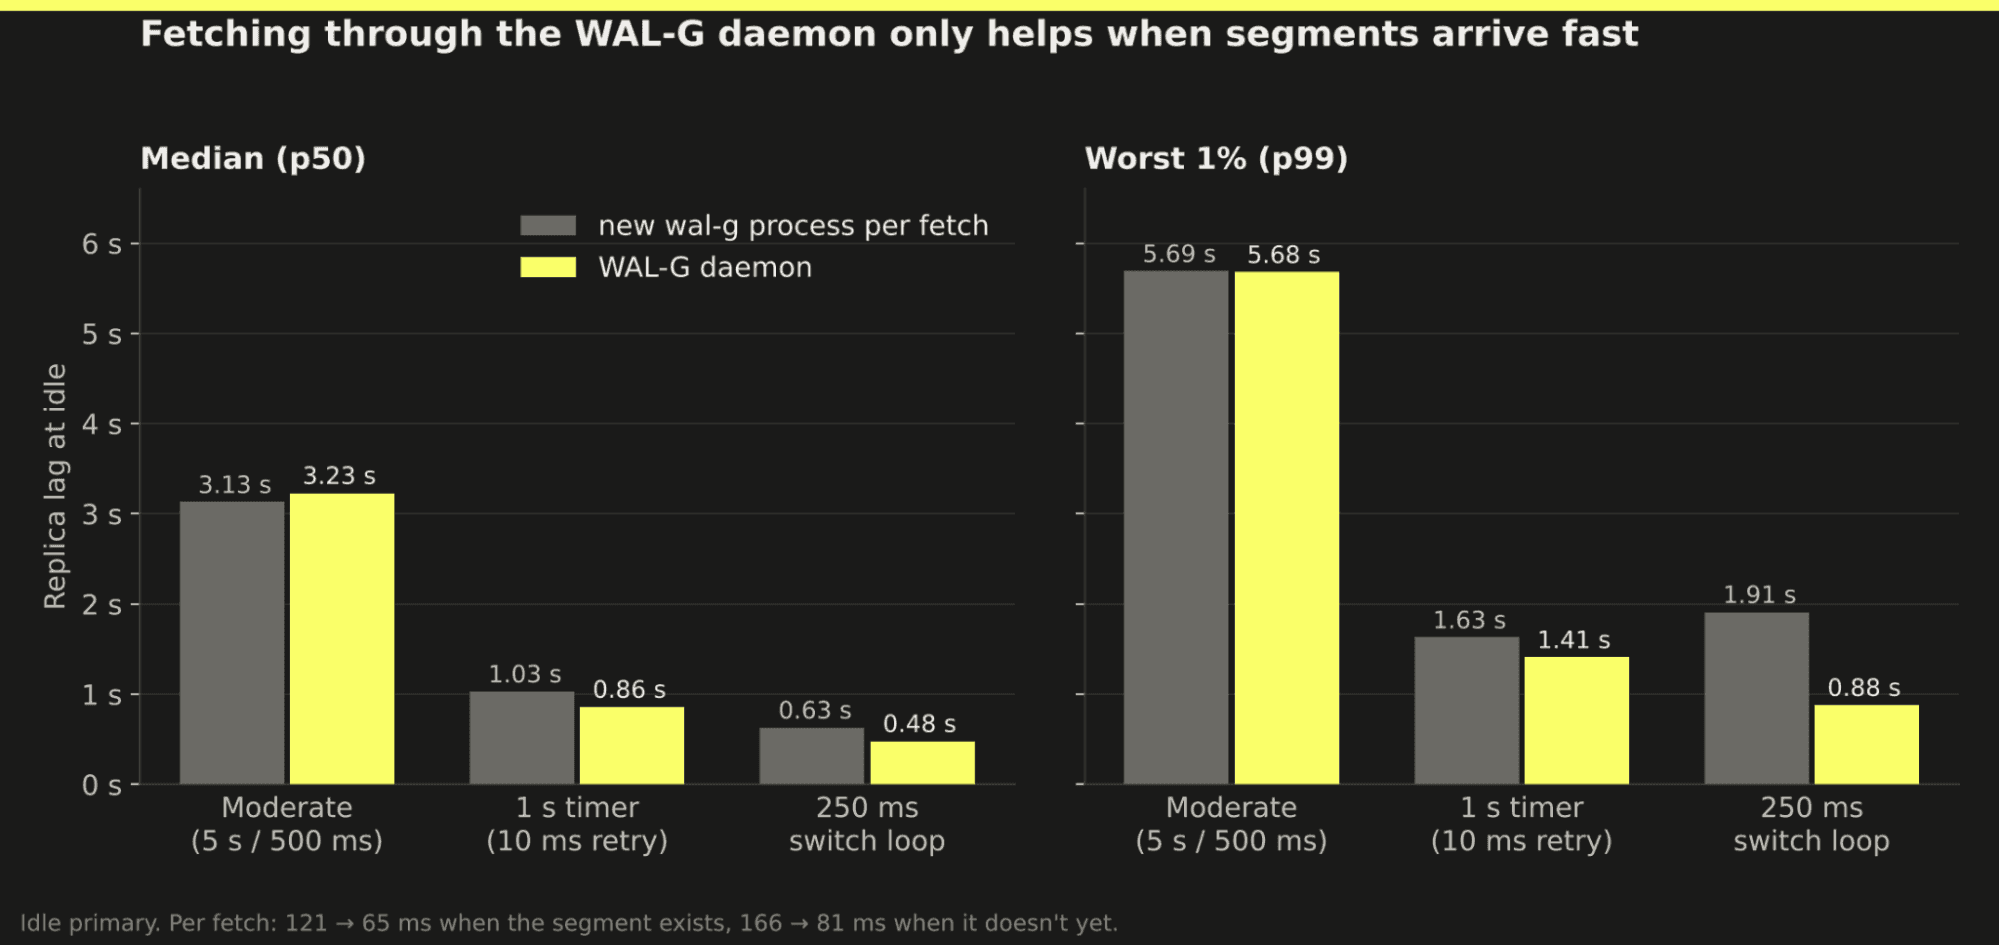
次に試したさらに無茶な手段は、工夫を凝らして WAL-G のオーバーヘッドに対処することでした。フェッチのたびに毎回 WAL-G が新しいプロセスを起動するのを待つことに多くの時間が費やされていましたが、実際にはそうする必要はありませんでした。これらのマシンではすでに WAL-G デーモンが稼働していたため、シンプルな設定を 1 行書くだけでそれを強引に利用できたのです:
restore_command = '/usr/bin/walg-daemon-client /tmp/wal-g wal-fetch %f %p'これにより、フェッチごとにヒット時で約 55 ms、ミス時で約 85 ms 短縮され、以下に示すように 250 ms の切り替えループではこの積み重ねが大きな効果を発揮しました。1s でも効果はあったもののそこまで劇的ではなく、それ以外ではほとんど無意味でした。リプレイパスにおける外部依存を増やすのは本番環境では決して良いアイデアとは言えませんが、こうした仕組みをどこまで限界まで追い込めるかを見るのは面白いものです:
総じて、なかなかの収穫があった 1 日でした! 最後にもう 1 つだけ確認しておきましょう。結局のところ、こうしたアーカイブ転送のチューニングは、単純にストリーミングレプリケーションを使う場合と比べてどうなのでしょうか?
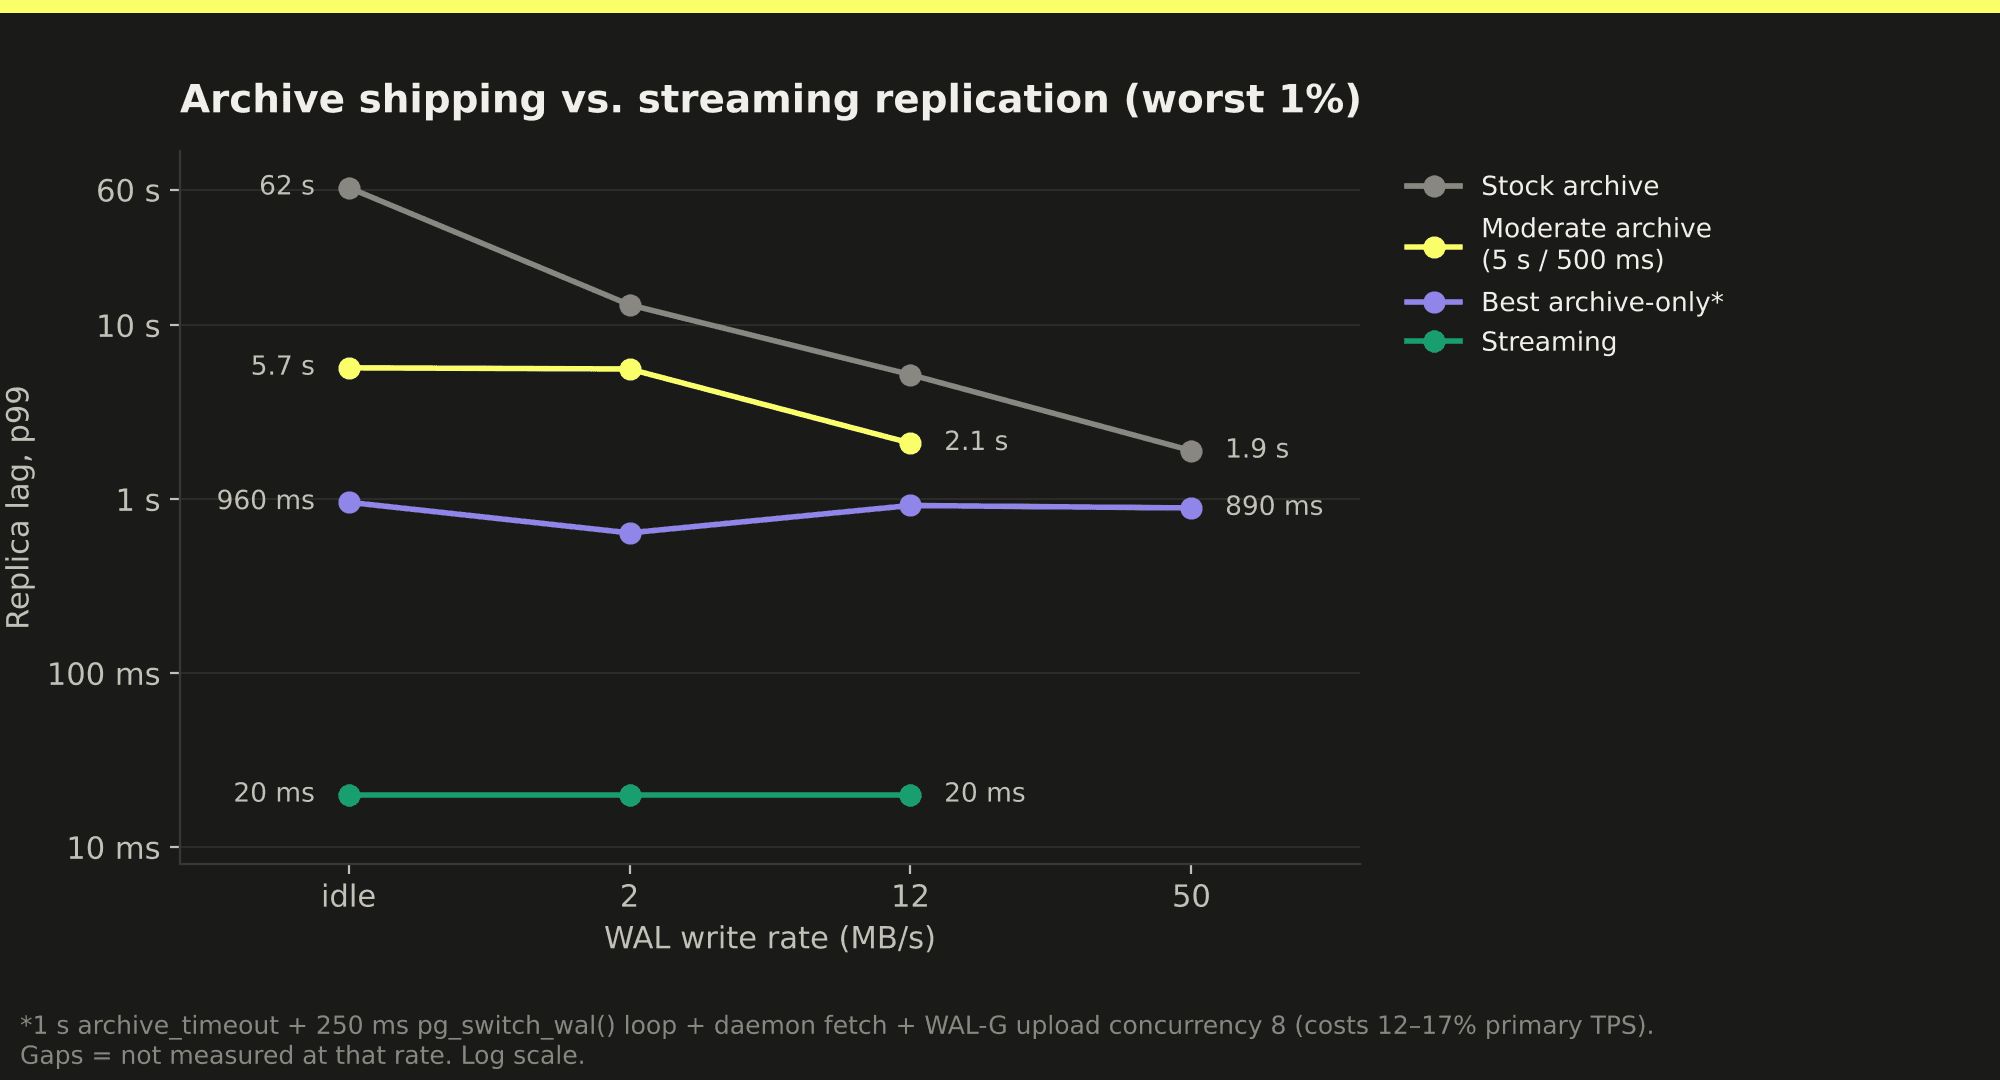
残念ながら、ストリーミングレプリケーションには勝てませんでした。とはいえ良い面を見れば、勝つ必要もありません。大半のユースケースでは 1〜3 秒のレプリケーションラグで十分すぎますし、ストリーミングレプリケーションには私たちがデフォルトの選択肢として採用するのをためらうよく知られた欠点がいくつかあるからです。
hot_standby_feedbackパラメータを有効にすると、プライマリ上で最近不要になった行であっても、レプリカ側で必要とされている場合は VACUUM による削除が妨げられることがある。- レプリケーションスロットがスタックしたり滞留したりすると、
max_slot_wal_keep_sizeを設定していない限りディスクが逼迫し、プライマリの障害を引き起こす可能性がある。 - レプリケーションのオーバーヘッドがプライマリの負荷を押し上げることがある。リードレプリカを利用するユーザーの大半はリソース制約を回避するために導入しているため、レプリカを最も必要としている人ほど打撃を受けることになる。
- HA フェイルオーバーの扱いが難しく、フェイルオーバー時にレプリカが壊れてしまう構成に陥りやすい。
なお、HA スタンバイにはストリーミングレプリカを使用しています。HA スタンバイでは読み取りアクティビティがなく、本番環境と同等のハードウェアが保証されているため、これらの欠点を効果的に軽減でき、ダウンタイムを最小化するうえで 1 秒未満のラグが非常に重要になるためです。
ClickHouse Managed Postgres を今すぐ始める
手元のデータで ClickHouse Managed Postgres の動作を試してみませんか。ClickHouse Cloud は数分で利用を開始でき、300 ドル分の無料クレジットを受け取れます。
サインアップ