5万

メモリオーバーコミットとは何であり、なぜ Postgres では厳格な設定が望ましいのでしょうか。プロセスが malloc を呼び出すと、Linux はアドレス空間を割り当てますが、物理メモリを関連付けるのは各ページに初めてアクセスしたときだけです。カーネルは割り当てた空間をコミットメントと呼び、オーバーコミットとは、大半のメモリ確保が完全には使い切られないことを前提に、マシンが実際に提供できる以上のコミットメントを許可するポリシーを指します。アクセスされたページ数が物理メモリを超えると、カーネルは OOM killer を呼び出し、プロセスに SIGKILL を送って強制終了させることでメモリを回収します。
Postgres はこのポリシーの影響をとりわけ強く受けます。すべてのバックエンドが共有バッファ、WAL バッファ、ロックテーブルを保持する単一の共有メモリセグメントを共有しており、バックエンドが SIGKILL で終了すると、そのセグメントが未知の状態のまま取り残される可能性があります。Postmaster にとって安全な対処法は破損を想定することだけであり、すべてのバックエンドを強制終了し、すべての接続を切断して、クラッシュリカバリにより WAL を再生します。
そのため、クエリ実行中に OOM killer によってバックエンドが 1 つ終了させられただけで、インスタンス全体が再起動することになります。
ClickHouse Managed Postgres では、すべてのサーバーで厳格なオーバーコミット(vm.overcommit_memory = 2)を設定して運用しています。カーネルはコミットされたメモリを追跡し、コミット制限を超えたメモリ確保を拒否するため、物理メモリが枯渇する前に malloc から ENOMEM として障害が表面化します。Postgres は ENOMEM を他の通常のエラーと同様に処理します。クエリは out of memory で失敗し、トランザクションはロールバックされ、残りの接続はそのまま稼働し続けます。これは、Postgres の公式ドキュメントのカーネルリソースに関する章でも推奨されている設定です。
コミット制限の設定
厳格なオーバーコミットは、制限値が適切な値に設定されていて初めて効果を発揮します。高すぎるとカーネルは裏付けのないメモリを依然として割り当ててしまい、低すぎるとメモリが余っているにもかかわらずクエリが失敗します。そのため、すべてのサーバーにはカーネルのデフォルトの比率ではなく、キロバイト単位で明示的な制限が設定されます。
# /etc/sysctl.d/99-overcommit.conf
vm.overcommit_memory=2
vm.overcommit_kbytes=<computed from MemTotal>制限値は、通常のメモリ確保に利用可能なメモリの 80% に 2 GB を加えた値です。この最初の項の大きさは、2 つの詳細によって決まります。
1 つ目は、マシンのメモリの 4 分の 1 がすでに shared_buffers 用の Huge Pages として予約されており、Huge Pages はコミット制限の計算対象に含まれないことです。Postgres は起動時にこのセグメントを一度だけマッピングし、コミット制限の管理対象外となるため、制限値はマシン全体ではなく残りの 75% の RAM を基準に計算されます。
2 つ目は 80% という比率です。残りのメモリはカーネル自体、ページテーブル、ページキャッシュ、そして Postgres が実行時にバックエンドごとに行うあらゆるメモリ確保をカバーする必要があるため、制限値は意図的に実メモリ量よりも手前に抑えられています。さらに上乗せされた 2 GB は、バックアップエージェントやメトリクスエクスポーターなど、Postgres と同じホスト上で稼働するサイドカープロセスのための余裕です。
結果として、コミット制限は合計 RAM の約 60% に 2 GB を足した値になり、物理的に数 GB の空きが残っている段階でカーネルは ENOMEM を返し始めます。このギャップこそが目的です。エラーを処理するためのメモリがまだ残っているうちに、エラーを確実に発生させることができます。
ClickHouse Managed Postgres を今すぐ始める
ClickHouse Managed Postgres が手元のデータでどのように機能するか試してみませんか?数分で ClickHouse Cloud を利用開始でき、300 ドル分の無料クレジットを進呈しています。
サインアップ実機での検証
単一の EC2 インスタンス上で両方のポリシーを検証しました。インスタンスは m7i.2xlarge (8 vCPU、30.8GiB) で、メモリの 4 分の 1 を 2MB の Huge Page として確保した Postgres 16 を稼働させ、そのプール上に shared_buffers = 6864MB をマッピングし、3GB の pgbench データセットを用意しました。30.8GiB のうち Huge Page プールが 7.7GiB を占めるため、残りの全用途には 23.1GiB が残ります。本番環境向けの計算式に基づくと厳格なコミット上限は 20.5GiB となり、マシンが物理的に割り当て可能な容量を約 2.6GiB 下回ります。
ワークロードは両条件で同一です。傍観者としてアイドル状態のセッション 20 本を接続したまま維持し、サーバーへの疎通を確認するためクライアントが 0.3 秒ごとに新しい接続を開きます。その上で、それぞれ約 2GB のインメモリアレイを構築して保持するセッションを 1 本ずつ順次追加していきます。クエリ自体に特異な点は一切なく、データ量が大きくなっただけの generate_series に対する一般的な集約であり、想定以上のソートや集約が発生した際の典型的なクエリパターンです。セッションの追加は実行が自律的に終了するまで続けます。2 つの条件間で異なる変数は vm.overcommit_memory のみです。
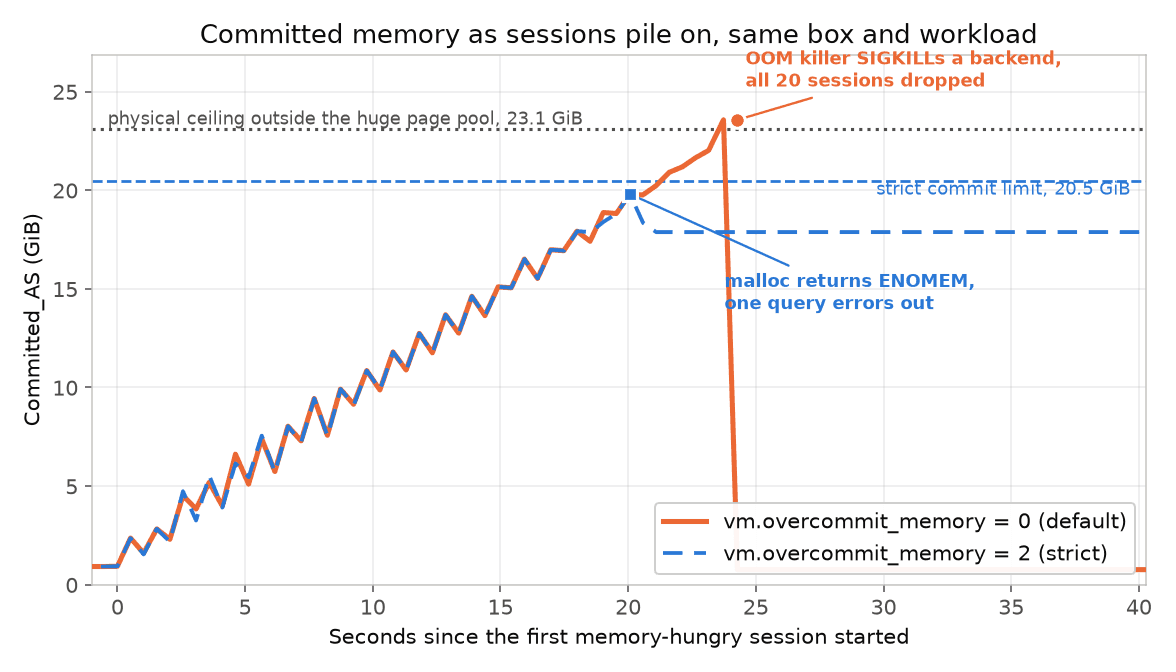
カーネルのデフォルトポリシーでは、コミット済みメモリはカーネル自身が報告する上限をそのまま突き抜けて上昇します。このマシンでの CommitLimit は 11.6GiB と表示されていましたが、コミット済みメモリは 6 本目のセッションでこれを超え、最終的には 2 倍以上の 23.6GiB にまで達しました。これは vm.overcommit_memory = 0 ではその上限があくまで参考値にすぎず、カーネルは割り当てごとに緩やかなヒューリスティックしか適用しないためです。負荷の増加開始から 24 秒後、空きメモリが残り 1.3GB となったところで 12 本目のセッションが物理メモリの裏付けのないページにアクセスし、OOM killer は常駐メモリサイズが最も大きかったプロセス (2.4GB を保持していたバックエンド) を標的に選びました。
Out of memory: Killed process 21268 (postgres) total-vm:9779160kB, anon-rss:2480672kB, oom_score_adj:0Postgres がその後に取った挙動はサーバーログに記録されており、その影響範囲はメモリを過剰に要求したセッションだけにとどまりません。
22:13:30.507 LOG: server process (PID 21268) was terminated by signal 9: Killed
22:13:30.509 LOG: terminating any other active server processes
22:13:30.604 FATAL: the database system is in recovery mode
22:13:30.808 LOG: all server processes terminated; reinitializing
22:13:30.876 LOG: database system was not properly shut down; automatic recovery in progress
22:13:30.886 LOG: redo starts at 3/592F5160
22:14:00.699 LOG: checkpoint complete: wrote 239686 buffers (27.3%); ... distance=1964319 kB
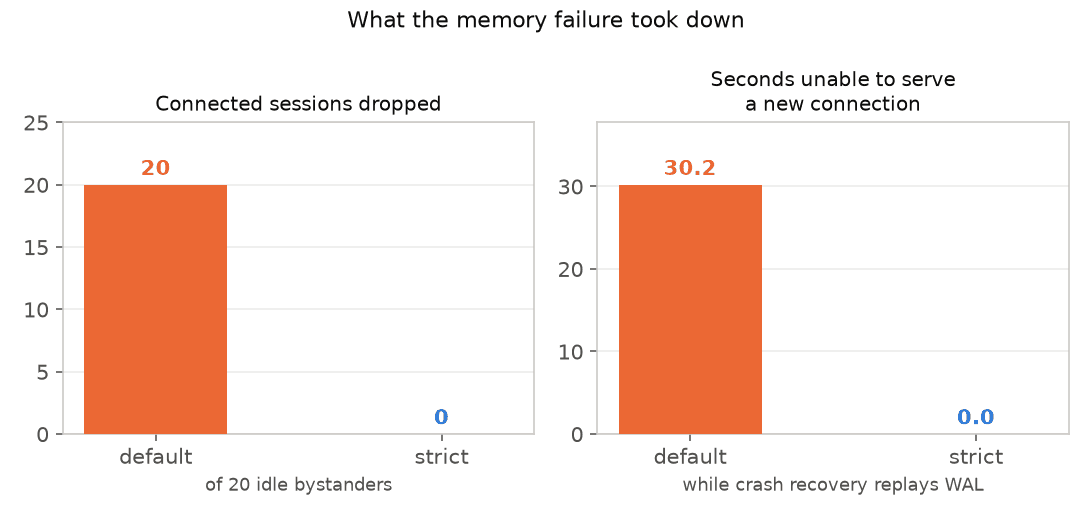
22:14:00.703 LOG: database system is ready to accept connections無関係な 20 本のセッションがすべて切断されました。これらのセッションには、同一インスタンス上で動作していたという点以外、メモリを大量消費するクエリとの関わりはまったくありません。負荷増加前の書き込み負荷により直前のチェックポイントから 1.9GB の WAL が残っていたため、その処理 (redo ログの適用と、それに続くバッファキャッシュの 27% を書き出すチェックポイント処理) により、サーバーは 30.2 秒間にわたってサービス停止に追い込まれました。0.3 秒ごとに新規接続を試行していたクライアントが計測した停止時間も、タイムスタンプが示す時間枠と一致していました。また、カーネルが選ぶ犠牲者は Postgres 内にもとどまりません。同一の OOM イベントによってログインセッションの systemd および (sd-pam) も強制終了され、テストを実行していた SSH セッション自体が切断されました。
厳格なオーバーコミットでは、同一マシン上での同じ負荷増加がより早い段階で、はるかに静かに停止します。コミット済みメモリは強制された上限値である 20.5GiB に対して 19.8GiB まで増加し、そこで停止しました。開始から 20.4 秒の時点で 10 本目のセッションがさらに 500MB を要求しましたが、カーネルはこれを拒否しました。
ERROR: out of memory
DETAIL: Failed on request of size 502000072 in memory context "SPI TupTable".
CONTEXT: SQL statement "SELECT array_agg(repeat('x', 1000)) FROM generate_series(1, 500000) g"障害の全容はこれだけです。1 つのクエリがエラーを受け取り、そのトランザクションがロールバックされ、メモリが解放されました。すでに 2GB を確保していた 9 本のセッションはメモリをそのまま保持しました。20 本の接続中セッションはすべて接続を維持し、新規接続の確認プローブもすべて成功し、カーネルには OOM kill が一切記録されませんでした。拒否された時点でまだ 3.8GB の空き容量があり、これが結果を左右しました。Postgres はエラーを報告し、ロールバックして処理を継続するだけのメモリが残っている段階で割り当てを拒否されたのです。
| デフォルトポリシー | 厳格なオーバーコミット | |
|---|---|---|
| コミット上限 | 11.6GiB (参考値) | 20.5GiB (強制) |
| コミット済みメモリのピーク | 23.6GiB | 19.8GiB |
| 障害発生時の残余空きメモリ | 1.3GB | 3.8GB |
| 障害の発生形態 | バックエンドへの SIGKILL | ERROR: out of memory |
| 影響を受けたセッション | 20 本中 20 本が切断 | 1 クエリ、切断されたセッションは 0 本 |
| 新規接続を受け付けられなかった時間 | 30.2 秒 | 0 秒 |
最後の論点は、障害が発生していない通常時にこのポリシーがどの程度のオーバーヘッドをもたらすかです。vm.overcommit_memory は実行時に変更可能なカーネルパラメータであるため、Postgres を再起動することなく 2 つの条件を比較できます。測定中も shared_buffers、ページキャッシュ、各バックエンドを同一の状態に保つことができ、キャッシュの温まり具合やテーブルの肥大化が双方に均等に影響するよう、2 つの条件を交互に繰り返して計測しました。
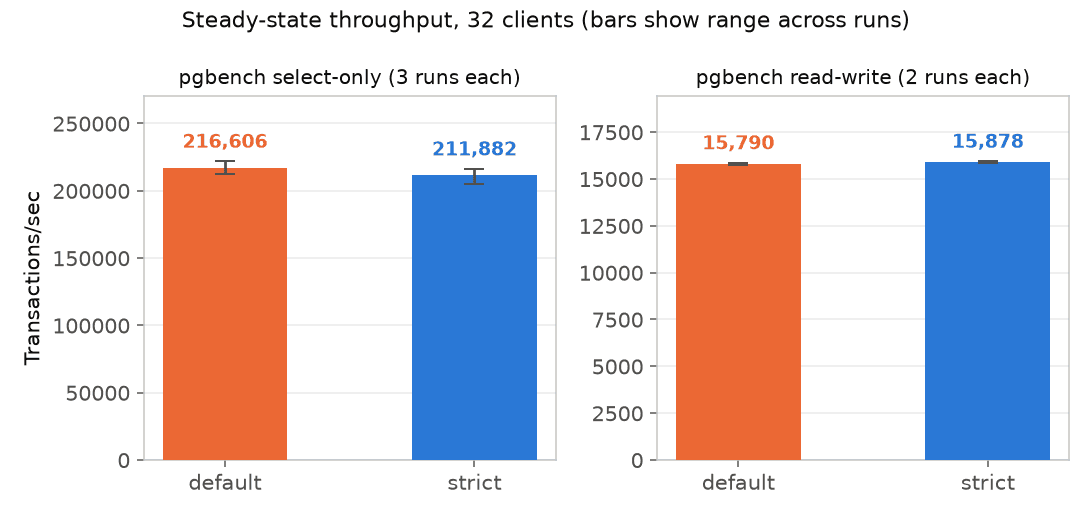
どちらのワークロードでも、2 つのポリシー間に有意な差は見られませんでした。参照のみのワークロードではデフォルトポリシーが 216,606 トランザクション/秒、厳格なポリシーが 211,882 トランザクション/秒で、その差は各条件内での測定ごとのばらつき (4〜5%) の範囲内に収まる 2.2% でした。読み書きのワークロードでは 15,790 と 15,878 で、差は 0.6% でした。厳格なオーバーコミットが変えるのはカーネルが保証する内容であり、その保証を維持するための計算処理にかかるコストは、このマシン上のベンチマークにおいてノイズと区別がつかないレベルにとどまります。
この最後の比較の厳密性について、補足事項が 2 点あります。新しくロードしたデータセットに対する読み書きのスループットは、安定するまでに 12,800 から 15,800 トランザクション/秒へと上昇したため、上記の読み書きの数値はプラトーに達した後の 2 回目のパスから取得したものです。1 回目のパスはポリシーではなくウォームアップを測定してしまうためです。また、このパスでは条件を デフォルト、厳格、厳格、デフォルト の順序で実行しています。順序を固定してしまうと、残存するどのようなドリフトも後から実行される条件に有利な形で累積してしまうためです。
まとめ
メモリの枯渇は発生するかどうかではなく「いつ発生するか」の問題であり、設定されたポリシーがその際の被害規模を決定づけます。カーネルのデフォルトポリシーでは、その代償は SIGKILL、インスタンス全体の再起動、そして接続されているすべてのクライアントの切断となります。Postgres サーバーで実際に利用可能なメモリに合わせて調整された厳格なオーバーコミットでは、他のすべてのセッションが稼働を続ける中で、被害は単一のクエリに対する 1 つのエラーだけで済みます。
すべての ClickHouse Managed Postgres サーバーには、デフォルトで厳格なオーバーコミットが設定されています。ぜひ Postgres をプロビジョニングして、その動作をお確かめください: https://clickhouse.com/cloud/postgres
今すぐ ClickHouse Cloud を始めて、$300 のクレジットを受け取りましょう。30 日間の無料トライアル終了後は、従量課金プランに移行できます。ボリュームベースの割引について詳しくは お問い合わせ ください。詳細は 料金ページ をご覧ください。