5万

概要
Managed ClickStack は、クエリビルダーチャートでの統計的な異常検知に対応し、アラート機能をスケールさせてさらに大規模なワークロードを処理できるようになりました。また、アラートの可視化と管理のためのツールも強化されています。これらの改善により、Grafana などのツールからより多くのアラートワークロードを ClickStack へ移行しやすくなります。
はじめに
5月、より複雑なアラート条件を必要とするユーザーの声に応え、SQL によるチャート作成とアラート機能を導入しました。これにより、移動ベースラインと比較したエラーのスパイクのチェックなど、任意の ClickHouse SQL でアラート条件を表現できるようになりました。しかしその柔軟性の反面、ベースラインを計算してアラートを発行するタイミングを判定する SQL の作成と保守が必要でした。
こうした要件の多くは、直近の履歴と比較して異常な値を検出することに集約されます。ユーザーは既存のクエリビルダーによる可視化にこうしたチェックを適用したいと考えていたため、Managed ClickStack に z スコアを用いた組み込みの異常検知機能を追加しました。感度を調整し、前日にアラートがどれくらいの頻度で通知を発行したかをプレビューできます。特に、通常は安定しているメトリクスのわずかな変動による誤検知の防止に注力しました。
Grafana からの移行を含め、Managed ClickStack を導入するチームからは、既存の数万件規模のアラートも持ち込まれました。大規模なアラートワークロードに対応するため、スケジューラーを改善し、シャーディングを導入して複数のワーカーに評価を分散できるようにしました。
これらの大規模なコレクションを実用的に管理できるようにするため、アラート UI での検索とフィルタリングの改善、アラートのアクティビティを示すチャートの追加、アラートの発行や失敗の理由を調査しやすくするための評価履歴の拡充も行いました。
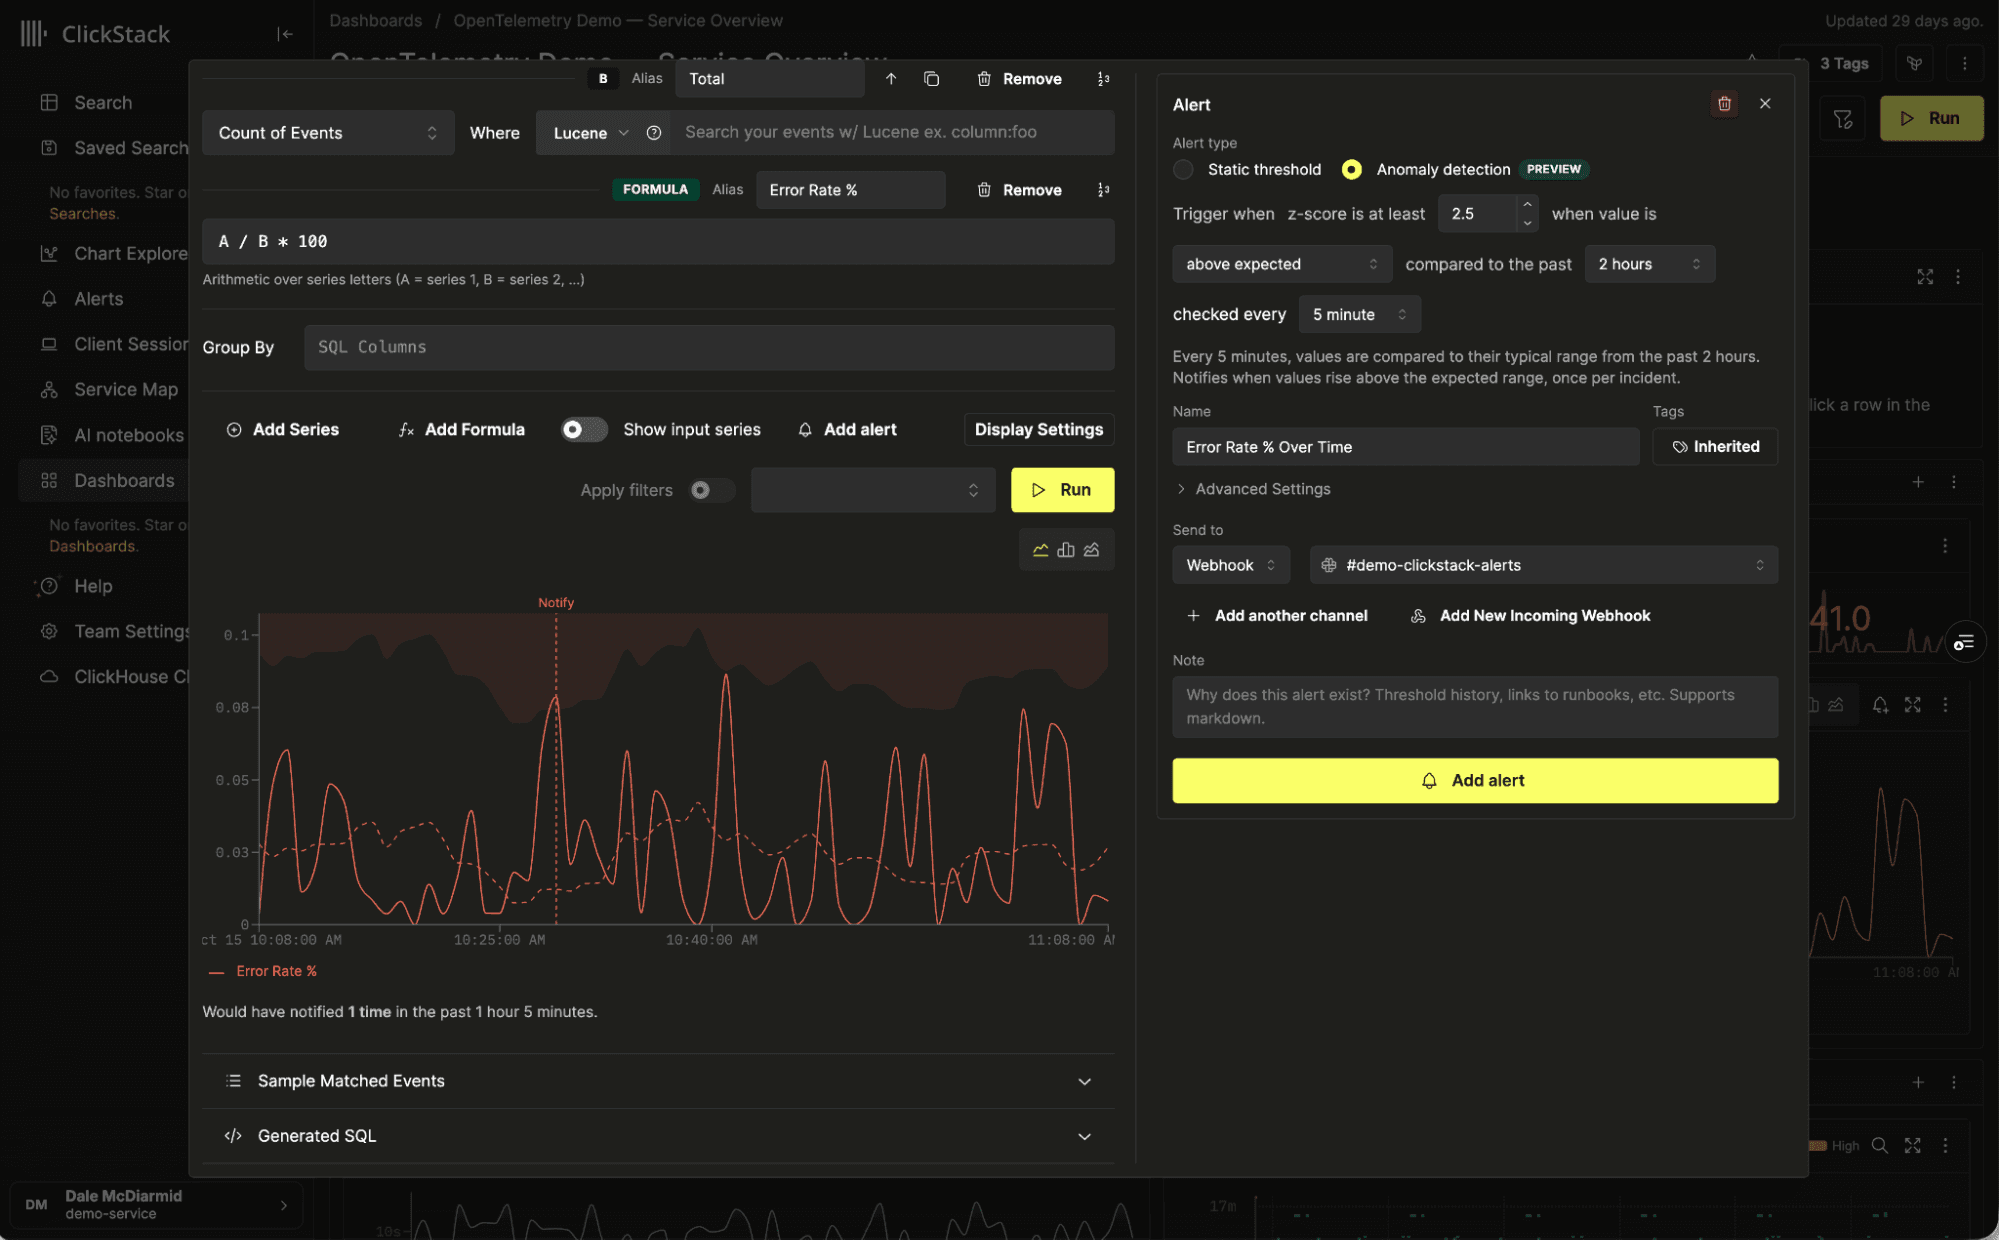
本記事では、これらの変更点と、Managed ClickStack へのアラートワークロードのさらなる移行をこれらがどのように支援するかを詳しく見ていきます。
普段お使いのチャートで使える異常検知
ClickStack は以前から静的しきい値アラートをサポートしてきました。これらは、適用したい明確な制限がある場合には効果的です。一方で、挙動の変化を捉えたい場合、特に通常稼働範囲が異なるサービス間では、設定が難しくなります。
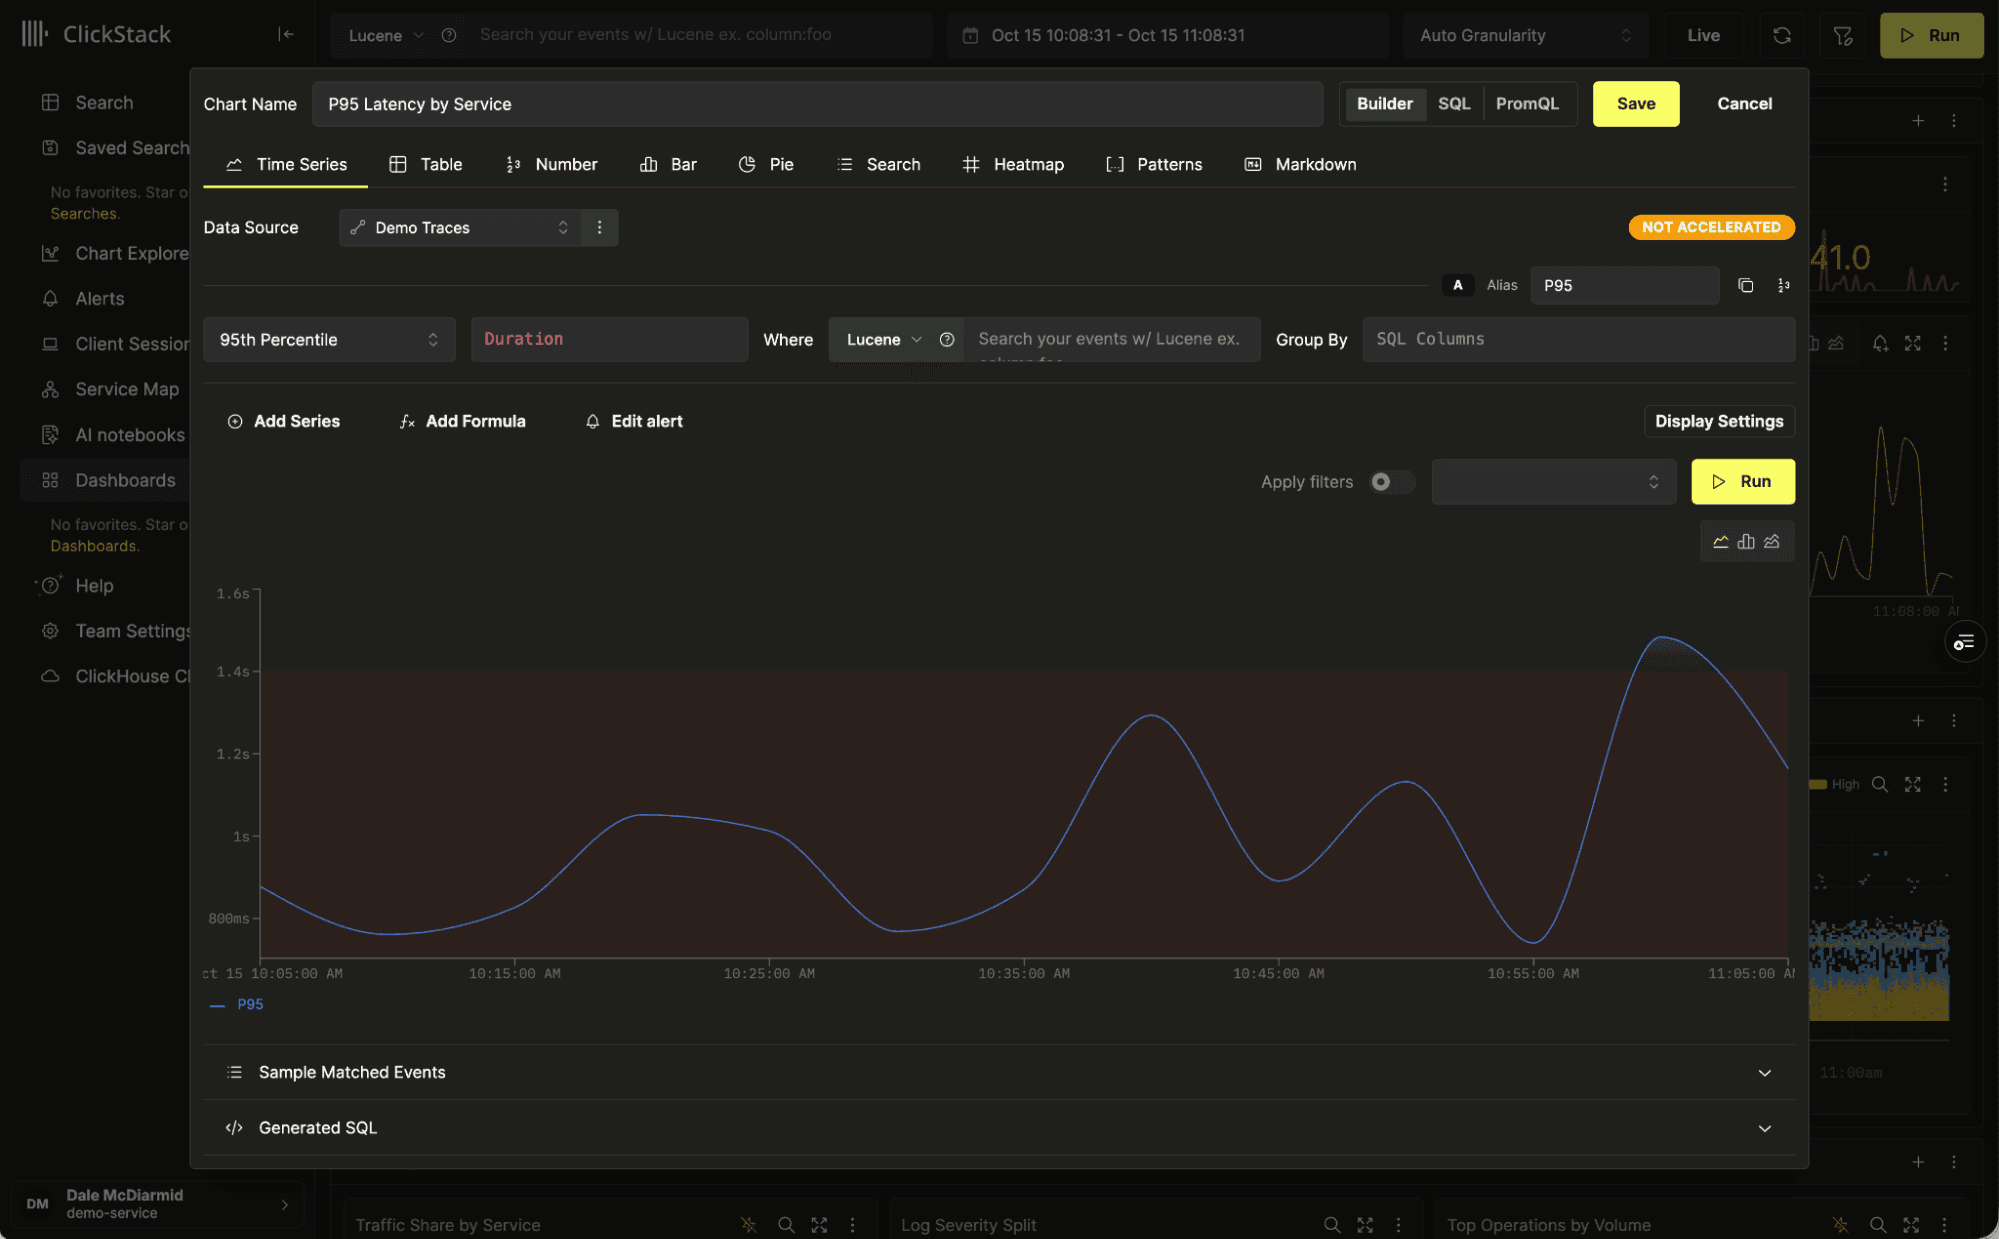
たとえば、通常のエラー率が約 0.1% で推移しているサービスを考えてみましょう。0.9% への増加は大きな変化ですが、1% に設定された静的アラートは作動しません。このサービスに対してしきい値を下げることは有効かもしれませんが、バックグラウンドでのエラー率がより高い別のサービスには異なる設定が必要になります。
各サービスをそれ自体の履歴と比較することで、個別にしきい値を維持することなく、こうした変化を検出できるようになります。初期実装の異常検知では、ある値を直近の履歴と比較するための一般的な統計的手法である z スコアを使用しています。これにより各サービスは独自のベースラインに対して評価されますが、そのベースラインをどのように計算するかにはいくつかの工夫が必要です。
z スコアは、値がベースラインの平均値からどれだけ離れているかを標準偏差の単位で表します。そのため、その感度はメトリクスが通常どれだけ変動するかによって左右されます。安定したサービスにとって異常な変化であっても、変動の激しいサービスにとっては日常茶飯事かもしれません。統計的に異常な変化が、必ずしも注意を払うに値するほど大きな変化とは限らないため、この特性がアラート作成における課題となります。
私たちは開発中にこの問題に直面しました。最初の試みでは、評価ウィンドウの直前の短い期間からベースラインの平均値と標準偏差の両方を推定していました。ほとんど変動しないメモリメトリクスでテストしたところ、標準偏差はほぼゼロになりました。その結果、ごくわずかな変動であっても高い z スコアが算出され、メモリ使用量に実質的な変化がほとんどないにもかかわらず、検出器が繰り返しトリガーされてしまいました。
そこで、期待値と標準偏差を異なる期間で計算することでこの問題に対処しました。期待値は、1 評価間隔前の 7 つの過去の 1 分間バケットの移動平均から算出します。標準偏差は、より長いベースライン (デフォルトでは 2 時間) で計算します。短い平均によって比較対象となる水準を定め、より長い履歴によってどの程度の変動が正常であるかを把握します。そして、観測値と期待値の差をその標準偏差で割ることで z スコアを算出します。
さらに、期待値に対して少なくとも 5% の変化があることを必須条件としました。これにより、安定したメトリクスにおけるわずかな動きが、単に大きな z スコアを生み出すという理由だけでアラートを生成することを防ぎます。先ほどのエラー率の例では、0.1% から 0.9% への増加は 1 パーセントポイント未満の変化ですが、この要件を容易に満たします。
不完全なデータも異常のように見える場合があることがわかりました。コレクターは多くの場合、データをバッチで送信するため、終了直後の 1 分間を評価すると、安定したストリームが急落したように見えることがあります。そのため、異常評価ではウィンドウをチェックする前にデータが到着するまで 30 秒の猶予を設けています。
異常検知の設定
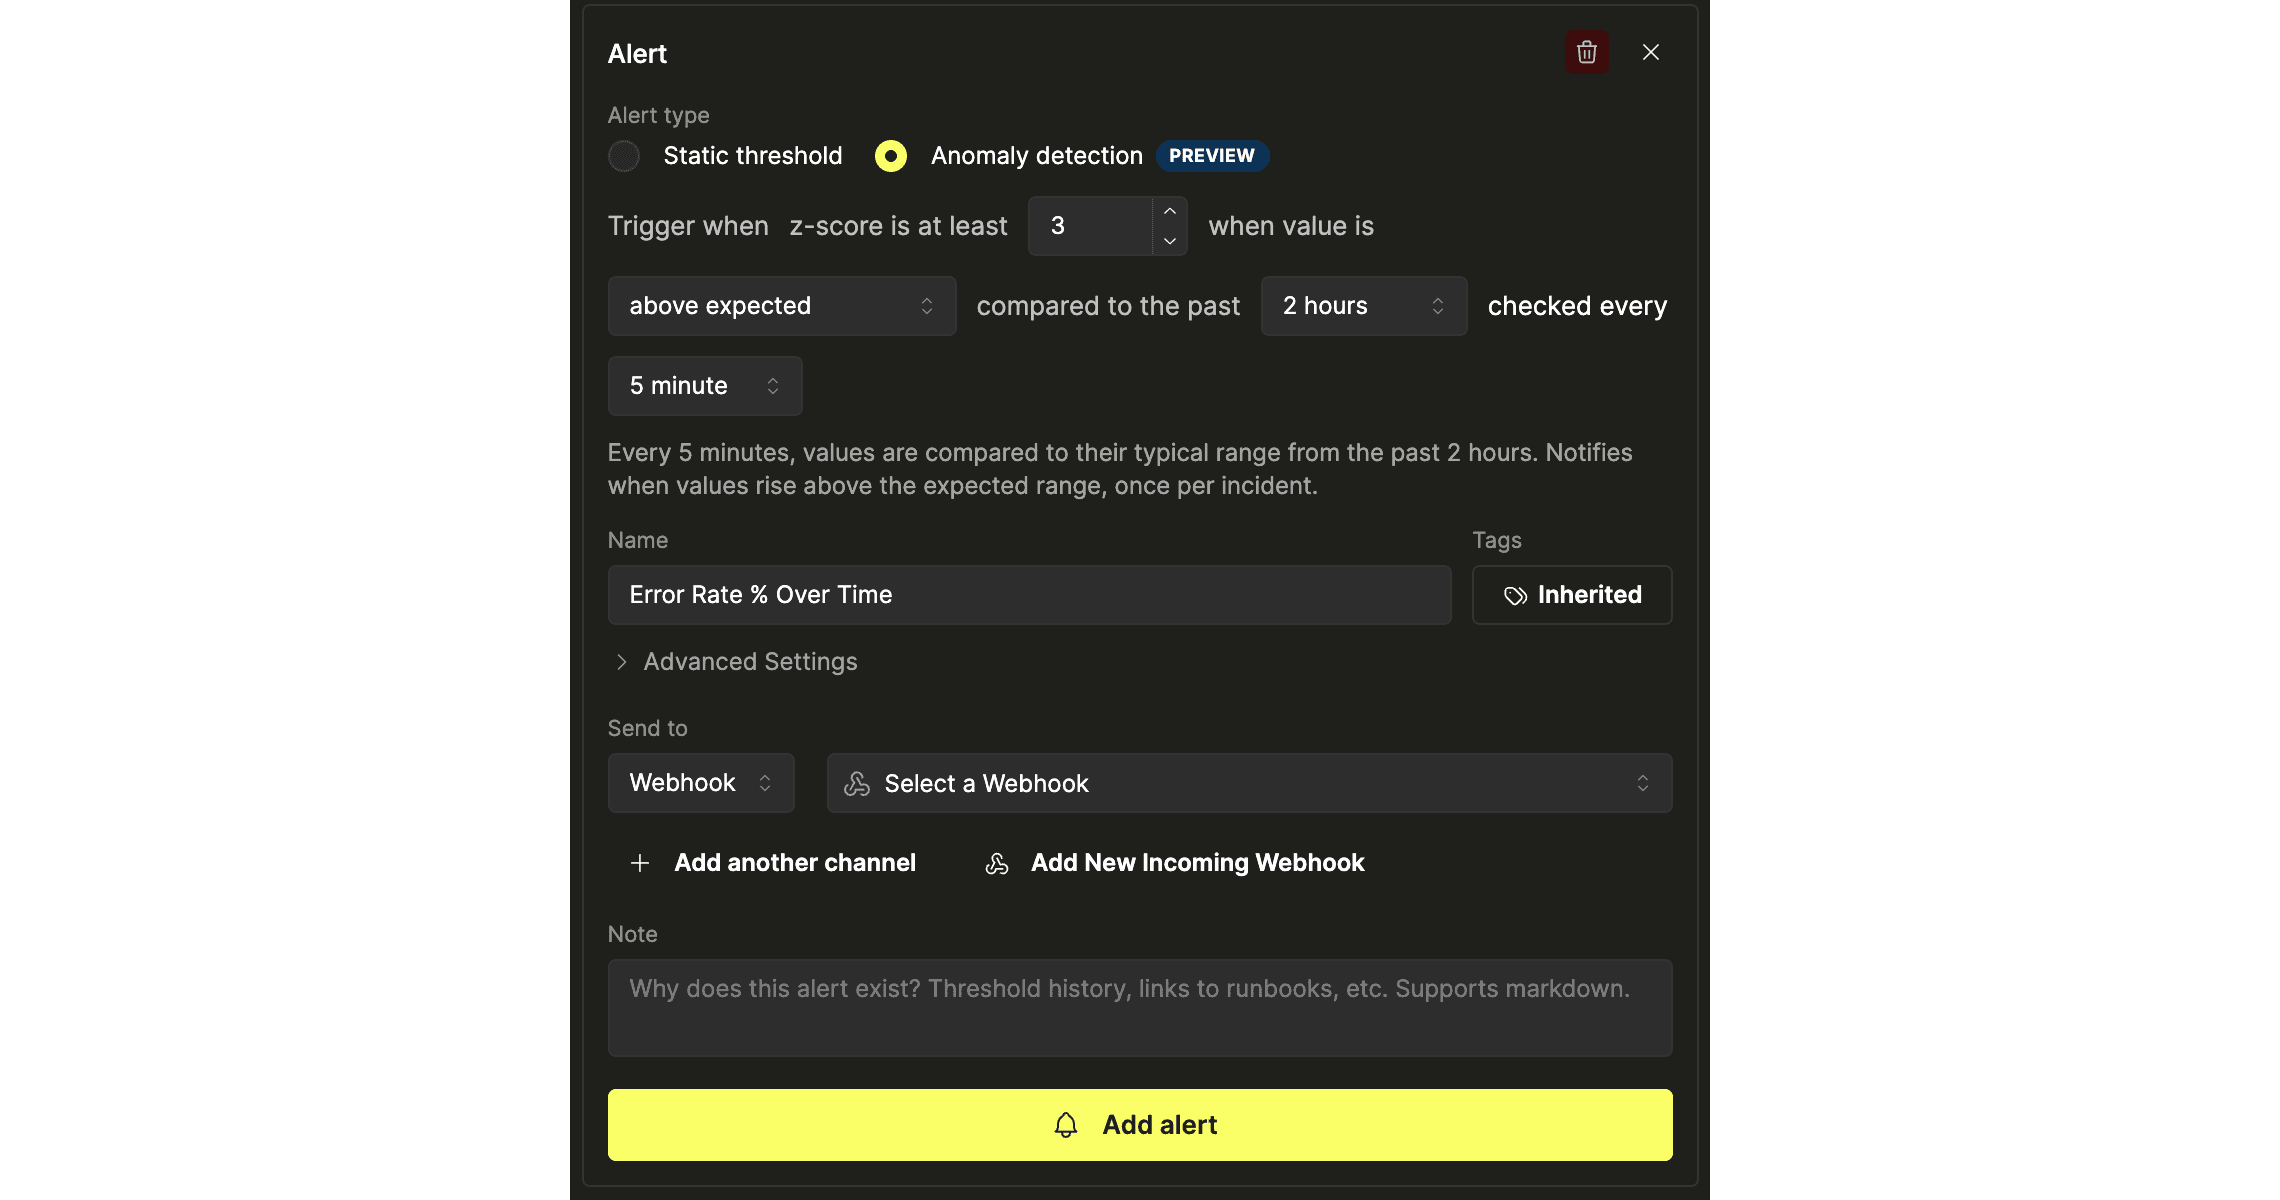
既存のクエリビルダーのチャートから、アラートタイプを Anomaly detection に変更するだけで、異常アラートを直接設定できます。感度に加え、ベースラインとして使用する履歴の長さと、アラートをトリガーする変化の方向を選択します。デフォルト値は、z スコアのしきい値が 3、ベースラインが 2 時間です。
エラー率の例では、エラーの異常な増加に関心があるため、Above the expected range を選択します。スループットのアラートであれば、リクエストの予期せぬ低下を検出するために Below the expected range を使用できます。どちらの方向への変化も調査の対象となる場合は、Outside the expected range を選択します。これは、急増と急落の両方が問題を示す可能性があるリクエスト量のアラートに適しています。
いずれの場合も、期待される範囲はメトリクスの直近の履歴と設定された感度を使用して計算されます。チャートで値がサービスごとにグループ化されている場合、各サービスは自身の履歴に対して個別に評価されるため、トラフィックレベルの異なるサービスでも同じアラート設定を共有できます。
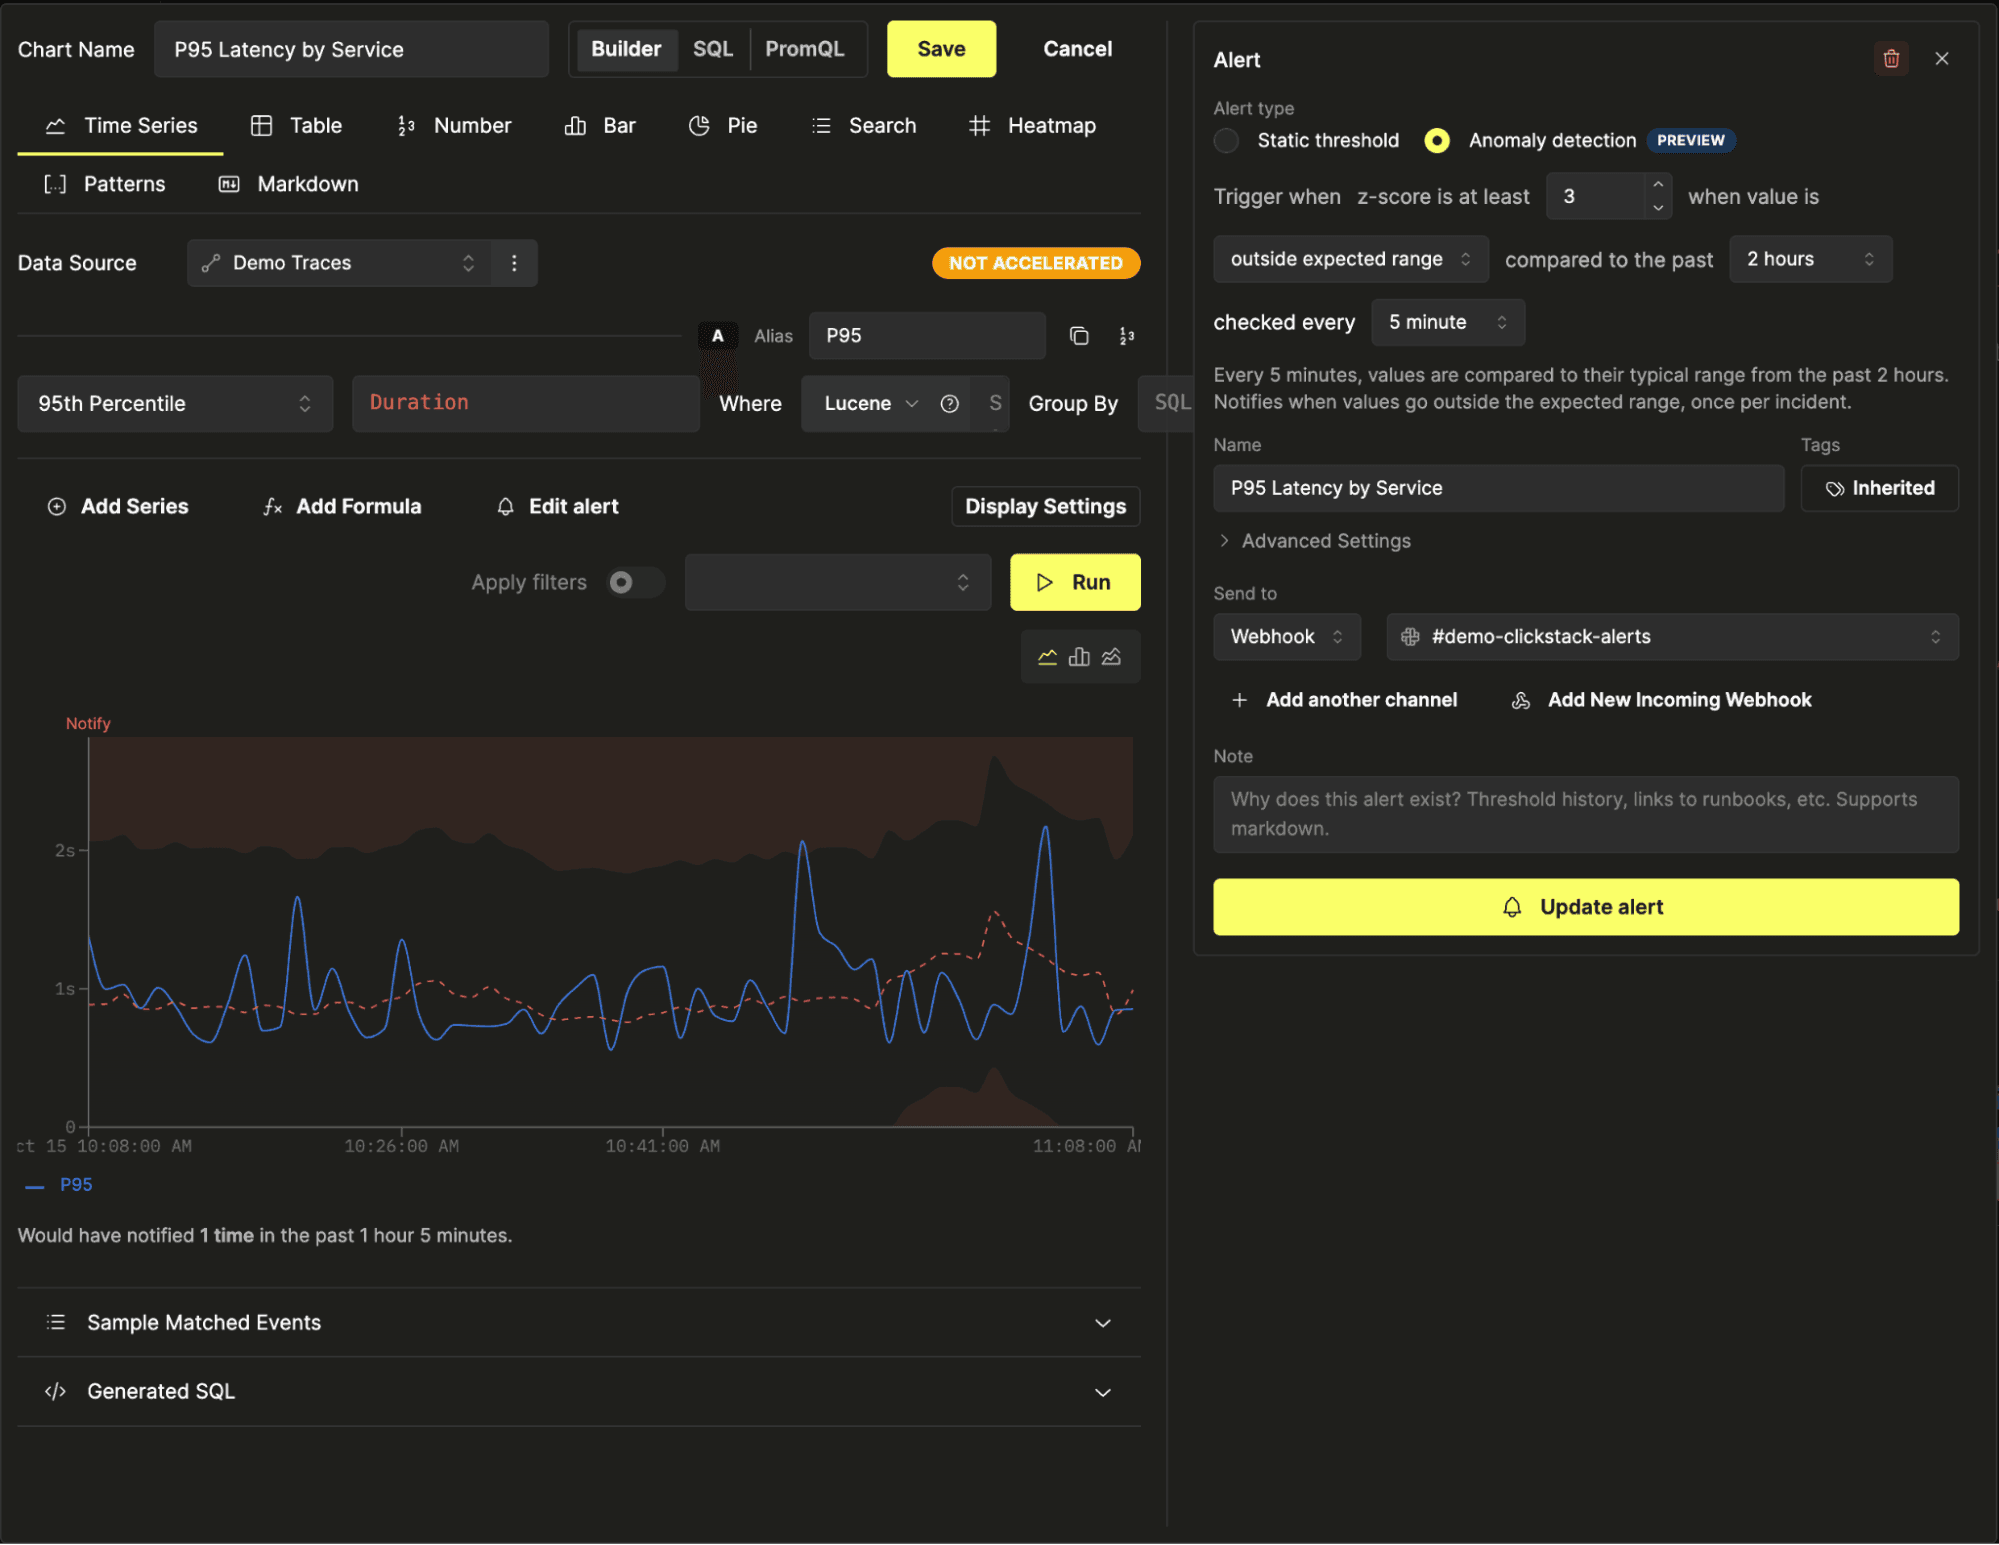
適切な感度の選択は、依然としてデータに依存します。保存する前に設定の挙動を確認できるようにするため、エディタには過去 24 時間を対象としたプレビュー機能が含まれています。チャートには期待される範囲が表示され、通知が送信されたであろう箇所にマークが付けられます。感度を調整するとプレビューが更新されるため、関心のあるスパイクをアラートが捕捉できているか、また通常の動作中にどれくらいの頻度で発報してしまうかを確認できます。
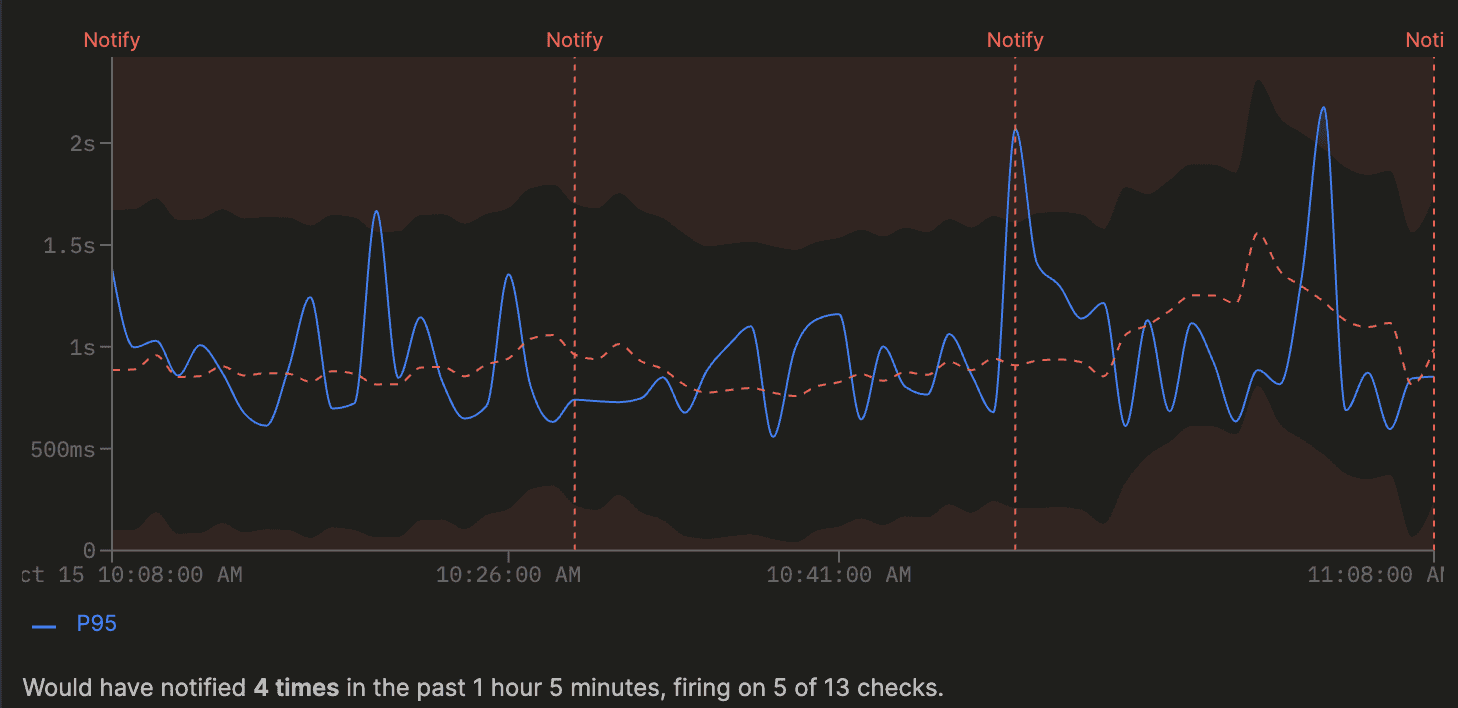
この初期実装は、直近の挙動からの急激な逸脱を捉えることを目的としています。ベースラインが追従してしまうため、緩やかな悪化は検出されない可能性があります。また、長引く問題が期待される範囲の一部となってしまい、問題が継続しているにもかかわらずアラートが解消されることもあります。日々や週ごとの周期的なパターンにも、異なるアプローチが必要です。今後のリリースでは、季節性のサポートの追加を含め、これらの制限に対処する予定です。最後に、エラー率を 1% 未満に保つ必要があるといった恒常的な制限値には、引き続き静的しきい値アラートを使用することをお勧めします。
ClickStack におけるアラートのスケーリング
ここ数か月、特に大規模なオブザーバビリティにおいて可能な限り低いユニットコストを求めるチームの間で、Managed ClickStack の導入が急速に進んでいます。こうした大規模なデプロイでは、既存の数万件のアラートが持ち込まれることも珍しくありません。これらのユーザーをサポートするには、アラートの数と評価頻度の両方が増加しても、アラートフレームワークが追従できるようにする必要があります。
アラートの数が膨大になると、スケジューラーがすべてのアラートを評価するのにかかる時間が、次回のスケジュール実行までの利用可能時間を超えてしまうことがありました。バックフィル機構により、スキップされた評価ウィンドウは後からチェックされますが、これでは問題の検出が遅れる可能性があります。こうしたワークロードのおかげで、スケジューラーのどこを改善すべきかが明らかになりました。
ClickHouse 内でのアラートクエリ自体の実行は高速でした。時間の多くは、アラート設定の読み込みと接続の待機に費やされていました。評価を開始する前に、スケジューラーは保存された検索、ダッシュボードのタイル、および関連するデータソースをルックアップする必要がありました。これらのルックアップは順次実行され、ダッシュボードやデータソースを共有するアラートに対して同じ情報が繰り返し取得されることがよくありました。
これに対処するため、期限を迎えたアラートについてのみ完全な設定を読み込み、これらのルックアップを並行して実行し、各実行内で共有メタデータを再利用するようにスケジューラーを変更しました。
結果の書き込みにも同様の問題がありました。各アラートが個別にデータベースへ書き込みを行っていたため、不要な書き込み処理が増加していました。現在ではこれらの結果をバッチで書き込み、データベース操作の回数を削減しています。また、ClickHouse の接続プールを増やし、評価キューに上限を設けることで、スケジューラーが一度に投入する作業量を制御できるようにしました。
通知も遅延のもうひとつの原因となっていました。以前は、評価処理が Webhook の配信を待機していたため、通知エンドポイントの応答が遅いとスケジューラー全体が滞ることがありました。これに対処するため、配信処理をバックグラウンドキューに移動しました。特定のアラートに対する通知の順序は維持され、Slack などの送信先からの応答を待つことなく評価を継続できます。
これらの変更により、単一のアラートワーカーが処理できる作業量が増加しました。これを活かすには、複数のワーカーに処理を分散させる必要がありました。そこで、アラート評価のシャーディングを導入しました。
各アラートは、その ID のハッシュを使用してシャードに割り当てられます。すべてのワーカーが同じ割り当てルールを使用し、自身のシャードに属するアラートを評価します。シャード数が一定であれば、各アラートのオーナーは 1 つになります。ワーカーを追加するとアラートがより多くのシャードに再分散され、ワークロードに応じて評価キャパシティをスケールさせることができます。シャード数は、評価の需要に基づいて自動的に決定されます。
ここでは頻度が重要になります。30 秒ごとにチェックされるアラートは、1 分ごとにチェックされるアラートの 2 倍の評価を必要とします。シャード数が変化するとオーナーシップがワーカー間で移行し、移行中に逃した評価ウィンドウはバックフィルによって補完されます。
これらの改善により、Managed ClickStack は最も要件の厳しいアラートワークロードにも確実に対応できるようになりました。
大規模なアラートの管理
アラートを大規模に評価するインフラが整ったことで、それらのコレクションを実用的に管理できるようにする必要もありました。ユーザーは、自身のサービスに関連するアラートを見つけ、何が発報しているかを把握する必要があります。過去数か月間にわたり、これらのワークフローを支援するため、アラート UI に一連の漸進的な改善を提供してきました。
最初の要件は、コレクションが大きくなってもアラートページの応答性を維持することでした。現在、ページはアラートを 100 件単位のバッチで取得し、画面に現在表示されている行のみをレンダリングします。これにより、すべてのアラートを一度に読み込んで表示することなく、大規模なコレクションを閲覧できます。
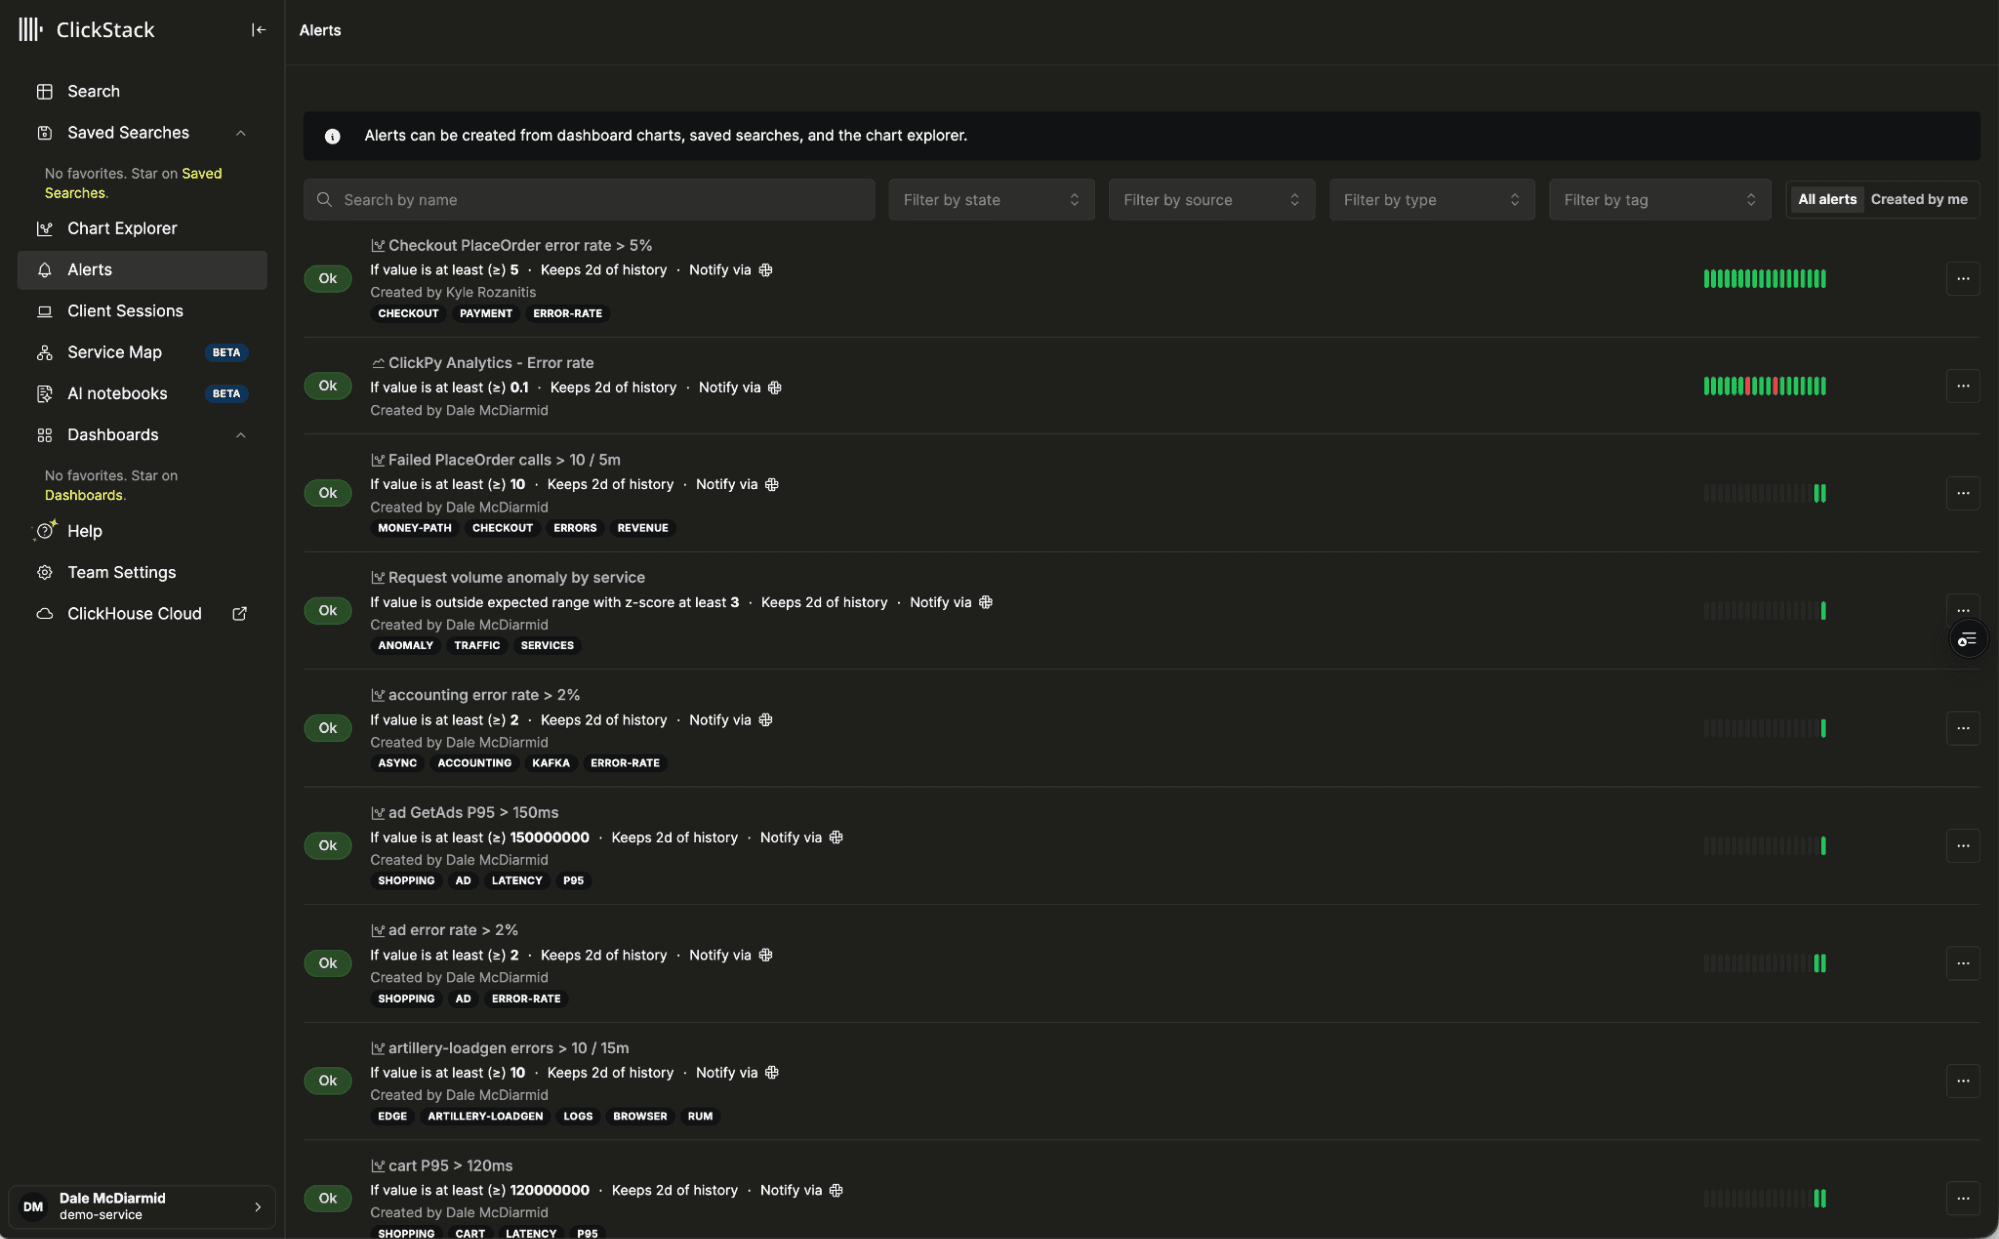
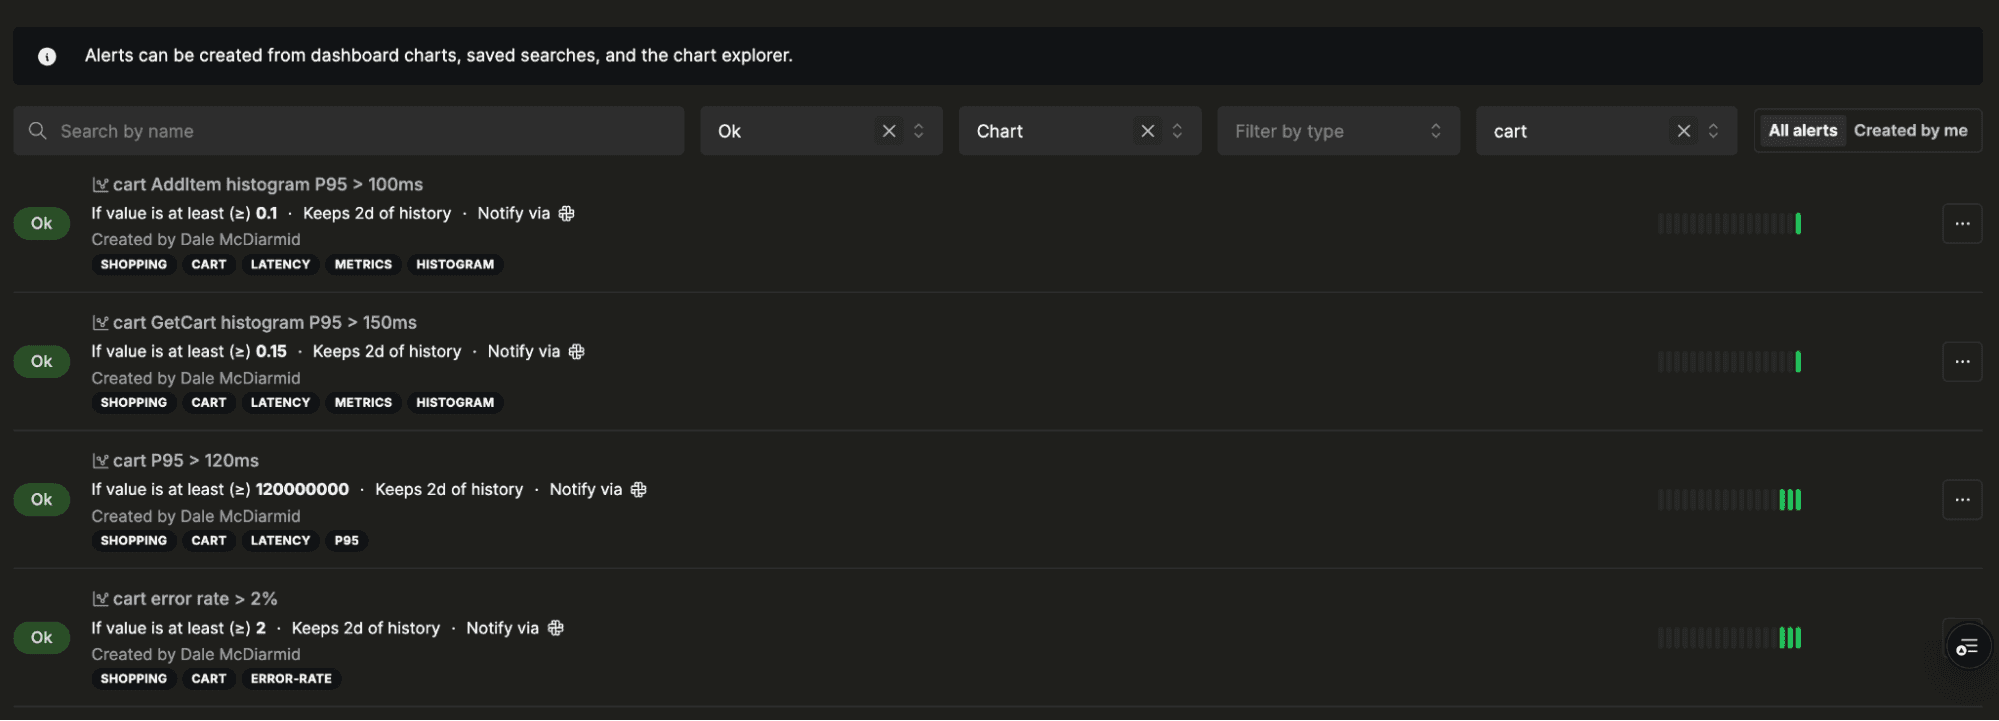
また、選択肢が数万件に及ぶと、特定のアラートを見つけることが難しくなります。アラートに独自の名前とタグを付与できるようになり、属している保存済み検索やダッシュボードチャートとは無関係に、アラートを整理して検索できるようになりました。状態、ソースタイプ、またはアラートが静的しきい値と異常検知のどちらを使用しているかでフィルタリングできます。自身が作成したアラート用のフィルターもあります。
たとえば、チームのアラートにサービスと環境のタグを付け、特定の本番サービスで発報中のアラートのみを表示するようにリストを絞り込むことができます。フィルターは URL に保持されるため、そのビューをブックマークしたり、他のチームメンバーと共有したりできます。
アラートを見つけたら、そのアクションメニューから編集、基盤となるソースの表示、Terraform へのエクスポート、削除を実行できます。各行には設定されているすべての通知チャンネルも表示され、通知がどこに送信されているかを簡単に確認できます。すでにインシデントを調査中であれば、アラートを確認 (acknowledge) し、30 分から 24 時間の範囲でミュートできます。
個々のアラートに関して利用可能な情報も拡充しました。各アラートの詳細ページには、発報時と復旧時を示すアノテーション付きのチャートが表示されます。チャートの横にある最近の評価結果のストリップが履歴を提供し、アラートが継続して発報しているのか、それとも状態間を繰り返し遷移しているのかを確認するのに役立ちます。
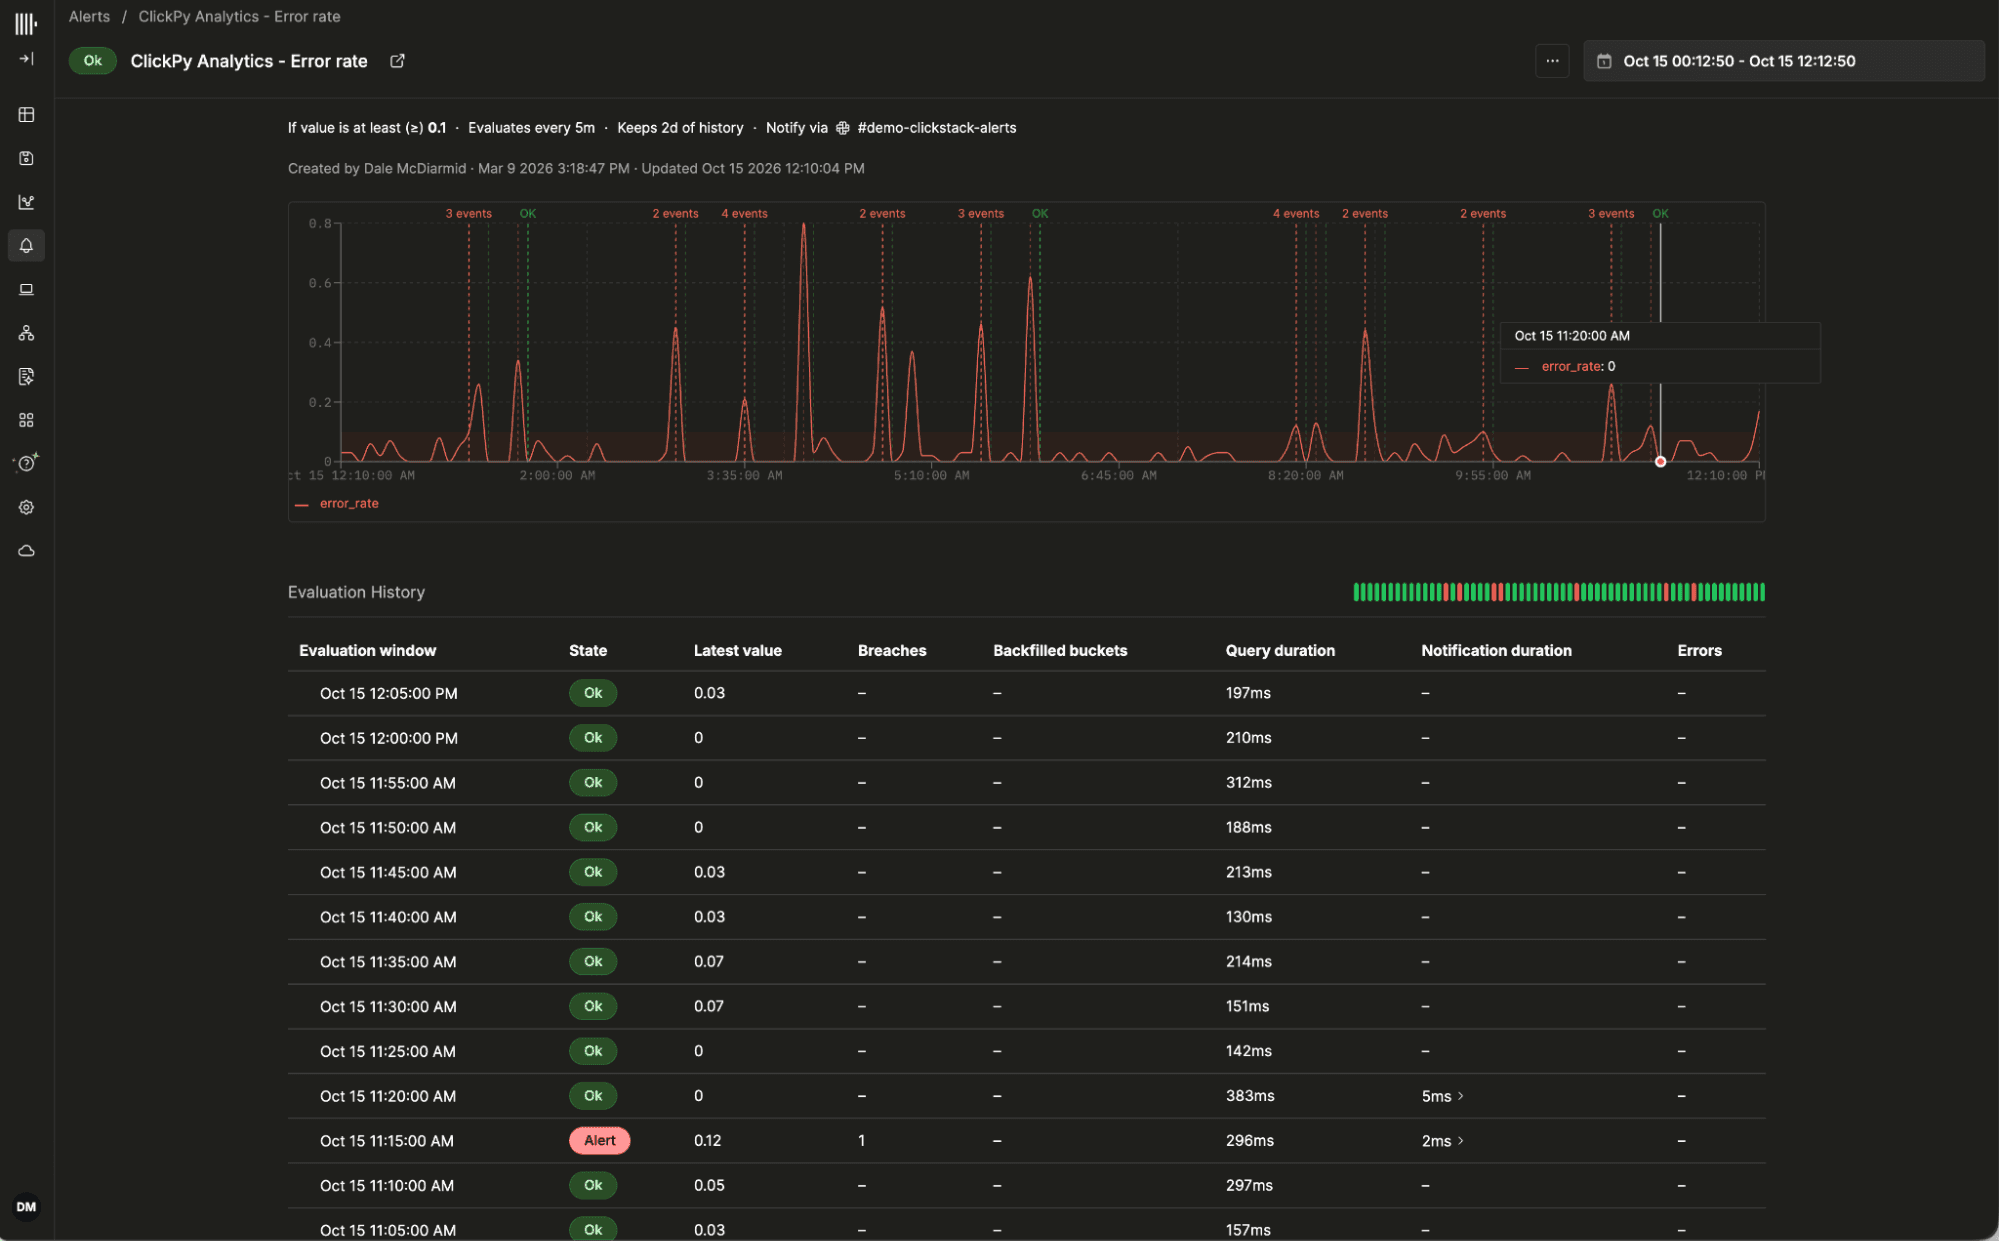
調査が必要な際には、評価テーブルによって詳細な情報が提供されます。観測値とアラート状態にあったシリーズの数が、クエリおよび通知の所要時間とともに記録されます。エラーの有無や、逃した評価ウィンドウがバックフィルされたかも表示されます。期待していた通知が届かなかった場合は、クエリが失敗またはタイムアウトしたのか、あるいは評価には成功したものの通知の配信が失敗したのかを確認できます。
今後の展望
アラートフレームワークが数万件のアラートをサポートできるようになったことで、従来 Grafana などのツールで処理されていた複雑なアラート要件に、さらに広く対応できると確信しています。
異常検知における次のステップは季節性への対応です。月曜の朝におけるサービスの通常の挙動は、週末の挙動とは大きく異なる場合があります。時間帯や曜日に対応するベースラインと値を比較することで、こうした周期的なパターンを考慮できるようにする予定です。また、過去の計算結果をキャッシュすることで、これらの比較による追加のクエリコストを抑制します。
初期の取り組みを通じて、ノイズの多いデータや低トラフィックのサービスに対する検知を改善する機会も見出しました。中央値に基づく推定や分位点バンドなど、外れ値の影響を受けにくい推定手法を検討する予定です。トラフィックが少ない場合、わずかなリクエストの失敗でも大きなパーセンテージの変化につながるため、エラー率のアラートには特別な配慮が必要です。リクエスト量を考慮したモデルにより、そうした変動と調査に値する変化とを区別しやすくなります。
さらに、よりシンプルな感度プリセットを用意したり、テレメトリが接続された際に初期の異常アラートを自動的に作成するオプションを追加したりして、これらの機能をより簡単に設定できるようにしたいと考えています。具体的なユーザー要件に応じた機能追加を継続しつつ、検知の改善につながる機械学習手法の探求も進める予定です。
PromQL および TimeSeries のサポート発表に続き、Prometheus メトリクスに対するアラート対応も優先事項のひとつです。プライベートプレビューでは、メトリクスの保存とクエリ、ClickStack でのチャート作成が対象となっています。PromQL クエリに基づくアラートのサポートは、ユーザーが主要なメトリクスアラートのワークロードを Managed ClickStack に移行できるようにするための重要な次のステップです。
今後数か月間のさらなる発表にぜひご注目ください。
今すぐ始める
自社のデータで ClickStack がどのように動作するか試してみませんか?ClickHouse Cloud の Managed ClickStack をわずか数分で開始でき、300 ドル分の無料クレジットも利用できます。
サインアップ