5万

私たちはこれまで、ClickHouse Cloud 向けの社内オブザーバビリティプラットフォームである LogHouse について公開記事で紹介してきました。前回の記事では、プラットフォーム全体で 1,000 兆行を突破したことについて書きましたが、OpenTelemetry はその中でも重要かつ急成長している部分を占めており、スタック内の全コンポーネントにわたるログ、メトリクス、トレースの統合収集レイヤーとして機能しています。
現在、私たちの OTel パイプラインは毎秒 5,000 万イベントを取り込み、177 PiB の非圧縮データを保存しています。このデータは、ClickHouse サーバーや Keeper、社内の Kubernetes ベースのサービス、外部クラウドプロバイダーのインフラストラクチャなどから収集されています。本シリーズの前回の記事では、コレクターベースの取り込みにおける耐障害性を確保するための、カスタム S3 バックエンドパイプラインを予告しました。本記事では、その完全なアーキテクチャと、ここに至るまでの経緯をご紹介します。
これまでの経緯
イテレーション 1: エージェントからゲートウェイへ
最初のイテレーションは、OTel のあらゆるリファレンス構成に見られる標準的なものでした。ノードローカルなエージェントが共有ゲートウェイ群へとデータを送信する 2 層構造のパイプラインです。
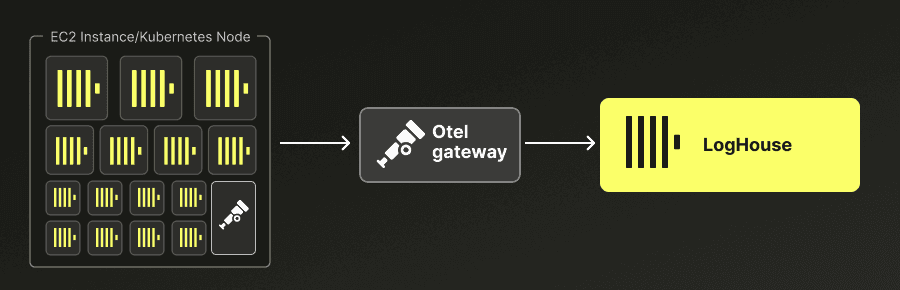
エージェントは各 Kubernetes ノード上で DaemonSet として稼働し、Pod のログを収集するとともにメトリクスとトレースを受信していました。ノードのメモリは実際のワークロードへ可能な限り割り当てたいため、これはリソースに制約のある環境です。そのため、エージェントは単にリソース属性を付与し、ごく最小限のバッチ処理を行うだけで、データをゲートウェイレイヤーへと転送していました。
ゲートウェイは、より重い処理を行うためのスケーラブルなレイヤーでした。ここでは、より多くのメモリを割り当てて、ClickHouse が最も得意とする大きな挿入バッチを蓄積できました。
この構成を選択したのは、誰もがそうするのと同じ理由からです。目新しさのないデフォルトの構成ですが、99% のユースケースで機能するからです。
プレッシャーによる破綻
このアーキテクチャでは、データベースからのバックプレッシャー(背圧)に耐えられないことがすぐに判明しました。デフォルトでは、ゲートウェイはリモートの下流にある ClickHouse の宛先にデータを送信する前に、メモリ内キューに送信データを格納します。毎秒 5,000 万イベントは(圧縮後で)10 GB/秒のデータ量に相当し、下流で発生するごくわずかな停止時間であっても、メモリで吸収することは経済的に現実的ではありません。
バックプレッシャーに遭遇する理由は、プロデューサーがテレメトリを生成するレートを制御することも、確実に予測することもできないためです。LogHouse は、フリート全体の ClickHouse サーバーや Keeper、Kubernetes サービス、クラウドプロバイダーのインフラストラクチャ、その他のシステムからデータを収集しています。それらのプロデューサーは、下流システムが取り込み用にプロビジョニングした許容量を上回るレートで、いつでもデータを送信する可能性があります。
持続的なデータ増加への対応は比較的容易です。テレメトリのデータ量が時間の経過とともに増加した場合は、手動で容量を追加するか、オートスケーリングによって対応できます。より難しいのは、一時的なスパイクへの対処です。フリートの一部に影響するエラーによって突然大量のログが生成されたり、頻繁に使用されるサービスで特定のリージョンにおけるアクティビティが突発的に急増したりすることがあります。これらは大きな規模になり得ますが、一時的であることが多く、スケーリングを行う妥当な理由にならないことが少なくありません。考えられるすべてのスパイクを吸収できるだけの容量をプロビジョニングすると、その容量の大部分は平常時にはアイドル状態のままになってしまいます。
そのため、LogHouse は考え得る最大の一時的な急増ではなく、適切な余裕を持たせた上で、想定される持続的なスループットに合わせてサイジングしています。取り込みパイプラインは、テレメトリが生成されるレートと ClickHouse がそれを受け入れられるレートの間で発生する一時的な不一致を吸収しなければなりません。それも、データを失うことなく、バックログのせいで最新のテレメトリが遅延することもなく、ピーク需要に合わせた恒久的なプロビジョニングを強いられることもなく実現する必要があります。この制約が、本記事の以降で紹介するあらゆるアーキテクチャの意思決定に影響を与えています。
イテレーション 2: ローカル Write-Ahead Log
メモリが不十分な場合、次の一手として明確なのはディスクベースのストレージです。OTel コレクターには、まさにこの目的のための file_storage エクステンションという組み込み機能があります。これを有効にすると、コレクターから送信されるすべてのデータは、下流に送信される前にローカルの Write-Ahead Log(WAL)に書き込まれます。
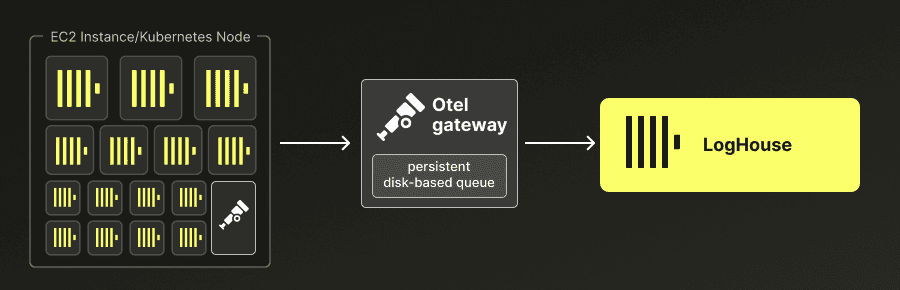
理論上は、これで問題が解決するはずでした。ディスクはメモリよりも安価で容量密度が高いため、最も長引くデータベースの停止にも耐えうる十分なバッファ領域をプロビジョニングできます。さらに、再起動によって転送中のバッチが失われることもなくなります。
残念ながら、これも私たちのニーズを満たすには至りませんでした。WAL を PVC(永続ボリューム要求)で運用することは、ゲートウェイを StatefulSet としてデプロイする必要があることを意味しました。Pod 仕様の大部分が変更不可になり、かつてはルーチンワークだったロールアウトも、慎重に計画して実行しなければならなくなりました。
第二に、必要なパフォーマンスを維持できませんでした。下流のデータベースが正常な間はスループットが安定していましたが、下流のバックプレッシャーが発生している間やその後に WAL のサイズが肥大化すると、スループットが低下しました。私たちの観測では、1 TiB のバックログを処理し切るまでに約 4 時間かかりました。私たちのテレメトリデータ量では、データベースがごくわずかに停止しただけでも、解消に何時間も要する WAL のバックログが生じることになります。このような状況では、WAL は Pod ごとに存在し、分割や分散ができないため、水平スケーリングを行っても効果がありません。
さらに悪いことに、WAL は概ね FIFO(先入れ先出し)の順序で処理されます。停止の後、最新のテレメトリは、一時停止が始まって以降に蓄積されたすべてのデータの背後、つまりログの最後尾に置かれます。そして、最新のデータが最も重要になるのは、まさにこうした状況のときなのです。
その結果、苦肉の策をとることになりました。最新のデータが何時間も遅延するほど WAL が大きくなった場合は、WAL を切り詰める(トランケートする)という運用です。テレメトリ用の高耐久ストレージを構築するために手間とコストをかけたにもかかわらず、そのデータを日常的に破棄していたのです。これは、コレクターの WAL が私たちにとって適切なソリューションではないことを示す兆候でした。
Kafka はどうか?
大規模なテレメトリパイプラインに詳しい方であれば、おそらく今 Kafka のことを考えているでしょう。エージェントとゲートウェイの間に Kafka や Warpstream、Pulsar などのストリーミングシステムを配置するのが標準的な定石です。ゲートウェイはストリームを消費するシンプルなステートレスレイヤーとなり、バックプレッシャーを吸収して個別にスケールできます。これは大規模環境でも実績のあるよく知られたパターンであり、私たちの問題の多くを解決してくれます。
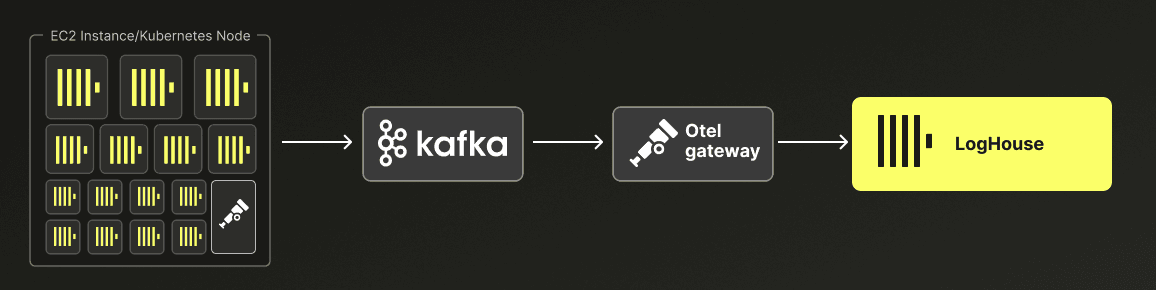
私たちは真剣に検討しましたが、その道を選ばないことにしました。これは技術的な評価ではなく、運用の観点からの判断です。私たちはインフラの他の場所で Kafka を一切デプロイしていません。Kafka を採用するということは、すべてのクラウドアベイラビリティゾーン/リージョンにわたって新しい Tier 0 サービスを立ち上げることを意味します。デプロイ、キャパシティプランニング、チューニング、オンコール対応、アップグレードなど、この単一のユースケースのためだけに膨大な専門知識と工数が必要になります。
そこで私たちは一歩引いて、次のように問い直しました。テレメトリの取り込みパイプラインに本当に求めているものは何だろうか?
イテレーション 3 の設計
コレクターアーキテクチャの 2 つのイテレーションと Kafka ベースの代替案の調査を経て、要件の輪郭は明確になりました。私たちの第 3 のイテレーションは、次の 4 つの制約を満たす必要がありました。
- 生のテレメトリ用の外部キューイングシステムを持たないこと。ホットパス上でデータをバッファリングするためだけに Kafka のような別のステートフルサービスを運用する負荷は引き受けられず、Kafka のヘッドオブラインブロッキングを受け入れることもできませんでした。
- 大規模でも高い費用対効果を維持すること。テレメトリはコストセンターであり、デプロイするすべてのものがクラウドのマージンに影響します。
- 障害時にも高い信頼性を発揮すること。パイプラインは、データを失うことなく、ClickHouse からの任意の期間のバックプレッシャーを吸収できる必要があります。
- オープンソースであること。ユーザーが ClickHouse と OTel を運用する方法と引き続き足並みを揃えたいと考えています。
設計の指針となったのは、2 つの着眼点でした。
1 つ目はブロブストレージです。S3、GCS、Azure Blob は容量制限がなく、耐久性に優れ、メンテナンスフリーであり、すでに私たちのクラウドの中核コンポーネントとなっています。
2 つ目は優先度ベースのフェイルオーバーです。OTel コレクターには、プライマリの送信先へルーティングし、プライマリからの障害を検知したときにのみセカンダリへフォールバックする failoverconnector が標準で用意されています。これにより、ClickHouse をホットパスに維持しつつ、バックプレッシャーが発生したときにのみ作動する安全弁としてブロブストレージを扱う手段が得られました。
これはコスト管理において決定的に重要でした。すべてのデータを最大取り込みレートでブロブストレージに書き込むと、コストが跳ね上がってしまいます。毎秒 5,000 万イベントの場合、PUT オペレーションのコストだけでストレージ料金をはるかに上回ります。オブジェクトストレージはデータの保持には安価ですが、高いスループットでの書き込みには費用がかかります。現在のデータ量における自社のワークロードでは、API コストだけで年間 10 万ドルから 50 万ドルになると試算され、指数関数的な成長率を前にして到底持続不可能な額でした。優先度ベースのフェイルオーバーを採用することで、ClickHouse が利用できない断続的な時間枠の間だけ、それらの PUT コストを支払えばよくなりました。通常稼働時には、テレメトリは ClickHouse へ直接送信されます。
ブロブストレージにデータが溢れ出た後は、イベント通知を利用してブロブを取り出し、別のコレクターで ClickHouse に書き戻します。これもブロブストレージの基本的な機能であり、特定の操作(新規オブジェクトの作成など)の記録を、オブジェクトのメタデータとともにキューに発行できます。これにより、バケット内の一覧取得や進捗のチェックポイント作成を行うよりも、シンプルでスケーラブルなモデルが実現します。
ブロブストレージがダウンした場合はどうなるか?
ここでそう疑問に思うのはもっともなことです。特に、ClickHouse Cloud 自体もブロブストレージをバックエンドとしているためです。ブロブストレージが完全に停止した場合は、プライマリとバックアップが同時に停止することになり、このオーバーフローメカニズムでは対処できません。
しかし、S3 の完全な停止は稀であり、私たちが備えようとしている障害とは種類が異なります。オーバーフロー用のバケットを、対応する LogHouse クラスターとは異なるリージョンに配置することも検討しましたが、これほど稀な状況のためにオーバーフローバッチをリージョン間で転送するエグレスコストは割に合いませんでした。
そのため、私たちはより一般的な障害モードを想定して設計しました。ブロブストレージでは、特定のキーやプレフィックスに対する厳しいスロットリングという形で、部分的な障害が頻繁に発生します。そこで、フェイルオーバー時に特定のプレフィックスへ負荷が集中しないよう、オーバーフローしたバッチを広いキースペースに分散させました。イベント通知にはオブジェクトの完全なキーが含まれているため、キーの構造は完全に不透明(Opaque)で構わず、範囲スキャン向けに最適化する必要がないことから、この設計が成り立ちます。
新しいパイプライン
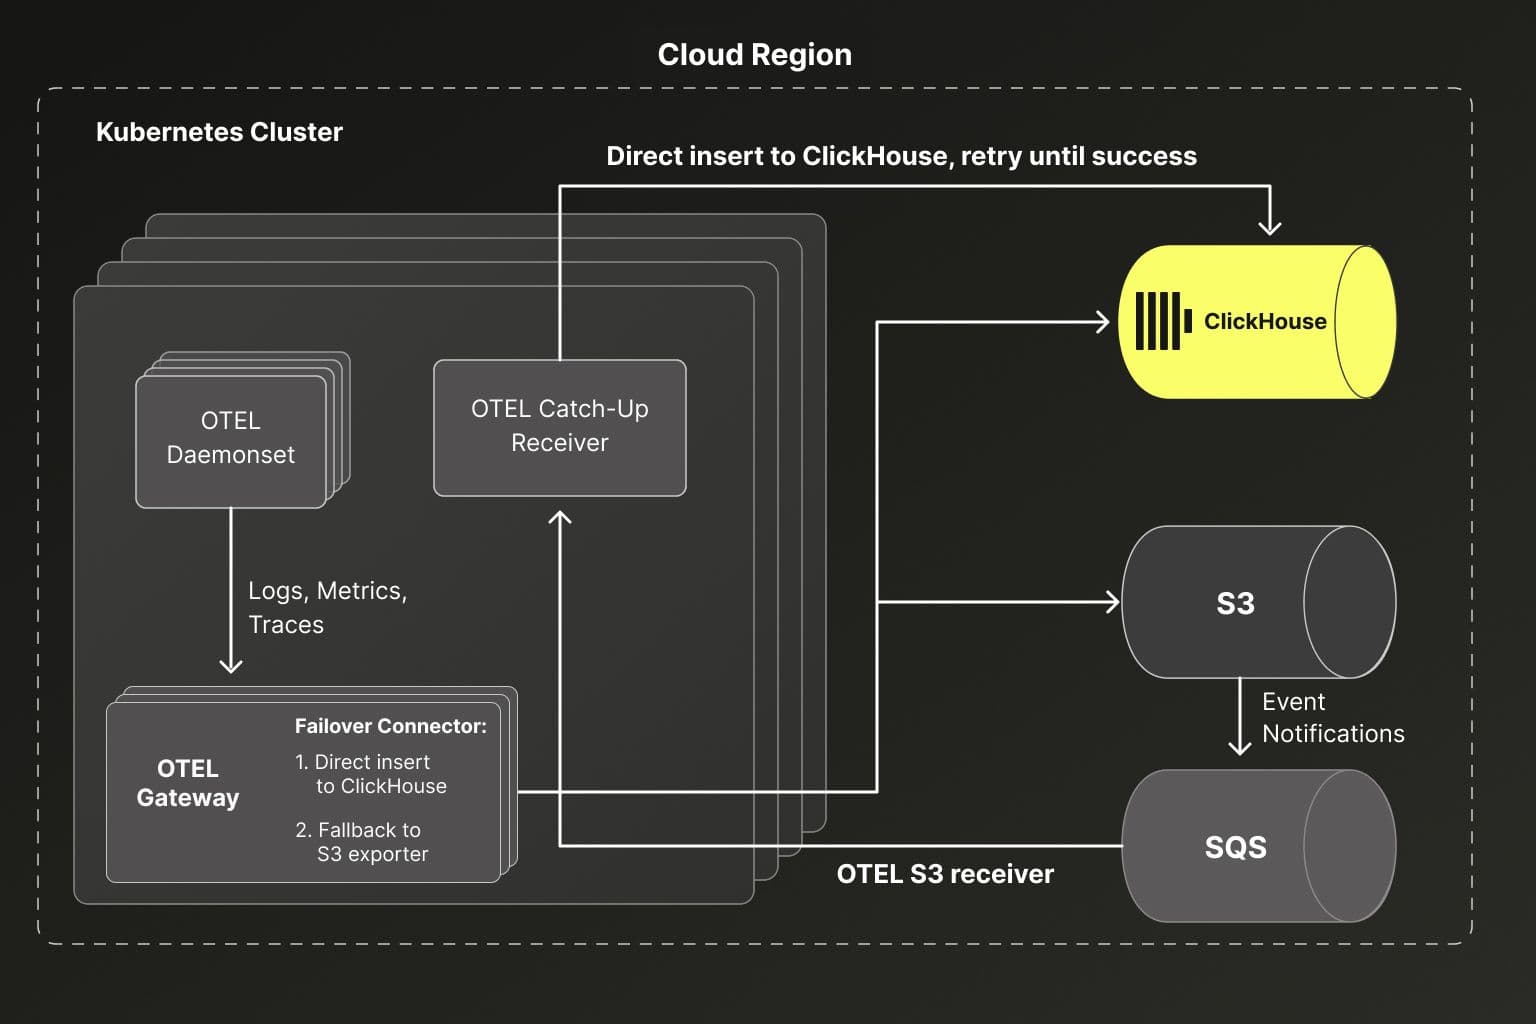
追加されたコンポーネントはごくわずかです。クラウド側では、テレメトリシグナルごとにプレフィックスを分けた S3 バケットを導入しました。各プレフィックスには、関連付けられたイベント通知と SQS キューがあります。Kubernetes インフラ内では、エージェント層は変更していません。ゲートウェイ層はステートレスであり、フェイルオーバーコネクターが正常なターゲットへのルーティングを担当します。そして、SQS からイベント通知をポーリングして ClickHouse に挿入する独立したキャッチアップレシーバーを配置しています。データベースが異常な状態にあるときは、通知は単に SQS に蓄積されます。
フェイルオーバーコネクター
OTel において、コネクター(connector)とはレシーバーとエクスポーターの両方として振る舞うコンポーネントです。フェイルオーバーコネクター(failover connector)は、優先順位のついたパイプラインのリストを受け取り、受信したバッチを、正常なパイプラインの中で最も優先度の高いものへとルーティングします。ヘルスチェックを実行するのではなく、各パイプラインの処理結果を検査します。
注意点が 1 つあります。ClickHouse エクスポーターの送信キュー(sending queue)を無効にしておかなければならないという点です。そうしないと、あらゆるエラーがコネクターから隠蔽されてしまい、フェイルオーバーが遅延してしまいます。すべての OTel エクスポーターで送信キューを有効にするのがベストプラクティスですが、それを行うと同期パイプラインが非同期パイプラインに変わってしまいます。これにより、バックプレッシャーのシグナルがフェイルオーバーコネクターに届くのが遅れてしまいます。これを回避するため、コネクター自体が送信キューをサポートしており、ルーティングの判断よりも上流にキューが配置されます。
また、ClickHouse からの一時的なネットワークエラーや個々のクエリの失敗によって完全なフェイルオーバーがトリガーされることは避けたいので、retry_on_failure 設定を使用してエクスポーター内のインライン同期リトライは有効のままにしています。
ブロブストレージのエクスポーターでは、その逆を行います。つまり、障害をフェイルオーバーコネクターから隠蔽したいのです。優先度レベルが 2 つあるため、すべてのレベルがフェイルオーバーコネクターに対して異常を報告する状況は避けなければなりません。その状態になると、フェイルオーバーコネクターは下流へのデータ送信を停止し、正常な送信先が回復するまで自身の送信キューにバッファリングしてしまいます。そのため、ブロブストレージのエクスポーターで送信キューを有効にし、個別のバッチ障害を隠蔽します。前述のとおり、キーの形式はブロブストレージでよく見られるスロットリングを回避するように設計されています。積極的なリトライポリシーと組み合わせることで、停止時の OOM(メモリ不足)のリスクを回避しながら、十分強固な耐久性の保証を得ることができました。
この組み合わせにより、すべての要件を満たすパイプラインが実現します。通常運用時、データは ClickHouse に直接流れます。一時的なエラーはインラインでのリトライで対応され、フェイルオーバーがトリガーされることはありません。ClickHouse から実際のバックプレッシャーが発生した場合は、フェイルオーバーによってトラフィックが自動的に S3 へ切り替わります。ClickHouse が復旧すると、failover コネクタがそれを自動的に検知し、ライブトラフィックを元に戻します。ライブトラフィックが S3 内のバックログの後ろで待たされることは決してありません。
connectors:
failover/logs:
priority_levels:
- [logs/clickhouse]
- [logs/s3]
retry_interval: 30s
sending_queue:
enabled: true
queue_size: 10000
service:
pipelines:
logs:
receivers: [otlp]
exporters: [failover/logs]
logs/clickhouse:
receivers: [failover/logs]
exporters: [clickhouse]
logs/s3:
receivers: [failover/logs]
exporters: [awss3/logs]
exporters:
clickhouse:
endpoint: ""
connection_params:
async_insert: "1"
wait_for_async_insert: "1"
...
sending_queue:
enabled: false
retry_on_failure:
enabled: true
awss3/logs:
s3uploader:
s3_base_prefix: logs
s3_bucket: ""
...
sending_queue:
enabled: true
queue_size: 10000キャッチアップ用レシーバー
データがブロブストレージにフェイルオーバーされた後は、イベント通知をトリガーにして ClickHouse への書き戻しを行います。主要なクラウドプロバイダーはそれぞれ、自社のキューイングシステム (SQS、Event Hubs、PubSub) への at-least-once (少なくとも1回) 配信を伴うこの機能をサポートしています。OTel Collector のブロブストレージレシーバーをこれらのキューに向けることで、通知を消費してブロブを処理できます。
私たちのキャッチアップ用 Collector のデプロイ構成は非常にシンプルです。ブロブストレージレシーバーを使用し、キューからイベントをポーリングするステートレスな Collector を Kubernetes デプロイメントとして実行します。キューが空になると、これらの Collector はゼロにスケールダウンします。これはゲートウェイとは完全に分離されたデプロイメントであるため、ライブトラフィックとキャッチアップが互いに干渉することはなく、それぞれ独立してスケールできます。
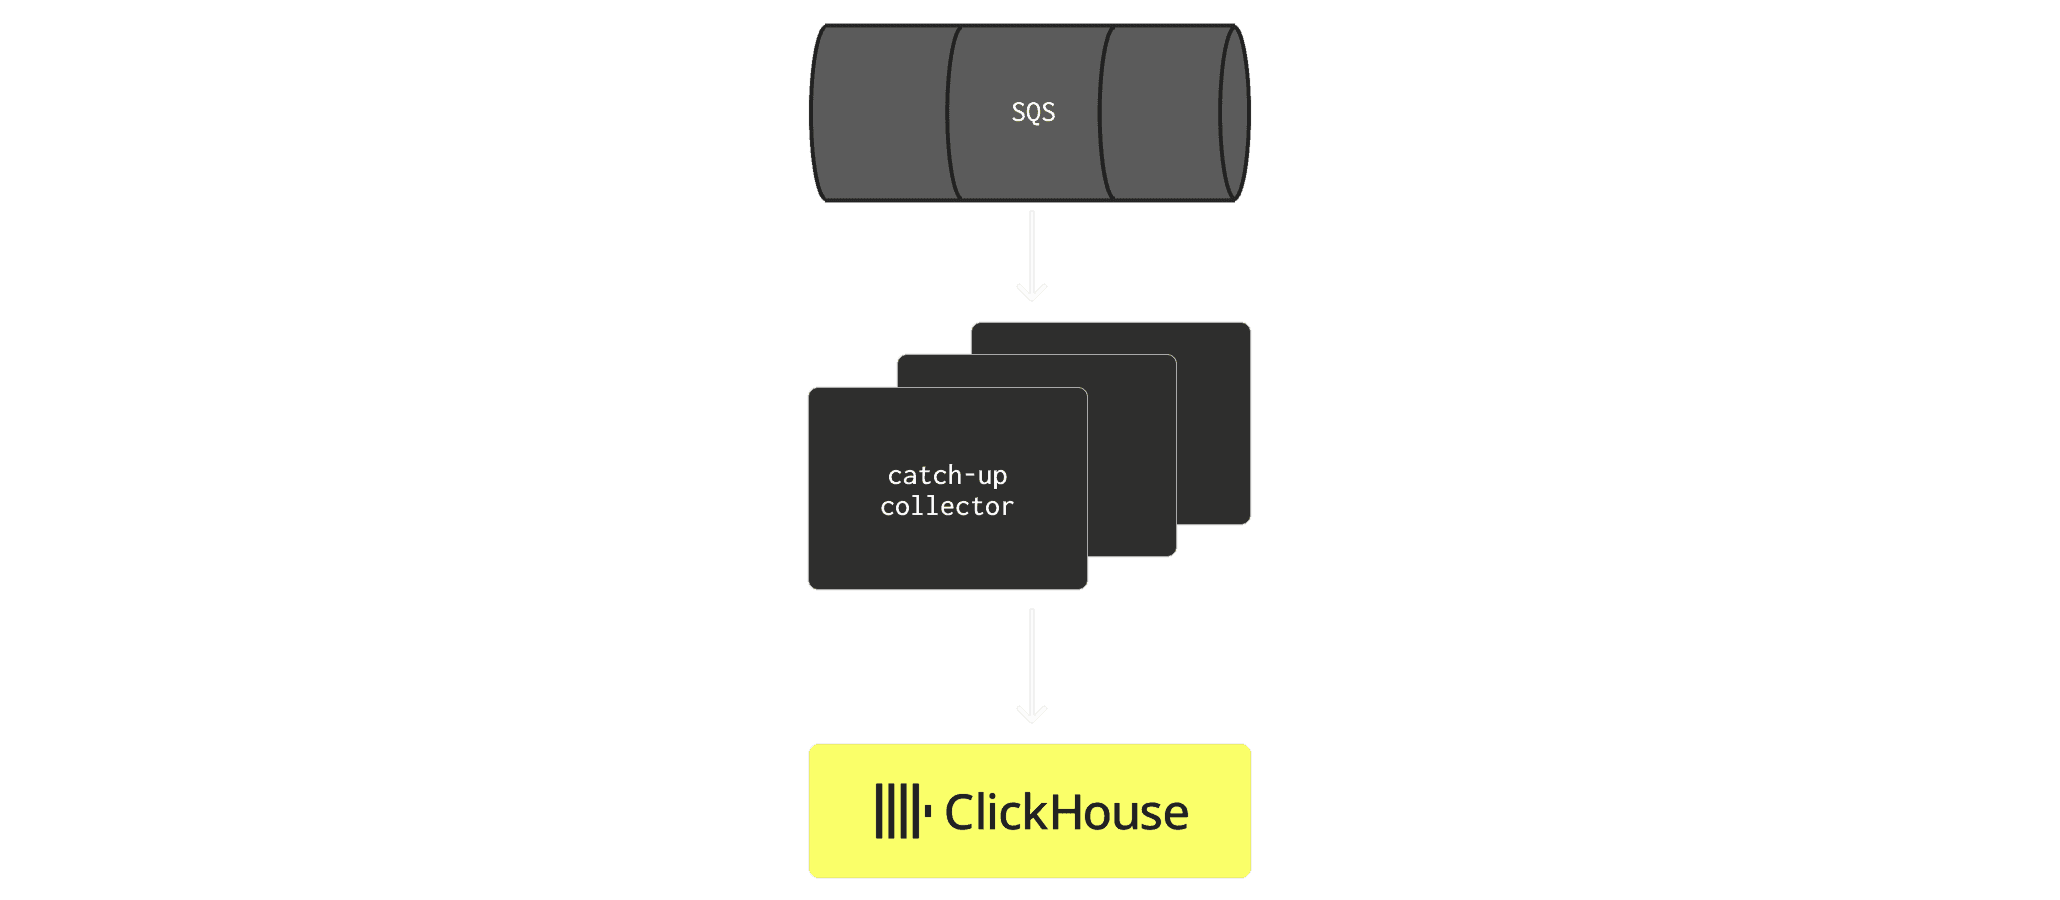
フェイルオーバーが発生すると、キューにイベントが送信されます。Collector はイベントをプルし、ブロブをダウンロードして、ClickHouse への同期挿入を試みます。エンリッチメントと処理はすべてエージェント層およびゲートウェイ層で完了しているため、これらのバッチはそのままデータベースへ流し込むことができます。ClickHouse がまだ利用できない状態であれば、挿入は失敗してメッセージはキューに残り、次のポーリング時にリトライされます。
receivers:
awss3/logs:
s3downloader:
s3_bucket: ""
s3_prefix: logs
sqs:
queue_url: ""
exporters:
clickhouse:
endpoint: ""
connection_params:
async_insert: "1"
wait_for_async_insert: "1"
...
sending_queue:
enabled: false
retry_on_failure:
enabled: true
service:
pipelines:
logs:
receivers: [awss3/logs]
exporters: [clickhouse]Kafka 経由でテレメトリデータをストリーミングする場合と異なり、通知キューは軽量です。メッセージはオーバーフローが発生したときにのみ送信され、メッセージ自体にも、数 MB の生データのバッチではなく、オブジェクトキーを表す数百バイトのデータしか含まれていません。
実運用におけるフェイルオーバー
この設計を検証するため、パイプラインが負荷下でどのように動作するかを確認するエンドツーエンドのゲームデーを実施しました。最も極端なテストケースとして、下流の完全な停止を設定しました。取り込みキャパシティがゼロになるため、流入するすべてのテレメトリによって持続的なバックプレッシャーが発生します。
反復 1 (Iteration 1) では、ClickHouse が停止してから数分以内にゲートウェイが OOM を起こしてクラッシュしていました。反復 2 (Iteration 2) では数時間の停止にも耐えられましたが、30 分を超える停止があると WAL のバックログが解消できなくなっていました。反復 3 (Iteration 3) を検証するため、ステージングリージョンの LogHouse クラスターを丸 1 時間ハードストップさせました。このリージョンは、定常状態で毎秒 12 万イベントを処理しています。
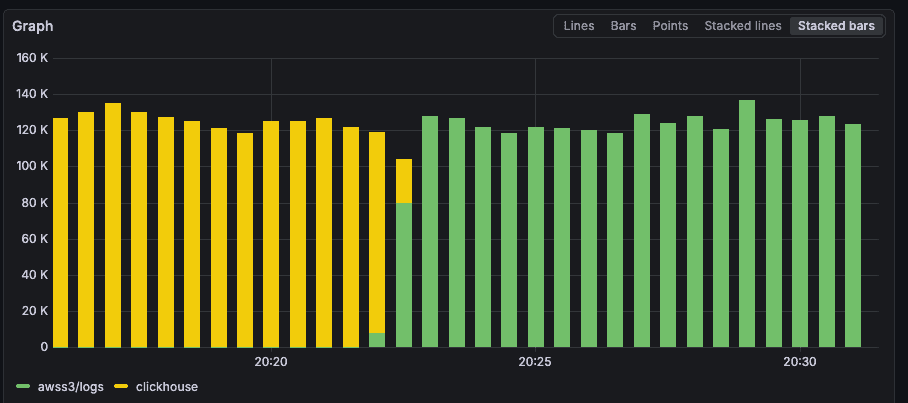
これは、エクスポーター別にグループ化した otelcol_exporter_sent_log_records_total メトリクスのグラフです。黄色のバーは ClickHouse エクスポーターに書き込まれるログのレートを表し、緑色は S3 エクスポーターに書き込まれるレートを表しています。データベースが停止すると自動的にフェイルオーバーが発生し、その後はログが定常状態で S3 に流れました。フェイルオーバー中もその後も、ゲートウェイ Collector のリソース使用率に変化は見られませんでした。
1 時間後、LogHouse クラスターを再起動しました。
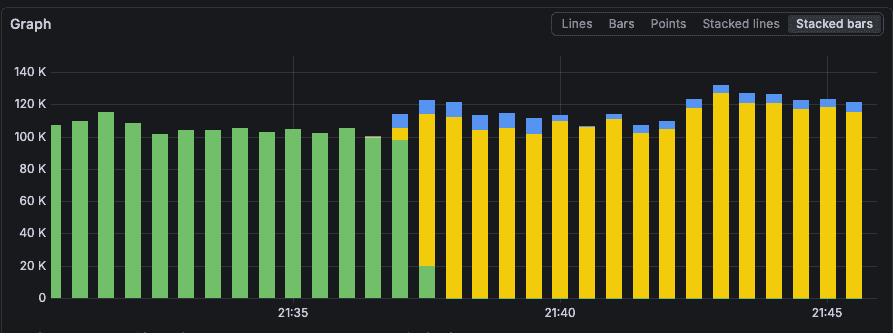
再起動すると直ちに S3 へのレコード書き込みが急減し、ClickHouse へのレコード書き込みが再開されました。さらに、上部の青いバーは、キャッチアップ用 Collector から ClickHouse に送信されたログを示しています。障害発生中、この Collector はオーバーフロー通知の処理を試みては失敗していましたが、ClickHouse が復旧すると処理に成功し、キューの消化を開始しました。
まとめ
当初のパイプラインは脆弱で、信頼性に欠けていました。データベースでわずかな不調が起きるたびに OOM やクラッシュループが発生し、運用上の負担となっていました。現在では、高い信頼性を誇る高度にカスタマイズされた Collector アーキテクチャを運用しており、データを失うことなく何度もデータベースの停止を吸収してきました。ローカル WAL 用の PVC を排除したことで、スタックの運用負担は軽くなり、コストパフォーマンスも大幅に向上しました。
もちろんトレードオフもありました。展開するリージョンが増えるたびに、バケット、キュー、イベント通知を追加するためのインフラセットアップが必要になります。また、Collector の設定が複雑になることも受け入れざるを得ませんでした。非同期リカバリの設計では、障害からの復旧フェーズにおいて曖昧さも生じます。バックログの解消中、全体としてどれだけのデータが残っているかは把握できますが、特定の Pod からのテレメトリなど、具体的にどのデータが未処理のまま残っているかまでは把握できません。
私たちはこのアーキテクチャをまず毎秒 1,000 万イベントの規模で導入し、その後も毎秒 5,000 万イベントまで問題なくスケールさせることができました。この実績により、確信を持って本アーキテクチャを完全マネージド型オブザーバビリティサービスである Clickstack Cloud の OTLP 取り込みエンドポイントへと展開できました。
今すぐ始める
自社データで ClickStack の動作を試してみませんか? ClickHouse Cloud の Managed ClickStack を使えば、わずか数分で開始でき、300 ドル分の無料クレジットも受け取れます。
サインアップ