5万

ClickHouse Cloud は、利用者に代わってサービスを垂直方向にオートスケーリングします。裏側ではレコメンデーションサービスが各サービスの挙動を監視し、割り当てるべき CPU とメモリの量を決定しています。ワークロードが増加するとスケールアップし、落ち着くとスケールダウンするため、使用しなくなったキャパシティに対して料金を支払い続けることはありません。これらの判断は、独自の 2 ウィンドウレコメンダー によって行われています。
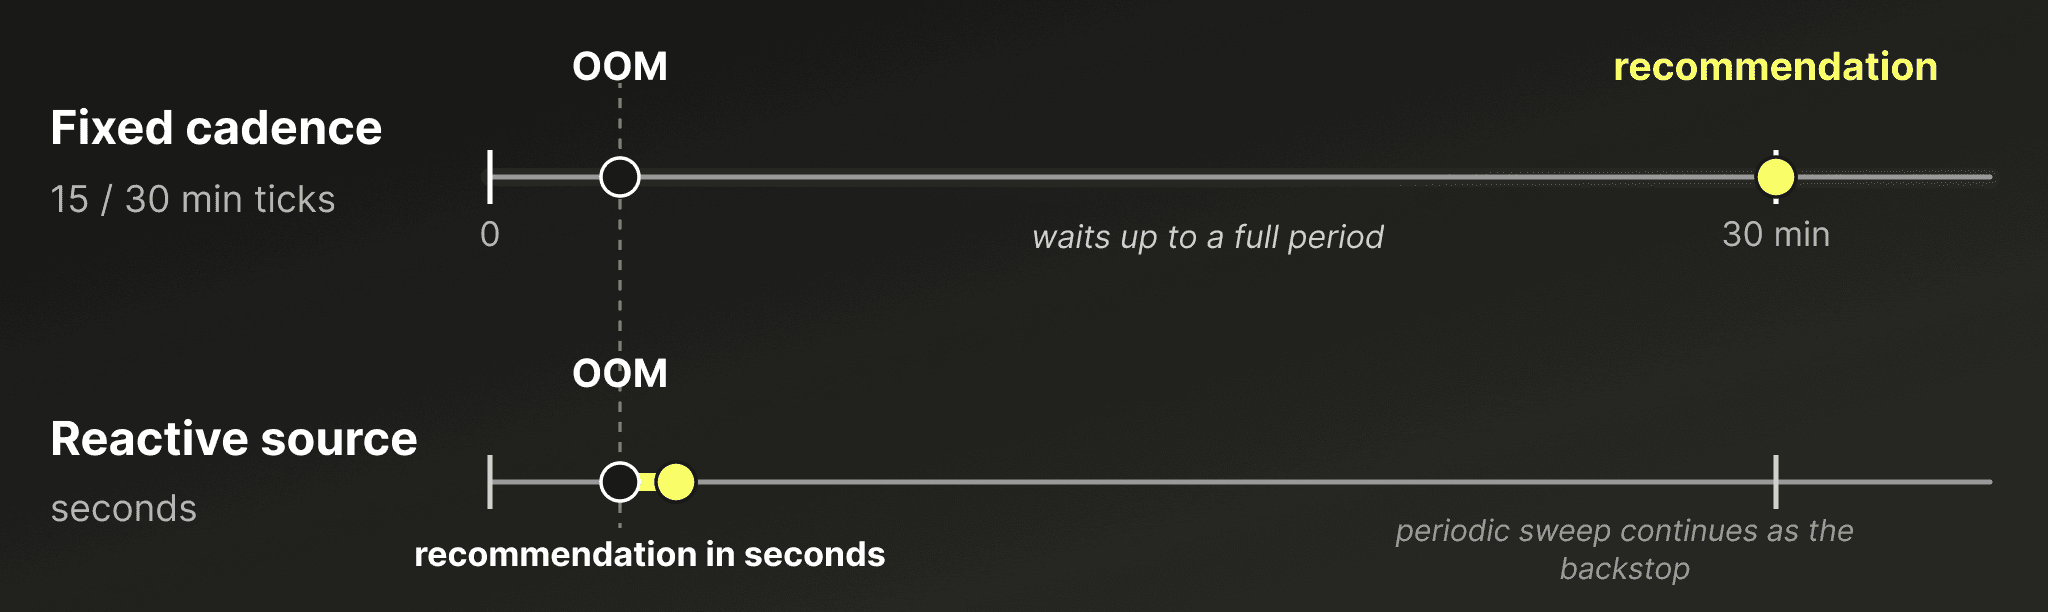
長きにわたり、このレコメンデーションサービスは固定のスケジュールで動作していました。タイマーで起動し、すべてのサービスを確認して(時間枠全体に全サービスのリストを割り振り)、レコメンデーションを生成したあと、次のタイマートリガーまで再びスリープしていました。この設計はシンプルで予測しやすいものの、固定スケジュールであったため、リソースが必要になったサービスを即座にスケールアップできないという課題がありました。
この問題を解決するため、ソフトウェアエンジニアが専ら Kubernetes 向けと認識している本番実績の豊富なライブラリ、controller-runtime をベースにオーケストレーション層を再構築しました。これにより、リアクティビティ(即応性)、重複排除、バックオフ、同時実行制御を、自前で実装することなく手に入れることができました。そして、この仕組みにニアリアルタイムのシグナルを供給する段になり、明白な選択肢として選んだのが ClickHouse 自体でした。
スケジュール実行による看過できないレイテンシ
正時(0 分)を迎えた瞬間に、大量のクエリワークロードが急激にサービスへ押し寄せる状況を想像してみてください。メモリの追加が必要ですが、レコメンダーは数分前に実行されたばかりで、次の定期実行まではしばらく時間が空いています。次のトリガーが来るまで、サービスは要求されている負荷に対してアンダーサイジングな状態のままになります。クエリは遅くなり、利用可能なメモリの不足によって拒否されることさえあります。
いずれはオートスケーリングが作動し、リソース不足に対処するレコメンデーションが発行されます。問題は純粋にレイテンシです。メモリ不足(OOM)イベントのように最も重要な事象において、次の定期実行を待つのは決して望ましい状態ではありません。
レコメンデーションロジックの改善にあたり、2 つの要件がありました。
- タイマーベースの定期実行を維持すること。すべてのサービスを安定して予測通りに巡回することは、手放してはならないセーフティネットです。利用パターンを継続的に検証し、リソースを調整する必要があります。これは特にスケールダウンにおいて重要です。スケールダウンは緊急の対応ではないものの、使用しなくなったリソースに対するユーザーのコスト負担を最適化するために、合理的な範囲でできるだけ早く実施したいためです。
- 高速パス(fast path)を追加すること。今すぐ対応が必要なサービスに対しては、次の定期実行を待つのではなく、数秒以内にレコメンデーションが発行されるようにします。
スタート地点
オリジナルのレコメンダーは、独自に制御ループを実装した自己完結型のバイナリでした。タイマーが作動すると、ループがサービスを巡回し、そのループ処理の一部として(さまざまなデータソースからのデータを集約する)実タスクが実行されていました。この設計は、定期的にレコメンデーションを作成する用途には十分でした。
しかし、当初の設計に含まれていなかった「高速パス」の追加は困難でした。複数のトリガーから処理対象が届くようになると、オートスケーリングとは無関係で、ジョブプロセッサーの構築に特有の課題が一気に生じます。
- 定期巡回と高速パスの両方がほぼ同時に「特定のサービスに対応が必要」と判断した場合、2 回処理してはならない。
- レコメンデーションの生成に失敗した場合はリトライしたいが、即座に、かつ無限にリトライするべきではない。バックオフが必要になる。
- レコメンデーションを無制限に同時実行させることはできず、さもなければメトリクス取得元のシステムに過負荷をかけてしまう。
- クリーンな起動・停止や、ジョブプロセスの新旧インスタンス間での責務の引き継ぎが必要になる。
これらは特に珍しい課題ではなく、実際にはキューベースのワーカーシステムならどれも必要とする仕組みです。既存の実装の上にこれらを自前で書いてテストし、維持管理したくはありませんでした。この手の仕組みを手作りすると、本番環境で再現しにくい微妙なバグの温床になりがちです。
controller-runtime はすでにイベントエンジンである
ClickHouse Cloud は Kubernetes 上で動作しており、プラットフォームコードはすでに controller-runtime に大きく依存しています。これは、大半のサードパーティ製 Kubernetes コントローラーやオペレーターの基盤となっているライブラリです。オペレーターを作成したことがある方なら、その大まかな流れをご存じでしょう。リソースを監視(watch)し、Reconcile(調整)関数が呼び出されて、望ましい状態へと世界を収束させていきます。
しかし、Kubernetes 固有の表層を取り払えば、controller-runtime は汎用のイベント処理エンジンとして活用できます。Kubernetes 固有の用語を使わずに言えば、次の流れに集約されます。
- 1 つ以上のソースが、対応が必要なアイテムを生成する。
- それらのアイテムがレート制限付きのワークキューに入る。
- Reconciler がキューから論理アイテムを 1 つずつ取り出し、処理を実行する。
controller-runtime のワークキューは、実際には Kubernetes に縛られていません。キー単位で重複排除を行うため、同一アイテムが待機中に 2 回キューイングされても 1 回だけ処理されます。レート制限と指数バックオフが適用されるため、失敗したアイテムは即座にリトライを繰り返すのではなく、時間を置いてから再試行されます。有界な同時実行性(bounded concurrency)をサポートしているため、行き当たりばったりにならず、並行処理するアイテム数を制御できます。さらに、ライブラリに標準で備わっているリーダー選定やメトリクスとも連携します。
以前の実装を Kubernetes の言葉に置き換えると、Reconcile 関数は単一のサービスに対して「現在わかっているすべての情報に基づき、このサービスはどのサイズであるべきか?」という 1 つの問いに答えることになります。この関数を単一の冪等な作業単位として定義すると、controller-runtime がこの用途に極めて適していることが明白になりました。さらに、前述した課題のすべてを、実戦で鍛え抜かれたソリューションによって解決できます。
ソースは汎用の監視機能である
私たちの「トリガー」は、Kubernetes オブジェクト(だけ)ではありません。幸い、controller-runtime は簡単に拡張できます。controller-runtime において、ソース(Source)とは指定されたキューにアイテムを投入し始めるものにすぎません。ライブラリには Kubernetes API を監視するソースが付属していますが、ソースのインターフェース自体にはそれを要求する要素は一切ありません。
分解してみると、ソースのインターフェースは単一のメソッドだけで構成されています。
type Source interface {
Start(context.Context, workqueue.TypedRateLimitingInterface[reconcile.Request]) error
}ソースの実装はこれがすべてです。キューを受け取り、そこへリクエストの投入を開始するだけです。たとえば、最小限のポーリングソースは次のようになります。
// pollingSource は一定の間隔で needsAttention が報告した内容をエンキューします。
type pollingSource struct {
interval time.Duration
needsAttention func(context.Context) ([]reconcile.Request, error)
}
func (s *pollingSource) Start(ctx context.Context, q workqueue.TypedRateLimitingInterface[reconcile.Request]) error {
go func() {
ticker := time.NewTicker(s.interval)
defer ticker.Stop()
for {
select {
case <-ctx.Done():
return
case <-ticker.C:
reqs, err := s.needsAttention(ctx)
if err != nil {
continue
}
for _, req := range reqs {
q.Add(req) // 重複排除、バックオフ、レート制限はキューの役割です
}
}
}
}()
return nil
}私たちが用意した両方のトリガー(全サービスの定期巡回と、リアクティブな「高速パス」)は、まさにこの構造をしています。異なるのは needsAttention が実際に行う処理内容だけです。これにより、両方のトリガーを 1 つの共有キューに投入するソースとして表現し、その背後にある 1 つの共有 Reconciler で処理できるようになりました。
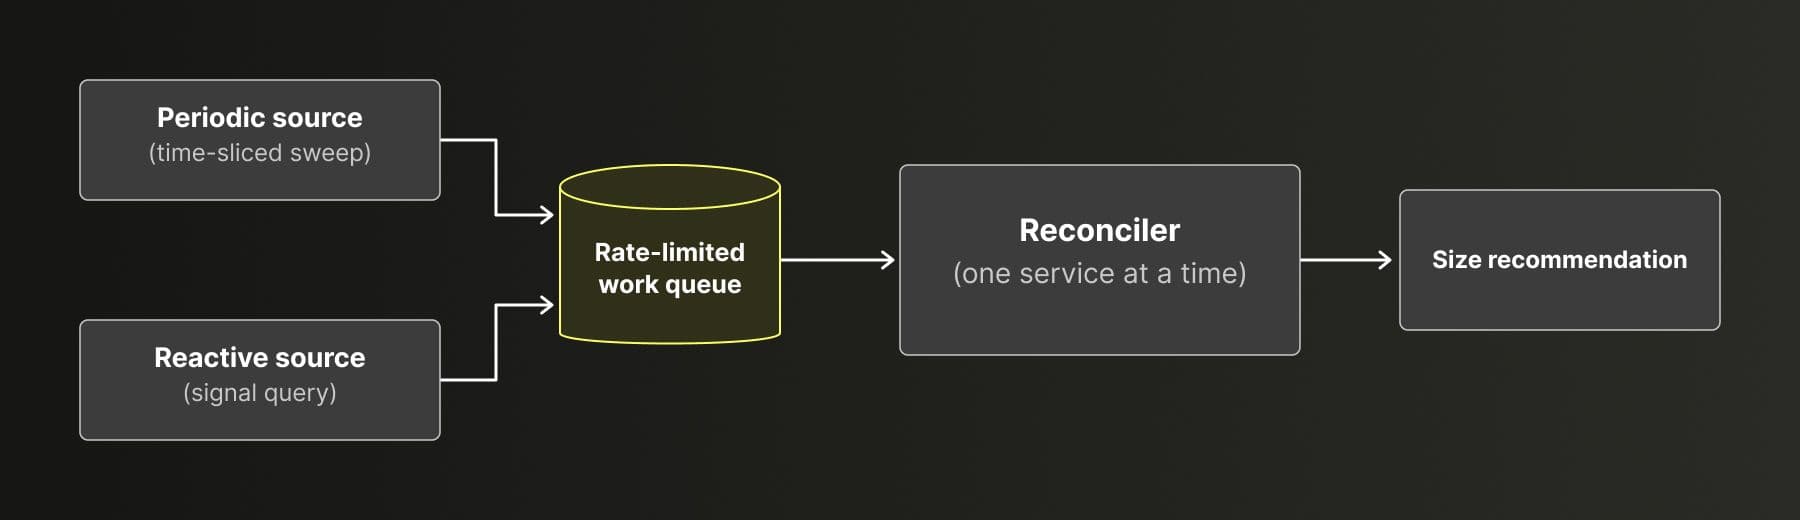
中央のキューが重複排除、バックオフ、有界な同時実行性を一手に引き受けるため、どちらのソースもお互いの存在を意識する必要がありません。
1 つ目のソースは**定期実行型(periodic)**のレコメンデーションループです。これは従来のタイマーを刷新した実装です。各サービスに決定論的にスロットが割り当てられ、そのスロットの時刻が来るとエンキューされるため、各サイクルの開始時に負荷がスパイクすることなく、定期的な負荷が平準化されます。
2 つ目のソースは**リアクティブ型(reactive)**であり、今回の取り組みを始めた最大の理由でもあります。先述したような、今すぐ対応が必要であることを示す一連のシグナルを監視します。そのようなシグナルが現れると、ソースはそのサービスを即座にエンキューします。Reconciler は数秒以内に実行され、かつては次のタイマートリガーまで待たされていたレコメンデーションが、トリガーとなったイベントの発生とほぼ同時に行われます。
しかし、そのシグナルのストリームはどこに保持すべきでしょうか。独自のメッセージバスを開発したり、新たなキューを追加したりしたくはありませんでした。シグナルは単純に、ClickHouse テーブルの行として保持されています。フリート全体のサービスがシグナルの閾値を超過すると(メモリ不足に陥るなど)、それらのイベントがどのサービスに属し、いつ発生したかのタグとともにテーブルに行として書き込まれます。リアクティブソースが行うのは、短い間隔でそのテーブルに対して小さなクエリを実行し、「過去数分間に該当するシグナルを生成したサービスはどれか?」という標準的な分析の問いを投げかけることだけです。
重要なのは、どちらのソースも Kubernetes の watch ではない点です。どちらも同じコントラクトに基づいて構築された単純なトリガーであり、一方はクロックで駆動し、もう一方は ClickHouse クエリで駆動します。それでも、controller-runtime に見事に適合しています。
ClickHouse に反応する ClickHouse
ClickHouse Cloud サービスのサイズを適切に維持するシステムは、そのリアクティブな中核において、当然ながら ClickHouse 自体によって動いています。
フリート全体からテーブルへとイベントが継続的にストリーミングされます。ソースは数秒ごとに、直近の短い時間枠に対してクエリを実行し、どのサービスに対応が必要かを問い合わせます。これはリアルタイム分析の典型例です。一方では高頻度のイベント取り込みが行われ、もう一方では低レイテンシのウィンドウクエリが実行され、テーブルが肥大化してもミリ秒単位で結果が返されることが期待されます。
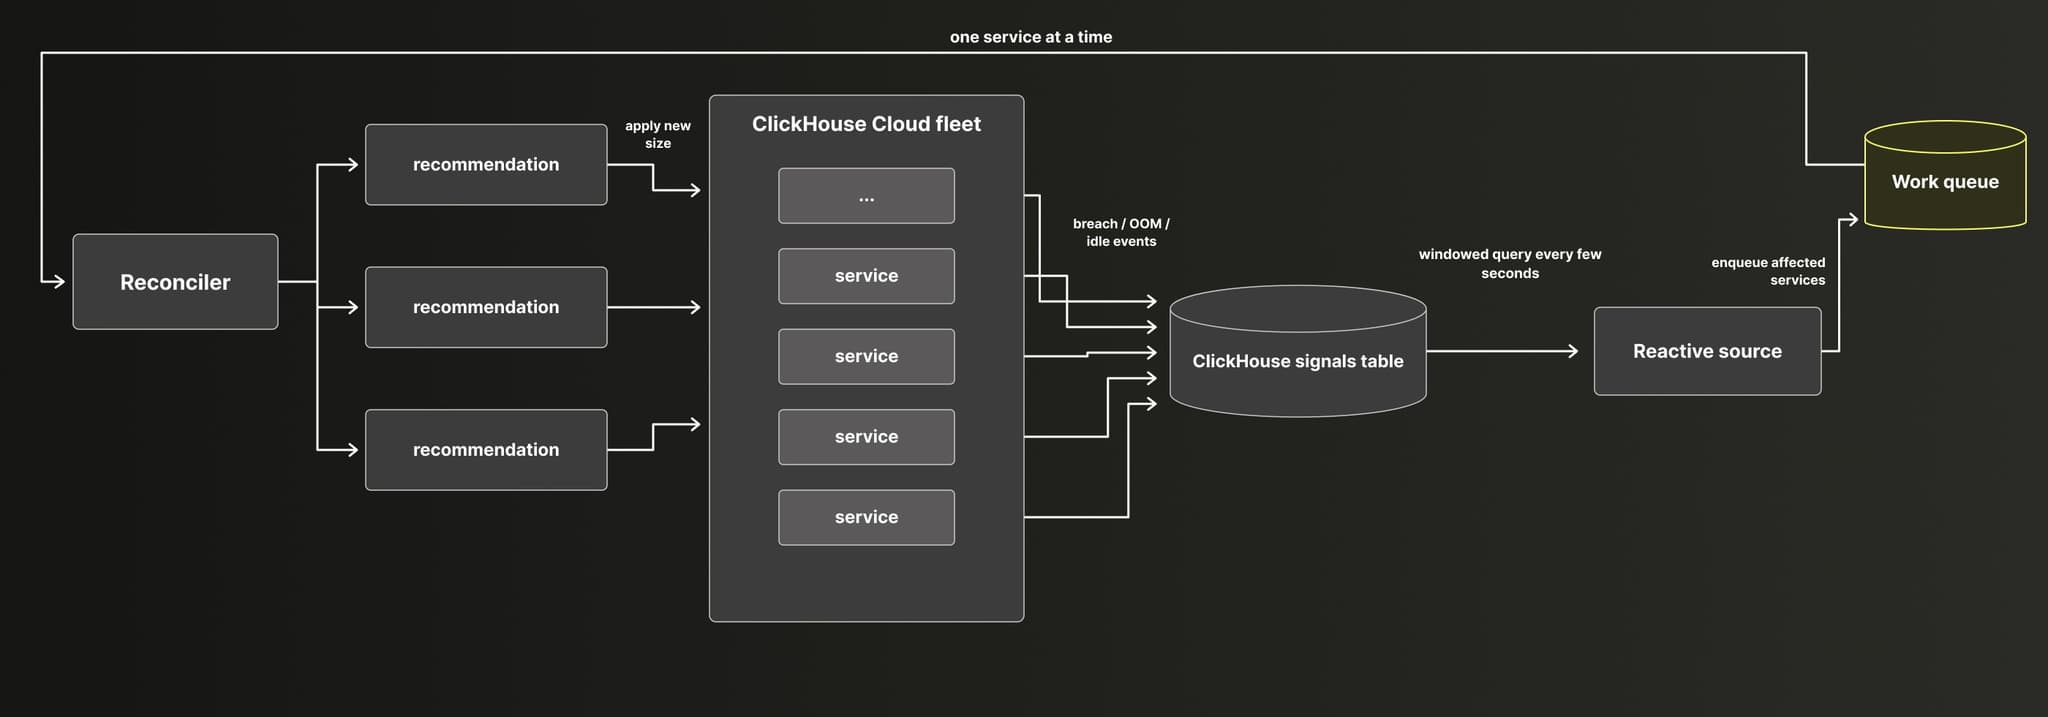
これこそまさに ClickHouse が得意とする領域であり、データの構造もそれを最大限に活かせるよう設計されています。リアクティブソースは、シグナルの行のみを保持する専用の小さなテーブルから読み取ります。
CREATE TABLE recommendation_signals
(
scrape_ts DateTime,
service_name LowCardinality(String),
metric_name LowCardinality(String),
metric_value Float64
)
ENGINE = SharedMergeTree
ORDER BY (scrape_ts, service_name)
TTL scrape_ts + INTERVAL 1 HOUR;ここには特殊な設定は一切ありません(それこそが狙いでもあります)。テーブルは scrape_ts でソートされているため、ソースが実行するクエリはほぼ 1 つのグラニュールにしかアクセスしない狭い時間範囲スキャンで済み、1 時間の TTL によってテーブルの肥大化も防がれます。
続いて、リアクティブソースがこのテーブルに対して実行するクエリです。
SELECT DISTINCT service_name, metric_name
FROM recommendation_signals
WHERE scrape_ts > now() - INTERVAL 5 MINUTE;この 5 分間のウィンドウがソースの参照期間(ルックバック)であり、リアクティブクエリの処理はこれですべてです。返された各 service_name が、調整処理のためにキューイングされるアイテムになります。
ClickHouse の巧みな工夫が活きているのは、このテーブルへのデータの投入方法です。私たちはすでに、Prometheus メトリクスの膨大なストリームを、想定されるアクセスパターンに合わせておおむね (service_name, metric_name, scrape_ts) の順でソートした、はるかに大きなテーブルへと取り込んでいます。scrape_ts だけで絞り込むフリート全体のポーリングではその主キーを活用できず、実行のたびにパーティション全体をスキャンすることになってしまいます。そこで、大元のデータストリームを直接クエリするのではなく、マテリアライズドビューを使って挿入時に一度だけフィルタリングを行い、閾値を超過した行だけをこの小さなシグナルテーブルに書き込みます。
CREATE MATERIALIZED VIEW recommendation_signals_mv
TO recommendation_signals
AS
SELECT
scrape_ts,
service_id,
metric_name,
metric_value
FROM prometheus_metrics
WHERE metric_name IN ('soft_memory_rejections') -- 他のシグナル種別もここに追加
AND metric_value > 0;マテリアライズドビューの採用には、いくつかの大きな利点があります。
- コストの高いフィルタリング処理がポーリングごとではなく、データ到着時にインクリメンタルに実行される。
- 読み取り側は、直近の閾値超過イベントのみを保持するテーブルに対する、グラニュール規模の安価なスキャンにとどまる。
- 将来新しい種類のシグナルを追加するのが容易。メモリ OOM や CPU の閾値超過など、パイプラインに投入されるデータで表現できるものであれば、読み取りパスやソース側に手を加えることなく、
INリストに項目を 1 つ追加するだけで済みます。SQL には意図的にレコメンデーションのロジックを持たせていません。SQL は何がシグナルに該当するかを決定し、ソース側がそれに対してどう対処するかを決定します。
リアクティブソースが数秒ごとのポーリングを実行できるのは、クエリという形で問いを投げる時点で、データがすでにその問いに適した形に整えられているからです。
ソースは直近のウィンドウ内のシグナルのみを考慮するため、長い過去の時間枠をクエリするのではなく、今起きていることに反応します。これはクエリの時間条件としてごく自然に表現されます。さらに、レコメンデーションロジックは速度重視で最適化されており、連続して複数回実行しても決定論的な結果を生成できます。これら 2 つのルールにより、高速パスはノイズ源になることなく高レスポンスを維持できています。
この再帰的な構造は非常に美しいものです。製品自体がリアルタイム分析において最高峰であり、その製品に伸縮性をもたらすメカニズム自体もまたリアルタイム分析なのです。問題が発生しているサービスを迅速かつ継続的に把握するビューが必要になったとき、その答えは私たちが顧客に提案していることとまったく同じでした。「イベントを ClickHouse に投入し、クエリを実行する」ということです。
controller-runtime をベースに構築する強み
両方のソースが同一のキューと同一の Reconciler に処理を流し込むため、難しい部分は Kubernetes のグローバルコミュニティによって磨き上げられたコードによって一箇所で処理されます。また、オープンソースであるため、改善点があれば直接コントリビュートして還元できます。
重複排除は、controller-runtime へ移行したことによる嬉しい「副産物」です。定期実行ソースとリアクティブソースの両方が、ほぼ同時に同じサービスへの対応が必要だと判断した場合でも、キューによって 1 つの作業単位に集約されます。キューが不要にしてくれるため、2 つのトリガー間で協調動作を行うメカニズムを自前で構築する必要はありませんでした。
バックオフとリトライも同様に処理されます。依存関係の一時的な停止によってレコメンデーションが生成できない場合、アイテムは消失したり高頻度のループで再試行されたりすることなく、遅延時間を延ばしながらキューに戻されます。有界な同時実行性により、同時に実行されるレコメンデーションの数に上限を設けられるため、シグナルが突発的に大量発生してもメトリクス取得元のシステムを保護できます。
オーケストレーションのロジックを一から書き直すことはせず(既存のライブラリプリミティブの上に構築しました)、サービスのあるべきサイズを決定するロジックにも手を加えませんでした。新しいソースを追加して既存のキューに接続するだけで、リアクティブパスは導入初日から重複排除、バックオフ、同時実行制限、メトリクスの恩恵をそのまま受け継ぎました。今後新たに対応したいシグナル種別が出てきても、(確立されたパターンに従うことで)単に別のソースを追加するか、既存のマテリアライズドビューを更新するだけで対応できます。
即応性が高まったことで、ロールアウトの判断プロセスも有利になりました。新しいソースを観察専用モード(observe-only mode)として慎重に導入し、実際にスケーリングを作動させる前にどのような挙動を示すかを確認できます。ソースと Reconcile ロジックがきれいに分離されているため、このような段階的ロールアウトは後から簡単な設定変更を切り替えるだけで実現できます。
学んだ教訓
ソフトウェアがすでに何らかの形で Kubernetes と連携しているなら、Kubernetes 以外のイベントソースを扱う場合であっても、controller-runtime は有力な選択肢になります。
定期的に、あるいはリアクティブに対応が必要な処理を抱えるシステムであれば、まさに controller-runtime が想定している用途に合致します。Reconcile パターン(1 つのアイテムを受け取り、望ましい状態へと収束させる冪等な関数)は、Kubernetes 特有のものではありません。重複排除、バックオフ、有界な同時実行性を備えたワークキューは、純粋に優れた汎用キューです。トリガーをそのキューに対するソースとして表現することで、十分に理解され、実績のある強固な基盤を無償で手に入れられ、自チーム固有の課題解決ロジックに注力できるようになります。
ただし、controller-runtime はデータパイプラインではないため、その限界を正しく認識しておくことが重要です。ワークキューは(シャーディングしない限り)単一プロセス内のメモリ上に存在します。永続性やリプレイ機能はありません。アイテムが重複排除されるのはキューに入っている間だけであり、マネージャーが再起動すればキューイングされていた内容は消失します。また、これはストリームプロセッサではなくレベルトリガー型の調整エンジンであるため、イベント時間ウィンドウ、結合、イベント間の集約といった概念はありません。「同じ 10 分以内に OOM と持続的な CPU 閾値超過が両方発生した場合にのみ反応する」といったロジックは、当然ながらクエリ側または Reconciler のコード側に実装する必要があります。
私たちのリアクティブソースはプッシュ型のストリームを購読するのではなくテーブルをポーリングしているため、ポーリング間隔が反応速度の事実上の限界値になります。もしプロセスの再起動によってリアクティブなエンキューが失われても、恒久的に失われるものはありません。イベントテーブルに対する次回のソースクエリによって、該当サービスは再びエンキューされます。
当然ながら、これ以外の構築アプローチもあります。ClickHouse に通常接続される一般的なデータパイプラインと比べると私たちのシグナル量は控えめであり、レコメンデーションは冪等で再計算コストも低く、定期的な Reconcile 処理があらゆる漏れをカバーしてくれます。シグナルに確実な配信保証、厳格な順序付け、あるいはステートフルなウィンドウにまたがる相関処理が必要になった暁には、その部分のパスを専用のデータストリーミングプラットフォームへと移行することになるでしょう。
controller-runtime を採用したのは、すでに本番環境で運用実績があり、チームが熟知していたこと、そして Reconcile モデルがオートスケーリングに非常に適していたからです(冪等なタスクを望ましい状態へと収束させ、定期巡回によってシステム全体を自己修復させるアプローチです)。今回の取り組みから得られた教訓は、この仕組みがいかに Kubernetes 自体に依存していなかったかという気づきでした。
今後の展望
リアクティブパスは安全第一の姿勢でロールアウトを進めています。定期巡回をメインの原動力として維持しつつ、リアクティブトリガーは慎重に有効化しています。実際の判断を下す前に安定状態と比較して検証できるよう、まずは観察専用モードから導入を進めています。ここからの作業は基本的に追加していくアプローチとなります。シグナル種別を増やすことは、ソースを増やすことを意味します。そのひとつひとつが、サービスに割り当てられたリソースとワークロードが実際に要求するリソースとのギャップを縮めていきます。
私たちの目標は当初から明確でした。タイマーの進み具合ではなく、ワークロードのスピードに合わせてサイズを適正化することです。OOM などの致命的なイベントに対して、レコメンデーションパイプラインの次回の定期実行を待つことなく、まもなく即座にスケールアップが作動するようになります。これまでと同じ的確なレコメンデーションをはるかに高速に提供し、ClickHouse Cloud のオートスケーリングをさらに優れた体験へと進化させていきます。