5万

概要
ClickHouse と Grafana の組み合わせは、ClickHouse におけるオブザーバビリティ体験の重要な要素です。本記事では、このプラグインへの投資方針と、より強力で使いやすくするための私たちのビジョンについて解説します。
ClickHouse は、急速に拡大するオブザーバビリティやリアルタイム分析の環境を支えるエンジンとして広く採用されるようになりました。コストやクエリ性能を犠牲にすることなく、数十億行のログ、数百万件のトレース、大規模な時系列データを処理できる点が、多くのチームに選ばれている理由です。
私たちは、ユーザーがオブザーバビリティデータを自由に活用できるよう支援しており、その強力な選択肢として Grafana と ClickStack の 2 つを提供しています。ClickStack はリッチな探索的体験に重点を置いており、ネイティブな ClickHouse インターフェースを求めるチームに最適です。一方の Grafana は、既存のエコシステムに自然に組み込めます。すでにエンジニアに広く知られ、組織内で運用されており、複数のソースからのデータを単一のビューに統合する用途に長けています。使い慣れた環境であること、標準化のため、あるいは複数のシグナルを統合する必要性からなど、理由は様々ですが、オブザーバビリティと分析の両方のユースケースで広く見られる組み合わせです。
導入は極めて順調に進んでおり、オブザーバビリティや分析のために ClickHouse と Grafana を組み合わせて利用するチームは増え続けています。
同時に、現状のエクスペリエンスには課題があることも認識しています。特にプラグインで SQL の記述が求められる場面がその一つです。ClickStack ではこの複雑さの大半が抽象化されており、スキーマを深く理解していなくても容易にデータを探索できます。私たちはその経験から多くの知見を得ており、現在はそれらの知見を Grafana プラグイン に反映させ、これまで以上に使い始めやすく、すべてのユーザーが初日から使いこなせるようにすることを目指しています。
プラグインをこれまで以上に使いやすくするというビジョンを踏まえ、それが実際にどのような形になるのかをご紹介します。
> これらのアイデアは、私たちが現在検討・プロトタイピングを進めている内容を反映したものであり、確定したロードマップやコミットメントではありません。その多くは検証済みですが、まだ実験段階にあり、皆様からのフィードバックを積極的に求めています。確定した計画ではなく、このプラグインが目指すべき方向性についての展望として捉えてください。
真にネイティブな Grafana 体験
Grafana には、クリックによるフィルタリング、属性コレクション、ログボリュームのヒストグラム、スマート変数やアノテーションを備えたダッシュボードなど、プラグイン向けに豊富な組み込み機能が用意されています。
しかし、これらの機能はプラグイン側が対応を宣言して初めて有効になり、エンドユーザーが利用できるようになります。
現在、ClickStack プラグインは利用可能なすべての機能を公開しているわけではありません。そのため、私たちの優先事項は、関連するすべてのインターフェースを整理して実装し、ClickHouse プラグインが真に最高水準で緊密に統合された Grafana 体験を提供できるようにすることです。
では、これは実際に何を意味するのでしょうか。
ログ詳細からの即時フィルタリング
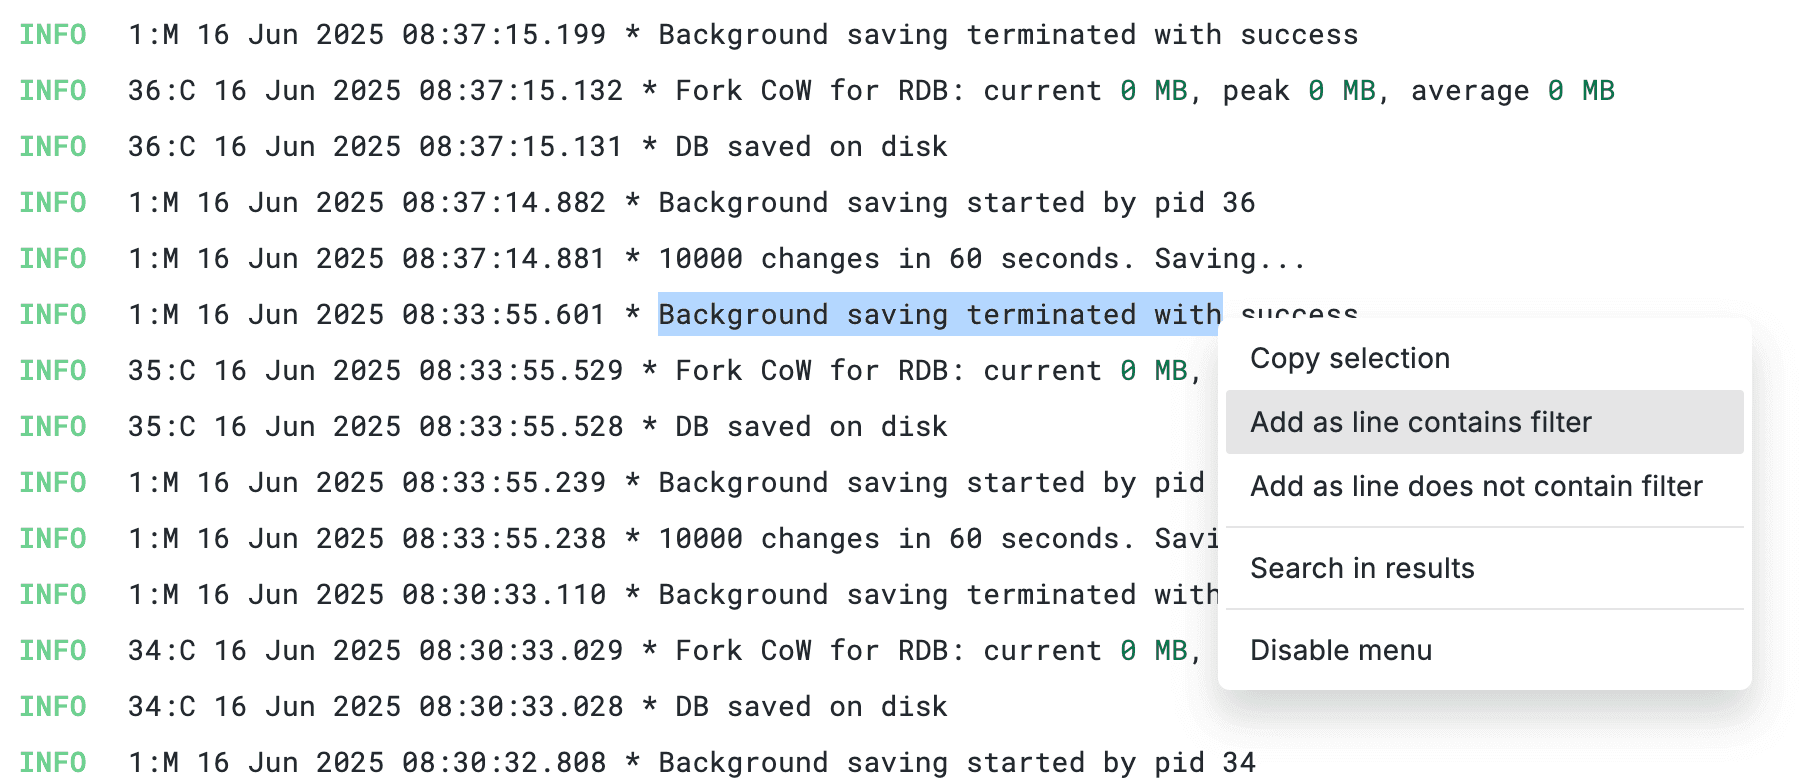
インシデントの調査中にログ行を確認しているとします。そこに ServiceName: payment-gateway という表示を見つけました。クエリビルダーに移動して手動でフィルターを追加する代わりに、フィールドの横にある「+」アイコンをクリックします。これだけでクエリが即座に更新され、該当サービスにデータが絞り込まれます。同様に、「-」をクリックするとそのサービスのデータセットが除外されます。ログ本文内のテキストを選択して「line contains filter」をクリックすれば、全文検索が追加されます。
その結果、UI の操作に煩わされることなくシームレスにデータを絞り込み・フィルタリングできるようになり、インシデント調査を加速できます。
構造化された属性表示
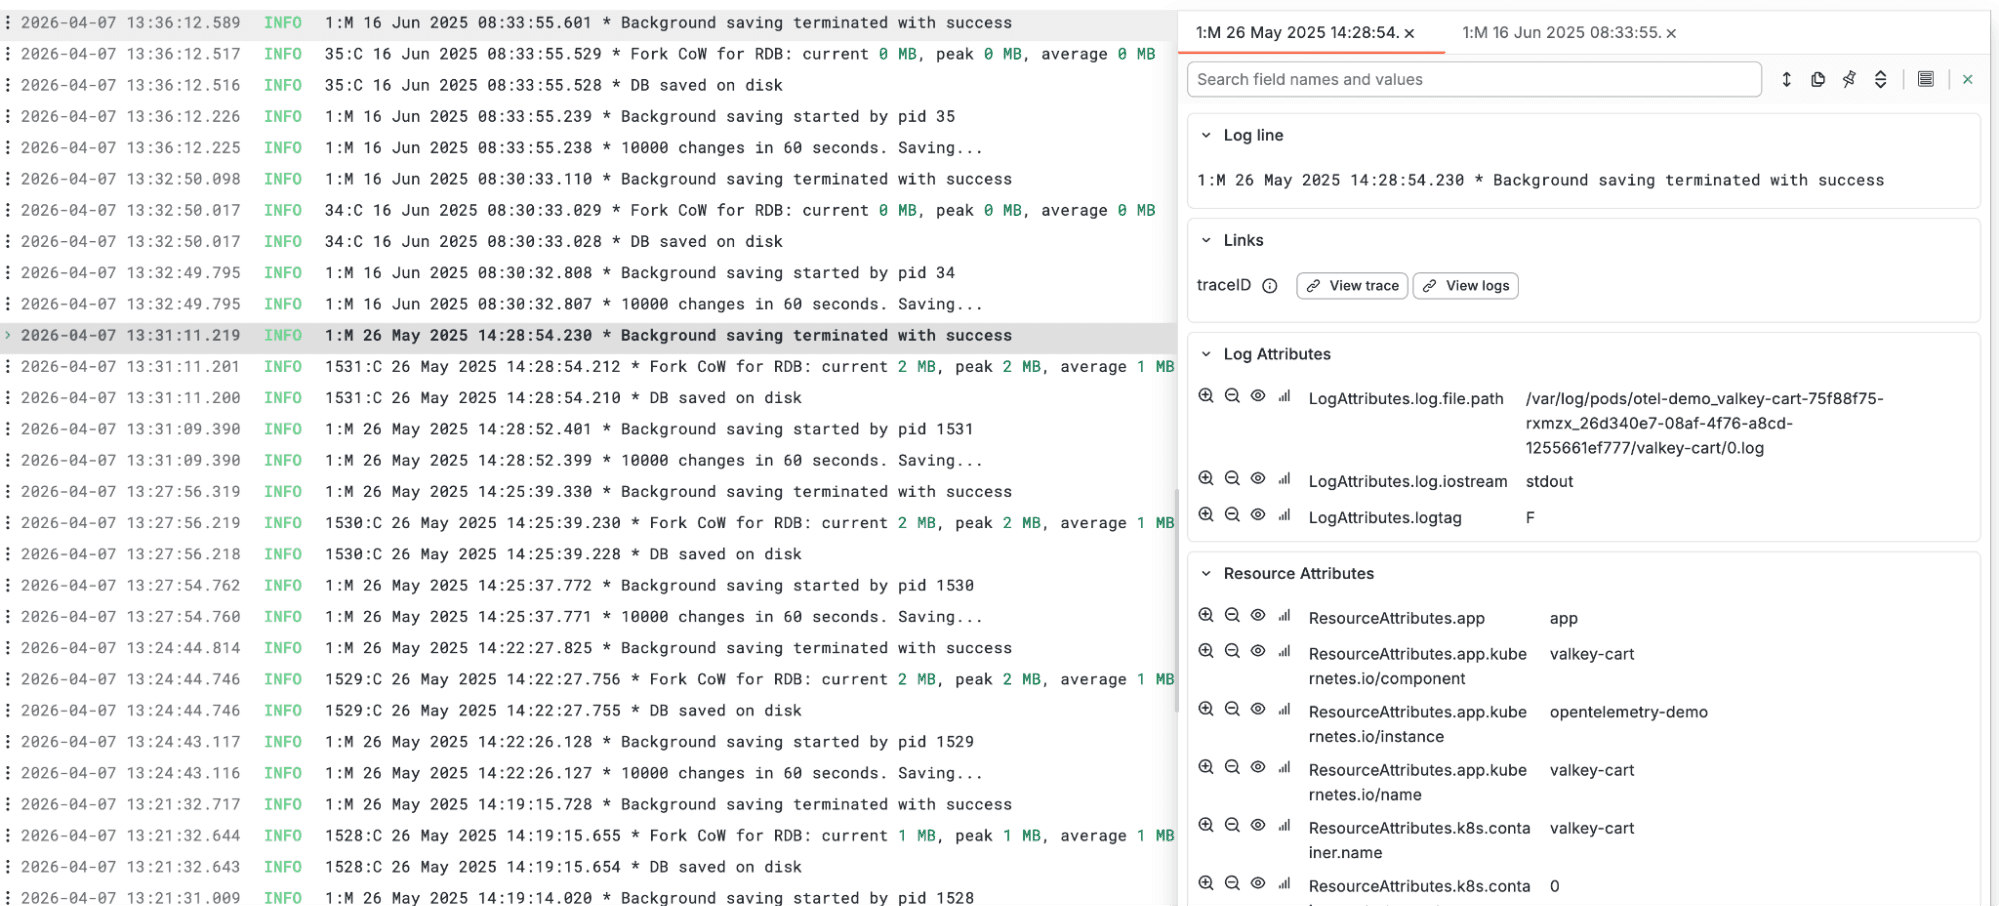
OpenTelemetry のログとトレースは、リソース、ログ、スパン、スコープの各属性にわたって 40 以上のフィールドを持つことがありますが、現状ではそれらが 1 つのフラットなリストとして表示されます。私たちは、OTel データの構造をより適切に反映するために、カテゴリごとに属性をグループ化し、視覚的に明確に区別する方法を検討しています。目的はフィールドを見つけやすくし、果てしないスクロールから解放されて必要な情報へすばやくアクセスできるようにすることです。
SQL モードでの自動ログボリュームヒストグラム
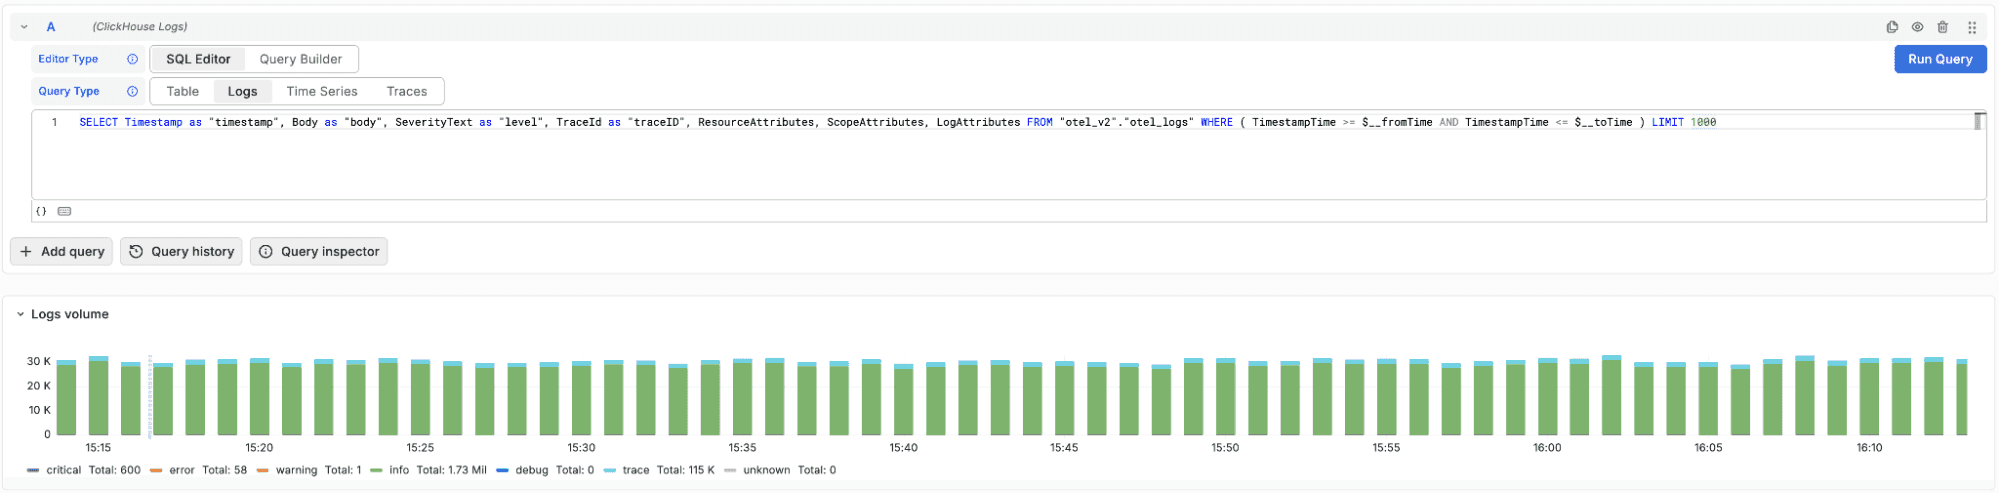
現在クエリビルダーモードで利用できるログボリュームヒストグラムは、未加工の SQL クエリでも機能するべきです。OTel カラムが設定されていれば、カスタム SQL を解析できない場合でも、プラグインが重要度別のボリューム内訳を自動生成できます。ログ検索と並行して個別に集計クエリを作成する必要はありません。
よりスマートなダッシュボード変数
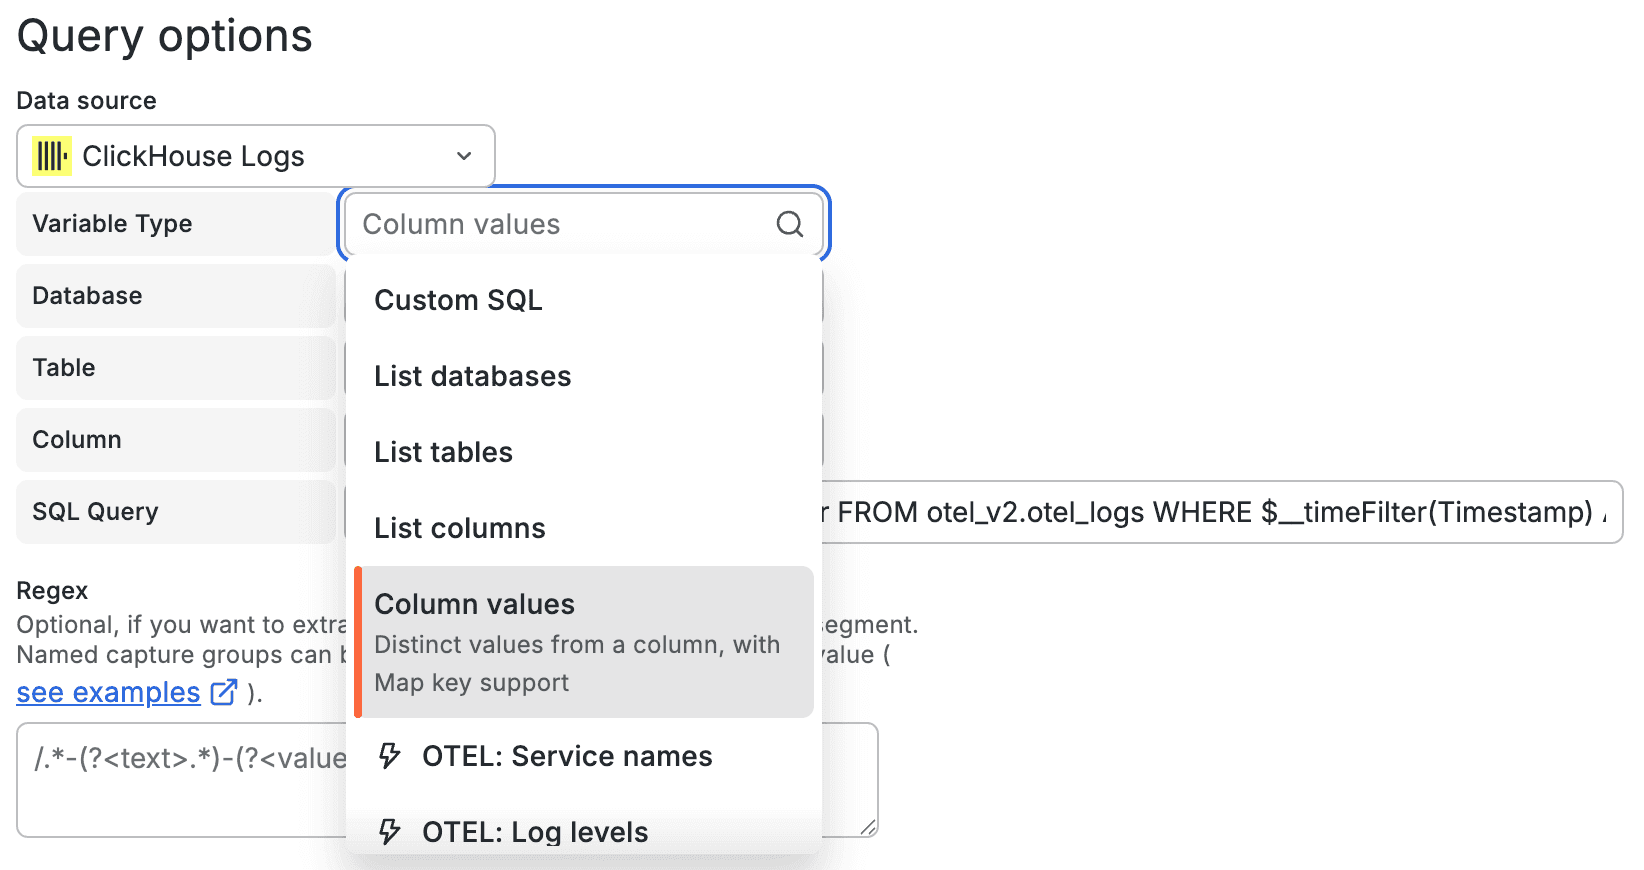
現状、変数エディターでダッシュボードのドロップダウンに値を取り込むには、未加工の SQL を記述する必要があり、事前に正確なデータベース名、テーブル名、カラム名を把握していなければなりません。私たちは、SQL を自動生成するガイド付きエディターによって、この体験を改善することを目指しています。
変数のタイプを選択すると、クエリが動的に生成されます。データベース、テーブル、カラムの一覧取得や、カラムの重複を除いた値の取得から選択できます。あるいは、サービス名やログレベルなどの事前定義された OTel プリセットも使用可能です。カスケード式のドロップダウンにより、スキーマを記憶していなくてもデータベースから特定のカラムまで辿ることができます。特定のカラムを選択すると、その一意な値が変数の選択肢として取得され、SQL を一切記述することなく、データベース -> テーブル -> カラム -> 値というワークフローが完結します。
アノテーション - OTel データからのデプロイおよび K8s イベント
Grafana のアノテーションは時系列パネル上に垂直マーカーとして表示され、KPI の推移グラフと変更点を関連付けるのに役立ちます。現在、多くのチームは CI/CD の Webhook や手動の API 呼び出しを介してこれらを設定し、補助的なデータベースから個々のイベントを取り込んでいます。
OTel データがあれば、こうした作業は不要になります。トレースとログにはすでに ResourceAttributes['service.version'] や ResourceAttributes['container.image.tag'] が含まれています。SQL アノテーションクエリによってこれらの値の変化を検出し、デプロイやロールバックをダッシュボード上のマーカーとして表示できます。これはサービスがすでに送信しているデータから自動的に導出されるため、外部連携は不要です。
同様に、OTel Collector によって取り込まれた Kubernetes イベント (Pod の再起動、OOM kill、スケーリングイベント) は、本質的にタイムスタンプを持つ個別のイベントです。これらはシンプルな WHERE フィルターによって、アノテーションへと直接マッピングされます。
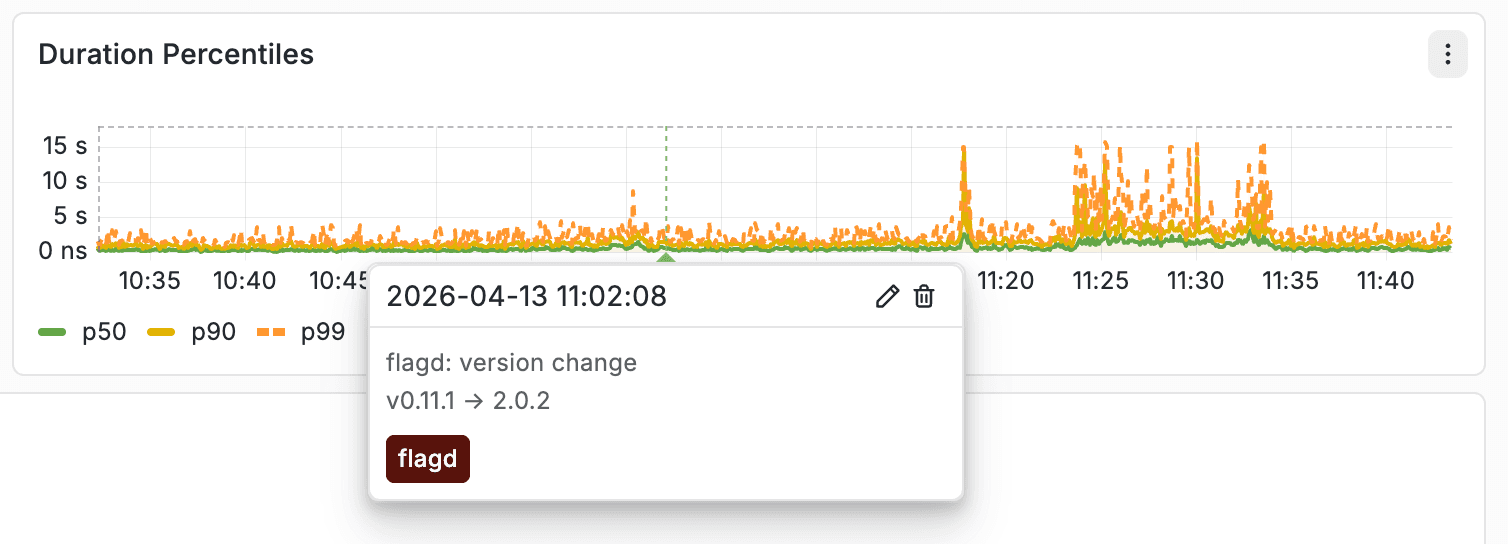
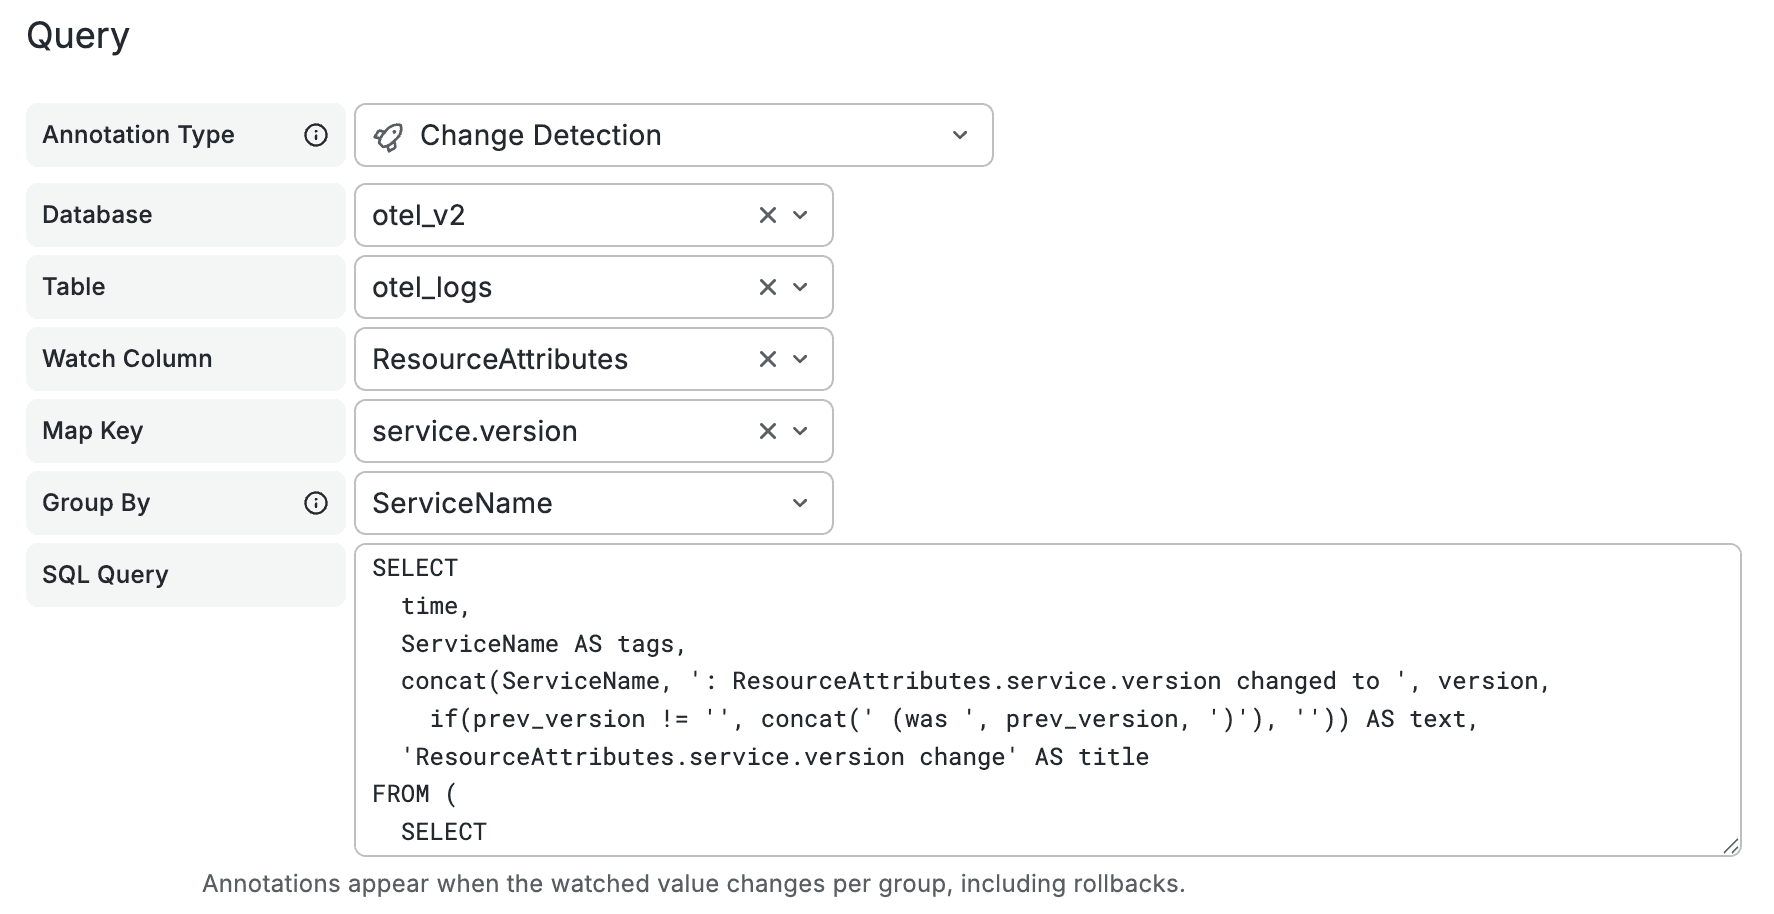
私たちは、エディターにアノテーションプリセットを導入する選択肢を検討しています。「Change detection」や「K8s lifecycle events」を選択するだけで、SQL を記述することなく動作するクエリを取得できます。属性の変更検出については、プラグイン側で差分検出を自動処理することも可能です。時系列でのサービスバージョンのシンプルな SELECT 文を記述するだけで、実際の変更点のみがアノテーションマーカーになります。カスタム SQL によるアノテーションも従来どおり機能します。
データソース間でのフィルター保持
現在、Explore でデータソースを切り替えると、作業コンテキストが失われてしまうことがよくあります。時間をかけて構築したフィルター、条件、絞り込みを最初から再作成しなければならず、調査の遅れや思考の流れの中断につながります。
理想的には、切り替え時にもそのコンテキストを維持し、フィルターが自動的に引き継がれるようにしたいと考えています。これにより、クエリを再構築することなく分析を続行でき、データソースをまたぐ探索がより迅速になり、作業の中断を大幅に減らせます。
これらはいずれも単体で画期的なものではなく、ユーザーが当然期待する標準的な動作です。そして、まさにそれこそが要点です。特別な学習を必要とせず、手になじむ体験であるべきなのです。
まずは検索、必要なときに SQL
現在のクエリビルダーは、あらゆるデータベース、あらゆるテーブル、あらゆるカラム、あらゆるクエリタイプに対応できるよう、柔軟性を最大限に高めて設計されています。汎用的な SQL データソースとしては適切なデフォルトですが、代償も伴います。ログを検索するといった単純なタスクであっても、Explore を開くたびにスキーマを把握しているか、何度も調べ直すことをユーザーに強いてしまいます。
これをよりシンプルにするために、検索バーから始められるコンパクトなクエリモードを試験運用しています。ClickStack と同様に、ユーザーは SQL を書くことなく自然にログを検索できるため、初期体験がより直感的になり、事前に背後にあるスキーマを理解しておく必要がなくなります。
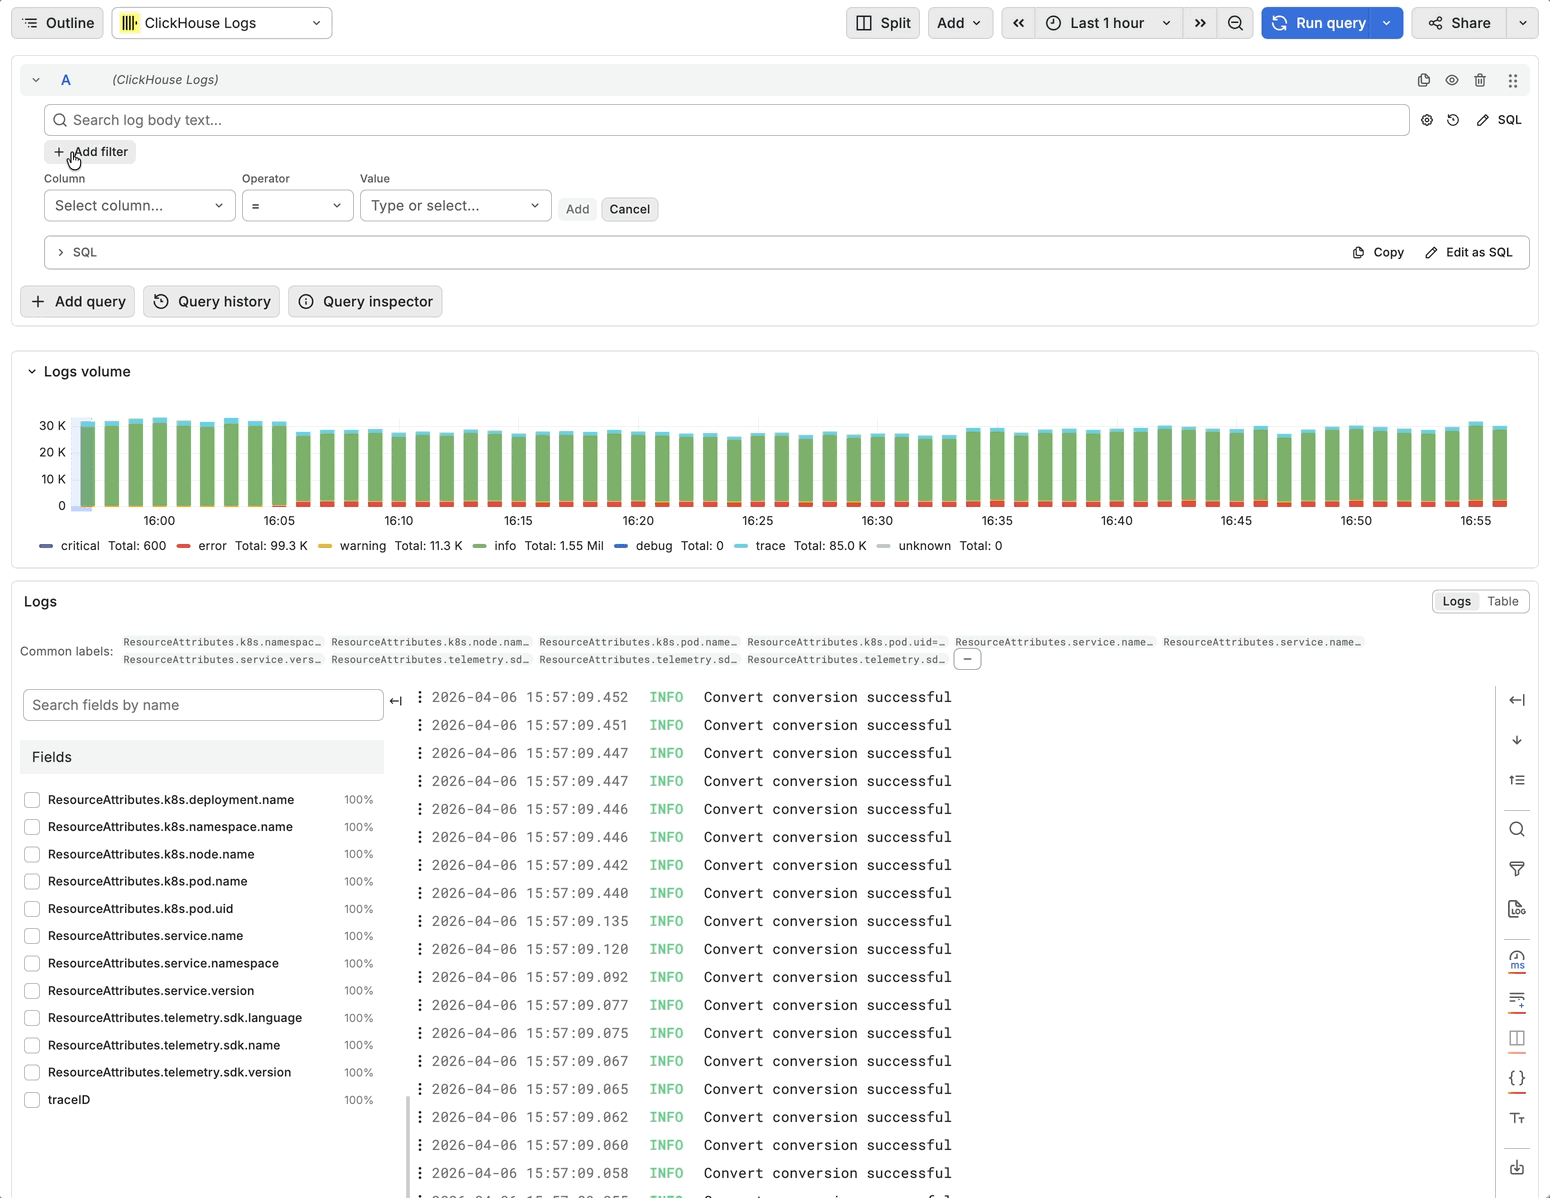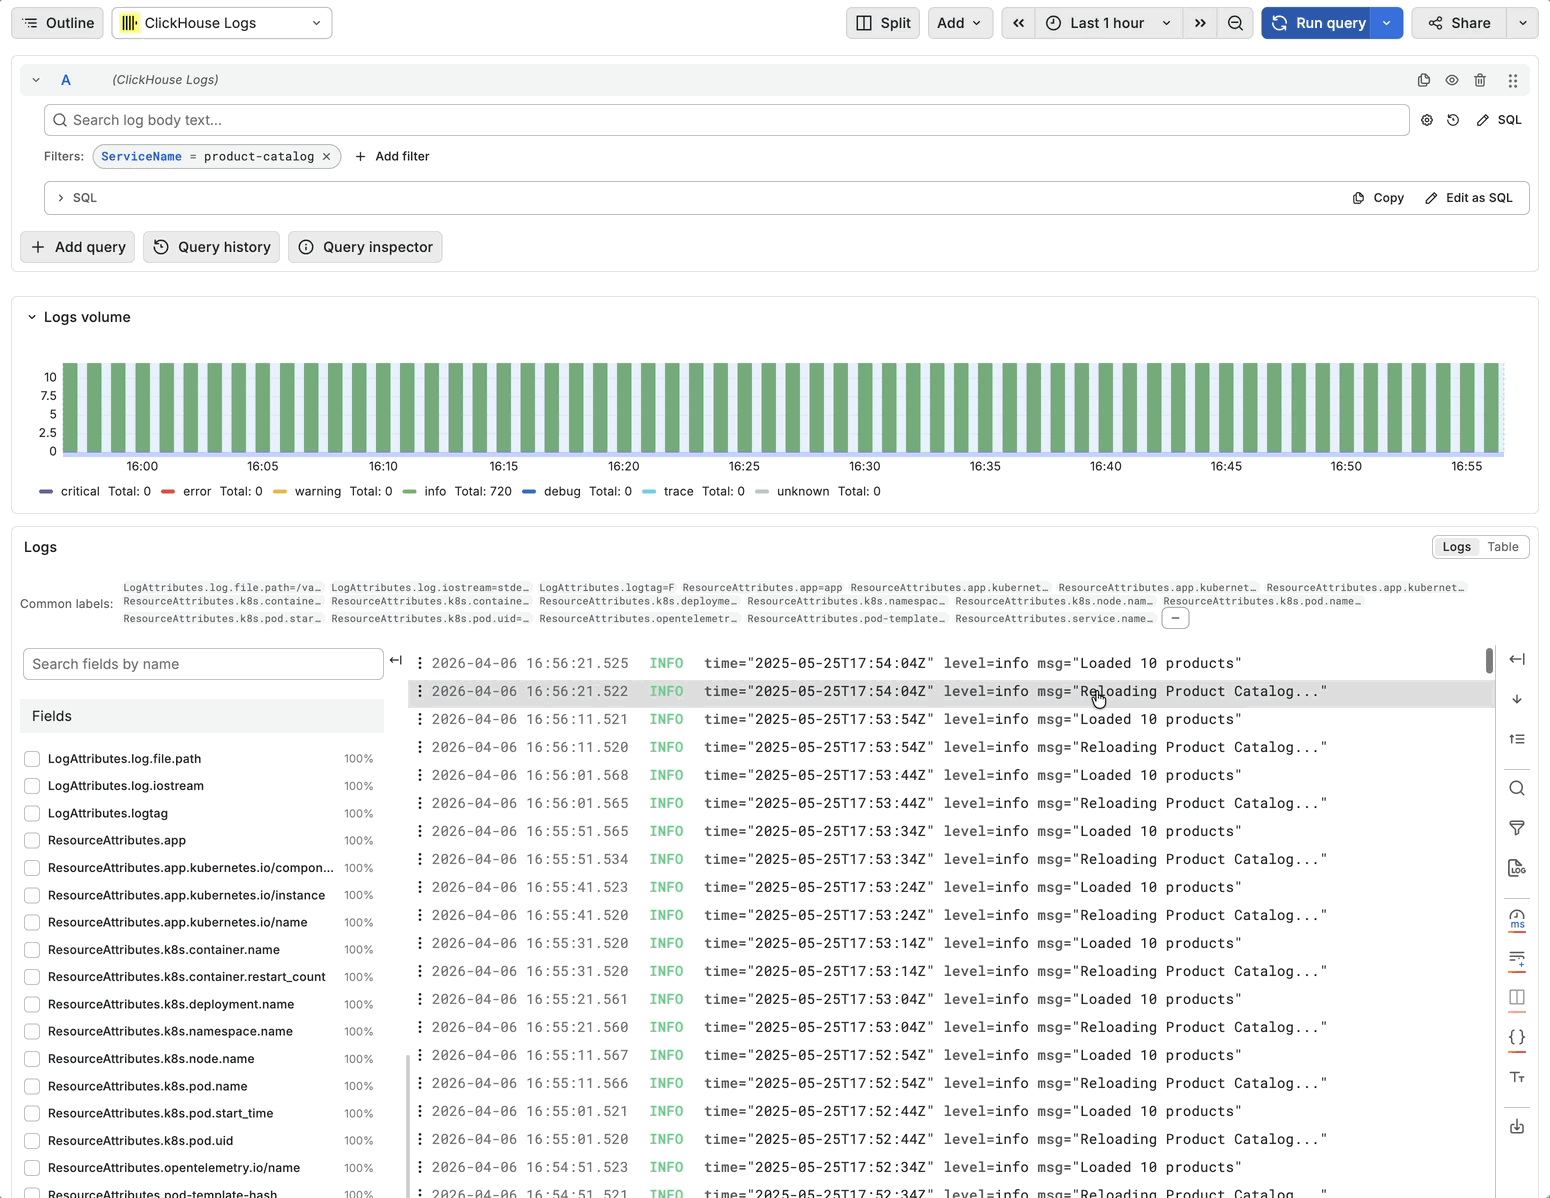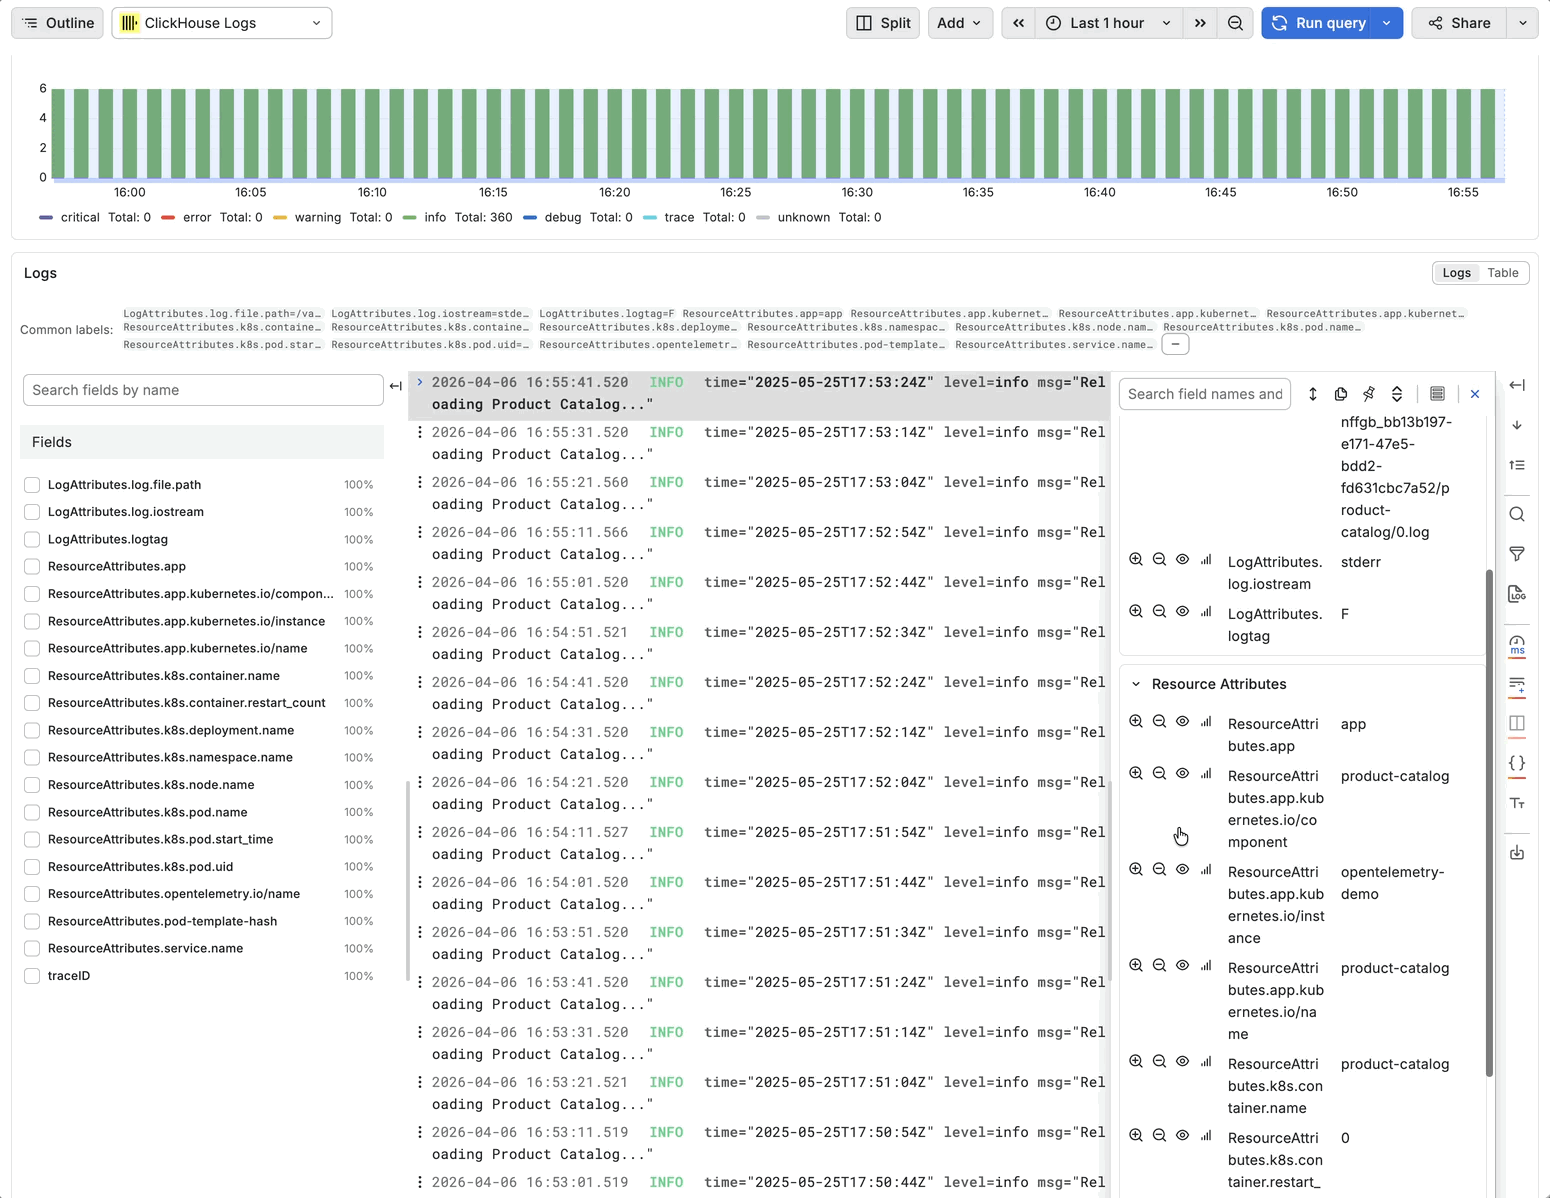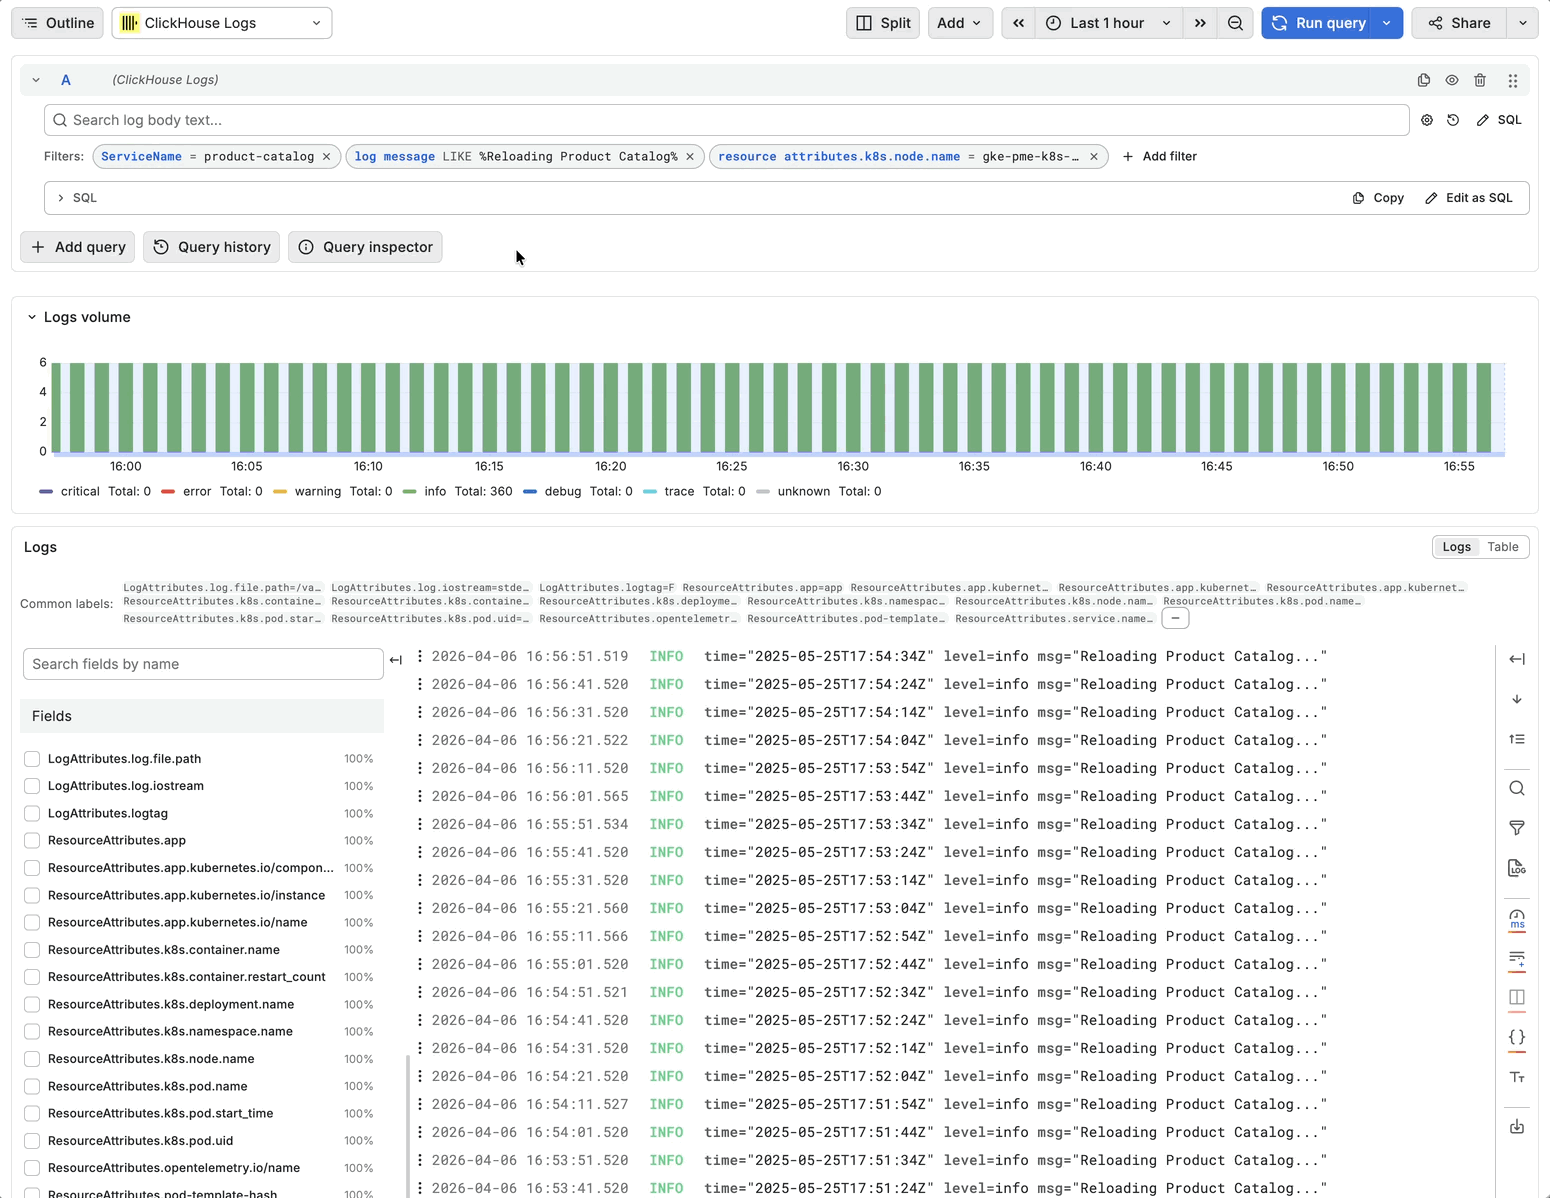
新しい検索動作の現在のプロトタイプ。
データソースを選択すると、必要最低限に絞り込まれた新しいエディターが、検索バーとフィルターピルとともに表示されます。検索語句を入力して Enter キーを押すだけです。内部的には、インデックス付きカラムの全文検索に最適化された ClickHouse の hasToken() 関数が使用され、数十億行のログを数秒で検索します。ファセットはコンパクトなリストとして表示され、カラム名、演算子、値のオートコンプリート対応検索が可能です。
カスタムの並び順やリミットが必要ですか? 歯車アイコンを 1 回クリックするだけです。
生成された SQL を確認したいですか? プレビューを展開してください。
完全に制御したいですか? 「Edit as SQL」をクリックすれば、現在のクエリがあらかじめ入力された状態で生のエディターに移行します。
テーマはシンプルです。一般的な使い方はシンプルで直感的に、より高度なワークフローもすぐに手の届く場所に置いておくということです。何も隠されておらず、必要になるまで邪魔にならないようになっているだけです。
このテーマをさらに発展させると、現在 Explore でデータソースを選択して作業すること自体にも、不要な摩擦が存在しています。両方に対応可能な 1 つのデータソースにおいて、クエリ実行時にログを扱うのかトレースを扱うのかを指定することがユーザーに求められます。しかし多くの場合、ユーザーは同じ種類のデータを検索しています。これが探索を遅らせる余分な反復ステップとなっています。
これを簡素化するため、単一テーブルデータソースモードを計画しています。ログ用のテーブル向けにデータソースを設定しておけば、Explore を開くだけでモードセレクターやテーブルピッカーを介さずに、直接ログ検索体験へと移行できます。Explore を開き、データソースを選択し、すぐに検索と分析を開始できます。
すぐに使えるダッシュボード
現在、ClickHouse エクスポーターを含む OpenTelemetry Collector をデプロイすると、データは ClickHouse に格納されますが、Grafana でのダッシュボード作成は依然としてゼロから行う必要があります。導入体験をよりスムーズにするため、標準スキーマですぐに動作する OpenTelemetry および Kubernetes オブザーバビリティ向けの標準ダッシュボードを提供する予定です。
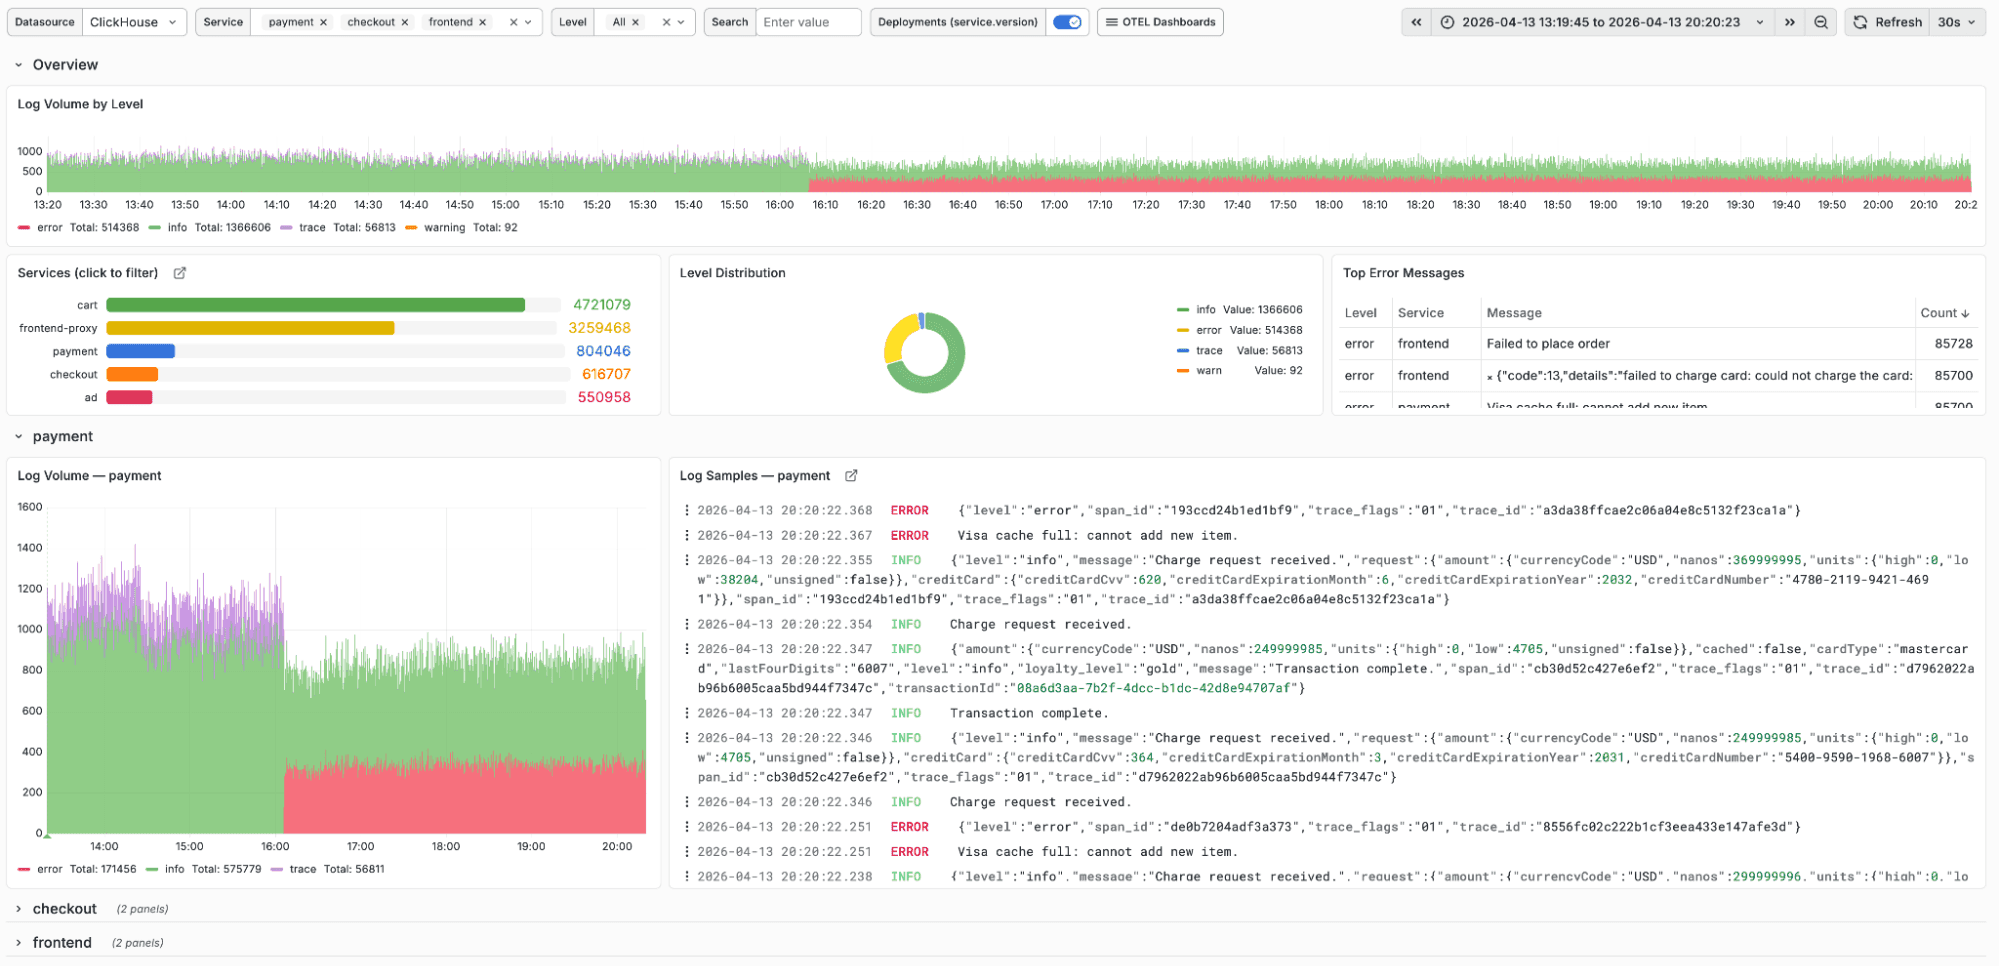
最初のセットは、主要なオブザーバビリティワークフローをカバーする予定です。サービスごとの内訳を伴う重要度別ボリュームを表示するログダッシュボードや、所要時間の分布、サービス依存関係マッピング、サービスごとの RED メトリクス (リクエストレート、エラーレート、所要時間)、上位スパンの可視化を備えたトレースダッシュボードが含まれます。ダッシュボードでは、変数やアノテーションの活用例も示されます。
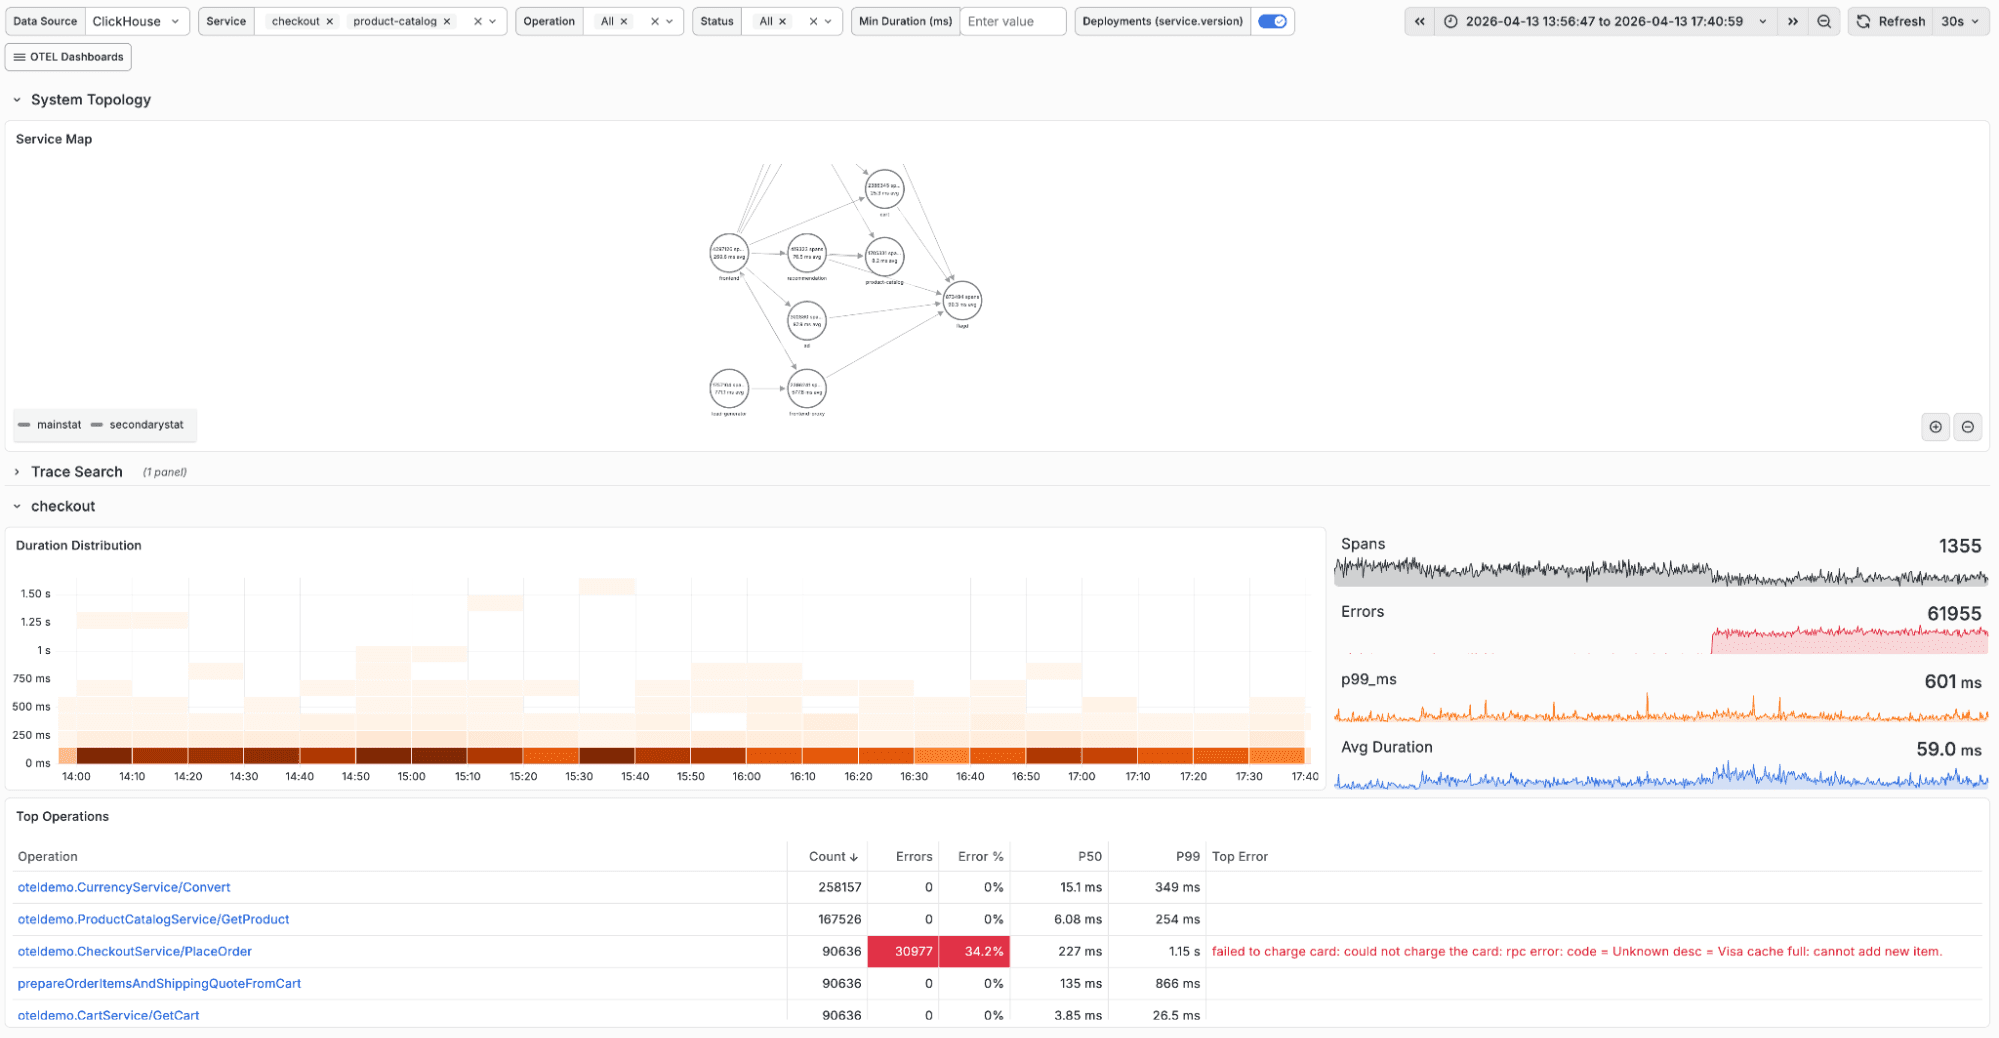
目指しているのは、オブザーバビリティのために ClickHouse をデプロイするチームが、数時間ではなく数分でデータ取り込みから実用的なダッシュボードの利用まで進められるようにすることです。ユーザーはデータソースの設定時に関心のあるダッシュボードをインポートするだけで済みます。
生の SQL を使わないメトリクス探索
ClickHouse OpenTelemetry エクスポーターは、OTel エージェントや Kubernetes からの CPU 使用率、メモリ、ネットワーク I/O、その他のインフラストラクチャシグナルといったメトリクスの取り込みをすでにサポートしています。
課題は、Grafana でこのデータを視覚的に探索する際、手作業で SQL 集計クエリを記述しなければならないことが多く、メトリクスネイティブなデータソースにユーザーが期待する体験とは乖離している点です。
ClickStack がネイティブなクエリビルダーを提供して複雑な SQL クエリを記述不要にしているのと同様に、私たちはその体験を Grafana にも持ち込みたいと考えています。このコンパクトなメトリクスビルダーにより、テーブルタイプを選び、メトリクスを選択し、集計方法を指定して、グループ化ディメンションを追加できるようになります。ResourceAttributes のような OTel の Map カラムの場合、それを選択するとキーピッカーが開き、ブラケット記法を書かなくても k8s.namespace.name や host.name などのフィールドへとドリルダウンできるようになる予定です。
これにより、インフラストラクチャやランタイムのメトリクスを、クエリ用の別システムを維持することなく、あらゆるメトリクスファーストのツールと同様の方法で探索できるようになることを目指しています。
さらなる展望
上記は、私たちが近い将来の提供を目指している変更点です。もう少し先を見据えて、私たちが検討している領域をいくつかご紹介します。
双方向の SQL パース
現在、クエリビルダーは SQL を自動生成しますが、その流れは一方通行です。その SQL を編集した場合、変更を保持したままビルダーに戻ることはできません。これは、システムがクエリ自体を真に理解していないという、より根本的な制限を示しています。
適切な SQL パーサーを導入し、完全な AST を構築することで、この制約を克服できます。ランブックからクエリを貼り付けてフィルターピルやボリュームヒストグラムに自動変換させたり、ビルダーとエディターを自由に行き来しながら作業内容を維持したりできるようになります。クエリが双方向で完全に理解されているからです。
ユーザーごとのクエリ識別
現在、Grafana のすべてのクエリは、データソースに設定された ClickHouse ユーザーとして実行されます。これにより、きめ細かなアクセス制御を適用することが困難になり、チームごとに個別のデータソースを用意してそのレベルでアクセスを管理せざるを得ないケースが多く、スケールやガバナンスの維持が急速に難しくなります。
JWT フォワーディングを使用すると、各クエリが Grafana ユーザーのアイデンティティを保持するようになります。これにより、適切な監査ログ、ユーザーごとのクエリコスト追跡、実際にクエリを実行している人物に基づいた行レベルのアクセス制御が可能になり、共有認証情報ではなく実際のユーザーコンテキストに合わせたアクセス権と可視性を実現できます。
AI を活用したクエリ作成
LLM は ClickHouse SQL の作成に長けてきており、ClickHouse には LLM がスキーマを理解するのを支援するツールも備わっています。私たちは、見たい内容を言葉で説明するだけで、テーブル、カラム、データモデルの完全なコンテキストを反映した実用的なクエリが得られる対話型モードを検討しています。
皆様からのご意見をお待ちしています
オブザーバビリティ、リアルタイム分析、あるいはその両方に Grafana と ClickHouse を併用されているかどうかにかかわらず、この方向性についてのご意見をぜひお聞かせください。どの点に魅力を感じますか? 足りないものは何でしょうか? どのような点でユースケースに適合していませんか? また、チームの体験をより良くするために何が必要でしょうか?
オブザーバビリティニュースレターに登録する
ClickStack や Grafana プラグインに関するオブザーバビリティ関連の機能リリースや最新情報をお届けします。