5万


ClickHouse の ClickPipes チームでは、さまざまなデータソースから ClickHouse へデータを移行するための、高性能なマネージドコネクターを開発しています。Postgres、MySQL、MongoDB 向けの CDC (Change Data Capture) コネクターを構築したのに続き、現在は Delta Lake を皮切りにデータレイクソースからの CDC サポートに取り組んでいます。
本記事では、Delta Lake の Change Data Feed (CDF) の活用に向けた調査から得られた知見をすべて共有します。さらに、Delta Lake から ClickHouse への CDC を実現する Python 製リファレンス実装を MIT ライセンスでオープンソース公開しています。
今後数か月以内に、ClickPipes で Delta Lake CDC のプロダクショングレードのサポートを追加する予定です。デザインパートナーとしての連携にご興味がある場合は、clickpipes@clickhouse.com までメールでお問い合わせください。
Delta Lake と ClickHouse
Delta Lake はオブジェクトストレージ上にトランザクショナルなストレージ層を提供し、ペタバイト規模のデータの取り込みと処理に最適です。一方で ClickHouse は、高性能な分析クエリ向けに最適化されたオープンソースの列指向データベースです。これらを組み合わせることで、データレイクハウスの領域には Delta Lake を、高速なリアルタイムデータアクセスには ClickHouse を活用し、両テクノロジーの強みを引き出せます。ClickHouse はすでに DeltaLake や deltaLakeCluster テーブルエンジンを用いて Delta Lake の Parquet に対する読み取り専用クエリエンジンとして使用でき、近いうちに書き込みのサポートも予定されています。
CREATE TABLE my_delta_table
ENGINE = DeltaLake('s3://path/to/deltalake/table', 'access-key', 'secret-key')スキーマは Delta Lake のメタデータから自動的に推論され、次のようにクエリできます:
SELECT col1, col2, col3, _file, _time, …etc
FROM my_delta_tableよりアドホックなクエリには、テーブル関数の deltaLake および deltaLakeCluster を使用してその場でデータをクエリできます:
SELECT col1, col2, col3, _file, _time, …etc
FROM deltaLake('s3://path/to/deltalake/table', 'access-key', 'secret-key')Delta テーブルのクエリ層として ClickHouse を使用する構成は、データが主にコールドでクエリ頻度が高くなく、レイクハウスとウェアハウス間でのデータ重複を避けながらリモートオブジェクトストレージ読み取りのレイテンシを許容できる場合に効果的な戦略です。一方で、高頻度かつ低レイテンシの読み取りを必要とし、API、ダッシュボード、レコメンデーションシステム、その他のユーザー向けアプリケーションなどの別システムからリアルタイムにデータへアクセスするために ClickHouse を利用するユーザーもいます。さらに、キャッシュなどの最適化技術を用いても、リモートオブジェクトストレージのスキャンは低速でコストがかかる場合があるため、そうしたユースケースではデータを ClickHouse 内に保持することが魅力的な選択肢となります。
CDC (Change Data Capture) は、通常はデータのスナップショット取得後に Delta Lake テーブルから増分変更をレプリケーションするプロセスです。これによりデータ転送のオーバーヘッドが削減され、最小限のレイテンシで ClickHouse が Delta テーブルの最新状態を常に反映できるようになります。
パイプラインの主要コンポーネント
Delta Lake から ClickHouse への CDC パイプラインは、以下の主要コンポーネントで構成されます:
- Delta Lake テーブル: データが永続化されるソースデータレイク。
- Change Data Feed (CDF): 行レベルの変更をキャプチャする Delta Lake の仕組み。
- ClickHouse: データのリアルタイム活用を可能にする移行先データベース。
データモデリング
アップストリームの状態と結果整合性 (eventual consistency) を保ちながら整合させるため、ClickHouse の ReplacingMergeTree テーブルエンジンを使用します。これは MergeTree の一種で、重複の解消や順序が前後したデータの取り込み (挿入、削除、更新の順など) を処理する CDC ワークフローに有用です。これらの手法は、過去に提供した Postgres 向けデータモデリングのガイドラインとおおむね一致しています。ClickHouse テーブルは以下の DDL で作成できます。ソートキーとして name と age を、バージョンキーとして Delta テーブル CDF から取得した _commit_version を指定しています。更新や削除のない追加専用 (append-only) ワークフローでは、通常の MergeTree テーブルの方がより最適なクエリ条件を提供します。
CREATE TABLE default.new_cdc_table
(
    `id` String,
    `name` String,
    `age` Int64,
    `created_at` DateTime,
    `_change_type` String,
    `_commit_version` Int64,
    `_commit_timestamp` DateTime
)
ENGINE = ReplacingMergeTree(`_commit_version`)
PARTITION BY toYYYYMM(`created_at`)
ORDER BY (`name`, `age`)このテーブル定義では、主キーに基づいた重複排除が設定されます。マージ中に重複が見つかると、ClickHouse はユニークなキーの組み合わせごとに 1 行だけを保持します。バージョンカラム (この場合は _commit_version) を追加すると、ClickHouse は最も高いコミットバージョンを持つ行を保持するようになります。バージョンカラムを指定しない場合、ClickHouse は最後に追加された行をデフォルトで保持しますが、これは CDC のような結果整合性のユースケースには通常最適ではありません。このデータ挿入パターンは確立されたものであり、ClickPipes や PeerDB の Postgres および MySQL CDC プロセスの内部でも使用されています。
ReplacingMergeTree を使って CDC データをモデリングする際には、注意すべき点がいくつかあります。1 点目はマージのタイミングです。従来の RDBMS の UPSERT 操作とは異なり、挿入直後に重複が削除されるわけではありません。データの重複排除は、ClickHouse が自動的に制御するバックグラウンドのマージ処理中にのみ行われます。これは、テーブルに対するクエリに FINAL を付与することで回避できます。もう 1 つの注意点は削除されたレコードの扱いです。行を論理削除した場合、移行先の ClickHouse テーブルには最後の値または ClickHouse のデフォルト値を持つレコードが残り続けます。本パイプラインのサンプルスクリプトでは、現時点で削除イベントをサポートしていません。
Delta Lake でのデータ準備
サンプルデータローダースクリプトを使用して、パーティション分割されていない Delta Lake テーブルを作成し (非常に大規模なテーブルではパーティショニングを推奨します)、合成生成されたデータをストリーミングします。指定されたバッチサイズでレコードを作成するために DataFrame ライブラリの Polars が使用されています。データ生成の性能ベンチマークの例として、S3 バケットと同じリージョンにある 2 vCPU・4 GB RAM の c5.large AWS EC2 インスタンス上で、1 秒ごとに 1 回あたり 20,000 件 (Delta Lake テーブルへの書き込み量として約 10 MB 相当) のレコードを生成および書き込みできます。バッチサイズは変更可能で、ノートパソコンなどの汎用ハードウェアでも実行できます。このデータローダースクリプトは、Delta Lake テーブルが存在しない場合に作成し、作成時に CDF を有効化します。なお、CDF の有効化による挿入処理への影響はごくわずかです。Delta Lake テーブルに十分なコミットが蓄積されたら、ClickHouse へのデータ取り込みを開始する準備が整います。
Change Data Capture
CDC は、ソースや関係するプロトコルによって困難な処理になり得ます。Delta Lake や Apache Iceberg などのオープンテーブルフォーマット (OTF) では、Postgres のような従来のトランザクショナルデータベースと比較して CDC の複雑さが増します。Postgres はトランザクション境界内で時系列順にすべての変更を記録する Write-Ahead Log (WAL) を標準で保持していますが、オープンテーブルフォーマットでは分散ストレージ全体のファイルレベルの操作から変更ストリームを再構築しなければなりません。これらのフォーマットはメタデータ層とコミットバージョンの差分に依存して変更を追跡するため、順序の維持、同時書き込みの処理、およびコンシューマーがテーブルバージョン間で何が変更されたかを確実に識別できるようにする点において課題が生じます。幸いにも Delta Lake は Change Data Feed (CDF) を提供しており、これにより行レベルのデータに対する操作が可能になり、ClickHouse や ClickPipes などのダウンストリームシステムで処理できるようになります。変更データはトランザクションの一部としてコミットされ、新しいデータがテーブルにコミットされると同時に利用可能になります。この設定は Delta Lake テーブルの作成時に有効化できます:
CREATE TABLE my_cdc_table (id STRING, name STRING, age INT, created_at TIMESTAMP) TBLPROPERTIES (delta.enableChangeDataFeed = true)あるいは、既存のテーブルに対して次のように追加することもできます:
ALTER TABLE my_cdc_table SET TBLPROPERTIES (delta.enableChangeDataFeed = true)RDBMS の CDC メカニズムとは異なり、CDF は物理ストレージから明示的な変更レコードを消費するのではなく、変更データをクエリする際に複数のコンポーネントから構築される論理的な抽象化です。コミットされたデータはトランザクションログ (_delta_log ディレクトリ内) に記録され、データパートを参照し、レコードバッチのストリームとして読み取ることができます。これは、(以下の例のように) レコードが特定の時間範囲内の変更を特定する INSERT (追加) 専用ワークロードの場合に当てはまります。Delta Lake は min/max 統計を利用して、関連する変更を含まないデータファイルをスキップします。このデータスキッピングにより、変更イベントを計算するために読み取る必要のあるデータ量が削減されます。トランザクションログの内容は次の例のようになります:
{
  "add": {
    "path": "part-00001-bcb81f71-8bd9-4626-9186-0580428941d0-c000.snappy.parquet",
    "partitionValues": {},
    "size": 489819,
    "modificationTime": 1752068897913,
    "dataChange": true,
    "stats": {
      "numRecords": 10000,
      "minValues": {
        "id": "000bcedc-d231-40f7-9897-189010d9d7f5",
        "name": "AABCX",
        "age": 18,
        "created_at": "2025-07-09T13:48:13.648587Z"
      },
      "maxValues": {
        "id": "fff6a0e8-bccb-46be-9af4-0d7d3c5d37172",
        "name": "ZZZTR",
        "age": 65,
        "created_at": "2025-07-09T13:48:13.650625Z"
      },
      "nullCount": {
        "id": 0,
        "name": 0,
        "age": 0,
        "created_at": 0
      }
    },
    "tags": null,
    "baseRowId": null,
    "defaultRowCommitVersion": null,
    "clusteringProvider": null
  }
}
{
  "commitInfo": {
    "timestamp": 1752068897913,
    "operation": "WRITE",
    "operationParameters": {
      "mode": "Append"
    },
    "clientVersion": "delta-rs.py-1.0.2",
    "operationMetrics": {
      "execution_time_ms": 1213,
      "num_added_files": 1,
      "num_added_rows": 10000,
      "num_partitions": 0,
      "num_removed_files": 0
    }
  }
}Delta Lake テーブルに対する更新や削除の場合、変更は _change_data サブディレクトリに記録され、ここには変更されたレコードのみを含む Parquet ファイルが格納されます。更新を記録したトランザクションログは次のようになります:
{ "add": { "path": "part-00001-bf9a82c5-0eda-433a-a2e6-8ec7c8757f23-c000.snappy.parquet", ... }}
{ "cdc": { "path": "_change_data/part-00001-5482b246-deb0-4338-a82c-d56a32d38ac3-c000.snappy.parquet", ... }}
{ "add": { "path": "part-00001-e653da14-92ee-4b6d-a03d-86333a1a56a5-c000.snappy.parquet", ... }}
{ "cdc": { "path": "_change_data/part-00001-3acf8a12-71aa-4f0c-8c61-e24046633a98-c000.snappy.parquet", ... }}
{ "remove": { "path": "part-00001-ec06b026-ca3b-48ec-8687-bafd2706a877-c000.snappy.parquet", ... }}
{ "remove": { "path": "part-00001-93252f4b-72ae-4bf3-8be0-ae2031441ab8-c000.snappy.parquet", ... }}
{ "commitInfo": { "timestamp": 1753784155897, "operation": "MERGE", ... }}上記は、target.id = source.id という条件に基づいてターゲットテーブル内の 100 件の既存レコードを 100 件のソースレコードと照合して更新したマージ操作を記録したものです。更新されたレコードを含む 2 つの新しいデータファイルが作成され、変更を追跡するために 2 つの CDC ファイルが作成されました。さらに、2 つの古いデータファイルが削除されました。
変更データイベントファイルを一覧表示すると、生データを確認できます。これは ClickHouse から次のようにクエリできます:
select _file from s3(
   's3://path/to/deltalake/table/_change_data/*.parquet',
   '[HIDDEN]',
   '[HIDDEN]'
)part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet
part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet
part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet
part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet
part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet
part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet
part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet
part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet
…_change_data のパートファイルは ClickHouse を使ってその場でクエリできます
select *, _file, _time from s3(
   's3://path/to/deltalake/table/_change_data/*.parquet',
   '[HIDDEN]',
   '[HIDDEN]'
)431cbe31-e33f-4a8c-9d4d-5d0b0f1b38c1 XUBSG 53 2025-07-09 14:38:21.646311 update_preimage part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet 2025-07-28 13:04:52
431cbe31-e33f-4a8c-9d4d-5d0b0f1b38c1 WDMGN 43 2025-07-28 13:03:49.198168 update_postimage part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet 2025-07-28 13:04:52
07edd0c9-adc2-4110-8cc3-448b99ec1900 OJSSL 29 2025-07-09 13:48:50.254035 update_preimage part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet 2025-07-28 13:04:52
07edd0c9-adc2-4110-8cc3-448b99ec1900 GEKKK 38 2025-07-28 13:03:49.198218 update_postimage part-00001-08d3c1e5-87e9-4455-8b48-ea7398277003-c000.snappy.parquet 2025-07-28 13:04:52
…
286e746a-eb0f-4474-a72f-0323a95b79d9 TURGH 46 2025-07-09 13:56:11.702183 delete part-00001-8421b723-9407-47aa-826e-1c594698e5cc-c000.snappy.parquet 2025-07-28 13:05:55
26c54093-5aae-4bf6-93a8-58912ec41655 SFYVN 53 2025-07-09 14:15:59.204611 delete part-00001-8421b723-9407-47aa-826e-1c594698e5cc-c000.snappy.parquet 2025-07-28 13:05:55
26c54093-5aae-4bf6-93a8-58912ec41655 SFYVN 53 2025-07-09 14:15:59.204611 delete part-00001-8421b723-9407-47aa-826e-1c594698e5cc-c000.snappy.parquet 2025-07-28 13:05:55更新については 2 つの変更イベントが記録されていることがわかります。update_preimage は操作前のデータを反映し、update_postimage は操作後のデータを反映しています。delete イベントは単一のレコードのみで、どの行が削除されたかを示し、ダウンストリームでもそのようにマークできます。その後、このデータを ClickHouse に挿入できます。前述のメタフィールドと同様に、ClickHouse への挿入時に _change_type、_commit_version、および _commit_type のメタデータを含めます。これらと前節で説明したテーブルの DDL を組み合わせることで、更新が発生した場合でも最新バージョンを特定できるようになります。プログラムのメモリ上やソース側で整合性を取ろうとするとコストが高く低速になる可能性があるため、基本的には ReplacingMergeTree テーブルエンジンに結果整合性のアプローチでテーブルの状態を解決させるのが得策です。
Delta Lake から ClickHouse への CDC 向け Python プロトタイプ
私たちのリファレンス実装では、delta-rs バインディングを使用して Delta Lake から読み取る DeltaLake Python ライブラリを使用しています。大まかな処理として、基盤となるアルゴリズムは指定された範囲内の各バージョン (開始バージョンから継続的なポーリングまで) を反復処理し、バージョンごとにトランザクションログを読み取って、アクションを CDC / 行の追加 / 行の削除の各操作に分類します。ファイルタイプごとに個別の DataFusion 実行プランが作成されます。その後、3 つの操作すべてを結合し、CDF メタデータカラム (_change_type, _commit_version, _commit_timestamp) を含む最終的なスキーマをプロジェクションします。
基盤となるライブラリはバージョンまたはタイムスタンプからの CDF の消費をサポートしていますが、この例ではバージョンのみをサポートすることを選択しました。受信するレコード数は、そのバージョンがコミットされたときに行われた変更の規模によって変動する可能性があります。これを制御するために、CDF レコードを収集して ClickHouse に書き込むのに最適であると判明した約 80,000 件単位でレコードをバッチ処理しています。変更データレコードのバッチサイズがこのサイズ以上になると、データは ClickHouse にフラッシュされます。サンプルのベンチマークとして、このリファレンス CDF リーダー/ライターは、Delta Lake の S3 バケットおよび ClickHouse サービスと同じリージョンにある c5.large AWS EC2 インスタンス (2 vCPU、4 GiB メモリ、10 Gbps ネットワーク帯域幅) 上で、約 80,000 件のレコードを約 1.2 秒で ClickHouse に移行できました。これ以上にインスタンスプロファイルをスケールアップしても、ワークロードのスループットは向上しませんでした。考えられる最適化としては、CDF の読み取りからマテリアライズされたデータ量に基づいて、10,000〜100,000 件のバッチを挿入する複数の ClickHouse ライターを導入することが挙げられます。これは、Delta Lake テーブルへの継続的なデータストリーミングではなく、バッチジョブなどに起因するバースト性のあるワークロードに理想的です。
$ python main.py
 -p "s3://path/to/deltalake/table"
 -r "us-east-2"
 -t "default.my_cdc_table"
 -H "[service].us-east-2.aws.clickhouse.cloud"
 -v 28000
-b 800002025-07-23 10:56:54,143 - INFO - Using provided AWS credentials
2025-07-23 10:56:54,625 - INFO - Starting continuous processing from version 28000
2025-07-23 10:56:55,064 - INFO - Processing changes from version 28000 to 28252
2025-07-23 10:57:02,185 - INFO - Processed batch 1: 81920 rows (total: 81920) in 1.55 seconds
2025-07-23 10:57:03,411 - INFO - Processed batch 2: 83616 rows (total: 165536) in 1.23 seconds
2025-07-23 10:57:04,535 - INFO - Processed batch 3: 83616 rows (total: 249152) in 1.12 seconds
2025-07-23 10:57:05,651 - INFO - Processed batch 4: 81920 rows (total: 331072) in 1.12 seconds
2025-07-23 10:57:06,754 - INFO - Processed batch 5: 81920 rows (total: 412992) in 1.10 seconds
...スナップショットの取得
データレイクにおける変更のキャプチャは、技術的に大きな挑戦です。これまで CDF が有効化されていなかったテーブルにおいて、スナップショット取得前のデータをバックフィルするには特別な配慮が必要です。テーブル作成時に CDF が有効化されていた場合、Delta テーブルのバージョン 0 から消費できるため、技術的にはスナップショットは不要です。ただし、テーブルのバージョン数が多い場合、これは最適ではない可能性があります。Delta Lake は 100 コミットごとに Delta テーブルの集計状態としてチェックポイントを書き込むため、CDF が有効化されていたとしてもバージョン 0 から読み取るのではなく、特定のバージョンでクエリを実行することでより効率的なバックフィルを行えます。テーブルに対する操作が INSERT のみでない場合、バックフィルでデータスキッピングを活用できます。データレイクも併用している ClickHouse ユーザーはテラバイトやペタバイト規模のテーブルサイズを持つ傾向があり、一度に移動するには膨大なデータ量になります。これは、以下のクエリを使用して ClickHouse により非同期で移行できます:
CREATE TABLE my_delta_table
   ENGINE = DeltaLakeCluster('"s3://path/to/deltalake/table"');

INSERT INTO
 `default`.`my_cdc_table`
SELECT
 *, 'snapshot', 0, now()
FROM
 `default`.`my_delta_table``
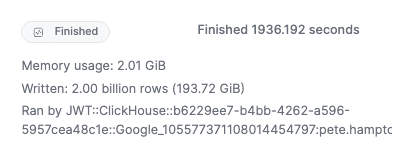
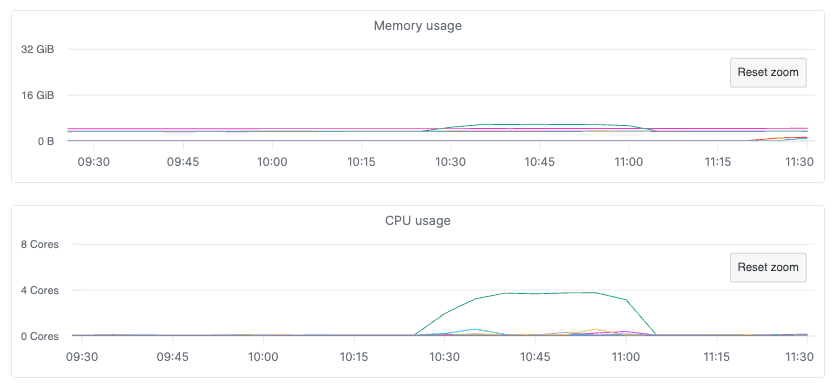
LIMIT 2000000000;この INSERT INTO SELECT クエリは、テーブルのメタデータカラムに「snapshot」、0、now() という値を設定し、データが取り込まれて ClickHouse がバックグラウンドマージを実行する際に ReplacingMergeTree がアップストリームの正しい状態を解決できるようにします。参考までに、このサンプルクエリでは、Delta Lake テーブルと ClickHouse サービスが同一リージョンにある構成において、オートスケーリングを無効化した ClickHouse Cloud サービスへ Delta Lake テーブルから 20 億行を移行しました。メモリ使用量は 700 MB から 2 GB の間で一定に保たれました。この優れたパフォーマンスは、データレイクのテーブル関数やテーブルエンジンを支えるオブジェクトストレージエンジンが、並列化とプリフェッチを活用していることによって実現されています。このスナップショットは 1,936 秒 (約 32 分) で完了します。
このクエリが ClickHouse クラスターのリソース使用率に与えた影響はごくわずかでした。クエリで使用するスレッド数を増やすことで、スループットをさらに調整できます。
さらなる利点として、オブジェクトストレージを基盤としている場合、これらの読み取りによって Delta Lake テーブルに負荷がかからない点が挙げられます。これは、データベースサーバーのクラッシュなどの悪影響を防ぐためにソースデータベースに細心の注意を払わなければならない、他の CDC ClickPipes とは対照的です。以下のクエリを使用して、ClickHouse に書き込まれたデータを確認できます。
SELECT
   hostName(),
   database,
   table,
   sum(rows) AS rows,
   formatReadableSize(sum(bytes_on_disk)) AS total_bytes_on_disk,
   formatReadableSize(sum(data_compressed_bytes)) AS total_data_compressed_bytes,
   formatReadableSize(sum(data_uncompressed_bytes)) AS total_data_uncompressed_bytes,
round(sum(data_compressed_bytes) / sum(data_uncompressed_bytes), 3) AS compression_ratio
FROM system.parts
WHERE database != 'system'
GROUP BY
   hostName(),
   database,
   table
ORDER BY sum(bytes_on_disk) DESC FORMAT VerticalhostName(): c-creamaws-by-66-server-pzltzls-0
database: default
table: new_cdc_table
rows: 2000000000 -- 2.00 billion
total_bytes_on_disk: 45.44 GiB
total_data_compressed_bytes: 45.43 GiB
total_data_uncompressed_bytes: 141.56 GiB
compression_ratio: 0.321スナップショットのパフォーマンスを向上させるもう 1 つの方法は、(データが何らかの形で適切にパーティショニングされていると仮定して) それぞれがパーティショングループを対象とする INSERT INTO SELECT クエリを複数並列で実行することです。パーティショニングされていない場合、スナップショットプロセスはパーティションキーとして機能する適切なカラムを推論する必要があります。これにはバッチの追跡が必要になりますが、CPU とメモリの使用量増加と引き換えに、大幅なパフォーマンス向上が得られます。
このアプローチを前述の CDF リーダーと組み合わせることで得られる注目すべき利点は、理論上両者を同時に実行できる点です。最初に初期ロード (選択されている場合) を実行してからデータベース固有の CDC ログを消費する従来の RDBMS CDC ClickPipes とは異なり、CDC ログのバージョンはスナップショットよりも高いため、Delta Lake のプロセスは同時に実行しても最終的に正しい状態に収束します。RDBMS の CDC ClickPipes では、スナップショットからの初期ロードと CDC を並列に実行することは容易ではなく、実装が困難です。たとえば MySQL では、スナップショットやレプリケーションスロットが提供されません。つまり、スナップショットと binlog を並列で読み取った場合、イベントが時系列順に同期される保証がありません。現在、すべての CDC ClickPipes では、1 つのテーブルを再同期する必要がある場合、通常そのスナップショットが完了するまで全 CDC 操作が停止します。Delta Lake CDC ではテーブルの再同期が他のテーブルの CDF 消費に影響を与えないため、このような事態にはならず、複数テーブルにまたがる CDF 消費のスループットが向上します。
リファレンス実装の制限事項
このリファレンス実装はプロダクショングレードの ClickPipe に向けた前段階のものであり、いくつかの重要な制限事項があります。本番環境ですぐに使用できる状態ではありません。既存のオーケストレーションや処理ツール (Spark や Airflow など) に拡張・統合して、本番環境で利用可能な Delta Lake から ClickHouse へのレプリケーション / CDC を構築するための基盤を提供するものです。
耐障害性
現在、CDC プロセスを開始する際は、ユーザーがバージョンを指定する必要があります。何らかの理由でスクリプトが失敗して停止した場合、ユーザーは処理済みの最後のバージョンを記録し、スクリプトを再起動するか最初から実行し直さなければなりません。オフセットの追跡は、すべての CDC ClickPipes における重要な機能です。これは大規模なスナップショットでも同様であり、さまざまな理由でクエリが完了しない可能性があるためです。
更新と削除
更新および削除操作を伴う CDC ワークロードには ReplacingMergeTree テーブルを使用します。基本的にこれらの DML 操作は INSERT 操作として処理されます。これにより、前述のようにテーブルの状態が結果整合性を持つようになります。
ClickHouse は、大半の列指向ストアと同様に、もともと高速な行レベルの更新向けには設計されていませんでした。しかし、2025年6月以降、ClickHouse v25.7 は高パフォーマンスな SQL 標準の UPDATE をサポートしています。
ReplacingMergeTree はすでにすべての ClickPipe CDC コネクタで使用されており、本番環境で長年にわたり信頼性と高いパフォーマンスが実証されています。そのため、今回もこのパターンを採用し続けています。
スキーマの進化 (Schema Evolution)
テーブルの初期状態のスナップショット作成では、この時点でのスキーマが固定されているため問題になることはほぼありません。一方、Delta Lake CDF はプロトコルレベルで DDL 変更イベントが表現されないため、スキーマ変更の処理において制限があります。カラム名の変更、削除、データ型の変更など、非加法的なスキーマ変更が発生すると、CDF の消費が完全に機能しなくなる可能性があります。このため、ユーザーはスキーマの進化スケジュールを慎重に管理するか、そうでなければ CDC プロセスを停止してテーブル状態を再同期しなければなりません。そのアプローチの 1 つがカタログサポートの利用です。今回のスクリプトでは IAM 認証情報のみをサポートしていますが、ユーザーの環境に合わせるには多様な認証プロトコルをサポートする必要があることを認識しています。Amazon Glue カタログ、OpenMetadata、Hive Metastore、Unity Catalog など、複数のカタログへの対応が必要になる可能性があります。
削除のサポート
削除のサポートは CDC パイプラインにおける重要な機能です。Delta Lake テーブルの ACID 特性により削除はすでに反映済みと見なされるため、スナップショット (該当する場合) においては問題になりません。現在のプロトタイプでは、チェンジログ内の削除を無視しています。他の CDC ClickPipes と同様に、行を削除済みとしてマークし、主キーとメタデータフィールドを保持したまま、その他の全行フィールドに ClickHouse の型のデフォルト値を設定する論理削除 (Soft Delete) をサポートする予定です。パフォーマンス上の理由から、トゥームストーンレコードに null 値を使用することは圧縮に影響を与える可能性があるため推奨しません。
今後の改善予定
ご覧のとおり、このようなプロトタイプを構築することで、Delta テーブルを扱う際における ClickHouse の既存の制限事項がいくつか浮き彫りになります。以下のように書くだけで済めば非常に便利です。
SELECT * FROM table_changes(‘default.my_delta_table’, 5, 10);これだけでバージョン 5 から 10 の間に変更されたデータが取得できます。あるいは、ClickHouse が Iceberg でサポートしているように、特定のスナップショットをクエリできるのも便利です。
SELECT * FROM deltaLakeCluster(‘s3://path/to/deltalake/table’) SETTINGS snapshot_version=5;ClickHouse のデータレイク連携に関する多くの改善と同様に、CDC の利便性を向上させるこれら 2 つの機能 (#73704 および #85070) も近日中に ClickHouse へ追加される予定です。
まとめ
Delta Lake をソースとした ClickHouse への CDC パイプラインを構築することで、リアルタイム分析アプリケーションを設計するための強力なソリューションが実現します。両テクノロジーの強みを活かし、アーキテクチャのコンポーネントと実装の詳細を慎重に検討することで、信頼性と拡張性に優れたデータレプリケーションソリューションを構築できます。これにより、最新データに基づいたより迅速なインサイト獲得と的確な意思決定が可能になります。
なお、ClickPipes ではすでに、Postgres、MySQL、MongoDB からの変更データキャプチャに対応したエンタープライズグレードのコネクタを提供しているほか、オブジェクトストレージやストリーミングソースに対する堅牢な取り込みサポートも用意されています。
私たちは今後数か月以内に、ClickPipes で Delta Lake CDC のプロダクショングレードのサポートを追加する予定です。デザインパートナーとしての協力にご関心のある方は、clickpipes@clickhouse.com までメールでお問い合わせください。