5万

インタラクティブなスプレッドシートのように応答する、1,000 億行のクエリを想像してみてください。
ClickHouse Cloud では、複雑な GROUP BY を含む単一のクエリであっても、数千ものコアへ自動的にスケールできるようになりました。
私たちはこの機能を parallel replicas と呼んでいますが、名前そのものよりもその効果こそが重要です。
事前集約もデータのリシャッフルもなしに、1,000 億行を 0.5 秒未満で集計します。
ノードを追加して実行するだけです。
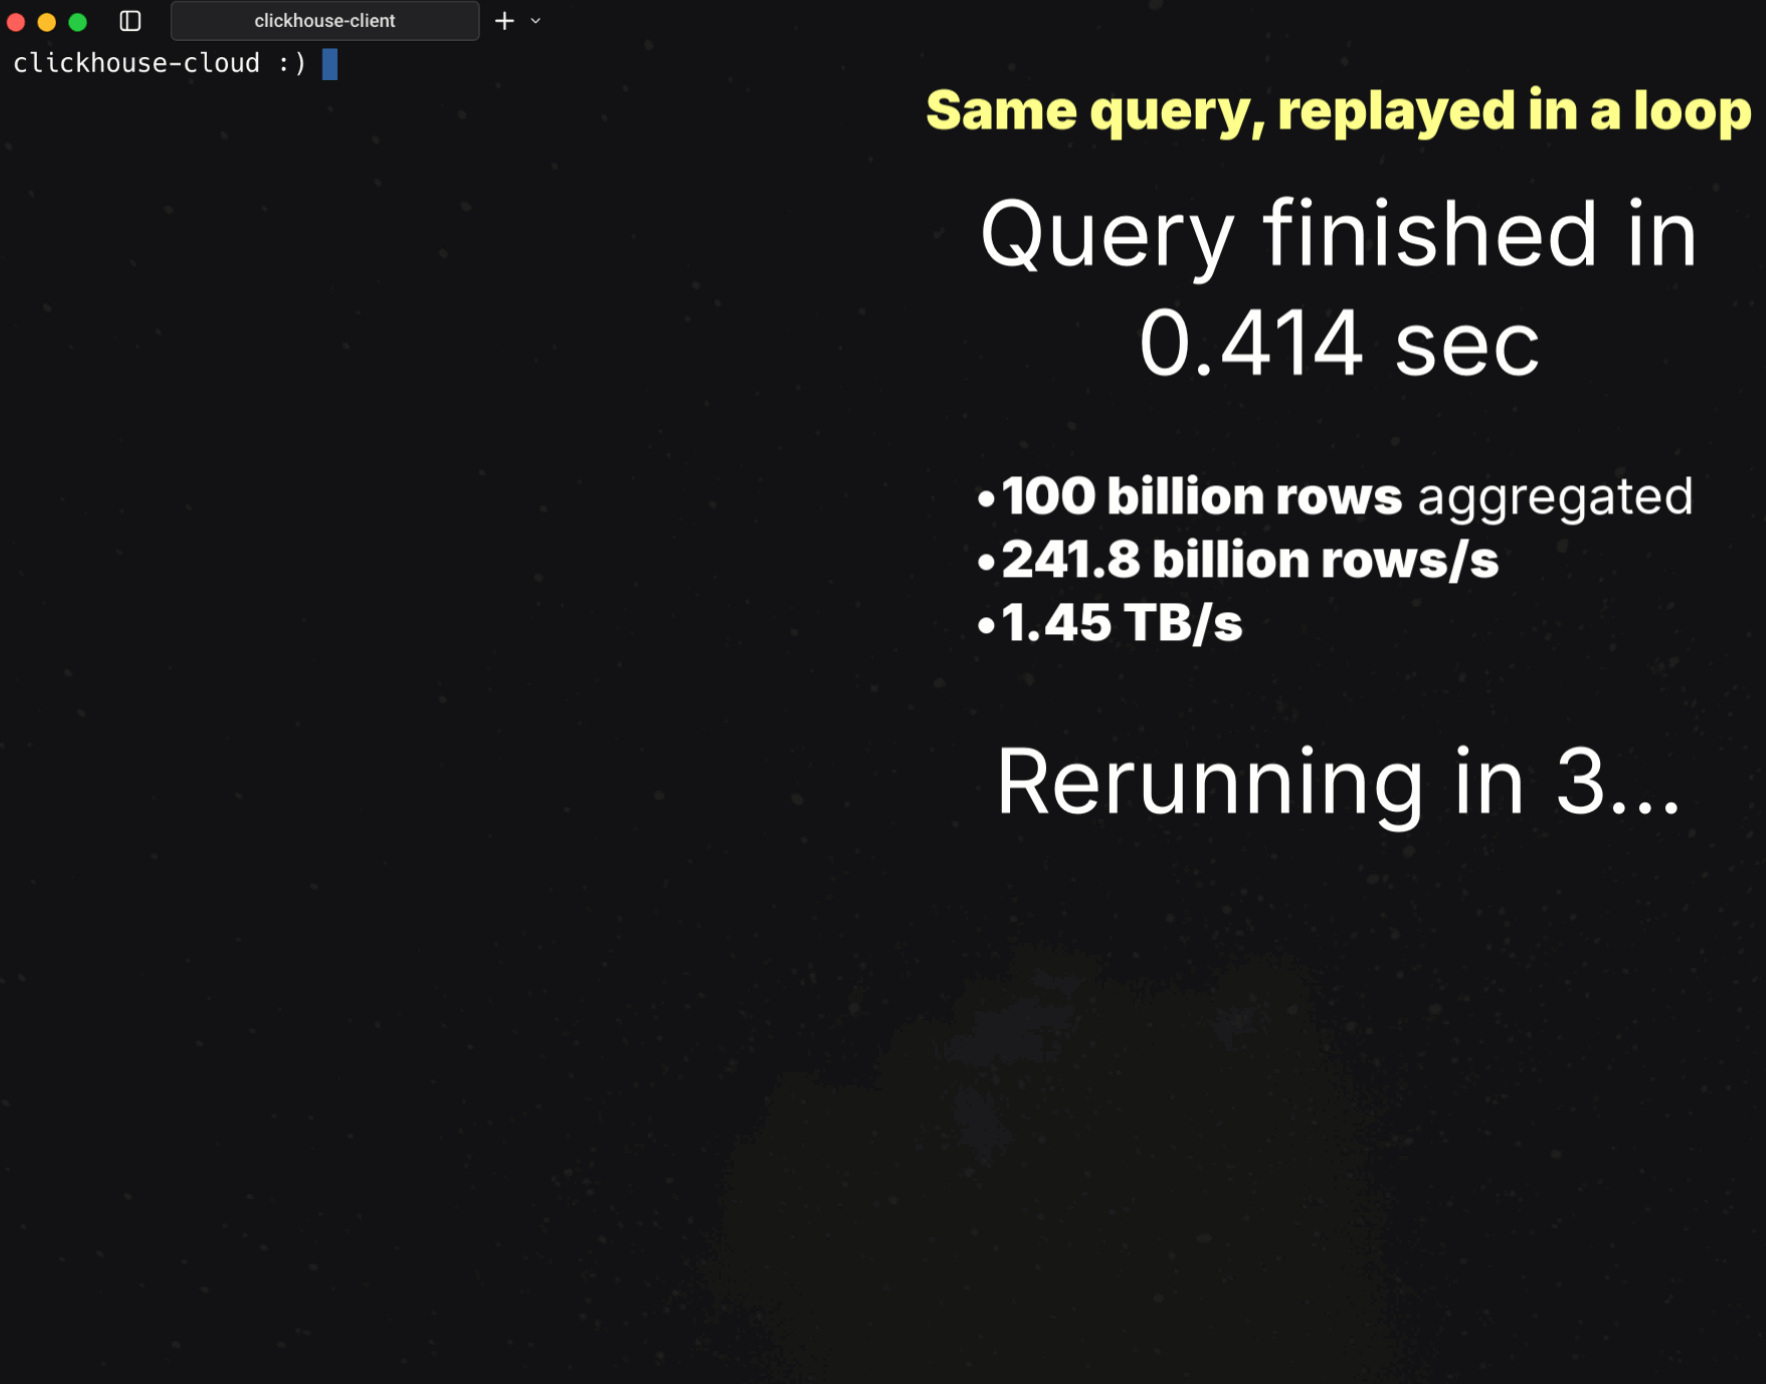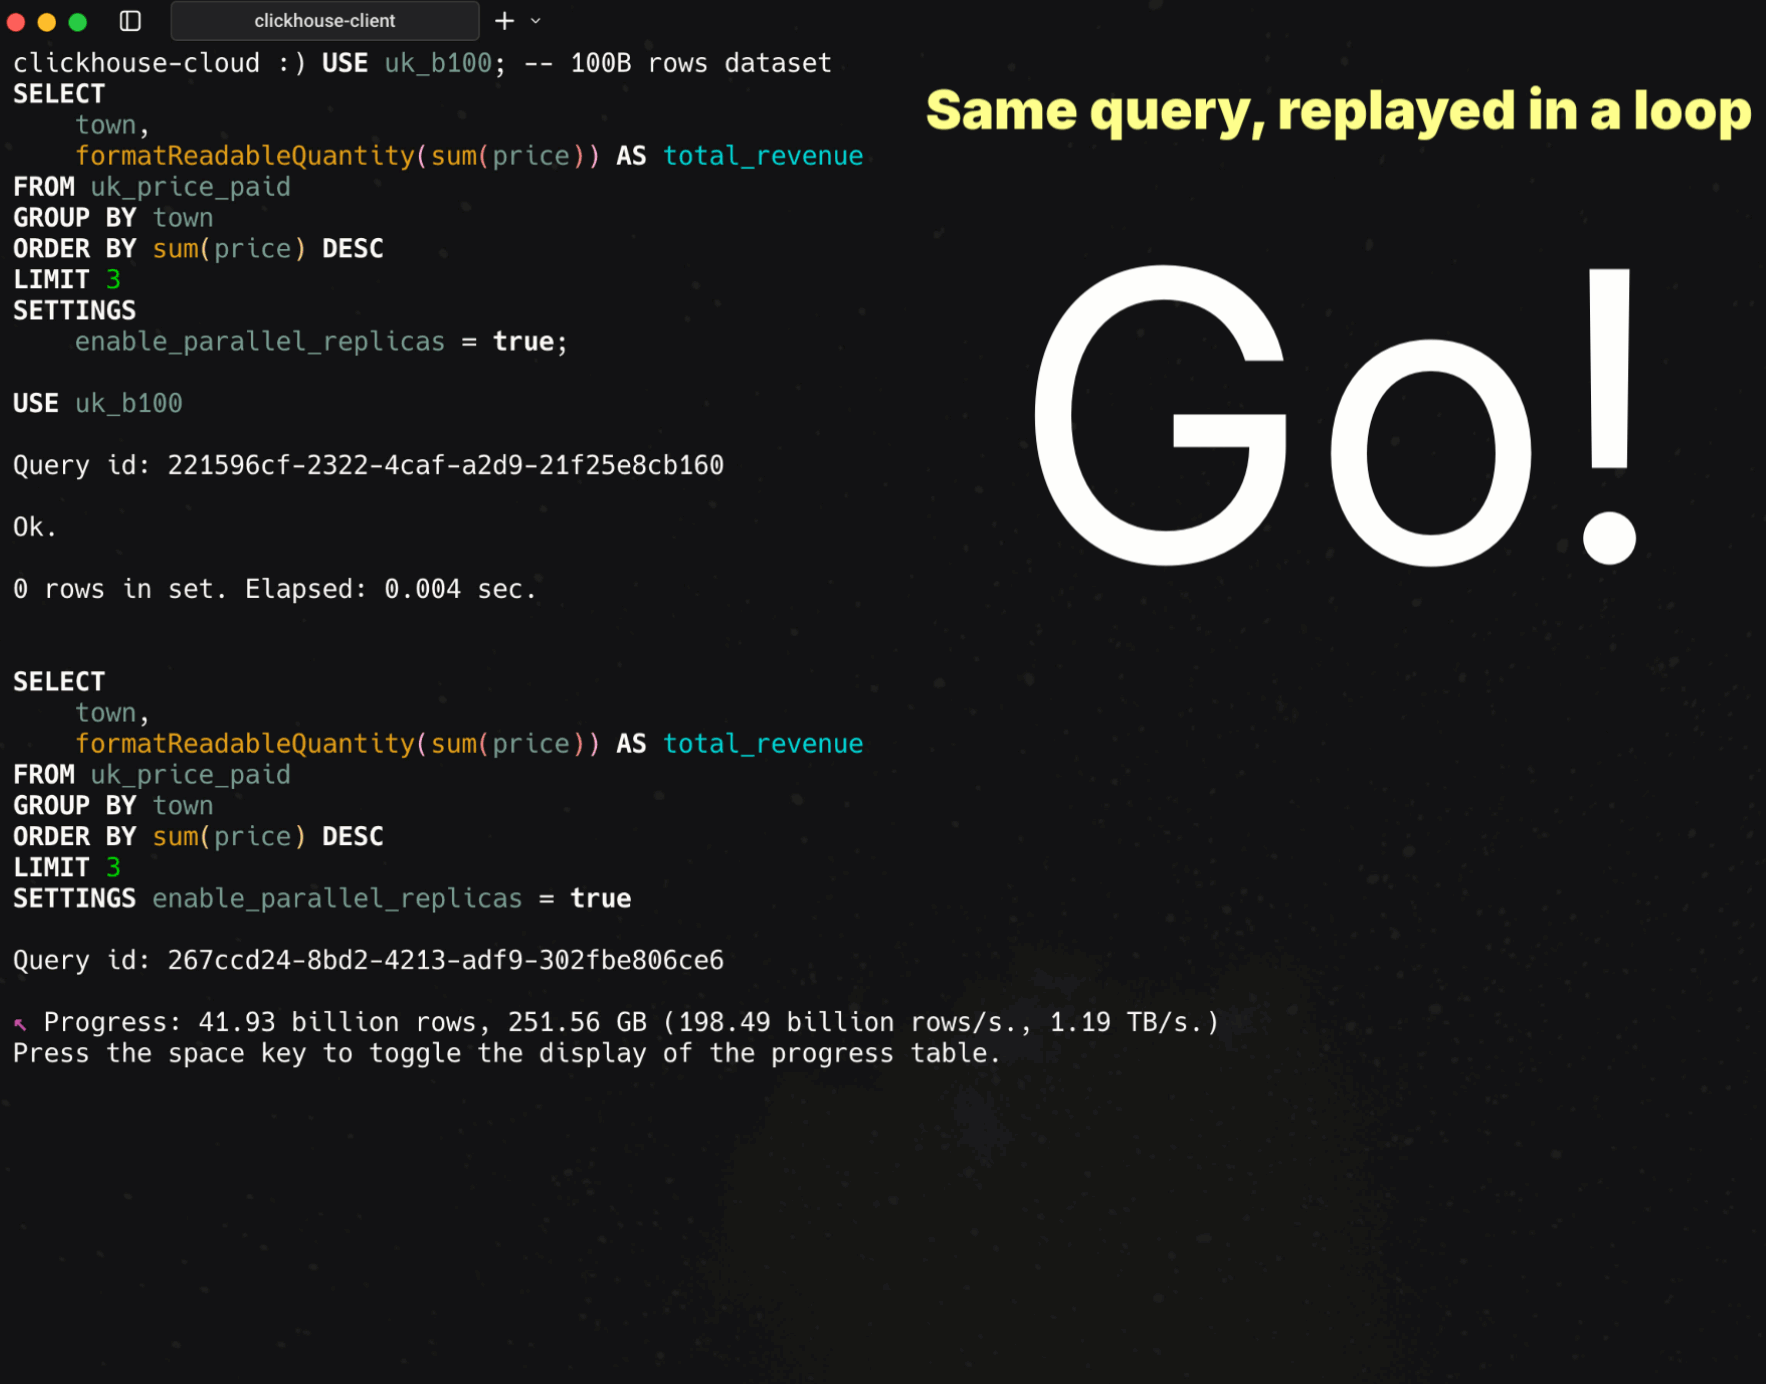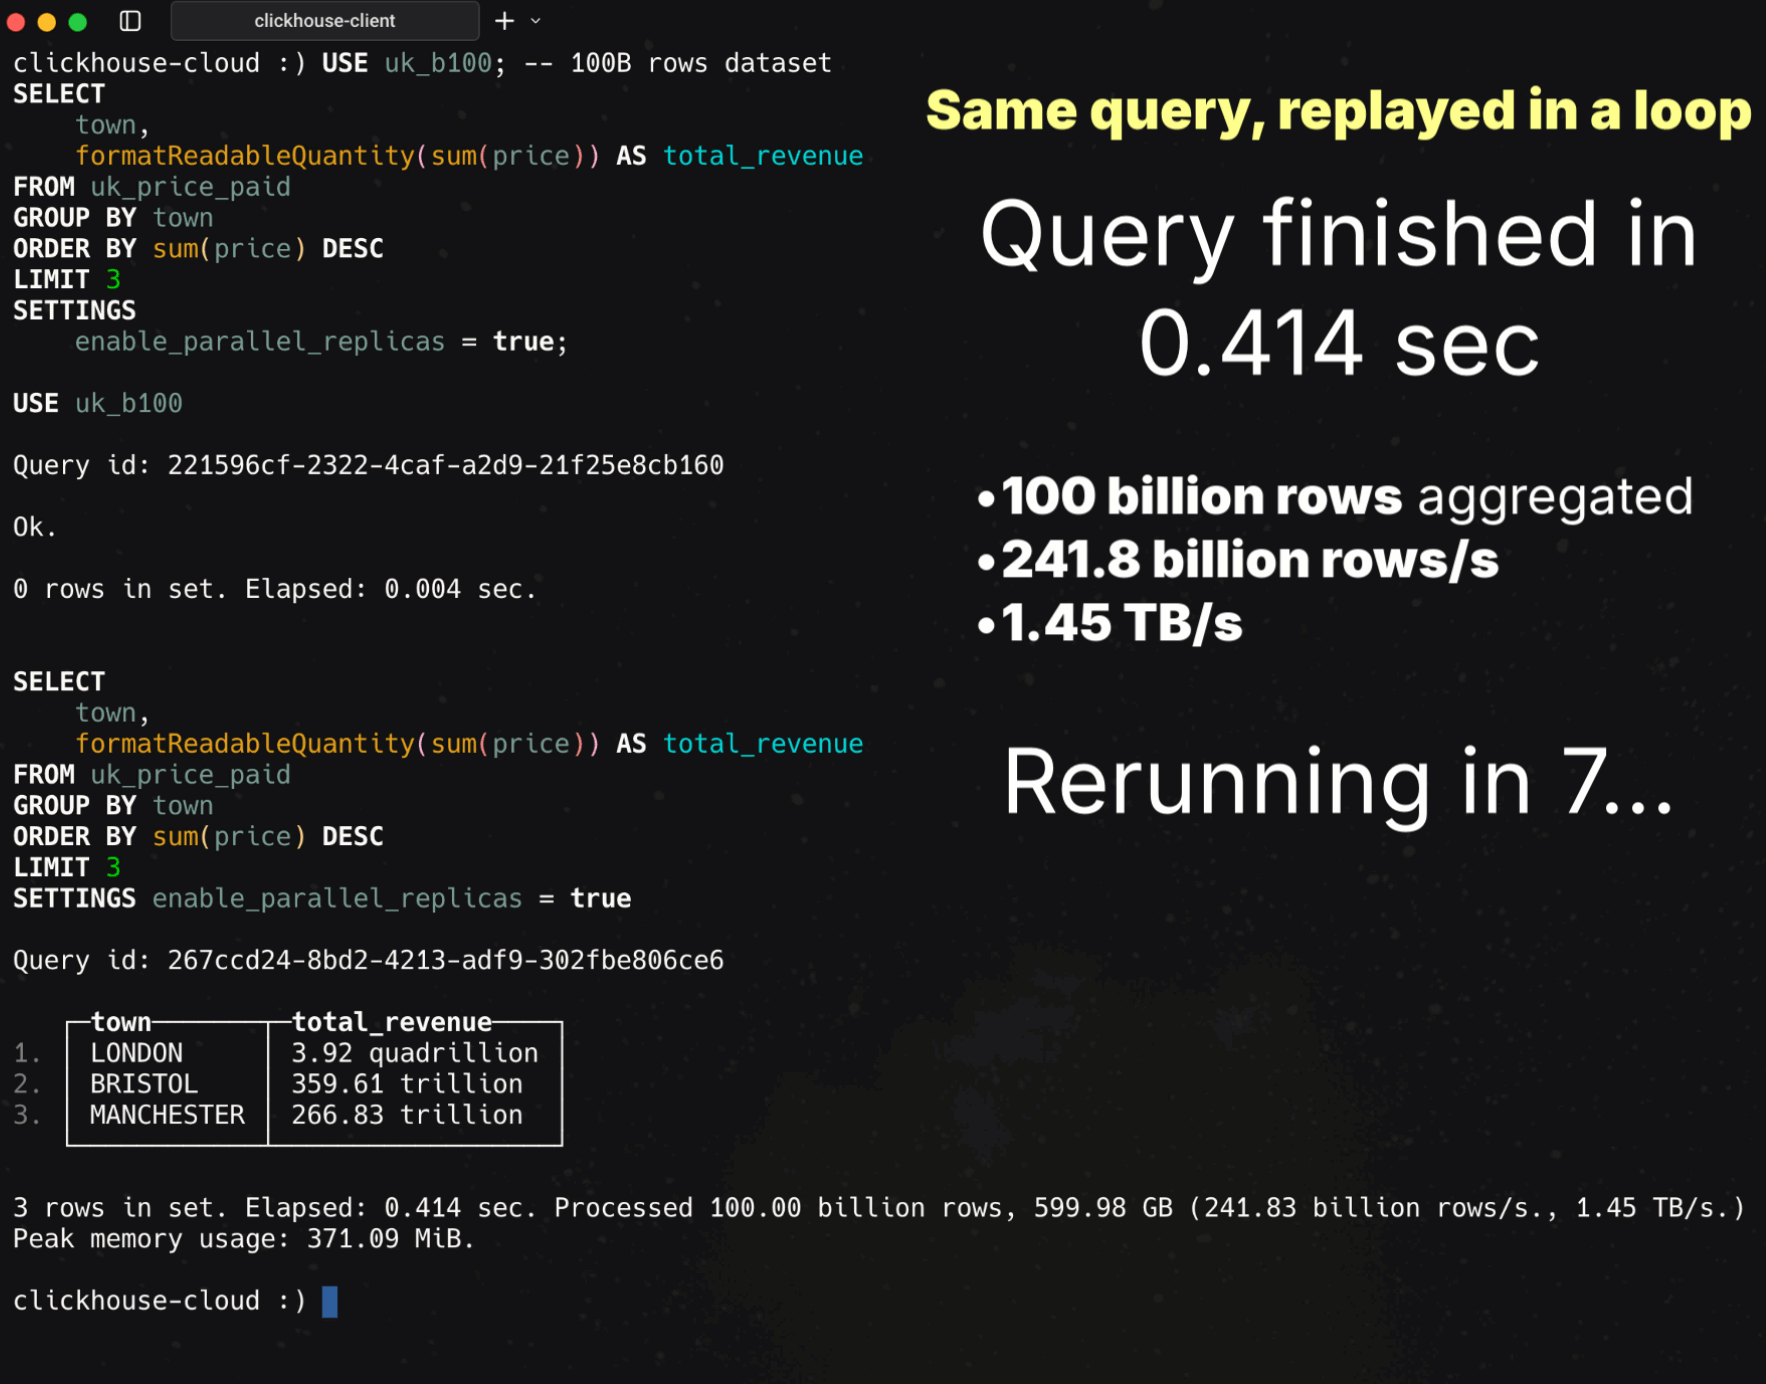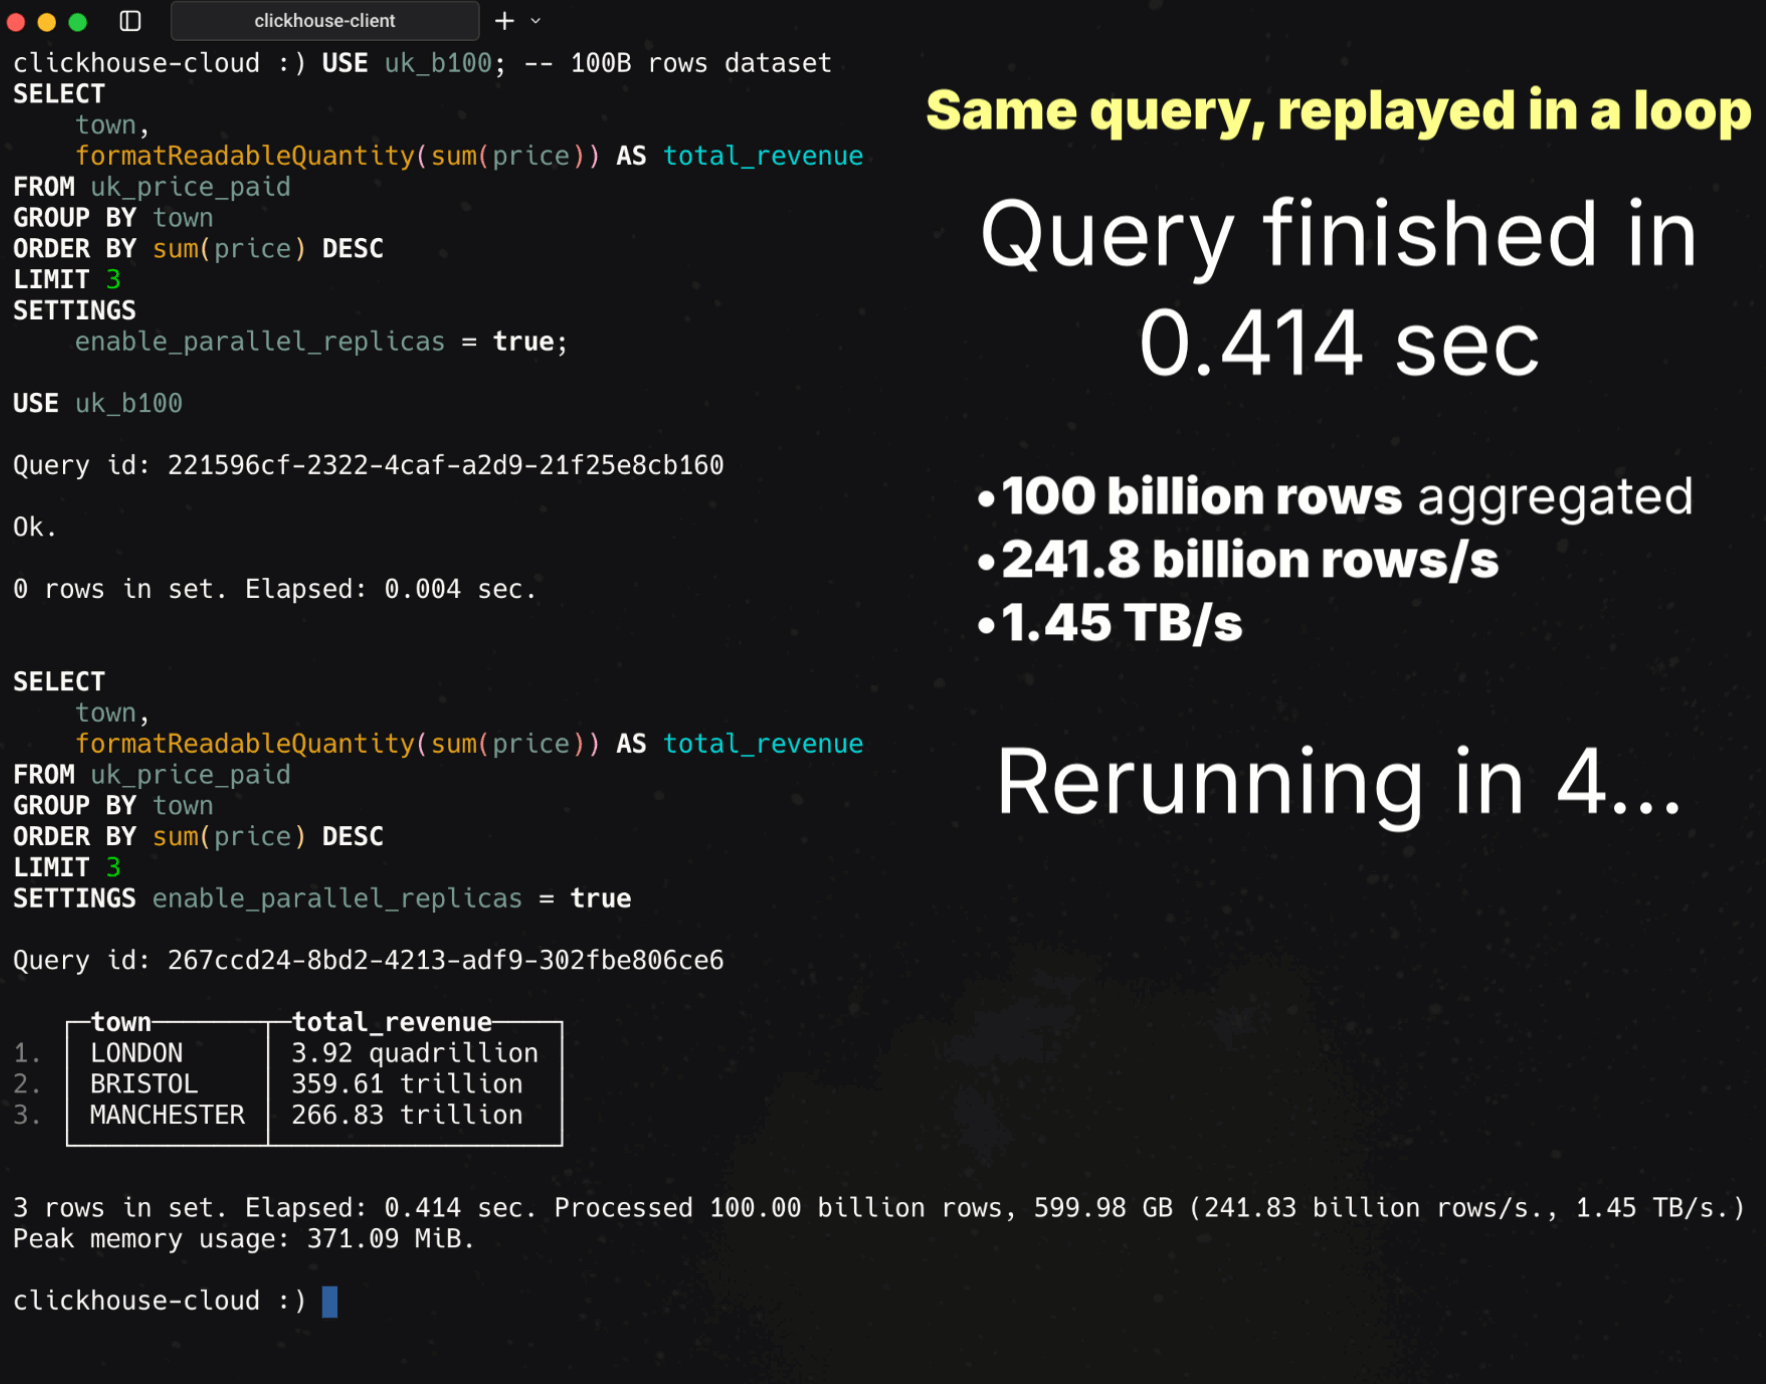
注: 同じクエリをループで継続的に再実行しています。初回の実行はあまりに速く終わるため目にとまらないほどです。速度を視覚的に確認できるよう、アニメーションではクエリを繰り返し実行しています。
-
実行時間: 0.414 秒
-
処理行数: 1,000 億行
-
スループット: 毎秒 2,418 億行 (1.45 TB/s)
クエリの無限の水平スケーリング
このデモは小細工ではありません。私たちが長年追い求めてきたクエリの無限の水平スケーリングを解き放つ、ClickHouse Cloud の新機能 parallel replicas によって実現されています。
クラウドでのクエリのスケーリングは、ダイヤルを回すかのような感覚で行えます。ノードを追加すれば、より高速な結果が得られます。
これは実質的に、データの移動を一切伴わないオンデマンドの仮想シャーディングです。
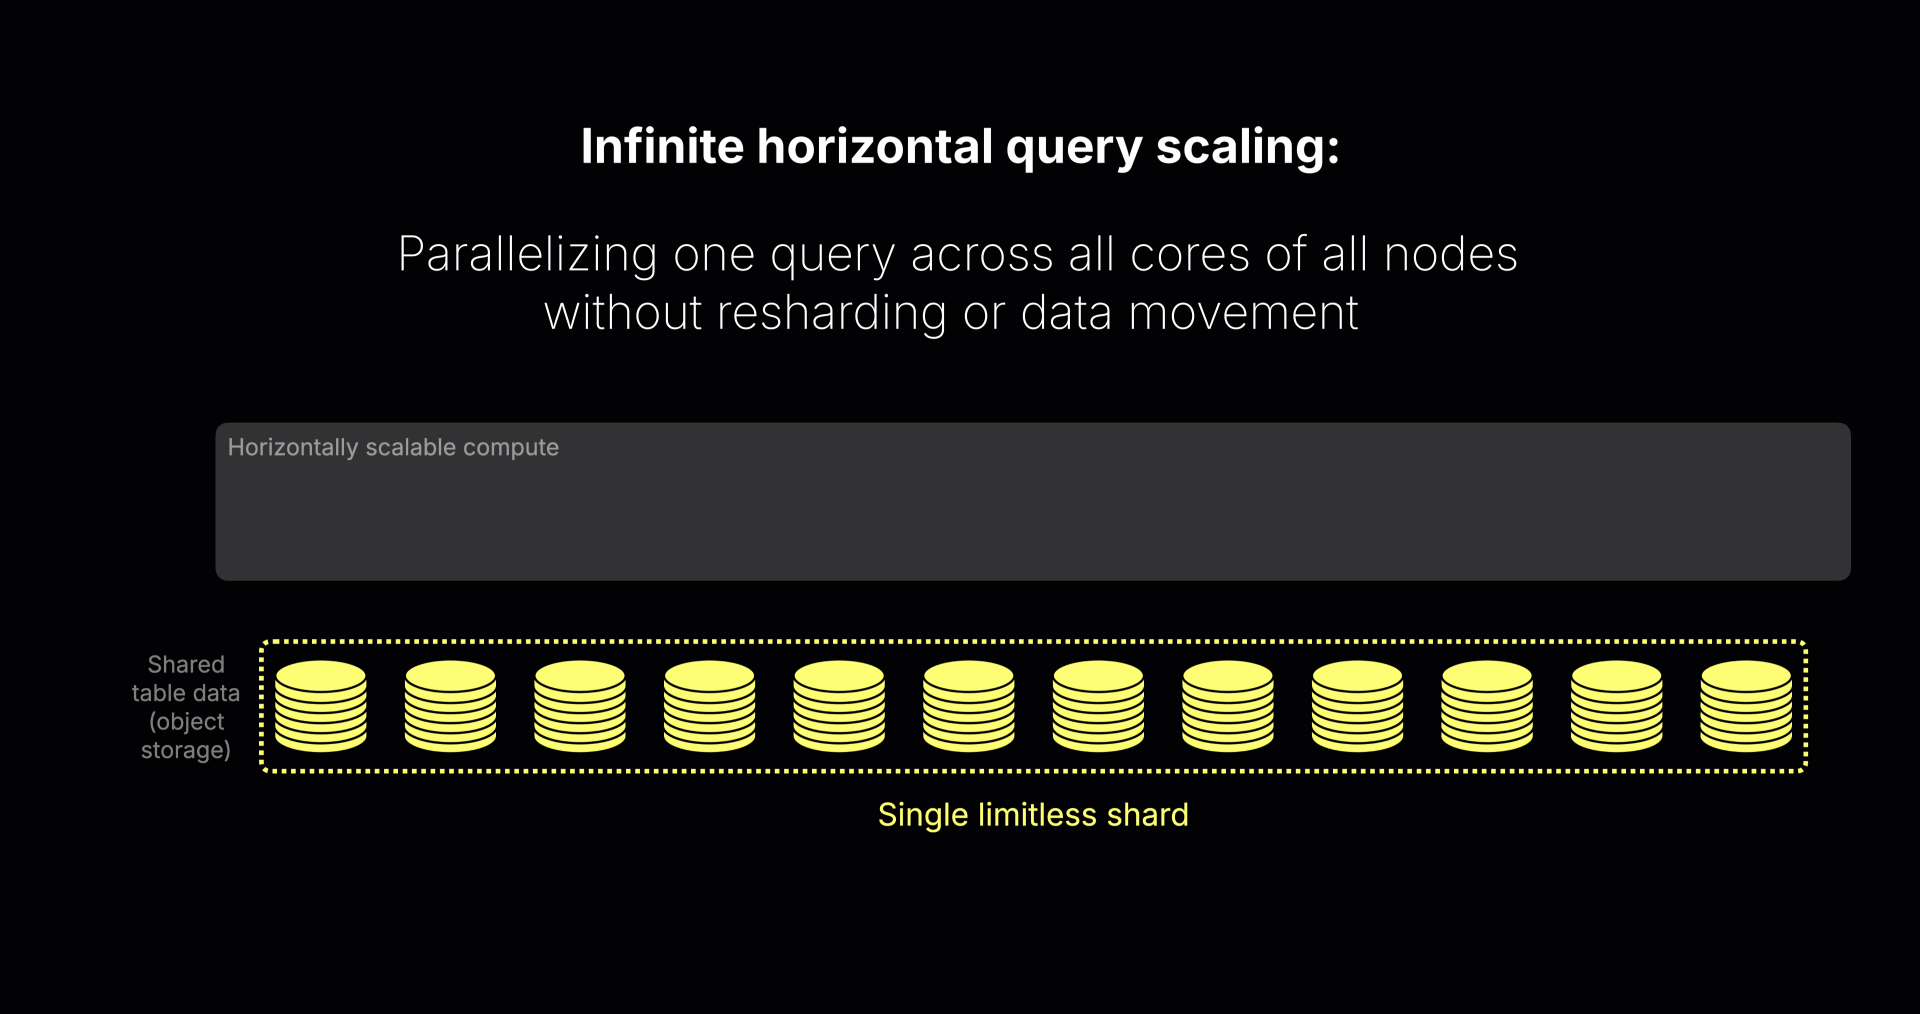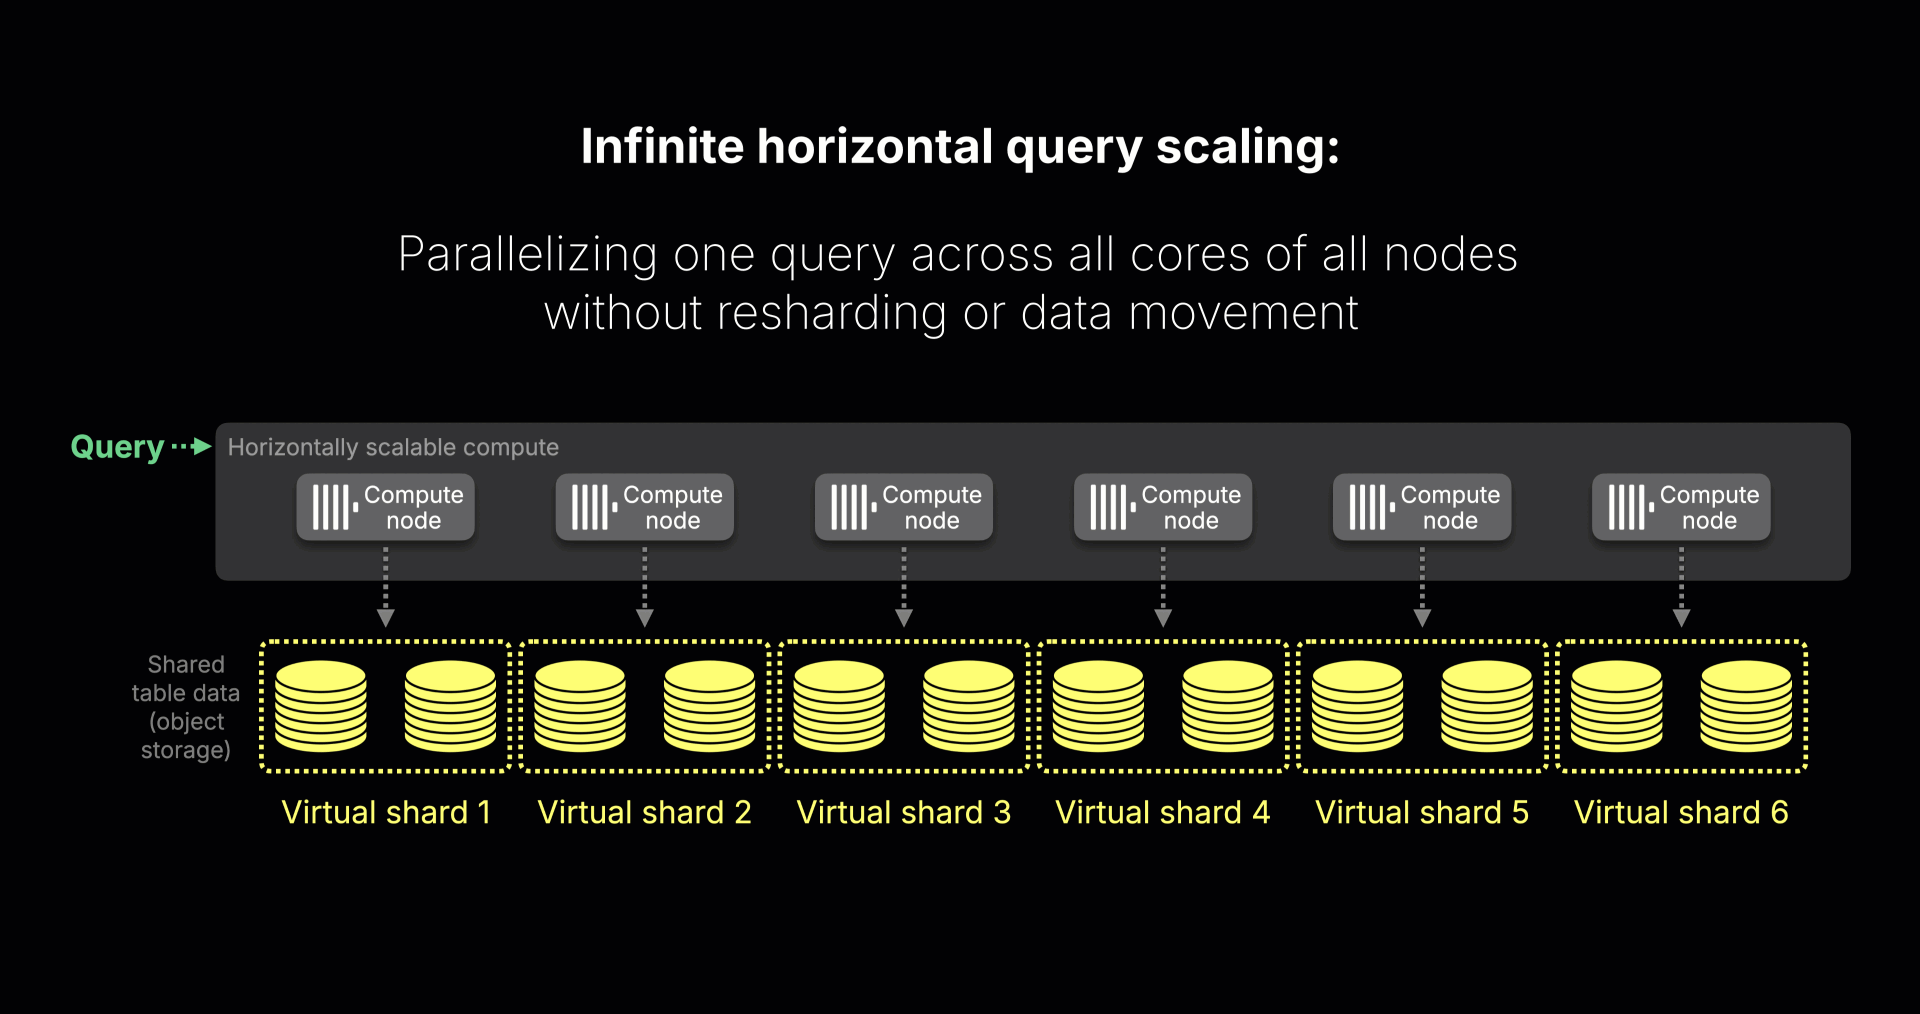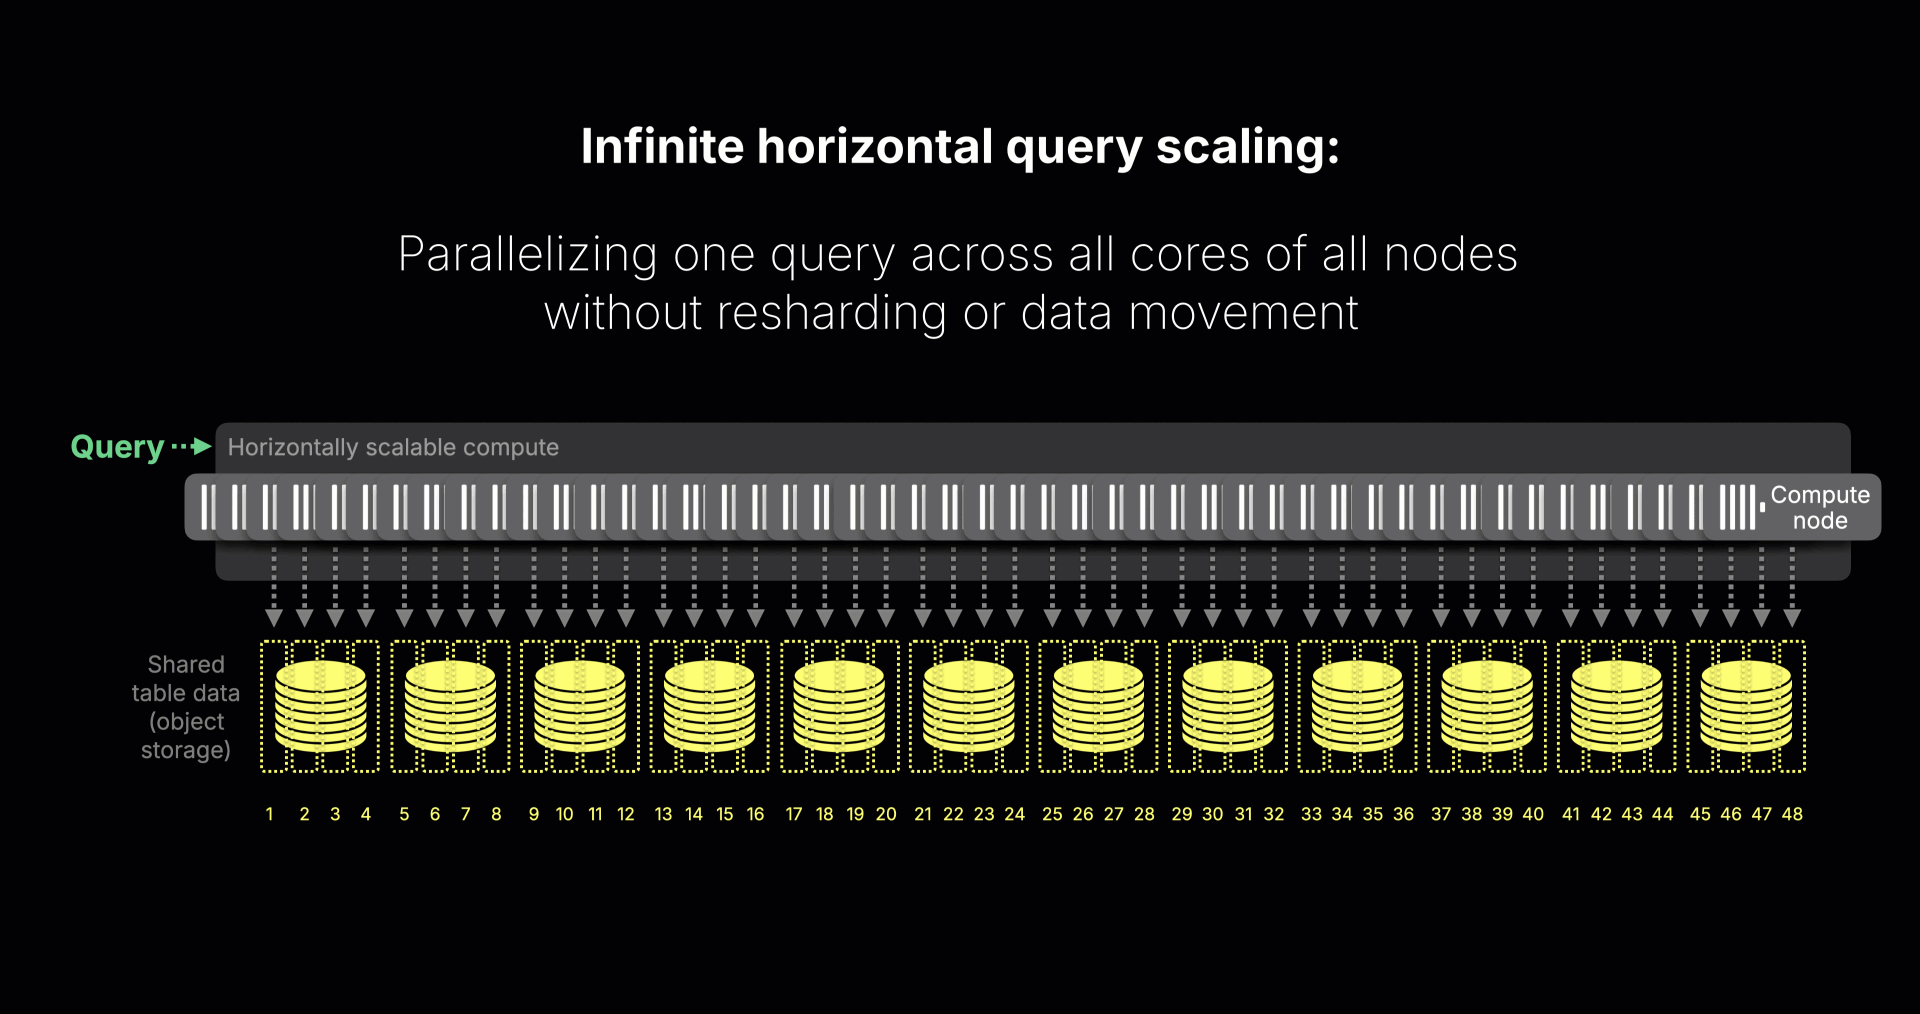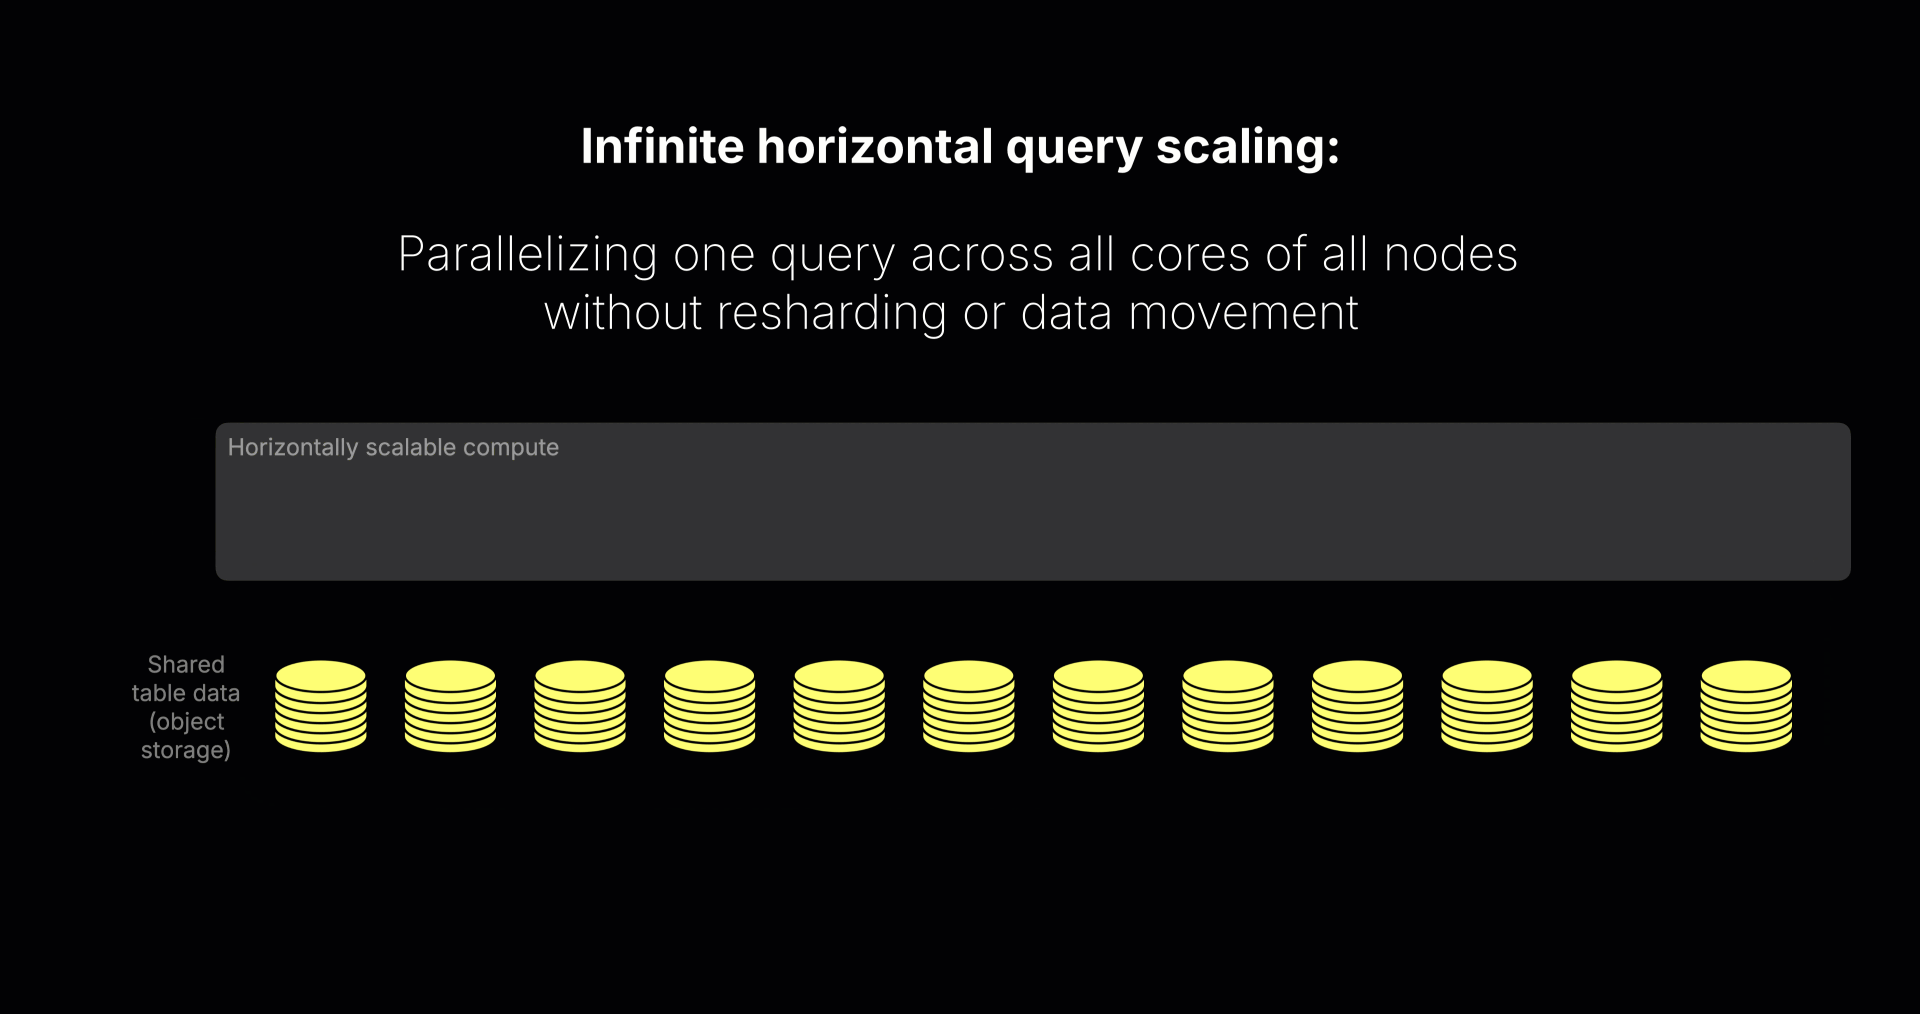
現在 Cloud でベータ版 (まもなく一般提供 (GA)) として提供されているこの OSS 機能により、ClickHouse は 90 コアの単一マシンも、9,000 コアを備えた 100 台のマシンもまったく同様に扱えるようになります。
単一のクエリが 1 台のコンピュートノードに縛られることはなくなり、クラスター内の全ノードの全コアにまたがって実行できるようになります。
これは次のことを意味します。
-
弾力性 — ノードを追加すると、クエリが即座に高速化します。
-
シンプルさ — データのリシャッフルは不要で、設定を有効にするだけです。
-
大規模環境でのインタラクティブな速度 — 1,000 億行以上を 1 秒未満で処理します。
Spark や、BigQuery、Snowflake といったクラシックなクラウドデータウェアハウスをご利用の方には、大規模並列処理 (MPP) をより軽量にしたものとして馴染み深く感じられるはずです。
現時点では、parallel replicas を GROUP BY のパフォーマンスにおける新たなベンチマークとして捉えてみてください。 分析速度を決定づけるこの処理は、割り当てられたコア数に応じて線形にスケールするようになりました。
なぜ GROUP BY が分析の心臓部なのか
極めて洗練されたシステムの中には、1 つの役割を例外的なまでに完璧にこなすものがあります。万年筆は紙に優雅にインクを落とすために存在します。grep のような Unix ツールは 1 つの仕事を完璧に遂行します。ClickHouse もまったく同じ理念から始まりました。何よりも高速に GROUP BY を実行することです。
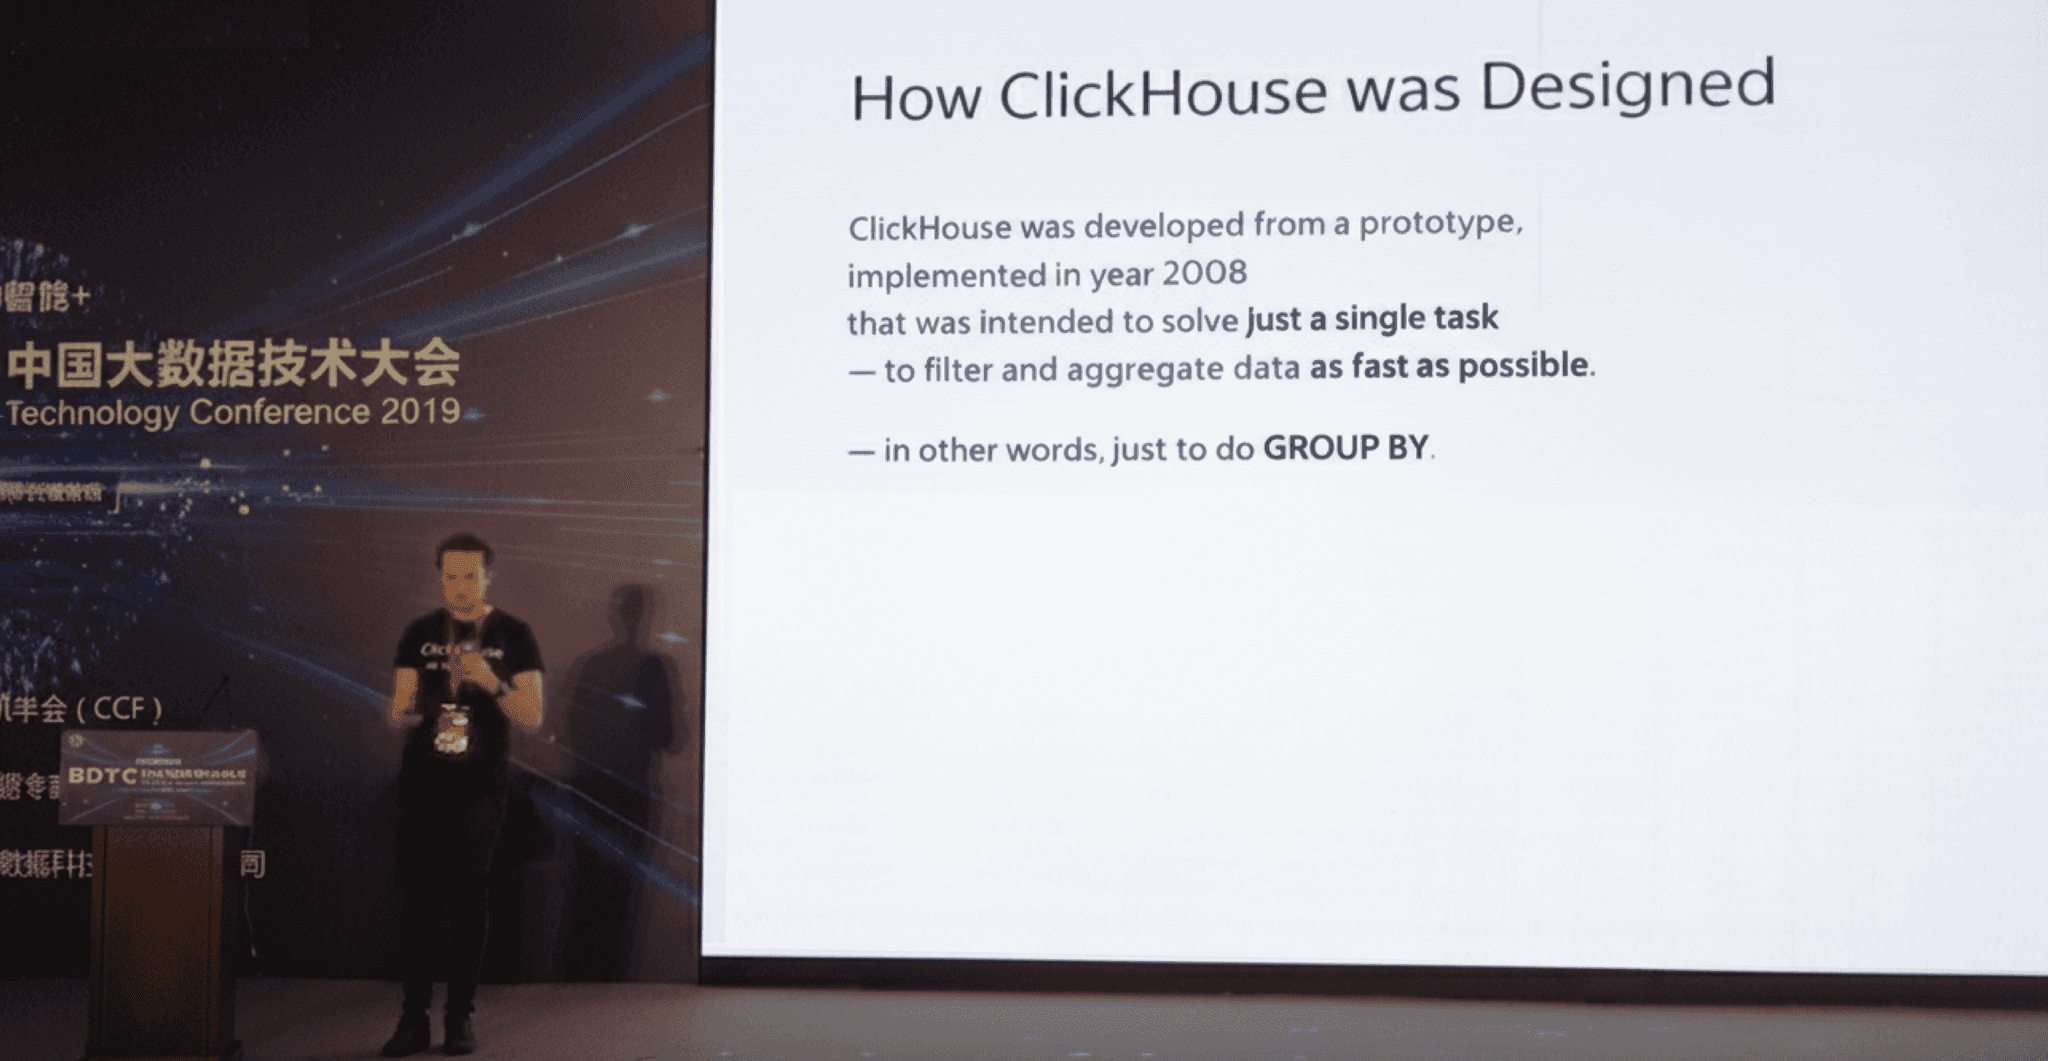
「可能な限り高速にデータをフィルタリングして集計するという、たった 1 つの課題を解決することを目的としていました。言い換えれば、単に GROUP BY を実行するためです。」— ClickHouse の生みの親、Alexey Milovidov、BDTC 2019 にて
数百万行や数十億行に対する集計を実行したとき、何かエラーが起きたのではないかと思うほど一瞬で完了する様子を想像してみてください。それは私が初めて ClickHouse に触れたときの衝撃でもありました。「何かおかしいのでは? こんなに速いわけがない。本当に?」
GROUP BY はほぼあらゆる分析クエリの中核に位置しており、オブザーバビリティのダッシュボードを支え、自然言語を SQL に変換する会話速度の AI を加速し、エージェント向け分析など、多岐にわたる用途を支えています。GROUP BY を高速化できれば、ほぼすべての分析ワークロードが高速化します。
実際の BI ワークロードを対象とした最近の VLDB 2025 の調査によると、クエリの半数以上に GROUP BY が含まれており、分析におけるその中心的な役割が浮き彫りになっています。
ClickHouse はそのために作られました。しかし、ワークロードが増大しクエリが複雑になるにつれて、期待値も高まりました。データ量が爆発的に増加し、クラスターが数百ノードに及ぶようになっても、エンジンは GROUP BY の高速性を維持し続けなければなりませんでした。
本記事では、この課題にどのように取り組んでいるかを解説します。まず手短なデモを行い、続いて GROUP BY を単一コアから数千コアへとクリーンにスケールさせる実行モデルを詳しく見ていきます。
ClickHouse のスピードで GROUP BY を実行する
パフォーマンスの話は、ミリ秒やグラフの数値の中に埋もれてしまいがちです。代わりに、高速であるとはどういうことなのかを「体感」してみましょう。単一ノード上の数百万行からフリート全体に分散された数千億行まで、桁違いに大きくなっていくデータセットに対して同じ GROUP BY を実行します。
まずは小さく始める: 数百万行の重要性
4 年前に ClickHouse で初めて集計を実行したとき、目にも留まらぬ速さで数百万行が処理されたため、何か障害でも起きたのではないかと思いました。
実際のワークロードにおいて数百万行は今でも重要です。そこで、まずは英国の不動産価格データセット (英国政府によって継続的に更新されており、2025年8月時点で約 3,000 万行) を使ったシンプルな集計から始めましょう。このクエリは町ごとの販売額を合計し、上位 3 件を返します。
USE uk_base; -- ~30M rows

SELECT
    town,
    formatReadableQuantity(sum(price)) AS total_revenue
FROM uk_price_paid
GROUP BY town
ORDER BY sum(price) DESC
LIMIT 3
SETTINGS
enable_parallel_replicas = false;単一ノード (89 コア) での 3,000 万行
ClickHouse Cloud に対し、parallel replicas を無効化した状態 (enable_parallel_replicas = 0) で clickhouse-client 経由で実行しました。
注: これは同じクエリをループで継続的に再実行したものです。初回の実行はあまりに速く終わるため目にとまらないほどです。速度を視覚的に確認できるよう、アニメーションでは同じクエリを繰り返し実行しています。
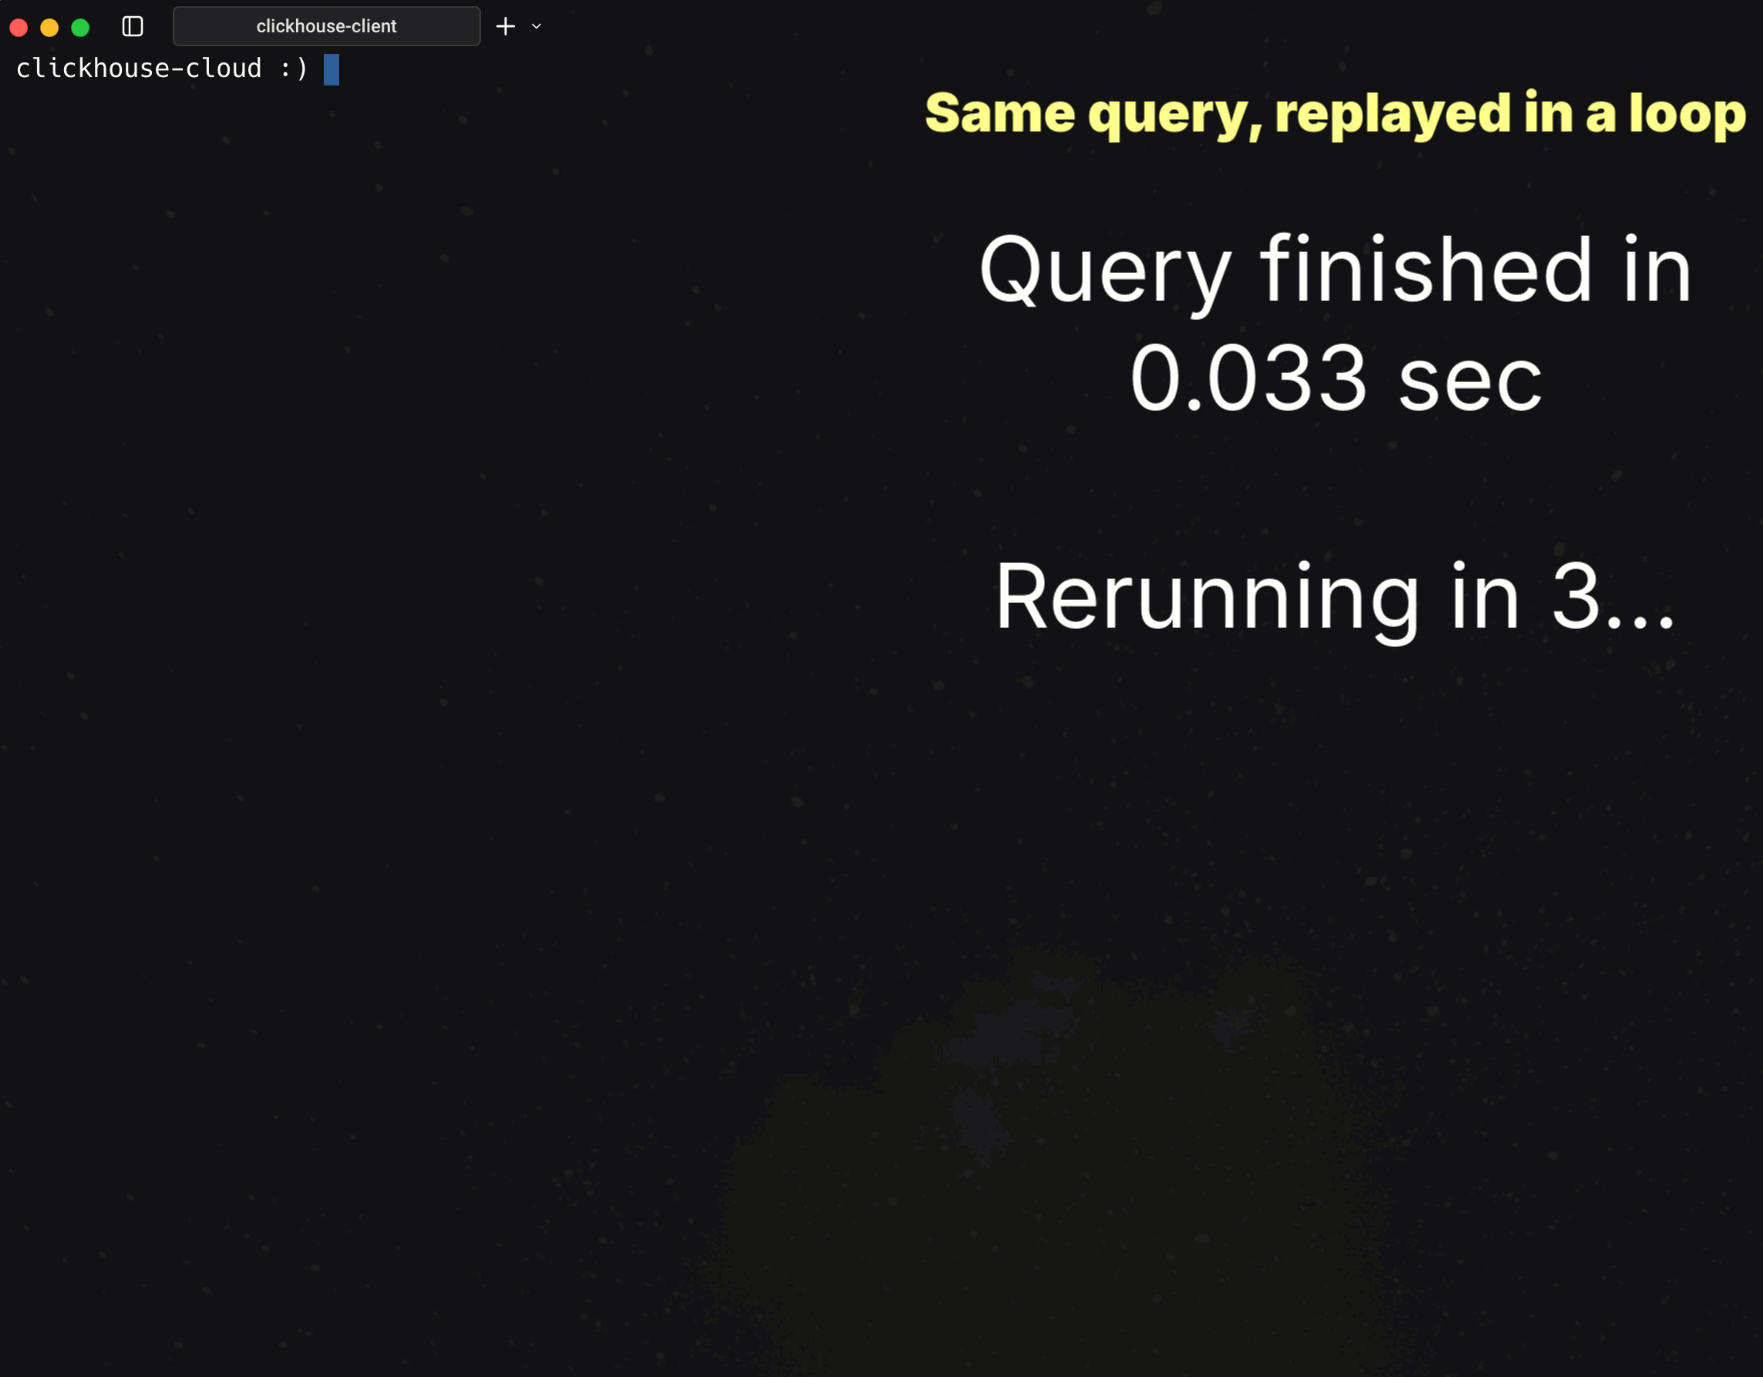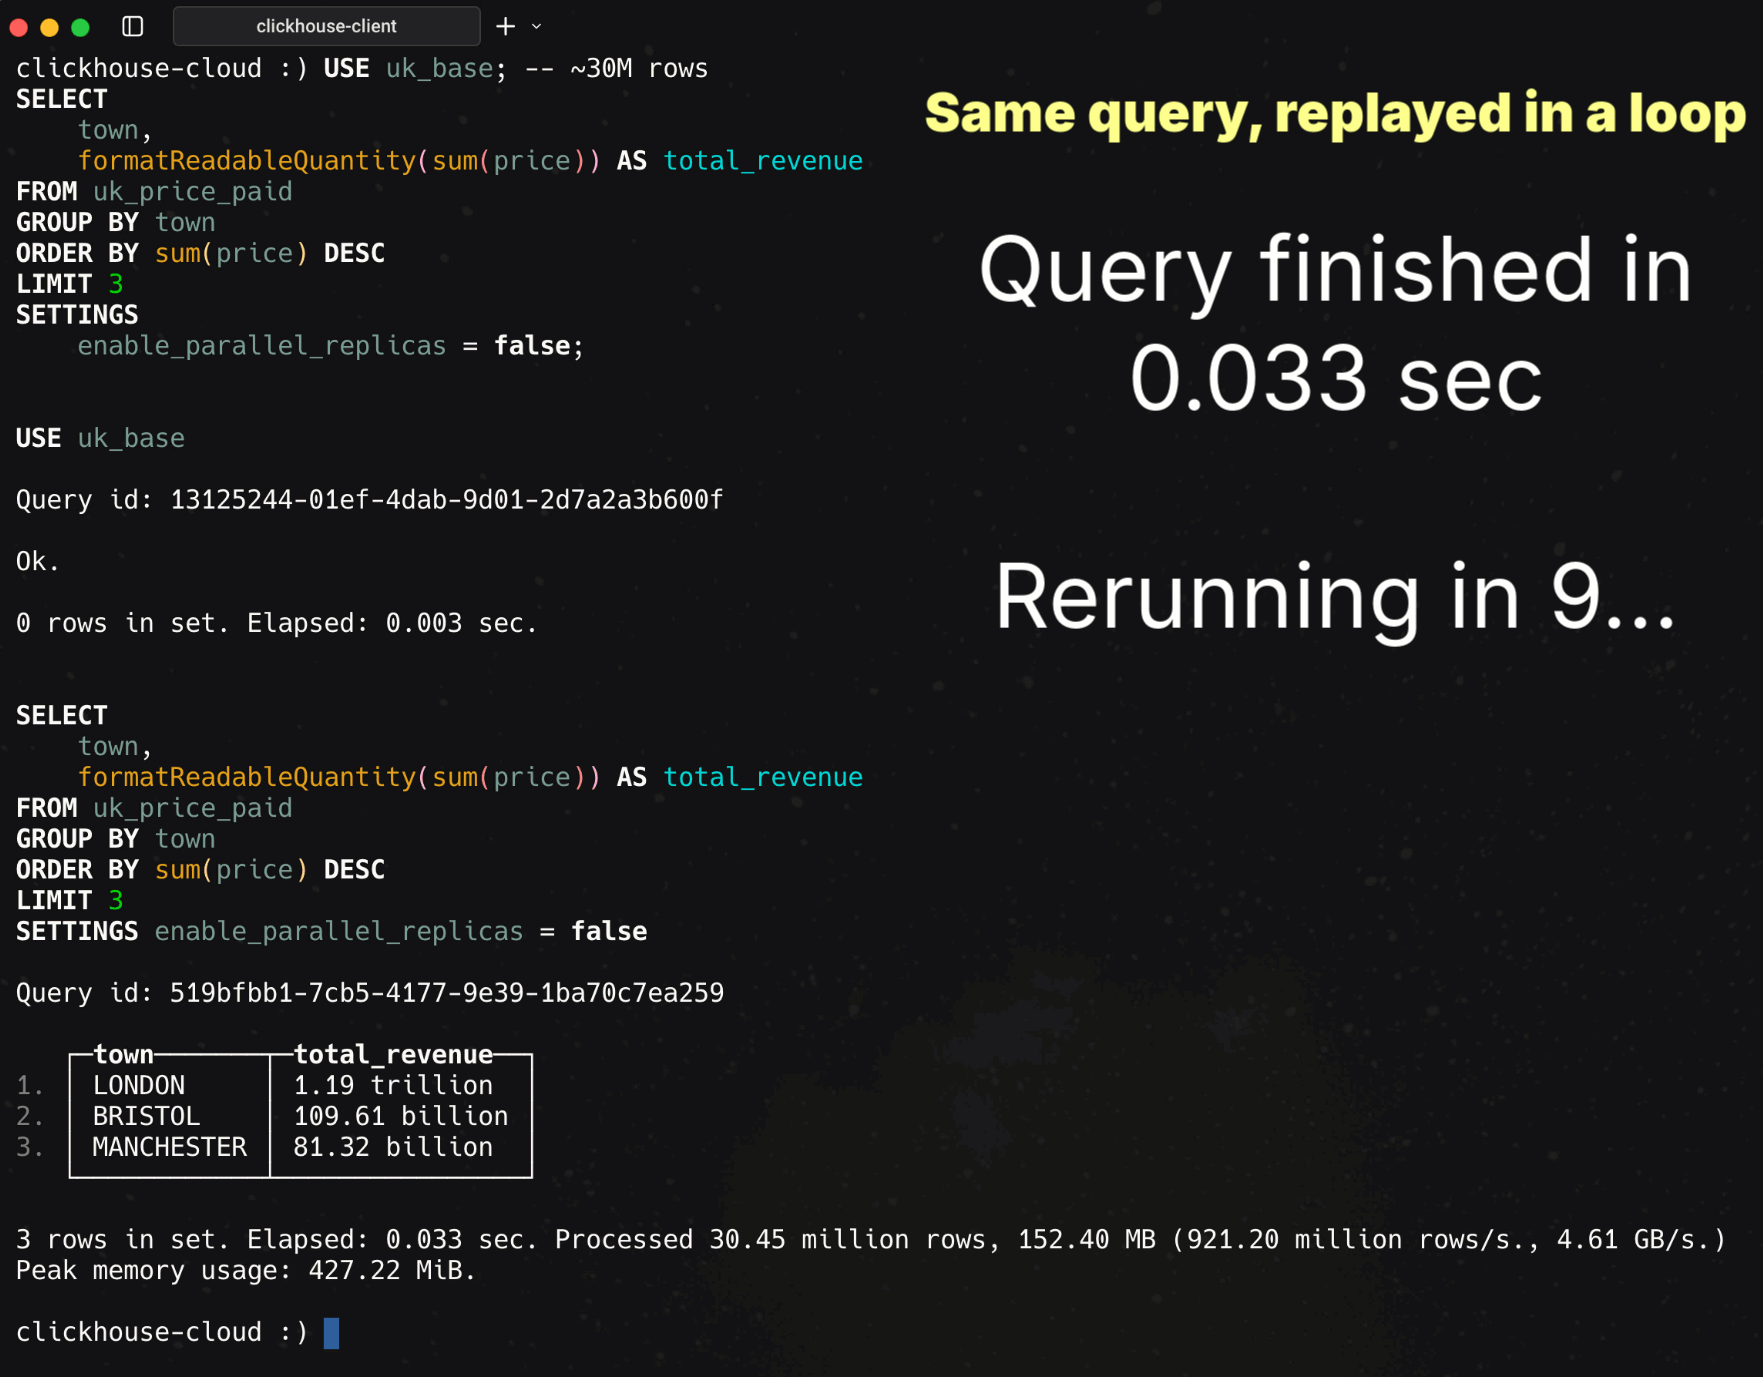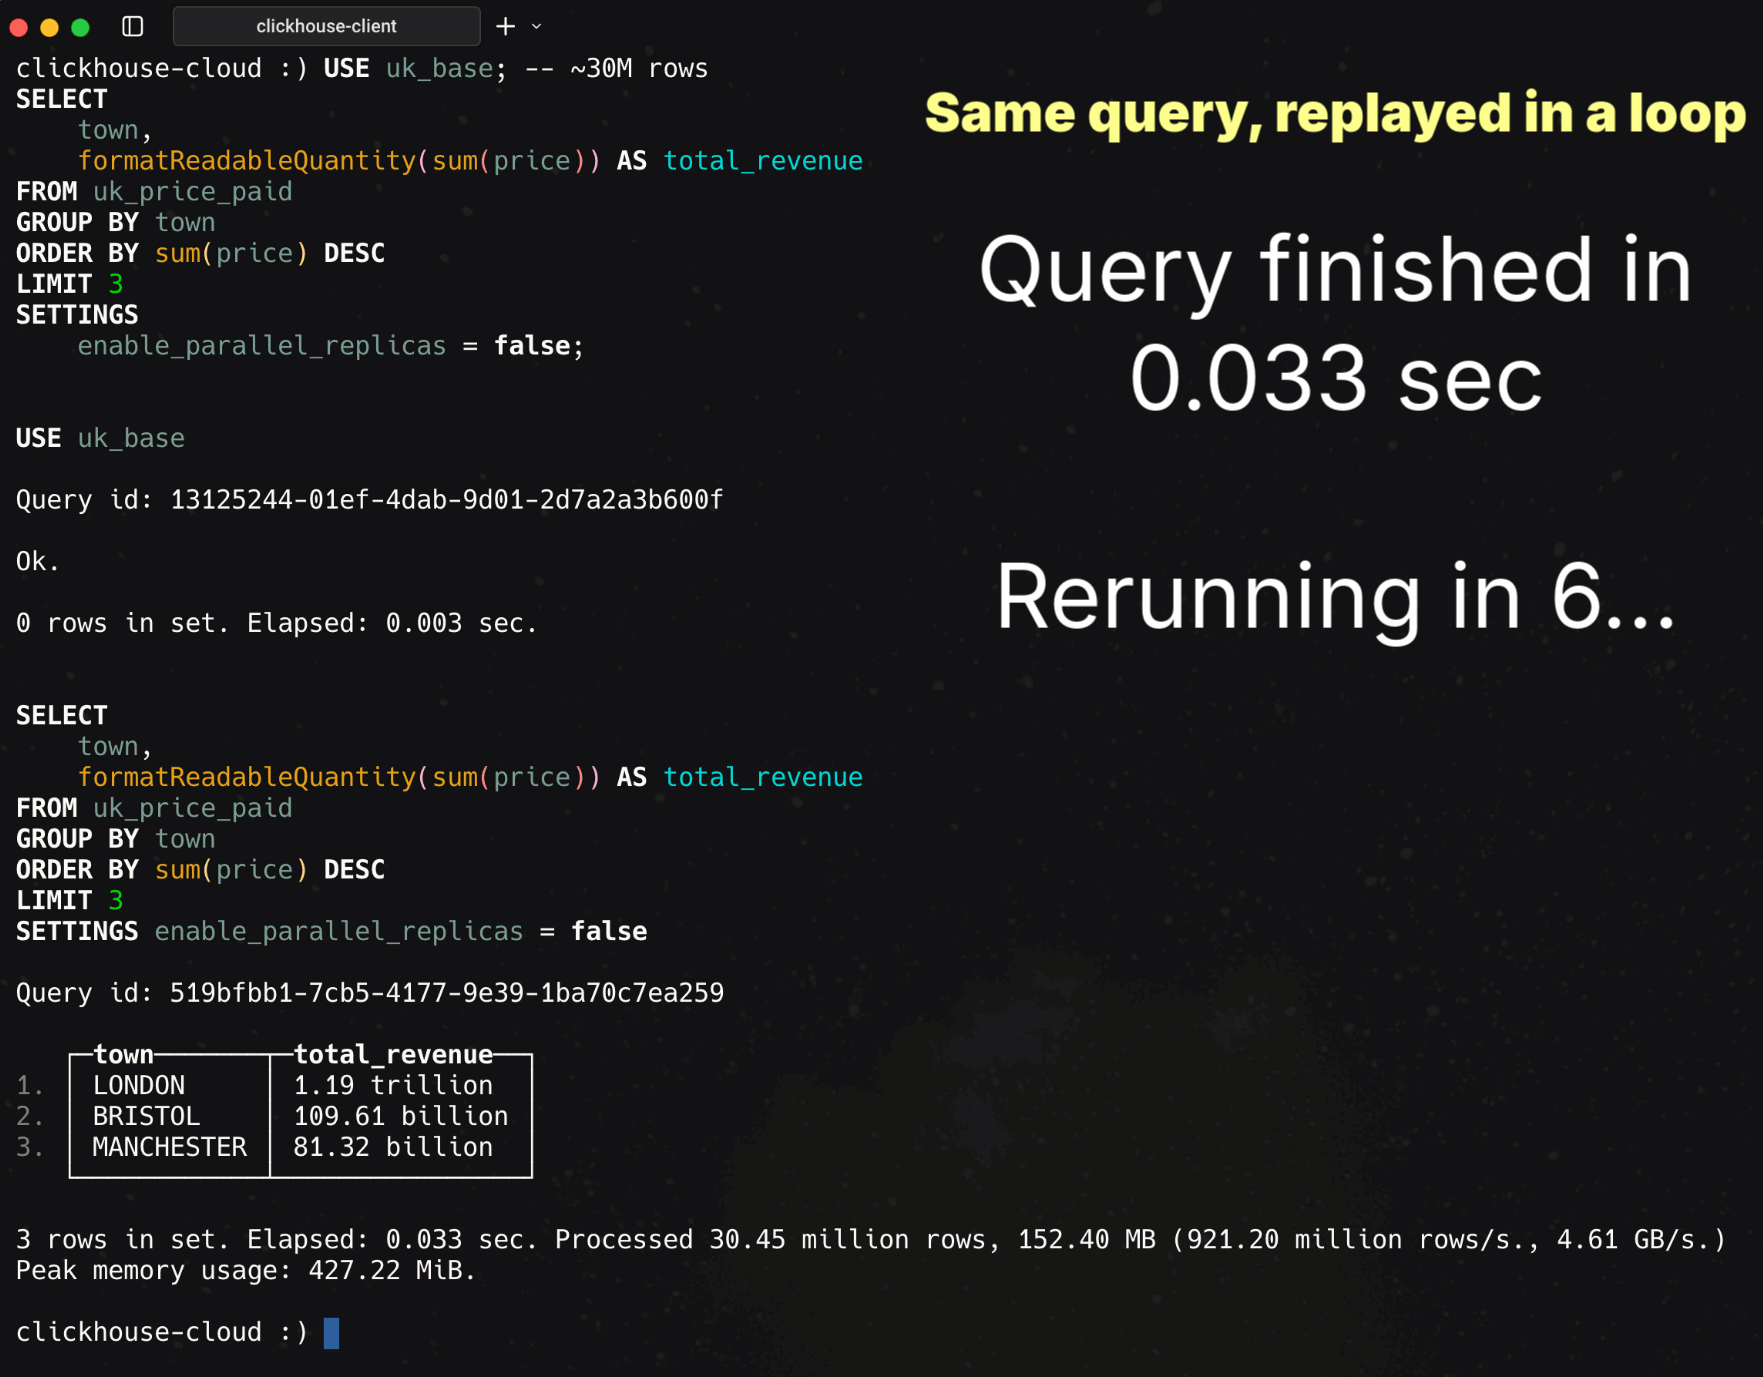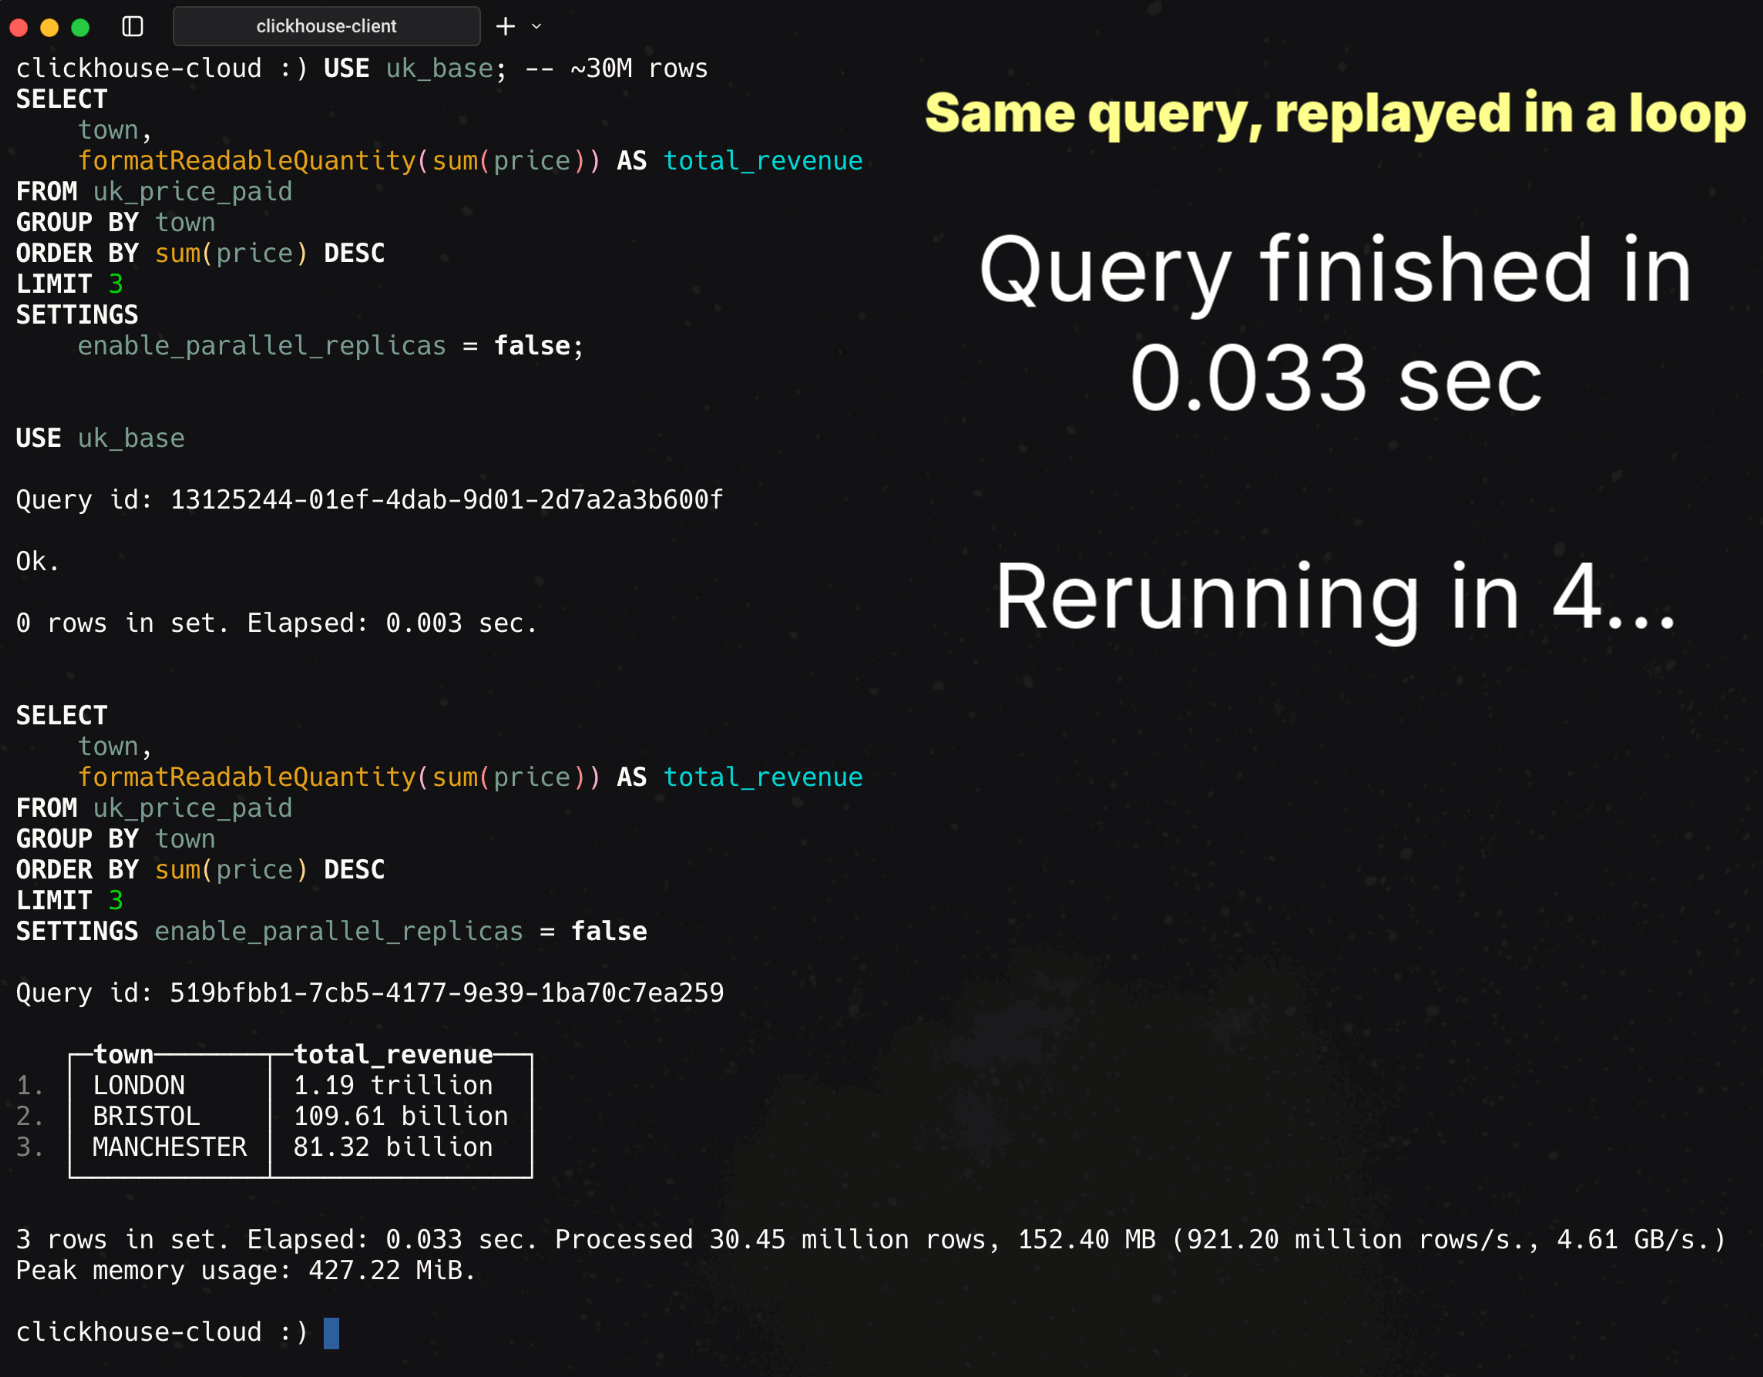
-
実行時間: 33 ms
-
処理行数: 3,045 万行
-
スループット: 毎秒 9 億 2,120 万行、4.61 GB/s
人間がまばたきをする時間は約 100〜150 ms です。33 ms という処理速度は、まばたきのおよそ 4 分の 1 であり、カメラのシャッター音が鳴るほどの速さです。
スケールアップ: 数十億行が新たな標準に
現在のデータセットは、数十億、数兆、さらには数千兆行に達することも珍しくありません。Tesla は負荷テストのために、ClickHouse に 1,000 兆行を超えるデータを取り込みました。
それでは、スケールさせてみましょう。
10 億行: まばたき 2 回分の時間
同じく 89 コアの 1 ノード上で、10 億行に対して同じクエリを実行しました。
USE uk_b1; -- 1B rows dataset

SELECT
    town,
    formatReadableQuantity(sum(price)) AS total_revenue
FROM uk_price_paid
GROUP BY town
ORDER BY sum(price) DESC
LIMIT 3
SETTINGS
    enable_parallel_replicas = false;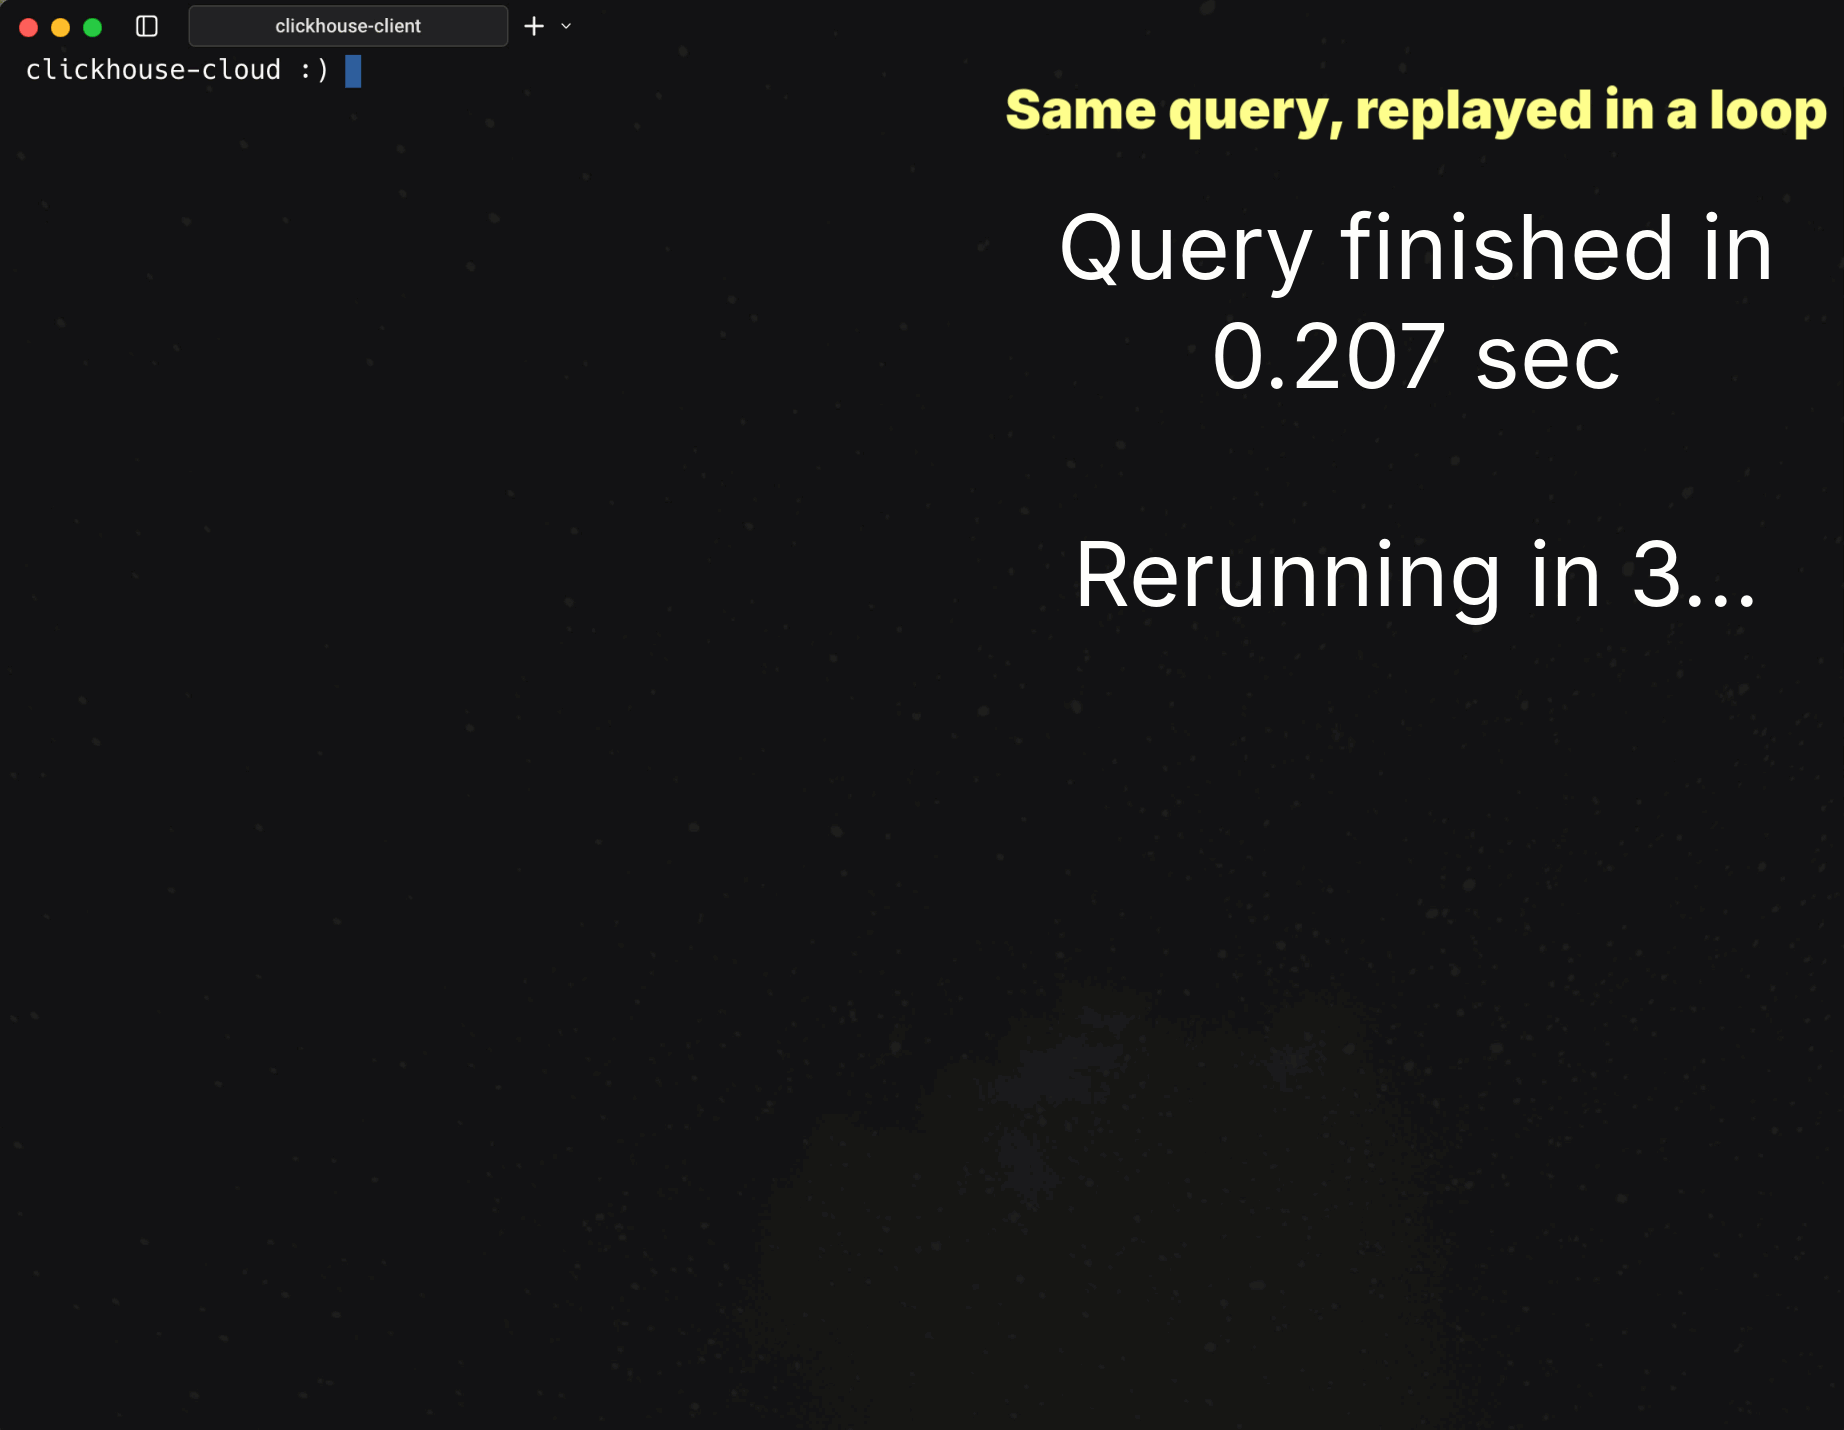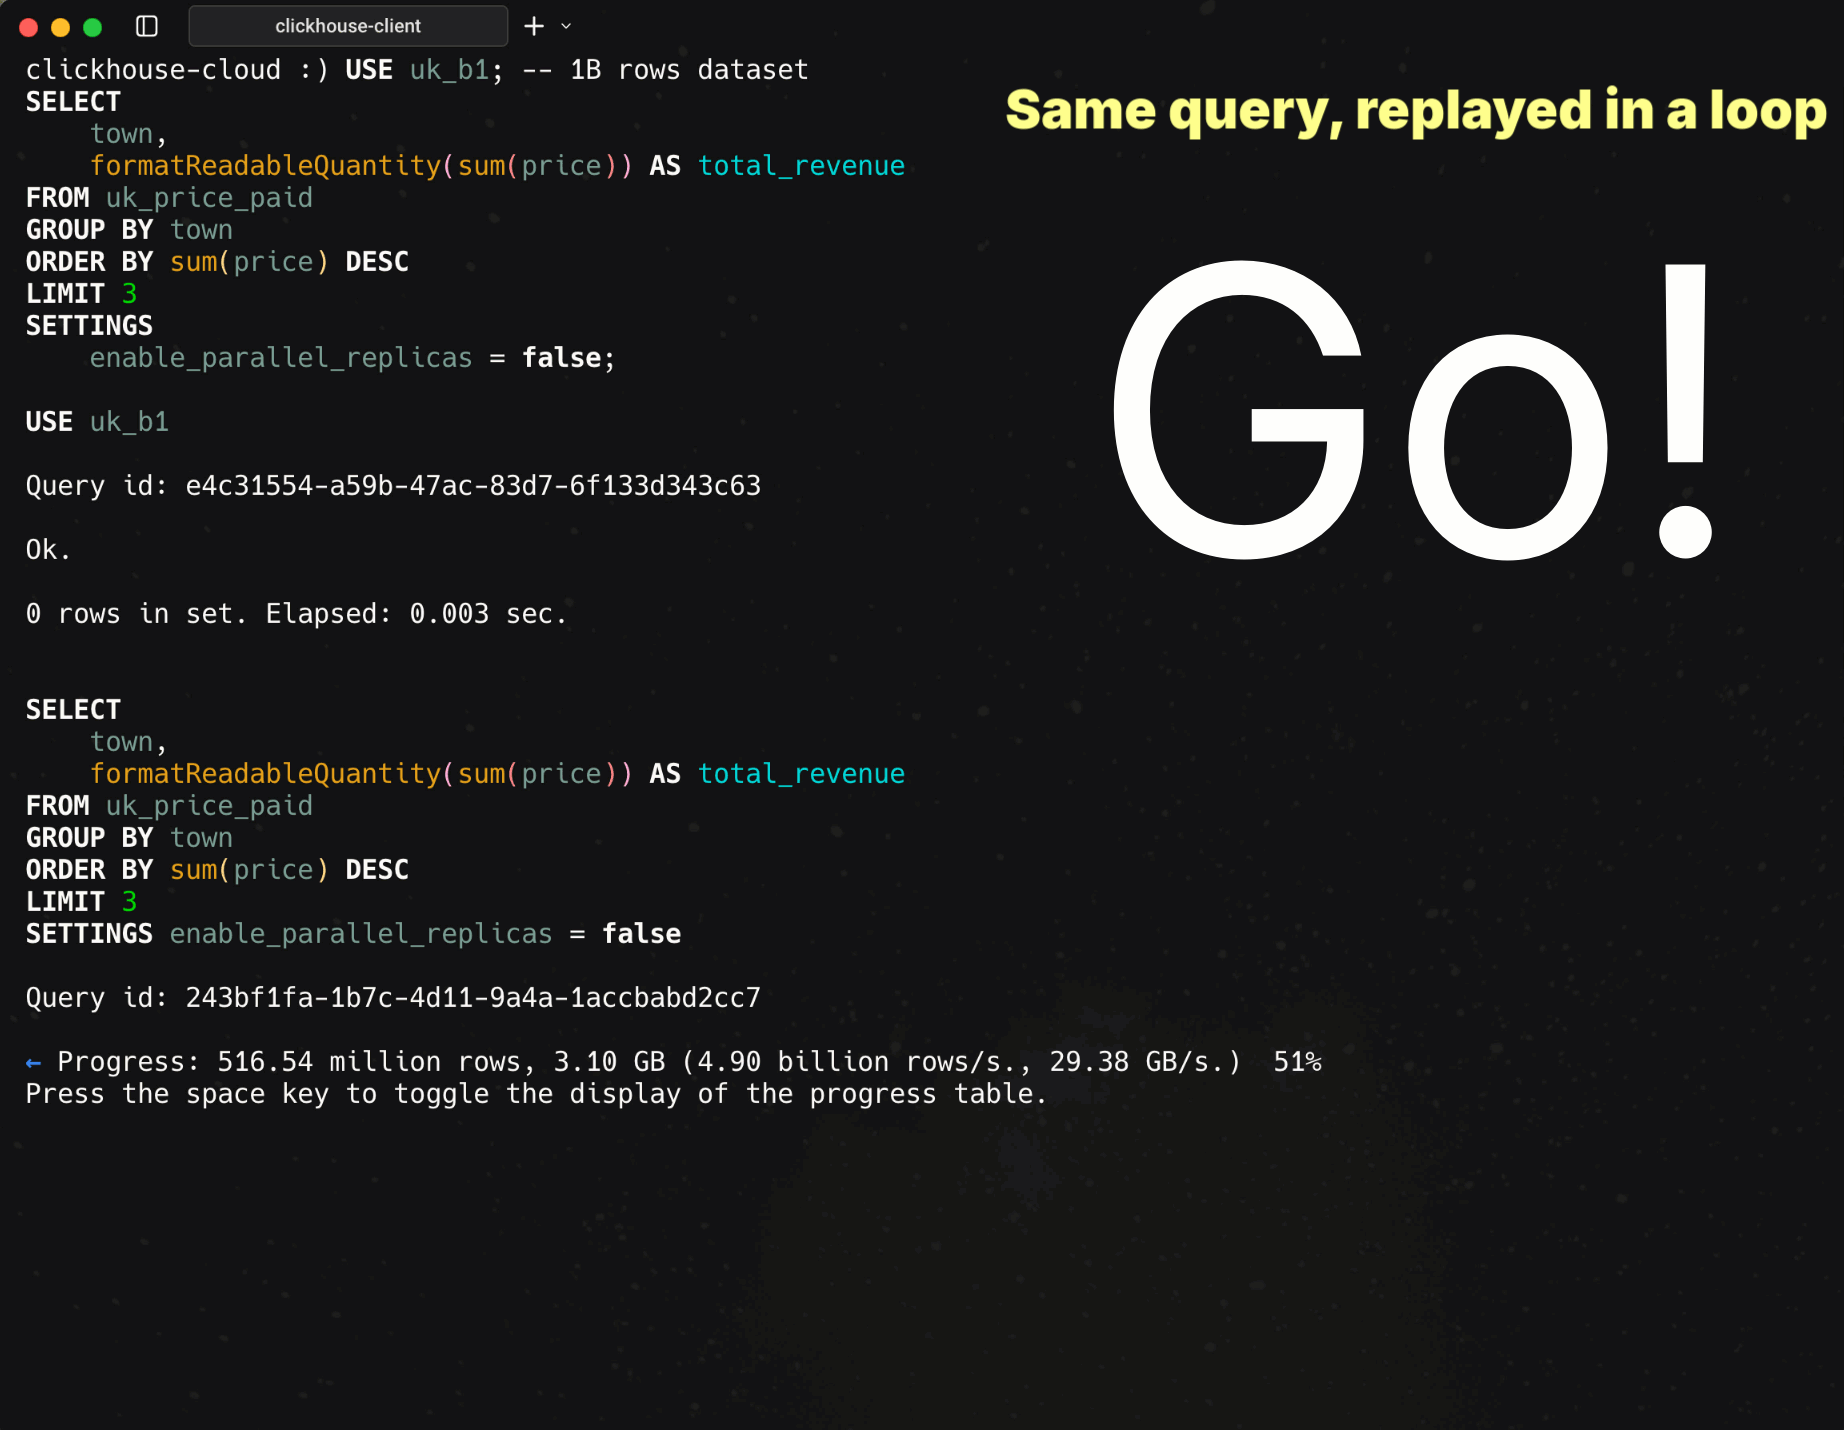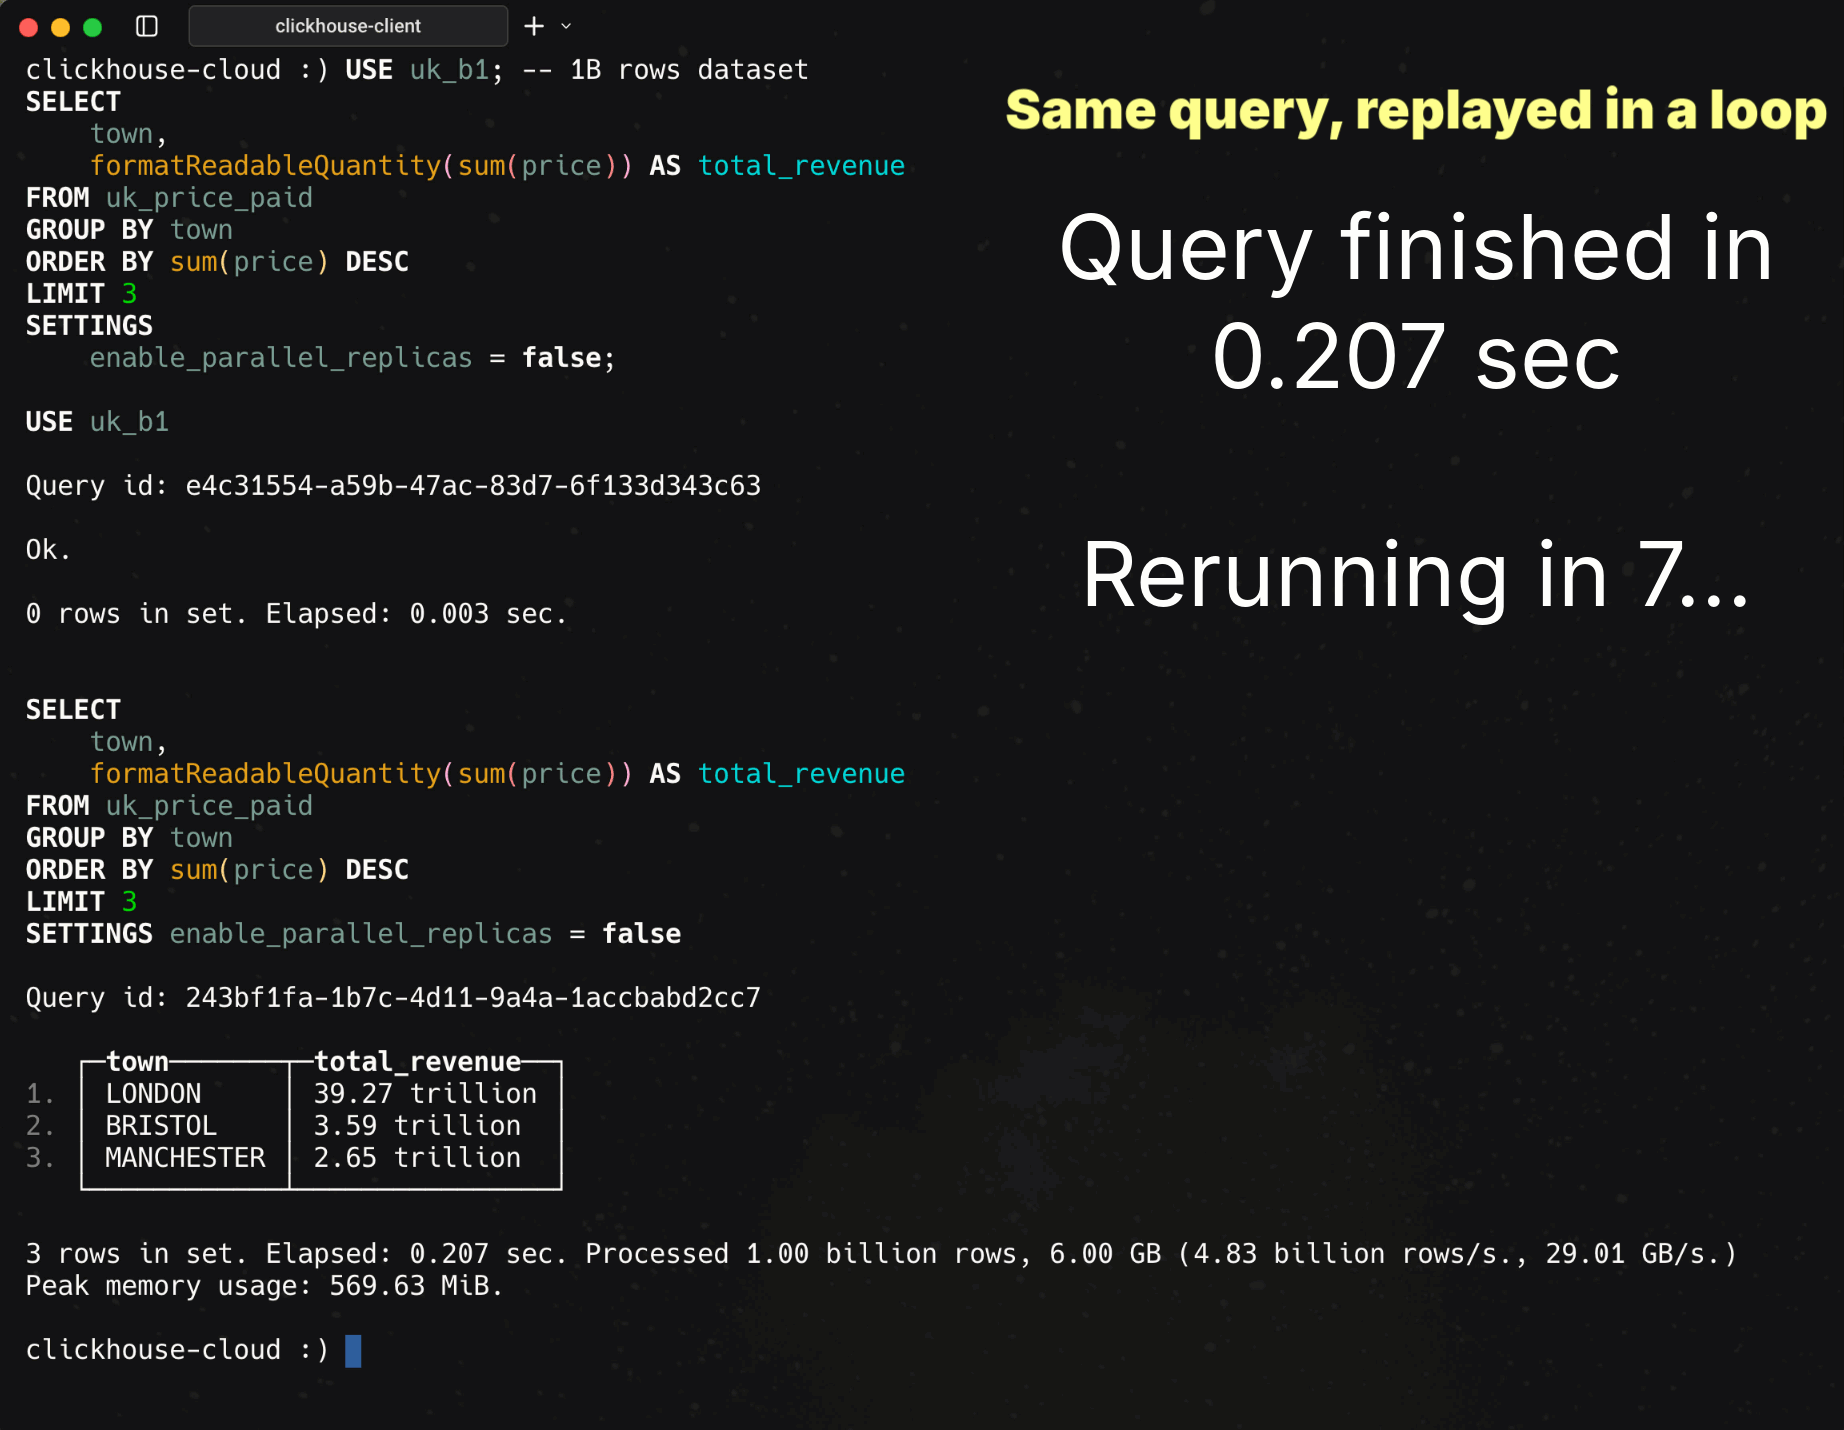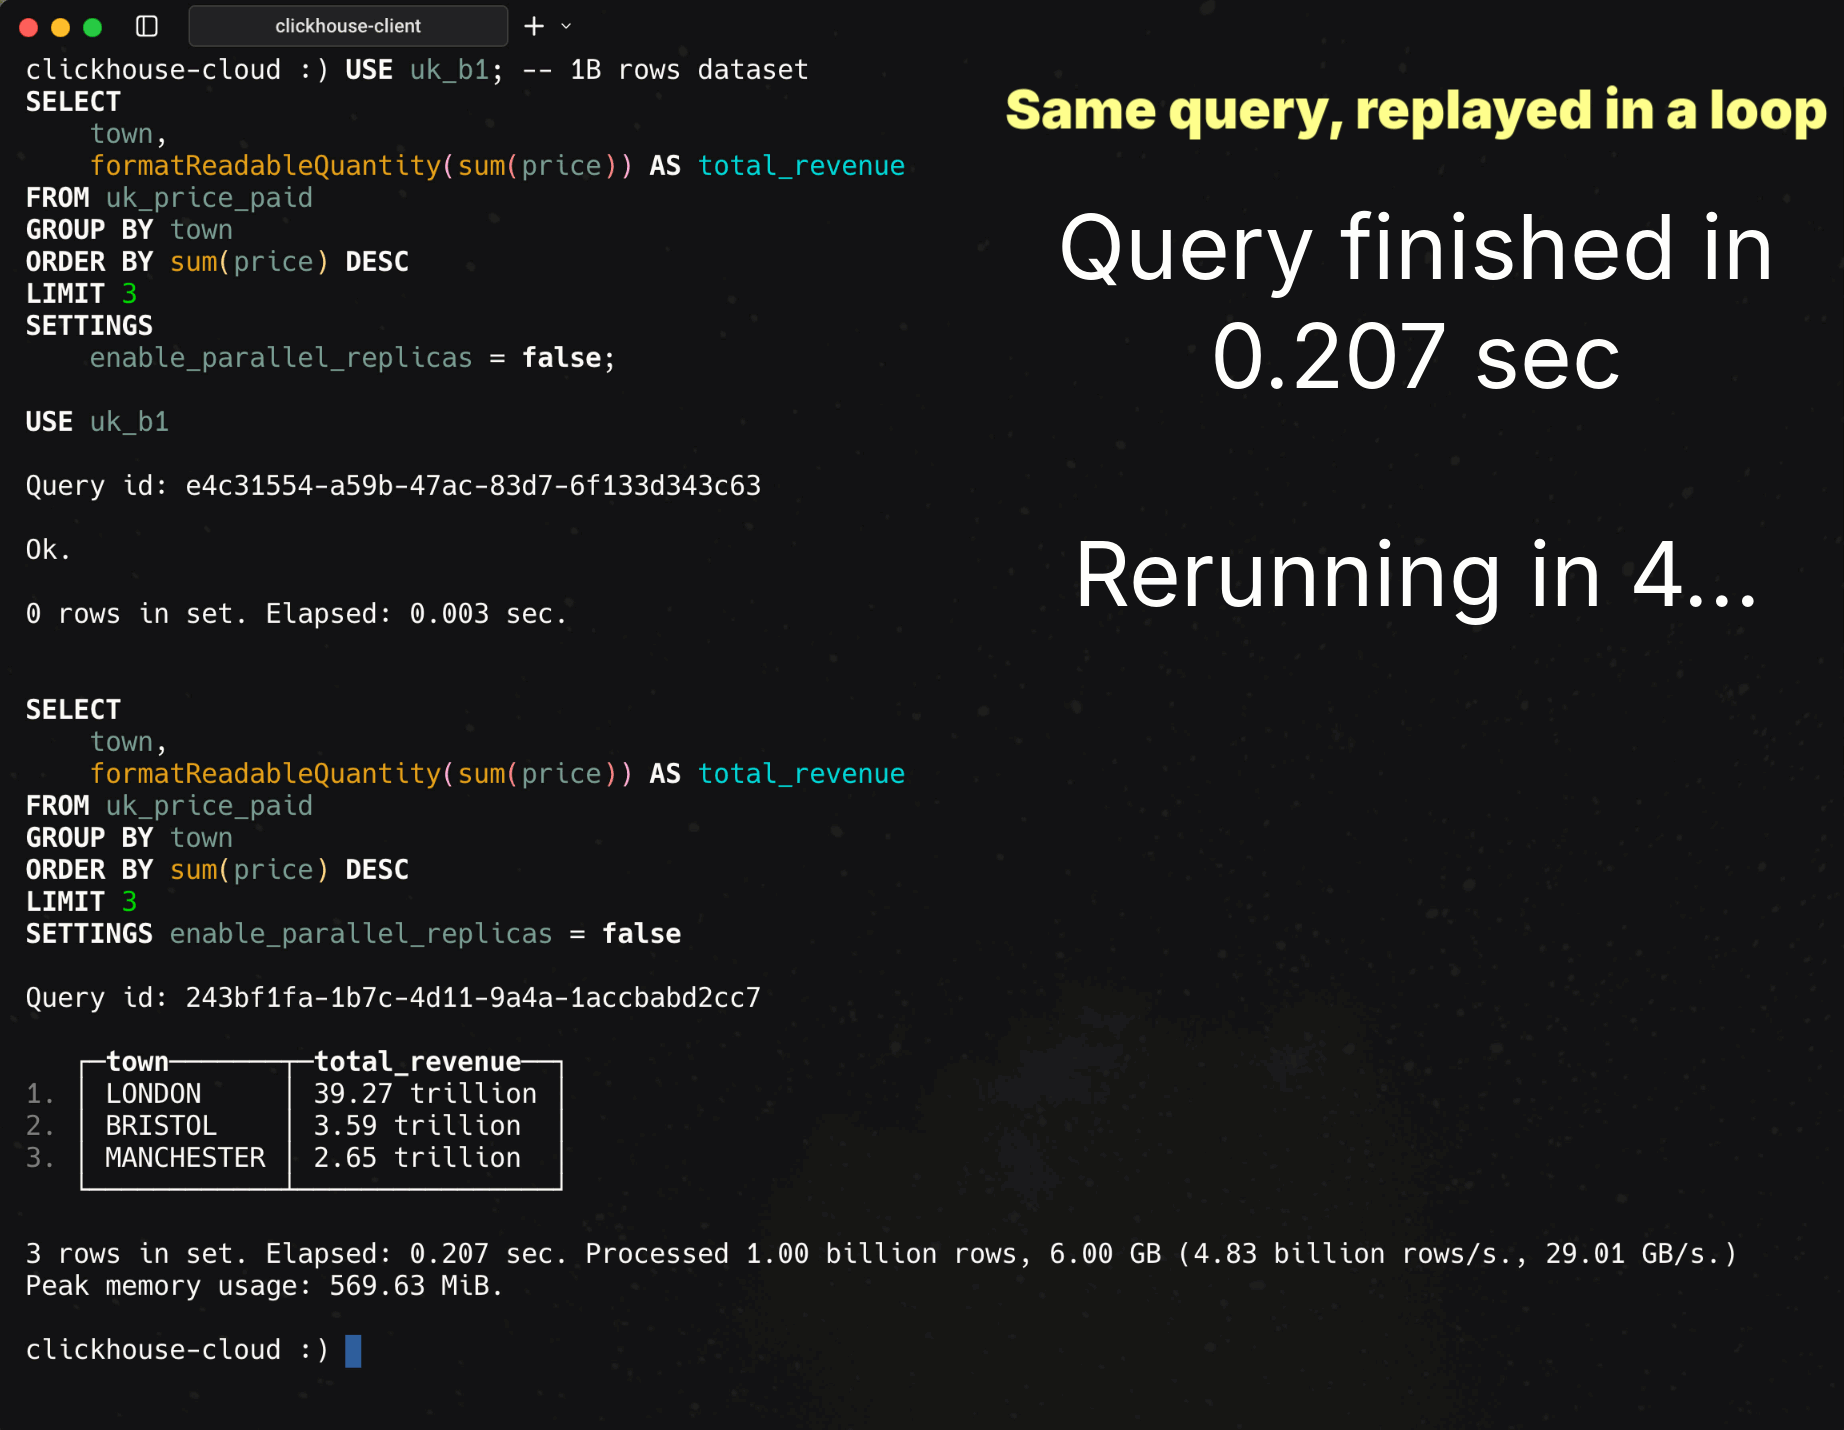
-
実行時間: 207 ms
-
処理行数: 10 億行
-
スループット: 毎秒 48 億 3,000 万行、29.01 GB/s
2 回まばたきをするほどの時間で、10 億行のグループ化が完了しました。
1,000 億行: 指を鳴らすほどの時間
今度は 1,000 億行に引き上げ、同じクエリを再度実行します (89 コアの 1 ノード上)。
USE uk_b100; -- 100B rows dataset

SELECT
    town,
    formatReadableQuantity(sum(price)) AS total_revenue
FROM uk_price_paid
GROUP BY town
ORDER BY sum(price) DESC
LIMIT 3
SETTINGS
enable_parallel_replicas = false;┌─town───────┬─total_revenue────┐
│ LONDON │ 3.92 quadrillion │
│ BRISTOL │ 359.61 trillion │
│ MANCHESTER │ 266.83 trillion │
└────────────┴──────────────────┘
3 rows in set. Elapsed: 16.581 sec. Processed 100.00 billion rows, 600.00 GB (6.03 billion rows/s., 36.19 GB/s.)
Peak memory usage: 572.19 MiB.1,000 億行の処理が約 17 秒で完了しました 🐌。
スループットは良好ですが (毎秒 60 億 3,000 万行、36.19 GB/s)、アニメーションのループとしてここで見せるには実行時間が長すぎます。
ターボスイッチを入れる時間です 🏎️。
parallel replicas を有効化すると、同じクエリがサービス内の全ノードの全コアへとファンアウトされます。
USE uk_b100; -- 100B rows dataset

SELECT
    town,
    formatReadableQuantity(sum(price)) AS total_revenue
FROM uk_price_paid
GROUP BY town
ORDER BY sum(price) DESC
LIMIT 3
SETTINGS
    enable_parallel_replicas = true;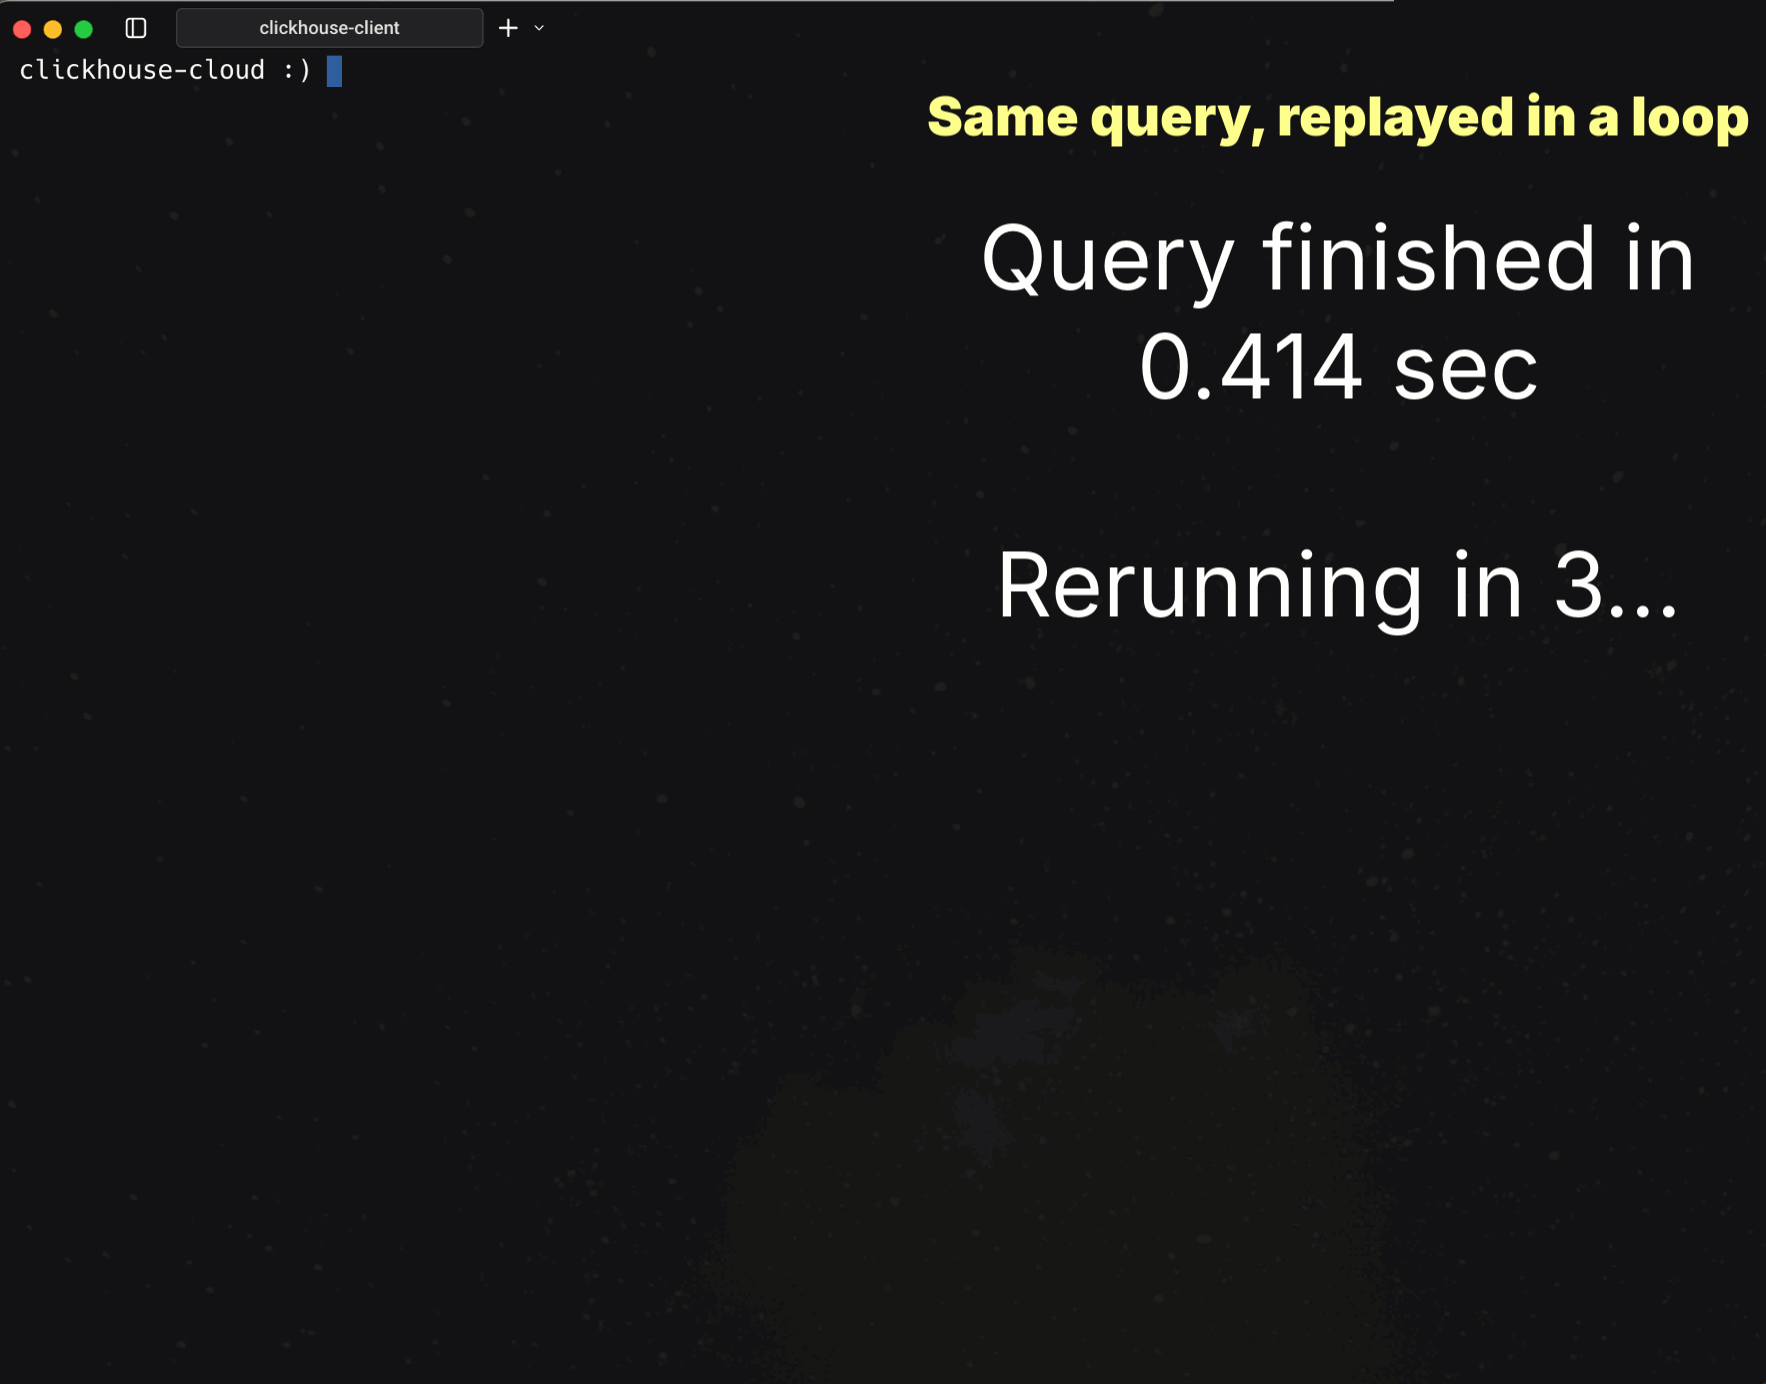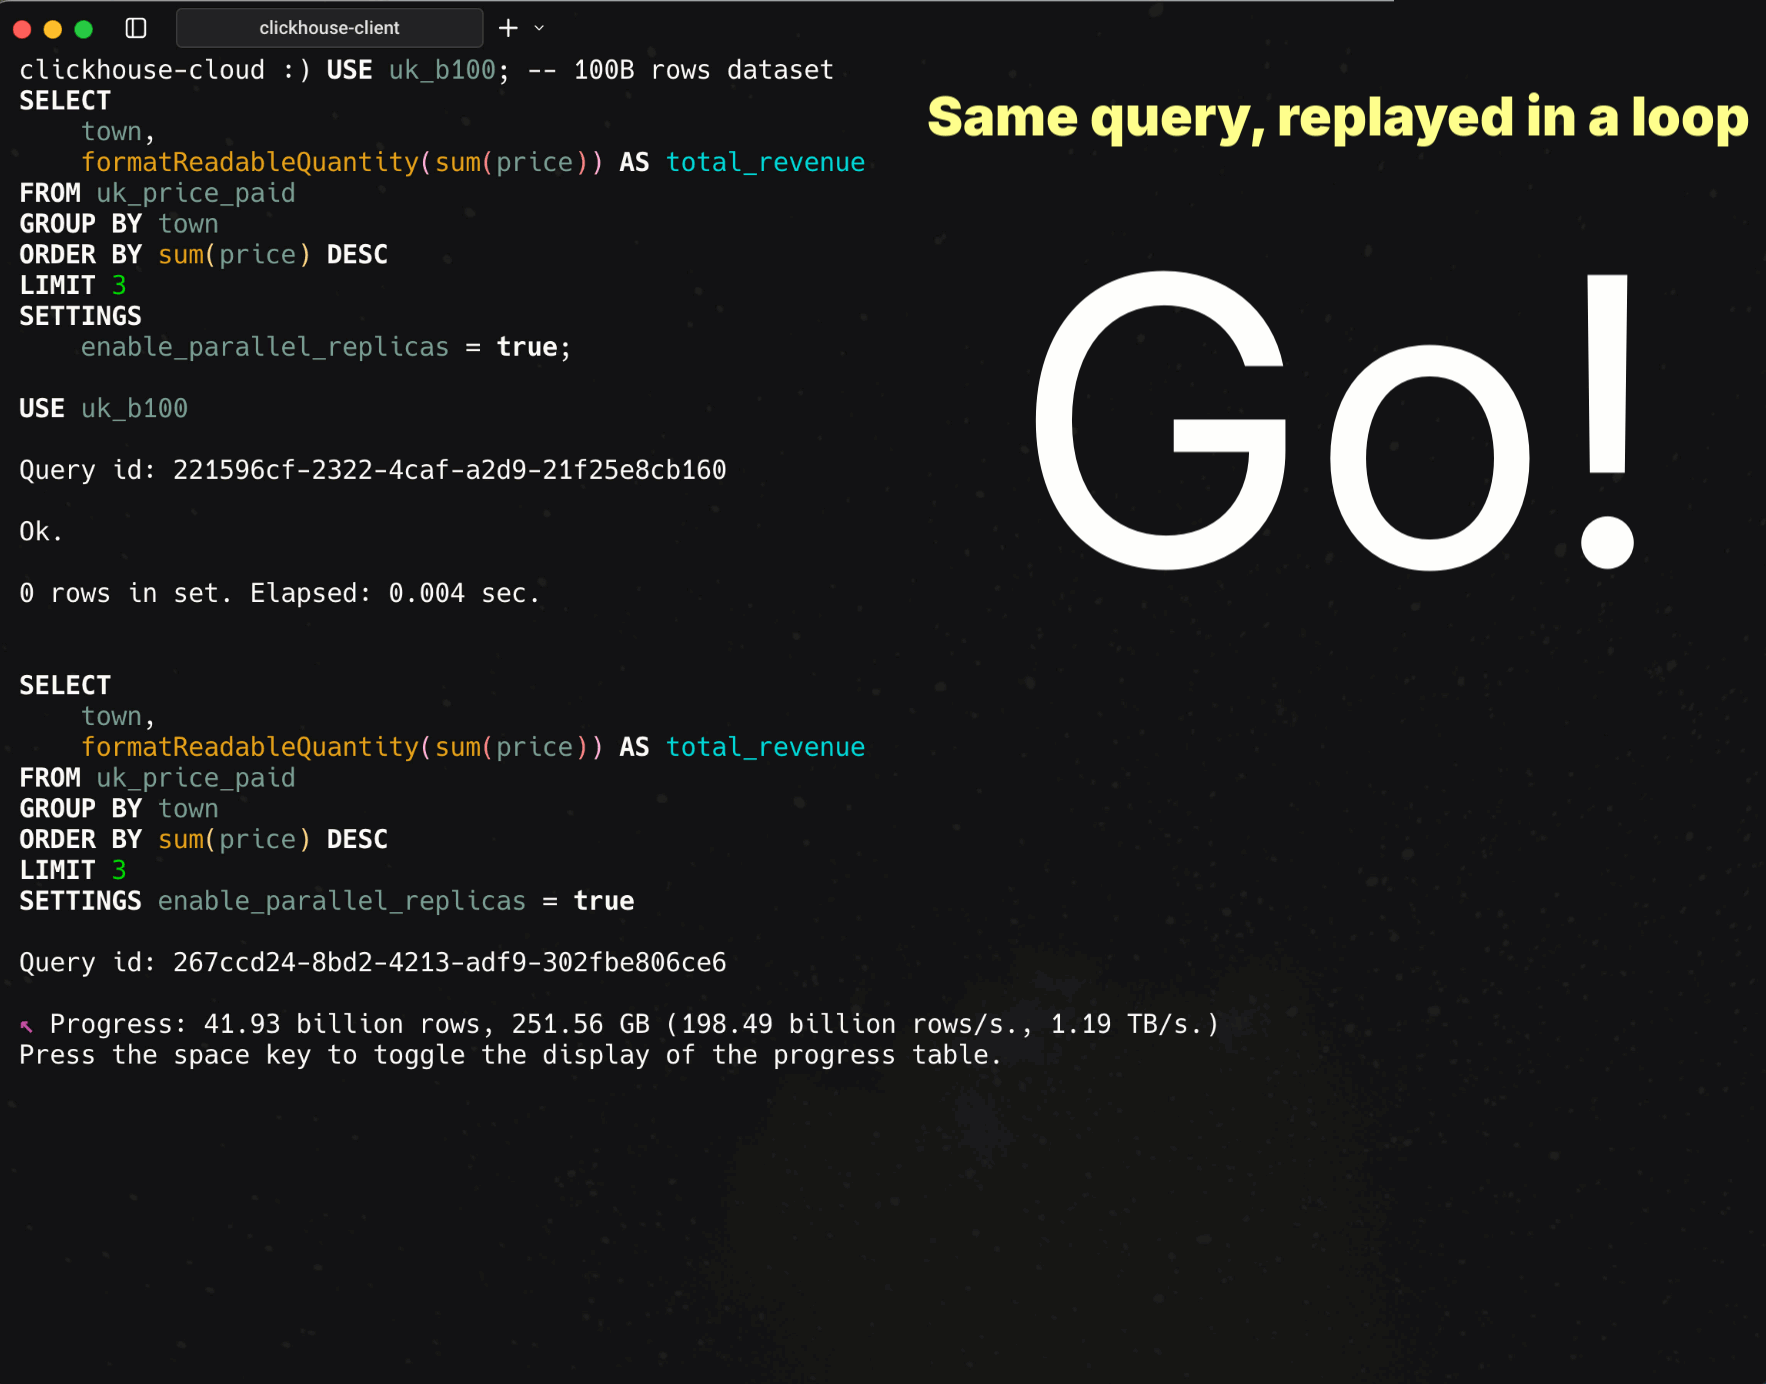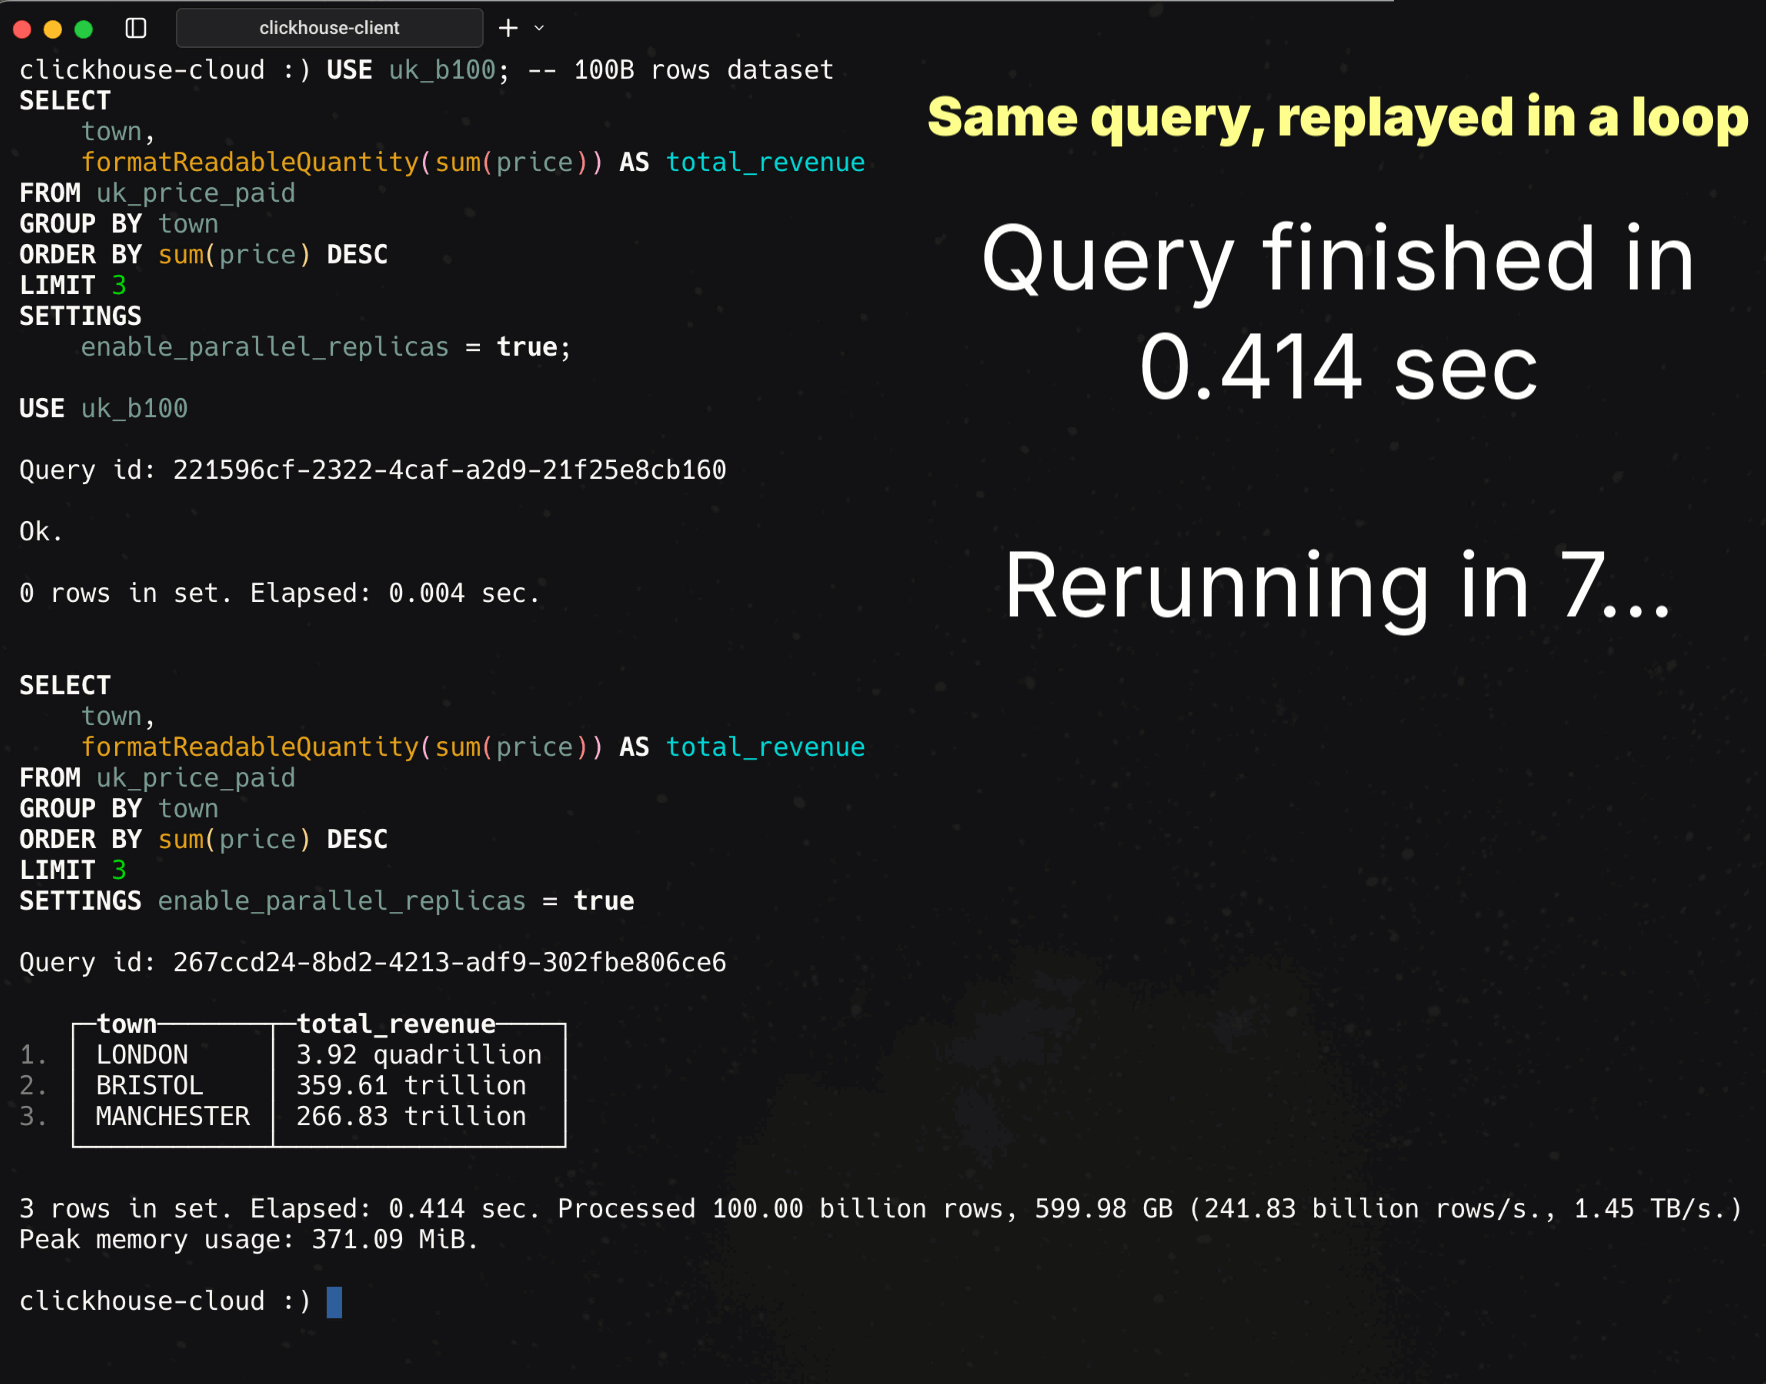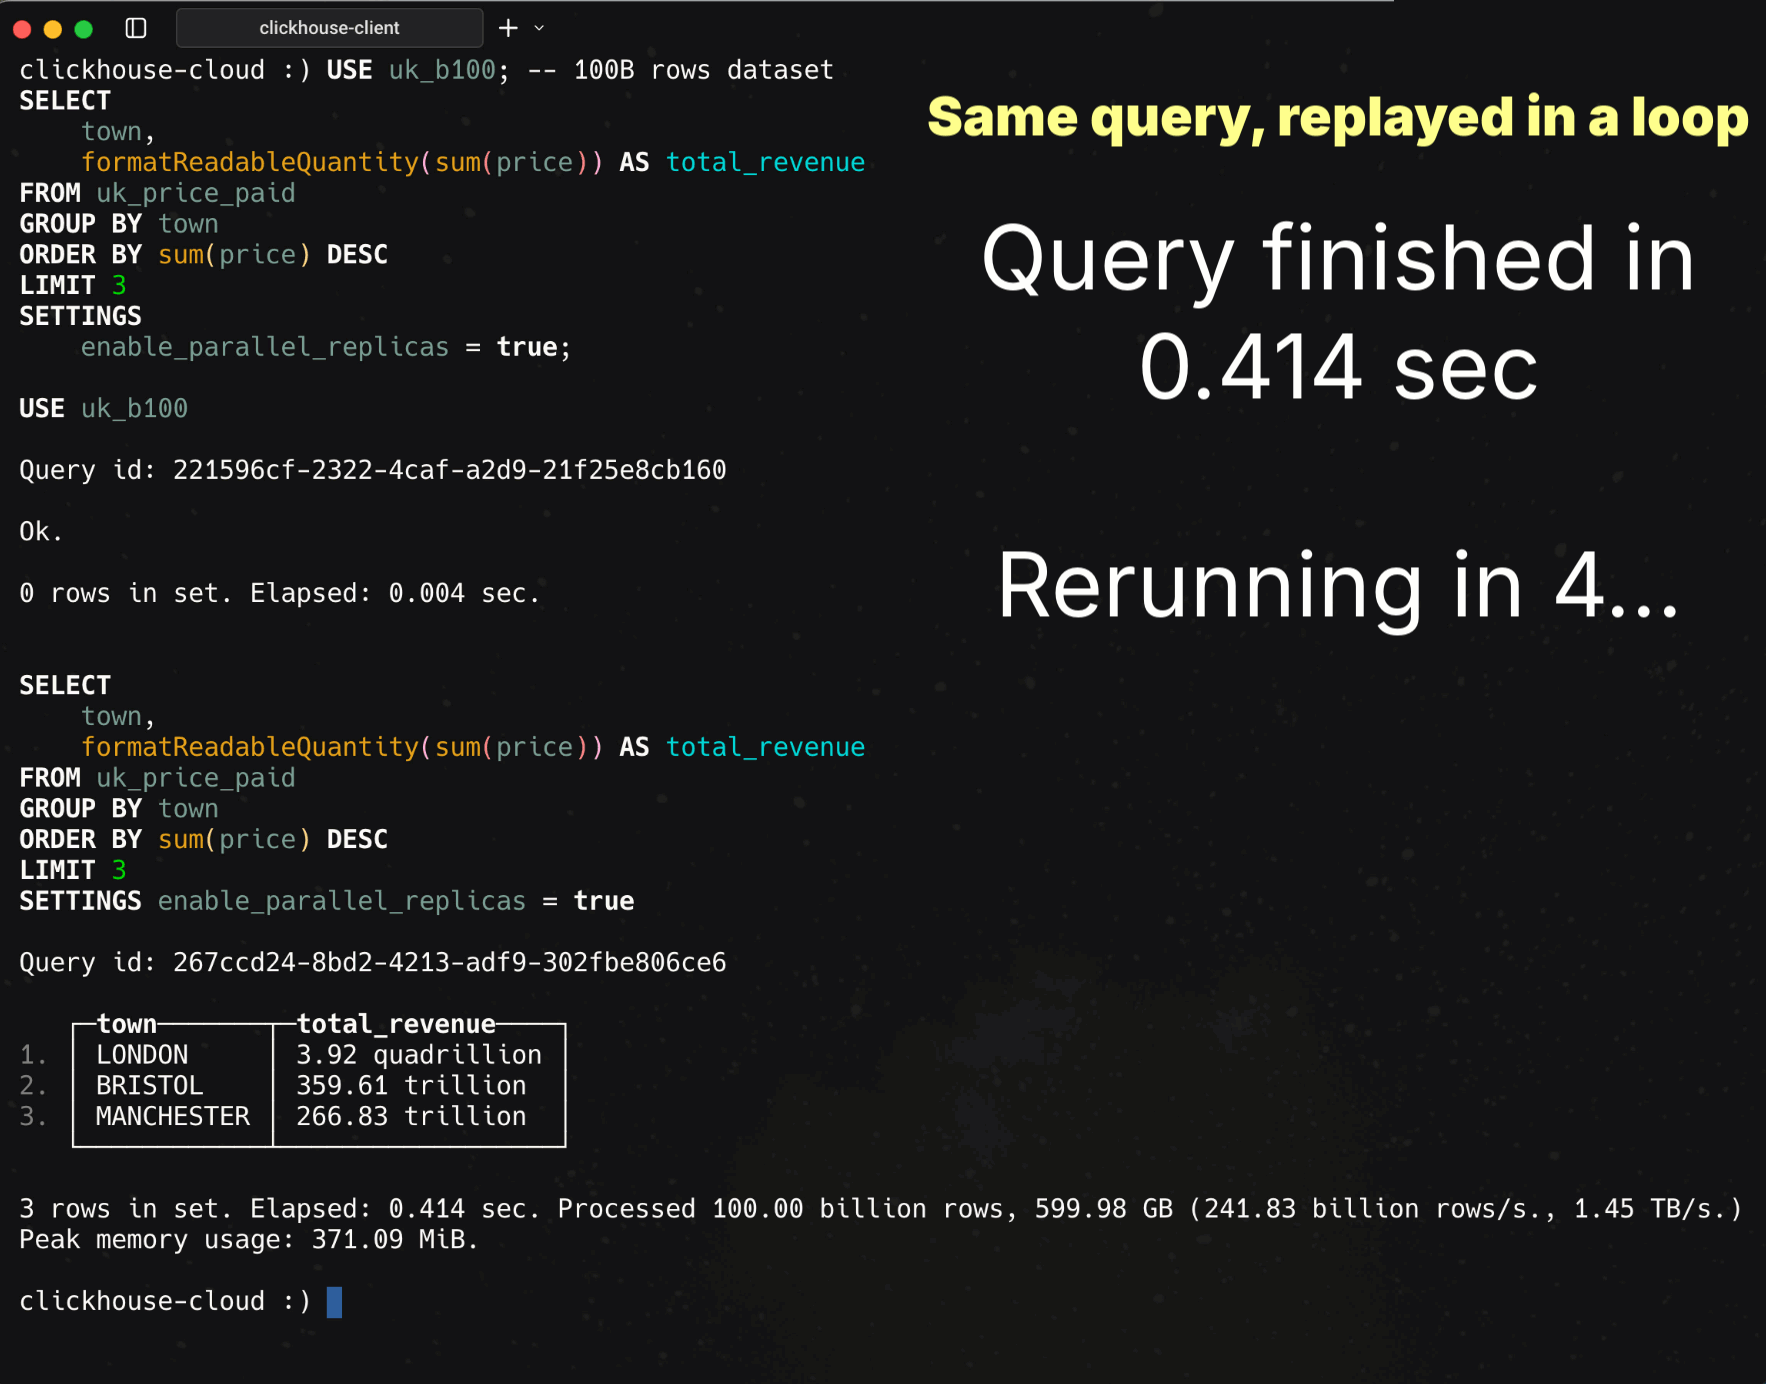
-
実行時間: 414 ms
-
処理行数: 1,000 億行
-
スループット: 毎秒 2,418 億 3,000 万行、1.45 TB/s
414 ms は指をパチンと鳴らすか、1 回手を叩くほどの時間です。その瞬間に、ClickHouse は 1,000 億行を毎秒 1 テラバイト以上の速度で集計しました。
まさに圧巻です。1,000 億行を 1 秒未満、TB/s 級のスループットで集計できました。
では、ClickHouse はこれをどのように実現しているのでしょうか。単一ノード上で ClickHouse が GROUP BY をこれほど高速化できる仕組みから順に、内部構造を解き明かしていきましょう。
ClickHouse が GROUP BY を高速化する仕組み
ClickHouse が高速なのは、クエリパイプライン (物理クエリプラン) 内の並列ストリーム (高速道路の車線をイメージしてください) を利用し、すべての CPU コアにクエリを並列分散させて部分集計状態 (partial aggregation states) を構築するためです。
列指向ストレージによる下地作り
ClickHouse は列指向ストレージを採用しています。クエリは参照されたカラムのみを読み取り、カラムごとの高い圧縮率によってスキャンバイト数を抑え、連続したデータに対してベクトル化 (SIMD) 演算を実行します。その結果、I/O が低く抑えられ演算密度が高くなり、CPU コアごとに 1 つの並列クエリパイプラインストリームを実行するのに最適な環境が整います。
1 コアあたり 1 つのストリーム
ClickHouse は、CPU コアごとに 1 つの並列クエリパイプラインストリームを実行します。各ストリームは行のスキャン、フィルターの適用、部分集計状態の構築を並列で行います。
クエリエンジン内部では次のような処理が行われます。

① 多数のパート範囲を同時に読み込み
ClickHouse は、複数のデータパート範囲 (インデックス分析によって選択された連続する行ブロック) から異なるストリームへとデータを同時にスキャンします。
② 並列フィルタリングと集計
各ストリームは互いに重複しない専用の範囲を担当し、ベクトル化実行 (SIMD) を使用して行のフィルタリングと部分状態の更新を行います。
③ 部分状態のマージ
すべてのストリームからの部分状態が統合され、最終的な結果になります。このマージステップは通常、複数のマージスレッドにまたがって並列に実行されます。ただし、従来は必ずしも並列化されていなかった特殊な GROUP BY バリアントも存在します。私たちはこれらの実装に対しても完全並列マージをサポートするよう拡張を続けています。
(これとは別に、クエリが COUNT、SUM、MAX などの複数の集計を計算する場合、各集計は独自の部分状態を保持し、それらのマージ処理は互いに並行して実行されます。)
④ ソートと LIMIT の適用
マージされた結果が並べ替えられ、クエリに LIMIT 句がある場合はそれが適用されます。
⑤ 応答の返却
最終結果がクライアントに返送されます。
この設計が機能するのは、パイプラインストリームが最終的な値を直接計算しないためです。後から 1 つの正しい結果へと結合できるマージ可能な部分状態を構築するのです。
部分状態が重要な理由
部分状態があるからこそ、並列化が可能になります。
これがなければ、後から GROUP BY をコア間やノード間に効率的に分割することはできません。すべてのコア (またはノード) が、特定のグループに属するすべての行を参照しなければならなくなるからです。部分状態があれば、どのコア (またはノード) でも任意の行のサブセットを独立して処理し、1 つの正しい結果に結合できるマージ可能な状態を出力できます。
この柔軟性により、以下が実現します。
-
効率的で明快なパイプラインストリームのスケジューリング: ストリームはキーごとに事前にパーティショニングされたデータを必要とせず、任意の範囲をスキャンできます。
-
動的な負荷分散: あるストリームでデータの偏り (スキュー) が発生した場合でも、行を他のストリームに再ルーティングできるため、全体のスループットを高く維持できます。重要なのは、マージ可能な状態を生成することだけです。
ClickHouse は、170 以上のすべての集計関数 (およびそのコンビネータ) をコア間で並列化し、後述するようにノード間でも並列化します。
次に、クエリパイプラインの集計ステージの内部について、さらに詳しく見ていきましょう。
GROUP BY 実行パイプラインの内部
GROUP BY クエリは、各パイプラインストリームにおいてハッシュ集計アルゴリズムを用いて独立して処理されます。各ストリームはインメモリハッシュテーブルを保持し、各キー (例: town) が部分集計状態を指し示します。
GROUP BY を支えるハッシュテーブル
ClickHouse は単一のハッシュテーブルを使用しているわけではなく、グループ化キーの型、カーディナリティ、ワークロードなどの要素に基づいて自動的に選択される 30 種類以上の特殊なバリアントを使い分けています。
カーネギーメロン大学の Andy Pavlo 氏が評したように、「ClickHouse は常軌を逸したシステムだ。ハッシュテーブルのバージョンを 30 個も持っているなんて!」というわけです。低レベルの詳細に対するこの徹底的なこだわりこそが、GROUP BY をこれほど高速に実行できる理由です。
下のアニメーションは、町ごとの平均価格を計算し、ソートして最上位の町を返すクエリでの動作を示しています。
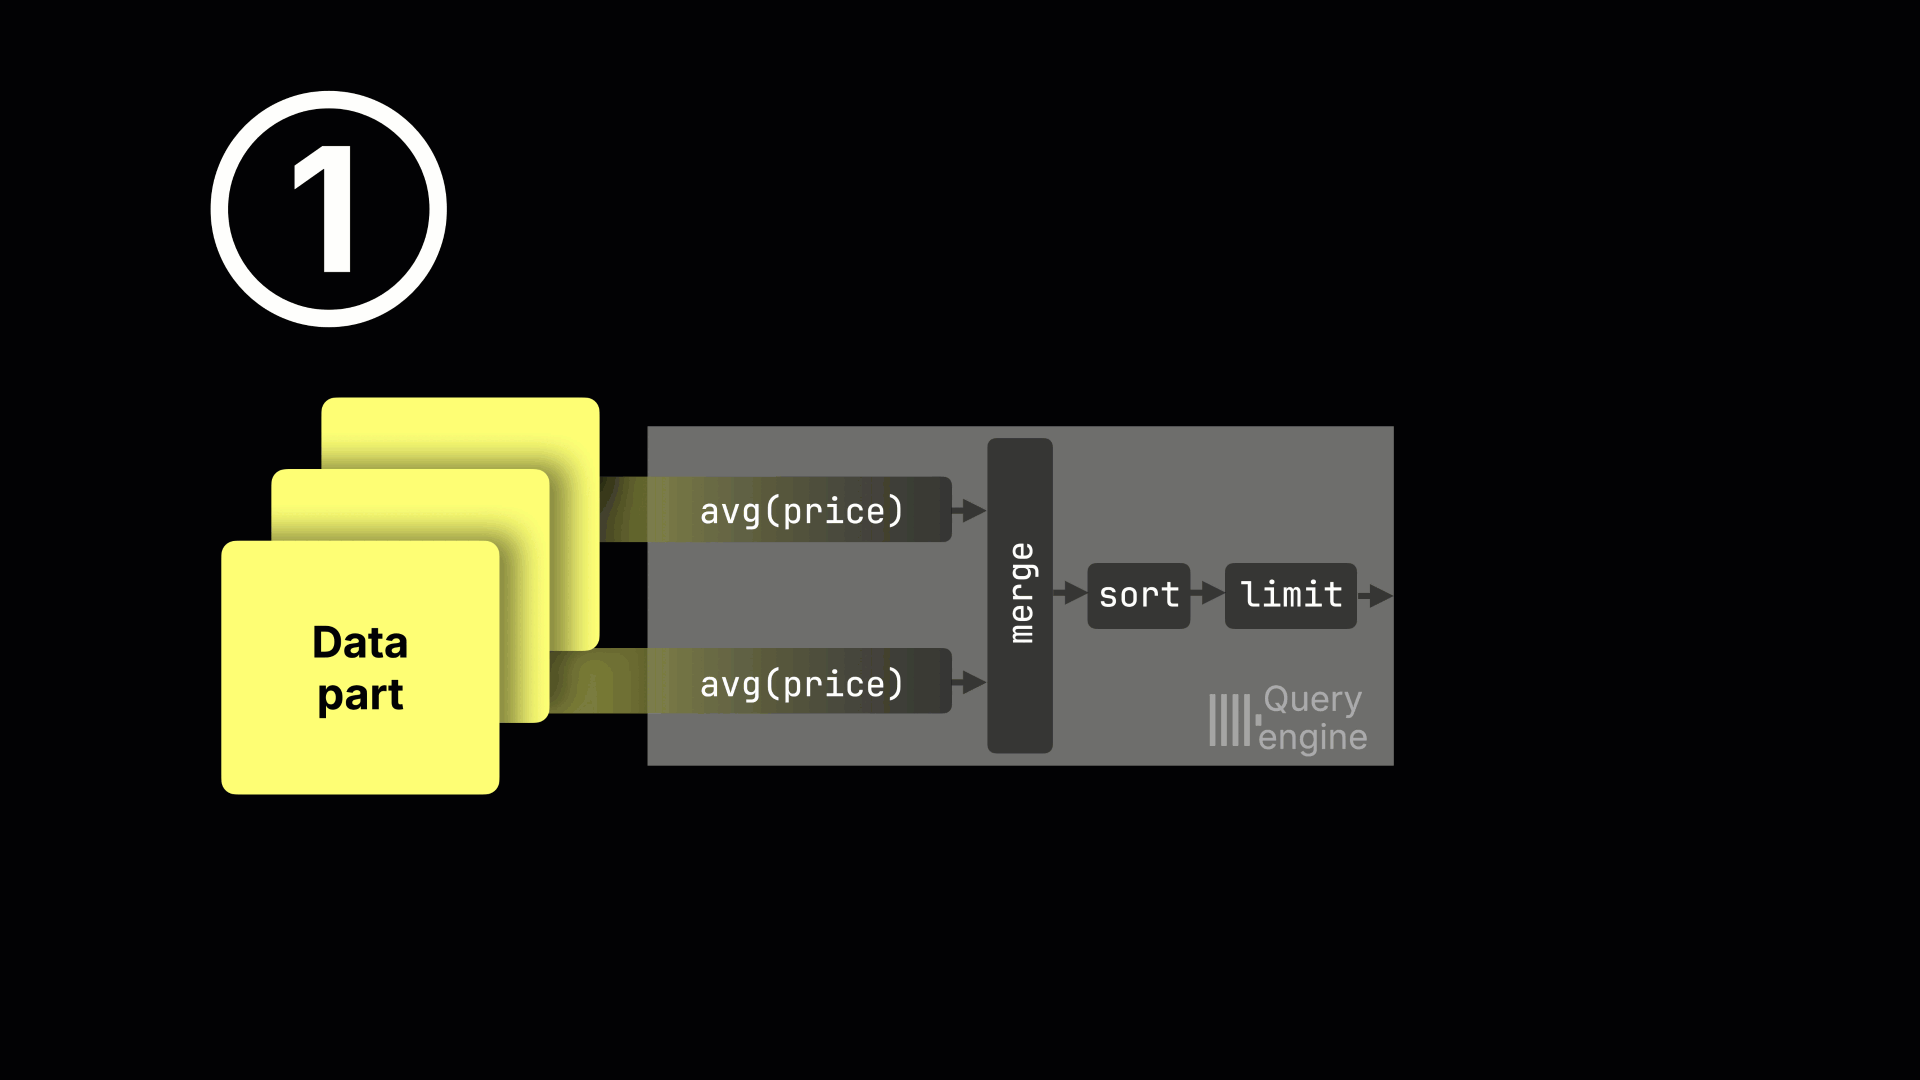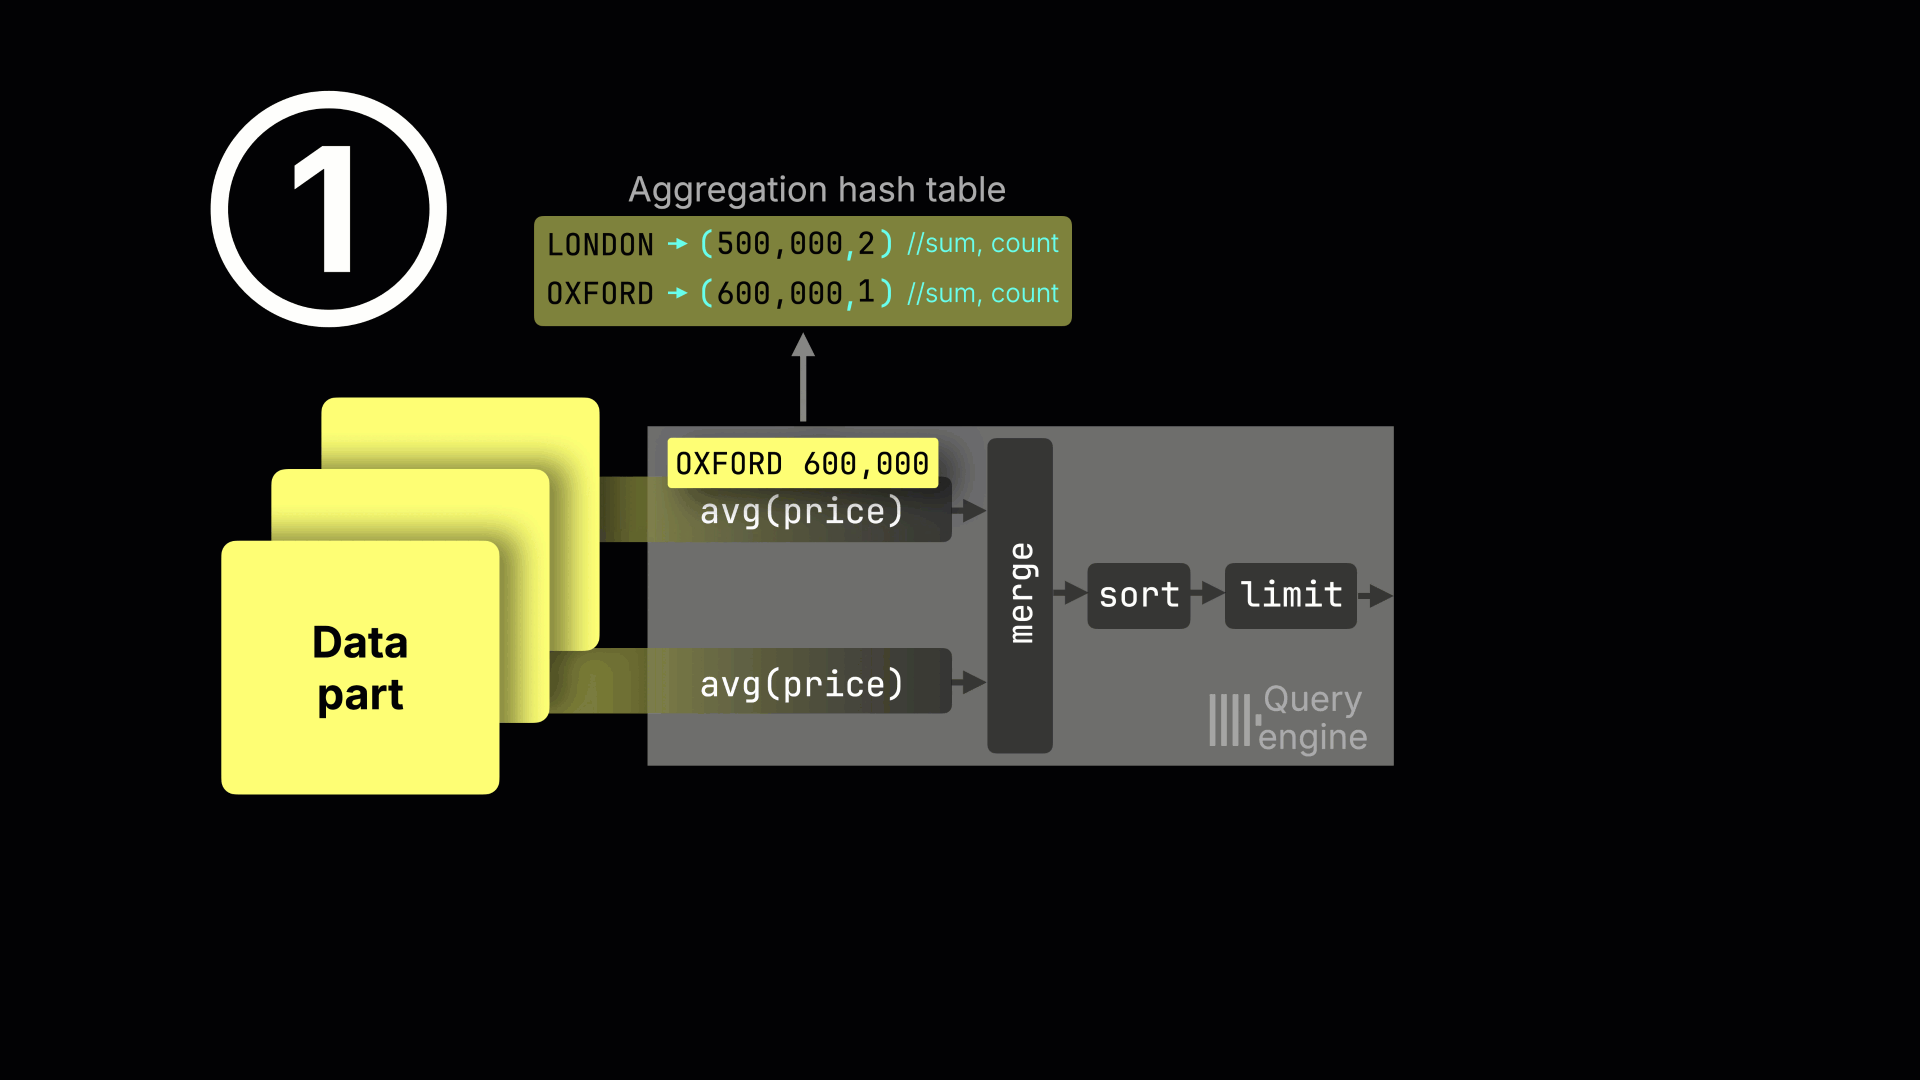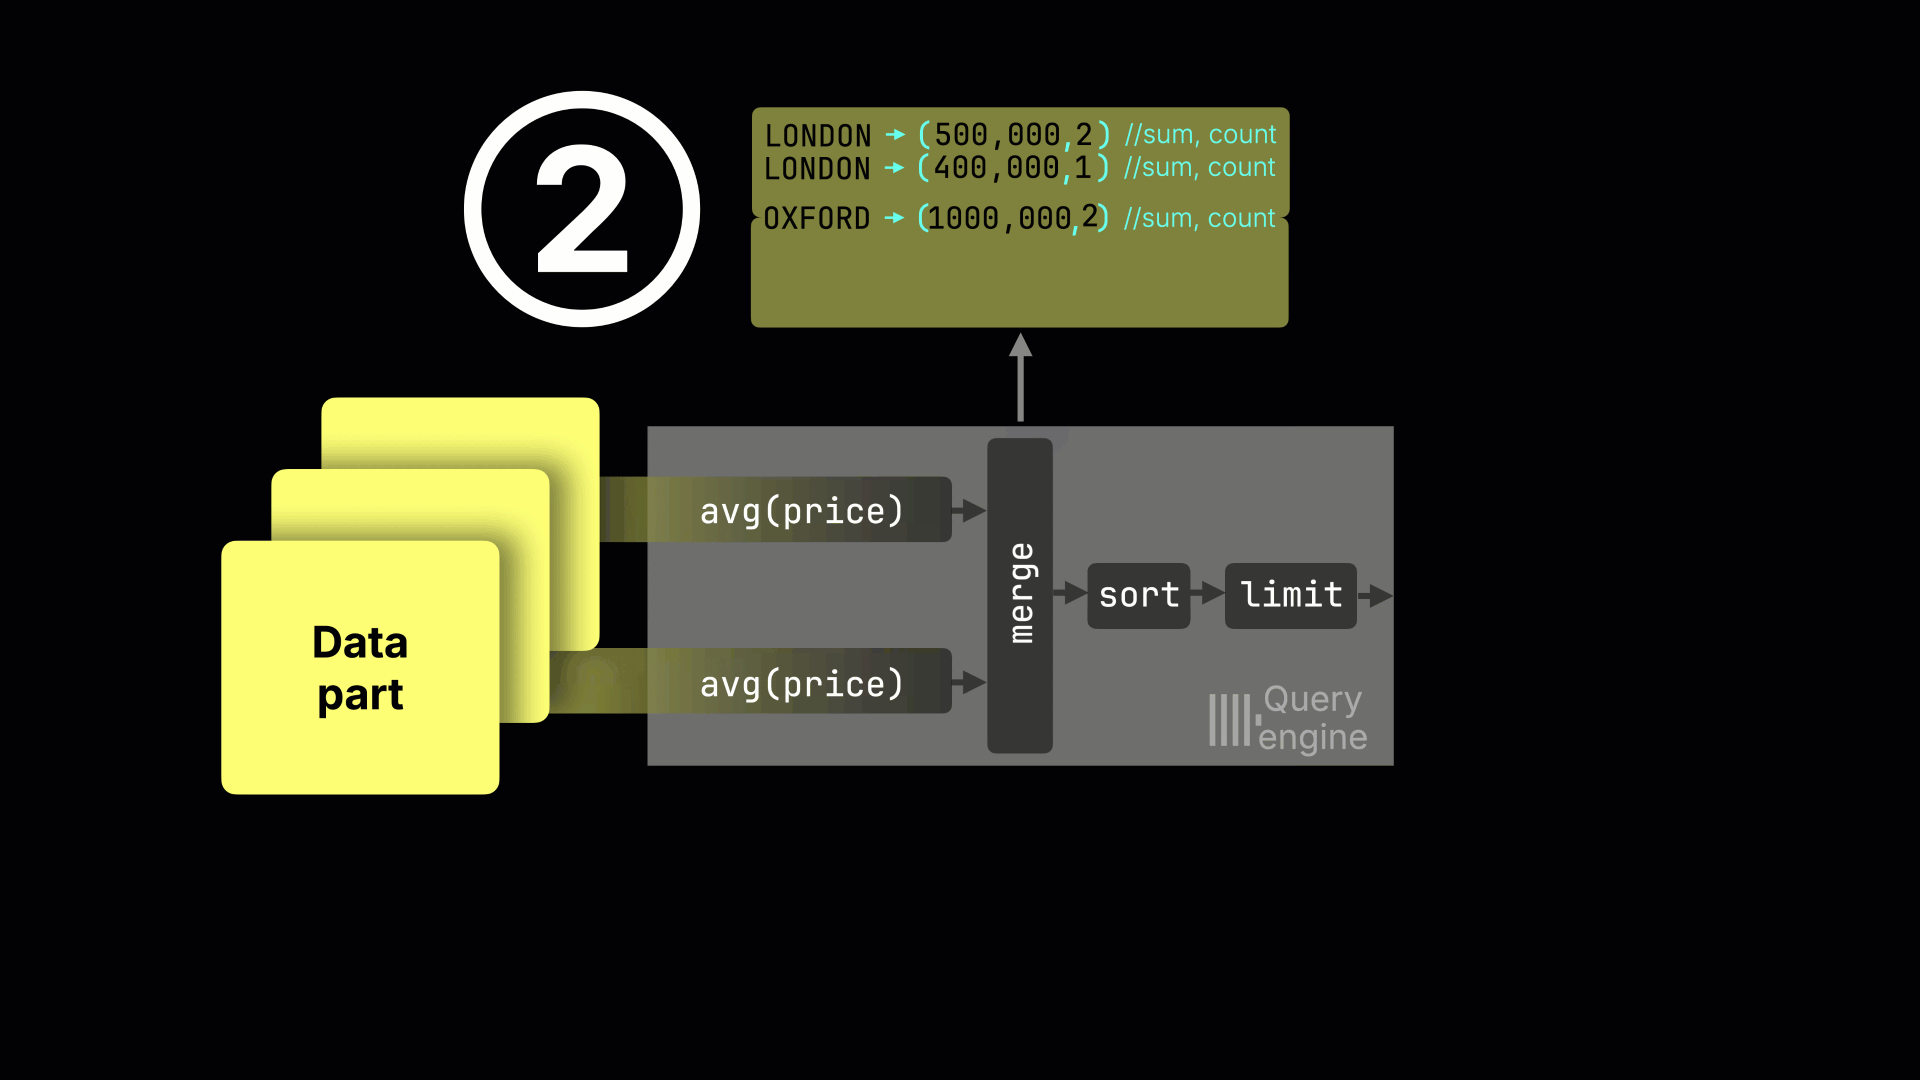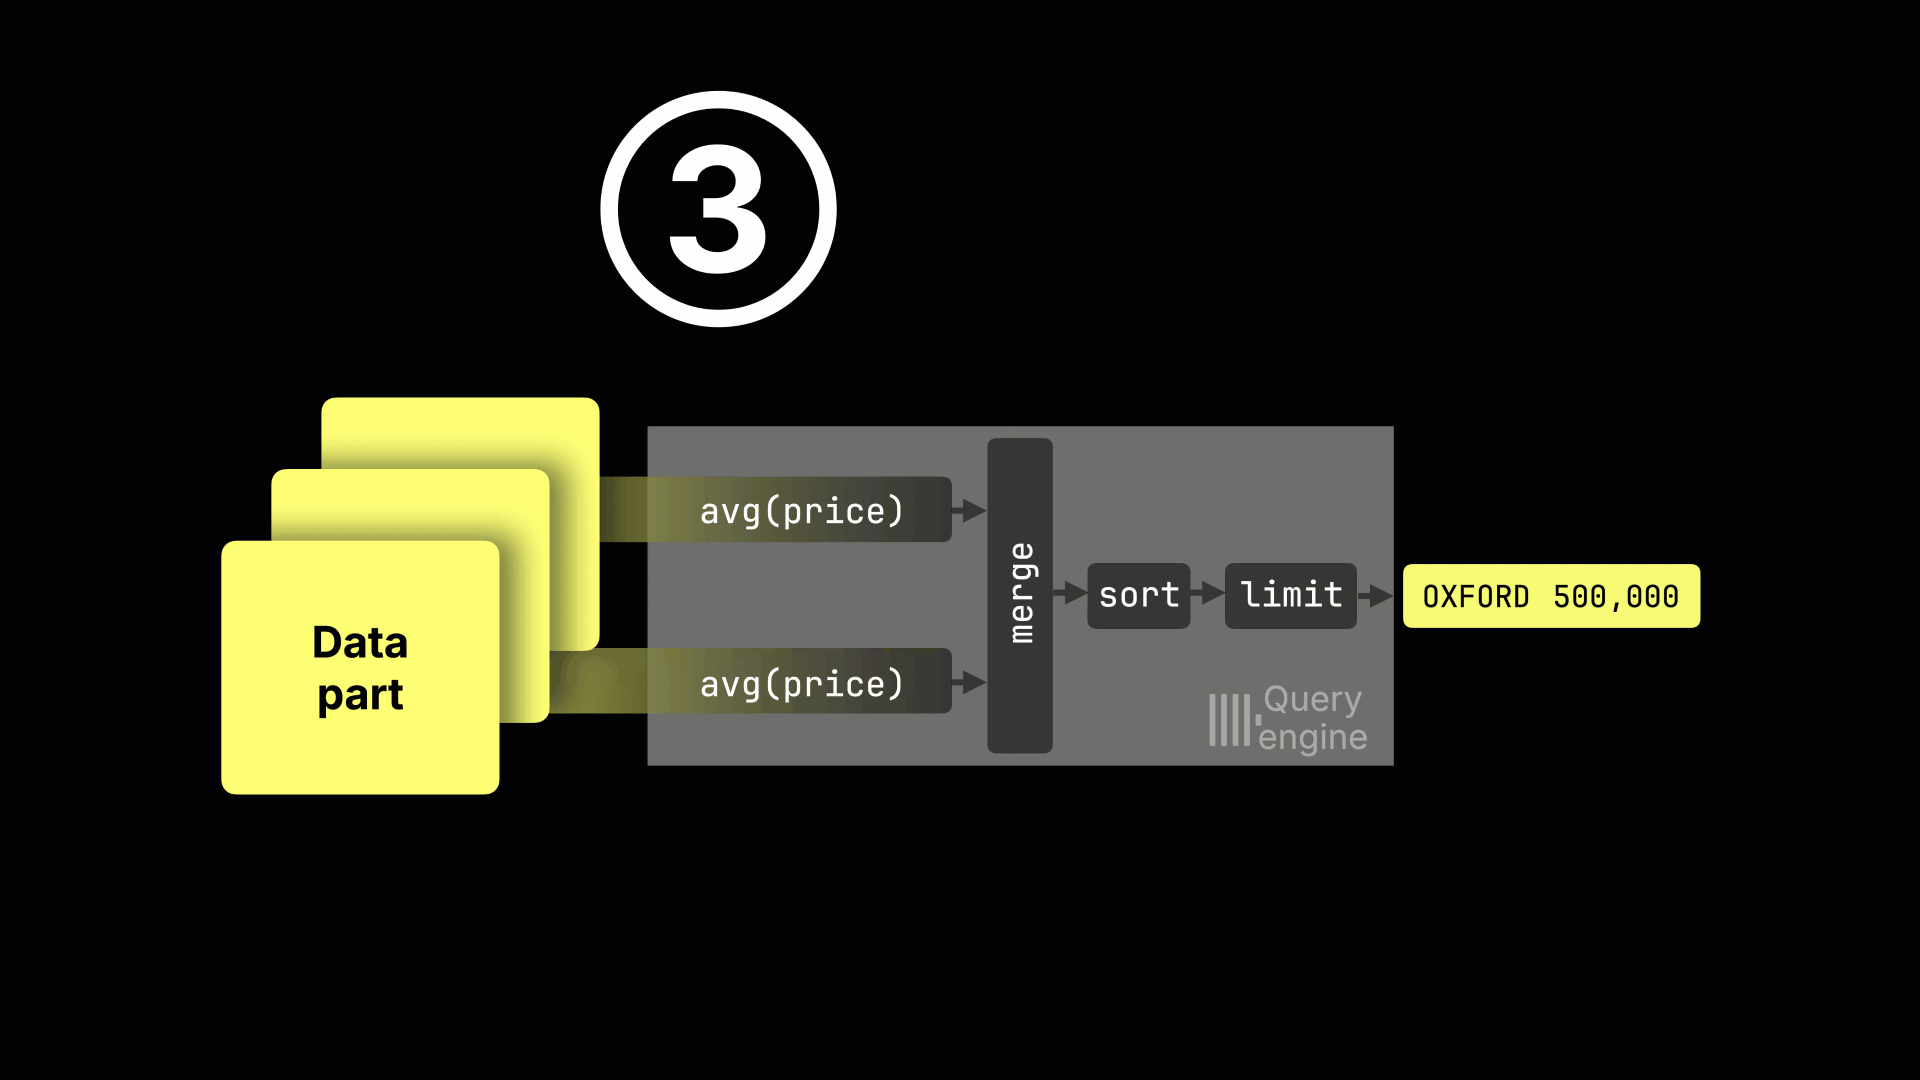
① 各ストリームが独自のハッシュテーブルを構築
-
ストリーム 1: London → (sum=500k, count=2); Oxford → (sum=600k, count=1)
-
ストリーム 2: Oxford → (sum=400k, count=1); London → (sum=400k, count=1)
(実際にはすべてのストリームが並列に実行されますが、アニメーションでは分かりやすさのために順次表示しています。また、ハッシュテーブルも簡略化しています。実際の実装では、集計状態が割り当てられて更新される共有メモリアリーナへのポインタを保持しています。)
② 部分結果をマージ
合計値とカウントが結合され、全体の結果になります。
-
Oxford: (600k+400k) / (1+1) = 500k
-
London: (500k+400k) / (2+1) = 300k
なぜ単純に平均値の平均を取らないのか?
ストリーム 1 の London の値が 250k で、ストリーム 2 の London の値が 400k だった場合、単純に平均すると 325k になってしまい誤った結果になります。合計値とカウントをマージすることで、ClickHouse は London に対して正しい 300k を導き出すことができます。
③ ソートと LIMIT の適用
マージされたグループがソートされ、LIMIT が適用されて、最終結果が返されます。
洗練された並列処理
要するに、部分状態は独立性と正確性の両立を可能にします。
-
任意のクエリパイプラインストリームが任意の行を集計できるため、独立性が保たれます。
-
マージ処理によって常に正しい最終結果が生成されるため、正確性が保たれます。
これは極めてシンプルで優れたアイデアです。妥協のない並列化。これこそが ClickHouse の GROUP BY の真髄です。
GROUP BY 部分状態のためのメモリ
グループ化キーのカーディナリティ (例: 町の数) がピーク時のメモリ使用量を左右します。個別値が多くなるほど、クエリパイプラインストリームあたりのハッシュテーブルエントリが増加します。
ClickHouse は以下の最適化を提供しています。
-
グループ化キーがテーブルのソートキーのプレフィックスを構成している場合、行をスキャンして順序どおりに集計できます。この場合、各ストリームは一度に少数のグループの行を処理し、1 つのグループが完了するとその結果をパイプラインの前方へフラッシュします。これによりメモリ使用量は低く抑えられますが、並列性が制限されるため、デフォルトでは無効になっています。
-
メモリが不足した場合、ClickHouse は部分状態をディスクにスピル (退避) します。
メモリ使用量は、選択された集計関数にも左右されます。
-
ごく小さな部分状態 →
sum、count、min、max、avg(数値 1 つか 2 つのみ) -
中規模の部分状態 →
groupArray(サイズ制限付き配列) -
大きな部分状態 →
uniqExact(型に応じて生の個別値またはそのハッシュを保持し、和集合によってマージ)
これらの違いは、メモリフットプリントとノード間でのスケーラビリティの双方に影響を与えます。この点については後ほど改めて取り上げます。
これらすべての最適化が積み重なることで、GROUP BY のパフォーマンスはコア数およびノード数に応じてスケールするようになります。実際に測定してみましょう。
測定方法
結果の透明性と再現性を保つため、すべてのベンチマークで使用した構成を以下に示します。単一ノードから parallel replicas を備えたマルチノードクラスターまで、さまざまなサイズの ClickHouse Cloud サービスを実行しました。スケーリングの効果を正確に切り分けて比較できるよう、各テストでは同一のデータセットとクエリを使用しています。
すべてのベンチマークは完全に再現可能です。コードは GitHub の公開リポジトリで公開されており、任意のデータセットやクエリセットに対して実行できます。このフレームワークは垂直スケーリング (ノードあたりのコア数増加) と水平スケーリング (ノード数増加) の両方をサポートし、英国の不動産価格データセットの大規模生成ツールも含まれています。
この生成ツールは既存の行を複製します。作為的に聞こえるかもしれませんが、テストクエリの GROUP BY キー (county、town、district) は同一のままであるため、実データと同様に自然な形でスケールします (販売される家が増えたからといって、Oxford が新しい町になるわけではありません)。
以下の環境を使用しました。
-
AWS us-east-2 上で動作する、コンピュートノード数を変更可能な ClickHouse v25.6 の ClickHouse Cloud サービス
-
clickhouse-client経由でベンチマークを駆動するための、専用の EC2 m6i.8xlarge (32 vCPU、128 GB RAM、同リージョン) インスタンス
各構成で各クエリを 10 回実行しました。追跡した指標は以下のとおりです。
-
cold — 初回実行 (キャッシュ無効)
-
hot — キャッシュが効いた状態での最速実行
-
hot_avg — キャッシュが効いた状態での実行の平均値
わかりやすさを重視し、ここでは hot の結果のみを掲載しています。リポジトリには parallel replicas の実行に関する詳細情報に加え、完全なデータセット (cold、hot、hot_avg) が用意されています。
検証環境が明確になったところで結果を見ていきましょう。まずは、単一ノードで GROUP BY が追加コアをどれだけ効率的に活用できるかを示す垂直スケーリングから確認します。
GROUP BY の垂直スケーリング (ノードあたりのコア数を増やす)
スケールアップをシンプルに: すべてのベンチマークは、コンピュートとストレージが分離された ClickHouse Cloud で実行されました。そのため、ノードの CPU コア数を増やすリサイズは極めて容易であり、ClickHouse は自動的に GROUP BY をそれらのコアに並列分散します。コアが増えるほど、クエリは高速化します。
単一ノードでの並列処理はスケールするか?
下のグラフは、100 億行に対するサンプルの GROUP BY クエリが、コア数の増加に伴って単一ノード上でどのようにスケールするかを示しています。
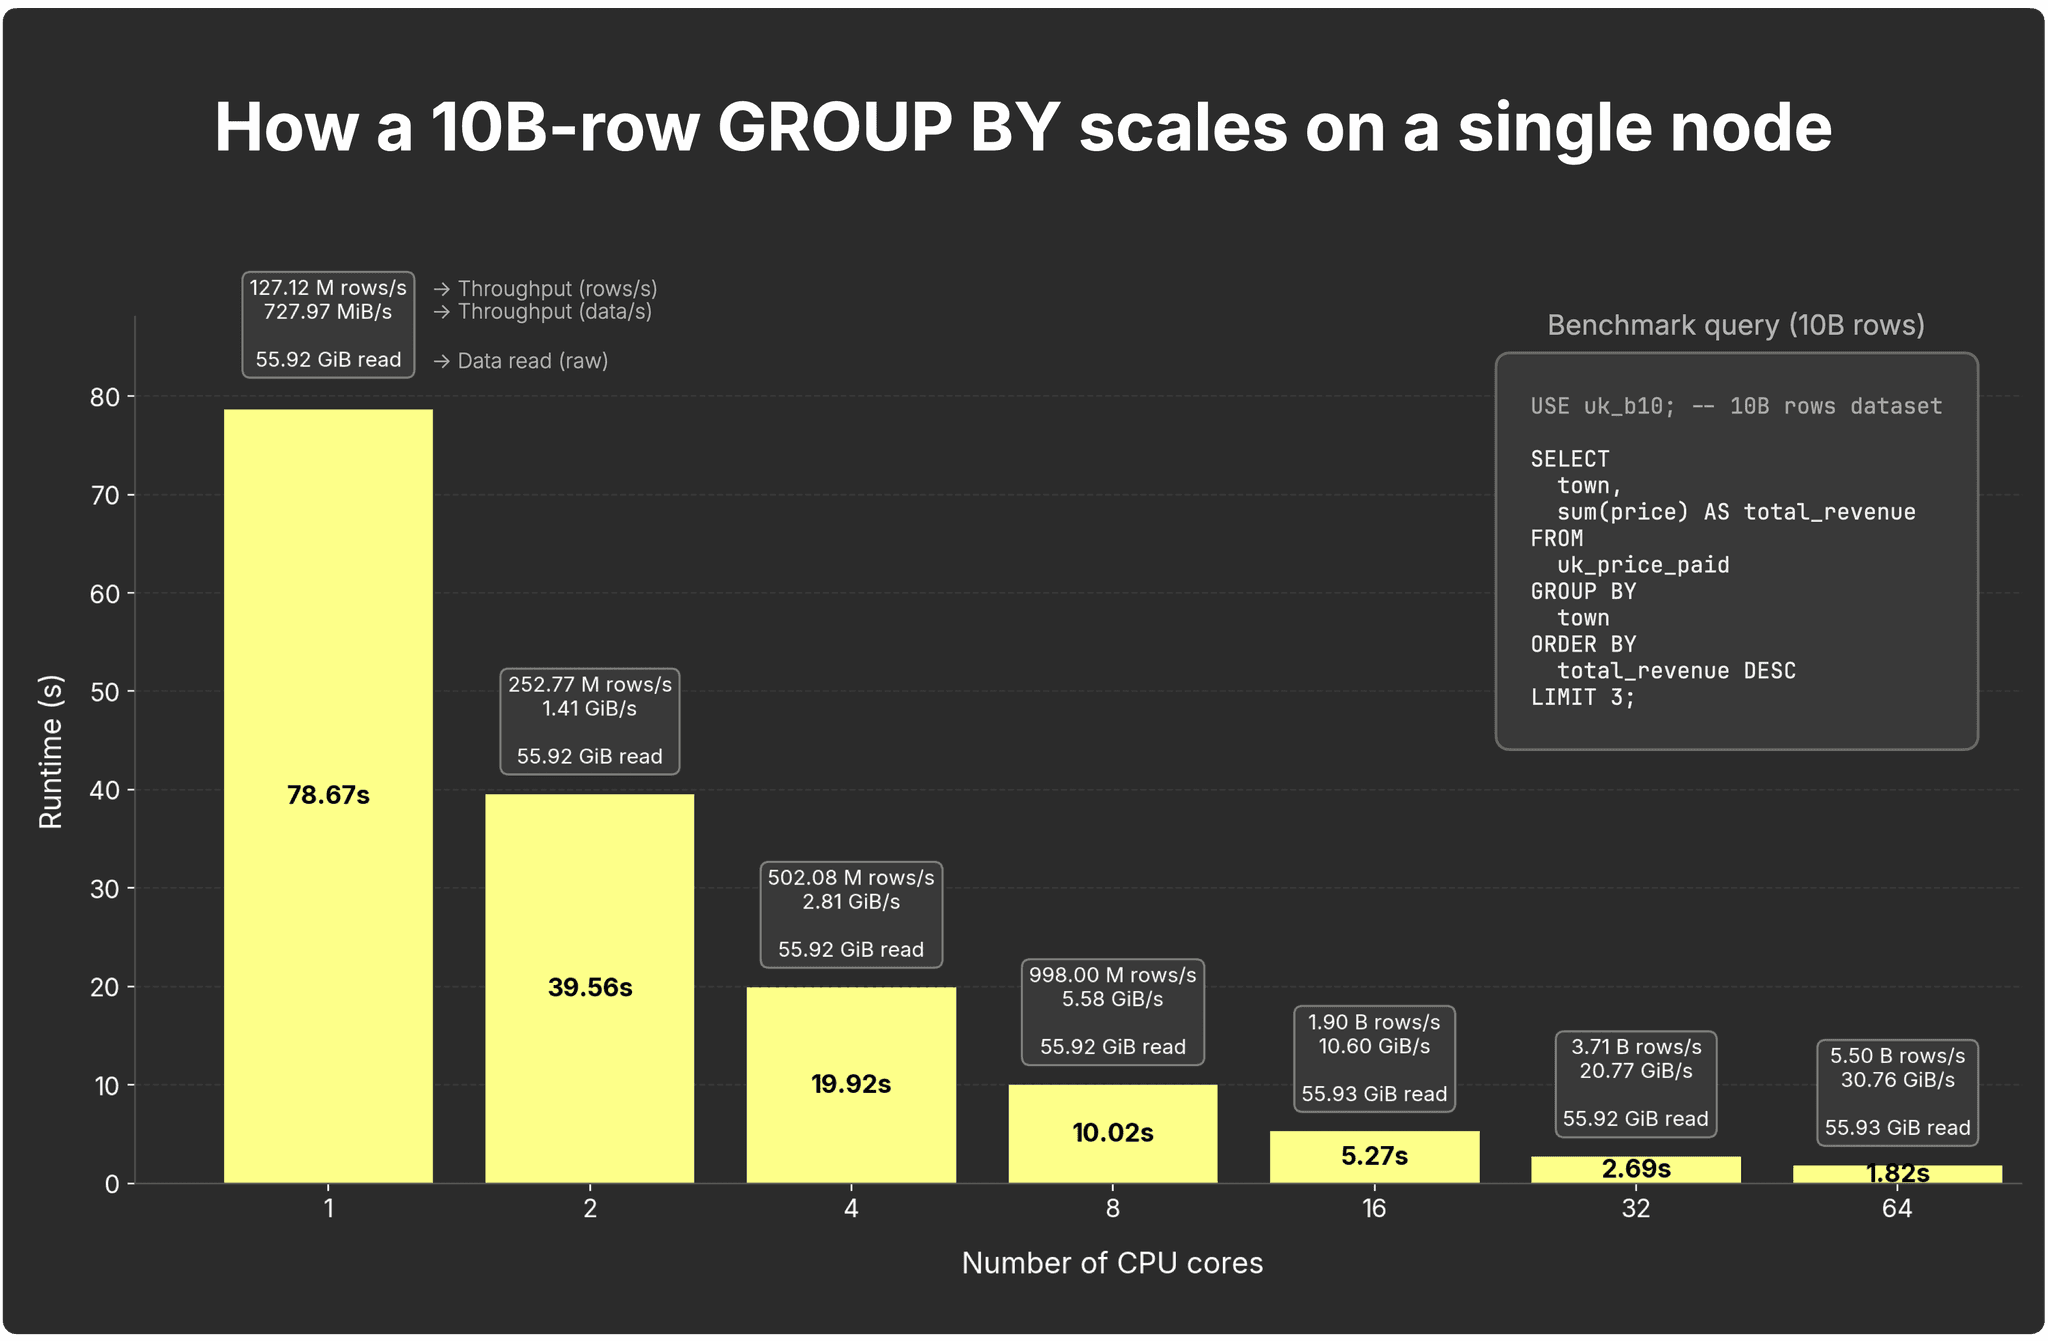
完全な結果 (行数、バイト数、タイミングの詳細な内訳を含む) は、当社のベンチマーク GitHub リポジトリのこちらからご確認いただけます。
1 コアの場合、クエリはエンドツーエンドで約 1 億 2,700 万行/秒 (~728 MiB/s)、78.7 秒で完了します。コア数を倍にすると実行時間はほぼ半減し、スループットが向上します。
- 2 コア → 39.6 秒、毎秒 2 億 5,300 万行 (~1.4 GiB/s)
- 4 コア → 19.9 秒、毎秒 5 億 300 万行 (~2.8 GiB/s)
- 8 コア → 10.0 秒、毎秒 9 億 9,800 万行 (~5.3 GiB/s)
- 16 コア → 5.3 秒、毎秒 19 億行 (~10.6 GiB/s)
- 32 コア → 2.6 秒、毎秒 37 億行 (~20.7 GiB/s)
- 64 コア → 1.9 秒、毎秒 55 億行 (~30.6 GiB/s)
要するに、GROUP BY はコア数に対してほぼ線形にスケールします。各コアが全体データのうち自身のスライスに対して部分状態を構築し、エンジンがそれらを効率的にマージします。
垂直スケーリングが限界を迎える場所
次のクエリは、100 億行のデータセットに含まれるすべての (county, town, district) の組み合わせについて集計を計算します。
-
COUNT() – 販売された不動産の件数
-
SUM(price) – 総販売額
-
AVG(price) – 平均販売価格
総販売額でソートし、上位 10 の地域、つまり最も収益性の高い地域をそれぞれ返します。
USE uk_b10; -- 10B rows dataset

SELECT
    county,
    town,
    district,
    formatReadableQuantity(count())    AS properties_sold,
    formatReadableQuantity(sum(price)) AS total_sales_value,
    formatReadableQuantity(avg(price)) AS average_sale_price
FROM uk_price_paid
GROUP BY
    county,
    town,
    district
ORDER BY sum(price) DESC
LIMIT 10
SETTINGS
enable_parallel_replicas = false;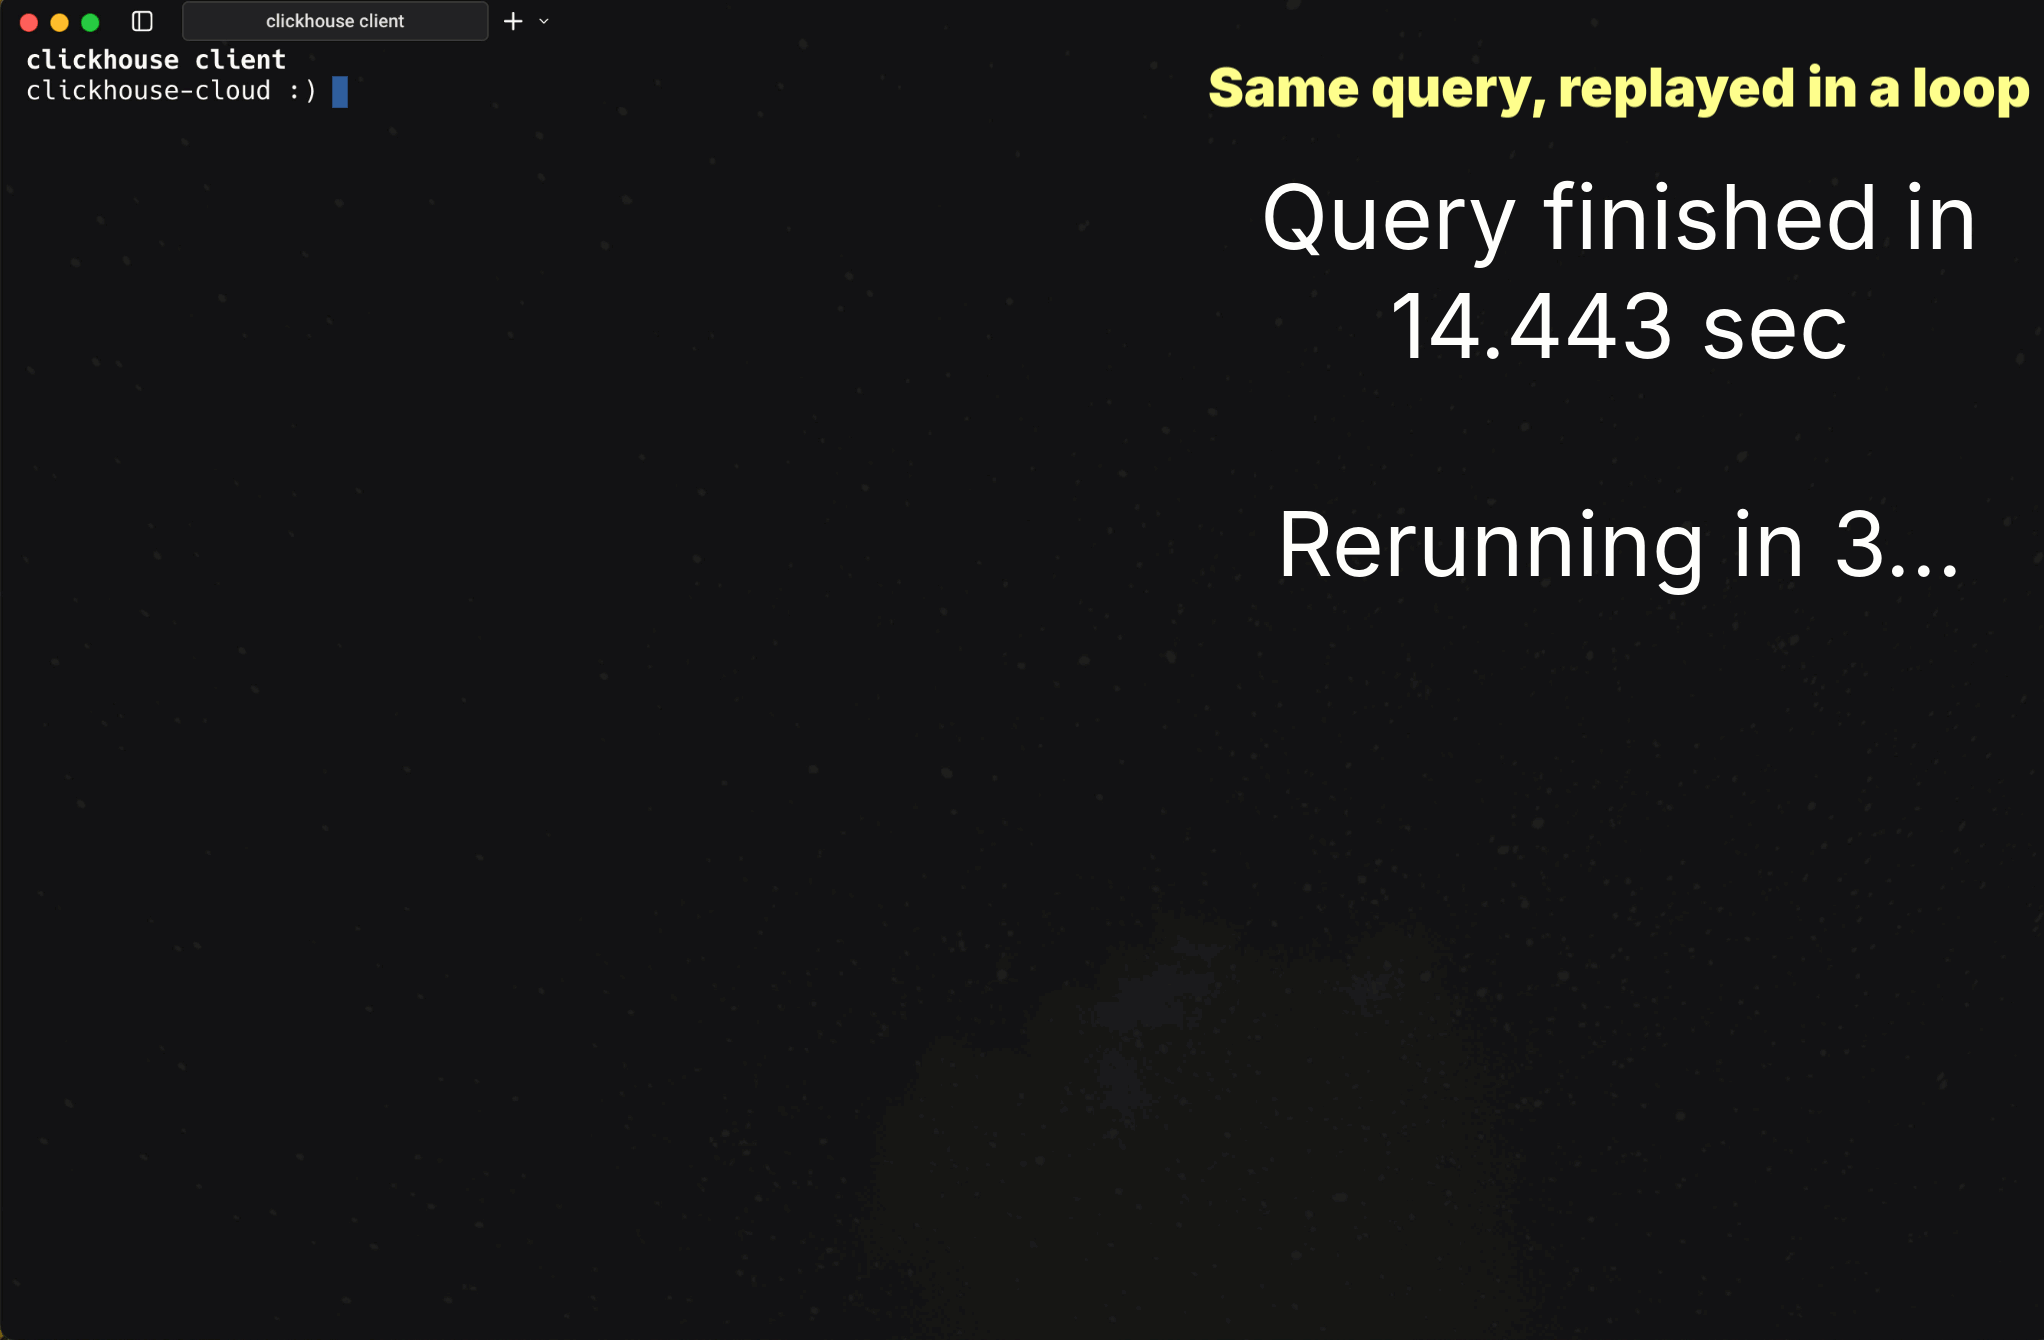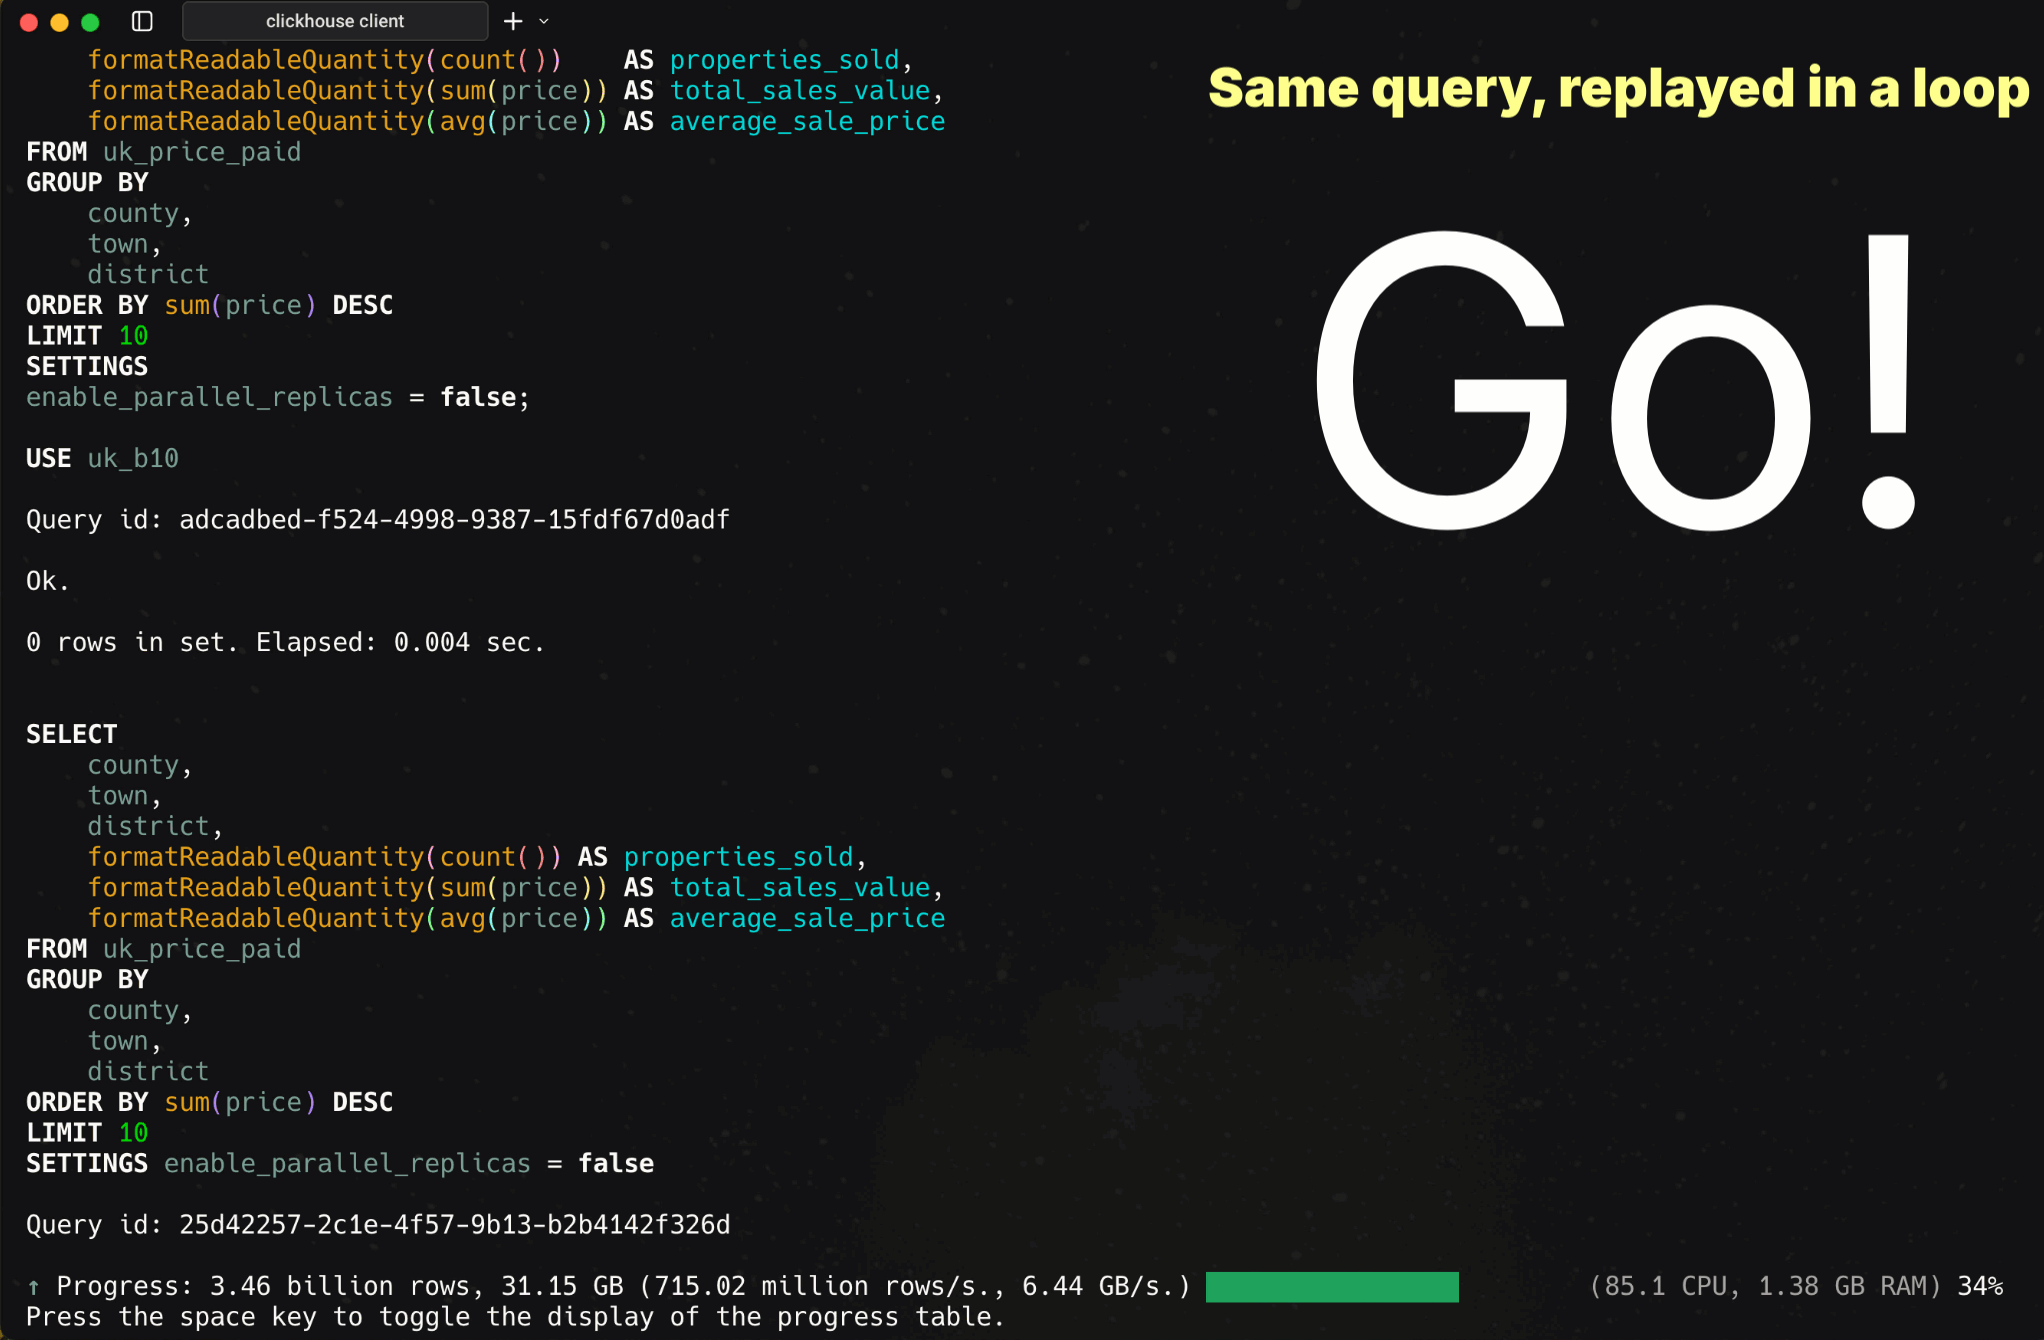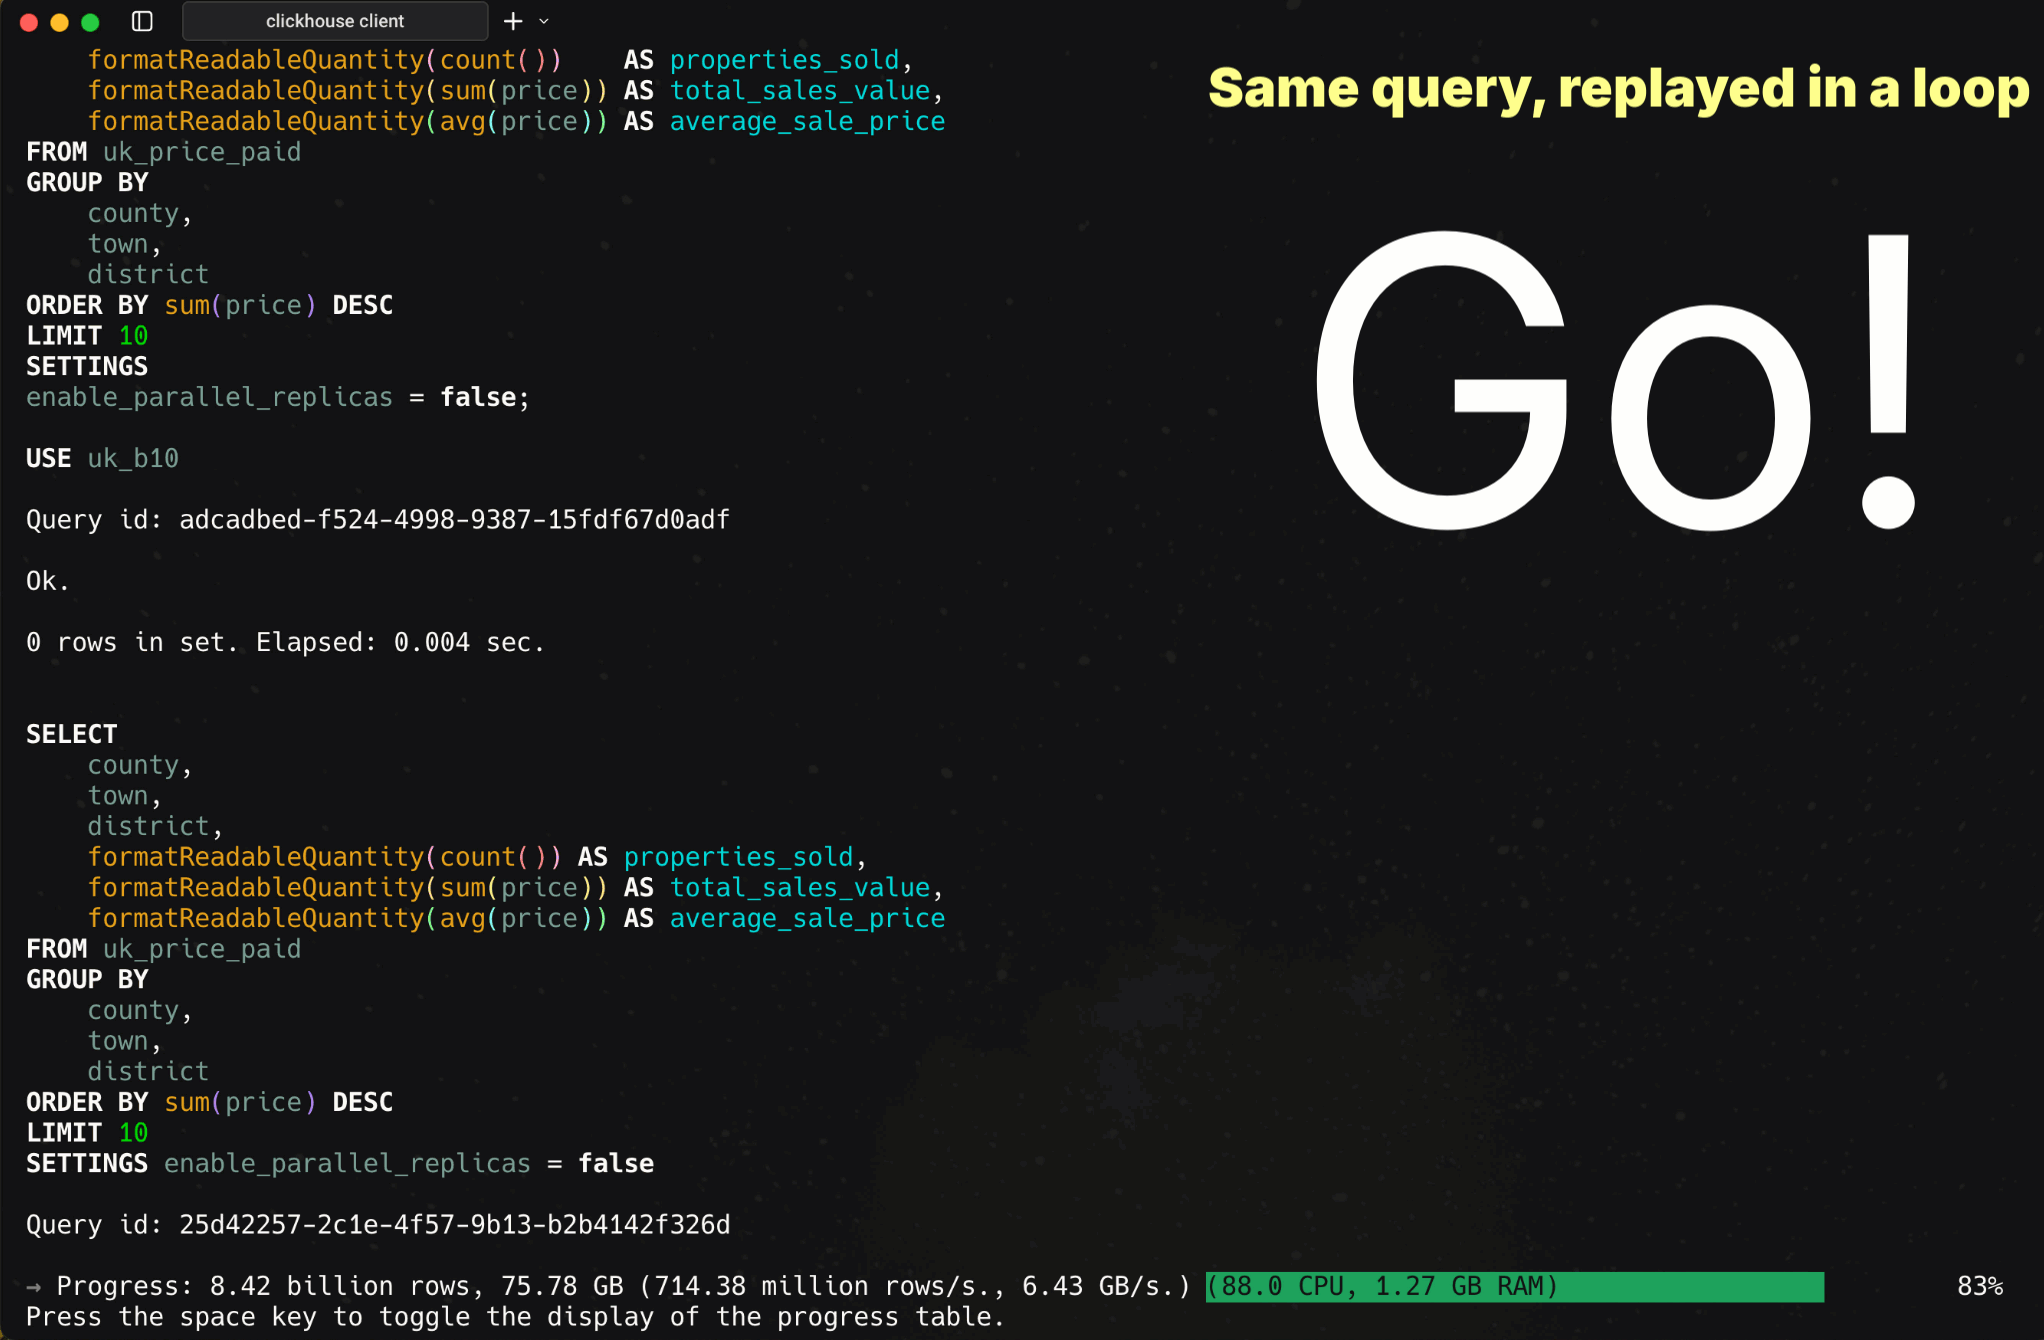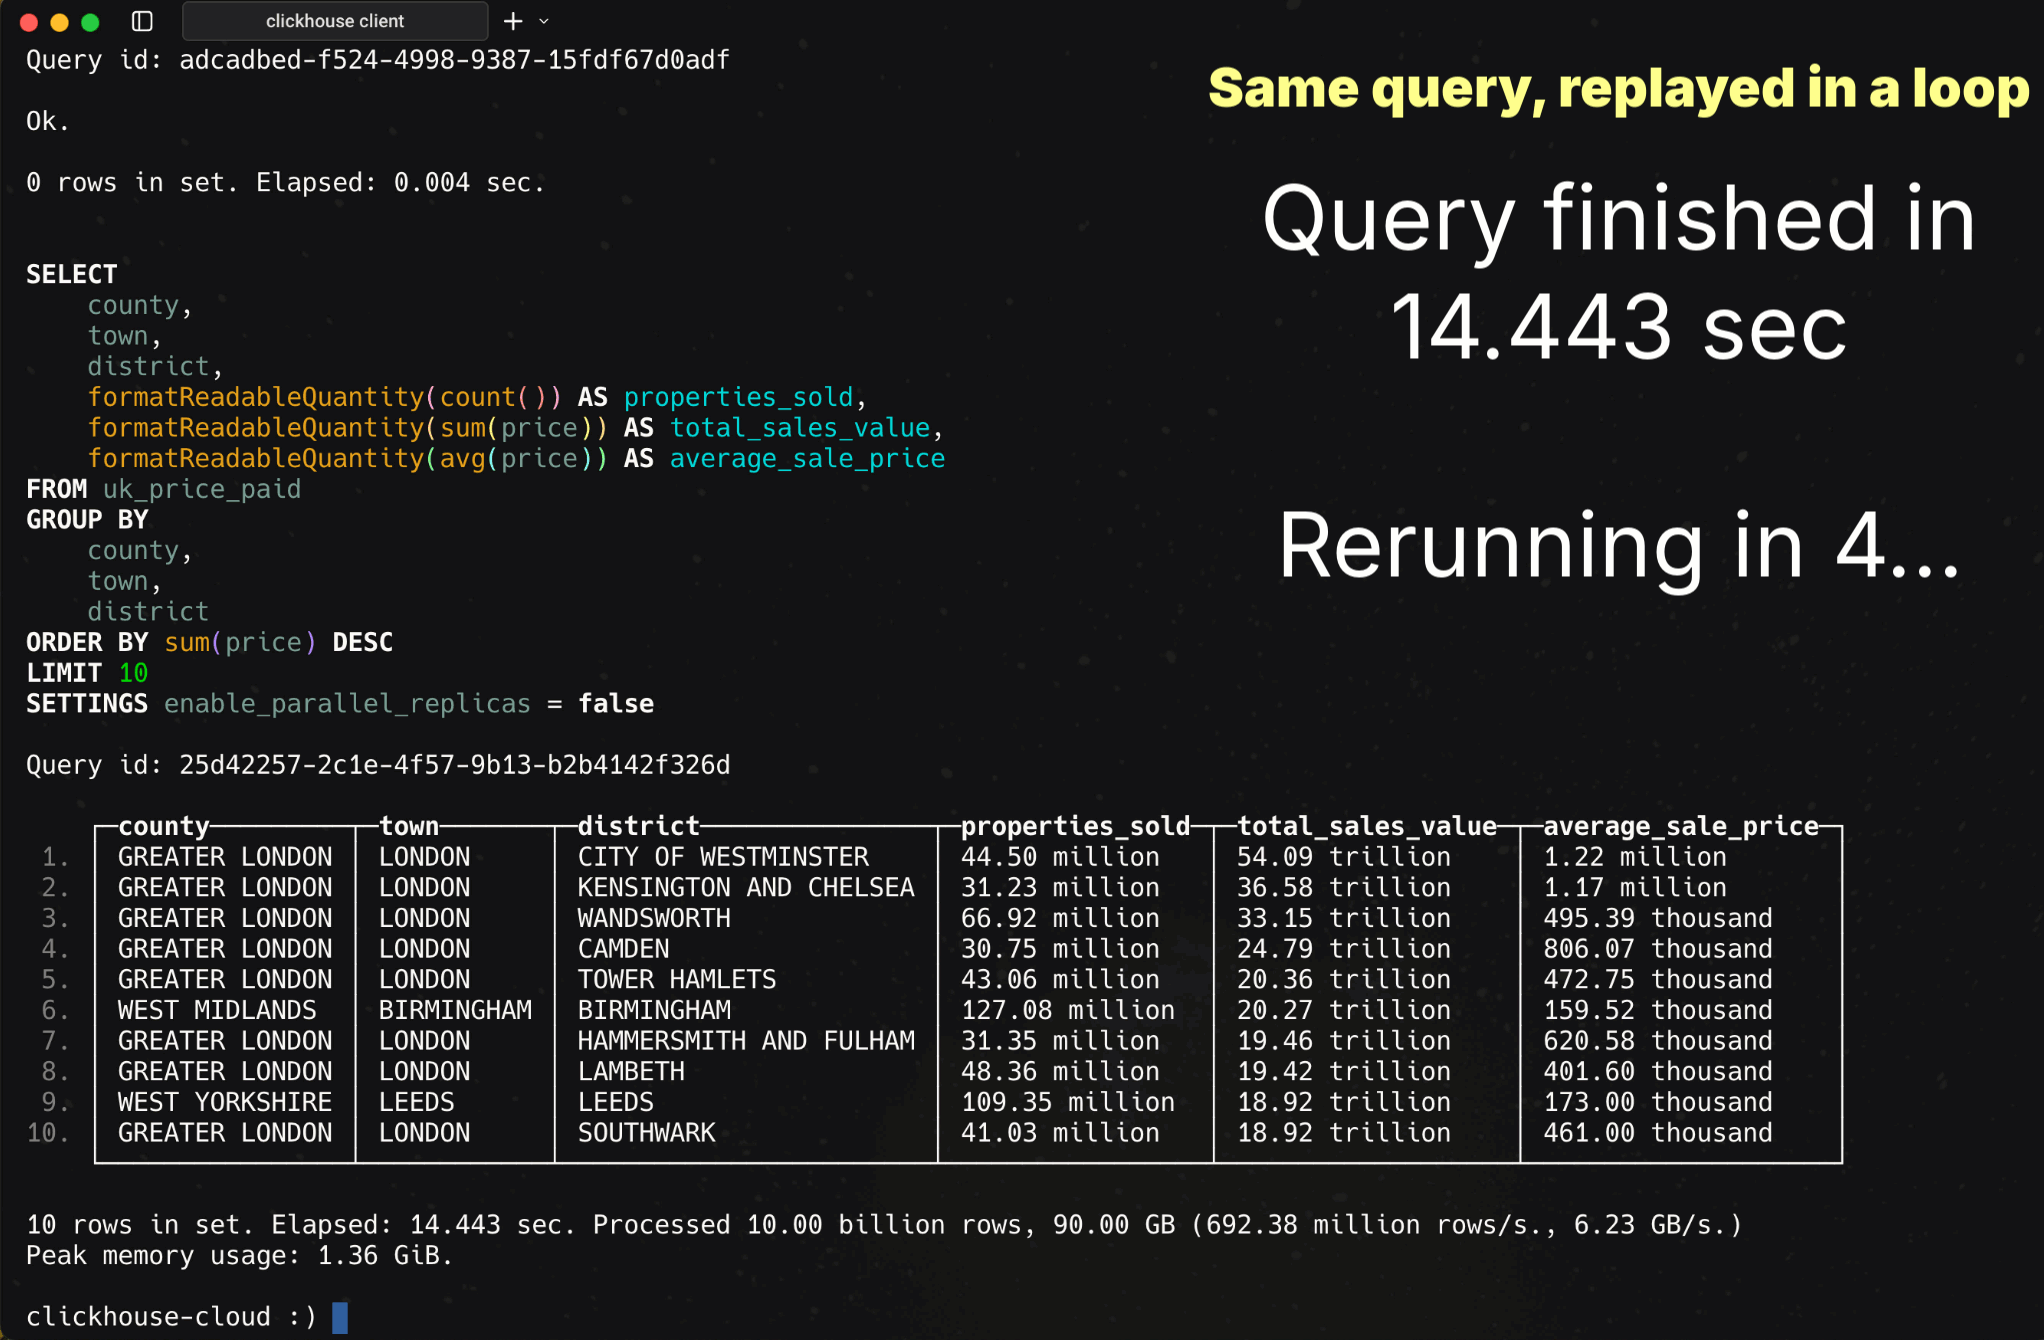
最大スペックの 89 コアノードにおいて、実行時間は 14.4 秒 (毎秒約 6 億 9,200 万行) でした。まずまずの速度ですが、インタラクティブとは言えません。ダッシュボードやアドホック分析において 14 秒という待ち時間は長く感じられます。
靴紐を結ぶ、赤信号を待つ、あるいは電子レンジでピザを温め直すくらいの時間です (イタリアの読者の皆さん、ごめんなさい)。
このようにカーディナリティが固定されているワークロード (英国で新しい州や町が次々と増えるわけではありません) では、インクリメンタルなマテリアライズドビューを利用するのが賢明な解決策です。地理情報ごとに事前集計しておくことでデータ量が大幅に削減され、ミリ秒単位の応答時間が保証されます。
マテリアライズドビュー: 部分状態をディスクに保存する
ClickHouse のインクリメンタルマテリアライズドビューは、部分集計状態のアイデアを拡張したものです。クエリ実行時に GROUP BY を再計算する代わりに、挿入時に部分集計状態をキャプチャしてデータパートに保存し、バックグラウンドマージでそれらを段階的に結合させます。バックグラウンドパイプラインで集計処理が常時実行されているようなものです。これについては後続の記事で詳しく取り上げます。
しかし、事前集計が常に実行可能とは限りません。オブザーバビリティではすべてのログ行が重要であり、アドホックなクエリがあらゆるディメンションにまたがって行われる可能性があります。グループ化のカーディナリティが固定されていない場合も同様です。そうなると残された手段は力技 (ブルートフォース) しかありません。 たとえ 89 コアを備えた巨大なマシンであっても 1 台では足りない場合、唯一の選択肢はスケールアウトです。そこで parallel replicas の出番となります。
GROUP BY の水平スケーリング (parallel replicas を使用)
スケールアウトをシンプルに: ClickHouse Cloud ではコンピュートとストレージが分離されているため、新しいコンピュートノードを即座に稼働させることができます。
物理的にデータをシャーディングする代わりに、ClickHouse Cloud 内のすべてのノードはオブジェクトストレージ内の制限のない単一のシャードから読み取りを行い、仮想レプリカとして機能します。parallel replicas 機能を使用すると、これらのノードは同一クエリに対する追加の並列処理ストリームへと変貌します。ノードが増えるほど、クエリは高速化します。単一のコーディネーターが全体を統括し、実行時にノード間でデータを動的にスライスします (いわばオンデマンドの仮想シャーディングです)。
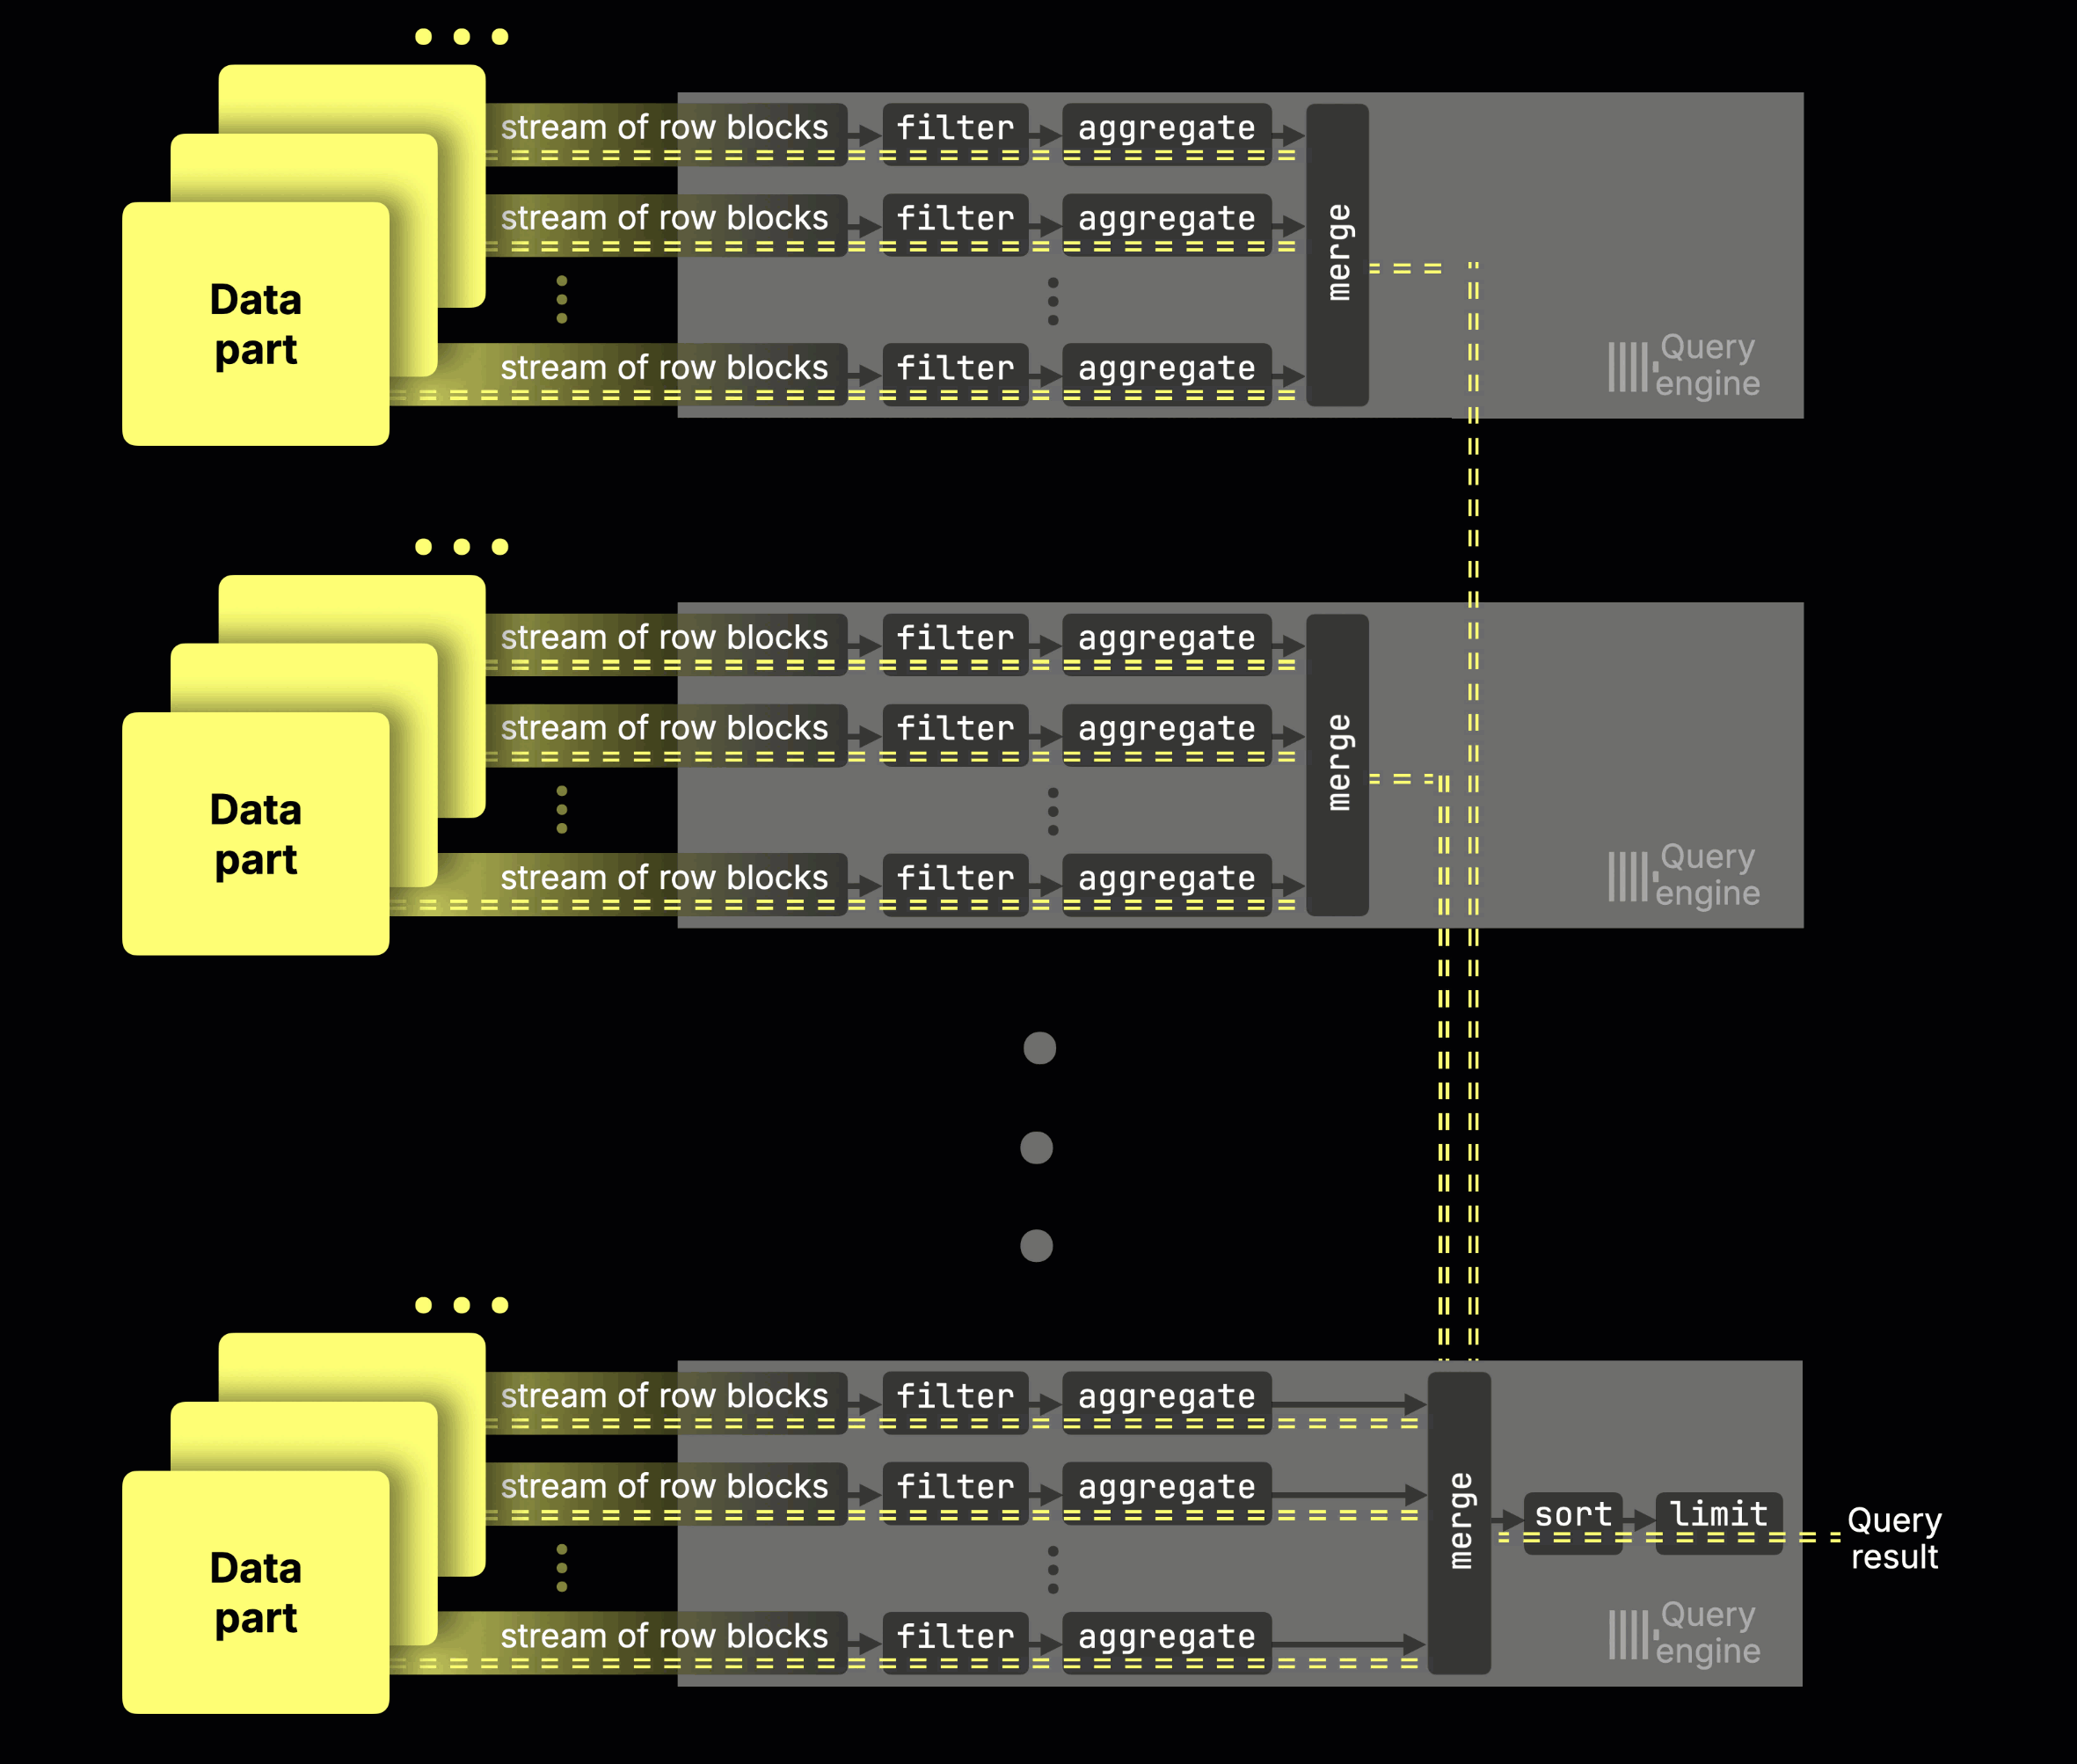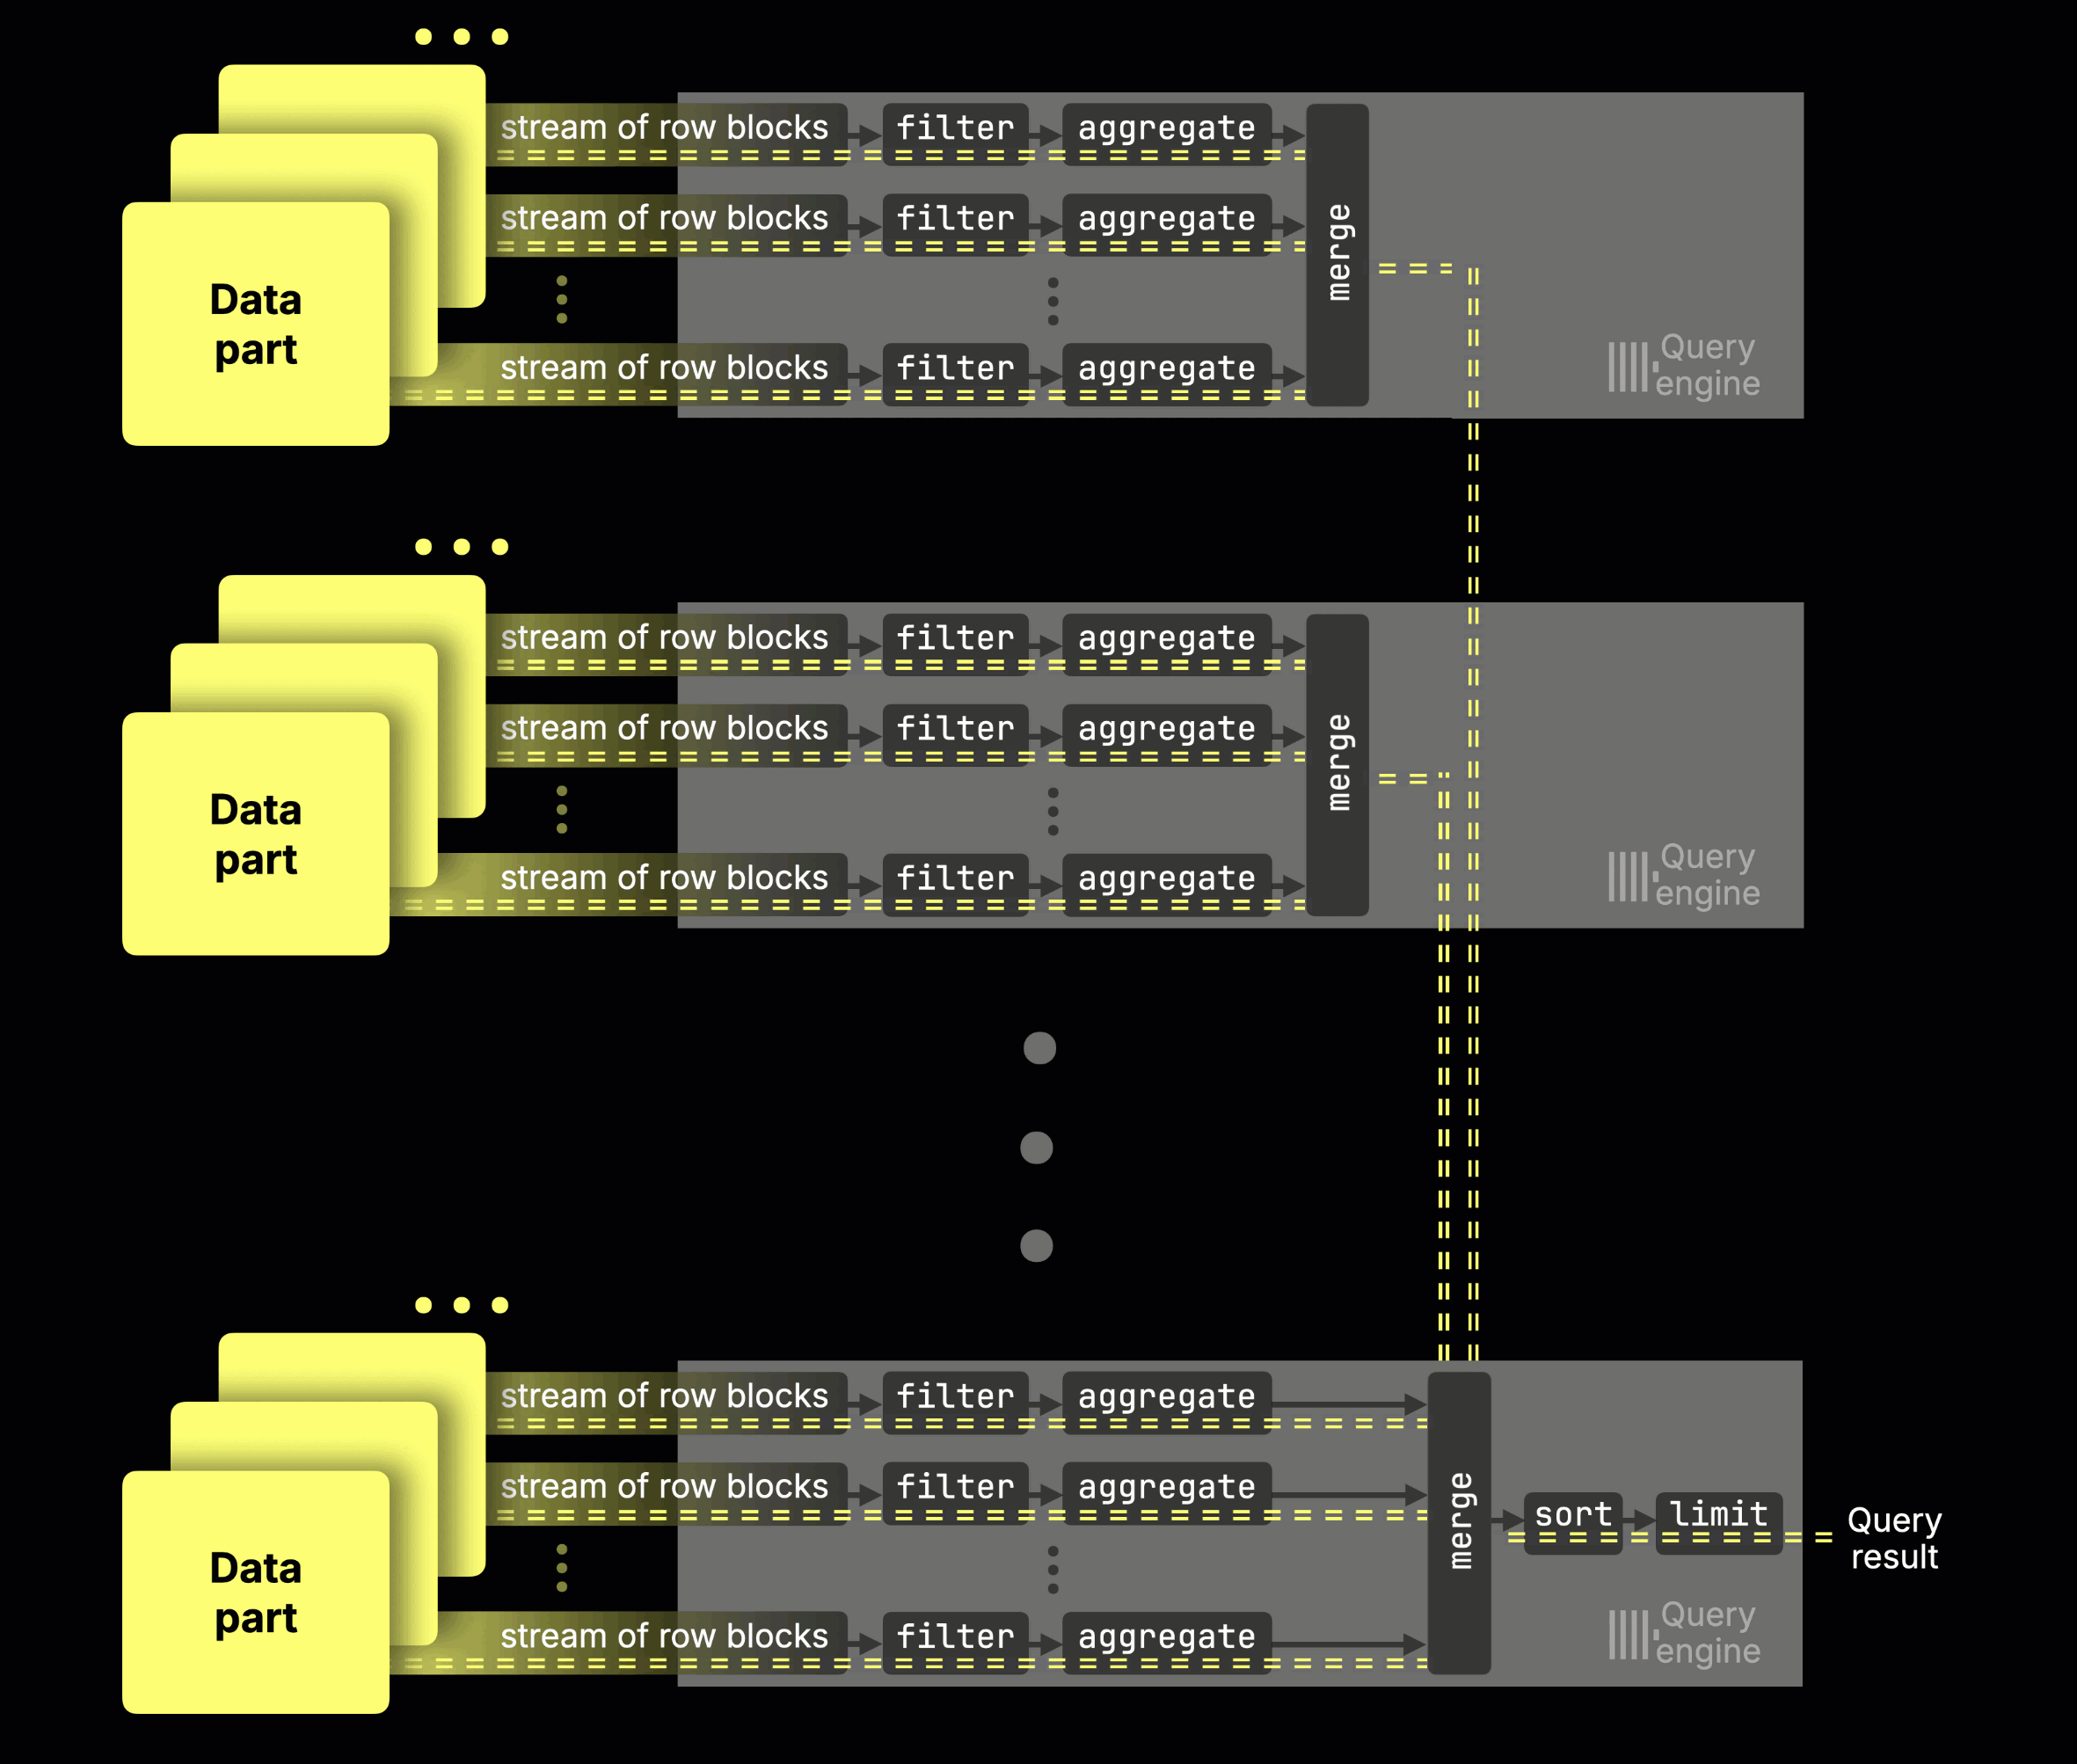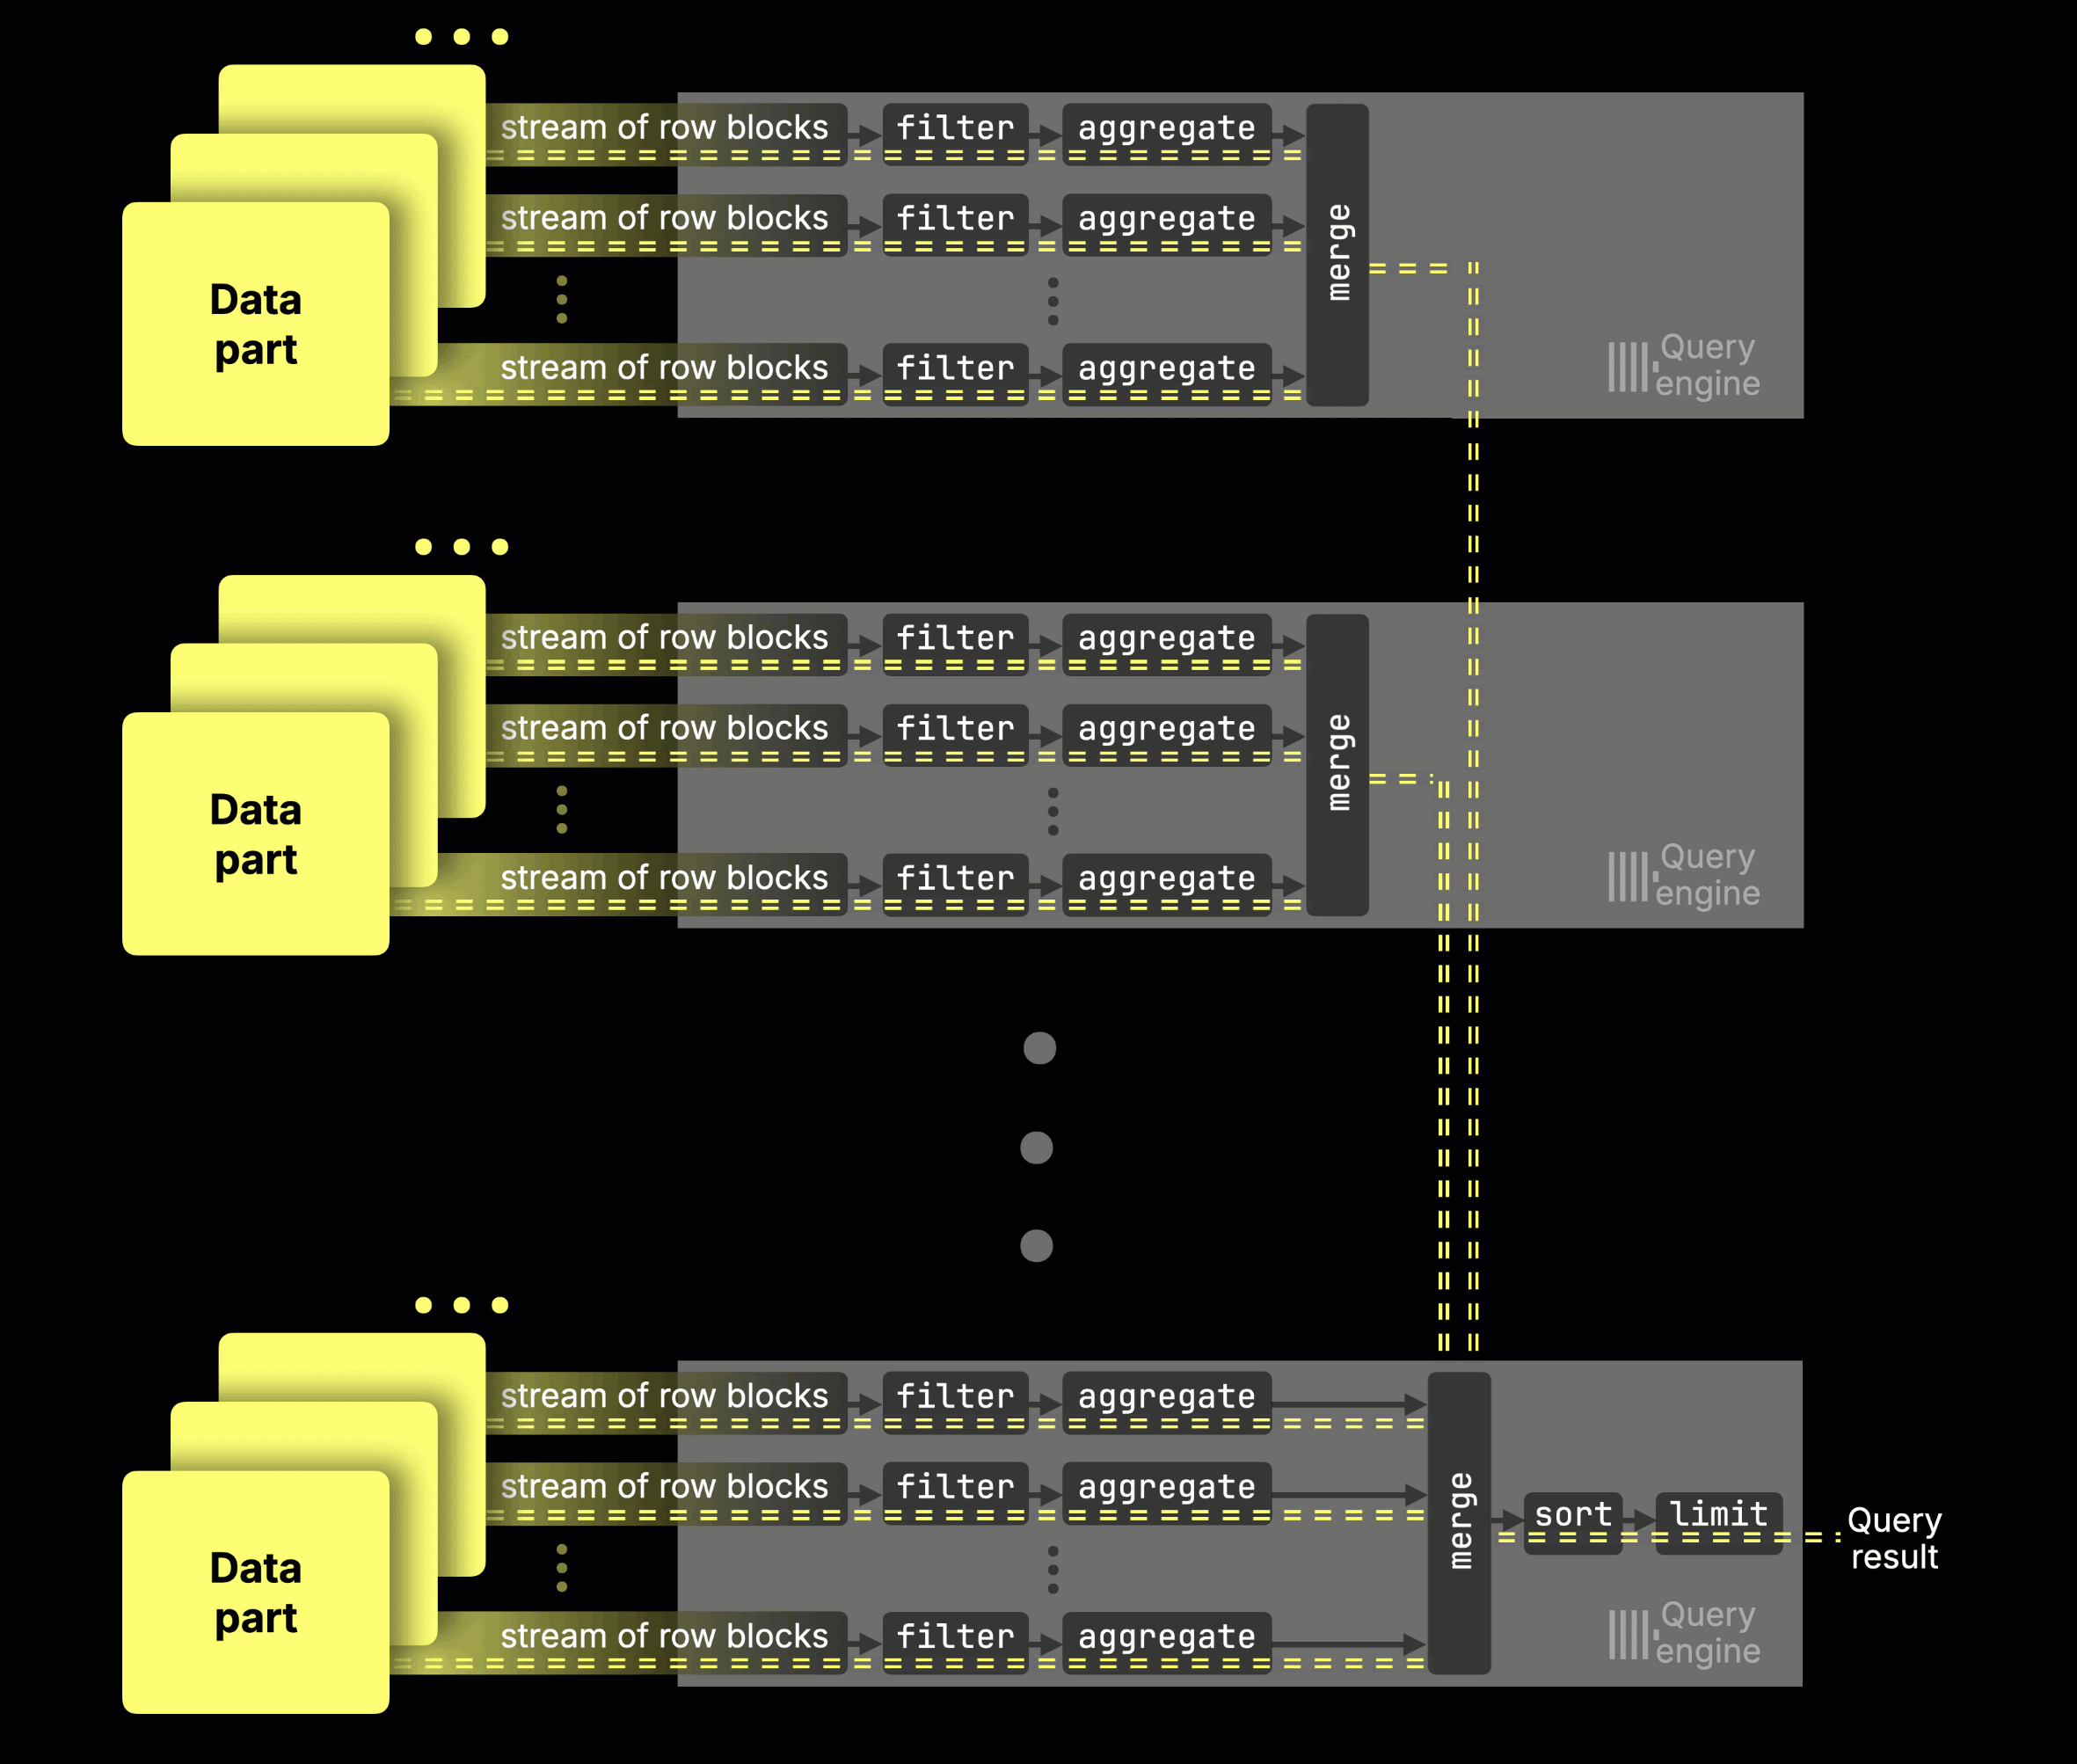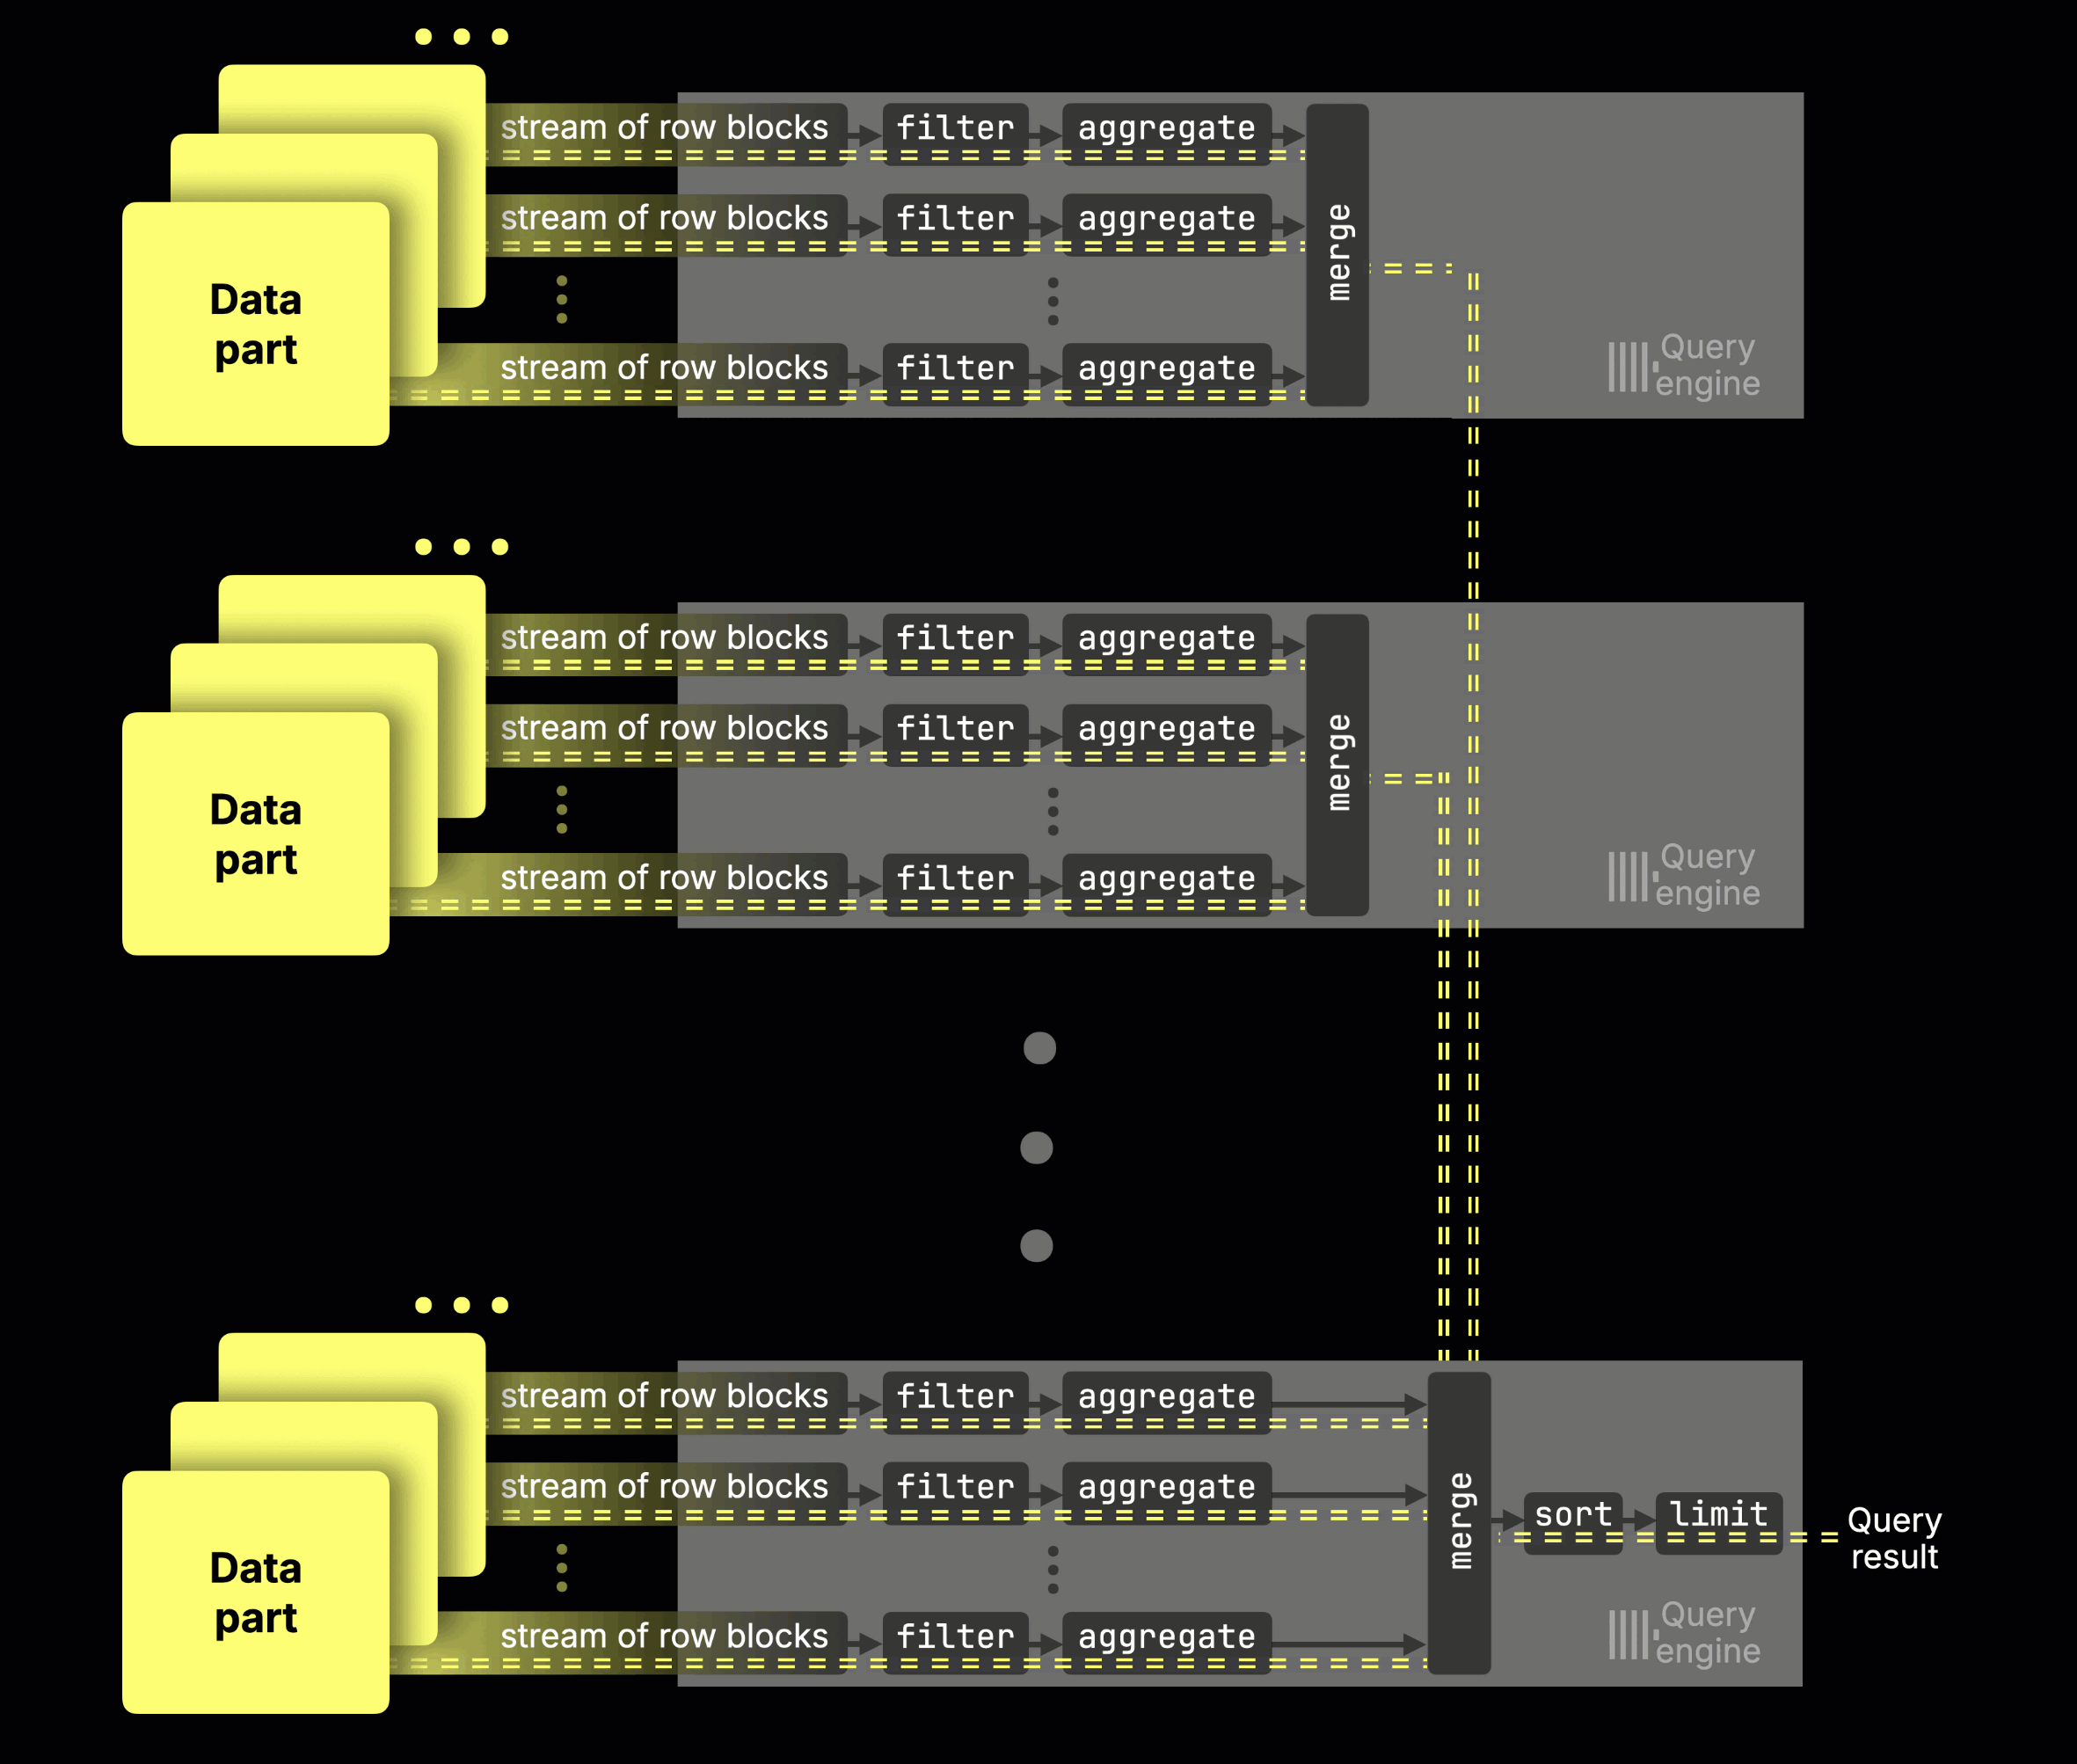
(この機能は現在 ClickHouse Cloud でベータ版として提供されています。本日時点でも一部のワークロードで有効化でき、まもなく GA となる予定です。)
parallel replicas を使用しない場合、GROUP BY クエリは単一ノードのコア (この検証環境では 89 コア) しか使用できませんでした。parallel replicas を有効化すると、すべてのノードのコアが同一のクエリに参加します。
-
デフォルトの 3 ノードでも、すでに 89 コアから 267 コアへとスケールします。
-
10 ノードでは 890 コアになります。
-
20 ノードでは 1,780 コアになります。
-
100 ノード以上になれば、単一の GROUP BY を 8,900 コア以上 (および 35,600 GiB 以上の RAM) にファンアウトすることになります。
これはシャーディングもデータの移動も行わずに、ステートレスなコンピュートノードを追加するだけで実現できます。操作はワンクリック (または API 呼び出し 1 回) です。
本記事では 100 ノードまでを対象としています。「どこまでスケールできるのか?」という徹底検証については、parallel replicas が GA になった後の専用記事に譲ることにします。
parallel replicas は、スカラー集計や通常の SELECT も高速化します。スカラー集計 (GROUP BY のない SUM や AVG など) の場合、各コンピュートノードは前述と同様に部分状態を構築、送信、マージします。集計を伴わない SELECT の場合、各ノードがデータを並列処理してサブ結果を送信し、コーディネーターが最終的な SORT や LIMIT を実行します。
レプリカ間での作業分割の仕組み
グラフは、100 億行の GROUP BY がノード間 (各 89 コア) でどのようにスケールするかを示しています。
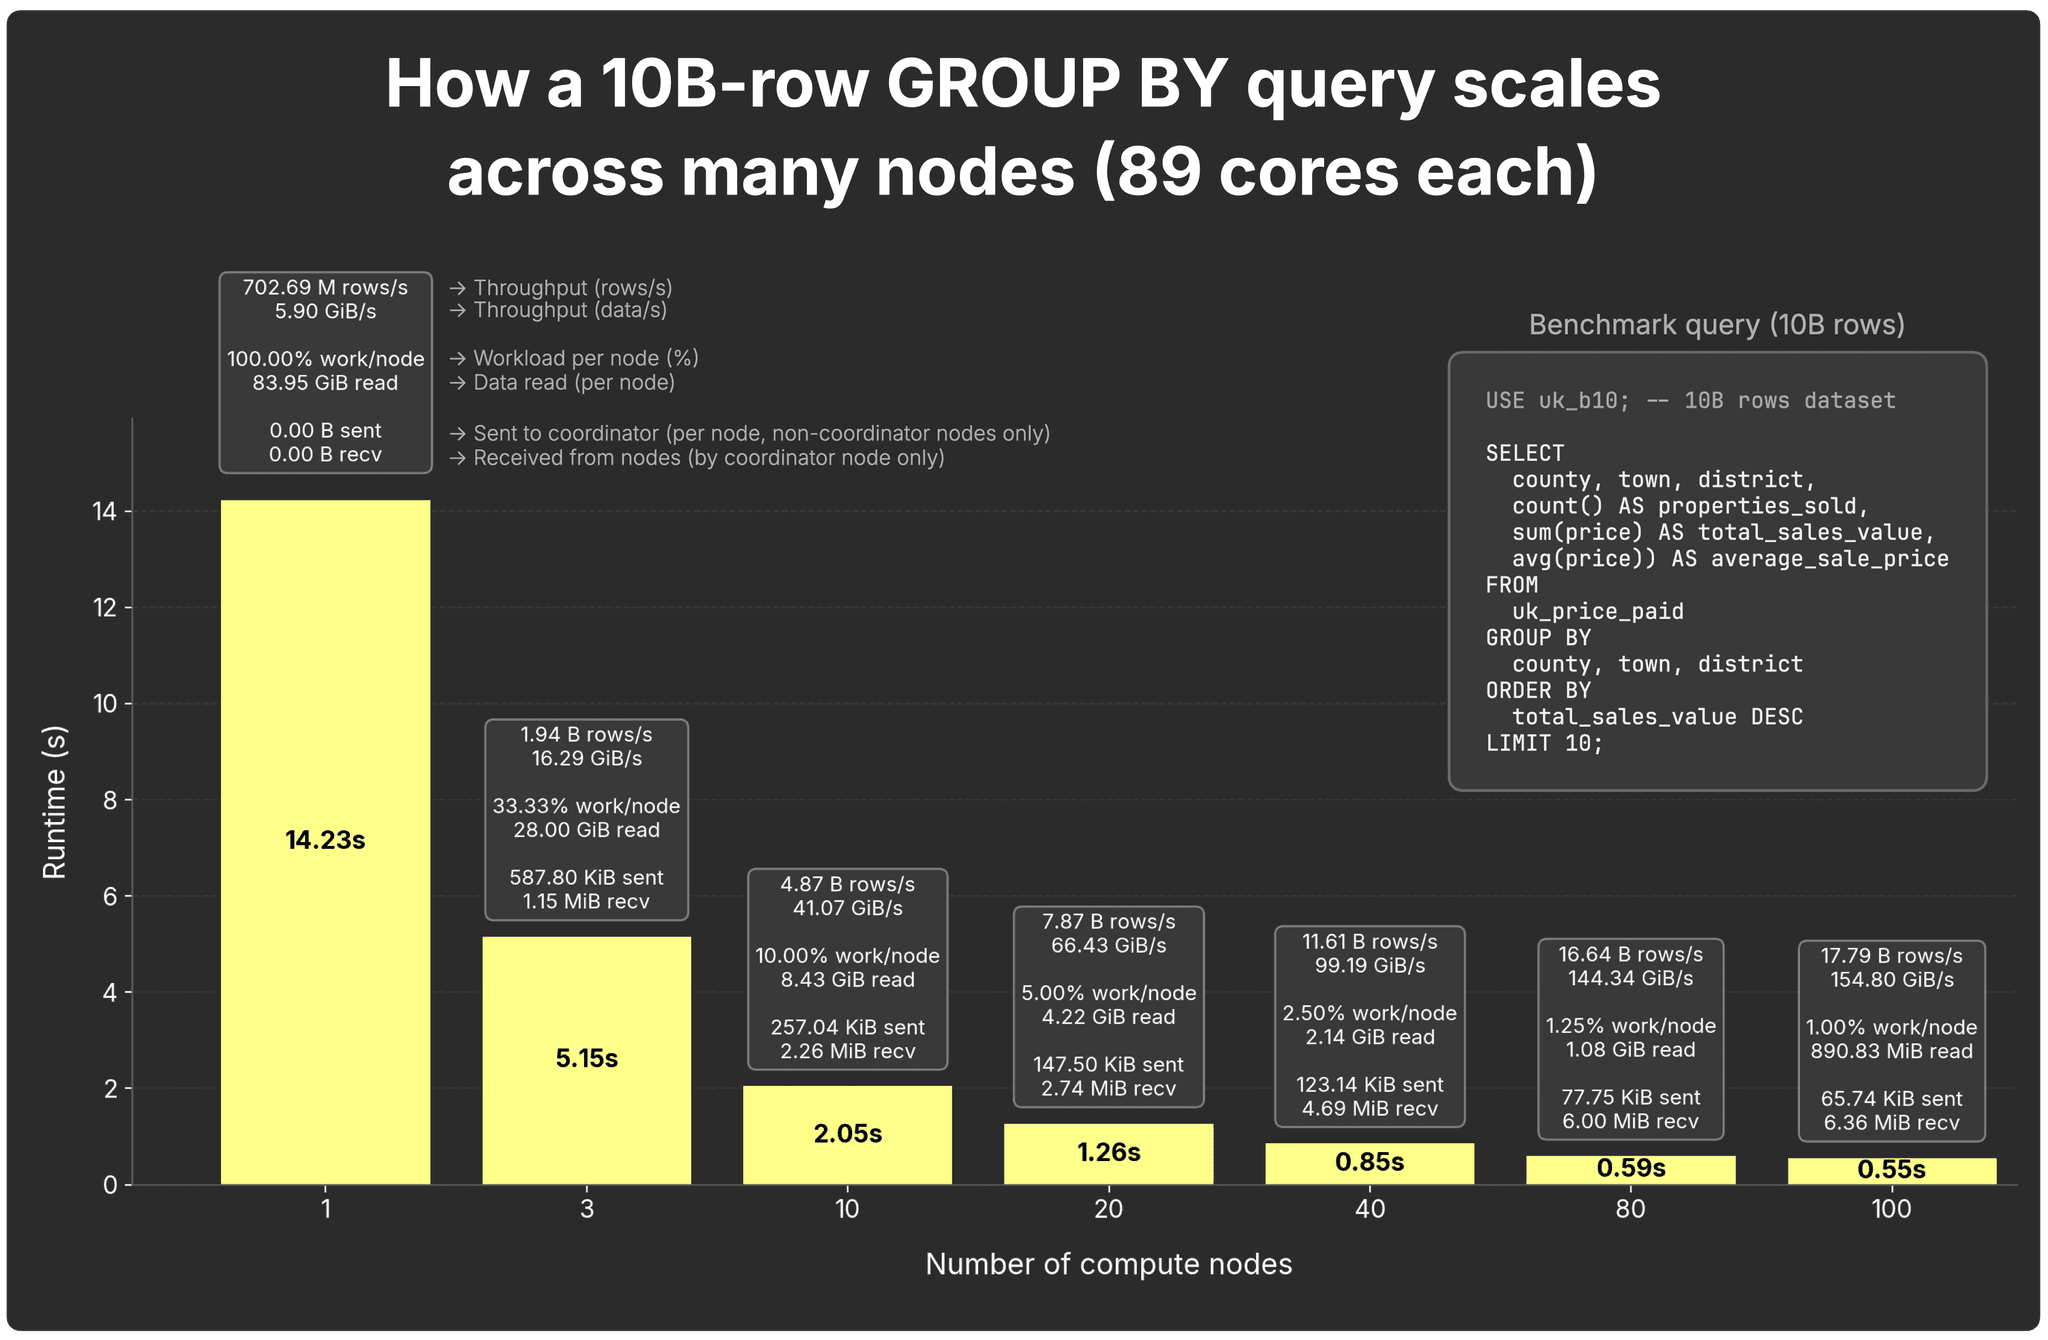
上記グラフの基となった完全な結果はこちらで確認できます。
1 ノードの場合、クエリは毎秒約 7 億 300 万行 (~5.9 GiB/s) で 14.2 秒で完了します。
ノードを追加していくと実行時間が短縮され (スループットが向上し) ます。
- 3 ノード → 5.2 秒
- 10 ノード → 2.0 秒
- 20 ノード → 1.3 秒
- 40 ノード → 0.85 秒
- 80 ノード → 0.56 秒
- 100 ノード → 0.55 秒
グラフには、ノードごとのワークロード分担、ノードごとのデータ読み込み量 (非圧縮)、およびネットワークトラフィック (各ノードがコーディネーターに部分状態を送信し、コーディネーターが全ノードからそれらを受信してマージします) も示されています。
数値の裏側を覗く: 当社のベンチマークドライバは、ノードごとの処理行数、スキャンされた圧縮/非圧縮バイト数、メモリ使用量、スキャン時間と集計時間の内訳、cold/warm/hot の状態など、はるかに詳細な情報を記録しています。グラフの見やすさを保つためにそれらは省きましたが、完全な結果は GitHub リポジトリで公開されています。
スケーリングは完全に線形というわけではなく、ノードを倍にしても実行時間が常に半減するとは限りませんが、それに近い数値が出ています。1 ノードで約 84 GiB をスキャンし、3 ノードでは約 28 GiB、10 ノードでは約 8 GiB となります。80〜100 ノードになると各レプリカの処理量は約 1 GiB 以下となり、コーディネーションのオーバーヘッド (コーディネーターへネットワーク経由で部分状態を送信するなど) が支配的になり始めるため、データセットが小さめの場合にはグラフの傾きが緩やかになります。
1 兆行でのスケーリング
その傾きの鈍化は、parallel replicas のコーディネーションオーバーヘッドに見合わないほどノードあたりの処理量が小さくなったときに現れます。それを証明するために、100 倍のサイズである 1 兆行のデータセットを用い、同じコンピュートノード (各 89 コア) で同じクエリを再実行しました。
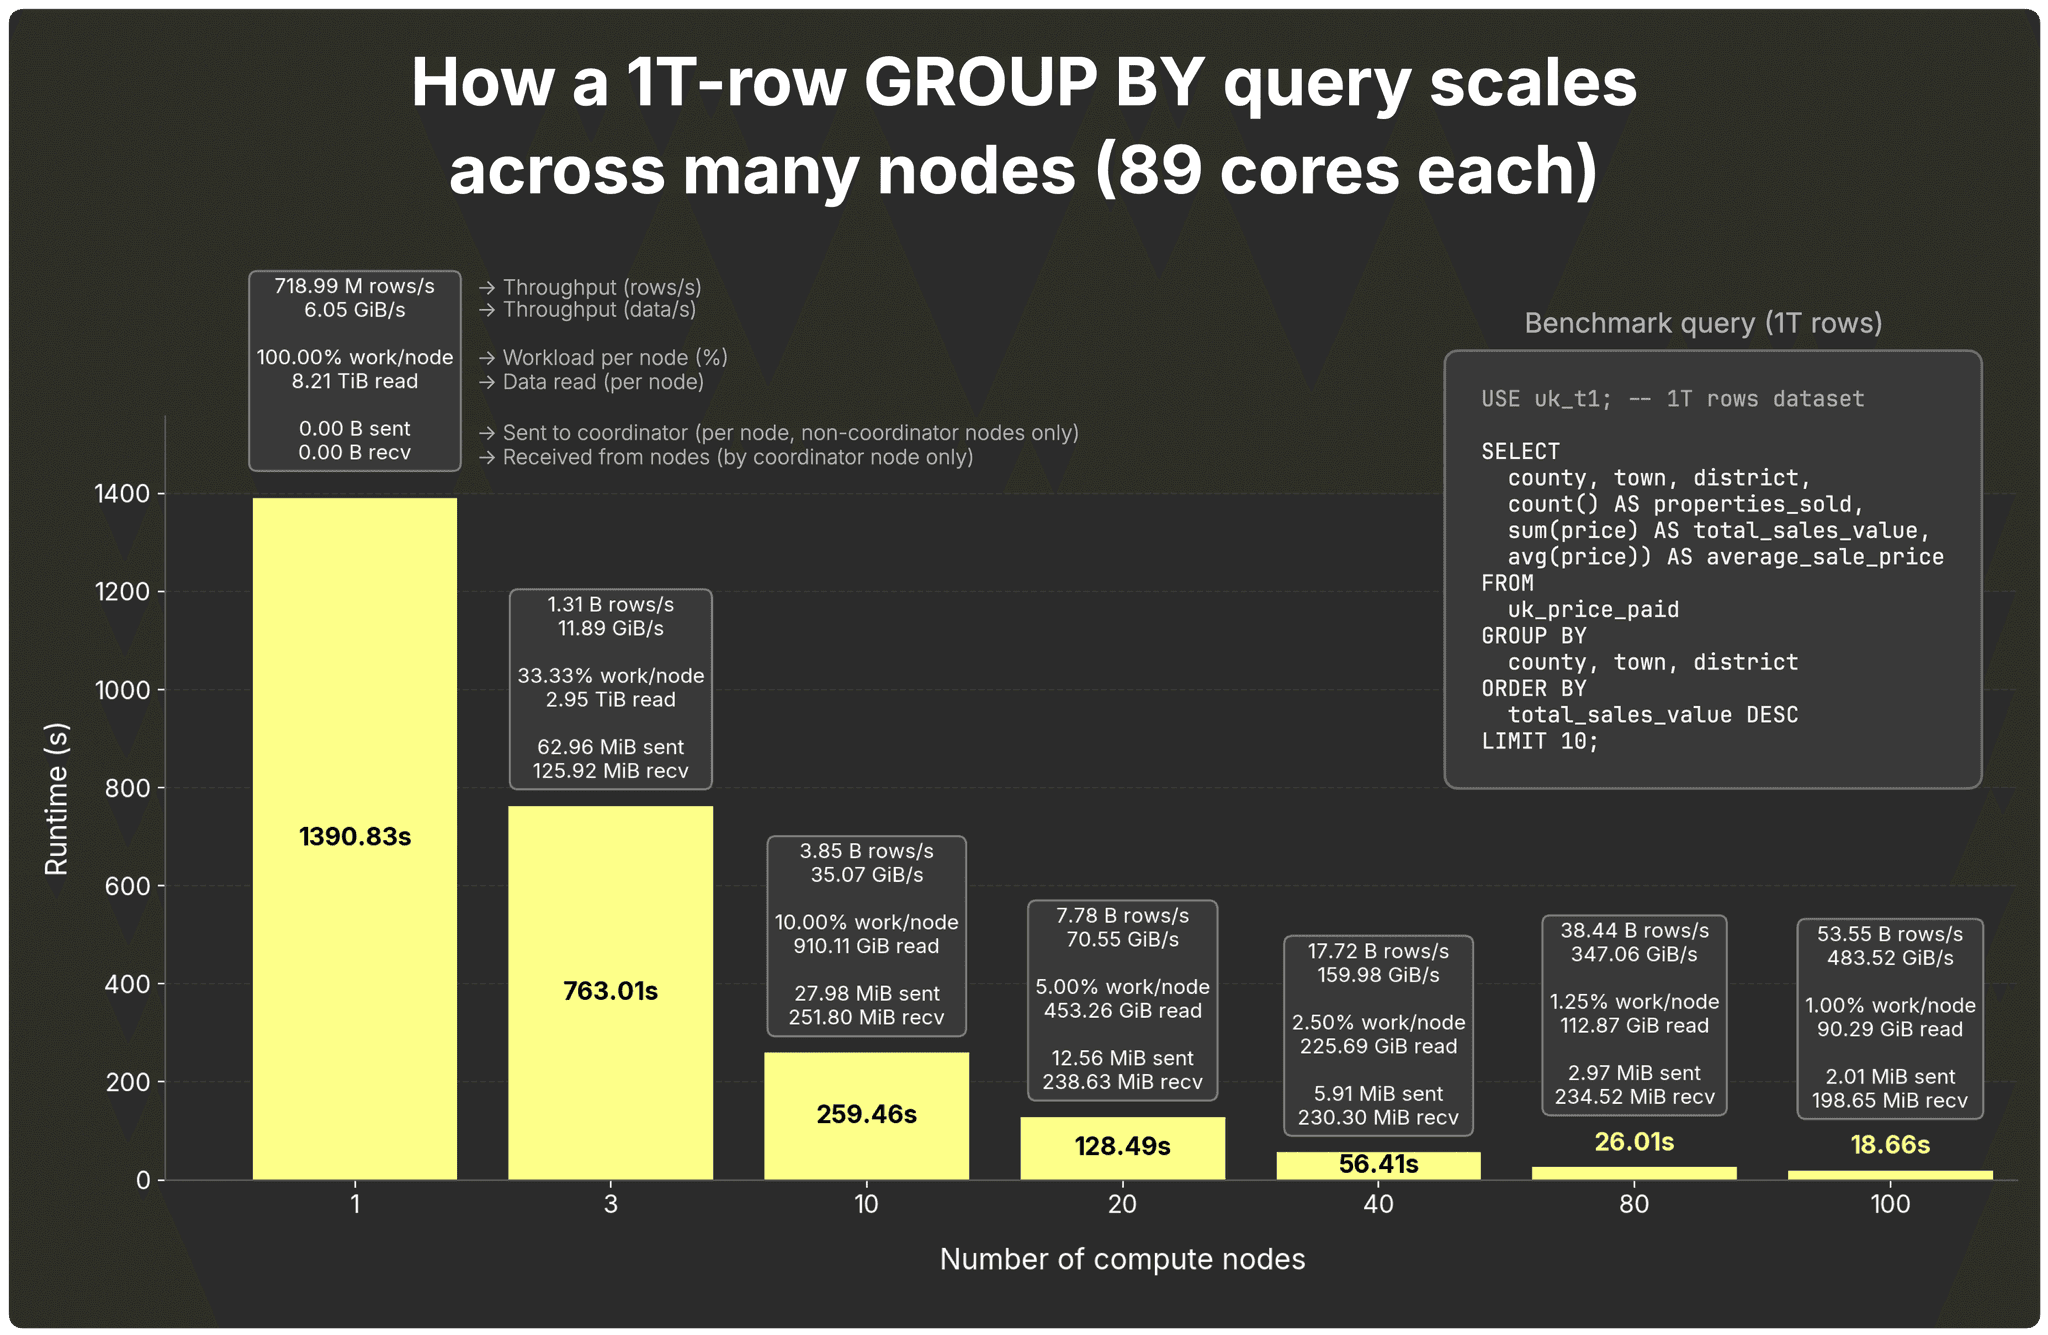
完全な結果はこちらにあります。
ノード数が少ない段階では、各ノードに過剰な負荷がかかっています。単一ノードでは 8.2 TiB をスキャンして集計する必要があり、3 ノードであっても各ノードでほぼ 3 TiB に達します。
10 ノードになるとノードあたりの読み込み量は ~910 GiB に減少し、優れたスケーリング効果が現れ始めます。それ以降のノード倍増では、線形またはそれ以上の性能向上が見られます。
- 10 → 20 ノード: 2.02 倍高速
- 20 → 40 ノード: 2.28 倍高速
- 40 → 80 ノード: 2.17 倍高速
- 80 → 100 ノード: 1.39 倍高速 (線形予測値である 1.25 倍を上回る)
100 ノードの時点でも各レプリカは ~90 GiB を処理しており、parallel replicas のコーディネーションオーバーヘッドを正当化するのに十分な作業量があるため、力強いスケーリングが維持されています。
もちろん、1 兆行のデータセットであれば 100 ノードを超えてもスケールし続けますが、前述のとおり、「どこまでスケールできるのか?」という詳細な検証は parallel replicas が GA を迎えてからのフォローアップ記事に残しておきます。
parallel replicas 機能がどれほど良好に機能するかは、部分状態のサイズにも依存します。次にそれを見ていきましょう。
GROUP BY の負荷が重くなる場合
すべての GROUP BY が同じ負荷というわけではありません。これまでは SUM や AVG のような、部分状態が極めて小さい軽量な集計を紹介してきました。しかし、COUNT DISTINCT のようなより重い GROUP BY では何が起きるでしょうか。そこではスケーリングの様相が異なり、部分状態のサイズが重要な意味を持ち始めます。
これを実証するために、100 億行のデータセットを使い、四半期ごとに各州で取引があった個別の通りの数をカウントしてみます。
USE uk_b10; -- 10B rows dataset

SELECT
  county,
  toStartOfQuarter(date) AS qtr,
  uniq(street) AS distinct_streets_with_sales
FROM
  uk_price_paid
GROUP BY
  county, qtr
ORDER BY
qtr, county;クエリ自体はシンプルですが、どの集計関数を選択するかが鍵となります。
注: このベンチマークは、異なる集計関数によって生成される部分状態のサイズの違いに焦点を当てています。これまでのベンチマークとは異なる新しい GROUP BY クエリを使用しているため、89 コアのノードではなく 16 コアのノードで実行しており、コア数に関係なく parallel replicas が効率的にスケールすることも同時に示しています。
軽量なケース: uniq
uniq 集計関数は近似値を算出しますが、非常に効率的です。アダプティブサンプリング (最大 65,536 ハッシュ) を使用し、状態をコンパクトに保ちます。
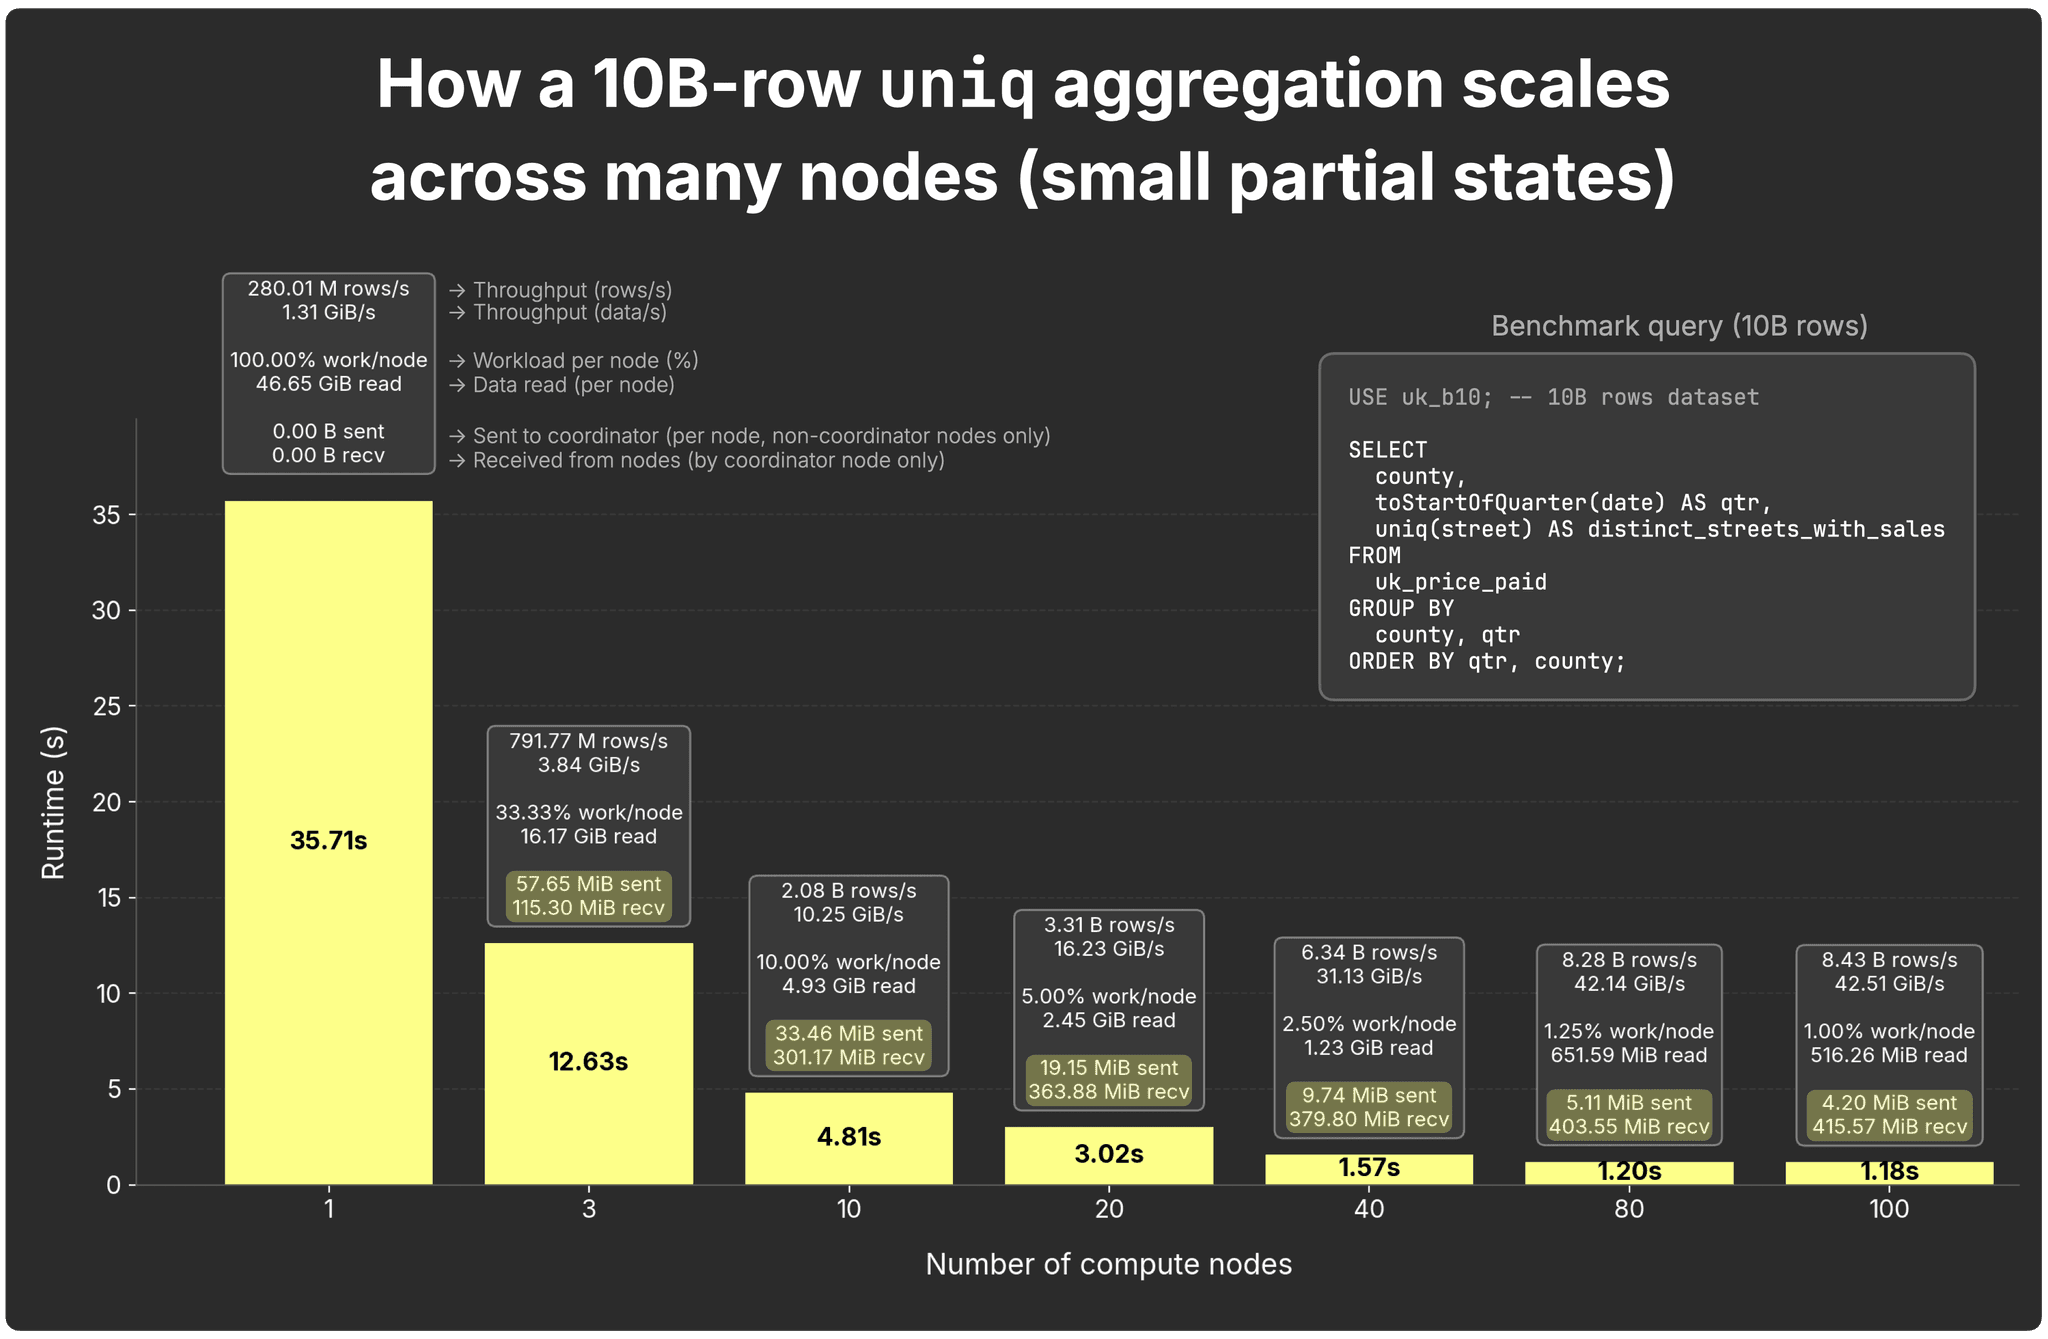
完全な結果はこちらで確認できます。
-
ノードあたりの送信状態サイズ: 送信ノードあたり ~58 MiB (3 ノード構成時の送信側 2 ノード) から、100 ノード構成時のノードあたり ~4.2 MiB まで減少
-
コーディネーターの受信総量: 3 ノード構成時の ~115 MiB (2×58 MiB) から、100 ノード構成時の ~416 MiB (99×4.2 MiB)
→ コーディネーターへのファンインは小さく保たれ、ノードが増えるにつれてノードあたりのトラフィックは縮小します。
重いケース: uniqExact
uniqExact 集計関数は正確な COUNT DISTINCT を計算します。コーディネーターがマージする前に、各ノードが検出したすべての個別値を型に応じて生の値またはハッシュとして追跡・保持しなければならないため、部分状態が大きくなります。
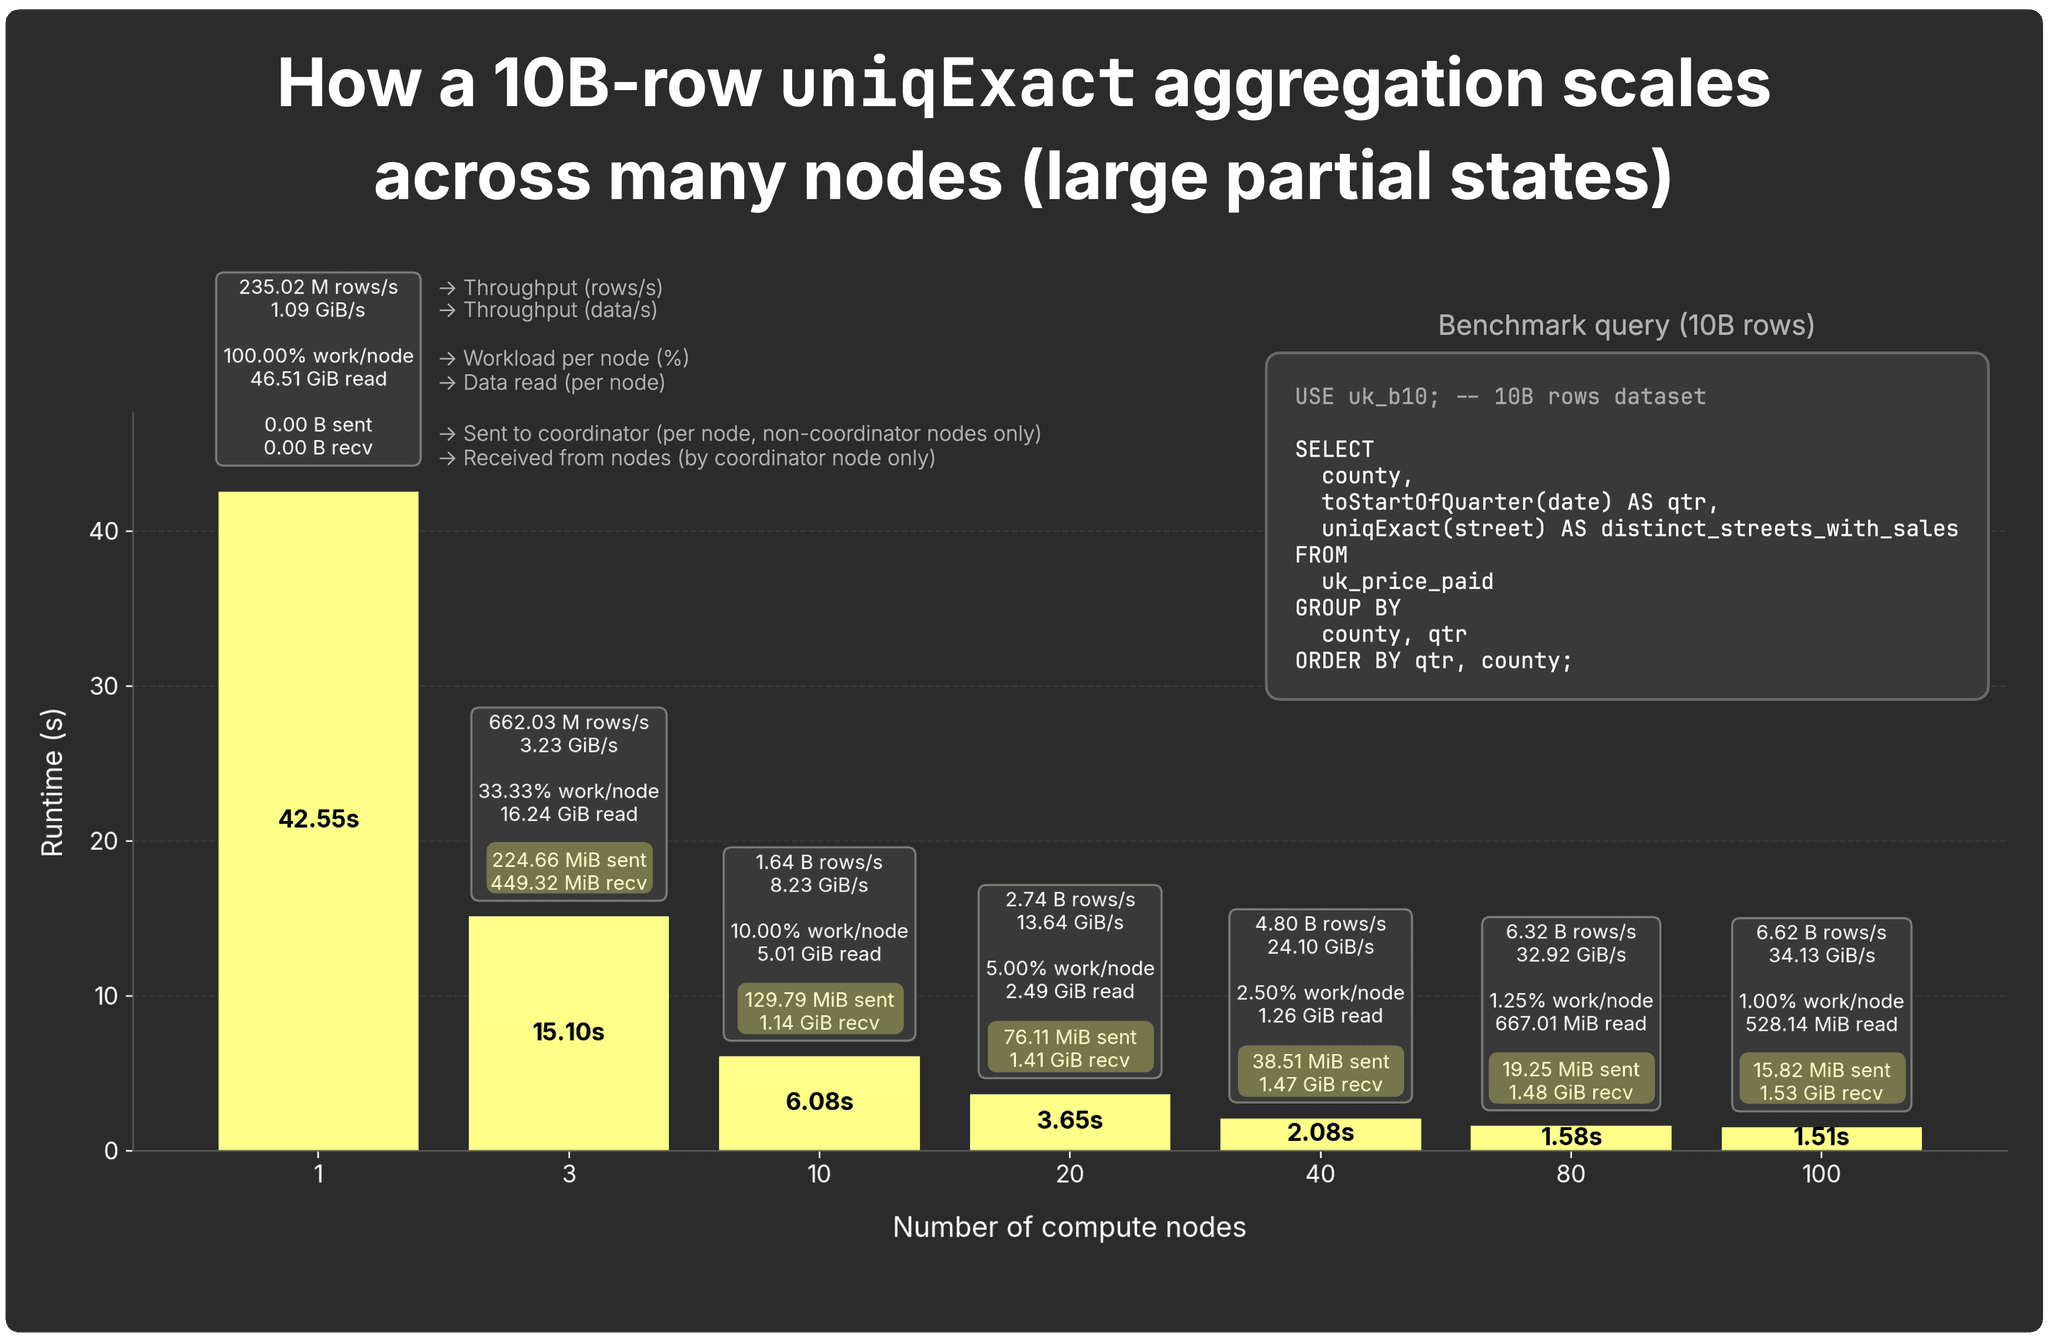
完全な結果はこちらにあります。
-
ノードあたりの送信状態サイズ: 送信ノードあたり ~225 MiB (3 ノード構成時の送信側 2 ノード) から、100 ノード構成時のノードあたり ~16 MiB まで減少
-
コーディネーターの受信総量: 3 ノード構成時の ~450 MiB (2×225 MiB) から、100 ノード構成時の ~1.5 GiB (99×16 MiB)
状態のサイズが uniq と比較して ~4 倍大きくなるため、実行時間は短縮されるものの、ネットワークファンインとマージ処理の負荷がより顕著になります。
ただし、これは一概には言えません。uniqExact の状態サイズはカーディナリティに応じてスケールするためです。このデータでは、(county, quarter) ごとの個別の通りの数は最大約 1 万 7,000 件で安定しており、この例での負荷は比較的穏やかな部類に入ります。
カーディナリティに関する注意点: 個別値の数が爆発的に増加する場合 (例: 数十億のユーザーに対する
uniqExact(user_id)や Web 全体を対象としたuniqExact(url))、状態はuniqと比較して数桁大きくなる可能性があり、ネットワークオーバーヘッドもそれに応じて増大します。
個別値カウントに関するまとめ
parallel replicas は 170 種類以上の集計関数すべてをスケールさせますが、その効率は部分状態のサイズに左右されます。
-
軽量な状態 (sum、count、uniq など): 非常に良好にスケールします。
-
重い状態 (uniqExact): 同様にスケールしますが、ネットワークおよびマージのコストが高くなります。
-
その他の選択肢 (uniqHLL12): 1 万〜1 億件の個別値に対して約 1〜2% の誤差で約 2.5 KB の固定状態サイズを維持します。ごく小さなデータセットでは精度が落ち、1 億件を超えると劣化しますが、一部のワークロードにとっては実用的なバランスの取れた選択肢となります。
重い集計であってもスケールすることに変わりはありませんが、部分状態が大きくなるとネットワークトラフィックとマージコストが増加します。そのトレードオフが見合うかどうかは、各ノードが処理すべきデータ量に依存します。このことが、parallel replicas の効率性を保つために ClickHouse が適用している安全策の話題へとつながっていきます。
スケーリングの限界と安全策
クエリは単にノード数を増やせば速くなるというものでもありません。
小規模なデータセット (例: 100 億行) では、parallel replicas はノード数が少ないうちは良好にスケールしますが、ノード数が増えると各ノードの処理対象データが枯渇し、コーディネーションのオーバーヘッドが支配的になります。
大規模なデータセット (例: 1 兆行) では逆のことが起こります。ノード数が少ないと負荷をさばききれませんが、ノード数を増やすと各ノードに十分な処理対象行が残るため、コーディネーションのコストに見合う形で綺麗にスケールします。
ClickHouse は、parallel replicas の効率性を保つために 2 つの安全策を設けています。
-
parallel_replicas_min_number_of_rows_per_replica — ノードにオーバーヘッドを正当化できるだけの十分な行数が割り当てられる場合にのみ、そのノードを parallel replica として稼働させます。
-
max_parallel_replicas — 1 つのクエリに対して parallel replica として使用されるノード数の上限を設定します (デフォルトは 1000)。
内部では、クエリプランナーがクエリによって実際にスキャンおよび処理されると予測される行数である rows_to_read を (インデックス分析などを通じて) 見積もります。上記 2 つの設定値が組み合わさることで、parallel replicas を使用する価値があるかどうか、使用する場合はノード数をいくつにするかが判断されます。
- 有効化の判定ルール: クエリに対して parallel replicas が有効化されるのは、次の条件を満たす場合のみです。
rows_to_read >= 2* parallel_replicas_min_number_of_rows_per_replicaこの条件を満たさない場合、parallel replicas は無効化され、クエリは単一ノードで実行されます。
- 上限の判定ルール: 上記のルールで有効と判定された場合、parallel replica として使用されるノード数 (number_of_replicas_to_use) は以下のように制限されます。
rows_to_read / parallel_replicas_min_number_of_rows_per_replica

(ただし min(クラスターサイズ, max_parallel_replicas) を上限とする)この値が 1 以下の場合は、parallel replicas は同様に無効化され、クエリは通常の単一ノード実行へとフォールバックします。
つまり、小規模なデータセットでは parallel replicas を完全にスキップし、大規模なデータセットでは各ノードが有意義な処理量を持てる範囲内でのみ利用します。
例: クエリの読み取り対象行が 100 億行 (10B rows to read) であり、max_parallel_replicas = 100、parallel_replicas_min_number_of_rows_per_replica = 1B (10 億行) の場合を考えます。
-
有効化の判定ルール: 10B ≥ 2×1B → 条件クリア (parallel replicas 有効)。
-
上限の判定ルール: 10B ÷ 1B = 10 → このクエリの parallel replica として 10 ノードを使用 (100 ノードではありません)。
有効化された各ノードは約 10 億行を処理することになり、オーバーヘッドに見合う十分な作業量となります。
デフォルトの動作: デフォルトでは parallel_replicas_min_number_of_rows_per_replica は 0 に設定されており、この安全策は無効になっています。この場合、parallel replicas は常に有効化され、max_parallel_replicas (デフォルト 1000) またはクラスターサイズのうち小さい方によって上限が設定されます。小規模なデータセットでは不要なコーディネーションオーバーヘッドが発生する可能性があるため、本番環境ではこの設定を調整することをお勧めします。また、enable_parallel_replicas を使用してクエリごとに parallel replicas を切り替えることもできますし、必要に応じてそのクエリに対して max_parallel_replicas をオーバーライドすることも可能です。
これらの安全策が連動することで、クエリ時間を短縮できる場合にのみ parallel replicas が作動し、処理時間が延びてしまうのを防ぐようになっています。
次に、parallel replicas が実際にどのようにノード間で作業を分散しているのか、その内部の仕組みを見てみましょう。
parallel replicas による作業の分散方法
(parallel replicas を使用した作業の分散方法に関する詳細なガイドはすでに公開されていますので、ここでは要点のみをまとめます。)
クエリを受信したノード (ClickHouse Cloud ではロードバランサーによって選定されたノード) が、常にそのクエリのコーディネーターになります。重要な点として、前半のアニメーションで示したように、コーディネーターも完全な parallel replica として機能し、他のノードと同様に自身の割り当て分の作業を実行します。
クエリが到着すると、コーディネーターはグラニュール (ClickHouse における最小処理単位であり、デフォルトでは約 8,192 行の連続した行で構成され、インデックス分析によって選出されます) の範囲単位で作業を計画します。そして、自身を含む参加レプリカ全体にグラニュールを割り当てます。
各レプリカは割り当てられたグラニュールをローカルでスキャンし、集計の部分状態を計算して、その状態をストリーミングで送り返します。その後、コーディネーターが最終マージを実行し、結果を返します。
このグラニュールベースのモデルにより、きめ細かなロードバランシングが実現します。
-
動的なコーディネーション: レプリカは直前のタスクを完了すると新しいタスクを要求するため、処理の速いレプリカが自動的により多くの作業を引き受けます。
-
タスクスティーリング: あるレプリカの処理が遅れている場合、他のレプリカがその残りのグラニュールを引き取って処理できます。
-
キャッシュ局所性: コンシステントハッシュ法により、繰り返しのクエリにおいて同一ノードが同一グラニュールを処理するため、キャッシュされたデータを再利用できます。これはクラスター全体が使用されている場合 (クラスターサイズ ≤ max_parallel_replicas) に最も効果を発揮し、そうでない場合はノードの割り当てはランダムになります。
低レイヤーの詳細についてはここまでとします。視点を広げ、クラウドのより広い視野において GROUP BY がどのように進化してきたかを見てみましょう。
クラウド規模での GROUP BY
ClickHouse Cloud では、GROUP BY は複数のノードフリート全体にわたって、以下の 2 つの補完的なアプローチによって伸縮自在にスケールするようになりました。
-
クエリ間のスケーリング (Inter-query scaling): ノードを追加することで、同時実行できるクエリ数を増やせます。ロードバランサーがリクエストをルーティングできるコンピュートプールが単純に拡大するため、クラスターサイズに応じて全体のスループットが向上します。
-
クエリ内のスケーリング (Intra-query scaling) (本記事の主題): 1 つのクエリを多数のノードに分散させることで、クエリを高速化します。parallel replicas 機能を有効にすると、ClickHouse は利用可能な全ノードの利用可能なすべての CPU コアにわたってクエリを並列化します。
オープンソースの ClickHouse では、シャーディングまたは parallel replicas を用いて単一クエリをスケールさせることもできます。シャーディングはデータを複数のノードに分散させますが、キャパシティを追加するにはリシャーディングが必要であり、数時間から数日かかる作業になる場合があります。parallel replicas も利用可能ですが、シェアードナッシングの構成ではデータの完全な物理コピーが必要となります。
クラウドでは、このモデルがより大きな強みを発揮します: コンピュートとストレージが分離されており、各ノードは共有オブジェクトストレージからデータを読み取る実質的にステートレスな仮想レプリカとなります。データのコピーや再配置を行うことなくノードを即座に追加・削除でき、スイッチを切り替えるだけで単一クエリの高速化が実現します。
クラウドはさらに多くの恩恵をもたらします。分散キャッシュによってホットデータをコンピュートノードの近くに保持し、フリート全体で繰り返されるクエリを高速化します。Shared Catalog がデータベースのメタデータを一元管理するため、新しいノードはわずかな時間でオンラインになります。さらに、ネイティブテーブルだけでなく、Iceberg や Delta Lake などのオープンテーブルフォーマットに対しても GROUP BY がシームレスに機能します。
外部フォーマットに対するクエリでも、本記事で説明した集計の部分状態を用いた同じ実行モデルが使用されます。ネイティブテーブルでは parallel replicas はグラニュール単位で作業を分割します。外部フォーマットの場合は、…Cluster 関数 (s3Cluster、azureBlobStorageCluster、deltaLakeCluster、icebergCluster、その他) を使用する必要があり、これらはファイル単位 (例: Iceberg 内の Parquet ファイル) で作業を分割します。
つまり、データがネイティブテーブルにあろうと外部のオープンフォーマットにあろうと、ClickHouse Cloud はステートレスなコンピュートノード全体に GROUP BY をファンアウトし、対話的な速度で結果を返すことができます。
単一ノードからクラウドへ
本記事は、単一ノードのクエリが瞬きするよりも速く完了することへの驚きから始まり、その同一の実行モデルがマシンフリート全体へとシームレスに広がっていく様子を見届ける、私自身の探求の旅でもありました。
GROUP BY は、ほぼすべての分析クエリの中核に位置しています。オブザーバビリティダッシュボードを支え、会話速度の AI やエージェント向け分析を駆動し、その間のあらゆるユースケースを支えています。
ClickHouse は、GROUP BY を高速に実行するために構築されました。クラウドにおいて、その設計はさらに大きなものへと進化します。parallel replicas (ClickHouse Cloud の OSS 機能であり、現在はベータ版、まもなく GA 予定) により、コアごとの処理ストリームというモデルが無限の水平クエリ拡張へと変わり、リシャーディングやデータ移動を行うことなく、すべてのノードの全コアに 1 つのクエリを分散させます。その結果、どのような形状や規模のデータであっても対話的な速度が実現します。
その美しさはシンプルさにあります。処理ストリームごとの部分状態が、あらゆる規模で正しい結果へとマージされるのです。
万年筆と同じように、ClickHouse は今でも 1 つのことに卓越しています。それは GROUP BY であり、手元のノート PC からクラウドに至るまでシームレスに広がるスケールとスピードでそれを実現しています。
parallel replicas は現在ベータ版であり、ClickHouse Cloud においてまもなく一般提供 (GA) となります。すでにお手元のワークロードの一部で有効化して、このスピード向上を直接ご体験いただけます。
今すぐ ClickHouse Cloud を始めて、$300 のクレジットを受け取りましょう。30 日間の無料トライアル終了後は、従量課金プランに移行できます。ボリュームベースの割引について詳しくは お問い合わせ ください。詳細は 料金ページ をご覧ください。