5万

2026年6月にサンフランシスコで開催された Open House において、私たちは ClickStack MCP サーバーを発表しました。これは、AI エージェントが生の SQL を手作業で組み立てる代わりに、本番環境のインシデント調査に向けた構造化された高水準のプリミティブを提供する専用のオブザーバビリティツール群です。ステージ上では、ClickStack MCP と汎用的な ClickHouse SQL インターフェースを比較したベンチマークの初期結果を共有しました。根本原因と対処策の特定精度が 18% 向上、ツール呼び出しが 26% 削減、実行ごとの結果の一貫性が 2.4 倍向上という結果です。
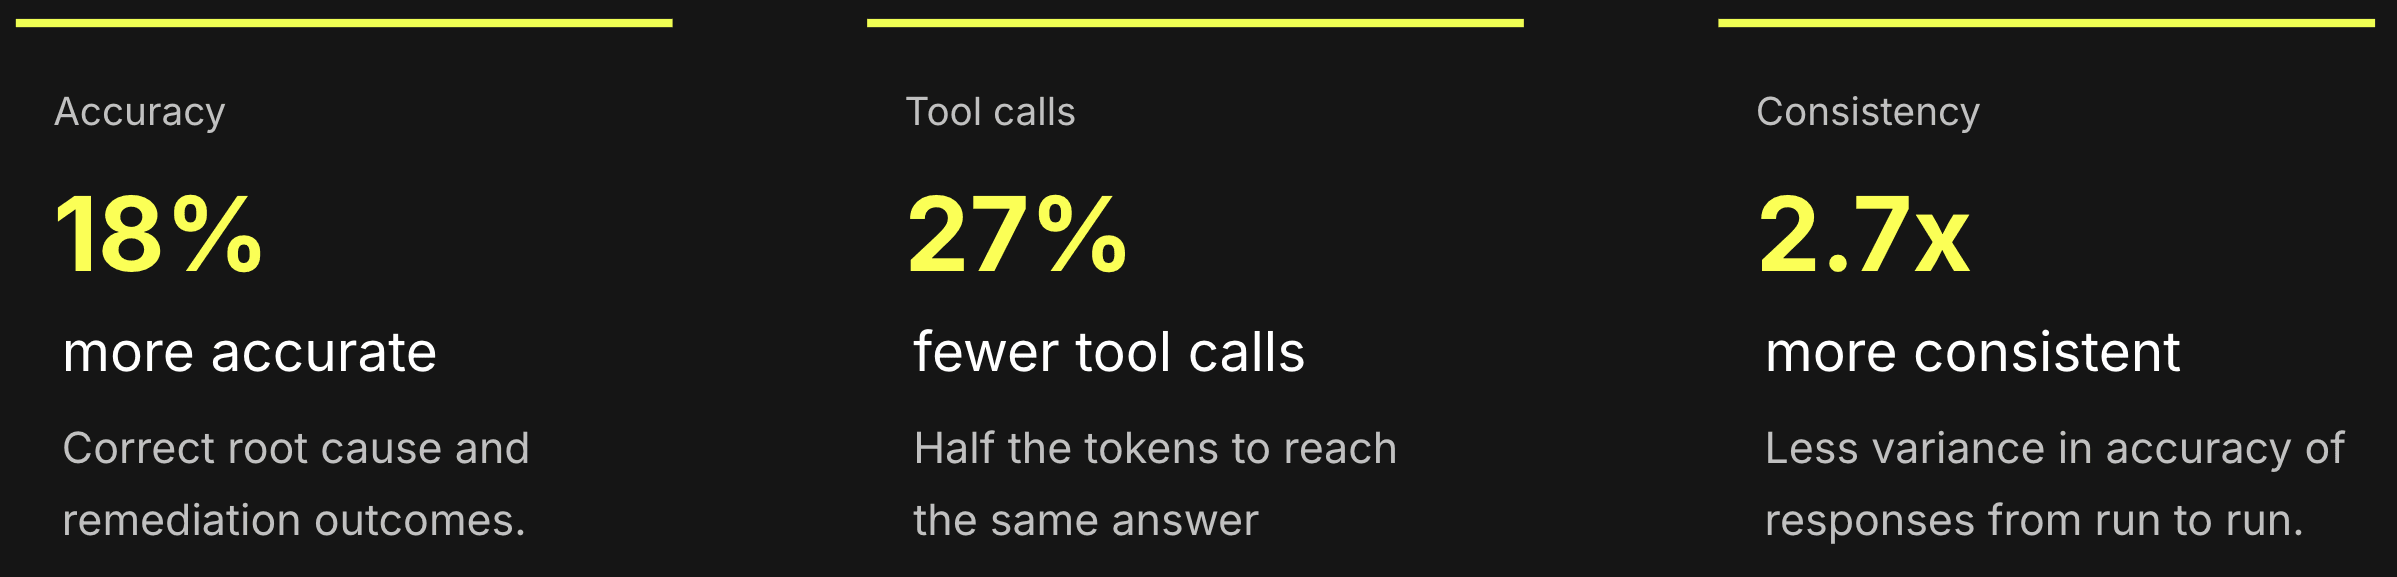
これらの数値を受けて、どのように測定したのかについて多くの質問が寄せられたため、本記事では私たちが実際に行った取り組みを詳しく解説します。
エージェントが本番環境のインシデント調査に使う MCP (Model Context Protocol) ツールを提供することには、新しい種類のリスクが伴います。同じ質問を 2 回投げても常に同じ回答が得られるとは限らず、ツールのリファクタリング、パラメーターの名前変更、クエリロジックの変更などが、測定するための構造化された手法がないまま調査品質を静かに低下させてしまう可能性があります。
私たちは 2 つの問いに答える必要がありました。第 1 に、MCP の各新バージョンが前回よりも優れた調査結果をもたらしているか。第 2 に、ClickHouse へ直接 SQL アクセスできるエージェントよりも、MCP が実際に優れた成果を出しているか、です。そのために私たちは hdx-evals を構築しました。同一の合成テレメトリをシードし、各構成に対して Claude エージェントを実行し、実装間で結果をブラインドスコアリングする再現性の高いベンチマークフレームワークです。このフレームワークは MCP とモデルのあらゆる組み合わせを実行するため、有益な副次効果も得られました。新しいモデルがリリースされた際、hdx-evals を向けることで、本番環境で何を実行するか決定する前に、同一のシナリオ上でそのパフォーマンスを確認できます。
hdx-evalsはオープンソースであり、HyperDX リポジトリにあります。コードを確認したい場合は、github.com/hyperdxio/hyperdx/tree/main/packages/hdx-eval をご覧ください。
ClickStack MCP と ClickHouse MCP の比較
ベンチマークシナリオの説明に入る前に、ClickHouse MCP と並行して専用の ClickStack MCP を構築した理由を簡単に振り返ります。この違いをすでにご存じの場合は、インシデントシナリオまで読み飛ばしてかまいません。
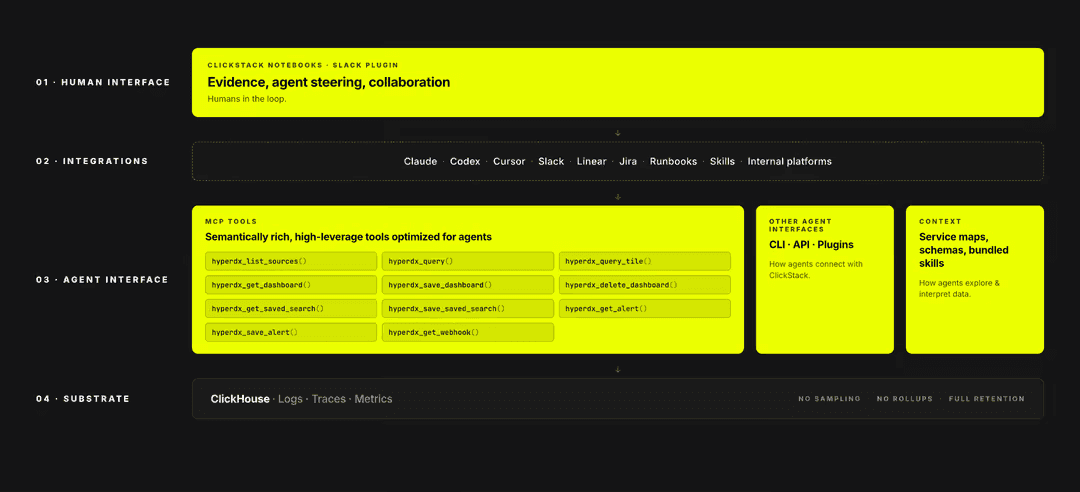
ClickHouse MCP は、SQL を介して ClickHouse への直接アクセスをエージェントに提供します。これは柔軟ですが、スキーマの検出、各クエリの構築、複数ステップからなる調査ワークフローの組み立てをモデル自身に委ねることになります。オブザーバビリティの調査においては、これがツールの余計な呼び出し、非効率なクエリ、カーディナリティが高すぎる結果、実行間でのアプローチの不整合につながる恐れがあります。
対照的に ClickStack MCP は、繰り返し発生するイベントパターンの検索、時間枠の比較、外れ値の特定、ログとトレースの相互移動といった、一般的なオブザーバビリティタスク向けの高水準なセマンティックツールを提供します。これらのツールも裏側では SQL を実行しますが、クエリロジックをパッケージ化し、エージェントが使いやすい構造化された結果を返します。目的は、ツール呼び出しや一般的なクエリエラーを削減しながら、精度と一貫性を向上させることです。以下のシナリオでは、さまざまな種類の調査においてそれらの利点が維持されるかどうかをテストします。
インシデントシナリオ
ベンチマークの質は、テスト対象となるインシデントの質で決まります。インシデントが単純すぎると、どのエージェントも優秀に見えてしまいます。逆に非現実的すぎると、本番環境で MCP がどのように機能するかについて何も分かりません。
そのため、hdx-evals の各シナリオは実際のインシデントをシミュレートしています。数千万行の合成ログとスパンが決定論的にシードされ、すべての実行が同一のデータから開始されます。現実的なノイズの中に意図的な異常値が埋め込まれ、さらに真の問題のように見せかけるタイミングと文言で設定された二次的な問題である「おとり」(distractor) も含まれています。最初に見つかったエラーに飛びつくようなエージェントは失敗するはずです。データを論理的に分析できるエージェントは失敗しないはずです。
このデータは、OpenTelemetry Demo や既存の製品、記録されたテレメトリから取得したものではなく、完全に合成されたものです。公開データセットには既知の文書化された障害パターンが含まれていることが多く、モデルのトレーニングデータにすでに現れている可能性があります。それらを再利用すると、利用可能なツールを通じて調査するのではなく、見覚えのあるインシデントをエージェントが認識してしまう可能性があるため、独自のシナリオを生成することで、エージェントの事前知識ではなく調査能力そのものをテストできます。
トレースとログは、シード付きの擬似乱数生成器 (PRNG) から TypeScript で決定論的に生成され、ClickStack の実際のおよび OTel スキーマを反映した ClickHouse テーブルへ直接書き込まれます。トポロジーはシナリオごとに異なり、単一の api-server から、名前付きの 25 個の e コマースサービス、さらにはカーディナリティのために手続き型で生成された約 100 個のバックグラウンドサービスまで多岐にわたります。データ量も意図的に設定されています。error-root-cause だけでも、1,200 万以上のスパンと 1,200 万件のログの中に、失敗しているトレースはわずか 8 件しか埋め込まれていません。そのためこの評価では、エージェントがエラーの数を数えられるかではなく、正常なベースラインの上に存在する本物そっくりなおとりから、小さく埋め込まれたインシデントを切り分けられるかを測定します。
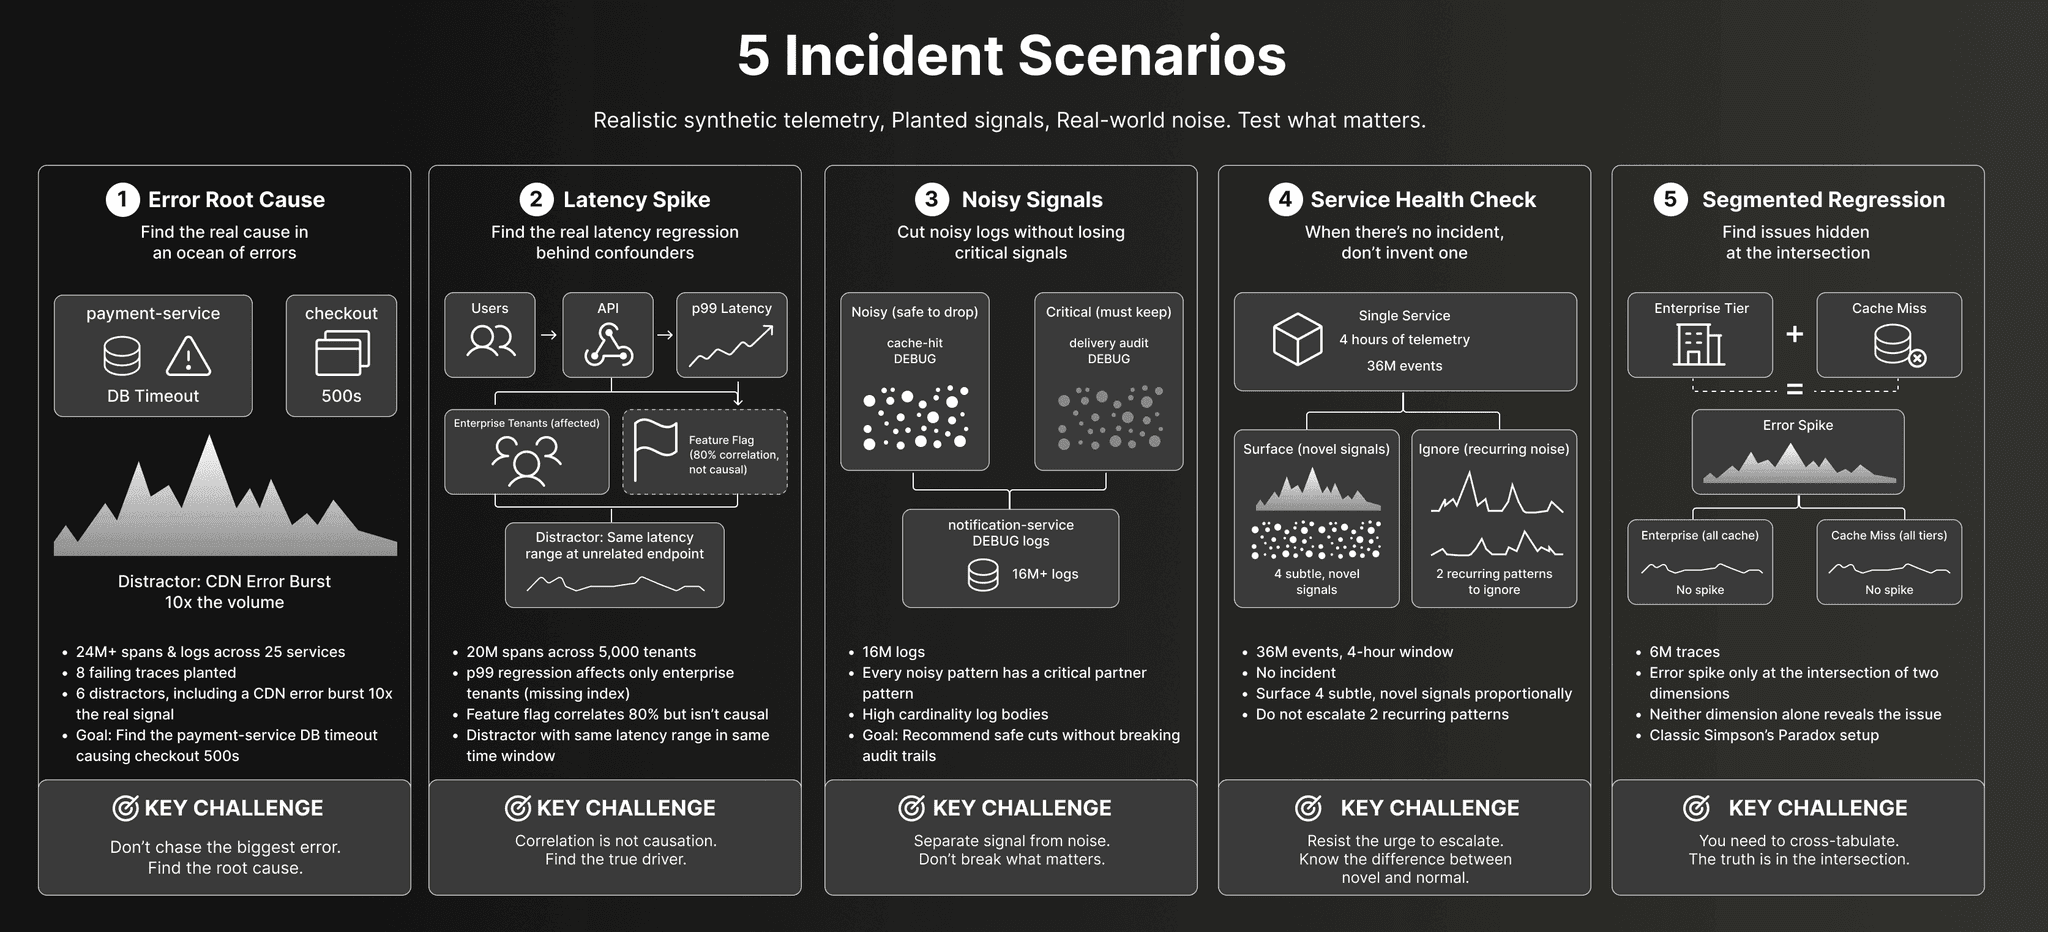
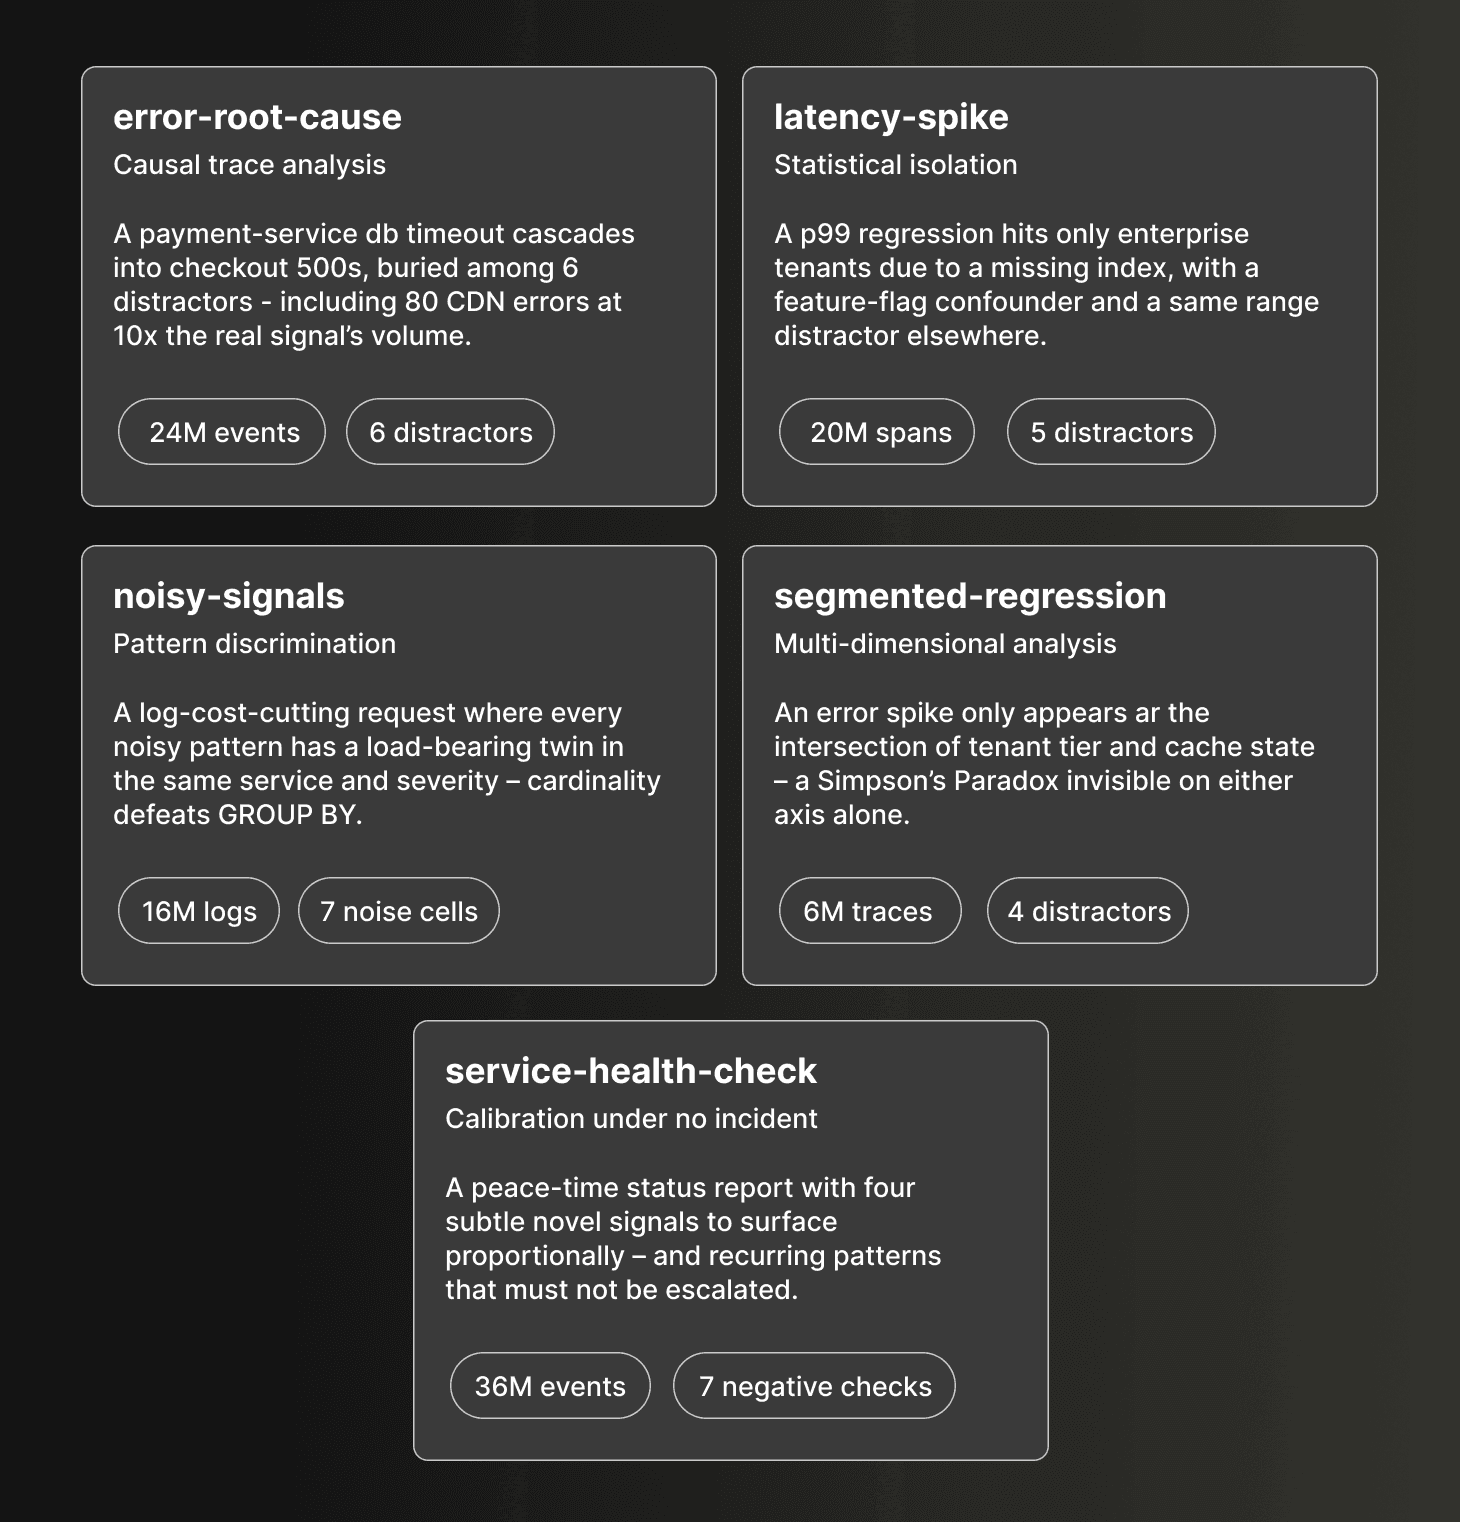
それぞれ異なる調査スキルを対象とした合計 5 つのシナリオを構築しました。
- error-root-cause:25 サービスにまたがる 2,400 万件のスパンとログの中に隠された、決済サービスのデータベースタイムアウトがチェックアウトの 500 エラーへと波及するインシデントです。6 つのおとりには、真のシグナルの 10 倍のボリュームを持つ CDN エラーの急増が含まれており、真っ先に
WHERE StatusCode = 'ERROR'を実行するようなエージェントを欺くよう設計されています。 - latency-spike:インデックスの欠落によりエンタープライズテナントにのみ影響を与えている p99 (99 パーセンタイルレイテンシ) の悪化で、5,000 テナントにまたがる 2,000 万件のスパンの中に埋もれています。影響を受けるセグメントと 80% の相関関係を持つものの因果関係はないフィーチャーフラグの交絡因子と、無関係なエンドポイントで同じ時間枠に発生している同等のレイテンシ範囲のおとりが存在します。
- noisy-signals:取り込みおよびストレージコストを削減するために、ドロップまたはスロットリングできるログを特定するようエージェントに求めます。データセットには 1,600 万件のログが含まれています。大量かつ低価値なログパターンは、それぞれ同じサービスかつ同じ重大度レベルの、同様に一般的でありながら重要なパターンとペアになっています。たとえば、
notification-serviceからすべての DEBUG ログをドロップすると、定期的なキャッシュヒットメッセージだけでなく、通知が送信されたことを確認するために必要な配信記録まで削除されてしまいます。 - service-health-check:インシデントがまったく発生していない、単一サービスの 4 時間・3,600 万イベントのデータセットです。4 つのわずかな新しいシグナルを適切に浮き彫りにし、2 つの反復パターンについてはエスカレーションしてはなりません。優れたベンチマークとは正解を評価することと、自信満々な誤答を減点することの両方が等しく重要であるため、このシナリオは他のシナリオと同じくらい重要です。
- segmented-regression:2 つのディメンション (エンタープライズ層とキャッシュミス) の交差点でのみ発生する、600 万トレースにわたるエラー急増です。どちらの軸単体でも問題は明らかにならないため、エージェントはクロス集計を行ってそれを見つけ出さなければなりません。シンプソンのパラドックスの教科書通りの設定です。
noisy-signals を例に取ってみましょう。エージェントは、重要な運用情報を失うことなく、1,600 万件のログのうちどれをドロップまたはスロットリングできるかを判断しなければなりません。notification-service DEBUG ログの半分は、削除しても安全な日常的なキャッシュヒットメッセージです。もう半分は通知の配信を記録したものであり、監査証跡として保持する必要があります。
この 2 種類のログは同じサービスと重大度レベルを共有しているため、それらのフィールドに対するフィルタリングだけでは分離できません。メッセージ内の値が大きく異なるため、完全なログメッセージでグループ化しても解決しません。エージェントは代わりに、類似したメッセージをパターンへとグループ化し、不要なキャッシュログと不可欠な配信記録を区別する必要があります。このシナリオでは、MCP のイベントパターンツールが、エージェントにそれを実行するための適切な手段を提供しているかどうかをテストします。
テレメトリのセットアップとシード
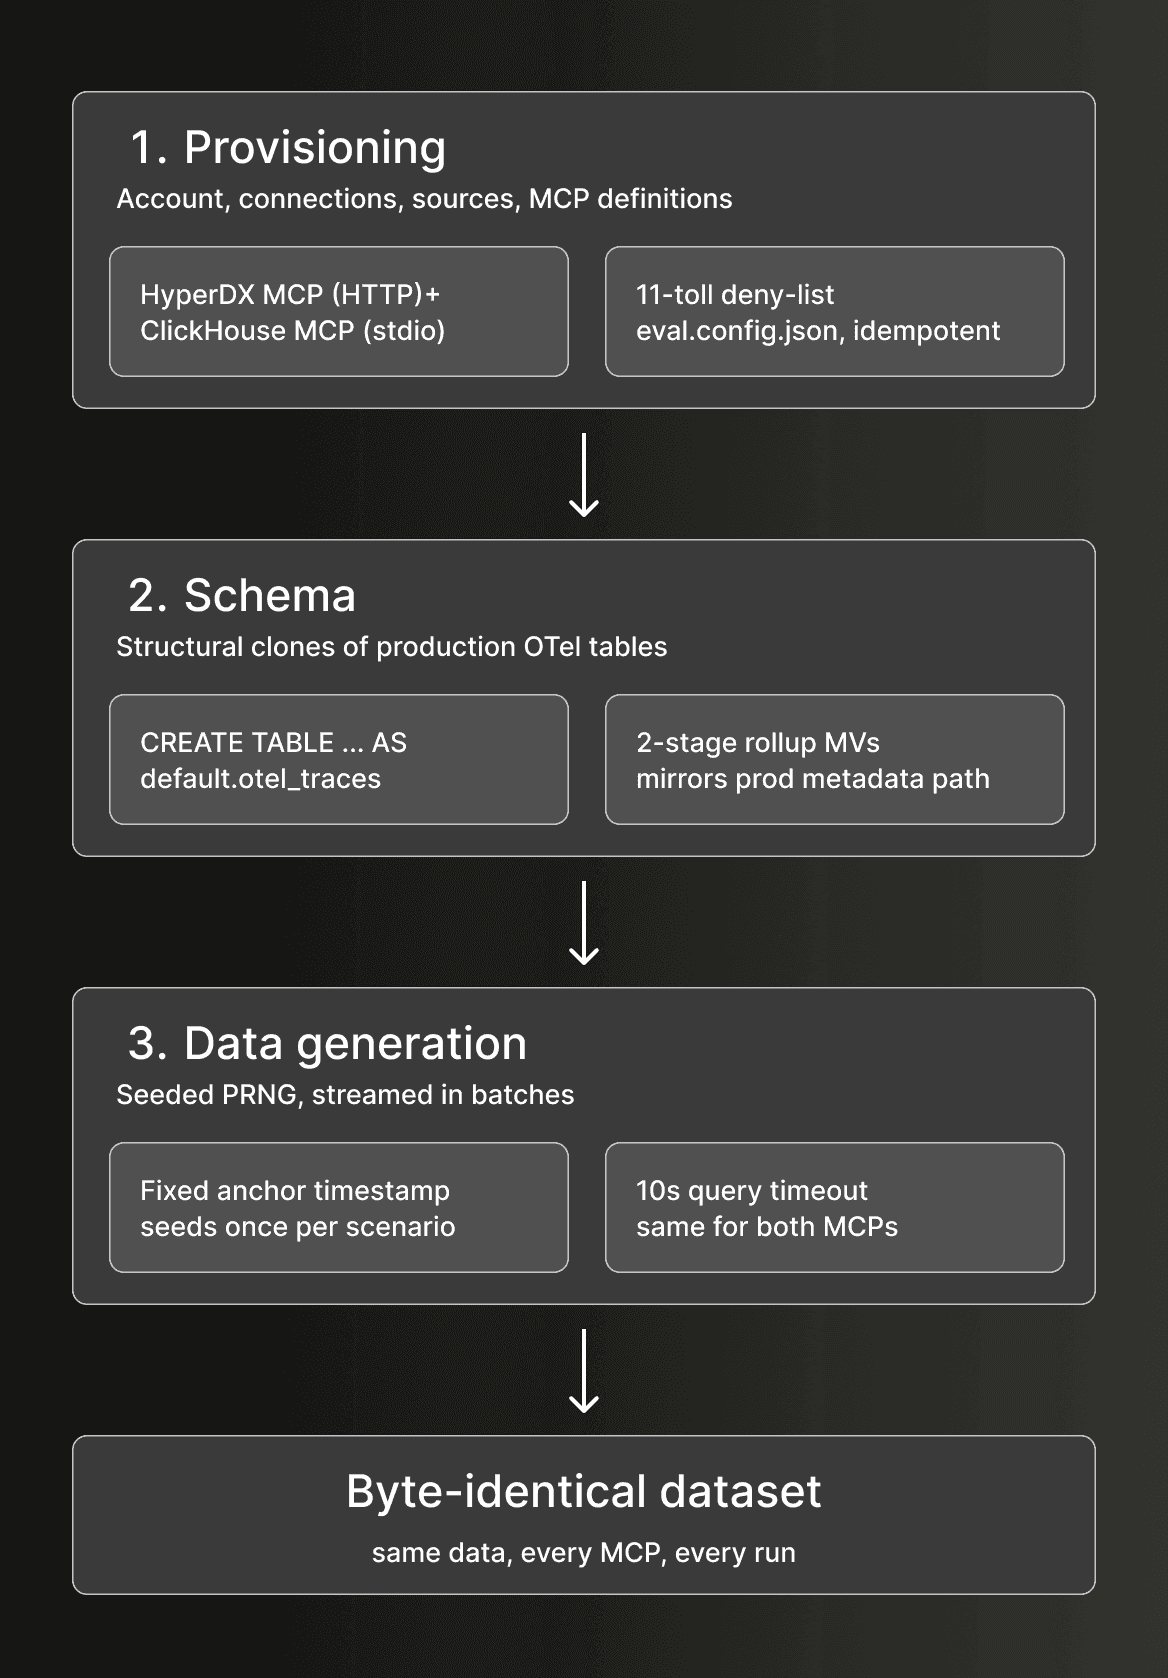
エージェントがインシデントに対して実行される前に、hdx-evals は ClickStack 環境をプロビジョニング、スキーマ、データ生成の 3 つの段階で構築します。
プロビジョニングでは、評価用アカウント、接続、ソースに加え、ClickStack MCP (HTTP 経由) と ClickHouse MCP (stdio 経由) の両方の MCP サーバー定義を作成します。ダッシュボード、アラート、保存された検索など、調査に関係のない 11 個のツールの拒否リストにより、エージェントをクエリツールのみに集中させます。すべてが単一の eval.config.json に書き込まれ、セットアップは冪等であるため安全に再実行できます。
スキーマでは、評価テーブルを ClickStack の本番 OTel テーブルの構造的クローンとして作成するため (CREATE TABLE ... AS default.otel_traces)、近似値ではなく実際のスキーマ、エンジン、インデックスを継承します。各シナリオには 6 つのテーブルが割り当てられます。生のトレースとログに加え、ClickStack の本番メタデータ検出パスを反映した 2 段階のマテリアライズドビューパイプラインから構築されたロールアップテーブルです。つまり、MCP の「どのようなフィールドが存在するか」というクエリは、生データをスキャンするのではなく、事前集計されたロールアップにアクセスします。これは ClickStack UI でオートコンプリートやファセット生成を支えているのと同じ最適化です。これらのマテリアライズドビューの仕組みについては、ClickStack ドキュメントで詳細を読むことができます。
データ生成では、実際のテレメトリを書き込みます。すべてのランダム性はシード付きの単一 PRNG を通過するため、指定されたシードとアンカー時刻からは常にバイト単位で同一のデータが生成されます。すべての実行で同じデータセットが使われるため、MCP 間の A/B 比較に意味が生まれます。数百万行であってもメモリを一定に抑えるため、データはバッチでストリーミングされます。
各シナリオでは固定された「現在」時刻が使用され、指示とともにエージェントに渡されます。これにより、評価がいつ実行されたかに関係なく、「過去 10 分間」などのフレーズがシードされたデータ内の常に同じ期間を指すようになります。したがって、データセットは一度生成すれば再利用できます。各実行の前に、フレームワークはデータセットが存在することを確認し、必要に応じて作成します。
ランナー
データがシードされると、hdx-evals は (MCP、モデル、実行) の組み合わせごとに本物の Claude Code プロセスを生成し、足場やヒントなしで、質問とツールだけを与えて SRE と同じようにシナリオを調査させます。
| シナリオ | システムプロンプト |
|---|---|
| error-root-cause | 過去 10 分間において、一部のユーザーでチェックアウトのリクエストが失敗しています。根本原因を特定してください。 |
| latency-spike | 過去 15 分間で api-server の p99 レイテンシが跳ね上がりました。何が遅くなっており、その原因は何ですか? |
| segmented-regression | 過去 10 分間で一部のユーザーに対して API エラー率が上昇しました。回帰が集中しているセグメントと、何が問題を引き起こしているかを特定してください。 |
| service-health-check | 過去 1 時間の api-server に対する定期的なステータスチェックです。主要な SLI (トラフィック、エラー率、レイテンシ) を要約し、新しい事象や詳しく調査すべき点があれば報告してください。通常の変動はエスカレーションしないでください。簡潔に記載してください。 |
| noisy-signals | ログの取り込みコストを削減したいと考えています。ドロップまたはスロットリングすべき、最もノイズの多い上位のシグナルは何ですか? |
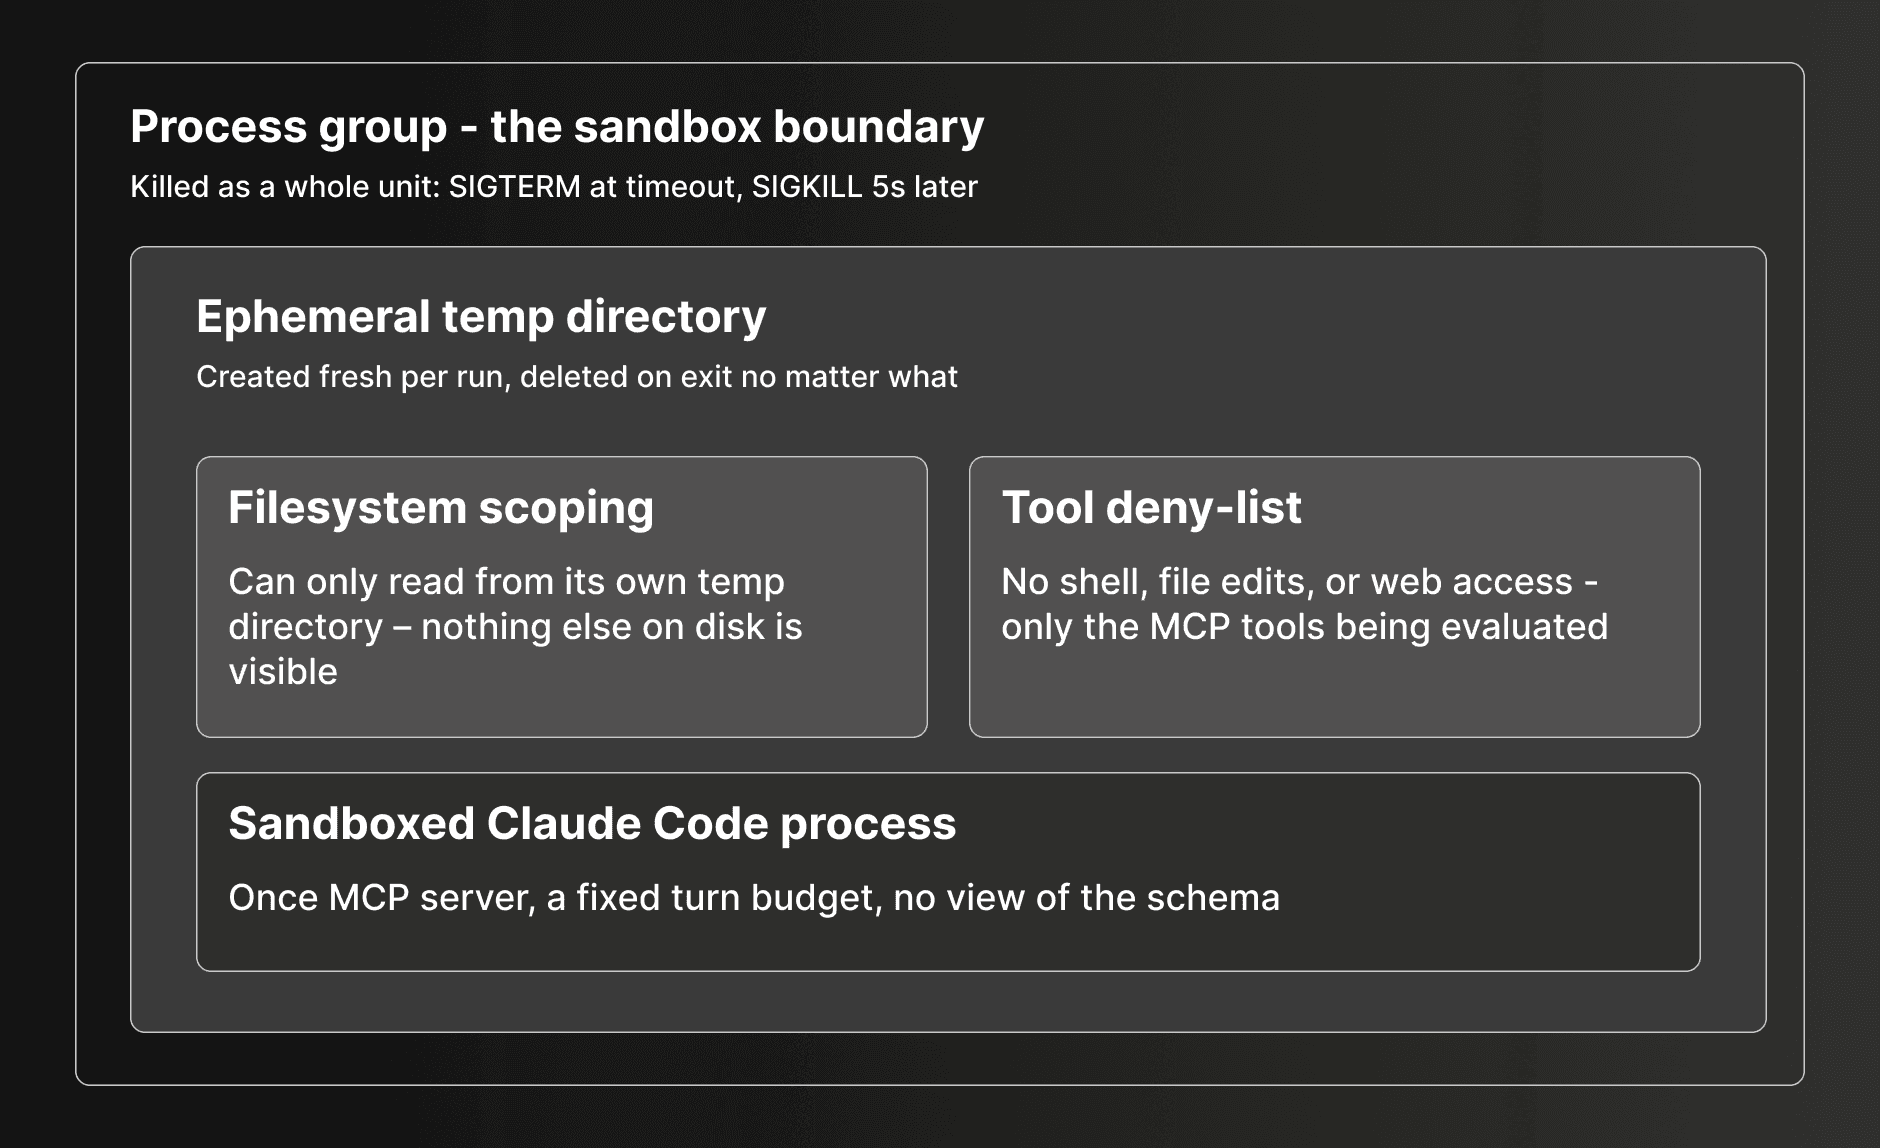
各実行には独自のサンドボックスが与えられます。新規の一時的なテンポラリディレクトリ、単一の MCP サーバー定義 (評価対象のもののみ)、そして調査ツール以外をすべて排除したツールパーミッションファイルです。bash、書き込み、編集、glob、webfetch の機能はなく、読み取りアクセスはその実行自身のテンポラリディレクトリのみにスコープされます。これは気まぐれに追加した予防策ではありません。初期の試行において、Claude が以前の実行結果、スコアリング基準、または正解データを探してファイルシステムを探索し、調査するのではなく事実上不正行為を行う方法を探していることが判明したためです。各実行を使い捨てのブラインドサンドボックス内に閉じ込めることで、その可能性を完全に排除しました。内部からはリポジトリルート、以前の実行、評価設定のいずれも参照できません。
各サンドボックスでは複数の分離レイヤーが使用されます。ファイルシステムの制限によってエージェントがアクセスできる対象を制御し、拒否リストによって実行可能なアクションを制限します。また、各実行は独自のプロセスグループで実行されるため、ランナーはクリーンアップ時にエージェントおよび任意のサブプロセスを確実に終了できます。タイムアウト時には、緩やかな SIGTERM が送信され、孤立した MCP サブプロセスなど何らかのプロセスがまだ残っている場合は、5 秒後にプロセスグループ全体に対して SIGKILL へとエスカレーションされます。プロセスが正常に起動しなかった場合でもテンポラリディレクトリは常に削除されます。有効な API キーが含まれる MCP 設定の流出は、許容できない障害モードだからです。
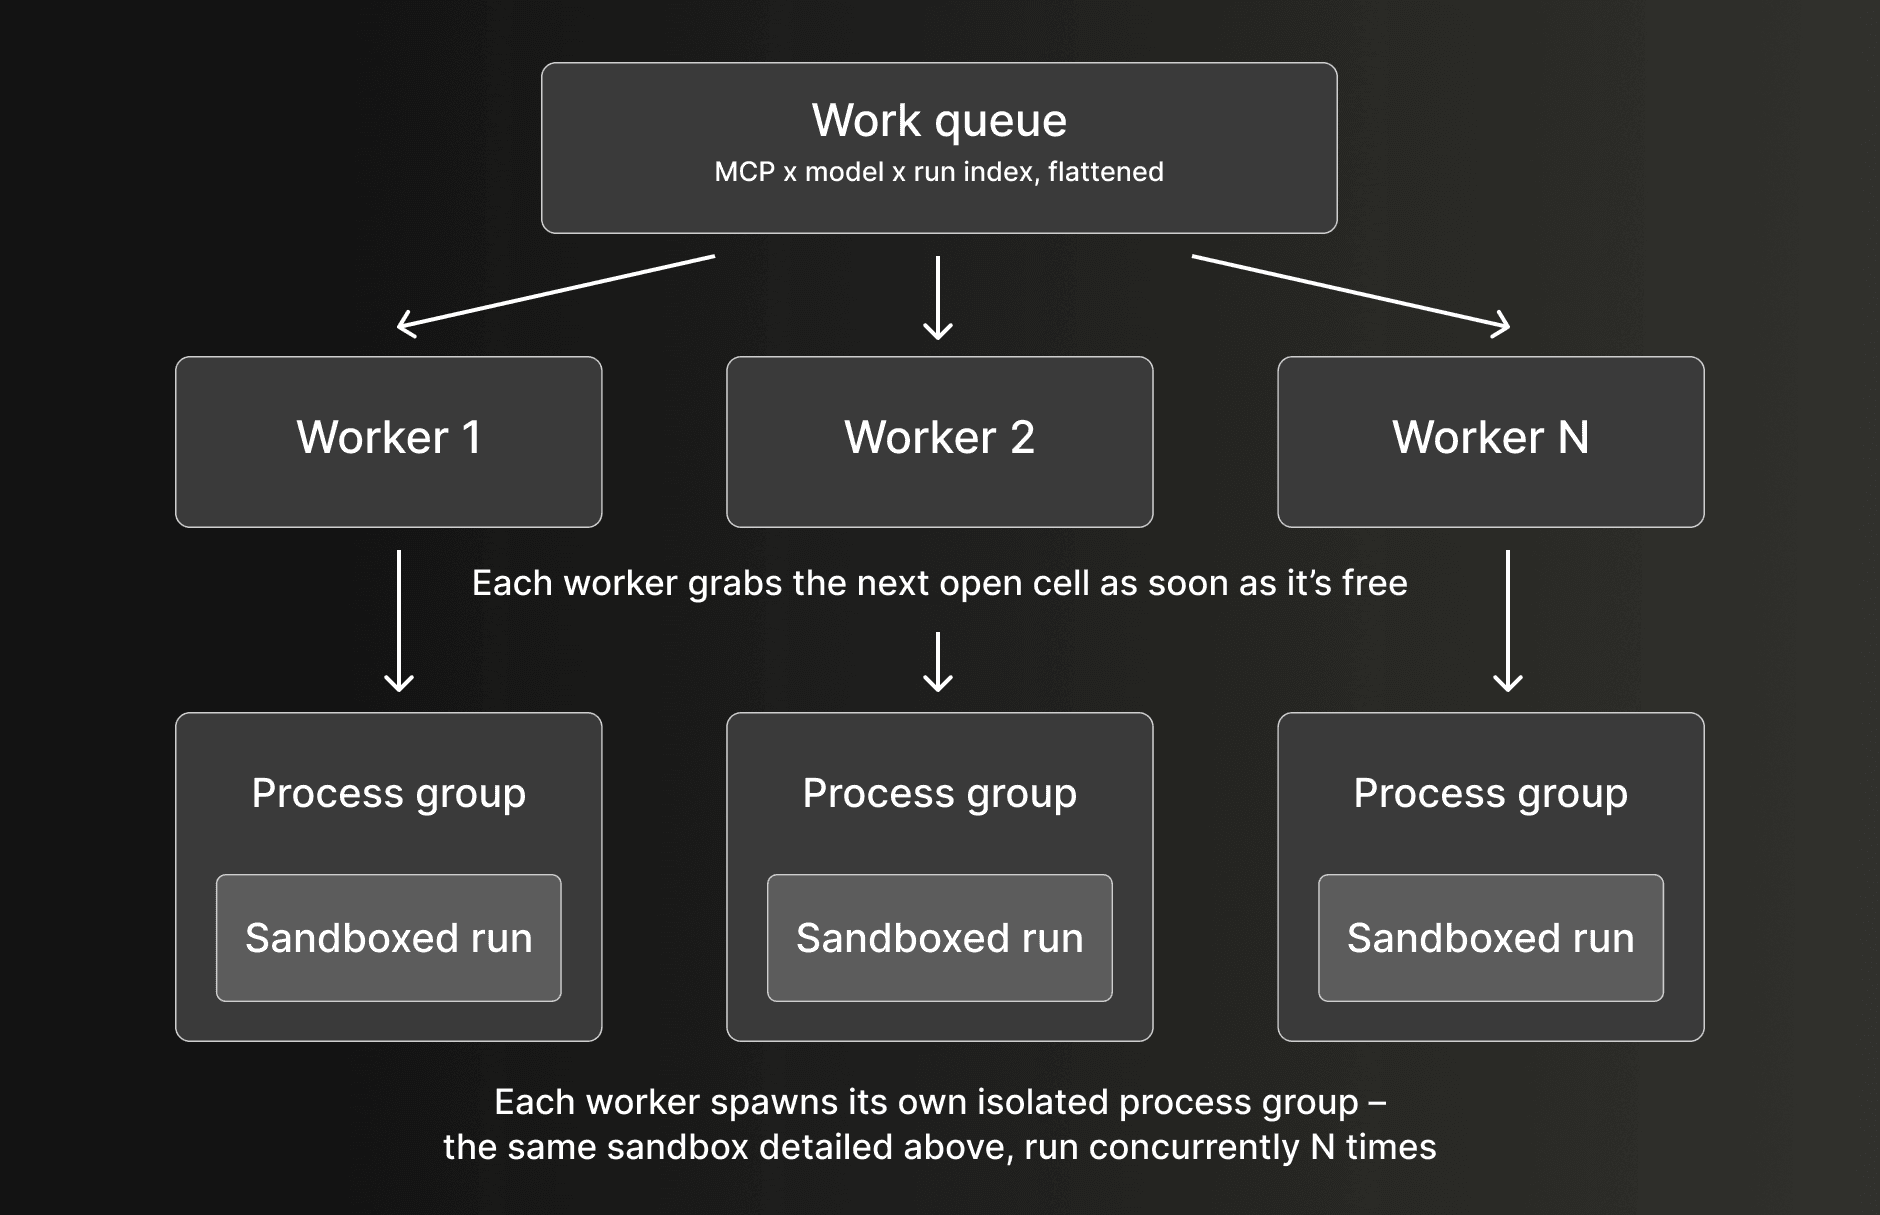
実行はシンプルなワーカープールを通じてディスパッチされます。(MCP、モデル、実行インデックス) のすべてのタプルがキューにフラット化され、ワーカーはキューが空になるまで次に利用可能なセルを取り出します。1 つの実行が失敗してもバッチ全体が停止することはありません。失敗として記録され、プールは次の処理に移ります。
各エージェントには共通のシステムプロンプトの骨格が与えられます。SRE としての役割、「過去 10 分間」が実行ごとに同じ意味を持つように固定されたアンカー時刻、そして回答を出すまでに想定される約 15〜25 回のツール呼び出しのバジェットです。私たちは意図的にスキーマを決して説明しません。スキーマの検出は前提条件ではなく評価対象の一部であるため、エージェントは MCP 自体を通じてスキーマを発見する必要があります。すべてのツール呼び出し、すべての結果、消費されたすべてのトークンを含む、各実行の完全な軌跡が記録されます。これにより採点ステップにおいて、エージェントが何を回答したかだけでなく、どのようにしてその回答にたどり着いたかを正確に再構築できます。
採点の詳細
すべての実行で最終的な回答が生成されます。これは、エージェントが根本原因を挙げ、証拠を提示し、原因ではないと考えたものを除外するテキストブロックです。その回答の採点は、プログラムによるチェック、LLM ジャッジ、ツールエラーのペナルティからなる 3 段階のパイプラインで行われ、単一のスコアへと統合されます。
プログラムによるチェックは、最終的な回答に対して直接実行される重み付けされた正規表現テストです。各シナリオには、ポジティブチェック (エージェントが正しいサービス、エラータイプ、スパンを指定しているか) とネガティブチェック (責任のないおとりを非難していないか) があります。ネガティブチェックは言語理解を行うものではなく、因果関係を示す言い回しの前後の狭い近接ウィンドウに対して照合されます。たとえば error-root-cause における TLS ハンドシェイクのおとりチェックは、「tls handshake」が「root cause」または「caused by」の 80 文字以内に現れた場合にのみトリガーされます。そのため、「the root cause was a database timeout; TLS handshake was ruled out (根本原因はデータベースのタイムアウトであり、TLS ハンドシェイクは除外された)」は一致しませんが、「the root cause was the TLS handshake failure (根本原因は TLS ハンドシェイクの失敗だった)」は一致します。これはヒューリスティックでありセマンティックなパースではないため、正規表現で捉えられない部分を補うために LLM ジャッジが存在します。
LLM ジャッジは、エージェントの推論に一貫性があるか、証拠が結論を裏付けているかなど、正規表現では評価が難しい事前定義された基準に基づいて同じ最終回答を採点します。極めて重要な点として、ジャッジが回答を見る前に、MCP 固有のツール名やブランド用語を匿名のラベル (「MCP A」、「MCP B」) に置き換えるブラインド化が行われます。これにより、エージェントがそこに至るまでにどのツールを使用したかではなく、正解データに対する回答の品質をジャッジが採点することが保証されます。統合スコアの 60% をジャッジが占めます。
ツールエラーのペナルティでは、タイムアウトしたクエリ、不正な形式の入力、誤って呼び出されたツールなど、エージェントに起因するツールの失敗に対して最大 20% が減点されます。レート制限、サーバーの 503 エラー、TCP 障害などのインフラストラクチャエラーはペナルティ計算前に除外されるため、クラスターの一時的な不調によってエージェントが不当に評価されることはありません。ペナルティは回数ベースではなく率ベースであるため、1 回の呼び出しでの 1 回の失敗は、20 回の呼び出しでの 20 回の失敗と同じように扱われます。
これら 3 つは単一の計算式に統合されます。
combined = clamp((0.4 × programmatic + 0.6 × judge) − penalty, 0, 1)ルーブリック設計に関して特筆すべき点は、ネガティブチェックがポジティブチェックと同じくらい重要であることです。error-root-cause では、エージェントが誤ったサービスとの因果関係を明示的に導き出した場合にのみトリガーされる近接正規表現を使用して、おとりごとに 1 つずつ、計 5 つのネガティブチェックが設けられています。慎重な言い回しをするエージェント (「SMTP failures were also present but are not related to the checkout errors (SMTP の失敗も存在したが、チェックアウトのエラーとは無関係である)」) は合格します。CDN を自信満々に非難するエージェントは、回答のどこかで真の根本原因を挙げていたとしても不合格になります。
得られた知見
エージェントのパフォーマンスを確実に向上させる MCP サーバーを構築するには、適切なツールを追加するだけでは不十分です。複数の側面にわたって細部を同時に正しく詰める必要があります。
ツールの説明とスキーマは見た目以上に重要です。 パラメーターが少なすぎたり、解釈の余地があるほどパラメーターの説明が曖昧だったりすると、エージェントは必要な方法でクエリを調整できません。たとえば、「filter results (結果をフィルタリングする)」としか説明されていないフィルターパラメーターがあると、モデルは構文やセマンティクスを推測せざるを得なくなり、その使用を避けるか、呼び出しごとに一貫性のない使い方をしてしまいます。一方でパラメーターが多すぎると、モデルが誤解したり混同したりする対象領域が増えるため、ハルシネーションが増加し一貫性が低下します。適切な表現力を見つけることは、継続的な調整作業です。
レスポンスの設計が最も重要な領域です。 正しい情報を返すことは最低条件にすぎません。優れた MCP ツールと並外れた MCP ツールを分けるのは、エッジケースでの動作です。返される行数が多すぎる場合、ツールはエージェントをより絞り込んだクエリへと誘導するヒントを提供すべきです。エラーが発生した場合は、生のスタックトレースではなく、次にとるべき実行可能なステップを返す必要があります。エージェントが最初のツール呼び出しで不明瞭なエラーに遭遇すると、その後の調査全体でそのツールの使用を完全に諦めてしまうことが多いことが分かりました。
スピードは複利で効果をもたらします。 ツールの応答に時間がかかりすぎると、エージェントがそれを再度呼び出す可能性は低くなります。これは調査の初期段階において特に顕著であり、エージェントがまだ仮説を構築している最中であるため、遅い応答は調査の勢いを削いでしまいます。本番環境クラスのクエリパフォーマンスは、調査の品質を直接左右します。
結果
以下の結果は、エージェントに SQL を通じたデータへの直接アクセスを提供する ClickHouse MCP サーバーと、ログやトレースの調査向けに専用のオブザーバビリティツールを備えた ClickStack MCP サーバーを比較したものです。ClickStack は 5 つすべてのシナリオで高いスコアを記録し、執筆時点でのアドバンテージは 7〜20 パーセンテージポイントに及びました。以下の数値は統合された総合スコアを測定したものです。ご自身で評価を実行すると豊富なデータポイントが得られ、多くの軸に沿って結果を分析できます。
| シナリオ | ClickStack MCP | ClickHouse SQL MCP | 差分 |
|---|---|---|---|
| error-root-cause | 93% | 73% | +20pp |
| noisy-signals | 64% | 45% | +19pp |
| latency-spike | 60% | 43% | +17pp |
| segmented-regression | 75% | 60% | +15pp |
| service-health-check | 61% | 54% | +7pp |
これらの結果は Claude Opus 4.6 を使用し、各シナリオにおいて各 MCP で 10 回の実行を行って生成しました。各評価を繰り返すことで、極端に良い実行や悪い実行の影響を軽減しています。満点は、エージェントが期待されるすべての所見を特定し、すべての誤った結論を回避し、LLM ジャッジによって評価される定性的な基準を満たしたことを意味します。
評価フレームワークの今後の展望
フレームワークは機能していますが、まだ取り組むべき重要な領域が残されています。
当面の最優先事項は、評価を CI に移行することです。これには、セットアップ時間の短縮、より小規模なマシンでの高速な同時実行を可能にする ClickHouse Cloud を活用した事前シード済みデータベースの利用、プロセスのコンテナ化、そして MCP に変更があった際に評価を自動実行するための GitHub Actions の設定が含まれます。現時点では評価は意識的に行う手動のステップですが、今後はデプロイのゲートとするべきです。
パイプラインの改善に加えて、シナリオのカバレッジを拡大したいと考えています。現在の 5 つのシナリオは、SRE の主要なワークフローであるトレースとログの調査に焦点を当てています。しかし、ClickStack の機能はそれにとどまらず、ダッシュボード生成の品質、アラートの成功率、メトリクスの調査など、それぞれ個別のシナリオを設ける価値があります。フレームワークはこれらに対応できるように設計されているため、それらを構築することが次のステップです。
目標は、新しいツール、パラメーターの名前変更、レスポンススキーマの変更など、ClickStack MCP に対するあらゆる重要な変更が、リリース前に再現可能なベンチマークを通過する hdx-evals の運用です。私たちは評価を、開発の後付けではなく、開発ワークフローの第一級の構成要素にしたいと考えています。
結論
オブザーバビリティがよりエージェント主導になるにつれて、私たちがエージェント向けに提供するツールは、本番環境のインシデント対応経路の一部となっていきます。その経路にある他のすべての要素と同様に、それらの品質は測定可能でなければなりません。Open House で共有した数値は、一過性の結果ではありません。決定論的なデータに基づき、どのツールが生成したかではなく調査の品質自体がスコアに反映されるようブラインド化された状態で、私たちが繰り返し実行しているフレームワークのアウトプットです。
これこそが、私たちが確信を持って ClickStack MCP を改善できる理由です。新しいツールの追加、スキーマの変更、レスポンスの微調整を行うたびに、ユーザーの手元に届く前に前バージョンや生の SQL ベースラインと比較して測定できます。
私たちは、他の開発者も同様の検証を行えるよう、hdx-evals をオープンソースとして公開しました。オブザーバビリティ向けの MCP ツールを構築している場合や、エージェントの一貫性が重要となるツールを開発している場合、フレームワーク、シナリオ、グレーディングパイプラインのすべてを github.com/hyperdxio/hyperdx/tree/main/packages/hdx-eval でご利用いただけます。新しいシナリオの追加やグレーディングの改善など、コミュニティからの貢献をお待ちしています。