5万


概要
9月に私たちはエージェント型分析ベンチマークを公開しました。これは、合成ClickHouseデータウェアハウス上で29のモデルがエージェント型ループ内で自身でSQLを作成しながら201の分析上の質問に答えるというものです。本記事はその続編です。
- エージェント型分析ベンチマークに5モデルを追加しました。第1弾と同じ201の質問、ウェアハウス、判定パネルを用いて、GPT-6ファミリー (Astra、Luna、Sol)、Claude Opus 5.5、Claude Sonnet 5.5を検証しました。
- Claude Fable 5.1が76.6%で首位を維持しています。新しく追加した5モデルはいずれも68.7〜69.7%の範囲に収まり、中位で統計的にほぼ同率となっています。
- デフォルトの推論エフォートでは、どのGPT-6バリアントもGPT-5.5を上回っておらず、3モデルとも1ポイント差以内に収まっています。
- 今回のラウンドで最も大きな世代的進化を見せたのはSonnet 5.5です。Sonnet 5から6.5ポイント向上し、予算超過による打ち切り実行は16回からゼロ回になり、質問1件あたり約5セントでした。
本記事で使用する用語
- ボード: 60ターンの上限内で201問の正解率に基づき順位付けされた34モデル。構成は固定されており、新しいモデルも同じ質問、ウェアハウス、判定員(judge)で追加されます。
- ターン: モデルの1回の呼び出し。1ターンで複数のSQLクエリを発行できます。上限は1問あたり60ターンです。
- ターン上限到達(TL: Turn-limited): 回答を出せずに60ターンの上限に達した実行。不合格としてカウントされます。
- 判定パネル: 各回答に対して投票を行う、プロバイダーごとに1席を割り当てた3名のモデル判定員。評価対象モデル自身のモデルが自分を採点することはありません。
- カラムリンカー: 2つの正解回答でカラム名が異なる場合があります。一方の回答のカラムがもう一方のカラムを包含している場合、共通するカラムはモデルを呼び出すことなく名前で一致させます。それ以外の場合は、小型モデルにどのカラムが対応するかを問い合わせ、そのマッピングに基づいて結果の比較を実行します。
- ディメンショナルCRMレイヤー(dbt_dds): ウェアハウスの正規化テーブル群。201問中83問でこれらを必要とし、これらを見つけ出せるかが第1回の記事における主要な識別要素でした。
第1回の記事からの変更点
第1回の記事では、60ターンの上限、決定論的な結果比較、プロバイダーごとに1席を持ち自モデルを採点しない判定パネルによるエージェント型ループ(モデルがSQLを書き、結果を読み取り、回答のタイミングを判断する)を実行しました。この点に変更はありません。本記事では5つのモデルを追加しています。
テストハーネスにも変更が加えられました。github.com/ClickHouse/data-agent-mnist で公開されており、ボードの実行ツリーと同期されています。第1回の記事でリンクされたバージョンからの変更点は以下のとおりです。
- エンジンとタイムゾーンの固定。 ボードのマニフェストにクエリエンジンのリリースとセッションのタイムゾーンを記録し、異なる環境での実行を拒否します。エンジンが意図せずアップグレードされたことで、ある質問の正解データ(ground truth)が反転してしまったことがありました。これこそ、再現可能なベンチマークが防ぐべきドリフトです。
- 認証情報の事前確認。 候補モデル、判定員、カラムリンカーがアクセスするすべてのプロバイダーを、最初の有料呼び出しの前に確認します。これにより、判定員の認証情報が無効な場合に、1問ずつスコアリングの精度を落とすことなく実行を停止できます。
- 設定項目としての数値許容範囲。 比較機能は金額データのみを想定したものではなくなりました。丸め処理と許容誤差はモデル設定のスコアリングセクションとなり、通貨値がデフォルトとして設定されています。
- ワイドな結果セットに対するリンカーの修正。 一方の回答のカラムがもう一方のカラムを包含している場合、共通カラムはモデルを呼び出さずに完全一致でマッピングされます。この修正は以降の実行にのみ適用され、公開済みのボードの再スコアリングは行っていません。
- 不確実性を考慮した判定モデル。 キャッシュされたパネルの投票データに対して多面ラッシュモデル(many-facet Rasch model)を適用し、結果ファイルからオフラインで、ブートストラップ区間を伴う候補の能力、判定員の厳しさ、自系統係数を算出します。
- 実験用のフック。 2つ目のコーパスを1つの環境変数で指定できるようにしたため、開発用セットを固定されたボードと並行して保持できます。すべてのランナーは、クエリ結果にメモを付与できるゲートコールバックを受け取ります。
- LibreChatランナー。 直接ループと同じ質問、ウェアハウス、パネルを使用してLibreChatエージェントをスコアリングするランナーです。ボード全体において、この製品は同一モデルの直接ループでの66.2%に対し、ノイズの範囲内である69.7%を記録しました。
第1回の記事で実施したコンタミネーション検証を、新たに追加した5つのモデルすべてに対して実行しました。質問の先頭部分から匿名化されたエンティティ名を復元できたモデルはなく(各25問中0問)、質問に対する補完の類似度もボードの他のモデルと同等の低い水準にとどまりました。5つのうちSpider対照群を持つ唯一のモデルであるSonnet 5.5は、Spider開発セットで81%のエンティティ名を復元したのに対し、私たちの質問では7%にとどまりました。この結果から、暗記が存在する場合にはこの検証が確実に検知できることがわかります。
34モデルによるボード
下の図では、60ターンの上限における正解率順にモデルをランク付けしています。新しく追加された5つの行は青色で示されています。
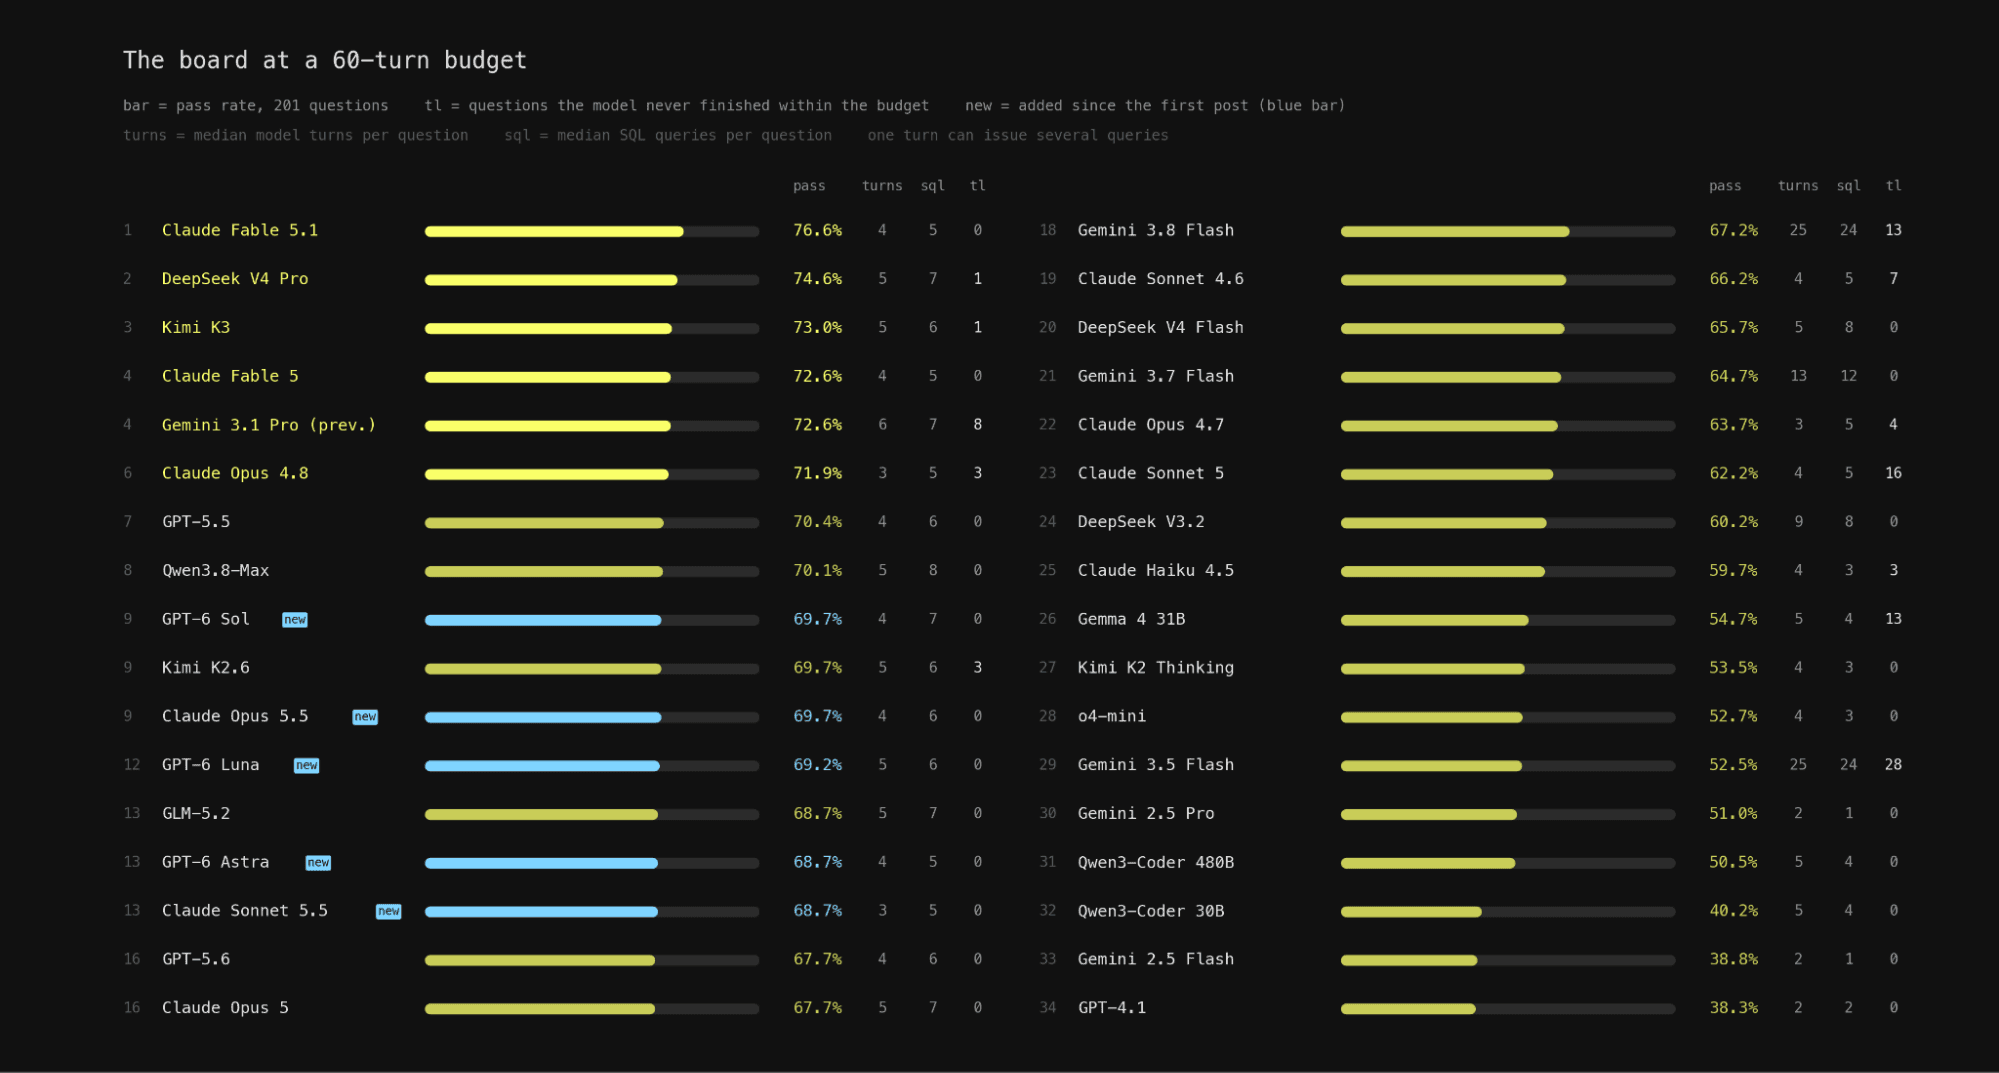
60ターンの上限におけるボード(34モデル)。鮮やかな黄色は、首位と統計的に同等(タイ)の6つの行を示しています。201問において、95%信頼区間はおよそ±6〜7ポイントです。ターン数とSQL数は1問あたりの中央値です。TLは、モデルが予算内で完了できなかった質問の数を示します。青色のバーは、第1回の記事以降に追加された5つのモデルを示しています。
ボードの上位陣は第1回の記事から変わっていません。追加された5つのモデルはいずれも9位から15位の間に位置し、5つすべてがすべての質問で回答を完了しました。この点は、TLカラムが示すようにフロンティアモデルであっても当然のことではありません。
GPT-6ファミリー
GPT-6 Astra、Luna、Solは、ボード上の他のOpenAIモデルと同じOpenAI互換の経路を使用し、デフォルトの推論エフォート(reasoning effort)で実行されました。区間が重複する68.7〜69.7%に収まり、GPT-5.5(70.4%)のわずか下、GPT-5.6(67.7%)の上に位置しています。今回の結果では、GPT-6のバリアントはいずれも前世代を上回りませんでした。3モデルすべてが上限内で全質問に回答を完了し、その失敗の傾向は、実行時エラーはなく計画の誤りが先行するというボード全体で一般的なものでした。
デフォルトのエフォート設定である点には留意が必要です。第1回の記事では、Geminiのラインにおいて、予算に応じた調整ノブが数値を大きく変動させることが示されました。GPT-6は、ボード上のどのモデルも実行されていない「xhigh」エフォートをサポートしています。その検証が実施されるまでは、これらの行は「デフォルトエフォートのGPT-6」という位置付けになります。
Claude Opus 5.5
Opus 5.5は69.7%でランクインしました。Opus 5を2.0ポイント上回ってノイズの範囲内に収まり、Kimi K2.6やGPT-6 Solと同水準です。Opus 5と同様にすべての質問で回答を完了し、中央値は5ターン7クエリに対して4ターン6クエリと、ループがわずかに短縮されました。
Claude Sonnet 5.5
Sonnet 5.5は5つの中で最も興味深いモデルです。精度はわずかに変化しただけですが、それ以外のあらゆる要素が大きく変化しました。
精度。 Sonnet 5の62.2%に対し、68.7%(201問中138問)でした。同じ質問で比較すると31勝18敗で、p値は約0.09、実質13勝の勝ち越しとなり、有意ではないものの方向性のある差が見られます。GLM-5.2およびGPT-6 Astraと同等で、Opus 5を1ポイント上回り、Opus 5.5を1ポイント下回っています。
向上の要因。 ディメンショナルCRMレイヤー(dbt_dds)を必要とする83の質問において、Sonnet 5の正解率が62.7%であったのに対し、Sonnet 5.5は73.5%を記録しました。それ以外の質問では61.9%に対して65.3%でした。向上したのは複数ホップ(multi-hop)を要する質問であり、テーブルの検出頻度が高まったことによるものではありません。どちらのモデルも、ディメンショナルレイヤーを必要とする質問のおよそ89%でそれを発見しています。発見したテーブルの活用精度が向上しています。
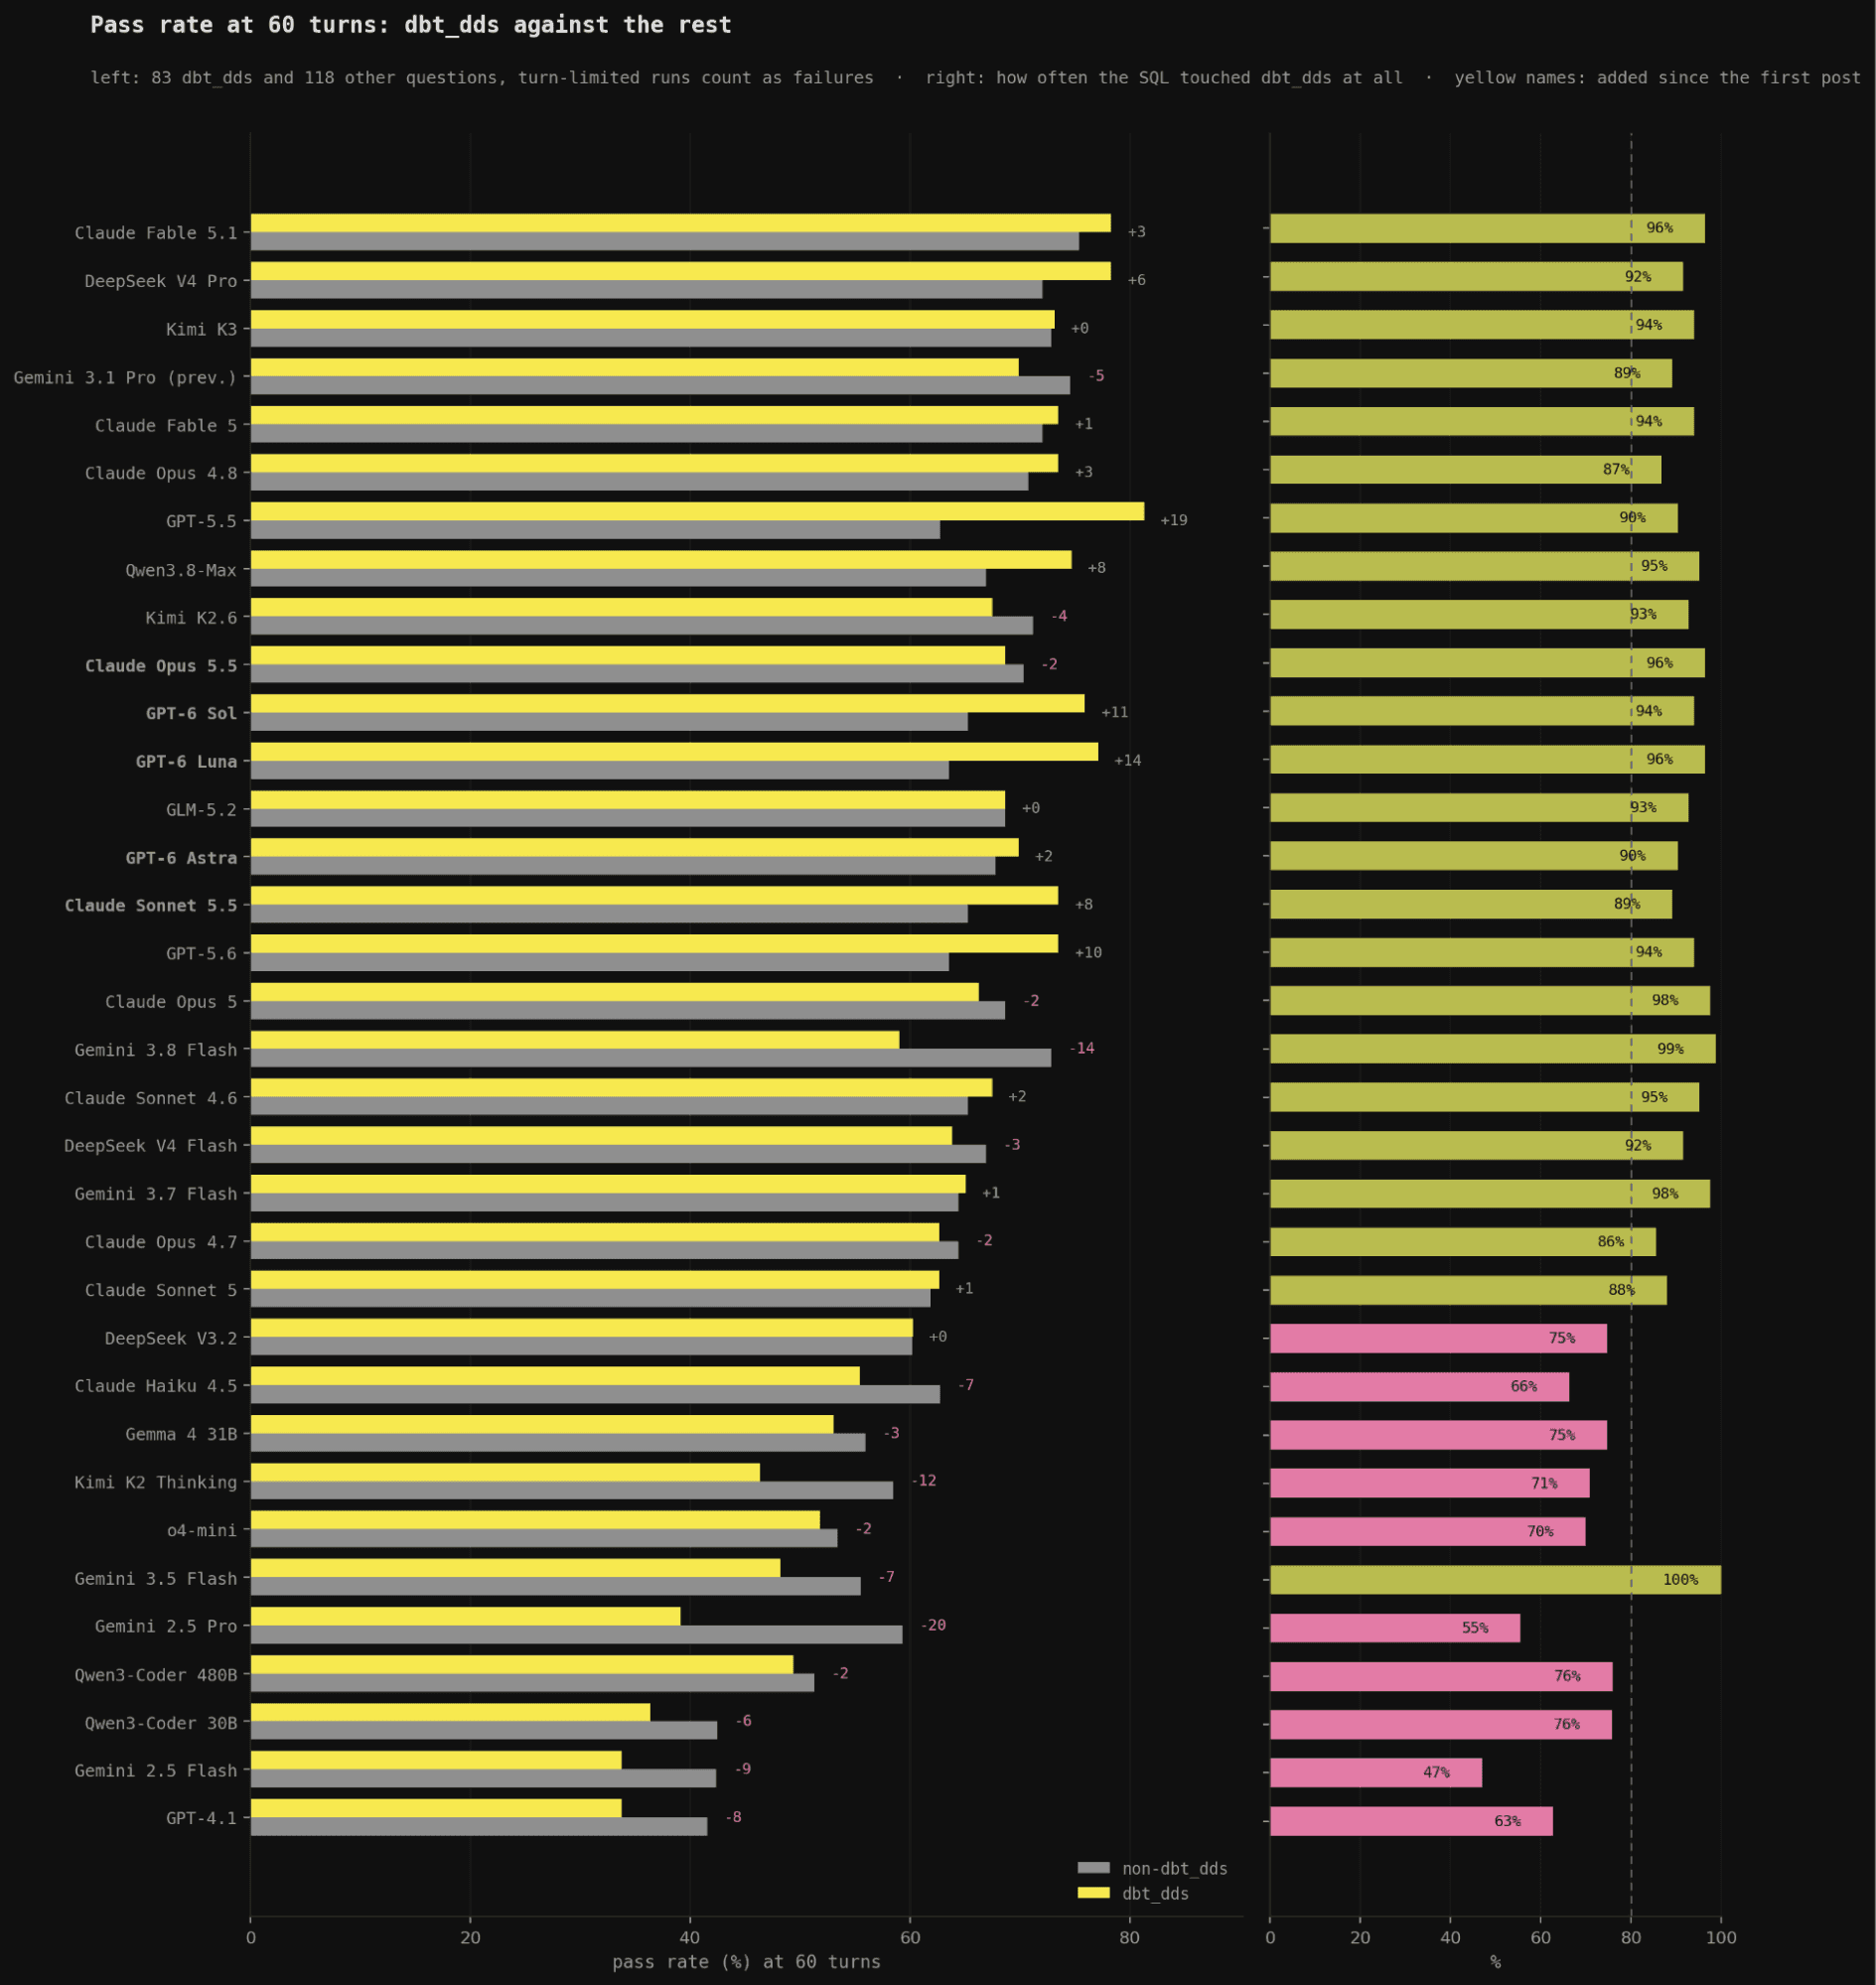
ディメンショナル(dbt_dds)に関する83の質問とその他118の質問における60ターンでの正解率(34モデル)、および各モデルのSQLがディメンショナルレイヤーに1回でもアクセスした頻度。新たに追加された行は、ディメンショナルな質問において他の質問より2ポイント低かったOpus 5.5を除き、すべて同等以上の成果を維持または獲得しています。
効率性。 ここに最大の改善が見られます。Sonnet 5は201回の実行中16回で60ターンの上限に達したため、正解率は完了した実行での数値を5ポイント下回っていました。Sonnet 5.5は上限到達が0回で、1問あたりの平均ターン数は9.1ターンに対して3.5ターン、回答時間の中央値は26秒に対して13.7秒、定価での全実行コストは14.40ドルに対して10.39ドル(1問あたり約7セントに対して約5セント)でした。
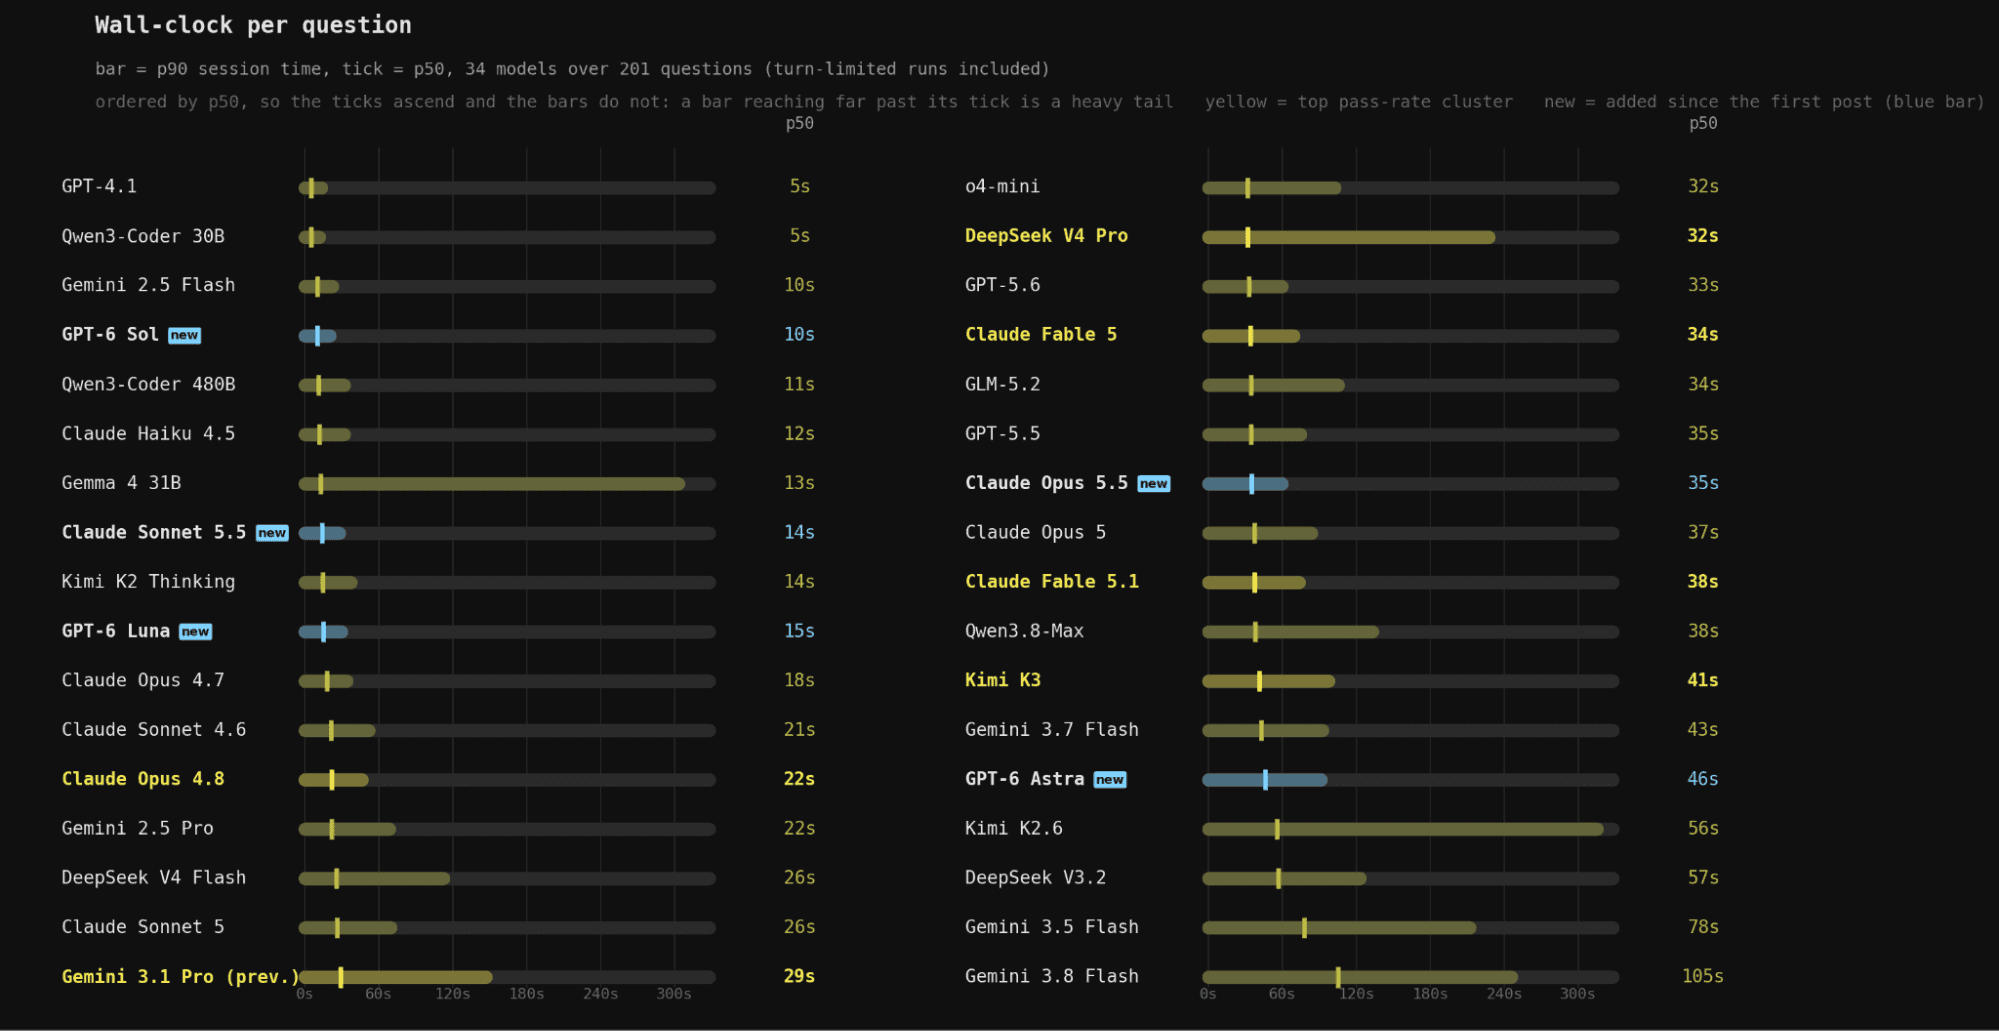
1問あたりの経過時間(34モデル、中央値(目盛り)順)。バーは90パーセンタイルを示します。GPT-6 SolとSonnet 5.5はボード上で最も高速なグループに属しています。Astraは新しい行の中で最も遅く、中央値は46秒、90パーセンタイルは90秒を超えています。
失敗の傾向。 Sonnet 5.5の63件の失敗のうち、75%が計画の誤り、19%がデータ選択の誤り、6%が実装の誤りでした。試行なしや実行時エラーはありませんでした。Sonnet 5では試行なしが5%、実装の誤りが15%ありました。Sonnet 5.5は常に試行を行い、計算を正しく行う頻度も高くなっています。失敗する場合、その原因は計画にあります。
全体像は変わらず、ベースラインが底上げ
第1回の記事で見られた2つの結果は、5つのモデルが追加された後も維持されています。
計画が依然として主な失敗原因です。 新しいすべてのモデルにおいて、最大の割合を占めるのは計画の誤りであり、実行時エラーは見られません。このクラスのモデルにとってSQLの実行は解決済みの問題であり、残る課題は何を計算すべきかを判断することです。
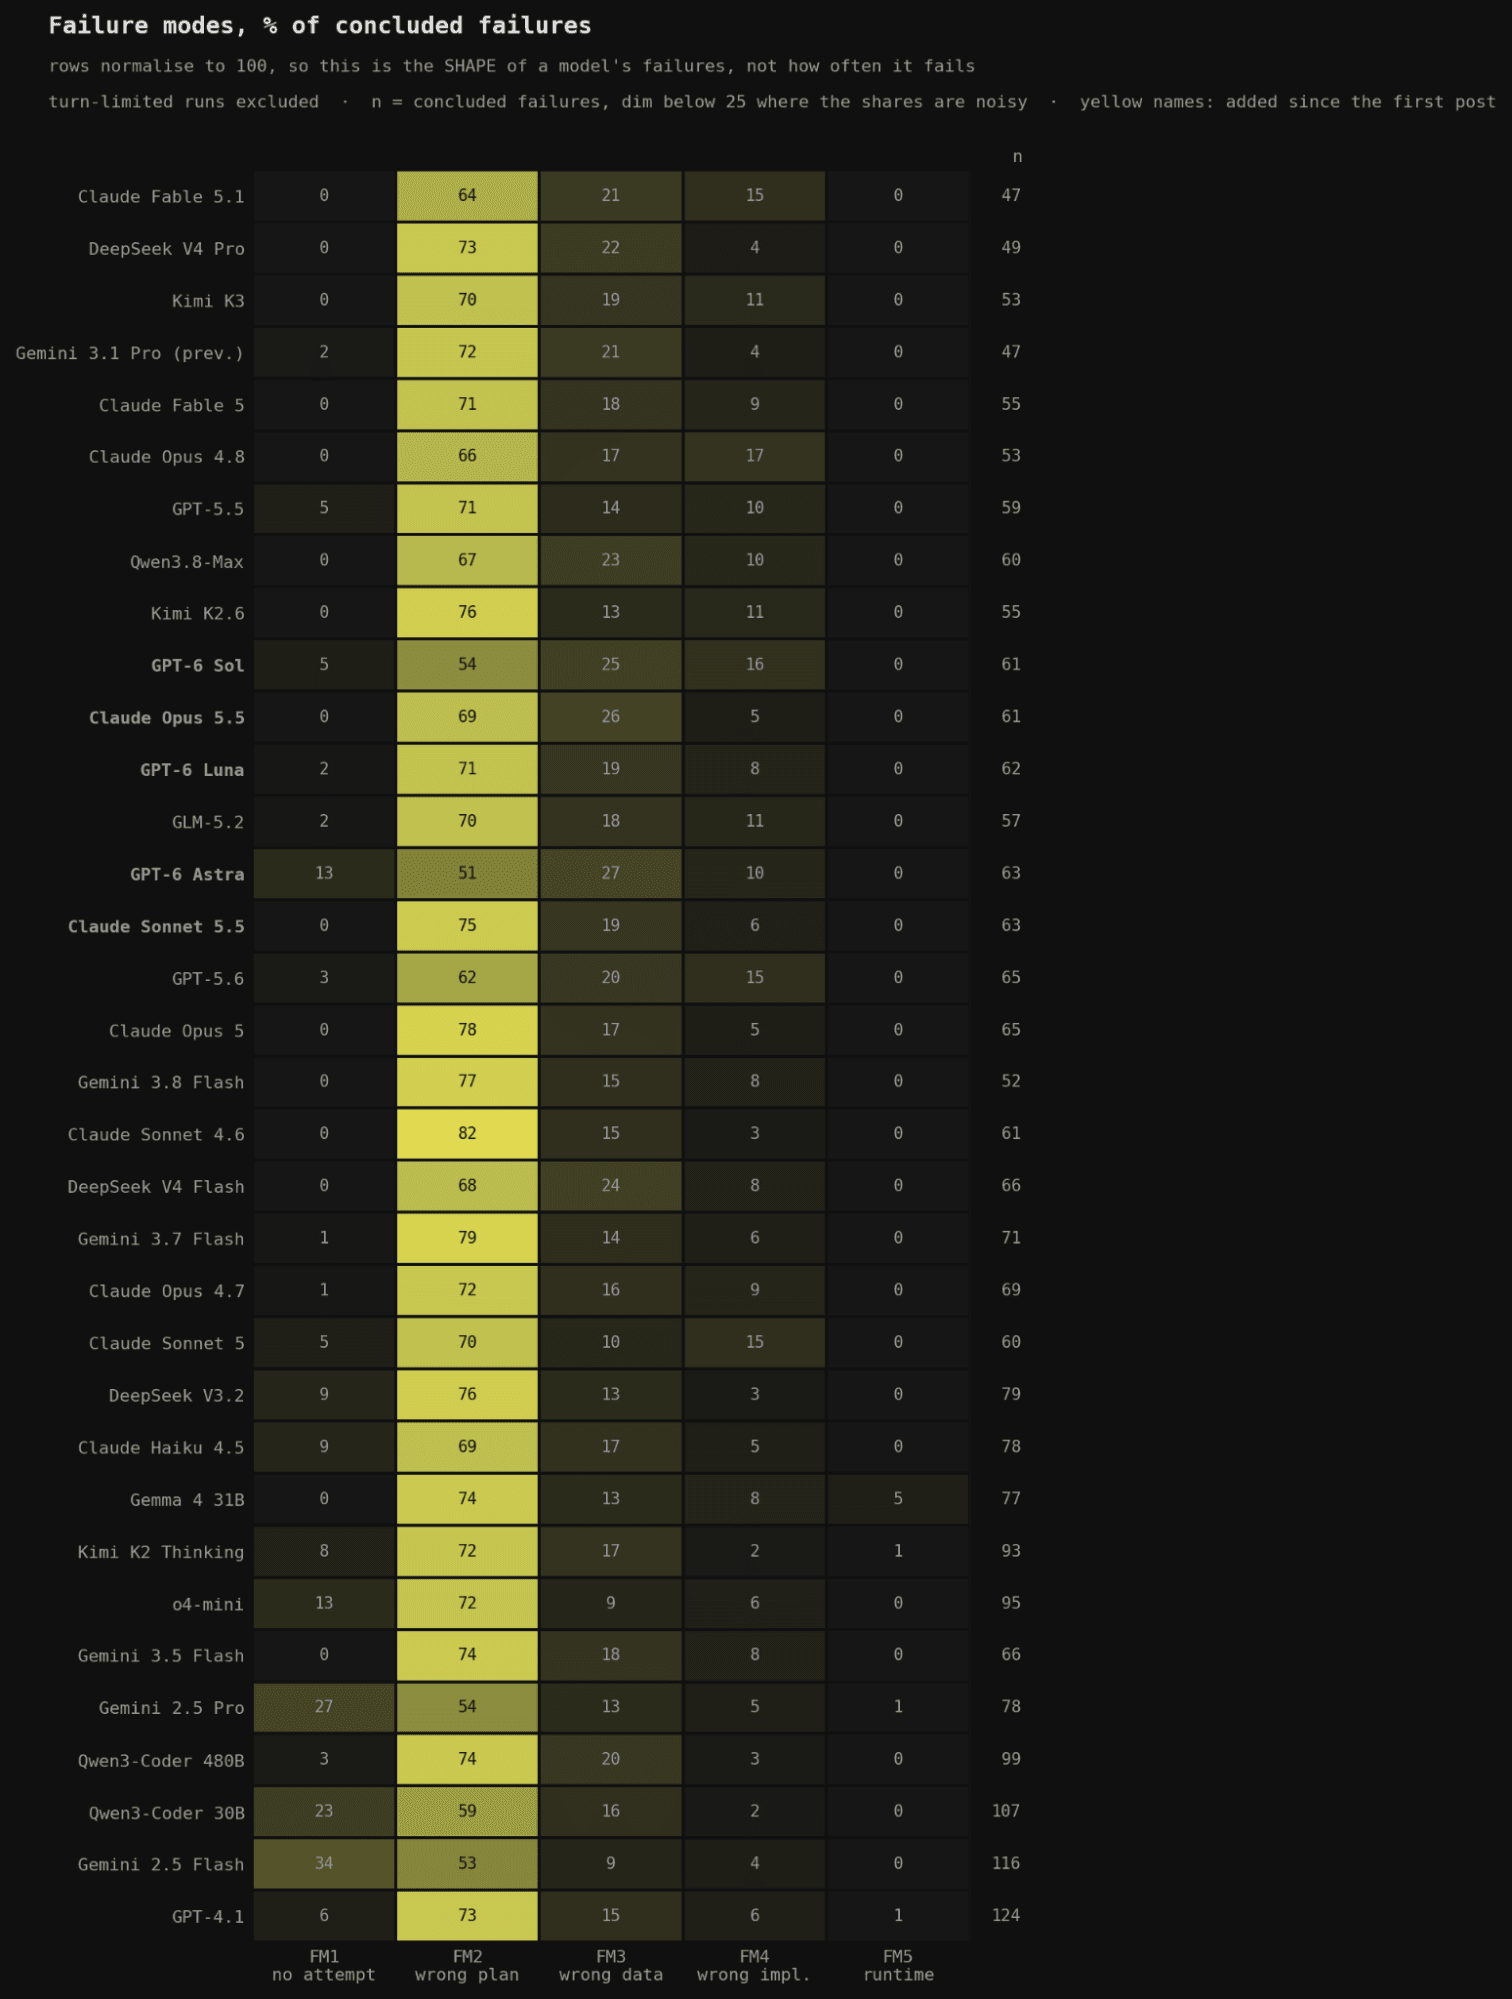
各モデルの回答完了に至った失敗の内訳(34モデル、ターン上限に達した実行を除く)。新しく追加されたすべての行において計画の誤りが最大のシェアを占めており、51%(Astra)から75%(Sonnet 5.5)に及びます。また、5つのモデルのいずれも実行時エラーを出しませんでした。Astraはデータ選択の誤りが27%、試行なしが13%と際立っています。Opus 5.5とSonnet 5.5は常に試行を行っています。
上位グループ内では依然として価格に8倍の開きがあり、中間層はその差を縮めつつあります。 最初のボードでは、同一ファミリー内の安価なモデルが予算切れを起こしていました。Sonnet 5はOpus 5の0問に対して16問で上限に達し、Gemini 3.5 Flashは28問で上限に達しました。Sonnet 5.5はそのパターンを打破しています。打ち切りとなる実行を出すことなく、Opus 5の約5分の1のコストでボード全体を実行し、1ポイント以内の差につけています。
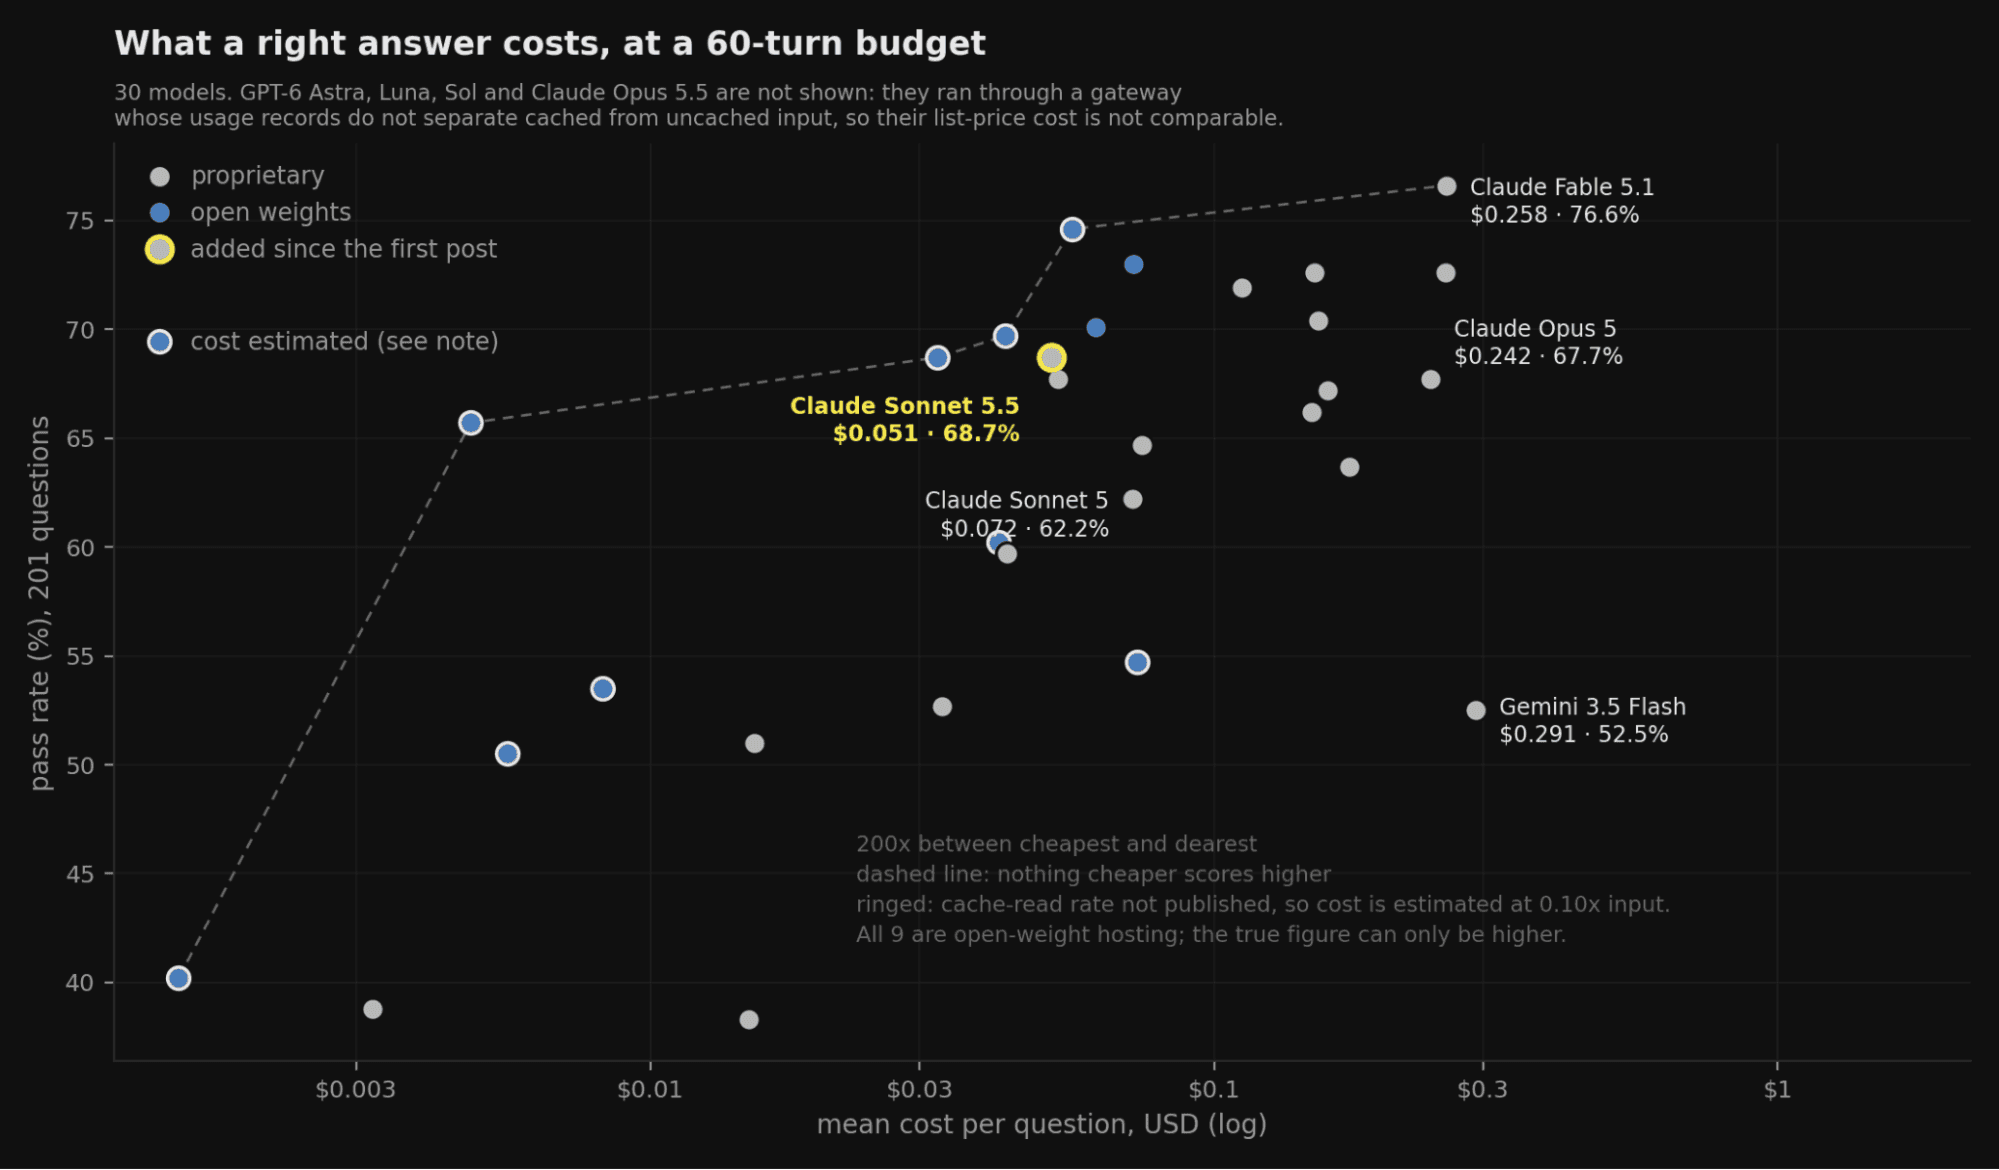
正解率に対する1問あたりの平均定価コスト(30モデル、対数スケール)。Sonnet 5.5は1問あたり約5セントで、コストフロンティアのすぐ右側に位置しています。GPT-6 Astra、Luna、SolおよびOpus 5.5は除外されています。これらはキャッシュされた入力とキャッシュされていない入力を利用実績で正確に分離できないゲートウェイ経由で実行されたため、それらに基づく定価コストはGPT-6では低すぎ、Opus 5.5では高すぎることになります。
前回、モデルを選定するにはユーザー自身でベンチマークを実行する必要があると述べました。新たに5つのフロンティアモデルを経た今も、その助言は変わりません。最上位のスコアはほとんど動いておらず、実際に変化した特性(ターン数、コスト、打ち切り)こそが、リーダーボードの単一の数字からは見えなくなっているものだからです。
自社のデータウェアハウスで実行する
ここで紹介した内容は、ClickHouseや私たちのウェアハウスに特有のものではありません。テストハーネスは第1回の記事で説明したものと同じです。計測機能を備えたアシスタント、モデル化されたウェアハウススキーマ、委員会による正解データを備えた精査・匿名化済みの質問セット、そしてどのモデルも自分自身の回答を採点しない判定パネルで構成されています。モデルの追加はレジストリへの登録と1つのコマンドで完了し、エンジンが固定されているため再実行してもボードを再現できます。
ウェアハウスごとに固有の識別要素が存在します。私たちの環境ではディメンショナルCRMレイヤーでしたが、お使いの環境ではSlowly Changing Dimension(緩やかに変化するディメンション)、半構造化イベントテーブル、あるいは明文化されていない命名規則かもしれません。それを見つけ出す唯一の方法は、自身のスキーマと自身の質問でベンチマークを実行し、モデルがどこで失敗しているかを確認することです。
今後の展望
GPT-6ファミリーにおける推論エフォートの検証を行い、3つのバリアントを複数のエフォートレベルで比較する予定です。第1回の記事で取り上げた役割分担アーキテクチャの検証(最強のモデルが計画を立て、最も安価なモデルが実行する)は、引き続き私たちが最も関心を寄せているテーマです。本記事に続いて、失敗のラベリングとテーブルのランキングに関する関連記事を公開予定です。
コード
- テストハーネス: github.com/ClickHouse/data-agent-mnist、Apache 2.0。examples/ 配下にある2つの動作サンプルは、公開されたツリーから3つのAPIキーを使用して実行できます。
今すぐ始める
自社データでClickHouseがどのように機能するか試してみたいですか? わずか数分でClickHouse Cloudを開始でき、300ドル分の無料クレジットをご利用いただけます。
サインアップ