5.1万


ClickHouse Cloud は AWS、GCP、Azure にまたがる何千もの Kubernetes ノード上で稼働しています。この規模になると、ディスク故障、カーネルタスクのスタック、中途半端にしか機能しないネットワークといったノード障害が日常茶飯事になります。こうした障害の大半は、一見するとノード障害には見えません。Kubernetes はノードを依然として Ready と報告し、クラウドプロバイダーのコンソールでもインスタンスは稼働中と表示されます。代わりに目にするのは、キャッシュディスクに書き込めない ClickHouse レプリカ、ContainerCreating のまま進まない Pod、あるいは 1 台のレプリカではタイムアウトするのに他のレプリカでは正常に完了するクエリです。
クラウドサービスプロバイダー (CSP) がこうした問題の検知と修正を試みることもありますが、100% のケースで成功しているわけではありません。また、「修正」の挙動はクラウドプロバイダーごとに異なり、必ずしも個々の問題に対する最適解とは限りません。私たちは CSP 間でより高い制御性と一貫性を確保したいと考えました。そこで、Compute Layer Reliability と呼ぶプロジェクトを立ち上げました。
本記事では、各クラウドにおけるノード健全性の扱いを調査してわかったこと、検知と対処の両方を自前で担うことにした理由、そしてその実装のために構築または採用した全 3 種のコンポーネントについて解説します。
-
Node Problem Detector (NPD): センサー。クラウドネイティブコンポーネントを私たちの要件に合わせて採用したものです。すべてのノード上で稼働し、カーネルやシステムログの行といくつかのアクティブプローブを Kubernetes ノードの Condition および Event に変換します。
-
Node Problem Mitigator (NPM): アクチュエーター。これらの Condition を監視し、taint、drain、そしてインスタンスの終了という制御された手順でノードをサービスから切り離すコントローラーです。
-
Node Debug Collector (NDC): フォレンジックツール。ノードが消失する前に、たとえそのノードに到達できなくなっていても、ログとシステムの状態を取得します。
なぜ始め、何を学び、何を決定したのか
きっかけとなったインシデント
ある EC2 ノードで、ソフトウェア RAID アレイを構成する 2 台の NVMe ドライブのうち 1 台が故障しているのを発見しました。カーネルは raid0 array has a missing/failed member をログに記録し、それに続いてキャッシュファイルシステム上の EXT4 エラーと I/O エラーを大量に出力していました。そのノード上の ClickHouse Pod では長時間にわたり書き込みが失敗し続けていました。データ損失はありませんでしたが、システムは劣化状態にあり、オンコール担当者は根本原因の特定に多くの時間を費やしました。
ノード自体の異常についてページャー通知を受けた者は誰一人いませんでした。Kubernetes の Node オブジェクトは Ready ステータスのままであり、クラウドプロバイダーもインスタンスにフラグを立てていませんでした。障害が確認できた唯一の場所は、VM 自身のカーネルリングバッファだけでした。
そのクラスターでは Node Problem Detector を稼働させていました。NPD はこの用途における標準の Kubernetes ツールであり、カーネルおよびシステムログを追跡してルールと照合し、Node オブジェクト上に問題を報告する DaemonSet です。ログを確認したところ、NPD は EXT4 エラーにマッチしていました。しかし、EXT4 エラーに対するアップストリームのルールは「temporary (一時的)」とマークされています。一時的なルールは 1 時間で期限切れになる Kubernetes Event を生成するだけで、Node Condition は設定せず、私たちのスタック内のどのコンポーネントもそれに反応しませんでした。
他にも、単にノードを drain するだけでさまざまな問題が解決するケースがありました。そのたびに人間がログを読んで問題を見つけ、毎回同じ対処を行っていました。
Kubernetes が提供するものと、その限界
Kubernetes には組み込みの Node condition として、Ready、MemoryPressure、DiskPressure、PIDPressure、NetworkUnavailable があります。kubelet がこれらを設定し、Kubernetes の組み込みコントローラーがそれに反応します。Ready が false になると、ノードに taint が付与され、Pod が退避 (evict) させられます。
これらの Condition がカバーするのは、kubelet 自身から見たノードの状態です。劣化した RAID アレイ、読み取り専用になったファイルシステム、ハングしたカーネルタスクでスタックしたコンテナランタイムなど、VM が劣化しているにもかかわらず kubelet が Ready を報告し続ける数多くの故障モードはカバーされません。
Kubernetes v1.37 では Lifecycle Conditions がサポートされ、ノード状態の監視と drain プロセスの制御が一部改善されています。しかし、これはプロジェクト開始時点では利用できず、現在も本番環境で採用するにはまだ十分に成熟していません。
プロジェクト以前、各クラウドはどう対処していたか
私たちは 3 社のクラウド上でフリートを運用していましたが、それぞれの対応は異なっていました。各クラウドについて徹底的な調査を行い、一部のクラウドプロバイダーが提供している組み込み VM エージェントから、実際に稼働している設定を抽出しました。その結果判明したのは以下のとおりです。
AWS では、ディスク断片化のヒューリスティックによってノードが繰り返し異常とマークされるケースが見られたため、ノードの自動修復 (auto-repair) を意図的に無効化していました。また、自動修復の挙動はノードへのボリュームのマウントやアンマウントの方法にも影響します。自動修復の完了を待つよりも、異常なノードから単純に Pod を退避させる方が高速です。ほとんどのケースで自動修復はノードのインプレース再起動であり、実行中のコンテナが短時間停止することを意味します。しかも再起動されたノードでは、同じ問題が再発することがよくありました。
GCP では、プロバイダーがカスタムプラグインをいくつか含む多数のチェック項目を備えた独自の NPD をすべてのノードにデプロイしています。自動修復は同様の理由で無効化していました。組み込みの NPD チェックは、私たちが重視する重要なシグナルをカバーしていませんでした。
Azure では、プロバイダーが同じく多数のチェックを備えた NPD をホストプロセスとして実行しています。Azure には、NPD が公開した Condition に基づいて動作する組み込みの仕組みがありません。また、これらの VM に対する自動修復メカニズムを制御する手段もありません。Azure によって問題が検知された場合、VM は再起動、再イメージ化、または再デプロイされる可能性があります。つまり、処理が完了した後に以前の問題が再発する可能性が残るうえ、私たちが重視するシグナルは依然としてカバーされません。
下した決定
私たちは独自の道を選ぶことにしました。3 社のクラウドプロバイダーすべてにわたり、一貫した検知、対処、デバッグ情報収集を実装することです。
- 検知を自前で担う。3 社すべてのクラウド上で、独自の node-problem-detector (NPD) 設定を実行します。実際に遭遇した障害に基づき、チェック項目を自分たちで記述します。運用に悪影響を及ぼす障害は、1 時間で消える Event ではなく、永続的な Condition にします。
- 対処を自前で担う。ノードのインプレース修復は試みません。ハードウェアやカーネルの問題を報告したノードはサービスから切り離し、健全なノードへワークロードを再スケジュールします。私たちは node-problem-mitigator (NPM) というコントローラーを開発しました。これは NPD が公開する Condition を監視し、Condition ごとに設定された 1 種類のレスポンス (監視のみからインスタンス終了まで) を適用します。
- 証拠を保全する。プロジェクト以前、異常なノードから診断情報を収集する作業は drain との手作業による時間との戦いであり、すでにノードが応答しなくなっていることも珍しくありませんでした。オペレーターは CSP ごとに異なる手順を記憶し、収集したデータを分析用の共有ストレージへアップロードするために毎回同じ一連のコマンドを実行する必要がありました。これらの課題を解決するために、node-debug-collector を作成しました。
Node Problem Detector: 異常なノードを Kubernetes に可視化する
Kubernetes はノードの内部を見ることができない
ここまで見てきたように、一部のノード障害は Kubernetes まで届きません。カーネルのソフトロックアップやマウントに失敗した NVMe キャッシュディスクは、ワークロードに影響を与えながらもノードを Ready のままにします。こうした障害を Kubernetes が理解できるシグナルに変換する、ノード内部のセンサーが必要でした。
私たちは独自のエージェントを一から書くのではなく、アップストリームの Node Problem Detector (NPD) を選択しました。軽量な DaemonSet であり、活発にメンテナンスされており、標準の Node Condition と Event を出力します。アップストリームのイメージには一切手を加えずにデプロイしています。私たちが追加するのはすべて設定のみであるため、3 社のクラウドにまたがる全クラスターが単一のチェックカタログを持つ同じ検出器を実行でき、チェックの追加や調整も設定変更とロールアウトだけで完結します。
内部からの監視
NPD には複数のモニター種別が用意されており、そのうち 2 種類を使用しています。
ログモニター: NPD がカーネルリングバッファや journald ユニットを追跡し、すべての行を正規表現ルールと照合します。低コストで、ログに痕跡を残す事象であれば何でもカバーできます。以下は ext4 ファイルシステム上のエラーを捕捉するルールです:
{
"type": "permanent",
"condition": "Ext4Error",
"reason": "Ext4HasError",
"pattern": "EXT4-fs error .*"
}ログモニターの主な欠点は、一度設定されると解除されない性質 (stickiness) にあります。ログパターンにマッチした後、結果として設定された Node Condition は無期限にアクティブなまま残ります。これに対しカスタムプラグインモニターはチェックを繰り返し実行し、最新の結果に基づいて Condition を更新します。
カスタムプラグインモニター: スケジュールに従ってスクリプトを実行し、その終了コードと標準出力を読み取ります。ログに何も残らない場合や、1 行のログだけでは判断できない場合に使用します。一例が NVMe タイムアウトチェックで、同じ 1 分以内に少なくとも 2 台のデバイスがタイムアウトした場合にのみ発火します。単一デバイスのタイムアウトは通常は自然回復する一時的な事象ですが、2 台同時に起きる場合はほぼ確実にホスト側の障害を意味するためです。もう 1 つの例は、ローカルの NVMe ディスクが適切にマウントされていることを確認するスクリプトです。
検知手法にかかわらず、私たちの構成で検知されたすべての問題は Node オブジェクト上に公開される Condition になります。これによりノードの問題が可視化され、対処できるようになります。
検知の速さよりも誤検知の少なさが重要
作業の大部分は、本番環境でのノード問題を調査し、それぞれを検知ルールに落とし込み、誤検知を避けるためにチューニングすることに費やされました。ユーザーのワークロードを移動させる処理は高コストで多少の中断を伴う可能性があるため、各チェックは単一の Pod の問題や一時的な不具合ではなく、ノード自体に問題があることを示す必要があります。また、誤ったネットワークポリシーや CNI の設定ミスといったクラスター全体の問題に対してアクションを起こすことも避けたいところです。ワークロードを移動させてもそれらは解決せず、かえって影響を悪化させる可能性が高いためです。
前述の NVMe タイムアウトチェックが影響を受けたデバイス数をカウントしているのはそのためです。ネットワークチェックは監視シグナルとしては有用ですが、緩和処置の対象にはしていません。リージョン規模の障害が発生するとすべてのノードが同じプローブに失敗するため、Pod を移動させても意味がないからです。Pod 作成チェックでは、ノードの CSI/CNI が初期化中で失敗が普通に起こり得る起動直後の数分間を無視します。想定外のケースについては、通常のオンコール手順に従って調査・対処します。
すべてのクラウドに同じチェックセットがデプロイされます。GCP と AKS は独自の NPD デーモンをデプロイしており、これらを無効化することはできません。プロバイダーのマネージド NPD がすでに報告している Condition については、同じ問題を二重に報告するのを避けるため、私たちの側のチェックをオフにしています。
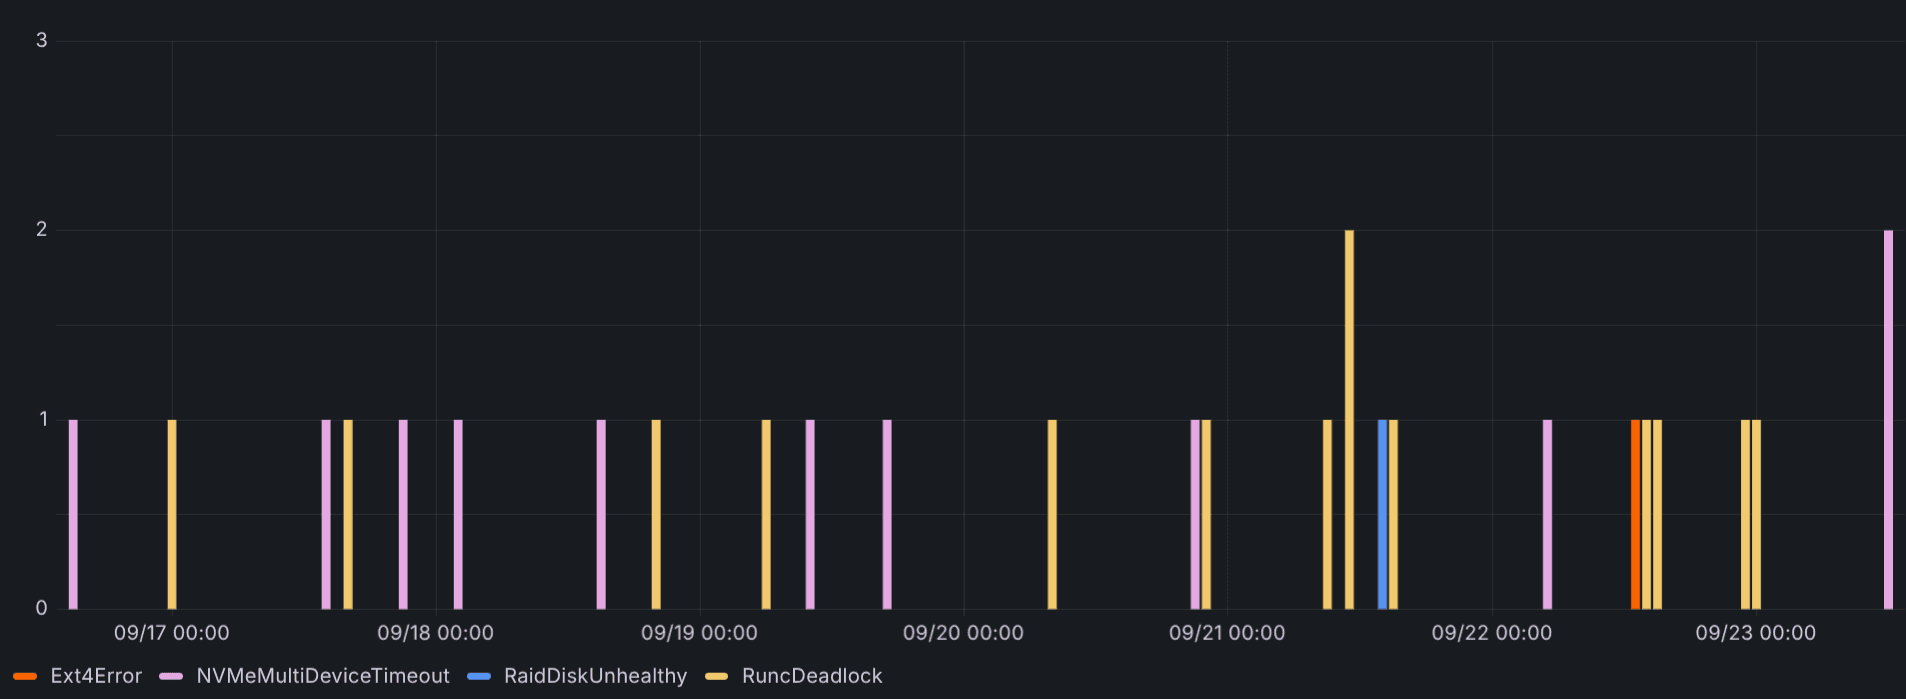
図: 本番ノードで 1 週間に検知された問題
Node Problem Mitigator: パッケージマネージャーではない方の NPM
緩和処置における課題
大いなる力には大いなる責任が伴います。つまり、既存のどのツールも「誤ったノードを停止させてしまう責任」を負いたがらないのです。結果として、私たちの目的にとっては力不足になりがちです。ノードに異常があると確信できたなら、確実に排除する必要があります。この点を踏まえると、ノード終了というタスクは「業界標準化」に非常に馴染みにくく、万能な解決策は存在しません。
問題は既存のツールが十分に洗練されていないことではなく、「終了のしきい値」が以下の要素によって大きく異なり得ることにあります。
- ワークロードの種類 (ステートフル / ステートレス)
- クラスター内で稼働するソフトウェアの成熟度 (PDB、SIGTERM の扱い、タイムアウト保証など)
- 組織の開発者文化 / クラスター運用者の思い切りの良さ (YOLO レベル)
方針を決定する前に、既存のオープンソースコントローラーを検討しました。
- Medik8s の node-healthcheck-operator および self-node-remediation。高機能ですが、CustomResource のインストールと設定が必要です。カーネルログの 1 行からノードの drain に至るまでの経路が、NPD、Condition、Operator、カスタムリソース、そして 2 つ目の DaemonSet を経由することになります。私たちの要件に対して構成要素が多すぎるうえ、必要に応じたカスタムロジックの実装も容易ではありませんでした。
- Draino。開発が停止しており、最終コミットは約 6 年前です。drain しか行いません。
- Cluster API MachineHealthChecks。解決したい課題に対して、アーキテクチャ変更の規模が大きすぎました。
- 新しいアップストリームの node-readiness-controller と descheduler の組み合わせ。カスタムコードが不要で、すでに運用しているコンポーネントを再利用できます。しかし結合が疎であり、descheduler の設定にミスがあるとノードに taint が付くだけで決して drain されません。また、インスタンスの終了など後続のステップを制御する手段もありませんでした。さらに、プロジェクト開始時点では Node Readiness Controller 自体が未成熟でした。
- Karpenter 独自のノード自動修復。GCP および Azure のクラスターでは Karpenter を稼働させていません。機能自体も AWS ノードエージェントに依存しており、クラウド間の一貫性を確保できません。
独自の NPM
そこで私たちは、「異常なノードを望ましい積極度で停止させる」というシンプルな使命を持つ独自のコントローラーを構築しました。このコントローラーはノードの破棄・削除のみを行い、ノードの良否は一切判断しません。その判断は node-problem-detector に委譲されています。
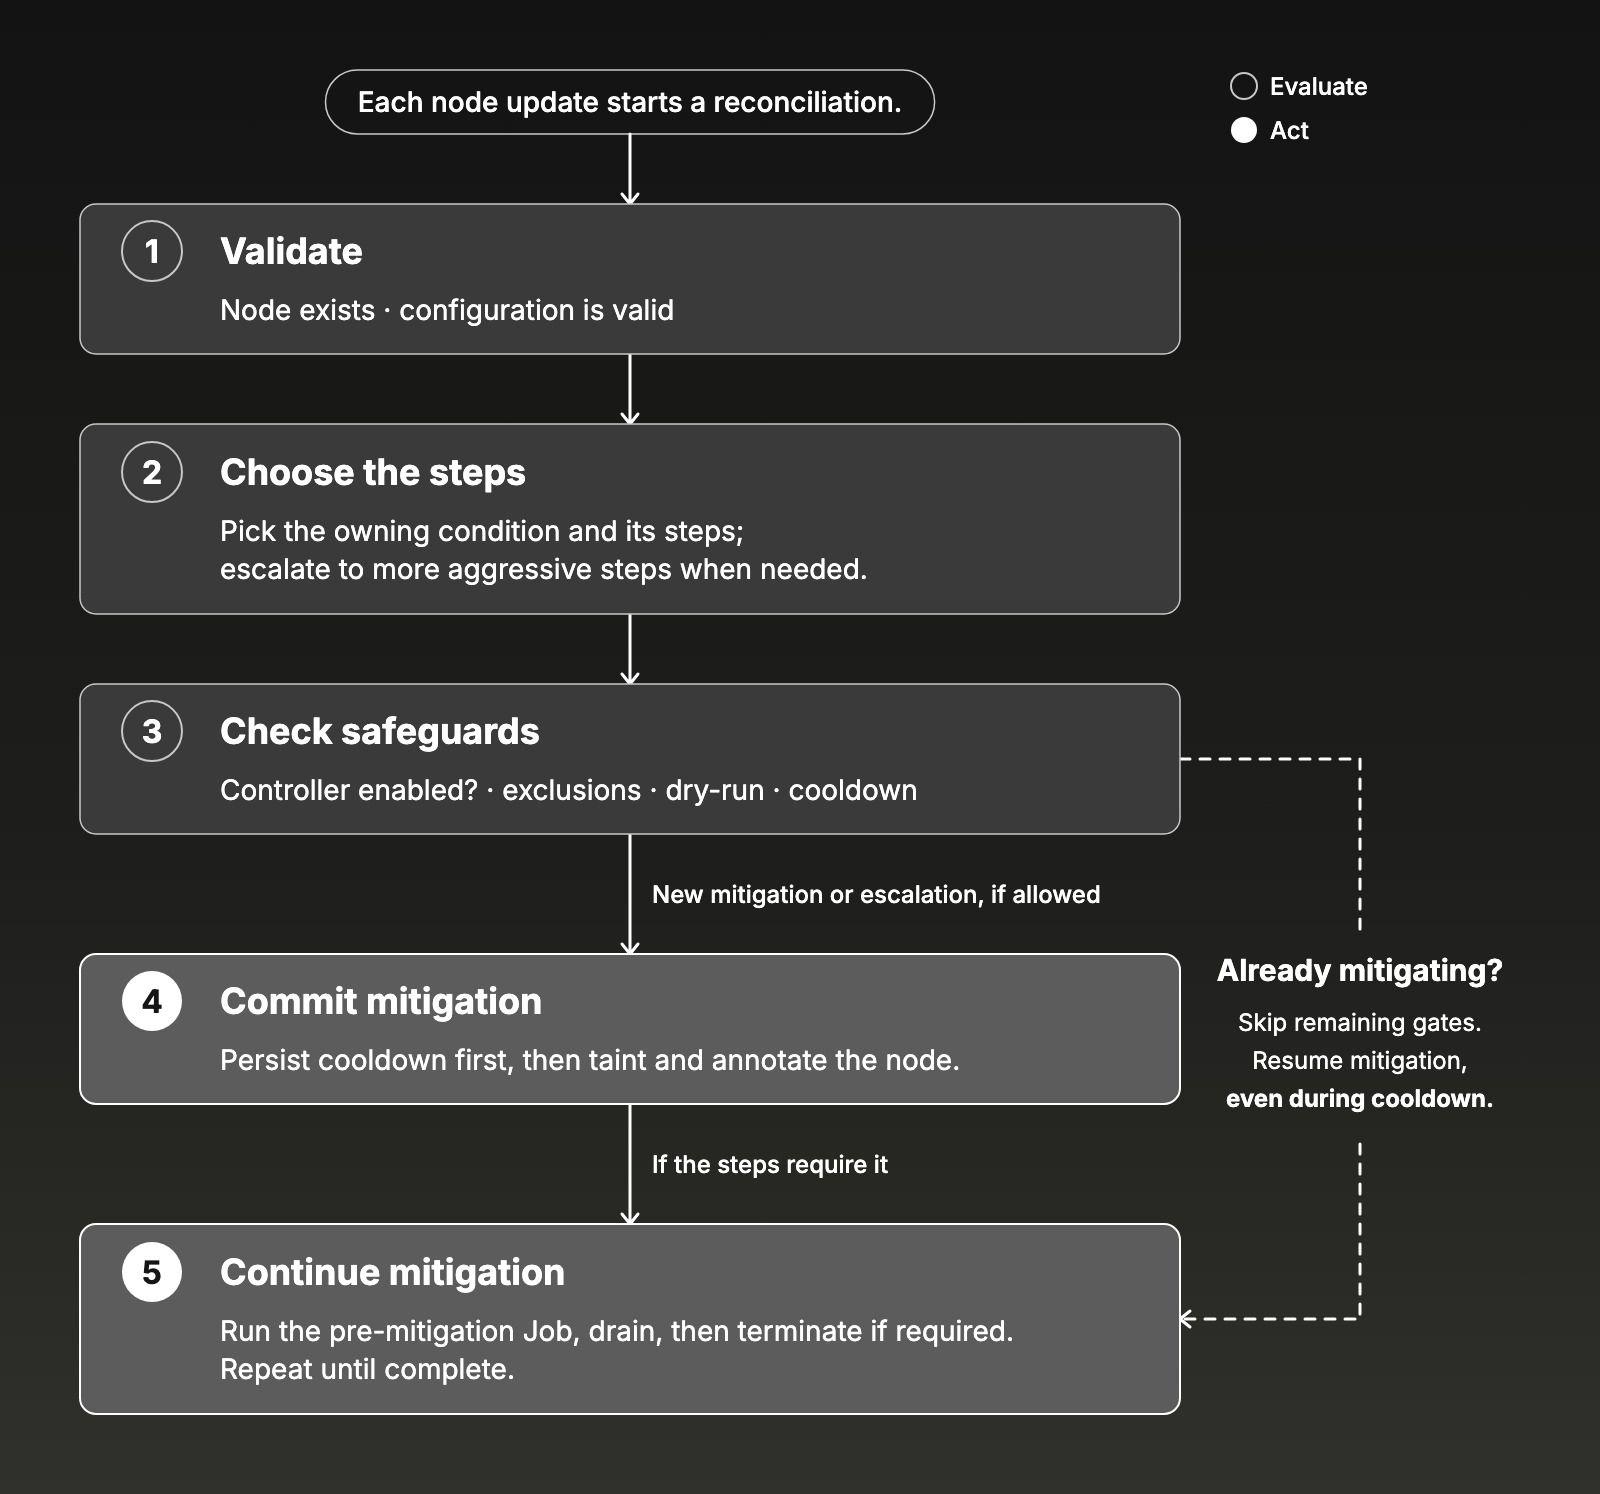
コントローラーはノードのステータスと Condition を監視し、各 Condition にはノードに対する緩和ステップが設定されます (穏健なものから積極的なもの順):
- Evaluate: 状況を監視するためのドライラン
- Drain: PDB を尊重しながら Pod をグレースフルに退避
- Terminate: (タイムアウト付きで) drain した後、インスタンス/VM を終了
進行中の緩和処置に対して (より積極的なステップを持つ別の Condition が発火した場合に) ステップを変更することは可能ですが、方向はより積極的なステップへの一方通行のみです。
選択されたステップにかかわらず、緩和前の Job によってまずノードのデバッグ情報を収集できます (次節の NDC を参照)。デバッグバンドルの収集はデフォルトでベストエフォートであり、異常なノードを可能な限り迅速に排除できるよう、緩和処置をブロックしません。
安全性
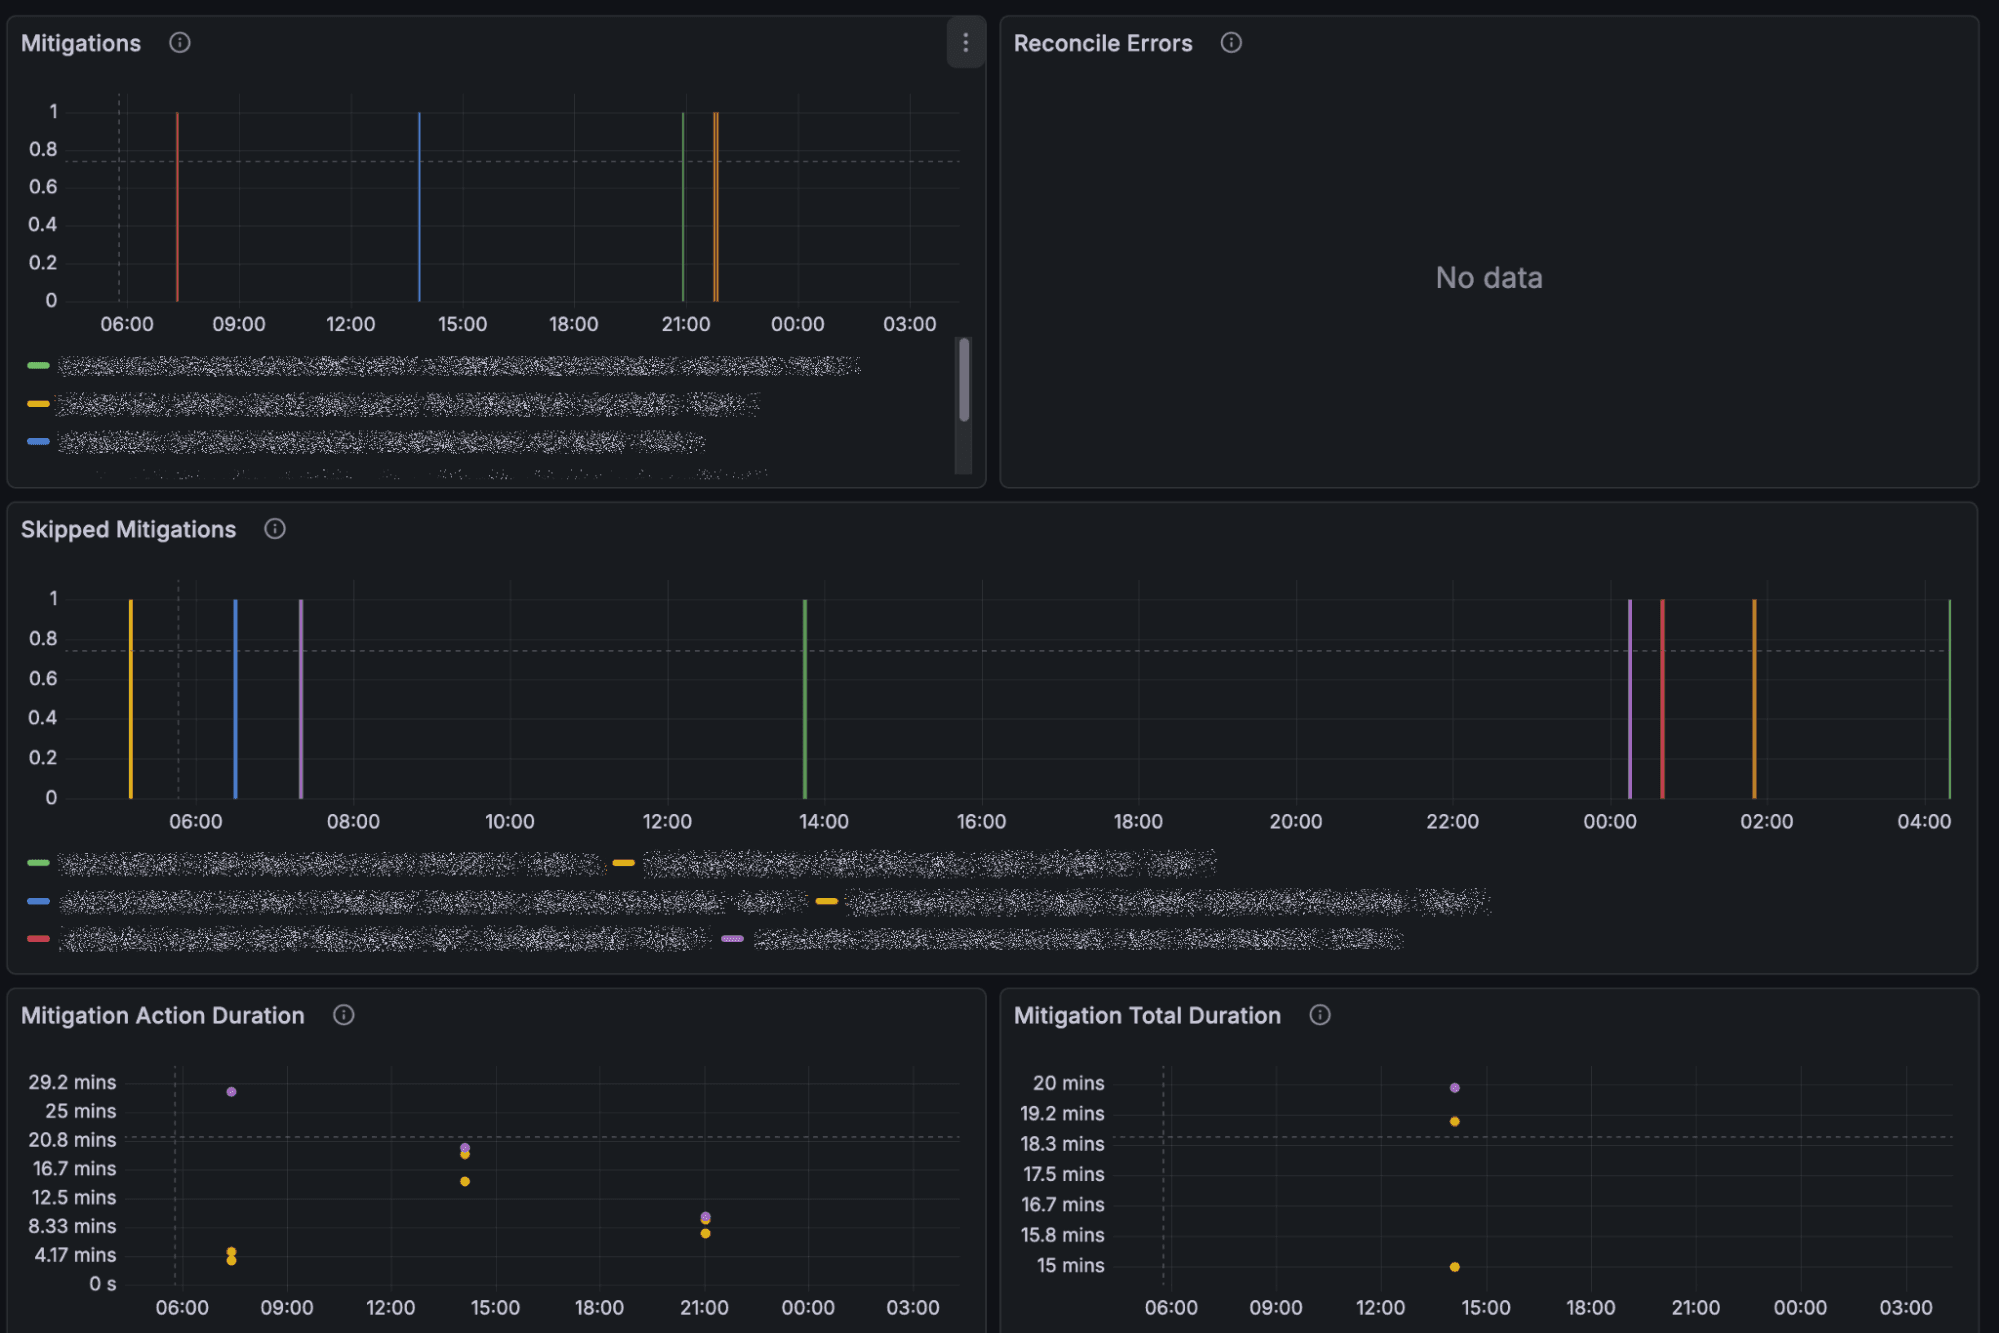
このような仕組みを本番クラスターにデプロイする際、真っ先に頭に浮かぶのは「もし〜だったらどうする?」という懸念です。一度に大量のノードを削除し始めたら? 停止させる前に人間が確認したいワークロードがあったら? node-problem-mitigator は、緩和処置に伴うリスクを抑えるために多様な安全ゲートを備えています。
- キルスイッチ: コントローラーのあらゆる動作を停止させる ConfigMap の値
- ドライラン / 評価モード: 実際には実行せず、行われるはずの緩和処置をプレビュー
- 除外設定: ワークロードの Namespace、ノードの taint、annotation、label に基づき対象ノードをフィルタリングしてスキップ可能
- グローバルなノード緩和クールダウン: ノードを緩和処置できるペースの制限。たとえば (クラスターあたり) 15 分につき最大 1 ノードの緩和処置、といった設定が可能
- 各種メトリクスの公開と、スタックした緩和処置や異常に多い緩和処置件数などに対するアラート発報
ロールアウト
これほど「危険な」ツールをロールアウトするのは大きな責任を伴います。幸い、私たちのチームには一歩ずつ着実に進める勇気がありました。
- まずは Condition とそのパターンの評価から開始します。プロセス全体にセンサーとアラートを手厚く配置し、最初は手動でダッシュボードを監視します。
- 確信が持てた Condition に対して、段階的により積極的な緩和処置を設定します。
- 開発環境とステージング環境から始め、常に本番環境の一歩先を行く状態を保ちます。
- 設定はきめ細かく保ちます。Condition によってリスクの高さは異なるためです。
node-problem-mitigator はオープンソースとして公開しており、コントリビューションを歓迎しています:
https://github.com/ClickHouse/node-problem-mitigator
Node Debug Collector: ノードから証拠を取得する
疑わしいノードを検知したとき、最初にやりたいのはログ、メトリクス、システムステータスなどのテレメトリをそこから取り出すことです。ノードが削除されてしまえば、有用かもしれない診断情報は失われます。異常なノードを置き換える直前に、そのデバッグバンドルを手元に残せたら素晴らしいと思いませんか?
クラウドサービスプロバイダーごとにデバッグバンドルの収集手法は異なりますが (EC2RL、AKS periscope)、いずれもクラウド固有であり、主に各社のサポート窓口向けに作られています。クラウドごとに異なる認可方式や収集手法を使い分け、ノードとクラウドインスタンスの表現を突き合わせる必要があり、デバッグ情報の収集は煩雑になりがちです。特にインシデント対応中にはかなりの負担になります。
私たちがサポートする 3 社の CSP のうち、GCP が使用しているツールが私たちの要件に最も近いものでした。それが sosreport です。モジュラー性が高く、オープンソースで、クラウドに依存しません。実際、搭載されているプラグインの数は膨大だったため、サポートされているすべてのコレクターを精査し、私たちのクラスターに関連するコレクターだけを含むようパッケージを絞り込む必要がありました。
これでコレクターは揃いました。残る作業は、それを異常なノードに送り込み、実行し、結果を回収することだけです。ところが実際には、ここがデバッグ収集において最も難しい部分であることが判明しました。3 社の異なるクラウドプロバイダーを利用していることに加え、対象ノード自体が異常を抱えているため、配信と実行は容易ではありません。異常なノードはテレメトリ収集に対して適切に出力・応答できないほど状態が悪化していることもあれば、完全に応答不能になっていることもあります。
この課題に対する私たちのアプローチは以下のとおりです。
- まず kubectl cp と kubectl run の使用を試みます。
- kubelet が停止している場合は、トランスポートとして SSM/S3 (および GCP/Azure における同等サービス) にフォールバックします。
- オプションとして snapshot モードで実行し、オフラインでデバッグ情報を収集します。スナップショット経由でルートボリュームをクローンし、一時的なインスタンス/VM を作成してルートボリュームをアタッチし、オフラインで取得可能なあらゆる情報を収集します。
snapshot モードは「繊細な」ノード、つまりコレクター自体の実行がもたらすわずかな負荷すら懸念されるノードに対しても利用できます。
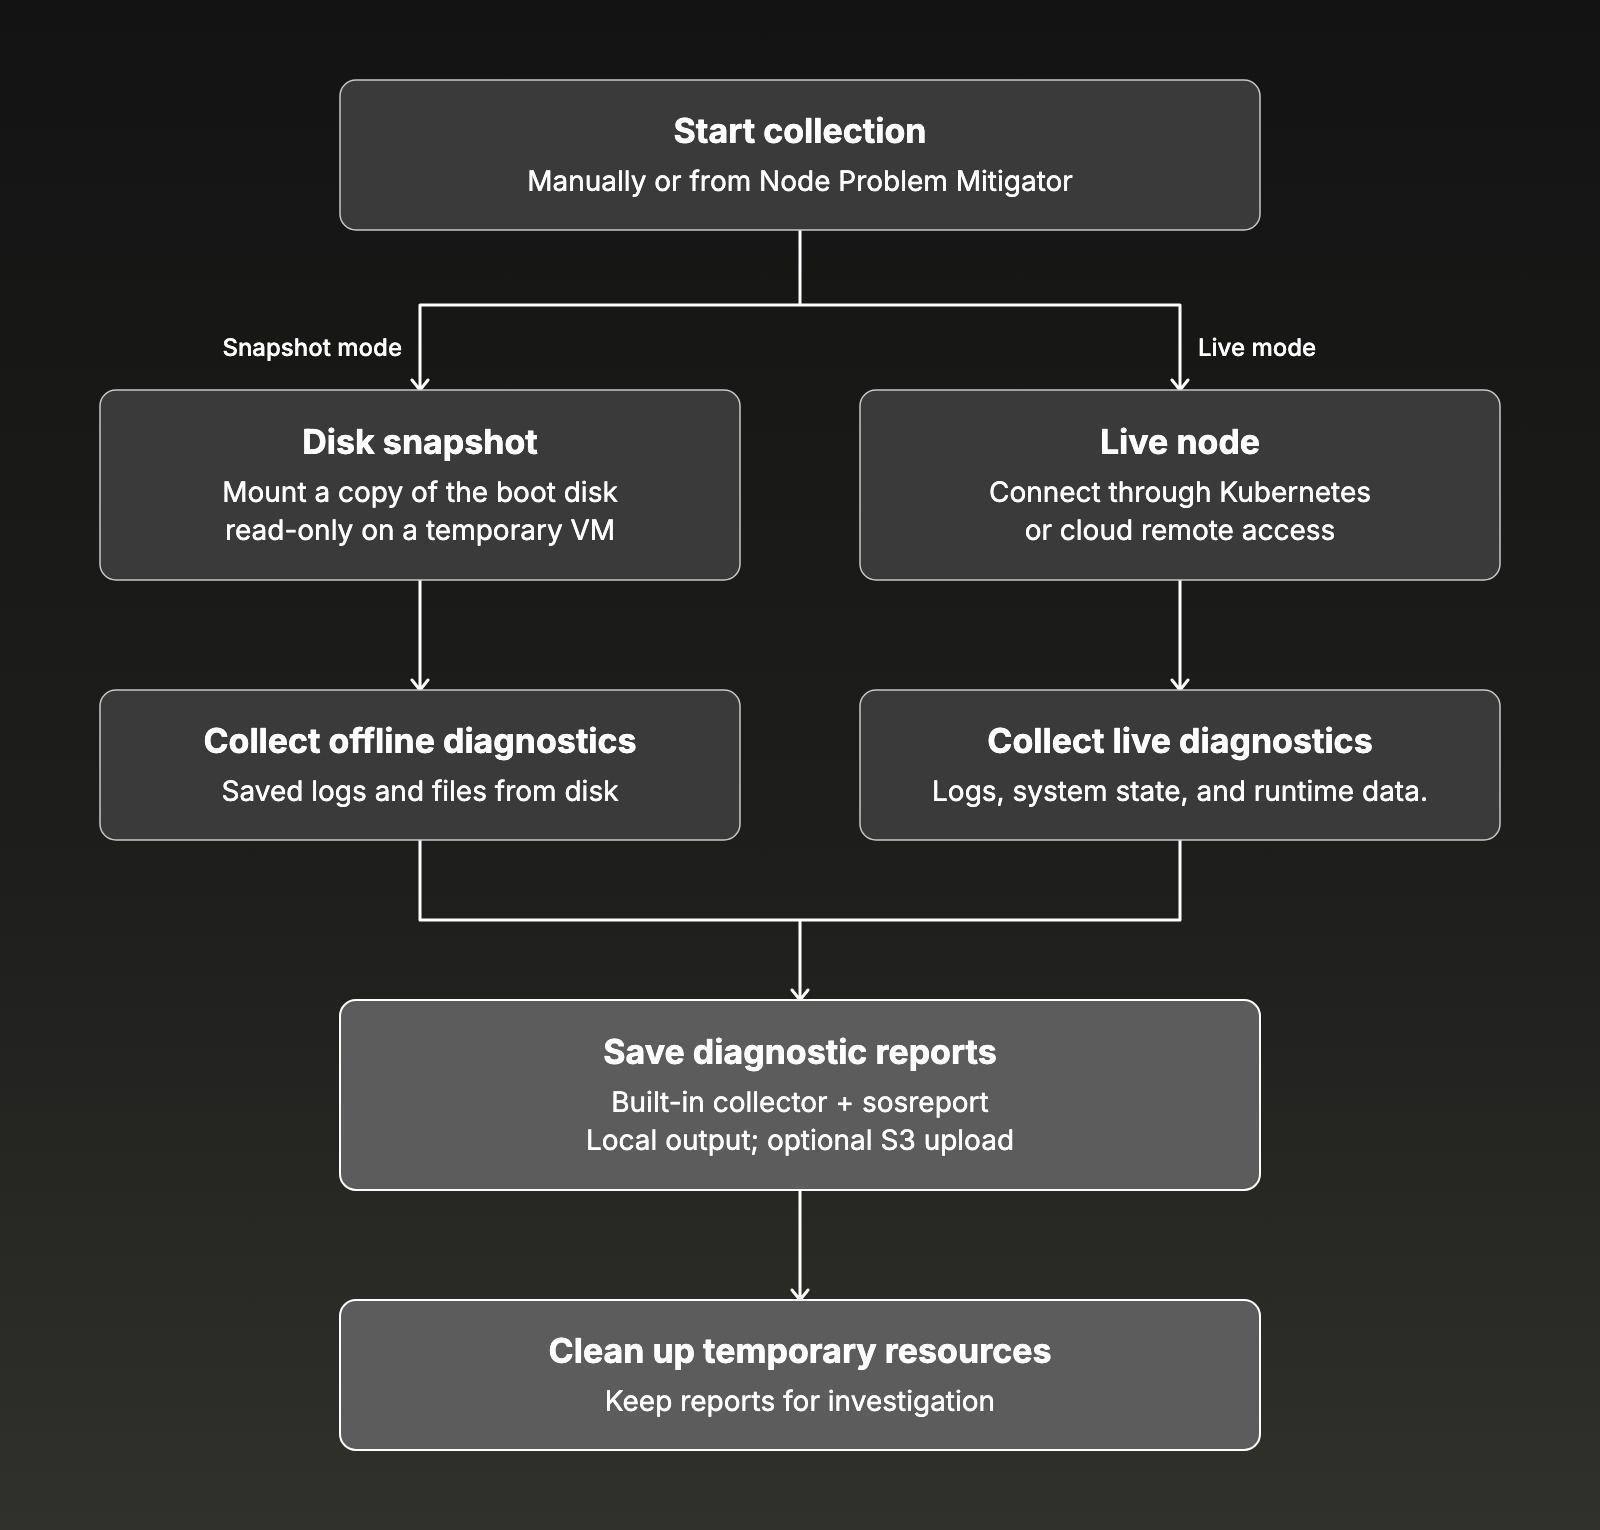
このツールは開発者が手動で使用できるほか、node-problem-mitigator から自動トリガーすることも可能です。いずれの場合も CSP 固有の差異は安全に抽象化されているため、単一のコマンドで収集を実行でき、クラウド固有の情報は ProviderID などのノード属性から推論されます。データプライバシーポリシーを遵守するため、機密データはノードからダンプされません。
まとめ
NPD + NPM + NDC システムのロールアウト以降、毎月多数の異常ノードを自動で修復しています。こうした問題に対する可視性が向上したことで、新たな故障モードを発見できるようになったほか、VM 設定の変更を本番環境へデプロイする前に検証することも可能になりました。診断情報は自動的に収集されるため、遅延なく CSP のサポートに提出できます。
他のあらゆる「信頼性向上」の取り組みと同様、これにもシステムの複雑性増大というコストが伴います。新たな自動化は新たな故障モードを生むため、私たちはこうした新しい課題を確実に理解し、備えることに注力しました。広すぎる検知ルールは問題を解決しないまま健全なノードを drain してしまう可能性があり、mitigator のバグは一度に過剰な数のノードを drain したり、逆にアクションを起こさずエラーを握りつぶしたりする恐れがあります。それでもこのトレードオフを受け入れたのは、安全ゲート (キルスイッチ、ドライラン、レート制限、除外設定) によってこれらの故障モードのそれぞれが影響範囲の限定された観測可能なイベントに変わるからであり、また私たちが完全には制御できないプロバイダー固有の 3 種類の修復メカニズムよりも、3 社のクラウドで同じように動作する単一のコントローラーの方が挙動を把握しやすいためです。
なお、本システムは VM の問題に関する外部シグナルには反応しない点に留意してください。AWS は EC2 インスタンスのステータスチェックを公開しており、GCP には Shielded Node の整合性モニタリングがあり、Azure はノード自動修復の失敗に関する Kubernetes イベントを公開しています。また、NPD が CPU やネットワークリソースの割り当てを得られず一切の Condition を公開できないほど完全に応答不能になったノードに対しても、アクションを起こしたいケースがあるでしょう。こうした状況への対処については、今後の記事で取り上げる予定です。
ClickHouse でこのようなプロジェクトを実装するチームへの参加に興味がある方は、ぜひご連絡ください。
今すぐ始める
お使いのデータで ClickHouse がどのように機能するか試してみませんか。ClickHouse Cloud は数分で利用を開始でき、300 ドル分の無料クレジットが付与されます。
サインアップ